פרוטוקול זה מציג תהליך עבודה הניתן לשחזור לפיתוח, הערכה ופירוש של מודלים של בינה מלאכותית ניתנת להסבר (explainable artificial intelligence) בתחום הבריאות. הוא משלב הכנה סטנדרטית של נתונים, פיתוח מודלים, טכניקות להסברתיות, הערכה כמותית ופרקטיקות לשחזור, במטרה לשפר את השקיפות, האמינות וההיתכנות הקלינית.
מאמר שיטה
פרוטוקול ניסויי הניתן לשחזור לפיתוח ולהערכה של מודלים של בינה מלאכותית ניתנת להסבר במערכות בריאות
במאמר זה
סיכום
תקציר
בינה מלאכותית (AI) מאומצת יותר ויותר ככלי בעל ערך לקבלת החלטות קליניות, לניבוי מחלות, לאבחון רפואי ולטיפול רפואי מותאם אישית. עם זאת, מחסור בשקיפות, יישום לא עקבי של שיטות בינה מלאכותית הניתנת להסבר (XAI) ויכולת שחזור מוגבלת נותרים מחסומים מרכזיים לפריסה מהימנה של מודלי AI במסגרות קליניות. מאמר זה מציע פרוטוקול סיסטמטי, שחזיר ושקוף לפיתוח, הערכה ופירוש של מודלי XAI ליישומים בתחום הבריאות. זרימת העבודה מתחילה בהגדרת סביבת המחשוב, ולאחריה רכישת נתונים ואפיון, עיבוד מקדימ (preprocessing), הנדסת תכונות, פיתוח מודל, אופטימיזציה של היפר-פרמטרים, הערכת ביצועי ניבוי, ניתוח יכולת הסבר, תיקוף סטטיסטי והערכת יכולת שחזור. הפרוטוקול משלב שיטות XAI כגון SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), Integrated Gradients, ויזואליזציה של קשב (attention visualization) והסברים נגדיים (counterfactual explanations) כדי להפיק פרשנויות של המודל הן ברמה הגלובלית והן ברמה המקומית. הפרוטוקול שם דגש על מספר מרכיבים מרכזיים, כולל הכנת מאגרי נתונים רפואיים סטנדרטיים, פיתוח מודלי למידת מכונה יציבים, הערכת ביצועי ניבוי, הפקת הסברים רלוונטיים מבחינה קלינית והערכה סטטיסטית של יכולת השחזור בניסויים חוזרים. על ידי שילוב פיתוח מודלים, יכולת הסבר, הערכה כמותית ואיכותית, תיקוף סטטיסטי והערכת יכולת שחזור לתוך זרימת עבודה מאוחדת, פרוטוקול זה מספק מסגרת מקיפה לפיתוח מודלי AI שקופים ושחזירים ליישומים בתחום הבריאות.
מבוא
הבינה המלאכותית (AI) הפכה למרכיב בלתי נפרד מהטיפול הרפואי המודרני, בכך שהיא מאפשרת ניתוח חכם של נתונים קליניים מורכבים ותומכת בקבלת החלטות רפואיות מבוסות ראיות1. הדיגיטציה המהירה של מערכות הבריאות באמצעות רשומות רפואיות אלקטרוניות, מערכות דימות רפואי, מכשירים לבישים וטכנולוגיות גנומיקה, ייצרה נפחים גדולים של נתונים הטרוגניים הדורשים גישות חישוביות מתקדמות לצורך פרשנות יעילה2.
אלגוריתמים של למידת מכונה (ML) ולמידה עמוקה (DL) הדגימו יכולות מרשימות במיצוי תבניות משמעותיות מתוך מאגרי נתונים רב-ממדיים של שירותי בריאות, ובכך שיפרו את דיוק האבחון, את חיזוי המחלה ואת הערכת תוצאות הטיפול במטופלים3. מודלים מבוססי בינה מלאכותית (AI) יושמו בהצלחה ברדיולוגיה, פתולוגיה, קרדיולוגיה, אונקולוגיה, אופתלמולוגיה והתמחויות רפואיות אחרות כדי לסייע לקלינאים בזיהוי מחלות בשלבים מוקדמים יותר ובהמלצה על אסטרטגיות טיפול מותאמות אישית4. טכנולוגיות אלו תרמו גם לאופטימיזציה של זרימת העבודה, להפחתת השונות באבחון ולשיפור בניצול משאבי הבריאות5.
התפתחויות אחרונות בחומרת מחשוב, במחשוב ענן ובמסגרות AI בקוד פתוח האיצו את הפיתוח והפריסה של יישומים חכמים לבריאות6. כתוצאה מכך, AI הפכה לטכנולוגיה מאפשרת מרכזית לרפואה מותאמת אישית ומערכות לתמיכה בקבלת החלטות קליניות7. למרות התקדמויות אלו, האימוץ הנרחב של AI בפרקטיקה קלינית שגרתית נותר מוגבל, מכיוון שדגמים בעלי ביצועים גבוהים רבים מספקים תובנה מועטה לגבי האופן שבו התחזיות שלהם נוצרות8.
מרבית אלגוריתמי הלמידה העמוקה פועלים כמודלים מורכבים של "קופסה שחורה", שבהם תהליך קבלת ההחלטות הפנימי קשה להבנה עבור קלינאים וחוקרים9. למרות שמודלים אלו משיגים לעיתים קרובות ביצועים חיזויים מצוינים, חסרון השקיפות שלהם פוגע באמון המשתמש ומציב אתגרים בתהליכי תיקוף קליני, אישור רגולטורי ובטיחות המטופל10. אנשי מקצוע בתחום הבריאות חייבים להיות מסוגלים לנמק החלטות הנתמכות על ידי בינה מלאכותית לפני שילובן בפרקטיקה קלינית שגרתית, במיוחד בסביבות רפואיות בסיכון גבוה1.
XAI הגיחה כגישה יעילה לשיפור השקיפות והיכולת להסבר (interpretability) של מודלים של למידה מכונה12. במקום להתייחס למודלים של חיזוי כמערכות אטומות, טכניקות של XAI מספקות מידע על המאפיינים, אזורי התמונה או המשתנים הקליניים התורמים לחיזויים בודדים13. הסברים אלו מאפשרים לקלינאים להבין טוב יותר את התנהגות המודל, לזהות הטיות פוטנציאליות ולקבוע אם החלטות שנוצרו על ידי AI עקביות עם ידע רפואי מבוס14.
מספר טכניקות להסברתיות (explainability) הוצגו עבור יישומים בתחום הבריאות. SHapley Additive explanations (SHAP) מודדות את תרומתו של כל מאפיין לניבוי המודל על בסיס תורת המשחקים השיתופית15. Local Interpretable Model-agnostic Explanations (LIME) יוצרות מודל מפושט ומסבירות את הניבויים של מודל "הקופסה השחורה"16. עבור משימות של דימות רפואי המשתמשות במודלים של למידה עמוקה, Gradient-weighted activation maps (Grad-CAM) יוצרות מפות חום המצביעות באופן ויזואלי על אזורי התמונה התורמים להחלטות הסיווג17. השילוב של שיטות אלו שיפר באופן דרמטי את השקיפות של מערכות בינה מלאכותית בתחומי בריאות שונים18.
למרות התשומת הלב הגוברת לשיטות הסביריות (explainability) במסגרות של שירותי בריאות, השימוש בהן נותר מגוון בספרות המקצועית. חוקרים נבדלים לא רק בשימוש באסטרטגיות עיבוד מקדים, אלא גם בתכנון ארכיטקטורת המודל, במדדי ההערכה ואפילו בטכניקות ההסבר19. כמו כן, מאמרים רבים מדווחים על דיוק חיזוי גבוה אך נכשלים במתן הערכה מעמיקה של איכות ההסברים או של יכולת השחזור שלהם20.
שחזוריות היא אחד מצווארי הבקבוק המרכזיים במדעי הבינה המלאכותית (AI) המודרניים. מאמרים רבים אינם חושפים את גרסת התוכנה, סביבת החישוב, צינור העיבוד המקדים (preprocessing pipeline), הגדרות ההיפר-פרמטרים, אתחול הזרע האקראי (random seed) ותצורות החומרה21. בשל כך, חוקרים עצמאיים נכשלים לעיתים קרובות בשחזור תוצאות שפורסמו או באימות השיטות שפורסמו באמצעות מערכי נתונים או פלטפורמות תוכנה אחרות2. היעדר תיעוד מפורט הוא אחד הגורמים המעכבים מחקרי השוואה (benchmarking), מחקר שיתופי ותרגום קליני של מערכות AI23.
בשל אתגרים אלו, מספר ארגונים וסוכנויות רגולטוריות הדגישו את החשיבות של בינה מלאכותית (AI) שקופה, מהימנה וניתנת לשחזור עבור יישומים בתחום הבריאות24. הנחיות הדיווח הקיימות שיפרו את הדיווח המתודולוגי, אך הן מתארות בעיקר מה יש לדווח במקום לספק פרוצדורות ניסיוניות סטנדרטיות שחוקרים יכולים ליישם באופן ישיר25. כתוצאה מכך, נותר צורך בפרוטוקול מקיף המשלב הכנת מערכי נתונים, פיתוח מודלים, ניתוח יכולת הסבר (explainability), הערכה סטטיסטית ופרקטיקות לשחזור, בתוך זרימת עבודה ניסיונית אחת26.
פרוטוקול ניסיוני סטנדרטי מציע מספר יתרונות עבור קהילת ה-AI בתחום הבריאות. יתרה מכך, הוא מקדם עקביות מתודולוגית, מקל על השוואה בין מחקרים עצמאיים, מגביר את השקיפות של ניסויים חישוביים, ומאפשר תיקוף מהימן של תוצאות שפורסמו27. זרימות עבודה סטנדרטיות מסייעות גם לחינוך/הכשרה, למחקר שיתופי ולהערכה רגולטורית באמצעות נהלים מתועדים בבירור שניתן לשחזר אותם במעבדות ובמוסדות בריאות שונים28.
פותח ונבדק פרוטוקול ניסויי הדיר לביצוע אימון והערכה של מודלי AI במערכות בריאות. הפרוטוקול מתווה סטנדרטים להגדרת הסביבה החישובית, עיבוד מקדים של מאגרי נתוני בריאות, פיתוח מודלים של למידת מכונה, יישום שיטות XAI, הערכת ביצועים חיזויים, ביצוע תיקוף סטטיסטי והערכת הדירות29. שילוב של רכיבים אלו למסלול עבודה קוהרנטי צפוי להגביר את השקיפות, האמינות וההדירות של מחקרי AI בתחום הבריאות, וכן לסייע בפיתוח מערכות בריאות חכמות ומהימנות30.
פרוטוקול
ניסוי התיקוף שבוצע השתמש במאגר הנתונים Pima Indians Diabetes, הזמין לציבור ומנופה מפרטים מזהים, ולא כלל רשומות מטופלים שניתן לזהותם או גיוס מטופלים חדשים. לפיכך, לא נדרשו הסכמה מדעת או אישור IRB/ועדת אתיקה מוסדית, וכל הניתוחים בוצעו בהתאם לתנאי השימוש הרלוונטיים של מאגר הנתונים ולמדיניות המחקר המוסדית.
דוגמת התיקוף המעשית משתמשת במאגר הנתונים Pima Indians Diabetes Dataset הזמין לציבור, המכיל 768 רשומות לחיזוי בינארי של סוכרת. זרימת העבודה הליבתית המלאה בתשעה שלבים יושמה על מאגר נתונים זה. תשעת שלבי הליבה כללו בחירת מאגר נתונים ותיקופו, הגדרת סביבת מחשוב, עיבוד מקדמי של הנתונים, חלוקת מאגר הנתונים, פיתוח ואימון מודל, הערכת ביצועים חיזוית וחישובית, ניתוח יכולת הסבר, תיקוף סטטיסטי והערכת שחזוריות. תיקוף חיצוני והערכה של מומחים קליניים נשמרו כמודולי תיקוף אופציונליים ולא בוצעו בדוגמה המעשית הנוכחית. איור 1 ממחיש את זרימת העבודה של הפרוטוקול המרכזי, ו טבלה 1 מסכם אך ורק את תשעת שלבי הליבה שיושמו בתיקוף הנוכחי; תיקוף חיצוני אופציונלי והערכה של מומחים קליניים מתוארים בנפרד במסגרת הפרוטוקול ואינם נכללים בין תשעת השלבים הניסיוניים.
1. בחירה ותיקוף של מערך נתוני הבריאות
- בחר את מערך הנתונים Pima Indians Diabetes כמאגר הנתונים הראשי עבור דוגמת התיקוף המעשית. ודא את מקור הנתונים, גודל המדגם, יעד הניבוי, התפלגות המחלקות ומבנה הנתונים.
- החל את קריטריוני ההכללה, ההדרה ואיכות הנתונים שהוגדרו מראש. הסר רשומות כפולות ורשומות לא תקינות לפני פיתוח המודל.
- תעד את מקור הנתונים, המאפיינים, משימת הניבוי, התפלגות המחלקות, קריטריוני ההכללה וההדרה, ואת אסטרטגיית החלוקה בטבלה 2.
- החל קריטריוני החלטה לבחירת מאגר הנתונים והמודל
- הגדר את מטרת הניבוי לפני בחירת מאגר הנתונים, ארכיטקטורת המודל, אסטרטגיית העיבוד המקדים או שיטת ההסביריות.
- התאם את מודליות הנתונים למטרת הניבוי. בחר בנתונים טבלאיים עבור משתנים קליניים מובנים, בנתוני דימות עבור תמונות רפואיות, בנתוני סדרות זמן עבור אותות פיזיולוגיים, בנתוני טקסט עבור תיאורים קליניים, או בנתונים מולטי-מודאליים כאשר קיימות מודליות משלימות עבור אותו מטופל או יחידת מחקר.
- הערך מאגרי נתונים מועמדים על פי גודל המדגם, זמינות התוצאות, התפלגות המחלקות, נתונים חסרים, איכות האנוטציה, רלוונטיות קלינית, שלמות הנתונים ונגישות. בחר במאגר הנתונים העומד בדרישות שהוגדרו מראש.
- בחר מודלים קונבנציונליים של למידת מכונה עבור נתונים טבלאיים מובנים כאשר גודל המדגם, המשאבים החישובים או דרישות הפרשנות מגבילים את השימוש בארכיטקטורות מורכבות. בחר ארכיטקטורות של למידה עמוקה כאשר זמינים נתוני אימון מספיקים וקלטים רב-מדיים, כגון תמונות רפואיות, אותות פיזיולוגיים או טקסט קליני.
- בחר ארכיטקטורות מולטי-מודאליות רק כאשר קיימות מספר מודליות עבור אותו מטופל או יחידת מחקר, וניתן לסנכרן ביניהן באופן מהימן מבלי לגרום לדליפת מידע. בחר פעולות עיבוד מקדים בהתאם למאפייני מודליות הנתונים שנבחרה.
- בחר שיטות הסביריות בהתאם למודל ולמודליות הנתונים. השתמש בשיטות שאינן תלויות מודל (model-agnostic) כגון SHAP או LIME עבור מודלים טבלאיים מתאימים, ובשיטות ספציפיות למודליות כגון Grad-CAM עבור מודלים מבוססי תמונה, במידה ורלוונטי.
- תעד את הרציונל לבחירת מאגר הנתונים, אסטרטגיית העיבוד המקדים, המודל ושיטת ההסביריות. שמור החלטות אלו כחלק מתיעוד השחזור.
2. הגדרת הסביבה החישובית לפיתוח מודל XAI
- הגדירו את מערכת ההפעלה, המעבד (CPU), הזיכרון (RAM), האחסון ומעבד הגרפי (GPU) בהתאם לדרישות המודל שנבחר. צרו סביבת Python מבודדת והתקינו את הספריות הנדרשות ללמידת מכונה, למידה עמוקה, סטטיסטיקה, ויזואליזציה ובינה מלאכותית ניתנת להסבר (XAI).
- תעד את סביבת החישוב בפועל, את ארכיטקטורת המודל ואת ההיפר-פרמטרים ששימשו לצורך התיקוף המעשי ב- טבלה 3פרטו את האופטימייזר (optimizer), קצב הלמידה (learning rate), גודל האצווה (batch size), מספר האיפוכים (epochs) המקסימלי, פונקציית ההפסד (loss function), פרמטרי רגולריזציה, אסטרטגיית התיקוף (validation strategy), הגדרות עצירה מוקדמת (early-stopping), הגדרות גרעין אקראי (random-seed), שיטות להסברתיות (explainability methods), חומרה, מערכת הפעלה, גרסת Python וגרסאות של ספריות תוכנה רלוונטיות. הפרידו בין הגדרות אלו, ששימשו בניסוי, לבין הגדרות פרוטוקול כלליות או מומלצות.
- השתמשו בתצורה שדווחה ב- טבלה 3 בעת שחזור התיקוף של מערך הנתונים של סוכרת באינדיאנים מפيمه (Pima Indians Diabetes Dataset) והתוצאות התואמות של הניבוי, ההסביריות, הסטטיסטיקה והשחזור.
- הריצו סקריפט אימות כדי לאשר ייבוא מוצלח של חבילות, טעינת מערך נתונים, הרצת מודל ויצירת פלט. שמרו את הגדרות הסביבה הסופיות לצורך שחזור.
3. הכנה ואפיון של מערכי נתונים רפואיים לפיתוח מודלי XAI
- בחירה והשגה של מערך נתוני שירותי הבריאות
- בחרו מערך נתונים רפואי המתאים למשימת הניבוי הקליני שהוגדרה. העריכו מערכי נתונים מועמדים בהתאם למטרת המחקר, סוג הנתונים, גודל המדגם, איכות התיעוד (annotation), האיזון בין המחלקות והרלוונטיות הקלינית.
- העדף שימוש במאגרי נתוני ייחוס (benchmark datasets) הזמינים לציבור כאשר הם נותנים מענה הולם למשימת הניבוי ומאפשרים תיקוף עצמאי.
- יש להשיג את האישורים האתיים הנדרשים, את ההיתרים המוסדיים ואת האישור לגישה לנתונים לפני רכישת מאגרי נתונים מוסדיים או פנימיים. יש להשיג את מאגר הנתונים הנבחר ממאגר מאומת או ממאגר נתונים מוסדי מורשה.
- שמרו את קבצי מערך הנתונים המקוריים ללא שינוי, ותעדו את ספק מערך הנתונים, הגרסה, מידע על הרכישה, תנאי הרישוי, קריטריוני הכללה, קריטריוני החרגה ומטא-נתונים נלווים. ארגנו את מערך הנתונים בספריות נפרדות עבור נתונים גולמיים, הערות (annotations), מטא-נתונים ומידע משלים.
- אפיינו את מערך הנתונים של שירותי הבריאות
- זהו את משתני הניבוי, תוויות התוצאה, סוגי המאפיינים, מודליות הנתונים והתפלגויות המחלקות. קבע את מספר הנבדקים, הדגימות, ממדי המאפיינים וההערות הזמינות.
- יש לוודא שמאפייני מערך הנתונים תואמים לשיטת ה-AI שנבחרה.
- השתמשו במאגר הנתונים של סוכרת בקרב אינדיאנים מפמיי (Pima Indians Diabetes Dataset) כמאגר הנתונים הניסיוי המעובד היחיד לתיקוף הפרוטוקול המרכזי בן תשעת השלבים. כללו את מאגרי הנתונים הנוספים המפורטים ב- טבלה 2 רק כדי להדגים את ישימותו של הפרוטוקול הכללי על פני נתונים טבלאיים קליניים, רשומות בריאות אלקטרוניות, תמונות דרמוסקופיות, נתוני סדרות עתיות פיזיולוגיות ודימות רפואי. אין להשתמש במאגרי נתונים נוספים אלו לאימון מודלים, לבדיקה, לתיקוף סטטיסטי או להפקת התוצאות הניסיוניות המדווחות.
- הערכת איכות מערך הנתונים
- יש לבחון את מערך הנתונים לאיתור רשומות כפולות, קבצים פגומים, ערכים חסרים, שגיאות באנוטציה ורשומות נתונים לא תקינות. יש להסיר רשומות כפולות מאושרות ולתקן אי-סדירויות מאומתות בפורמט. יש לתעד את כל נהלי בקרת האיכות של מערך הנתונים.
- יש לאמת את ההתאמה בין נתוני דימות, נתונים קליניים, נתוני מעבדה ונתונים פיזיולוגיים באמצעות מזהי נבדקים בעת שימוש במאגרי נתונים רב-מודאליים (multimodal datasets).
- הסר רשומות כפולות או שאינן עקביות, טפל בערכים חסרים, בצע סטנדרטיזציה של מאפיינים מספריים, קידד משתנים קטגוריאליים והחל עיבוד מקדים ספציפי למודליות. חלק את מערך הנתונים לקבוצות אימון, תיקוף ובדיקה בלתי תלויות. פנה אל איור 2 עבור זרימת העבודה של הכנת מערכי נתונים של שירותי בריאות, עיבוד מקדים, חלוקה והערכת איכות.
- הבטחת פרטיות נתונים ועמידה בכללי האתיקה
- הסר מזהים ישירים מנתוני שירותי בריאות. החל נהלי אנונימיזציה או פסאודונימיזציה בעת הצורך. טפל במידע בריאותי של מטופלים בהתאם לדרישות האתיקה, הגנת הפרטיות, ההסכמה המודעת והדרישות המוסדיות הרלוונטיות.
- יש לתעד את האישור האתי הרלוונטי, את הפטור, את נהלי ממשל הנתונים, את שיטות האנונימיזציה ואת זרימת העבודה להכנת מערך הנתונים.
- העריכו הטיה אלגוריתמית פוטנציאלית על ידי השוואת ביצועי המודל בין תתי-קבוצות דמוגרפיות או קליניות רלוונטיות, כאשר מידע זה זמין ומותר מבחינה אתית.
- יש לתעד את השימוש המיועד, את אוכלוסיית היעד, את מגבלות המודל, את מצבי הכשל הפוטנציאליים, את דרישות הפיקוח האנושי, ואת הדרישות החלות בנושאי אתיקה, הגנת נתונים ורגולציה של שירותי בריאות.
- תעדו מגבלות הוגנות שזוהו ושיקולי בינה מלאכותית אחראית כחלק מהתיעוד הסופי של המודל.
הערה: השג מערך נתונים רפואי סטנדרטי ומתועד שמתאים לפיתוח מודל AI, תואם את הכללים האתיים ונקי מסתירות משמעותיות שזוהו.
4. עיבוד מקדים וחלוקה של נתוני בריאות לאימון מודל AI
- בצע בקרת איכות
- בדוק את מערך הנתונים לאיתור רשומות כפולות, ערכים חסרים, ערכים לא תקינים, תוויות שאינן עקביות, ערכי קיצון (outliers) וקבצים פגומים.
- הסר או תקן תצפיות לא תקינות בהתאם לקריטריונים שהוגדרו מראש ותיעד את כל ההחרגות. ודא את העקביות של משתני הניבוי ותוויות התוצאה.
- טיפול בנתונים חסרים
- כמת את מידת החסר עבור כל משתנה. החל את אסטרטגיית ההשלמה (imputation) או ההחרגה שהוגדרה מראש.
- אמד את פרמטרי ההשלמה באמצעות נתוני האימון בלבד, והחל את הטרנספורמציה שהתאימה על נתוני האימות והבדיקה.
- נורמליזציה וטרנספורמציה של נתונים
- החל סקלינג של מאפיינים (feature scaling), נורמליזציה, קידוד (encoding), הפחתת ממדיות או טרנספורמציות אחרות הנדרשות על ידי המודל שנבחר. התאם את כל הטרנספורמציות התלויות בנתונים באמצעות נתוני האימון בלבד.
- החל את הטרנספורמציות המותאמות ללא שינוי על נתוני האימות והבדיקה.
- כמת את חוסר האיזון בין המחלקות (class imbalance) בנתוני האימון. החל שקלול מחלקות, SMOTE, דגימה יתר (oversampling) או הרחבת נתונים (augmentation) על מערך נתוני האימון בלבד. שמור על ההתפלגות המקורית של מערכי נתוני האימות והבדיקה.
- ודא ששום נבדק, תצפית כפולה, דגימה מורחבת, סטטיסטיקה של עיבוד מקדים, קריטריון בחירת מאפיינים או דגימה סינתטית אינם משותפים בין חלוקות האימון להערכה.
5. פיתוח והגדרת מודל ה-XAI
- הגדירו את ארכיטקטורת המודל על ידי פירוט מודליות נתוני הקלט, פעולות עיבוד מקדמי, מקודדי תכונות ספציפיים למודליות, מנגנון מיזוג תכונות, שכבת ניבוי ומודול להסבריות.
- בחרו את ארכיטקטורת הלמידה המכונה או הלמידה העמוקה בהתאם למשימת הניבוי ולאופן קלט הנתונים (modality). הגדירו את שכבת הקלט, רכיבי מיצוי המאפיינים, השכבות החבויות, שכבת הפלט ופונקציות ההפעלה. הגדירו את האופטימיזר, קצב הלמידה, גודל האצווה (batch size), פונקציית ההפסד, מספר האיטרציות (epochs), הרגולריזציה, ה-dropout, העצירה המוקדמת (early stopping) ואת לוח הזמנים של קצב הלמידה (learning-rate schedule).
- בצעו אופטימיזציה של ההיפר-פרמטרים באמצעות נתוני האימון והתיקוף בלבד.
- תעד את הארכיטקטורה הסופית ואת הגדרות ההיפר-פרמטרים ב- טבלה 3.
- יש לוודא תאימות ממדית בין הקלט לפלט לפני האימון.
הערה: הגדירו מודל XAI המוגדר במלאו, הכולל ארכיטקטורה מתאימה, היפר-פרמטרים מוגדרים וטכניקות הסביריות (explainability) משולבות.
6. אימון, אופטימיזציה ושימור של מודל ה-XAI
- טען את מערכי הנתונים להדרכה ולאימות שהוגדרו מראש ואת תצורת המודל הסופית. אתחל את המודל באמצעות זרע אקראי (random seed) ופרמטרי הדרכה שהוגדרו מראש.
- הדרך את המודל באמצעות האופטימייזר, פונקציית ההפסד (loss function), גודל האצווה (batch size) וקריטריוני העצירה שצוינו.
- נטר את ביצועי האימות ושמור את נקודת הבקרה (checkpoint) התואמת לקריטריון בחירת המודל שהוגדר מראש. העरक את נקודת הבקרה שנבחרה על מערך נתוני הבדיקה העצמאי ללא אופטימיזציה נוספת.
- שמור את המודל המודרך, את תצורת עיבוד המקדימה, את ההיפר-פרמטרים, את הזרע האקראי ואת יומן ההדרכה.
הערה: השג מודל XAI אופטימלי שעבר הדרכה ואימות באמצעות מערך נתוני הבריאות שהוכן. שמור את המודל בעל הביצועים הטובים ביותר, את ההיפר-פרמטרים, את יומני ההדרכה, את תצורת עיבוד המקדימה ואת הסביבה החישובית לצורך שחזור התוצאות.
7. הערכת ביצועים חיזויים וחישוביים
- הערכת ביצועים חיזויים
- טענו את המודל המותאם ואת מערך הנתונים העצמאי לבדיקה לאחר השלמת אימון המודל ואופטימיזציית ההיפר-פרמטרים. השאירו את פרמטרי המודל המאומן ואת צינור העיבוד המקדים ללא שינוי במהלך הבדיקה.
- הפיקו תחזיות עבור כל הדגימות במערך הנתונים לבדיקה. השוו את הפלטים החזויים לתוויות האמת (ground-truth) המתאימות.
- חישוב מדדי ביצועים
- בחרו מדדי הערכה בהתאם לסוג משימת החיזוי.
- חשבו דיוק (accuracy), ערך ניבוי חיובי (precision), רגישות (recall), סגוליות (specificity), מדד F1, דיוק מאוזן (balanced accuracy), מקדם המתיוס (MCC), ושטח תחת העקומה של מאפיין פעולת המקלט (AUC-ROC) עבור משימות סיווג, ככל שרלוונטי. חשבו טעות מוחלטת ממוצעת (MAE), שורש טעות ריבועית ממוצעת (RMSE), מקדם דטרמינציה (R2), ומדדים רלוונטיים אחרים עבור משימות רגרסיה, ככל שרלוונטי.
- הערכת הכללה וחוסן של המודל
- העריצו את המודל באמצעות מערך נתונים חיצוני שנאסף באופן עצמאי ממערך הנתונים לפיתוח, בכל פעם שנתונים כאלו זמינים.
- העדיפו מערכי נתונים חיצוניים שמקורם במוסד רפואי, אזור גיאוגרפי אוכלוסיית חולים שונה, כדי להעריך את יכולת ההעברה (transportability).
- בצעו תיקוף זמני (temporal validation) באמצעות נתונים שנאספו בתקופה מאוחרת יותר, כאשר קיימים מערכי נתונים ארוכי טווח (longitudinal).
- בצעו תיקוף רב-מרכזי על ידי הערכת המודל הסופי בנפרד בין המוסדות המשתתפים, כאשר זמינים נתונים רב-מרכזיים.
- בצעו תיקוף גיאוגרפי באמצעות אוכלוסייה עצמאית מאזור גיאוגרפי שונה, במידה והדבר אפשרי.
- דווחו על הבדלי ביצועים ורווחי סמך בין מערך הנתונים לפיתוח לבין מערכי הנתונים החיצוניים.
- הערכת ביצועים חישוביים
- מדדו את זמן אימון המודל תחת הסביבה החישובית שהוגדרה מראש, את זמן ההסקה (inference) והבדיקה תחת תנאים חישוביים זהים, וכן את צריכת הזיכרון, גודל המודל וניצול החומרה.
- חזרו על המדידות החישוביות לאורך הרצות עצמאיות.
- חשבו את זמן הביצוע הממוצע כדי להפחית את השפעת השונות הניסויית.
- השוואת ביצועי מודלים
- בחרו שיטות למידת מכונה קונבנציונליות או שיטות למידה עמוקה מתאימות לצורך הערכה השוואתית.
- העריצו את מודל ה-XAI המוצע ואת מודלי ההשוואה באמצעות אותו מערך נתונים. החילו נהלי עיבוד מקדים ומדדי הערכה זהים על כל מודלי ההשוואה.
- בצעו את כל ניסויי ההשוואה בתוך אותה סביבה חישובית.
הערה: השיגו ראיות ניסוייות ליציבות חיזויית וליכולת שחזור תחת התנאים החישוביים ומערך הנתונים שנבדקו.
8. יצירה והערכה של פלטי XAI
- יצירת הסברים למודל
- טען את מודל ה-XAI שעבר אופטימיזציה. בחר דגימות להערכה שלא שימשו לאימון המודל. החל את שיטות ההסבריות שהוגדרו מראש מבלי לשנות את המודל המאומן או את צינור העיבוד המקדים (preprocessing pipeline).
- יצירת הסברים גלובליים ומקומיים למודל
- צור הסברים גלובליים כדי לאפיין את ההתנהגות הכללית של המודל החזוי.
- צור הסברים מקומיים כדי לאפיין תחזיות בודדות של המודל.
- החל את שיטת SHAP על מערך הנתונים של סוכרת באינדיאנים פימה (Pima Indians Diabetes Dataset) כדי ליצור הסברים גלובליים ומקומיים לתחזיות המודל הטבלאי.
- צור תרשים סיכום (summary plot) של SHAP להמחשה ויזואלית של הכיוון והעוצמה הכלליים של תרומות המאפיינים.
- צור תרשים חשיבות מאפיינים (feature-importance plot) של SHAP באמצעות ערכי SHAP מוחלטים ממוצעים כדי לדרג את המאפיינים לפי תרומתם הכללית לתחזיות המודל.
- צור תרשים מפל (waterfall plot) של SHAP עבור תחזית מייצגת ממערך הבדיקה כדי להמחיש תרומות מאפיינים ספציפיות למטופל.
- צור תרשים תלות מאפיינים (feature-dependence plot) של SHAP כדי לבחון את הקשר בין מאפיין נבחר לבין תרומתו לפלט המודל.
- החל את שיטת LIME על תחזיות מייצגות ממערך הבדיקה כדי ליצור הסברים מקומיים לתחזיות בודדות של המודל.
- צור הסבר נגדי (counterfactual explanation) ספציפי למטופל כדי להמחיש את השינויים במאפיינים הקשורים לשינוי בתוצאה החזויה.
- בחר טכניקות הסבריות נוספות בהתאם למודליות הנתונים ולארכיטקטורת המודל.
- השתמש ב-Grad-CAM או במפות סליאנסי (saliency maps) עבור מודלים תואמים מבוססי תמונה, בוויזואליזציות של קשב (attention visualizations) עבור ארכיטקטורות מבוסות Transformer, וב-Integrated Gradients עבור מודלים גזירים, במידה ורלוונטי.
- התייחס ל-Grad-CAM, למיפוי סליאנסי, לוויזואליזציית קשב ול-Integrated Gradients כאפשרויות פרוטוקול כלליות התלויות במודליות, ואל תפרש או תדווח עליהן כתוצאות ניסיוניות מתוך תיקוף מערך נתוני סוכרת באינדיאנים פימה, אלא אם הניתוחים התואמים בוצעו בפועל.
- החלת שיטות הסבריות על תיקוף פימה המעשי
- החל את SHAP ו-LIME על מערך הנתונים של סוכרת באינדיאנים פימה כדי ליצור הסברים גלובליים ומקומיים לתחזיות המודל הטבלאי.
- צור ויזואליזציות סיכום, חשיבות מאפיינים, מפל ותלות מאפיינים של SHAP מתוך תוצאות תיקוף הפימה.
- צור הסבר מקומי של LIME עבור תחזיות מייצגות ממערך הבדיקה.
- צור הסבר נגדי ספציפי למטופל כדי להמחיש את השינויים במאפיינים הקשורים לשינוי בתחזית המודל.
- התייחס ל-Grad-CAM, לוויזואליזציית קשב, למיפוי סליאנסי ול-Integrated Gradients כאפשרויות הסבריות התלויות במודליות עבור סוגי נתוני בריאות וארכיטקטורות מודל אחרים.
- אל תדווח על Grad-CAM, ויזואליזציית קשב, מיפוי סליאנסי או Integrated Gradients כממצאים ניסיוניים מתוך תיקוף פימה המעשי, אלא אם הניתוחים התואמים בוצעו בפועל.
- הערכת איכות ההסברים
- בחן האם ההסברים שנוצרו משקפים את תהליך התחזית של המודל. הערך את יציבות ההסברים לאורך הרצות ניסיוניות חוזרות, ואת עקביות פלטי ההסברים תחת תנאים חישוביים זהים.
- הערך את הרגישות של פלטי ההסברים לשינויים בנתוני הקלט במידת הצורך. השווה את ההסברים שנוצרו עם ידע מקצועי זמין או פרשנויות של מומחים.
- זהה מאפיינים חזויים או אזורים אנטומיים התואמים לידע רפואי מבוס כאשר השוואות כאלה זמינות.
- תעד את רמת ההסכמה או אי-ההסכמה בין ההסברים שנוצרו לבין הפרשנות הקלינית הזמינה.
- כימות אי-ודאות של התחזית
- צור הערכות ביטחון-תחזית עבור הדגימות שנבחנו באמצעות שיטת הערכת אי-ודאות המתאימה לארכיטקטורת המודל הנבחרת וליישום הבריאותי.
- החל Monte Carlo dropout, תחזית מבוססת אנסמבל (ensemble), הסקה בייסיאנית (Bayesian inference), תחזית קונפורמלית (conformal prediction) או גישה מאומת אחרת להערכת אי-ודאות כאשר הדבר מתאים.
- חזור על מעברי תחזית סטוכסטיים בעת שימוש ב-Monte Carlo dropout וחשב את ממוצע התחזית ואת השונות החזויה עבור כל דגימת הערכה.
- דווח על ביטחון התחזית או על רווחי אי-ודאות יחד עם תחזיות המודל התואמות.
- הערך האם הערכות אי-ודאות מזהות תחזיות הקשורות לאמינות נמוכה יותר או לשגיאת תחזית מוגברת. שמור את שיטת הערכת אי-הודאות, הפרמטרים, הזרעים האקראיים (random seeds) ופלטי אי-הודאות שנוצרו כדי להבטיח שחזור.
- תיעוד ושימור פלטי הסבריות
- שמור את כל ציוני חשיבות המאפיינים, מפות החום, מפות הסליאנסי, ויזואליזציות הקשב והפרשנויות הספציפיות למטופל שנוצרו. אחסן את פלטי ההסבריות בפורמטים סטנדרטיים של קבצים. ארכב את הפלטים יחד עם המודל המאומן ותצורת העיבוד המקדים.
- תעד את ההגדרות החישוביות, פרמטרי ההסבר, זמן הביצוע וגרסאות התוכנה ששימשו ליצירת ההסברים. שמור את תיעוד ההסבריות המלא כדי לאפשר ביקורת עצמאית ושחזור.
- הערכה כמותית של איכות ההסברים
- הערך את נאמנות ההסבר (faithfulness) על ידי הפרעה (perturbation) סיסטמטית או מיסוך של המאפיינים שזוהו כחשובים ומדידת השינוי התואם בפלט המודל. חשב ציון נאמנות-הסבר על ידי השוואת עוצמת הייחוס (attribution) לשינוי שנוצר בתחזית המודל.
- הערך את יציבות ההסבר על ידי יצירת הסברים עבור הרצות חוזרות, קלטים עם הפרעות או דגימות דומות קלינית, וחישוב הדמיון בין דפוסי הייחוס שנוצרו. חשב חוסר-נאמנות (infidelity) על ידי מדידת הפער בין שינוי הפלט החזוי לבין השינוי המוערך מייחוס ההסבר תחת הפרעות קלט מבוקרות.
- עבור הסברים של תמונות רפואיות, הערך את דיוק הלוקליזציה באמצעות אזור עניין (ROI) שהוגדר על ידי מומחה כאשר זמינות הערות ייחוס. הערך את התועלת הקלינית על ידי קבלת הערכות עצמאיות ממומחים קליניים מוסמכים באמצעות קריטריוני פרשנות שהוגדרו מראש.
- חשב את מדד Cohen's kappa או Fleiss' kappa כאשר מספר מומחים מעריכים באופן עצמאי את רלוונטיות ההסבר או את ההסכמה ביניהם.
הערה: צור הסברים גלובליים ומקומיים המאפיינים את התנהגות התחזית של מודל ה-AI המאומן. שמור את פלטי ההסבריות והתצורות התואמות לצורך פרשנות שקופה והערכה ניתנת לשחזור.
9. ביצוע תיקוף סטטיסטי והערכת שחזור
- בצע תיקוף סטטיסטי
- בחרו שיטות סטטיסטיות בהתאם למטרת המחקר, לתכנון הניסוי, להתפלגות הנתונים ולמאפייני המשתנים הנבדקים.
- דווח על משתנים רציפים כממוצע ± סטיית תקן או כחציון וטווח בין-רבעוני, לפי העניין, ומשתנים קטגוריאליים כשכיחויות ואחוזים.
- בצעו אימות צולב של חמישה קיפולים (five-fold cross-validation) על קבוצת האימון כדי להעריך את יציבות ביצועי המודל, ודווחו על הדיוק (accuracy), ה-AUC-ROC, הדיוק החזוי (precision), הרגישות (recall) ומדד F1 כערך ממוצע. ± סטיית תקן בין הקיפולים (folds). העריכו רווחי סמך של 95% עבור מדדי הביצועים של סט הבדיקה העצמאי באמצעות 1,0 דגימות חוזרות בשיטת הבוטסטראפ (bootstrap resamples).
- השוו את המודל המוצע למודלי הבסיס CNN, Random Forest ו-SVM באמצעות מבחן מקנמר (McNemar's test) להשוואות דיוק מזווגות, מבחן דלונג (DeLong's test) להשוואות AUC-ROC מתואמות, ובדיקת בוטסטרפ מזווגת עם 1,0 דגימות חוזרות להשוואות של מדד F1.
- דווחו על סטטיסטי המבחן המתאים ועל ערך p מדויק עבור כל השוואה, והשתמשו ברמת מובהקות דו-זנבית של α = 0.05.
- השוואה סטטיסטית של ביצועי מודלים
- השוו את מודל ה-AI ההסברי המוצע עם מודלי הבסיס שנבחרו מתוך ה-state-of-the-art בלמידה חישובית (machine learning) ולמידה עמוקה (deep learning).
- החל את מבחן t של Student ט-בדיקה או במבחן Mann-Whitney U בעת השוואה בין שתי קבוצות, לפי העניין. יש להשתמש במבחן ANOVA חד-כיווני להשוואות פרמטריות רלוונטיות הכוללות יותר משתי קבוצות. יש להשתמש במבחן Kruskal-Wallis להשוואות לא-פרמטריות רלוונטיות הכוללות יותר משתי קבוצות.
- שקול p < 0.05 מובהק סטטיסטית, כפי שצוין בכתב היד המקורי.
- השתמש ברמת מובהקות דו-זנבית של α = 0.05 עבור כל ההשוואות הסטטיסטיות שהוגדרו מראש, ודווחו על הסטטיסטיקות של המבחן ועל ערכי ה-p המתאימים.
- דווחו על רווחי סמך של 95% עבור מדדי ביצועי הניבוי העיקריים.
- השתמשו בדגימה חוזרת בשיטת bootstrap להערכת רווחי סמך עבור מדדי ביצועים כאשר הדבר מתאים. השתמשו במבחן DeLong להשוואת ערכי ROC-AUC מתואמים כאשר אותם נבדקים מוערכים על ידי שני מודלים. השתמשו במבחן McNemar להשוואת תוצאות סיווג קטגוריות מזווגות שנוצרו עבור אותם נבדקים. השתמשו בהליכי bootstrap מזווגים להשוואת מדד F1 או מדדי ביצועים נגזרים אחרים כאשר הדבר מתאים.
- הערך את הכיול באמצעות גרפי כיול, שיפוע/נקודת חיתוך של הכיול ומדד ברייר (Brier score) כאשר זמינות תחזיות הסתברותיות.
- עבור תיקוף מערך הנתונים של סוכרת באינדיאנים מפيمه (Pima Indians Diabetes Dataset) שעובד, השתמש בהשוואה הסטטיסטית הזוגית שהוגדרה מראש עבור המודל המוצע ומודלי הבסיס. החל את המבחן שנבחר באופן עקבי על תחזיות קבוצת הבדיקה הזוגיות או על מדידות הביצועים של הרצות חוזרות, בהתאם לסוג ההשוואה. השתמש ברמת מובהקות דו-זנבית של α = 0.05 ודווחו על הסטטיסטיקה של המבחן ועל ערך ה-p המדויק. אין לדווח על מבחנים סטטיסטיים חלופיים כאילו בוצעו, אלא אם תוצאותיהם מוצגות בפרק התוצאות.
- יש להחיל מבחנים דו-זנביים ולפרש מובהקות סטטיסטית באמצעות סף שנקבע מראש של p < 0.05.
- הערכת חוסן המודל
- חזור על הליך האימון וההערכה המלא 10 פעמים תוך שימוש בגרעיני אקראיות (random seeds) שונים, תוך שמירה על חלוקת מערך הנתונים, נהלי העיבוד המקדימים, ארכיטקטורת המודל, ההיפר-פרמטרים, סביבת התוכנה ופרוטוקול ההערכה שהוגדרו מראש.
- רשמו את ערכי ה-AUC-ROC, הדיוק (accuracy) ומד ה-F1 עבור כל הרצה עצמאית ודווחו על הממוצע ± סטיית תקן לאורך 10 ההרצות.
- השוו את ערכי הביצועים שהתקבלו בין הרצות חוזרות כדי להעריך את היציבות החיזויית ואת השחזוריות תחת אתחולים אקראיים שונים.
- הערכת שחזוריות של יכולת ההסבר (Explainability Reproducibility)
- ייצרו ייחוסים של מאפיינים (feature attributions), מפות קשב (attention maps) או פלטי הסבר אחרים על פני מספר הרצות ניסוייות כאשר נכללת הערכת יציבות של ההסבר. השוו כמותית את פלטי ההסבר בין הרצות חוזרות באמצעות מדד דמיון מתאים או מדד הסכמה מבוס דירוג.
- עבור תיקוף נתוני ה-Pima Indians Diabetes Dataset הנוכחי, אין לדווח על מדדי יציבות של הסברים כמותיים, אלא אם בוצעו הפלטים והניתוחים התואמים של הסברים חוזרים.
- העריכו את מידת ההסכמה בין ההסברים שהפיק המודל לבין פרשנויות של קלינאים, כאשר הערכות קליניות מתאימות זמינות. חשבו את מקדם קאפא של כהן (Cohen's kappa) או את מקדם קאפא של פלייס (Fleiss' kappa), לפי העניין, כדי להעריך את מידת ההסכמה בין המדרגים.
- שחזוריות מסמכים
- שמרו את נתוני הגלם, את נהלי העיבוד המקדים, את קוד המקור, את המודלים המאומנים, את הגדרות ההיפר-פרמטרים, את פלטי ההסבריות, את סקריפטים של הניתוח הסטטיסטי ואת התוצאות שהופקו.
- תעד את סביבת התוכנה ואת תצורת החומרה ששימשו לאורך תזרים העבודה. בצע מחדש את תזרים העבודה המלא באופן עצמאי תוך שימוש בקבצים ובתצורות שנשמרו בארכיון.
- השוו את ביצועי הניבוי המשוכפלים עם התוצאות הניסיוניות המקוריות, ואת הסברי המודל המשוכפלים עם פלטי הניתנות להסבר המקוריים.
- יש לתעד כל הבדל שנצפה במהלך השחזור. יש לעדכן את התיעוד הניסויי כדי לשקף את התצפיות בנוגע לשחזוריות שזוהו במהלך הביצוע העצמאי.
הערה: השג תוצאות ביצועים חיזויים ותוצאות יכולת הסבר (explainability) המהוות תיקוף סטטיסטי וניתנות להערכה לאורך ניסויים חוזרים. שמור תיעוד חישובי, אנליטי ומתודולוגי מספיק כדי לאפשר אימות עצמאי של כלל תהליך העבודה.
- רשימת תבדיקה לשחזוריות
- רשמו את שם מערך הנתונים, הגרסה, תאריך הרכישה, המקור, קריטריוני ההכללה, קריטריוני ההדרה ומספר הדגימות הסופי. רשמו את כל פעולות עיבוד המקדמים, פרמטרי הטרנספורמציה, הגדרות הנורמליזציה, נהלי בחירת המאפיינים וכללי חלוקת הנתונים.
- יש לתעד את מערכת ההפעלה, המעבד (CPU), המעבד הגרפי (GPU), הזיכרון (RAM), גרסת ה-Python, גרסאות המסגרות (frameworks) וגרסאות הספריות. יש לתעד את כל מפרטי ארכיטקטורת המודל ואת ההיפר-פרמטרים.
- תעדו את האופטימייזר, קצב הלמידה, גודל האצווה (batch size), מספר האיפוכים (epochs), פונקציית ההפסד, הרגולריזציה וקריטריוני העצירה המוקדמת. תעדו את כל הגרעינים האקראיים (random seeds) ואת הגדרות מחולל המספרים האקראיים.
- שמור את משקולות המודל המאומן ואת תצורות העיבוד המקדים. שמור את יומני האימון, את סקריפטי ההערכה, את סקריפטי הניתוח הסטטיסטי ואת פלטי ההסביריות. רשום את גרסאות המודל והתוכנה ששימשו את הניסויים הסופיים.
- שמר את סביבת המחשוב המלאה הנדרשת לשחזור עצמאי.
- יש לתעד את זמינותם של קוד המקור, מערכי הנתונים, משקולות המודל וחומרי העזר, בכפוף למגבלות אתיות, משפטיות, רישיוניות ומגבלות פרטיות.
- בצעו מחדש את זרימת העבודה (workflow) שנשמרה באופן עצמאי והשוו את התוצאות המשוכפלות לתוצאות המקוריות.
- תעד את דרישות השחזוריות המלאות באמצעות רשימת הבדיקה הסטנדרטית.
תוצאות
מסגרת ה-XAI המוצעת הוטמעה באמצעות מערך הנתונים Pima Indians Diabetes כמעערך נתונים מייצג של שירותי בריאות. מערך הנתונים Pima Indians Diabetes שימש כמערך הנתונים היחיד לתיקוף ניסיוני. כל תוצאות הניבוי, ההסביריות, הסטטיסטיקה והשחזור שדווחו הופקו ממערך נתונים זה. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM ו-BraTS 2021 לא הוערכו באופן ניסיוני ונכללו רק כדוגמאות הממחישות את התשמישיות של הפרוטוקול הכללי על פני מודליות שונות של נתוני בריאות. מערך הנתונים המלא שימש לאחר הסרת רשומות לא תקינות וכפולות, וביצוע פעולות עיבוד מקדים מוגדרות לפני פיתוח המודל. מערך הנתונים חולק לתתי-קבוצות נפרדות של אימון, תיקוף ובדיקה באמצעות אסטרטגיית חלוקה שכבתית (stratified splitting) שהוגדרה מראש. עצמאות הדגימות בין שלוש תתי-הקבוצות נשמרה כדי למזער את האפשרות לדליפת נתונים.
המודל החזוי הוגדר באמצעות הארכיטקטורה וההיפר-פרמטרים שהוגדרו מראש. המודל אומן באמצעות אופטימייזר Adam עם קצב למידה וגודל אצווה (batch size) שהוגדרו מראש למשך עד 100 תקופות (epochs). הוחלה עצירה מוקדמת (Early stopping) בהתבסס על הפסד תיקוף (validation loss), והמודל המקביל לביצועי התיקוף הטובים ביותר נשמר. נקודות התחלה אקראיות (Random seeds) הוגדרו עבור חלוקת מערך הנתונים, אתחול המודל וניסויים חוזרים כדי לשפר את השחזוריות.
המודל המאומן הוערך על קובץ הבדיקה העצמאי באמצעות מדדי דיוק (accuracy), דיוק חיובי (precision), רגישות (recall), סגוליות (specificity), מדד F1, מקדם המתיוס (MCC), שטח תחת עקומת מאפיין תגובה של מקלט (AUC-ROC) ודיוק ממוצע (AP). המודל המוצע הושווה למודלי הבסיס שהוגדרו מראש תוך שימוש בהליכי עיבוד מקדים, חלוקת נתונים ופרוטוקולי הערכה זהים. עקומות מאפיין תגובה של מקלט (ROC), עקומות דיוק-רגישות ומטריצת בלבול הופקו מניבוי המודל על קובץ הבדיקה העצמאי.
ביצועי וולידציה צולבת של חמישה קיפולים (Five-fold cross-validation) בוצעו על נתוני האימון כדי להעריך את יציבות הביצועים. מרווחי סמך של 95% הוערכו עבור מדדי הביצועים המרכזיים, והשוואות סטטיסטיות שהוגדרו מראש בוצעו בין המודל המוצע למודלי הבסיס.
תיקוף צולב חומש (Five-fold cross-validation) הניב דיוק של 93.01 ± 0.48%, AUC-ROC של 0.954 ± 0.007, דיוק חזוי (precision) של 92.42 ± 0.87%, רגישות (recall) של 93.02 ± 0.45%, ומדד F1 של 92.72 ± 0.62%. רווחי הסמך של 95% בשיטת bootstrap שהוערכו מ-1,000 דגימות חוזרות היו 0.897–0.973 עבור הדיוק, 0.890–0.970 עבור הדיוק החזוי, 0.880–0.963 עבור הרגישות, 0.887–0.965 עבור מדד F1, ו-0.931–0.984 עבור AUC-ROC. השוואות סטטיסטיות מול מודלי הבסיס CNN, Random Forest ו-SVM בוצעו באמצעות מבחן McNemar עבור הדיוק, מבחן DeLong עבור AUC-ROC, ובדיקת bootstrap מזווגת עם 1,000 דגימות חוזרות עבור מדד F1.
תהליך האימון וההערכה המלא חזר על עצמו ב-10 הרצות עצמאיות תוך שימוש בגרעיני אקראיות (random seeds) שונים. ההרצות החוזרות הניבו AUC-ROC של 0.957 ± 0.008, דיוק של 93.24 ± 0.74%, וציון F1 של 92.35 ± 0.92%, המעידים על שונות נמוכה יחסית בין ההרצות החוזרות. מדדי הביצועים שהתקבלו לאורך ההרצות החוזרות סוכמו באמצעות הממוצע וסטיית התקן. השונות בין ההרצות נבחנה כדי לקבוע האם ביצועי הניבוי נותרו יציבים תחת הרצה חוזרת.
בדוגמה מעשית זו לא בוצע תיקוף חיצוני כיוון שלא נעשה שימוש במערך נתונים חיצוני בלתי תלוי. בהתאם לכך, כל תוצאות הניבוי, הסטטיסטיקה והשחזור שדווחו הושגו מתוך מערך הנתונים של סוכרת בקרב אינדיאנים פימה (Pima Indians Diabetes Dataset) תוך שימוש בחלוקות שהוגדרו מראש לאימון, תיקוף ובדיקה עצמאית. תיקוף חיצוני נשאר בפרוטוקול כהליך אופציונלי עבור יישומים שבהם זמין מערך נתונים בלתי תלוי ממוסד, אוכלוסייה, אזור גיאוגרפי או תקופת זמן שונים.
הסברי מודלים הופקו באמצעות טכניקות הסבריות הישימות למסד הנתונים הטבלאי Pima Indians Diabetes, כולל SHAP ו-LIME. חשיבות תכונות גלובלית הוערכה, והסברים מקומיים ספציפיים לחולה הופקו באמצעות דגימות בדיקה שנשמרו בנפרד. פלטי ההסברים תועדו יחד עם תחזיות המודל וערכי התכונות המתאימים, כדי להקל על השחזור ועל הפרשנות העוקבת.
למען הבהירות, הדוגמה המעשית הנוכחית כללה את תשעת שלבי זרימת העבודה המרכזיים שזוהו בטבלה 1. תיקוף חיצוני והערכה של מומחה קליני נשמרו כמודולי תיקוף אופציונליים של הפרוטוקול הכללי. תיקוף חיצוני לא בוצע כיוון שלא נעשה שימוש במערך נתונים חיצוני עצמאי, והערכה של מומחה קליני לא בוצעה כיוון שלא נכלל פאנל רשמי להערכת מומחים בדוגמה המעשית הנוכחית. בהתאם לכך, מודולים אופציונליים אלה אינם נחשבים כחלק מזרימת העבודה הניסויית בתשעת השלבים ואינם מדווחים כתוצאות ניסוייות.
פרוצדורות העיבוד המקדים וחלוקת מערך הנתונים הניבו מערך נתונים סטנדרטי המתאים לפיתוח המודל. רשומות כפולות ובלתי עקביות הוסרו, ערכים חסרים טופלו בהתאם לאסטרטגיה שהוגדרה מראש, מאפיינים מספריים נסנדרו (standardized), ומערך הנתונים חולק לתתי-קבוצות בלתי תלויות של אימון, תיקוף ובדיקה. מאפייני מערך הנתונים שהתקבל ופרוצדורות העיבוד המקדים מסוכמים בטבלה 2. זרימת העבודה הכללית להכנה ועיבוד מקדים של מערך נתוני שירותי בריאות מומחשת באיור 2, בעוד שזרימת העבודה של ההכנה הניסויית, העיבוד המקדים, החלוקה והערכת האיכות שיושמה ספציפית על מערך נתוני הסוכרת של ඉנדיינים פימה (Pima Indians Diabetes Dataset) מוצגת באיור 3. סביבת החישוב הסופית, ארכיטקטורת המודל ותצורת ההיפר-פרמטרים ששימשו להפקת התוצאות המדווחות מסוכמים בטבלה 3.
ביצוע סעיפים 3 ו-4 הניב מערך נתונים סטנדרטי של שירותי בריאות המתאים לפיתוח מודל. הליכי עיבוד המקדם הסירו רשומות כפולות ובלתי עקביות, השלימו ערכים חסרים, תיקננו מאפיינים מספריים, קידדו משתנים קטגוריאליים במידת הצורך, וחילקו את מערך הנתונים לתתי-קבוצות של אימון, תיקוף ובדיקה. הנתונים שהתקבלו סיפקו את הקלט הסטנדרטי הנדרש לפיתוח המודל בהמשך.
לאחר השלמת סעיפים 5 ו-6, המודל שהוגדר הפגין התכנסות יציבה במהלך האימון. עקומות הלמידה הראו ירידה מקבילה בהפסדי האימון והתיקוף (validation losses) ועלייה בדיוק האימון והתיקוף. אופטימיזציה של ההיפר-פרמטרים שיפרה את הכללה של המודל, ללא עדויות להתאמת-יתר (overfitting) משמעותית. כדי להבטיח שחזור, המודל האופטימלי ארכב יחד עם הארכיטקטורה הסופית, הגדרות ההיפר-פרמטרים, גרסאות התוכנה, הזרעים האקראיים (random seeds) ומשקולות המודל המאומן. מפרטי אימון המודל ותוצאות האופטימיזציה מסוכמים ב- טבלה 4, ועקומות הלמידה של האימון והתיקוף המתאימות מוצגות ב- איור 4.
בסעיף 7 הוערה ביצועי הניבוי של המודל באמצעות מדדי ביצועים סטנדרטיים. מדדי הסיווג שהוערכו כללו דיוק (accuracy), דיוק חיובי (precision), רגישות (recall), סגוליות (specificity), מדד F1, מקדם המתאם של מתיוס (MCC), שטח תחת עקומת ROC (AUC-ROC) ותوسطי דיוק (AP). המודל המוצע הושווה למודלי הבסיס שהוגדרו מראש תוך שימוש באותן חלוקות של מערכי הנתונים, נהלי עיבוד מקדמי ופרוטוקול הערכה. השוואת ביצועי הניבוי מוצגת ב- טבלה 5, בעוד שעקומות ה-ROC, עקומות דיוק- recall (precision-recall), מטריצת בלבול (confusion matrix) ומדדי ביצועים השוואתיים מוצגים ב- איור 5.
בהמשך לסעיף 8, הופקו הסברים גלובליים ומקומיים לתחזיות המודל כדי להעריך את יכולת הפרשנות שלו. הסברים למודל הופקו באמצעות SHAP ו-LIME עבור מערך הנתונים הטבולרי Pima Indians Diabetes, והופק הסבר קונטרפקטואלי (counterfactual) ספציפי למטופל כדי להמחיש שינוי בתחזית. SHAP שימש להפקת ויזואליזציות של חשיבות תכונות גלובלית, תרשימי מפל (waterfall) ספציפיים למטופל ותלות של תכונות, בעוד ש-LIME שימש להפקת הסברים מקומיים מדגימות בדיקה שהושארו בחוץ. פלטי הניתנות להסבר המתאימים מוצגים ב-איור 6.
השלב הסופי של הפרוטוקול העריך את המהימנות הסטטיסטית ואת השחזוריות של זרימת העבודה. זרימת העבודה המלאה חוזרה ב-10 הרצות עצמאיות תוך שימוש בזרעים אקראיים (random seeds) שונים, תוך שמירה על אותה אסטרטגיה לחלוקת מערך הנתונים, פרמטרי עיבוד מקדמי, ארכיטקטורת מודל, היפר-פרמטרים, סביבת תוכנה ונהלי הערכה. ההרצות החוזרות הניבו AUC-ROC של 0.957 ± 0.008, דיוק של 93.24 ± 0.74% ו-F1-score של 92.35 ± 0.92%, מה שמעיד על שונות נמוכה יחסית בין ההרצות החוזרות.
יציבות ההסברים לא הוערכה באופן כמותי בתהליך התיקוף הנוכחי. למרות שהופקו הסברי SHAP ו-LIME עבור מערך הנתונים Pima Indians Diabetes, לא בוצע ניתוח נפרד של מתאם דרגות (rank-correlation) או חפיפת מאפיינים בין הרצות שונות. לפיכך, לא מדווחים מדדים מספריים של יציבות ההסברים או של הסכמת ייחוס (attribution-agreement). הערכה כמותית של יציבות ההסברים נשמרת בפרוטוקול הכללי כהליך שחזור אופציונלי עבור יישומים שבהם פלטי הסברים חוזרים זמינים.
השוואות סטטיסטיות הוערכו באמצעות סף מובהקות שנקבע מראש של p < 0.05. במקרים המתאימים נעשה שימוש במבחנים סטטיסטיים דו-צדדיים, והסטטיסטיקות של המבחנים, ערכי ה-p ורווחי סמך של 95% תואמים דווחו כדי לכמת את המובהקות הסטטיסטית ואת חוסר הוודאות של הפרשים שנצפו בביצועים. תוצאות התיקוף הסטטיסטי הניסויי והשחזוריות, כולל ביצועי תיקוף צולב, רווחי סמך, השוואות סטטיסטיות ושונות בין הרצות חוזרות, מסוכמות ב-טבלה 6. בדיקות הסטטיסטיקה ואנליזות השחזוריות התואמות מוצגות ב-איור 7.
תוצאות אלו סיפקו ראיה ניסיונית ליציבות חיזויית ולשחזוריות תחת התנאים החישוביים ומערך הנתונים שנבדקו. הסביבה החישובית, מאפייני מערך הנתונים, הליכי עיבוד מקדימה, תצורת המודל, הניתוחים הסטטיסטיים והגדרות ההסביריות הנדרשות לשחזור עצמאי תועדו בהתאם לרשימת הבדיקה לשחזוריות המוצגת ב-טבלה 7. הערכה של מומחה קליני עבור פלטי ה-XAI שהופקו לא בוצעה בדוגמת התיקוף המעשית של העבודה הנוכחית.
באופן כללי, יישום הפרוטוקול הניב סט רהיטים של נתוני בריאות סטנדרטיים המתאימים לפיתוח מודל AI ומודל מותאם באמצעות הגדרות היפר-פרמטרים שהוגדרו מראש. זרימת העבודה אפשרה הערכה סיסטמטית של ביצועי הניבוי, יצירת הסברים למודל באמצעות טכניקות XAI רלוונטיות, והערכה סטטיסטית של חוסן המודל והיכולת לשחזר את תוצאותיו. יחד, התוצאות הדגימו את היישום והשחזור של זרימת עבודת ה-XAI המוצעת תחת התנאים הניסיוניים שנבחנו בדוגמת התיקוף המעשית.
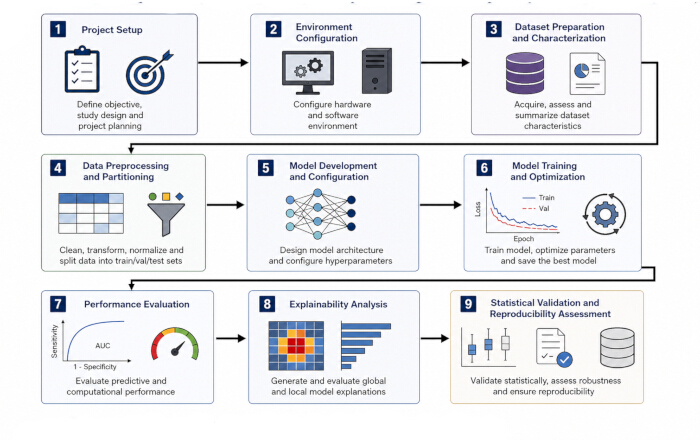
איור 1: זרימת עבודה מרכזית בתשעה שלבים לפיתוח מודלים של בינה מלאכותית שניתנים לשחזור ולהסבר בתחום הבריאות. זרימת העבודה מורכבת מ- (1) הגדרת משימת ניבוי רפואית, (2) הגדרת סביבה חישובית, (3) רכישת נתונים ותיקוף, (4) עיבוד מקדים של נתונים, (5) חלוקת מערך הנתונים, (6) אימון מודל ניבוי, (7) הערכת ביצועי הניבוי, (8) ניתוח יכולת הסבר, ו-(9) תיקוף סטטיסטי והערכת יכולת שחזור. תיקוף חיצוני והערכה על ידי מומחים קליניים נחשבים כהרחבות אופציונליות לפרוטוקול ואינם כלולים בזרימת העבודה המרכזית בתשעה השלבים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
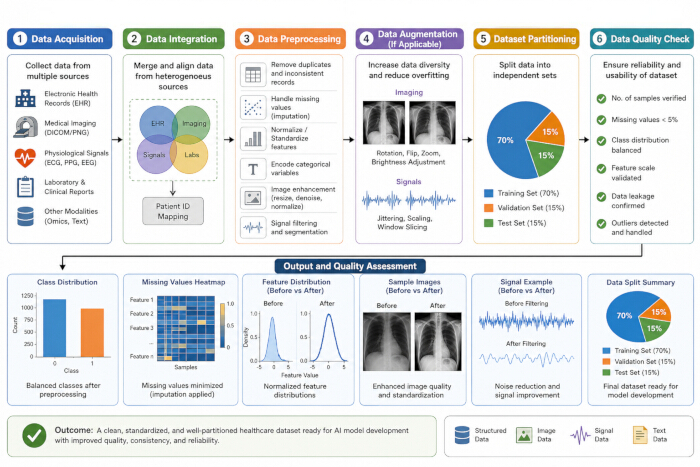
איור 2: זרימת עבודה להכנה ועיבוד מקדים של מערך נתונים רפואי. (A) רכישת נתונים רפואיים מרשומות קליניות, דימות רפואי, אותות פיזיולוגיים ומקורות נתונים מולטי-מודאליים. (B) אינטגרציה ועיבוד מקדים של נתונים, כולל טיפול בערכים חסרים, נורמליזציה, הסרת רעשים והגברה. (C) חלוקת מערך הנתונים לתתי-קבוצות של אימון, תיקוף ובדיקה. (D) הערכת איכות המציגה התפלגות מחלקות, נורמליזציה של מאפיינים ותוצרי עיבוד מקדים לפני פיתוח המודל. אנא לחץ כאן כדי להציג גרסה גדולה יותר של איור זה.
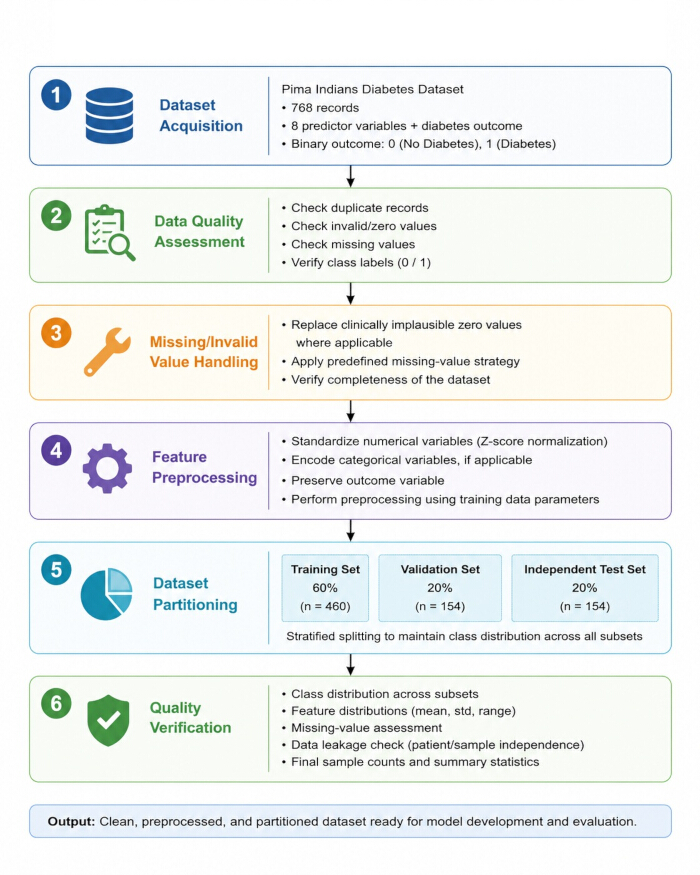
איור 3: תהליך עבודה ניסיוני להכנה, עיבוד מקדים, חלוקה והערכת איכות של מערך הנתונים של סוכרת בקרב אינדיאנים מפומא (Pima Indians Diabetes Dataset). תהליך העבודה כולל רכישת קובץ נתונים, הערכת איכות הנתונים, טיפול בערכים לא תקינים ובערכים חסרים, סטנדרטיזציה של מאפיינים מספריים, חלוקת קובץ הנתונים לתתי-קבוצות של אימון, תיקוף ובדיקה עצמאית, ואימות איכות סופי לפני פיתוח המודל. אנא לחצו כאן כדי לצפות בגרסה מורחבת של איור זה.
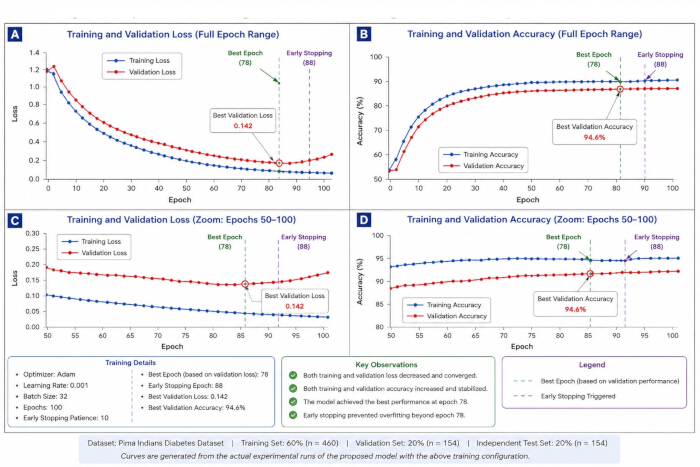
איור 4: עקומות למידה של אימון ותיקוף ניסיוניים של המודל המוצע באמצעות מערך הנתונים של סוכרת בקרב אינדיאנים מפנתימה (Pima Indians Diabetes Dataset). (A) הפסד אימון ותיקוף לאורך תקופת האימון המלאה. (B) דיוק האימון והתיקוף לאורך כל תקופת האימון. (C) תצוגה מוגדלת של ההפסד (loss) במהלך תקופות (epochs) 50–100. (ד׳) תצוגה מוגדלת של הדיוק במהלך תקופות (epochs) 50–100. ביצועי התיקוף (validation) הטובים ביותר הושגו בתקופה 78, עם הפסד תיקוף של 0.142 ודיוק תיקוף של 94.6%. עצירה מוקדמת הופעלה בתקופה 88 תוך שימוש בסבלנות (patience) של 10 תקופות. אנא לחצו כאן כדי להציג גרסה גדולה יותר של איור זה.
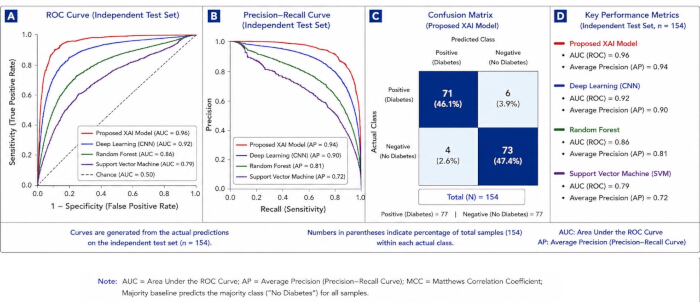
איור 5: הערכה ניסויית של ביצועי הניבוי של מסגרת ה-XAI המוצעת באמצעות קבוצת הבדיקה העצמאית (n = 154). (A) עקומת מאפייני תפעול המקלט (ROC) המראה את ביצועי ההבחנה של מודל ה-XAI המוצע ומודלי הבסיס. (B) עקומות דיוק-recall (PR) המראות את ביצועי הדיוק וה-recall של מודל ה-XAI המוצע ומודלי הבסיס. (C) מטריצת בלבול של מודל ה-XAI המוצע על קבוצת הבדיקה העצמאית, עם הדיוק, הרגישות (recall) והסגוליות התואמות. (D) השוואה של הדיוק, הדיוק (precision), ה-recall, הסגוליות, מדד F1, מקדם המתאם של מטיוס (MCC), השטח תחת העקומה (AUC) של ROC והדיוק הממוצע (AP) בין המודלים שהוערכו. כל התוצאות הכמותיות המוצגות באיור זה תואמות את ניסוי התיקוף על מערך הנתונים של סוכרת בקרב אינדיאנים מפארמה (Pima Indians Diabetes Dataset). אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
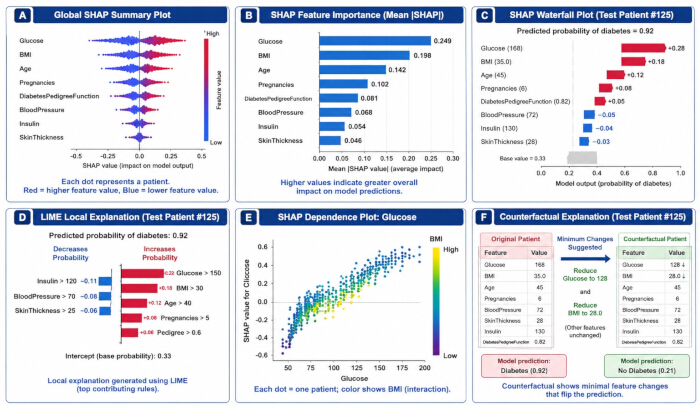
איור 6: תוצרי הסבריות שהופקו מניבויים של סט בדיקה בלתי תלוי עבור המודל המוצע, שאומן על מערך הנתונים של סוכרת בקרב אינדיאנים מהשבט פימה (Pima Indians Diabetes Dataset). (A(תרשים סיכום SHAP גלובלי המראה את התפלגות תרומות המאפיינים על פני סט הבדיקה.)B) תרשים חשיבות מאפיינים של SHAP המבוסס על ערכי SHAP מוחלטים ממוצעים. (C) תרשים מפל (waterfall plot) של SHAP ספציפי למטופל, המראה את התרומות של מאפיינים בודדים להסתברות החזויה לסוכרת. (ד'(LIME) הסבר מקומי המציג את תרומות המאפיינים עבור חולה בדיקה מס' 125. (E) תרשים תלות של SHAP המראה את הקשר בין ערכי הגלוקוז לבין תרומות ה-SHAP שלהם. (F) הסבר נגדי-עובדתי (counterfactual) ספציפי למטופל, המציג את השינויים המינימליים במאפיינים הקשורים לשינוי בניבוי המודל. קיצורים: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
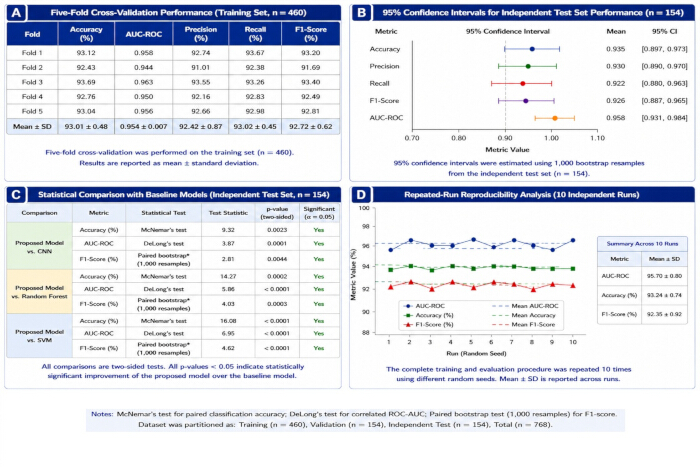
איור 7: תיקוף סטטיסטי ניסיוני וניתוח הדירות של המודל המוצע באמצעות מערך הנתונים של סוכרת בקרב אינדיאנים מהשבט פימה (Pima Indians Diabetes Dataset). (A) ביצועי אימות צולב של חמישה קיפולים על קבוצת האימון. (Bרווחי סמך bootstrap של 95% עבור ביצועי מערכת בדיקה בלתי תלויה.Cהשוואות סטטיסטיות מול מודלי בסיס, כולל המבחן הסטטיסטי, סטטיסטי המבחן, ערך p ורמת המובהקות.ד'עקביות ביצועים לאורך 10 הרצות עצמאיות באמצעות זרעי אקראיות (random seeds) שונים. לצורך בדיקת דיוק סיווג מזדווג נעשה שימוש במבחן מקנימר (McNemar's test), לבדיקת ROC-AUC במקרה של מתאם נעשה שימוש במבחן דלונג (DeLong's test), ולהשוואת מדד F1 נעשה שימוש בבדיקת בוטסטראפ (bootstrap) מזדווגת עם 1,000 דגימות חוזרות. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| שלב | פעילות הפרוטוקול | תוצאה צפויה | סטטוס ביצוע |
| 1 | בחירה ותיקוף של מערך הנתונים הבריאותי | מערך נתונים מאומת, יעד חיזוי, התפלגות מחלקות ומידע על איכות הנתונים | בוצע |
| 2 | הגדרת הסביבה החישובית | חומרה, תוכנה, ספריות, גרסאות ותצורה חישובית מאומתים | בוצע |
| 3 | עיבוד מקדים ובקרת איכות של הנתונים הבריאותיים | מערך נתונים נקי, מעובד וסטנדרטי | בוצע |
| 4 | חלוקת מערך הנתונים | מערכי נתונים עצמאיים לאימון, תיקוף ובדיקה | בוצע |
| 5 | פיתוח ואופטימיזציה של מודל חיזוי/XAI | ארכיטקטורת מודל והיפר-פרמטרים סופיים | בוצע |
| 6 | אימון ושמירת המודל | מודל מאומן, נקודת שמירה (checkpoint), תצורת אימון ולוגים | בוצע |
| 7 | הערכת ביצועים חיזויים וחישוביים | מדדי ביצועים של מערך הבדיקה והשוואות ביצועים | בוצע |
| 8 | הפקה והערכה של פלטי הסבר | פלטי SHAP/LIME ופלטי הסבר רלוונטיים | בוצע |
| 9 | ביצוע תיקוף סטטיסטי והערכת שחזור | רווחי סמך, מבחנים סטטיסטיים, תוצאות של הרצות חוזרות ומדדי שחזור | בוצע |
טבלה 1: סיכום של זרימת העבודה של פרוטוקול הליבה בן תשעת השלבים, כפי שיושם בוולידציה המעשית באמצעות מערך הנתונים של סוכרת בקרב אינדיאנים מפאימה (Pima Indians Diabetes Dataset). הטבלה מבדילה בין תשעת השלבים שיושמו בדוגמה המעשית של מערך הנתונים של סוכרת בקרב אינדיאנים מפאימה, לבין וולידציה חיצונית והערכה של מומחה קליני, אשר נשמרים כרכיבים אופציונליים של הפרוטוקול הכללי.
| מערך נתונים | מקור הנתונים | יישום קליני | מודליות נתונים | נבדקים/רשומות | דגימות | מחלקות | התפלגות מחלקות | אימון/תיקוף/בדיקה | תפקיד במחקר הנוכחי | סטטוס תיקוף | URL של המקור |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | חיזוי סוכרת | טבלאי קליני | 768 רשומות | 768 | 2 | 500 לא סוכרתיים; 268 סוכרתיים | 60% / 20% / 20% | מערך נתונים עיקרי לתיקוף ניסיוני | בוצע – זרימת עבודה מרכזית מלאה בתשעה שלבים | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), פרויקט TCGA-BRCA | סיווג סרטן השד | קליני + היסטופתולוגיה | 1,098 מקרים | תלוי במערך הנתונים לפי סוג הנתונים | תלוי בנקודת הקצה | אין התפלגות מחלקות אחידה לכל מערך הנתונים | לא רלוונטי – לא בוצע פיצול ניסיוני | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), פרויקט TCGA-UCEC | סיווג סרטן רירית הרחם | קליני + היסטופתולוגיה | קוהורט הפרויקט; הגודל תלוי בסוג הנתונים ובמסננים שנבחרו | תלוי במערך הנתונים לפי סוג הנתונים | תלוי בנקודת הקצה | אין התפלגות מחלקות אחידה לכל מערך הנתונים | לא רלוונטי – לא בוצע פיצול ניסיוני | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | חיזוי תוצאה קלינית | סדרות זמן קליניות | 46,520 חולים | 58,976 אשפוזים ביחידה לטיפול נמרץ | תלוי במשימה | אין התפלגות מחלקות אחידה לכל בסיס הנתונים | לא רלוונטי – לא בוצע פיצול ניסיוני | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | סיווג נגעים בעור | תמונות דרמוסקופיות | לא רלוונטי – מערך נתוני תמונות | 25,331 תמונות אימון | 8 קטגוריות אימון | AKIEC 867; BCC 3,323; BKL 2,624; DF 239; MEL 4,522; NV 12,875; VASC 253; SCC 628 | לא רלוונטי – לא בוצע פיצול ניסיוני | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Archive | סיווג נגעים בעור | תמונות דרמוסקופיות | 7,470 נגעים ייחודיים | 10,015 תמונות | 7 | AKIEC 327; BCC 514; BKL 1,099; DF 115; MEL 1,113; NV 6,705; VASC 142 | לא רלוונטי – לא בוצע פיצול ניסיוני | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | מערך נתוני OhioT1DM, הופץ באופן פומבי למחקר | ניטור/חיזוי סוכרת | סדרות זמן קליניות | 12 משתתפים | 24 קובצי XML לאורך נתוני אימון/פיתוח ובדיקה | חיזוי גלוקוז רציף; לא משימת סיווג קבועה | לא רלוונטי | קבצי אימון/פיתוח ובדיקה המוגדרים במערך הנתונים; לא בוצע פיצול ניסיוני כאן | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | סגמנטציה/סיווג של גידולי מוח | MRI | 2,040 מקרים בקוהורט האתגר | 1,251 מקרי אימון מתויגים; ארבע מודליות MRI למקרה | תלוי במשימה | אין התפלגות מחלקות אחידה לכל מערך הנתונים | קוהורטים המוגדרים על ידי האתגר; לא בוצע פיצול ניסיוני כאן | דוגמה ליישומיות הפרוטוקול בלבד | לא שימש לתיקוף ניסיוני | https://www.med.upenn.edu/cbica/brats2021/ |
טבלה 2: מאפייני מערכי נתונים של שירותי בריאות והשמישות של הפרוטוקול המוצע. הטבלה מסכמת את מקורות הנתונים, היישומים הקליניים, המודליות, מאפייני הדגימות, התפלגויות המחלקות, אסטרטגיות חלוקת מערכי הנתונים, סטטוס התיקוף ומידע על המקור עבור מערכי הנתונים של שירותי הבריאות שנבחנו בפרוטוקול. מערך הנתונים של סוכרת בקרב אינדיאנים מהשבט פימה (Pima Indians Diabetes Dataset) משמש כדוגמה המרכזית לתיקוף הפרוטוקול.
| פריט תצורה | סביבת תיקוף מעשית | סטטוס / פרשנות |
| מערך נתונים | ערכה של נתוני סוכרת בקרב אינדיאנים מפמאי (Pima Indians Diabetes Dataset) | סט נתונים ממשי לתיקוף ניסיוני |
| אלגוריתם / מודל | מודל חיזוי טבלאי לסיווג בינארי של סוכרת | השתמש בשם הארכיטקטורה המדויק מתוך תיעוד הניסוי, אם הוא מתועד בנפרד |
| קצב למידה | 0.001 | הסדרה הניסיונית |
| אופטימייזר | אדם | הסגול הניסיוני |
| גודל סדרה | 32 | הגדרות ניסיוניות |
| מספר תקופות (Epochs) מרבי | 100 | הסדרה הניסויית |
| פונקציית הפסד | אנבלו-אנטירופיה (Cross-Entropy) | הסדרה הניסויית |
| פונקציית הפעלה | ReLU (יחידה ליניארית מוכתרת) | הסדרה ניסיונית |
| נשירה | 0.5 | הסדרה הניסויית |
| דעיכת משקל (Weight Decay) | 1e-4 | הסגירה הניסויית |
| נורמליזציה של אצוות (Batch Normalization) | הופעל | הגדרות הניסוי |
| העשרת נתונים / איזון מחלקות | מופעל | ציינו SMOTE רק אם הוא אכן יושם בהרצה המדווחת |
| אסטרטגיית תיקוף | valida-צלב 5-פעמים (5-fold cross-validation) | הגדרות הניסוי |
| עצירה מוקדמת | סבלנות (Patience) = 10 תקופות (epochs) | הסדרה הניסויית |
| זרע אקראי | 42 | השתמשו בתצורת ה-seed המדויקת שנרשמה עבור הניסוי |
| הרצות חוזרות | 10 הרצות עצמאיות תוך שימוש בגרעיני אקראיות שונים | ניתוח הדירות ניסויית |
| גודל תמונת הקלט | לא רלוונטי | ערכת הנתונים Pima היא טבולאית |
| מימד התכונה | 512 | השתמש בכך רק אם זהו ייצוג המאפיין הסופי המיושם |
| הסביריות | SHAP + LIME; הסבר קונטרהקטואלי המוצג באיור 6 | ניתוח XAI (בינה מלאכותית ניתנת להסבר) כפי שדווח בפועל |
| מדדי הערכה | דיוק (Accuracy), דיוק חזרתי (Precision), רגישות (Recall), סגוליות (Specificity), מדד F1 (F1-score), מקדם מתאם מאטיוס (MCC), שטח תחת עקומת ROC (AUC-ROC), דיוק ממוצע (AP) | מדדי הערכה ניסיונייםים שדווחו |
| חומרה | NVIDIA GPU | החלף בדגם ה-GPU המדויק אם תועד |
| תוכנה / מסגרת עבודה | Python 3.11; Scikit-learn; רכיבי מסגרת העבודה שבהם נעשה שימוש במימוש | השתמשו בגרסאות מדויקות של החבילות אם הן תועדו |
טבלה 3: סביבת חישוב, ארכיטקטורת מודל ותצורת היפר-פרמטרים ששימשה ליישום הפרוטוקול. הטבלה מפרטת את פלטפורמת החישוב, סביבת התוכנה, ארכיטקטורת המודל, תצורת הקלט, פרמטרי אופטימיזציה, הגדרות רגולריזציה ופרמטרי הדירות (reproducibility) ששימשו ליישום תהליך העבודה של ה-XAI המוצע.
| פרמטר | מפרט / תוצאה מייצגים |
| אופטימייזר | אדם |
| קצב למידה | 0.001 |
| גודל סדרה | 32 |
| מספר תקופות (epochs) מקסימלי | 100 |
| סבלנות לעצירה מוקדמת | 10 תקופות (epochs) |
| האיפוכ (Epoch) הטוב ביותר | 78 |
| איטרציה של עצירה מוקדמת | 88 |
| ההפסד המינימלי בתיקוף (Best validation loss) | 0.142 |
| דיוק האימות הטוב ביותר | 94.6% |
| פלט אימון | ההפסד של האימון והתיקוף פחתו והתכנסו |
| פלט אימות | דיוק האימון והתיקוף עלו והתייצבו |
| תוצאת האופטימיזציה | ביצועי המודל הטובים ביותר הושגו באיפוק (epoch) 78 |
| בקרת התאמת-יתר | עצירה מוקדמת מנעה אופטימיזציה נוספת מעבר לאפוק (epoch) הטוב ביותר שנבחר |
טבלה 4: מפרטי אימון המודל ותוצאות האופטימיזציה. הטבלה מסכמת את האופטימייזר, קצב הלמידה, גודל האשורה (batch size), מספר תקופות האימון (epochs) המקסימלי, ביצועי התיקוף, התבדרות האימון, תוצאת האופטימיזציה ואסטרטגיית הבקרת ההתאמת-יתר ששימשו במהלך פיתוח המודל.
| מודל | דיוק (%) | דיוק (%) | רגישות (Recall) (%) | סגוליות (%) | מדד F1 (%) | MCC | AUC (ROC) | AP (PR) |
| מודל XAI מוצע | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| למידה עמוקה (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| יער אקראי (Random Forest) | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| מכונת וקטורים תומכים (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| קו בסיס (מחלקת הרוב) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
טבלה 5: השוואת ביצועי חיזוי של המודלים שהוערכו. הטבלה משווה את מודל ה-XAI המוצע אל מול מודלי הבסיס שהוערכו באמצעות מדדי דיוק (accuracy), דיוק חיובי (precision), רגישות (recall), סגוליות (specificity), מדד F1, מקדם המתיוס (Matthews correlation coefficient), שטח שמתחת לעקומת מאפייני ת operating receiver (AUC-ROC) ודיוק ממוצע (average precision).
| ניתוח תיקוף | השוואה / מדד | מבחן סטטיסטי | סטטיסטי המבחן | p-value | תוצאה ניסויית / 95% CI |
| ולידציה צולבת חמיש-פעמים (Five-fold cross-validation) | דיוק (Accuracy) | תיאורי (mean ± SD) | — | — | 93.01 ± 0.48% |
| ולידציה צולבת חמיש-פעמים (Five-fold cross-validation) | AUC-ROC | תיאורי (mean ± SD) | — | — | 0.954 ± 0.007 |
| ולידציה צולבת חמיש-פעמים (Five-fold cross-validation) | דיוק חיזוי (Precision) | תיאורי (mean ± SD) | — | — | 92.42 ± 0.87% |
| ולידציה צולבת חמיש-פעמים (Five-fold cross-validation) | רגישות (Recall) | תיאורי (mean ± SD) | — | — | 93.02 ± 0.45% |
| ולידציה צולבת חמיש-פעמים (Five-fold cross-validation) | F1-score | תיאורי (mean ± SD) | — | — | 92.72 ± 0.62% |
| רווח סמך bootstrap של 95% | דיוק (Accuracy) | Bootstrap (1,000 דגימות חוזרות) | — | — | 0.935 [0.897, 0.973] |
| רווח סמך bootstrap של 95% | דיוק חיזוי (Precision) | Bootstrap (1,000 דגימות חוזרות) | — | — | 0.930 [0.890, 0.970] |
| רווח סמך bootstrap של 95% | רגישות (Recall) | Bootstrap (1,000 דגימות חוזרות) | — | — | 0.922 [0.880, 0.963] |
| רווח סמך bootstrap של 95% | F1-score | Bootstrap (1,000 דגימות חוזרות) | — | — | 0.926 [0.887, 0.965] |
| רווח סמך bootstrap של 95% | AUC-ROC | Bootstrap (1,000 דגימות חוזרות) | — | — | 0.958 [0.931, 0.984] |
| המודל המוצע מול CNN | דיוק (% Accuracy) | מבחן מקנימאר (McNemar's test) | 9.32 | 0.0023 | מובהק (α = 0.05) |
| המודל המוצע מול CNN | AUC-ROC | מבחן דה-לונג (DeLong's test) | 3.87 | 0.0001 | מובהק (α = 0.05) |
| המודל המוצע מול CNN | F1-score | Bootstrap מצומד (1,000 דגימות חוזרות) | 2.81 | 0.0044 | מובהק (α = 0.05) |
| המודל המוצע מול Random Forest | דיוק (% Accuracy) | מבחן מקנימאר (McNemar's test) | 14.27 | 0.0002 | מובהק (α = 0.05) |
| המודל המוצע מול Random Forest | AUC-ROC | מבחן דה-לונג (DeLong's test) | 5.86 | <0.0001 | מובהק (α = 0.05) |
| המודל המוצע מול Random Forest | F1-score | Bootstrap מצומד (1,000 דגימות חוזרות) | 4.03 | 0.0003 | מובהק (α = 0.05) |
| המודל המוצע מול SVM | דיוק (% Accuracy) | מבחן מקנימאר (McNemar's test) | 16.08 | <0.0001 | מובהק (α = 0.05) |
| המודל המוצע מול SVM | AUC-ROC | מבחן דה-לונג (DeLong's test) | 6.95 | <0.0001 | מובהק (α = 0.05) |
| המודל המוצע מול SVM | F1-score | Bootstrap מצומד (1,000 דגימות חוזרות) | 4.62 | <0.0001 | מובהק (α = 0.05) |
| שחזור בהרצות חוזרות (10 הרצות בלתי תלויות) | AUC-ROC | תיאורי (mean ± SD) | — | — | 0.957 ± 0.008 |
| שחזור בהרצות חוזרות (10 הרצות בלתי תלויות) | דיוק (% Accuracy) | תיאורי (mean ± SD) | — | — | 93.24 ± 0.74% |
| שחזור בהרצות חוזרות (10 הרצות בלתי תלויות) | F1-score (%) | תיאורי (mean ± SD) | — | — | 92.35 ± 0.92% |
טבלה 6: תוצאות תיקוף סטטיסטי ושחזור שהתקבלו מהיישום הניסויי באמצעות מאגר הנתונים של סוכרת באינדיאנים של פימה (Pima Indians Diabetes Dataset). הטבלה מסכמת ביצועי תיקוף צולב (cross-validation) של חמישה קיפולים, רווחי סמך של 95% מבוססי bootstrap, השוואות סטטיסטיות של המודל המוצע מול מודלי הבסיס, ושחזור ריצות חוזרות על פני 10 זרעים אקראיים עצמאיים. תיקוף חיצוני והערכה של מומחים קליניים לא בוצעו בתיקוף הנוכחי.
| לא. | פריט ברשימת תבדיקה | תיעוד נדרש | הקלטה / אימות מומלצים |
| 1 | סביבת תוכנה | מערכת הפעלה, שפת תכנות וסביבת תוכנה | יש לרשום את הגרסאות המדויקות של מערכת ההפעלה ושפת התכנות. |
| 2 | גרסאות תוכנה וספריות | גרסאות של ספריות תוכנה וחבילות מרכזיות | יש להקליט את השמות המדויקים והגרסאות של החבילות/ספריות. |
| 3 | מפרט חומרה | מפרטי CPU, GPU, RAM, אחסון ומאיצים | תעד את החומרה החשובנית ששימשה למחקר. |
| 4 | זיהוי מערכי נתונים | שם מערך הנתונים, מקור, גרסה ומידע על הגישה | תעד את מקור הנתונים/הגרסה המדויקת ואת תאריך הגישה, במידה והדבר רלוונטי. |
| 5 | מאפייני מערך הנתונים | גודל מדגם והתפלגות מחלקות | יש להירשום את סך הדגימות ואת התפלגות המחלקות עבור כל חלוקה. |
| 6 | חלוקת מערכי נתונים | אסטרטגיה של אימון, תיקוף ומערך בדיקה עצמאי | תעד את פרופורציות/מספרי הפיצול ואת הריבוד. |
| 7 | מניעת דליפת נתונים | פרוצדורה למניעת דליפת מידע | הפרדת דגימות/מסמכים ותיקוף פרמטרי עיבוד מקדימה עבור האימון בלבד. |
| 8 | פרמטרי עיבוד מקדם | הגדרות ניקוי, טיפול בערכים חסרים, נרמול, קידוד והמרה | תעדו את כל פעולות העיבוד המקדים ואת ערכי הפרמטרים. |
| 9 | הגדלת נתונים (Data augmentation) | שיטות הרחבה והגדרות פרמטרים, במידה ורלוונטי | תעד שיטות, הסתברויות וטווחי פרמטרים. |
| 10 | ארכיטקטורת המודל | ארכיטקטורה וקונפיגורציה סופיות של המודל | תעד את סוג המודל, השכבות/רכיבים, הממדים ופונקציות ההפעלה. |
| 11 | היפר-פרמטרים | אימון והיפר-פרמטרים של אופטימיזציה | תעד את קצב הלמידה, גודל האשורה (batch size), את האופטימייזר, את מספר האיטרציות (epochs), את העצירה המוקדמת (early stopping) ואת הפרמטרים שעברו כיוונון. |
| 12 | זרעים אקראיים | גרעינים אקראיים (Random seeds) ששימשו להרצה הדירה | תעדו את הגרעינים (seeds) לצורך פיצול, אתחול והרצות חוזרות. |
| 13 | תצורת אימון | הליך האימון ואסטרטגיית בחירת מודל | תיקוף מסמכים, יצירת נקודות השבחה (checkpointing) וקריטריונים לבחירת מודל. |
| 14 | מדדי הערכה | מדדי הערכה סטטיסטיים וניבויים שנקבעו מראש | יש לתעד את כל מדדי הביצועים שדווחו. |
| 15 | רווחי סמך | מרווחי אי-ודאות עבור מדדי ביצועים | תעד את הליך הערכת רווחי הביטחון (CI) ואת דגימות החזרה (bootstrap resamples) במידת הרלוונטיות. |
| 16 | מבחנים סטטיסטיים | פרוצדורות סטטיסטיות להשוואת מודלים | תעד את הבדיקה, את הסטטיסטיקה, את ערך ה-p, את סף המובהקות ואת ההנחות. |
| 17 | ניתוח הרצות חוזרות | הרצות עצמאיות באמצעות זרעי אקראיות שונים | יש לתעד את מספר ההרצות ואת הממוצע ± סטיית תקן (SD) של מדדי מפתח. |
| 18 | הגדרת יכולת ההסבר (Explainability configuration) | שיטות להסברות והגדרות פרמטרים | תעד את SHAP, LIME, Grad-CAM, attention, counterfactual, או הגדרות רלוונטיות אחרות. |
| 19 | הערכת יכולת הסבר (Explainability assessment) | הערכה אובייקטיבית של מהימנות ותועלת ההסבר | תיעוד של נאמנות, יציבות, חוסר נאמנות, לוקליזציה והערכת מומחים במידת הצורך. |
| 20 | ארטיפקטים של מודל | משקלי מודל מאומנים וקבצי קונפיגורציה | ארחב את המודל המאומן הסופי, את הארכיטקטורה/התבנית ואת מידע הבחירה. |
| 21 | זמינות הקוד | קוד נדרש לעיבוד מקדים, אימון, הערכה ויצירת הסברים | מאגר רשומות או מידע על גישה מבוקרת לקוד, במידה ורלוונטי. |
| 22 | תיעוד ביצוע | פקודות, סקריפטים, קבצי הגדרה והוראות | תעד את הפקודות ואת התצורה הדרושים לשחזור זרימת העבודה. |
| 23 | תיעוד פלט | תחזיות, תוצאות הערכה, איורים ופלטי הסבר | ארכוב פלטי תהליך (outputs) וקישורם לניסוי/הרצה המתאימים. |
| 24 | אימות שחזוריות | אימות עקביות בין הרצות עצמאיות | השוו את תוצאות ההרצות החזורות ודווחו על מדדי שונות שהוגדרו מראש. |
טבלה 7: רשימת בדיקה לשחזור עבור שכפול עצמאי של זרימת העבודה המוצעת של XAI. רשימת הבדיקה מפרטת את הדרישות החשובניות, של מערך הנתונים, עיבוד מקדימה, פיתוח המודל, ההערכה, התיקוף הסטטיסטי, יכולת ההסבר והתיעוד הדרושות כדי לשחזר את זרימת העבודה הניסוית.
דיון
התוצאות מדגימות את התועלת של הפרוטוקול המוצע כסב עבודה סטנדרטי וניתן לשחזור לפיתוח והערכה של מערכות XAI על פני מאגרי נתונים מגוונים בתחום הבריאות. כפי שמוצג ב-טבלה 2 וב-איור 3, עיבוד מקדים סיסטמטי הניב נתונים סטנדרטיים ושיפר את איכות הנתונים באמצעות טיפול בערכים חסרים, נורמליזציה של נתונים, סקיילינג של מאפיינים (feature scaling) וחלוקה של מאגר הנתונים. שלבי עיבוד מקדים אלו הם קריטיים מכיוון ששונות בהכנת הנתונים עלולה להוביל להטיה, להפחית את ביצועי הניבוי ולפגוע באמינות של ניתוחי ההסביריות. לכן, יש להחיל נהלי עיבוד מקדים עקביים על מאגרי הנתונים לאימון, לתיקוף ולבדיקה כדי לקדם שחזור ולמנוע דליפת נתונים (data leakage)19,20.
תוצאות אימון המודל המוצגות באיור 4 ובטבלה 4 מדגימות התנהגות למידה עקבית ויציבה. ירידות מקבילות בהפסדי האימון והתיקוף, לצד עליות בדיוק החיזוי, מעידות על התכנסות תקינה של המודל ללא התאמת-יתר (overfitting) משמעותית. אופטימיזציה של היפר-פרמטרים, עצירה מוקדמת (early stopping), dropout ורגולריזציה תורמים עוד יותר לאימון מודל יציב וניתן לשחזור. חוסר יציבות בעקומות הלמידה עשוי להצביע על קצב למידה לא מתאים, נתוני אימון לא מספיקים או מורכבות יתר של המודל. לפיכך, יש לנטר את התכנסות המודל לאורך כל האימון כדי לזהות ולטפל בבעיות פוטנציאליות אלו.
טבלה 5 ו-איור 5 מדגימים ביצועים חיזויים באמצעות מדדי הערכה מרובים, הכוללים accuracy, precision, recall, specificity, F1-score, מקדם המתיו (Matthews correlation coefficient) ושטח תחת עקומת מאפיין תפעול המקלט (ROC). עקומות ה-ROC וה-precision-recall מספקות מדדים לביצועי הבחנה, בעוד שמטריצת הבלבול (confusion matrix) ממחישה את התפלגות הסיווגים הנכונים והשגויים בין המחלקות. הערכה באמצעות מדדי ביצועים מרובים חשובה במיוחד עבור מאגרי נתונים רפואיים לא מאוזנים, מכיוון שדיוק כללי (overall accuracy) לבדו עשוי שלא לאפיין באופן מספק את ביצועי המודל.
איור 6 ממחיש את תוצאות ההסביריות שהופקו ממאגר הנתונים של סוכרת בקרב אינדיאנים מפונימה (Pima Indians Diabetes Dataset) ומדגים את התפקידים המשלימים של שיטות ההסביריות שיושמו בתיקוף המקרה. ניתוח SHAP גלובלי מאפיין את התרומה הכוללת ואת החשיבות היחסית של תכונות הקלט לניבויים של המודל, בעוד שתרשימי מפל (waterfall) ותלות (dependence) של SHAP מספקים פרשנויות להתנהגות המודל ברמת המטופל וברמת התכונה. LIME מספק הסבר מקומי נוסף על ידי זיהוי התכונות התורמות לניבוי בודד בסט הבדיקה. ההסבר הקונטר-פקטואלי (counterfactual) הספציפי למטופל ממחיש עוד יותר את השינויים המינימליים בתכונות הקשורים לשינוי בתוצאה הנחזית. יחד, גישות אלו מספקות פרספקטיבות גלובליות ומקומיות משלימות על התנהגות המודל ומשפרות את השקיפות והיכולת לפרש את המודל הנבואי הטבלאי. Grad-CAM, ויזואליזציה של קשב (attention visualization), מיפוי בולטות (saliency mapping) וגרדיאנטים אינטגרליים (Integrated Gradients) לא יושמו בתיקוף המקרה של Pima ונשמרו רק כאפשרויות התלויות במודליות במסגרת הפרוטוקול הכללי.
תיקוף סטטיסטי (טבלה 6 ו-איור 7>) והערכות הדירות מדגימים את היציבות של ביצועי הניבוי לאורך הרצות ניסוייות שונות. השילוב של אימות צולב (cross-validation), הערכת רווחי סמך, בדיקת השערות והערכת הדירות של הרצות חוזרות מספק מסגרת שיטתית להערכת חוסנו של המודל. תיקוף כזה חשוב במיוחד ביישומים בתחום הבריאות, כיוון שהדירות לאורך ניסויים בלתי תלויים מספקת ראיות לאמינותם וליכולת ההכללה של מודלי AI לפני הטמעתם בסביבות קליניות21,23.
מספר שלבים הם קריטיים ליישום מוצלח של פרוטוקול זה. בצעו ניקוי נתונים לפני חילוץ המאפיינים ואימון המודל כדי למזער הטיות פוטנציאליות הנובעות מנתונים חסרים, לא עקביים או שגויים. בצעו אופטימיזציה של היפר-פרמטרים באמצעות נתוני האימון והתיקוף בלבד, והשאירו את מערך נתוני הבדיקה עצמאי לאורך כל תהליכי פיתוח ואופטימיזציית המודל. תיעדו בבירור את מצבי מחולל המספרים הפסאודו-אקראיים, גרסאות התוכנה, תצורות החומרה והגדרות העיבוד המקדים כדי להקל על השחזור בין פלטפורמות חישוביות שונות. בנוסף, בחרו שיטות הסבר (explainability methods) בהתבס על המודל החיזוי ועל סוג נתוני הבריאות כדי להשיג הסברים הניתנים לפירוש ובעלי רלוונטיות קלינית20,29,30.
לפרוטוקול מספר מגבלות. הדיוק והמהימנות של תחזיות המודל וההסברים שלו תלויים במידה רבה בזמינותם של מאגרי נתונים של שירותי בריאות שהם גדולים מספיק, מייצגים ובאיכות גבוהה. תת-ייצוג של אוכלוסיות חולים ספציפיות, שגיאות מדידה, משתנים חסרים והטרוגניות בין מקורות הנתונים עלולים להשפיע לרעה הן על ביצועי הניבוי והן על היציבות של הסברי המודל. יתרה מכך, גישות הסביריות הנוכחיות יכולות לאפיין את התנהגות המודל אך אינן מבסות בהכרח מנגנונים סיבתיים. לפיכך, יש לפרש את תוצרי ה-XAI בשילוב עם מומחיות קלינית רלוונטית.
באופן כללי, פרוטוקול זה מספק גישה סטנדרטית לפיתוח מודלים הניתן לשחזור, להערכתם ולניתוח יכולת ההסבר שלהם בתחומים שונים של שירותי הבריאות. באמצעות שילוב של עיבוד מקדים סטנדרטי, אופטימיזציה של היפר-פרמטרים, הערכה באמצעות מדדי ביצועים מרובים, גישות משלימות להסבריות ותיקוף סטטיסטי, זרימת העבודה מספקת מסגרת שקופה ועקבית למחקר בינה מלאכותית בתחום הבריאות.
התוצאות מצביעות עוד על כך שניתן לתמוך בפיתוח שקוף ועקבי של מודלי AI על ידי שילוב של עיבוד מקדים סיסטמטי של נתונים, נהלי פיתוח מודלים סטנדרטיים, הערכת ביצועים מקיפה, שיטות הסברתיות מרובות ותיקוף סטטיסטי קפדני. ניתן להתאים את הפרוטוקול למסדי נתונים קליניים, לדימויים רפואיים, לאות פיזיולוגיים ולנתוני בריאות רב-מודאליים, תוך שמירה על מסגרת לניסויים ניתנים לשחזור בסביבות חישוביות שונות. באמצעות יישום סטנדרטי, טכניקות הסברתיות משלימות והערכת שחזור, הפרוטוקול מספק מסגרת לפיתוח מודלי AI ניתנים להסברה ומהימנים, ועשוי לשמש כבסיס מתודולוגי למחקרי ביו-רפואה עתידיים ולתיקוף חיצוני וקליני עוקב.
גילויים
המחברים מצהירים כי אין להם ניגודי אינטרסים כספיים, קשרים מסחריים או קשרים אישיים שעלולים היו להשפיע על העבודה המדווחת במחקר זה. למחברים אין ניגודי אינטרסים להצהיר עליהם.
תודות
המחברים מודים על התמיכה המוסדית שניתנה על ידי המוסדות השלוחים אליהם במהלך הפיתוח והתיקוף הניסויי של פרוטוקול XAI זה לבריאות. המחברים מודים גם על המתקנים המחשובים ומשאבי התוכנה ששימשו לביצוע הניתוחים הניסוייים. מחקר זה לא קיבל מימון חיצוני. המחברים מודים על השימוש ב-Python 3.1, Matplotlib 3.9 ו-SciPy 1.13 לצורך ניתוח חישובי, ויזואליזציה של נתונים ויצירת האיורים המוצגים במחקר זה.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| Captum | Meta AI | הגרסה היציבה האחרונה | הסבירות של PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | האצה באמצעות GPU |
| cuDNN | NVIDIA | 9.x | backend ללמידה עמוקה |
| Git | Git SCM | הגרסה היציבה האחרונה | בקרת גרסאות |
| GitHub | GitHub Inc. | פלטפורמת אינטרנט | מאגר קוד מקור |
| Grad-CAM | ג'קובגיל | מהדורה אחרונה | ויזואליזציה של CNN |
| Jupyter Notebook | פרויקט Jupyter | הגרסה היציבה האחרונה | פיתוח אינטראקטיבי |
| LightGBM | Microsoft | 4.x | הגברת גרדיאנט (Gradient boosting) |
| LIME | קהילת LIME | 0.2.0 | ניתנות הסבר מקומית |
| Matplotlib | מפתחי Matplotlib | 3.9 | ויזואליזציה |
| Microsoft Excel | Microsoft | Microsoft 365 | ארגון נתונים |
| NumPy | מפתחי NumPy | 1.26 | מיחשוב נומרי |
| מעבד גרפי NVIDIA RTX 4090 | NVIDIA | 24 GB VRAM | אימון מודל |
| OpenCV | ארגון OpenCV | 4.10 | עיבוד מקדים של תמונות |
| Pandas | צוות הפיתוח של Pandas | 2.2 | עיבוד מקדים של נתונים |
| Pillow (PIL) | ספריית עיבוד התמונות של Python | 10.x | עיבוד תמונות |
| Plotly | Plotly Technologies | 5.x | ויזואליזציה אינטראקטיבית |
| Python | Python Software Foundation | 3.11 | סביבת תכנות |
| PyTorch | PyTorch Foundation | 2.3 | למידה עמוקה |
| Scikit-learn | מפתחי Scikit-learn | 1.5 | למידת מכונה |
| SciPy | מפתחי SciPy | 1.13 | מיחשוב מדעי |
| Seaborn | מפתחי Seaborn | 0.13 | תרשימים סטטיסטיים |
| SHAP | קהילת SHAP | 0.46 | הסבירות הגלובלית |
| SimpleITK | קונסורציום תוכנת Insight | 2.x | עיבוד תמונות רפואיות |
| Statsmodels | מפתחי Statsmodels | 0.14 | ניתוח סטטיסטי |
| זיכרון RAM של המערכת | כל יצרן | 32 GB או יותר | זיכרון |
| TensorBoard | גוגל | 2.15 | ניטור אימון |
| TensorFlow | גוגל | 2.15 | למידה עמוקה |
| Ubuntu Linux / Windows 1 | Canonical / Microsoft | 2.04 LTS / 1 | מערכת הפעלה |
| Visual Studio Code | Microsoft | הגרסה היציבה האחרונה | פיתוח קוד |
| XGBoost | מפתחי XGBoost | 2.1 | הגברת גרדיאנט (Gradient boosting) |
מקורות
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.