תהליך עבודה זה משלב טרנסקריפטומיקה של תאי מאס (bulk) ותאים בודדים עם בדיקות ראשוניות של רקמות מטופלים כדי לתעדף את MMP1 באולקוס רגל סוכרתי. MMP1 הראה דפוס ביטוי המתרכז בפיברובלסטים ושכיחות גבוהה יותר ברקמה, מה שתומך בקשר לשחזור המטריקס (matrix remodeling), בעוד ששאלות של סיבתיות ותועלת קלינית נותרו ללא מענה.
מאמר מחקר
טרנסקריפטומיקה אינטגרטיבית של תאיו整个 (Bulk) ותאים בודדים עם תיקוף רקמתי מתעדפת את MMP1 באולקוס של רגל סוכרתית
* These authors contributed equally
במאמר זה
סיכום
תקציר
המקורות התאיים לשינויים טרנסקריפטומיים הניתנים לשחזור באולקוס רגל סוכרתית (DFU) נותרו שאינם מוגדרים באופן מלא. מחקר זה שילב ניתוח ביטוי דיפרנציאלי, ניתוח רשת ביטוי גנים משוקלל (WGCNA), סריקת גנים של נוירופתיה פריפרית סוכרתית (DPN), בחירת מאפיינים גששית באמצעות למידת מכונה, שני מאגרי נתונים טרנסקריפטומיים חיצוניים (bulk-transcriptomic), ניתוח של תאים בודדים (single-cell), ניתוח רשת של הרפואה הסינית המסורתית (TCM), וכן qPCR ו-western blotting של רקמות ממטופלים. ב-GSE199939 (10 דגימות DFU ו-11 דגימות ביקורת), זוהו 3,691 גנים בעלי ביטוי דיפרנציאלי, והמודול הכחול של ה-WGCNA נמצא קשור באופן חזק ל-DFU (r = 0.97, p = 5 × 10-13). חיתוך של הגנים בעלי הביטוי הדיפרנציאלי, גני ה-hub של המודול הכחול ו-1,062 גנים הקשורים ל-DPN הניב 77 מועמדים. CCL7, CHEK1, MKI67, MMP1, MMP13, ו-TRPV2 נתמכו על ידי לפחות שתי שיטות לבחירת מאפיינים; הפרדה מלאה בשיטת recursive feature elimination של support vector machine העלתה חששות לגבי overfitting של קוהורט הגילוי. MMP1 הראה את שינוי הביטוי הגדול ביותר בקוהורט הגילוי (log2 fold change = 9.854; adjusted p = 1.24 × 10⁻²⁹). במטריצה המאוחדת של GSE68183/GSE80178, ל-MMP1 היה adjusted p של 0.0159 ושטח תחת העקום של מאפייני תפעול מקלט (AUC) של 0.981. ב-GSE134431, ביטוי MMP1 היה גבוה יותר באופן נומינלי ב-DFU מאשר בעור רגל סוכרתית ללא אולקוס (p = 0.0225; adjusted p = 0.135; AUC = 0.808). ניתוח של 69,944 תאים מ-24 דגימות הראה את ממוצע ביטוי ה-MMP1 הגבוה ביותר בפיברובלסטים, עם ביטוי גבוה יותר ברמת הדגימה בפיברובלסטים, קרטינוציטים ותאי אנדותל של DFU. בדיקות ברקמות ממטופלים הראו שפע גבוה יותר של mRNA של MMP1 בארבעה זוגות תואמים (paired test on ΔCq, p = 3.04 × 10⁻⁵) ושפע חלבון גבוה יותר בשלושה זוגות תואמים (paired p = 0.0107). השחזור הסטטיסטי היה חלקי. הממצאים מרמזים על קשר של עיצוב מחדש של המטריקס הממוקד בפיברובלסטים, בכפוף למגבלות הנובעות מקלט של transcripts per million (TPM) בניתוח גילוי מבוסס ספירה, רישומים חלקיים של עיבוד מקדים של תאים בודדים וקוהורטים קטנים של בדיקות רקמה. סיבתיות ותועלת קלינית טרם הוכחו.
מבוא
כיב רגל סוכרתי הוא סיבוך חמור וחוזר של סוכרת הנובע מהשילוב של נוירופתיה, עומס מכני חוזר, מחלה עורקית פריפרית, רגישות לזיהומים ופגיעה בתיקון הרקמות. הערכות עכשוויות מצביעות על כך שמיליוני אנשים נפגעים מכך מדי שנה ברחבי העולם, ותהליך הריפוי הוא לרוב ממושך, עם סיכונים משמעותיים להישנות, אשפוז, קטיעת גפיים תחתונות ומוות1. לכן, המניעה והניהול תלויים לא רק בטיפול מקומי בפצע, אלא גם בזיהוי של אובדן תחושה מגנה, הפחתת לחץ פלנטרי, טיפול בזיהום ובאיסכמיה, וטיפול בגורמי סיכון מערכתיים1,2. נוירופתיה פריפרית סוכרתית רלוונטית במיוחד מכיוון שדטר deterioration תחושתי פרוגרסיבי עלול להפחית את המודעות ללחץ, טראומה ופירוק רקמות, בעוד שהפרעות מוטוריות ואוטונומיות עלולות לשנות עוד יותר את הביומכניקה של כף הרגל ואת שלמות העור2,3. ברמת הרקמה, פגיעה נוירופתית עשויה להתקיים לצד נוירו-דלקת, תפקוד לקוי של מיקרו-כלי דם, עקה מטבולית ותיקון לקוי, מה שיוצר סביבת פצע שבה הפגיעה נמשכת למרות טיפול סטנדרטי1,3.
ריפוי עורי מוצלח דורש דלקת מתואמת, רה-אפיתלייזציה, אנגיוגנזה, הפעלת פיברובלסטים, השקעת מטריקס חוץ-תאי (ECM) ועיצוב מחדש (remodeling) עוקב של המטריקס. בסוכרת, תהליכים אלו עלולים להפוך לבלתי מאורגנים מבחינה זמנית: אותות דלקתיים עלולים להישאר פעילים, נדידת קרטינוציטים עלולה להיות פגועה, תגובות אנדותליאליות עלולות להיות לא מספיקות, ופיברובלסטים עלולים לייצר או לארגן מטריקס חריג. פיברובלסטים הם מרכזיים לשלב הסטרומלי של התיקון מכיוון שהם מסנתזים חלבוני מטריקס, מווסתים את ארכיטקטורת הקולגן, מתקשרים עם תאי מערכת החיסון ותאים אפיתליאליים, ותורמים להתכווצות הפצע. מחקרים שהשתמשו בפיברובלסטים מ-DFU שהופקו מחולים הראו חריגויות מתמשכות בשעתוק הקשור ל-ECM ובהרכבת המטריקס, מה שתומך בסברה שמצב הפיברובלסט הוא מרכיב חשוב בביולוגיה של פצעים כרוניים4. מטריקס מטלופרוטאינאזים (MMPs) משתתפים בתהליך זה על ידי פיצול סובסטראטים של ECM ואפשור נדידת תאים, תחלופת רקמה ועיצוב מחדש; עם זאת, השפעותיהם תלויות במיקום, בתזמון, בזמינות הסובסטראט ובוויסות על ידי מעכבי רקמה של מטלופרוטאינאזים (TIMPs)5. לפיכך, חוסר איזון בין פרוטאוליזה לבין החלפת מטריקס עשוי להתאים לתיקון פגום, אך ביטוי מוגבר של MMP בודד אינו קובע כשלעצמו תפקיד מזיק או מועיל. מטריקס מטלופרוטאינאז 1 (MMP1), קולגנאז אינטרסטיציאלי המסוגל להשתתף בתחלופת קולגן פיברילרי, דווח כמשתנה ברקמת DFU, ומחקרים קליניים קודמים קישרו בין פרופילי MMP/TIMP למצב הפצע או למסלולי הריפוי6,7. תצפיות אלו תומכות בחקירה נוספת של MMP1 ב-DFU.
פרופיל טרנסקריפטומי מספק גישה שיטתית לזיהוי תוכניות מולקולריות הקשורות ל-DFU, אך מגבלות מתודולוגיות מספרים מקשירות את הפרשנות. מערכי נתונים של רקמה כוללת (Bulk-tissue) מבצעים מיצוע של אותות על פני קרטינוציטים, פיברובלסטים, תאי אנדותל, תאי מערכת החיסון ומדורי תאים אחרים, מה שמקשה לקבוע אם מועמד מסוים משקף ביטוי משתנה בתוך סוג תא, שינויים בהרכב התאי, או את שניהם. היכולת להשוות בין מערכי נתונים עלולה להיפגע גם בשל הבדלים בפלטפורמות, באסטרטגיות נורמליזציה, במיקומי דגימת הרקמה, בחומרת האולקוס, במצב הזיהום, בשלב המחלה ובסוג רקמת הביקורת. חשוב לציין כי עור של רגל סוכרתית שאינו פגוע באולקוס מהווה מדד השוואה קליני רלוונטי של רקמה סוכרתית, אך הוא אינו ניתן להחלפה עם עור בריא. ריצוף RNA של תא בודד (Single-cell RNA sequencing) יכול לפתור חלקית את בעיית מקור התא על ידי הבחנה בין אוכלוסיות תאים הטרוגניות ובין המצבים הטרנסקריפציונליים שלהן. מחקר קודם של טרנסקריפטומיקה מרחבית ותאים בודדים של DFU זיהה אוכלוסיות נפרדות של פיברובלסטים והדגים כי תוכניות פיברובלסטים נבדלות בהתאם להקשר הפצע ולמצב ההחלמה8. ממצאים אלו תומכים בשימוש בניתוח ברזולוציית תא כדי להשלים נתונים טרנסקריפטומיים של רקמה כוללת.
שיטות לבחירת מאפיינים עשויות לסייע בתעדוף מועמדים מתוך נתוני ביטוי רב-ממדיים, אך מחקרים ביו-רפואיים עם מדגמים קטנים פגיעים במיוחד להערכות אופטימיות ולבחירת גנים לא יציבה. כאשר מספר המשתנים הנמדדים עולה במידה ניכרת על מספר הדגימות הביולוגיות, עלולה להתרחש הפרדה מושלמת לכאורה גם כאשר המידע החזוי הניתן להכללה הוא מוגבל. שימוש חוזר באותן תצפיות לצורך בחירת מאפיינים, כיוונון והערכת ביצועים מנפח עוד יותר את ה-AUC, מה שהופך אימות צולב מקונן (nested cross-validation), מודלים נעולים וקוהורטות בדיקה עצמאיות באמת לחיוניים לצורך הערכת ביצועי החיזוי9,10. חששות אלו רלוונטיים למחקרי DFU מכיוון שקוהורטות הזמינות לציבור הן לרוב קטנות והטרוגניות. מאגרי נתונים של רכיב-מטרה-צמח ברפואה סינית מסורתית שימשו בנוסף אך ורק לצורך יצירת השערות.
מחקר זה שילב טרנסקריפטומיקה של אוכלוסיות תאים (bulk transcriptomics), WGCNA, סריקת גנים הקשורים ל-DPN, בחירת מאפיינים באמצעות למידת מכונה, הערכת מאגרי נתונים חיצוניים, ניתוח של תאים בודדים (single-cell analysis), ניתוח רשת של TCM ותיקוף ברקמות של מטופלים. גנים מועמדים שזוהו בקוהורט הגילוי נבחנו במאגרי נתונים טרנסקריפטומיים נוספים, והמועמד המוביל מומקם בסוגי תאים ספציפיים באמצעות נתוני תאים בודדים. לאחר מכן, MMP1 נבדק ברמות ה-mRNA והחלבון ברקמות של מטופלים באמצעות qPCR ו-western blotting. מסגרת עבודה זו תוכננה כדי לזהות מועמד הניתן לשחזור הקשור ל-DFU ולאפיין את ההקשר התאי והביולוגי שלו.
פרוטוקול
מבנה המחקר ומקורות הנתונים
המחקר, כולל איסוף ושימוש בדגימות רקמה של מטופלים לצורך תיקוף באמצעות qPCR ו-western blot, נסקר ואושר על ידי ועדת האתיקה של בית החולים הרביעי של ווהאן (מספר אישור KY2024-161-01). כל ההליכים שכללו רקמה אנושית בוצעו בהתאם לפרוטוקול המאושר ולעקרונות האתיים הרלוונטיים. מרכיב התעתוק (transcriptomics) של המחקר השתמש במאגרי נתונים מזוהים שאינם ידועים (de-identified) וזמינים לציבור. הסכמה מודעת בכתב התקבלה מכל המשתתפים שדגימות הרקמה שלהם שימשו לתיקוף הניסויי. מאגרי הנתונים התעתוקיים הזמינים לציבור נותחו בצורה שאינה מזוהה, והליכי ההסכמה עבור המחקרים המקוריים שיצרו את הנתונים טופלו על ידי המוסדות הרלוונטיים.
מחקר זה שילב טרנסקריפטומיקה של תאי אוכלוסייה (bulk transcriptomics), ניתוח רשתות, בחירת מאפיינים, ניתוח של תאים בודדים, חיזוי רשתות של רפואה סינית מסורתית (TCM) ותיקוף של רקמות ממטופלים. קהל התגליות היה מאגר הנתונים GSE199939 מ-Gene Expression Omnibus (GEO) (10 דגימות של כיב רגל סוכרתי [DFU] ו-11 דגימות ביקורת). הערכה טרנסקריפטומית חיצונית של תאי אוכלוסייה כללה מטריצה ממוזגת של GSE68183/GSE80178 (9 דגימות DFU ו-6 דגימות ביקורת) ו-GSE134431 (13 דגימות DFU ו-8 דגימות של עור רגל סוכרתי שאינו פגוע בכיב [DFS]). בניתוח התאים הבודדים נעשה שימוש באובייקט Seurat שעבר עיבוד מקדמי ואנוטציה באמצעות SingleR, שנגזר מ-GSE165816 וכלל 69,944 תאים מ-24 דגימות (14 DFU ו-10 ביקורות). הערכת הרקמות כללה ארבעה זוגות תואמים של DFU ורקמה סביב הכיב (periwound) מאותו מטופל עבור qPCR ושלושה זוגות תואמים עבור western blotting, בהתבסס על רישומי בדיקות ששוחזרו והתאמה שאושרה על ידי המחברים. כל החומרים והציוד ששימשו במחקר זה מפורטים ב- טבלת חומרים.
בניית סט הגנים הקשור ל-DPN
גנים הקשורים ל-DPN נשלפו ממאגר הגנים של המרכז הלאומי למידע ביולוגי (NCBI) באמצעות rentrez. מונחי החיפוש כללו “diabetic peripheral neuropathy”, “diabetic neuropathy”, “diabetic polyneuropathy”, “painful diabetic neuropathy”, ו-“diabetic sensorimotor polyneuropathy”, בהגבלה ל-Homo sapiens. המזהים שהתקבלו מופו לסמלי גנים רשמיים, הומרו לאותיות רישיות, ננקו והסרו מהם כפילויות. הגנים שהופקו מהמאגר שולבו עם רשימת גני DPN שנערכה על בסיס ספרות מקצועית ועברו הסרת כפילויות, מה שהניב 1,062 גנים הקשורים ל-DPN. מחרוזות החיפוש המלאות וקוד ניקוי המזהים כלולים בסקריפטים המצורפים; הם כוללים גם נוירופתיות סוכרתית, סוכרת בשילוב עם פולינוירופתיя סימטרית דיסטלית או נוירופתיя פריפרית, ואת מונח ה-MeSH של Diabetic Neuropathies. הרכיב שהופק מהספרות עדיין דורש תיעוד מקור ברמת הציטוט.
עיבוד מקדים של קוהורט הגילוי וניתוח ביטוי דיפרנציאלי
מטריצת הביטוי GSE199939 הותאמה לטבלת הפנוטיפ לפי מזהה הדגימה. מזהי גנים כפולים הפכו לייחודיים. בניתוח הגילוי שנשמר, ערכי הביטוי עוגלו והותאם מודל בינומי-שלילי באמצעות DESeq2 (גרסה 1.48.2), כאשר הקבוצה שימשה כגורם העיצוב וההשוואה הייתה בין DFU לבקרה. גנים עם ערכי p מתוקננים חסרים הוצאו מהניתוח. בקרת בדיקות מרובות בוצעה באמצעות הליך Benjamini–Hochberg (BH). רשימת הגנים עם ביטוי שונה (DEG) שנשמרה התבססה על ערך מוחלט של log2 fold change הגבוה מ-1 וערך p מתוקנן לפי BH של < 0.05. השוואה עם מקור ה-GEO הציבורי אישרה כי הקלט היה TPM, ולא ספירות קריאות גולמיות (raw read counts). עיגול של ערכי TPM אינו עומד בדרישת הספירות הגולמיות של DESeq2. האומדנים המקוריים נשמרו, אך תוקף הסטטיסטיקה של הגילוי ותוצאות ה-WGCNA ובחירת המאפיינים התלויות בהם נותרים לא פתורים עד לביצוע ניתוח חוזר מתאים. השוואת המקור מתועדת בארכיון המשלים.
לצורך ויזואליזציה, הוחלה התמרת ייצוב השונות (VST) של DESeq2 עם blind = FALSE. ניתוח רכיבים ראשיים (PCA) בוצע על מטריצת הביטוי שעברה VST. במפת החום (heatmap) נעשה שימוש במדדי z בשורות עבור 50 הגנים עם ערכי ה-p המתוקננים הנמוכים ביותר. מימוש ה-PCA ביצע מרכוז ונרמול של הערכים ההתמירתיים עבור כל גן באמצעות prcomp עם scale. = TRUE.
ניתוח רשתות ביטוי גנים משותף משוקלל
עבור WGCNA, נשמרו גנים עם ספירות הגבוהות מ-5 בלפחות שלושה דגימות מ-GSE199939. מקדמי גודל (Size factors) הוערכו באמצעות DESeq2, הופעל VST עם blind = TRUE, ונבחרו ה-5,000 הגנים בעלי השונות הגבוהה ביותר בין הדגימות. איכות הדגימות והגנים הוערכה באמצעות goodSamplesGenes, ולצורך הערכת איכות ברמת הדגימה נעשה שימוש בקיבץ היררכי בשיטת average-linkage.
רשת חתומה (signed network) נבנתה באמצעות WGCNA (גרסה 1.74). חזקות מועמדות של 1–10 ו-12–30 במרווחים של 2 נבחנו באמצעות pickSoftThreshold; נעשה שימוש ביעד התאמה לטופולוגיה חסרת קנה מידה (scale-free topology fit) של 0.85, והחזקה שנבחרה לסף הרך (soft-thresholding power) הייתה 18. מודולים זוהו באמצעות blockwiseModules תוך שימוש בסמיכות חתומה ובמטריצת חפיפה טופולוגית חתומה, מתאם פירסון (Pearson correlation), גודל מודול מינימלי של 30, גובה מיזוג (merge cut height) של 0.25, סף הקצאה מחדש של 1 × 10⁻⁶, pamRespectsDendro = FALSE, וגודל בלוק מקסימלי של 10,000.
ביצעו מתאם בין הגנים המייצגים של המודולים (Module eigengenes) לבין תכונת DFU בינארית. מודולים שאינם אפורים עם |r| > 0.5 ו-p < 0.05 נחשבו כקשורים ל-DFU. עבור כל מודול קשור, מובהקות הגן (GS) הוגדרה כמתאם פירסון בין ביטוי הגן לבין סטטוס ה-DFU, וחברות במודול (MM) הוגדרה כמתאם פירסון בין ביטוי הגן לבין הגן המייצג של המודול המתאים. גני מפתח (Hub genes) הוגדרו על ידי |MM| > 0.8 ו-|GS| > 0.5. המודול הכחול, שהראה את הקשר החיובי החזק ביותר עם DFU, נבחר להמשך הניתוח. גני המפתח שלו הושוו לחיתוך עם ה-DEGs ועם סט הגנים הקשור ל-DPN. לכן, סף גני המפתח המדווח משתמש בערכים מוחלטים שלהם של MM ו-GS, ללא קשר לסימן המתאם.
תיעדוף תכונות מבוסס למידת מכונה
77 הגנים המשותפים לקבוצות הגנים של DEG, גני ה-hub של המודול הכחול וגנים הקשורים ל-DPN הוערכו ב-GSE199939. סמלי גנים כפולים אוחדו לפי ממוצע הביטוי שלהם. מטריצת הגנים המועמדים עברה טרנספורמציית log2 כאשר הערך המקסימלי עלה על 50, מאפיינים בעלי שונות אפס הוסרו, והמאפיינים שנותרו עברו סטנדרטיזציה. נעשה שימוש ב-random seed של 123. הרצף שיושם כלל סריקת מועמדים בכלל העמותה, איחוד סמלים כפולים, טרנספורמציית לוג מותנית, סינון שונות אפס, מרכזיזציה וסקלינג של כל העמותה, ובחירת מאפיינים ספציפית לאלגוריתם. סריקת DEG ו-WGCNA השתמשה בעמותת הגילוי המלאה לפני תיקוף צולב (cross-validation) ברמת האלגוריתם. לפיכך, זרימת העבודה המדווחת אינה מבססת תיקוף מקונן (nested validation) נטול זליגה, ולא ניתן להשתמש ב-AUCs הפנימיים שלה כהערכות לא מוטות של ביצועים חיזויים.
יושמו שלושה הליכי בחירת מאפיינים. ראשית, בוצע רגרסיה לוגיסטית מסוג LASSO (least absolute shrinkage and selection operator) באמצעות glmnet (גרסה 5.0), עם binomial family, alpha = 1, כאשר מדד התיקוף הצולב היה שגיאת סיווג (classification error), ללא סטנדרטיזציה נוספת, ותיקוף צולב חומש (five-fold cross-validation) המוגבל על ידי גודל המחלקה הקטנה יותר. נבחרו מאפיינים ב-lambda.1se; ה-lambda.min שימש רק אם lambda.1se לא בחר אף גן. שנית, בוצע יער אקראי (random forest) עם 1,000 עצים באמצעות randomForest (גרסה 4.7-1.2); נשמרו גנים שערך ה-mean decrease in Gini שלהם היה גדול לפחות כחשיבות הממוצעת בקרב הגנים המועמדים. שלישית, בוצע תהליך SVM-RFE (linear support vector machine recursive feature elimination) באמצעות e1071 (גרסה 1.7-17), המדרג את המאפיינים לפי המשקל הליניארי בריבוע על פני כל העקבה לפני הערכת תתי-קבוצות קטנות יותר של מאפיינים באופן הדרגתי באמצעות AUC בתיקוף צולב מסוג leave-one-out (LOOCV). הדירוג לא חושב מחדש בתוך כל קיפול אימון. התאמת ה-Linear SVM השתמשה ב-scale = FALSE וב-probability = TRUE ללא רשת כוונון עלויות (cost-tuning grid) מפורשת. בחירת העונש ב-LASSO השתמשה בתיקוף צולב פנימי ללא לולאת הערכה חיצונית נפרדת, וחשיבות היער האקראי חושבה מכל העקבה.
אף גן לא נבחר על ידי שלוש השיטות; לפיכך, נשמרו גנים שנתמכו על ידי שתי שיטות לפחות. SVM-RFE הניב AUC של 1.00 בכל גדלי תת-הקבוצות שנבדקו, ונבחרה תת-הקבוצה הקטנה ביותר מבין אלו שהשיגו תוצאה זהה. מכיוון שהפרדה מלאה זו עוררה חששות לגבי overfitting והערכה אופטימית בקוהורט הגילוי הקטן, ה-AUC של SVM-RFE לא פעל כהערכה לביצועים קליניים. לא נבדק מודל רב-גנים סגור בקוהורט חיצוני; ניתוחי ROC חיצוניים העריכו את הביטוי של גנים מועמדים בודדים. בדיקת סקריפט הניתוח אישרה כי עיבוד מקדים ודירוג מאפיינים של SVM לא היו מוגבלים למקפלי האימון. אותן תוצאות LOOCV שימשו לבחירת גודל תת-הקבוצה, ללא לולאת הערכה חיצונית. כתוצאה מכך, זרימת עבודה זו כוללת דליפת מידע (information leakage) ותומכת אך ורק בתעדוף מאפיינים גשש.
ניתוח העשרה פונקציונלית
ניתוחי ייצוג-יתר של Gene Ontology (GO) ו-Kyoto Encyclopedia of Genes and Genomes (KEGG) בוצעו עבור פאנל ששת הגנים. סמלי הגנים מופו למזהי Entrez באמצעות org.Hs.eg.db (גרסה 3.21.0). ניתוח GO בוצע באמצעות clusterProfiler (גרסה 4.16.0) על פני אונטולוגיות של תהליכים ביולוגיים, רכיבים תאיים ותפקודים מולקולריים. להעשרת KEGG נעשה שימוש בקוד האורגניזם האנושי (hsa). מונחים מובהקים הוגדרו כערכי p נומינליים < 0.05 וערכי p מתוקננים לפי BH < 0.05. מכיוון שרק שישה גנים נכללו, ניתוח ההעשרה שימש בעיקר לצורך אנוטציה תפקודית. הסקריפט של KEGG השתמש באנוטציות מקומיות של KEGG.db עם enrichKEGG(use_internal_data = TRUE); יש לתעד את גרסת האנוטציה. הסקריפטים של GO ו-KEGG לא סיפקו "universe" מותאם אישית, ולכן מאגרי האנוטציות הגדירו את הרקע (background) כברירת מחדל.
הערכה טרנסקריפטומית חיצונית של אוכלוסיות תאים (bulk-transcriptomic)
עבור המטריצה המאוחדת GSE68183/GSE80178, סמלי הגנים סטנדרטו וסמלים כפולים אוחדו על ידי ממוצע הביטוי בין השורות התואמות. ששת הגנים המועמדים הותאמו לקובץ הפנוטיפ. מכיוון שהקבצים הזמינים לא תיעדו באופן מלא את תהליך האיחוד ותיקון האפקטים של הסדרות (batch-correction) המקדימים, מערך נתונים זה נותח כפי שסופק ופורש בזהירות. כתוצאה מכך, לא ניתן לבסס מהרישום של עיבוד הנתונים שסופק את הסרת אפקטי הסדרות או את עצמאות אות הקבוצה מאפקטים של המחקר. מטריצה זו מספקת תמיכה גישושית בין מערכי נתונים ולא שכפול סופי.
עבור GSE134431, ששת הגנים המועמדים הופקו ממטריצת ה-reads per kilobase per million mapped reads (RPKM) ועברו טרנספורמציה של log2(RPKM + 1). DFS שימשה כקבוצת הייחוס ו-DFU כקבוצת ההשוואה. DFS מייצגת עור של רגל סוכרתית ללא כיב. ב-איור 4C שהוגש במקור, הוצגו ערכי RPKM גולמיים; הפאנל המעודכן משתמש בסולם log2(RPKM + 1) שצוין. מבחני Wilcoxon דו-זנביים עם קירוב נורמלי ותיקון רציפות, וניתוחי ROC מכוונים אוטומטית, אומתו בשני הסולמות והניבו ערכי p ו-AUC זהים, מכיוון שהטרנספורמציה היא מונוטונית באופן מוחלט.
בכל מערך נתונים של תיקוף מסה (bulk validation), הבדלי ביטוי בין קבוצות נבחנו באמצעות מבחני Wilcoxon rank-sum דו-זנביים, ובוצע תיקון BH עבור ששת הגנים. עקומות ROC חושבו באמצעות pROC (גרסה 1.19.0.1), תוך שימוש בכיוון שנבחר באופן אוטומטי על ידי החבילה. ערכי AUC ומרווחי סמך (CIs) של 95% תואמים חושבו כדי להשוות דפוסי הבחנה בין מערכי הנתונים. בחירה אוטומטית של כיוון ה-ROC מכל מערך נתונים להערכה עלולה להוביל להבחנה אופטימית; ערכי AUC של גנים בודדים אלו הם תיאוריים ואינם מתקפים מודל חיזוי קליני שהוגדר מראש.
מיקום ברמת תא בודד וניתוח ברמת הדגימה
בניתוח של תאים בודדים נעשה שימוש באובייקט Seurat השמור biofsci_SingleR_annotated_MMP1_analyzed.rds מ-GSE165816, המכיל 22,889 גנים ו-69,944 תאים בבדיקת ה-RNA. בדיקת ה-RNA שמרה על שכבת ספירות של מספרים שלמים לא-שליליים ושכבת נתונים שנוצרה באמצעות LogNormalize עם scale factor של 10,000 ואחריו טרנספורמציית log1p; האחרונה לא הייתה TPM. האובייקט הכיל 2,000 גנים משתנים שנבחרו באמצעות שיטת vst (loess.span = 0.3; 20 equal-width bins), ביטוי מנורמל (scaled expression) עבור כל הגנים שנשמרו (centering and scaling פעילים; scale.max = 10), ו-50 רכיבים ראשיים (principal components) שחושבו מהמאפיינים המשתנים עם seed 42. היסטוריית הפקודות השמורה השתמשה במימדי Harmony 1–20 לבניית השכנים הקרובים ביותר (nearest-neighbor construction) ולקירוב והקרבה של סבך אחיד (UMAP). הגדרות השכנים כללו k = 20, Annoy עם 50 עצים ומרחק אוקלידי, וסף גיזום של שכנים קרובים משותפים (SNN) של 1/15. לצורך הצבירה (Clustering) נעשה שימוש ברזולוציה 0.8, אלגוריתם 1, n.start = 10, n.iter = 10, ו-random.seed = 0. ב-UMAP נעשה שימוש במימוש של uwot, 30 שכנים, שני מימדי פלט, מדד מרחק קוסינוס, min.dist = 0.3, spread = 1, learning.rate = 1, ו-seed 42. האובייקט שמר על צמצום Harmony, אך לא ניתן היה לשחזר את נקודות החיתוך המקוריות של בקרת האיכות, את קריאת RunHarmony המלאה כולל משתני השבתיות (batch covariates), ואת הגדרות הייחוס וההערה של SingleR עבור אובייקט מנותח זה. תוויות סוגי תאים, תוויות קבוצות ומזהי דגימות נשמרו ב-SingleR_label, Group, ו-orig.ident, בהתאמה. נשמרו עשרה סוגי תאים עם הערות: B cells, CD8+ T cells, תאים אנדותלליים, תאים אפיתליאליים, פיברובלסטים, תאי גזע המטופויטיים, קרטינוציטים, מקרופגים, מונוציטים ונוירונים.
MMP1 הביטוי סוכם לפי סוג התא. תאים עם ערכים מנורמלים MMP1 ביטוי הגדול מאפס סווג כ- MMP1חיובי. עבור ניתוח ברמת הדגימה, חושב ביטוי מנורמל ממוצע עבור כל שילוב של דגימה-סוג תא. דגימות DFU ודגימות ביקורת הושוו בתוך כל סוג תא באמצעות מבחני Wilcoxon rank-sum דו-צדדיים, ולאחריהם תיקון BH על פני כל סוגי התאים שנבדקו. מספר הגישה לדגימה ב-GEO, ולא התא הבודד, היה היחידה ששימשה בהשוואות המדווחות אלו. 24 מספרי הגישה לא נחשבו כהוכחה ל-24 תורמים עצמאיים. האובייקט שנשמר לא הכיל מזהה תורם מאומת, ודגימות רקמה חוזרות בתוך תורמים לא מודלו; כתוצאה מכך, המבחנים ברמת הדגימה מפורשים כשלבי סקר. סיכומים אלו מחשבים ממוצע של ביטוי מנורמל בתוך דגימה וסוג תא; אין מדובר במודלים של ביטוי דיפרנציאלי מסוג pseudobulk המבוססים על סכום ספירות.
עשרה סטים של גנים פונקציונליים דורגו באמצעות Seurat AddModuleScore. מתאמי ספירמן בין ערכים לרמת תא MMP1 חושבו ציוני ביטוי וציוני מודול, והם תוקנו בשיטת BH. עבור ניתוח גשש MMP1-ניתוח גבוה, שלושת סוגי התאים בעל הממוצע הגבוה ביותר MMP1 נבחר ביטוי בקרב סוגי תאים המכילים לפחות 50 תאים. סף גלובלי הוגדר כחציון הביטוי בקרב MMP1תאים חיוביים כאשר היו זמינים יותר מ-10 תאים חיוביים; אחרת, הסקריפט השתמש באחוזון ה-75 הכללי. תאים שערכיהם היו מעל סף חיתוך זה שויכו ל- MMP1-קבוצה הגבוהה ואת התאים הנותרים ל- MMP1-קבוצה נמוכה. כדי לזהות סמנים (FindMarkers), נעשה שימוש במבחן וילקוקסון (Wilcoxon test), עם סף logfc.threshold = 0.25 ו-min.pct = 0.1. גנים בעלי ביטוי מוגבר עם ערך מתוקנן של p < הועברו להעשרה של תהליכים ביולוגיים (biological-process) לפי GO עם ערך של 0.05. מכיוון שהקבוצות הוגדרו על ידי MMP1 ביטוי, ניתוח זה שימש לתיאור מסלולים הקשורים ל- MMP1-מצב גבוה. מתאמים לכל תא, המותאמים שלהם p ערכים, ו- MMP1גבוה לעומת MMP1-הערכים הנמוכים של ההעשרה הם תיאוריים, מכיוון שתלות בתוך הדגימה לא מודלה. תאים בודדים לא פורשו כחזרות ביולוגיות בלתי תלויות.
חיזוי מרכיב-מטרה-צמח ברפואה סינית מסורתית (TCM)
ששת הגנים שתועדפו הותאמו לעמודה 4 בטבלת האינטראקציות בין כימיקלים לגנים של מאגר המידע המקומי Comparative Toxicogenomics Database (CTD). הרשומות הוגבלו ל-Homo sapiens בעמודה 7. שמות הרכיבים נקטמו ונורמלו לאותיות קטנות לצורך התאמה, ומיפויים כפולים של רכיב-מטרה ושל צמח-רכיב הוסרו. הרכיבים קושרו לצמחים באמצעות טבלת הייחוס של צמח-רכיב. העשרה של מאגר המידע בוצעה באמצעות p נומינלי < 0.05 ו-p מתוקנן < 0.05. רשומות כפולות של צמח-רכיב-מטרה הוסרו לפני סיכום מבוסס כיסוי. העשרת הצמחים בוצעה באמצעות clusterProfiler::enricher כאשר מיפוי הצמח-רכיב שימש כ-TERM2GENE, עם minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1, ו-qvalueCutoff = 1 לפני החלת ספי רמת המובהקות הנומינליים והמתוקננים לפי BH. קישורים אלו למאגרי המידע עשויים לתאר שינויים בביטוי או בפעילות ואינם מבססים קישור ישיר או כיוון השפעה אחיד.
צמחי מרפא דורגו באמצעות ציון הכיסוי הבא:
S = 3R + 5L +2T + 3C + 2I + N (1)
כאן, R הוא מספר רשומות ה-MMP1, L הוא מספר הרכיבים המקושרים ל-MMP1, T הוא מספר המטרות המכוסות, C הוא מספר רכיבי הליבה, I הוא מחוון ציר המטריצה, ו-N הוא המספר הכולל של הרכיבים.
מרכיבי הליבה היו quercetin, luteolin ו-berberine. מדד ציר-המטריצה נקבע ל-1 כאשר צמח כיסה הן את MMP1 והן את MMP13, ול-0 אחרת. צמחים מועמדים נדרשו להכיל לפחות רשומה אחת הקשורה ל-MMP1, ובנוסף לפחות שני מרכיבים הקשורים ל-MMP1 או לפחות ארבעה מטרות בתוספת מרכיב ליבה אחד. הניקוד שימש לסיכום הכיסוי במסד הנתונים ולא נחשב כמדד ליעילות פרמקולוגית. המקדמים מגדירים כלל כיסוי 휴ריסטי מותאם אישית המדגיש רשומות ומרכיבים הקשורים ל-MMP1, כיסוי מטרות רחב יותר, את שלושת המרכיבים הייעודיים וכיסוי משותף של MMP1/MMP13. הם לא הותאמו לתוצאות קליניות ולא תוקפו ניסויית, ומשקולות חלופיות עשויות לשנות את דירוג הצמחים.
איסוף רקמות ממטופלים והערכה ראשונית באמצעות qPCR ו-western blot
מטופלים עם כיבים כרוניים בכף הרגל סוכרתית (DFU) שאובחנו קלינית ועברו דהברידמנט או ניתוח כפי שהתחייב קלינית בבית החולים הרביעי של ווהאן (Wuhan Fourth Hospital), היו כשירים להשתתפות כאשר רקמת כף רגל הייתה זמינה והסכמה מדעת בכתב התקבלה. קריטריוני ההדרה היו ממאירות באתר הדגימה, סיבה שאינה סוכרתית לכיב, או כמות או איכות רקמה לא מספקות עבור הבדיקות המתוכננות. רקמת DFU ורקמה לא פגועה שהקיפה את הפצע נלקחו מאותו מטופל תחת פרוטוקול המחקר המאושר. האחרונה שימשה כביקורת תואמת של רקמה סביב הפצע (periwound); היא לא הייתה עור בריא של אדם שאינו סוכרתי. הערכת ה-qPCR כללה ארבעה זוגות תואמים (ארבע דגימות DFU וארבע דגימות תואמות מסביב לפצע), ובדיקת ה-western blotting כללה שלושה זוגות תואמים. התאמה אושרה על ידי המחברים עבור כל בדיקה; זהות בין בדיקות שונות לא שימשה בהשוואות הסטטיסטיות. כל מטופל נחשב ליחידה ביולוגית, ובארות PCR טכניות נחשבו למדידות חוזרות בתוך דגימה אחת. בדיקות ראשוניות אלו נועדו להעריך את רמות הביטוי של MMP1 ברמת הרקמה, ולא תוכננו כדי לקבוע ביצועים אבחנתיים, סיבתיות או יכולת הכללה על פני פנוטיפים שונים של DFU.
לצורך תיקוף qPCR, RNA כולל הוצא מהדגימות של רקמות מטופלים באמצעות ריאגנט להוצאת RNA כולל, בהתאם להוראות היצרן. ריכוז ה-RNA ודרגת הזיכוך שלו נבחנו ספקטרופוטומטרית, ודגימות עם יחס A260/A280 של 1.8–2.1 שימשו לניתוחים הבאים. RNA כולל (1 µg) עבר תעתוק הפוך באמצעות ערכה לתעתוק הפוך של נגיף הלוקמיה של העכבר של Moloney (M-MLV) בנפח תגובה סופי של 20 µL. פרויקט המכשיר הזמין מזהה מערכת real-time PCR. qPCR כמותי בוצע באמצעות 2x SYBR Green PCR master mix בתגובה של 20 µL המכילה 10 µL של 2x SYBR Green master mix, 0.4 µL מכל אחד מהפריימרים הקדמי וההפוך, 2 µL של DNA משלים (cDNA), ו-7.2 µL של מים נטולי נוקלאז. תוכנית ההגברה כללה דנטורציה ראשונית ב-95 °C למשך 30 s, ולאחריה 40 מחזורים של 95 °C למשך 5 s ו-60 °C למשך 30 s. ניתוח עקומת התכה בוצע כדי לאמת את ספציפיות ההגברה. שפע התעתוק של MMP1 נמדד כאשר β-actin (ACTB) שימש כגן הייחוס. רצפי הפריימרים מפורטים בTable 1. עבור הניתוח הזוגי המעודכן, חמש הבארות הטכניות לכל מטרה בתוך כל דגימה הובאו לממוצע לפני חישוב ה-ΔCq, וביטוי MMP1 יחסי חושב באמצעות שיטת 2-ΔΔCq , כאשר קבוצת רקמות מסביב לפצע שאינן כיבייתיות שימשה ככיול. זוגות הדגימות ששוחזרו היו NC–DFU, NC1–DFU1, NC2–DFU2, ו-NC3–DFU3, אשר אושרו על ידי המחברים כארבעה זוגות תואמים של מטופלים. גרף ה-qPCR הקודם השתמש בחמישה ערכי בארות טכניות רק מ-NC ו-DFU; הגרף המעודכן מציג ערך אחד ברמת הדגימה לאחר מימוצע הבארות הטכניות עבור כל אחד מארבעת הזוגות. הסקה זוגית השתמשה ב-ΔCq = mean Cq(MMP1) − mean Cq(ACTB), במקום בערכי fold-change ברמת הבארה. פרויקט המכשיר שנשמר שונה גם הוא מנפח התגובה ומתוכנית המחזורים שדווחו, וההתאמה שלו לניסוי המוצג בגרף נותרה לא פתורה.
עבור תיקוף באמצעות western blot (WB), דגימות רקמה הומוגניזו בבאפר radioimmunoprecipitation assay קר על קרח, בתוספת מעכבי פרוטאז. הליזאטים דגרו על קרח למשך 30 min וסובבו בצנטריפוגה במהירות 12,000 x g למשך 15 min בטמפרטורה של 4 °C. התוצרים העליונים (supernatants) נאספו, וריכוזי החלבון נקבעו באמצעות bicinchoninic acid assay. כמויות שוות של חלבון (20 µg לכל נתיב) הופרדו על ג'לי sodium dodecyl sulfate-polyacrylamide במדרג של 4%–20% והועברו לממברנות polyvinylidene difluoride של 0.22 µm. הממברנות נחסמו עם 5% חלב רזה ב-Tris-buffered saline המכיל 0.1% Tween-20 למשך 1 h בטמפרטורת החדר, ודגרו למשך לילה ב-4 °C עם נוגדן פוליקלונלי ל-MMP1 (1:1,000) ונוגדן פוליקלונלי ל-cofilin (1:6,000). לאחר שלושה שטיפות עם Tris-buffered saline המכיל 0.1% Tween-20, הממברנות דגרו עם goat anti-rabbit immunoglobulin G (IgG) המשורשר ל-horseradish peroxidase (1:5,000) למשך 1 h בטמפרטורת החדר. פסי החלבון הודגמו באמצעות תת-מצע chemiluminescent משופר וצולמו במערכת דימוי chemiluminescence באמצעות תוכנת ההפעלה הנלווית (גרסה 1.2.0), כפי שרשום במטא-נתוני התמונה. הפסים כוונתו באמצעות תוכנת ImageJ. חלבון cofilin שימש כביקורת טעינה (loading control), ושפע חלבון MMP1 נורמל ל-cofilin לצורך השוואה בין קבוצות.
ניתוח סטטיסטי ותוכנה
כל הבדיקות היו דו-זנביות אלא אם צוין אחרת. ערך p < 0.05 בתיקון BH שימש כסף הבדיקות המרובות העיקרי. גדלי המדגמים המדויקים השתנו בהתאם למסד הנתונים, ועבור ניתוח ברמת המדגם של תא בודד, בהתאם לנוכחות של סוג תא נתון בכל מדגם. סיכומי ביטוי רציפים מוצגים כתצפיות בודדות עם תרשימי קופסה (boxplots) המציגים את החציון ואת הטווח הבין-רבעוני; השפנים נמתחים עד פי 1.5 מהטווח הבין-רבעוני. עבור western blotting, שישה יחסי MMP1-to-cofilin שחזרו נותחו באמצעות t-test זוגי דו-זנבי על שלושה זוגות חולים שאושרו על ידי המחברים (df = 2; p = 0.0107). עבור qPCR, חמישה ערכי Cq של ACTB וחמישה ערכי Cq של MMP1 חושבו כממוצע בנפרד בתוך כל דגימה לפני חישוב ה-ΔCq. t-test זוגי דו-זנבי השווה בין ערכי ΔCq של DFU לבין ערכי ΔCq תואמים של רקמה מסביב לפצע (periwound) בארבעה זוגות חולים שאושרו על ידי המחברים (df = 3; p = 3.04 × 10⁻⁵). ממוצע ה-ΔCq של הרקמה מסביב לפצע שימש כמכיול המשותף לתצוגת הביטוי היחסי. הממוצע הגיאומטרי של שינוי הקיפול (fold change) בתוך המטופל ורווח הסמך (CI) של 95% שלו התקבלו על ידי טרנספורמציה חוזרת של ממוצע הפרש ה-ΔCq הזוגי ורווח הסמך מבוסס ה-t שלו. תצפיות ביולוגיות בודדות מוצגות עם קווים המחברים רקמות תואמות; בארות טכניות אינן מגדילות את גודל המדגם הביולוגי. ערכי p של בדיקות רקמה הם נומינליים וגששיים. עם שלושה או ארבעה חולים, לא ניתן להעריך באופן מהימן את הנורמליות של ההפרשים הזוגיים, והבדיקות נותרות ראשוניות. ניתוחים ביו-אינפורמטיים ויצירת איורים בוצעו ב-R 4.5.2 על Windows 11. גרסאות חבילות הליבה כללו DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4, ו-ggplot2 4.0.3. רשימה מאוחדת של תוכנות, מאגרי נתונים ופרמטרים מסופקת ב-Supplementary Table 1.
תוצאות
טרנסקריפטומיקה של גילוי מזהה תוכנית ביטוי רחבה הקשורה ל-DFU
GSE199939 שימשה כקוהורט הגילוי וכללה 10 דגימות DFU ו-11 דגימות ביקורת (איור 1A). ניתוח רכיבים ראשיים (PCA) של ביטוי שעבר נרמול VST הראה הפרדה ברורה בין הקבוצות; הרכיבים הראשיים 1 ו-2 הסבירו 34.8% ו-15.1% מהשונות הכוללת, בהתאמה (איור 1B).
באמצעות שימוש ב- |log2 fold change| > 1 ו- BH-adjusted p < 0.05, ניתוח ביטוי דיפרנציאלי זיהה 3,691 DEGs, הכוללים 1,247 גנים בעלי ביטוי מוגבר (upregulated) ב-DFU ו-2,444 גנים בעלי ביטוי מופחת (downregulated) ב-DFU (איור 1C). 50 ה-DEGs המובילים הראו דפוס ביטוי בעל מבנה קבוצתי חזק (איור 1D). מבין ששת הגנים שנבחרו לאחר מכן, MMP1 הראה את השינוי הגדול ביותר בקו הגילוי (log2 fold change = 9.854; adjusted p = 1.24 × 10⁻²⁹).
מודול ביטוי משותף הקשור ל-DFU מתכנס עם DEGs ועם גנים הקשורים ל-DPN
בוצע ניתוח WGCNA על 5,000 הגנים בעלי השונות הגבוהה ביותר לאחר טרנספורמציית VST. עבור הרשת החתומה (signed network) נבחר ערך חזקה לסף רך (soft-thresholding power) של 18, במטרה לאזן בין התאמה לטופולוגיה חסרת קנה מידה (scale-free topology) לבין קישוריות (איור 2A). קיבץ היררכי וזיהוי מודולים דינמי זיהו מספר מודולי ביטוי משותף (איור 2B). למודול הכחול הייתה ההקשר החיובי החזק ביותר עם DFU (Pearson נא לספק את הטקסט באנגלית שברצונך לתרגם. = 0.97, p = 5 × 10-13; איור 2C). סיכומי בקרת איכות תואמים של קיבצי-דגימות (sample-clustering) וגודל מודולים מוצגים ב- איור משלים 1A,B.
בתוך המודול הכחול, 689 גנים עמדו בקריטריונים של גני צומת (hub genes) |MM| > 0.8 ו-|GS| > 0.5 (איור 2D). חיתוך של 3,691 DEGs, 689 גני צומת מהמודול הכחול, ו-1,062 גנים הקשורים ל-DPN הניב 77 גנים מועמדים משותפים (איור 2E). תצוגה מדורדרת (sparsified) של רשת גני הצומת של המודול הכחול והסטטיסטיקות של גני הצומת בעלי הדירוג הגבוה ביותר מוצגות ב-איור משלים 2A,B.
בחירת תכונות מרובת-שיטות מתעדפת שישה גנים אך מראה התאמת-יתר (overfitting) לקוהורט הגילוי
77 הגנים החופפים נותחו באמצעות LASSO, random forest ו-SVM-RFE. שיטת LASSO שמרה על שבעה גנים בענשי המוגדר: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 ו-CHEK1 (איור 3A). סינון באמצעות random-forest שמר על 41 גנים עם רמת חשיבות שווה או גבוהה מהממוצע, כולל חמישה מחברי הפאנל הסופי בין המאפיינים בעלי הדירוג הגבוה ביותר (איור 3B). SVM-RFE הניב AUC של 1.00 עבור כל תת-קבוצה מקוננת שנבדקה; תחת כלל השוויון לגודל המינימלי, CHEK1 נבחר כתת-קבוצה של גן אחד (איור 3C), דבר שעורר חששות לגבי overfitting והערכה אופטימית מדי בקוהורט הגילוי. תצוגות הביטוי, מפת החום (heatmap) ועקומות ROC המתאימות בקוהורט הגילוי מוצגות ב-איור משלים 3A–C.
שום גן לא נבחר על ידי כל שלוש השיטות. השארת גנים הנתמכים על ידי לפחות שתי שיטות הניבה את CCL7, CHEK1, MKI67, MMP1, MMP13 ו-TRPV2 (איור 3D). אנוטציית GO של שישה גנים אלו הדגישה תפקודי פירוק של המטריקס החוץ-תאי, תהליכים קטבוליים ומטבוליים של קולגן, כרומוזום מעובה ותפקודים הקשורים למטלו-אנדופפטידאז (כולם BH-adjusted p < 0.05; איור 3E). ניתוח KEGG זיהה סיגנלינג של אינטרלוקין-17 (IL-17) (CCL7/MMP1/MMP13; adjusted p = 1.81 × 10⁻⁴) וסיגנלינג של רלקסין (MMP1/MMP13; adjusted p = 0.0175; איור 3F). תוצאות העשרה אלו שימשו לאפיון התפקודים הביולוגיים המיוצגים על ידי פאנל ששת הגנים.
הערכה בין-מאגרי נתונים מראה תמיכה הטרוגנית ב-MMP1
במטריצה הממוזגת של GSE68183/GSE80178 (9 DFU ו-6 ביקורות), CCL7, MMP1 ו-MMP13 היו שונים בין הקבוצות לאחר תיקון BH עבור ששת הגנים (adjusted p = 0.0168, 0.0159, ו-0.0431, בהתאמה; איור 4A). CHEK1, MKI67 ו-TRPV2 לא הגיעו לסף המובהקות המתוקן (adjusted p = 0.259, 0.680, ו-0.259). ניתוח ROC של גן בודד הניב ערכי AUC של 0.944 עבור CCL7 (95% CI, 0.825–1.000), 0.704 עבור CHEK1 (0.403–1.000), 0.574 עבור MKI67 (0.243–0.905), 0.981 עבור MMP1 (0.930–1.000), 0.870 עבור MMP13 (0.686–1.000), ו-0.722 עבור TRPV2 (0.447–0.997; איור 4B). ערכי ROC אלו נחשבו כגילויים ראשוניים (exploratory) מכיוון שפרוצדורת המיזוג ותיקון ה-batch שקדמה להם לא תועדה באופן מלא.
ב-GSE134431 (13 דגימות DFU ו-8 דגימות DFS ללא כיב), הביטוי של MMP1 היה גבוה יותר ב-DFU מאשר ב-DFS במבחן Wilcoxon ברמת מובהקות נומינלית (p = 0.0225), למרות שקשר זה לא נותר מובהק לאחר תיקון BH (ערך p מתוקנן = 0.135; איור 4C). חמשת הגנים האחרים לא הראו הבדלים מובהקים בין הקבוצות. MMP1 הראה גם את ה-AUC התיאורי הגבוה ביותר, עם AUC של 0.808 (95% CI, 0.589–1.000), בעוד שערכי ה-AUC של המועמדים האחרים נעו בין 0.529 ל-0.635 (איור 4D). באופן כללי, MMP1 הראה את התבנית התיאורית העקבית ביותר מבין ששת המועמדים, אך השחזור הסטטיסטי היה חלקי.
ניתוח של תאים בודדים מראה כי MMP1 ממוקם בעיקר בפיברובלסטים
סט הנתונים של התא הבודד הכיל 69,944 תאים מ-24 דגימות (14 DFU ו-10 ביקורות) וכלל 10 סוגי תאים מאותננים (איור 5A). ויזואליזציה של מאפיינים באמצעות UMAP מיקמה את ביטוי ה-MMP1 באזורים תאיים מוגבלים במקום להראות ביטוי אחיד על פני האטלס (איור 5B). באופן כללי, ל-3,799 תאים (5.43%) היה ביטוי MMP1 מנורמל הגבוה מאפס. לפיברובלסטים היה הממוצע הגבוה ביותר של ביטוי מנורמל (0.181) והחלקיות הגדולה ביותר של תאים חיוביים ל-MMP1 (7.88%; איור 5C).
ברמת הדגימה, ביטוי MMP1 הממוצע היה גבוה יותר בדגימות DFU מאשר בדגימות ביקורת בתאי קרטינוציטים, פיברובלסטים ותאי אנדותל. לאחר תיקון BH עבור כל סוגי התאים שנבדקו, לכל אחת מההשוואות הללו היה p מתוקנן של 0.0214 (קרטינוציטים: 9 דגימות ביקורת ו-14 דגימות DFU; פיברובלסטים: 10 ו-14; תאי אנדותל: 10 ו-14; איור 5D). חלק התאים החיוביים ל-MMP1 עלה מ-5.86% ל-9.29% בפיברובלסטים, מ-0.026% ל-6.68% בקרטינוציטים, ומ-0.29% ל-2.67% בתאי אנדותל (איור 5E).
המתאמים של ציון המודול לכל תא היו מתונים. המתאם החיובי הגבוה ביותר נצפה עבור ציון המודול של הזקנה/פנוטיפ הפרשה הקשור להזקנה (SASP) (Spearman rho = 0.274), ואחריו עיצוב מחדש של המטריצה החוץ-תאית (rho = 0.240), פרופטוזיס (rho = 0.197), ואקטיבציה של פיברובלסטים (rho = 0.170; איור 5F). השוואה בין פיברובלסטים עם ביטוי גבוה של MMP1 לבין פיברובלסטים עם ביטוי נמוך של MMP1 הראתה העשרה של מונחים הקשורים לארגון המטריצה החוץ-תאית, ארגון מבנה חוץ-תאי, ארגון סיבי קולגן, עיבוד גליקופרוטאינים וקיפול חלבונים (איור 5G). ממצאים תיאוריים אלה קישרו את מצב הפיברובלסט בעל ביטוי MMP1 גבוה לתהליכים הקשורים לעיצוב מחדש של המטריצה. תרשימי UMAP נוספים ברמת קבוצה, סיכומי דגימות של כל סוגי התאים והקשר של ציונים פונקציונליים מופיעים ב-איור משלים 4A–C. קשרים ברמת התא הבודד לא נחשבו כראיות בלתי תלויות בתורם.
כיסוי הרשת מתעדף רכיבים הקשורים ל-MMP1 ועשבי סממנים מועמדים
טבלת קשרי צמח-מרכיב-מטרה המסוננת הכילה 561 רשומות ייחודיות המקשרות בין 99 צמחים, 14 מרכיבים וחמישה מתוך ששת המטרות המועמדות. MMP1 היה המטרה השכיחה ביותר, עם 156 רשומות, ואחריו CHEK1 (120), MMP13 (102), MKI67 (100) ו-TRPV2 (83; איור 6A). מבין המרכיבים, ל-quercetin ול-luteolin היה הכיסוי הרחב ביותר של צמחים, והם היו מקושרים ל-83 ו-62 צמחים, בהתאמה. Berberine היה מקושר ל-10 צמחים; שלושת מרכיבים אלו שימשו כמרכיבי ליבה בכלל התעדוף (איור 6B).
מדד הכיסוי דירג את Guanhuangbo, Mahuang ו-Niuxi במקום הגבוה ביותר במשותף (ניקוד = 38 לכל אחד; איור 6C). כל אחד מהם כיסה את כל חמשת המטרות הזמינות והכיל שני מרכיבים הקשורים ל-MMP1. מטריצת המרכיבים-מטרות הראתה כי quercetin סיפק את הכיסוי הרחב ביותר על פני פאנל המטרות, בעוד ש-luteolin ו-berberine סיפקו קישוריות נוספת הממוקדת ב-MMP1 (איור 6D). רשת ממוקדת קישרה בין הצמחים המובילים למרכיבים מייצגים ולחמש המטרות הזמינות (איור 6E). תוצאות אלו זיהו שילובי צמח-מרכיב-מטרה בעלי כיסוי מסד נתונים גבוה להערכה נוספת. מטריצות כיסוי תומכות של צמח-מטרה ומרכיב-ליבה מוצגות ב-איור משלים 5A,B.
בדיקות ראשוניות של רקמות מזווגות מראות שכיחות גבוהה יותר של mRNA וחלבון MMP1
הערכה בשיטת Western blot הראתה שפעוּל גבוה יותר של MMP1 בדגימות DFU מאשר בדגימות התואמות מהאזור שסביב האולקוס שאינו פתוח (Figure 7A,B). לשלושת הזוגות התואמים היה הפרש ממוצע של DFU פחות periwound ביחס של MMP1/cofilin של 0.3553 (95% CI, 0.1959–0.5147; מבחן t מצומד דו-זנבי, t(2) = 9.592, p = 0.0107). המדידות הזוגיות של כל מטופל מוצגות ב-Figure 7B. לאחר חישוב ממוצע של חמשה בארות טכניות לכל גן לכל דגימה, qPCR הראה שפעוּל נורמליזציה גבוה יותר של mRNA של MMP1 בכל אחת מארבע דגימות ה-DFU מאשר בדגימת ה-periwound התואמת לה (Figure 7C). הפרש ה-ΔCq הממוצע בתוך המטופל בין DFU ל-periwound היה −2.6035 (95% CI, −2.8024 to −2.4046; מבחן t מצומד דו-זנבי, t(3) = −41.663, p = 3.04 × 10⁻⁵), התואם לעלייה של 6.08-מכפלות בממוצע הגיאומטרי (95% CI, 5.30–6.98). תצפיות אלו במדגם קטן הן ראשוניות ואינן מבססות השפעה פונקציונלית.
במעבר בין מערכי הנתונים של הגילוי (discovery) ומערכי הנתונים החיצוניים (external bulk), ל-MMP1 הייתה התבנית התיאורית העקבית ביותר מבין ששת הגנים שתועדפו, אם כי השחזור הסטטיסטי היה חלקי. סיכומים של תאים בודדים (Single-cell) הראו את ממוצע הביטוי הגבוה ביותר בפיברובלסטים, ומדידות WB זוגיות משלושה מטופלים ומדידות qPCR זוגיות מארבעה מטופלים הראו שפע גבוה יותר של MMP1. תצפיות אלו תומכות ב-MMP1 כמועמד הקשור ל-DFU להמשך חקירה. זרימת העבודה הכוללת של ההערכה מהחישוב למרקמה מסוכמת ב-Supplementary Figure 6.
זמינות נתונים:
מאגרי הנתונים הטרנסקריפטומיים הציבוריים זמינים ב-NCBI Gene Expression Omnibus תחת מספרי גישה GSE199939, GSE68183, GSE80178, GSE134431, ו-GSE165816. סקריפטים זמינים לניתוח וליצירת איורים, טבלאות ביטוי ותוצאות מעובדות, טבלאות מקור כמותיות לאיורים, טבלאות פלט סטטיסטי, חוברת העבודה המקורית של ה-qPCR ופרויקט המכשיר, ותמונות western blot לא חתוכות המצורפות כלולים ב-Supplementary File 1. הארכיון מכיל גם מטא-נתונים תאים שחולצו והיסטוריית פקודות מהאובייקט של התא הבודד (single-cell object) ששוחזר, דוחות אימות מסוג מטריצה, ומניפסט קבצים. Supplementary File 1 שומר קבצי מקור היסטוריים וכולל תיקיית R2_Updates המכילה את טבלאות המקור המעודכנות של הבדיקות הזוגיות (paired-assay), פלטי סטטיסטיקה, קוד ליצירת איורים ומלאי פרמטרים מתוקן. קובץ ה-Seurat RDS המנותח במלואו מזוהה בתיעוד הארכיון אך אינו מוטמע בקובץ ה-ZIP הנלווה זה. היסטוריית מיזוג ה-bulk המלאה, הגדרות סינון ואנוטציה מקוריות של תאים בודדים, ופרטי חיסור רקע של ה-blot ופירוט המרת נתיבים לכמות (lane-to-quantification) מקוריים אינם זמינים במלואם; מגבלות אלה מתוארות בפרוטוקול ובדיון. קובץ ה-RDS ששוחזר מקומית לא הופקד במאגר ציבורי.
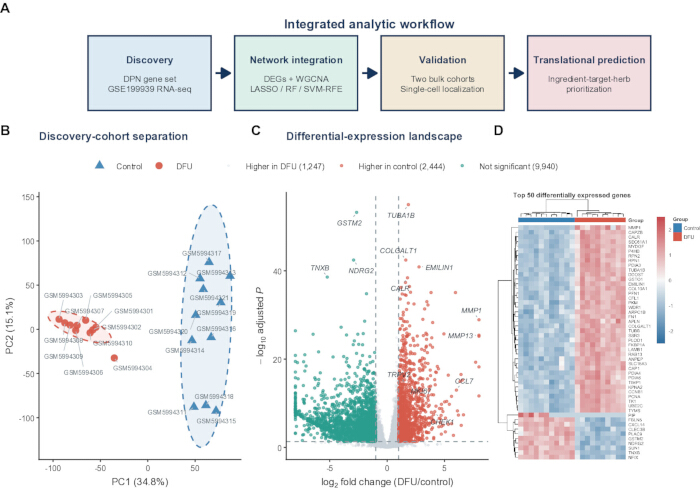
איור 1: טרנסקריפטומיקה של גילוי מזהה תוכנית ביטוי הקשורה ל-DFU. (A) סקירה כללית של זרימת העבודה החישובית, הכוללת בניית סט גנים של DPN וניתוח גילוי של GSE199939, אינטגרציה של רשתים ולמידת מכונה, הערכה של תאים בודדים ובמסות (bulk), וחיזוי רכיב-מטרה-צמח של TCM. (B) ניתוח רכיבים ראשיים (PCA) של פרופילי ביטוי GSE199939 שעברו ייצוב שונות מ-10 דגימות DFU ו-11 דגימות ביקורת. אליפסות מציינות אזורי קבוצה של 90%; אחוזים מציינים את השונות המוסברת על ידי כל רכיב. (C) תרשים געש (Volcano plot) של תוצאות ביטוי דיפרנציאלי ב-DESeq2 עבור DFU לעומת ביקורת. נקודות אדומות וטורקיז מציינות גנים עם ביטוי מוגבר ב-DFU ובביקורת, בהתאמה, תוך שימוש ב-|log2 fold change| > 1 ו-BH-adjusted p < 0.05; נקודות אפורות לא עמדו בשני הספים. (D) מפת חום של z-score לפי שורות עבור 50 הגנים עם ערכי ה-p המתוקננים הנמוכים ביותר. העמודות הן דגימות ביולוגיות ופס האנוטציה מציין את הקבוצה. DEGs, גנים בעלי ביטוי דיפרנציאלי; DFU, כיב רגל סוכרתית; DPN, נוירופתיה פריפרית סוכרתית; VST, טרנספורמציה לייצוב שונות. ההערכה הניסויית הסופית מתוארת בפרוטוקול ובאיור 7. qPCR, תגובת שרשרת פולימראז כמותית; TCM, רפואה סינית מסורתית; RF, יער אקראי; LASSO, מפעיל בחירה וצמצום מוחלט מינימלי; SVM-RFE, סילוק תכונות רקורסיבי של מכונת וקטור תמיכה. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
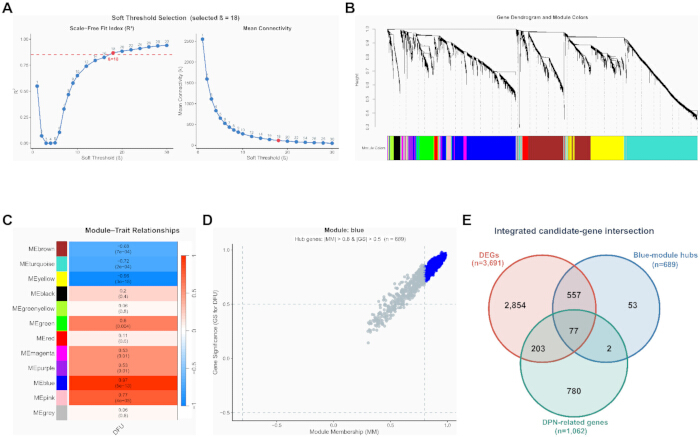
איור 2: WGCNA וידע מוקדם על DPN מתכנסים ל-77 גנים מועמדים. (A) הערכת סף רך (soft-threshold) של רשת חתומה עבור 5,000 הגנים בעלי השונות הגבוהה ביותר שעברו טרנספורמציית VST. החזקה שנבחרה הייתה beta = 18; הקו המקווקו מסמן את התאמה של טופולוגיה ללא קנה מידה (scale-free) ביעד של 0.85. (B) דנדרוגרמה של גנים בשיטת קישור ממוצע (average-linkage) עם הקצאות צבע של מודולים דינמיים. (C) מתאמי פירסון בין eigengenes של מודולים לבין התכונה הבינארית של DFU. כל תא מציג את מקדם המתאם ואת ערך ה-p הדו-צדדי המתאים; הצבע מציין את הכיוון והעוצמה. (D) מובהקות גנים (gene significance) עבור DFU לעומת שיוך למודול (module membership) במודול הכחול. נקודות כחולות מקיימות |module membership| > 0.8 ו-|gene significance| > 0.5; n = 689 גני hub. (E) חיתוך של שלוש קבוצות הכוללות 3,691 DEGs, 689 גני hub של המודול הכחול, ו-1,062 גנים הקשורים ל-DPN, מה שמעניק 77 מועמדים משותפים. DFU, diabetic foot ulcer; DPN, diabetic peripheral neuropathy; GS, gene significance; MM, module membership; WGCNA, weighted gene co-expression network analysis. קבוצת הגילוי הכילה 21 דגימות (10 DFU ו-11 ביקורות). ההערה ב-איור 2D משתמשת ב-|MM| > 0.8 ו-|GS| > 0.5, בהתאם לקריטריון הערך המוחלט שאומת בקוד הבחירה המקורי. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
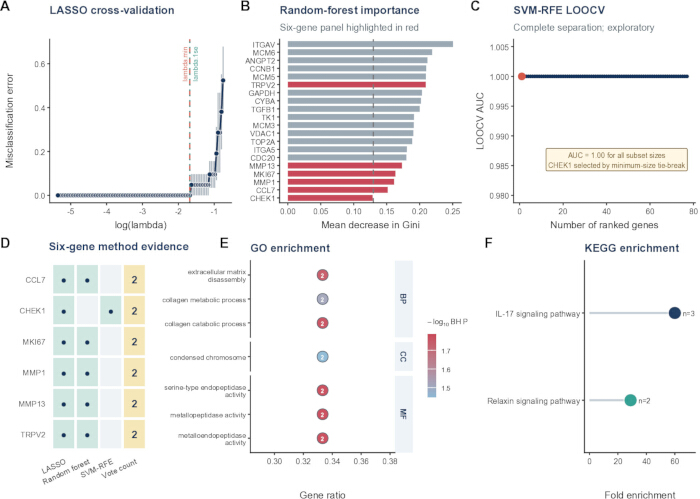
איור 3: תיעדוף מאפיינים באמצעות מספר שיטות מניב פאנל של שישה גנים. (A) עקומת תיקוף צולב של חמישה קיפולים (Five-fold cross-validation) עבור רגרסיית binomial LASSO. קווים מקווקווים אנכיים מציינים את lambda.min ו-lambda.1se; המאפיינים שנבחרו שאינם אפס נלקחו ב-lambda.1se, אלא אם כן קנס זה לא הניב אף מאפיין. (B) ירידה ממוצעת במדד ג'יני (mean decrease in Gini) של Random-forest עבור 20 הגנים בעלי הדירוג הגבוה ביותר ממודל של 1,000 עצים. פסים אדומים מזהים את חברי הפאנל הסופי של ששת הגנים; הקו המקווקו מסמן את החשיבות הממוצעת ששימשה כסף השמירה עבור כל קבוצת המועמדים. (C) AUC של Linear SVM-RFE LOOCV על פני תתי-קבוצות מקננות של מאפיינים. כל גדלי תתי-הקבוצות הניבו AUC = 1.00; הגן CHEK1 נבחר על פי כלל השוויון בגודל המינימלי, דבר המצביע על overfitting בקוהורט הגילוי. (D) מטריצת תמיכת שיטות עבור CCL7, CHEK1, MKI67, MMP1, MMP13, ו-TRPV2. נקודות מציינות בחירה על ידי LASSO, random forest או SVM-RFE; העמודה האחרונה מציגה את מספר השיטות התומכות. (E) מונחי Gene Ontology נבחרים המועשרים בקרב ששת הגנים. מיקום הנקודה מראה את יחס הגנים, תוויות הנקודות מראות את מספר הגנים שמופו, הצבע מראה את -log10 של p מותאם BH, והפס הצדדי מציין את האונטולוגיה. (F) מסלולי KEGG המועשרים בקרב הגנים שמופו. מיקום הנקודה מראה את פי ההעשרה (fold enrichment), תוויות גודל הנקודה מראות את מספר הגנים שמופו, והצבע מבדיל בין המסלולים. העשרה דרשה p נומינלי < 0.05 ו-p מותאם BH < 0.05. AUC, שטח תחת עקומת מאפייני תפעול המקלט; BH, Benjamini-Hochberg; BP, תהליך ביולוגי; CC, רכיב תאי; KEGG, Kyoto Encyclopedia of Genes and Genomes; LOOCV, תיקוף צולב של השארת אחד בחוץ; MF, תפקוד מולקולרי; SVM-RFE, סילוק מאפיינים רקורסיבי של מכונת וקטורים תומכים. LASSO, מפעיל הבחירה והכיווץ המוחלט המינימלי. פאנלים A–D משתמשים ב-21 דגימות הגילוי (10 DFU ו-11 ביקורות). בפאנל A, פסי השגיאה מציינים את השגיאה הסטנדרטית של שגיאת התיקוף הצולב. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
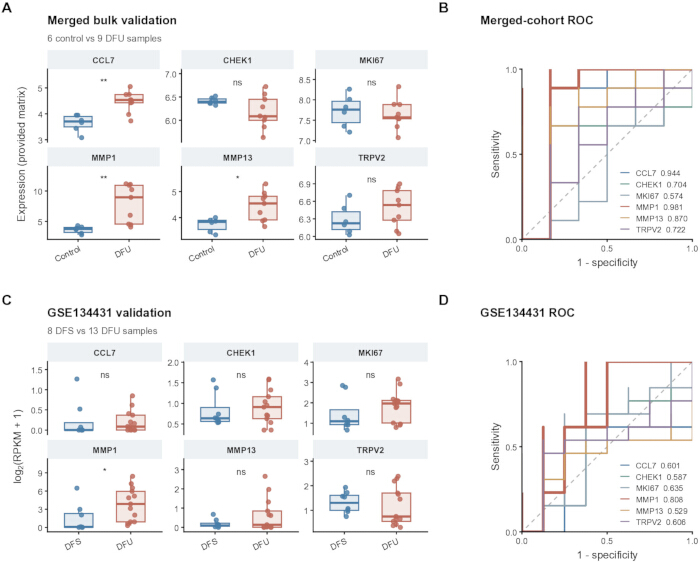
איור 4: הערכה טרנסקריפטומית של ה-bulk על פני מספר מאגרי נתונים עבור פאנל ששת הגנים. (A) ביטוי של ששת הגנים במטריצה המאוחדת של GSE68183/GSE80178 (6 ביקורות ו-9 דגימות DFU). (B) עקומות ROC תואמות עבור גן בודד עם ערכי AUC; רווחי סמך של 95% מופיעים בטבלת נתוני המקור. מכיוון שהאיחוד המוקדם ותיקון האפקט של הסבבה (batch correction) לא תועדו באופן מלא, תוצאות אלו פורשו כexploratory. (C) ביטוי log2(RPKM + 1) ב-GSE134431 (8 דגימות DFS לא כיבתיות ו-13 דגימות DFU). (D) עקומות ROC תואמות וערכי AUC עבור גן בודד. ב-(A) וב-(C), התיבות מראות את החציון ואת הטווח הבין-רבעוני, השפיצים נמתחים עד ל-1.5 מהטווח הבין-רבעוני, והנקודות מייצגות דגימות ביולוגיות. כוכביות מציינות מובהקות נומינלית ממבחני Wilcoxon rank-sum דו-זנביים (*p < 0.05, **p < 0.01); ערכי p מותאמי BH עבור ששת הגנים מדווחים בטקסט ובטבלת נתוני המקור. כיוון ה-ROC נבחר באופן אוטומטי על ידי pROC. AUC, השטח תחת עקומת מאפייני המקלט; DFS, עור כף רגל סוכרתית ללא כיב; DFU, כיב כף רגל סוכרתית; RPKM, קריאות לכל קילו-בסיס לכל מיליון קריאות ממופות; ROC, מאפייני מקלט. אנא לחץ כאן להצגת גרסה גדולה יותר של איור זה.
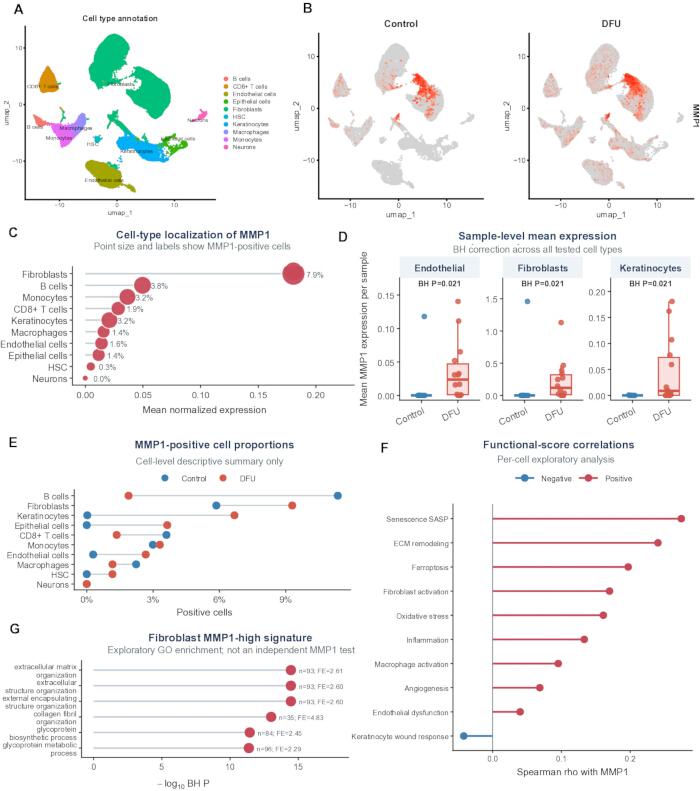
איור 5: לוקליזציה ברמת התא הבודד מקשרת את MMP1 לאותות של פיברובלסטים ועיצוב מחדש של המטריצה. (A) UMAP של 69,944 תאים מ-24 דגימות (10 ביקורות ו-14 דגימות DFU), צבועים לפי 10 סוגי תאים שהוגדרו באמצעות SingleR. (B) תרשימי מאפיינים של UMAP המראים ביטוי נורמלי של MMP1 בתאי ביקורת ובתאי DFU. (C) סיכום לפי סוג תא של ביטוי MMP1 נורמלי ממוצע; גודל הנקודות והתוויות מציינים את החלק הכולל של התאים החיוביים ל-MMP1, המוגדר כביטוי נורמלי > 0. (D) ביטוי MMP1 ממוצע ברמת הדגימה בתאי אנדותל, פיברובלסטים וקרטינוציטים. התיבות מראים את החציון ואת הטווח הבינקוורטילי; הנקודות הן דגימות ביולוגיות. מבחני Wilcoxon rank-sum דו-צדדיים בוצעו ואחריהם תיקון BH עבור כל סוגי התאים שנבדקו. מספר הדגימות הזמינות היה 10 ביקורות ו-14 DFU עבור תאי אנדותל ופיברובלסטים, ו-9 ביקורות ו-14 DFU עבור קרטינוציטים. (E) חלקי תאים חיוביים ל-MMP1 לפי קבוצה וסוג תא. (F) מתאמי Spearman לכל תא בין ביטוי MMP1 לבין ציוני מודולים פונקציונליים. (G) העשרה של תהליכים ביולוגיים ב-GO בקרב גנים בעלי ביטוי מוגבר בפיברובלסטים עם MMP1 גבוה לעומת MMP1 נמוך. BH, Benjamini-Hochberg; DFU, diabetic foot ulcer; ECM, extracellular matrix; GO, Gene Ontology; HSC, hematopoietic stem cells; UMAP, uniform manifold approximation and projection. מתאמי התאים וההעשרה המותנית בביטוי בפאנלים F ו-G הם תיאורים גששיים, ללא הסקה מאששת המביאה בחשבון את התורמים. עצמאות ברמת הדגימה דורשת אימות של מזהי התורמים. אנא לחצו כאן כדי לצפות בגרסה גדולה יותר של איור זה.
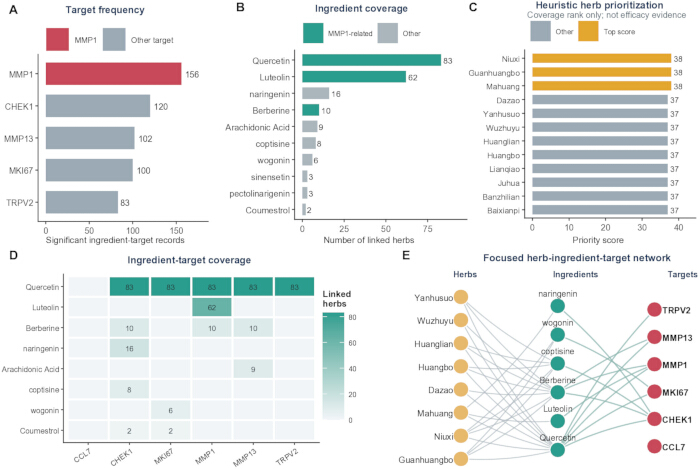
איור 6: חיזוי רכיב-מטרה-צמח ב-TCM מבוסס כיסוי הממוקד ב-MMP1. (A) מספר רשומות צמח-רכיב-מטרה מסוננות ממאגר הנתונים עבור כל מטרה מועמדת זמינה. (B) מספר הצמחים המקושרים לרכיבים השכיחים ביותר; צבע טורקיז מציין רכיבים המקושרים ל-MMP1. (C) צמחים מובילים המדורגים לפי מדד הכיסוי; פסים בצבע זהב מסמנים את שלושת הציונים הגבוהים ביותר. (D) מטריצת רכיב-מטרה עבור רכיבים נבחרים בעלי כיסוי גבוה. ערכי התאים מראים את מספר הצמחים המקושרים; תאים ריקים מציינים היעדר רשומה בטבלת היחסים המסוננת. (E) רשת ממוקדת המחברת בין צמחים, רכיבים ומטרות מועמדות נבחרות בעלות דירוג גבוה. צבע הצומת מציין את סוג הישות; קשתות אפורות בין צמח לרכיב מציינות הכלה, וקשתות טורקיז בין רכיב למטרה מציינות קישורים במאגר הנתונים. טבלת היחסים המסוננת הכילה 561 רשומות ייחודיות, 99 צמחים, 14 רכיבים וחמש מטרות עם קישורים מתאימים; CCL7 מוצג כצומת מועמד שישי מבודד. TCM, רפואה סינית מסורתית. אנא לחץ כאן כדי להציג גרסה גדולה יותר של איור זה.
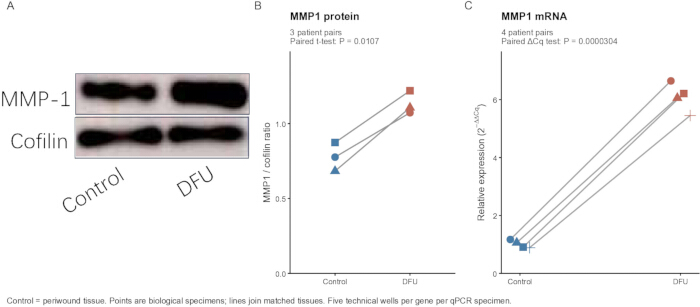
איור 7: הערכה ראשונית של ביטוי MMP1 ברקמות חולים באמצעות qPCR ו-western blot ב-DFU. (A) western blot מייצג שסופק בעבר, המראה את שפע חלבון MMP1 ברקמת periwound שאינה כיבית וברקמת DFU, כאשר cofilin שימש כבקרת טעינה. (B) יחסי MMP1-to-cofilin שהופקו מפרויקט שרטוט המקור. הסמלים מראים מדידות ביולוגיות בודדות משלושה זוגות חולים; קווים מחברים דגימות תואמות של periwound ו-DFU. מבחן t-test זוגי דו-זנבי הניב t(2) = 9.592 ו- p = 0.0107. (C) שפע יחסי של MMP1 mRNA בארבעה זוגות חולים תואמים שאושרו על ידי המחברים: NC–DFU, NC1–DFU1, NC2–DFU2, ו-NC3–DFU3. חמישה בארות טכניות של ACTB וחמישה בארות טכניות של MMP1 חושבו כממוצע בנפרד בתוך כל דגימה לפני חישוב ה-ΔCq. ביטוי יחסי חושב בשיטת 2−ΔΔCq תוך שימוש ב-ΔCq הממוצע של periwound ככיול משותף. כל סמל מייצג דגימה ביולוגית אחת; קווים מחברים רקמות תואמות. מבחן t-test זוגי דו-זנבי השתמש בערכי ΔCq ברמת הדגימה (t(3) = −41.663; p = 3.04 × 10⁻⁵), ולא בשינויי קיפול (fold changes) של בארות טכניות. לא נעשה שימוש בכוכבי מובהקות. בארות טכניות אינן חזרות ביולוגיות. Control מציין רקמת periwound שאינה כיבית. Cq, מחזור כימות. ערכי p של בדיקת הרקמה הם נומינליים וחקוריים. אנא לחץ כאן כדי לצפות בגרסה גדולה יותר של איור זה.
| גן | מספר גישה של RefSeq | פריימר קדמי 5' ל-3' | פריימר הפוך מקצה 5' לקצה 3' |
| MMP1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
טבלה 1: רצפי פריימרים לתיקוף של MMP1 באמצעות PCR כמותי. רצפי אוליגוניוקלאוטידים קדמיים ואחוריים (5′–3′) ומספרי גישה של NCBI RefSeq לטרנסקריפטים מוצגים עבור MMP1 (NM_002421) ו-ACTB (NM_001101.5) אנושיים. ACTB (β-actin) שימש כגן הייחוס עבור ביטוי יחסי של MMP1.
איור משלים 1: סיכומי בקרת איכות של WGCNA. (A) קיבץ היררכי בשיטת Average-linkage של דגימות מ-GSE199939 בהתבסס על 5,000 הגנים בעלי השונות הגבוהה ביותר שעברו ייצוב שונות. תוויות הדגימות צבועות לפי קבוצה; הקו האופקי המקווקו הוא מדריך גובה הדנדרוגרמה באחוזון ה-95 ששימש להערכה חזותית של חריגים. (B) מספר הגנים שהוקצו לכל מודול WGCNA. פסים בצבע טורקיז מציינים את שמונת המודולים שאינם אפורים שעומדים בקריטריון הקישור ל-DFU; פסים אפורים מציינים מודולים אחרים. DFU, כיב רגל סוכרתית; VST, variance-stabilizing transformation; WGCNA, weighted gene co-expression network analysis. אנא לחץ כאן להורדת קובץ זה.
איור משלים 2: תמיכה בקו-אקספרסיה של המודול הכחול. (A) רשת קו-אקספרסיה מפוספסת של 25 גני ה-hub בעלי הדירוג הגבוה ביותר במודול הכחול. מבין מתאמי הזוגות עם |r| > 0.70, הרשת המוצגת מכילה את האיחוד של שני הקישורים החזקים ביותר של כל גן. גודל הצומת מציין את הדרגה בתוך רשת זו, המופשטת ומוצגת, ומילוי הצומת מציין את המובהקות הגנטית (gene significance) עבור DFU. (B) מובהקות גנטית וחברות במודול הכחול עבור 15 גני ה-hub בעלי הדירוג הגבוה ביותר. תת-קבוצת הקשתות נבחרה לצורך קריאות ואינה מייצגת את כל המתאמים העומדים בקריטריונים. DFU, diabetic foot ulcer; GS, gene significance; MM, module membership. אנא לחץ כאן כדי להוריד קובץ זה.
איור משלים 3: תצוגות למידת מכונה של קוהורט הגילוי הפנימי. (A) ביטוי רשמי (scaled expression) של CCL7, CHEK1, MKI67, MMP1, MMP13, ו-TRPV2 בקוהורט הגילוי GSE199939. התיבות מראות את החציון ואת הטווח הבינקוורטילי, והנקודות מייצגות דגימות ביולוגיות. (B) מפת חום (heatmap) של row-z-score ברמת הדגימה עבור אותם שישה גנים. תוויות דגימה קצרות ממופות למזהי GEO במפתח נתוני המקור. (C) עקום ROC של מודל רב-גני מותאם עבור קוהורט הגילוי. ערך AUC של 1.00 התקבל על ידי התאמה והערכה של המודל על אותן 21 דגימות, דבר המעיד על התאמת יתר (overfitting) בקוהורט הגילוי. AUC, השטח תחת עקום מאפייני תפעול המקלט; ROC, מאפייני תפעול המקלט. קוהורט הגילוי הכיל 21 דגימות (10 DFU ו-11 ביקורות). אנא לחץ כאן להורדת קובץ זה.
איור משלים 4: הקשר ביטוי של תא בודד. (A) UMAP של 69,944 תאים הצבועים לפי קבוצת ביקורת וקבוצת DFU. (B) ממוצע ביטוי של MMP1 ברמת דגימה ביולוגית על פני כל 10 סוגי התאים המסווגים; הנקודות מייצגות דגימות, וציר ה-x משתמש בטרנספורמציית שורש ריבועי לצורך התצוגה. (C) מפת חום (Heatmap) של ציוני מודולים פונקציונליים שסוכמו על פני תאים בתוך כל סוג תא מסווג וסטנדרטיזו בתוך כל מודול. DFU, כיב פסוריאזי/סוכרתי בכף הרגל; UMAP, קירוב ומקרב רבגלי אחיד. אנא לחצו כאן להורדת קובץ זה.
איור משלים 5: מטריצות כיסוי תומכות של TCM. (A) ספירות רשומות של צמחים ומטרות במסד הנתונים עבור 18 הצמחים בעלי הדירוג הגבוה ביותר עם כיסוי הקשור ל-MMP1, וחמש המטרות המועמדות המיוצגות בטבלת הקשרים המסוננת. (B) ספירות רשומות במסד הנתונים המקשרות בין אותם צמחים למרכיבי הליבה quercetin, luteolin ו-berberine. ערכי התאים מציינים רשומות ייחודיות במסד הנתונים לאחר הסרת כפילויות. TCM, רפואה סינית מסורתית. אנא לחץ כאן כדי להוריד קובץ זה.
איור משלים 6: זרימת העבודה להערכה חישובית ורקמתית. הסכימה מסכמת את קלט הגילוי, חיתוך DEG/WGCNA, בחירת מאפיינים גישושית, הערכה חיצונית של bulk, הקשר של תא בודד, הרחבת TCM והערכה תואמת של ביטוי ברקמה. ב-qPCR נעשה שימוש בארבעה זוגות חולים תואמים וב-western blotting נעשה שימוש בשלושה זוגות חולים תואמים. מספר המועמדים והתוצאות החישוביות המדווחות נשמרו מהניתוח המקורי. קלט TPM בזרימת העבודה של הגילוי המבוסס על ספירה, רשומות עיבוד מקדמי לא מלאות של תאים בודדים ומאוכלוסיות קטנות של בדיקות רקמה נותרים כמגבלות. הסכימה אינה מרמזת כי ניתוחי הגילוי תוקפו מחדש. אנא לחץ כאן להורדת קובץ זה.
טבלה משלימה 1: רשימת מלאי של תוכנות ניתוח, מאגרי נתונים, פרמטרים ומגבלות. חוברת עבודה זו מתעדת 26 שלבי ניתוח, הכוללים את שלב הניתוח, הכלי או מאגר הנתונים, הגרסה המדווחת, הקלט, הפרמטרים המרכזיים, הפלט ומידע חסר או מגבלות. היא מכסה טרנסקריפטומיקה של גילוי, WGCNA, סריקת גנים ובחירת מאפיינים, העשרה, ניתוחים חיצוניים של תאי בודדים ושל דגימות מאסיביות (bulk), ניתוח רשתות של TCM ודיווח על בדיקות רקמה. הטבלה מתעדת את המידע המתודולוגי הזמין ואינה מהווה כשלעצמה הוכחה לשחזוריות עצמאית. אנא לחצו כאן להורדת קובץ זה.
קובץ משלים 1: ארכיון נתונים, קוד ניתוח, מקורות איורים ומקורות בדיקות. ארכיון זה מכיל סקריפטים זמינים לניתוח וליצירת איורים, טבלאות תוצאות וביטוי מעובדות, איורים כמותיים ונתוני מקור סטטיסטיים, את חוברת העבודה המקורית של ה-qPCR ואת פרויקט המכשיר, תמונות Western blot לא חתוכות שסופקו, מטא-דאטה של תאים בודדים והיסטוריית פקודות שחולצו, דוחות אימות מסוג מטריצה ורשימת קבצים. קבצים היסטוריים נשמרו; תיקיית R2_Updates מספקת את ניתוח הבדיקות הזוגיות המתוקן, מקורות איורים מעודכנים ומלאי פרמטרים ששונה. אנא לחצו כאן להורדת קובץ זה.
דיון
תהליך עבודה אינטגרטיבי זה תיעד עדיפות ל-MMP1 על בסיס טרנסקריפטומיקה של תאי bulk, WGCNA, סריקת גנים הקשורים ל-DPN ובחירת מאפיינים גישושית, ולאחר מכן בחן את ההקשר התאי ואת הביטוי הרקמתי שלו. שישה גנים נתמכו על ידי לפחות שתי שיטות בחירה, ו-MMP1 הראה את השינוי הגדול ביותר בביטוי בקוהורט הגילוי. ראיות חיצוניות היו הטרוגניות: MMP1 נשאר מובהק במטריצה הממוזגת של GSE68183/GSE80178, בעוד שהקשר שלו ב-GSE134431 היה נומינלי (p = 0.0225) ולא שרד את תיקון BH (p מתוקנן = 0.135). ה-AUC של 0.808 ב-GSE134431 הוא תיאורי, במיוחד משום שכיוון ה-ROC נבחר בתוך מערך הנתונים להערכה. בהתאם לכך, המונח "עקבי ביותר" מתאר את הדפוס שנצפה בין ששת המועמדים ואינו מרמז על שחזור סטטיסטי מלא או על סמן ביולוגי אבחנתי מתוקף.
פאנל המועמדים סווג תחת תחלופה של קולגן, פירוק ה-ECM, פעילות של metalloendopeptidase, ואותות של IL-17 ו-relaxin. סיווגים אלה תואמים לביולוגיה של פצעים כרוניים אך כוללים רק מספר קטן של גנים. מחקרים קודמים בבני אדם דיווחו על פרופילים משתנים של MMP ומעכבים בפצעים סוכרתיים6, בעוד שמחקר פרוספקטיבי על DFU קישר יחס גבוה יותר של MMP1 למעכב רקמתי של מטאלופרוטאינאזות 1 (TIMP1) לריפוי7. לפיכך, ביטוי מוגבר של MMP1 אינו חייב להצביע על השפעה מזיקה באופן אחיד; הרלוונטיות שלו עשויה להיות תלויה בשלב התיקון, בזמינות הסובסטרט ובמאזן המעכבים. תצפיות ניסיוניות בנוגע ל-MMP13, CCL7 ו-IL-17 מספקות הקשר נוסף11,12,13,14, אך לא ניתן להניח שתפקודיהם שקולים ב-DFU אנושי.
סיכומי תאים בודדים מיקמו את ממוצע הביטוי הגבוה ביותר של MMP1 בפיברובלסטים, כאשר נצפה ביטוי גבוה יותר ברמת הדגימה בפיברובלסטים, קרטינוציטים ותאי אנדותל מ-DFU. דפוס זה תואם לדיווחים על ארגון משתנה של ה-ECM בפיברובלסטים המופקים מ-DFU4, מצבי פיברובלסטים הטרוגניים במחקרי תאים בודדים ומחקרים מרחביים8, ותוכניות של פיברובלסטים מעוררי ריפוי הקשורים למקרופאגים15. עם זאת, מזהי הדגימות דורשים אימות ברמת התורם, ומתאמי ציון-מודול ברמת התא והעשרה מותנית בביטוי נותרים תיאוריים כיוון שתלות בתוך התורם לא מודלה. תרומות מאוכלוסיות אפיתליאליות ואנדותליאליות מצביעות אף הן נגד מנגנון אוטונומי של פיברובלסטים בלבד. טרנסקריפטומיקה מרחבית, היברידיזציית RNA in situ, או צביעה אימונוהיסטוכימית יעניקו מיקום משלים16.
הערך המתודולוגי טמון בשילוב של ביטוי דיפרנציאלי, ביטוי משותף (co-expression), ידע גנטי מוקדם, סיכומים ברזולוציית תא ואמצעי בדיקה עצמאיים כדי לתעדף מועמדים. הוא אינו טמון בדיוק החיזוי של קבוצת הגילוי. סריקה של כלל הקבוצהקדמה לאימות צולב ברמת האלגוריתם, וערך ה-AUC אחיד של 1.00 עבור SVM-RFE מעלה חששות לגבי זליגה (leakage), התאמת יתר (overfitting) והערכה אופטימית מדי. לכן, הפאנל צריך להישאר כתוצאה של תיעדוף מאפיינים. לצורך הערכה ניבויית, יידרשו שלבי עיבוד מקדימים, בחירה וכיוונון מקוננים באופן מלא, ולאחריהם בדיקה עצמאית נעולה9,10. קלט הגילוי אומת כ-TPM למרות השימוש בו במודל מבוסס ספירות (count-based); לפיכך, הסטטיסטיקות של הגילוי והבחירה העוקבת נותרות לא מאומתות עד לביצוע ניתוח חוזר מתאים. למטריצת ה-bulk הממוזגת חסר היסטוריית העיבוד המקדימי המלאה שלה. אובייקט ה-Seurat המשוחזר מספק הגדרות של נורמליזציה, בחירת מאפיינים משתנים, PCA, שכנים, מקבץ (clustering) ו-UMAP, אם כי הסינון המקורי, קריאת ה-Harmony המלאה ורפרנס האנוטציה נותרים מתועדים באופן חלקי. עיבוד מחדש הרמוני מנתוני המקור, הערכת אפקט-אצווה (batch-effect) מתועדת, וניתוחי pseudobulk מודעי-תורם או מודלים מעורבים (mixed-model) הם גישות חלופיות להערכה נוספת.
בדיקות של רקמת מטופלים מספקות ראיות אורתוגונליות ראשוניות לשפע גבוה יותר של MMP1. קבוצת ההשוואה הייתה רקמה שאינה פצעית מהסביבה המיידית של הפצע מאותם מטופלים, כך שהניגוד משקף הבדלים מקומיים הקשורים לפצע בתוך רקמה סוכרתית ולא השוואה לעור בריא. מדידות WB שהושגו משלושה זוגות מטופלים תואמים ומדידות qPCR מארבעה זוגות תואמים שאושרו על ידי המחברים נותחו באמצעות מבחנים מזווגים, כאשר התצפיות הביולוגיות האישיות מוצגות. עבור qPCR, נעשה ממוצע של בארות טכניות בתוך כל דגימה וההסקה התבססה על ΔCq; הבארות הטכניות לא הגדילו את גודל המדגם הביולוגי. הכיוון העקבי של התצפיות המזווגות תומך בהשוואת ביטוי ראשונית, אך הקוהורטות הקטנות אינן יכולות לבסס הכללה או להעריך באופן מהימן הנחות התפלגותיות. שפע ברקמה כוללת (Bulk-tissue) אינו מבסס לוקליזציה תאית של חלבונים, פעילות אנזימטית או השפעה סיבתית על ריפוי. נדרשות קוהורטות גדולות יותר המאופיינות קלינית. מגבלות נוספות כוללות משתנים קליניים (covariates) חסרים, רקמות השוואה שונות, סט גנים של DPN מהספרות שאינו מתועד במלואו, ורישומים חסרים של חיסור רקע מהבלאטים המקוריים. אין להתייחס לרקמה בריאה, לרקמת ביקורת המוגדרת במחקר ולעור כף רגל סוכרתית שאינו פצעי כניתנים להחלפה.
רשת ה-TCM היא הרחבה ליצירת היפותזות. המשקולות המותאמות שלה מסכמות את כיסוי מסד הנתונים ולא את המעורבות במטרה או את היעילות, והדירוגים עשויים להשתנות בהתאם לתוכן מסד הנתונים ולבחירת המשקולות. ל-Quercetin ול-berberine יש גם חשיפה סיסטמית משתנה או מוגבלת17,18. לכן, רכיבים ועשבים מועמדים דורשים בדיקות ישירות של המטרה, תגובת מינון, פרמקוקינטיקה, רעילות ובדיקות תפקודיות. עבודות עתידיות צריכות לשלב קהלים עצמאיים מתועדים היטב עם לוקליזציה מרחבית והפרעה ל-MMP1 בפיברובלסטים ראשוניים או במודלים רב-תאיים של פצעים. הממצאים הנוכחיים תומכים ב-MMP1 כמועמד הקשור ל-DFU בהקשר של עיצוב מחדש של המטריקס הממוקד בפיברובלסטים, מבלי לבסס סיבתיות או תועלת קלינית.
גילויים
המחברים מצהירים כי אין ניגודי עניינים.
תודות
מחקר זה נתמך על ידי פרויקט המחקר המדעי הרפואי של עיריית ווהאן (פרויקט הנחיה, מענק מס' WX23Z77), המנוהל על ידי ועדת הבריאות של עיריית ווהאן.
המחברים מודים למשתתפים שסיפקו דגימות רקמה למחקר זה ולחוקרים שיצרו והפקידו את מערכי הנתונים הזמינים לציבור ב-NCBI Gene Expression Omnibus.
חומרים
| שם | חברה | מספר קטלוג | הערות |
|---|---|---|---|
| פסים של 8 מבחנות PCR שקופות בעלות דופן דקה, 0.2-mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| טיפים סטריליים למסננת פיפט, 1,000-μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| מבחנות מיקרוצנטריפוגה סטריליות, 1.5-mL, נקיות מ-DNase/RNase | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| טיפים סטריליים למסננת פיפט, 10-μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× SYBR Green PCR Mastermix | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| 20× Tris-buffered saline | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| טיפים סטריליים למסננת פיפט, 200-μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| זוג פריימרים ל-qPCR עבור ACTB | Solarbio Life Sciences (סינתזת אוליגנוקלאוטידים בהתאמה אישית) | Custom | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Sweden | Amersham Imager 600 | דגם רשום בכל 22 קובצי ה-TIFF שסופקו; גרסת תוכנת הפעלה 1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| ערכה לבדיקת חלבונים באמצעות חומצה ביצינכונינית (BCA) | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | גרסה 4.16.0 |
| נוגדן פוליקלונלי ל-Cofilin (rabbit anti-Cofilin) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | דילול WB ששימש במחקר זה: 1:6,000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | משאב רכיב-מטרה |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | גרסה 1.48.2 |
| מים נקיים מ-DNase/RNase | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / e1071 authors | https://cran.r-project.org/package=e1071 | גרסה 1.7-17 |
| מצע כימילומנצנטי ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | GO |
| ggplot2 | ggplot2 developers | https://ggplot2.tidyverse.org/ | גרסה 4.0.3 |
| glmnet | CRAN / glmnet authors | https://cran.r-project.org/package=glmnet | גרסה 5.0 |
| טבלת ייחוס צמחי-מרכיב | מקור לא דווח במאמר | לא דווח | לא מתועד: שם מסד נתונים/קובץ מדויק, גרסה/תאריך וכתובת URL לגישה ציבורית |
| נוגדן עז anti-rabbit IgG (H+L) מצומד ל-HRP | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | דילול WB ששימש במחקר זה: 1:5,000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| דגימות רקמה של כיב רגל סוכרתי אנושי | Wuhan Fourth Hospital, Wuhan, China | N/A | דגימות DFU תואמות למטופל; qPCR n=4 דגימות; WB n=3 דגימות; פרוטוקול מאושר KY2024-161-01 |
| דגימות רקמה אנושית לא כיבתית מסביב לפצע | Wuhan Fourth Hospital, Wuhan, China | N/A | ביקורת רקמה מסביב לפצע תואמת למטופל; qPCR n=4 דגימות; WB n=3 דגימות; פרוטוקול מאושר KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | גרסה לא מתועדת |
| Kyoto Encyclopedia of Genes and Genomes | KEGG | https://www.genome.jp/kegg/ | קוד אורגניזם אנושי hsa |
| רשימת גנים DPN שנאספה מהספרות | מרכיב מבוסס ספרות; טבלת מקור ברמת הגן לא תועדה במלואה | לא דווח | מקור ברמת הגן לא תועד במלואו |
| ספקטרופוטומטר UV-visible לנפח קטן | יצרן/דגם לא דווח במאמר | לא דווח | לא מתועד: יצרן מדויק, דגם וכתובת URL של המוצר; שימוש מדווח: הערכת ריכוז RNA ויחס A260/A280 |
| נוגדן פוליקלונלי ל-MMP1 (rabbit anti-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | דילול WB ששימש במחקר זה: 1:1,000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| זוג פריימרים ל-qPCR עבור MMP1 | Solarbio Life Sciences (סינתזת אוליגנוקלאוטידים בהתאמה אישית) | Custom | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | מסד נתוני גנים אנושיים |
| חלב רזה מיובש, רכיב חסימה | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | גרסה 3.21.0 |
| ג'ל SDS-PAGE מוכן מראש, גרדיאנט 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / pROC authors | https://cran.r-project.org/package=pROC | גרסה 1.19.0.1 |
| תערובת מעכבי פרוטאז, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| מערכת להעברת חלבונים | יצרן/דגם לא דווח במאמר | לא דווח | לא מתועד: יצרן מדויק, דגם וכתובת URL של המוצר; שימוש מדווח: העברה לממברנת PVDF בסינון של 0.22-μm |
| ממברנת PVDF, 0.22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | גרסה 4.5.2 |
| randomForest | CRAN / randomForest authors | https://cran.r-project.org/package=randomForest | גרסה 4.7-1.2 |
| מכשיר PCR בזמן אמת | Roche Diagnostics | LightCycler 96 | גרסת תוכנה לא אושרה. נפח הפרויקט/מחזורים שונה מהפרוטוקול המדווח; הקשר מדויק לניסוי טרם נבדק. |
| מיקרוצנטריפוגה מקוררת | יצרן/דגם לא דווח במאמר | לא דווח | לא מתועד: יצרן מדויק, דגם וכתובת URL של המוצר; שימוש מדווח: 12,000 × g למשך 15 דקות ב-4 °C |
| rentrez | CRAN / rentrez authors | https://cran.r-project.org/package=rentrez | גרסה 1.2.4 |
| בופר ליזיס RIPA, חוזק גבוה | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| מערכת אלקטרופורזה SDS-PAGE | יצרן/דגם לא דווח במאמר | לא דווח | לא מתועד: יצרן מדויק, דגם וכתובת URL של המוצר; שימוש מדווח: הפרדת חלבונים על ג'לים בגרדיאנט של 4%–20% |
| Seurat | Satija Lab / Seurat developers | https://satijalab.org/seurat/ | גרסה 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | גרסה 2.10.0 |
| הומוגניזטור לרקמות | יצרן/דגם לא דווח במאמר | לא דווח | לא מתועד: יצרן מדויק, דגם וכתובת URL של המוצר; שימוש מדווח: הומוגניזציה של רקמה בבופר ליזיס קר מאוד |
| TriQuick Reagent רכיב להפקת RNA כולל | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| מכסיים שטוחים ושקופים במיוחד לפסי מבחנות PCR בנפח 0.2-mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| ערכה אוניברסלית ל-RT-PCR (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / WGCNA authors | https://cran.r-project.org/package=WGCNA | גרסה 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
מקורות
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.