Questo protocollo descrive un apprendimento e memoria di Drosophila chiamato condizionamento di corteggiamento. Questo saggio classico si basa su una riduzione del comportamento maschile di corteggiamento dopo il rifiuto sessuale da parte di una femmina prematurata non ricettiva. Questa forma naturale di plasticità comportamentale può essere usata per testare l'apprendimento, la memoria a breve termine e la memoria a lungo termine.
Articolo metodologico
Condizionamento del corteggiamento di Drosophila come misura dell'apprendimento e della memoria
In questo articolo
Sommario
Abstract
Molti approfondimenti sui meccanismi molecolari che sono alla base dell'apprendimento e della memoria sono stati spiegati attraverso l'uso di semplici test comportamentali in organismi modello come la mosca di frutta, Drosophila melanogaster . Drosophila è utile per comprendere la neurobiologia di base sottesa ai deficit cognitivi derivanti da mutazioni nei geni associati a disturbi cognitivi umani, come la disabilità intellettiva (ID) e l'autismo. Questo lavoro descrive una metodologia per testare l'apprendimento e la memoria usando un paradigma classico in Drosophila noto come condizionamento di corteggiamento. La maschile vola le femmine di corte utilizzando un modello distinto di comportamenti facilmente riconoscibili. Le femmine premate non sono ricettive per l'accoppiamento e rifiuteranno i tentativi di copulazione maschile. In risposta a questo rifiuto, le mosche maschi riducono il loro comportamento di corteggiamento. Questa riduzione imparata nel comportamento di corteggiamento viene misurata nel tempo, servendo da indicatore di apprendimento e di memoria. Il nume di baseL'output rical di questo saggio è l'indice di corteggiamento (CI), che è definito come la percentuale di tempo che un maschio spende corteggiare durante un intervallo di 10 minuti. L'indice di apprendimento (LI) è la riduzione relativa di CI nelle mosche che sono state esposte a una femmina prematurata rispetto alle mosche naïve senza precedenti incontri sociali. Per il confronto statistico di LI tra genotipi, viene utilizzato un test di randomizzazione con bootstrap. Per illustrare come il saggio può essere utilizzato per affrontare il ruolo di un gene relativo all'apprendimento e alla memoria, è stata caratterizzata qui la disgregazione pan-neuronale di Dihydroxyacetone phosphate acyltransferase ( Dhap-at ). L' ortologo umano di Dhap-at , l'O-aciltransferasi ( GNPT ) di glicerofosfato , è coinvolto nella chondrodysplasia punctata tipo 2, una sindrome autosomica recessiva caratterizzata da un grave ID. Utilizzando il test di condizionamento di corteggiamento, è stato determinato che Dhap-at è richiesto per la memoria a lungo termine, ma non permemoria a breve termine. Questo risultato serve come base per un'ulteriore ricerca dei meccanismi molecolari sottostanti.
Introduzione
I meccanismi molecolari alla base dell'apprendimento e della memoria sono conservati in molte specie. L'analisi del lavoro pionieristico Le linee mutanti di Drosophila melanogaster per i difetti nell'apprendimento olfattivo e nella memoria hanno fornito le conoscenze molecolari chiave nei processi che sottendono all'apprendimento e alla memoria 1 . Questi studi hanno individuato alcuni dei primi geni coinvolti nell'apprendimento e nella memoria, come il rutabaga 2 , l' amnesia 3 e il dunk 4 , rivelando un ruolo fondamentale per la segnalazione 5 del ciclo di adenosina monofosfato (cAMP).
Gli schermi genetici precoci per i mutanti di memoria sono stati condotti principalmente usando il condizionamento olfattivo. Tuttavia, nel tempo sono emersi diversi metodi per misurare altre forme di apprendimento e di memoria. Uno dei paradigmi di apprendimento e memoria più diffusi, e il saggio descritto qui, è noto come cIl nostro condizionamento, che è stato descritto per la prima volta da Siegel e Hall 6 ed è stato successivamente raffinato da diversi altri gruppi di ricerca 7 , 8 , 9 . Il condizionamento della cortesia è dipendente dalla presenza di un feromone specifico, cis- vaccenil acetato (cVA), sull'addome femminile, che viene depositato dal maschio durante la copulazione. La sensazione cVA sull'addome femminile riduce naturalmente il comportamento di corteggiamento, e quando accoppiato con l'atto di rifiuto da parte della femmina, l'effetto della cVA sulla riduzione del corteggiamento maschile è notevolmente migliorato. La risposta delle mosche maschili in questo saggio può essere facilmente quantificata osservando il loro comportamento distinto di corteggiamento, caratterizzato dall'orientamento verso e seguendo la femmina, toccando, estendendo e vibrante l'ala, leccando e tentando di copulare 10 ( Figura 1A ). Le mosche maschili imparano a distinguere H tra le femmine ricettive virginiche e non ricettive femminili 11 e dopo il rifiuto sessuale, mostrano un comportamento ridotto di cortesia verso le femmine non ricettive fino a 9 giorni 8 . Questo comportamento naturale può essere utilizzato per chiarire i meccanismi alla base dell'apprendimento, della memoria a breve termine (STM) e della memoria a lungo termine (LTM) 8 , 9 , 12 . L'apprendimento è definito come la riduzione immediata del comportamento di corteggiamento che si verifica durante il periodo di addestramento e viene spesso indicata come memoria di richiamo immediato, misurata 0 - 30 min dopo l'esposizione a una femmina matura 6 , 8 . La STM è misurata tra 30 minuti e 1 ora dopo l'allenamento, mentre LTM è più spesso misurata 24 ore dopo l'allenamento 8 ( Figura 1B ). L'STM può essere indotto usando un periodo di formazione di 1 ora, ma dura solo 2-3 oreS = "xref"> 6 , 8 . Nella maggior parte dei paradigmi di apprendimento, LTM può essere indotto solo da attacchi distanziati di formazione ripetuta. Mcbride et al . (1999) 8 hanno mostrato che tre sessioni di allenamento distanziate sono state sufficienti per indurre la memoria di corteggiamento che dura fino a 9 giorni, a differenza dei 2-3 h indotti da una singola sessione di allenamento. McBride et al . 8 ha anche dimostrato che una singola sessione di allenamento a 5 ore ha prodotto una risposta simile LTM per un massimo di 9 giorni. Le mosche non contendono costantemente durante questo periodo di 5 ore, in effetti producono la loro formazione distanziata per indurre LTM in una sola sessione di allenamento. Questo è molto importante da una prospettiva pratica, aumentando notevolmente la facilità con cui questo test può essere utilizzato per indagare la LTM. I protocolli correnti utilizzano prevalentemente una singola sessione di allenamento di 7 ore per LTM 11 , 12 . Diversi studi hanno indagato diversiCondizioni mutanti che presentano difetti specifici in diversi aspetti dell'apprendimento di corteggiamento. Ad esempio, l'ablazione del corpo di funghi influenza STM e LTM, ma non l'apprendimento 8 . Le mutazioni del gene amnesia , definito per la prima volta come un regolatore specifico della memoria usando il condizionamento olfattivo 3 , influenzano l'STM ma non l'apprendimento 6 . La rottura del regolatore di traduzione orb2 (sottofamiglia CPEB2 per il rilascio di RNA oo18) e ecdysone che segnalano esclusivamente l'effetto LTM 9 , 13 . Così, il condizionamento di corteggiamento è un paradigma utile per disseccare i meccanismi che sottendono le diverse fasi dell'apprendimento e della memoria.
Questo lavoro dimostra una configurazione sperimentale ottimizzata che consente il test relativamente elevato di calibrazione. Inoltre, descrive uno script di analisi statistica e discute fattori critici del dosaggio. È shProprio qui che il Drosophila gene Dihydroxyacetone fosfato aciltransferasi ( Dhap-at ) È richiesto nei neuroni per LTM, ma non per STM. L' ortologo umano di questo gene, il glicerofosfato O-aciltransferasi ( GNPAT ), è mutato in chondrodysplasia punctata tipo 2 14 , un disturbo autosomico-recessivo caratterizzato da gravi disabilità intellettuali, convulsioni e molte altre caratteristiche cliniche 15 . In questo contesto, il condizionamento di corteggiamento può essere utilizzato per validare funzionalmente il ruolo dei geni della malattia umana nell'apprendimento e nella memoria, fornendo una base per studi meccanici.
Protocollo
NOTA: Nel protocollo descritto di seguito viene descritta una replica di raccolta, formazione e test. Per testare la riproducibilità dei risultati, questi passaggi dovrebbero essere ripetuti in parallelo, in più giorni e con gruppi separati di mosche ( Tabella 1) . Il protocollo si basa su un ciclo di vita di 10 giorni dall'uovo all'adulto, che è normale quando allevano mosche in condizioni costanti di 25 ° C, umidità del 70% e ciclo di luce / buio da 12 h. Tutti gli aspetti di questo protocollo presuppongono che le condizioni siano mantenute costanti per tutto il saggio. I tempi sono indicati come ore prima che le luci si accendano (BLO) o dopo che le luci si accendano (ALO) nell'incubatrice, in quanto questo può essere impostato comodamente a seconda del giorno preferito del ricercatore. Utilizzare gas CO 2 solo per la raccolta iniziale di mosche maschili naïve e per la raccolta di femmine premate. Questo protocollo per il condizionamento di corteggiamento è composto dalle seguenti fasi:
- ECreazione di colture femminili premate di raccolta
- Istituzione di culture per la raccolta di soggetti di prova maschile
- Preparazione dei blocchi abitativi
- Realizzazione di fiale di accoppiamento per la produzione di femmine premature standardizzate
- Raccolta di soggetti di prova maschile
- Formazione
- analisi
- Analisi dei dati video e statistiche
1. Istituzione di colture femminili premature femminili
- Preparare il powerfood 16 . Boilizzare l'agar, l'8% (w / v) lievito, l'estratto di lievito 2% (w / v), il peptone 2% (w / v), il saccarosio 3% (w / v), 6% ( W / v) glucosio, 0,05% (w / v) MgSO 4 e 0,05% (w / v) CaCl2 in acqua per 15 minuti. Lasciare raffreddare la soluzione a 70 ° C prima di aggiungere 0,05% (w / v) metilparabene (ATTENZIONE: tossico) e 0,5% (v / v) acido propionico (ATTENZIONE: tossico). Mescolare bene mescolando raffreddando ulteriormente a 50 ° C per ottenere una soluzione omogenea.
- Prima che il cibo cosìSi coniuga a temperatura ambiente, aggiunge ~ 50 ml di alimentatore a ogni fiala di plastica da 175 ml. Lasciare raffreddare ulteriormente il cibo. Chiudere la fiala con una spina.
NOTA: Powerfood è una miscela alimentare specializzata formulata specificatamente per la produzione di un gran numero di mosche, presumibilmente indurre l'uovo. Powerfood non viene utilizzato per produrre mosche maschili che verranno utilizzate per l'analisi del comportamento (passo 2) perché la dieta atipica e l'affollamento potenziale potrebbero influenzare lo sviluppo. - Al giorno -11 ( Tabella 1 ), iniziare 5-20 colture di wildtype con circa 60-100 mosche (un mix di maschi e femmine) in fiale di alimentazione; Questi saranno utilizzati nel passaggio 4 per produrre femmine premate standardizzate 17 . Aggiungere una carta filtrante ad ogni flaconcino per aumentare l'area su cui le larve possono ingannare; Questo aumenterà il numero di mosche che possono escludere.
- Ripetere periodicamente i passaggi 1.1-1.3 per tutta la durata dell'esperimento per ottenere sufficienti mosche di eclissazione sufficienti come input per"Creazione di flaconcini per la produzione di femmine premate standardizzate" (fase 4).
2. Istituzione di culture per la raccolta di soggetti test maschili
- Preparare l'alimento normale 16 , prodotto con agar 0,5% (w / v), lievito 2,75% (w / v), farina di mais (5,2% (w / v), zucchero 11% (w / v), 0,05% (w / ) Metilparabene e 0,5% (v / v) acido propionico in acqua, come descritto nei passaggi 1.1 e 1.2. Chiudere i flaconi di plastica da 175 ml con una spina del flacone a mosca.
- Al giorno -10 ( Tabella 1 ), posizionare circa 10-20 maschi con circa 30-75 femmine vergini ( Tabella Materiali / Attrezzatura ) in ogni flaconcino da 175 ml contenente alimenti normali. Aggiungere una carta filtrante per aumentare la superficie per la pupazione e per massimizzare la produttività.
- Stabilire da tre a sei fiale da 175 ml per genotipo per ottenere il numero richiesto di maschi soggetti alla prova.
NOTA: Possono essere necessarie più fiale, a seconda della produttività del gene desideratooType.
3. Preparazione dei blocchi di alloggiamento ( Figura 2A )
- Sciogliere circa 50 ml di alimentatore per blocco di alloggiamento in un forno a microonde o prepararlo fresco.
- Aggiungere 500 μL di alimentatore a ciascun pozzetto di un blocco a 96 pozzetti a fondo piano utilizzando una pipetta multidissima.
- Lasciare che il cibo si solidifichi a temperatura ambiente.
- Coprire i blocchi con pellicola adesiva PCR e utilizzare un ago per realizzare almeno 4 fori per pozzetto per fornire aria fresca alle mosche.
- Per poter aprire ogni pozzetto, utilizzare una lama del rasoio per tagliare la pellicola adesiva longitudinalmente tra ciascuna fila. Lasciare intatta la pellicola su un'estremità del blocco.
- I blocchi possono essere conservati a 4 ° C per un massimo di 2 giorni.
NOTA: Consentire ai blocchi di ri-equilibrare a temperatura ambiente prima dell'uso.
4. Istituzione di fiale di accoppiamento per la produzione di femminili premature standardizzate
- Il giorno -1, rimuovi eScartare tutte le mosche wildtype adulte dalle colture premature di raccolta femminile a 2-5 h BLO.
- Raccogli le mosche usando l'aspiratore ( Figura 2B ) da questi flaconcini in intervalli da 2 a 3 ore ( ad esempio, a 30 minuti, 2,5 h e 5 ore ALO) e collocarli in una nuova fiala di alimentatore integrata con una piccola quantità di lievito Pasta e carta filtrante.
- Per evitare l'affollamento e per promuovere un'atmosfera di accoppiamento ottimale, non trasferire più di 150-200 mosche ad ogni nuova fiala. Assicurarsi l'accoppiamento di tutte le femmine fornendo almeno il 25% dei maschi. Assicurarsi che le femmine sufficienti siano presenti nelle fiale di accoppiamento per soddisfare le dimensioni dell'esperimento.
NOTA: poiché questo è un passo cruciale nel protocollo, assicurarsi che solo le mosche fresche esplorate e le vecchie mosche, larve o pupae non siano trasferite alla nuova fiala di accoppiamento. - Incubare questi "fiale di accoppiamento" per quattro giorni per consentire un tempo sufficiente per tutte le femmine.
5. ColLezione di soggetti di prova maschile
- Il giorno 1 ( Tabella 1 ) a 2-3 ore BLO, utilizzare CO 2 per rimuovere tutte le mosche adulte dai flaconi di raccolta maschile (fase 2), Ma lasciate più mosche eclose nelle prossime ore.
- Nel successivo 5-6 h, rimuovere le mosche appena sventolate ogni 20-30 minuti utilizzando CO 2 e mettere ciascun maschio in un pozzetto individuale del blocco di alloggiamento (fase 3) usando l'aspiratore ( Figura 2B ).
- Reinserire il pozzetto con il film adesivo PCR.
NOTA: questo è un passo cruciale nel protocollo. I maschi devono essere raccolti frequentemente. I maschi raccolti dovrebbero essere isolati nel blocco di alloggiamento vicino al tempo dell'eclosione, quando dimostrano la pigmentazione pallida e la presenza del meconium nell'addome traslucido.
NOTA: L'uso delicato dell'aspirazione consente il trasferimento delle mosche; Tuttavia, l'uso inadeguato metterà in risalto le mosche, provocando la varianza nel dosaggio (vedi Discussione). - Obiettivo del coLlect fino a 48 maschi per genotipo. Ciò fornisce un piccolo eccesso al numero massimo di maschi necessari per l'analisi di entrambe le condizioni naïve e addestrate, consentendo una certa perdita durante i passaggi successivi di trasferimento.
6. Formazione
- Rimuovere le mosche dal flacone di accoppiamento (punto 4.2) usando CO 2 e separare le femmine premate dai maschi.
- Usando l'aspiratore, aggiungere a ciascun pozzetto una singola femmina anestetizzata e premedicata in una fila di un nuovo blocco di alloggiamento.
- Utilizzando l'aspirazione e senza anestesia, trasferire un maschio individuale naïve dal blocco di alloggiamento impostato nel punto 5.2 al pozzetto contenente una femmina preimpostata. Dopo aver inserito il maschio nel pozzetto, ri-sigillare immediatamente con la pellicola adesiva; Non permettere al maschio di fuggire.
NOTA: Trasferire le mosche maschi dall'aspirazione al blocco abitativo sfruttando il loro naturale comportamento "geotassiale negativo" (vedi Discussione). - Ripetere i passaggi6.2-6.3 finché non si creano coppie maschio-femmine sufficienti. Idealmente, stabilire 24 coppie, due file complete di un blocco abitativo, per genotipo. Lasciare i rimanenti maschi ingannati nel blocco di alloggiamento originale impostato nel punto 5.2.
- Lasciare le coppie maschio-femmine indisturbate durante il periodo di allenamento ( Tabella 2 , Figura 1B ).
NOTA: Durante questo periodo, il maschio si accorcerà e sarà respinto dalla femmina prematurata. Per l'apprendimento e la STM, il periodo di addestramento è di 1 ora e per LTM il periodo di formazione è di 7-9 h. - Terminare l'allenamento ( Tabella 2 , Figura 1B ) usando un aspiratore per separare delicatamente il maschio dalla femmina premato; Non usare anestesia. Posizionare il maschio separato in un nuovo blocco di alloggiamento.
- Utilizzare l'aspiratore per trasferire tutti i maschi ingenue con delicatezza e senza anestesia dal blocco di alloggiamento impostato al punto 5.2 ad un nuovo blocco di alloggiamento.
NOTA: Questo passaggio è facoltativo per STM e leaMa è molto importante per LTM perché le mosche sono alloggiate per ulteriori 24 ore per testare la LTM. - Per STM e LTM, consentire ai maschi di riposare per 1 h e ~ 24 h rispettivamente ( Tabella 2 , Figura 1B ) prima della prova (punto 7).
- Per imparare, provare immediatamente i maschi addestrati e ingenui (passo 7).
7. Prova
- Raccogli le mosche dai flaconi di accoppiamento (fase 4.2) usando CO 2 e separare le femmine premate dai maschi.
- Lasciare che le femmine recuperino dall'anestesia per almeno 1 ora in un flaconcino contenente alimenti normali.
- Montare i videoregistratori in anticipo ( Figura 2C ) per avere tutte le apparecchiature pronte prima dell'avvio del test.
- Avviare il test in base alle diverse scadenze temporali per l'apprendimento, STM e LTM ( Tabella 2 , Figura 1B ). Eseguire i test immediatamente dopo l'allenamentoPer l'apprendimento, 1 h dopo la formazione per STM e 24 ore dopo la formazione per LTM.
- Usando l'aspirazione, trasferire delicatamente un singolo maschio dal blocco dell'alloggiamento di riposo o dal blocco dell'alloggiamento di allenamento se l'apprendimento viene sottoposto a test (punto 6.7, addestrato, passo 6.8, ingenuo) ad una metà di un'arena di corteggiamento con il divisore chiuso ( Figura 2D ; Vedere il file S1 per un piano di costruzione).
NOTA: L'uso del comportamento naturale "negativo di geotassi" dovrebbe essere sufficiente per trasferire le mosche maschili dall'aspirazione all'arena di corteggiamento (Discussione). - Spostare rapidamente ma con delicatezza il foro di entrata nell'arena successiva e ripetere il passo 7.5 finché tutte le 18 arene contengano un maschio.
- Utilizzando l'aspirazione e senza CO 2 , aggiungere una femmina preimpostata (raccolta alla fase 7.2) all'altra metà di tutte le 18 arene.
- Posizionare con cautela la camera di corteggiamento sotto la fotocamera, con l'apertura dei pozzetti rivolti verso il basso ( Figura 2C ).
- Rimuovere il divisore delle arene per consentire l'interazione diretta tra i maschi e le femmine premate.
- Avviare immediatamente il comportamento per almeno 10 minuti.
NOTA: quando si utilizza una configurazione a due telecamere, la registrazione parallela di due targhe di cortesia può essere eseguita in tempi temporali sovrapposti per ottimizzare l'efficienza. - Svuoti le arene di corteggiamento usando un aspirapolvere portatile e lasciate che la camera di corteggiamento venga ventilata prima di riutilizzarla.
- Ripetere il passaggio 7.4-7.11 finché non sono stati completati i test di tutti i genotipi e le condizioni ( ad esempio, naive e addestrate).
8. Analisi dei dati video e statistiche
- Calcolare l'indice di corteggiamento (CI), definito come la percentuale di tempo che i tribunali maschi durante i primi 10 minuti del periodo di prova, per ogni mosca maschile.
NOTA: questo può essere fatto manualmente osservando un comportamento stereotipato di corteggiamento ( Figura 1A ) o da uCantare software per la quantificazione automatizzata del comportamento di corteggiamento (discussione).
NOTA: Si raccomanda di analizzare 40-60 maschi per condizione nel corso di tre giorni per ottenere una potenza statistica sufficiente e per giudicare la coerenza dei dati CI. - Calcolare l'indice di apprendimento (LI), definito come la riduzione percentuale della media CI dei maschi addestrati rispetto ai maschi ingenuo (LI = (CI naive - CI trainato ) / CI naive ). Valutare il LI per ogni giorno di prova e confrontarlo con il LI accumulato calcolato da tutti i giorni di prova combinati.
- Creare un file di dati separato a due colonne con "Genotype" e "CI" come intestazioni.
NOTA: Queste intestazioni sono sensibili ai casi di maiuscole. Il nome del genotipo per ogni CI deve essere costituito da una descrizione del genotipo seguita da un sottolineatura e dalla condizione di addestramento ( es., Genotipo_N genotipoL, ecc., Dove N = naïve e LTM = a lungo terminememoria; Vedere un esempio Supplementare File S2). Questa annotazione è essenziale, in quanto l'analearn funzione individuerà le mosse addestrate e ingenue basate sui caratteri presenti dopo la prima sottolineatura nella colonna "Genotipo". - Utilizzare lo script analearn R (Supplemental File S3) per eseguire un test di randomizzazione per valutare la significatività statistica delle differenze tra i valori LI da diversi genotipi.
- Fonte dello script (File aggiuntivo S3) in R 18 , che definisce una funzione chiamata "analearn".
NOTA: la definizione di funzione è: analearn <- funzione (nboot = 10,000, naivelevel = 'N', inversione = NA, datname = NA, intestazione = TRUE, seme = NA, writeoutput = TRUE). - Avviare la funzione inserendo "analearn ()" nella riga di comando R e selezionando il file di dati da analizzare (prodotto nel passaggio 8.3) tramite la finestra popup.
- Scegli la mutazione di riferimento, cheÈ il genotipo di controllo, immettendo il numero corrispondente e premendo enter.
NOTA: Dopo aver selezionato il genotipo di riferimento, lo script richiede diversi secondi per eseguire 10.000 repliche di bootstrap. - Osservare la tabella di output (tabella 3), che contiene il genotipo, la condizione di apprendimento ( cioè l'apprendimento, STM o LTM), significa CI naïve, media CI addestrato, LI, la differenza tra il LI del controllo rispetto alla condizione sperimentale (LI dif), il limite inferiore (LL) e il limite superiore (UL) dell'intervallo di confidenza del 95% del LI dif e il valore p che indica la probabilità che non vi sia differenza significativa.
NOTA: Analearn memorizza un file di testo di output nella directory in cui si trova il file di dati. Tuttavia, la tabella di output viene visualizzata anche nella console R-Studio. Il nome predefinito viene costruito in base al nome del file di dati fornito. - Ci sono diversi argomenti nella funzione analearn che possono essere utilizzati per alterare il deImpostazioni di errore della funzione per regolare i parametri del bootstrap.
NOTA: "nboot" definisce il numero di repliche di bootstrap e viene impostato su 10.000 per impostazione predefinita. Questo valore può essere modificato in un numero intero maggiore di zero. La tabella 5 elabora diversi argomenti che possono essere utilizzati per modificare le impostazioni predefinite della funzione. Tuttavia, non è consigliabile utilizzare i dati che vengono prodotti con un numero ridotto di repliche di bootstrap.
- Fonte dello script (File aggiuntivo S3) in R 18 , che definisce una funzione chiamata "analearn".
Risultati
Il test di condizionamento per corteggiamento può essere utilizzato per misurare l' apprendimento e la memoria in Drosophila . Per dimostrare questo, i risultati qui presentati analizzano STM e LTM nelle mosche di controllo rispetto alle mosche con il disagio specifico del neurone di Dhap-at. I maschi di controllo esprimono una sequenza di forcella di interferenza di RNA che punta a un gene specifico di Caenorhabditis elegans , la presuntuosa proteina delle dita di zinco C02F5.12 19 . Questo ceppo di controllo assicura un numero uguale di elementi di sequenza di attivazione a monte (UAS) tra il knockdown e il controllo nello stesso sfondo genetico e il cono di controllo RNAi rappresenta per ogni effetto non specifico del sistema RNAi. I maschi di controllo (genotipo: UAS-dcr2 / +; P {KK108109} VIE-260B / +; elav-Gal4 / + ) mostrano una riduzione significativa del CI in formazione a fronte di entrambi STM ( figura 3A , p = 1,2 x 10 - 4 , Mann-WhitneY U-test) e LTM ( Figura 3B , p = 1,2 x 10 -4 , Mann-Whitney U-test). Questo risultato riflette la capacità normale di apprendimento e di memoria in queste mosche. Anche le mosche a disagio di Dhap (genotipo: UAS-dcr2 / +; P {KK101437} VIE-260B / +; elav-Gal4 / + ) mostrano anche una significativa riduzione di CI in mosche nautiche addestrate per STM ( Figura 3A , p = 1,2 x 10 -4 , Mann-Whitney U-test). Tuttavia, non mostrano una riduzione significativa del CI dopo l'allenamento LTM ( figura 3B , p = 0,33, Mann-Whitney U-test). L'U-test di Mann-Whitney è stato utilizzato per confrontare il CI medio delle mosche naïve e addestrate a causa della distribuzione non parametrica dei dati CI per alcune condizioni ( Figura 3A e 3B ). Le differenze osservate attraverso l'analisi dei CI sono riflesse dal LI per ciascun genotipo, che misura il reddito percentualeIn CI in mosche naïve contro versate ( Figura 3C ). Non vi è alcuna differenza significativa in LI tra i controlli e le mosche a discesa di Dhap per STM ( p = 0.115, 10.000 repliche di bootstrap, Figura 3C , Tabella 3 ), mentre il LI per LTM è significativamente più basso nelle mosche di Dhap ( p = 0.0034, 10.000 repliche di bootstrap, Figura 3C , Tabella 3 ). Per il confronto di LI tra i genotipi, un test di randomizzazione 20 adattato da un metodo primo raccomandato da Kamyshev et al. 7 è stato utilizzato. Poiché il LI è un unico valore derivato da dati di popolazione ( cioè CI-naïve e medio CI-formati), i metodi statistici standard che si basano su distribuzioni derivate sperimentalmente non si applicano. Il test di randomizzazione è privo di distribuzione e utilizza il bootstrapping ( cioè, campioni casualiNg con sostituzione) per generare set di dati ipotetici derivanti dai dati reali. Lo script analearn (File S3) genera un insieme di LIs ipotetici per ogni genotipo e calcola la differenza tra il controllo e il genotipo di prova (LIdiff). Questo processo viene ripetuto 10.000 volte e i valori risultanti vengono utilizzati per determinare l'intervallo di confidenza del 95% di LIdiff ( Tabella 3 ). Questi dati vengono usati per generare un valore p che indica la probabilità che il LI dei due genotipi sia diverso. I risultati mostrati qui dimostrano che Dhap-at è richiesto nei neuroni per LTM ma non per STM.
Al fine di controllare la variabilità quotidiana, i valori CI e LI vengono confrontati tra i giorni replicati ( tabella 4 ). Sebbene sia osservata una certa oscillazione di LI da un giorno all'altro, i risultati sono generalmente riproducibili. È importante notare che i dati CI possono variare notevolmente a seconda dello str. Di controlloUtilizzati e le condizioni ambientali di prova. I dati CI qui mostrati sono tipici per questo genotipo di controllo, ma altri genotipi possono presentare una media CI maggiore e minore e la distribuzione.
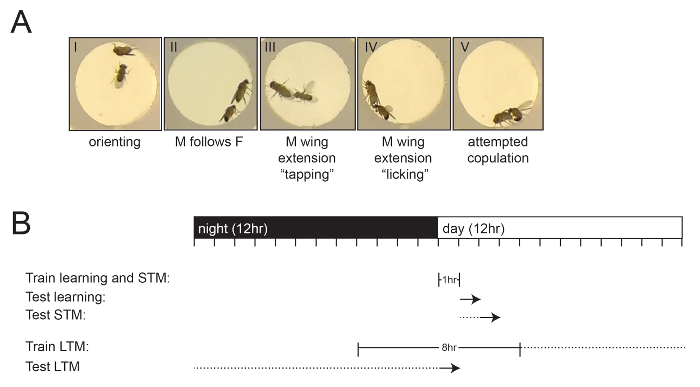
Figura 1: Determinazione dell'indice di cortesia e panoramica sperimentale. ( A ) Immagini che mostrano un comportamento stereotipato di corteggiamento maschile verso una mosca femminile. Sono mostrate diverse fasi di comportamento di corteggiamento: orientamento (I), seguito (II), vibrazione dell'ala (estensione) e toccatura (III), leccata (IV) e tentata copulazione (V). ( B ) Schema generale dei tempi di formazione e di prova relativi al ciclo della luce dell'incubatore, contrassegnati in ore. I tempi di allenamento sono indicati con barre, i periodi di riposo per STM e LTM sono indicati con una linea tratteggiata e il punto di partenza del test è indicato come una freccia. Si noti che ilIl tempo di prova per LTM è il giorno dopo dopo l'allenamento. Clicca qui per visualizzare una versione più grande di questa figura.
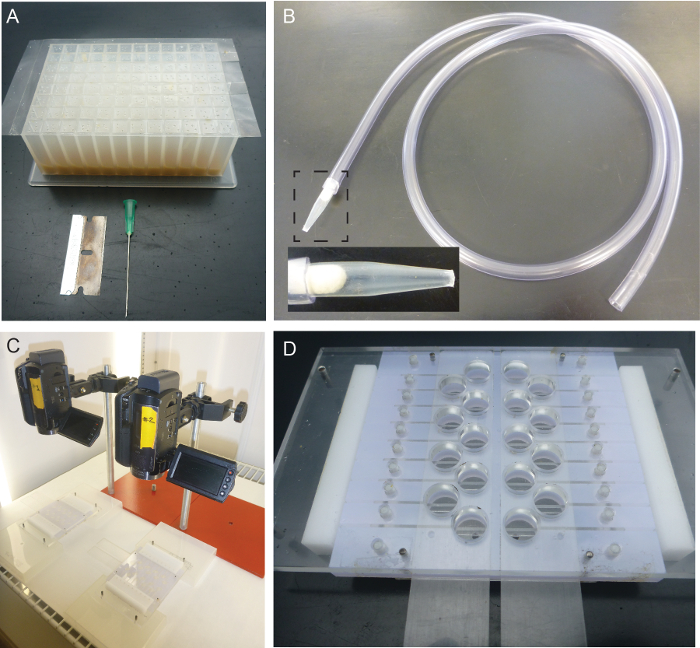
Figura 2: Apparecchiatura utilizzata per il test di condizionamento Drosophila Courtship. ( A ) Il blocco di alloggiamento è un blocco di fondo piano con 500 μL di alimentatore per pozzetto. È sigillato con una pellicola adesiva qPCR con almeno 4 fori per pozzetto che sono stati creati utilizzando un ago a siringa con un diametro di 0,8 mm. Le file individuali vengono tagliate in lunghezza in strisce utilizzando una lama di rasoio per consentire l'apertura e la chiusura. ( B ) L'aspirazione è necessaria per il dolce trasferimento delle mosche maschili e femminili senza l'uso di anestesia. L'inserto mostra la punta dell'aspirazione, chiusa con un pezzo di cotone a keEp le mosche all'interno della punta. ( C ) Impostazione di un sistema a due telecamere per la registrazione simultanea di due camere di corteggiamento. ( D ) Camera di corteggiamento con 18 arene. Per posizionare le mosche nelle arene vengono impiegati fori di ingresso scorrevoli. I divisori bianchi possono essere aperti contemporaneamente per avviare l'interazione tra i maschi e le femmine. Clicca qui per visualizzare una versione più grande di questa figura.
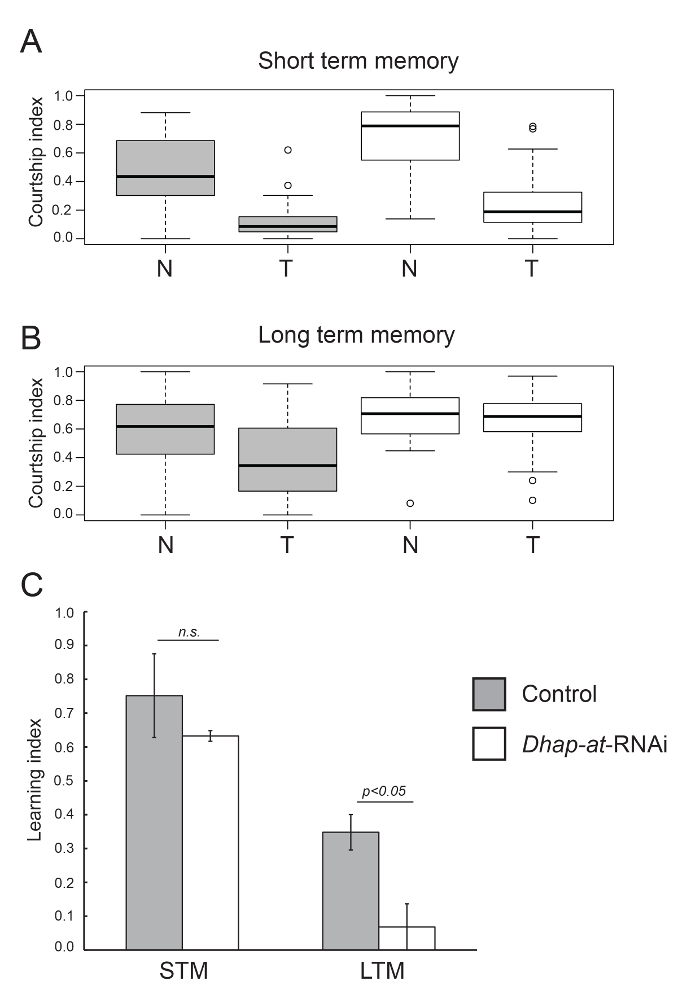
Figura 3: Analisi di STM e LTM in Controllo e Dhap-in le mosse di Knockdown. ( AB ) Boxplots che mostrano la distribuzione dei valori di CI per le mosche naïve (N) e addestrate (T) dei genotipi di controllo (grigio) e Dhap-at knockdown (bianco) testati per STM (A) e LTM (B). ( C ) CorrespoNding i valori LI per il controllo e le mosche a scatto Dhap-at test per STM e LTM. Le differenze di LI tra i genotipi di controllo e knockdown sono state confrontate usando un test di randomizzazione (10.000 repliche di bootstrap). Le barre di errore indicano l'errore standard della media derivata dai valori LI calcolati nei diversi giorni di prova. I genotipi sono: w +, UAS-dcr2 / + ; P {KK108109} VIE-260B / + ; E elav-Gal4 / + ( controllo ) E w +, UAS-dcr2 / + ; P {KK101437} VIE-260B / +; E elav-Gal4 / + ( Dhap-at- RNAi). Clicca qui per visualizzare una versione più grande di questa figura.
| Generale | Raccogliere | Treno | Test | |
| Giorno -11 | Avviare le colture femminili di premattere (passo 1.3) | |||
| Giorno -10 | Avviare le culture per la raccolta di soggetti di prova maschile (punto 2.2) | |||
| giorno 1 | rappresentante. 1 | |||
| giorno 2 | rappresentante. 2 | |||
| Giorno 3 | rappresentante. 3 | |||
| Giorno 4 | rappresentante. 4 | rappresentante. 1 | ||
| Giorno 5 | rappresentante. 2 | rappresentante. 1 | ||
| Giorno 6 | rappresentante. 3 | rappresentante. 2 | ||
| Giorno 7 | rappresentante. 4 | rappresentante. 3 | ||
| Giorno 8 | rappresentante. 4 | |||
| Giorno 9 | Analisi dei dati video e statistiche (passaggio 8) | |||
| Rep = ripetizione | ||||
Tabella 1 : Timeline di esempio per testare LTM su tre repliche in giorni individuali.
| Apprendimento | STM | LTM | |
| Tempo di allenamento | 1 h. | 1 h. | 8 h. |
| Tempo di riposo | 0 h. | 1 h. | ~ 24 h. |
| Inizia la formazione | 0h. ALO | 0 h. ALO | 4 h. BLO |
| Smettere di allenarsi | 1 h. ALO | 1 h. ALO | 4 h. ALO |
| Avviare il test | 1 h. ALO | 2 h. ALO | 0 h. ALO (il giorno dopo) |
| ALO = dopo che le luci si accendono, BLO = prima che accendino le luci, STM = memoria a breve termine, LTM = memoria a lungo termine | |||
Tabella 2 : durata della formazione, tempi di addestramento e tempi di prova per l'apprendimento, STM e LTM.
| Genotipo | Apprendimento condizione | CI ingenuo | CI allenato | LI | LI differenza | Limite inferiore (Intervallo di conficenza del 95%) | Limite superiore (Intervallo di conficenza del 95%) | p-value |
| Controllo | STM | 0,467 | 0,116 | 0,752 | N / A | N / A | N / A | N / A |
| Dhap-at-RNAi | STM | 0,699 | 0,257 | 0,633 | 0.119 | -0.030 | 0,265 | 0,116 |
| Controllo | LTM | 0,590 | 0,384 | 0,348 | N / A | N / A | N / A | N / A |
| Dhap-at-RNAi | LTM | 0,697 | 0.650 | 0.068 | 0,280 | 0.103 | 0.446 | 0.003 |
Tabella 3: Dati statistici prodotti dall'Analearn Script.
Dati statistici prodotti dallo script analearn. Il file di output dello script R di bootstation che contiene il genotipo, la condizione di apprendimento ( cioè l'apprendimento, STM o LTM), significa CI naïve, media CI addestrato, LI, differenza tra LI del controllo rispetto allo stato sperimentale (LI dif) , Il limite inferiore (LL) e il limite superiore (UL) dell'intervallo di confidenza del 95% di LI dif e il valore p che indica la probabilità che non vi sia alcuna differenza significativa.
| Controllo | Dhap-at-RNAi | ||||||
| Media CI naïve | Media CI addestrato | LI | Media CI naïve | Media CI addestrato | LI | ||
| STM | Giorno 1 | 0.300 | 0,125 | 0,584 | 0,679 | 0,239 | 0,648 |
| Giorno 2 | 0,634 | 0,107 | 0,831 | 0,720 | 0,276 | 0,617 | |
| Tutti i giorni | 0,467 | 0,116 | 0,752 | 0,699 | 0,257 | 0,633 | |
| LTM | Giorno 1 | 0,590 | 0.441 | 0.252 | 0.630 | 0,646 | -0,027 |
| Giorno 2 | 0,640 | 0.363 | 0.432 | 0,709 | 0,710 | -0,002 | |
| Giorno 3 | 0,547 | 0,349 | 0.363 | 0.738 | 0,598 | 0.190 | |
| Tutti i giorni | 0,590 | 0,384 | 0,348 | 0,697 | 0.650 | 0.068 |
Tabella 4 : valori CI e LI ottenuti in giorni di prova separati.
| "Naivelevel" determina il testo che identifica i valori ingannevoli per ogni genotipo. Il valore predefinito è "N", ma questo può essere modificato in qualsiasi altro testo alfanumerico. |
| Per "default" è impostato su "NA" (non applicabile) per impostazione predefinita, ma può essere modificato al nome del controllo o del genotipo per eseguire comparazioni statistiche. Ciò causerà gli sScript per selezionare automaticamente il genotipo di controllo. |
| "Datname" si riferisce al nome del file di dati e può essere specificato in questo argomento anziché la selezione predefinita di file. |
| "Header" può essere utilizzato per indicare se il file di dati contiene o non contiene intestazioni di colonna. L'impostazione predefinita è "TRUE", ma un file senza intestazioni può essere utilizzato quando questo argomento viene modificato in "FALSE". |
| "Seed" inizializza il generatore di numeri casuali, impostato per impostazione predefinita su "NA" e assicura un numero casuale ogni volta che viene utilizzato lo script. Dal disegno, un'analisi di bootstrap fornirà risultati leggermente diversi ogni volta che viene eseguito, anche quando si utilizza lo stesso file di dati. Quando il seme è specificato da un numero intero maggiore di zero, si ottiene lo stesso insieme di campioni di bootstrap casuali. |
| "accantonare Put "può essere impostato su" TRUE "o" FALSE "per determinare se verrà generato un file di output. L'impostazione predefinita è "TRUE". |
Tabella 5: Argomenti utilizzati nella funzione Analearn che possono modificare le impostazioni predefinite della funzione per regolare i parametri di avvio di avvio
Supplemento File S1: Piano di costruzione di una camera di corteggiamento. Il file può essere aperto con qualsiasi applicazione che consente le estensioni .stp (file CAD) . Clicca qui per scaricare questo file.
Supplemento File S2 : Esempio di un file di input per lo script Analearn .S2.zip "target =" _ blank "> Fare clic qui per scaricare questo file.
Supplemento File S3 : L'Analearn.R Acript. Il file può essere aperto con R-studio 18 . Clicca qui per scaricare questo file.
Discussione
Il test di condizionamento di corteggiamento è un paradigma classico per l'analisi dell'apprendimento e della memoria in Drosophila . Il protocollo qui presentato segue la metodologia generale descritta in precedenza 6 , 7 , 8 , 9, ma include aspetti unici quali orientamenti pratici, attrezzature specializzate e uno script di analisi dati 9 , 12 per i test di randomizzazione. Utilizzando questo protocollo, è possibile analizzare un numero elevato di mosche in parallelo utilizzando blocchi a fondo piano a 96 pozzetti ( Figura 2A ) per raccogliere e formare i maschi. I blocchi sono sigillati con pellicola adesiva PCR, che rende le mosche facilmente accessibili quando richiesto. Inoltre, le camere uniche di corteggiamento qui descritte consentono l'accoppiamento simultaneo di 18 coppie maschio-femmine in uno spazio quasi bidimensionale cheS ottimale per l'analisi video. Le camere da corteggiare personalizzate sono facili da usare e viene fornito un piano di costruzione ( File S1 , Figura 2D ). Questo protocollo, dalla creazione delle culture utilizzate per raccogliere i soggetti sottoposti a test all'acquisizione di dati video, richiede circa 20 giorni ( tabella 1 ). È necessario un tempo aggiuntivo per l'analisi dei dati video. Nella nostra esperienza, il test STM è estremamente robusto. Il test LTM è anche abbastanza robusto, ma è più sensibile a confondere variabili ambientali e quindi può essere più difficile da padroneggiare.
Il comportamento animale può essere abbastanza variabile. Pertanto, i passi critici del protocollo devono essere eseguiti con cura per ridurre questa varianza. Innanzitutto, l'uso delicato dell'aspirazione ( Figura 2B ) ridurrà lo stress che può essere imposto dalla manipolazione ruvida o soffiando troppo forte. Un metodo suggerito per il trasferimento di individuiTira fuori dall'aspirazione usando la geotassi negativa. Mentre le mosche tendono a salire, si può semplicemente puntare la punta dell'aspirapolvere; Poco prima che la mosca raggiunga la punta, un soffio leggero è sufficiente a far uscire il volo. Inoltre, per lasciare i maschi nelle camere di corteggiamento prima della prova, un colpo spesso non è necessario.
Un altro passo importante è la raccolta e la generazione di soggetti di prova maschile. Tutti i maschi devono essere raccolti quando sono molto giovani e socialmente ingenui. Ciò può essere ottenuto con una frequente raccolta durante i periodi di picco dell'eclosione (fase 5.2). Se i maschi non vengono raccolti in questo stretto periodo di tempo, possono avere interazioni sociali precoci, che possono portare ad un scarso apprendimento o ad un'elevata variabilità nel CI. Un altro fattore di soggetti di prova maschile che dovrebbe essere valutato è il background genetico. Diversi ambiti di provenienza genetica mostreranno diversi livelli di cortigia naif e possono anche differire in attività generali o capacità locomotori. Quando compaAnnotare più genotipi, occorre prestare attenzione ai precedenti genetici per evitare questi fattori confusi che possono influenzare i punteggi LI. Inoltre, la distribuzione dei dati CI dovrebbe essere attentamente valutata. I dati CI possono essere sia parametrici che non parametrici, a seconda del genotipo o di altri fattori ambientali. In alcuni casi, se la distribuzione di CI è drammaticamente spostata da una distribuzione normale, potrebbe essere meglio utilizzare il CI mediano piuttosto che la media per il calcolo di LI. Tuttavia, secondo la nostra esperienza, l'uso di media mediana o media CI non fa differenza nell'interpretazione statistica dei dati e l'utilizzo della media CI è la pratica comune in letteratura.
Per il condizionamento di corteggiamento di successo, il rifiuto attivo dei tentativi di corteggiamento maschile da parte delle femmine premate è cruciale durante il periodo di allenamento. È importante assicurarsi che le femmine premate utilizzate in questo dosaggio siano state accoppiate in modo efficace e sonoQuindi non consentendo la copulazione. Questa prematura è stabilita nei flaconi di accoppiamento preparati al punto 4, dove le mosche maschi e femmine sono alloggiate insieme per 4 giorni ( Tabella 1 ). Successivamente, l'accoppiamento può essere monitorato regolarmente esaminando i video di prova e osservando le coppie maschio-femmine durante l'allenamento. Se si verifica l'accoppiamento, ci sono diverse misure che possono essere adottate durante la preparazione di femmine premate. In primo luogo, le femmine premate dovrebbero essere allevati in ottime condizioni di riproduzione. Le fiale possono essere integrate con pasta di lievito e una carta filtrante piegata per aumentare le superfici di accoppiamento potenziali. L'incubazione delle mosche nelle condizioni qui descritte ha prodotto in passato robuste donne premate, ma questo può variare in diversi laboratori e con l'impiego di vari ceppi genetici. Pertanto, può essere necessario ottimizzare la generazione di femmine premate variando il tempo e le condizioni di incubazione.
La quantificazione del comportamento di corteggiamento èUn altro passo critico in questo protocollo. Questo può essere fatto manualmente o automaticamente utilizzando programmi software specializzati 9 . La quantificazione automatizzata è veloce e, in linea di principio, imparziale. Numerosi programmi sono stati pubblicati 21 , 22 , 23 ; Tuttavia, non sono semplici da usare, spesso richiedendo formati video specializzati e abilità computazionali avanzate. La quantificazione manuale è facile e accurata, ma è altamente intensa e soggetta a variabilità individuale e polarizzazione. È importante sottolineare che questo protocollo non affronta i requisiti per la formattazione video che sono potenzialmente necessari per la quantificazione automatizzata dei CI. Per la quantificazione manuale, utilizzare qualsiasi semplice dispositivo di registrazione video che ha il potenziale per produrre un video di qualità sufficiente per osservare con precisione il comportamento di corteggiamento. Per la quantificazione automatica, probabilmente sarà diversoRequisiti in base al software utilizzato e gli utenti dovrebbero indagarli in modo approfondito se si desidera la quantificazione automatica.
In combinazione con gli strumenti estesi disponibili per la manipolazione genetica delle mosche, il test di condizionamento di cortesia fornisce una lettura robusta che può essere usata per disseccare i meccanismi molecolari e le reti neuronali coinvolte nell'apprendimento e nella memoria.
Dichiarazioni
Gli autori non hanno niente da rivelare.
Ringraziamenti
Riconosciamo il Centro Resource Drosophila di Vienna per fornire i ceppi Drosophila . Inoltre, in questo studio sono stati utilizzati i titoli ottenuti dal Bloomington Drosophila Stock Center (NIH P40OD018537). Questa ricerca è stata sostenuta in parte dalla rete integrata Gencodys a KK, HvB e AS della rete FP7 dell'Unione europea e da NSERC Discovery e CIHR Project Grants a JMK
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| P{KK101437}VIE-260B | VDRC | 101437 | Dhat-at-RNAi in 60100 background |
| P{KK108109}VIE-260B | - | - | Control-RNAi in 60100 background (dono di K. Keleman) |
| w+, UAS-dcr2/yhh;; elav-Gal4 (III) | - | - | linea di driver panneuronale |
| Contenitori per la coltura di tessuti vegetali | VWR | 960177 | 175 ml fiale di plastica |
| Filtri piegati | Whatman | 10311643 | Carta da filtro per allargare l'area su cui le mosche possono impuparsi |
| Blocchi a fondo piatto (96 pozzetti) | Qiagen | 19579 | Utilizzato per l'alloggiamento di blocchi |
| MicroAmp Pellicola adesiva trasparente | Applied Biosystems | 4306311 | PCR Pellicola adesiva come coperchio su blocchi a fondo piatto |
| Lama di rasoio | : | qualsiasi affilato andrà bene | |
| Ago | - | - | Aspiratore da 0,8 mm di diametro |
| - | - | Tagliare un puntale per pipetta da 1 ml con le forbici in modo da avere due pezzi. La punta stretta del pipettip è posizionata come ingresso per mosche in un tubo flessibile di ~80 cm. Per evitare che una mosca entri nel tubo, un normale pezzo di cotone o un piccolo sguardo a rete viene posizionato tra la punta e il tubo. L'altra metà del pipettip può essere utilizzata come bocchino all'estremità del tubo. | |
| Camere di corteggiamento | - | il file S1 può essere aperto con il software CAD indicato | |
| Specifiche | Sony | : | >4 milioni di pixel, full HD. Per la quantificazione manuale, qualsiasi semplice dispositivo di registrazione video ha il potenziale per produrre un video di qualità sufficiente per osservare accuratamente il comportamento di corteggiamento. Per la quantificazione automatizzata, ci saranno probabilmente requisiti diversi a seconda del software da utilizzare e gli utenti dovrebbero indagare a fondo se si desidera la quantificazione automatizzata. |
| Name | Azienda | Numero di catalogo | Comments |
| power food | |||
| Agar | Sigma | A7002 | |
| Lievito | Bruggeman-Estratto | ||
| lievito | MP biomedicals | 0210330391 | |
| Peptone | Sigma | P6838 | |
| Saccarosio | Sigma | S9378 | |
| Glucosio | Sigma | G7021 | |
| MgSO4 | Sigma | M2643 | |
| CaCl2 | Merck | 1023780500 | |
| Metilparabene (ATTENZIONE) | Sigma | H5501 | |
| Acido propionico (ATTENZIONE) | Sigma | P1386 | |
| Acqua demineralizzata-pasta | |||
| di lievito-grani di lievito e miscela di acqua in rapporto 1:1 | |||
| Nome | Azienda | Numero di catalogo< | forte>Commenti |
| cibo normale | |||
| Agar | MP biomedicals | 215017890 | |
| Lievito | bruggeman-Farina | ||
| mais | de Molen-Zucchero | ||
| de Molen-Metilparabene | |||
| (ATTENZIONE) | Sigma | H5501 | |
| Acido propionico (ATTENZIONE) | Sigma | P1386 | |
| Acqua demineralizzata | - |
Riferimenti
- Quinn, W. G., Harris, W. A., Benzer, S. Conditioned behavior in Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 71, 708-712 (1974).
- Livingstone, M. S., Sziber, P. P., Quinn, W. G. Loss of calcium/calmodulin responsiveness in adenylate cyclase of rutabaga, a Drosophila learning mutant. Cell. 37, 205-215 (1984).
- Quinn, W. G., Sziber, P. P., Booker, R. The Drosophila memory mutant amnesiac. Nature. 277, 212-214 (1979).
- Dudai, Y., Jan, Y. N., Byers, D., Quinn, W. G., Benzer, S. dunce, a mutant of Drosophila deficient in learning. Proc. Natl. Acad. Sci. USA. 73, 1684-1688 (1976).
- Dubnau, J., Tully, T. Gene discovery in Drosophila: new insights for learning and memory. Annu. Rev. Neurosci. 21, 407-444 (1998).
- Siegel, R. W., Hall, J. C. Conditioned responses in courtship behavior of normal and mutant Drosophila. Proc. Natl. Acad. Sci. USA. 76, 3430-3434 (1979).
- Kamyshev, N. G., Iliadi, K. G., Bragina, J. V. Drosophila conditioned courtship: two ways of testing memory. Learning & memory. 6, 1-20 (1999).
- McBride, S. M., et al. Mushroom body ablation impairs short-term memory and long-term memory of courtship conditioning in Drosophila melanogaster. Neuron. 24, 967-977 (1999).
- Keleman, K., Kruttner, S., Alenius, M., Dickson, B. J. Function of the Drosophila CPEB protein Orb2 in long-term courtship memory. Nature Neurosci. 10, 1587-1593 (2007).
- Hall, J. C. The mating of a fly. Science. 264, 1702-1714 (1994).
- Keleman, K., et al. Dopamine neurons modulate pheromone responses in Drosophila courtship learning. Nature. 489, 145-149 (2012).
- Kramer, J. M., et al. Epigenetic regulation of learning and memory by Drosophila EHMT/G9a. PLoS Biol. 9. 9, e1000569(2011).
- Ishimoto, H., Sakai, T., Kitamoto, T. Ecdysone signaling regulates the formation of long-term courtship memory in adult Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 106, 6381-6386 (2009).
- Kochinke, K., et al. Systematic Phenomics Analysis Deconvolutes Genes Mutated in Intellectual Disability into Biologically Coherent Modules. Am. J. Hum. Genet. 98, 149-164 (2016).
- Buchert, R., et al. A peroxisomal disorder of severe intellectual disability, epilepsy, and cataracts due to fatty acyl-CoA reductase 1 deficiency. Am. J. Hum. Genet. 95, 602-610 (2014).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. Drosophila Maintenance. JoVE. , Cambridge, MA. (2017).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. An Introduction to Drosophila melanogaster. JoVE. , Cambridge, MA. (2017).
- R Core Team. R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. , Vienna (Austria). (2016).
- Stepien, B. K., et al. RNA-binding profiles of Drosophila CPEB proteins Orb and Orb2). Proc. Natl. Acad. Sci. USA. 113, E7030-E7038 (2016).
- Basu, D. Randomization Analysis of Experimental Data: The Fisher Randomization Test. J Am Stat Assoc. 75, 575-582 (1980).
- Dankert, H., Wang, L., Hoopfer, E. D., Anderson, D. J., Perona, P. Automated monitoring and analysis of social behavior in Drosophila. Nat Methods. 6, 297-303 (2009).
- Reza, M. A., et al. Automated analysis of courtship suppression learning and memory in Drosophila melanogaster. Fly. 7, 105-111 (2013).
- Schneider, J., Levine, J. D. Automated identification of social interaction criteria in Drosophila melanogaster. Biol. Lett. 10, 20140749(2014).
Ristampe e permessi
Tag
Saggio di apprendimento e memoriaMisurazione dell'indice di corteggiamentoCalcolo dell'indice di apprendimentoTest della memoria a breve termineTest della memoria a lungo termineAnalisi del knockdown geneticoBootstrapping per il test di randomizzazioneRifiuto delle femmine accoppiateComportamento di corteggiamento maschile
