Un protocollo di estrazione del genoma guidato dalla spettrometria di massa è stabilito e descritto qui. Si basa sulle informazioni sulla sequenza genomica e sull'analisi LC-MS/MS e mira a facilitare l'identificazione di molecole da complessi estratti microbici e vegetali.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Mass Spectrometry-Guided Genome Mining come strumento per scoprire nuovi prodotti naturali
In questo articolo
Sommario
Abstract
Lo spazio chimico coperto da prodotti naturali è immenso e ampiamente non riconosciuto. Pertanto, sono desiderate metodologie convenienti per eseguire una valutazione ad ampio raggio delle loro funzioni in natura e potenziali benefici umani (ad esempio, per applicazioni di scoperta di farmaci). Questo protocollo descrive la combinazione di estrazione del genoma (GM) e networking molecolare (MN), due approcci contemporanei che corrispondono alle annotazioni con codifica a cluster genico nel sequenziamento dell'intero genoma con le firme della struttura chimica da estratti metabolici grezzi. Questo è il primo passo verso la scoperta di nuove entità naturali. Questi concetti, se applicati insieme, sono qui definiti come estrazione genomica guidata da MS. In questo metodo, i componenti principali sono designati in precedenza (utilizzando MN) e i nuovi candidati strutturalmente correlati sono associati alle annotazioni della sequenza del genoma (utilizzando GM). La combinazione di GM e MN è una strategia redditizia per colpire nuove spinadorsali molecolari o raccogliere profili metabolici al fine di identificare analoghi da composti già noti.
Introduzione
Le indagini sul metabolismo secondario spesso consistono nello screening di estratti grezzi per specifiche attività biologiche seguite da purificazione, identificazione e caratterizzazione dei costituenti appartenenti a frazioni attive. Questo processo si è dimostrato efficiente, promuovendo l'isolamento di diverse entità chimiche. Tuttavia, al giorno d'oggi questo è visto come irrealizzabile, principalmente a causa degli alti tassi di riscoperta. Come l'industria farmaceutica rivoluzionato senza conoscenza dei ruoli e le funzioni di metaboliti specializzati, la loro identificazione è stata effettuata in condizioni di laboratorio che non rappresentavano con precisione la natura1. Oggi, c'è una migliore comprensione delle influenze di segnalazione naturale, secrezione, e la presenza della maggior parte degli obiettivi a concentrazioni non rilevabili basse. Inoltre, la regolamentazione del processo aiuterà la comunità accademica e l'industria farmaceutica a trarre vantaggio da queste conoscenze. Ne beneficeranno anche la ricerca che coinvolgerà l'isolamento diretto dei metaboliti legati ai cluster genici biosintetici silenziosi (BCC)2.
In questo contesto, i progressi nel sequenziamento genomico hanno rinnovato l'interesse per i metaboliti dei microrganismi di screening. Questo perché l'analisi delle informazioni genomiche degli ammassi biosintetici scoperti può rivelare geni che codificano nuovi composti non osservati o prodotti in condizioni di laboratorio. Molti progetti o correnti d'aria microbici dell'intero genoma sono oggi disponibili, e il numero è in crescita ogni anno, fornendo enormi prospettive per scoprire nuove molecole bioattive attraverso l'estrazione del genoma3,4.
L'Atlante dei cluster di geni biosintetici è la più grande collezione di cluster genici estratti automaticamente come componente della piattaforma integrata dei genomi microbici del Joint Genome Institute (JGI IMG-ABC)2. Più recentemente, la Minimum Information for Biosynthetic Gene Clusters (MIBiG) Standardization Initiative ha promosso la riannotazione manuale dei BMC, fornendo un set di dati di riferimento altamente curato5. Al giorno d'oggi, sono disponibili molti strumenti per consentire l'estrazione computazionale dei dati genetici e la loro connessione ai metaboliti secondari noti. Sono state inoltre sviluppate diverse strategie per accedere a nuovi prodotti naturali bioattivi (ad esempio, espressione etetologa, cancellazione genica mirata, ricostituzione in vitro, sequenza genomica, screening guidato da isotopi [approccio genomitopico], manipolazione delle autorità di regolamentazione locali e globali, estrazione basata su target di resistenza, estrazione indipendente dalla cultura e, più recentemente, approccio al codiceMS 2,6,7,8,9, 10,11,12,13,14,15).
L'estrazione del genoma come strategia singolare richiede sforzi per annotare un singolo o un piccolo gruppo di molecole; pertanto, permangono lacune nel processo in cui i nuovi composti sono prioritari per l'isolamento e la chiarificazione della struttura. In linea di principio, questi approcci si rivolgono a un solo percorso biosintetico per esperimento, con conseguente rallentamento del tasso di scoperta. In questo senso, l'utilizzo di GM insieme a un approccio di rete molecolare rappresenta un importante progresso per la ricerca sui prodotti naturali14,15.
La versatilità, la precisione e l'elevata sensibilità della spettrometria cromatografica-massa liquida (LC-MS) lo rendono un buon metodo per l'identificazione composta. Attualmente, diverse piattaforme hanno investito algoritmi e suite software per metabolomica non mirata16,17,18,19,20.20 Il nucleo di questi programmi include il rilevamento delle funzionalità (picco di raccolta)21 e l'allineamento di picco, che consente la corrispondenza di funzionalità identiche in un batch di campioni e la ricerca di modelli. Gli algoritmi basati su modelli MS22,,23 confrontano i modelli di frammentazione caratteristici e corrispondono alle somiglianze ms2 generando famiglie molecolari che condividono caratteristiche strutturali. Queste caratteristiche possono quindi essere evidenziate e raggruppate, conferendo la capacità di scoprire rapidamente molecole note e sconosciute da un complesso estratto biologico in tandem MS2,24,25. Pertanto, la SM in tandem è un metodo versatile per ottenere informazioni strutturali su diversi chemiotipi contenuti contemporaneamente in una grande quantità di dati.
L'algoritmo Global Natural Products Social Molecular Networking (GNPS)26 utilizza l'intensità degli ioni di frammento normalizzati per costruire vettori multidimensionali, in cui le somiglianze vengono confrontate utilizzando una funzione coseno. La relazione tra i diversi ioni padre viene tracciata in una rappresentazione del diagramma, in cui ogni frammentazione viene visualizzata come nodo (cerchi) e la correlazione di ogni nodo è definita da uno spigolo (linee). La visualizzazione globale delle molecole provenienti da un'unica fonte è definita come una rete molecolare. Molecole strutturalmente divergenti che si frammentano in modo univoco formeranno il proprio ammasso o costellazione specifica, mentre le molecole correlate si raggruppano. I chemiotipi di clustering consentono l'ipotetica connessione di caratteristiche strutturali simili alle loro origini biosintetiche.
La combinazione di approcci chemiotipo-genotipo e genotipo è potente quando si creano collegamenti bioinformatici tra BCC e i loro piccoli prodotti molecolari27. Pertanto, l'estrazione del genoma guidata dalla MS è un metodo rapido e una strategia a basso consumo di materiali e aiuta a colmare gli ioni dei genitori e le vie biosintetiche rivelate dal WGS di uno o più ceppi in diverse condizioni metaboliche e ambientali.
Il flusso di lavoro di questo protocollo (Figura 1) consiste nell'inserire i dati WGS in una piattaforma di annotazione del cluster di geni biosintetici come antiSMASH28,29,30. Aiuta a stimare la varietà di composti e la classe di composti codificati dal genoma. Deve essere adottata una strategia per colpire un cluster di geni biosintetici che codifica un'entità chimica di interesse, e gli estratti di coltura da un ceppo di tipo selvaggio e/o ceppo eteboloso contenente il BGC possono essere analizzati per generare ioni raggruppati in base alle somiglianze utilizzando GNPS26,31. Di conseguenza, è possibile identificare nuove molecole che si associano al BGC mirato e non sono disponibili nel database (principalmente analoghi sconosciuti, a volte prodotti in elementi bassi). È importante considerare che gli utenti possono contribuire a queste piattaforme e che la disponibilità di bioinformatica e dati MS/MS sta aumentando rapidamente, spingendo a uno sviluppo costante e l'aggiornamento di strumenti e algoritmi computazionali efficaci per guidare connessioni efficienti di estratti complessi con molecole.
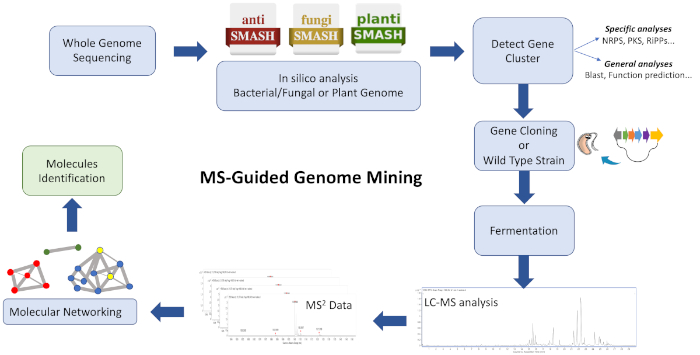
Figura 1: Panoramica dell'intero flusso di lavoro. È mostrato un'illustrazione delle fasi bioinformatiche, clonazione e networking molecolare coinvolte nell'approccio descritto nell'estrazione del genoma guidato dalla Ms per identificare nuovi metaboliti. Fare clic qui per visualizzare una versione più grande di questa figura.
Questo protocollo descrive un flusso di lavoro rapido ed efficiente per combinare l'estrazione del genoma e la rete molecolare come punto di partenza per la pipeline di scoperta naturale dei prodotti. Anche se molte applicazioni sono in grado di visualizzare la composizione e la relatedness delle molecole rilevabili dalla MS in una rete, diverse sono adottate qui per visualizzare molecole raggruppate strutturalmente simili. Utilizzando questa strategia, vengono identificati con successo nuovi prodotti ciclodepsipeptide osservati negli estratti metabolici di Streptomyces sp. CBMAI 2042. Guidato dall'estrazione del genoma, l'intera codifica del cluster genico biosintetico per le valiomiciche è riconosciuta e clonata nel ceppo produttore Streptomices coelicolor M1146. Infine, a seguito di una rete molecolare basata su modelli di SM, le molecole rilevate dalla SM sono correlate con i BMC responsabili della loro biogenesi32.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
1. Estrazione del genoma per cluster genici biosintetici
- Eseguire il sequenziamento dell'intero genoma (WGS) come primo passo per eleggere un cluster genico biosintetico (BCG) per l'estrazione del genoma guidata dalla MS. L'intero genoma del ceppo di interesse (batteri) può essere ottenuto dalla tecnologia Illumina MiSeq utilizzando quanto segue con DNA genomico di alta qualità: fucile TruSeq PCR-Free library prep e Nextera Mate Pair Library Preparation Kit33.
NOTA: dopo la sequenza, è possibile assemblare la libreria del fucile Illumina e la libreria della coppia di accoppiamenti Illuminazione utilizzando Newbler v3.0 (Roche, 454) programma assembler (disponibile all'indirizzo ) e annotato utilizzando una pipeline basata su FgeneSB (disponibile all'indirizzo ), come descritto in precedenza33. Microbiology Resource Announcements (MRA) è una rivista ad accesso aperto con articoli che pubblicano la disponibilità di qualsiasi risorsa microbiologica depositata in un repository disponibile (disponibile all'indirizzo ). I geni candidati per la codifica delle proteine vengono identificati utilizzando l'annotazione del server RAST34e il progetto Whole Genome Shotgun (WGS) viene depositato nel dDBJ/ENA/GenBank (trovato in ) e Gold (disponibile nella sequenza ). - Per ottenere in silico informazioni sul metabolismo secondario cluster annotazioni da un genoma sequenziato completo, inviare il file di sequenza (formato GenBank/EMBL o FASTA) a una piattaforma antiSMASH (trovato a ).
- Selezionare il cluster genico di interesse dai dati di output (Figura 2) in base al cluster conosciuto più simile.
NOTA: In primo luogo, è di routine esplorare gene per gene e condurre ricerche individuali (blastp) per valutare quali funzioni sono associate ai gruppi genici biosintetici desiderati. Questa procedura può anche aiutare a determinare quale BGC è probabilmente associato con la produzione di un composto desiderato, anche se si tratta di una percentuale bassa. Una previsione antiSMASH considera tutti i geni all'interno di un cluster per fare una copertura percentuale, che può rappresentare una bassa percentuale globale di somiglianza per il BGC mirato. Tuttavia, quando si analizza gene per gene, è possibile ottenere informazioni più accurate utilizzando il cluster conosciuto più simile. In secondo luogo, antiSMASH ha due opzioni per affinare una ricerca: 1) rigore di rilevamento: il grado di rigore a cui il cluster genico biosintetico deve essere considerato un colpo. Per questa opzione, l'utente deve utilizzare i seguenti parametri: a) rigorosi: rileva cluster esclusivamente ben definiti contenenti tutte le regioni richieste, insuscettibile agli errori relativi alle informazioni genetiche; b) rilassato: rileva cluster parziali privi di una o più regioni funzionali, che funziona anche per rilevare la caratteristica rigorosa; o c) loose: rileva cluster e cluster mal definiti che probabilmente corrispondono ai metaboliti primari, il che può portare alla comparsa di falsi positivi o di BGC mal definiti. L'altra opzione è 2) caratteristiche extra: il tipo di informazioni che la piattaforma deve cercare e mostrare nell'output. In generale, queste due opzioni possono risparmiare tempo dopo la stima. Tuttavia, il lavoro antiSMASH richiede un periodo di tempo più lungo.
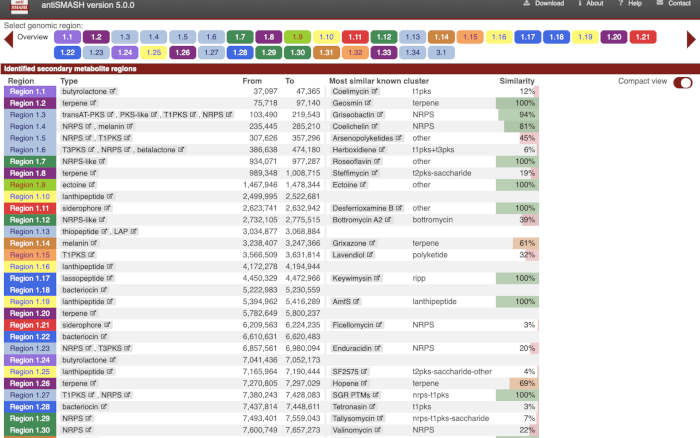
Figura 2: Output dalla piattaforma antiSMASH. Metabolismo secondario nell'analisi del silico dall'annotazione della sequenza dell'intero genoma. Fare clic qui per visualizzare una versione più grande di questa figura.
- Sulla base delle informazioni sulla sequenza del DNA del BGC, i primer di progettazione (20-25 nt) che fiancheggiano il cluster genico per lo screening della biblioteca ESAC (E. coli/Streptomyces Artificial Chromosome).
NOTA: diversi metodi35,36 possono essere utilizzati per catturare l'intero cluster genico biosintetico dal DNA. In questo caso, il metodo utilizzato è la costruzione di una biblioteca ESAC rappresentativa37,38 da Streptomyces sp. CBMAI 2042 contenente cloni con frammenti di dimensioni medie di 95 kb.
2. Espressione etetologa dell'intero cluster di geni biosintetici della biblioteca ESAC
- Spostare il vettore ESAC da E. coli DH10B a E. coli ET12567 con la coniugazione triparentale32.
- Inoclate A. coli ET12567 (CamR), TOPO10/pR9604 (CarbR), DH10B/ESAC4H (AprR) in 5 mL di Luria-Bertani (LB) mezzo contenente cloramramhenicol (25 g/mL), carbenicillina (100g/mL) e apramycina (50 g/mL).
- Incubare la coltura durante la notte a 37 e 250 giri/min.
- Inoculare 500 - L della coltura notturna in 10 mL di lB medio contenente una mezza concentrazione di antibiotici.
- Incubare la coltura a 37 e 250 giri/min fino a raggiungere un600 A di 0,4-0,6.
- Raccogliere le cellule per centrifugazione a 2.200 x g per 5 min.
- Lavare le cellule due volte con 20 mL di lB medio.
- Risospendere le cellule in 500 , l di lB medio.
- Mescolare 20 l di ogni ceppo in un tubo di microcentrifuga e gocciolare in una piastra di agar con mezzi LB privi di antibiotici.
- Incubare le piastre a 37 gradi durante la notte.
- Streak le cellule coltivate su una piastra di agar LB fresca contenente antibiotici e incubare a 37 gradi centigradi durante la notte.
3. Streptomici/E. coli coniugazione
- Per ottenere l'organismo eterologia ricombinante, eseguire la coniugazione32 tra E. coli ET12567 contenente il vettore ESAC, il plasmid e l'aiutante pR9604 e streptomice coelique M1146 o un altro ceppo host selezionato39.
- Giorno 1: inoculare colonie isolate di S. coelicolor M1146 in 25 mL di mezzo TSBY in una fiaschetta Erlenmeyer da 250 ml dotata di una molla inossidabile a 30 e 200 rpm per 48 h.
- Giorno 2/3: Inoculare ET12567/ESAC/pR9604 in 5 mL di lB medio contenente cloramfenicolo (25 g/mL), carbenicillina (100g/mL) e apramicina (50 g/mL) durante la notte a 37 e 250 mL.
- Giorno 3/4: Inoculare 500 - L della coltura notturna in 10 mL di 2TY (in un tubo conico da 50 mL) contenente concentrazioni semi-lavoratrici di antibiotici. Incubare a 37 e 250 giri/min fino a raggiungere un600 A di 0,4-0,6.
- Centrifugare le colture (ET12567/ESAC/pR9604 e M1146) a 2200 x g per 10 min.
- Lavare i pellet 2x in 20 mL di mezzo 2TY e risospendere in 500 gradi l 2TY.
- Aliquota 200 L della s. coelicolor M1146 sospensione e diluire in 500 L di 2TY (sospensione A).
- Aliquota 200 - L di sospensione A e diluire in 500 -L di 2TY (sospensione B).
- Aliquota 200 - Dissoluta di sospensione B e diluita in 500 - L di 2TY (sospensione C).
- Aliquota 200 -L delle sospensioni ET12567/ESAC/pR9604 e mescolare con 200 - L di sospensione C.
- Piastra 150 -L della miscela di coniugazione su una piastra di agar SFM priva di antibiotici.
- Incubare a 30 gradi centigradi per 16 ore.
- Piastre di copertura con 1 mL di soluzione antibiotica (secondo la resistenza plasmide). Dopo l'essiccazione, incubare a 30 gradi centigradi per 4-7 giorni.
NOTA: Qui è stata preparata una soluzione contenente 1,0 mg/mL thiostrepton e 0,5 mg/mL di acido nalidixico. - Streak putative exconjugants su piastre di agar SFM contenenti thiostrepton (50 mg/mL) e acido nalidixic (25 mg/mL). Incubare a 30 gradi centigradi.
- Streak exjugants su un agar SFM contenente solo acido nalidixico.
- Eseguire l'analisi PCR con colonie isolate per confermare che l'intero cluster genico è stato trasferito all'ospite S. coelicolor M1146.
4. Coltivazione della deformazione
- Per ottenere il profilo metabolico, inoculare 1/100 della pre-coltura del ceppo in adeguati mezzi di fermentazione e nelle condizioni di coltura appropriate.
- Centrifuga colture a 2200 x g per 10 min.
- Eseguire l'estrazione in base alla classe del composto di interesse40.
5. Acquisizione di spettri di massa e preparazione per l'analisi GNPS
- Per acquisire i dati MS/MS, programmare i metodi HPLC e di spettrometria di massa adatti utilizzando il software di controllo. È possibile analizzare sia l'analisi della spettrometria di massa dipendente dai dati ad alta che a bassa risoluzione (DDA).
NOTA: Generalmente, una soluzione da 1 mg/mL di complessi campioni di estratti grezzi è l'ideale. Le diluizioni sono necessarie per estratti meno complessi. Va notato che la rete MS/MS è la rete molecolare rilevabile in base alle condizioni spettrometriche di massa specificate. - Convertire gli spettri di massa in formato .mzXML utilizzando MSConvert da Proteowizard (disponibile all'indirizzo ). I parametri di input per la conversione sono illustrati nella Figura 3. I dati provenienti dal software di quasi tutte le aziende sono compatibili.
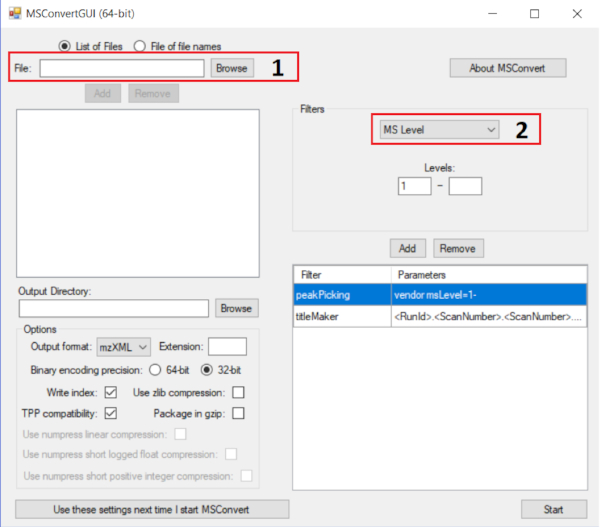
Figura 3: Utilizzo di MsConvert per convertire i file MS in mzXML estensione. Viene visualizzato il parametro corretto per l'analisi GNPS. Le istruzioni sono le seguenti: aggiungi tutti i file MS nella casella 1 e aggiungi il filtro Picco picking nella casella 2; per questo filtro, utilizzare il fornitore dell'algoritmo; premere start e seguiranno i processi di conversione. Fare clic qui per visualizzare una versione più grande di questa figura.
- Caricare i file LC-MS/MS convertiti nel database GNPS. Sono disponibili due opzioni: utilizzando un protocollo di trasferimento file (FTP) o direttamente in un browser attraverso la piattaforma online.
NOTA: informazioni dettagliate su come installare e trasferire dati in GNPS sono disponibili all'indirizzo .
6. Analisi dei GNPS
- Dopo aver creato un account in GNPS (disponibile all'indirizzo ), selezionare Crea rete molecolare. Aggiungere una posizione lavorativa.
- Opzioni di base: selezionare i file mzXML per eseguire la rete molecolare. Possono essere organizzati in un massimo di sei gruppi. Selezionare le librerie per la routine di dereplica (Figura 4).
NOTA: questi gruppi non interferiscono con la costruzione di reti molecolari. Queste informazioni verranno utilizzate solo per la rappresentazione grafica.
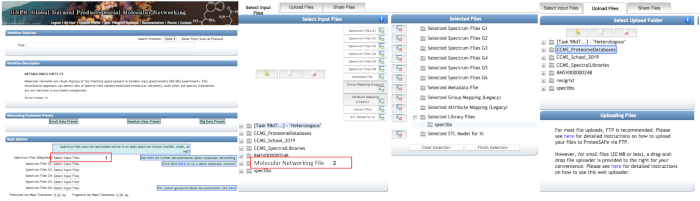
Figura 4: Utilizzo della piattaforma GNPS online per eseguire l'analisi della rete molecolare. La selezione dei file mzXML viene eseguita facendo clic nella casella 1. Nella finestra di dialogo Apri, i file possono essere selezionati dalla cartella personale (casella 2) o essere caricati nella seconda scheda utilizzando il caricatore di file drag-and-drop (meno di 20 MB). I file possono essere raggruppati in un massimo di sei gruppi. Fare clic qui per visualizzare una versione più grande di questa figura.
- Selezionare la tolleranza di massa iosprecursore e la tolleranza di massa iosone a frammentazione rispettivamente di 0,02 Da e 0,05 Da.
NOTA: GNPS dispone di diversi tipi di rigore disponibili in base a 1) quanto siano accurati i dati MS/MS e 2) quanto deve essere accurata l'associazione. Opzioni di base: in questa cartella, è possibile impostare Precursor Ion Mass Tolerance e Fragment Ion Mass Tolerance. Questi parametri sono utilizzati come guida per determinare quanto deve essere preciso lo ione precursore e lo ione di frammentazione. Le tolleranze di massa selezionate dipendono dalla risoluzione e dall'accuratezza dello spettrometro di massa utilizzato. - Opzioni di rete avanzate: selezionare i parametri in base alla figura 5. Questi parametri influenzano direttamente le dimensioni e la forma del cluster di rete. Un altro parametro nella sezione schede rimanenti sono per gli utenti avanzati; pertanto, lasciare i valori predefiniti.
NOTA: i parametri avanzati possono essere letti nella documentazione di GNPS (disponibile all'indirizzo ).
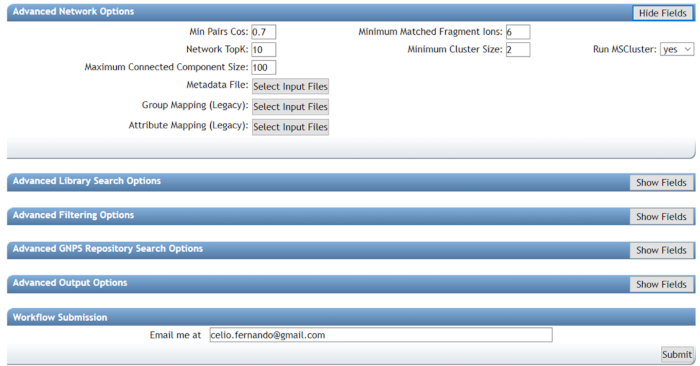
Figura 5: Utilizzo di GNPS per eseguire l'analisi della rete molecolare (opzioni avanzate). Min Pair Cos influenzerà direttamente le dimensioni dei cluster, poiché valori elevati si tradurrà nella combinazione di composti strettamente correlati e valori bassi nella combinazione di composti distanti correlati. L'utilizzo di valori troppo bassi dovrebbe essere evitato. Gli ioni di frammento con partita minima rappresentano il numero di frammenti condivisi tra due spettri di frammentazione da collegare nella rete. Insieme, entrambi i parametri guidano il formato di rete; composti inferiori si raggruppano composti più distanti e viceversa. Utilizzando i valori appropriati aiuterà notevolmente il chiarimento composto. Fare clic qui per visualizzare una versione più grande di questa figura.
- Scegliere un indirizzo di posta elettronica per ricevere un avviso al termine del lavoro e inviare il processo.
7. Analisi dei risultati del PNL
- Accedere a GNPS. Selezionare Processi > Processo pubblicato > Fine per aprire il processo. Verrà aperta una pagina Web, come illustrato nella figura 6. Verranno visualizzati tutti i risultati ottenuti dalla rete molecolare.
- Selezionare Visualizza famiglie spectrali (nel visualizzatore di rete del browser) per visualizzare tutti i cluster di rete (casella rossa, figura 6).
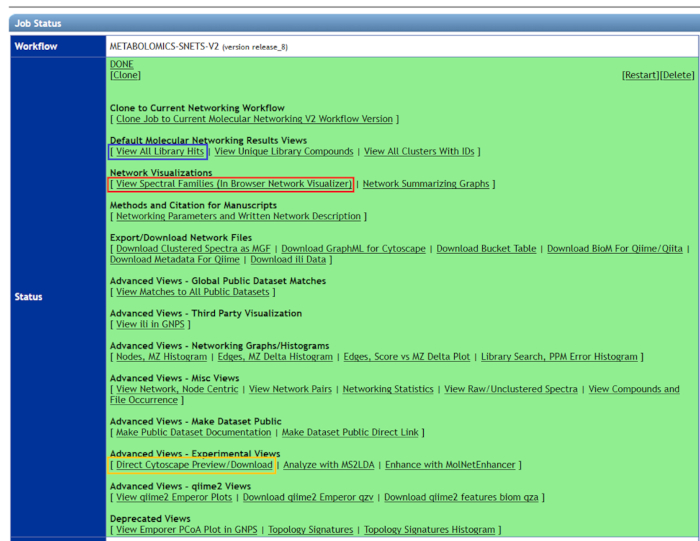
Figura 6: Utilizzo di GNPS per visualizzare i risultati della rete molecolare. Tutti i cluster composti correlati possono essere visualizzati nelle famiglie spettrali di visualizzazione (scatola rossa). Per visualizzare solo gli hit della libreria, è necessario selezionare "Visualizza tutti gli hit della libreria" (casella blu). Per una migliore rappresentazione grafica dei risultati della rete molecolare, è necessario scaricare "Direct Cytoscape Preview" (scatola gialla) e utilizzare l'ultima versione di Cytoscape. Fare clic qui per visualizzare una versione più grande di questa figura.
- Verrà visualizzato un elenco con tutti i cluster di reti molecolari generate. Se è stata selezionata una ricerca nella libreria per generare i risultati, l'identificazione provvisoria delle molecole verrà visualizzata in AllID. Selezionare Mostra per visualizzarli.
NOTA: Le analisi dei dati possono essere guidate per altri risultati (ad esempio, l'estrazione del genoma, i saggi biologici, le molecole di dereplicazione della biblioteca, ecc.). - Per analizzare il cluster di rete molecolare, selezionare Visualizza rete.
NOTA: Ogni cluster è composto da nodi (cerchi) e bordi, che rappresentano rispettivamente molecole e somiglianza molecolare. Le molecole dereplicate saranno evidenziate come un nodo blu nel visualizzatore di rete del browser online. - Nella casella etichette nodo selezionare la massa padre (casella rossa, figura 7).
- Nella casella Etichette spigolose, selezionare Cosine o DeltaM per osservare rispettivamente la somiglianza o la differenza di massa tra i nodi (casella gialla, Figura 7).
- Nel caso di analisi a più gruppi, fare clic su Disegna torte nella casella di colorazione del nodo per osservare la frequenza con cui ogni nodo viene visualizzato in ogni gruppo (casella blu, Figura 7).
NOTA: Sono possibili altre scelte, ma quelle suggerite in precedenza sono ottimali per annotare i nodi del cluster e svelare le proprie strutture.
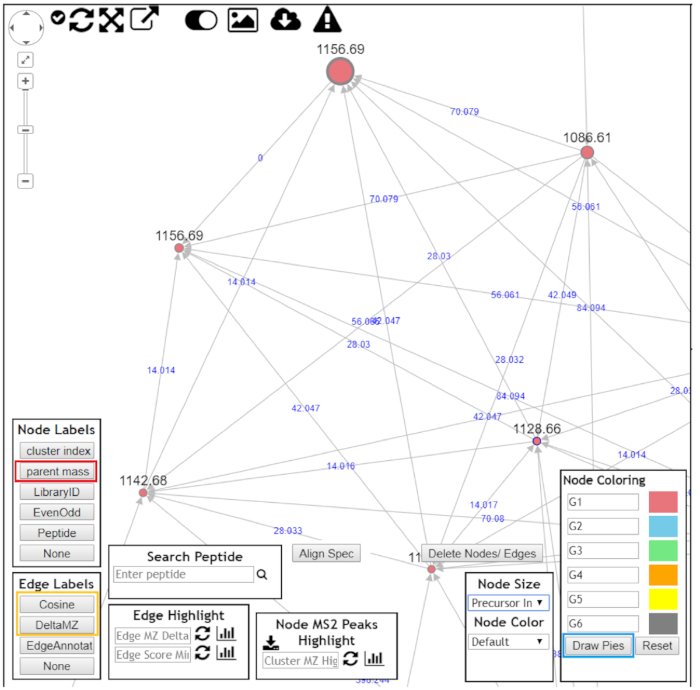
Figura 7: Utilizzo di GNPS per visualizzare i risultati del cluster molecolare. Dopo aver aperto i cluster molecolari per una migliore visualizzazione dei dati, è necessario scegliere quanto segue: "Massa padre" come etichette dei nodi (casella rossa); Come etichette di bordo (casella gialla); e "Disegna torte" come colorazione del nodo (casella blu). Navigare attraverso il cluster molecolare e cercare di annotare tutti i nodi. Fare clic qui per visualizzare una versione più grande di questa figura.
- Per visualizzare tutti gli hit della libreria, selezionare Visualizza tutti gli hit della libreria (casella blu, Figura 7).
NOTA: Inoltre, il MNW può essere scaricato in "Direct Cytoscape Preview/Download" (scatola gialla, Figura 7),e il file può essere aperto nella piattaforma Cytoscape (che si trova a ) per ulteriori opzioni nella struttura grafica. - Sono necessarie la conferma manuale dei composti dereplicati e la chiarificazione della struttura dei composti correlati. Aprire gli spettri di frammentazione direttamente nella piattaforma GNPS o nei file raw originali.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Il protocollo è stato esemplificato con successo utilizzando una combinazione di estrazione del genoma, espressione etetologa e approcci MS-guidato/codice per accedere a nuove molecole specializzate di analoghi di valinomicina. Il flusso di lavoro genoma-molecola per il bersaglio, la valiomicina (VLM), è rappresentato nella Figura 8. Il genoma del progetto CBMAI 2042 è stato analizzato in silico e il cluster genico VLM è stato quindi identificato e trasferito in un ospite etelogoo. ...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Il vantaggio più forte di questo protocollo è la sua capacità di dereplicare rapidamente i profili metabolici e le informazioni genomiche del ponte con i dati MS al fine di chiarire le strutture di nuove molecole, in particolare analoghi strutturali2. Sulla base di informazioni genomiche, è possibile studiare chemiotipi di prodotti naturali diversi, come i polionidi (PK), i peptidi non ribonsuici (NRP) e i prodotti naturali glicosillati (GNP), nonché gli screening metabolomici criptici. Così, un B...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno nulla da rivelare.
Ringraziamenti
Il sostegno finanziario a questo studio è stato fornito dalla Fondazione ricerca di San Paolo - FAPESP (2019/10564-5, 2014/12727-5 e 2014/50249-8 a L.G.O; 2013/12598-8 e 2015/01013-4 a R.S.; e 2019/08853-9 a C.F.F.A). B.S.P, C.F.F.A. e L.G.O. hanno ricevuto borse di studio dal Consiglio nazionale per lo sviluppo scientifico e tecnologico - CNPq (205729/2018-5, 162191/2015-4 e 313492/2017-4). L.G.O. è anche grato per il sostegno alla borsa di studio fornito dal programma For Women in Science (2008, edizione brasiliana). Tutti gli autori riconoscono CAPES (Coordinamento per il Miglioramento del Personale per l'Istruzione Superiore) per aver sostenuto i programmi post-laurea in Brasile.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Acetonitrile | Tedia | AA1120-048 | HPLC grado |
| Agar | Oxoid | LP0011 | NA |
| Apramicina | Sigma Aldrich | A2024 | NA |
| Carbenicillina | Sigma Aldrich | C9231 | NA |
| Centrifuga | Eppendorf | NA | 5804 |
| Cloramfenicolo | Sigma Aldrich | C3175 | NA |
| Colonna C18 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2,1 x 50 mm, 1,8 µ m, limite di pressione 1200 bar Art. 757700-902 |
| Kanamicina | Sigma Aldrich | K1377 | NA |
| Manitol P.A.- A.C.S. | Synth | NA | |
| NA Microcentrifuga | Eppendorf | NA | 5418 |
| Acido nalidixico | Sigma Aldrich | N4382 | NA |
| Phusion Flash PCR ad alta fedeltà Master Mix | ThermoFisher Scientific | F548S | NA |
| Q-TOF spettrometro di massa | Agilent technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| Sacarosio P.A.- A.C.S. | Synth | NA | NA |
| Shaker/Incubator | Marconi | MA420 | NA |
| Cloruro di sodio | Synth | NA | P. A. - ACS Estratto di |
| soia | NA | NA | NA |
| Saccarosio | Synth | NA | P. A. - ACS |
| Cicli termici | Eppendorf | NA | Mastercycler Nexus Gradient |
| Thiostrepton | Sigma Aldrich | T8902 | NA |
| Triptone | Oxoid | LP0042 | NA |
| Triptone Brodo di soia | Oxoid | CM0129 | NA |
| UPLC | Agilent Technologies | NA | 1290 Infinity LC System |
| Estratto di lievito | Oxoid | LP0021 | NA |
Riferimenti
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Ristampe e permessi
