Qui descriviamo un adattamento ad alto rendimento di un saggio di stabilità colloidale di anticorpi su larga scala per generare grandi dataset e supportare previsioni di sviluppabilità pronte per IA/ML.
Articolo metodologico
Misurazioni Ultradiluite Automatizzate dell'Auto-Associazione per l'Identificazione di Anticorpi con Proprietà Favorevoli di Soluzione ad Alta Concentrazione
In questo articolo
Sommario
Abstract
Una delle principali sfide nell'ingegneria degli anticorpi è lo sviluppo di metodi analitici di screening per valutare la stabilità colloidale, assicurando che i biologici siano adatti alla formulazione e somministrazione ad alta concentrazione. La spettroscopia di nanoparticelle auto-interazione stabilizzata con carica (CS-SINS), una versione modificata della convenzionale spettroscopia di nanoparticelle di auto-interazione per cattura di affinità (AC-SINS), è stata adattata come una robusta valutazione della stabilità colloidale per prevedere il comportamento della soluzione ad alta concentrazione. Questo metodo consente decisioni critiche di sviluppabilità nelle fasi iniziali identificando problemi di stabilità colloidale prima che vengano investite risorse significative, riducendo notevolmente i tassi di abbandimento a valle e accelerando i tempi di selezione dei candidati. Questo studio dimostra che il saggio si integra perfettamente nei flussi di lavoro di scoperta esistenti e può essere eseguito in parallelo con i tipici saghi in fase iniziale grazie ai requisiti minimi di campionamento, fornendo dati preziosi per prevedere comportamenti ad alta concentrazione senza compromettere altri sforzi di caratterizzazione. È stato dimostrato che le misurazioni di diffusione dinamica della luce (DLS) di routine, oltre allo spostamento della lunghezza d'onda della risonanza plasmonica, possono migliorare l'affidabilità del metodo HTP descritto qui. Nel complesso, si prevede che la validazione incrociata tramite misurazioni DLS e programmi di analisi automatica faciliterà la selezione affidabile di terapie anticorpali candidate di varie modalità.
Introduzione
Nello sviluppo e nella formulazione di anticorpi terapeutici, opalescenza e viscosità sono considerazioni chiave nello sviluppo di un prodotto commerciale incentrato sulpaziente 1,2,3,4,5,6,7,8. Classicamente, sono necessarie grandi quantità di proteine per osservare direttamente queste proprietà ad alte concentrazioni, impedendo di fatto un'identificazione ottimale dei piombi nelle prime fasi della scoperta degli anticorpi, dove la disponibilità proteica è limitata. L'identificazione affidabile di questi fenomeni è fondamentale per le valutazioni di sviluppabilità volte a mitigare un cattivo comportamento di soluzioni ad alta concentrazione avalle 1,2,3,4,5,6,7,8. Di conseguenza, esiste un interesse significativo per metodi ad alto rendimento e bassa concentrazione che prevedono un comportamento scadente della soluzione ad alteconcentrazioni 9,10,11,12,13,14,15,16. Uno di questi metodi, kD-DLS, si è dimostrato affidabile nel prevedere proprietà ad alta concentrazione ma non soddisfa i bassi consumi proteici e i requisiti di alta produttività dei flussi di lavoro in faseiniziale 12,13.
Recentemente, un saggio a base di nanoparticelle d'oro a consumo ultrabasso noto come CS-SINS ha dimostrato avere una forte correlazione con i risultati degli esperimenti kD-DLS ed è ragionevolmente efficace nel prevedere le scarse proprietà della soluzione ad altaconcentrazione 16. Queste caratteristiche rendono CS-SINS un candidato ideale per lo sviluppo come strumento di screening ad alta produttività. Il saggio CS-SINS utilizza un anticorpo di cattura immobilizzato sulle superfici di nanoparticelle d'oro per ancorare gli anticorpi candidati attraverso le loro regioni Fc, lasciando i bracci Fab accessibili alle interazioni della soluzione. Questa configurazione significa che le interazioni Fab-Fab dominano il segnale di auto-associazione misurato, il che è vantaggioso poiché gli studi indicano che i domini Fab contribuiscono prevalentemente alle caratteristiche di auto-associazione mAb, probabilmente a causa delle proprietà superficiali della regione determinante la complementarità(CDR) 17,18,19,20,21,22,23 . Questa base meccanicistica rende CS-SINS particolarmente adatto a prevedere i rischi di stabilità colloidale rilevanti per formulazioni ad alta concentrazione. Metodi HTP alternativi, tra cui la cromatografia monostrato in piedi (SMAC), un approccio basato su colonne per cromatografia a esclusione di dimensioni (SEC) che imita l'auto-associazione con una fase stazionaria generica, e la cromatografia a interazione incrociata (CIC), prevedono la preparazione della colonna e requisiti di campioni grandi 17,24,25,26,27.
Il metodo descritto qui dettaglia una configurazione validata su lastra del test CS-SINS e consente lo screening HTP tramite automazione e analisi di laboratorio, combinando i vantaggi dei metodi esistenti migliorando l'affidabilità dei risultati. Questo studio dimostra anche come vari tipi di campione producano risultati di alta qualità grazie alla natura dell'arricchimento dell'auto-interazione nel saggio, stabilendo che il metodo è agnostico rispetto alle fonti proteiche. Inoltre, consideriamo come una comunicazione anticipata delle proprietà colloidali ai team di progetto possa ulteriormente supportare la progettazione strategica di farmaci anticorpalimultispecifici 28,29,30,31,32,33,34.
Lo studio delle proprietà della soluzione ad alta concentrazione viene tipicamente svolto a valle in campagne multispecifiche di selezione dei candidati, dopo la selezione dei lead e il completamento dell'ingegneria (Figura 1A). La previsione precoce di queste proprietà è diventata fattibile con metodi come il CS-SINS che richiedono pochi microgrammi di campione, prevedendo così i rischi di stabilità colloidale con misurazioniultradiluite 16. L'introduzione dello screening precoce della capacità di sviluppo (Figura 1A), quando il pool di candidati è ampio, e campagne parallele di generazione dati sia per formati monospecifici che multispecifici potrebbero informare meglio il processo di scoperta del farmaco31,32. HTP CS-SINS si inserisce nel paradigma esistente di screening delle molecole in parallelo al legame e alla determinazione della funzione, aggiungendo così al pacchetto informativo senza interrompere o rallentare i flussi di lavoro esistenti. La selezione dei candidati principali, con enfasi sulle proprietà colloidali favorevoli, influenzerà la progressione della selezione come rappresentato nella Figura 1B.
Nel flusso di lavoro proposto per lo screening della capacità di sviluppo iniziale, l'identificazione dei lead considera il quadro completo delle proprietà favorevoli del farmaco, inclusa la produzione e l'accesso dei pazienti, semplificando così lo sviluppo avalle 34. Le proprietà ad alta concentrazione dei biologici possono determinarne la via di somministrazione: iniezioni endovenose che richiedono visite ospedaliere o iniezioni sottocutanee, che possono essere somministrate a casa dal paziente, ma spesso richiedono un prodotto ad altaconcentrazione 35,36. I mab sviluppabili con bassa auto-associazione sono spesso formulati a >100 mg/mL 5,35. L'ottimizzazione della formulazione tramite escipienti, come agenti visco-riducenti, può superare i rischi di stabilità colloidale per candidati desiderabili con scarse proprietà di soluzione nelle fasi di sviluppoCMC 34,35. Tuttavia, ciò introduce sfide a valle nella produzione biofarmaceutica e aumenta i tempi per l'approvazione di un farmacodi successo 36. Gli excipienti noti per abbassare la viscosità (come sali e amminoacidi) possono anche influenzare la stabilità delle proteine, alterando i profili di sviluppabilità precedentemente caratterizzati e complicando ulteriormente ilprocesso 36,37. Inoltre, eccessi eccessivi possono limitare la popolazione di pazienti a causa di considerazioni di immunogenicità, varie preoccupazioni di sicurezza o influenzare l'aderenza al trattamento e introdurre nuove sfide nello spazioproduttivo 38,39,40. Starr et al. pubblicarono per la prima volta il metodo CS-SINS, descrivendo la frazione massica ottimale di PLL e IgG come 0,03 e confermando la stabilizzazione delle nanoparticelle tramite misurazioni del potenziale zeta per l'auto-associazione di mAb nelle formulazionidi istidina 16. In particolare, aggiungere troppa PLL crea sovrastabilizzazione nel saggio e impedisce l'osservazione dell'auto-interazione del mAb (il miglioramento della stabilità delle nanoparticelle d'oro tramite PLL è illustrato nella Figura Supplementare 1). L'uso di formulazioni di istidina senza sale minimizza lo screening elettrostatico (aumentando la lunghezza di Debye), estendendo così la gamma delle interazioni intermolecolari, amplificando così segnali deboli di auto-associazione e imitando comportamenti ad alta concentrazione quando gli anticorpi sono più vicini. In generale, le formulazioni a bassa forza ionica sono preferite per quelle ad alta concentrazione in cui non si osserva l'auto-associazione.
I grandi polimeri PLL impediscono l'occupazione di più mAbs di cattura sulle superfici delle nanoparticelle d'oro, restringendo così la finestra di spostamento plasmonico e richiedendo un programma di adattamento delle curve più sofisticato e un'analisi per l'analisi successiva dei dati. Questo studio ha utilizzato uno strumento di portale web che si sincronizza con i database interni. Il principale vantaggio di questo costo iniziale è il potenziale di costruzione dati di un ampio pool di sequenze per massimizzare la diversità dei candidati a valle e mitigare i colli di bottiglia nelle fasi di sviluppo piùcostose 34, 35, 36. Il saggio CS-SINS che descriviamo qui si distingue come un metodo compatibile con HTP, che si è dimostrato correlare bene con i saggi di stabilità colloidalein fase avanzata 16. È in corso una profilazione assistita dall'IA per la progettazione attenta di multispecifici per i programmi futuri e per la comprensione dei contributi individuali di ciascun dominio in formaticomplessi 41,42,43,44. Questi sforzi influenzeranno collettivamente le meta-analisi e una determinazione più dettagliata delle proprietà di stabilità coloidale per le terapie con anticorpi, risparmiando quindi tempo nelle prime fasi di R&S.
Protocollo
La Figura 2 mostra la preparazione della coniugazione delle nanoparticelle, la Figura 3 mostra il flusso di lavoro nella sua interezza, la Figura 4 traccia il processo di automazione in laboratorio, e la Figura 5 contiene un diagramma della pipeline di analisi dei dati. I reagenti e le attrezzature utilizzate sono elencati nella Tabella dei Materiali.
1. Preparazione dei tamponi
NOTA: Settimana 1 (preparazione del campione)
- Prepara istidina (10 mM), pH 6,0 (campione e tampone per il saggio).
NOTA: Questi passaggi vengono eseguiti il giorno 1.- Sciogliere 5 mM di L-istidina monocloridrato e 5 mM di L-istidina in acqua ultrapura. Aggiungere acido cloridrico a goccia durante la mescola finché il pH non raggiunge 6,0, misurato con un misuratore calibrato.
- Filtrare la soluzione attraverso un filtro poroso di 0,22 μm sotto vuoto e raccogliere il filtrato in una bottiglia sterile.
- Misurare la conducibilità per scopi di controllo qualità e assicurarsi una lettura di circa 500 μS/cm.
- Prepara acetato di potassio (20 mM), pH 4,3 (tampone di coniugazione cattura mAb).
- Sciogli l'acetato di potassio in acqua ultrapura e regola il pH a 4,3 con acido acetico glaciale.
- Sterilizza la soluzione tramite filtrazione sottovuoto attraverso un filtro di 0,22 μm di dimensione poro come descritto nel passaggio 1.1.2.
- Prepara la poli-L-lisina.
- Prepara una soluzione di brodo da 5 mg/mL in acqua ultrapura e conserva a −20 °C fino all'uso.
2. Dialisi di tutti i campioni (candidati mAbs)
NOTA: Esegui questi passaggi nei giorni 2–5.
- Pre-ammollare 100 μL o 300 μL dializzatori in 10 mM di istadina, pH 6,0, per 5 minuti.
- Trasferire tutti i campioni (50–100 μL) su cassette per dialisi. Immergi le cassette in un buffer di istidina da 10 mM, pH 6,0 (700 mL per scatola), aggiungi barre di agitazione ai serbatoi, posiziona i serbatoi su piastre magnetiche di agitazione e incuba a 4 °C per 2 ore e 15 minuti.
- Eseguire sette scambi di tampone con istidina da 10 mM, pH 6,0, ogni 2 ore e 15 minuti, oppure quattro scambi tampone notturni per garantire una completa rimozione del sale dai campioni.
- Recuperare i campioni, trasferirli in fiale a matrice pulita e conservare a 4 °C fino a quando non viene eseguito il test CS-SINS.
- Misura le concentrazioni del campione e registra le informazioni sulla polidispersione dopo la dialisi. Calcola le concentrazioni corrette dividendo i valori grezza di assorbenza a 280 nm per l'assorbanza a 280 nm per una soluzione da 1 mg/mL.
- Prepara il file di input del gestore di liquidi con gli indirizzi del pozzo e le concentrazioni (μg/mL), inclusi i controlli.
3. Scambio buffer di cattura mAb (Figura 2, passo 1)
NOTA: Esegui questi passaggi al giorno 1 della seconda settimana (analisi).
- Rimuovere il tampone di stoccaggio dalle colonne di desalinizzazione da 2 mL centrifugando per 2 minuti a 1.000 × g a temperatura ambiente. Preparare due colonne di desalinizzazione per ogni 700 μL di mAb di cattura richiesti. Scartare il flusso di passaggio dopo ogni passaggio di centrifugazione.
- Lavare le colonne tre volte con 1 mL di tampone di acetato di potassio da 20 mM, pH 4,3. Centrifuga le colonne per 2 minuti a 1.000 × g durante ogni lavaggio.
- Aggiungi 700 μL di mAb di cattura (anticorpo anti-umano specifico Fcγ) a ciascuna colonna e eludi in un tubo fresco da 15 mL centrifugando per 2 minuti a 1.000 × g.
- Raccogli l'eluato desalinato, applicalo a una seconda colonna di desalinizzazione equilibrata e centrifuga per altri 2 minuti a 1.000 × g.
- Combina tutti i campioni eluti.
- Misurare la concentrazione della soluzione di mAb di cattura dopo la desalinizzazione come descritto nei giorni 2–5, passo 2.5.
- Diluire la soluzione di stocco di capture mAb a 0,8 mg/mL con 20 mM di tampone di acetato di potassio, pH 4,3, e mettere da parte fino all'uso.
4. Preparazione di un materiale di lavoro di poli-L-lisina
- Diluire una piccola aliquota della soluzione stock di poli-L-lisina a 2,66 mg/mL con acqua ultrapura.
5. Concentrazione di nanoparticelle d'oro (Figura 2, passo 2)
- Preparare 1,2 mL aliquote della sospensione originale in tubi da 1 mL o aliquote da 4,8 mL in tubi da 5 mL utilizzando tubi microcentrifughe in polipropilene contenenti nanoparticelle d'oro da 20 nm. Centrifuga a 21.130 × g per 6 minuti.
- Rimuovere i sopranattivi (~1,1–1,15 mL) senza disturbare i pellet e trasferirli in un tubo conico separato.
- Combina i pellet concentrati e i volumi residui in un tubo microcentrifuga pulito. Determinare il volume delle nanoparticelle tramite pipetto e regolare il volume a (numero di tubi da 1 mL × 50 μL) oppure (numero di tubi da 5 mL × 200 μL) usando il sovrantantante riservato. Ad esempio, dopo aver centrifugato 10 aliquote di 1,2 mL in tubi da 1 mL, si regola il volume finale delle nanoparticelle concentrate a 500 μL.
6. Assemblaggio di nanoparticelle
- Mescolare accuratamente 1,5 μL della soluzione lavorativa poli-L-lisina con 48,5 μL del mAb di cattura scambiato in tampone (Figura 2, passo 3).
- Prepara una miscela 1:1 della soluzione concentrata di nanoparticelle del passo 5 e della soluzione poli-L-lisina/cattura mAb del passaggio 6.1 (Figura 2, passo 4).
- Incubare la miscela durante la notte a temperatura ambiente (23 °C) (Figura 2, passo 5).
7. Installazione della piastra per il saggio del manipolatore di liquidi
NOTA: Esegui questi passaggi al giorno 2.
- Compilare i materiali necessari per il saggio, inclusi anticorpi dializzati, il file di input del liquid-handler contenente le concentrazioni post-dialisi, nanoparticelle d'oro coniugate, punte per la manipolazione robotica, piastre e serbatoi (Figura 3, Automazione di laboratorio, passo 1). Precarica punte, campioni, piastre e serbatoi sul ponte secondo la disposizione mostrata nella Figura 3 (Automazione del laboratorio, passo 1).
- Aggiungi i controlli ai pozzi A12–D12 della piastra campionaria (due controlli positivi e due controlli negativi). Lascia il pozzo H12 vuoto per il campione tampone preparato dal responsabile del liquido.
- Apri il metodo del liquid-handler CS-SINS e avvia il programma (Figura 3, Automazione del Laboratorio, passaggi 2–3). Carica il file di input del liquid-handler quando richiesto e inserisci il numero di campioni (Figura 4A). Rivedere le due finestre successive di controllo di calcolo (Figura 4B, C), confermare i valori e procedere con l'esecuzione.
- Normalizzare i campioni, inclusi i controlli, a 55,5 μg/mL in un tampone di istidina da 10 mM, pH 6,0, trasferendoli dai tubi del campione della matrice alla piastra di reazione a catena della polimerasi in un volume finale di 100 μL (Figura 4D, passo 1). Monitorare i progressi, notando che le aree completate appaiono grigie e i passi attivi sono evidenziati in verde (Figura 4E).
- Preparare una diluizione di volume maggiore di ciascun campione a 11,1 μg/mL in un tampone di istidina da 10 mM, pH 6,0, trasferendo materiale dalla piastra di reazione a catena della polimerasi a un blocco di pozzo profondo a un volume finale di 200 μL (Figura 4D, passo 2).
- Permette al sistema di mettere in pausa dopo il passaggio 2. Quando richiesto, miscela le nanoparticelle d'oro concentrate preparate nel passaggio 6.3 invertendo il tubo e pipettando su e giù circa 10 volte.
- Distribuire le nanoparticelle in modo uniforme tra due tubi microcentrifughe in polipropilene e posizionare i tubi, con i tappi aperti, nella posizione designata del rack dei tubi sul ponte (Figura 4D, evidenziata "AuNP"). Riprendere la corsa e lasciare che il manipolatore di liquidi dispensi 20 μL di nanoparticelle in ciascun pozzo del secondo blocco di pozzo profondo, due pozzi alla volta (Figura 4D, passo 3).
- Lasciare che il manipolatore di liquidi trasferisca 192 μL di campione dal blocco del pozzo profondo contenente i campioni da 11,1 μg/mL (Figura 4D, passo 2) al secondo blocco del pozzo profondo e mescolare accuratamente. Generare un mastermix CS-SINS di 4× per ogni campione, ottenendo una concentrazione finale di 10 μg/mL dopo l'aggiunta di 48 μL di nanoparticelle d'oro a un volume finale di 240 μL (Figura 4D, passo 3). A questo punto inizia il timer di incubazione di 4 ore.
- Si lascia che il manipolatore di liquidi eroghi 30 μL nel pozzo sorgente e poi 60 μL in tre dei quattro pozzi di ciascun quadrante di una piastra da 384 pozzi per generare triplicati tecnici per ogni campione (Figura 4D, passo 4). Restituire i restanti 30 μL alla piastra sorgente.
- Monitora la disposizione del ponte dei gestori di liquidi man mano che la corsa procede. Osserva le punte utilizzate e i pozzi di campione riempiti che passano dal grigio chiaro al grigio scuro in tempo reale, mentre i movimenti attivi sono indicati in verde (Figura 4E).
- Rimuovi la piastra dopo aver completato la corsa. Sigilla la piastra con una sigilla trasparente minimamente adesiva e incuba a temperatura ambiente per un totale di 4 ore. Al punto di tempo di 3,5 ore, avviare il programma di scattering dinamico della luce per bilanciare la camera a 20 °C utilizzando le impostazioni mostrate nella Figura Supplementare 2.
- Misurare lo spettro di assorbanza di ciascun pozzo da 510 a 570 nm in incrementi di 1 nm (30 nm su ciascun lato del picco) nel punto temporale di 4 ore.
- Misura immediatamente la piastra usando il lettore di lastre a scattering dinamico della luce nel punto temporale di 4,5 ore con le impostazioni mostrate nella Figura Supplementare 2.
NOTA: Utilizzare un lettore di lastre ad alte prestazioni per le misurazioni spettrali a causa della gamma dinamica limitata. Non usare la funzione di lettura veloce.
8. Analisi dei dati (Figura 5, Schema di elaborazione dei dati)
- Esporta i file grezzi dalla piattaforma dello spettrofotometro e salvali in una cartella accessibile per l'unità.
- Accedi al portale web di scripting collegato al server interno. Inserire i parametri di input richiesti di CS-SINS, inclusi: (1) lunghezza d'onda iniziale; (2) Posizione della directory del file grezzo dei risultati; (3) Set di targhe e identificatori candidati; (4) indirizzi dei pozzi di controllo positivo e negativo per la normalizzazione; (5) designazione di impostazione del metodo ("Manuale" o "Liquido handler"); (6) Strumenti utilizzati per la scansione spettrale e le misurazioni dinamiche di diffusione della luce; (7) Identificatore del quaderno elettronico di laboratorio (ELN); (8) Data di acquisizione.
- Invia i parametri al portale web e verifica che tre file Excel siano generati in una sottocartella della directory raw-results.
- Calcola i valori λmax utilizzando lo script di adattamento delle curve eseguito dal portale web.
- Rivedi i due file di output contenenti valori replicati, risultati normalizzati e grafici rappresentativi per la scansione spettrale e le misurazioni di scattering dinamico della luce.
- Utilizzare il terzo file di output, contenente i metadati del saggio e i risultati normalizzati, per creare risultati di laboratorio in massa nell'interfaccia utente del database. Definire gli attributi di reportistica in base ai requisiti specifici del gruppo e caricare i risultati nel database per consentire l'accesso a livello aziendale.
Risultati
La Figura 6 mostra i risultati, la Figura Supplementare 3A mostra un esempio di punteggio CS-SINS da un campione rappresentativo di grezzo e purificato, la Figura Supplementare 3B mostra la variabilità del segnale da pozzo a pozzo in giorni diversi, la Figura Supplementare 4 contiene i risultati del processo di validazione delle lastre, e la Figura Supplementare 5 descrive il calcolo della normalizzazione per entrambe le letture CS-SINS.
È importante sottolineare che i campioni sono stati raccolti con concentrazioni riportate di almeno 55 μg/mL dopo la dialisi in 10 mM di istidina, pH 6,0, per garantire la fattibilità del saggio, poiché questa è la concentrazione minima dello stock (un minimo di 6 μg per campione) e hanno creato nuovi identificatori figli. In totale, c'erano 70 campioni purificati e 20 campioni di espressione grezza, ciascuno rappresentando tipi di campione in diversi punti di controllo di sviluppabilità (purificati nella fase di ottimizzazione del piombo e materiale grezzo purificato in 1 o 2 fasi dalla fase di identificazione del piombo evidenziato nella Figura 1A). Il materiale grezzo è stato generato da un sistema di espressione mammiferico completamente automatizzato, la Protein Expression and Purification Platform (PEPP; GNF, San Diego, CA, USA). I controlli erano derivati da materiali commerciali e precedentemente validati come aventi valori di viscosità massima o minima, kD-DLS e CS-SINS. Le aliquote fresche vengono conservate a -80°C e per ogni analisi viene utilizzata una nuova aliquota.
Le Figure 6A,B mostrano i punteggi medi spettrali e DLS tracciati per tipo di campione, e i grafici a barre mostrano barre di errore (deviazione standard) con codici colore corrispondenti. La normalizzazione viene calcolata dallo script dividendo la differenza tra il campione e i valori di controllo negativi (calcolato lambda max per spostamento spettrale o media Z, diametro idrodinamico in nm) per la differenza tra i controlli (Figura supplementare 5). La Figura 6C rappresenta i punteggi spettrali rispetto ai punteggi DLS, mostrando una chiara correlazione tra gli approcci analitici. La Tabella 1 elenca gli identificatori, gli indirizzi dei pozzi, il tipo di campione, i punteggi spettrali e i punteggi DLS insieme alle loro deviazioni standard per riferimento. La soglia per il rischio di stabilità colloidale (indipendentemente dalla lettura spettrale o DLS) per un IgG monospecifico è qualsiasi valore superiore a un valore normalizzato di 0,35 (indicato da una linea tratteggiata verde nella Figura 6A,B), 6/70 (escludendo i controlli replicati) i campioni purificati hanno ottenuto un punteggio ad alto rischio, mentre 64/70 ha ottenuto un punteggio basso per il materiale purificato. È importante sottolineare che ci aspettiamo che il cutoff tenda più alto per i formati multispecifici. Per i campioni di espressione grezza, 2 su 20 campioni hanno ottenuto un punteggio alto, mentre 18 su 20 ha ottenuto un punteggio basso. Tra i materiali purificati testati qui, è stata anche selezionata l'espressione grezza dei lotti genitori di un sottoinsieme che ha prodotto risultati simili (illustrati nella Figura Supplementare 3A), indicando la natura rappresentativa del saggio al momento della scala (purificazione) delle proteine candidate da lotti indipendenti. Nonostante le dimensioni dei campioni limitanti, si nota che l'errore standard può tendere a salire per i campioni PEPP grezzi rispetto a quelli purificati. Il vantaggio di eseguire CS-SINS nelle fasi avanzate garantisce che valutazioni ortogonali possano essere effettuate con saghi che richiedono più proteine per l'analisi, come misurazioni di viscosità e kD-DLS, mentre il beneficio di eseguire CS-SINS in screening di sviluppabilità precoce affronta preventivamente i rischi di stabilità colloidale, influenzando potenzialmente il pool finale di candidati lead (Figura 1B). I candidati borderline con alto errore possono essere confermati come ad alto o basso rischio con analisi a valle.
A causa della natura ridotta degli spostamenti plasmonici rilevati, è stata descritta una lettura alternativa per infondere fiducia nel saggio, ampliando così la gamma dinamica, il che potrebbe rivelarsi particolarmente utile in assenza di un lettore di lastre di fascia alta per rilevare i minimi cambiamenti. La lettura DLS distingue tra clustering di nanoparticelle e dipendenza dalle proprietà spettrali delle nanoparticelle; tuttavia, entrambi i descrittori hanno intervalli di errore standard simili e sono piccoli rispetto alle loro misure. Sembra che i campioni più soggetti a letture di valori anomali abbiano un errore più alto (o siano "multimodali" e non riportino un risultato tramite DLS), ma i valori CS-SINS all'interno dell'intervallo di lavoro del saggio presentano basse distribuzioni di errore. Quando si confrontano i valori DLS con i valori dei punteggi spettrali, la distribuzione degli errori è più stretta per i risultati DLS prelevati da campioni grezzi rispetto ai punteggi spettrali; tuttavia, questo ha fatto la differenza solo per un candidato che scendeva sotto la soglia come punteggio DLS ma non come punteggio spettrale. Questo potrebbe rivelarsi utile se i laboratori disponessero di strumenti diversi.
Per affrontare specificamente l'affidabilità dell'elaborazione dei dati e del metodo stesso, i tempi di scansione sono stati modificati end-to-end sia per le letture dei controlli positivi che negativi nel dataset sopra, oltre a molteplici controlli medi e bassi che fungevano da punti di riferimento intermedi all'inizio e alla fine di una piastra a 384 pozzi. La Figura Supplementare 4 mostra i risultati della validazione finale della targa, mostrando valori per lo più insignificanti tra i campioni posti all'inizio e quelli alla fine della targa (Figura Supplementare 4A,B) e un'alta correlazione tra entrambi i valori di lettura (Figura Supplementare 4C). Infine, il fattore Z e la percentuale di CV sono stati calcolati per i controlli dalla scansione spettrale e dal dataset DLS nella Figura 6. Dai dati generati per i controlli e presentati qui, la lettura della scansione spettrale è stata determinata avere un fattore Z di 0,648, con 0,019% di CV per il controllo positivo e 0,012% per il controllo negativo. Per la lettura DLS è stato calcolato un fattore Z di 0,998, con 0,025% di CV per il controllo positivo e 0,021% per il controllo negativo. Nel complesso, il coefficiente di correlazione di Spearman tra i valori campionari in questo saggio (Figura 6C) è stato calcolato come fortemente positivo a 0,829. Questi valori rappresentano una solida precisione e riproducibilità per entrambi i tipi di misura e, non sorprende, la nuova strategia di rilevamento DLS vantaggiosa ottimizza il fattore Z, ma la scansione spettrale fornisce una banda di separazione sufficiente per registrare risultati affidabili (Z > 0,5). È importante notare che il punteggio DLS è una lettura ortogonale raccolta simultaneamente nel flusso di lavoro CS-SINS, senza richiedere preparazione aggiuntiva del campione. La differenza maggiore nei valori per i punteggi DLS grezzi spiega un miglioramento del fattore Z, ma i "punteggi" sono interpretati allo stesso modo perché sono normalizzati dai valori grezzi. Inoltre, le letture DLS catturano dimensioni tridimensionali degli ammassi di nanoparticelle rispetto a indicazioni indirette di prossimità dovute allo spostamento plasmonico e alle informazioni spettrali, il che potrebbe rafforzare la nostra comprensione della dinamica del saggio CS-SINS. Considerando la natura basata su lastre e temporalmente critica di un saggio HTP, abbiamo puntato ad aumentare l'affidabilità del saggio con questi metodi.
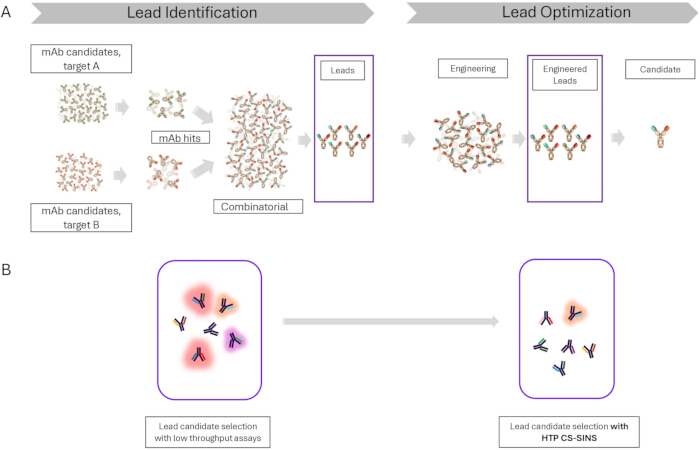
Figura 1: Paradigma di sviluppabilità e raccolta dati CS-SINS. (A) Il flusso di lavoro tipico da una campagna di scoperta alla selezione dei candidati è rappresentato per gli anticorpi multispecifici in questo diagramma. Il processo di discovery porta a candidati monospecifici da selezionare, seguiti da una selezione da vari pacchetti dati per restringere i monospecifici di interesse prima di combinarli in formati multispecifici. I pacchetti dati vengono ripetuti o ampliati per restringere i candidati principali fino a quando non viene scelto il miglior candidato per lo sviluppo. Saggi a bassa portata vengono eseguiti nel flusso di lavoro corrente quando viene selezionato un piccolo pannello di molecole (scatole viola). Le HTP CS-SINS possono essere eseguite in ogni fase del percorso, aggiungendo dati preziosi e migliorando il processo di selezione. (B) L'esito ipotetico delle proprietà colloidali per i primi 6 candidati viene mostrato per 2 possibili percorsi: selezione dei candidati principali con saghi a basso rendimento e selezione dei candidati principali con HTP CS-SINS. I candidati con comportamento sfavorevole di soluzione sono rappresentati con un bagliore. Nel primo scenario, metà dei candidati principali basati sulle caratteristiche di legame ottimali degli schermi di scoperta mostra un comportamento ad alta concentrazione scarso. Nel secondo scenario, è incluso solo 1 candidato con stabilità colloidale moderatamente scarsa, perché i dati CS-SINS sono stati considerati in parallelo ai dati di legame negli schermi di scoperta precoce. Nel secondo scenario, la diversità dei potenziali candidati validi è maggiore rispetto al primo. Clicca qui per visualizzare una versione più grande di questa figura.
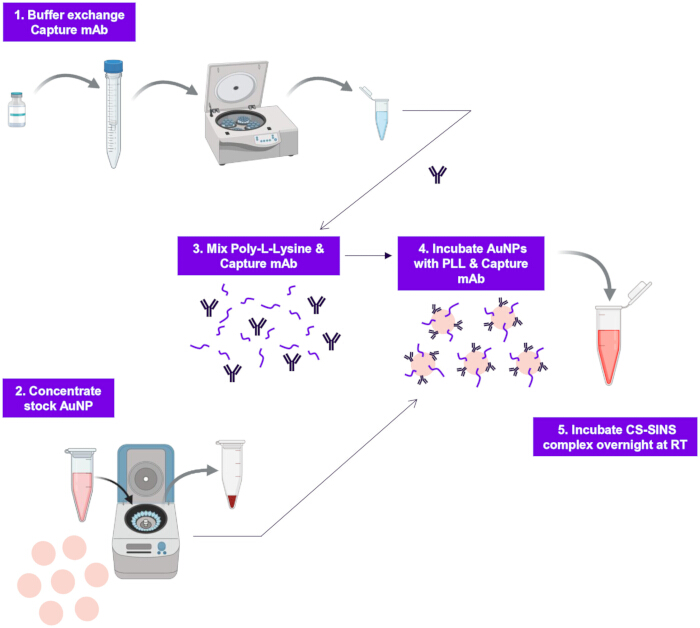
Figura 2: flusso di lavoro del saggio SINS. Preparazione e coniugazione delle nanoparticelle d'oro: (1) Il mAb di cattura viene scambiato in tampone in 20 mM di acetato di potassio, pH 4,3, e diluito a 0,8 mg/mL. (2) Le nanoparticelle d'oro sono concentrate dalla serie. (3) La poli-l-lisina viene miscelata con il mAb di cattura scambiato tramite buffer. (4) Le nanoparticelle d'oro vengono incubate con la poli-l-lisina e catturano mAb, e vengono miscelate accuratamente. (5) Incubazione del complesso CS-SINS durante la notte a temperatura ambiente. Clicca qui per visualizzare una versione più grande di questa figura.
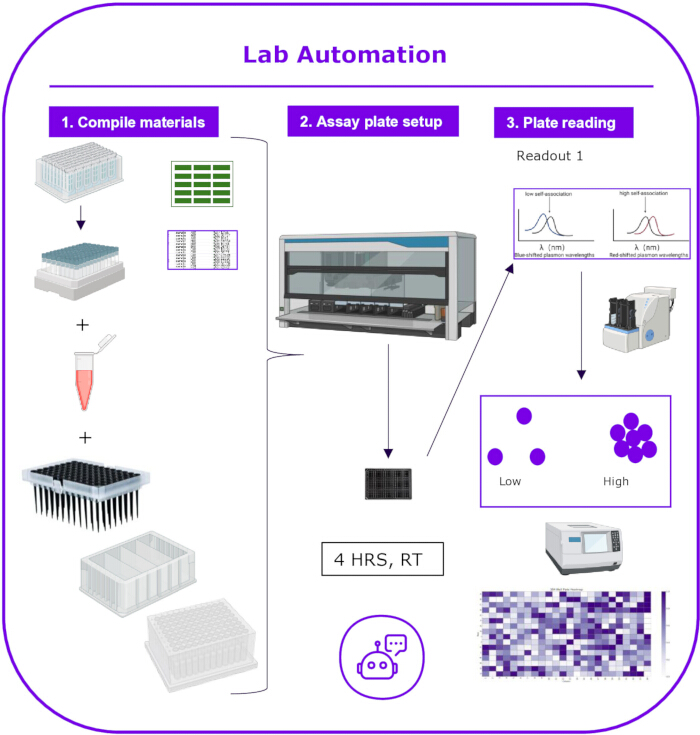
Figura 3: Flusso di lavoro di automazione in laboratorio. Flusso di lavoro di automazione in laboratorio: (1) Materiali e campioni vengono compilati per il metodo del liquid handler. Campioni dialisi in istidina da 10 mM, pH 6, vengono raccolti in tubi a matrice o piastre a 96 pozzi. Le concentrazioni dei campioni sono formattate in un file di input del gestore di liquidi. Nanoparticelle d'oro complesse CS-SINS coniugate per catturare mAb, punte robotiche per la gestione dei liquidi e oggetti in plastica vengono raccolti in preparazione per la preparazione del test del trattamento dei liquidi. (2) La piastra per il saggio viene preparata sul manipolatore di liquidi e incubata per 4 ore a temperatura ambiente. 3) Al minuto 4, vengono raccolte scansioni spettrali (lettura 1) da pozzi campione per una durata di 25 minuti; Dopo il traguardo delle 4,5 ore, la diffusione dinamica della luce (lettura 2) raccoglie informazioni sulle dimensioni di ogni popolazione di pozzi più uniforme. Clicca qui per visualizzare una versione più grande di questa figura.
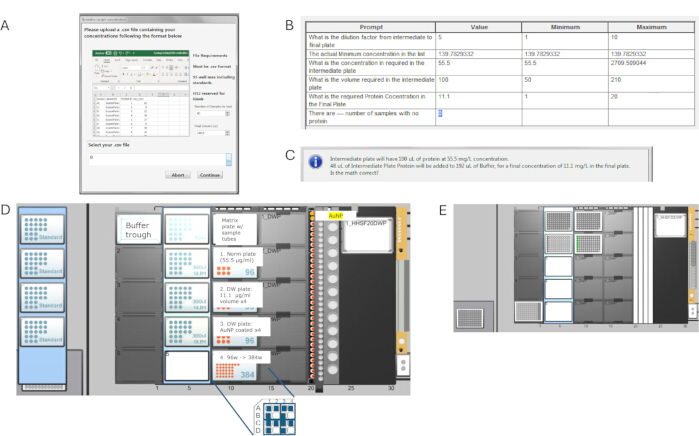
Figura 4: Programma di gestione liquido e configurazione della piastra. (A) All'avvio del programma e dopo l'inizializzazione del sistema, si aprirà una finestra/prompt separato per selezionare il file di input con gli indirizzi del pozzo designati e le concentrazioni del campione. Il numero di campioni deve essere specificato ogni volta, ma il volume di 200 μL (il volume finale dei reagenti misti prima della stampatura a 384 pozzi) rimane invariato. (B) Dopo aver cliccato su continua dalla finestra precedente in (A), questa seconda finestra apparirà per confermare le interpretazioni dal file di input a sinistra e dai valori a destra. (C) Dopo aver confermato le interpretazioni da (B), appare questa terza finestra con una finestra di dialogo che verifica due volte la matematica per la concentrazione del campione per la normalizzazione (il volume di 100 μL) verso la piastra finale del pozzo profondo (il volume da 200 μL). (D) Questa disposizione proviene dalla visuale Method Editor del modulo software di gestione liquidi. A sinistra sono caricate punte standard da 300 μL, e al centro del palco sono caricate 1 scatola da 50 μL e 3 scatole di punte sottili da 300 μL, compatibili con la robotica per la gestione dei liquidi. Una vasca tampone è caricata nella parte anteriore con 10 mM di istidina, pH 6 (il tampone in cui i campioni sono stati dializzato). Le nanoparticelle d'oro sono divise equamente in 2 tubi microcentrifughe e caricate, senza tappo, nella parte posteriore del rack dei tubi a destra. La piastra matriciale con i tubi campione viene caricata nella parte posteriore del portante nella colonna 10. Dopo i campioni, sono indicate la piastra di normalizzazione (1), la piastra del pozzo profondo con campione da 11,1 μg/mL (2), la piastra di pozzo profonda da 200 μL del campione combinato e le nanoparticelle (3), e la lastra formattata a 384 pozzi (4). (E) La disposizione del ponte del maneggiatore di liquidi mostra il recupero delle punte e la distribuzione dei campioni in tempo reale e segna i pozzi man mano che procede ogni passaggio. Qui, tutti i campioni (immagine a 96 pozzi sul retro del portante nellaterza colonna) sono in grigio così come la successiva piastra di normalizzazione, il che indica che i campioni sono stati aggiunti alla piastra di normalizzazione dalle piastre matriciali sorgente. In verde, mostriamo la testa a 8 canali dopo aver aspirato il tampone dalla mangiata e averlo dispensato nella prima colonna della piastra di normalizzazione durante la miscelazione. Clicca qui per visualizzare una versione più grande di questa figura.
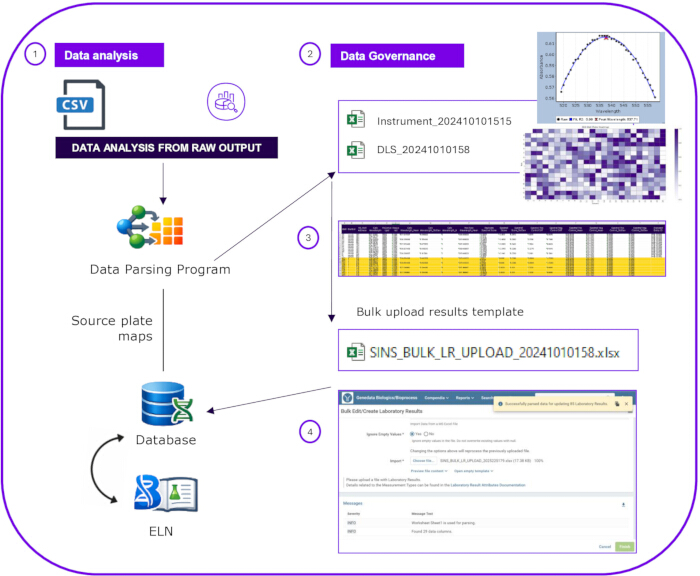
Figura 5: Schema di elaborazione dei dati. Lo schema di elaborazione dei dati: (1) I file di dati grezzi vengono inviati a un server interno. (2) I file dati vengono letti e processati da uno script personalizzato per affinare l'adattamento delle curve delle scansioni spettrali, calcolare il lambda max per repliche CS-SINS e verificare le popolazioni multimodali tramite DLS. (3) I dati vengono raggruppati per repliche, poi successivamente mediati e normalizzati su controlli specificati; Le mappe a lastre corrispondenti nel portale del database sono reperite per collegare i risultati. (4) Tutti i dati sono organizzati in un template pronto per essere caricato nel database, e i grafici vengono creati automaticamente per la reportistica ELN. Clicca qui per visualizzare una versione più grande di questa figura.
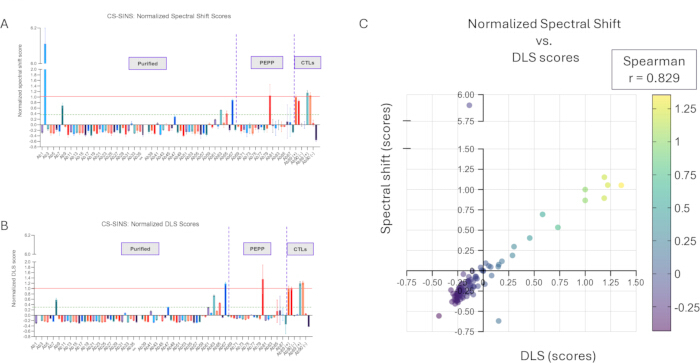
Figura 6: Dati rappresentativi della lettura 1 e della lettura 2. (A) I punteggi di spostamento spettrale normalizzati sono stati tracciati tramite PPB ID per campioni purificati, a espressione grezza, e campioni di controllo dove indicato e separati da una linea tratteggiata verticale, in un grafico a barre a barre per determinare la distribuzione delle barre di errore tra i tipi di campioni. La linea rossa continua indica il limite superiore del saggio, che corrisponde al controllo positivo, mentre la linea tratteggiata verde indica il valore di soglia per un profilo molecole a basso rischio per CS-SINS. (B) I punteggi DLS normalizzati sono stati tracciati da PPB ID per campioni di espressione purificati, grezza e campioni di controllo, dove indicato e separato da una linea tratteggiata, in un grafico a barre per determinare la distribuzione delle barre di errore tra i tipi di campioni. Alcuni valori sono mancanti (come ilsecondo valore in azzurro chiaro con un punteggio superiore alla media in (A)) a causa delle scansioni multimodali dall'output DLS, che il portale web del software di scripting ha dichiarato invalido. La linea rossa continua indica il limite superiore del saggio, che corrisponde al controllo positivo, mentre la linea tratteggiata verde indica il valore di soglia per un profilo molecole a basso rischio per CS-SINS. (C) I punteggi mediati e normalizzati per i valori dello spostamento spettrale e del DLS sono stati confrontati tramite un grafico di punti di correlazione, come mostrato (i punteggi di spostamento spettrale corrispondono all'asse Y e i punteggi DLS corrispondono all'asse X). Il codice colore è coordinato solo con i punteggi DLS. Clicca qui per visualizzare una versione più grande di questa figura.
Tabella 1. Punteggi di stabilità coloidale dei campioni di anticorpi determinati da CS-SINS. La tabella riassume gli identificatori dei campioni, gli indirizzi dei pozzi, le classificazioni dei campioni, i punteggi spettrali normalizzati e i punteggi di diffusione dinamica della luce (DLS) ottenuti dal saggio CS-SINS. Clicca qui per scaricare questa tabella.
Figura supplementare 1: PLL ha migliorato la stabilità dell'AuNP in 10 mM di suo tampone, pH 6, per CS-SINS. Questa figura mostra la sovrapposizione ravvicinata del mAb di controllo negativo legato al complesso CS-SINS rivestito con PLL e al controllo solo buffer, in contrasto con nanoparticelle d'oro non rivestite con il controllo negativo mAb o buffer da solo, che hanno picchi in intervalli completamente diversi. In blu sono mostrate le scansioni spettrali incrementali (effettuate a incrementi di 1 nm nel momento di 4 ore) per AuNP coniugato incubato con 10 mM Il suo buffer sovrapposto a perle coniugate incubate con il controllo negativo (PPB-117487) in assenza di una pre-incubazione di poli-l-lisina. In rosso sono mostrate le scansioni spettrali incrementali (effettuate in incrementi di 1 nm al punto temporale di 4 ore) per AuNP coniugato incubato con 10 mM. Il suo buffer sovrapposto con perle coniugate incubate con il controllo negativo (PPB-117487) dopo la pre-incubazione della poli-l-lisina. Il lambda max calcolato per entrambi i controlli negativi in presenza di PLL sono molto vicini. Clicca qui per scaricare questo file.
Figura supplementare 2: Impostazioni per DLS e selezione della piastra di pozzo per il lettore di targhe DLS. Clicca qui per scaricare questo file.
Figura supplementare 3: Punteggi CS-SINS da ABS espressi in PEPP rispetto a quelli purificati a valle. (A) I punteggi di spostamento spettrale normalizzati sono stati tracciati tramite pozzo e ID di piastra per campioni PEPP (ad esempio, A1PL1 = pozzo A1 dalla lastra 1) che esprimono Ab64 e separati da una linea tratteggiata verticale dal normalizzato spostamento spettrale o dai punteggi DLS di Ab64 purificati a valle, in un grafico a barre a barre per determinare la distribuzione delle barre di errore (deviazione standard) tra i tipi di campioni. La linea tratteggiata verde segna il valore di soglia per un profilo molecoleale a basso rischio per CS-SINS. (B) L'AUC totale e la distribuzione sulla piastra per tutti i campioni degli esperimenti eseguiti in (A) sono qui tracciati (codificati a colori per gli esperimenti corrispondenti). Clicca qui per scaricare questo file.
Figura supplementare 4: Validazione end-to-end a 384 pozzi di controllo delle placche. (A) I punteggi spettrali mediati e normalizzati per i campioni nelle colonne iniziali della piastra a 384 pozzi sono rappresentati e mostrati in rosso, mentre i valori duplicati scansionati alla fine della piastra da 384 pozzi sono mostrati in verde lime. I valori replicati sono affiancati, variando dal controllo positivo (indicato con un segno più accanto all'ID PPB) al controllo negativo (indicato con un segno meno accanto all'ID PPB). Il valore del controllo del buffer preparato dal programma di gestione del liquido (indipendente dal prompt di input del campione) viene mostrato in un pattern a scacchi. (B) I punteggi DLS mediati e normalizzati per i campioni nelle colonne iniziali della piastra da 384 pozzi sono rappresentati e mostrati in rosso, mentre i valori duplicati scansionati alla fine della piastra da 384 pozzi sono mostrati in verde lime. I valori replicati sono affiancati, variando dal controllo positivo (indicato con un segno più accanto all'ID PPB) al controllo negativo (indicato con un segno meno accanto all'ID PPB). Non esiste un valore di controllo del buffer per la lettura DLS (a causa delle letture multimodali). (C) I punteggi spettrali mediati e normalizzati vengono rappresentati rispetto ai punteggi DLS in un grafico di correlazione per campioni che vanno dalle letture nelle colonne iniziali della piastra a 384 pozzi fino alla fine della piastra a 384 pozzi. La codifica colore dei punti dati corrisponde direttamente ai punteggi medi normalizzati della scansione spettrale. Poiché non esiste un valore di controllo del buffer per la lettura DLS (a causa delle letture multimodali), solo i 6 controlli in duplicato vengono confrontati da entrambe le letture in questo grafico. Clicca qui per scaricare questo file.
Figura supplementare 5: I calcoli per la normalizzazione dei punteggi spettrali o punteggi DLS per consentire la segnalazione e il riferimento universale tra utenti e giorni. I valori di controllo positivi sono impostati a 1, mentre i controlli negativi sono a 0, e i punteggi alti sono associati a un comportamento colloidale scadente. Clicca qui per scaricare questo file.
Discussione
Questo protocollo rappresenta diverse modifiche chiave rispetto al metodooriginale CS-SINS 16. È importante sottolineare che il rapporto ottimizzato PLL:IgG e il buffer di istidina sono stati mantenuti dallo studiooriginale 16. In particolare, il saggio è stato adattato per la piattaforma robotica del maneggiatore di liquidi per consentire l'elaborazione HTP (fino a 352 campioni in 1 giorno contro ~20), riducendo il tempo di lavoro manuale e migliorando la riproducibilità tramite la gestione automatica dei liquidi. Il sistema robotico è compatibile con i formati basati su lastre, inclusa la stampatura in nuovi formati come la piastra a 384 pozzi e vari tipi di materiale da laboratorio. I programmi possono girare indipendentemente e il flusso di lavoro end-to-end offre una lettura ad alto volume con maggiore riproducibilità in un contesto che limita i campioni. Le misurazioni DLS sono state incorporate anche come lettura ortogonale dello spostamento spettrale con un fattore Z più ottimale rispetto alle interpretazioni dello spostamento spettrale (0,998 contro 0,648), il che si rivela particolarmente prezioso per campioni con punteggi spettrali borderline o deviazioni standard elevate, e descrive l'interpretazione dello spostamento plasmonale per migliorare la gamma dinamica evidente solo dall'uscita del lettore di placche. Si suggerisce che i laboratori disposti di lettori multimodalità di fascia alta possano utilizzare DLS per eseguire in modo affidabile CS-SINS. Per affrontare la potenziale variabilità dipendente dal tempo su una piastra a 384 pozzi, è stata effettuata una validazione estesa della lastra (Figura Supplementare 4) posizionando controlli sia all'inizio che alla fine della placca, confermando effetti minimi sul tempo di scansione. Inoltre, è stato dimostrato che i campioni grezzi di PEPP producono risultati comparabili a quelli del materiale purificato (Figura 6, Figura Supplementare 3A), ampliando l'applicabilità del metodo a fasi di scoperta precedenti in cui la proteina purificata non è disponibile, che non erano state precedentemente riportate. I dati nella Figura Supplementare 3 indicano l'affidabilità del campionamento tra le fonti, ma indicano anche una minima variabilità del saggio di giorno in giorno, poiché i dati sono stati raccolti e normalizzati da diversi dataset. Più specificamente, la Figura Supplementare 3B rappresenta l'area totale sotto la curva per tutti i pozzi provenienti dalle rispettive lastre sperimentali (codificate a colori per corrispondere alla lastra dello stesso esperimento nella Figura Supplementare 3A) per dimostrare la variabilità attesa, ma minima, all'interno dello stesso esperimento e in giorni diversi con preparazioni distinte delle perle. Nella fase iniziale di scoperta, metodi come kD-DLS e approcci basati su colonne (SMAC, CIC) non sono fattibili a causa di requisiti più elevati di consumo di campioni e dell'incapacità di processare il materialegrezzo 12,13,24,25,26,27; Il CS-SINS consente in modo unico lo screening della stabilità colloidale in questa fase con soli 6 μg per campione, che può essere purificato in un solo passo. Infine, lo script di adattamento delle curve è stato aggiornato per consentire la finetuning di piccoli spostamenti lambda max e per consentire una migliore gestione dei file e la segnalazione automatica dei dati ai database interni.
Gli scenari comuni di risoluzione dei problemi includono: (1) alte deviazioni standard nei punteggi spettrali o DLS, spesso indicando una miscelazione incompleta di nanoparticelle (passo 7.6) o aggregazione di campioni - in tali casi si raccomanda di effettuare un controllo qualità qualità rispetto ai campioni dializzati tramite DLS per garantire l'integrità post-dialisi e utilizzare di default i punteggi spettrali come lettura standard; (2) distribuzioni DLS multimodali o letture DLS fallite, tipicamente causate da aggregazione preesistente di campioni o contaminazione da polvere - la filtrazione tramite filtri da 0,22 μm prima della dialisi può mitigare questo problema; (3) discrepanze tra i punteggi spettrali e quelli DLS, tipicamente attribuibili a misurazioni DLS distorsioni (probabilmente dovute all'elevata polidispersione, che si manifesterebbe nell'intervallo normale-alto secondo il punteggio spettrale); (4) valori di controllo positivi incoerenti, solitamente derivanti da improprie immagino delle nanoparticelle o da mAb di cattura degradata; per ogni test si devono usare aliquote fresche conservate a -80 °C (non conservate a 4 °C per più di qualche giorno).
Alcune limitazioni del saggio includono la necessità di tempo per dialisare accuratamente i campioni e preparare le nanoparticelle coniugate semi-manualmente il giorno precedente al saggio; tuttavia, il tempo di dialisi è equivalente indipendentemente dalla dimensione del set di campione. Per quanto riguarda i rischi di ostruzione delle punte, le punte per la gestione dei liquidi monitorano i cambiamenti di pressione durante l'aspirazione, e durante il funzionamento si manifestano errori rilevanti. Durante la fase di sviluppo del metodo, abbiamo controllato i file di log (e continuiamo dopo il servizio) per assicurarci che i volumi attesi vengano calcolati dallo script. Le funzioni di aliquotazione sono state testate per la preparazione concentrata delle perline e non prevedono problemi. Riconosciamo la natura sensibile al tempo del saggio, la natura dominata da Fab della valutazione e il suo ruolo come test surrogato senza misurare direttamente comportamenti colloidali come viscosità e opalescenza. Tuttavia, questo adattamento consente la caratterizzazione efficiente di dataset più ampi nelle fasi precoce del processo di scoperta del farmaco, fungendo da potente strumento di screening dove prima non esistevano.
Diversi passaggi critici di questo protocollo richiedono un'attenta attenzione per garantire risultati riproducibili. Innanzitutto, è essenziale una regolazione precisa del pH durante la preparazione del tampone (passaggi 1.1.1 e 1.2.1), poiché deviazioni oltre ±0,1 unità di pH possono influire sulla stabilità delle nanoparticelle e sull'efficienza della cattura degli anticorpi. Il buffer a basso pH utilizzato per la preparazione degli anticorpi di cattura garantisce una coniugazione ottimale, e le condizioni del buffer specificate erano ottimizzate per la stabilizzazione della carica e per una ampia compatibilità degli anticorpi (tipicamente in un contesto di formulazione). Il buffer di istidina di 10 mM pH 6.0 fornisce interazioni elettrostatiche ottimali mantenendo la stabilità proteica. In secondo luogo, una dialisi completa con rimozione completa del sale (passo 2.3) è fondamentale; La dialisi incompleta può interferire con le interazioni elettrostatiche durante l'assemblaggio delle nanoparticelle. In terzo luogo, la fase di concentrazione delle nanoparticelle d'oro (passaggi del protocollo 5.1–5.3) deve essere eseguita con attenzione per evitare di disturbare il pellet, poiché concentrazioni incoerenti delle nanoparticelle influenzano direttamente la sensibilità del saggio. In quarto luogo, il rapporto PLL:cattura mAb di 0,03 (passo 4.1) è ottimizzato per la massima copertura superficiale mantenendo una finestra di spostamento plasmonica sufficiente, come precedentementestabilito 16. Per quanto riguarda la dinamica della gestione dei liquidi, sono stati utilizzati dei puntini di rilevamento dei liquidi per effettuare normalizzazioni e miscelazione delle lastre fino all'introduzione di nanoparticelle d'oro, che non vengono misurate in modo affidabile in soluzione (e quindi impostano i volumi di erogazione a quantità standard). Il rilevamento liquido a monte permette che l'operatore rilevi problemi di disallineamento delle piastre o campioni mancanti, mentre la fase di stampatura a 384 pozzi identifica i problemi di allineamento Z. Infine, è fondamentale rispettare rigorosamente il tempo di incubazione di 4 ore (passaggi del protocollo 7.10–7.12) e leggere costantemente la lastra dall'inizio alla fine (indipendentemente da una placca incompleta), poiché lo spostamento plasmonico e il clustering delle nanoparticelle sono fenomeni dipendenti dal tempo; ritardi o letture anticipate possono portare a punteggi CS-SINS inaccurati, mentre la lettura completa garantisce la coerenza dei punteggi tra i giorni nel formato HTP.
Man mano che la stabilità colloidale degli anticorpi multispecifici viene sempre più studiata, i grandi dataset forniti da saghi biofisici HTP come CS-SINS hanno il potenziale di alimentare modelli AI/ML per comprendere meglio gli effetti combinatori sulla stabilità delle molecole. Gli studi hanno dimostrato che, con l'aumentare della diversità di sequenza, la necessità di dataset più ampi per migliorare l'accuratezza dei risultati AI/ML 41,42,43. Le proprietà e i descrittori molecolari per i monospecifici possono cambiare se riformattati in bispecifici o trispecifici, considerando l'intera distribuzione e l'equilibrio della carica molecolare piuttosto che considerazioni specifiche per la sequenza o il motivo per attributi come le responsabilità da degradazionechimica 17,18,19,20,21,22 . In particolare, caratteristiche strutturali come le macchie elettrostatiche previste, l'idrofobia e l'area superficiale accessibile al solvente possono migliorare le previsioni di aggregazione e stabilità indipendentemente dalle caratteristiche specifiche della sequenza, rendendo diversi dataset più piccoli compatibili con la preparazione dellaprevisione 17,18,19,20,21,22 . La semplicità del punteggio CS-SINS come riferimento alla culminazione rappresentativa del profilo biofisico di una molecola rende il saggio adatto all'addestramento di modelli AI/ML.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi o interessi finanziari concorrenti.
Ringraziamenti
Vorremmo ringraziare i seguenti team e individui per i loro contributi e le discussioni riflessive: Jonathan Kingsbury, responsabile del gruppo CMC Developability and Preformulation Science per la sua esperienza esperta, Peter Tessier, Professore di Scienze Farmaceutiche e Ingegneria Chimica all'Università del Michigan per la collaborazione nello sviluppo del metodo CS-SINS, altri membri all'interno o affiliati alle divisioni LMR durante l'evoluzione di questo progetto (in particolare Samantha Schultz, Xiaohua Liu, Megan Salemi, Tina Matin, Julie Jaworski, Sanjana Mandala, Kalie Mix, Maciej Majewski, Jinrong Ma, May Cindhuchao, David Reczek, Tristan Magnay, Drew Lynch, Ailin Wang, Dietmar Hoffmann, Eva Bric-Furlong, Karen Wong, Leighton Marcovici, Christian Lange, Christa Pescher, Ben Mittelstaedt e Melanie Fischer) e il team di preparazione del tampone impiegato da Thermo Fisher Scientific (in particolare Archer Killingsworth ed Elisa Ferrara).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| CLEARSEAL FILM 100PKCLEARSEAL | Fisher Scientific | 500214 | |
| CO-RE II (50 μL Conductive Tips, 300 μL Conductive Tips, 300 µL Slim Conductive Tips) | Hamilton Company | 235966, 235902, 235806 | |
| Eppendorf Tubes Snap Cap (5.0 mL, Microtube) | Eppendorf | 30119401 | |
| Falcon Conical Centrifuge Tubes (15 mL) | Thermo Fisher Scientific | Falcon 352196 | |
| Goat antihuman Fcγ-specific antibody | Jackson ImmunoResearch Laboratories | 109-005-008 | |
| Gold nanoparticles (20 nm) | Ted Pella Inc. | 157051 | |
| Greiner Bio-One 384-well μClear Bottom Polystyrene Microplates – (SS & DLS assay plates) | Fisher Scientific | 07-000-057 | |
| Greiner Bio-One MASTERBLOCK 96 Deep Well Conical Bottom 2 mL Storage Plate – (mastermix and reagent mixing plates) | Fisher Scientific | 07-000-122 | |
| Hard-Shell PCR Plates normalization (96-Well, low profile, thin wall, skirted, white/clear HSP9601) | Bio-Rad | HSP9601 | URL: https://www.bio-rad.com/en-us/sku/HSP9601-hard-shell-96-well-pcr-plates-low-profile-thin-wall-skirted-white-clear?ID=HSP9601 |
| Histidine hydrochloride buffer sample (10 mM, pH = 6.0, sample and assay buffer) | Sigma | H8125; H6034 | Prepare final concentration of 5 mM per reagent in ultra-pure water, adjust pH to 6.0, adjust final volume with ultra-pure water, and filter with 0.22 μm filter |
| Matrix ScrewTop Tubes sample (500 μL) | Thermo Fisher Scientific | 3744 | |
| MD100 or MD300 Xpress Mini Dialyzer (Xpress Micro Dialyzer, Scienova, 6-8 kDa, 96 pcs. in deep well plate (12 cartridges), sealing sheet) and dialysis reservoir/box (low volume dialysis cassettes) | Vivaproducts, Inc. | 40789, 40076 | |
| Microcentrifuge tubes pure polypropylene (1.5 mL) | USA Scientific | 1615-5500 | |
| Nalgene Disposable Polypropylene Robotic Reservoirs – (buffer trough) | Thermo Fisher Scientific | 1200-2300 | |
| Nalgene Rapid-Flow Sterile Disposable Filter Units with PES Membranes | Thermo Fisher Scientific | 567-0020 | |
| Poly-L-lysine, >70,000 MW | MP Biomedicals | 219454405 | Prepare a 5 mg/mL stock solution in ultra-pure water |
| Positive and negative Controls (1 mg/mL dialyzed into 10 mM Histidine, pH 6) | Internally-produced commercial antibodies | N/A | ~2 nm spectral shift and DLS size of 250-300 nm for positive control; negligible spectral shift and DLS size comparable to buffer only control |
| Potassium acetate buffer capture (20 mM, pH = 4.3, mAb conjugation buffer) | Fisher Scientific | P171-500 | Prepare final concentration of 10 mM reagent in ultra-pure water, adjust pH to 4.3 with acetic acid, adjust final volume with ultra-pure water, and filter with 0.22 μm filter |
| Zeba desalting columns (2 mL, 5 mL, or 10 mL) | Thermo Fisher Scientific | PI-89889; 89891; 89893 |
Ristampe e permessi
Tag
BiochimicaNumero 232Numero 232Valore VuotoNumeroautomazione di laboratorioSistema automatizzato per la manipolazione dei liquidirobotica di laboratorioScreening ad alto rendimento HTSbiologiciprofilazione della sviluppabilitstabilit colloidalecaratterizzazione biofisicapropensione all aggregazioneDynamic light scattering DLSmodellazione AI ML
Questo articolo è stato pubblicato
Video in arrivo