Lo studio attuale descrive un flusso di lavoro per il sequenziamento nanoporo dei plasmidi quando la sequenza cromosomica è già nota o non ha alcun interesse. Un primo passaggio di arricchimento del DNA plasmidico garantisce una profondità ottimale della sequenza plasmidica e massimizza il numero di campioni che possono essere sequenziati per cella di flusso.
Articolo metodologico
Sequenziamento e assemblaggio di plasmidi a lunga lettura utilizzando flussi di lavoro basati sul sequenziamento nanopore
* These authors contributed equally
In questo articolo
Sommario
Abstract
Il presente studio descrive un flusso di lavoro per il sequenziamento nanoporo progettato per massimizzare la resa del DNA plasmidico e l'accuratezza del sequenziamento. I ricercatori coprono ogni fase del processo, che include l'estrazione del DNA plasmidiale, la preparazione della libreria con rapida codeding a barre e legazione degli adattatori, il caricamento della libreria su una cella di flusso per il sequenziamento, la chiamata di base (in tempo reale o post-hoc) e l'assemblaggio della sequenza tramite Autocycler. Gli autori specificano anche i requisiti del computer, che dipendono in gran parte dal fatto che la basecalling venga effettuata in tempo reale. Gli autori hanno sequenziato plasmidi purificati da dieci ceppi clinici utilizzando questo flusso di lavoro. Per rimuovere le differenze tra ceppi ospite e cellula come variabile, gli autori hanno anche coniugato questi ceppi clinici con un ceppo comune ricevente e hanno sequenziato i transconiuganti. Questi esperimenti hanno prodotto assemblaggi plasmidi che corrispondono a dimensioni plasmidiche dedotte dalla mobilità del gel e che, in 2/3 dei casi, corrispondono anche a assemblaggi lucidati a breve lettura o sono entro lo 0,05% di identità di sequenza a coppie. L'arricchimento delle sequenze di DNA plasmidico massimizza anche l'efficienza del sequenziamento plasmidiale, permettendo il sequenziamento parallelo di fino a 24 campioni con copertura ottimale. Questo protocollo è adeguato per plasmidi che vanno da 4 a 174 kb e tollera fino al 72% di contaminazione cromosomica senza comprometterne l'accuratezza. Questo protocollo è ideale per situazioni in cui la sequenza cromosomica è già nota o non ha alcun interesse, come per la verifica della sequenza plasmidica, il miglioramento dell'accuratezza delle sequenze plasmidiche già ottenute da WGS, o il sequenziamento dei plasmidi catturati tramite coniugazione. L'organismo utilizzato per illustrare questo lavoro è Escherichia coli, che rappresenta gli ospiti utilizzati per l'espressione genica ricombinante e per la cattura dei plasmidi tramite coniugazione.
Introduzione
I plasmidi sono frammenti di DNA autoreplicanti che si trovano ubiquitariamente nei batteri. Sono altamente variabili nelle dimensioni, variando da <800 bp a 2,5 Mbp, e seguono tipicamente una distribuzione bimodale, con un picco più piccolo corrispondente a plasmidi multicopia non coniugative e un picco maggiore corrispondente a plasmidi a bassa copia, spesso coniugativi, 1,2. I plasmidi svolgono un ruolo chiave nell'ecologia microbica, portando geni che aiutano i loro ospiti ad adattarsi alle sfide ambientali o ad accedere a nuove nicchie ecologiche. I plasmidi fungono anche da piattaforme per l'evoluzione accelerata, fornendo una maggiore plasticità genetica e mediando il trasferimento genico orizzontale tra ceppi, specie, generi e persino famiglie 3,4. Analisi genomiche comparative e di rete hanno confermato il ruolo del resistoma ambientale come serbatoio persistente per i geni di resistenza agli antibiotici (ARG) clinicamente rilevanti, facilitandone così il mantenimento e la diffusione in contestiecologici 5. Tracciare plasmidi e il loro carico di geni di resistenza agli antibiotici e virulenza aiuta a identificare le viedi trasmissione 6. Pertanto, l'identificazione e la caratterizzazione dei plasmidi sono di grande interesse per una varietà di applicazioni di salute pubblica, microbiologia clinica e biotecnologiche.
L'introduzione delle tecnologie di sequenziamento di nuova generazione (NGS), che consentono il sequenziamento ad alto rendimento di template di DNA sconosciuti, ha aperto la strada alla caratterizzazione genomica degli isolati microbici. Il sequenziamento del genoma completo (WGS) consente di monitorare l'emergenza, la diffusione e la trasmissione di nuovi patogeni, ceppi resistenti ai farmaci e varianti che evitano il vaccino. Viene inoltre sempre più utilizzata per aiutare a identificare le vie di trasmissione durante focolai clinici, potenzialmente informando interventi per future prevenzioni7. Infine, il WGS consente la profilazione degli ARG, che può informare decisioniterapeutiche 8, anche se collegare gli ARG a fenotipi qualitativi e quantitativi di resistenza agli antibiotici è ancora un lavoro incorso 9.
Tuttavia, i dati di sequenziamento a lettura breve (SR) tipicamente prodotti da WGS su larga scala sono generalmente nell'intervallo 400–500 bp. Questa dimensione è più corta della maggior parte degli Elementi Genetici Mobili (MGE) e quindi non può risolverli10. L'identificazione in silico delle sequenze plasmidiche nei dati WGS è ulteriormente complicata dalla copertura incompleta e dalla condivisione delle sequenze tra plasmidi e tra cromosomi batterici e altriplasmidi 10. Di conseguenza, gli assemblaggi sono spesso ampiamente frammentati e incompleti, rendendo impossibile attribuire la loro posizione subgenomica (cromosomica o plasmide).
La tecnologia di sequenziamento a lunga lettura (LR) genera assemblaggi altamente contigui che si estendono su più ripetizioni, facilitando notevolmente la produzione di assiemi plasmidi completi. Esistono essenzialmente due tipi di tecnologie a lunga lettura e singola molecoladisponibili 11,12. Uno di questi approcci, il sequenziamento nanoporo, sta diventando popolare nella genomica microbica grazie al suo basso costo, ai tempi di risposta rapidi e all'idoneità per ambienti con risorselimitate 13,14.
I dispositivi di sequenziamento dei nanopori utilizzano celle di flusso contenenti array di migliaia di nanopori. Il DNA viene caricato nella cella di flusso, aperto da una proteina motoria con attività elicasa, e attraversa il nanoporo guidato da un differenziale di corrente. Quando i nucleotidi in un singolo filamento passano attraverso nanopori individuali, la corrente viene interrotta per produrre un segnale caratteristico che viene misurato da un sensore elettronico collegato a ciascun poro. Questo segnale viene decodificato utilizzando algoritmi di basecalling, e i dati risultanti vengono raccolti e analizzati ulteriormente a valle utilizzando vari strumenti bioinformatici.
Rispetto agli approcci di sequenziamento SR, il sequenziamento nanoporo tende a produrre una qualità di lettura inferiore (punteggi Q più bassi) e a generare insertioni/delezioni nelle sequenze omopolimeriche durante l'analisi dei dati dei segnali elettrici (basecalling)15. È stato inoltre osservato che la metilazione vicina nel DNA nativo può causare errori sistematici di chiamatadelle basi 16. Una soluzione comunemente adottata è stata includere dati a lettura breve per la correzione degli errori post-assemblaggio. Tuttavia, questo processo (noto come "lucidatura") aumenta i costi e la complessità17. Aumentare la copertura di sequenziamento può anche migliorare la precisione, ma non è sempre tecnicamente realizzabile.
Nel 2024 è stato dimostrato che le celle di flusso Oxford Nanopore Sequencing (ONT) R10.4.1 e la chimica V14 producono assemblaggi di alta qualità e contigui per i batteri G-, mentre analisi su scala più fine su livelli di singolo nucleotide beneficiano ancora dei dati di sequenziamento SR18. Tuttavia, il divario tra l'accuratezza del sequenziamento LR e SR si sta gradualmente riducendo. Vari miglioramenti recenti includono un processo di campionamento dati più preciso a velocità di sequenziamento aumentata, l'introduzione di un nuovo basecaller adattato al DNA batterico nativo e alla metilazione, che ha portato a una maggiore accuratezza nella chiamata di base19, e strumenti di analisi aggiornati come nuovi algoritmi per la fase di fase, la chiamata variante e la chiamata star-allele. Si noti inoltre che l'ultimo algoritmo Dorado V.0.9.0 ONT (2025) può essere utilizzato per la chiamata di rebase di dati grezzi di squiggle. Infatti, alcuni studi WGS stanno già riportando la generazione di genomi microbici tramite sequenziamento nanoporo di una qualità per la quale la lucidatura a lettura breve non si prevede migliori significativamente la sequenzaconsensuale 20,21.
I plasmidi spesso contengono la maggior parte dei geni di resistenza acquisiti, in particolare negli isolati22 di Enterobacteriaceae. Pertanto, la risoluzione delle sequenze plasmidiali consente la contestualizzazione dei geni AR, fondamentale per tracciare la trasmissioneAMR 23,24. Il sequenziamento nanoporo è già stato utilizzato per esaminare la microevoluzione di bla KPC che ospitaplasmidi 25. I dispositivi MinION sono stati inoltre utilizzati per il sequenziamento in tempo reale da banco di plasmidi e per il rilevamento di geni di resistenza in isolati clinici in contestiospedalieri 26. Detto ciò, l'interrogatorio plasmidico non fa ancora parte della pratica di routine del controllo delle infezioni.
Nonostante il notevole miglioramento del LR-sequenziamento rispetto al SR-sequenziamento nella capacità di salvare plasmidi dalla sequenzagenomica 27, alcuni problemi persistono. Gli assemblatori a lunga lettura come Flye28, Canu29 e Raven30 producono assemblaggi cromosomici di alta qualità ma faticano ad assemblare sequenze plasmide. Ciò è dovuto in parte alla scarsa profondità di copertura perché il DNA plasmidico è sottorappresentato nei dati di sequenziamentoWGS 31. Si noti che, a causa della loro struttura modulare, abbondanza di strutture secondarie e frequente presenza di ripetizioni, l'assemblaggio di alta qualità per la sequenza di DNA plasmidico richiede una copertura maggiore rispetto al DNA cromosomico (50x profonditàdi lettura 32).
Arricchire i campioni di DNA con sequenze plasmidiche è un approccio efficace per aumentare la profondità della copertura, ma l'isolamento o l'arricchimento del DNA plasmidico prima del sequenziamento del DNA è troppo costoso o laborioso per applicazioni diagnostiche cliniche e potrebbe introdurre un bias arricchiendo sequenze di DNA selezionate. Nel 2017, il DNA arricchito con plasmidi è stato utilizzato per tentare l'assemblaggio completo del DNA plasmidico in campioni clinici per la rilevazione degli ARG24. Otto isolati di sei diverse specie di Enterobacteriaceae sono stati sequenziati per massimizzare la diversità strutturale della popolazione e dei plasmidi. Dopo aver provato diversi assemblatori, si dimostrò che Canu/Canu+Pilon superava chiaramente gli altri; Questo gruppo di ricerca ha inoltre provato un approccio di meta-assemblaggio che ha raggiunto la risoluzione di ulteriori strutture plasmidiali, risultando nell'assemblaggio completo del 78% di tutti i plasmidi noti nei campioni sequenziati. Tuttavia, la presenza di strutture a grandi ripetizioni e (in misura minore) problemi di estrazione del DNA rappresentavano comunque problemi significativi per la rilevazione di tutti gli assemblaggi plasmidi a singolocontig 24.
Più recentemente, il campionamento adattivo come approccio complementare per l'arricchimento di sequenze plasmidiche a bassa abbondanza è stato esaminato rifiutando sequenze cromosomiche in campioni isolati batterici, anche se questo metodo richiede sequenze di riferimentonote 33.
Qui, gli autori descrivono protocolli per il sequenziamento ONT personalizzati per campioni arricchiti con DNA plasmidico. Combinando una maggiore rappresentazione del DNA plasmidico con protocolli di preparazione delle librerie aggiornati, tecnologia a celle di flusso e strumenti di assemblaggio di sequenze, il flusso di lavoro ha prodotto assemblaggi che corrispondevano alle dimensioni dedotte dalla mobilità del gel e, in due terzi dei casi, o corrispondevano alla lucidatura per sequenziamento SR o erano entro lo 0,05% di identità di sequenza a coppie. L'arricchimento delle sequenze di DNA plasmidico massimizza anche l'efficienza del sequenziamento plasmidiale, permettendo il sequenziamento parallelo di fino a 24 campioni con copertura ottimale. I protocolli non sono pensati per sostituire gli approcci standard WGS per nanopori, ma per massimizzare l'accuratezza e l'efficienza del sequenziamento plasmomico in situazioni in cui la sequenza cromosomica è già nota o non di interesse.
Il flusso di lavoro include l'estrazione del DNA plasmidicale, la preparazione della libreria con codice a barre, la ligatura dell'adattatore a una proteina motoria, il controllo della cella di flusso, il caricamento della libreria su una cella di flusso per il sequenziamento, l'analisi dei dati dei segnali elettrici (in tempo reale o post hoc), l'assemblaggio delle sequenze tramite Autocycler34 e varie analisi a valle (Figura 1).
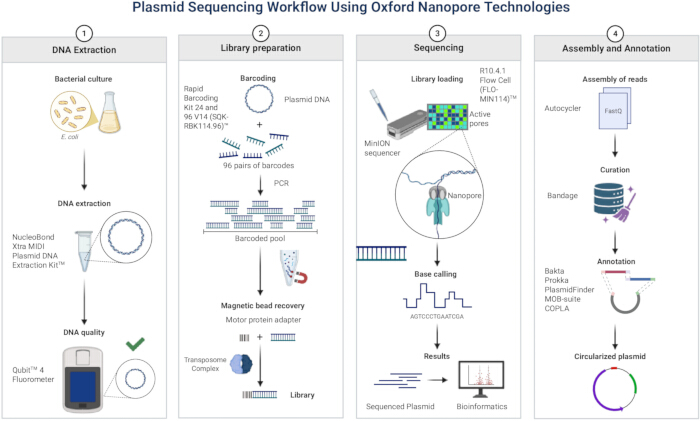
Figura 1: Flusso di lavoro di sequenziamento dei plasmidi utilizzando Oxford Nanopore Technologies. Passo 1: estrazione del DNA; Passo 2: Preparazione della biblioteca; Passo 3: Sequenziamento; Passo 4: Assemblaggio e annotazione. Creato in BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Clicca qui per visualizzare una versione più grande di questa figura.
Protocollo
1. Estrazione del DNA plasmidico
NOTA: Questo protocollo è stato utilizzato per estrarre DNA plasmidico da un ceppo clinico di Escherichia coli e dai suoi corrispondenti transconiuganti utilizzando un kit commerciale di estrazione del DNAplasmidico 35. Protocolli dettagliati per la coniugazione si trovano in36. Il protocollo è adatto sia per plasmidi ad alta copia che a bassa copia, che vanno da ~3 kb fino a ~200 kb. I plasmidi grandi richiedono particolare attenzione perché tendono ad avere un basso numero di copie (anche solo 1–2 copie per cellula), limitando la produzione di DNA. Per compensare, il protocollo raccomanda di aumentare la massa cellulare e i volumi di lisi e tampone di neutralizzazione per garantire un adeguato DNA plasmidico per il legame delle colonne. Plasmidi fino a 200 kb possono ancora essere recuperati utilizzando questo protocollo; tuttavia, la sua applicabilità ai mega plasmidi (>200 kb) è limitata.
- Estrazione dei plasmidi
- Giorno 1: Esposizione di campioni di striatura sulle placche di agar di Luria–Bertani (LB) integrata con l'antibiotico appropriato per selezionare il rispettivo marcatore di resistenza trasmesso dal plasmide e incubare a 37 °C per 24 ore.
NOTA: Aggiungere carbenicillina (o antibiotico appropriato) al LB a una concentrazione finale di 100 μg/mL aggiungendo 1 μL di una soluzione stock da 100 mg/mL per mL di mezzo. - Giorno 2: Inoculare 3–5 mL di LB con il mezzo antibiotico appropriato con una singola colonia isolata dal primo giorno. Incubare con agitazione a 37 °C per ~8 ore, o fino a quando la coltura non raggiunge un OD₆₀₀ di 1–2.
NOTA: Misurazione di OD600: Svuotare lo spettrofotometro con un substrato LB fresco contenente l'antibiotico appropriato, poi trasferire 1 mL di coltura su una cuvetta pulita e misurare il OD a 600 nm. Se la lettura supera l'intervallo lineare, diluire il campione e rimisurare. - Inoculare 400 mL di LB integrati con il mezzo antibiotico appropriato con 400 μL di coltura iniziale del secondo giorno. Incubare con scuotimento a 37 °C per 8–12 ore, o fino a quando il OD600 raggiunge 1–2 (come descritto in precedenza).
NOTA: Aumentare il volume di coltura oltre 400 mL se OD600 non raggiunge 1–2 entro 12 ore. Per ridurre il rischio di perdita o riorganizzazione del plasmide, limitare il passaggio in coltura il più possibile e mantenere la selezione degli antibiotici durante tutte le fasi di crescita. Aumentare il volume di coltura solo quando si desidera una maggiore resa di DNA. - Giorno 3: Trasferire la coltura in bottiglie centrifughe appropriate al volume di coltura. Centrifugare a 4200 x g per 10 minuti, poi risospendere il pellet utilizzando i volumi di reagente raccomandati dal produttore secondo la seguente formula:
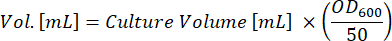
NOTA: Esempio: Per 400 mL di una coltura batterica a bassa copia (OD600 = 2) da lisi, i volumi appropriati di tampone di lisi RES, LYS e NEU sono di 16 mL ciascuno.
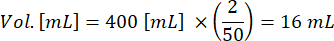
NOTA: se i volumi dei reagenti per la risospensione, la lisi o la neutralizzazione non sono correttamente scalati alla biomassa totale della coltura (OD600 × Volume, o ODV), la lisi può essere incompleta, la neutralizzazione inefficiente e la formazione dei precipitati eccessiva. Ciò può portare a una resa plasmidicale inferiore, una minore purezza e un potenziale ostruzione delle colonne di purificazione. Scalare proporzionalmente i volumi del buffer, utilizzando la formula del produttore (passo 1.1.4), garantisce una lisi efficiente, una neutralizzazione completa e un recupero costante di DNA plasmidico di alta qualità. - Esegui la lisi cellulare, l'umidificazione del filtro usando il tampone appropriato e la neutralizzazione come indicato dal kit.
NOTA: Impila due filtri se il volume di precipitato è grande, regolando il buffer proporzionalmente. Eseguire ulteriori passaggi di centrifugazione se il sovrantantante rimane opaco. Dopo la neutralizzazione, l'elevato volume di precipitato può richiedere ulteriori passaggi di centrifugazione. Questo vale per la maggior parte dei campioni clinici di E. coli, probabilmente perché tendono a formare biofilm nella cultura37, che coinvolge la secrezione di una matricespessa 38. Un eccessivo precipitato nel lisato può ostruire la colonna, prolungare i tempi di drenaggio e potenzialmente contaminare il campione con proteine. Se il sovrantantante è chiaro, questi passaggi aggiuntivi potrebbero non essere necessari. - Centrifuga il lisato a 4200 x g per 30 minuti. Trasferisci il soprandanante in un nuovo tubo e centrifuga di nuovo per 30 minuti. Se il sovrantantante rimane opaco dopo questi spin (Figura 2), eseguire una centrifugazione aggiuntiva a 4200 x g.
NOTA: Il trasferimento del lisato in un tubo di coltura da 50 mL durante la centrifugazione può facilitare la rimozione del sovrandante, poiché il precipitato a volte non si forma correttamente e rimanere intrappolato vicino alla sommità del tubo. A causa dei grandi volumi processati, una singola colonna può saturarsi e non poter ospitare campioni aggiuntivi. Per aumentare la velocità di filtrazione o massimizzare la resa di DNA, il lisato può essere suddiviso in due colonne. - Esegui i passaggi EQU, WASH ed ELU secondo le istruzioni del kit.
- Precipitare il DNA usando isopropanolo.
NOTA: Incubare a -20 °C per ~10 minuti se il pellet non è visibile. Tuttavia, generalmente è meglio rimuovere con attenzione il surnante, confidando che il pellet rimanga attaccato alle pareti del tubo, anche se non è visibile. - Lava il DNA con etanolo come indicato. Esegui un lavaggio aggiuntivo se persiste il precipito proteico.
- Seccare il DNA a temperatura ambiente (~20 °C) per 15–30 minuti.
- Risospendere il DNA in 100 μL di acqua priva di nucleasi; questo piccolo volume aiuta a massimizzare la concentrazione per la preparazione della libreria Nanopore.
NOTA: Questo è un punto di sosta comodo. Il DNA plasmidico può essere conservato per diversi mesi a –20 °C. Il kit di estrazione utilizzato in questo protocollo è progettato per minimizzare la contaminazione dal DNA cromosomico (genomico) tramite chimica tampone ottimizzata, lisi gentile e chiarificazione del lisato, anche se non si può escludere una contaminazione sostanziale del DNA cromosomico, e gli autori l'hanno trovata nei preparati (vedi risultati).
- Giorno 1: Esposizione di campioni di striatura sulle placche di agar di Luria–Bertani (LB) integrata con l'antibiotico appropriato per selezionare il rispettivo marcatore di resistenza trasmesso dal plasmide e incubare a 37 °C per 24 ore.
- Resa del DNA e controllo qualità
Quantificare il DNA e valutarne la qualità utilizzando coloranti fluorescenti, che offrono maggiore specificità e sensibilità per basse concentrazioni di DNA rispetto ai metodi di assorbimento UV. In questo protocollo, si utilizza un dispositivo Fluorometro per quantificare in modo accurato e conveniente campioni di DNA, RNA oproteine 39.- Flusso di lavoro con fluorometro
- Porta i campioni di DNA a temperatura ambiente. Preparare i tubi per standard e campioni.
NOTA: Calcola i volumi appropriati di colorante e tampone da includere nella soluzione operativa in base al numero di campioni. Per ogni standard e campione, 200 μL di soluzione di lavoro devono essere preparati diluendo il colorante nel tampone in un rapporto 1:200. Il dispositivo dispone di un Calcolatore di Reagenti integrato che può essere utilizzato anche per questi calcoli. - Prepara i tubetti di prova secondo la Tabella 1.
- Vortice ogni tubo per qualche secondo prima di incubare per 2 minuti a temperatura ambiente.
- Calibra il fluorometro usando gli standard. Inserire i tubi campione e registrare le letture. Per istruzioni dettagliate, consulta il manualedel Fluorometro 39.
NOTA: Per le tipiche preparazioni di Midi plasmidi, si prevede che la resa di DNA vari da ~50 a 150 μg per coltura da 100–400 mL, a seconda della dimensione del plasmide, del numero di copie e delle condizioni di crescita. Le lunghezze tipiche delle letture dei nanopori variano da ~2 kb a 20 kb, con letture mediane spesso intorno a 5–10 kb per i plasmidi standard. I kit basati su legatura possono produrre letture più lunghe (mediana di >20 kb) per plasmidi più grandi, ma il kit rapido offre una preparazione più rapida a scapito di letture leggermente più brevi.
- Porta i campioni di DNA a temperatura ambiente. Preparare i tubi per standard e campioni.
- Flusso di lavoro con fluorometro
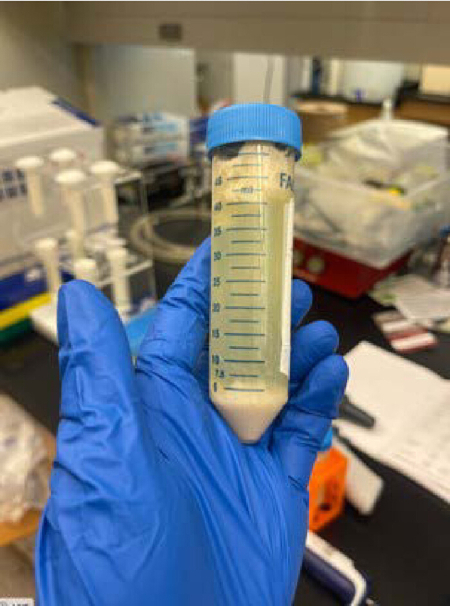
Figura 2: Sovranante di lisato torbido dopo un passaggio di centrifugazione. La centrifugazione seriale è necessaria finché il sovrantantante non è pulito per evitare l'ostruzione della colonna di filtrazione. Clicca qui per visualizzare una versione più grande di questa figura.
| Tubi standard per il test | Tubi per il test di prova per l'utente | |
| Soluzione operativa (colorante e tamponante, 1:200) | 190 μL | 180–199 μL |
| Standard (dal kit) | 10 μL | – |
| Esempio utente | – | 1–20 μL |
| Volume totale in ciascun tubo di prova | 200 μL | 200 μL |
Tabella 1: Volumi e quantità di reagenti per fluorometro. Le quantità sono mostrate per un singolo campione; Un pool può essere preparato in base al numero di campioni da analizzare.
2. Metodo 2: Preparazione della biblioteca
NOTA: Considerazioni. La preparazione della libreria per il sequenziamento dei plasmidi estratti è stata eseguita secondo le istruzioni fornite con il Kit di Barcoding40. Questo protocollo utilizza un kit che utilizza un approccio basato sulla trasposasi per frammentare e frammentare simultaneamente il DNA con codice a barre, fornendo un flusso di lavoro rapido e snello che riduce il tempo di utilizzo pratico e semplifica la preparazione della libreria.
- Preparazione del DNA
- Giorno 1: Programma un termociclatore: 30 °C per 2 minuti, poi 80 °C per 2 minuti.
- Scongelare i componenti del kit a temperatura ambiente, centrifugare e mescolare secondo la Tabella 2.
NOTA: Se usi una centrifuga, gira a una velocità bassa che non superi i 330 x g. - Preparazione del DNA in acqua priva di nucleasi: trasferire 200 ng di DNA in tubi PCR da 0,2 mL e aggiungere un volume appropriato di acqua priva di nucleasi a ciascun campione per portare il volume finale a 10 μL. Mescolare pipettando delicatamente 10–15 volte. Spina brevemente in un microfuge o centrifuga a 330 x g per facilitare la pipettura nei passaggi successivi.
- Prepara le miscele in tubetti PCR come indicato nella Tabella 3.
- Mescola tramite pipetta, poi centrifuga brevemente.
- Incubare i tubi PCR utilizzando il programma di ciclo termico dello Step 1. Metti i tubi sul ghiaccio per raffreddarli.
- Gira giù brevemente.
- Legatura del codice a barre nativa
- Campioni con codice a barre in piscina in un tubo Eppendorf pulito da 1,5 mL. Assicurarsi che il volume totale non superi i 1000 μL.
- Sostieni le perline tramite vortice. Aggiungi un volume uguale di Sfere ai campioni con codice a barre raccolti e mescola con un flick.
- Incubare i tubi per 10 minuti a temperatura ambiente su un mixer Hula.
- Prepara 2 mL di etanolo all'80% in acqua priva di nucleasi.
- Fai girare il campione e la pellet tenendo il tubo contro un magnete. Tenere il tubo sul magnete, rimuovere il soprandanante come scarto.
NOTA: Qualsiasi magnete di potenza e dimensione adeguate, inclusi i magneti al neodimio, può essere un'alternativa efficace all'uso di un costoso rack magnete. I magneti con una forza di mantenimento di circa 5–12 libbre e un diametro di 0,3–1 pollice sono tipicamente adatti per tubi standard da 0,2–1,5 mL, permettendo una rimozione pulita del surnante durante le fasi di pulizia a perline. - Lava le perline con 1 mL di etanolo all'80% mentre sono sul magnete. Rimuovi l'etanolo. Ripeti il lavaggio.
NOTA: Cambiare la posizione del tubo rispetto al magnete può migliorare la facilità di rimozione dell'etanolo. Utilizza una rotazione aggiuntiva a bassa velocità per garantire un pellet completo con la perlina se il pellet viene accidentalmente disturbato. - Gira brevemente verso il basso e rimetti il tubo sul magnete. Pipetta via qualsiasi etanolo residuo. Asciuga per 30 secondi, ma non asciugare il pellet fino a farlo creparsi.
- Rimuovi il magnete e risospezioni le perline nel buffer di eluzione. Vedi la Tabella 4 per i volumi appropriati di EB da utilizzare a seconda del numero di codici a barre in uso.
- Incuba il tubo per 10 minuti a temperatura ambiente.
- Riporta il tubo al magnete finché l'eluato non è libero.
- Quantificare la concentrazione di DNA utilizzando 1 μL del campione eluzionato sul Fluorometro per garantire che la preparazione della libreria sia stata eseguita con successo ed evitare di sprecare una cella di flusso su una libreria guasta.
- Legatura degli adattatori
- Trasferire 11 μL della libreria di DNA in un nuovo tubo e marcatore.
NOTA: Conservare DNA extra a -20 °C per futuri sequenziamenti se necessario. - Diluire il Rapid Adapter scongelato in un nuovo tubo secondo la Tabella 5 e pipetta su e giù per mescolare.
- Aggiungere 1 μL di AR diluita alla libreria di DNA da 11 μL.
- Muovi il tubo per mescolarlo, gira brevemente verso il basso per assicurarti che il volume completo si accumuli sul fondo del tubo.
- Incubare per 5 minuti sulla panca.
- Trasferire 11 μL della libreria di DNA in un nuovo tubo e marcatore.
| Reagente | Scongelamento a temperatura ambiente | Sfila giù | Miscela tramite pipetto |
| Codici a barre rapidi | Non Frozen | ✓ | ✓ |
| Adattatore rapido | Non Frozen | ✓ | ✓ |
| Perle XP AMPure | ✓ | ✓ | Mescola tramite pipetto o vortice immediatamente prima dell'uso |
| Tampone di eluzione | ✓ | ✓ | ✓ |
| Buffer adattatore | ✓ | ✓ | Miscelazione tramite vortice |
Tabella 2: Volumi e quantità di reagenti per la preparazione della libreria dei nanopori. Le azioni da eseguire con ciascun reagente sono contrassegnate (✓).
| Reagente | Volume/campione |
| DNA modello da 10 μL (200 ng dal passaggio precedente) | 10 μL |
| Codici a barre rapidi da 1,5 μL, uno per ogni campione | 1,5 μL |
| Volume totale | 11,5 μL |
Tabella 3: Reagenti e volumi per il codice a barre rapido. I volumi sono mostrati per campione di DNA; si può preparare un mix in pool e aggiungere il DNA separatamente.
| Codici a barre 1-24 | 48 codici a barre | 72 codici a barre | 96 codici a barre | |
| Volume del tampone di eluzione | 15 μL | 30 μL | 45 μL | 60 μL |
Tabella 4: Volumi del buffer di eluzione utilizzati per ogni 24 codici a barre. I volumi sono indicati in base al numero di codici a barre.
| Reagente | Volume |
| Adattatore Rapido (RA) | 1,5 μL |
| Buffer adattatore (ADB) | 3,5 μL |
| Volume totale | 5μL |
Tabella 5: Reagenti e quantità per l'adattatore. I volumi possono essere regolati in base al numero di campioni.
3. Funzionamento della cella di flusso
NOTA: Scegli una cella di flusso a uscita standard quando sequenzi un piccolo numero di plasmidi con esigenze di copertura moderate. Nanopore raccomanda di effettuare un controllo a celle di flusso per determinare il conteggio attivo dei pori; Le celle di flusso dei dispositivi Nanopore dovrebbero avere almeno 800 pori attivi come definito dai criteri di garanzia. Una singola cella di flusso MinION fornisce output sufficiente per il sequenziamento di più campioni di DNA arricchiti con DNA plasmidico (vedi maggiori dettagli sul multiplexing nella sezione discussione) offrendo al contempo costi inferiori e maggiore flessibilità rispetto a una cella di flusso GRIDion o Promethean.
- Innesco e carico della cella di flusso
NOTA: Le celle di flusso R10.4.1 (rilasciate nel 2022) sono state utilizzate per sviluppare questo protocollo. Queste celle di flusso hanno pori più lunghi con una doppia testa lettura, il che ha conseguente un sequenziamento omopolimerico migliorato20,21. Questo protocollo di sequenziamento e il Barcoding Kit non sono compatibili con altre celle di flusso. Opta per una cella di flusso ad alta uscita quando si esegue multiplexing su larga scala, si punta a una copertura elevata o si lavora con plasmidi o genomi più grandi. Considera il numero di campioni e la profondità del target per bilanciare costo, produttività e qualità del sequenziamento.- Rimuovere i reagenti dalla conservazione a freddo, inclusi buffer di sequenziamento (SB), perle di biblioteca (LIB) o soluzione di libreria (LIS), albumina sierica bovina (BSA), ancoraggio a celle di flusso (FCT) e lavaggio a cella di flusso (FCF). Scongelamento sul ghiaccio a temperatura ambiente. Una volta che i reagenti si sono scongelati, si forma un vortice da mescolare, far ruotare rapidamente e conservare sul ghiaccio.
- Prepara il priming della cella di flusso mescolando un tubo di DNA fresco utilizzando i reagenti elencati nella Tabella 6. Mescola per inversione e pipettatura.
- Solleva il coperchio del dispositivo e inserisci la cella di flusso. Applica una pressione delicata per assicurarti una corretta posizione.
- Esponi la porta di innesco spostando leggermente il coperchio.
- Controlla se ci sono bolle d'aria all'interno o adiacenti alla porta di innesco. Ritirare 20–30 μL di liquido per rimuovere le bolle.
NOTA: Non rimuovere più di 20–30 μL di buffer. I pori devono rimanere sempre sommersi nel buffer. I pori esposti all'aria possono diventare inutilizzabili. Assicurati che il buffer sia continuo lungo tutto il canale visibile. - Preleva 800 μL di miscela per il primer e dispensa nella porta di innesco. Evita di introdurre bolle d'aria. Lascia riposare il dispositivo per 5 minuti.
- Sospezione del liberatorio pipettando su e giù.
NOTA: Sospendere immediatamente prima dell'uso, poiché la liberazione si stabilizza rapidamente. - Mescola la libreria di DNA con il volume appropriato di perle della libreria in un nuovo tubo, come indicato nella Tabella 7.
NOTA: Il kit Rapid Barcoding utilizzato dagli autori utilizza un approccio basato sulla trasposasi per frammentare il DNA e attaccare codici a barre senza selezione intenzionale della dimensione, quindi le lunghezze di lettura riflettono principalmente il DNA originale in ingresso. A differenza dei kit basati su legatura come i Native Barcoding Kits, il kit Rapid Barcoding non include buffer separati per frammenti brevi o lunghi. Sebbene il DNA più lungo possa comunque generare letture lunghe, la distribuzione è più variabile e generalmente più breve rispetto alle librerie basate su legazione che utilizzano Long Fragment Buffer per arricchire frammenti lunghi. L'assenza di buffer semplifica il flusso di lavoro e riduce il tempo di lavoro manuale, ma offre meno controllo sulla distribuzione delle dimensioni della libreria, il che può influire sulla qualità dell'assemblaggio. I kit basati su ligazione, arricchendo selettivamente grandi frammenti e rimuovendo quelli brevi, tipicamente producono lunghezze medie di lettura più elevate e una continuità dell'assemblaggio migliorata, specialmente per assemblaggi de novo e genomi complessi. - Regola il coperchio della porta campione per rivelare la porta. Carica 200 μL di miscela di priming nella porta di priming della cella di flusso.
- Mescola delicatamente la libreria di DNA preparata prima di caricare.
- Erogare 75 μL della libreria di DNA con le sfere nella porta campionaria, una goccia alla volta, permettendo a ciascuna goccia di assorbirsi prima di aggiungere la successiva.
- Riapplica il coperchio della porta campione e chiudi la porta di innesco.
- Aggiungi lo schermo luminoso alla cella di flusso allineando il bordo anteriore dello schermo con la clip e poi abbassando il resto per coprire la cella di flusso. Non tentare di posizionare lo schermo luminoso sotto la pinza. La barriera luminosa dovrebbe stare attorno al coperchio, proteggendo l'intera sezione superiore della cella di flusso dall'esposizione alla luce.
NOTA: Installare lo schermo luminoso sulla cella di flusso non appena la libreria è stata caricata per ottenere un'uscita ottimale di sequenziamento. Lascialo acceso durante eventuali passaggi successivi finché la libreria non è stata rimossa dalla cella di flusso. Lo schermo luminoso non è fissato saldamente al dispositivo; Maneggiare con attenzione per evitare di spostarlo. - Chiudi il coperchio del dispositivo e inizia la sequenza.
- Avvio dei requisiti di esecuzione di sequenziamento:
Minimo: CPU a 8 thread, 16 GB di RAM, GPU NVIDIA 1070, SSD da 500 GB
Consigliato: CPU a 16 thread, 32 GB di RAM, GPU NVIDIA 2070, SSD da 1 TB
NOTA: Assicurati che sia il software che il computer siano aggiornati e abbiano almeno 500 GB di memoria libera per i nuovi file. Gli aggiornamenti software e altri programmi possono interferire con l'esecuzione della sequenza. Assicurati di eseguire il software sia su Windows che su Ubuntu.- Imposta il limite di tempo di esecuzione: a seconda di quanti plasmidi vengono multiplexati, imposta il limite di esecuzione. Il tempo predefinito è 48 ore, con un tempo massimo di 72 ore. Per istruzioni dettagliate, consulta il manuale.
NOTA: il tempo di esecuzione dipende dal multiplexing e dalla dimensione del plasmide piuttosto che dal numero di plasmidi. Il numero di campioni o plasmidi che possono essere multiplexati dipende dalla profondità di sequenziamento desiderata e dall'uscita della cella di flusso. Per il sequenziamento tipico dei plasmidi, il multiplexing di 20–24 campioni per cella di flusso nanoporo standard di solito fornisce una copertura sufficiente per un assemblaggio accurato e la rilevazione di varianti, assumendo dimensioni plasmidiche inferiori a ~200 kb. Plasmidi più grandi o requisiti di copertura più elevati possono richiedere meno campioni per cella di flusso. Le celle a flusso ad uscita più elevata possono sostenere molti più campioni (fino a 96 o più) per ogni run, rendendole adatte al sequenziamento di plasmidi ad alta produttività o a progetti che richiedono una copertura molto profonda. Gli utenti dovrebbero bilanciare il numero di codici a barre, la dimensione del plasmide e la profondità del bersaglio per garantire che ogni plasmide riceva letture adeguate per l'assemblaggio completo. - Abilita il taglio del codice a barre se esegui il demultiplexing durante il sequenziamento.
NOTA: Monitorare le letture per ogni codice a barre e interrompere la corsa quando si raggiunge una copertura sufficiente per preservare la vita della cella di flusso. - Seleziona modalità di basecalling super-accurata.
NOTA: Non selezionare il campionamento adattivo/bilanciamento con codice a barre. Questa opzione riduce notevolmente l'output di lettura e degrada i pori a un ritmo più rapido. Se non hai una GPU, è meglio rimandare il basecall dopo la fine della run. - Seleziona il kit rapid-codice a barre appropriato (24 o 96).
- Assicurati che il dispositivo sia a livello e avvia la sequenza con le impostazioni predefinite (punteggio minimo Q 10)
NOTA: Questo è un punto di sosta comodo. Il dispositivo può essere utilizzato durante la notte. - Basecalling post-hoc (nel caso in cui il computer non abbia sufficiente capacità per il basecalling live o per migliorare la precisione del basecalling, rianalizzando i dati grezzi con strumenti analitici migliorati): apri l'esecuzione di sequenziamento completata nel software
NOTA: I passaggi successivi si applicano solo se non hai selezionato la chiamata live base. - Seleziona Basecalling e scegli il modello di super-accuratezza (SUP).
- Seleziona i dati grezzi FAST5/POD5 e imposta una cartella di output.
- Inizia a fare bascall.
- Imposta il limite di tempo di esecuzione: a seconda di quanti plasmidi vengono multiplexati, imposta il limite di esecuzione. Il tempo predefinito è 48 ore, con un tempo massimo di 72 ore. Per istruzioni dettagliate, consulta il manuale.
| Reagenti | Volume per cella di flusso |
| Lavaggio della cella di flusso (FCF) | 1.170 μL |
| Albumina Sirica Bovina (BSA) a 50 mg/mL | 5 μL |
| Cavo a Cella di Flusso (FCT) | 30 μL |
| Volume totale finale in tubo | 1.205 μL |
Tabella 6: Reagenti e volumi per l'innesco e il carico della cella di flusso. I volumi di reagenti sono indicati per cella di flusso.
| Reagenti | Volume per cella di flusso |
| Buffer di sequenziamento (SB) | 37,5 μL |
| Perle di libreria (LIB) o soluzione di libreria (LIS), se utilizzate | 25,5 μL |
| Libreria del DNA | 12 μL |
| Totale | 75 μL |
Tabella 7: Reagenti e volumi per caricare la libreria. I volumi sono mostrati per la libreria del DNA; Le perline della biblioteca (bid) devono essere miscelate immediatamente prima dell'uso.
4. Metodo 4: assemblaggio con un autociclatore
NOTA: Ci sono molte opzioni per assemblare le letture nei contig. Ogni assembler ha i suoi aspetti positivi e i suoi bias di scena. Questo protocollo raccomanda l'uso di Autocycler, che utilizza molti assemblaggi diversi e li combina in un unico assemblaggio. Questo è più laborioso e puoi usare un singolo assemblatore per risparmiare tempo. Si prega di installare Conda nel terminale per scaricare il software appropriato. Il documento dei comandi supplementari contiene un collegamento a un file ambientale per configurare il sistema.
- Valuta la qualità delle run: Controlla la qualità della run dal software Minknow o dal file di report di run .html per annotare le metriche di qualità (rendimento, Q-score, lunghezza, distribuzione). Opzionalmente, valuta i file FASTQ usando NanoPlot per confermare la distribuzione della lunghezza di lettura, il N50 e i profili di punteggio di qualità per ciascun codice a barre. Procedere solo se le distribuzioni di resa e lunghezza di lettura di sequenziamento sono coerenti con le dimensioni attese dei plasmidi.
- Rimuovere i codici a barre: Determinare se il taglio dei codici a barre è stato abilitato durante l'esecuzione della sequenziazione. Se i codici a barre non sono stati rimossi, tagliare i file FASTQ usando Porechop (v0.2.4) e verificare la rimozione riuscita delle sequenze di adattatori di codice a barre prima dell'analisi a valle.
- Trim letture: Taglia le letture lunghe usando Filtlong (v0.3.1), rimuovendo circa il 5–10% delle letture di qualità più bassa mantenendo il ~90% della resa totale. Genera un file FASTQ filtrato per l'assembly. Se gli assemblaggi successivi producono contigi chimerici, aumentare la stringenza di filtraggio imponendo una soglia minima di lunghezza di lettura di ≥3.000 bp e rigenerare le letture filtrate.
- Subcampionare e assemblare readsubsets: Subsample legge usando Autocycler secondo le impostazioni raccomandate e assembla ogni sottoinsieme di lettura usando Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) e qualsiasi altro assembly scelto. Annota le lunghezze contig e lo stato di circolarizzazione per ogni assemblaggio. Gli assemblatori che riportano la circolarizzazione (Raven, Flye, miniasm, Myloasm e Plassembler) dovrebbero essere prioritari per la ricostruzione dei plasmidi. Per gli assemblaggi Canu e NECAT, si identificano i contigi plasmidicali candidati in base alla dimensione attesa del plasmide dai contigi circolari degli assemblaggi precedenti.
- Ispezionare e curare gli assemblaggi: visualizzare ogni file di grafo assemblaggio (.gfa) usando Bandage (v0.9.0) e valutare i contigi per circolarità, consistenza delle dimensioni tra assemblatori e evidenza di giunzioni chimeriche. Rimuovere contig lineari privi di supporto su più assembler e mantenere contig circolari con stime di dimensione costanti. Se molti assemblaggi contengono giunzioni chimeriche, si torna al passo 4.3 e aumenta la soglia minima di lunghezza di lettura (raccomandata ≥3.000 bp). Nei casi in cui i plasmidi principali sono circolarizzati ma rimangono contigi più piccoli e non supportati, rimuovere contigi minori prima della generazione di consenso. Procedere con la generazione del consenso e i passaggi di lucidatura possono essere eseguiti in batch, dopo la cura manuale.
- Generare consenso e assemblaggio finale: Dopo la curazione manuale, procedere con la generazione di consenso Autocycler utilizzando gli assemblaggi curati. Esegui i restanti comandi Autocycler per produrre la sequenza finale del plasmide consensuale. Istruzioni dettagliate in linea di comando e impostazioni dei parametri sono fornite nel Materiale Supplementare.
- Lucidatura: una volta generata una serie completa, lucida l'assemblaggio usando le lunghe letture tagliate con Medaka (v2.1.1) per migliorare significativamente la precisione del consenso.
NOTA: Sebbene i colpi di lucidatura extra possano aiutare con la precisione del consenso, possono anche introdurre errori. È buona prassi utilizzare un programma come DNAapler per ruotare il nuovo contig prima di lucidare; I comandi si trovano nella sezione Comandi Supplementari.
5. Metodo 5: Annotazione
NOTA: Esistono molti strumenti efficaci di annotazione per i batteri. I seguenti programmi sono raccomandati per un'annotazione approfondita.
- Bakta è ottimo per le analisi proteomiche perché attualmente è attivamente mantenuto e funge da successore spirituale di Prokka41,42.
- Per la tipizzazione dei repliconi, la tipizzazione della mobilità plasmidiale e la tipizzazione della coniugazione, MOB-suite èaffidabile 6. MOB-suite può dedurre la filogenesi plasmidiale usando il distanziamento del mash e può identificare gli elementi43 della sequenza di inserzione (IS).
- COPLA è anche uno strumento utile per la tassonomia dei plasmidi. L'approccio unico di Copla, che classifica i plasmidi in unità tassonomiche dei plasmidi, è raccomandato nelcampo 44.
NOTA: La filogenesi dei plasmidi ha storicamente posto sfide significative perché la struttura modulare dei plasmidi e l'alta frequenza di ricombinazione rendono difficile l'allineamento delle sequenze. COPLA affronta queste sfide calcolando le identità medie dei nucleotidi (ANI).
Risultati
Ceppi clinici di E. coli
Per illustrare l'uso dell'ONT per il sequenziamento dei plasmidi da ceppi clinici, gli autori hanno sequenziato 10 ceppi, che sono stati un generoso dono del dottor Stephen Salipante dell'Università di Washington. Questi ceppi facevano parte di una raccolta di 312 isolati di E. coli patogeno extraintestinale (ExPEC), ottenuti durante le cure cliniche di routine presso l'University of WashingtonMedical Center 45.
Coniugazione e caratterizzazione dei plasmidi tramite saggio di mobilità in gel
I ricercatori hanno inoltre effettuato un test di coniugazione utilizzando il ceppo di E. coli LMB100 come ricevente. La coniugazione è un processo che porta al trasferimento di un plasmide presente in una cellula (il donatore) a un'altra cellula (chiamata ricevente)46. Il trasferimento richiede un contatto fisico tra le due cellule ed è tipicamente rilevato tramite marcatori che indicano la presenza del plasmide coniugativo nelle cellule riceventi. Questo ha permesso agli autori di eliminare le differenze nella ceppa dell'ospite come variabile e di illustrare l'uso del protocollo per il sequenziamento dei plasmidi ottenuti tramite cattura dei plasmidi (un metodo utilizzato per profilare plasmidi di una determinata nicchia ecologica). Tutti i saggi di coniugazione hanno prodotto transconiuganti, confermando la presenza di un plasmide coniugativo nei donatori. Il protocollo seguito dagli autori è descritto in36. Il gruppo identificò i plasmidi presenti nei ceppi donatori e riceventi e ne stimò la mobilità tramite elettroforesi su gel a campo impulsivo (PFGE). Un elenco di dieci ceppi donatori rappresentativi è mostrato nella Tabella 8, e le dimensioni stime dei plasmidi presenti in essi sono elencate nella terza colonna. I plasmidi al di fuori dell'intervallo di risoluzione del gel PFGE sono esclusi da questa tabella, ma i ricercatori sono riusciti ad assemblare diversi plasmidi più piccoli intorno a ~4kb (non mostrati).
| Ceppo donatore | Plasmide | Dimensione stimata del PFGE | Lunghezza dell'assemblaggio | Profondità media | bp Profondità zero | Percentuale di copertura | Cambi di posizione | Percentuale di accuratezza pre-SR |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tabella 8: Stime della dimensione del plasmide e metriche di accuratezza del sequenziamento per un pannello di 10 ceppi donatori. Sono elencate stime della dimensione del plasmide basate su PFGE o sequenze assemblate di plasmidi donatori ONT. I confronti a coppie tra assemblaggi plasmidi lucidati solo ONT e SR sono anch'essi mostrati come indicatore di accuratezza. Le metriche includono: lunghezza di assemblaggio, profondità media, regioni a profondità zero, percentuale di copertura, posizioni modificate e percentuale di accuratezza pre-SR.
Metriche di output per sequenziamento plasmidico basate su ONT
La corsa di sequenziamento era impostata per 24 ore. Un totale di 24 campioni sono stati multiplexati. I dati tecnici per ciascun campione, inclusi punteggio di qualità (Q), lunghezza e copertura, sono elencati nella Tabella 9. Il sequenziamento nanopore ha prodotto un'uscita di lettura e una qualità sufficienti per tutti i campioni analizzati. In tutte le librerie, il sequenziamento generava in media 134.115 letture per campione, corrispondente a una resa media di 576,2 Mb. Le letture avevano una lunghezza media di 8.797 bp con un N50 medio di 3.693 bp, fornendo sufficiente continuità di lettura per l'assemblaggio dei plasmidi. Il punteggio medio di qualità di lettura era Q16.0 con una mediana di Q16.6, e le corse individuali variavano da Q13.7 a Q18.0.
| Deformazione sequenziata | Letture (KB) | Basi (Mb) | Lunghezza media | Lunghezza massima | Lunghezza minima | N50 | Lunghezza mediana | Q media | Mediana Q | |
| Blood_08_0081 donatore | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 donatore | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 donatore | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 donatore | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 donatore | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 donatore | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 donatore | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 donatore | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 donatore | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 donatore | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 trasconiugante LMB100 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 trasconiugante LMB100 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 trasconiugante LMB100 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 trascongiugato LMB100 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 trasconiugante LMB100 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 trasconiugante LMB100 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 trasconiugante LMB100 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 trasconiugante LMB100 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 trasconiugante LMB100 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 trascongiugente LMB100 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tabella 9: Rapporto NanoQ delle metriche di output del sequenziamento per un pannello di 10 ceppi donatori. Le metriche di output di sequenziamento sono elencate. Questi includono leture, basi, lunghezza (media, mediana, massimo e minimo), lunghezze, N50 e valori Q (media e mediana) da donatori e transconiuganti.
Assemblaggio e precisione del plasmide
Le sequenze plasmidiche venivano assemblate utilizzando Autocycler34. Le dimensioni delle sequenze plasmidiche assemblate per 10 dei campioni sono elencate nella Tabella 8, quarta colonna, e in tutti i casi erano congruenti con le stime basate sulla mobilità del PFGE (elencate nella terza colonna). L'accuratezza veniva valutata confrontando gli assemblaggi a lettura lunga lucidati con Medaka con gli assemblaggi Medaka (v2.2.0) più polipolish (v0.6.1). L'identità della sequenza è stata calcolata utilizzando dnadiff da MUMmer (v3.2.4) (Tabella 8). In tutti i plasmidi analizzati (n = 12), gli assemblaggi avevano una lunghezza media di 120,4 kb e erano supportati da una profondità media di sequenziamento di 109x, con una copertura media del 97,9% tra le sequenze plasmidi. Prima della lucidatura, gli assemblaggi mostravano un'identità media della sequenza del 99,74% rispetto all'assemblaggio lucidato dalla sequenza SR.
Stima della contaminazione cromosomica
Per stimare la copertura plasmidica e la contaminazione cromosomica, le letture sono state mappate sulle sequenze plasmidiche assemblate e sulla sequenza cromosomica LMB100 di E. coli. Le letture Nanopore chiamate in base venivano allineate usando minimap2 (v2.2.6). Gli allineamenti risultanti venivano elaborati utilizzando SAMtools (v1.1.7) per generare file BAM ordinati e calcolare statistiche di mappatura. La copertura plasmidica e la profondità media sono state stimate utilizzando la copertura di SAMtools. La profondità di sequenziamento dei plasmidi variava tra i campioni ma rimaneva ben al di sopra della copertura minima richiesta per un assemblaggio accurato (50–70 x). Una frazione delle letture è stata mappata sul cromosoma, indicando il trasferimento del DNA ospite durante l'estrazione del plasmide (Tabella 10).
| Plasmidi | Totali letture | Letture cromosomiche | Percentuale di letture cromosomiche | Copertura cromosomica media | Copertura media dei plasmidi | Rapporto P:C |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tabella 10: Stime della contaminazione da DNA cromosomico. La contaminazione cromosomica nei plasmidi purificati da ceppi riceventi è stata quantificata come proporzione di letture che si mappano alla sequenza cromosomica LMB100 rispetto alle letture plasmidiali. Per ogni plasmide sono elencate le letture dei plasmidi, le letture totali, le letture cromosomiche, la copertura cromosomica media, la copertura media dei plasmidi e il rapporto P:C. Si noti che pBlood_08_0081_1 è assente perché non è stata recuperata nel ricevente, e queste stime sono state effettuate sui riceventi a causa del loro background cromosomico uniforme.
La contaminazione cromosomica è stata quantificata come la proporzione di letture che si mappano alla sequenza cromosomica LMB100 assemblata rispetto alle letture plasmidiali. I tassi di contaminazione cromosomica variavano tra il 72,1% e il 28,0%, con una media del 46,9% (Tabella 10). Il metodo probabilmente sovrastima la contaminazione cromosomica perché le letture che la mappatura sia del plasmide che del cromosoma sono conteggiate come solo cromosomiche, ma indica comunque un sostanziale trasferimento cromosomico. Nonostante questo mantenimento cromosomico, il flusso di lavoro dell'assemblaggio ricostruì con successo sequenze complete di plasmidi, che erano ancora coerenti con la dimensione prevista dalla mobilità del PFGE su tutti i campioni (Tabella 8, terza e quarta colonna).
Coppie rappresentative donatore-ricevente di plasmidi coniugativi
Lo ceppo upec271 è stato isolato da un campione urinario tra il 2011 e il 2013 ed è stato assegnato al filogruppo B2 e al tipo di sequenza ST131. L'analisi PFGE ha rivelato la presenza di una banda corrispondente a un plasmide di circa 145 kb [Figura 3A, (Donatore)]. L'analisi di sequenza a lettura breve ha identificato la presenza di un replicone IncF.
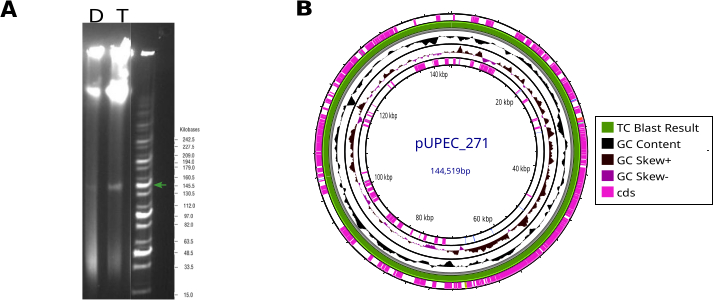
Figura 3: Caratterizzazione di pUPEC271. (A) PFGE di donatore e transconiugante. Sono mostrate le bande PFGE per il donatore (D) e il transconiugante (T); le frecce verdi indicano la banda plasmidiale corrispondente a pUPEC271. Il protocollo utilizzato per la PFGE è descritto in uno studio36. (B) Mappa di pUPEC271. Il transconiugante è stato lanciato contro il donatore, e il consenso (che è identico al 100%) è mostrato come l'anello verde. Questa rappresentazione è stata generata utilizzando Proksee48. L'anello più esterno mostra la posizione del CDS, due anelli interni mostrano il contenuto e il distorsione GC, e l'anello più interno mostra la posizione dei geni tRNA. Clicca qui per visualizzare una versione più grande di questa figura.
Il trasferimento di questo plasmide, che gli autori chiamarono pUPEC271, fu ulteriormente confermato dall'analisi PFGE utilizzando il protocollo precedentemente descritto in36 [Figura 3A, T(transcongiugante)]. Il DNA plasmidico purificato dal ceppo donatore upec271 (pUPEC271_donor) è stato sequenziato utilizzando nanoporo. In linea con la dimensione della sua banda sul gel PFGE, la sequenza pUPEC271_donor ha rivelato un plasmide di 144.519 bp (Figura 3B). Questo plasmide aveva un replicone di tipo IncF e ospitava geni di resistenza a sei distinte classi di antibiotici (vedi Tabella Supplementare 1). Gli autori hanno anche purificato il DNA da uno dei transconiuganti (pUPEC271_TC) e ottenuto una sequenza identica a quella del donatore. L'assemblaggio finale, confrontato con pUPEC271_donor, è rappresentato nella Figura 3B. Questo confermò che il plasmide coniugativo presente nel donatore era stato trasferito al ceppo transconiugante. I dati tecnici sono mostrati nella Tabella 9.
Il Blood_10_0913 di deformazione è un esempio di ceppo con più di un plasmide. Questo campione è stato raccolto dal sangue tra il 2008 e il 2013, e il sequenziamento a lettura breve ha indicato la presenza di due repliconi, uno IncF e uno IncY. L'analisi PFGE di questo ceppo ha identificato due plasmidi rispettivamente di circa 70 e 110 kb (Figura 4A). Ciò è stato confermato dal sequenziamento nanoporo, che ha prodotto due assemblaggi, rispettivamente di 71.182 bp e 111.226 bp. Gli autori hanno nominato questi due plasmidi pBlood_10_0913_1 e pBlood_10_0913_2 (Figura 4B). Tuttavia, inizialmente gli assemblaggi non si circolarizzarono a causa dell'estesa omologia di successione nella sezione dei plasmidi che ospitava la macchina di coniugazione (la sezione di omologia estesa è evidenziata nella Figura 4B). Il diagramma di assemblaggio fallito, generato usando la benda47 , è mostrato nella Figura 4C. L'assemblaggio completo dei due plasmidi era possibile solo dopo una lettura aggressiva di sequenze a lettura più corta (< 3000 bp).
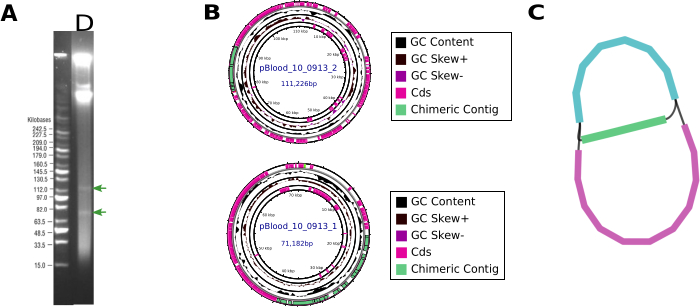
Figura 4: Identificazione e assemblaggio dei plasmidi di Blood_10_0913 ceppo. (A) PFGE. Le frecce verdi indicano le bande plasmidi. Il protocollo utilizzato per il PFGE è descrittonell'assemblaggio della sequenza 36 (B). Assemblaggio dei due plasmidi più piccoli presenti nel campione pBlood_10_0913, pBlood_10_0913_2 e pBlood_10_0913_2. (C) Assemblaggio fallito. Rappresentazione del fallimento dell'assemblaggio dovuta alla presenza di una sequenza condivisa tra due assiemi distinti. Questa rappresentazione è stata generata utilizzando la benda47. Clicca qui per visualizzare una versione più grande di questa figura.
Tabella supplementare 1: Geni di resistenza trasportati da pUPEC271. Sono mostrate la dimensione del plasmide, i repliconi e i geni di resistenza associati a pUPEC271. Clicca qui per scaricare questo file.
Comandi Supplementari. Clicca qui per scaricare questo file.
Discussione
L'identificazione e la caratterizzazione dei plasmidi sono di grande interesse per la salute pubblica, la microbiologia clinica e l'ecologia microbica, poiché facilitano il mantenimento e la diffusione dei geni adattivi in contestiecologici 1,5 e fungono da piattaforme per un'evoluzioneaccelerata 4. L'introduzione delle tecnologie NGS ha permesso il sequenziamento ad alta velocità dei genomi di isolati microbici e di popolazioni, anche se l'identificazione post-assemblaggio di plasmidi completi o di conti derivati dai plasmidi generalmente richiede sequenze a lettura lunga perché i dati di sequenziamento a lettura breve non riescono a risolvere regioni ripetute maggiori della dimensione delle letture. ONT è diventato un approccio molto popolare per il sequenziamento a lunga lettura, con applicazioni che vanno oltre il sequenziamento dell'intero genoma e la metagenomica, che includono la verifica delle sequenze plasmidi, la rilevazione e caratterizzazione di modifiche epigenetiche, il sequenziamento dell'RNA e la valutazione dell'instabilità intrinseca degli array genici tandem (revisionati in12,49).
Qui, i ricercatori presentano un flusso di lavoro per il sequenziamento ONT dei plasmidi progettato per situazioni in cui la sequenza cromosomica è già nota o non ha alcun interesse. La ragione è che l'estrazione dei plasmidi è laboriosa, costosa e richiede tempo (poiché la popolazione ospite deve essere coltivata in coltura e processata), e il sequenziamento dell'intero genoma utilizzando la tecnologia nanopore è spesso sufficiente per ottenere assemblaggi completi dei plasmidi fornendo il loro contesto genomico. Esempi in cui il protocollo è utile includono la verifica di una sequenza plasmidica nel contesto dell'ingegneria geneticadei plasmidi 50,51, il miglioramento dell'accuratezza delle sequenze plasmidiche già ottenute dalWGS 24, o la caratterizzazione dei plasmidi catturati da campioni clinici o ambientali tramite coniugazione.
L'estrazione del DNA da campioni clinici e ambientali potrebbe richiedere una certa personalizzazione. Qui, gli autori riportano che alcuni dei ceppi clinici utilizzati hanno prodotto una matrice di biofilm che ostruiva i filtri, richiedendo molteplici fasi di pelleting e talvolta richiedendo l'aggiunta di due filtri. Inoltre, per sequenziare plasmidi coniugativi, è necessario un volume di coltura maggiore rispetto al sequenziamento dei plasmidi multicopia, poiché i plasmidi di medie e grandi dimensioni naturali tendono ad avere un numero di copiadi plasmide basso 2.
Il protocollo ha permesso il sequenziamento di plasmidi tra 4 kb e 173 kb di dimensione. Questa gamma rientra esattamente nelle specifiche del produttore (tra 2 e 200 kb). Recentemente, uno studio ha esaminato 23.000 sequenze di plasmidi depositate nel NCBI e ha riscontrato differenze significative di dimensione a seconda della fonte, con plasmidi di origine umana che presentano la dimensione mediana più piccola (76 kb), e plasmidi di suolo e piante i maggiori (215 e 427 kb, rispettivamente); I plasmidi provenienti da tutte le altre fonti avevano una dimensione mediana compresa tra 79 e 147 kB, quindi questo protocollo dovrebbe coprire la maggior parte dei plasmidi, con la possibile eccezione dei megaplasmidi52 e dei plasmidi di origine del suolo odelle piante 3.
Gli autori includono un passaggio di arricchimento del DNA plasmidico per migliorare l'accuratezza degli assemblaggi del DNA plasmidico. La presenza di grandi quantità di DNA cromosomico allaga i pori cellulari sulla cellula di flusso sequenziante con letture non bersaglio, riducendo sostanzialmente la profondità del DNA plasmidicale. Era già stato implementato un passaggio di arricchimento del DNA plasmidico per tentare l'assemblaggio completo del DNA plasmidico in campioni clinici per la rilevazione degli ARG24. Questo ha mostrato miglioramenti sostanziali nell'efficacia del completamento dell'assemblaggio dei plasmidi con sequenze solo a nanopori (78% degli assemblaggi completi rispetto al benchmark). Altri esempiseguirono 50, 53, 54.
Per migliorare la precisione delle letture, due di questi studi hanno utilizzato una tecnica sviluppata da nanopore chiamata "chiamata a base accoppiata su letture pseudopare"50,53. Questo approccio prevede l'allineamento dei segnali elettrici grezzi provenienti dai filamenti sensoriali e antisensi della stessa molecola di DNA, con conseguente miglioramento della precisione di circa un ordine di grandezza. Il peercalling a base su letture pseudo-pareate è compatibile con il multiplexing, purché la strategia consenta l'identificazione dei filamenti diretti e inversi della stessa molecola. Pertanto, non può essere utilizzato in plasmidi purificati da campioni di complemento plasmidico sconosciuto o contenenti una miscela di plasmidi. Si noti che il numero di plasmidi in un genoma varia tipicamente tra 0 e 7 plasmidi (in particolare negli isolati clinici)2,55.
I ricercatori hanno notato un alto livello di contaminazione cromosomica nei campioni (Tabella 10). Il livello di contaminazione di 10 campioni analizzati variava tra il 28 e il 72% secondo la mappatura delle leture. Tuttavia, quando i ricercatori hanno normalizzato questa sequenza alla dimensione del cromosoma rispetto a quella del plasmide o dei plasmidi presenti, si è scoperto che le sequenze plasmidiche erano in media 144 volte più abbondanti di quelle cromosomiche. Tradurre questo numero al livello di arricchimento del DNA plasmidico richiederebbe di conoscere il numero di copie plasmidiche in ciascun campione.
Le celle di flusso MinION producono tipicamente un'uscita di sequenziamento di ~30 GB, consentendo teoricamente il sequenziamento di oltre 96 plasmidi per run. In pratica, il multiplexing è anche vincolato dal limite di 96 codici a barre, rendendo 96 plasmidi il limite superiore pratico per cella di flusso. Tuttavia, la contaminazione da DNA cromosomico e lo squilibrio naturale dei codici a barre riducono la profondità effettiva di lettura per campione. Per garantire una profondità di lettura sufficiente per ogni campione, un approccio più conservativo consiste nel multiplexare circa 24 plasmidi per cella di flusso. La profondità raccomandata per l'assemblaggio accurato della sequenza plasmidiale è compresa tra 50 e70x32,56. Negli esempi illustrativi presentati in questo articolo, gli autori hanno analizzato 21 campioni multiplexati in una cella di flusso e ottenuto una profondità media (109x), che si allinea bene con l'ottimale del campione raccomandato per cella di flusso.
Si noti che, con una profondità di lettura eccessa, le partizioni di lettura pass/fail sono meno informative per valutare la qualità complessiva della lettura. Invece, le metriche derivate dalla distribuzione della lunghezza forniscono una rappresentazione più chiara della qualità del dataset. Una di queste metriche è l'N50, definita come la lunghezza di lettura a cui le letture di quella lunghezza o più rappresentano il 50% del totale delle basi. Questo valore è altamente sensibile ai passaggi di controllo qualità. Ad esempio, filtrare letture di bassa qualità o brevi con strumenti come Filtlong rimuove una frazione sostanziale della coda più corta della distribuzione, gonfiando così l'N50. Questo effetto è evidente nella Tabella 9.
Gli autori hanno utilizzato il kit Rapid Barcode di ONT, che utilizza un trasosoma per frammentare il DNA plasmide, e quindi non richiede una conoscenza preventiva del modello di restrizione del plasmide. Uno studio precedente ha rilevato che per plasmidi piccoli (<20 kb), la frammentazione enzimatica è necessaria perché i plasmidi piccoli rimangono circolarizzati durante la maggior parte delle estrazioni di DNA e quindi non contengono estremità libere per la ligaturadell'adattatore 54. Quello studio non ha utilizzato codici a barre, che generano ulteriori estremità libere tramite amplificazione PCR, quindi in questo caso è probabilmente irrilevante. OnRamp, una delle procedure avanzate per la validazione di plasmidi di routine, evita l'uso di codici a barre sfruttando letture di plasmidi a lunghezza intera per l'assemblaggio, semplificando la preparazione delcampione 54. In questo caso, gli autori preferivano i codici a barre per tre motivi. La prima è costruire un assemblaggio indipendentemente dalla lunghezza del plasmide. La seconda è tollerare la contaminazione da DNA cromosomico. Il terzo è che questo apre la possibilità di multiplexare diversi campioni, come detto sopra.
Uno studio precedente ha osservato che l'aggregazione di diversi assemblatori ha migliorato il risultato finale annullando i bias integrati nelle singole piattaformedi assemblaggio 24. Questa meta-analisi è una funzionalità che è stata incorporata nel programma di assemblaggio utilizzato dagli autori, Autocycler34. Rispetto alla sua versione precedente, chiamata Trycycler57, Autocycler è un po' più automatizzato; Utilizza diversi sottoinsiemi delle letture e (come già detto) esegue assemblaggi con più assemblatori per creare un assemblaggio consenso più accurato. Tuttavia, la maggior parte degli assemblatori, anche i migliori, come Flye28, Canu29 e Raven30, ha difficoltà con la presenza di plasmidi con un'ampia omologia di sequenza, unendo erroneamente sequenze plasmidiche o generando più copie di un singolo plasmide, e sono soggetti a mancare piccoliplasmidi 58,59 (vedi anche Figura 4C). Quando ciò accade, eliminare letture di qualità inferiore e rimuovere letture brevi può portare alla risoluzione dei contigi chimerici.
Per stabilire l'accuratezza complessiva dei protocolli di sequenziamento, gli autori hanno confrontato gli assembly solo ONT con assembly rifiniti combinando letture lunghe e brevi, che (a meno dei dati PacBio) è lo standard d'oro attuale. Gli autori avevano anche dati in gel che mostravano il numero di plasmidi presenti e le loro dimensioni stimate (Tabella 8, terza colonna). I ricercatori hanno assemblato con successo tutti i 13 plasmidi presenti nei 10 campioni e hanno ottenuto dimensioni coerenti con le sequenze assemblate. Questo è un notevole successo, poiché gli assemblatori di sequenze LR spesso non riescono ad assemblare plasmidi con sequenze strutturalmente complesse. A un livello più granulare, i confronti a coppie tra i due insiemi di sequenze indicavano un livello variabile di accuratezza (Tabella 8). Cinque degli assemblaggi plasmidiali avevano aree senza copertura negli assemblaggi ONT, presumibilmente il risultato di sequenze aggiunte artificialmente durante l'assemblaggio della sequenza solo ONT. Degli altri sette, tre hanno mostrato polimorfismi a singolo nucleotide, con differenze a coppie che variano tra lo 0,0023 e lo 0,05%, e quattro hanno mostrato concordanza perfetta. Il livello di accuratezza non sembra corrispondere al livello di arricchimento del DNA plasmidico o alla profondità di sequenziamento, ma la presenza di più di un plasmide in un dato campione sì, probabilmente perché avere più di un plasmide tende ad amplificare il livello di complessità della sequenza (Tabella 8). In sintesi, il flusso di lavoro è progettato per ottimizzare la resa e l'accuratezza delle sequenze plasmidiali. Sebbene sia in grado di assemblare sequenze plasmidi, produce un livello variabile di accuratezza a livello nucleotidico. Il protocollo può essere utilizzato per sequenziare plasmidi di un'ampia gamma di dimensioni, tollera almeno il 72% di contaminazione da DNA cromosomico e può ospitare (a seconda della dimensione del plasmide e dello stato della cella di flusso) almeno 24 plasmidi in una singola cella di flusso.
Dichiarazioni
Gli autori non hanno nulla da rivelare.
Ringraziamenti
Siamo molto grati a Steve Salipante (Università di Washington) per aver condiviso generosamente un set di ceppi clinici di E. coli pubblicati in45. Questo lavoro è stato parzialmente supportato da fondi di supporto alla ricerca per una nomina alla Direzione in Innovazione e Sviluppo Imprenditoriale da UCSC a MC e dalla sovvenzione Alianza MX dell'Università della California "Profilazione genomica degli isolati di tubercolosi tra popolazioni ad alto carico e vulnerabili in Messico: approfondimenti sulla trasmissione e la resistenza ai farmaci" alla MC.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Può essere sostituito da un altro marchio |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Può essere sostituito da un altro marchio |
| 15 mL conical tubes | FALCON | 352096 | Può essere sostituito da un altro marchio |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Può essere sostituito da un altro marchio |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Può essere sostituito da un altro marchio |
| 250 mL sterile flasks | PYREX | 5320 | Può essere sostituito da un altro marchio |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Può essere sostituito da un altro marchio |
| Centrifuge | Eppendorf | 5424R-PR-R | Può essere sostituito da un altro marchio |
| Centrifuge | Eppendorf | 5810R-P-R | Può essere sostituito da un altro marchio |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Può essere sostituito da un altro marchio |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Può essere sostituito da un altro marchio |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Può essere sostituito da un altro marchio |
| Ethanol | Fisher Scientific | 04-355-720 | Può essere sostituito da un altro marchio |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Può essere sostituito da un altro marchio |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Qualsiasi marchio di guanti in nitrile funziona |
| Ice bucket | Thermo Fisher Scientific | 432128 | Può essere sostituito da un altro marchio |
| Isopropanol | Fisher Scientific | BP26184 | Può essere sostituito da un altro marchio |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Può essere sostituito da un altro marchio |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Può essere sostituito da un altro marchio |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Le micropipette devono essere calibrate |
| Spectrophotometer | Thermo Scientific | 335905P | Può essere sostituito da un altro marchio |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Può essere sostituito da un altro marchio |
| Water bath | Thermo Scientific | 51221052 | Può essere sostituito da un altro marchio |
Riferimenti
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Ristampe e permessi
