Questo articolo presenta un protocollo progressivo per la raccolta di dati di eye-tracking ad alta precisione negli esperimenti di lettura umana, che comprende la selezione dell'hardware e del display, l'allestimento del laboratorio, la gestione dei partecipanti, la calibrazione e la validazione, il controllo di qualità in tempo reale e il preelaborazione (rilevamento degli eventi e correzione della deriva) per ottenere dati ad alta accuratezza e precisione e risultati riproducibili.
Articolo metodologico
Protocollo metodologico per la raccolta di dati di alta qualità durante l'eye tracking nella lettura umana
In questo articolo
Sommario
Abstract
Il tracciamento oculare è un approccio metodologico centrale per lo studio dell'attenzione e dell'elaborazione del linguaggio durante la lettura. La validità e la riproducibilità dei risultati dipendono dalla qualità dei dati, da una metodologia chiara e da un preelaborazione coerente. Questo articolo presenta un protocollo completo, passo dopo passo, per la raccolta di dati di tracciamento oculare di alta qualità negli studi sulla lettura. Il protocollo inizia con la preparazione dell'ambiente di laboratorio e la configurazione dell'apparecchiatura, prosegue con la selezione e configurazione dell'hardware e del software per il tracciamento oculare, e con la preparazione degli stimoli e la progettazione sperimentale. Vengono gestiti i partecipanti, ottenuto il consenso informato e documentate le caratteristiche linguistiche e psicometriche. Successivamente vengono eseguite le procedure di calibrazione e validazione, monitorando attentamente in tempo reale il comfort del partecipante e la qualità dei dati durante la raccolta. La pipeline di preelaborazione include l'esportazione dei dati grezzi in formati standard, la pulizia dei dati, il rilevamento di fissazioni e saccadi (utilizzando algoritmi basati sulla velocità e su quelli basati sulla dispersione) con parametri chiaramente definiti, l'ispezione visiva per la perdita di segnale e il controllo del rumore, la correzione della deriva verticale per testi su più righe ed estrazione di misure standard di lettura (durata della fissazione, metriche delle saccadi, omissione di parole e frequenza di regressioni). Durante tutto il protocollo, viene particolarmente enfatizzata l'allineamento tra le domande di ricerca e le specifiche dell'hardware, la gestione della deriva mediante controlli regolari e una descrizione dettagliata di tutti i parametri e le decisioni critiche. Una raccolta dati riuscita produce tipicamente un'accuratezza di validazione stabile entro limiti prestabiliti, tassi bassi di perdita dati e distribuzioni interpretabili delle durate di fissazione e del comportamento delle saccadi, che riproducono effetti ben noti legati alla lunghezza, frequenza e prevedibilità delle parole. Il protocollo è compatibile con sistemi di tracciamento oculare da banco, ambienti software comuni e configurazioni sia con testa stabilizzata che libera, affrontando questioni pratiche come le condizioni di illuminazione, i riflessi dagli occhiali e i cambiamenti nella postura del partecipante. Questo studio presenta un protocollo chiaro e pratico che unifica le indicazioni metodologiche in un flusso di lavoro integrato. Ha lo scopo di supportare la raccolta affidabile di dati di tracciamento oculare nella ricerca sulla lettura, promuovere la riproducibilità e le meta-analisi, migliorare la coerenza tra laboratori e gruppi e, in ultima analisi, rafforzare la credibilità scientifica della ricerca sulla lettura.
Introduzione
Il tracciamento oculare è un metodo centrale per lo studio dell'attenzione e dell'elaborazione del linguaggio durante la lettura, poiché le fissazioni e i movimenti saccadici indicano l'allocazione momento per momento delle risorse visive e cognitive agli stimoli. Recensioni classiche e contemporanee documentano solide connessioni tra i movimenti oculari e costrutti teorici come l'ampiezza percettiva, il vantaggio di anteprima e i modelli di controllo dei movimenti oculari1,2. Per condurre studi affidabili che esaminino tali connessioni, è essenziale un rigore metodologico nella scelta dell'apparecchiatura, nella progettazione sperimentale, nella calibrazione e validazione e nella preelaborazione; in caso contrario, il degrado della qualità dei dati altera le stime e compromette la riproducibilità3.
Negli ultimi dieci anni, diversi articoli introduttivi e di buone pratiche hanno consolidato le conoscenze metodologiche del settore. Una recente serie di articoli fondamentali collega la teoria alle misurazioni, discute l'operazionalizzazione e la variabilità degli algoritmi e fornisce indicazioni per la scelta di eye tracker adatti a specifiche domande di ricerca4,5,6,7,8. Linee guida complementari presentano le migliori pratiche per la selezione dell'hardware, per garantire accuratezza e precisione, per definire le misurazioni e per la loro reportistica, con raccomandazioni per ridurre le minacce alla validità9. Risorse introduttive per la ricerca sulla lettura offrono inoltre panorami accessibili sulla progettazione degli esperimenti, sulle misurazioni più comuni e sui flussi di analisi10,11. In ambito linguistico applicato e nella ricerca sulla lettura, recensioni specifiche per il settore riassumono la selezione di misurazioni e dispositivi di tracciamento, evidenziando i vincoli dipendenti dal compito12,13,14,15,16,17.
Questo articolo traduce tali indicazioni in un protocollo passo dopo passo per la raccolta di dati ad alta precisione mediante eye-tracking in studi sulla lettura. A differenza delle risorse esistenti, che offrono principalmente linee guida teoriche generali sulle migliori pratiche o si concentrano esclusivamente su specifiche tecniche analitiche, questo protocollo rende operativi tali concetti in un flusso di lavoro completo ed eseguibile. L'obiettivo è facilitare la pratica quotidiana in laboratorio fornendo istruzioni concrete e sequenziali. Per quanto riguarda l'applicabilità, il protocollo è stato specificamente ottimizzato per esperimenti di lettura in laboratorio altamente controllati, che utilizzano eye-tracker fissi ad alta frequenza (ad esempio 500-2000 Hz) con configurazioni di stabilizzazione della testa (appoggio per il mento o per la fronte). È particolarmente indicato per ricerche che richiedono stringenti requisiti di qualità dei dati, elevata accuratezza spaziale e precisione, come studi che analizzano fissazioni a livello di singola parola o metriche finemente dettagliate dei movimenti saccadici.
L'uso di configurazioni senza supporto per la testa o di tipo naturalistico sta ottenendo crescente popolarità, anche nella ricerca sulla lettura, anche se nel presente articolo ci limitiamo a studi di laboratorio. Vengono trattati la selezione di hardware e software, l'allestimento del laboratorio, la preparazione degli stimoli, la gestione dei partecipanti, la calibrazione e la validazione, il controllo di qualità in tempo reale e la pre-elaborazione dei dati (inclusa la rilevazione degli eventi e la correzione delle deriva). Seguendo il protocollo, i ricercatori possono documentare e ottenere una qualità dei dati conforme agli standard attuali, migliorando così la trasparenza, la credibilità e la riproducibilità dei risultati legati alla lettura.
Protocollo
L'autorizzazione etica per la raccolta dati del COST CA21131 è stata concessa dal Comitato Etico per la Ricerca della Facoltà di Filosofia dell'Università Jagellonica, Polonia, con il numero di protocollo 221.0042.18_2024. Il consenso informato è stato ottenuto da tutti i partecipanti.
1. Preparazione dell'ambiente di laboratorio e configurazione dell'attrezzatura
- Preparazione dell'ambiente di laboratorio
- Verificare le condizioni di illuminazione e di rumore ambientale. Le finestre nell'ambiente del laboratorio possono causare improvvisi cambiamenti nella dilatazione della pupilla e riflessi di luce sulla telecamera del sistema di eye tracking e sul monitor. Se possibile, raccogliere i dati in una stanza senza finestre o utilizzare tende oscuranti per bloccare la luce solare. Utilizzare un'illuminazione artificiale ed eliminare fonti di luce riflettente. Verificare che non compaiano riflessi sul monitor; regolare tapparelle o angolazioni finché non siano completamente eliminati. Assicurarsi che l'ambiente sia silenzioso e prevenire interruzioni (ad esempio, mediante cartelli o serrature delle porte). Utilizzare segnali esterni per evitare interruzioni (ad esempio, posizionare un avviso all'esterno con la scritta: “Esperimento in corso. Si prega di non bussare né entrare nella stanza.”)
- Verificare l'ergonomia fisica. Utilizzare una sedia stabile e non girevole; regolare l'altezza del tavolo (se possibile) per mantenere una postura corretta ed evitare la perdita di calibrazione dovuta alla rotazione della sedia.
- Evitare la presenza sociale. La presenza di un sperimentatore nella stessa stanza potrebbe distrarre il partecipante. Separare la stanza di controllo da quella del partecipante, oppure mantenere lo sperimentatore fuori dalla vista, per minimizzare gli effetti della presenza sociale.
- Verificare la ventilazione dell'aria. Arieggiare la stanza prima e dopo le sessioni sperimentali. Controllare la temperatura ambiente, poiché i partecipanti dovranno rimanere immobili per un certo periodo di tempo.
- Selezione dell'equipaggiamento per l'eye tracking
- Verificare la compatibilità tra obiettivi di ricerca e misure. Gli obiettivi di uno studio specifico, e quindi le misure target (variabili dipendenti), dovrebbero corrispondere alle capacità del sistema di eye tracking. La disponibilità istituzionale dell'equipaggiamento potrebbe introdurre limitazioni all'ambito dello studio previsto. Verificare le tre caratteristiche principali del sistema di eye tracking (frequenza di campionamento, precisione e accuratezza) e la loro idoneità a soddisfare le esigenze della ricerca. L'obiettivo principale è garantire che le prestazioni dell'equipaggiamento siano compatibili con gli obiettivi dello studio.
NOTA: Frequenza di campionamento = La frequenza di campionamento è espressa in Hz e indica la dimensione dei campioni raccolti dal sistema di eye tracking in un determinato periodo: un eye tracker a 60 Hz raccoglie campioni ogni 16 ms, mentre un eye tracker a 500 Hz raccoglie campioni ogni 1 ms. Questo influisce sui diversi tipi di misurazione, poiché eye tracker a bassa frequenza potrebbero classificare saccadi iniziate durante un intervallo di 16 ms come fissazioni, o viceversa. Il campionamento talvolta viene confuso con l'accuratezza dei dati, ma si tratta di proprietà distinte.
Precisione = La coerenza con cui il sistema di eye tracking è in grado di raccogliere dati nel tempo.
Accuratezza = L'entità dell'errore tra il punto di fissazione rilevato dal sistema di eye tracking e il punto di fissazione effettivo.
Ad esempio, lo studio delle posizioni di atterraggio delle fissazioni sulle parole, descritte in termini di posizione dello sguardo sulle lettere di una parola, richiede una frequenza di campionamento (≥500-2000 Hz), una precisione e un'accuratezza molto più elevate rispetto a uno studio focalizzato esclusivamente sulla percentuale di saccadi regressive (rispetto a quelle progressive) durante la lettura. - Definire la metodologia di registrazione dei movimenti oculari. Utilizzare un eye tracker da banco con elevata frequenza di campionamento, precisione e accuratezza. Utilizzare un sistema di stabilizzazione della testa con supporto per il mento o per la fronte. Nel caso di eye tracking senza vincolo della testa (eye tracking remoto), utilizzare adesivi, se disponibili, sulla fronte del partecipante per migliorare il tracciamento del volto; evitare, a meno che non raccomandato dal produttore, adesivi riflettenti.
NOTA: L'uso di dispositivi indossabili per l'eye tracking è stato raro negli studi sulla lettura a causa della loro frequenza di campionamento, precisione e accuratezza relativamente basse rispetto agli eye tracker da banco, nonché per le difficoltà nell'analisi dei dati sui movimenti oculari. Tuttavia, negli ultimi dieci anni, configurazioni senza vincolo della testa o in contesti naturalistici hanno guadagnato popolarità, accompagnate da un miglioramento della qualità dei dati e da pipeline di analisi automatizzate, ampliando così l'ambito degli studi sui movimenti oculari durante la lettura verso contesti naturalistici e alla lettura in ambienti di realtà virtuale.
- Verificare la compatibilità tra obiettivi di ricerca e misure. Gli obiettivi di uno studio specifico, e quindi le misure target (variabili dipendenti), dovrebbero corrispondere alle capacità del sistema di eye tracking. La disponibilità istituzionale dell'equipaggiamento potrebbe introdurre limitazioni all'ambito dello studio previsto. Verificare le tre caratteristiche principali del sistema di eye tracking (frequenza di campionamento, precisione e accuratezza) e la loro idoneità a soddisfare le esigenze della ricerca. L'obiettivo principale è garantire che le prestazioni dell'equipaggiamento siano compatibili con gli obiettivi dello studio.
- Configurazione dell'hardware e del software
- Configurazione dell'hardware. Misurare le distanze tra il volto del partecipante, il monitor e il sistema di eye tracking. Impostare la distanza di visione secondo le indicazioni del produttore (ad esempio, ~60–70 cm) e la geometria di configurazione richiesta, preferibilmente utilizzando un monitor LCD piatto da 21–27 pollici (ad esempio, 24 pollici a 60 cm, campo visivo di ~48° x 28°), in modo che tutto il testo rimanga all'interno del campo visivo centrale e nel range efficace del tracker. Verificare l'inclinazione e la rotazione del monitor, e l'allineamento tra il vettore dello sguardo e la posizione corrispondente sullo schermo. Impostare le dimensioni del monitor e la frequenza di aggiornamento ai valori desiderati. Impostare la risoluzione dello schermo al valore specificato. Misurare la luminanza del monitor su sfondo bianco alla distanza specificata. Registrare il valore di luminanza nel rapporto della sessione.
- Se necessario, preferire monitor LCD con alta frequenza di aggiornamento (120 Hz o superiore, ad esempio 144–240 Hz), specialmente per compiti contingenti allo sguardo e per una temporizzazione verificata. Disattivare le tecnologie di aggiornamento variabile (G-Sync/FreeSync). Se il sistema di eye tracking viene utilizzato da diversi ricercatori per esperimenti differenti, è importante tenere traccia di ogni modifica apportata durante la raccolta dati. Alla fine di ogni sessione di raccolta dati, la configurazione deve essere ripristinata allo stato iniziale, o a quello definito dal protocollo del laboratorio.
- Configurazione del software. La maggior parte dei produttori di eye tracker fornisce software specifici, kit di sviluppo software (SDK) e/o librerie per garantire compatibilità e integrazione con software open source.
NOTA: Recentemente, alcune configurazioni specifiche sono rimaste una sfida tecnica che richiede soluzioni personalizzate. Ad esempio, la sincronizzazione temporale di un eye tracker con metodi complementari di misurazione, come EEG e fNIRS, richiede soluzioni hardware e/o software specifiche per garantire un adeguato livello di sincronizzazione tra l'orologio del sistema di eye tracking e l'orologio di presentazione degli stimoli, e/o per gestire la desincronizzazione con l'aggiornamento dello schermo. Pertanto, la maggior parte degli strumenti forniti dai produttori offre un ambiente per la progettazione di esperimenti che soddisfa le esigenze di base dei ricercatori, come la presentazione degli stimoli e la registrazione dei movimenti oculari. Un elenco dei pacchetti software attualmente disponibili è riportato nella Tabella dei Materiali.
- Configurazione dell'hardware. Misurare le distanze tra il volto del partecipante, il monitor e il sistema di eye tracking. Impostare la distanza di visione secondo le indicazioni del produttore (ad esempio, ~60–70 cm) e la geometria di configurazione richiesta, preferibilmente utilizzando un monitor LCD piatto da 21–27 pollici (ad esempio, 24 pollici a 60 cm, campo visivo di ~48° x 28°), in modo che tutto il testo rimanga all'interno del campo visivo centrale e nel range efficace del tracker. Verificare l'inclinazione e la rotazione del monitor, e l'allineamento tra il vettore dello sguardo e la posizione corrispondente sullo schermo. Impostare le dimensioni del monitor e la frequenza di aggiornamento ai valori desiderati. Impostare la risoluzione dello schermo al valore specificato. Misurare la luminanza del monitor su sfondo bianco alla distanza specificata. Registrare il valore di luminanza nel rapporto della sessione.
2. Progettazione e prova dell'esperimento
- Preparazione degli stimoli
- Preparare i materiali di lettura. I materiali di lettura sono solitamente presentati sotto forma di frasi o paragrafi, a seconda degli obiettivi dello studio. Si consiglia di estrarre i materiali di lettura da fonti disponibili piuttosto che creare manualmente il testo, purché questo metodo sia in linea con l'obiettivo dello studio.
- Verificare le condizioni di licenza per il riutilizzo del testo. Controllare le condizioni di licenza per tutti i testi. Se i materiali provenienti da esperimenti pubblicati sono open source e quindi pubblicamente disponibili per chiunque desideri utilizzarli, non è necessaria alcuna autorizzazione. In caso contrario, ottenere le autorizzazioni richieste prima dell'uso. È importante verificare se gli stimoli possano essere utilizzati per l'esperimento e se possano essere condivisi come materiali supplementari.
- Preparare stimoli formattati. La formattazione degli stimoli testuali richiede l'utilizzo di proprietà appropriate del carattere (tipo, dimensione, spaziatura tra lettere, parole e righe). Utilizzare un carattere monospazio con dimensione e spaziatura adeguata, tenendo conto delle impostazioni utilizzate in letteratura.
NOTA: Per esperimenti di lettura che utilizzano Aree di Interesse (AOI) basate su parole, si raccomandano font a larghezza fissa, come Courier New, poiché questi garantiscono la stessa dimensione in pixel per diversi caratteri alfanumerici e simboli dell'alfabeto latino. Il ricercatore deve verificare la compatibilità del font, dell'interfaccia e delle proprietà specifiche degli stimoli, ad esempio la presentazione di stimoli in caratteri non latini o in direzioni di lettura da destra a sinistra, e se gli strumenti software per l'esperimento offrono una metodologia per effettuare automaticamente la definizione delle IA (Interest Area) o AOI (Area of Interest).
- Progettare la procedura dell'esperimento
- Preparazione delle istruzioni
NOTA: Le istruzioni sono importanti poiché hanno un impatto significativo sui movimenti oculari durante la lettura. L'uso di istruzioni relative al compito, anche in forma minima, è fondamentale. L'assenza di istruzioni esplicite può causare conseguenze non intenzionali che influenzano il comportamento oculare dei partecipanti. Ad esempio, un partecipante potrebbe avere un'assunzione latente di lettura accurata, mentre un altro potrebbe effettuare una lettura superficiale anziché una lettura naturale per la comprensione.- Presentare istruzioni standardizzate sullo schermo e registrare il tempo di inizio e la durata delle istruzioni; evitare suggerimenti verbali durante la registrazione. Una pratica comune consiste nel chiedere al partecipante di leggere per comprendere. Se ci si aspetta che i partecipanti leggano come farebbero in contesti quotidiani, informarli che devono leggere in modo naturale; ovvero, non devono evitare di battere le palpebre né rileggere. Informare inoltre i partecipanti se è previsto un compito aggiuntivo, come domande di comprensione (fondamentali per garantire che i partecipanti stiano leggendo con lo scopo di comprendere). Le istruzioni possono variare non solo in base al compito, ma anche in base alla fase dell'esperimento (ad esempio, fase di allenamento rispetto al compito principale). A titolo illustrativo, di seguito viene fornito un esempio di istruzioni utilizzate durante una fase di allenamento18.
Inizieremo ora con una sessione di allenamento. Per questa, avrai bisogno dei quattro tasti contrassegnati (A, B, C, D). Ti verranno mostrate ulteriori istruzioni tra breve. Al termine dell'allenamento, la tua prestazione verrà valutata, operazione che richiederà uno o due minuti. Se la tua prestazione durante l'allenamento non sarà sufficiente, l'ultima parte dell'allenamento verrà ripetuta. Se invece sarà sufficiente, tornerò nella stanza. Quando sei pronto, premi semplicemente il tasto spaziatore. - Spetta al ricercatore utilizzare tali istruzioni per le sessioni di allenamento di esperimenti progettati per lo studio della lettura. Tuttavia, si devono comunque utilizzare le istruzioni per la sessione sperimentale. Un esempio di istruzioni utilizzate nella fase sperimentale in una condizione generale di istruzioni sulla rilevanza (sia con che senza una domanda nel testo) può essere simile a quella riportata di seguito19.
Leggerai un insieme di brevi testi espositivi. Ti chiediamo di leggere attentamente il testo, cercando di comprenderne il maggior contenuto possibile. Successivamente, dopo aver letto, ti verrà chiesto di fornire un riassunto orale delle idee principali del testo, al fine di valutare quanto hai compreso di ciò che hai letto.
Un altro esempio di istruzione è riportato di seguito per un esperimento che utilizza compiti di lettura di frasi20.
Benvenuti al nostro studio sulla lettura. In questo studio, verranno presentate circa cento frasi, selezionate casualmente da diverse fonti e mostrate in ordine casuale. Leggetele silenziosamente, cercando di comprenderne il significato, al vostro ritmo naturale di lettura, in modo simile a come leggereste delle frasi in un libro. Dopo alcune frasi, potrebbero essere poste domande di comprensione. Si prega di rispondere alle domande di comprensione. Se non si conosce la risposta, si può saltare la domanda. È prevista una pausa a metà della sessione. È possibile richiedere una pausa o interrompere la sessione in qualsiasi momento qualora ci si senta a disagio. Se si hanno domande, informare il sperimentatore. In caso contrario, premere un pulsante per iniziare la procedura.
- Presentare istruzioni standardizzate sullo schermo e registrare il tempo di inizio e la durata delle istruzioni; evitare suggerimenti verbali durante la registrazione. Una pratica comune consiste nel chiedere al partecipante di leggere per comprendere. Se ci si aspetta che i partecipanti leggano come farebbero in contesti quotidiani, informarli che devono leggere in modo naturale; ovvero, non devono evitare di battere le palpebre né rileggere. Informare inoltre i partecipanti se è previsto un compito aggiuntivo, come domande di comprensione (fondamentali per garantire che i partecipanti stiano leggendo con lo scopo di comprendere). Le istruzioni possono variare non solo in base al compito, ma anche in base alla fase dell'esperimento (ad esempio, fase di allenamento rispetto al compito principale). A titolo illustrativo, di seguito viene fornito un esempio di istruzioni utilizzate durante una fase di allenamento18.
- Progettare le prove e i blocchi. Progettare il flusso dell'esperimento considerando la presentazione delle prove in blocchi e la randomizzazione dell'ordine delle prove all'interno e tra i blocchi. Utilizzare una croce di fissazione prima di ogni prova (500-800 ms) per assicurare che le fissazioni iniziali dei partecipanti siano concentrate sulla stessa posizione del display e lontane da qualsiasi parte del testo.
La progettazione di un esperimento di eye-tracking in cui la dimensione della pupilla è una variabile dipendente richiede un'adeguata regolazione della sequenza sperimentale, poiché la dimensione della pupilla non costituisce una risposta immediata come una sequenza fissazione-saccommessa. In particolare, quando si utilizza la dimensione della pupilla come variabile dipendente, è necessario introdurre una finestra basale pre-onset e intervalli con schermo nero di durata appropriata, al fine di garantire la stabilizzazione della dimensione della pupilla prima della presentazione degli stimoli e del successivo trial. Il ricercatore dovrebbe consultare studi recenti sulle linee guida della pupillometria per assicurare che i dati registrati sulla pupilla possano essere interpretati in modo appropriato come variabile dipendente.21,22. - Introdurre pause tra i blocchi. Inserire schermate di correzione della deriva e brevi pause opzionali tra i blocchi sperimentali per garantire la qualità dei dati e ridurre l'affaticamento. Inserire controlli della deriva dopo un numero predeterminato di prove o quando l'accuratezza peggiora visibilmente (verificare la presenza di tasti brevi per forzare la calibrazione/validazione durante l'esperimento); rieseguire la validazione se la deriva >1° dell'angolo visivo (media delle coordinate x e y).
- Identificare le variabili indipendenti bersaglio. Negli studi sulla lettura, specifiche proprietà del testo, come la frequenza delle parole e la prevedibilità contestuale delle parole all'interno della frase, costituiscono le principali variabili indipendenti bersaglio. Elencare le variabili indipendenti dell'esperimento, in base agli obiettivi dello studio. Nelle analisi statistiche, le metriche delle variabili indipendenti possono richiedere una normalizzazione dei valori. Valutare la rilevanza di ciascuna variabile in base alle proprietà degli stimoli.
- Escludere dall'analisi le parole all'inizio della riga di testo, poiché le fissazioni su tali parole di solito non sono accurate: possono riflettere la prima fissazione provvisoria nel testo/frase o la prima fissazione dopo un'interruzione di riga (quella che viene chiamata "return-sweep"), che in ogni caso non è accurata ed è generalmente seguita da fissazioni correttive. Escludere l'ultima parola di ciascuna riga perché tali parole sono soggette a un minore affollamento visivo (da parte di parole successive) e perché le fissazioni sulle parole a fine riga spesso riflettono la conclusione di una prova o la programmazione di una "return-sweep" alla riga successiva del testo.
NOTA: La durata della prima fissazione potrebbe essere meno significativa in lingue con molte parole funzionali, come gli articoli prima dei sostantivi (la regione di analisi dovrebbe includere l'articolo e il sostantivo, ma la prima fissazione sarà meno importante, poiché potrebbe riflettere soltanto l'elaborazione dell'articolo).
- Escludere dall'analisi le parole all'inizio della riga di testo, poiché le fissazioni su tali parole di solito non sono accurate: possono riflettere la prima fissazione provvisoria nel testo/frase o la prima fissazione dopo un'interruzione di riga (quella che viene chiamata "return-sweep"), che in ogni caso non è accurata ed è generalmente seguita da fissazioni correttive. Escludere l'ultima parola di ciascuna riga perché tali parole sono soggette a un minore affollamento visivo (da parte di parole successive) e perché le fissazioni sulle parole a fine riga spesso riflettono la conclusione di una prova o la programmazione di una "return-sweep" alla riga successiva del testo.
- Identificare le variabili dipendenti di interesse. Negli studi sulla lettura, un insieme di metriche del movimento oculare, come la durata della prima fissazione, la durata della singola fissazione, la durata dello sguardo, la percentuale di regressioni e la probabilità di saltare una parola, costituisce le principali variabili dipendenti in relazione agli obiettivi dello studio. Specificare le metriche del movimento oculare da analizzare. Utilizzare queste metriche come base per l'analisi statistica.
NOTA: Evitare l'utilizzo di compiti che richiedono al partecipante di digitare sulla tastiera, poiché ciò potrebbe richiedere di allontanarsi dal supporto per il mento, causando la perdita della calibrazione. In alternativa, i partecipanti possono utilizzare il mouse per selezionare la risposta. Nei casi in cui è necessario un feedback orale da parte del partecipante durante la registrazione dei movimenti oculari, utilizzare un supporto per la fronte al posto del supporto per il mento e chiedere al partecipante di rispondere verbalmente oppure consentire risposte con un singolo tasto, rimanendo sempre appoggiato al supporto per la fronte.
- Preparazione delle istruzioni
- Implementazione della procedura sperimentale
- Selezionare un software per la presentazione degli stimoli. Configurare l'esperimento utilizzando un software adeguato per la presentazione degli stimoli. È possibile utilizzare sia strumenti forniti dal produttore sia strumenti generali per la progettazione di esperimenti al fine di presentare stimoli testuali e registrare i movimenti oculari. Nella scelta del software, considerare le integrazioni hardware disponibili (ad esempio, il supporto nativo per il proprio eye tracker), il grado di accuratezza temporale richiesto e il livello preferito di progettazione tramite scripting rispetto a interfacce grafiche (GUI). Indipendentemente dalla piattaforma, il software deve garantire una sincronizzazione affidabile tra gli eventi dello stimolo (ad esempio, inizio della parola, inizio della frase) e il flusso di dati dell'eye tracking, in modo che fissazioni e saccadiche possano essere allineate agli elementi testuali corrispondenti durante l'analisi. Se si utilizza un software esterno, verificare la compatibilità tra il software dell'eye tracker e il software esterno, in particolare per quanto riguarda la visualizzazione dei dati e l'esportazione dei dati.
NOTA: Esempi di software: Experiment Builder (SR Research, per sistemi EyeLink) fornisce un'interfaccia grafica con supporto integrato per i controlli di deriva, procedure di calibrazione e invio di messaggi di evento al computer di registrazione. Piattaforme open source come PsychoPy e OpenSesame offrono funzionalità simili ed sono indipendenti dall'hardware, in quanto permettono di progettare le prove tramite interfaccia grafica o scripting (ad esempio, Python nel caso di PsychoPy), controllare i tempi di presentazione degli stimoli e definire aree di interesse, note anche come Interest Areas (IA) o Areas of Interest (AOI), attorno a parole o righe di testo. A volte, il collegamento tra visualizzazione dei dati ed esportazione dei dati non risulta immediato per ricercatori all'inizio della loro carriera e, pertanto, potrebbe essere più semplice utilizzare il software del produttore. Di conseguenza, un aspetto importante nella scelta dei sistemi di eye tracking è il livello di supporto fornito dai diversi produttori o dalla comunità di sviluppatori. - Eseguire uno studio pilota. Testare la procedura sperimentale implementata e verificare i dati registrati per assicurarsi che l'esperimento proceda come previsto. Condurre studi pilota nell'ambiente di laboratorio monitorando criteri predefiniti di successo per garantire che l'esperimento si svolga come atteso. Esaminare i dati registrati per confermare che vengano acquisiti tutti gli elementi necessari per lo studio.
- Selezionare un software per la presentazione degli stimoli. Configurare l'esperimento utilizzando un software adeguato per la presentazione degli stimoli. È possibile utilizzare sia strumenti forniti dal produttore sia strumenti generali per la progettazione di esperimenti al fine di presentare stimoli testuali e registrare i movimenti oculari. Nella scelta del software, considerare le integrazioni hardware disponibili (ad esempio, il supporto nativo per il proprio eye tracker), il grado di accuratezza temporale richiesto e il livello preferito di progettazione tramite scripting rispetto a interfacce grafiche (GUI). Indipendentemente dalla piattaforma, il software deve garantire una sincronizzazione affidabile tra gli eventi dello stimolo (ad esempio, inizio della parola, inizio della frase) e il flusso di dati dell'eye tracking, in modo che fissazioni e saccadiche possano essere allineate agli elementi testuali corrispondenti durante l'analisi. Se si utilizza un software esterno, verificare la compatibilità tra il software dell'eye tracker e il software esterno, in particolare per quanto riguarda la visualizzazione dei dati e l'esportazione dei dati.
3. Reclutamento e informazione dei partecipanti
- Selezione dei partecipanti
- Stabilire i requisiti relativi allo stato della vista. Reclutare partecipanti con vista normale o corretta alla norma. È possibile accogliere chi porta occhiali o lenti a contatto, a condizione che producano riflessi minimi (antiriflesso, angolazione del monitor) secondo le indicazioni del produttore. Documentare il tipo di correzione (occhiali, lenti a contatto) per i controlli relativi alle covariate.
NOTA: Di solito, le lenti a contatto rigide (ormai poco comuni) sono molto difficili da tracciare. Sebbene le lenti a contatto non rappresentino un problema, a volte può formarsi una bolla d'aria tra la lente e la cornea, causando riflessi che interferiscono con il tracciamento. Anche gli occhiali con montature lucide possono interferire con il tracciamento. Per montature di vetro lucide, ridurre il campo visivo rilevato nel software del sistema di eye-tracking. - Valutare i partecipanti in base a specifiche caratteristiche individuali, come età, livello di competenza nella lettura, background linguistico, manualità (destrimane o mancini) e criteri comuni di inclusione ed esclusione. Ad esempio, condizioni come dislessia, bilinguismo o disturbi della lettura possono influenzare i dati relativi ai movimenti oculari. Pertanto, in base agli obiettivi della ricerca, specificare le condizioni in base alle quali un lettore è un partecipante idoneo all'esperimento, definendo così i criteri di inclusione ed esclusione (vedere la Discussione).
- Verificare la presenza di deficit visivi. Assicurarsi che il partecipante non abbia deficit visivi non correggibili, come cataratta (anche dopo intervento chirurgico), glaucoma o degenerazione maculare.
- Verificare le condizioni neurologiche. Assicurarsi che il partecipante non abbia condizioni che lo rendano a disagio durante la registrazione dei movimenti oculari. La maggior parte dei sistemi di eye-tracking utilizza LED/laser a infrarossi vicini (near-IR) o illuminazione certificata NIR LED/VCSEL, considerati sicuri per gli occhi. Verificare la certificazione di sicurezza oculare del dispositivo (ad esempio, Classe 1 IEC 60825-1, IEC/EN 62471 o equivalente). Informare il partecipante sulle normative di sicurezza dell'apparecchiatura (come la disponibilità di un certificato CE rilasciato dal produttore, comunemente noto come Dichiarazione UE di Conformità, un documento emesso dal produttore per attestare che un prodotto rispetta tutte le normative europee necessarie in materia di salute, sicurezza e ambiente).
- Stabilire i requisiti relativi allo stato della vista. Reclutare partecipanti con vista normale o corretta alla norma. È possibile accogliere chi porta occhiali o lenti a contatto, a condizione che producano riflessi minimi (antiriflesso, angolazione del monitor) secondo le indicazioni del produttore. Documentare il tipo di correzione (occhiali, lenti a contatto) per i controlli relativi alle covariate.
- Garantire l'igiene
- Adottare precauzioni relative alla distanza personale. Se necessario, indossare guanti monouso e mascherina, poiché l'esecuzione dei protocolli sperimentali può richiedere una riduzione della distanza personale.
- Disinfettare l'equipaggiamento. Disinfettare il supporto per il mento e gli altri accessori utilizzando salviette alcoliche, seguendo le indicazioni istituzionali vigenti. Fare attenzione a non utilizzare sostanze chimiche che potrebbero danneggiare l'equipaggiamento. Consultare le specifiche del produttore. I partecipanti potrebbero sentirsi più a loro agio se la pulizia avviene alla loro presenza, in particolare per il supporto per il mento e per la testa, il mouse o qualsiasi altra parte dell'equipaggiamento con cui verranno a contatto.
- Informativa al partecipante
- Informato sul laboratorio. Preparare una sessione di istruzioni verbali in cui lo sperimentatore presenta al partecipante l'ambiente del laboratorio e l'equipaggiamento per il tracciamento oculare.
- Informato sull'esperimento. Fornire una spiegazione chiara del contesto dell'esperimento (l'obiettivo e la durata approssimativa dello studio; ciò dovrebbe essere verificato durante i test preliminari), la procedura relativa all'incentivo o al compenso, il contributo del partecipante all'esperimento e i suoi diritti di seguire a lungo termine i risultati dello studio. Informare il partecipante su cosa fare e cosa evitare durante una sessione di registrazione. Chiedere al partecipante di cercare di non muovere eccessivamente la testa durante la registrazione (in assenza di un sistema di stabilizzazione della testa) o di non allontanarsi dal supporto per il mento, spiegando che queste precauzioni sono necessarie per ottenere una registrazione di alta qualità dei dati (in ogni caso, i partecipanti possono sempre interrompere l'esperimento e abbandonare la sessione senza fornire una motivazione).
- Richiedere il consenso informato. Consegnare ai partecipanti i documenti relativi all'approvazione etica e al consenso e spiegarli prima dell'inizio della sessione. Per gli adulti, ottenere il consenso informato scritto dopo essersi accertati che comprendano lo scopo dello studio, ciò che accadrà e i loro diritti, inclusa la possibilità di partecipare volontariamente, la privacy dei dati e il diritto di ritirarsi. Per i minori partecipanti, ottenere il consenso scritto da un genitore o tutore legale e l'assenso del minore. Procedere con la calibrazione e la registrazione solo dopo che tutti i moduli di consenso e assenso richiesti sono stati completati. Le procedure di consenso informato variano notevolmente tra partecipanti adulti e minori. Pertanto, il ricercatore deve seguire le linee guida istituzionali locali.
NOTA: Se durante l'esperimento si verifica una pausa o una sospensione, è necessaria una riconvalida della calibrazione; se la riconvalida fallisce, è necessaria una nuova calibrazione.
4. Esecuzione della calibrazione e della validazione
- Posizionamento del partecipante e regolazione dell'apparecchiatura
- Posizionare il partecipante. Chiedere al partecipante di sedersi comodamente. Regolare la sedia/il tavolo e/o il supporto per il mento per mantenere una posizione stabile della testa. Informare il partecipante che questa è la posizione attesa della testa durante le fasi di calibrazione, validazione e registrazione.
- Regolare l'apparecchiatura. Regolare l'apparecchiatura di eye-tracking allineando la telecamera del tracker in modo che le pupille del partecipante siano chiaramente visibili e rilevabili. Alcuni sistemi di eye-tracking eseguono automaticamente questo allineamento, mentre altri potrebbero richiedere un’impostazione manuale della messa a fuoco della telecamera.
NOTA: L’operatore dovrebbe esercitarsi nella regolazione dell’apparecchiatura e nella calibrazione prima di iniziare la raccolta effettiva dei dati, per evitare di appesantire il partecipante con questi passaggi.
- Eseguire la calibrazione
- Informare il partecipante. Informare il partecipante sulla procedura di calibrazione (ad esempio, spiegare che verranno visualizzati una serie di marcatori bersaglio e che il partecipante dovrà seguirli per circa un minuto).
NOTA: È consigliabile prestare attenzione al linguaggio utilizzato durante le regolazioni. Ad esempio, l’operatore deve sottolineare che la procedura serve a calibrare il tracker oculare per il partecipante, e non a calibrare il partecipante per il tracker oculare. Inoltre, è importante assicurarsi che nessun video/immagine venga registrato con l’apparecchiatura di eye-tracking. Anche se l’occhio del partecipante è visibile, verrà registrata soltanto la posizione dell’occhio, convertita in coordinate. - Eseguire la procedura di calibrazione. Istruire il partecipante a seguire i marcatori bersaglio e a mantenere costante la posizione della testa; ad esempio, a non appoggiarsi all’indietro al termine della procedura di calibrazione. Chiedere ai partecipanti di fissare il centro del simbolo di calibrazione e di non muovere gli occhi finché il simbolo non si sposta. I partecipanti tendono a anticipare il movimento del simbolo, specialmente durante la validazione, il che può aumentare gli errori e portare a ulteriori passaggi di calibrazione non necessari. Includere questa spiegazione nelle istruzioni o nella descrizione del processo di calibrazione/validazione.
NOTA: I produttori offrono diversi tipi di simboli per la calibrazione (punti, simboli adatti ai bambini, simboli statici o che si restringono, ecc.) e diverse configurazioni di calibrazione (ovvero, il numero di punti di calibrazione). È importante verificare le differenze di calibrazione con queste diverse configurazioni e scegliere quella che meglio soddisfa le esigenze di uno studio specifico. Ad esempio, se gli stimoli utilizzano l’intero schermo (ad esempio, un testo con molti paragrafi), è importante avere una configurazione di calibrazione che garantisca una buona calibrazione dall’alto verso il basso, compresi gli angoli. Tuttavia, se gli stimoli sono frasi presentate al centro dello schermo, una configurazione con un numero ridotto di punti può essere sufficiente. Inoltre, per quest’ultimo caso, l’accuratezza della calibrazione nella direzione orizzontale, o coordinata x, è più importante rispetto al primo caso, che richiede una buona accuratezza sia nelle coordinate verticali che orizzontali. - Terminare la procedura di calibrazione. Informare il partecipante sulla procedura di validazione subito dopo aver completato la calibrazione.
NOTA: In caso di fallimenti persistenti nella calibrazione, verificare l’allineamento della telecamera del tracker oculare, le condizioni di illuminazione e il posizionamento del partecipante. Per partecipanti adulti, trucchi riflettenti, occhiali o lenti a contatto possono interferire con il rilevamento. Rassicurare il partecipante, concedere brevi pause o ripetere la calibrazione secondo necessità. Se i problemi persistono, si può prendere in considerazione il riavvio del sistema di eye-tracking. Se i problemi persistono anche dopo il riavvio del sistema e non si trova alcuna causa per il fallimento della calibrazione dopo aver verificato i parametri di configurazione, informare il partecipante che la tecnologia di eye-tracking non è ancora sufficientemente sviluppata e che si tratta di un problema legato allo stato attuale della tecnologia, non al partecipante.
- Informare il partecipante. Informare il partecipante sulla procedura di calibrazione (ad esempio, spiegare che verranno visualizzati una serie di marcatori bersaglio e che il partecipante dovrà seguirli per circa un minuto).
- Eseguire la validazione
- Eseguire la procedura di validazione. Avviare la procedura di validazione immediatamente dopo la calibrazione.
- Verificare gli errori. Controllare l’errore medio della posizione dello sguardo e assicurarsi che rientri nei limiti accettabili. In genere, si desidera un angolo visivo inferiore a 1 grado (<1°), che corrisponde a circa 4 caratteri (ovvero, 0,5 corrisponde a ~2 caratteri). Eseguire una nuova calibrazione se gli errori superano questi limiti. Ad esempio, accettare la calibrazione se l’errore medio è ≤0,5–1,0° e l’errore massimo/per punto è ≤1,5–2,0°; altrimenti, eseguire una nuova calibrazione. Specificare la cadenza di re-validazione (ad esempio, dopo ogni blocco o interruzione). A titolo esemplificativo, secondo i criteri di valutazione della qualità della calibrazione forniti dal produttore SR Research, gli errori sono considerati accettabili per la maggior parte dei compiti se l’errore medio è <1° e l’errore massimo è <1,5°; sufficienti se l’errore medio è <1°-1,5° e l’errore massimo è <1,5°-2°; e scadenti se superiori a questi valori.
- Informare il partecipante. Istruire il partecipante a mantenere la propria posizione il più possibile simile e informarlo dell’inizio della sessione di registrazione.
5. Raccolta dei dati
- Procedura di raccolta dati
- Avviare la sessione di registrazione. Iniziare la sessione di registrazione ed evitare di interrompere il partecipante mentre svolge il compito, ad esempio fornendo istruzioni verbali.
- Monitorare il partecipante. Controllare il comfort del partecipante durante la registrazione dei dati. Assicurarsi che il partecipante mantenga una postura stabile senza sforzi o affaticamento. Osservare segni di distrazione, secchezza oculare o disagio causato dal supporto per il mento/il poggiatesa.
- Monitorare la registrazione dei dati. Controllare la qualità dei dati durante la registrazione. Eseguire una nuova calibrazione se l'errore medio di validazione o l'accuratezza in tempo reale supera 1° (o una soglia di accuratezza prestabilita), oppure se il partecipante cambia postura.
- Tenere un registro. Conservare un registro della sessione di registrazione annotando eventuali anomalie osservate durante l'esperimento (ad esempio, una procedura di calibrazione insolitamente lunga o un'interruzione involontaria durante la registrazione) per l'ispezione successiva all'esperimento, utilizzando uno schema di registro della sessione per monitorare l'orario degli eventi, le interruzioni, il numero di calibrazioni effettuate e i relativi errori, i controlli di deriva e i cambiamenti nell'illuminazione.
- Fine della sessione
- Salvare i dati. Salvare i dati grezzi dello sguardo alla fine della sessione sperimentale, preferibilmente utilizzando un metodo sistematico per etichettare la sessione (ad esempio, la data dell'esperimento e il numero del partecipante, come 25071801 o 250718-P01 per il partecipante 01 del 18 luglio 2025; evitare di utilizzare informazioni personali identificabili del partecipante).
- Congedo. Ringraziare il partecipante e rispondere a eventuali domande che potrebbe avere riguardo all'esperimento; sanificare l'equipaggiamento (vedere punto 3.2.2).
- Verificare i dati. Controllare i dati e i registri per assicurarsi che la sessione sia stata completata correttamente.
6. Preelaborazione dei dati e controllo della qualità
- Esportazione, organizzazione e pulizia dei dati grezzi
- Esportare i dati. Esportare i dati grezzi dello sguardo in un formato standard (ad esempio, .csv, .tsv, .edf) e standardizzare l'ID della sessione (ad esempio, 25071801 o 250718-P01, vedere 5.2.1).
- Pulire i dati. Pulire i dati grezzi applicando algoritmi per il rilevamento di battiti di ciglia e dati mancanti, utilizzando strumenti integrati forniti dal software del produttore o script personalizzati, adattati al dispositivo o alla frequenza di campionamento.
NOTA: Creare copie di backup dei dati grezzi durante l'esecuzione delle procedure di pulizia.
- Rilevamento degli eventi del movimento oculare
- Selezionare l'algoritmo di rilevamento del movimento oculare. Selezionare ed eseguire le procedure per il rilevamento delle fissazioni, regolando i parametri degli algoritmi secondo necessità. Gli algoritmi rappresentativi per l'identificazione delle fissazioni includono principalmente algoritmi basati sulla velocità (ad esempio, I-VT Velocity-Threshold Identification) e algoritmi basati sulla dispersione (ad esempio, I-DT Dispersion-Threshold Identification), tra gli altri23. Ogni algoritmo ha i propri parametri.
NOTA: Il software del produttore di solito presuppone un algoritmo specifico e un insieme specifico di parametri comunemente utilizzati per impostazione predefinita. È responsabilità del ricercatore selezionare un algoritmo appropriato e i relativi parametri e riportarli nella descrizione della metodologia dello studio, come le soglie di dispersione/velocità, una soglia minima di durata della fissazione (ad esempio, 60 ms o 100 ms) per eliminare fissazioni più brevi di questo valore, una soglia massima di durata della fissazione (ad esempio, 1000 ms) per eliminare fissazioni più lunghe di questo valore, la finestra di smoothing utilizzata e le regole di unione per fissazioni adiacenti23. - Identificare le fissazioni illegittime. Rimuovere o etichettare le fissazioni al di fuori dell'area di visualizzazione. Rimuovere o etichettare le fissazioni più brevi di una soglia minima predefinita e più lunghe di una soglia massima predefinita.
- Ispezione visiva dei dati. Ispezionare visivamente i dati utilizzando strumenti di visualizzazione disponibili per garantire la validità dei dati. Verificare la perdita di segnale, rumore eccessivo, campioni mancanti o fissazioni non allineate. Dopo ogni sessione di registrazione, ispezionare visivamente i dati utilizzando gli strumenti di visualizzazione forniti con il software di eye-tracking (ad esempio, grafici dello sguardo, scanpath, tracce in serie temporale). Questo passaggio aiuta a garantire che i dati siano di qualità sufficiente prima di procedere con la pre-elaborazione e l'analisi.
- In particolare, verificare la perdita di segnale e problemi di tracciamento cercando lunghe interruzioni nei modelli di sguardo o aree negli stimoli in cui non vengono registrati campioni di sguardo. Perdite frequenti o prolungate del tracciamento potrebbero indicare che la sessione dovrebbe essere esclusa o ripetuta.
- Per verificare il rumore eccessivo, esaminare le tracce grezze delle posizioni x/y alla ricerca di salti improvvisi o campioni errati che non corrispondono alla disposizione dello stimolo. Un rumore eccessivo potrebbe indicare una cattiva calibrazione, una posizione instabile della testa o problemi hardware.
- Per individuare campioni mancanti o irregolari, verificare se la frequenza di campionamento è approssimativamente quella prevista (ad esempio, 500 Hz) e se ci sono gruppi inattesi di campioni mancanti oltre ai normali battiti di ciglia.
- Per individuare fissazioni non allineate, sovrapporre le fissazioni agli stimoli presentati e verificare che cadano sulle righe e parole previste. Deviazioni sistematiche (ad esempio, fissazioni costantemente al di fuori del testo) potrebbero indicare una deriva della calibrazione o un mapping errato tra le coordinate dello sguardo e quelle dello schermo. I modelli di sguardo registrati dovrebbero seguire approssimativamente la struttura del testo (ad esempio, progressioni da sinistra a destra, riga per riga), con fissazioni raggruppate sulle parole e saccadi relativamente fluide tra di esse. Una deviazione sistematica da questo modello, o una perdita frequente di dati utilizzabili, potrebbe richiedere l'esclusione dei dati interessati dall'ulteriore analisi.
- Eseguire la correzione della deriva. Eseguire la correzione dell'errore di deriva verticale quando necessario. Applicare la correzione della deriva verticale per riga nel caso di testi con più righe. Verificare l'applicabilità di metodi validati21.
NOTA: Figura 1 presenta una rappresentazione dei passaggi coinvolti nella progettazione di un setup sperimentale di eye-tracking e di una pipeline di analisi dei dati, come descritto nella sezione del protocollo. La sezione seguente presenta risultati rappresentativi ottenuti da sessioni registrate.
- Selezionare l'algoritmo di rilevamento del movimento oculare. Selezionare ed eseguire le procedure per il rilevamento delle fissazioni, regolando i parametri degli algoritmi secondo necessità. Gli algoritmi rappresentativi per l'identificazione delle fissazioni includono principalmente algoritmi basati sulla velocità (ad esempio, I-VT Velocity-Threshold Identification) e algoritmi basati sulla dispersione (ad esempio, I-DT Dispersion-Threshold Identification), tra gli altri23. Ogni algoritmo ha i propri parametri.
Risultati
Qualità e validazione dei dati
Le sessioni di successo producono tipicamente un'accuratezza di validazione con errore medio ≤0,5–1,0° e errore massimo/per punto <1,0–1,5° rispetto ai target; riportare sia i valori medi che quelli per punto. Fornire un istogramma dell'errore per punto e una tabella che riassuma media ± DS e errore massimo per ogni sessione. Questi criteri sono in linea con le pratiche comuni e con le raccomandazioni del produttore; le sessioni che superano tali soglie dovrebbero essere escluse parzialmente o totalmente, a seconda delle regole dello studio. Figura 2 mostra un esempio di istogramma dell'errore per punto relativo all'accuratezza di calibrazione per una calibrazione a 9 punti, ottenuta da tre tentativi di calibrazione.
Precisione e perdita di dati
Riportare la precisione (ad esempio, dispersione RMS –Root Mean Square– tra campioni durante la fissazione) e la perdita di dati (% di campioni mancanti per prova/sessione). Le prove di buona qualità mostrano di solito una bassa dispersione durante la fissazione e una bassa perdita di dati (ad esempio, <5–10%, a seconda dell'apparecchiatura e dell'allestimento per il tracciamento oculare). Fornire le distribuzioni delle percentuali di perdita di dati e un grafico a dispersione prova per prova della precisione rispetto alla perdita, per evidenziare i valori anomali. Consultare la letteratura recente per le definizioni e gli elementi minimi da riportare3,4,5,6,7,8,9,10,11.
Comportamento alla deriva (prima/dopo la correzione)
Le prove valide mostrano scostamenti verticali ridotti e quasi costanti, che vengono notevolmente ridotti dalla correzione riga per riga, sia mediante algoritmi automatici di correzione della deriva21 che manualmente. Al contrario, le prove problematiche mostrano deriva residua non monotona o eccessiva. Includere l'errore verticale assoluto mediano prima e dopo la correzione. Verificare l'applicabilità dei metodi automatici di correzione della deriva.
Distribuzioni di misure comuni nella lettura
Fornire distribuzioni riassuntive per la durata della prima fissazione (FFD), la durata della singola fissazione (SFD), la durata del primo passaggio (FP) e la durata totale/gaze (GD), il tempo di andata, la probabilità di saltare e la probabilità di regressione. Nella lettura alfabetica da parte di adulti esperti, le durate delle fissazioni si concentrano tipicamente intorno a ~200–250 ms (con una notevole asimmetria), e le saccadi coprono in media ~7–9 caratteri. Valori fortemente al di fuori di questi intervalli o distribuzioni delle saccadi fortemente bimodali devono essere verificati per stabilire se indicano saccadi progressive e regressive attese dovute a vincoli del compito o difficoltà di elaborazione, piuttosto che errori temporali. La scelta e l’intervallo delle misure possono variare di conseguenza tra popolazioni diverse, lingue specifiche e ortografie. Figura 3 mostra un esempio di protocollo di distribuzione della durata delle fissazioni proveniente da una sessione rappresentativa.
Verifiche di coerenza
Un aumento della lunghezza delle parole (parole lunghe) porta solitamente a una riduzione della frequenza di salti e a durate di fissazione più lunghe su tali parole. D'altro canto, le parole funzionali (ad esempio articoli o preposizioni) vengono generalmente saltate. Le parole molto frequenti e quelle altamente prevedibili in base al contesto linguistico (all'interno del testo o della frase) determinano tipicamente durate più brevi della prima fissazione e della fissazione globale, nonché tassi di salti più elevati (l'opposto ci si aspetta per parole a bassa frequenza e bassa prevedibilità). Verificare se i dati replicano alcuni di questi schemi, almeno in una direzione. Inversioni significative potrebbero indicare errori di deriva, un allineamento errato tra parole e fissazioni o errori nell'elaborazione dei dati.
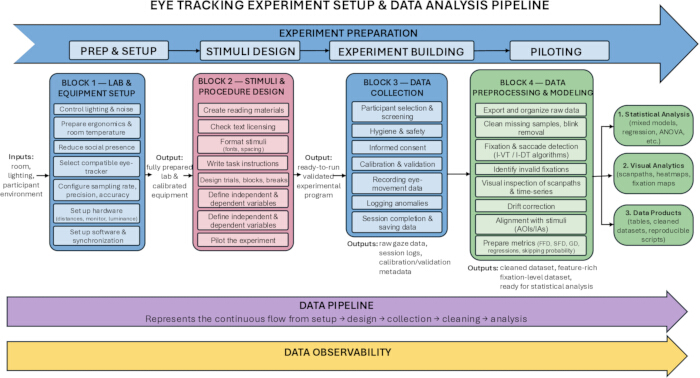
Figura 1. Rappresentazione dei passaggi coinvolti nella progettazione di un esperimento di tracciamento oculare e del flusso di analisi dei dati. Cliccare qui per visualizzare una versione ingrandita di questa figura.
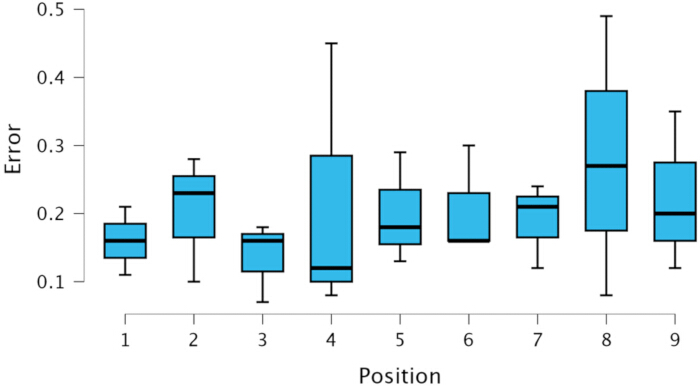
Figura 2. Istogramma dell'errore per punto relativo all'accuratezza della calibrazione per una calibrazione a 9 punti, ottenuta da tre tentativi di calibrazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
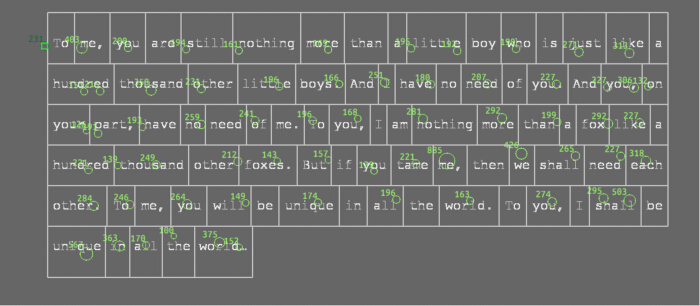
Figura 3. Protocollo della distribuzione della durata delle fissazioni da una sessione rappresentativa; un partecipante che legge un estratto del romanzo "Il Piccolo Principe". La posizione e le dimensioni dei cerchi indicano rispettivamente la posizione e la durata delle fissazioni. I numeri accanto ai cerchi indicano la durata delle fissazioni in ms. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Discussione
Il protocollo presentato qui riassume i passaggi principali necessari per ottenere dati affidabili di eye-tracking nella ricerca sulla lettura. Sebbene molti di questi passaggi possano essere ben noti ai ricercatori esperti, spesso sono dispersi in articoli metodologici distinti, nella documentazione dei produttori e nelle pratiche informali di laboratorio. Organizzandoli in un unico flusso di lavoro, dalla preparazione del laboratorio al pre-elaborazione dei dati, l'obiettivo è fornire una guida pratica per i ricercatori alle prime armi con studi di eye-tracking applicati alla lettura. Rispetto alle linee guida generali per l'eye-tracking o alle risorse incentrate prevalentemente sugli algoritmi di rilevamento dei movimenti oculari, questo protocollo offre un quadro completo, concepito come risposta alle esigenze della ricerca sulla lettura, che richiede la registrazione di dati con elevata risoluzione spaziale e alta frequenza di campionamento.
Un tema centrale in tutte le fasi del flusso di lavoro è l'importanza di una gestione proattiva della qualità dei dati, a partire dal controllo ambientale e dalla configurazione delle apparecchiature. Piccoli problemi come riflessi sul monitor, instabilità della sedia o distanze di visione non costanti possono generare bias sistematici nella posizione o nella precisione della fissazione. Affrontare precocemente questi fattori riduce la necessità di correzioni post hoc complesse e favorisce un'accuratezza di validazione più costante (errore medio ≤ 0,5–1°).
Il protocollo sottolinea inoltre l'importanza dell'allineamento tra le domande di ricerca e le caratteristiche dell'apparecchiatura. Molti studi sulla lettura si basano su misurazioni spaziali e temporali precise delle fissazioni, delle posizioni di atterraggio delle saccadi e delle regressioni1,2. È quindi essenziale scegliere un eye tracker con una frequenza di campionamento, una precisione e un'accuratezza adeguate, specialmente per misure come la posizione di atterraggio o l'anteprima parafoveale, che sono sensibili a piccoli errori spaziali. A seconda dei vincoli specifici dello studio, questi metodi possono essere modificati. Ad esempio, quando si lavora con popolazioni neurodivergenti che non tollerano un supporto per il mento, i ricercatori possono passare a sistemi remoti senza vincolo della testa, compensando la minore precisione spaziale utilizzando caratteri più grandi, interlinee più ampie e Aree di Interesse più ampie. Quando si utilizzano sistemi senza vincolo della testa, i ricercatori devono tenere conto di un maggiore movimento e di un potenziale smarrimento dei dati. Sebbene i sistemi remoti consentano configurazioni più naturalistiche, la stabilizzazione della testa rimane comunque preferibile per la maggior parte dei compiti di lettura attuali.
La progettazione dell'esperimento è un altro fattore chiave che influenza sia la qualità dei dati che la loro interpretazione. Istruzioni standardizzate a schermo, randomizzazione delle prove e una struttura di blocchi adeguata aiutano a mantenere un comportamento stabile del partecipante durante tutta la sessione. Includere controlli di deriva a intervalli regolari è particolarmente importante negli esperimenti di lettura, poiché anche piccoli spostamenti graduali possono accumularsi attraverso le righe di testo. Il protocollo supporta inoltre l'uso di norme lessicali dipendenti dalla lingua e una descrizione trasparente delle variabili indipendenti e dipendenti, facilitando la replicabilità e il confronto tra studi.
Durante la raccolta dei dati, il monitoraggio continuo dell'accuratezza, della postura e del comfort del partecipante aiuta a prevenire perdite di dati su larga scala. Spesso è necessaria una risoluzione attiva dei problemi comuni. Ad esempio, la calibrazione potrebbe fallire agli angoli dello schermo; in tal caso, regolando l'altezza del monitor o della sedia è possibile risolvere la perdita di tracciamento periferico. Problemi causati da occhiali riflettenti o lenti a contatto talvolta possono essere risolti regolando l'illuminazione ambientale o modificando gli angoli del monitor. La tenuta di un registro dettagliato della sessione supporta la risoluzione successiva dei problemi e aumenta la trasparenza documentando interruzioni, ricalibrazioni e eventi imprevisti. Ciò risulta sempre più importante poiché molti studi pubblicati richiedono attualmente una segnalazione esplicita delle metriche di qualità, inclusa la precisione e la percentuale di perdita dei dati.
La sezione di preelaborazione sottolinea la necessità di scelte coerenti e ben documentate nella rilevazione degli eventi, nella correzione delle deriva e nelle procedure di pulizia. Poiché gli algoritmi e le soglie di classificazione delle fissazioni possono influenzare fortemente le misure risultanti, i ricercatori dovrebbero specificare tutti i parametri utilizzati e giustificarli qualora differiscano dai valori predefiniti più comuni. L'ispezione visiva rimane un passaggio fondamentale, anche quando si utilizzano strumenti automatizzati. Il protocollo raccomanda inoltre di riportare indicatori standard di qualità, come accuratezza della validazione, precisione, perdita di dati e comportamento della deriva, in modo da permettere confronti più affidabili tra gli studi.
Inoltre, il protocollo raccomanda semplici verifiche di controllo del comportamento di lettura, come gli effetti della lunghezza delle parole, della frequenza o della prevedibilità. La riproduzione di questi schemi canonici fornisce un ulteriore controllo contro problemi di allineamento non rilevati, deriva anomala o errori di preelaborazione. Queste verifiche non sostituiscono un'analisi statistica completa, ma offrono un feedback rapido sull'effettivo comportamento dei dati in linea con quanto atteso per una lettura esperta.
Oltre ai dettagli del protocollo sperimentale già menzionati, è importante descrivere le caratteristiche linguistiche e psicometriche dei partecipanti. La principale motivazione risiede nella difficoltà che i ricercatori sperimentali incontrano nel confrontare studi diversi. Ciò è particolarmente rilevante nell'era della scienza aperta, in cui set di dati disponibili pubblicamente possono essere utilizzati da ricercatori che non li hanno raccolti originariamente e che pertanto potrebbero non essere a conoscenza di eventuali peculiarità derivanti da variazioni nei background (socio)linguistici dei partecipanti.
Per quanto riguarda il background linguistico, va annotata la lingua madre dei partecipanti e raccolte informazioni sui dialetti che utilizzano, al fine di considerare eventuali differenze dialettali che potrebbero influenzare i risultati. Se i partecipanti parlano più di una lingua – una situazione comune nel mondo attuale – va registrata la competenza nella seconda lingua. Negli studi sul bilinguismo o sull'elaborazione della seconda lingua, la competenza nella seconda lingua deve essere valutata mediante test standardizzati validati per la collocazione nella seconda lingua. Inoltre, possono essere registrati aspetti rilevanti dello status socioeconomico (ad esempio, le abitudini di lettura dei partecipanti).
Devono essere effettuati test per valutare le caratteristiche psicometriche dei partecipanti, come la capacità di memoria di lavoro e la flessibilità cognitiva (in particolare negli studi su soggetti bilingui). Dal punto di vista metodologico, si dovrebbe considerare quali test selezionare, le loro richieste cognitive e temporali, e quando somministrare queste misurazioni all'interno del protocollo sperimentale – prima, dopo la sessione di eye-tracking, oppure in una sessione separata.
È essenziale ricordare che negli studi sulla lettura, il comportamento linguistico viene misurato e spiegato utilizzando sia le caratteristiche linguistiche dello stimolo sia le caratteristiche psicometriche dei lettori (o qualsiasi altro fattore rilevante per il comportamento linguist游戏副本 dei partecipanti)11,12,17,20. Per consentire il confronto tra studi, tutti i fattori che potrebbero essere rilevanti per l'interpretazione dei dati devono essere inclusi. La scelta delle caratteristiche da includere dipenderà dall'obiettivo dello studio. I dati devono essere comparabili. In sintesi, i dati devono essere raccolti e descritti con sufficiente dettaglio da offrire a qualsiasi potenziale utilizzatore la massima flessibilità nell'uso. Queste considerazioni potrebbero non far parte del protocollo stesso, ma sono rilevanti per ogni singolo studio. Nell'attuale contesto scientifico globale, tali dettagli aumentano le potenzialità future d'uso dei dati raccolti.
Questo protocollo presenta delle limitazioni, in particolare il compromesso tra qualità dei dati e validità ecologica, poiché la lettura su un monitor statico con la testa immobilizzata non riproduce completamente il comportamento di lettura in condizioni naturali, e criteri visivi di inclusione rigorosi possono limitare la rappresentatività del campione. Inoltre, i sistemi di eye-tracking differiscono notevolmente nella scala delle coordinate, nella precisione dei timestamp e nella classificazione degli eventi. Una limitazione del presente protocollo è che non chiarisce in che modo questa variabilità influisca sulla riproducibilità tra laboratori o tra diversi marchi di hardware. La definizione di linee guida per la validazione incrociata tra dispositivi e per applicazioni future realistiche, come l’adattamento di paradigmi di laboratorio ad ambienti di lettura immersivi in Realtà Virtuale o in Realtà Aumentata, e lo sviluppo di biomarcatori digitali per disturbi cognitivi o dell’attenzione, colmerebbe un’importante lacuna.
Nel complesso, il protocollo riunisce le indicazioni metodologiche esistenti in un flusso di lavoro chiaro e trasparente per la raccolta di dati di eye-tracking di alta qualità nella lettura. Seguendo i passaggi e riportando le metriche di qualità associate, i ricercatori possono migliorare la riproducibilità e l'affidabilità degli studi sulla lettura e contribuire a stabilire una maggiore coerenza metodologica in tutto il settore.
Ringraziamenti
Finanziamento: Questo progetto è stato sostenuto da COST–Cooperazione europea in materia di scienza e tecnologia (CA21131–Abilitazione della raccolta di dati di eye-tracking multilingue per la ricerca sul processamento del linguaggio umano e artificiale (MultiplEYE), https://www.cost.eu/actions/CA21131)24, dalla Fondazione per la Scienza e la Tecnologia, Portogallo (assegni: UID/214/2025, UI/BD/154500/2022) e dal programma strategico dell'Università Jagellonica nell'ambito dell'Iniziativa di Eccellenza, Area di Ricerca Prioritaria DigiWorld (ID.UJ), progetto „Aspetti cognitivi dell'interazione e della comunicazione in agenti naturali e artificiali”. Ringraziamo Anna Maria Wilkosz per il gentile supporto tecnico.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Salviette alcoliche (70% isopropilico) | Materiale per la pulizia | Fornitore locale di laboratorio | |
| Poggiatesta con altezza regolabile | Dispositivo di stabilizzazione della testa | Vari fornitori di laboratorio | |
| Modulo di consenso e materiale di debriefing | Documentazione | Modelli approvati dall'istituto | |
| Eye tracker (ad esempio, SR Research EyeLink 1000 Plus, Tobii Pro Fusion) | Hardware per il tracciamento oculare | SR Research Ltd., Tobii AB | |
| Software per l'analisi dei dati di eye-tracking (Data Viewer, Tobii Pro Lab) | Software per l'analisi dei dati dei movimenti oculari | SR Research Ltd., Tobii AB | |
| Software per eye-tracking (ad esempio, Experiment Builder, Tobii Pro Lab, PsychoPy) e i relativi SDK | Software per la presentazione degli stimoli e kit di sviluppo software | SR Research Ltd., Tobii AB, Open source | |
| Software generico per l'analisi dei dati (R con lme4, ggplot2, JASP, Python con Pandas, NumPy, Matplotlib) | Preprocessing e analisi dei dati | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Software generico per la progettazione di esperimenti (PsychoPy) | Software per la presentazione degli stimoli | Open source, https://www.psychopy.org | |
| Altro software di terze parti (ad esempio, E-Prime) | Software per la presentazione degli stimoli | Psychology Software Tools, Inc. | |
| Stanza insonorizzata | Controllo ambientale | Struttura istituzionale | |
| Monitor LCD standard da 24 pollici (o più piccolo) | Dispositivo di visualizzazione | Qualsiasi produttore conforme agli standard ISO |
Riferimenti
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).