Questo articolo propone un metodo di monitoraggio della sicurezza in linea di produzione che integra You Only Look Once versione 11 (YOLOv11) con reti neurali convoluzionali. Il metodo ha raggiunto una precisione media media a soglia di intersezione-su-unione pari a 0,5 (mAP@0,5) di 0,91, un mAP@0,5:0,95 di 0,82 e 120 fotogrammi al secondo su un'unità di elaborazione grafica, superando i modelli di riferimento valutati.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Monitoraggio in tempo reale della sicurezza della linea di produzione mediante rilevamento di oggetti basato sul deep learning e potenziamento delle caratteristiche
In questo articolo
Sommario
Abstract
Con l'approfondimento dell'Industria 4.0, i livelli di automazione e di intelligenza delle linee di produzione sono notevolmente migliorati, aumentando i requisiti relativi alle prestazioni in tempo reale, all'accuratezza e alla sicurezza del monitoraggio. I sistemi di monitoraggio tradizionali, basati su ispezioni manuali o su semplici decisioni basate su soglie, soffrono generalmente di tempi di risposta lenti, elevati tassi di falsi allarmi e intelligenza limitata. Pertanto, questo articolo propone un sistema di monitoraggio della sicurezza per linee di produzione che integra You Only Look Once versione 11 (YOLOv11) con una rete neurale convoluzionale (CNN). In primo luogo, le immagini acquisite sono state preelaborate. Successivamente, YOLOv11 è stato utilizzato per identificare in tempo reale operatori, attrezzature e potenziali rischi. Poi, è stata introdotta una rete CNN potenziata con fusione di caratteristiche multiscala e meccanismi di attenzione per migliorare le capacità di estrazione delle caratteristiche per obiettivi piccoli e parzialmente oscurati. Infine, i risultati di rilevamento sono stati fusi con le caratteristiche potenziate dalla CNN per valutare lo stato di sicurezza. Sono stati condotti esperimenti utilizzando un dataset autocostruito sulla sicurezza delle linee di produzione, impiegando l'ottimizzatore di discesa del gradiente stocastico (SGD) con momento 0.9, un tasso di apprendimento iniziale di 0,01, una riduzione del peso di 0,0005, un aggiustamento del tasso di apprendimento con annealing coseno, una dimensione del batch di 32 e un addestramento per 200 epoche. Sono stati utilizzati mAP@0.5 e la velocità di rilevamento in frame al secondo (FPS) come metriche di valutazione per il confronto con gli algoritmi di riferimento valutati. I risultati mostrano che il sistema proposto ha raggiunto un mAP@0.5 di 0,91 e una velocità di rilevamento di 120 FPS. Ha inoltre dimostrato prestazioni robuste in condizioni complesse come l'ombreggiatura e variazioni di illuminazione, confermando la sua efficacia e il potenziale di applicazione pratica nel monitoraggio della sicurezza delle linee di produzione.
Introduzione
Nella produzione industriale moderna, la sicurezza è il fondamento per garantire l'efficienza produttiva e il benessere del personale. L'ambiente della linea di produzione coinvolge tipicamente apparecchiature meccaniche ad alta velocità, processi tecnologici complessi e operazioni collaborative che richiedono più mansioni. Ogni piccolo rischio potenziale per la sicurezza può causare gravi incidenti industriali, con ingenti perdite economiche e persino decessi. È quindi fondamentale istituire un sistema di monitoraggio della sicurezza efficiente, intelligente e in tempo reale per migliorare la sicurezza nella produzione industriale1,2.
I metodi tradizionali di monitoraggio della sicurezza si basano principalmente sulla sorveglianza manuale tramite video e su vari sensori (ad esempio, infrarossi, fumo e vibrazioni)3. Il monitoraggio manuale non è solo inefficiente, ma è anche soggetto a mancati rilevamenti a causa della fatica del personale addetto alla sorveglianza, e non è in grado di garantire una copertura continua e completa. Sebbene i sensori possano offrire una certa funzione di preallarme, il loro raggio di rilevamento è limitato ed essi sono sensibili alle interferenze ambientali, con conseguenti problemi significativi di falsi allarmi4. I sistemi intelligenti di monitoraggio stanno diventando un settore di ricerca sempre più rilevante. L'analisi in tempo reale di un flusso video mediante un algoritmo di apprendimento profondo (deep learning) consente di identificare automaticamente eventi anomali, comportamenti non sicuri e potenziali rischi, migliorando così notevolmente l'intelligenza del sistema di sorveglianza4,5.
Il rilevamento di oggetti è una tecnologia fondamentale nel monitoraggio intelligente. Come rappresentanti dei rilevatori di oggetti monostadio, gli algoritmi della serie You Only Look Once (YOLO) mostrano vantaggi significativi. Dal YOLOv1 al YOLOv8, questa serie di algoritmi ha subito uno sviluppo continuo, con miglioramenti apportati all'architettura della rete, alla funzione di perdita e alle metodologie di addestramento, tra gli altri aspetti6,7. Il YOLOv11, in particolare, ha raggiunto una maggiore accuratezza nel rilevamento mantenendo al contempo un'elevata frequenza di fotogrammi, specialmente in presenza di sfondi complessi e oggetti densamente affollati8.
Tuttavia, nonostante le ottime prestazioni in compiti generali di rilevamento oggetti, YOLOv11 affronta ancora alcune sfide in specifici scenari di monitoraggio della sicurezza in linea di produzione9. Ad esempio, l'accuratezza di rilevamento di YOLOv11 può diminuire quando i lavoratori sono parzialmente oscurati da attrezzature o quando i segnali di sicurezza sono piccoli e presentano un colore molto simile a quello dello sfondo. Ciò richiede al modello capacità più elevate di estrazione delle caratteristiche e di comprensione semantica10.
Le reti neurali convoluzionali (CNN) possiedono notevoli capacità nell'estrazione delle caratteristiche delle immagini11. Progettando architetture di rete più profonde e complesse, le CNN possono apprendere caratteristiche d'immagine più ricche e astratte. Combinare una CNN con YOLOv11 sfrutta le capacità di rilevamento rapido di YOLOv11 e l'estrazione profonda delle caratteristiche della CNN, consentendo così di realizzare un sistema di monitoraggio della sicurezza più robusto e intelligente.
Sulla base di ciò, questo articolo propone un sistema di monitoraggio della sicurezza in linea di produzione che utilizza YOLOv11 e una CNN. Gli aspetti innovativi di questo studio includono: (1) la proposta di un'architettura di fusione profonda di YOLOv11 e una CNN migliorata; (2) l'introduzione della fusione di caratteristiche multiscala e di un meccanismo di attenzione composito per potenziare il riconoscimento delle caratteristiche chiave di sicurezza; e (3) la verifica dei vantaggi prestazionali del modello su un dataset autocostruito di scene complesse.
Sviluppo degli algoritmi della serie YOLO
Dalla sua prima introduzione da parte di Redmon et al. nel 201512, l'algoritmo You Only Look Once (YOLO) ha suscitato notevole interesse. A differenza dei rilevatori a due stadi che si basano su proposte di regione, YOLO tratta il rilevamento di oggetti come un compito di regressione. Prevedendo direttamente le classi e le posizioni degli oggetti in un'immagine, YOLO aumenta in modo significativo la velocità di rilevamento, rendendolo adatto all'uso in tempo reale13.
Come lavoro pionieristico di questa serie, YOLOv1 realizza per la prima volta una rilevazione end-to-end degli obiettivi14. YOLOv1 prevede la suddivisione dell'immagine in ingresso in una struttura a griglia, in cui ogni cella della griglia, solitamente organizzata in un formato S × S, ha il compito di rilevare gli oggetti che rientrano nei suoi limiti.
In particolare, l'output di YOLOv1 è un tensore. Tra gli S × S × (B × 5 + C), la previsione di ciascun riquadro delimitatore contiene 5 elementi: coordinate del punto centrale (x,y), larghezza w, altezza h e valore di confidenza c. Il processo di calcolo è illustrato nell'Equazione (1):
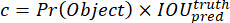 (1)
Tra questi, Pr(Object) rappresenta la probabilità che ci sia un bersaglio nella griglia, mentre IOU rappresenta il rapporto tra l'intersezione e l'unione tra il riquadro delimitatore predetto e il riquadro reale. Ogni griglia prevede anche un insieme di probabilità per le classi, Pr che indica la probabilità che il bersaglio appartenga alla i-esima classe qualora sia presente un bersaglio. La funzione di perdita di YOLOv1 è composta da tre componenti principali: la perdita per la predizione delle coordinate, la perdita per la stima della fiducia e la perdita per la predizione della categoria15.
YOLOv2 introduce la normalizzazione del batch, un classificatore ad alta risoluzione e una strategia di addestramento multi-scala, che migliorano stabilità e accuratezza16. YOLOv3 utilizza Darknet-53 come rete principale e si ispira al concetto di Feature Pyramid Network (FPN) per potenziare il rilevamento degli oggetti17.
YOLOv4 ha introdotto numerose ottimizzazioni rispetto a YOLOv3, adottando tecnologie come la Cross Stage Partial Network (CSPNet)18, la Path Aggregation Network (PANet)19 e il miglioramento dei dati tramite tecnica Mosaic, al fine di migliorare ulteriormente le prestazioni del modello. YOLOv5 ha apportato significativi contributi nell'ambito ingegneristico, offrendo un'implementazione più semplice da utilizzare e più efficiente20.
Negli ultimi anni, la serie YOLO ha continuato a evolversi, con il rilascio di versioni come YOLOv6, YOLOv7 e YOLOv8 una dopo l'altra. Introducendo la struttura Extended Efficient Layer Aggregation Network (E-ELAN) e tecniche di ri-parametrizzazione del modello, YOLOv7 raggiunge nuovi traguardi sia in termini di velocità che di accuratezza. Questi miglioramenti non solo aumentano l'efficienza dell'apprendimento delle caratteristiche, ma ottimizzano anche le prestazioni di inferenza della rete, consentendo a YOLOv7 di superare le versioni precedenti e molti detector mainstream in svariate attività di rilevamento oggetti in tempo reale. YOLOv8 ottimizza ulteriormente la struttura della rete, adotta un design privo di ancoraggi (anchor-free), semplifica il modello e ne migliora la capacità di generalizzazione21.
Basandosi sui vantaggi delle versioni precedenti, YOLOv11, utilizzato in questo studio, è stato ottimizzato per scenari industriali complessi. I suoi principali miglioramenti includono una rete di estrazione delle caratteristiche, un modulo di fusione delle caratteristiche più efficiente e una progettazione della funzione di perdita più robusta. Questi miglioramenti consentono a YOLOv11 di prestare meglio nel gestire occlusioni, piccoli bersagli e sfondi complessi negli ambienti produttivi. YOLOv11 è una versione della serie YOLO rilasciata da Ultralytics. Rispetto a YOLOv8, migliora il modulo C3K2 e il percorso di fusione delle caratteristiche, e introduce una strategia adattiva per le box di ancoraggio, fornendo così una maggiore robustezza nella rilevazione in scenari industriali.
Fondamenti e progressi della rete neurale convoluzionale (CNN)
La rete neurale convoluzionale (CNN) è un modello fondamentale che ha profondamente influenzato il successo dell'apprendimento profondo nel campo della visione artificiale. Opera estraendo caratteristiche locali dell'immagine attraverso operazioni di convoluzione e successivamente riducendo la dimensionalità delle caratteristiche tramite operazioni di pooling, realizzando così un'astrazione gerarchica dell'immagine22.
Un CNN tipico è composto da diversi strati convoluzionali, di pooling e completamente connessi. Lo strato convoluzionale analizza l'immagine in ingresso con un kernel di convoluzione, calcola prodotti scalari su regioni locali e produce una mappa delle caratteristiche. Il processo di calcolo è mostrato nell'Equazione (2):
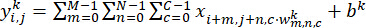 (2)
Dove x è l'immagine in ingresso, wk e bk sono rispettivamente il peso e il bias del kernel di convoluzione, e  sono i valori della mappa delle caratteristiche in uscita nella posizione (i,j). Il livello di pooling utilizza comunemente il Max Pooling o l'Average Pooling. Il livello completamente connesso è responsabile dell'estrazione delle caratteristiche e della previsione delle probabilità di classificazione.
Sulla base di ciò, questo articolo propone un modulo di potenziamento delle caratteristiche CNN per YOLOv11, costituito da due rami paralleli: un ramo con convoluzioni multi-scala che utilizza kernel convoluzionali 3 × 3 e 5 × 5 per estrarre caratteristiche a diverse scale; e un ramo di attenzione che collega in sequenza i moduli di attenzione ai canali (Squeeze-and-Excitation) e di attenzione spaziale, al fine di potenziare le caratteristiche discriminanti degli obiettivi principali. Gli output dei due rami vengono fusi mediante somma puntuale, e la corrispondente funzione di perdita per il potenziamento delle caratteristiche è mostrata nella formula (3):
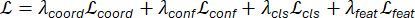 (3)
Lcoord è la perdita di regressione delle coordinate del riquadro delimitatore; Lconf è la perdita di confidenza del target; Lcls è la perdita di classificazione della categoria; Lfeat è la perdita di miglioramento delle caratteristiche, utilizzata per vincolare le caratteristiche discriminative dei target di piccole dimensioni e dei target parzialmente oscurati estratte dal modulo di potenziamento della CNN; λcoord, λconf, λcls, λfeat sono i coefficienti di peso dei rispettivi termini di perdita. Per questo compito, si imposta λfeat = 0,05, mentre i restanti pesi vengono bilanciati in base ai requisiti del compito di rilevamento.
Le strutture classiche di CNN, come VGGNet23 e ResNet24, hanno ottenuto un notevole successo nei compiti di classificazione delle immagini. Tra queste architetture, ResNet attenua efficacemente il problema del gradiente che scompare durante l'addestramento di reti profonde, facilitando così la costruzione di strutture di rete più profonde e complesse.
Nei compiti di rilevamento degli oggetti, la CNN è solitamente utilizzata come estrattore di caratteristiche (backbone). Ad esempio, Darknet, cross-stage partial Darknet (CSPDarknet), ecc., nella serie di algoritmi YOLO, sono tutti basati sulla CNN25. Per potenziare le capacità di estrazione delle caratteristiche, i ricercatori hanno proposto numerose strutture CNN migliorate. Ad esempio, il modulo Inception estrae caratteristiche in parallelo attraverso kernel di convoluzione multi-scala. DenseNet migliora il riutilizzo delle caratteristiche mediante connessioni dense. La Squeeze-and-Excitation Network regola in modo adattivo l'importanza dei canali delle caratteristiche attraverso meccanismi di attenzione26.
In questo studio, abbiamo progettato un modulo CNN migliorato per potenziare le capacità di estrazione delle caratteristiche di YOLOv11. Questo modulo combina la fusione di caratteristiche multiscala con un meccanismo di attenzione per catturare in modo più efficace le informazioni chiave relative alla sicurezza negli scenari di linea di produzione.
Stato di applicazione dell'apprendimento profondo nel monitoraggio della sicurezza industriale
L'apprendimento profondo ha ottenuto un notevole sviluppo nel monitoraggio della sicurezza industriale. Gli algoritmi basati su CNN vengono utilizzati per determinare se i lavoratori indossano correttamente i caschi di sicurezza, rilevare intrusioni non autorizzate in zone pericolose e monitorare lo stato di funzionamento di apparecchiature difettose27.
Per quanto riguarda il riconoscimento del comportamento, vengono utilizzati CNN 3D e reti neurali ricorrenti per analizzare il comportamento operativo dei lavoratori e identificare azioni potenzialmente pericolose. Ad esempio, analizzando le sequenze della postura dei lavoratori, è possibile determinare se stanno violando le procedure operative di sicurezza28.
YOLO e Faster R-CNN sono ampiamente utilizzati per il rilevamento di persone e attrezzature in video di sorveglianza in tempo reale. Ad esempio, è stato proposto in letteratura un sistema di rilevamento in tempo reale di caschi basato su YOLOv5, che migliora efficacemente l'intelligenza nella gestione della sicurezza nei cantieri29.
Sebbene siano stati compiuti alcuni progressi nella ricerca esistente, rimangono diverse sfide. In primo luogo, le scene industriali presentano tipicamente illuminazione complessa, occlusioni e interferenze di sfondo, che impongono requisiti rigorosi sulla robustezza dell'algoritmo. In secondo luogo, le prestazioni in tempo reale rappresentano un requisito fondamentale, e l'algoritmo deve raggiungere un'inferenza ad alta velocità mantenendo l'accuratezza. Infine, la ricerca esistente si concentra principalmente sul rilevamento di un singolo compito e manca di esplorare la fusione di informazioni provenienti da più fonti e un'analisi completa30.
In questo studio, il modello proposto di fusione tra YOLOv11 e CNN mira ad affrontare le sfide sopra menzionate e a realizzare un monitoraggio completo ed in tempo reale dei rischi per la sicurezza in linea di produzione, potenziando le capacità di estrazione e fusione delle caratteristiche.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Algoritmo YOLOv11 e CNN
Architettura generale del sistema
Il sistema di monitoraggio della sicurezza per la linea di produzione proposto in questo articolo adotta un'architettura ibrida che combina YOLOv11 con una CNN migliorata per realizzare un monitoraggio della sicurezza in tempo reale ad alta precisione e velocità. Come mostrato in Figura 1, il sistema è composto principalmente da un modulo di pre-elaborazione dell'input, un modulo di rilevamento oggetti YOLOv11, un modulo di potenziamento delle caratteristiche CNN e un modulo di decisione di fusione. L'immagine in ingresso viene innanzitutto normalizzata e aumentata dal modulo di pre-elaborazione per migliorare la capacità di generalizzazione del modello. Successivamente, le caratteristiche vengono estratte tramite il backbone CSPDarknet, e il campo recettivo viene ampliato dal modulo di pooling piramidale spaziale rapido (SPPF). Le caratteristiche multiscala vengono fuse dopo il campionamento superiore, e l'attenzione ai canali e l'attenzione spaziale vengono applicate in sequenza alle caratteristiche fuse per potenziare ulteriormente la rappresentazione discriminativa degli obiettivi principali. Il modulo di potenziamento delle caratteristiche CNN viene inserito dopo le uscite dei livelli C3, C4 e C5 della rete principale di YOLOv11, ricevendo mappe delle caratteristiche multiscala di dimensioni rispettivamente di 80 × 80 × 256, 40 × 40 × 512 e 20 × 20 × 1.024. Il modulo di potenziamento delle caratteristiche CNN migliora ulteriormente l'estrazione delle caratteristiche per obiettivi piccoli e parzialmente oscurati. Infine, il modulo di decisione di fusione combina i risultati del rilevamento di YOLOv11 con le caratteristiche potenziate dalla CNN e li ottimizza congiuntamente attraverso una funzione di perdita progettata per fornire la posizione precisa, la categoria e il punteggio di confidenza dell'obiettivo.
Framework di rilevamento YOLOv11
YOLOv11 ha introdotto diversi miglioramenti fondamentali che sfruttano i punti di forza del framework di rilevamento in un'unica fase della serie YOLO. La sua architettura è suddivisa in tre componenti principali: una rete backbone, una rete di fusione delle caratteristiche e un head di rilevamento. La rete backbone utilizza una struttura CSPDarknet potenziata. La rete di fusione delle caratteristiche incorpora connessioni locali tra stadi e convoluzioni separabili per profondità, ispirandosi alle reti piramidali di caratteristiche e alle reti di aggregazione del percorso per fondere efficacemente caratteristiche a più scale.
Modulo di potenziamento delle caratteristiche
Il modulo di potenziamento delle caratteristiche ha lo scopo di migliorare la sensibilità del modello nei confronti delle caratteristiche chiave per la sicurezza. Esso elabora le mappe delle caratteristiche prodotte da ciascun livello della rete principale YOLOv11, fondendo informazioni a diverse scale mediante operazioni di upsampling e downsampling. In particolare, il ramo multi-scala cattura la diversità spaziale delle scale, mentre il ramo di attenzione potenzia dinamicamente i canali e le risposte posizionali più rilevanti. Questi due rami non agiscono in modo indipendente, ma sono complementari e vengono fusi attraverso connessioni residue e una ricampionatura delle caratteristiche. La mappa delle caratteristiche elaborata dal modulo di potenziamento a ciascuna scala viene regolata in modo da corrispondere al numero originale di canali della mappa delle caratteristiche mediante una convoluzione 1 × 1, quindi fusa con la mappa delle caratteristiche originale di YOLOv11 attraverso un'addizione elemento per elemento. La mappa delle caratteristiche fusa viene quindi inviata alla successiva rete piramidale di caratteristiche (FPN) per la fusione multi-scala, formando così una rappresentazione gerarchica delle caratteristiche di sicurezza. Per garantire un'integrazione senza interruzioni tra i moduli, viene adottata una strategia di addestramento congiunto end-to-end, in cui la funzione di perdita combina la perdita di rilevamento di YOLOv11 e la perdita di potenziamento delle caratteristiche del modulo CNN.
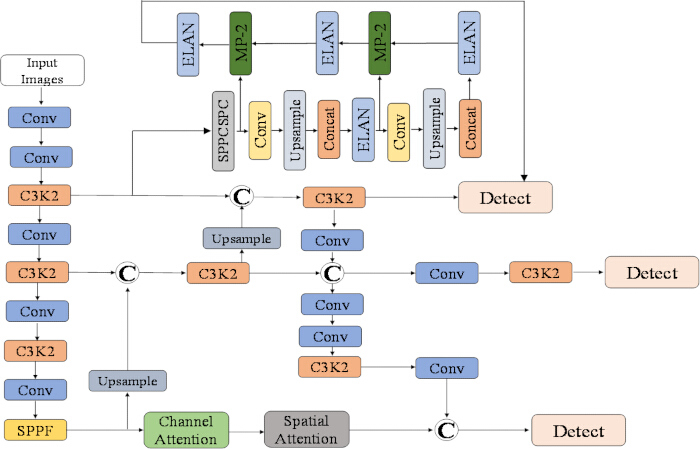
Figura 1. Algoritmo YOLOv11-CNN. Il modulo di potenziamento delle caratteristiche mira ad amplificare la sensibilità del modello nei confronti di caratteristiche critiche per la sicurezza. Esso elabora le mappe delle caratteristiche provenienti da diversi strati del backbone YOLOv11, fondendo caratteristiche a diverse scale mediante operazioni di upsampling e downsampling. Inoltre, incorpora meccanismi di attenzione di tipo spaziale e per canale. Per garantire un'integrazione senza interruzioni tra i moduli YOLOv11 e CNN, viene impiegata una strategia di addestramento congiunta. Durante l'addestramento, i parametri di entrambi i moduli vengono ottimizzati in modo end-to-end. La funzione di perdita combina la perdita di rilevamento di YOLOv11 con la perdita di potenziamento delle caratteristiche del modulo CNN. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Per verificare l'efficacia del modello proposto di fusione tra YOLOv11 e CNN nel monitoraggio della sicurezza in linea di produzione, è stato costruito un dataset che copre vari scenari di rischio per la sicurezza. Questo dataset contiene 12.000 immagini di scenari in linea di produzione, suddivise in set di addestramento, validazione e test in un rapporto 7:1,5:1,5, con un seme casuale fisso pari a 42. Include diverse condizioni operative, come illuminazione standard, scarsa illuminazione, occlusione parziale, occlusion...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
I risultati sperimentali mostrano che il modello proposto di fusione YOLOv11–CNN migliora l'accuratezza di rilevamento e le prestazioni in tempo reale per il monitoraggio della sicurezza in linea di produzione. Sfruttando il rilevamento efficiente in un'unica fase di YOLOv11 e il potenziamento delle caratteristiche del modulo CNN, il sistema ha identificato lavoratori, attrezzature e aree pericolose in condizioni complesse di illuminazione e occlusione. La fusione di caratteristiche multiscala e i meccanismi di attenzion...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Questo lavoro è stato finanziato in parte dalla Fondazione per la Ricerca Scientifica dell'Università di Taizhou per i Talenti Avanzati "Ricerca sulle tecnologie chiave del rilevamento di precisione per la produzione intelligente" (TZXY2020QDJJ006).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| API COCO | N/D | Strumento di valutazione utilizzato per la valutazione dell'accuratezza nel rilevamento degli obiettivi e per l'analisi statistica. | |
| CUDA 11.4 | NVIDIA | N/D | Piattaforma di calcolo parallelo utilizzata insieme al framework PyTorch 1.12. |
| Edge TPU | N/D | Piattaforma di distribuzione utilizzata per i test di latenza e consumo energetico; la latenza riportata era di 18 ms e il consumo energetico era di 15 W. | |
| Dispositivo di elaborazione edge Jetson Xavier | NVIDIA | Dispositivo di elaborazione edge utilizzato per i test del throughput; la velocità di elaborazione riportata era di 70 FPS con una latenza al 99° percentile entro i 50 ms. | |
| GPU NVIDIA Tesla V100 | NVIDIA | GPU utilizzata nel server di addestramento/valutazione. | |
| PyTorch 1.12 | N/D | Framework di deep learning utilizzato per l'addestramento e la valutazione del modello. | |
| scikit-learn | N/D | Strumento di valutazione/analisi statistica utilizzato per la valutazione del modello. | |
| Dati immagini di sicurezza della linea di produzione autocostruiti | N/D | N/D | Dati costituiti da 12.000 immagini di scenari di linea di produzione in formato VOC, comprendenti condizioni di illuminazione standard, scarsa illuminazione, occlusione parziale, occlusione pesante, sfocatura per movimento e sfondi complessi; sei categorie di annotazione: operatori, caschi di sicurezza, bracci robotici, aree pericolose, attrezzi e veicoli. |
| Server di addestramento | Server dotato di GPU NVIDIA Tesla V100 e sistema operativo Ubuntu 20.04. | ||
| Sistema operativo Ubuntu 20.04 | N/D | Sistema operativo utilizzato sul server di addestramento/valutazione. | |
| Formato di annotazione VOC | N/D | N/D | Formato di annotazione utilizzato per il dataset autocostruito di sicurezza della linea di produzione. |
| Modello di rilevamento oggetti YOLOv11 | Ultralytics | N/D | Modello di rilevamento oggetti utilizzato per rilevare in tempo reale operatori, attrezzature e potenziali rischi. |
Riferimenti
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.