Questo studio presenta un framework automatizzato per la prototipazione di interfacce utente che integra principi di progettazione cognitiva, modellazione percettiva del colore e apprendimento profondo. Il sistema migliora l'accessibilità, la chiarezza del layout, l'armonia cromatica e la coerenza tra schermi, producendo progetti di interfaccia coerenti e centrati sull'utente.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Framework di prototipazione automatizzata dell'interfaccia utente che integra i principi del design cognitivo e visivo per migliorare l'usabilità e la chiarezza del layout
In questo articolo
Sommario
Abstract
Una progettazione efficace dell'interfaccia utente (UI) richiede un equilibrio armonioso tra attrattiva visiva, usabilità cognitiva e coerenza del layout. Tuttavia, gli attuali approcci di generazione automatica dell'interfaccia utente si concentrano principalmente sull'aspetto visivo o sul rilevamento dei componenti, mancando di un framework unificato che integri principi cognitivi, intelligenza cromatica e ragionamento strutturale. Inoltre, i metodi esistenti soffrono di generalizzazione limitata del layout, scarsa interpretabilità, selezione cromatica statica e comportamento non coerente tra schermate diverse. In questo contesto, questo studio propone un framework automatizzato per la prototipazione dell'interfaccia utente che integra il rilevamento dei componenti basato sulla rete neurale convoluzionale region-based più veloce (Faster R-CNN) e la modellazione cromatica percettiva guidata dallo spazio colore uniforme CIECAM02 (CAM02-UCS), arricchita con principi di progettazione cognitiva e visiva. Il Faster R-CNN viene utilizzato per identificare i componenti dell'interfaccia utente e inferire strutture gerarchiche da dataset di interfacce su larga scala. Un modulo avanzato di generazione del colore analizza immagini del marchio o di riferimento per garantire temi cromatici percettivamente uniformi, armoniosi e conformi ai requisiti di usabilità, utilizzando CAM02-UCS. Questi risultati vengono ulteriormente ottimizzati attraverso regole di progettazione cognitiva, tra cui il raggruppamento secondo la psicologia della Gestalt, le leggi di Fitts e di Hick, la spaziatura basata sull'attenzione e la modellazione della gerarchia visiva, al fine di generare automaticamente layout dell'interfaccia utente raffinati e orientati al compito. Esperimenti condotti sui dataset RICO, ENRICO e Guo’s UI Color Datasets mostrano che il sistema proposto raggiunge un'accuratezza del 92,4% nel rilevamento dei componenti, migliora la chiarezza del layout e l'accuratezza dell'ordine di lettura del 18,7% e produce palette cromatiche giudicate dal 24,5% più armoniose dai progettisti rispetto ai metodi di base. Le valutazioni degli utenti indicano inoltre una riduzione del 31% del carico cognitivo percepito e un aumento del 28% della coerenza progettuale tra schermate. Questi risultati dimostrano che la combinazione della comprensione strutturale basata sul deep learning con la modellazione cromatica fondata sulle percezioni e i principi di progettazione cognitiva produce prototipi di interfacce utente altamente efficienti, esteticamente coerenti e facili da usare. Questo framework stabilisce un nuovo approccio end-to-end per la prototipazione automatizzata dell'interfaccia utente intelligente e centrata sull'essere umano.
Introduzione
Le interfacce grafiche per l'utente (GUI) svolgono un ruolo fondamentale di comunicazione tra esseri umani e sistemi informatici, influenzando in modo significativo l'usabilità, l'accessibilità e l'esperienza complessiva dell'utente (UX)1,2. I sistemi software moderni si basano su interfacce intuitive e visivamente accattivanti per attrarre e mantenere gli utenti. Tradizionalmente, la progettazione dell'interfaccia utente prevede la creazione di layout grafici che successivamente vengono tradotti in codice front-end da parte degli ingegneri. Tuttavia, le differenze nei protocolli specifici delle piattaforme tra diversi sistemi operativi richiedono adattamenti ripetuti, aumentando la complessità e lo sforzo di sviluppo. La generazione automatica del codice per l'interfaccia utente si è quindi affermata come un'importante direzione di ricerca, riducendo lo sforzo manuale e migliorando l'efficienza dello sviluppo.
I primi approcci alla generazione automatica di interfacce utente combinavano tecniche tradizionali di elaborazione delle immagini con modelli di apprendimento profondo per la rilevazione e la classificazione delle regioni3,4. Attualmente, le strategie predominanti per la generazione di codice GUI applicano tecniche di visione artificiale per analizzare le immagini delle interfacce utente e convertirle in rappresentazioni strutturate per il front-end5,6,7. Mentre i metodi di elaborazione delle immagini si basano su caratteristiche progettate manualmente, gli approcci basati sull'apprendimento profondo estraggono rappresentazioni gerarchiche da dataset su larga scala. Di conseguenza, i ricercatori hanno esplorato approcci ibridi che combinano l'apprendimento profondo con tecniche specifiche del dominio di elaborazione delle immagini per migliorare robustezza e accuratezza.
Il colore è un altro fattore fondamentale nella progettazione dell'interfaccia utente, che influenza la percezione dell'utente, l'usabilità e l'estetica1. Mantenere una coerenza tra il contenuto delle immagini e le combinazioni cromatiche dell'interfaccia utente risulta difficile quando gli input visivi variano per tonalità e contesto8,9,10. Di conseguenza, una notevole quantità di ricerca si è concentrata sulla generazione automatica di palette cromatiche e sulla modellizzazione percettiva del colore. I metodi esistenti per la generazione di colori includono tecniche basate sullo spazio colore CIELAB11. Altri approcci utilizzano algoritmi di clustering, come k-means, per estrarre i colori dominanti dalle immagini12. Di recente, pertanto, si è assistito a un crescente ricorso ad approcci basati sui dati e sul machine learning per la modellizzazione del colore.
Parallelamente, gli approcci di deep learning hanno notevolmente migliorato il rilevamento dei componenti dell'interfaccia utente e la comprensione della disposizione. Le reti neurali hanno reso possibile un'analisi strutturale più accurata delle interfacce mobili13. Tuttavia, questi metodi si concentrano principalmente sull'accuratezza del rilevamento e spesso trascurano aspetti di livello superiore come l'usabilità cognitiva, la gerarchia della disposizione e l'efficienza delle interazioni. Sono stati inoltre proposti modelli generativi per la sintesi della disposizione dell'interfaccia utente14,15, ma incontrano difficoltà nel mantenere la coerenza tra schermate diverse e nel fornire decisioni di progettazione interpretabili16. Altri approcci si focalizzano sulla similarità visiva o sulla qualità di rendering, ma mancano di un framework unificato che combini semantica dei componenti, armonia cromatica e vincoli di usabilità17. Il riconoscimento del testo è inoltre importante per comprendere il contenuto dell'interfaccia utente. Tecniche come le reti neurali ricorrenti convoluzionali (CRNN) consentono un riconoscimento accurato di modelli testuali complessi negli schermi dell'interfaccia18,19,20.
Sono stati proposti diversi sistemi per generare codice UI da schizzi o immagini. Sketch2Code utilizza il rilevamento degli oggetti per convertire schizzi in rappresentazioni codificate21,22, ma è sensibile alla qualità dell'immagine. REDRAW offre una pipeline automatizzata per la raccolta dati e l'addestramento del modello, combinando reti neurali convoluzionali e ricorrenti per generare rappresentazioni strutturate dell'interfaccia utente23,24. Lavori successivi hanno introdotto metriche di valutazione migliorate per analizzare la qualità dell'interfaccia utente generata25. Approcci più recenti includono modelli basati su diffusione e su trasformatori per la generazione di layout, come i trasformatori per layout basati su diffusione senza metodi di autoencoder, la generazione di layout GUI mediante grafi di disposizione GUI basati su trasformatori, e la generazione guidata da modelli linguistici di grandi dimensioni di layout per l'interfaccia utente26,27,28. Un panorama comparativo di questi approcci è fornito nella Tabella 1.
| Riferimenti e Metodo(i) Chiave | Obiettivo | Vantaggi | Svantaggi |
| Generazione automatica basata su immagini di temi cromatici per interfacce utente: estrazione dei colori predominanti + modellazione cromatica percettiva CAM02-UCS¹ | Generare automaticamente temi cromatici per interfacce utente a partire da immagini di riferimento, ottimizzando armonia e usabilità. | Fondamento percettivo solido (CAM02-UCS); bilancia esplicitamente armonia e usabilità (contrasto e diversità); include un'implementazione basata sul web e una valutazione da parte di designer. | Si concentra esclusivamente sui colori/temi (non sul layout o sulla struttura dei componenti); basato su regole/euristiche piuttosto che su sintesi end-to-end appresa. |
| Unificazione della generazione di layout con un modello di diffusione disaccoppiato (LDGM)²⁵ | Generazione unificata e flessibile di layout per scene grafiche e interfacce utente. | Diversità e controllabilità all'avanguardia nella generazione di layout; supporta la generazione condizionata e diversi tipi di attributi. | Gli output basati sulla diffusione possono presentare problemi di allineamento o dettagli fini nel layout se non vincolati; maggiore complessità del modello e costo computazionale durante l'inferenza. |
| Diffusion Layout Transformers senza metodi autoencoder: trasformatore + diffusione per la generazione di layout (senza autoencoder)²⁶ | Migliorare fedeltà e allineamento nei benchmark di generazione di layout (metriche FID, allineamento e sovrapposizione). | Migliore cattura delle correlazioni semantiche tra oggetti adiacenti; prestazioni elevate nelle metriche FID e di allineamento. | Si concentra principalmente sulla geometria del layout (posizioni, dimensioni, categorie) piuttosto che sulla semantica dell'interfaccia utente. |
| Generazione di layout GUI con modelli basati su trasformatori a partire da grafi di disposizione GUI (GUI-AGs)²⁷ | Creare layout GUI a partire da vincoli posizionali/grafici per assistere i designer. | Le rappresentazioni grafiche catturano i vincoli relazionali; il trasformatore consente una generazione flessibile condizionata ai vincoli. | Potrebbe richiedere grafi di vincoli espliciti da parte dei designer; attenzione limitata a metriche di colore e usabilità. |
| Generazione di layout UI con modelli linguistici di grandi dimensioni guidati da una grammatica UI: modelli linguistici di grandi dimensioni (LLMs) + grammatica UI gerarchica²⁸ | Esplorare l'uso degli LLM per la generazione di layout e migliorare spiegabilità/controllo tramite rappresentazioni grammaticali. | Controllabilità ed esplicabilità a alto livello; possibilità di sfruttare l'apprendimento contestuale degli LLM (tipo GPT). | Lavoro in fase iniziale con validazione empirica limitata; progettazione della grammatica e robustezza attraverso diversi tipi di UI |
Tabella 1: Confronto tra metodi esistenti di modellazione del colore nell'interfaccia utente e generazione di layout. La tabella riassume approcci rappresentativi per la progettazione dell'interfaccia utente, inclusa la generazione di temi cromatici, la generazione di layout basata su diffusione, metodi basati su trasformatori e la generazione di layout guidata da modelli linguistici di grandi dimensioni. Per ciascun metodo vengono presentati la tecnica sottostante, l'obiettivo, i vantaggi e i limiti, evidenziando le differenze in termini di modellazione percettiva, capacità di generazione del layout, controllabilità e considerazioni sull'usabilità.
Nonostante questi progressi, permane una limitazione fondamentale: nessun sistema esistente integra contemporaneamente rilevamento dei componenti, modellazione percettiva del colore, principi cognitivi di progettazione e coerenza del layout multipiattaforma all'interno di un unico framework end-to-end1. Gli approcci attuali tipicamente ottimizzano solo uno o due aspetti—come rilevamento, layout o colore—senza considerarne le interdipendenze. Questa frammentazione evidenzia un'importante lacuna nella ricerca volta a sviluppare sistemi unificati di prototipazione automatica di interfacce utente centrati sull'essere umano. In particolare, principi cognitivi di progettazione come le leggi della Gestalt, la legge di Fitts e la legge di Hick sono spesso trattati a livello concettuale piuttosto che essere formalmente integrati nei modelli computazionali.
Per affrontare queste limitazioni, lo studio propone un framework automatizzato end-to-end per la prototipazione dell'interfaccia utente che integra il rilevamento dei componenti, la modellazione percettiva del colore e i principi di design cognitivo all'interno di un sistema unificato. Il framework è stato progettato per migliorare la qualità del layout, ridurre il carico cognitivo, ottimizzare l'armonia cromatica e aumentare l'usabilità complessiva. Questi miglioramenti sono stati validati attraverso esperimenti sui dataset RICO, ENRICO e Guo’s UI Color Datasets, dimostrando l'efficacia della combinazione di aspetti strutturali, percettivi e cognitivi all'interno di una singola pipeline automatizzata per la prototipazione dell'interfaccia utente. Si ipotizza che l'integrazione del rilevamento dei componenti basato sul deep learning, della modellazione percettiva del colore e dei principi di design cognitivo all'interno di un framework unificato consentirà un miglioramento significativo della qualità dei prototipi di interfaccia utente rispetto agli approcci esistenti. In particolare, H1 propone che il framework migliori la qualità del layout, inclusi allineamento, raggruppamento e ordine di lettura. H2 afferma che il framework riduce il carico cognitivo dell'utente. H3 suggerisce che la modellazione percettiva del colore migliora la coordinazione cromatica e l'armonia visiva. H4 afferma che l'usabilità complessiva e la qualità estetica dei prototipi di interfaccia utente risultano migliorate.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio utilizza set di dati disponibili pubblicamente e non prevede soggetti umani o animali.
Il framework proposto per la prototipazione automatizzata di interfacce utente integra una comprensione strutturale basata sul deep learning, una modellazione cromatica percettivamente uniforme e principi di design cognitivi per generare prototipi di interfaccia coerenti e centrati sull'utente. La metodologia inizia con un'architettura Faster R-CNN addestrata sui dataset RICO ed ENRICO per rilevare i componenti dell'interfaccia utente ed estrarre le loro relazioni gerarchiche, consentendo un'interpretazione accurata di layout schermo diversificati. I componenti rilevati vengono quindi elaborati da un modulo di intelligenza cromatica, che estrae suggerimenti cromatici basati su marchio o immagine, modella la similarità percettiva utilizzando CAM02-UCS e genera palette di colori armoniose, sensibili al contrasto e conformi ai requisiti di accessibilità. Successivamente, principi di design cognitivi — tra cui le leggi del raggruppamento di Gestalt, la legge di Fitts, la legge di Hick, la spaziatura basata sull'attenzione e i vincoli di gerarchia visiva — vengono applicati attraverso un motore di ottimizzazione cognitiva per perfezionare l'organizzazione spaziale e l'allineamento dei componenti. Infine, un livello di ragionamento sul layout integra vincoli strutturali, percettivi e cognitivi per generare prototipi di interfaccia utente coerenti su più schermate, bilanciando usabilità, estetica e chiarezza funzionale. Questa pipeline integrata garantisce coerenza percettiva, riduce il carico cognitivo e rispetta i principi di design centrati sull'essere umano. L'intero flusso di lavoro del metodo proposto è illustrato in Figura 1.
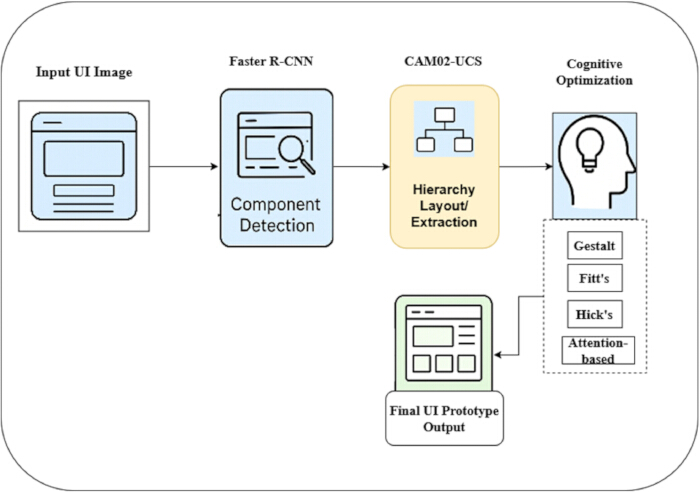
Figura 1. Architettura generale del framework proposto per la prototipazione automatica dell'interfaccia utente. Il diagramma illustra l'intera pipeline, a partire da un'immagine iniziale dell'interfaccia utente. Il rilevamento dei componenti viene eseguito utilizzando Faster R-CNN per identificare gli elementi dell'interfaccia. I componenti rilevati vengono quindi elaborati mediante modellazione percettiva basata su CAM02-UCS per l'estrazione della gerarchia e del layout. Successivamente, viene applicata un'ottimizzazione cognitiva basata sui principi della Gestalt, sulla legge di Fitts, sulla legge di Hick e su aggiustamenti basati sull'attenzione. Le frecce indicano il flusso dei dati tra i moduli, che porta in output il prototipo finale dell'interfaccia utente. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Panoramica del framework
Figura 1 illustra il flusso di lavoro end-to-end del framework proposto per la prototipazione automatica dell'interfaccia utente, che trasforma uno screenshot grezzo dell'interfaccia in un prototipo affinato dal punto di vista cognitivo. Il processo inizia con l'immagine di input dell'interfaccia utente, che viene inviata al modulo di rilevamento dei componenti basato su Faster R-CNN. Questo modulo identifica elementi dell'interfaccia come pulsanti, icone, campi di testo e contenitori, e restituisce i rispettivi riquadri delimitatori e le etichette di classe. I componenti rilevati vengono quindi elaborati nella fase di estrazione della gerarchia e del layout. Sulla base delle relazioni spaziali e dei modelli strutturali, il sistema costruisce un albero gerarchico del layout che riflette il modo in cui gli utenti percepiscono naturalmente l'organizzazione dello schermo. Questa rappresentazione cattura il raggruppamento visivo e le dipendenze strutturali tra gli elementi dell'interfaccia utente. Il layout estratto viene successivamente affinato mediante un'ottimizzazione cognitiva che applica principi di progettazione centrati sull'utente. Tali principi includono il raggruppamento di Gestalt per il clustering visivo, la legge di Fitts per ottimizzare dimensioni e accessibilità delle aree sensibili al tocco, la legge di Hick per ridurre la complessità decisionale e un'organizzazione dello spazio basata sull'attenzione per migliorare la gerarchia visiva. Di conseguenza, il layout diventa più intuitivo, leggibile ed efficiente per l'interazione dell'utente. Infine, il layout ottimizzato viene combinato con un modello percettivo del colore per generare un prototipo di interfaccia coerente. L'interfaccia risultante è strutturalmente accurata, visivamente armoniosa e conforme alle aspettative umane in termini di usabilità.
Il framework è stato implementato utilizzando PyTorch 2.0 su Ubuntu 22.04. Gli esperimenti sono stati condotti su un sistema dotato di una GPU NVIDIA RTX 4090 (24 GB di VRAM). Il modello Faster R-CNN ha utilizzato un'architettura ResNet-50 pre-addestrata sul dataset ImageNet. L'addestramento è stato eseguito utilizzando l'ottimizzatore stochastic gradient descent (SGD) con un tasso di apprendimento di 0,001, una dimensione del batch di 16 e fino a 60 epoche. È stata applicata l'arresto anticipato (early stopping) per prevenire l'overfitting, utilizzando un insieme di validazione costituito dal 20% dei dati. Sebbene l'addestramento sia stato effettuato per un massimo di 60 epoche, la convergenza è stata generalmente raggiunta prima grazie all'arresto anticipato basato sulla perdita di validazione. I valori di momento e riduzione del peso sono stati impostati rispettivamente a 0,9 e 0,0005. L'aumento dei dati ha incluso normalizzazione, inversione orizzontale casuale e ritaglio ridimensionamento casuali.
Preparazione del set di dati
Per supportare il framework proposto per la prototipazione automatizzata dell'interfaccia utente (UI), sono stati utilizzati tre dataset complementari: ENRICO29, RICO30 e il Guo’s UI Color Dataset1. Il dataset RICO contiene 66.261 schermate UI Android raccolte da 9.700 applicazioni, offrendo una notevole diversità su larga scala per il rilevamento dei componenti e l'estrazione dei layout gerarchici. ENRICO comprende 1.464 screenshot UI di alta qualità, classificati manualmente in 20 modelli di design, consentendo una migliore generalizzazione nel ragionamento strutturale e nella modellazione della coerenza del layout. Il Guo’s UI Color Dataset è costituito da 128 immagini UI curate con temi cromatici annotati, utilizzate per la modellazione percettiva del colore e la valutazione delle palette. Tuttavia, a causa delle dimensioni relativamente ridotte, questo dataset potrebbe introdurre una certa variabilità nelle caratteristiche del layout. Per questo studio, è stato preparato un dataset combinato di 5.128 schermate per il training e la valutazione. In particolare, circa 4.000 immagini da RICO sono state utilizzate per addestrare il modello Faster R-CNN nel rilevamento dei componenti, 1.000 immagini da ENRICO per l'apprendimento dei modelli di layout e la modellazione della coerenza strutturale, e 128 immagini dal dataset di Guo per le attività di valutazione del colore. Tutte le immagini sono state normalizzate a una risoluzione di 480 × 800 pixel, convertite in uno spazio colore sRGB uniforme e riannotated con box delimitatori standardizzati e metadati gerarchici per garantire la compatibilità tra i dataset. Una panoramica dei dataset utilizzati in questo studio è riportata nella Tabella 2. Il dataset RICO supporta il rilevamento su larga scala dei componenti UI e l'analisi strutturale, mentre ENRICO migliora la capacità del modello di riconoscere i modelli di layout e applicare coerenza tra schermate diverse. Il Guo’s UI Color Dataset, sebbene più piccolo, svolge un ruolo fondamentale nella valutazione dell'armonia cromatica percettiva e della modellazione del contrasto. Nel complesso, questi dataset forniscono una base completa ed equilibrata per il training, la validazione e la valutazione del framework proposto per la prototipazione automatizzata dell'interfaccia utente.
| Dataset | Numero totale di immagini disponibili | Immagini utilizzate nello studio | Scopo nel framework proposto |
| RICO Dataset30 | 66,261 | 4,000 | Rilevamento dei componenti dell'interfaccia utente, estrazione del layout strutturale |
| ENRICO Dataset29 | 1,464 | 1,000 | Apprendimento dei modelli di progettazione, modellazione della coerenza del layout |
| Guo’s UI Color Dataset1 | 128 | 128 | Estrazione del tema cromatico, valutazione percettiva del colore |
| Totale combinato | 67,853 | 5,128 | Dataset completo per il rilevamento, il layout e la modellazione cromatica |
Tabella 2: Sintesi dei set di dati utilizzati nel framework proposto. La tabella presenta i set di dati impiegati per il training e la valutazione, inclusi i set di dati RICO, ENRICO e Guo’s UI Color. Vengono riportati il numero totale di immagini disponibili, il sottoinsieme utilizzato in questo studio e il ruolo specifico di ciascun set di dati nel rilevamento dei componenti, nella modellazione del layout e nell'analisi percettiva del colore all'interno del framework proposto.
È stata adottata una strategia di campionamento stratificato per preservare la diversità nei componenti dell'interfaccia utente, nelle strutture di layout e nelle distribuzioni dei colori nei dataset RICO, ENRICO e Guo. Il dataset è stato suddiviso in sottoinsiemi di training (70%), validazione (15%) e test (15%) utilizzando un campionamento stratificato. Le immagini sono state normalizzate utilizzando la media (0.485, 0.456 e 0.406) e la deviazione standard (0.229, 0.224 e 0.225). L'aumento dei dati ha incluso il ribaltamento orizzontale casuale (probabilità = 0.5) e il ritaglio casuale (intervallo di scala: 0.8–1.0), seguito da ridimensionamento a 224 × 224 pixel applicato durante il training.
Annotazione dei componenti e preelaborazione
I dataset RICO, ENRICO e Guo’s UI Color supportano congiuntamente i tre componenti funzionali principali del framework proposto per la prototipazione automatica di interfacce utente: rilevamento dei componenti, modellazione del layout e ottimizzazione percettiva dei colori. Il dataset RICO contiene una raccolta su larga scala di oltre 66.000 schermate di interfacce utente per dispositivi mobili ed è utilizzato principalmente per addestrare il modulo di rilevamento dei componenti. La sua diversità consente al modello Faster R-CNN di apprendere rappresentazioni robuste di elementi comuni delle interfacce utente, come pulsanti, immagini e campi di testo, in un'ampia varietà di applicazioni. Ciò garantisce un rilevamento e una localizzazione accurati dei componenti dell'interfaccia utente in condizioni di progettazione variabili. Il dataset ENRICO fornisce schermate di interfacce utente di alta qualità, etichettate per modelli, per l'apprendimento delle relazioni strutturali e dei modelli di layout. Permette al sistema di comprendere le relazioni tra i componenti, l'organizzazione gerarchica e i modelli di progettazione comuni. Questo dataset svolge un ruolo fondamentale nella modellazione delle strutture di layout e nel garantire la coerenza tra più schermate, consentendo al framework di generare layout allineati alle convenzioni di progettazione consolidate. Al contrario, il dataset Guo’s UI Color è specificamente impiegato per la modellazione percettiva e cognitiva dei colori. A differenza di RICO ed ENRICO, che si concentrano sugli aspetti strutturali, questo dataset contiene immagini di interfacce utente selezionate con temi cromatici annotati. Tali annotazioni vengono utilizzate per addestrare i moduli di estrazione dei colori e di valutazione dell'armonia cromatica. Mappando le relazioni cromatiche in spazi colore percettivi come CAM02-UCS, il framework impara a generare palette di colori che bilanciano contrasto, accessibilità e coerenza estetica. Nel complesso, questi dataset formano una pipeline integrata: RICO supporta il rilevamento dei componenti, ENRICO permette la comprensione dei modelli di layout e la coerenza strutturale, mentre il dataset di Guo facilita l'ottimizzazione percettiva dei colori. Questa integrazione assicura che i prototipi di interfaccia utente generati siano strutturalmente accurati, visivamente armoniosi e ottimizzati dal punto di vista cognitivo.
La normalizzazione è stata eseguita utilizzando una media di [0.485, 0.456, 0.406] e una deviazione standard di [0.229, 0.224, 0.225]. Sono state applicate tecniche di aumento dei dati, tra cui ritaglio casuale, inversione orizzontale e rotazione, per migliorare la generalizzazione del modello. Inoltre, i valori dei pixel sono stati ridimensionati all'intervallo [0, 1] e tutte le immagini sono state ridimensionate a una risoluzione di 480 × 800 pixel per garantire coerenza tra i dataset. Le immagini ridimensionate a 224 × 224 pixel vengono utilizzate per l'aumento durante l'addestramento, mentre la risoluzione originale di 480 × 800 pixel viene mantenuta per l'analisi del layout. Le bounding box sono state aggiustate per filtrare annotazioni irrilevanti utilizzando soglie predefinite. Per ottenere uniformità tra i dataset, tutti gli elementi dell'interfaccia utente sono stati annotati manualmente utilizzando lo strumento di annotazione LabelImg. Uno schema predefinito è stato stabilito prima dell'annotazione per classificare gli elementi dell'interfaccia utente in categorie come pulsante, testo, immagine, icona e contenitore. Per la rappresentazione delle bounding box, è stato applicato un sistema di coordinate uniforme e sono state costruite informazioni gerarchiche basate sulle relazioni spaziali tra gli elementi e le loro associazioni padre-figlio all'interno dell'albero del layout. Inoltre, sono state stabilite linee guida per garantire un'annotazione coerente degli elementi, una corretta gestione dei componenti sovrapposti e l'applicazione di soglie minime di dimensione attraverso i dataset RICO, ENRICO e Guo.
Formulazioni matematiche dettagliate per l'addestramento del rilevamento dei componenti e l'estrazione dei modelli di layout sono fornite nel File Supplementare 1.
Il modello Faster R-CNN è stato addestrato utilizzando SGD con un momento di 0,9 e un decadimento del peso di 0,0005. Il tasso di apprendimento iniziale è stato impostato a 0,001 e aggiustato mediante una politica di decadimento a gradini basata sulle prestazioni di validazione. L'addestramento è stato eseguito per un massimo di 60 epoche con una dimensione del batch di 16. È stata applicata l'arresto anticipato per prevenire l'overfitting, utilizzando un insieme di validazione costituito dal 20% dei dati di addestramento.
La funzione di mappatura f(.) prende come input gli elementi dell'interfaccia utente rilevati e produce in output una rappresentazione gerarchica del layout. Calcola le relazioni di adiacenza tra gli elementi dell'interfaccia utente in base a criteri di distanza spaziale e allineamento, e costruisce una matrice di adiacenza per rappresentare tali relazioni. Successivamente, viene applicato un algoritmo di clustering, come DBSCAN, per raggruppare i componenti correlati. Infine, gli elementi raggruppati vengono organizzati in strutture gerarchiche in base alle relazioni padre-figlio, formando una rappresentazione strutturata del layout.
Formulazioni dettagliate per la modellazione dell'armonia cromatica e per l'obiettivo di ottimizzazione unificato sono fornite nel File Supplementare 1.
Questa funzione obiettivo formalizza matematicamente l'integrazione del rilevamento strutturale, del ragionamento sul layout e della modellazione percettiva del colore, garantendo che tutti i componenti del framework contribuiscano congiuntamente alla generazione di prototipi di interfaccia utente coerenti e centrati sull'utente. L'ottimizzazione viene eseguita in modo modulare per ciascun componente del framework. Viene utilizzato SGD per l'addestramento del modulo di rilevamento dei componenti, mentre l'ottimizzatore Adam viene impiegato durante l'ottimizzazione congiunta dell'obiettivo unificato. La funzione obiettivo combinata viene utilizzata per guidare le prestazioni complessive del sistema. Per le fasi di ottimizzazione congiunta, la funzione obiettivo viene minimizzata utilizzando l'ottimizzatore Adam con un tasso di apprendimento di 0,001 e una dimensione del batch di 16. L'addestramento viene eseguito per un massimo di 60 epoche, applicando l'arresto anticipato quando la variazione della perdita sulla validazione è inferiore a 10−4 per cinque epoche consecutive.
Rilevamento dei componenti mediante Faster R-CNN
Il framework proposto utilizza Faster R-CNN per la rilevazione automatica di componenti dell'interfaccia utente (UI), inclusi pulsanti, icone, campi di testo, immagini e contenitori. Faster R-CNN è particolarmente adatto a questo compito poiché combina un'elevata accuratezza nel rilevamento degli oggetti con una generazione efficiente di proposte di regione, elemento essenziale per gestire layout complessi dell'interfaccia utente contenenti elementi densamente impacchettati. Il modello utilizza un'architettura ResNet-50 pre-addestrata sul dataset ImageNet per estrarre mappe di caratteristiche convoluzionali da ogni schermata dell'interfaccia utente. Durante l'addestramento, i primi strati sono stati congelati per mantenere caratteristiche visive generali, mentre i livelli superiori (conv4_x e conv5_x) sono stati affinati per la rilevazione specifica di componenti dell'interfaccia utente. Queste mappe di caratteristiche catturano strutture visive, bordi, trame e contorni dei componenti. Durante il rilevamento, la rete di proposta di regioni (RPN) identifica regioni candidate (ancore) che probabilmente contengono componenti dell'interfaccia utente. Le ancure sono definite utilizzando diverse scale (128, 256 e 512) e rapporti d'aspetto (1:1, 1:2 e 2:1) per adattarsi a elementi dell'interfaccia utente di dimensioni variabili. Durante l'addestramento, le ancure con un valore di intersezione rispetto all'unione (IoU) superiore a 0,7 rispetto ai riquadri di riferimento sono etichettate come positive, mentre quelle con un valore di IoU inferiore a 0,3 sono etichettate come negative; le ancure con valori intermedi di IoU vengono ignorate. A ciascuna ancore viene assegnata una probabilità che indica la presenza di un componente. Successivamente viene applicata la soppressione non massima (NMS) per rimuovere proposte ridondanti e sovrapposte, garantendo una localizzazione efficiente di elementi significativi dell'interfaccia utente anche in interfacce affollate. Una volta generate le regioni candidate, ogni proposta viene classificata in categorie predefinite di componenti e vengono affinate le coordinate del suo riquadro delimitatore. Un'operazione di allineamento della regione di interesse (ROI) estrae rappresentazioni di caratteristiche di dimensione fissa per ciascuna proposta, che vengono poi elaborate da strati completamente connessi per la classificazione e la regressione. Il ramo di classificazione produce probabilità di classe, mentre il ramo di regressione predice coordinate precise del riquadro delimitatore. L'intero modello Faster R-CNN viene addestrato end-to-end ottimizzando una funzione di perdita congiunta che combina la perdita della RPN con la perdita finale di rilevamento. Ciò consente al sistema non solo di riconoscere accuratamente i componenti dell'interfaccia utente, ma anche di localizzarli con precisione all'interno di strutture d'interfaccia diverse. Una descrizione dettagliata della rilevazione dei componenti con Faster R-CNN, inclusa la fase della RPN, la classificazione delle ROI, l'affinamento del riquadro delimitatore e l'obiettivo finale di ottimizzazione, è fornita in Supplementary File 1.
Algoritmo S1 fornisce il flusso di lavoro dettagliato per il rilevamento dei componenti ed estrazione strutturale (File Supplementare 1). Viene descritto il processo completo di rilevamento automatico dei componenti dell'interfaccia utente ed estrazione strutturale a partire da un'immagine grezza dello schermo. L'immagine in ingresso viene inizialmente preelaborata e inviata a un'architettura CNN per estrarre caratteristiche visive profonde. Queste caratteristiche sono utilizzate dall'RPN per generare box delimitatori candidati, che vengono successivamente affinati mediante classificazione e regressione. La NMS elimina i rilevamenti ridondanti per garantire una localizzazione accurata. Dopo il rilevamento, i componenti vengono raggruppati in base alla vicinanza spaziale utilizzando il clustering spaziale basato sulla densità di applicazioni con rumore (DBSCAN). Questo passaggio di clustering consente la costruzione di un albero gerarchico dell'interfaccia utente che cattura le relazioni padre-figlio e i raggruppamenti logici tra i componenti. Questa rappresentazione gerarchica costituisce la base per l'analisi successiva del layout e la comprensione dell'interfaccia utente. Figura 2 illustra il processo di rilevamento dei componenti mediante Faster R-CNN su uno schermo di interfaccia utente mobile. L'interfaccia in ingresso (a sinistra) contiene elementi dell'interfaccia utente come pulsanti e blocchi di testo, che vengono automaticamente racchiusi all'interno di box delimitatori. Queste regioni rilevate vengono quindi classificate in categorie di componenti (ad esempio, Pulsante e Testo), come indicato dai collegamenti etichettati. Il modulo di rilevamento Faster R-CNN (a destra) affina le coordinate dei box delimitatori, assegna etichette semantiche e produce informazioni strutturate a livello di componente. Questo passaggio costituisce una base fondamentale per i processi successivi, inclusi l'estrazione del layout, l'ottimizzazione cognitiva e la generazione di prototipi di interfaccia utente, fornendo rappresentazioni accurate e semanticamente significative dei componenti dell'interfaccia utente.
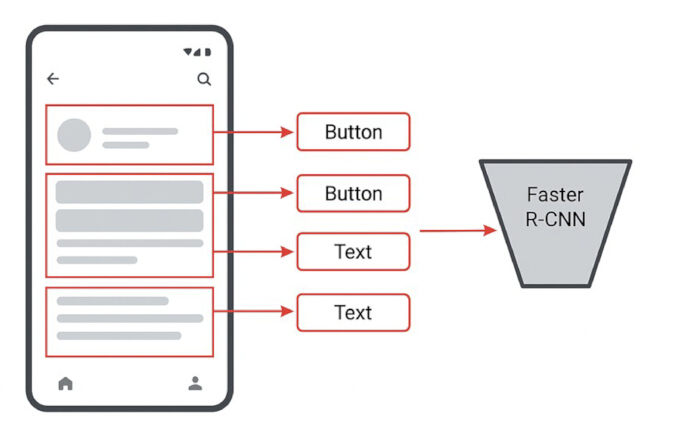
Figura 2. Rilevamento dei componenti degli elementi dell'interfaccia utente mediante Faster R-CNN. La figura illustra il rilevamento dei componenti dell'interfaccia utente a partire da una schermata di input. Le regioni di interesse vengono identificate mediante box delimitatori e gli elementi come pulsanti e campi di testo vengono classificati utilizzando Faster R-CNN. Le frecce indicano l'associazione dei componenti rilevati alle rispettive etichette semantiche. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Estrazione del modello di layout e modellizzazione gerarchica
Dopo il rilevamento dei componenti mediante Faster R-CNN, ogni elemento dell'interfaccia utente è rappresentato da un riquadro delimitatore. Tuttavia, questi riquadri da soli non indicano come gli elementi siano organizzati strutturalmente all'interno dell'interfaccia, ad esempio quali elementi appartengano a intestazioni, barre di navigazione o aree di contenuto raggruppate. Per superare questa limitazione, i componenti rilevati vengono trasformati in un albero logico dell'interfaccia utente, in cui ciascun componente è considerato un nodo e i componenti correlati funzionalmente o visivamente vengono raggruppati sotto nodi genitore comuni. Per identificare gruppi di layout significativi, vengono applicate tecniche di clustering come DBSCAN o il clustering gerarchico agglomerativo. Questi metodi analizzano la vicinanza spaziale e i modelli di allineamento tra i componenti per individuare le relazioni tra gli elementi dell'interfaccia utente. In modo analogo alle pratiche progettuali umane, il sistema impara a riconoscere modelli strutturali comuni come intestazioni, piè di pagina, griglie e blocchi di contenuto. Una volta stabilito il raggruppamento, vengono analizzate ulteriori proprietà strutturali, tra cui allineamento, organizzazione a griglia e ordine di lettura, al fine di costruire una rappresentazione completa del layout. Ad esempio, componenti allineati in colonne di uguale larghezza potrebbero indicare un layout basato su schede, mentre elementi disposti verticalmente potrebbero indicare un'interfaccia basata su moduli o flussi. Integrando clustering, ragionamento spaziale e regole di allineamento, il framework costruisce un albero gerarchico dell'interfaccia utente che cattura sia il raggruppamento visivo sia le relazioni funzionali. Questa rappresentazione gerarchica costituisce la base per il successivo affinamento del layout e la modellazione della coerenza tra più schermate, consentendo al sistema di generare progetti di interfacce strutturati, coerenti e centrati sull'utente.
Formulazioni dettagliate per la distanza spaziale e la similarità di allineamento sono fornite nel File Supplementare 1.
Raggruppamento per raggruppamento del layout (DBSCAN)
Per identificare i gruppi di layout, viene applicato DBSCAN. DBSCAN utilizza due parametri: (1) ε = distanza massima tra componenti adiacenti e (2) = numero minimo di componenti necessari per formare un cluster. Per questa analisi, i parametri di DBSCAN sono stati selezionati empiricamente in base alla risoluzione normalizzata dell'interfaccia utente (480 × 800 pixel). Il parametro della distanza del vicinato è stato impostato a ε = 50 pixel per rilevare la prossimità spaziale tra componenti dell'interfaccia utente adiacenti. Il numero minimo di punti richiesto per formare un cluster è stato impostato a MinPts = 3 per evitare la formazione di gruppi insignificanti o spurii di componenti dell'interfaccia utente.
La formulazione dettagliata della costruzione dell'albero logico dell'interfaccia utente è fornita nel File Supplementare 1.
Modellizzazione percettiva del colore con CAM02-UCS
La modellazione percettiva del colore garantisce che i colori utilizzati nell'interfaccia utente generata siano armoniosi, leggibili ed efficienti dal punto di vista cognitivo. I colori dominanti vengono estratti da fonti di input come immagini di interfacce utente, mediante tecniche di clustering. In particolare, si applica il clustering K-means con inizializzazione K-means++ per 300 iterazioni al fine di ottenere palette rappresentative. Tuttavia, lo spazio colore RGB non riflette accuratamente la percezione visiva umana, il che significa che colori numericamente simili possono apparire percettivamente diversi. Per superare questa limitazione, tutti i colori estratti vengono trasformati nello spazio CAM02-UCS, che è percettivamente uniforme. In questo spazio, distanze uguali corrispondono a differenze cromatiche percepite uguali, rendendolo adatto alla modellazione dell'armonia e del contrasto cromatico. Una volta mappati nello spazio CAM02-UCS, le differenze percettive tra i colori vengono calcolate mediante la distanza euclidea, consentendo al sistema di quantificare contrasto, armonia e variazione tra i colori. I colori troppo simili vengono separati per migliorare la leggibilità, mentre i colori con contrasto eccessivo vengono moderati per evitare disagio visivo. La palette generata rispetta inoltre standard di accessibilità come WCAG AA e AAA, garantendo un contrasto sufficiente tra elementi di primo piano e di sfondo. Inoltre, l'armonia cromatica viene applicata vincolando le relazioni all'interno della palette a schemi complementari, analoghi o triadici, a seconda del tema dell'interfaccia utente previsto. Ciò assicura che la palette risultante sia non solo esteticamente gradevole, ma anche funzionalmente accessibile e ottimizzata dal punto di vista cognitivo. Per affinare ulteriormente la palette, viene applicato un processo di ottimizzazione soggetto a vincoli di similarità percettiva, contrasto, armonia e coerenza del marchio. Viene selezionato un colore primario (ad esempio, proveniente dall'identità del marchio) e i colori secondari vengono regolati in termini di luminanza e croma per preservare la gerarchia visiva. Un meccanismo di valutazione basato su regole analizza le palette candidate in base alle distanze percettive e alle metriche di accessibilità, minimizzando lo sforzo cognitivo pur mantenendo l'equilibrio estetico. Di conseguenza, il framework produce schemi cromatici per interfacce utente caratterizzati da coerenza, leggibilità e consistenza percettiva a livello professionale.
Espressioni matematiche dettagliate per la modellizzazione del colore percettivo basata su CAM02-UCS sono fornite nel File Supplementare 1.
Algoritmo S2 (File Supplementare 1) descrive il flusso di lavoro per l'estrazione e l'ottimizzazione dei colori basato sullo spazio CAM02-UCS, vincolato da criteri di armonia e accessibilità. Inizialmente, i colori dominanti vengono estratti dall'immagine in ingresso e trasformati nello spazio CAM02-UCS per garantire che le differenze cromatiche corrispondano alla percezione umana. Successivamente, le distanze percettive tra i colori vengono calcolate e mantenute entro limiti predeterminati per assicurare chiarezza e armonia. In seguito, l'accessibilità è garantita valutando i rapporti di contrasto luminoso secondo le linee guida WCAG. La tavolozza finale è ottenuta ottimizzando una funzione obiettivo combinata che bilancia la distribuzione percettiva, i requisiti di contrasto e i vincoli di armonia cromatica. Ciò assicura che le combinazioni di colori generate per l'interfaccia utente siano non solo visivamente gradevoli, ma anche leggibili, accessibili e percettivamente coerenti.
Ottimizzazione della progettazione cognitiva
L'ottimizzazione del design cognitivo garantisce che i prototipi di interfaccia utente generati automaticamente siano non solo visivamente coerenti, ma anche facili da comprendere e utilizzare. Questo modulo integra principi fondamentali del design cognitivo, tra cui i principi della Gestalt, la legge di Fitts e la legge di Hick, per guidare la disposizione, il raggruppamento e gli spaziature dei componenti dell'interfaccia utente. Le formulazioni matematiche dettagliate relative all'ottimizzazione del design cognitivo sono fornite nel Supplementary File 1.
Obiettivo integrato di ottimizzazione cognitiva
L'espressione matematica per l'obiettivo integrato di ottimizzazione cognitiva è fornita nel File Supplementare 1. I coefficienti che rappresentano l'importanza del raggruppamento visivo, dell'efficienza dell'interazione e della complessità decisionale sono indicati rispettivamente con alfa, beta e gamma. In questo studio, i valori di alfa, beta e gamma sono stati determinati empiricamente utilizzando il dataset di validazione. Per l'esperimento in corso, i coefficienti sono stati impostati come segue: α = 0.5, β = 0.3 e γ = 0.2. Questa configurazione garantisce un equilibrio efficace tra raggruppamento visivo, efficienza dell'interazione e semplicità decisionale.
Coeerenza tra più schermate e generazione dell'interfaccia utente
La modellazione della coerenza multischermo garantisce che diversi schermi all'interno di un'applicazione condividano un'identità visiva, una struttura di layout e un modello di interazione coerenti. Mentre gli utenti navigano tra gli schermi, sviluppano aspettative riguardo al posizionamento degli elementi, al tipo di carattere, agli spazi e alla gerarchia visiva. Per soddisfare queste aspettative, il sistema analizza i modelli interschermo utilizzando modelli derivati dai dataset RICO ed ENRICO. Questi modelli catturano strutture comuni dell'interfaccia utente, come layout home–dettaglio, schemi lista–dettaglio, moduli a più passaggi e flussi di dashboard. Analizzando il posizionamento dei componenti e il comportamento di raggruppamento, il sistema costruisce un profilo strutturale interschermo che identifica quali elementi dovrebbero rimanere coerenti e quali possono variare. Una volta identificati i modelli strutturali, il framework impone coerenza nelle scale tipografiche, nei rapporti di spaziatura, nei layout a griglia e negli ancoraggi di navigazione. Ad esempio, le barre di intestazione mantengono un'altezza costante, i pulsanti principali conservano dimensioni e allineamento uniformi, e i blocchi di contenuto seguono un ordine visivo prevedibile. Questo risultato si ottiene attraverso un processo di regolarizzazione del layout che valuta ogni schermo rispetto a vincoli strutturali globali. Se uno schermo si discosta dai modelli appresi—ad esempio per padding non coerente o titoli non allineati—il sistema regola automaticamente il layout per ripristinare la coerenza. Queste correzioni contribuiscono a garantire un'esperienza utente fluida e a ridurre i costi cognitivi legati al passaggio tra schermi. Il framework analizza inoltre il grafo di navigazione tra gli schermi per mantenere la coerenza nel flusso di interazione. Vengono identificati e applicati modelli comuni di navigazione, inclusi passaggi in avanti/indietro, navigazione a schede e flussi di lavoro a più passaggi. Ogni transizione viene convalidata per assicurare l'allineamento con il modello mentale dell'utente, migliorando così l'usabilità e riducendo la confusione. Di conseguenza, il modello di coerenza multischermo riduce il rumore visivo, aumenta la familiarità e promuove un'esperienza di interazione unificata.
Formulazioni matematiche dettagliate per la coerenza tra più schermate e la generazione dell'interfaccia utente sono fornite nel File Supplementare 1.
Infine, il motore di rendering genera output visivi in formati come wireframe SVG, prototipi HTML/CSS o mockup dell'interfaccia utente basati su pixel. Le schermate dell'interfaccia utente risultanti presentano un ordine di lettura corretto, relazioni cromatiche armoniose, un allineamento preciso alla griglia e una gerarchia visiva coerente tra più schermate.
Algoritmo S3 fornisce l'ottimizzazione del layout cognitivo-visivo e il flusso di lavoro per la coerenza tra più schermi (File Supplementare 1). L'Algoritmo S3 descrive il processo integrato di ottimizzazione cognitiva e strutturale utilizzato per generare layout di interfaccia utente facili da usare. Esso combina il raggruppamento percettivo (principi della Gestalt), l'efficienza dell'interazione (legge di Fitts) e la semplicità decisionale (legge di Hick) all'interno di un framework unificato di ottimizzazione. Inizialmente, vengono valutate le relazioni spaziali tra i componenti per definire i raggruppamenti percettivi. Successivamente, l'efficienza dell'interazione viene ottimizzata modificando dimensioni e posizionamento dei componenti, mentre la complessità decisionale è controllata limitando il numero di scelte presentate all'utente. Inoltre, l'algoritmo garantisce coerenza tra più schermi allineando ciascuno schermo con modelli di layout appresi, assicurando uniformità nella tipografia, nei margini e nell'organizzazione strutturale. Una funzione di ottimizzazione multi-obiettivo perfeziona quindi il layout bilanciando allineamento, spaziatura e costo cognitivo, producendo un'interfaccia sia visivamente coerente che cognitivamente efficiente. Nel complesso, questo algoritmo assicura che i layout multischermo generati mantengano elevati livelli di coerenza visiva, usabilità e chiarezza percettiva.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Il framework proposto per la prototipazione automatica di interfacce utente è stato valutato utilizzando un dataset integrato di 5.128 schermate UI provenienti da tre fonti: 4.000 immagini RICO, 1.000 schermate ENRICO e 128 campioni di interfacce utente con annotazioni cromatiche provenienti dal Guo’s UI Color Dataset. Questo dataset combinato fornisce un benchmark ben bilanciato per valutare l'accuratezza nel rilevamento dei componenti, la chiarezza strutturale del layout, la coerenza tra più schermate e l'armonia croma...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
I risultati dimostrano miglioramenti statisticamente significativi in termini di usabilità, organizzazione strutturale e qualità percettiva (p < 0,05), confermando l'efficacia dell'integrazione dei principi cognitivi di progettazione nella prototipazione automatizzata dell'interfaccia utente. A differenza dei sistemi tradizionali di generazione dell'interfaccia utente che si basano principalmente su rilevamento visivo o euristiche basate su regole, il framework proposto integra il raggruppamento secondo la Gestalt, l...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno conflitti di interessi.
Ringraziamenti
Gli autori ringraziano il sostegno accademico e istituzionale fornito dal Wuhan College of Foreign Languages & Foreign Affairs, dall'Università Keimyung e dall'Istituto di Commercio e Lingue Straniere di Shanghai durante il completamento di questa ricerca.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| CPU (Processore) | AMD Ryzen 9 7950X (16-core, 32-thread, 4,5–5,7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | Versione 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | Versione 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | Modello di rilevamento oggetti (con rete di proposta regionale) | Meta AI Research / Detectron2 | Framework Detectron2 |
| Matplotlib | Versione 3.7 | Squadra di sviluppo Matplotlib | v3.7.0 |
| GPU NVIDIA RTX 4090 | Scheda grafica con 24 GB di memoria GDDR6X | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | Versione 1.24 | Sviluppatori NumPy | v1.24.0 |
| OpenCV | Versione 4.8 | Fondazione OpenCV | v4.8.0 |
| PyTorch | Versione 2.0 | Fondazione PyTorch (Meta AI) | v2.0.0 |
| ResNet-50 con FPN | CNN principale con rete piramidale di caratteristiche | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Versione 1.3 | Sviluppatori Scikit-learn | v1.3.0 |
| SciPy | Versione 1.10 | Comunità SciPy | v1.10.0 |
| Memoria di sistema (RAM) | 64 GB DDR5 | Corsair / Kingston (o equivalente) | Kit DDR5 da 64 GB |
| Sistema operativo Ubuntu | Versione 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
Riferimenti
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.