Questo protocollo descrive lo sviluppo e la valutazione di un chatbot di generazione aumentata basata su linee guida per il recupero e la riassunzione di contenuti provenienti da linee guida cliniche per il cancro basate sul web, generando risposte basate su riferimenti alle domande degli utenti.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Sviluppo di un chatbot di generazione aumentata basata su linee guida basate su linee guida per il recupero che fa riferimento alle linee guida cliniche per il cancro basate sul web
In questo articolo
Sommario
Abstract
La diffusa disponibilità di informazioni mediche su Internet ha migliorato l'accesso alle conoscenze relative alla salute per i pazienti; tuttavia, ha anche aumentato l'esposizione a informazioni mediche inaccurate. La cura oncologica coinvolge informazioni complesse, rendendo difficile per i pazienti identificare fonti accurate e basate su evidenze. I grandi modelli linguistici permettono l'interazione con il linguaggio naturale ma spesso generano allucinazioni, limitandone l'applicazione nella trasmissione delle informazioni mediche. La generazione aumentata al recupero (RAG) ha il potenziale di mitigare questi rischi basandosi sulle risposte su fonti di riferimento esterne. Questo studio descrive lo sviluppo e la valutazione di un chatbot RAG basato su linee guida che utilizza linee guida cliniche per il cancro disponibili pubblicamente e basate sul web. Il sistema estrae gli URL dalle pagine indice di una linea guida, elabora il testo delle pagine utilizzando analisi morfologica e similarità coseno basata sulla frequenza dei termini–frequenza inversa del documento, e costruisce informazioni di riferimento da pagine altamente rilevanti. Un grande modello linguistico utilizza questi riferimenti per generare risposte vincolate ai contenuti delle linee guida. La Guida JLCS per i Pazienti e le Famiglie di Cancro Polmonare è stata utilizzata come linea guida di riferimento. I set di domande includevano sia i tipi di cancro inclusi nella linea guida che i tipi di cancro fuori ambito per valutare il controllo della risposta. Le informazioni mediche sono state estratte con successo dalle pagine dei contenuti contabili, con il 98% degli URL estratti contenente contenuti medici di riferimento. Per le domande in-scope, il chatbot ha generato risposte riassumendo i contenuti delle linee guida e non sono state identificate allucinazioni durante la revisione manuale secondo le condizioni di test definite. Per le domande fuori ambito, il chatbot ha costantemente rifiutato di rispondere e ha indicato che le informazioni disponibili erano insufficienti. La struttura web della linea guida ha facilitato uno scraping e un'organizzazione efficienti dei contenuti di riferimento a livello URL. Questo protocollo fornisce indicazioni pratiche per costruire sistemi di intelligenza artificiale che forniscono informazioni mediche utilizzando linee guida cliniche basate sul web.
Introduzione
L'uso diffuso di internet e dei social media ha facilitato l'accesso alle informazioni medicheper i pazienti 1,2. Le informazioni sulla cura del cancro sono spesso complesse ed estese, rendendo particolarmente difficile per i pazienti identificare fonti accurate, rilevanti e basate su provescientifiche 3. Sebbene le risorse online possano aiutare la comprensione dei pazienti, contengono anche una quantità significativa di informazioni medicheerrate 3, che possono influenzare negativamente le decisioni dei pazienti riguardo alla loro cura4. Poiché la disinformazione legata al cancro può influenzare gli esiti dei pazienti5, c'è una crescente necessità di sistemi di intelligenza artificiale (IA) che possano aiutare gli utenti individuali a cercare, riassumere e interpretare le informazionimediche 6.
I grandi modelli linguistici (LLM) permettono agli utenti di accedere alle informazioni tramite conversazioni in linguaggionaturale 7; Tuttavia, la generazione di disinformazione (cioè allucinazioni) rimane una seria preoccupazione nel campomedico 8,9,10,11. Una fonte chiave di disinformazione è la qualità e l'accuratezza dei dati di addestramento utilizzati per sviluppare il chatbot. Inoltre, la natura statica dell'addestramento del modello fa sì che la conoscenza possa diventare obsoleta nel tempo, limitando la capacità degli LLM di fornire informazioni attuali e contestualmenteappropriate 12,13. Queste limitazioni evidenziano l'importanza di strategie efficaci di gestione della conoscenza per garantire che le risposte dei chatbot rimangano accurate, rilevanti e aggiornate. In particolare, sistemi che possono accedere facilmente e fare riferimento alle risorse attuali basate sull'evidenza, come le linee guida di pratica clinica, sono desiderabili in contesti medici, dove raccomandazioni e standard di cura si evolvono continuamente. Per affrontare questa sfida, la generazione aumentata al recupero (RAG), che genera risposte incorporando informazioni provenienti da fonti di conoscenza esterne, ha ricevuto un'attenzione crescente 10,13,14,15,16,17.
Sebbene il RAG sia stato applicato sempre più ai chatbot medici, è stata data poca attenzione a come le linee guida di pratica clinica dovrebbero essere sistematicamente incorporate come fonti di riferimentoinformative 18. Molte linee guida cliniche sono disponibili pubblicamente sul web; tuttavia, non è chiaro se la loro struttura web esistente possa servire direttamente come framework di recupero per i sistemiRAG 18. Inoltre, metodi pratici per costruire informazioni di riferimento senza lo sviluppo manuale di una base di conoscenza non sono stati ben consolidati.
In questo studio, abbiamo mirato a stabilire principi di progettazione per sistemi di IA con riferimento alle linee guida nel campo medico, sviluppando e valutando un chatbot RAG basato su linee guida che utilizzi linee guida cliniche oncologiche disponibili pubblicamente e basate su internet, consentendo così un accesso semplice e tempestivo alle informazioni basate su linee guida. Come prova di concetto, abbiamo valutato la fattibilità tecnica del recupero delle linee guida, della generazione della risposta e della restrizione della risposta utilizzando la struttura web esistente delle linee guida cliniche disponibili pubblicamente, con l'obiettivo di proporre un protocollo di sviluppo riproducibile per sistemi RAG con riferimento alle linee guida.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio non coinvolge soggetti umani che necessitano di protezione dai rischi legati alla ricerca. Pertanto, non richiede la revisione da parte di un comitato di revisione istituzionale secondo le linee guida etiche giapponesi per la ricerca medica che coinvolge soggettiumani 19. Questo studio è riportato in conformità con le linee guida TRIPOD-LLM per la Segnalazione Trasparente di un Modello Multivariabile per la Prognosi o Diagnosi Individuale(TRIPOD)-LLM 20.
Consulta la Figura 1 per una panoramica schematica del protocollo chatbot RAG basato su linee guida.
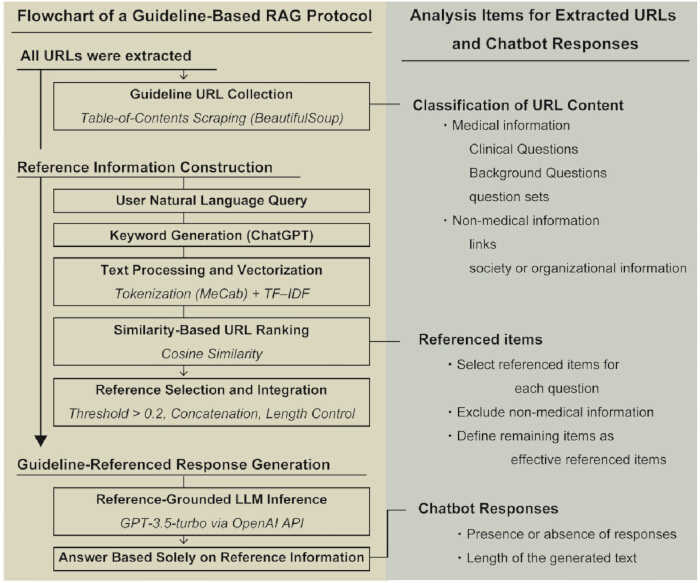
Figura 1. Workflow del protocollo chatbot RAG (Retrieval-Augmented Generation Basato su Linee Guida). Panoramica schematica del flusso di lavoro RAG dei chatbot basato su linee guida. Gli URL vengono estratti dalla pagina indice di una guida clinica online e utilizzati per costruire informazioni di riferimento. Le query degli utenti vengono convertite in parole chiave e il contenuto delle pagine web viene elaborato tramite tokenizzazione, vettoriazione frequenza dei termini e frequenza inversa del documento e analisi della similarità coseno per identificare le pagine delle linee guida rilevanti. Informazioni di riferimento selezionate vengono integrate e fornite a un grande modello linguistico per generare risposte basate esclusivamente sul contenuto della linea guida di riferimento. Il pannello a destra riassume gli elementi di valutazione utilizzati per gli URL estratti, le informazioni di riferimento e le risposte dei chatbot. Clicca qui per visualizzare una versione più grande di questa figura.
1. Preparazione delle informazioni di riferimento dalle linee guida basate sul web
- Estrai tutti gli URL dalle pagine indice delle linee guida cliniche web target utilizzando BeautifulSoup 4 (libreria di analisi sintattica HTML) implementata nel linguaggio di programmazione Python (versione 3.12).
NOTA: Implementa lo script di estrazione URL usando il linguaggio di programmazione con i seguenti pacchetti: libreria di analisi HTML (versione 4.12.3) e richieste (libreria di recupero pagina; versione 2.32.3). Installa i pacchetti usando pip. Il codice sorgente completo per l'estrazione degli URL è fornito nel Supplementary File 1. Consulta la Tabella dei Materiali per i dettagli sul software. - Rivedere manualmente tutti gli URL estratti per confermare l'accesso e la rilevanza con successo rispetto alla linea guida clinica target.
- Classifica ogni URL come contenente informazioni mediche o non mediche. Esegui la classificazione degli URL da parte di un autore (S.N.).
NOTA: Le informazioni mediche sono state definite come contenuti di riferimento delle linee guida, inclusi domande cliniche (CQ), domande di base e set di domande. Le informazioni non mediche includevano link, pagine di società o organizzazioni e altri contenuti accessori non idonei per il riferimento. - Compila gli URL validati in un workbook Microsoft Excel (formato .xlsx), con un URL registrato per riga. Memorizza la lista URL risultante come dataset di input per il recupero del testo, la preelaborazione e le analisi di similarità successive.
2. Generazione di parole chiave dalle query degli utenti
- Inserisci la query in linguaggio naturale in ChatGPT (Generative Pre-trained Transformer, versione 4o; modello di generazione di parole chiave).
- Chiede al modello di estrarre due parole chiave corrispondenti alla query dell'utente.
- Usa il seguente prompt, scritto in giapponese, per la generazione di parole chiave:
"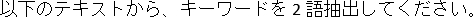 "
(Traduzione inglese: "Estrae due parole chiave dal testo seguente.") - Aggiungi la query in linguaggio naturale dell'utente a questa istruzione e inviala al modello di generazione delle parole chiave per la generazione delle parole chiave.
- Non modificare manualmente nessun parametro del modello. Eseguire la generazione di parole chiave utilizzando le impostazioni predefinite del modello di generazione delle parole chiave.
- Genera due parole chiave per ogni query dell'utente. Conservare entrambe le parole chiave senza ulteriori modifiche, filtri o selezioni manuali, e utilizzale per i calcoli successivi di somiglianza.
- Memorizza le parole chiave generate in un workbook Microsoft Excel (formato .xlsx). Per ogni record, memorizza la query utente originale e le corrispondenti parole chiave generate per il successivo recupero basato sulla somiglianza.
3. Elaborazione del testo e calcolo della similarità
- Recupera il contenuto integrale del testo da ogni URL estratto utilizzando la libreria di recupero della pagina web e la libreria di analisi sintetica HTML. Estrae il contenuto testuale dalla sorgente HTML usando la funzione BeautifulSoup get_text().
- Pre-elabora il testo estratto della pagina web e le parole chiave generate rimuovendo tag HTML e caratteri non giapponesi.
- Eseguire analisi morfologiche giapponesi usando MeCab (versione 0.996; Analizzatore morfologico giapponese) con il dizionario predefinito. Conserva solo i sostantivi e concatenali in una stringa di testo delimitata nello spazio.
- Combinare le parole chiave generate in un'unica stringa di testo e applicare le stesse procedure di pre-elaborazione e tokenizzazione utilizzate per il testo delle pagine web.
- Genera vettori frequenza dei termini–frequenza inversa del documento (TF–IDF) dal testo della pagina web elaborato e dal testo delle parole chiave utilizzando l'implementazione TfidfVectorizer nella libreria scikit-learn (versione 1.6.1) con le impostazioni dei parametri predefinite.
NOTA: Tutti i parametri del TfidfVectorizer sono stati lasciati ai valori predefiniti e non sono state applicate impostazioni personalizzate dei parametri. - Calcola la somiglianza coseno tra ciascun vettore di pagina web e il vettore parola chiave usando la funzione di somiglianza coseno.
- Classifica gli URL in ordine decrescente secondo i punteggi di similarità del coseno. Non applicare ulteriori criteri di spareggio.
- Seleziona le pagine con un punteggio di somiglianza coseno di ≥0,2 come informazioni di riferimento candidato.
NOTA: La soglia di similitudine coseno (0.2) è stata selezionata empiricamente durante lo sviluppo del sistema per dare priorità al richiamo di recupero ed evitare di escludere contenuti potenzialmente rilevanti delle linee guida. - Conservare tutte le pagine candidata che soddisfano la soglia di somiglianza.
4. Costruzione delle informazioni di riferimento
- Estrai sequenzialmente il contenuto testuale delle pagine selezionate dalla parte superiore della lista classificata.
- Concatenare i testi estratti per formare un unico documento di riferimento.
- Prima di inviarli al LLM, sostituire i caratteri di nuova linea e i caratteri spazi bianchi consecutivi nel testo di riferimento con uno spazio singolo.
- Tronca il testo di riferimento concatenato ai primi 4.096 caratteri prima di fornirlo al LLM.
NOTA: Il limite di troncamento si basava sui caratteri piuttosto che sui token. È stato selezionato empiricamente un limite di 4.096 caratteri per garantire che le informazioni combinate di prompt e riferimento rimanessero entro la capacità di input del modello di generazione di risposta GPT-3.5-turbo-16k.
5. Generazione di risposte basate sull'IA
- Fornire le informazioni di riferimento costruite e la query utente originale al modello di generazione di risposta tramite l'interfaccia di programmazione applicativa (API).
- Istruire l'IA utilizzando il seguente prompt (scritto interamente in giapponese) per assicurarsi che le risposte vengano generate esclusivamente sulle informazioni di riferimento fornite:
"Sei un'assistente alle informazioni mediche che fornisce indicazioni ai pazienti oncologici. Genera risposte basandoti esclusivamente sulle seguenti informazioni di riferimento e non utilizzare le tue conoscenze o ragionamenti generali. Le risposte dovrebbero essere dettagliate e facili da comprendere, di circa 500 caratteri. Se le informazioni di riferimento non contengono informazioni sufficienti per rispondere alla domanda, rispondi con: 'Non ci sono informazioni sufficienti nel testo', senza usare alcuna speculazione o conoscenza generale." - Fornire le informazioni di riferimento e la query dell'utente insieme all'interno di un unico messaggio utente. Struttura l'input come: "Informazioni di riferimento: [testo di riferimento]" seguito da "Domanda: [query utente]".
- Genera risposte utilizzando il modello di generazione di risposta con le seguenti impostazioni: temperatura = 0,1, lunghezza massima di uscita = 1.024 token, n = 1, e stop = Nessuno.
- Ottieni la risposta generata dall'IA per una valutazione successiva.
NOTA: Invia le informazioni di riferimento e la query dell'utente come un unico messaggio utente. Fornire le istruzioni di generazione delle risposte separatamente come messaggio di sistema.
6. Linee guida di riferimento e formulazione delle domande
- Seleziona la Guida JLCS per i Pazienti e le Famiglie con Cancro Polmonare (Lung Guidebook)21, che è disponibile gratuitamente online, come informazione di riferimento per il sistema chatbot RAG basato su linee guida.
- Crea due categorie di domande di valutazione basate sul tipo di tumore: tumori timici, che rientrano nell'ambito della linea guida, e glioma pediatrico, che è al di fuori dell'ambito delle informazioni di riferimento.
- Formula quattro domande che coprono la diagnosi e il trattamento per ogni tipo di cancro:
"Quali metodi diagnostici sono disponibili per tumori XX (ad esempio, il glioma timico o pediatrico)?
"Quali sono gli approcci diagnostici patologici per i tumori XX?"
"Quali opzioni di trattamento sono disponibili per i tumori XX?"
"Quali sono le opzioni di trattamento chirurgico per i tumori XX?" - Invia domande relative ai tipi di cancro coperti dalla linea guida web indicata al chatbot. Ad esempio, invia una domanda riguardante la diagnosi del tumore timico utilizzando la Lung Guide come informazione di riferimento.
- Invia domande al di fuori della linea guida di riferimento al chatbot per valutarne la capacità di astenersi dall'uso di informazioni esterne o non correlate. Ad esempio, invia una domanda riguardante il glioma pediatrico utilizzando la Lung Guide come informazione di riferimento.
- Valuta ogni domanda in una sessione di chat indipendente. Non trasferire la cronologia delle conversazioni tra una domanda e l'altra.
- Registra le risposte generate dall'IA per una valutazione successiva.
7. Valutazione della risposta
- Effettua una revisione manuale di tutte le risposte generate.
- Valuta se ogni risposta contiene allucinazioni.
- Valuta se ogni risposta è supportata dalle informazioni contenute nella linea guida di riferimento.
NOTA: Le allucinazioni sono state definite come risposte contenenti eventi, nomi o termini inesistenti che potrebbero potenzialmente causare dannimedici 14. Tutte le risposte generate sono state esaminate per accuratezza e assenza di allucinazioni da un autore con 8 anni di esperienza in un ospedale universitario, inclusi il supporto al paziente e la comunicazione medica per pazienti con cancro. Qualsiasi incertezza riguardo alla classificazione della risposta è stata risolta attraverso una discussione con un medico coautore con oltre 20 anni di esperienza nei servizi di informazione sul cancro presso il National Cancer Center Japan. - Considera una risposta supportata solo quando tutte le affermazioni clinicamente rilevanti possono essere confermate direttamente dalla linea guida di riferimento recuperata senza richiedere conoscenze aggiuntive o inferenze non supportate.
- Classifica ogni risposta usando etichette di risultato predefinite. Classifica le risposte contenenti solo informazioni supportate dalla linea guida di riferimento come "allucinazione assente." Classifica le risposte contenenti informazioni non supportate o fabbricate come "allucinazioni presenti".
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Recuperabilità dei contenuti medici tramite pagine di indice
L'architettura web-scraping raccoglieva gli URL dalla pagina indice della linea guida. Dalla Lung Guidebook, sono stati estratti 106 URL dalla pagina indice, di cui 104 (98%) contenevano informazioni mediche (Tabella Supplementare 1). L'efficacia delle risposte dei chatbot basate sulle pagine di contenuto delle linee guida è riassunta nella Tabella 1...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
In questo studio, abbiamo esaminato l'utilità di un chatbot RAG basato su linee guida che utilizzava una guida clinica web—il JLCS Guidebook for Lung Cancer Patients and Families—come fonte di riferimento informativa. Il chatbot generava risposte basate sui contenuti delle linee guida sfruttando la struttura web della linea guida e recuperando pagine in base alla loro somiglianza con le domande degli utenti. Questo approccio ha dimostrato che il recupero basato sulla similarità, combinat...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi in conflitto.
Ringraziamenti
Gli autori ringraziano Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), per il suo ampio supporto tecnico nello sviluppo del chatbot di generazione potenziata basata su linee guida. Gli autori ringraziano inoltre Chikako Yamaki, PhD, e tutti i membri del team di ricerca presso l'Institute for Cancer Control, National Cancer Center Japan (Tokyo, Giappone), per aver fornito preziosi consigli sull'argomento trattato in questo articolo. Inoltre, gli autori ringraziano Editage per la modifica in lingua inglese. Questo lavoro è stato supportato da una sovvenzione di ricerca per le scienze della salute e del lavoro (R6–Cancer Control–23EA1026).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
```html
```
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Beautiful Soup 4 (version 4.12.3) | Beautiful Soup Project | N/A | Libreria Python utilizzata per l'estrazione di URL e l'analisi HTML |
| ChatGPT versione 4o | OpenAI | N/A | Usato per la generazione di parole chiave |
| GPT-3.5-turbo | OpenAI | N/A | Usato per la generazione di risposte |
| Guida JLCS per pazienti affetti da cancro del polmone e famiglie | Japan Lung Cancer Society | N/A | Linea guida clinica basata sul web utilizzata come informazione di riferimento |
| MeCab (versione 0.996) | MeCab Project | N/A | Analizzatore morfologico giapponese |
| API di OpenAI | OpenAI | N/A | Usato per la generazione di risposte basate sull'intelligenza artificiale |
| Python (versione 3.12) | Python Software Foundation | N/A | Ambiente di programmazione |
| Requests (versione 2.32.3) | Requests Project | N/A | Libreria Python utilizzata per il recupero di pagine web |
| scikit-learn (versione 1.6.1) | Sviluppatori scikit-learn | N/A | Usato per la vettorizzazione TF–IDF e il calcolo della similarità del coseno. |
| urllib.parse | Python Software Foundation | N/A | Libreria Python utilizzata per la normalizzazione e l'unione di URL |
Riferimenti
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.