Lo studio propone un framework end-to-end per l'analisi multimodale delle emozioni che sfrutta codificatori transformer, rappresentazioni delle emozioni disincagliate e un'attenzione intermodale basata su grafi con mappatura visiva, al fine di migliorare l'accuratezza del riconoscimento delle emozioni su due dataset.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Mappatura visiva delle caratteristiche emotive multimodali per la progettazione di interazioni intelligenti
In questo articolo
Sommario
Abstract
Rendendo possibile alle macchine comprendere, interpretare e reagire agli stati affettivi umani, la mappatura visiva dei tratti emozionali multimodali risulta fondamentale per la progettazione di interfacce intelligenti. Tuttavia, gli attuali algoritmi di rilevamento delle emozioni multimodali si concentrano principalmente sulle prestazioni predittive, offrendo scarse informazioni riguardo all'interpretabilità, alla consapevolezza delle interazioni o alle interazioni incrociate tra modalità a livello di caratteristiche. Questo studio introduce un framework per la mappatura visiva degli aspetti emotivi multimodali che combina visualizzazione orientata all'interazione, apprendimento interpretabile di rappresentazioni e previsione delle emozioni. Senza ricorrere a caratteristiche create manualmente, encoder basati su trasformatori sono stati utilizzati per estrarre embedding emotivi ad alto livello dalle modalità testuale, audio e visiva. Per migliorare la robustezza, le informazioni specifiche per l'emozione e quelle specifiche per la modalità sono state separate mediante una tecnica di apprendimento di rappresentazioni disinnescate. Inoltre, è stata sviluppata una rete grafica di attenzione multimodale per simulare, attraverso un pesatura adattiva dell'attenzione, le relazioni emotive sottili tra le diverse modalità. È stato creato un modulo di mappatura visiva multivista per rappresentare traiettorie temporali delle emozioni, distribuzioni di attenzione incrociata tra modalità e embedding latenti delle emozioni, al fine di aumentare la trasparenza. Il framework proposto è stato valutato utilizzando il dataset Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) e il Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS). I risultati sperimentali indicano che il framework proposto offre una maggiore interpretabilità a livello di caratteristiche e una visualizzazione consapevole delle interazioni, superando costantemente le tecniche di riferimento rappresentative in termini di accuratezza, F1-score, correlazione ed errore assoluto medio. Inoltre, il modulo di mappatura visiva ha facilitato l'interpretazione qualitativa delle rappresentazioni emotive multimodali, delle interazioni incrociate tra modalità e della dinamica temporale delle emozioni, sostenendo la visualizzazione e l'analisi consapevole dell'interazione.
Introduzione
La capacità di identificare correttamente e comprendere il sentimento umano è diventata fondamentale per migliorare l'interazione tra esseri umani e macchine. Oltre a essere essenziale per migliorare l'interazione uomo-computer, l'analisi delle emozioni ha il potenziale di rivoluzionare diversi settori, tra cui la diagnosi medica pre-diagnostica1, l'analisi del comportamento in ambito scolastico2, il monitoraggio psicologico dei pazienti3, l'identificazione della fatica nei veicoli4 e la gestione intelligente negli ambienti domestici intelligenti5. I recenti sviluppi nel campo del computing affettivo e dell'apprendimento profondo6 hanno accresciuto l'interesse verso la creazione di sistemi in tempo reale in grado di cogliere la complessità delle emozioni umane.
Molti metodi attuali si basano principalmente su dati unimodali, come segni testuali, grafici o auditivi7,8,9. Questi approcci non riescono ripetutamente a rilevare segnali raffinati come l'ironia o le sfumature specifiche del contesto. La ricerca si è spostata verso una valutazione multimodale delle emozioni, che integra dati complementari provenienti da più fonti per superare tali limitazioni10,11,12I vantaggi della fusione di più modalità sono stati dimostrati da modelli di base come l'early fusion-long short-term memory (EF-LSTM)13 e le reti neurali profonde leggere e FM (LF-DNN)14, reti di fusione tensoriale (TFN) e approcci di fusione multimodale a rango ridotto. Tuttavia, la maggior parte di questi approcci si basa sulla generazione offline di caratteristiche e non è adatta a situazioni dinamiche e reali.
Per tenere conto degli stati emotivi, negli ultimi dieci anni la ricerca e le applicazioni nel campo dell'identificazione multimodale delle emozioni sono notevolmente cresciute15. Uno degli ambiti di ricerca più complessi e significativi al giorno d'oggi è il monitoraggio continuo degli stati emotivi mediante l'utilizzo di diverse fonti di dati16. L'idea di multimodalità è emersa in modo del tutto naturale con lo sviluppo di un sistema così variegato di conoscenze, portando a numerosi progressi nell'applicazione delle emozioni in settori come il calcolo emotivo, l'interazione uomo-macchina (HCI), l'apprendimento, i videogiochi, il servizio al consumatore, l'assistenza medica, la valutazione dell'esperienza utente (UX), ecc. Tuttavia, non è sempre stato semplice applicare le tecniche di riconoscimento delle emozioni nella valutazione dell'esperienza utente.
Uno dei motivi principali per cui è preferibile concentrarsi sul riconoscimento multimodale piuttosto che sui metodi unimodali risiede negli svantaggi intrinseci del dipendere da un'unica fonte informativa. I sistemi di rilevamento delle emozioni unimodali possono presentare un'accuratezza inferiore a causa di dati mancanti o poco chiari, mentre gli schemi di riconoscimento multimodale (MER) risultano più affidabili e offrono una comprensione più completa e articolata degli stati espressivi integrando più fonti di dati17. Ad esempio, il linguaggio facciale da solo potrebbe non essere sufficiente per classificare con precisione le emozioni, specialmente quando i gesti sono complessi o ambigui. Tuttavia, combinando le espressioni facciali con altre forme di comunicazione, come il linguaggio verbale o i segnali fisici, è possibile aumentare l'accuratezza nel riconoscimento delle emozioni.
Sono state condotte numerose ricerche sul riconoscimento delle emozioni in diverse modalità. Gli studi iniziali si sono concentrati sull'identificazione di caratteristiche distintive provenienti da modalità differenti, come input grafici, acustici o basati su testo. Tuttavia, sta diventando sempre più evidente che l'integrazione di diverse modalità può fornire informazioni emotive bilanciate, portando a un rilevamento del sentiment più affidabile e preciso. Questo segmento esamina i principali progressi nell'analisi emotiva unimodale e multimodale, concentrandosi sugli approcci di base, sui loro limiti e sulla giustificazione del nostro metodo.
Lo studio iniziale sul riconoscimento delle emozioni si è concentrato principalmente su una singola modalità. Nell'ambito visivo, ricerche pionieristiche hanno portato alla categorizzazione dei movimenti facciali prototipici20. Successivi progressi hanno incluso tecniche per catturare la dinamica temporale, come il movimento visivo21 e i modelli markoviani nascosti22, mentre le risposte facciali sono state suddivise in unità d'azione mediante il Facial Action Coding System (FACS)23. Le reti neurali ricorrenti a lunga memoria a breve termine (LSTM) e le reti neurali convoluzionali (CNN) sono state utilizzate con successo per estrarre caratteristiche significative direttamente da segnali audio grezzi; le metodologie per l'identificazione delle emozioni basate sull'audio sono evolute dal tradizionale processamento del segnale all'apprendimento profondo24. L'estrazione di segnali di sentimento contestuale nell'analisi delle emozioni basata sul testo è stata notevolmente potenziata da reti neurali ricorrenti (RNN) dotate di meccanismi di attenzione e, più recentemente, da modelli basati su trasformatori. Nonostante i loro risultati, le tecniche unimodali sono intrinsecamente incapaci di rappresentare con precisione le complessità vissute dalle persone, poiché mancano delle informazioni supplementari presenti in altre modalità.
Alcuni modelli basati su meccanismi di attenzione, come il modello DialogXL25, sono stati proposti nel 2021 per raccogliere dati ambientali a lungo termine nel campo dell'identificazione del sentiment nelle conversazioni. Kim et al.26 hanno introdotto il modello EmoBERTa nel 2021 per aumentare l'accuratezza dell'ERC. Questo modello utilizza dati relativi ai parlanti per migliorare le caratteristiche dei parlanti nelle conversazioni e le loro interazioni reciproche. Nel 2022, Li et al.27 ha presentato il metodo CoG-BART. L'organizzazione utilizza un apprendimento contrastivo supervisionato per migliorare la capacità del modello di interpretare dati rilevanti. Va notato che l'apprendimento supervisionato richiede una quantità sostanziale di dati etichettati.
Un esempio tipico di tali lavori è il framework Multimodal Interaction-Aware Representation (MIAR)28, che utilizza token di interazione delle caratteristiche e allineamento contrastivo per migliorare la generalizzazione tra le diverse modalità. MIAR migliora l'allineamento delle modalità e raggiunge prestazioni elevate su più dataset; tuttavia, si concentra principalmente sull'accuratezza predittiva senza affrontare il mapping visivo. Analogamente, il modello di fusione audio-visiva con attenzione incrociata29 cattura efficacemente interazioni audio-visive finemente dettagliate per la previsione di valenza ed eccitamento, ma è limitato a due sole modalità e non dispone di capacità di visualizzazione. Gli approcci di modellazione temporale basati su reti LSTM e fusione con autoencoder riescono a catturare con successo la dinamica temporale delle emozioni, ma offrono informazioni limitate sulle interazioni tra modalità e sulle rappresentazioni emotive apprese. Più di recente, metodi basati su trasformatori come la Transformer-based Multimodal Fusion Network (TMFN)30 hanno dimostrato ottime prestazioni su CMU-MOSI e CMU-MOSEI grazie a una fusione multimodale avanzata e all'apprendimento contrastivo. Tuttavia, questi approcci rimangono principalmente orientati alle prestazioni e offrono un supporto limitato per la spiegabilità, l'interpretazione a livello di caratteristiche e la visualizzazione orientata alle interazioni.
Per migliorare l'integrazione di dati testuali, acustici e visivi, sono state proposte diverse tecniche di riconoscimento delle emozioni multimodali. Sebbene non siano riuscite a catturare interazioni intricate tra i diversi modi, tecniche di fusione precoce come EF-LSTM e LF-DNN hanno dimostrato i vantaggi dell'uso di informazioni multimodali per l'analisi del sentiment e delle emozioni. Sebbene il TFN abbia migliorato le prestazioni su dataset di riferimento come CMU-MOSI e CMU-MOSEI e abbia introdotto una modellizzazione esplicita delle interazioni inter-modali, la sua limitata interpretabilità e la complessità computazionale elevata ne hanno ostacolato l'utilità. Per migliorare l'allineamento modale e la fusione dinamica delle caratteristiche, tecniche più recenti come MIAR, modelli di fusione con attenzione incrociata, TMFN e trasformatori multimodali adattivi hanno utilizzato topologie basate sui trasformatori e meccanismi di attenzione. Questi metodi si sono concentrati principalmente sulle prestazioni predittive, offrendo poche informazioni sulle rappresentazioni emotive a livello di caratteristiche e sulle dipendenze inter-modali, nonostante abbiano ottenuto risultati competitivi su metriche di valutazione comuni come accuratezza, F1-score ed errore assoluto medio. Inoltre, pochi studi hanno sviluppato tecniche di visualizzazione in grado di rivelare embedding latenti delle emozioni, distribuzioni dell'attenzione e dinamiche temporali delle emozioni, oppure hanno integrato modellizzazioni basate su grafi per le interazioni inter-modali. L'approccio proposto integra mappatura visiva multi-vista, fusione con attenzione inter-modale basata su grafi e apprendimento di rappresentazioni disaccoppiate per superare questi limiti e migliorare le prestazioni nel riconoscimento delle emozioni multimodali.
Allo stesso modo, l'Adaptive Multimodal Transformer32 propone una fusione basata sullo scambio per attenuare in modo adattivo informazioni modali rumorose o mancanti, migliorando così le prestazioni nella classificazione del sentiment. Sebbene questo approccio possa affrontare efficacemente le discrepanze nella distribuzione delle informazioni modali, la sua progettazione è specifica per l'analisi del sentiment e fornisce informazioni limitate sulle rappresentazioni emotive apprese. Un altro contributo significativo è il Multimodal Fusion Model33, che integra CNN, LSTM moltiplicativi e meccanismi di attenzione basati su transformer per il riconoscimento multimodale delle emozioni in tempo reale. Il modello esegue una fusione completa delle modalità video, audio e testo e mostra prestazioni robuste nella riconoscibilità. Tuttavia, come altri modelli esistenti, si concentra principalmente sull'accuratezza predittiva e presenta caratteristiche esplicite limitate per la visualizzazione e l'interpretabilità orientata all'interazione.
In conclusione, sebbene gli attuali approcci all'avanguardia per il riconoscimento multimodale delle emozioni abbiano ottenuto notevoli successi nel catturare le interazioni cross-modalità e nel migliorare l'accuratezza delle previsioni, la maggior parte di essi si concentra su compiti guidati dal riconoscimento. Aree come l'interpretabilità a livello di caratteristiche, la visualizzazione delle rappresentazioni emotive nello spazio dell'immagine e l'integrazione del framework proposto per la progettazione di interazioni intelligenti hanno ricevuto poca attenzione. È proprio tenendo presenti queste sfide che viene introdotto il framework proposto.
La maggior parte dei metodi attuali si concentra principalmente sul miglioramento delle prestazioni predittive, offrendo tuttavia scarsa interpretabilità delle rappresentazioni emotive apprese e delle interazioni cross-modali, nonostante i notevoli progressi nel riconoscimento multimodale delle emozioni28,29. Le interazioni complesse tra le modalità testuale, acustica e visiva risultano spesso difficili da modellare per le attuali strategie di fusione, specialmente in presenza di discrepanze tra le modalità e carenze informative 28,31. Sebbene le architetture basate sui transformer e i meccanismi di attenzione abbiano migliorato l'apprendimento delle rappresentazioni, la loro trasparenza e interpretabilità risultano spesso ridotte dall'assenza di una separazione esplicita tra informazioni specifiche dell'emozione e informazioni specifiche della modalità31,32,33. Inoltre, solo un numero limitato di studi ha esplorato la modellazione basata su grafi delle interazioni intermodali o sviluppato framework di visualizzazione in grado di rivelare la dinamica temporale delle emozioni, le distribuzioni dell'attenzione e gli embedding emotivi. Questi limiti evidenziano la necessità di un framework multimodale interpretabile per l'interazione intelligente uomo-macchina, che unisca un mappatura visiva orientata all'interazione con un apprendimento cross-modale robusto.
Questo lavoro presenta un framework interpretabile per la mappatura visiva di aspetti emotivi multimodali nella progettazione di interfacce intelligenti. Senza la necessità di caratteristiche create manualmente, il sistema utilizza un apprendimento profondo end-to-end per estrarre rappresentazioni emotive di alto livello da modalità testuale, audio e visiva. Le interazioni emotive cross-modalità sono modellate mediante un meccanismo di fusione basato sull'attenzione grafica che separa informazioni specifiche dell'emozione e informazioni specifiche della modalità, consentendo un apprendimento di rappresentazioni disgiunte e migliorando l'interpretabilità e la robustezza. Inoltre, viene creato un modulo di visualizzazione multivista per mostrare la dinamica temporale delle emozioni, i pattern di attenzione cross-modali e gli embedding emotivi. L'efficacia e l'idoneità del framework proposto nei sistemi di interazione uomo-macchina intelligenti viene valutata attraverso la validazione su dataset di riferimento per il riconoscimento emotivo multimodale.
Questo studio propone un framework innovativo per la mappatura visiva degli aspetti multimodali delle emozioni, superando gli approcci tradizionali orientati alla previsione e affrontando le limitazioni legate alla scarsa modellizzazione delle interazioni cross-modali e all’interpretabilità ridotta nei sistemi attuali di riconoscimento delle emozioni multimodali. All’interno di un’unica architettura, l’approccio proposto integra l’apprendimento della rappresentazione multimodale basato su transformer, la modellizzazione di caratteristiche disincagliate sensibili alle emozioni, la fusione dell’attenzione cross-modale basata su grafi e una visualizzazione orientata alle interazioni. A differenza degli approcci attuali, focalizzati principalmente sulle prestazioni di classificazione, il framework separa chiaramente le rappresentazioni specifiche dell’emozione da quelle specifiche della modalità, migliorando così interpretabilità, robustezza e coerenza cross-modale. Inoltre, viene introdotto un meccanismo di attenzione basato su grafi per consentire una modellizzazione adattativa delle interazioni inter-modali, catturando le interdipendenze emotive finemente dettagliate tra le modalità testuale, audio e visiva. Viene sviluppato un modulo di mappatura visiva multivista per aumentare la trasparenza, rivelando traiettorie temporali delle emozioni, schemi di attenzione cross-modale e incorporamenti latenti delle emozioni, fornendo così informazioni intuitive sul processo decisionale del modello. Oltre a offrire una visualizzazione e un’interpretabilità migliorate della dinamica emotiva multimodale, la valutazione sperimentale sui dataset di riferimento CH-SIMS e CMU-MOSEI ha mostrato prestazioni competitive in termini di accuratezza, punteggio F1, errore assoluto medio e correlazione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Il lavoro proposto mira a migliorare la progettazione dell'interazione intelligente offrendo un framework interpretabile per la mappatura visiva delle caratteristiche emotive multimodali. I database CH-SIMS e CMU-MOSEI, accessibili al pubblico, sono stati utilizzati in questo lavoro. Entrambi i dataset sono stati ottenuti dalle loro fonti ufficiali e impiegati nel rispetto delle linee guida d'uso, degli standard di ricerca e dei termini di licenza stabiliti dai rispettivi creatori. Il contenuto multimodale dei dataset, comprensivo di dati testuali, audio e video, è stato inizialmente raccolto e annotato dai fornitori dei dataset secondo le autorizzazioni rilasciate dai partecipanti e i protocolli di raccolta dati. Non è stata prevista alcuna interazione diretta con esseri umani, né il reclutamento di nuovi partecipanti, né la raccolta di informazioni personalmente identificabili in questo studio. Tutte le analisi sono state condotte utilizzando dataset di ricerca pubblicamente disponibili. Di conseguenza, la nostra analisi secondaria dei dati non ha richiesto ulteriore approvazione etica né revisione da parte di un comitato etico istituzionale (IRB). Lo studio è stato condotto nel rispetto delle norme istituzionali appropriate che regolano l'uso di dataset pubblicamente disponibili, le procedure di ricerca etica e le politiche applicabili in materia di utilizzo dei dati.
È stato impiegato un meccanismo di attenzione cross-modale basato su grafi per apprendere caratterizzazioni emotive tra diverse modalità, utilizzando caratteristiche specifiche per l'emozione o per la modalità al fine di migliorare la comprensione. Un componente di mappatura visiva multivista viene utilizzato per potenziare la progettazione interattiva in tempo reale sensibile alle emozioni, e la sua efficienza viene stimata per il riconoscimento delle emozioni. I risultati mostrano che il metodo proposto migliora sia l'interpretabilità che l'efficienza delle interfacce utente intelligenti sensibili alle emozioni nel mondo reale. Figura 1 mostra il flusso architetturale del lavoro proposto. Figura 1 illustra l'intero flusso di lavoro del framework di mappatura visiva suggerito per l'apprendimento delle caratteristiche emotive multimodali nel contesto dei sistemi di interazione intelligente. Il flusso inizia con tre modalità di ingresso sincronizzate, ovvero testo, audio e video, che acquisiscono informazioni emotive complementari rispettivamente dalle modalità linguistica, prosodica ed espressione facciale. Un codificatore transformer specifico per ciascuna modalità elabora ogni modalità per ottenere rappresentazioni ad alto livello dei dati grezzi in ingresso. Le rappresentazioni vengono quindi inviate a un modulo di apprendimento delle rappresentazioni disinnescate, in cui gli embedding specifici per l'emozione vengono separati dalle caratteristiche specifiche della modalità, garantendo coerenza nelle emozioni apprese provenienti da fonti di dati eterogenee. Gli embedding specifici per l'emozione di ciascuna modalità vengono quindi aggregati da una rete di attenzione cross-modale basata su grafi, che modella le dipendenze emotive inter-modalità e assegna pesi dinamici di importanza a ciascuna modalità in base al contesto d'interazione. Infine, il framework fornisce sia output di classificazione emotiva sia informazioni sull'interazione, facilitando decisioni trasparenti sensibili alle emozioni e una progettazione adattiva dell'interazione intelligente.
Acquisizione di dati multimodali
I dataset CH-SIMS e CMU-MOSEI sono due dataset multimodali esistenti di pubblico dominio che hanno raccolto informazioni multimodali, come video, audio e testo sincronizzati. Il dataset CH-SIMS comprende esami multimodali di persone di lingua cinese, inclusi 2.281 segmenti video, derivati da numerosi segmenti tratti da film, serie televisive e programmi di varietà. L'aggiunta di audio e testo corrispondenti a questi segmenti video rende gli studi sull'analisi multimodale delle emozioni più interessanti e fattibili. Tuttavia, uno dei più grandi dataset multimodali per l'esame di opinioni, sentimenti ed emozioni è il dataset CMU-MOSEI, raccolto da oltre 23.000 clip video di frasi pronunciate da più di 1.000 oratori su una varietà di argomenti. Il dataset è stato suddiviso casualmente in sottoinsiemi di training (70%), validazione (15%) e test (15%), mantenendo invariata la distribuzione delle classi.
Trascrizioni testuali, segnali audio e fotogrammi video vengono acquisiti e allineati temporalmente in modo da corrispondere a un livello temporale fine. L'integrazione a livello di fotogramma garantisce che i meccanismi proposti di apprendimento della rappresentazione e di fusione basata su grafi possano modellare e sfruttare congiuntamente il contenuto emotivo derivante da espressioni visive, toni vocali e contenuti linguistici. L'estrazione efficace delle dinamiche emotive intermodali è resa possibile da questa tipologia di tecnica di acquisizione multimodale, fondamentale per la progettazione di interazioni intelligenti e per una mappatura visiva comprensibile.
Tabella 1 presenta le strutture principali dei dataset multimodali sulle emozioni utilizzati nel metodo proposto. Per ottenere un ampio spettro di sentimenti correlati, come parole parlate, intonazioni vocali ed espressioni facciali, CH-SIMS e CMU-MOSEI integrano modalità video, audio e testo provenienti da questi dataset. Inoltre, il numero di campioni disponibili in CH-SIMS è limitato, consentendo un'analisi approfondita delle interazioni tra le modalità e delle variazioni emotive in ambito cinese. D'altra parte, il dataset CMU-MOSEI riveste un'importanza maggiore per la valutazione della robustezza degli algoritmi di apprendimento delle rappresentazioni e della visualizzazione qui trattati, poiché comprende una grande quantità di dati in diverse lingue, soggetti e livelli emotivi annotati. Inoltre, rispetto alle ricerche precedenti, riduce le difficoltà nella selezione delle informazioni durante i test dei modelli.
Preelaborazione e sincronizzazione multimodale
Le annotazioni temporali dei dataset CH-SIMS e CMU-MOSEI sono state utilizzate per sincronizzare le modalità testuale, uditiva e visiva, garantendo un apprendimento coerente della rappresentazione multimodale. Ogni enunciato fungeva da unità fondamentale di analisi ed era associato a segmenti audio e video corrispondenti all'interno dello stesso intervallo temporale. L'allineamento è stato effettuato a livello di enunciato. La trascrizione è stata suddivisa in segmenti in base ai timestamp di inizio e fine di ciascun enunciato. La corrispondenza tra trascrizione, audio e video è stata stabilita estraendo i fotogrammi video e i segnali audio corrispondenti che rientravano nello stesso intervallo temporale. Mentre i segmenti audio sono stati elaborati utilizzando Wav2Vec 2.0 per produrre rappresentazioni acustiche, i fotogrammi visivi del segmento video sono stati campionati a una frequenza predeterminata e codificati utilizzando il Vision Transformer (ViT). L'encoder RoBERTa è stato utilizzato per creare embedding testuali a partire dalle trascrizioni degli enunciati. La sincronizzazione temporale è stata ottenuta allineando tutte le caratteristiche delle modalità a un singolo confine dell'enunciato, poiché le tre modalità producevano sequenze di caratteristiche di lunghezza variabile. È stato utilizzato un formato di lunghezza fissa per normalizzare le sequenze di lunghezza variabile. Le sequenze più lunghe sono state accorciate alla lunghezza massima consentita, mentre quelle più brevi sono state completate con zeri. Durante l'addestramento, sono state utilizzate maschere di attenzione per separare gli elementi aggiunti tramite padding dalle posizioni legittime delle caratteristiche. Gli embedding specifici per ciascuna modalità sono stati proiettati in uno spazio latente comune prima della fusione, al fine di superare le diverse lunghezze delle sequenze tra le modalità. Ciò ha garantito coerenza dimensionale e ha permesso al meccanismo di attenzione basato su grafi di facilitare un efficace apprendimento dell'interazione cross-modale. Per preservare la qualità dei dati e l'integrità della sincronizzazione, sono stati esclusi dagli studi i campioni con file corrotti, annotazioni mancanti o informazioni incomplete sulle modalità.
Estrazione di caratteristiche basata su Transformer
Un metodo di apprendimento profondo viene utilizzato per apprendere rappresentazioni di caratteristiche di alto livello consapevoli delle emozioni a partire da informazioni provenienti da più modalità, come visione, audio e testo, in modo end-to-end, dopo l'allineamento dei dati multimodali e ogni preelaborazione necessaria. Utilizzando un codificatore transformer per apprendere rappresentazioni di caratteristiche intrinsecamente discriminative a partire da dati multimodali grezzi, il metodo proposto elimina la necessità di ingegnerizzazione delle caratteristiche. Per favorire la coerenza tra i diversi dataset utilizzati nell'approccio proposto, viene appresa un'incorporazione (embedding) di dimensione fissa per ciascuna modalità. Ad esempio, vengono apprese incorporazioni di caratteristiche di 768 dimensioni per ciascuna delle singole modalità, inclusa l'immagine, l'audio e il testo, formando collettivamente uno spazio unificato di caratteristiche utilizzato in tutto l'approccio, in particolare un approccio di estrazione delle caratteristiche applicato al dataset CH-SIMS proposto e al dataset CMU-MOSEI per apprendere caratteristiche di alto livello da dati di dimensioni variabili.
Modalità visiva: Vision transformer per incorporamenti di frame consapevoli delle emozioni
È stato utilizzato un modello Vision Transformer (ViT-Base) per estrarre informazioni visive dai fotogrammi video al fine di ottenere rappresentazioni spaziali rilevanti per le emozioni. Prima dell'estrazione delle caratteristiche, i fotogrammi di ciascun segmento video sono stati ridimensionati a (224 × 224) pixel e campionati a intervalli temporali regolari. Utilizzando una dimensione di patch di 16 × 16 pixel, l'architettura ViT-Base produce una serie di token visivi che vengono elaborati da 12 strati encoder transformer. Le rappresentazioni a livello di fotogramma recuperate sono state proiettate in uno spazio di embedding a 768 dimensioni mediante un modello ViT preaddestrato utilizzato come backbone visivo. Gli embedding a livello di fotogramma sono stati aggregati mediante media pooling per creare la rappresentazione visiva finale per ciascun segmento. Durante l'addestramento, sono state applicate normalizzazione delle immagini e comuni tecniche di aumento, come il ritaglio casuale e il ribaltamento orizzontale, per migliorare la capacità di generalizzazione. Successivamente, il framework proposto di fusione multimodale è stato utilizzato per combinare questi embedding visivi con rappresentazioni testuali e uditive.
Per mantenere la dinamica temporale delle emozioni, i campioni video dei dataset CH-SIMS e CMU-MOSEI verranno sottoposti a campionamento uniforme per la modalità visiva. I fotogrammi di ciascun video, 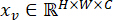 , possono essere suddivisi in N sezioni di dimensione fissa, che vengono quindi appiattite e trasformate inversamente in uno spazio di incorporamento latente con dimensione
 . Viene creata una serie aggiungendo incorporamenti posizionali e un token di raggruppamento addestrabile:
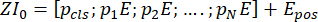 (1)
dove  rappresenta la codifica posizionale e
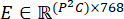 è la matrice di incorporamento delle porzioni.
Vengono utilizzati strati di encoder transformer impilati, composti da reti feed-forward e da auto-attenzione multi-testa, per elaborare la sequenza di patch incorporata. La trasformazione allo strato l è descritta come:
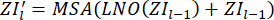 (2)
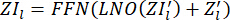 (3)
Per ottenere il vettore di caratteristiche visive consapevole delle emozioni, l'output equivalente al token di classe viene estratto come vettore di caratteristiche  . Per affrontare rappresentazioni visive delle emozioni coerenti nonostante le differenze linguistiche e di contenuto tra i diversi dataset, gli embedding a livello di fotogramma di ciascun segmento video vengono combinati per catturare le espressioni facciali e l'evoluzione delle emozioni.
Modalità audio utilizzando Wav2Vec 2.0 per embedding acustici prosodici e semantici Gli embedding vocali contestualizzati sono stati prodotti utilizzando un codificatore Wav2Vec 2.0 preaddestrato come base acustica. Un vettore di caratteristiche acustiche di lunghezza fissa per ogni frase è stato ottenuto aggregando le rappresentazioni nascoste in uscita mediante media pooling. Il modello Wav2Vec 2.0 è stato utilizzato per estrarre rappresentazioni acustiche dai segnali audio al fine di catturare caratteristiche vocali contestuali e rilevanti per l'emozione. Prima dell'estrazione delle caratteristiche, le registrazioni audio sono state normalizzate e ricampionate a 16 kHz. Per garantire la sincronizzazione tra le modalità testuale e visiva, ogni segmento audio a livello di enunciato è stato isolato utilizzando i limiti temporali forniti dalle annotazioni del dataset. Il codificatore acustico preaddestrato è stato adattato durante l'addestramento del modello per migliorare l'adattamento specifico al compito, consentendo alle rappresentazioni derivate di rappresentare in modo più accurato gli aspetti emotivi dei segnali vocali. Successivamente, è stata eseguita la fusione dell'attenzione multimodale basata su grafi e l'apprendimento di rappresentazioni disincagliate utilizzando gli embedding audio finali.
Nella modalità audio, Wav2Vec-2.0 viene utilizzato per modellare i segnali vocali derivati dalle informazioni vocali iniziali nei dataset CH-SIMS e CMU-MOSEI, estraendo direttamente caratteristiche audio relative all'emozione. Esiste una codifica delle caratteristiche convoluzionali per ogni segnale vocale in ingresso  :
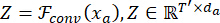 (4)
dove Z indica tratti prosodici di basso livello come melodia, tono ed energia. Una rete contestuale basata su transformer è utile per le strutture sopra menzionate, in quanto rappresenta dipendenze temporali a lungo raggio:
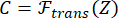 (5)
I dati acustici prosodici e semantici, essenziali per esprimere le emozioni, sono inclusi in queste rappresentazioni acustiche contestuali. Un'incorporazione audio di lunghezza specifica viene creata eseguendo una procedura di pooling temporale:
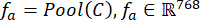 (6)
La progettazione evita l'uso di caratteristiche acustiche come gli MFCC e raggiunge robustezza estraendo semplicemente rappresentazioni dalle forme d'onda, utilizzando dati vocali in inglese da CMU-MOSEI e dati vocali in cinese da CH-SIMS.
Modalità testuale utilizzando RoBERTa per incorporamenti contestuali delle emozioni
Per la modalità testuale, il trasformatore bidirezionale profondo RoBERTa viene applicato alle trascrizioni vocali dei due set di dati per generare semantica contestuale e significato affettivo. Gli encoder trasformatori basati su RoBERTa sono stati utilizzati per estrarre rappresentazioni testuali dai dati delle trascrizioni al fine di catturare informazioni semantiche contestuali ed emozionali. È stato utilizzato un modello RoBERTa preaddestrato per il dataset CMU-MOSEI in lingua inglese, mentre per il dataset cinese CH-SIMS è stata impiegata una variante cinese di RoBERTa, per tenere meglio conto delle caratteristiche linguistiche specifiche della lingua. La pre-elaborazione del testo ha incluso la tokenizzazione mediante il tokenizer RoBERTa appropriato per ciascuna lingua e la normalizzazione del testo. Per garantire un'elaborazione coerente per batch, le sequenze di input sono state convertite in embedding di token e successivamente riempite o tagliate fino a una lunghezza massima predeterminata. In conformità al formato di input di RoBERTa, sono stati introdotti token speciali di classificazione e di separazione. Un embedding testuale di lunghezza fissa è stato ottenuto aggregando le rappresentazioni contestualizzate dei token prodotte dall'encoder trasformatore, utilizzando la rappresentazione finale della frase equivalente al [CLS]. Per adattare le rappresentazioni apprese al compito di riconoscimento delle emozioni, gli encoder RoBERTa preaddestrati sono stati perfezionati attraverso un addestramento multimodale. Successivamente, il framework proposto di fusione multimodale è stato utilizzato per unire gli embedding testuali con le caratteristiche audio e visive.
Gli embedding dei token e le codifiche posizionali possono essere combinati per ogni input tokenizzato, 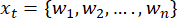 , al fine di creare la rappresentazione dell'input nella tecnica di trasformazione bidirezionale profonda nota come
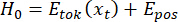 (7)
Questa forma è rappresentata attraverso i livelli del trasformatore L, che utilizza l'auto-attenzione per scoprire le dipendenze contestuali tra le parole:
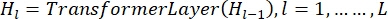 (8)
L'incorporamento contestuale dell'emozione si ottiene utilizzando lo stato nascosto finale del token di classificazione:
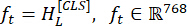 (9)
La polarità del sentiment, le emozioni intense e le implicazioni associate sono esempi di caratteristiche linguistiche relative alle emozioni che verranno rappresentate da questo embedding. RoBERTa semplifica la modellizzazione indipendente dal linguaggio. Ciò consente al sistema di utilizzare la stessa dimensione dell'embedding sia per i testi in inglese del dataset CMU-MOSEI che per i testi in cinese del dataset CH-SIMS.
Tre vettori caratteristici specifici per modalità, ciascuno di 768 dimensioni, relativi alle modalità visiva fv, audio fa e testuale ft, vengono estratti tramite il passaggio proposto di apprendimento della rappresentazione delle caratteristiche profonde. Nella progettazione dell'interazione intelligente, queste rappresentazioni apprese creano uno spazio unificato di caratteristiche multimodali che costituisce la base per il mapping visivo a livello di caratteristiche, la fusione incrociata multimodale basata su grafi e l'apprendimento di rappresentazioni disaccoppiate.
Apprendimento della rappresentazione disaccoppiata
Dopo aver appreso una rappresentazione di caratteristiche profonde, un'ulteriore elaborazione dei vettori di caratteristiche multimodali provenienti dalle modalità visiva, uditiva e testuale può produrre una descrizione emotiva disgiunta. Se gli embedding di caratteristiche specifiche per modalità delle modalità uditiva, visiva e testuale utilizzate nel passaggio precedente sono rappresentati da fv, fa e ft, rispettivamente, in modo tale che  e
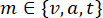 , l'obiettivo di questo passaggio è fattorizzare tutte le caratteristiche modali in due rappresentazioni latenti distinte, che includono le rappresentazioni emotive tenendo conto della semantica precedente di ciascuna delle diverse modalità.
Ciò viene ottenuto alimentando ogni caratteristica modale, fm, in due reti di proiezione parallele: un codificatore emotivo  e un codificatore modale
 , dove vengono prodotte le due codifiche.
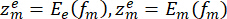 (10)
Dove  rappresenta la caratteristica latente associata all'emozione e
 rappresenta una caratteristica latente specifica per una modalità. Ciò consente agli embedding specifici per l'emozione di comunicare ripetutamente con uno spazio comune attraverso più input, tra cui audio, video e testo, mantenendo al contempo i dati strutturali unici associati a ciascuna modalità.
Una separazione efficace è ottenuta ricostruendo con vincoli di indipendenza. La ricostruzione della caratteristica dell'originale modalità è data da:
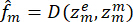 (11)
dove  è una rete decodificatrice. La perdita di ricostruzione preserva i seguenti dati:
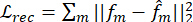 (12)
Inoltre, l'ortogonalità, o decorrelazione, tra emozione e rappresentazioni specifiche della modalità limita spesso la sovrapposizione di informazioni:
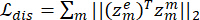 (13)
Raggiungendo questi obiettivi, il modello potrebbe apprendere rappresentazioni delle emozioni affidabili, comprensibili e resistenti alla variabilità delle modalità sensoriali. Successive fusioni multimodali basate su grafi e caratteristiche di mappatura visiva, in particolare per la progettazione di interazioni intelligenti, dipendono fortemente da rappresentazioni emotive interpretabili e strutturate.
Coincidenza delle emozioni tra diverse modalità
L'aggiunta della coerenza emotiva migliora chiaramente l'efficacia della fusione tra le diverse modalità. Questo perché le strategie di fusione non devono tenere conto di ampie differenze tra le due rappresentazioni, poiché gli embedding emotivi specifici per modalità condividono uno spazio latente. L'illustrazione combinata delle due emozioni è descritta come segue  . La fusione pesata sarà più stabile quando le rappresentazioni specifiche per emozione sono coerenti, poiché le variazioni tra i segnali provenienti da diverse modalità non influenzeranno più il risultato.
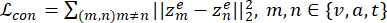 (14)
Imponendo l'allineamento semantico delle informazioni emotive, questo obiettivo riduce al minimo le discrepanze tra le diverse modalità e garantisce che la percezione delle emozioni rimanga coerente indipendentemente dalla modalità utilizzata per esprimerla. Di conseguenza, uno spazio rappresentativo coeso e affettivo viene creato proiettando gli indizi emotivi ottenuti dai segnali vocali, dalle espressioni facciali e dal contenuto linguistico.
Impatto sulla fusione multimodale
La fusione multimodale diventa più efficace quando viene introdotta una coerenza emotiva tra le diverse modalità. I meccanismi di fusione non devono più compensare ampie differenze nelle rappresentazioni inter-modali, poiché gli embedding specifici per l'emozione sono allineati in uno spazio latente comune. La rappresentazione emotiva fusa è definita come segue:
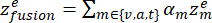 (15)
Dove αm rappresenta il peso dell'attenzione assegnato alla modalità m. La fusione pesata diventa più stabile e comprensibile quando le rappresentazioni specifiche per l'emozione sono coerenti, poiché il risultato della fusione mostra evidenze emotive complementari piuttosto che segnali di modalità contraddittori.
Matematicamente, ridurre  varianza tra diversi tipi di rappresentazione specifici per emozione in relazione a è equivalente a:
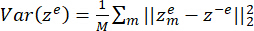 (16)
dove  rappresenta l'espressione emotiva media. Una varianza ridotta fa sì che le modalità di ingresso vengano ponderate in base al loro preciso significato emotivo piuttosto che al rumore della modalità, garantendo una migliore convergenza della rete e una valutazione dell'attenzione più accurata.
L'obiettivo finale dell'apprendimento delle visualizzazioni emotive disincagliate è combinare frammentazione, ricostruzione e uniformità emotiva:
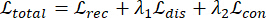 (17)
in cui due iperparametri, λ1 e λ2, controllano la relazione tra affidabilità emotiva multimodale e dissociazione. Il modello proposto acquisisce rappresentazioni emotive invarianti rispetto alla modalità, interpretabili e fusibili per raggiungere questo obiettivo, con un'enfasi particolare nel fornire una base solida per la successiva fusione basata su grafi e per la rappresentazione a livello di caratteristiche nella progettazione di interfacce intelligenti.
Fusione dell'attenzione multimodale basata su grafi
È stato utilizzato un network grafico con attenzione cross-modale per simulare relazioni emotive finemente dettagliate tra le diverse modalità. Per facilitare il flusso di informazioni tra le modalità, è stato costruito un grafo multimodale completamente connesso, in cui ogni embedding specifico per modalità (testo, audio e video) è rappresentato come un nodo del grafo. Le relazioni tra le modalità sono state utilizzate per definire la matrice di adiacenza del grafo, successivamente migliorata mediante un metodo di attenzione apprendibile. Uno spazio latente condiviso è stato creato concatenando e proiettando gli output di diversi head di attenzione. Una rappresentazione unificata dell'emozione multimodale è stata quindi prodotta aggregando le rappresentazioni dei nodi attraverso un pooling pesato sull'attenzione. Tale rappresentazione fusa è stata poi fornita ai moduli di previsione e visualizzazione per l'analisi consapevole delle interazioni e il riconoscimento delle emozioni. Il modulo di fusione basato sul grafo aveva una dimensione della rappresentazione nascosta pari a 256 e due livelli di attenzione grafica, ciascuno con otto head di attenzione. Per determinare l'importanza relativa delle modalità adiacenti, i coefficienti di attenzione tra nodi connessi sono stati calcolati e normalizzati utilizzando la funzione softmax. Ogni livello di attenzione grafica era seguito da una normalizzazione del livello, connessioni residue e un tasso di dropout pari a 0,2, al fine di aumentare la stabilità dell'addestramento e ridurre l'overfitting. Dopo aver concatenato e proiettato gli output di diversi head di attenzione in uno spazio latente comune, le rappresentazioni dei nodi sono state combinate in un unico embedding emotivo multimodale mediante pooling pesato sull'attenzione. Successivamente, la rappresentazione fusa è stata utilizzata per la mappatura visiva multi-vista e la previsione delle emozioni.
Diverse interazioni multimodali sono state catturate utilizzando un'attenzione grafica multi-testa. La funzione softmax è stata utilizzata per normalizzare i coefficienti di attenzione tra i nodi connessi per ogni nodo. Per aumentare la stabilità dell'addestramento ed evitare l'overfitting, ai livelli di attenzione grafica sovrapposti nel modulo di fusione grafica sono state aggiunte connessioni residue, normalizzazione del livello e regolarizzazione con dropout.
I termini rappresentano singolarmente le rappresentazioni corrispondenti alle emozioni specifiche raccolte attraverso le modalità visiva, audio e testuale; ogni componente risiede nello spazio latente condiviso  . I modelli per i nodi delle modalità utilizzano una notazione per il grafo
 , con i nodi dell'insieme
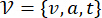 corrispondenti ai tre nodi delle modalità stesse, al fine di rafforzare esplicitamente le dipendenze emotive condivise tra le diverse rappresentazioni delle modalità.
Dopo aver assegnato un vettore di caratteristiche specifico per l'emozione a ciascun nodo nel grafo, abbiamo:
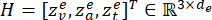 (18)
A differenza dei metodi tradizionali di fusione, che utilizzano pesi fissi o predeterminati, il metodo proposto apprende pesi adattivi per i collegamenti in base alla loro rilevanza e interdipendenze, sia tra canali che tra situazioni emotive.
Una rete di attenzione basata sui grafi (GAT) viene utilizzata per la fusione multimodale. Un coefficiente di attenzione viene calcolato per ciascun nodo i e per i suoi nodi adiacenti, ovvero il nodo j:
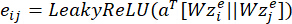 (19)
L'effetto emotivo del passaggio dalla modalità j alla modalità i è misurato dai pesi normalizzati αij.
Successivamente, l'aspetto fuso di ciascun nodo modale viene calcolato come un raggruppamento pesato dei suoi vicini:
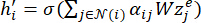 (20)
dove la funzione di attivazione  è non lineare. Infine, le caratteristiche aggiornate di ogni nodo vengono combinate per ottenere una rappresentazione globale fusa dell'emozione:
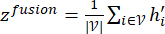 (21)
È una tecnica utile per la modellazione interpretabile delle emozioni e la successiva mappatura visiva poiché cattura informazioni complementari da diverse modalità preservando al contempo complesse relazioni inter-modalità.
L'algoritmo 1 (File Supplementare 1) fornisce lo schema generale per eseguire la fusione cross-modale basata su grafi. Inizialmente, viene creato un grafo con le caratteristiche specifiche dell'emozione associate a ciascuna delle modalità visiva, audio e testuale. Successivamente, vengono calcolati i punteggi di attenzione per ogni coppia di nodi del grafo, che rappresentano la combinazione delle dipendenze emotive. I punteggi di attenzione vengono quindi normalizzati per indicare il contributo relativo di ciascuna modalità al contesto emotivo specificato, consentendo l'apprendimento dei pesi di attenzione. L'embedding generale dell'emozione viene prodotto nell'ultima fase aggregando le caratteristiche associate ai nodi del grafo. In questo senso, la fusione generale dell'algoritmo delle caratteristiche multimodali legate alle emozioni specificate mostra potenzialità in termini di adattabilità, interpretabilità e intelligenza contestuale.
Figura 2 mostra la struttura e il funzionamento della rete proposta con attenzione cross-modale per la fusione del sentiment multimodale. Gli embedding specifici per l'emozione, derivati in modo indipendente per le modalità testuale, uditiva e video, vengono inizialmente elaborati da meccanismi di attenzione a livello modale che apprendono l'importanza relativa delle informazioni linguistiche, vocali e facciali in un dato contesto emotivo. Le rappresentazioni pesate mediante attenzione delle modalità vengono quindi combinate per formare un embedding emotivo unificato, nel quale la matrice di attenzione cattura le dipendenze inter-modalità e l'intensità delle interazioni. La matrice di attenzione appresa dalla rete modula dinamicamente il contributo delle modalità, consentendole di concentrarsi sulla modalità più informativa mentre ignora quelle rumorose o meno significative. La rappresentazione emotiva fusa permette un riconoscimento accurato delle emozioni e un'analisi fine degli stati emotivi, come neutro, abbraccio e preoccupazione.
Modulo di mappatura visiva
Con l'ausilio della sezione di mappatura visiva, creata appositamente per questo scopo, un progettista intelligente di interazioni può convertire la rappresentazione unificata dello stato emotivo in una forma visiva comprensibile e facilmente fruibile dopo il processo di fusione multimodale, in base al grafico.
Per facilitare la comprensione delle rappresentazioni emotive latenti, sono state utilizzate tecniche di riduzione della dimensionalità per visualizzare gli embedding multimodali delle emozioni appresi. Dopo aver ridotto la dimensionalità delle caratteristiche mantenendo la maggior parte della varianza mediante l'analisi delle componenti principali (PCA), gli embedding sono stati proiettati in uno spazio bidimensionale per la visualizzazione, usando l'incorporamento stocastico di vicini distribuiti in modo t (t-SNE). Per t-SNE sono stati utilizzati un valore di perplessità pari a 30, una velocità di apprendimento di 200 e 1.000 iterazioni di ottimizzazione. I cluster specifici per emozione e le relazioni tra modalità sono stati visualizzati mediante le proiezioni ottenute. I pesi normalizzati dell'attenzione incrociata ottenuti dalla rete attentiva basata su grafi sono stati utilizzati per creare mappe termiche di attenzione. Queste mappe termiche mostrano i contributi relativi delle modalità testuale, audio e visiva durante la previsione dell'emozione. I coefficienti di attenzione appresi sono stati utilizzati come pesi degli archi per creare grafi di interazione multimodale, consentendo l'analisi visiva delle relazioni intermodali e del flusso informativo all'interno del framework di fusione. Sono stati creati grafici delle traiettorie emotive monitorando l'evoluzione degli embedding emotivi latenti attraverso utterance successive, per esaminare la dinamica emotiva temporale. Queste traiettorie forniscono informazioni su come gli stati emotivi e i contributi delle modalità evolvono nel tempo. Tutte le visualizzazioni sono state create utilizzando pacchetti Python come Matplotlib e Scikit-learn. Per valutare l'interpretabilità, la formazione dei cluster, i contributi delle modalità e la dinamica temporale delle emozioni, sono state condotte analisi qualitative delle visualizzazioni degli embedding, dei grafi di interazione e delle mappe termiche di attenzione.
Sia la variabile 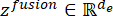 a rappresentare la rappresentazione fusa dello stato emotivo ottenuta tramite la funzione della rete di attenzione su grafi. A differenza della visualizzazione a livello di output dei grafici dello stato emotivo, l'obiettivo principale del modulo è trasformare le rappresentazioni dello stato emotivo e i pesi corrispondenti del meccanismo di attenzione in una forma visiva comprensibile.
Utilizzando i valori di αji appresi, viene creata una mappa termica di attenzione per esaminare visivamente il contributo di ciascuna modalità. I pesi di attenzione in ingresso vengono quindi sommati per determinare un punteggio composito di importanza per ogni modalità:
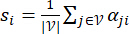 (22)
dove si rappresenta il contributo emotivo relativo della modalità I. Per facilitare la creazione di una mappa termica dell'attenzione, i valori ottenuti vengono normalizzati e associati a una mappa di colori che consente all'utente di identificare facilmente la modalità predominante in diversi passaggi temporali o stati interattivi. Attraverso varie modalità di input visive, uditive o testuali, un'interfaccia di questo tipo aiuta l'utente a comprendere il funzionamento del meccanismo di attenzione del sistema.
Il grafo appreso è modellato specificamente come un "grafo di interazione pesato" per rappresentare la dipendenza multimodale delle emozioni umane. Ogni modalità è rappresentata da un nodo nel grafo, mentre l'intensità delle interazioni relative alle emozioni umane è rappresentata dai pesi sotto forma di αji sui collegamenti che li uniscono. Il grafo pesato sopra illustra l'intensità delle interazioni emotive umane. La definizione di i e j è:
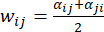 (23)
Lo spessore o la trasparenza delle linee nella visualizzazione del grafico viene mostrato correttamente grazie a questi pesi. Ciò facilita la comprensione delle interazioni tra le diverse modalità. Il progettista può comprendere meglio come gli indicatori emotivi interagiscono durante il processo di fusione, grazie ai grafici di interazione intermodale.
Gli embedding emotivi fusi  in diversi passi temporali vengono ridotti a uno spazio di dimensione inferiore mediante un algoritmo di riduzione della dimensionalità, come PCA o t-SNE, al fine di visualizzare l'evoluzione delle emozioni nel tempo:
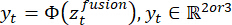 (24)
dove la funzione di proiezione è rappresentata da  . L'emergere di traiettorie emotive 2D/3D, che mostrano transizioni emotive, intensità e stabilità nelle interazioni, può essere interpretato come una rappresentazione intuitiva dell'evoluzione degli stati emotivi nel tempo. Questi aspetti possono essere utilizzati per interazioni intelligenti, processi decisionali e monitoraggio in tempo reale.
A differenza dei sistemi convenzionali di riconoscimento delle emozioni, che si limitano a fornire corrispondenze a determinate classi o punteggi, questo sistema si concentra sulla dimostrazione di come le emozioni umane si formano al suo interno. Rivela il proprio processo decisionale offrendo visualizzazioni delle caratteristiche intermedie, inclusi i fattori di ponderazione, le interazioni tra modelli e i relativi percorsi. Ciò consente all'utente di comprendere come ciascun fattore—visivo, vocale o linguistico—influisca sulla generazione delle risposte alle emozioni umane.
La rappresentazione visiva delle emozioni in forme comprensibili può pertanto colmare il divario tra l'analisi delle emozioni mediante metodi di apprendimento profondo e la loro integrazione nella progettazione di interfacce intelligenti. I dati raccolti da entrambi gli approcci possono quindi essere utilizzati per creare interfacce utente più precise. Di conseguenza, l'approccio proposto può fornire ai progettisti di interazioni informazioni fondamentali per sviluppare interfacce utente più accurate. In altri termini, la comprensione delle emozioni diventa una componente estremamente attiva della progettazione delle interazioni. L'accuratezza può aumentare soltanto quando la comprensione delle emozioni viene integrata attivamente nella progettazione delle interazioni.
Il modulo di mappatura visiva rende possibile la spiegabilità in diversi modi interconnessi ma distinti: la spiegabilità a livello di caratteristica rivela le rappresentazioni sottostanti delle emozioni create dalla rete neurale profonda (DNN), permettendoci di comprendere la semantica utilizzata per descrivere ogni caratteristica relativa all'emozione; la spiegabilità a livello di modalità utilizza dati provenienti dai grafi di interazione e dalle mappe termiche dell'attenzione visiva per descrivere come ciascuna modalità — visiva, audio o testuale — contribuisca alle decisioni prese per esprimere le emozioni; infine, le traiettorie risultanti dall'incorporamento emotivo ci permettono di comprendere come ciascuna modalità visiva e testuale cambi nel tempo da una prospettiva di interazione dinamica. Si rimanda all'Algoritmo 2 (Supplementary File 1).
Le caratteristiche emotive multimodali fuse vengono mappate in rappresentazioni visivamente significative per la progettazione di interazioni intelligenti, utilizzando l'algoritmo di mappatura visiva proposto, Algoritmo 2. I pesi dell'attenzione multimodale basati su grafi vengono utilizzati per quantificare le differenze tra gli elementi visivi, audio e testuali in ingresso a ogni passo temporale. Queste differenze vengono quindi mappate in rappresentazioni visive per evidenziare le principali fonti che influenzano le emozioni, mediante elementi visivi a mappa di calore. Per fornire una visione approfondita dell'interazione tra gli elementi in ingresso e trasmettere l'evoluzione emotiva generata dagli elementi in ingresso multimodali, vengono quindi calcolate le intensità di interazione a coppie al fine di creare i pesi di interazione multimodali. Nel frattempo, viene creata una rappresentazione dell'evoluzione emotiva mappando gli elementi emotivi fusi raccolti nel tempo in uno spazio a bassa dimensionalità, producendo così un'evoluzione continua degli elementi emotivi.
Previsione delle emozioni e feedback dell'interazione
L'esito della rappresentazione emotiva fusa, rappresentato come , viene quindi utilizzato come funzione sia per il feedback dell'interazione che per la previsione emotiva. Inoltre, la previsione emotiva è descritta come un modello multitask costituito da un compito di regressione per il riconoscimento dell'intensità emotiva continua e da un compito di classificazione per il riconoscimento emotivo discreto. Il seguente modello di classificazione basato su softmax viene utilizzato per il riconoscimento emotivo discreto:
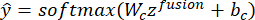 (25)
dove  rappresenta le probabilità attese delle classi emotive e Wc e bc sono vincoli apprendibili. La perdita di entropia incrociata viene utilizzata per migliorare l'obiettivo di classificazione:
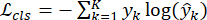 (26)
dove yk è l'etichetta reale e K è il numero di classi emotive. Un ramo di regressione viene utilizzato per stimare l'intensità emotiva in parallelo, producendo una previsione di diversi attributi affettivi continui, inclusi valenza ed attivazione. Assegnagli la seguente definizione:
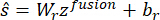 (27)
dove il punteggio previsto dell'intensità emotiva è indicato da  . Viene utilizzata la perdita del quadrato medio degli errori per migliorare il compito di regressione:
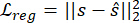 (28)
In generale, le due attività sono combinate nell'obiettivo di previsione:
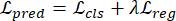 (29)
dove gli obiettivi della regressione e della classificazione sono bilanciati da λ. Si propone una modifica dinamica del modulo di visualizzazione in base allo stato emotivo identificato, al fine di consentire un feedback consapevole dell'interazione. Il contesto di interazione al tempo t è rappresentato da ct. La risposta del modulo di visualizzazione è fornita da:
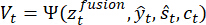 (30)
dove la funzione di adattamento della visualizzazione è rappresentata da  . Ciò rende possibile regolare in tempo reale le mappe termiche di modalità, i grafici di interazione e le traiettorie emotive in base ai cambiamenti e alle emozioni previsti. Ciò indica che il sistema fornisce un sostegno significativo per il feedback, oltre a prestarsi bene nella previsione dello stato emotivo.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Questo studio convalida il framework proposto di mappatura visiva per le caratteristiche emotive multimodali in termini sia di interpretabilità consapevole dell'interazione sia di prestazioni predittive, utilizzando due dataset di riferimento, CH-SIMS e CMU-MOSEI. Secondo i risultati sperimentali, l'approccio suggerito ottiene prestazioni costantemente superiori rispetto alle attuali tecniche di riconoscimento emotivo multimodale in una varietà di metriche, tra cui correlazione, accuratezza, punteggio F1 e errore assolut...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
I risultati sperimentali dimostrano che, nei dataset CH-SIMS e CMU-MOSEI, il framework proposto per il mapping visivo delle caratteristiche emotive multimodali supera le attuali tecniche di riconoscimento delle emozioni multimodali. Rispetto ai modelli a fusione precoce e tardiva, come EF-LSTM e TFN, la tecnica proposta raggiunge una maggiore accuratezza e punteggi F1, dimostrando la sua robustezza nel gestire informazioni emotive diverse. Il miglioramento del metodo è attribuibile alla rappresentazione disincagliata del...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno conflitti di interessi.
Ringraziamenti
Gli autori desiderano riconoscere il supporto fornito dalla School of Housing, Building and Planning, Universiti Sains Malaysia, Penang, Malaysia, e dalla School of Design Art, Changsha University of Science & Technology, Changsha, Cina. Gli autori esprimono inoltre il loro apprezzamento all'Xiamen Academy of Arts and Design, Fuzhou University, Xiamen, Cina, per il supporto accademico e di ricerca durante tutto questo lavoro.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Adam | Libreria di ottimizzatori PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Learning Rate = 1 × 10⁻⁴) | Ottimizzazione dei parametri durante l'addestramento del modello |
| CH-SIMS | Archivio del dataset originale | Ultima versione pubblica | Dataset di riferimento per l'analisi multimodale del sentiment/emozione in cinese |
| CMU-MOSEI | Archivio CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Ultima versione pubblica) | Dataset di riferimento per il riconoscimento multimodale del sentiment e delle emozioni |
| Disentangled Emotion Encoder | Implementazione personalizzata | https://pytorch-geometric.readthedocs.io/en/latest/(Architettura a doppio codificatore) | Separazione delle rappresentazioni latenti specifiche per l'emozione e specifiche per la modalità |
| Graph Attention Network (GAT) | PyTorch Geometric | GAT multi-testa (https://pytorch-geometric.readthedocs.io/en/latest/) | Modellizzazione delle relazioni emotive cross-modali e fusione adattiva delle caratteristiche |
| Graph-Based Cross-Modal Attention Layer | Implementazione personalizzata | Fusione con attenzione multi-testa | Apprendimento di dipendenze emotive finemente dettagliate tra le modalità |
| Matplotlib | Progetto Matplotlib | 3.7+ | Generazione di grafici e analisi visive |
| NetworkX | Progetto NetworkX | 3.0+ | Costruzione e visualizzazione di grafi di interazione cross-modale |
| NVIDIA GPU | NVIDIA Corporation | GPU abilitata CUDA | Accelerazione dell'addestramento di transformer e reti neurali grafiche |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | Riduzione iniziale degli embedding emotivi ad alta dimensionalità |
| Python | Python Software Foundation | 3.8+ | Linguaggio di programmazione principale per l'implementazione del framework di analisi emotiva multimodale |
| PyTorch | PyTorch Foundation | 2.0+ | Sviluppo, addestramento e ottimizzazione di reti neurali profonde |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, embedding 768-dim) | Estrazione di rappresentazioni linguistiche e semantiche contestuali delle emozioni |
| Seaborn | Progetto Seaborn | 0.12+ | Generazione di heatmap di attenzione e visualizzazioni statistiche |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (Perplessità = 30, Iterazioni = 1000) | Visualizzazione di cluster e traiettorie emotive latenti |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS o successiva | Ambiente sperimentale di esecuzione |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, embedding 768-dim | Estrazione di rappresentazioni visive consapevoli dell'emozione dai fotogrammi video |
| Wav2Vec 2.0 | Meta AI Research | Modello base, embedding 768-dim | Estrazione di caratteristiche acustiche e vocali contestuali delle emozioni |
Riferimenti
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.