In questo studio, presentiamo un protocollo per l'assemblaggio della coorte, l'armonizzazione di laboratorio, lo sviluppo di modelli penalizzati, la validazione e la costruzione di un punteggio al letto del paziente per la stratificazione precoce del rischio di sindrome da disfunzione d'organo multiplo nella pancreatite acuta.
Articolo di ricerca
Un protocollo riproducibile di punteggio biochimico-coagulativo all'ammissione per la sindrome da disfunzione multiorgano nella pancreatite acuta
In questo articolo
Sommario
Abstract
Il riconoscimento precoce del sindrome da disfunzione multiorgano nella pancreatite acuta rimane difficile poiché il deterioramento degli organi può verificarsi prima del completamento delle valutazioni convenzionali della gravità. Questo articolo descrive un protocollo riproducibile per lo sviluppo, la validazione e l'applicazione di un punteggio composito biochimico-coagulativo all'ammissione, basato su test di laboratorio di routine effettuati entro 24 ore dall'ingresso in ospedale. La sindrome da disfunzione multiorgano è stata scelta come endpoint primario perché riflette una disfunzione clinicamente rilevante in più di un sistema organico e orienta direttamente l'intensità del monitoraggio precoce, la pianificazione dell'escalation terapeutica e l'allocazione delle risorse di terapia intensiva. Il protocollo comprende l'assemblaggio di una coorte multicentrica, la selezione dei criteri di idoneità, la valutazione degli endpoint, l'armonizzazione delle unità di laboratorio, l'elaborazione dei dati mancanti, la standardizzazione dei predittori, lo sviluppo di un modello di regressione penalizzata, la validazione su campione distinto, la costruzione del punteggio, il confronto con punteggi di gravità consolidati e analisi di sensibilità. Le variabili di laboratorio continue vengono mantenute durante lo sviluppo del modello per ridurre la perdita di informazioni, mentre categorie clinicamente interpretabili vengono utilizzate soltanto al momento della traduzione del modello finale in un punteggio pratico al letto del paziente. I punti di controllo procedurali includono la conferma dell'assemblaggio della coorte, le soglie di dati mancanti, le regole predefinite di pre-elaborazione, gli output della selezione del modello, gli output della validazione e l'interpretazione del punteggio finale. Utilizzando questo flusso di lavoro, marcatori biochimici e della coagulazione comunemente misurati possono essere integrati in uno strumento strutturato di stratificazione del rischio all'ammissione per la sindrome da disfunzione multiorgano associata alla pancreatite acuta. Il punteggio è pensato per supportare un'osservazione più attenta, ripetute valutazioni di laboratorio e la preparazione di percorsi di supporto organico, ma deve affiancare, e non sostituire, il giudizio clinico o i consolidati schemi di valutazione della gravità.
Introduzione
La pancreatite acuta è un'emergenza digestiva comune il cui decorso clinico varia da un'infiammazione lieve e autolimitante a una malattia rapidamente progressiva complicata da disfunzione d'organo. La valutazione attuale della gravità è generalmente guidata dalla classificazione di Atlanta rivista, che definisce la severità della malattia in base a complicanze locali, complicanze sistemiche e alla presenza e durata dell'insufficienza d'organo1. Durante le prime fasi del ricovero ospedaliero vengono inoltre utilizzati sistemi di punteggio clinico per supportare la valutazione del rischio e le decisioni di intensificazione delle cure. L'indice clinico per la gravità della pancreatite acuta utilizza cinque variabili disponibili entro le prime 24 ore ed è stato sviluppato per stimare il rischio di mortalità ospedaliera2. Le linee guida cliniche più recenti continuano a sottolineare il riconoscimento precoce della malattia grave, la rivalutazione ripetuta, una adeguata rianimazione liquida, la pianificazione del supporto d'organo e un'intensificazione tempestiva delle cure3.
La valutazione precoce del rischio rimane difficile nella pratica clinica. La risposta infiammatoria nella pancreatite acuta cambia rapidamente e alcuni sistemi di punteggio tradizionali richiedono misurazioni ripetute, variabili fisiologiche che si evolvono dopo il ricovero o reperti di imaging che potrebbero non essere disponibili al primo contatto clinico4. Di conseguenza, la classificazione del rischio può variare in base al momento del campionamento, al flusso di lavoro locale e al percorso terapeutico. Queste incertezze possono portare a un monitoraggio intensivo o a interventi inutili in pazienti a basso rischio, mentre i pazienti che peggiorano rapidamente potrebbero subire un ritardo nell'escalation delle cure. Una recente revisione sulla predizione della gravità nella pancreatite acuta ha evidenziato che le prestazioni dei punteggi clinici e dei singoli biomarcatori variano tra diverse popolazioni di pazienti, distribuzioni della gravità della malattia e finestre temporali di valutazione5.
La maggior parte degli studi di previsione più recenti ha cercato di utilizzare variabili raccolte entro 24 ore dal ricovero, spesso con insufficienza d'organo persistente o pancreatite acuta grave come esito target. Questo approccio è clinicamente utile, ma molti modelli pubblicati rimangono limitati da una progettazione monocentrica, una validazione incompleta e una segnalazione insufficiente dei metodi di pre-elaborazione e di gestione dei dati mancanti6. La trasparenza nella segnalazione è particolarmente importante per i modelli predittivi poiché i criteri di idoneità, le definizioni dei predittori, la dimensione del campione, la gestione dei dati mancanti, le decisioni relative alla costruzione del modello e le procedure di validazione influiscono direttamente sulla riproducibilità e sull'interpretazione clinica7. Affinché un metodo basato sul ricovero possa essere utilizzabile in diverse strutture, dovrebbe basarsi su test comunemente disponibili, definire le procedure di conversione delle unità, spiegare come vengono armonizzati i valori di laboratorio e specificare come vengono gestiti i valori predittori incompleti prima dell'adattamento del modello.
Anomalie biochimiche e della coagulazione sono entrambe correlate al rapido peggioramento nella pancreatite acuta. L'attivazione infiammatoria, il danno endoteliale, l'emocoagulazione, l'ipoperfusione renale e il disturbo della microcircolazione possono manifestarsi precocemente e contribuire al malfunzionamento d'organo. L'attivazione della coagulazione è strettamente collegata all'infiammazione, e la coagulopatia associata alla pancreatite acuta è stata descritta come parte del decorso verso insufficienza d'organo persistente ed esiti avversi8. Il D-dimero è stato inoltre segnalato come un marcatore all'ammissione associato a insufficienza d'organo, complicanze locali, ricovero in terapia intensiva e mortalità nella pancreatite acuta9. Tuttavia, gli indicatori della coagulazione sono spesso interpretati separatamente, piuttosto che combinati con variabili biochimiche di routine in un percorso strutturato all'ammissione.
La sindrome da disfunzione multiorgano è stata selezionata come endpoint primario in questo protocollo perché rappresenta una disfunzione clinicamente rilevante che interessa più di un sistema d'organo. Il fallimento d'organo persistente rimane centrale nella classificazione della gravità della pancreatite acuta, ma la sindrome da disfunzione multiorgano si avvicina maggiormente alla domanda pratica posta all'ammissione: se un paziente richiederà probabilmente una sorveglianza più stretta, una rivalutazione ripetuta degli esami di laboratorio, la preparazione per il supporto d'organo o risorse di terapia intensiva. Questo endpoint consente inoltre di valutare i segnali biochimici e della coagulazione in relazione a un quadro più ampio di deterioramento sistemico, piuttosto che in base a un esito legato a un singolo organo.
L'articolo di questo metodo descrive un protocollo riproducibile di punteggio biochimico-coagulativo all'ammissione per la stratificazione precoce del rischio di sindrome da disfunzione multiorgano nella pancreatite acuta. Il protocollo utilizza variabili di laboratorio di routine ottenute entro 24 ore dall'ammissione, standardizza l'armonizzazione delle unità e la gestione dei dati mancanti, applica uno sviluppo del modello con penalizzazione e traduce il modello finale in un punteggio composito clinicamente interpretabile. L'obiettivo non è sostituire il giudizio clinico o i consolidati schemi di gravità, ma fornire un flusso di lavoro trasparente e replicabile che aiuti le strutture a organizzare i dati di laboratorio all'ammissione in informazioni di rischio utilizzabili.
Protocollo
Il protocollo dello studio è stato approvato dal Comitato Etico per la Ricerca Biomedica che coinvolge Esseri Umani del Primo Ospedale Popolare di Jiashan, Ospedale affiliato all'Università di Jiaxing (numero di approvazione 2026 Research Approval No. 005; numero di accettazione LW2026004; data di approvazione: 13 gennaio 2026). L'obbligo del consenso informato individuale è stato esentato poiché questo studio retrospettivo ha utilizzato dati clinici anonimizzati. Prima dell'analisi, gli identificatori diretti, tra cui nome, numero di identificazione ospedaliero, numero di telefono, indirizzo e numero di identificazione nazionale, sono stati rimossi. La gestione dei dati ha seguito i requisiti istituzionali di protezione dei dati e la Dichiarazione di Helsinki10.
Disegno dello studio e assemblaggio della coorte multicentrica
Questo studio retrospettivo di coorte multicentrica ha utilizzato dati biochimici e della coagulazione raccolti all'ammissione per costruire un flusso di lavoro di punteggio riproducibile per la stratificazione precoce del rischio di sindrome da disfunzione d'organo multiplo (MODS) nella pancreatite acuta (AP). L'AP è stata definita in presenza di almeno due dei seguenti criteri: dolore addominale tipico, amilasi o lipasi sierica almeno tre volte superiore al limite superiore della norma, oppure riscontri di imaging compatibili con AP. La finestra basale è stata definita come le prime 24 ore dopo il ricovero in ospedale. Per ciascun predittore di laboratorio, è stato utilizzato il valore idoneo più precoce all'interno di questa finestra. I valori ottenuti dopo il primo riscontro documentato di MODS non sono stati utilizzati per la costruzione dei predittori.
I ricoveri ospedalieri consecutivi per pancreatite acuta (AP) provenienti dai centri partecipanti dal 1° gennaio 2023 al 20 dicembre 2025 sono stati selezionati utilizzando un registro di selezione unificato, un elenco di idoneità, un dizionario dati e un modulo di valutazione degli endpoint. Il registro di selezione ha registrato il numero totale di ricoveri esaminati, i ricoveri duplicati, le esclusioni per AP non confermata, età inferiore a 18 anni, pancreatite cronica, pancreatite associata a malignità pancreatiche, orario di ricovero non affidabile, dati di laboratorio a 24 ore non disponibili, record degli endpoint incompleti e il coorte analitico finale. Il registro di selezione bloccato è stato utilizzato per generare Figura 1. I numeri dei pazienti riportati nella Figura 1 sono stati verificati rispetto al dataset analitico finale prima dell'analisi.
Dopo il blocco della coorte analitica, i pazienti sono stati assegnati a una coorte di sviluppo e a una coorte di validazione distinta in un rapporto 7:3. La suddivisione è stata effettuata in R versione 4.3.2 utilizzando il pacchetto caret versione 6.0-94, con il seme casuale fissato a 20260420. È stato eseguito un campionamento stratificato in base allo stato di MODS e al centro. Se la distribuzione per centro differiva di oltre 5 punti percentuali tra le coorti, sono state utilizzate stratificazioni combinate centro-MODS. L'assegnazione alle coorti è stata salvata prima dell'adattamento del modello e non è stata modificata successivamente. Le regole di preelaborazione, le impostazioni di imputazione, l'ottimizzazione del modello, la stima dei coefficienti, la costruzione del punteggio e la selezione della soglia sono state definite esclusivamente a partire dalla coorte di sviluppo. La coorte di validazione distinta è stata utilizzata unicamente per la valutazione del modello bloccato.
Criteri di idoneità e procedure di arruolamento
I pazienti idonei erano adulti di età pari o superiore a 18 anni con pancreatite acuta (AP) confermata, tempo di ricovero ospedaliero accertabile, almeno un profilo biochimico o emocoagulativo disponibile entro 24 ore dal ricovero e cartelle cliniche complete per la valutazione degli endpoint. I pazienti sono stati esclusi se non era possibile confermare la pancreatite acuta, se era presente una pancreatite associata a pancreatite cronica o a neoplasia pancreatica, o se il momento del primo ricovero ospedaliero non poteva essere ricostruito in modo affidabile. I casi di trasferimento sono stati esclusi quando il momento del primo ricovero, il momento del primo prelievo di laboratorio o lo stato di disfunzione d'organo precoce non erano accertabili tra diverse strutture. Per i ricoveri ripetuti dello stesso paziente durante il periodo dello studio, è stato considerato solo il primo ricovero idoneo. Per ogni caso escluso è stata registrata una causa primaria di esclusione.
Valutazione degli esiti e dei punti finali
L'esito primario era il danno multiorganico in ospedale (MODS), definito come disfunzione di due o più sistemi organici durante il ricovero. La disfunzione organica è stata valutata sulla base dei dati relativi ai sistemi respiratorio, cardiovascolare, renale, epatico, della coagulazione e neurologico presenti nella cartella clinica elettronica. Gli stessi criteri predeterminati per i sistemi organici sono stati applicati in tutti i centri prima dello sviluppo del modello, e i criteri operativi utilizzati per la valutazione dei punti finali sono riassunti nella Tabella Supplementare 1.
Due revisori esperti hanno valutato in modo indipendente ogni cartella anonimizzata utilizzando le note di ammissione, le note di evoluzione, i referti dell'unità di terapia intensiva, i referti delle procedure, i rapporti di laboratorio, i dati dei segni vitali e i riassunti alla dimissione. Il modulo di valutazione registrava il codice dello studio del paziente, l'apparato interessato, il referto di origine, la data e l'ora di insorgenza, il valore di laboratorio o fisiologico di supporto, la decisione del revisore e lo stato finale della valutazione. L'accordo tra i revisori era considerato definitivo. Le divergenze erano risolte da un terzo revisore esperto. Gli esiti secondari includevano l'ammissione in terapia intensiva, la ventilazione meccanica invasiva o non invasiva, la terapia di sostituzione renale, la mortalità in ospedale, la necrosi infetta o una procedura di drenaggio e la durata del ricovero ospedaliero. La durata del ricovero è stata calcolata come la data di dimissione meno la data di ammissione più 1 giorno.
Predittori in esame all'ammissione
I predittori in esame erano limitati alle variabili di routine disponibili entro 24 ore dall'ammissione. Per i test ripetuti entro la finestra di 24 ore, è stato mantenuto il valore idoneo più precoce. Le variabili biochimiche includevano il conteggio dei globuli bianchi, la proteina C-reattiva, la procalcitonina quando disponibile, il lattato, il glucosio, il calcio totale, l'azoto ureico nel sangue, la creatinina, l'alanina aminotransferasi, la bilirubina totale, l'albumina e la lattato deidrogenasi. Le variabili della coagulazione includevano il conteggio delle piastrine, il tempo di protrombina, il rapporto normalizzato internazionale del tempo di protrombina, il tempo di tromboplastina parziale attivata, il fibrinogeno e il D-dimero.
Sono state raccolte variabili cliniche di base per la descrizione del mix di casi e il calcolo del punteggio di riferimento. Queste variabili includevano età, sesso, indice di massa corporea, tempo trascorso dall'insorgenza dei sintomi al ricovero, eziologia della pancreatite, stato di fumatore, episodi precedenti di pancreatite, comorbidità, frequenza cardiaca al ricovero, pressione arteriosa media, stato di sindrome da risposta infiammatoria sistemica, punteggio dell'indice clinico per la gravità nella pancreatite acuta, punteggio di valutazione della fisiologia acuta e della salute cronica II e punteggio di valutazione della disfunzione organica sequenziale. Quando erano disponibili sia il tempo di protrombina sia il rapporto normalizzato internazionale del tempo di protrombina, per la modellizzazione è stato utilizzato il rapporto normalizzato internazionale del tempo di protrombina, mentre il tempo di protrombina è stato mantenuto per la descrizione dei dati. Il file di estrazione conteneva una riga per ogni ricovero e conservava il codice del centro, il codice dello studio del paziente, l'orario di ricovero, l'orario del campionamento, il valore grezzo, l'unità grezza, il valore armonizzato, l'unità armonizzata, la tabella di origine e l'indicatore di mancanza dei dati.
Armonizzazione dei laboratori tra i centri
Tutte le variabili di laboratorio sono state convertite in unità target predeterminate prima dell'analisi: conta dei globuli bianchi e conta delle piastrine, 109/L; proteina C reattiva, mg/L; procalcitonina, ng/mL; lattato, glucosio, calcio totale e azotemia, mmol/L; creatinina e bilirubina totale, µmol/L; alanina aminotransferasi e lattato deidrogenasi, U/L; albumina e fibrinogeno, g/L; tempo di protrombina e tempo di tromboplastina parziale attivata, secondi; rapporto normalizzato internazionale del tempo di protrombina, rapporto adimensionale; e D-dimero, mg/L in unità equivalenti al fibrinogeno. I valori di D-dimero riportati come µg/mL in unità equivalenti al fibrinogeno sono stati convertiti in mg/L in unità equivalenti al fibrinogeno utilizzando una conversione numerica 1:1. I valori di D-dimero riportati come unità D-dimero sono stati convertiti soltanto quando il laboratorio locale ha fornito un fattore di conversione validato. I valori senza un fattore di conversione validato sono stati considerati mancanti nell'analisi statistica.
Le unità di riferimento, i range di riferimento, i referti degli esami e le annotazioni dell'analizzatore di ciascun centro sono stati revisionati prima dell'aggregazione. Il file di armonizzazione ha mantenuto l'unità originale, l'unità target, la regola di conversione e il revisore responsabile della verifica della conversione. I valori di laboratorio non sono stati normalizzati in base ai range di riferimento specifici di ciascun centro nell'analisi primaria, poiché il punteggio era inteso per utilizzare valori clinici assoluti. Il codice del centro è stato mantenuto durante l'imputazione e l'analisi di sensibilità. Sono stati segnalati valori negativi per test non negativi, unità incompatibili, timestamp al di fuori della finestra di 24 ore e valori non supportati dai referti originali. Un valore è stato corretto soltanto quando il referto originale confermava un errore di trascrizione o di conversione dell'unità; in caso contrario, è stato impostato come mancante.
Preelaborazione dei dati e gestione dei dati mancanti
La percentuale di dati mancanti è stata riassunta per variabile, centro e stato di MODS prima dell'adattamento del modello. I predittori candidati sono stati esclusi dallo sviluppo del modello se la percentuale complessiva di dati mancanti superava il 30% o se tale percentuale superava il 50% in un singolo centro. I pazienti sono stati esclusi dal dataset di modellizzazione se mancavano più del 40% dei predittori candidati o se l'esito primario non poteva essere valutato.
I predittori continui sono stati winsorizzati al primo e al 99° percentile stimati nel gruppo di sviluppo. Le stesse soglie sono state applicate al gruppo di validazione tenuto in riserva. Le soglie non sono state ricalcolate sui dati di validazione. Le variabili con asimmetria superiore a 2 dopo la winsorizzazione sono state trasformate utilizzando il logaritmo naturale; è stato utilizzato log(x + 0,01) per le variabili che potevano contenere zero. I predittori continui sono stati standardizzati utilizzando la media e la deviazione standard del gruppo di sviluppo, e gli stessi parametri sono stati applicati ai dati di validazione.
L'analisi con imputazione multipla è stata eseguita mediante equazioni concatenate in R utilizzando il pacchetto mice versione 3.16.0. Sono stati generati venti dataset imputati con 20 iterazioni per ciascun dataset. Per le variabili continue è stato utilizzato il metodo di associazione predittiva delle medie, per le variabili binarie la regressione logistica e per le variabili categoriali nominali la regressione logistica polinomiale. Il modello di imputazione includeva predittori candidati, codice del centro, indicatore della coorte e stato MODS per lo sviluppo del modello. Gli esiti di validazione non sono stati utilizzati per modificare le regole di pre-elaborazione, l'idoneità delle variabili o le soglie. Le stime di regressione sono state combinate utilizzando le regole di Rubin quando riportate. Le metriche predittive sono state calcolate all'interno di ciascun dataset imputato e riassunte come stime combinate o mediane con relative escursioni. Sono state predefinite due analisi di sensibilità: un'analisi basata sui casi completi utilizzando i pazienti senza predittori mancanti nel modello finale e un'analisi basata sui valori basali utilizzando il valore del laboratorio peggiore ma idoneo entro 24 ore anziché il valore più precoce.
Analisi statistica e sviluppo del modello
Le caratteristiche alla baseline sono state riassunte separatamente nei cohort di sviluppo e di validazione indipendente. Le variabili continue sono state riportate come media ± deviazione standard o mediana con intervallo interquartile, e le variabili categoriche come n (%). Le variabili biochimiche e della coagulazione al ricovero sono state confrontate tra i pazienti con e senza MODS. Per le variabili continue è stato utilizzato il test t di Student o il test della somma dei ranghi di Wilcoxon, mentre per le variabili categoriche è stato utilizzato il test del chi-quadrato o il test esatto di Fisher. Questi valori P avevano carattere descrittivo e non sono stati utilizzati singolarmente per la selezione dei predittori.
Lo sviluppo del modello è stato limitato al gruppo di sviluppo. È stata utilizzata la regressione logistica penalizzata come modello principale per ridurre l'overfitting in presenza di un numero limitato di eventi e di predittori di laboratorio correlati. Il modello è stato adattato in R versione 4.3.2 utilizzando il pacchetto glmnet versione 4.1-8 con famiglia binomiale, predittori standardizzati e penalizzazione di tipo least absolute shrinkage and selection operator (LASSO), specificata da alpha = 1. È stata impiegata una validazione incrociata a dieci ripetizioni, ripetuta 10 volte, per l'ottimizzazione della penalizzazione, con il seme casuale fissato a 20260420. Il parametro di penalizzazione è stato selezionato utilizzando la regola dell'errore standard. Sono stati salvati il percorso dei coefficienti, i valori dell'errore di validazione incrociata, il parametro di penalizzazione selezionato e i predittori mantenuti. Il flusso di analisi è mostrato nella Figura 2. Il software, i pacchetti statistici, i sistemi di database e le piattaforme di laboratorio utilizzati nel protocollo sono elencati nella Tabella dei Materiali.
La regressione logistica non penalizzata non è stata utilizzata come modello inferenziale principale dopo la selezione penalizzata. Se i rapporti di probabilità (odds ratios) sono stati riportati per l'interpretazione clinica, sono stati etichettati come stime descrittive post-selezione. La capacità discriminante è stata stimata mediante l'area sotto la curva caratteristica operativa del ricevitore (ROC), con intervalli di confidenza al 95% calcolati utilizzando il metodo di DeLong nel pacchetto pROC versione 1.18.5. La calibrazione è stata valutata mediante l'intercetta di calibrazione, la pendenza della calibrazione, il punteggio di Brier e i grafici di calibrazione. È stato utilizzato un ricampionamento bootstrap con 1.000 ripetizioni nel gruppo di sviluppo per stimare le prestazioni corrette per l'ottimismo. L'analisi della curva decisionale non è stata mantenuta nel set di analisi rivisto; pertanto, le affermazioni sul beneficio clinico netto sono state rimosse dal manoscritto.
Derivazione e interpretazione del punteggio
Il punteggio composito biochimico-coagulativo basato su punti è stato derivato dai coefficienti del modello penalizzato bloccato. Le variabili continue sono state utilizzate durante l'adattamento del modello. Le soglie categorizzate sono state introdotte solo dopo la finalizzazione del modello per supportare il calcolo al letto del paziente. Le soglie sono state scelte in base a intervalli di riferimento clinici stabiliti, soglie comuni di anomalie di laboratorio o punti di taglio basati sui coefficienti definiti nel gruppo di sviluppo prima della validazione. Le soglie non sono state ottimizzate nel gruppo di validazione.
Sono stati assegnati punti interi in base alla direzione e alla grandezza relativa dei coefficienti bloccati. Punteggi più elevati indicavano profili di laboratorio più sfavorevoli. Il punteggio totale è stato calcolato sommando i punti relativi ai componenti mantenuti. Le categorie di rischio predefinite sono state utilizzate esclusivamente per la stratificazione del rischio; non sono state utilizzate per definire la MODS. Il punteggio aveva lo scopo di identificare i pazienti che potrebbero necessitare di un’osservazione più attenta, di ripetute valutazioni di laboratorio o di una preparazione per percorsi di supporto d'organo. Non è stato utilizzato come regola diagnostica autonoma, come trigger per anticoagulazione o come sostituto della rivalutazione da parte del clinico.
Validazione con campione di riserva e benchmarking
Le regole di preelaborazione bloccate, la struttura di imputazione, le soglie di winsorizzazione, i parametri di standardizzazione, i coefficienti del modello, le regole di punteggio e le soglie prefissate sono stati applicati al campione di validazione di riserva. Non è stata eseguita alcuna ulteriore selezione di predittori, riadattamento del modello, ricampionamento dei coefficienti o ottimizzazione delle soglie. Le prestazioni di validazione sono state riassunte mediante discriminazione, calibrazione, punteggio di Brier, sensibilità, specificità, valore predittivo positivo e valore predittivo negativo.
Gli strumenti di valutazione della gravità precedentemente stabiliti sono stati calcolati a partire dalla stessa finestra temporale di ammissione, quando i dati erano disponibili, inclusi l'Indice Clinico di Gravità nella Pancreatite Acuta, il punteggio Acute Physiology and Chronic Health Evaluation II, il punteggio Sequential Organ Failure Assessment, il punteggio di Ranson, il punteggio di Pancreatite Acuta Innocua e i criteri del sindrome da risposta infiammatoria sistemica. I confronti hanno utilizzato lo stesso endpoint, popolazione di analisi e schema di validazione. I confronti tra aree sotto la curva appaiate sono stati effettuati mediante test di DeLong.
Tutti i grafici di convalida e i grafici stratificati per punteggio sono stati generati a partire dal dataset analitico bloccato. La dimensione del campione in ciascun pannello delle figure è stata verificata rispetto al coorte analitico finale, al coorte di sviluppo, al coorte di convalida tenuto in riserva o allo strato di punteggio prestabilito prima della preparazione delle figure. I metodi visivi progettati per dati omici ad alta dimensione, dati ecologici di conteggio o analisi di abbondanza differenziale non sono stati utilizzati per dati di laboratorio clinico di routine.
Risultati
Caratteristiche della coorte e comparabilità alla baseline
Un totale di 300 pazienti con pancreatite acuta è stato incluso nella coorte analitica finale. Secondo la suddivisione prespecificata stratificata 7:3 con riserva, 210 pazienti sono stati assegnati alla coorte di sviluppo e 90 pazienti alla coorte di validazione con riserva. Tutti i pazienti inclusi presentavano misurazioni biochimiche e della coagulazione idonee entro 24 ore dall'ammissione in ospedale.
Le caratteristiche basali sono riportate nella Tabella 1. I gruppi di sviluppo e di validazione indipendente erano simili per età (54,0 anni ± 16,4 anni rispetto a 55,3 anni ± 15,2 anni, P = 0,486), distribuzione del sesso (maschi: 61,9% rispetto a 61,1%, P = 0,898), indice di massa corporea (25,0 [22,6–27,9] kg/m2 rispetto a 24,7 [22,2–27,5] kg/m2, P = 0,293), tempo dall'esordio dei sintomi al ricovero (13,2 [7,1–22,6] h rispetto a 12,8 [6,8–21,7] h, P = 0,612) e eziologia della pancreatite acuta (P = 0,931). Anche le comorbidità, i parametri vitali al ricovero, lo stato di sindrome da risposta infiammatoria sistemica, il punteggio dell'indice clinico per la gravità della pancreatite acuta (Bedside Index for Severity in Acute Pancreatitis), il punteggio di valutazione del fallimento d'organo sequenziale (Sequential Organ Failure Assessment) e le variabili biochimiche e della coagulazione al ricovero elencate erano bilanciati tra i due gruppi. Questi confronti hanno confermato che la suddivisione in campione di validazione indipendente non ha introdotto uno squilibrio basale clinicamente rilevante.
Profili biochimici e della coagulazione all'ammissione in base allo stato di MODS
Tra i 300 pazienti, 50 hanno sviluppato una sindrome da disfunzione d'organo multiplo (MODS) durante il ricovero, mentre 250 non l'hanno sviluppata. I profili biochimici e della coagulazione all'ammissione in base allo stato di MODS sono riassunti nella Tabella 2. Rispetto ai pazienti senza MODS, quelli che hanno sviluppato MODS presentavano un conteggio più elevato di globuli bianchi (14,4 × 10⁹/L ± 5,2 × 10⁹/L vs 12,3 × 10⁹/L ± 4,6 ×10⁹/L, P = 0,008), un rapporto neutrofili-linfociti più alto (13,4 [9,1–21,3] vs 9,0 [5,9–14,2], P < 0,001), valori più elevati di proteina C-reattiva (138,6 [86,9–226,7] mg/L vs 61,4 [29,2–123,8] mg/L, P < 0,001), procalcitonina (1,25 [0,56–3,28] ng/mL vs 0,43 [0,18–1,02] ng/mL, P < 0,001), lattato (2,7 [2,0–4,0] mmol/L vs 1,7 [1,2–2,4] mmol/L, P = 0,004) e glucosio (11,2 [8,9–15,1] mmol/L vs 8,9 [7,3–11,4] mmol/L, P = 0,010).
Il gruppo MODS ha mostrato anche valori più bassi di calcio (1,96 mmol/L ± 0,21 mmol/L rispetto a 2,06 mmol/L ± 0,17 mmol/L, P = 0,013) e albumina (32,5 g/L ± 5,6 g/L rispetto a 35,9 g/L ± 4,8 g/L, P < 0,001), insieme a valori più elevati di azotemia (9,4 [7,4–13,2] mmol/L rispetto a 6,6 [5,1–8,9] mmol/L, P < 0,001), creatinina (108,9 [84,7–163,4] µmol/L rispetto a 77,1 [62,4–97,6] µmol/L, P < 0,001), bilirubina totale (22,1 [14,2–38,9] µmol/L rispetto a 18,6 [12,3–31,7] µmol/L, P = 0,038) e lattato deidrogenasi (372,4 [289,8–512,3] U/L rispetto a 254,6 [203,2–329,1] U/L, P < 0,001). Il tempo di protrombina, il rapporto normalizzato internazionale del tempo di protrombina, il tempo di tromboplastina parziale attivato e la D-dimero erano anch'essi più elevati nel gruppo MODS. Il conteggio delle piastrine (P = 0,096) e il fibrinogeno (P = 0,268) non presentavano differenze significative tra i gruppi. Questi confronti erano descrittivi e non sono stati utilizzati da soli per la selezione dei predittori.
Schemi degli esiti precoci e tendenze correlate ai punteggi
Gli esiti clinici grezzi in base allo stato di sindrome da disfunzione d'organo multipla sono presentati in Figura 3. I pazienti che hanno sviluppato la sindrome da disfunzione d'organo multipla hanno avuto un ricovero ospedaliero più lungo rispetto a quelli che non hanno sviluppato tale sindrome (Figura 3A). Hanno inoltre presentato tassi più elevati di ammissione in terapia intensiva (Figura 3B), ventilazione meccanica (Figura 3C), terapia di sostituzione renale (Figura 3D), procedure per necrosi infetta o drenaggio (Figura 3E) e mortalità intraospedaliera (Figura 3F). Tutti i pannelli sono stati generati a partire dal gruppo analitico definitivo di 300 pazienti.
Gli esiti clinici osservati nelle categorie predefinite in base al punteggio composito sono presentati nella Figura 4. L'incidenza del sindrome da disfunzione multiorgano è aumentata progressivamente nei gruppi a rischio basso, intermedio, alto e molto alto (Figura 4A). Aumenti ordinati simili sono stati osservati per il ricovero in terapia intensiva (Figura 4B), la mortalità ospedaliera (Figura 4C) e le procedure per necrosi infetta o drenaggio (Figura 4D). Anche la durata del ricovero ospedaliero è aumentata attraverso le quattro categorie di punteggio (Figura 4E). I gradienti sono risultati più marcati per l'incidenza della sindrome da disfunzione multiorgano e per il ricovero in terapia intensiva. Tutti i grafici sono stati generati a partire dal dataset analitico bloccato, utilizzando le categorie di punteggio predefinite.
La distribuzione del punteggio composito basato su punti tra le categorie di gravità secondo la classificazione aggiornata di Atlanta è mostrata nella Figura 5. I punteggi compositi mediani sono aumentati progressivamente nelle forme di pancreatite acuta da lieve a moderatamente grave e poi grave, indicando una concordanza tra il punteggio biochimico-coagulativo al ricovero e le categorie cliniche di gravità precedentemente stabilite. La Figura 5 è stata generata a partire dallo stesso coorte analitica bloccata di 300 pazienti. Non è stata utilizzata alcuna visualizzazione basata su ordinamento, abbondanza differenziale, diagramma a vulcano, valore q, distanza di Bray–Curtis o analisi delle coordinate principali.
Sviluppo del modello penalizzato e predittori mantenuti
Lo sviluppo del modello penalizzato è stato effettuato esclusivamente nel gruppo di sviluppo. Le traiettorie dei coefficienti dei predittori candidati all'ammissione sono mostrate nella Figura 6A, mentre la curva di validazione incrociata ripetuta a 10 ripiegamenti utilizzata per selezionare il parametro di penalizzazione è riportata nella Figura 6B. Al valore del parametro di penalizzazione selezionato mediante la regola dell'errore standard unico, la penalizzazione mediante operatore di riduzione e selezione con norma L1 ha mantenuto nove predittori relativi all'ammissione: albumina, azotemia, creatinina, calcio, deidrogenasi lattica, tempo di protrombina–rapporto normalizzato internazionale, D-dimero, conta piastrinica e glucosio.
I predittori mantenuti e le stime descrittive post-selezione sono riportati nella Tabella 3. Queste stime sono state fornite per facilitare l'interpretazione clinica e non sono state considerate come inferenze confermative dopo la selezione penalizzata. La direzione dell'associazione era clinicamente coerente: albumina più bassa, azotemia più alta, creatinina più alta, calcio più basso, lattato deidrogenasi più alta, tempo di protrombina-rapporto normalizzato internazionale più alto, D-dimero più alto, conta piastrinica più bassa e glucosio più alto erano associati a un rischio aumentato di MODS. Le stime descrittive post-selezione erano le seguenti: albumina per ogni diminuzione di 5 g/L, odds ratio 1,29 (intervallo di confidenza al 95% 1,13–1,47); azotemia per ogni aumento di 1 mmol/L, odds ratio 1,12 (1,06–1,18); creatinina per ogni aumento di 10 µmol/L, odds ratio 1,05 (1,02–1,09); calcio per ogni diminuzione di 0,1 mmol/L, odds ratio 1,18 (1,07–1,30); lattato deidrogenasi per ogni aumento di 100 U/L, odds ratio 1,21 (1,07–1,37); tempo di protrombina-rapporto normalizzato internazionale per ogni aumento di 0,1, odds ratio 1,14 (1,05–1,25); D-dimero per ogni aumento di 1,0 mg/L in unità equivalenti di fibrinogeno, odds ratio 1,09 (1,02–1,17); conta piastrinica per ogni diminuzione di 50 × 109/L, odds ratio 1,16 (1,01–1,34); e glucosio per ogni aumento di 1 mmol/L, odds ratio 1,05 (1,00–1,10).
Costruzione del punteggio composito basato sui punti
Le regole utilizzate per costruire il punteggio composito biochimico-coagulativo basato sui punti per l'ammissione sono presentate nella Tabella 4. Il punteggio è stato ricavato dai coefficienti del modello penalizzato bloccato e tradotto in categorie clinicamente interpretabili per il calcolo al letto del paziente. Otto variabili—albumina, azotemia, creatinina, calcio, deidrogenasi lattica, tempo di protrombina, rapporto normalizzato internazionale, D-dimero e conta piastrinica—sono state incluse come componenti principali del punteggio. Il glucosio è stato mantenuto come modificatore opzionale poiché il suo contributo era inferiore rispetto a quello delle variabili biochimiche e della coagulazione principali, anche se la direzione della sua associazione con il sindrome da disfunzione multiorgano è rimasta coerente con il modello bloccato.
Un nomogramma che incorpora tutti e nove i predittori mantenuti dal modello penalizzato bloccato è presentato in Figura 7. Il nomogramma fornisce una stima personalizzata della probabilità di sindrome da disfunzione d'organo multiplo in base ai valori all'ammissione di albumina, azotemia, creatinina, calcio, deidrogenasi lattica, tempo di protrombina-rapporto normalizzato internazionale, D-dimero, conta piastrinica e glucosio. È stato incluso come strumento interpretativo, mentre il punteggio composito basato sui punti è rimasto lo strumento pratico principale al letto del paziente, poiché può essere calcolato direttamente dalle misurazioni di laboratorio all'ammissione di routine.
Prestazioni del modello e validazione interna
Le prestazioni del modello nei cohort di sviluppo e di validazione indipendente sono riportate nella Tabella 5. Il modello logistico penalizzato con termine di penalizzazione ha ottenuto un'area sotto la curva caratteristica operativa del ricevitore di 0,873 (intervallo di confidenza al 95% 0,820–0,926) nel cohort di sviluppo e di 0,836 (0,751–0,921) nel cohort di validazione indipendente. Il punteggio di Brier è stato pari a 0,117 nel cohort di sviluppo e a 0,139 nel cohort di validazione indipendente. L'intercetta e la pendenza della curva di calibrazione sono state rispettivamente 0,04 (−0,08–0,16) e 0,97 (0,79–1,18) nel cohort di sviluppo, e 0,08 (−0,14–0,30) e 0,91 (0,68–1,15) nel cohort di validazione indipendente.
Al cutoff prespecificato del rischio predetto di 0,18, il modello ha mostrato sensibilità e specificità di 0,82 e 0,77 nel gruppo di sviluppo e di 0,75 e 0,74 nel gruppo di convalida indipendente. I valori predittivi positivi e negativi sono stati rispettivamente 0,39 e 0,96 nel gruppo di sviluppo e 0,39 e 0,93 nel gruppo di convalida indipendente. Il punteggio composito basato su punti ha mostrato una capacità discriminatoria inferiore rispetto al modello penalizzato bloccato, ma ha mantenuto una performance utile per lo screening, con valori dell'area sotto la curva ROC di 0,823 nel gruppo di sviluppo e di 0,783 nel gruppo di convalida indipendente. Al cutoff prespecificato di ≥8 punti, il punteggio ha mostrato valori predittivi negativi di 0,93 e 0,91 rispettivamente nel gruppo di sviluppo e in quello di convalida indipendente.
Confronto con punteggi di gravità consolidati
I confronti di riferimento rispetto a strumenti di gravità consolidati sono riportati nella Tabella 6. Il modello biochimico-coagulativo all'ammissione bloccato ha mostrato una capacità discriminatoria superiore rispetto al punteggio di Ranson, al punteggio di pancreatite acuta innocua e ai criteri della sindrome da risposta infiammatoria sistemica in entrambi i cohorti. Nel cohort di sviluppo, il modello non differiva in modo significativo dal punteggio Sequential Organ Failure Assessment secondo il test di DeLong (P = 0.12), ma presentava una capacità discriminatoria maggiore rispetto al punteggio Acute Physiology and Chronic Health Evaluation II (P = 0.03), al punteggio Bedside Index for Severity in Acute Pancreatitis (P = 0.01), al punteggio di Ranson (P < 0.001), al punteggio di pancreatite acuta innocua (P < 0.001) e ai criteri della sindrome da risposta infiammatoria sistemica (P < 0.001). Nel cohort di validazione indipendente, le differenze non risultavano significative rispetto al punteggio Sequential Organ Failure Assessment (P = 0.34), al punteggio Acute Physiology and Chronic Health Evaluation II (P = 0.08) o al punteggio Bedside Index for Severity in Acute Pancreatitis (P = 0.05), ma rimanevano significative rispetto al punteggio di Ranson (P = 0.02), al punteggio di pancreatite acuta innocua (P = 0.01) e ai criteri della sindrome da risposta infiammatoria sistemica (P = 0.02).
Stratificazione del rischio mediante punteggio basato su punti
I risultati della stratificazione del rischio sono mostrati nella Tabella 7. I pazienti sono stati suddivisi in gruppi a basso rischio (0–4 punti), intermedio (5–8 punti), alto (9–12 punti) e molto alto (≥13 punti). L'incidenza di MODS è aumentata dal 3,5% (4/115) nel gruppo a basso rischio all'8,9% (9/101), 33,3% (20/60) e 70,8% (17/24) rispettivamente nei gruppi a rischio intermedio, alto e molto alto. L'ammissione in terapia intensiva è aumentata dall'8,7% al 23,8%, 60,0% e 83,3% nei quattro gruppi. La mortalità ospedaliera è aumentata dallo 0,9% al 2,0%, 10,0% e 25,0%, mentre la necrosi infetta o il drenaggio sono aumentati dal 2,6% all'8,9%, 23,3% e 33,3%. La durata mediana del ricovero è aumentata da 7,6 (5,2–10,4) giorni nel gruppo a basso rischio a 11,4 (8,0–16,5), 18,6 (13,0–26,8) e 24,9 (17,5–37,2) giorni nei gruppi a rischio più elevato.
Analisi di sensibilità
Le analisi di sensibilità sono riassunte nella Tabella supplementare 2. Queste analisi hanno valutato se i risultati principali dipendessero dalla gestione dei dati mancanti o dall'assegnazione dei valori basali. Nell'analisi dei casi completi, i predittori mantenuti e la direzione dell'associazione erano coerenti con l'analisi primaria con imputazione. La capacità discriminante è cambiata solo in modo modesto, con aree sotto le curve caratteristiche operative del ricevitore di 0,861 nella coorte di sviluppo e 0,821 nella coorte di validazione indipendente. Nell'analisi di sensibilità sui valori basali, utilizzando il peggiore valore di laboratorio ammissibile entro le prime 24 ore anziché il valore più precoce, il modello ha mostrato valori dell'area sotto la curva caratteristica operativa del ricevitore di 0,879 nella coorte di sviluppo e 0,829 nella coorte di validazione indipendente. L'incidenza del MODS stratificata per punteggio è rimasta ordinata tra i gruppi a basso, intermedio, alto e altissimo rischio in entrambe le analisi di sensibilità. Questi risultati indicano che il flusso di lavoro biochimico-coagulativo all'ammissione non è stato sostanzialmente alterato dalle alternative prespecificate di preelaborazione.
DISPONIBILITÀ DEI DATI:
Il set di dati anonimizzato utilizzato per riprodurre le analisi principali, insieme al dizionario dei dati, alla tabella di conversione delle unità e agli script di analisi, è stato depositato su Figshare con l'identificatore univoco del dato https://doi.org/10.6084/m9.figshare.32565768.v1. Gli identificatori diretti dei pazienti sono stati rimossi prima del deposito dei dati e gli identificatori dei centri sono stati codificati in conformità ai requisiti istituzionali di protezione dei dati. Il repository contiene i file necessari per riprodurre la descrizione della coorte, il preelaborazione dei predittori, lo sviluppo del modello, la costruzione del punteggio, la validazione su campione trattenuto, le analisi di confronto, le analisi di sensibilità e gli output a livello di figure riportati in questo manoscritto.
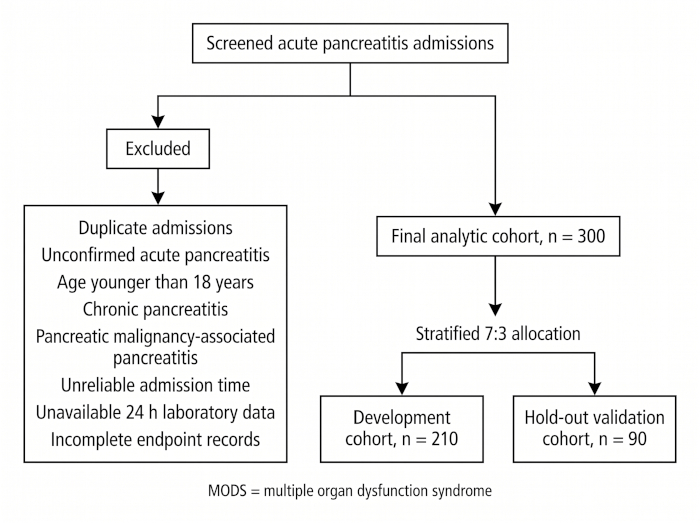
Figura 1: Selezione dei pazienti e assegnazione al gruppo. Il diagramma di flusso mostra i ricoveri consecutivi per pancreatite acuta sottoposti a screening presso i centri partecipanti, i motivi di esclusione, il gruppo analitico finale e la suddivisione stratificata 7:3 nei gruppi di sviluppo e di validazione indipendente. Il gruppo di sviluppo comprendeva 210 pazienti, mentre il gruppo di validazione indipendente comprendeva 90 pazienti. MODS indica la sindrome da disfunzione multiorgano. Cliccare qui per visualizzare una versione ingrandita di questa figura.
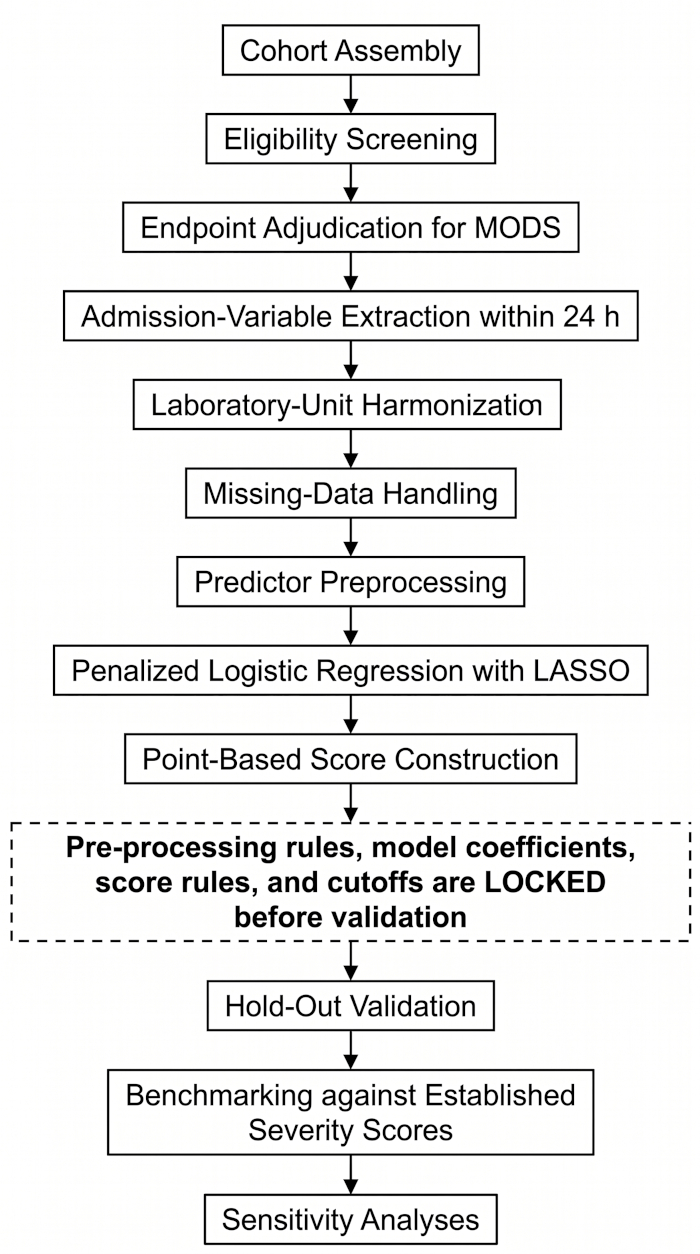
Figura 2: Flusso di lavoro analitico riproducibile per lo sviluppo del punteggio biochimico-emocoagulativo all'ammissione. Lo schema riassume l'assemblaggio del coorte, la selezione dell'idoneità, la valutazione degli endpoint, l'estrazione delle variabili all'ammissione, l'armonizzazione delle unità di laboratorio, la gestione dei dati mancanti, la pre-elaborazione dei predittori, lo sviluppo del modello penalizzato, la costruzione del punteggio basato su punti e la validazione su un campione trattenuto. Tutte le regole di pre-elaborazione, i coefficienti del modello, le procedure di costruzione del punteggio e le definizioni delle soglie sono state stabilite nel coorte di sviluppo prima della valutazione nel coorte di validazione trattenuto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
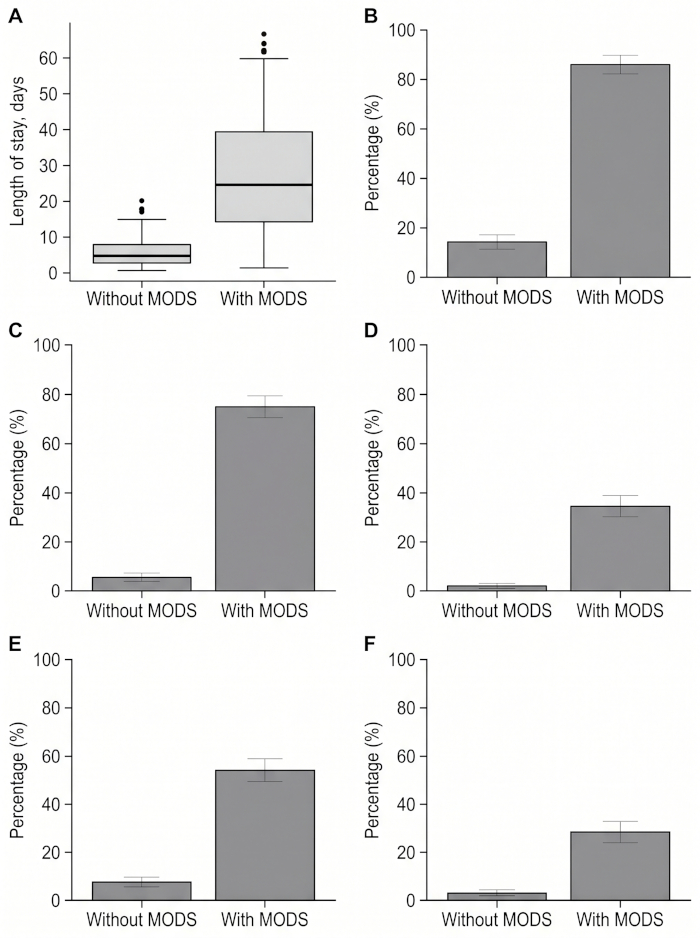
Figura 3: Esiti clinici grezzi in base allo stato di sindrome da disfunzione d'organo multipla. (A) Durata del ricovero ospedaliero nei pazienti senza e con sindrome da disfunzione d'organo multipla. (B) Tassi di ammissione in terapia intensiva in base allo stato di sindrome da disfunzione d'organo multipla. (C) Tassi di ventilazione meccanica in base allo stato di sindrome da disfunzione d'organo multipla. (D) Tassi di terapia di sostituzione renale in base allo stato di sindrome da disfunzione d'organo multipla. (E) Tassi di necrosi infetta o procedure di drenaggio in base allo stato di sindrome da disfunzione d'organo multipla. (F) Tassi di mortalità intraospedaliera in base allo stato di sindrome da disfunzione d'organo multipla. Tutti i pannelli sono stati generati a partire dal coorte analitico bloccato di 300 pazienti. MODS indica la sindrome da disfunzione d'organo multipla; ICU, unità di terapia intensiva. Cliccare qui per visualizzare una versione ingrandita di questa figura.
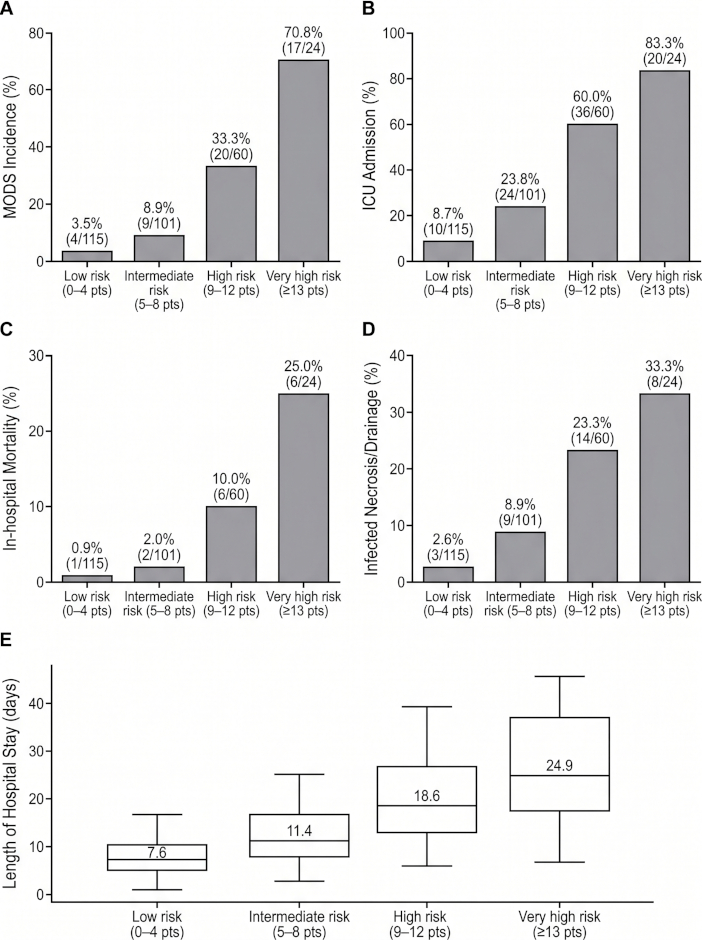
Figura 4: Tassi di esiti osservati nei sottogruppi definiti dal punteggio composito basato sui punti. (A) Incidenza del sindrome da disfunzione multiorgano nei gruppi a basso, intermedio, alto e altissimo rischio. (B) Tassi di ricovero in terapia intensiva nei quattro sottogruppi in base al punteggio. (C) Tassi di mortalità intraospedaliera nei quattro sottogruppi in base al punteggio. (D) Tassi di necrosi infetta o di interventi di drenaggio nei quattro sottogruppi in base al punteggio. (E) Durata del ricovero ospedaliero nei quattro sottogruppi in base al punteggio. Tutti i grafici sono stati generati a partire dal dataset analitico bloccato, utilizzando le categorie di punteggio predeterminate: basso rischio (0–4 punti), rischio intermedio (5–8 punti), alto rischio (9–12 punti) e rischio molto elevato (≥13 punti). MODS indica il sindrome da disfunzione multiorgano; ICU, terapia intensiva. Cliccare qui per visualizzare una versione ingrandita di questa figura.
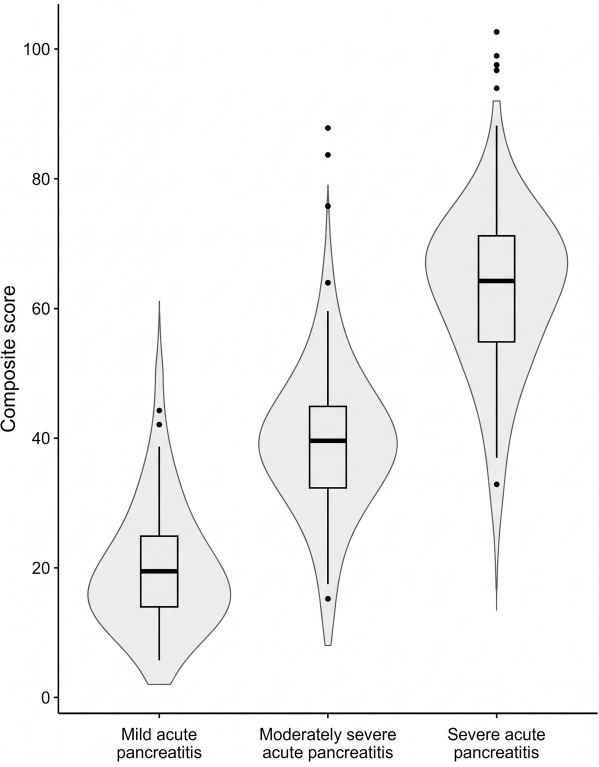
Figura 5: Distribuzione del punteggio composito basato sui punti tra le categorie di gravità secondo la classificazione di Atlanta rivista. La distribuzione dei punteggi compositi è mostrata per pazienti con pancreatite acuta lieve, moderatamente grave e grave. I punteggi compositi aumentano progressivamente attraverso le tre categorie di gravità, indicando una concordanza tra il punteggio biochimico-coagulativo al ricovero e la classificazione di gravità di Atlanta rivista. La figura è stata generata a partire dal coorte analitico bloccato di 300 pazienti. AP indica pancreatite acuta. Cliccare qui per visualizzare una versione ingrandita di questa figura.
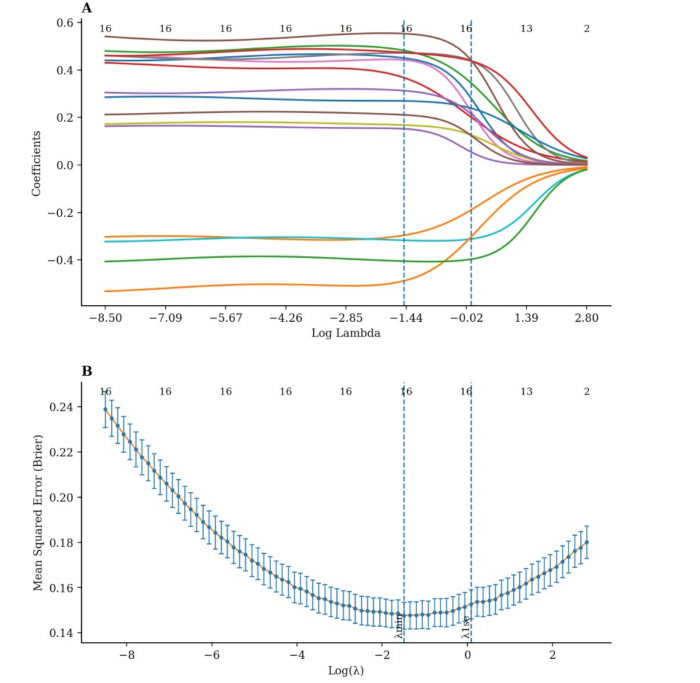
Figura 6: Sviluppo del modello penalizzato nel gruppo di sviluppo. (A) Traiettorie dei coefficienti dell'operatore di riduzione e selezione con norma L1 assoluta minima per i predittori biochimici e della coagulazione candidati all'ammissione. (B) I risultati della validazione incrociata ripetuta a 10 ripiegamenti sono stati utilizzati per selezionare il parametro di penalizzazione. È stata applicata la regola dell'errore standard per ottenere un modello bloccato parsimonioso per la costruzione del punteggio e la validazione su campione trattenuto. LASSO indica l'operatore di riduzione e selezione con norma L1 assoluta minima; PT-INR, rapporto internazionale normalizzato del tempo di protrombina. Cliccare qui per visualizzare una versione ingrandita di questa figura.
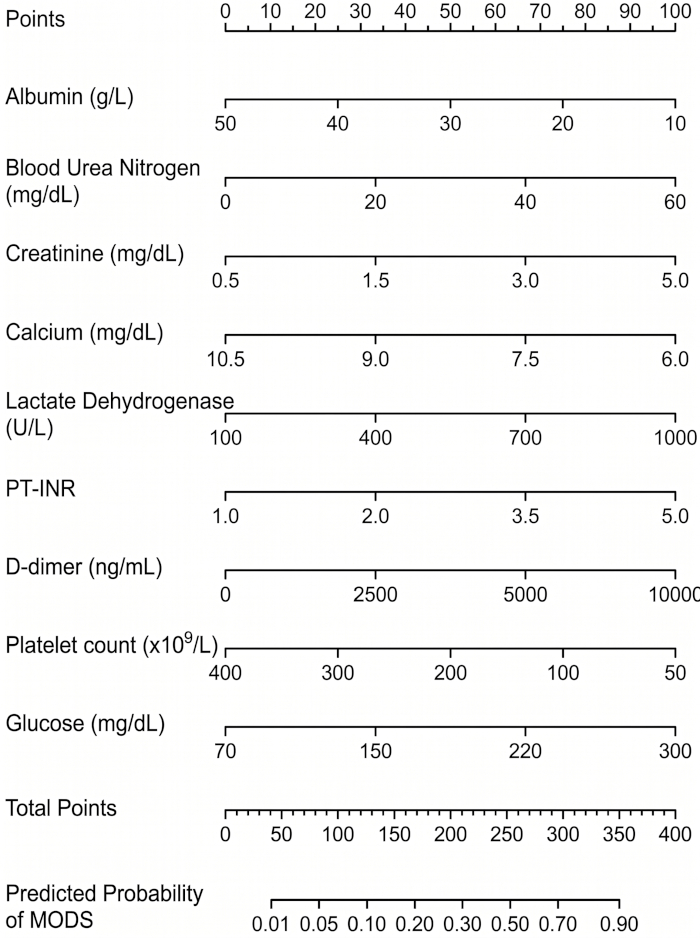
Figura 7: Nomogramma basato sul modello predittivo bloccato per la stima del rischio individualizzato. Il nomogramma incorpora i nove predittori all'ammissione mantenuti dal modello penalizzato bloccato: albumina, azotemia, creatinina, calcio, deidrogenasi lattica, tempo di protrombina-rapporto normalizzato internazionale, D-dimero, conta piastrinica e glucosio. Ciascun predittore contribuisce con punti a un punteggio totale che corrisponde alla probabilità stimata di sindrome da disfunzione d'organo multiplo. Il nomogramma è stato incluso come strumento interpretativo, mentre il punteggio composito basato sui punti è rimasto lo strumento pratico principale al letto del paziente. MODS indica sindrome da disfunzione d'organo multiplo; PT-INR, tempo di protrombina-rapporto normalizzato internazionale; FEU, unità equivalenti di fibrinogeno. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Variabile | Cohorte di sviluppo n=210 | Cohorte di validazione indipendente n=90 | Valore P |
| Età, anni | 54,0 ± 16,4 | 55,3 ± 15,2 | 0,486 |
| Sesso maschile, n (%) | 130 (61,9) | 55 (61,1) | 0,898 |
| Indice di massa corporea, kg/m² | 25,0 (22,6–27,9) | 24,7 (22,2–27,5) | 0,293 |
| Tempo dall'esordio dei sintomi al ricovero, h | 13,2 (7,1–22,6) | 12,8 (6,8–21,7) | 0,612 |
| Eziologia, n (%) | 0,931 | ||
| Biliare | 89 (42,4) | 38 (42,2) | |
| Ipertrigliceridemia | 65 (31,0) | 29 (32,2) | |
| Legata all'alcol | 19 (9,0) | 8 (8,9) | |
| Idiopatica | 25 (11,9) | 11 (12,2) | |
| Altro | 12 (5,7) | 4 (4,4) | |
| Pancreatite precedente, n (%) | 31 (14,8) | 12 (13,3) | 0,742 |
| Anamnesi del fumo, n (%) | 58 (27,6) | 24 (26,7) | 0,868 |
| Diabete mellito, n (%) | 37 (17,6) | 17 (18,9) | 0,795 |
| Ipertensione, n (%) | 62 (29,5) | 28 (31,1) | 0,784 |
| Malattia renale cronica, n (%) | 8 (3,8) | 4 (4,4) | 0,797 |
| Frequenza cardiaca al ricovero, battiti/min | 92,4 ± 15,8 | 93,1 ± 16,2 | 0,726 |
| Pressione arteriosa media, mmHg | 88,6 ± 12,4 | 87,9 ± 11,8 | 0,65 |
| Sindrome da risposta infiammatoria sistemica, n (%) | 72 (34,3) | 30 (33,3) | 0,871 |
| Punteggio dell'indice clinico per la gravità nella pancreatite acuta | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,842 |
| Punteggio di valutazione della disfunzione organica sequenziale | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,796 |
| Punteggio di valutazione della fisiologia acuta e della salute cronica II | 7,0 (5,0–10,0) | 7,0 (5,0–10,0) | 0,884 |
| Sindrome da disfunzione multiorgano, n (%) | 35 (16,7) | 15 (16,7) | 1 |
| Conteggio dei globuli bianchi, ×10⁹/L | 12,8 ± 4,7 | 12,9 ± 4,9 | 0,865 |
| Proteina C-reattiva, mg/L | 70,6 (32,8–141,5) | 72,4 (35,1–145,9) | 0,778 |
| Glucosio, mmol/L | 9,1 (7,4–11,8) | 9,0 (7,2–11,6) | 0,691 |
| Calcio totale, mmol/L | 2,05 ± 0,18 | 2,04 ± 0,19 | 0,672 |
| Azotemia, mmol/L | 6,9 (5,2–9,4) | 7,1 (5,3–9,6) | 0,584 |
| Creatinina, μmol/L | 80,2 (64,5–104,8) | 81,1 (65,1–106,2) | 0,731 |
| Albumina, g/L | 35,2 ± 5,1 | 35,0 ± 5,0 | 0,754 |
| Deidrogenasi lattica, U/L | 270,8 (212,5–356,7) | 275,6 (216,2–361,4) | 0,637 |
| Tempo di protrombina - rapporto normalizzato internazionale | 1,09 (1,02–1,18) | 1,10 (1,03–1,19) | 0,694 |
| D-dimero, mg/L in unità equivalenti al fibrinogeno | 1,84 (0,92–3,82) | 1,91 (0,95–3,96) | 0,744 |
| Conteggio delle piastrine, ×10⁹/L | 203,6 ± 68,4 | 201,8 ± 66,9 | 0,836 |
Tabella 1: Caratteristiche basali dei pazienti nei cohort di sviluppo e di validazione indipendente. Le variabili demografiche, cliniche, di punteggio di gravità, biochimiche e della coagulazione basali sono confrontate tra i cohort di sviluppo e di validazione indipendente. Le variabili continue sono riportate come media ± deviazione standard o mediana (intervallo interquartile), e le variabili categoriche come n (%). I valori P sono utilizzati per confronti descrittivi tra i cohort.
| Variabile | Gruppo senza MODS n = 250 | Gruppo MODS n = 50 | Valore P |
| Conta dei globuli bianchi, ×10⁹/L | 12,3 ± 4,6 | 14,4 ± 5,2 | 0,008 |
| Rapporto neutrofili-linfociti | 9,0 (5,9–14,2) | 13,4 (9,1–21,3) | <0,001 |
| Proteina C reattiva, mg/L | 61,4 (29,2–123,8) | 138,6 (86,9–226,7) | <0,001 |
| Procalcitonina, ng/mL | 0,43 (0,18–1,02) | 1,25 (0,56–3,28) | <0,001 |
| Lattato, mmol/L | 1,7 (1,2–2,4) | 2,7 (2,0–4,0) | 0,004 |
| Glucosio, mmol/L | 8,9 (7,3–11,4) | 11,2 (8,9–15,1) | 0,01 |
| Calcio totale, mmol/L | 2,06 ± 0,17 | 1,96 ± 0,21 | 0,013 |
| Azoto ureico nel sangue, mmol/L | 6,6 (5,1–8,9) | 9,4 (7,4–13,2) | <0,001 |
| Creatinina, μmol/L | 77,1 (62,4–97,6) | 108,9 (84,7–163,4) | <0,001 |
| Alanina aminotransferasi, U/L | 46,2 (25,6–93,8) | 58,7 (31,5–119,4) | 0,084 |
| Bilirubina totale, μmol/L | 18,6 (12,3–31,7) | 22,1 (14,2–38,9) | 0,038 |
| Albumina, g/L | 35,9 ± 4,8 | 32,5 ± 5,6 | <0,001 |
| Deidrogenasi lattica, U/L | 254,6 (203,2–329,1) | 372,4 (289,8–512,3) | <0,001 |
| Conta delle piastrine, ×10⁹/L | 207,4 ± 67,2 | 190,3 ± 72,5 | 0,096 |
| Tempo di protrombina, s | 12,7 (11,8–13,9) | 14,1 (12,9–15,7) | 0,002 |
| Rapporto internazionale normalizzato del tempo di protrombina | 1,08 (1,02–1,16) | 1,22 (1,10–1,38) | 0,002 |
| Tempo di tromboplastina parziale attivata, s | 31,8 (28,4–36,5) | 36,9 (31,7–42,8) | 0,006 |
| Fibrinogeno, g/L | 4,12 ± 1,18 | 4,31 ± 1,29 | 0,268 |
| D-dimero, mg/L in unità equivalenti al fibrinogeno | 1,48 (0,78–3,16) | 4,62 (2,10–8,95) | <0,001 |
Tabella 2: Profili biochimici e della coagulazione all'ammissione in base allo stato di sindrome da disfunzione d'organo multiplo. Gli indici di laboratorio rappresentano la prima misurazione disponibile effettuata entro 24 ore dall'ammissione ospedaliera. Le variabili continue sono espresse come media ± deviazione standard o mediana (intervallo interquartile). I valori P rappresentano confronti descrittivi tra i pazienti che hanno sviluppato la sindrome da disfunzione d'organo multiplo e quelli che non l'hanno sviluppata. Tali confronti sono stati utilizzati per caratterizzare le differenze all'ammissione e non sono stati impiegati singolarmente per la selezione dei predittori.
| Predittore mantenuto nel modello bloccato | Direzione associata a un rischio maggiore di MODS | Unità scalata per l'interpretazione | Rapporto di probabilità descrittivo | Intervallo di confidenza al 95% | Ruolo nel modello |
| Albumina | Valore più basso | Per ogni diminuzione di 5 g/L | 1,29 | 1,13–1,47 | Componente principale del punteggio |
| Azoto ureico nel sangue | Valore più alto | Per ogni aumento di 1 mmol/L | 1,12 | 1,06–1,18 | Componente principale del punteggio |
| Creatinina | Valore più alto | Per ogni aumento di 10 μmol/L | 1,05 | 1,02–1,09 | Componente principale del punteggio |
| Calcio totale | Valore più basso | Per ogni diminuzione di 0,1 mmol/L | 1,18 | 1,07–1,30 | Componente principale del punteggio |
| Deidrogenasi lattica | Valore più alto | Per ogni aumento di 100 U/L | 1,21 | 1,07–1,37 | Componente principale del punteggio |
| Tempo di protrombina - rapporto normalizzato internazionale | Valore più alto | Per ogni aumento di 0,1 | 1,14 | 1,05–1,25 | Componente principale del punteggio |
| D-dimero | Valore più alto | Per ogni aumento di 1,0 mg/L in unità equivalenti al fibrinogeno | 1,09 | 1,02–1,17 | Componente principale del punteggio |
| Conteggio delle piastrine | Valore più basso | Per ogni diminuzione di 50 × 10⁹/L | 1,16 | 1,01–1,34 | Componente principale del punteggio |
| Glucosio | Valore più alto | Per ogni aumento di 1 mmol/L | 1,05 | 1,00–1,10 | Modificatore opzionale |
Tabella 3: Predittori mantenuti dal modello penalizzato bloccato e stime descrittive post-selezione. La tabella mostra i predittori mantenuti dal modello logistico penalizzato con operatore di riduzione e selezione della norma L1 (least absolute shrinkage and selection operator) bloccato e le stime descrittive post-selezione per l'interpretazione clinica. I rapporti di probabilità (odds ratio) sono riportati per le unità scalate indicate. Queste stime non vengono considerate come inferenza confermativa dopo la selezione penalizzata.
| Componente del punteggio | Categoria | Punti assegnati |
| Albumina, g/L | ≥38 | 0 |
| 34–37,9 | 1 | |
| 30–33,9 | 2 | |
| <30 | 3 | |
| Azotemia (urea nel sangue), mmol/L | <6,5 | 0 |
| 6,5–8,9 | 1 | |
| 9,0–12,9 | 2 | |
| ≥13,0 | 3 | |
| Creatinina, μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| Calcio totale, mmol/L | ≥2,10 | 0 |
| 2,00–2,09 | 1 | |
| 1,90–1,99 | 2 | |
| <1,90 | 3 | |
| Lattato deidrogenasi, U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| Tempo di protrombina - rapporto normalizzato internazionale | <1,10 | 0 |
| 1,10–1,19 | 1 | |
| 1,20–1,39 | 2 | |
| ≥1,40 | 3 | |
| D-dimero, mg/L in unità equivalenti al fibrinogeno | <1,0 | 0 |
| 1,0–2,9 | 1 | |
| 3,0–5,9 | 2 | |
| ≥6,0 | 3 | |
| Conta piastrinica, ×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| Glucosio, mmol/L | <10,0 | 0 |
| ≥10,0 | 1 |
Tabella 4: Costruzione del punteggio composito biochimico-emostatico all'ammissione.
Il punteggio composito basato sui punti è stato ricavato dal modello penalizzato bloccato e tradotto in categorie cliniche interpretabili al letto del paziente. I punti sono stati assegnati in base alla direzione e al contributo relativo dei predittori mantenuti. Il punteggio totale viene calcolato sommando tutti i componenti del punteggio mantenuti. Il glucosio è stato mantenuto come modificatore opzionale poiché la sua associazione era più debole rispetto a quella dei componenti biochimici-corelativi principali, ma è rimasto coerente nella direzione con un rischio aumentato.
| Strumento | Cohorte | AUC | Punteggio Brier | Intercept di calibrazione | Pendenza di calibrazione | Valore soglia | Sensibilità | Specificità | PPV | NPV |
| (IC 95%) | (IC 95%) | (IC 95%) | ||||||||
| Modello penalizzato bloccato | Cohorte di sviluppo | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 a 0.16) | 0.97 (0.79–1.18) | Rischio predetto ≥0,18 | 0,82 | 0,77 | 0,39 | 0,96 |
| Modello penalizzato bloccato | Cohorte di validazione indipendente | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0.14 a 0.30) | 0.91 (0.68–1.15) | Rischio predetto ≥0,18 | 0,75 | 0,74 | 0,39 | 0,93 |
| Punteggio composito basato su punti | Cohorte di sviluppo | 0.823 (0.758–0.888) | 0.132 | Non applicabile | Non applicabile | ≥8 punti | 0,76 | 0,72 | 0,35 | 0,93 |
| Punteggio composito basato su punti | Cohorte di validazione indipendente | 0.783 (0.684–0.882) | 0.151 | Non applicabile | Non applicabile | ≥8 punti | 0,7 | 0,69 | 0,31 | 0,91 |
Tabella 5: Prestazioni del modello penalizzato bloccato e del punteggio composito basato sui punti. Sono mostrate la capacità discriminante, la calibrazione e le prestazioni basate sulla soglia per i cohort di sviluppo e di validazione indipendente. La capacità discriminante è riportata come area sotto la curva caratteristica operativa del ricevitore con intervallo di confidenza al 95%. La calibrazione è riassunta dal punteggio di Brier, dall'intercetta di calibrazione e dalla pendenza di calibrazione. Le metriche soglia sono riportate a cutoff predeterminati: rischio previsto ≥0,18 per il modello penalizzato bloccato e punteggio ≥8 punti per il punteggio composito basato sui punti.
| Strumento di previsione | Area sotto la curva di sviluppo | Valore P di DeLong rispetto al modello bloccato | AUC della validazione con campione trattenuto | Valore P di DeLong rispetto al modello bloccato |
| (95% CI) | (Sviluppo) | (95% IC) | (Convalida) | |
| Modello biochimico–coagulativo bloccato | 0.873 (0.820–0.926) | Riferimento | 0.836 (0.751–0.921) | Riferimento |
| Punteggio di valutazione del fallimento organico sequenziale | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| Punteggio Acute Physiology and Chronic Health Evaluation II | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| Punteggio Bedside Index for Severity in Acute Pancreatitis | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| Punteggio di Ranson | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| Punteggio di pancreatite acuta benigna | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| Criteri del sindrome da risposta infiammatoria sistemica | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
Tabella 6: Confronto con strumenti consolidati di gravità. Il modello biochimico-coagulativo bloccato all'ammissione viene confrontato con strumenti consolidati di gravità della pancreatite acuta o disfunzione d'organo, calcolati sulla stessa finestra temporale all'ammissione quando i dati erano disponibili. Sono riportati i valori dell'area sotto la curva ROC con intervalli di confidenza al 95% per i cohort di sviluppo e di validazione indipendente. Test di DeLong accoppiati confrontano ciascuno strumento di riferimento con il modello biochimico-coagulativo bloccato all'interno di ciascun cohort.
| Categoria di rischio | Intervallo di punteggio | Pazienti, n | Incidenza di MODS, n (%) | Ricovero in terapia intensiva, n | ventilazione meccanica, n (%) | Terapia sostitutiva renale, n (%) | Mortalità ospedaliera, n (%) | Necrosi infetta o drenaggio, n (%) | Durata del ricovero, giorni |
| (%) | |||||||||
| Basso rischio | 0–4 | 115 | 4 (3,5) | 10 (8,7) | 3 (2,6) | 1 (0,9) | 1 (0,9) | 3 (2,6) | 7,6 (5,2–10,4) |
| Rischio intermedio | 5–8 | 101 | 9 (8,9) | 24 (23,8) | 9 (8,9) | 4 (4,0) | 2 (2,0) | 9 (8,9) | 11,4 (8,0–16,5) |
| Alto rischio | 9–12 | 60 | 20 (33,3) | 36 (60,0) | 18 (30,0) | 10 (16,7) | 6 (10,0) | 14 (23,3) | 18,6 (13,0–26,8) |
| Altissimo rischio | ≥13 | 24 | 17 (70,8) | 20 (83,3) | 13 (54,2) | 7 (29,2) | 6 (25,0) | 8 (33,3) | 24,9 (17,5–37,2) |
Tabella 7: Stratificazione del rischio mediante punteggio composito basato sui punti. I pazienti sono suddivisi in gruppi a basso, intermedio, alto e altissimo rischio in base al punteggio totale. Sono riportate l'incidenza osservata di sindrome da disfunzione multiorgano e i principali esiti clinici nei diversi strati di punteggio. Gli esiti categorici sono espressi come n (%), mentre la durata del ricovero è espressa come mediana (intervallo interquartile).
Tabella supplementare 1: Criteri operativi per la valutazione dell'esito della sindrome da disfunzione multiorgano. La tabella definisce i criteri predefiniti per ciascun sistema d'organo utilizzati per valutare le disfunzioni respiratoria, cardiovascolare, renale, epatica, della coagulazione e neurologica. L'esito finale è stato assegnato quando si è verificata la disfunzione di due o più sistemi d'organo durante il ricovero. Due revisori esperti hanno valutato indipendentemente ogni caso, e le divergenze sono state risolte da un terzo revisore senior.Cliccare qui per scaricare il file.
Tabella supplementare 2: Analisi di sensibilità per la gestione dei dati mancanti e l'assegnazione dei valori basali. La tabella riassume l'analisi principale con dati imputati e le analisi di sensibilità predeterminate, inclusa l'analisi dei casi completi, l'assegnazione del valore peggiore come valore basale entro le prime 24 ore e la verifica delle prestazioni aggiustata per centro. Le analisi valutano se la capacità discriminante del modello, il punteggio di Brier, il modello dei predittori mantenuti e i gradienti di rischio stratificati per punteggio siano stati sostanzialmente modificati dalle alternative di preelaborazione.Cliccare qui per scaricare il file.
Discussione
La sindrome da disfunzione multiorgano (MODS) associata alla pancreatite acuta può svilupparsi in un breve periodo dopo il ricovero ospedaliero, in particolare nei pazienti con infiammazione sistemica precoce, danno endoteliale, alterata perfusione tissutale e instabilità metabolica. Il presente protocollo è stato progettato attorno a questa finestra temporale del ricovero perché le prime 24 ore spesso determinano se un paziente debba rimanere sotto osservazione ordinaria nel reparto oppure richieda una rivalutazione più accurata, un monitoraggio intensificato o la preparazione per percorsi di supporto d'organo. I risultati hanno mostrato che variabili biochimiche e della coagulazione comunemente disponibili, quando elaborate attraverso un flusso di modellizzazione bloccato e riproducibile, possono essere organizzate in un punteggio interpretabile per la stratificazione precoce del rischio di MODS nella pancreatite acuta11. Questo approccio è coerente con la realtà clinica secondo cui singoli biomarcatori o classificazioni ritardate della gravità potrebbero non cogliere pienamente il quadro di deterioramento sistemico precoce osservato nella pancreatite acuta ad alto rischio12.
La giustificazione biologica alla base della combinazione di variabili biochimiche e della coagulazione è clinicamente plausibile. La pancreatite acuta grave non è determinata da un singolo percorso isolato; infiammazione sistemica, attivazione endoteliale, fuoriuscita capillare, ipoperfusione renale, attivazione della coagulazione e alterazione della microcircolazione possono rafforzarsi reciprocamente durante il precoce deterioramento. I predittori biochimici conservati riflettevano questo processo multifattoriale. Un livello più basso di albumina può indicare una fuoriuscita vascolare legata all'infiammazione e una ridotta riserva fisiologica, mentre un aumento dell'azotemia e della creatinina è compatibile con ipovolemia, ipoperfusione renale o danno renale precoce. Un valore più basso di calcio, un aumento della lattato deidrogenasi e della glicemia possono riflettere stress metabolico, danno tissutale e un'alterazione infiammatoria sistemica più grave13. I predittori della coagulazione hanno aggiunto un segnale complementare: un tempo di protrombina- rapporto normalizzato internazionale prolungato, un aumento del D-dimero e una conta piastrinica più bassa possono indicare attivazione della coagulazione, turnover del fibrina, consumo piastrinico e compromissione della microcircolazione, prima che si manifesti in modo evidente un'insufficienza d'organo14. L'aumento progressivo dell'incidenza di MODS e degli esiti secondari attraverso le categorie di punteggio suggerisce quindi che il punteggio abbia catturato un modello clinicamente coerente di deterioramento sistemico precoce, piuttosto che anomalie di laboratorio isolate.
Un contributo metodologico fondamentale di questo studio è l'enfasi sulla riproducibilità. Il protocollo rivisto ha fissato la finestra di inclusione, utilizzato il valore di laboratorio più precoce disponibile entro 24 ore, applicato regole esplicite di armonizzazione delle unità, definito soglie di mancanza dei dati, standardizzato la pre-elaborazione e limitato l'ottimizzazione del modello al gruppo di sviluppo. Questi passaggi influenzano direttamente la possibilità di riprodurre il punteggio in diverse strutture. Ad esempio, la segnalazione del D-dimero varia tra laboratori, e non è possibile assumere unità equivalenti al fibrinogeno quando i referti locali riportano valori di D-dimero senza un fattore di conversione validato. Analogamente, i valori di laboratorio mancanti potrebbero riflettere i percorsi diagnostici locali piuttosto che un'assenza casuale di dati15. Per questo motivo, diversi passaggi del protocollo sono essenziali: la regola della finestra basale di 24 ore deve essere applicata in modo coerente, i valori di laboratorio successivi al MODS non devono essere utilizzati nella costruzione dei predittori, la valutazione degli endpoint deve seguire criteri predefiniti per sistema d'organo, i valori di laboratorio devono essere convertiti in unità comuni prima dell'aggregazione, e il gruppo di convalida indipendente non deve essere utilizzato per la selezione delle caratteristiche, la ricalibrazione dei coefficienti o l'ottimizzazione delle soglie16.
Il flusso di lavoro può essere modificato per adattarsi a diversi contesti istituzionali, ma tali modifiche devono essere predeterminate. Se una variabile candidata presenta un'elevata quantità di dati mancanti perché non viene misurata sistematicamente all'ammissione, essa deve essere esclusa dallo sviluppo del modello piuttosto che essere imputata oltre una soglia giustificabile. Se le unità del D-dimero non possono essere armonizzate in unità equivalenti al fibrinogeno, il valore deve essere considerato non armonizzabile invece di essere convertito mediante ipotesi non supportate. Se i laboratori locali utilizzano piattaforme analitiche diverse, l'analisi principale può mantenere i valori clinici assoluti, mentre le analisi di sensibilità possono includere il codice del centro o la piattaforma analitica come fattori di aggiustamento. Se il numero di eventi di MODS è inferiore al previsto, la strategia di modellizzazione dovrebbe privilegiare una riduzione più marcata, un numero minore di predittori mantenuti o una struttura del punteggio più semplice, piuttosto che espandere il modello per adattarlo a segnali instabili17. La risoluzione pratica dei problemi dovrebbe inoltre includere il controllo di se i test della coagulazione vengono richiesti sistematicamente all'ammissione, di se le distribuzioni dei predittori differiscono in modo inatteso tra i centri, di se le soglie di validazione sono state modificati accidentalmente e di se ogni pannello delle figure corrisponde al dataset analitico bloccato18.
I risultati devono essere interpretati tenendo conto di diverse limitazioni. Il gruppo di validazione trattenuto è stato ottenuto dallo stesso dataset retrospettivo multicentrico e pertanto rappresenta una validazione interna trattenuta piuttosto che una validazione esterna indipendente. Il numero di eventi era limitato, aumentando il rischio di mantenimento instabile dei predittori anche nei modelli penalizzati. I rapporti di probabilità descrittivi dopo la selezione sono stati inclusi solo per supportare l'interpretazione clinica e non devono essere considerati come inferenza confermativa. Alcuni componenti dell'endpoint dipendevano dalla qualità della documentazione nei record medici elettronici, e differenze non misurate a livello dei centri nelle pratiche cliniche potrebbero aver influenzato le decisioni riguardo al supporto d'organo. L'analisi della curva decisionale non è stata mantenuta nel set di analisi rivisto; pertanto, il manoscritto non afferma un beneficio clinico netto attraverso diverse probabilità soglia19. Il punteggio non deve inoltre sostituire la valutazione della gravità già stabilita, l'esame clinico ripetuto, l'imaging quando indicato o il giudizio del clinico. Punteggi bassi possono supportare l'osservazione di routine e la rivalutazione standard, ma non escludono un peggioramento successivo; punteggi più alti devono essere interpretati come indicazioni per un monitoraggio più stretto, per una rivalutazione di laboratorio ripetuta e per una preparazione anticipata ai percorsi di supporto d'organo, piuttosto che come prescrizioni terapeutiche fisse20.
Nel complesso, questo studio presenta un flusso di lavoro riproducibile basato su punteggio biochimico-emocoagulativo all'ammissione per la stratificazione precoce del rischio di SDOM nella pancreatite acuta. Il modello penalizzato bloccato e il punteggio basato su punti hanno mostrato una discriminazione coerente e gradienti di rischio ordinati nelle coorti di sviluppo e di validazione indipendente, mentre le analisi di sensibilità hanno suggerito che i risultati principali non sono stati sostanzialmente modificati da alternative prespecificate relative ai dati mancanti o ai valori basali. Il valore principale dell'approccio consiste nell'organizzare i dati di laboratorio disponibili in modo routinario all'ammissione in un segnale precoce di rischio interpretabile, che potrebbe supportare il triage, regolare l'intensità del monitoraggio e preparare percorsi di supporto d'organo21. Studi futuri dovrebbero dare priorità alla validazione prospettica esterna in ospedali con piattaforme di laboratorio diverse, alla valutazione della calibrazione in tempo reale, al confronto con calcolatori elettronici di rischio derivati dallo stesso modello bloccato e alla verifica se percorsi di monitoraggio guidati dal punteggio riducano gli interventi tardivi senza aumentare l'uso inutile delle terapie intensive22.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi rilevanti per questo studio.
Ringraziamenti
Gli autori desiderano ringraziare tutti i medici e il personale di laboratorio coinvolti nella diagnosi, nel trattamento e nella raccolta dei dati dei pazienti affetti da pancreatite acuta. Siamo inoltre grati ai pazienti le cui informazioni cliniche hanno reso possibile questo studio. Il loro contributo è sinceramente apprezzato.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Nome | Nome dell'azienda | Numero di catalogo / URL | Commenti |
| Software statistico R | Fondazione R per il Calcolo Statistico | Versione 4.3.2 https://www.r-project.org/ | Ambiente di calcolo statistico utilizzato per la preelaborazione dei dati, lo sviluppo del modello, la validazione e la generazione di figure. |
| Pacchetto R caret | CRAN / Max Kuhn | Versione 6.0-94 https://cran.r-project.org/package=caret | Utilizzato per la suddivisione stratificata 7:3 tra set di sviluppo e validazione con hold-out tramite la funzione createDataPartition. |
| Pacchetto R glmnet | CRAN / autori di glmnet | Versione 4.1-8 https://cran.r-project.org/package=glmnet | Utilizzato per la regressione logistica penalizzata LASSO con famiglia binomiale e alpha = 1. |
| Pacchetto R mice | CRAN / progetto amices | Versione 3.16.0 https://cran.r-project.org/package=mice | Utilizzato per l'imputazione multipla mediante equazioni concatenate con 20 dataset imputati e 20 iterazioni. |
| Pacchetto R pROC | CRAN / autori di pROC | Versione 1.18.5 https://cran.r-project.org/package=pROC | Utilizzato per l'analisi ROC, la stima dell'AUC, gli intervalli di confidenza e i confronti di DeLong. |
| Serie di analizzatori modulari cobas 8000 | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | Test biochimici e immunochemici. Verificare il modello dell'analizzatore e le informazioni del catalogo rispetto ai registri del laboratorio partecipante prima dell'invio. |
| Analizzatore ematologico automatico XN-1000 | Sysmex Corporation | Modello XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | Variabili dell'emocromo completo, inclusi i conteggi dei globuli bianchi e delle piastrine. Verificare rispetto ai registri del laboratorio partecipante prima dell'invio. |
| Analizzatore automatico di coagulazione CS-5100 | Sysmex Corporation | Modello CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | Variabili della coagulazione, inclusi PT, APTT, fibrinogeno e D-dimero. Verificare rispetto ai registri del laboratorio partecipante prima dell'invio. |
| Analizzatore di gas del sangue ABL90 FLEX PLUS | Radiometer Medical ApS | Modello ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | Misurazione del lattato, se questa piattaforma è stata utilizzata. Verificare rispetto ai registri del laboratorio partecipante prima dell'invio. |
| Sistema di cartella clinica elettronica | Ospedali partecipanti | Specifica per l'istituzione; non applicabile | Utilizzato per recuperare le note di ammissione, le note di avanzamento, i referti di terapia intensiva, le procedure, i parametri vitali e i referti di dimissione. Sostituire con il nome effettivo del fornitore e del sistema quando disponibile. |
| Sistema informativo di laboratorio | Ospedali partecipanti | Specifica per l'istituzione; non applicabile | Utilizzato per recuperare i timestamp di laboratorio, i valori grezzi, le unità e i dati armonizzati. Sostituire con il nome effettivo del fornitore e del sistema quando disponibile. |
| Modulo di valutazione dell'endpoint | Gruppo di studio | Documento personalizzato dello studio; non applicabile | Modulo standardizzato utilizzato da due revisori e da un terzo revisore senior per determinare lo stato e l'insorgenza del MODS. |
| Dizionario dei dati e tabella di conversione delle unità | Gruppo di studio | Documento personalizzato dello studio; non applicabile | Definisce i nomi delle variabili, le unità target, le regole di conversione, i flag per i dati mancanti, i codici dei centri e i formati pronti per l'analisi. |
Riferimenti
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.