La nefropatia diabetica (DN) coinvolge un malfunzionamento mitocondriale. Utilizzando la trascrittomica, la farmacologia delle reti e l'apprendimento automatico, abbiamo identificato CAT, FABP1, MAOA e MAOB come biomarcatori mitocondriali candidati per Ligustri Lucidi Fructus. Nei topi db/db, LLF ha aumentato l'espressione di CAT e MAOA, sostenendo ulteriori indagini meccanicistiche.
Articolo di ricerca
Identificazione di Biomarcatori Candidati Relativi ai Mitochondri del Ligustri Lucidi Fructus nella Nefropatia Diabetica
In questo articolo
Sommario
Abstract
La disfunzione mitocondriale e lo stress ossidativo eccessivo all'interno dei mitocondri sono fattori patologici chiave che determinano il danno tubulare renale nella nefropatia diabetica (DN). Sebbene il Ligustri Lucidi Fructus (LLF) venga tradizionalmente utilizzato per trattare la DN, i meccanismi coinvolti, in particolare quelli relativi ai geni e alle vie associate ai mitocondri, rimangono poco chiari. In questo studio è stata effettuata un'analisi dell'espressione differenziale del dataset GSE142025 per identificare geni con espressione differenziale (DEG) associati alla DN. I geni caratteristici sono stati selezionati incrociando i risultati ottenuti da quattro modelli di apprendimento automatico. I geni che mostravano una differenza significativa nell'espressione e un profilo di espressione coerente in entrambi i dataset sono stati ulteriormente valutati mediante analisi della curva ROC (caratteristica operativa del ricevitore). Quelli con un'area sotto la curva (AUC) > 0,7 in entrambi i dataset sono stati definiti biomarcatori candidati. Sono state eseguite analisi di arricchimento funzionale, infiltrazione immunitaria, costruzione di reti e docking molecolare. È stato utilizzato un modello murino di DN per valutare glicemia, microalbuminuria, istopatologia ed espressione mediante RT-qPCR dei biomarcatori candidati. CAT e MAOA sono risultati significativamente sovraespressi in vivo. I biomarcatori candidati erano arricchiti in vie associate alla funzione del ribosoma, alla degradazione di valina, leucina e isoleucina, alle interazioni citochina-recettore per citochine e ai perossisomi. Essi mostravano correlazione negativa con le cellule T CD8+ e i mastociti attivati, e correlazione positiva con le cellule NK attivate e le cellule B naive. La taxifolina, il beta-sitosterolo e l'eriodictiolo hanno mostrato energie di legame inferiori a -5 kcal/mol con i biomarcatori candidati. CAT e MAOA rappresentano candidati promettenti che meritano ulteriori indagini meccanicistiche.
Introduzione
La nefropatia diabetica (DN), la principale causa di malattia renale terminale in tutto il mondo, è una delle complicanze più comuni del diabete mellito. Dal punto di vista patologico, è caratterizzata da un'eccessiva accumulazione di matrice extracellulare sia nei compartimenti glomerulari che tubulari, insieme a un ispessimento e una sclerosi dei vasi sanguigni intrarenali2. La DN è comunemente associata a proteinuria e ipertensione3. Il suo sviluppo è strettamente legato a un danno delle cellule endoteliali vascolari, a una risposta infiammatoria esacerbata e a uno stress ossidativo accentuato causato da un'iperglicemia prolungata4. L'incidenza della DN è in aumento a livello globale, in particolare tra i soggetti diabetici di mezza età e anziani. Con il progredire della malattia, essa può portare a insufficienza renale terminale e persino a complicanze cardiovascolari, compromettendo significativamente la qualità della vita e la prognosi dei pazienti5. Nonostante i progressi compiuti negli approcci diagnostici e terapeutici per la DN, biomarcatori candidati precoci e accurati per la diagnosi restano ancora sfuggenti, e mancano strategie terapeutiche efficaci in grado di invertire i processi patologici. Pertanto, esiste un'urgente necessità di sviluppare nuovi farmaci specifici anti-DN.
I mitocondri sono fondamentali per la bioenergetica cellulare, la sintesi di precursori metabolici, l'omeostasi del calcio, la produzione di specie reattive dell'ossigeno (ROS), la segnalazione immunitaria e l'apoptosi, tutti processi essenziali per mantenere la stabilità cellulare e dell'organismo6. Essendo le centrali energetiche della cellula, i mitocondri svolgono un ruolo cruciale in processi fondamentali come la glicolisi, il ciclo dell'acido tricarbossilico e la fosforilazione ossidativa7. L'obesità altera il ciclo di Krebs e la catena respiratoria mitocondriale, portando a disfunzione mitocondriale e aumento della produzione di ROS. L'elevato livello di ROS nella catena respiratoria mitocondriale può indurre stress ossidativo, che amplifica la risposta infiammatoria associata all'obesità e promuove l'apoptosi8. Ricerche recenti hanno evidenziato il ruolo significativo della disfunzione mitocondriale nella patogenesi e nel decorso della DN, inclusi disturbi del metabolismo energetico, eccessiva generazione di ROS e potenziamento della segnalazione apoptotica9. La disfunzione mitocondriale cronica accelera il progresso della malattia renale10. Pertanto, il miglioramento della funzione mitocondriale potrebbe rappresentare una strategia protettiva fondamentale contro la DN.
Ligustri Lucidi Fructus (LLF) è un frutto secco e maturo della famiglia delle Luteaceae, noto per le sue proprietà nutritive per il fegato e i reni, nonché per la capacità di scurire i capelli e migliorare la vista. È stato identificato un eteropolisaccaride di origine naturale estratto dal LLF, che ha rivelato un potenziale protettivo nei confronti della fibrosi renale11. Negli ultimi anni, l'uso del LLF nel trattamento del DN ha ricevuto crescente attenzione, con effetti renoprotettivi significativi dimostrati11,12,13. Inoltre, la complessa relazione tra LLF e i mitocondri è stata ampiamente studiata e confermata. In particolare, uno studio ha dimostrato che il LLF esercita i suoi effetti benefici modulando la funzione mitocondriale attraverso l'attivazione della via di segnalazione AMPK14. Questo meccanismo protegge efficacemente i mitocondri dai danni causati dallo stress ossidativo. Questi risultati sottolineano ulteriormente il ruolo fondamentale del LLF nel mantenimento del metabolismo energetico cellulare e nel miglioramento della resistenza delle cellule allo stress ossidativo. Tuttavia, il meccanismo terapeutico preciso, in particolare riguardo al recupero della funzione mitocondriale, rimane ancora poco chiaro.
L'obiettivo di questo studio era chiarire i meccanismi biologici alla base dell'effetto terapeutico di LLF sulla funzione mitocondriale nel DN. Sono state consultate banche dati pubbliche mediante l'uso di strumenti di bioinformatica per identificare biomarcatori candidati associati agli effetti nefroprotettivi di LLF, integrando dati trascrittomici e informazioni sui principi attivi. Ulteriori analisi, tra cui infiltrazione immunitaria, associazione con caratteristiche cliniche, modificazione dell'RNA mediante m6A, arricchimento funzionale, costruzione di reti regolatorie e docking molecolare, hanno suggerito che questi biomarcatori candidati svolgono un ruolo fondamentale nella regolazione della funzione mitocondriale durante il trattamento del DN. Una validazione in vivo ha ulteriormente confermato la loro importanza. Questa analisi completa approfondisce la comprensione dei meccanismi attraverso cui LLF tratta il DN e fornisce una base solida per lo sviluppo di nuovi bersagli terapeutici basati sulla disfunzione mitocondriale.
Protocollo
Raccolta dei dati
La matrice di espressione genica e i dati clinici corrispondenti per i set di dati GSE142025 e GSE96804, relativi alla DN, sono stati recuperati dal database Gene Expression Omnibus (GEO) (https://www.ncbi.nlm.nih.gov/geo/)15. Il set di addestramento (GSE142025) include campioni di tessuto renale di 27 pazienti con DN e di nove controlli, sequenziati mediante la piattaforma GPL20301. Il set di validazione (GSE96804) comprende dati di sequenziamento di 41 pazienti con DN e 20 controlli, elaborati utilizzando la piattaforma GPL17586. Entrambi i set di dati si concentrano sul tessuto renale; il set di dati GSE96804 esamina specificamente il glomerulo, l'unità primaria di filtrazione del rene (Figura 1). Il set di dati GSE142025 (set di addestramento) comprende campioni di tessuto renale intero e fornisce una panoramica completa del paesaggio trascrittomico della DN. Il set di dati GSE96804 (set di validazione), invece, si concentra specificamente sul tessuto glomerulare, che rappresenta il sito principale del danno alla filtrazione glomerulare. Poiché questi due set di dati non sono stati direttamente uniti a causa delle differenze nella piattaforma e nel tessuto, non è stata applicata alcuna correzione per l'effetto di batch. Al contrario, è stata effettuata una validazione incrociata tra i set di dati in modo indipendente. Sono stati selezionati come candidati robusti i geni con variazioni direzionali coerenti e un'area sotto la curva (AUC) superiore a 0,7 in entrambi i set di dati, a sostegno della generalizzabilità attraverso i diversi compartimenti renali.
Un totale di 1.136 geni mitocondriali (MRGs) è stato estratto dal database MitoCarta3.0 (https://www.broadinstitute.org/mitocarta). I principi attivi di LLF sono stati predetti utilizzando il database Traditional Chinese Medicine Systems Pharmacology (TCMSP) (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php), sulla base di una soglia di biodisponibilità orale (OB) ≥30% e di una soglia di somiglianza ai farmaci (DL) ≥0,18. Successivamente, i geni bersaglio potenziali per i costituenti attivi sono stati predetti utilizzando il database Swiss Target Prediction (http://www.swisstargetprediction.ch/).
Analisi dell'espressione differenziale
L'analisi dell'espressione differenziale di GSE142025 (DN rispetto a controllo) è stata eseguita utilizzando il pacchetto limma (v3.54.1), con criteri di significatività stabiliti a P.adj < 0,05 e |log2FoldChange| > 0,516. I grafici a vulcano e le mappe termiche sono stati visualizzati rispettivamente mediante i pacchetti ggplot2 (v 3.3.6) e ComplexHeatmap (v 2.14.0)17,18. I DEG, i MRG e i geni bersaglio potenziali dei principi attivi sono stati incrociati, e i geni sovrapposti sono stati definiti come geni candidati. La rete che collega i principi attivi ai geni candidati è stata costruita utilizzando il software Cytoscape (v 3.9.0)19.
Analisi di arricchimento funzionale e costruzione della rete di interazione proteina-proteina (PPI)
Le analisi di arricchimento di Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) per i geni candidati sono state eseguite utilizzando il pacchetto clusterProfiler (v 4.6.2) per esplorare le loro funzioni biologiche e i percorsi di segnalazione associati (P.adjust < 0,05). I geni candidati sono stati quindi inseriti nel database STRING (https://cn.string-db.org/) per recuperare le relazioni di interazione proteina-proteina (livello di confidenza ≥ 0,4), seguite dalla costruzione di una rete PPI utilizzando Cytoscape (v 3.9.0)20.
Apprendimento automatico
Sono stati implementati quattro algoritmi di apprendimento automatico, inclusi foresta casuale (RF), k-nearest neighbor (KNN), minimi quadrati parziali (PLS) e macchina a vettori di supporto con kernel radiale (SVM), utilizzando il pacchetto caret (v6.0-93) basato sul dataset GSE142025. I geni candidati identificati nell'analisi precedente sono stati utilizzati come variabili predittive, mentre lo stato della malattia (DN o controllo) è stato utilizzato come outcome. Per il modello KNN, è stata implementata una cross-validazione a 10 ripetizioni mediante la funzione trainControl, con tuneLength = 10. Il modello RF è stato adattato con 20 alberi (ntree = 20); i modelli PLS e SVM sono stati adattati utilizzando le impostazioni previste nel flusso di lavoro originale di caret.
Le distribuzioni dei residui del modello sono state valutate utilizzando il pacchetto DALEX (v2.4.3). Successivamente, è stata eseguita un'analisi delle variabili basata sulla permutazione mediante la funzione variable_importance di DALEX, specificando l'errore quadratico medio (RMSE) come funzione di perdita. Il dropout_loss risultante rappresenta l'RMSE ottenuto dopo la permutazione della variabile corrispondente21,22. Nel flusso di lavoro analitico originale, sono state mantenute le variabili con un dropout loss < 0,281 in tutti i modelli, e i geni comuni a tutti e quattro i modelli sono stati definiti come geni caratteristici consensuali per la successiva validazione.
I quattro modelli di apprendimento automatico sono stati utilizzati principalmente per la priorizzazione delle caratteristiche piuttosto che per la costruzione di un classificatore clinico finale. Di conseguenza, la discriminazione diagnostica è stata successivamente valutata a livello di singolo gene mediante analisi ROC sia nei dati di scoperta che in quelli di convalida.
Identificazione di biomarcatori candidati
Nei dataset GSE142025 e GSE96804, le differenze di espressione nei geni caratteristici tra campioni DN e controlli sono state valutate mediante il test di Wilcoxon. Solo i geni con espressione differenziale significativa (P < 0,05) e tendenze di espressione concordanti nei due dataset sono stati selezionati per l'analisi della curva ROC (caratteristica operativa del ricevitore). Il pacchetto pROC (v1.18.0) è stato utilizzato per generare le curve ROC e calcolare l'area sotto la curva (AUC); i geni con AUC > 0,7 in entrambi i dataset sono stati classificati come biomarcatori candidati23.
Analisi dell'arricchimento di gruppi di geni (GSEA)
Le funzioni biologiche e le vie di segnalazione associate ai biomarcatori candidati sono state ulteriormente analizzate mediante GSEA sul dataset GSE142025. In primo luogo, è stata eseguita un'analisi della correlazione di Spearman tra i biomarcatori candidati e tutti gli altri geni utilizzando il pacchetto psych (v2.2.9).24. I coefficienti di correlazione sono stati calcolati e ordinati (da alto a basso). L'insieme di geni di riferimento era c2.cp.kegg.v2023.1.Hs.symbols.gmt del Molecular Signatures Database (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). Successivamente, è stata effettuata un'analisi GSEA per valutare l'arricchimento dei geni ordinati nell'insieme di geni di riferimento utilizzando il pacchetto clusterProfiler (v4.6.2). È stata applicata la correzione per confronti multipli. tramite il metodo FDR e aggiustato P-valori (indicati come P.ajustati) sono stati considerati significativi se < 0.05.
Analisi delle modifiche m6A
Per indagare le modifiche di metilazione dell'RNA dei biomarcatori candidati, è stato utilizzato il database SRAMP (http://www.cuilab.cn/sramp/) per prevedere i siti di modifica m6A sui biomarcatori candidati, concentrandosi su posizioni ad alta affidabilità all'interno delle loro strutture secondarie. Successivamente, il database ENCORI (https://starbase.sysu.edu.cn/) è stato impiegato per identificare le proteine modificate da m6A che interagiscono con i biomarcatori candidati, utilizzando il parametro |HepG2 (shRNA)| > 1 per selezionare le proteine chiave. Il database RPISeq (http://pridb.gdcb.iastate.edu/RPISeq/) è stato quindi utilizzato per prevedere la probabilità di interazioni tra le proteine chiave e i biomarcatori candidati. Le sequenze di RNA di entrambi sono state caricate in formato testo semplice per generare punteggi di previsione dei classificatori RF e SVM. Un'interazione è stata considerata significativa quando il punteggio superava 0,525. L'analisi SRAMP è stata eseguita con soglia impostata su ‘High’ per la previsione dei siti m6A, utilizzando la modalità ‘Transcript’ e parametri predefiniti. L'analisi ENCORI ha utilizzato la funzione di interazione ‘miRNA-mRNA’ con il parametro ‘HepG2 (shRNA)’ > 1. L'analisi RPISeq ha impiegato il classificatore RF con parametri predefiniti; punteggi > 0,5 indicavano un'interazione positiva. Si tratta di previsioni computazionali, non di evidenze sperimentali di modifiche m6A o di interazioni RNA-proteina nel tessuto renale. Il criterio HepG2 shRNA deriva dai set di dati precalcolati di ENCORI e potrebbe non riflettere una regolazione specifica del rene.
Analisi dell'infiltrazione immunitaria
L'algoritmo CIBERSORT è stato applicato per stimare le proporzioni di 22 tipi di cellule immunitarie sia nei campioni di controllo che in quelli con DN provenienti da GSE142025, con visualizzazione tramite una mappa termica generata utilizzando il pacchetto ggplot2 (v3.3.6)26. CIBERSORT è stato eseguito utilizzando la matrice di firma LM22, con 1.000 permutazioni e normalizzazione quantilica disabilitata (come raccomandato per i dati di microarray). Sono stati mantenuti per ulteriori analisi i campioni con p di CIBERSORT < 0,05. CIBERSORT stima le frazioni di cellule immunitarie a partire dall'espressione tissutale renale bulk, il che non consente di risolvere l'infiltrazione specifica per compartimento (ad esempio, glomerulare rispetto a tubulo-interstiziale) né di distinguere i leucociti infiltranti dalle cellule immunitarie residenti. Pertanto, le correlazioni riportate sono a livello tissutale e dovrebbero essere validate mediante metodi spaziali. È stata eseguita un'analisi di correlazione di Spearman tra le cellule immunitarie differenzialmente abbondanti e i biomarcatori candidati utilizzando il pacchetto psych.
Costruzione di reti e docking molecolare
Gli microRNA (miRNA) che interagiscono con i biomarcatori candidati sono stati predetti utilizzando il database miRNet (https://www.mirnet.ca). Successivamente, gli RNA non codificanti lunghi (lncRNA) che bersagliano i miRNA identificati sono stati predetti attraverso i database TarBase (http://www.diana.pcbi.upenn.edu/tarbase) e starbase (http://starbase.sysu.edu.cn/). Sono stati selezionati gli lncRNA comuni a entrambi i database per la costruzione della rete. Una rete regolatoria lncRNA-miRNA-mRNA è stata quindi costruita utilizzando il software Cytoscape. Sono stati scelti ingredienti attivi potenziali che bersagliano i biomarcatori candidati per costruire una rete tra ingredienti attivi e biomarcatori. Inoltre, gli ingredienti attivi, i biomarcatori candidati e i percorsi identificati nell'analisi GSEA sono stati incorporati in Cytoscape per creare una rete tra ingredienti attivi, biomarcatori e percorsi.
È stata eseguita un'analisi di docking molecolare per valutare l'affinità di legame tra i potenziali principi attivi e i biomarcatori candidati. Le strutture tridimensionali delle proteine biomarcatori sono state ottenute dal Research Collaboratory for Structural Bioinformatics Protein Data Bank (RCSB PDB, https://www.rscb.org/pdb) in formato file PDB. Le strutture bidimensionali dei potenziali principi attivi sono state recuperate in formato SDF dal database PubChem (http://pubchem.ncbi.nlm.nih.gov). Il docking molecolare è stato effettuato utilizzando la piattaforma CB-Dock (http://clab.labshare.cn/cb-dock/php/blinddock.php). Un'energia di legame inferiore a -5 kcal/mol indicava una forte affinità di legame27.
Preparazione e autenticazione di Ligustri Lucidi Fructus
In questo contesto, Ligustri Lucidi Fructus (LLF) indica il frutto secco maturo di Ligustrum lucidum W. T. Aiton (Oleaceae). Il materiale botanico è stato autenticato secondo il Farmacopea Cinese, e un esemplare depositato con numero voucher 20240506,20240911,20241103 è stato conservato presso l'Università di Medicina Tradizionale Cinese dello Shanxi.
Per la preparazione della decottura, 200 g di fette qualificate di LLF sono state immerse in 1.000 mL di acqua distillata per 30 min a temperatura ambiente. La miscela è stata portata a ebollizione vigorosa e poi fatta sobbollire delicatamente per 60 min. È stato raccolto il filtrato, e i materiali erbacei residui sono stati sottoposti nuovamente a decottura con altri 1.000 mL di acqua distillata per 60 min. I due filtrati sono stati combinati, filtrati, centrifugati e concentrati sotto pressione ridotta per ottenere una concentrazione finale di 1 g di droga grezza/mL (volume totale di 100 mL). La decottura preparata è stata conservata a 4 °C per un uso a breve termine o a −20 °C per la conservazione a lungo termine. La qualità del LLF e della sua decottura è stata rigorosamente identificata e verificata secondo gli standard della Farmacopea Cinese per garantire affidabilità e riproducibilità sperimentale.
Per l'identificazione qualitativa, è stata eseguita una cromatografia su strato sottile. In breve, un volume appropriato di decotto preparato è stato centrifugato ed il soprannatante è stato estratto con metanolo. Dopo la filtrazione, la soluzione del campione e la soluzione standard di riferimento di specnuezhenide sono state applicate sulla stessa piastra di gel di silice G. Dopo lo sviluppo, l'essiccazione e l'ispezione sotto luce ultravioletta, la macchia della soluzione del campione ha mostrato colore e posizione coerenti con il composto di riferimento, confermando la presenza del componente bioattivo caratteristico del LLF.
Per il controllo di qualità quantitativo, è stata eseguita la rilevazione mediante cromatografia liquida ad alte prestazioni. L'analisi è stata effettuata utilizzando una colonna C18 con metanolo–acqua come fase mobile. La lunghezza d'onda di rilevazione è stata impostata a 224 nm. Il contenuto di specnuezhenide nel decotto è stato determinato in base alla curva standard. I risultati hanno dimostrato una composizione chimica stabile e uniforme del decotto preparato, garantendo una qualità costante del farmaco durante tutto l'esperimento di intervento sugli animali.
Esperimenti sugli animali
Dodici topi maschi di ceppo db/db di grado SPF (8-9 settimane di età) e sei topi db/m di pari età sono stati mantenuti presso il laboratorio animale SPF dell'Università di Medicina Tradizionale Cinese dello Shanxi. Prima degli esperimenti, gli animali sono stati adattati per 7 giorni in un ciclo luce/buio di 12 ore/12 ore con ad libitum accesso a cibo e acqua. Lo studio è stato approvato dal Comitato Etico dell'Università di Medicina Tradizionale Cinese di Shanxi (Numero di approvazione: 2022DW167). Gli animali che mostravano >I topi che presentavano una perdita di peso corporeo del 20%, uno stato moribondo o un'incapacità di accedere a cibo o acqua sono stati sottoposti a eutanasia in modo umano prima del termine previsto dello studio. Al termine dello studio, tutti i topi rimanenti sono stati sottoposti a eutanasia mediante iniezione intraperitoneale di sodio pentobarbitalico seguita da dislocazione cervicale, in conformità ai protocolli istituzionali.
Al termine del periodo di acclimatamento, l'instaurazione di un modello di DN nei topi db/db è stata confermata da un livello di glucosio nel sangue prelevato dalla vena della coda ≥ 16 mmol/L e da microalbuminuria, indicata da una prova positiva con striscia reattiva per microalbuminuria urinaria. Dopo il corretto instaurazione del modello di DN, i topi db/db sono stati suddivisi casualmente in due gruppi (n = 6 per gruppo): il gruppo modello di DN (DN) e il gruppo trattato con LLF (Trattamento). Inoltre, sono stati utilizzati topi db/m (n = 6) come gruppo di controllo (Controllo). La dose è stata scelta in base a precedenti studi farmacodinamici di LLF in ratti diabetici ed è stata convertita nella dose equivalente per l'uomo utilizzando la normalizzazione per area della superficie corporea28. Ai gruppi Controllo e DN è stata somministrata acqua distillata, mentre al gruppo trattato è stata somministrata LLF a 3,5 g/kg per 8 settimane. Dopo 8 settimane di trattamento, tutti i topi sono stati soppressi per raccogliere siero, urina e tessuto renale da sottoporre ad analisi successive.
Indicatori ematici e urinari
I livelli sierici di glucosio sono stati analizzati utilizzando un analizzatore biochimico del sangue completamente automatico. La concentrazione di microalbumina urinaria è stata misurata seguendo le istruzioni del kit (File Supplementare 1).
Osservazione patologica dei tessuti renali di topo
I tessuti renali sono stati preparati per l'esame istopatologico. Dopo la fissazione in paraformaldeide al 4%, i tessuti sono stati lavati, disidratati, inclusi in paraffina e sezionati. Successivamente è stata eseguita la colorazione con ematossilina ed eosina (HE) e le sezioni colorate sono state esaminate al microscopio ottico per valutare le alterazioni patologiche.
Reazione a catena della polimerasi quantitativa con trascrizione inversa (RT-qPCR)
La RT-qPCR è stata utilizzata per determinare l'espressione dei biomarcatori candidati nel tessuto renale di topo. L'RNA totale è stato estratto seguendo le istruzioni del produttore, dopodiché sono state valutate la concentrazione e la qualità dell'RNA (Tabella 1). Il cDNA è stato sintetizzato dall'RNA estratto utilizzando il Kit per la sintesi di cDNA. L'amplificazione è stata eseguita con le coppie di primer elencate nella Tabella 1, utilizzando GAPDH come gene di riferimento. I livelli di espressione relativi sono stati calcolati con il metodo 2−ΔΔCt13,26.
Analisi statistica
Tutte le analisi statistiche sono state eseguite utilizzando il software R (versione 4.2.2) insieme al software necessario per le corrispondenti procedure sperimentali. A meno che non indicato diversamente, tutti i test statistici erano a due code e le differenze sono state considerate statisticamente significative per P < 0,05. L'analisi del differenziale di espressione trascrittomica è stata effettuata utilizzando il pacchetto limma. I geni con un valore di P aggiustato < 0,05 e un valore assoluto del log2fold change maggiore di 0,5 sono stati definiti come differenzialmente espressi.
Per i confronti dell'espressione dei geni candidati tra campioni indipendenti di DN e controlli, sono stati utilizzati test non parametrici di Wilcoxon rank-sum quando indicato nel flusso analitico originale. Le correlazioni tra biomarcatori candidati e frazioni di cellule immunitarie sono state valutate mediante correlazione rank di Spearman.
I dati sperimentali sono espressi come media ± DS. Il confronto tra i tre gruppi indipendenti di animali è stato effettuato mediante analisi della varianza ad un fattore quando erano soddisfatte le assunzioni dell'analisi parametrica. Per i confronti post hoc, è stato utilizzato il test della differenza minima significativa quando le varianze erano omogenee, mentre è stato impiegato il test T3 di Dunnett quando le varianze non erano omogenee. Le misurazioni farmacodinamiche alla baseline e alla settimana 8 sono state analizzate e presentate separatamente; non è stata effettuata alcuna inferenza riguardo all'interazione gruppo-per-tempo. Gli script R e i dati grezzi utilizzati per le analisi bioinformatiche e di apprendimento automatico sono forniti nel File Supplementare 1.
Risultati
Per indagare in modo sistematico potenziali biomarcatori legati ai mitocondri per LLF nel trattamento del DN, abbiamo progettato un flusso di lavoro analitico in quattro fasi (Figura 1). Nella Fase I, abbiamo integrato dati trascrittomici del set GSE142025 (set di addestramento, rene intero, n=36) e GSE96804 (set di validazione, glomerulo, n = 61) con 1.136 geni legati ai mitocondri provenienti dal database MitoCarta 3.0 e 517 bersagli predetti di 9 ingredienti attivi del database TCMSP. L'intersezione di questi tre insiemi genici ha prodotto 9 geni candidati. Nella Fase II, sono stati applicati quattro modelli di machine learning (RF, KNN, PLS e SVM) per selezionare i geni caratterizzanti, utilizzando un valore di RMSE < 0,281 come soglia. Una validazione incrociata mediante analisi ROC (AUC > 0,7 in entrambi i set) ha identificato quattro biomarcatori candidati: CAT, FABP1, MAOB e MAOA. Nella Fase III, abbiamo effettuato un'analisi GSEA per identificare i pathway KEGG arricchiti, un'analisi di infiltrazione immunitaria mediante CIBERSORT, una previsione di modificazione m6A e costruito reti lncRNA-miRNA-mRNA, reti ingrediente attivo–biomarcatore e reti ingrediente attivo–biomarcatore–pathway, seguite da docking molecolare. Nella Fase IV, gli effetti farmacodinamici di LLF e le variazioni nell'espressione mRNA dei quattro biomarcatori candidati sono stati valutati in un modello murino db/db di DN.
Selezione di geni candidati per il trattamento del DN con LLF
Nel dataset GSE142025, sono stati identificati 3.810 geni differenzialmente espressi (DEG) tra i gruppi DN e controllo, inclusi 1.904 DEG upregolati e 1.906 DEG downregolati (Figura 2A,B). Tredici ingredienti attivi provenienti da LLF sono stati predetti utilizzando il database TCMSP, ovvero beta-sitosterolo, kaempferolo, taxifolina, Lucidumoside D, Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetato, eriodictiolo, siringaresinolo diglucoside_qt, Lucidusculina, Olitoriside, Olitoriside_qt, luteolina e quercetina (Tabella 2). Quattro ingredienti attivi—Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetato, siringaresinolo diglucoside_qt e Olitoriside_qt—non hanno predetto alcun gene target potenziale, mentre i restanti nove ingredienti hanno predetto 517 geni target potenziali. Sovrapponendo i 3.810 DEG, 1.136 MRG e 517 geni target potenziali, sono stati identificati nove geni candidati: GPX1, BAX, CASP8, MAOA, MAOB, CAT, AKR1B10, ALDH2 e FABP1 (Figura 2C). Successivamente, è stata costruita una rete tra ingredienti attivi e geni candidati (Figura 2D). Questi nove geni candidati sono risultati arricchiti in 341 termini GO, inclusi risposta a sostanze tossiche, processo catabolico di composti idrossilici organici e detossificazione cellulare (Figura 2E). Inoltre, erano associati a 52 vie metaboliche KEGG, come il metabolismo del triptofano, le vie neurodegenerative e il metabolismo dell'istidina (Figura 2F).
Selezione di biomarcatori candidati per il trattamento della DN nella LLF
La rete di interazione proteina-proteina (PPI) ha rivelato sette nodi e otto connessioni, con MAOA, ALDH2, MAOB e AKR1B10 che interagiscono (Figura 3A). I geni con valori di RMSE inferiori a 0,281 in quattro modelli di apprendimento automatico sono stati identificati come geni caratterizzanti: CAT, MAOB, MAOA, BAX e FABP1 (Figura 3B-E). L'analisi dell'espressione ha mostrato che CAT, FABP1, MAOB e MAOA presentavano differenze significative tra i gruppi DN e controllo ed erano coerenti sia nel dataset GSE142025 che in GSE96804 (Figura 3F,G). Inoltre, i loro valori di AUC nell'analisi della curva ROC superavano 0,7 in entrambi i dataset, indicando che questi geni potrebbero distinguere efficacemente i campioni DN dai campioni di controllo e fungere da biomarcatori candidati per il trattamento della DN nella LLF (Figura 4A-H).
Significativo arricchimento di biomarcatori candidati in percorsi infiammatori e legati al sistema immunitario
L'analisi GSEA ha identificato quattro biomarcatori candidati notevolmente arricchiti nel percorso di segnalazione dei chemochine e nelle interazioni citochina-recettore di citochina (Figura 5A-D). Tra questi, il percorso di segnalazione della perossidasi ha mostrato un'associazione significativa con CAT, MAOA e MAOB.
Correlazione tra biomarcatori candidati e cellule immunitarie
Sono state osservate differenze significative nell'espressione di nove tipi di cellule immunitarie—cellule B naive, macrofagi M0, macrofagi M1, macrofagi M2, mastociti attivati, cellule NK attivate, cellule T CD4+ a memoria in stato di riposo, cellule T CD4+ naive e cellule T CD8+—tra i campioni DN e quelli di controllo (P < 0,05) (Figura 6A,B). È stata riscontrata una correlazione positiva significativa (cor = 0,6) tra le cellule B naive e le cellule NK attivate, mentre è stata rilevata una correlazione negativa significativa (cor = -0,69) tra le cellule B naive e i mastociti attivati (Figura 6C). Tutti i biomarcatori candidati hanno mostrato forti correlazioni negative con le cellule T CD8+ e i mastociti attivati, e correlazioni positive con le cellule NK attivate e le cellule B naive (Figura 6D).
Interazione tra proteine m6A modificate chiave e biomarcatori candidati
La modificazione della metilazione dell'RNA m6A influisce profondamente sulla sintesi e sul metabolismo dell'RNA ed è implicata nella patogenesi di diverse malattie29. Le posizioni dei siti di modificazione m6A nei biomarcatori candidati e le loro posizioni ad alta affidabilità nelle strutture secondarie sono illustrate in Figura 7A-H. Un'ulteriore analisi ha rivelato che le proteine chiave modificate da m6A che interagiscono con CAT includevano AQR e RBM22, mentre FABP1 interagiva sia con SF3A3 che con AQR. MAOA è risultata interagire con IGF2BP3 e IGF2BP2, e MAOB con TIA1 (Tabella 3).
Predizioni di legame in silico favorevoli per taxifolina, beta-sitosterolo ed eriodictiolo nel trattamento della DN con LLF
In miRNet, si è previsto che CAT interagisca con 24 miRNA, mentre FABP1 era associato a cinque miRNA. Inoltre, MAOB e MAOA erano collegati rispettivamente a 29 e 26 miRNA. Tra questi, 23 lncRNA sono state identificate in entrambi i database TarBase e Starbase. È stata quindi costruita una rete regolatoria lncRNA-miRNA-mRNA, comprendente quattro biomarcatori candidati, 74 miRNA e 23 lncRNA (Figura 8A). Gli ingredienti attivi potenziali che bersagliano i biomarcatori candidati includevano luteolina, beta-sitosterolo, eriodictiolo, kaempferolo, quercetina e taxifolina (Figura 8B). Inoltre, è stata stabilita una rete ingrediente attivo-biomarcatore-via metabolica basata sugli ingredienti attivi, i biomarcatori candidati e le prime cinque vie identificate nell'analisi GSEA (Figura 8C). Ad esempio, la taxifolina bersagliava CAT nella via del perossisoma. Le energie di legame tra CAT e taxifolina (-8,8 kcal/mol), FABP1 e beta-sitosterolo (-8,1 kcal/mol), e MAOB ed eriodictiolo (-9,8 kcal/mol) erano tutte inferiori a -5 kcal/mol, suggerendo forti affinità tra questi biomarcatori candidati e i rispettivi ingredienti attivi27. Taxifolina, beta-sitosterolo ed eriodictiolo sono stati identificati come ingredienti attivi potenziali con predizioni di legame in silico favorevoli nel trattamento della DN con LLF (Figura 8D-F). Tuttavia, essi sono riportati come costituenti predetti da database e non come intermedi bioattivi confermati degli effetti osservati in vivo.
Convalidare i biomarcatori candidati nel modello murino di DN
Valutazione farmacodinamica di LLF nel trattamento di topi con DN
Durante il periodo di somministrazione, sono stati monitorati i livelli di glucosio nel sangue e di microalbumina urinaria nei topi (Figura 9A-D). Rispetto al gruppo di controllo, i livelli di glucosio nel sangue e di microalbumina urinaria nel gruppo modello di DN sono risultati significativamente aumentati (P < 0,01); rispetto al gruppo modello di DN, i livelli di glucosio nel sangue nei topi del gruppo trattato sono risultati significativamente ridotti dopo 4 settimane di somministrazione (P < 0,01) e i livelli di microalbumina urinaria nei topi del gruppo trattato sono risultati significativamente ridotti dopo 8 settimane di somministrazione (P < 0,05). I risultati suggeriscono che LLF potrebbe essere benefico nel trattamento della DN.
Valutazione patologica di LLF nel trattamento di topi con DN
Dopo la colorazione con ematossilina-eosina, il gruppo di controllo ha mostrato strutture glomerulari chiare nel tessuto renale. Al contrario, il gruppo modello con DN ha evidenziato pirosi nucleare e ipercromasia glomerulare, insieme a infiltrazione di cellule infiammatorie attorno ai glomeruli, rispetto al gruppo normale. Il trattamento con LLF ha attenuato i danni patologici nei reni di topi db/db (Figura 9E).
Analisi RT-PCR dell'espressione dei biomarcatori candidati nei topi con DN
Dopo l'efficace creazione di un modello murino di DN e l'osservazione di un significativo miglioramento dei sintomi con il trattamento LLF, è stata ulteriormente utilizzata la RT-qPCR per analizzare le variazioni dei biomarcatori candidati. Rispetto al gruppo di controllo, il gruppo DN ha mostrato un'espressione significativamente ridotta di CAT e MAOA (P < 0,05 o P < 0,001). Al contrario, il gruppo trattato ha mostrato un'espressione di CAT e MAOA significativamente più elevata rispetto al gruppo DN (P < 0,05). Tuttavia, non sono state osservate differenze statisticamente significative nell'espressione di MAOB e FABP1 tra i gruppi (Figura 9F-I).
Disponibilità dei dati
I set di dati sull'espressione genica analizzati in questo studio sono disponibili pubblicamente nel Gene Expression Omnibus (GEO) con i numeri di accessione GSE142025 e GSE96804. Gli script R utilizzati per le analisi bioinformatiche, insieme ai dati sperimentali di origine (glicemia, microalbuminuria urinaria e dati di RT-qPCR), sono forniti nel File Supplementare 1. Tutti gli altri database, software e risorse web utilizzati in questo studio sono elencati nella Tabella dei Materiali.
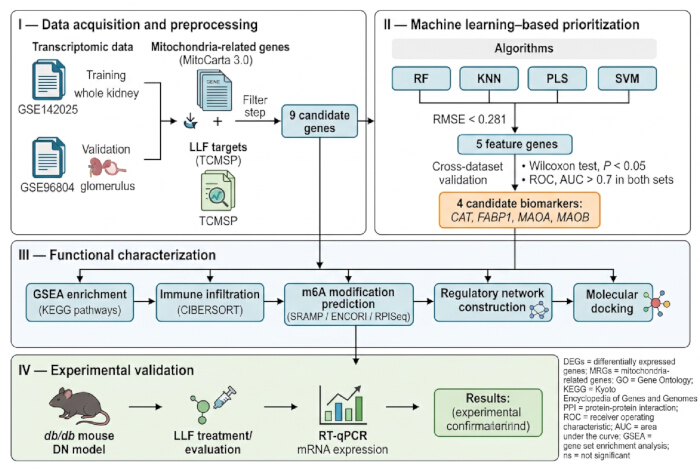
Figura 1: Flusso di lavoro dello studio. I set di dati trascrittomici, i geni associati ai mitocondri e le previsioni dei bersagli di Ligustri Lucidi Fructus sono stati integrati per identificare i geni candidati. Quindi, quattro algoritmi di apprendimento automatico sono stati utilizzati per stabilire una gerarchia dei geni caratteristici, seguiti da una validazione incrociata tra dataset, una caratterizzazione funzionale e una validazione sperimentale in topi db/db. Abbreviazioni: DN = nefropatia diabetica; DEGs = geni differenzialmente espressi; MRGs = geni associati ai mitocondri; LLF = Ligustri Lucidi Fructus; RF = foresta casuale; KNN = k-vicini più prossimi; PLS = minimi quadrati parziali; SVM = macchina a vettori di supporto; RMSE = errore quadratico medio; GSEA = analisi di arricchimento dei set di geni; RT-qPCR = reazione a catena della polimerasi quantitativa con trascrizione inversa. Cliccare qui per visualizzare una versione ingrandita di questa figura.
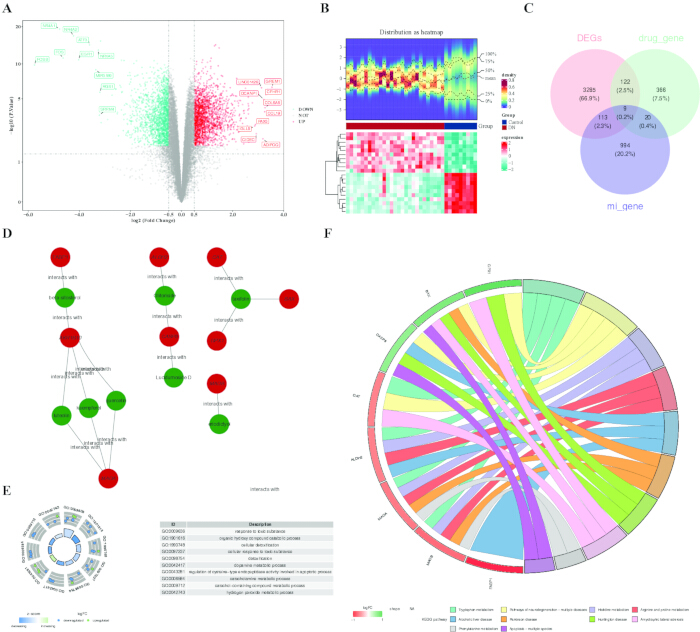
Figura 2: Selezione e caratterizzazione funzionale dei geni candidati per il trattamento della DN con LLF. (A) Diagramma a vulcano che mostra i geni differenzialmente espressi tra campioni di DN e controlli nel dataset GSE142025. (B) Mappa termica dei 10 geni maggiormente sovraespressi e dei 10 geni maggiormente sottoespressi, ordinati in base al valore assoluto di |log2FC|. (C) Diagramma di Venn che mostra l'intersezione tra DEG, MRG e geni bersaglio predetti di LLF. (D) Rete tra principio attivo e geni candidati. (E) Analisi di arricchimento dell'ontologia genica (Gene Ontology) dei geni candidati. L'altezza delle barre rappresenta il grado di significatività dell'arricchimento, mentre il punteggio z indica la direzione predetta della regolazione funzionale. (F) Analisi di arricchimento dei percorsi metabolici del Kyoto Encyclopedia of Genes and Genomes (KEGG) per i geni candidati. Abbreviazioni: DN = nefropatia diabetica; LLF = Ligustri Lucidi Fructus; DEGs = geni differenzialmente espressi; MRGs = geni legati ai mitocondri; GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Cliccare qui per visualizzare una versione ingrandita di questa figura.
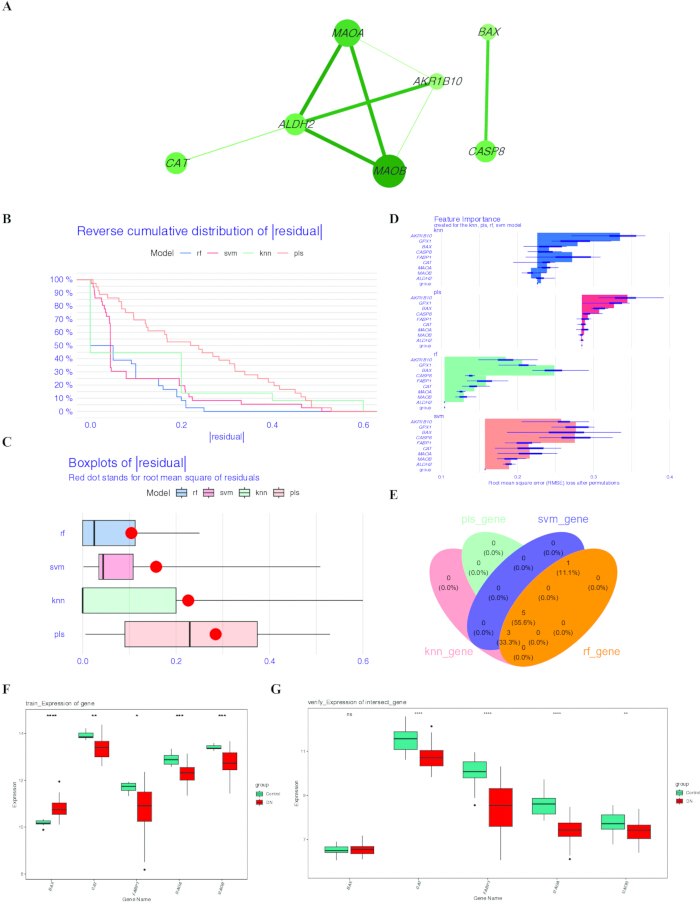
Figura 3: Identificazione basata sull'apprendimento automatico di biomarcatori candidati. (A) Rete di interazione proteina-proteina delle proteine codificate dai geni candidati. (B) Distribuzione cumulativa inversa dei residui per i modelli RF, KNN, PLS e SVM. (C) Diagrammi a scatola (boxplot) che mostrano le distribuzioni dei residui dei quattro modelli; il punto rosso indica l'errore quadratico medio. (D) Importanza basata sull'RMSE dei geni candidati nei quattro modelli di apprendimento automatico. (E) Intersezione dei geni caratterizzanti che soddisfano il criterio RMSE < 0,281 in tutti e quattro i modelli. (F,G) Espressione dei geni caratterizzanti selezionati in GSE142025 e GSE96804, rispettivamente. Abbreviazioni: RF = foresta casuale; KNN = k-vicini più prossimi; PLS = minimi quadrati parziali; SVM = macchina a vettori di supporto; RMSE = errore quadratico medio. Cliccare qui per visualizzare una versione ingrandita di questa figura.
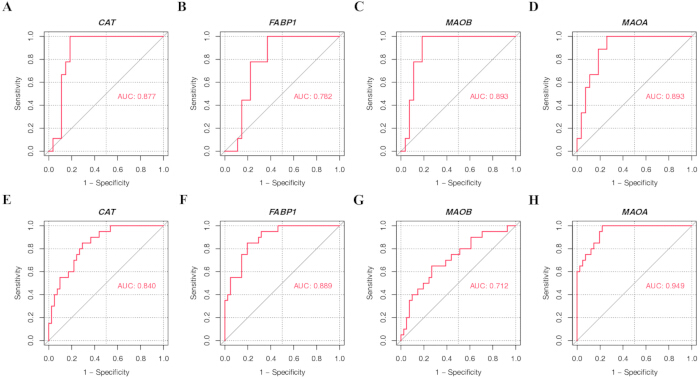
Figura 4: Curve caratteristiche operative del ricevitore dei quattro biomarcatori candidati. Curve ROC per CAT, FABP1, MAOB e MAOA nel set di dati di addestramento (A-D) GSE142025 e nel set di dati di convalida (E-H) GSE96804. L'AUC rappresenta l'area sotto la curva caratteristica operativa del ricevitore. Abbreviazioni: ROC = curva caratteristica operativa del ricevitore; AUC = area sotto la curva. Cliccare qui per visualizzare una versione ingrandita di questa figura.
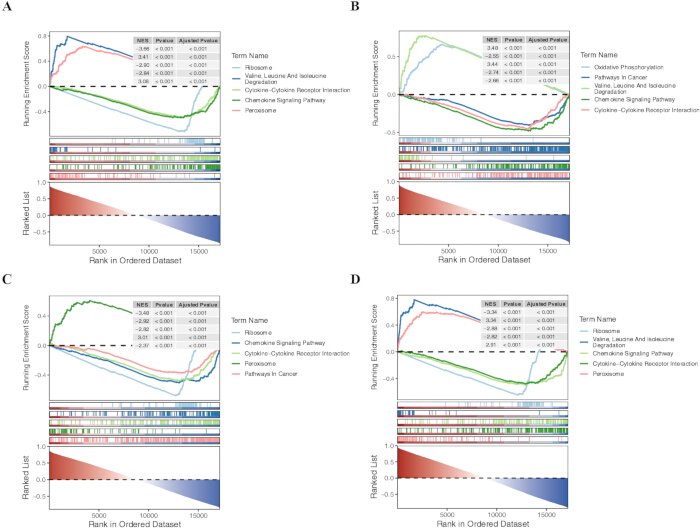
Figura 5: Analisi di arricchimento di insiemi genici dei biomarcatori candidati. GSEA che mostra i percorsi KEGG significativamente arricchiti associati a (A) CAT, (B) FABP1, (C) MAOA e (D) MAOB nel set di dati GSE142025. Abbreviazioni: GSEA = analisi di arricchimento di insiemi genici; KEGG = Kyoto Encyclopedia of Genes and Genomes. Cliccare qui per visualizzare una versione ingrandita di questa figura.
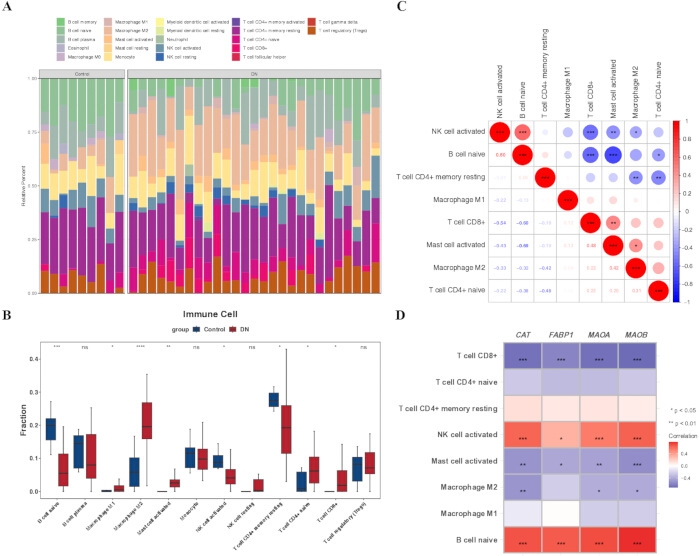
Figura 6: Infiltrazione di cellule immunitarie e la sua associazione con biomarcatori candidati nella DN. (A) Proporzioni relative di 22 tipi di cellule immunitarie stimati tramite CIBERSORT in campioni di DN e controlli. (B) Confronto delle frazioni di cellule immunitarie significativamente diverse tra i gruppi DN e controllo. (C) Matrice di correlazione tra i tipi di cellule immunitarie differenzialmente abbondanti. (D) Correlazioni di Spearman tra l'espressione di CAT, FABP1, MAOA e MAOB e i tipi di cellule immunitarie differenzialmente abbondanti. Abbreviazioni: DN = nefropatia diabetica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
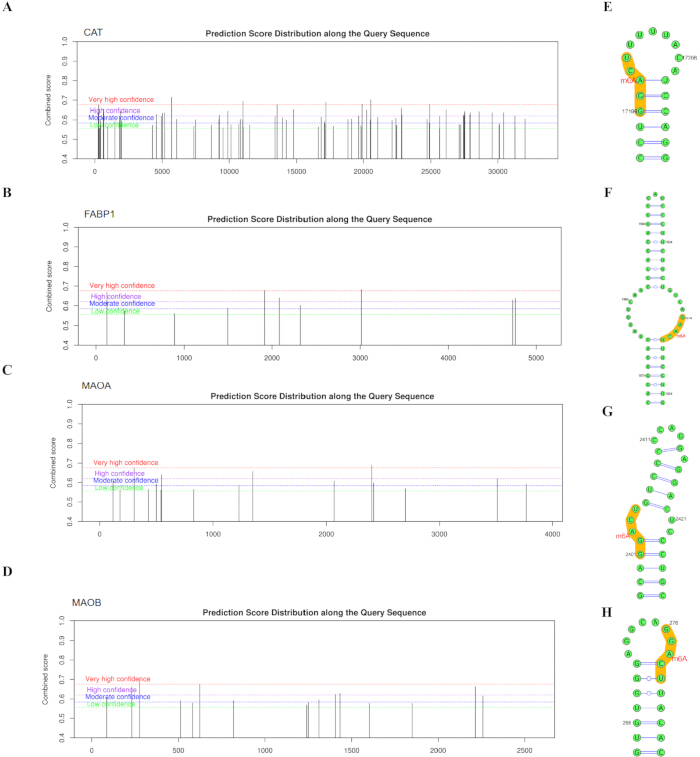
Figura 7: Siti previsti di modificazione m6A e strutture secondarie dell'RNA dei trascritti dei biomarcatori candidati. Siti previsti di modificazione m6A in (A) CAT, (B) FABP1, (C) MAOA e (D) MAOB. Strutture secondarie dell'RNA previste che mostrano regioni associate a m6A ad alta affidabilità di (E) CAT, (F) FABP1, (G) MAOA e (H) MAOB. Le regioni evidenziate in giallo indicano le regioni di sequenza previste contenenti siti di modificazione m6A. Abbreviazione: m6A = N6-metiladenosina. Cliccare qui per visualizzare una versione ingrandita di questa figura.
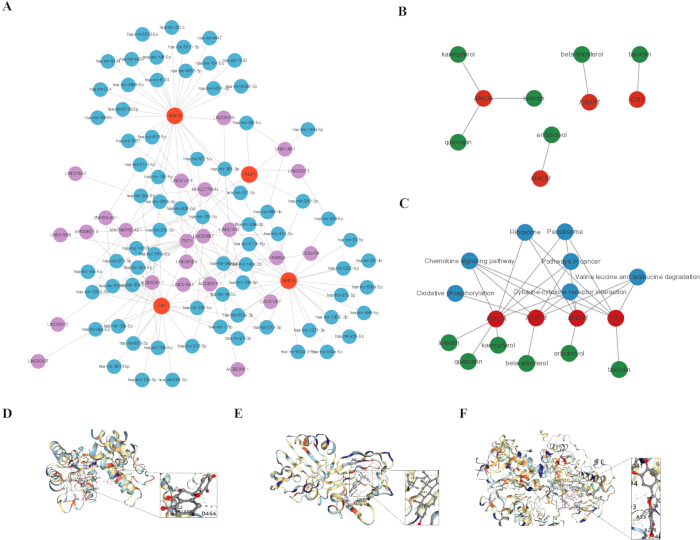
Figura 8: Reti di regolazione e docking molecolare degli ingredienti attivi potenziali di LLF. (A) Rete di regolazione predetta lncRNA–miRNA–mRNA che coinvolge i biomarcatori candidati. (B) Rete di ingredienti attivi potenziali di LLF e biomarcatori candidati. (C) Rete ingrediente attivo–biomarcatore–via metabolica basata sui risultati dell'analisi di arricchimento dei set genici (GSEA). (D-F) Conformazioni di docking molecolare predette di (D) CAT con taxifolina, (E) FABP1 con beta-sitosterolo e (F) MAOB con eriodictiole. Abbreviazioni: LLF = Ligustri Lucidi Fructus; lncRNA = RNA non codificante lungo; miRNA = microRNA; GSEA = analisi di arricchimento dei set genici. Cliccare qui per visualizzare una versione ingrandita di questa figura.
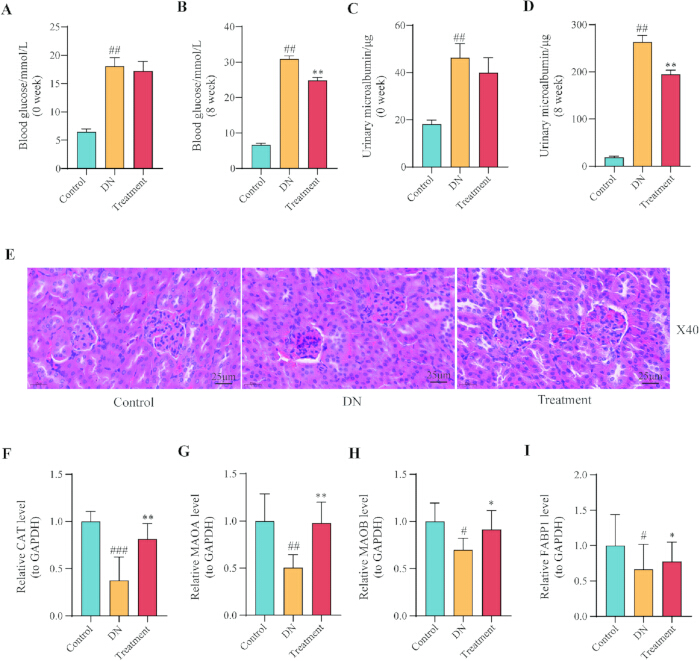
Figura 9: Effetti del trattamento con LLF su indicatori biochimici, istopatologia renale ed espressione di biomarcatori candidati nei topi db/db. (A,B) Livelli di glucosio nel sangue al basale e alla settimana 8, rispettivamente. (C,D) Livelli urinari di microalbumina al basale e alla settimana 8, rispettivamente. (E) Sezioni renali rappresentative colorate con ematossilina ed eosina dai gruppi Controllo, DN e Trattamento (ingrandimento, ×40; barra della scala = 25 µm). (F-I) Livelli relativi di espressione mRNA renale di Cat, Maoa, Maob e Fabp1, rispettivamente, misurati mediante RT-qPCR. #P < 0,05, ##P < 0,01 e ###P < 0,001 rispetto al gruppo Controllo; *P < 0,05, **P < 0,01 e ***P < 0,001 rispetto al gruppo DN. Abbreviazioni: LLF = Ligustri Lucidi Fructus; DN = nefropatia diabetica; RT-qPCR = reazione a catena della polimerasi quantitativa con trascrizione inversa. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| primer | sequenze |
| CAT F | TCACTGACGAGATGGCACAC |
| CAT R | ATCGAACGGCAATAGGGGTC |
| FABP1 F | CAATAGGTCTGCCCGAGGAC |
| FABP1 R | GTCATGGTCTCCAGTTCGCA |
| MAOB F | GCACTGAAACAGCCTCACAC |
| MAOB R | TCGTGCAGGGACATCCAAAG |
| MAOA F | ACTTACCCATTCCGTGGTGC |
| MAOA R | ACCACAGGGCAGATACCTCA |
| M-GAPDH F | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
Tabella 1: Sequenze dei primer utilizzate per l'analisi di RT-qPCR su tessuti renali di topo. Abbreviazioni: F = primer diretto; R = primer inverso; RT-qPCR = reazione a catena della polimerasi quantitativa con trascrizione inversa.
| ID MOL | Nome della molecola | OB (%) | DL | Numero bersaglio |
| MOL000358 | beta-sitosterol | 36,91 | 0,75 | 100 |
| MOL000422 | kaempferol | 41,88 | 0,24 | 103 |
| MOL004576 | taxifolin | 57,84 | 0,27 | 92 |
| MOL005146 | Lucidumoside D | 48,87 | 0,71 | 104 |
| MOL005147 | Lucidumoside D_qt | 54,41 | 0,47 | 0 |
| MOL005169 | (20S)-24-ene-3,20-diol-3-acetate | 40,23 | 0,82 | 0 |
| MOL005190 | eriodictyol | 71,79 | 0,24 | 101 |
| MOL005195 | syringaresinol diglucoside_qt | 83,12 | 0,8 | 0 |
| MOL005209 | Lucidusculine | 30,11 | 0,75 | 105 |
| MOL005211 | Olitoriside | 65,45 | 0,23 | 100 |
| MOL005212 | Olitoriside_qt | 103,23 | 0,78 | 0 |
| MOL000006 | luteolin | 36,16 | 0,25 | 102 |
| MOL000098 | quercetin | 46,43 | 0,28 | 103 |
Tabella 2: Tredici principi attivi del Ligustri Lucidi Fructus identificati utilizzando il database TCMSP. Abbreviazioni: OB = biodisponibilità orale; DL = somiglianza ai farmaci.
| mRNA | Proteina | RF | SVM |
| CAT | AQR | 0.7 | 0.98 |
| CAT | RBM22 | 0.8 | 0.97 |
| FABP1 | AQR | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| MAOB | TIA1 | 0.85 | 0.89 |
Tabella 3: Interazioni previste tra quattro mRNA di biomarcatori mitocondriali e proteine leganti l'RNA associate all'm6A. CAT, FABP1, MAOA e MAOB indicano mRNA di biomarcatori umani; AQR, RBM22, SF3A3, IGF2BP2, IGF2BP3 e TIA1 indicano proteine leganti l'RNA. Punteggi RF e SVM > 0,5 indicano interazioni RNA-proteina previste. Abbreviazioni: RF = foresta casuale; SVM = macchina a vettori di supporto.
File supplementare 1. Script di bioinformatica e dati sorgente sperimentali. Questo archivio contiene gli script R utilizzati per l'elaborazione dei dati, l'analisi dell'espressione differenziale, l'arricchimento funzionale, l'apprendimento automatico, l'analisi della curva ROC (receiver operating characteristic), l'analisi dell'arricchimento di set genici, l'analisi della correlazione di Spearman e l'analisi dell'infiltrazione di cellule immunitarie con CIBERSORT, insieme ai dati sorgente relativi agli esperimenti su glucosio ematico, microalbuminuria e RT-qPCR. Cliccare qui per scaricare il file.
Discussione
LLF è una medicina tradizionale cinese comunemente utilizzata, impiegata principalmente per nutrire il fegato e i reni e per trattare il diabete e le sue complicanze. Attualmente non esistono farmaci o terapie specifiche per la DN, e la sua gestione si basa principalmente su trattamenti ipoglicemizzanti, ipolipemizzanti e antiipertensivi30,31,32. Tuttavia, questi trattamenti possono rallentare la progressione del danno renale solo in una piccola percentuale di pazienti33. È stato dimostrato che LLF esercita effetti protettivi renali nei modelli di ratto con DN correggendo i disturbi del metabolismo del glucosio e dei lipidi e attenuando lo stress ossidativo34. In particolare, essendo un organo con un contenuto mitocondriale eccezionalmente elevato e un elevato consumo di ossigeno, dinamiche mitocondriali anomale nel rene svolgono un ruolo fondamentale nella patogenesi della DN35. Questo studio rivela un nuovo meccanismo attraverso il quale LLF potrebbe influenzare la funzione mitocondriale mediante specifici biomarcatori candidati (CAT, FABP1, MAOB e MAOA) nel trattamento della DN.
Studi precedenti hanno indicato che la catalasi (CAT), la proteina legante gli acidi grassi 1 (FABP1), la monoammina ossidasi B (MAOB) e la monoammina ossidasi A (MAOA) sono coinvolte nella nefropatia diabetica (DN) in misura variabile. CAT partecipa al sistema di difesa antiossidante, proteggendo il rene dai danni indotti dallo stress ossidativo36. La CAT, un enzima antiossidante fondamentale nell'organismo, contribuisce a regolare l'insorgenza e la progressione della DN modulando processi fisiologici mitocondriali37. La CAT catalizza specificamente la decomposizione del perossido di idrogeno (H₂O₂) in acqua e ossigeno, eliminando in modo efficace le specie reattive dell'ossigeno (ROS) di origine mitocondriale. Ciò riduce i danni indotti dallo stress ossidativo alla struttura e alla funzione mitocondriale, mantiene la stabilità del potenziale della membrana mitocondriale e l'efficienza della fosforilazione ossidativa, attenuando così il danno renale indotto dall'iperglicemia e ritardando la progressione della DN38. Inoltre, la ridotta espressione della CAT determina un insufficiente smaltimento delle ROS mitocondriali, aggravando la frammentazione mitocondriale e la rottura delle creste. Questo inibisce la fusione mitocondriale e promuove la fissione, destabilizzando ulteriormente la dinamica mitocondriale. Di conseguenza, cellule intrinseche come le cellule mesangiali e i podociti sviluppano disturbi metabolici, accelerando così la fibrosi del tessuto renale39.
FABP1, come membro della famiglia delle proteine leganti gli acidi grassi, partecipa principalmente al trasporto, al metabolismo e alla segnalazione intracellulare degli acidi grassi a catena lunga. È stato dimostrato che la sua espressione anomala è strettamente associata a diverse malattie metaboliche e al danno renale, svolgendo un ruolo regolatorio cruciale nello sviluppo e nella progressione della nefropatia diabetica (DN)40. Ricerche indicano che FABP1 modula la progressione della DN alterando il metabolismo lipidico. Nel diabete, l'espressione anomala di FABP1 perturba il trasporto e il metabolismo degli acidi grassi. Acidi grassi liberi e loro metaboliti si accumulano in eccesso nel tessuto renale, danneggiando direttamente le cellule endoteliali glomerulari e le cellule epiteliali tubulari, aggravando così l'infiammazione e la fibrosi renale41. Contemporaneamente, FABP1 peggiora il danno al tessuto renale mediando lo stress ossidativo e i danni indotti dall'ipossia. L'escrezione urinaria di FABP1 può aumentare prima dell'insorgenza di livelli anomali di albumina urinaria, rappresentando quindi un nuovo bersaglio per lo screening e la diagnosi precoce della DN41,42. Inoltre, FABP1 svolge un ruolo centrale nella regolazione del metabolismo mitocondriale degli acidi grassi43. Studi indicano che l'upregolazione di FABP1 aumenta significativamente l'efficienza del trasporto degli acidi grassi nei mitocondri, incrementa l'attività della β-ossidazione mitocondriale e l'attività degli enzimi del ciclo dell'acido tricarbossilico, migliorando così il metabolismo energetico cellulare44. Tuttavia, il meccanismo attraverso cui FABP1 influenza la patogenesi della DN mediante il coinvolgimento in processi mitocondriali rimane poco chiaro. In altre condizioni correlate alla DN, MAOB e MAOA, essendo enzimi coinvolti nel metabolismo dei neurotrasmettitori, sono stati associati alla progressione della DN, contribuendo a un'alterazione dello stato redox tissutale. Questo studio conferma ulteriormente il ruolo fondamentale di questi quattro biomarcatori candidati nella DN, i cui livelli di espressione risultano ridotti nel gruppo affetto da DN. Si ipotizza che la modulazione dell'espressione di questi biomarcatori candidati possa contribuire a ridurre l'infiammazione e lo stress ossidativo nella DN.
Sulla base dell'analisi di arricchimento GSEA, quattro biomarcatori candidati — CAT, FABP1, MAOB e MAOA — risultano arricchiti in più vie metaboliche, tra cui la via di segnalazione dei chemochine, l'interazione citochina-recettore per citochine e le vie dei perossisomi. Le chemochine sono componenti chiave della risposta immunitaria, che promuovono l'infiammazione. La via della perossidasi (POD) è associata allo stress ossidativo45. Si è riportato che la baicalina allevia la DN riducendo lo stress ossidativo e l'infiammazione, con un meccanismo che potrebbe coinvolgere l'attivazione della via di segnalazione antiossidante mediata da NrF2 e l'inibizione della via infiammatoria mediata da MAPK45. Inoltre, una disregolazione di FABP1 nel metabolismo dei lipidi potrebbe contribuire alla sclerosi glomerulare e alla fibrosi interstiziale nella DN9. Questi risultati suggeriscono che i biomarcatori candidati svolgono un ruolo fondamentale nei processi infiammatori e di stress ossidativo nella DN. L'indirizzamento di questi biomarcatori candidati per modulare le vie da essi influenzate potrebbe attenuare l'infiammazione e lo stress ossidativo associati alla DN, rallentandone così la progressione.
L'analisi bioinformatica ha mostrato che i livelli di infiltrazione di sottogruppi immunitari, come le cellule T CD8+, nel tessuto renale della nefropatia diabetica (DN) cambiano in modo significativo, e l'aumento delle cellule T CD8+ è significativamente e negativamente correlato all'espressione di quattro biomarcatori candidati legati ai mitocondri (CAT, FABP1, MAOB, MAOA). Queste previsioni computazionali sono coerenti con i risultati osservati nella patologia degli esperimenti sugli animali: le sezioni colorate con ematossilina-eosina (HE) dei reni di topi appartenenti al gruppo modello di DN mostravano un evidente infiltrato di cellule infiammatorie attorno ai glomeruli; dopo l'intervento con LLF, l'infiltrazione di cellule infiammatorie renali nel gruppo trattato era significativamente ridotta e il danno patologico era migliorato. Questo suggerisce che un aumento dell'infiltrazione di cellule infiammatorie rappresenta una caratteristica chiave del danno renale nella DN, e che LLF potrebbe svolgere un ruolo protettivo regolando l'infiltrazione immunitaria. Questo risultato è in accordo con studi precedenti: l'infiltrazione di cellule T CD8+ è associata allo sviluppo della DN, e l'inibizione della loro risposta può attenuare la malattia46, che inoltre aggrava il danno renale nella nefropatia da adriamicina47. Inoltre, diversi tipi di cellule immunitarie, come le cellule B, i macrofagi M1/M2 e le cellule NK, risultano alterati nella patologia della DN48. Il biomarcatore CAT potrebbe influenzare la funzione delle cellule immunitarie nella DN49, e MAOA potrebbe influenzare l'ambiente immunitario regolando la polarizzazione dei macrofagi. Questi risultati indicano che l'effetto protettivo renale di LLF è strettamente legato alla sua capacità di regolare l'infiltrazione immunitaria anomala, inclusa quella delle cellule T CD8+, riducendo così il danno infiammatorio. Le correlazioni negative tra i quattro biomarcatori candidati e le cellule T CD8+ e i mastociti attivati suggeriscono che questi geni potrebbero modulare l'ambiente immunitario renale. L'espressione di CAT è stata associata alla polarizzazione dei macrofagi e all'attività delle cellule T nei tessuti metabolici. Tuttavia, le nostre stime ottenute tramite CIBERSORT derivano da trascrittomi di tessuto renale bulk, che non permettono di distinguere i sottotipi di cellule immunitarie che infiltrano i compartimenti glomerulari rispetto a quelli tubulo-interstiziali. Le correlazioni osservate devono essere interpretate come associazioni generatrici di ipotesi, piuttosto che come evidenza di una regolazione immunitaria causale. Studi futuri che utilizzino immunohistochimica multiplex o sequenziamento dell'RNA a singola cellula (single-cell RNA-seq) saranno necessari per localizzare queste interazioni tra cellule immunitarie e biomarcatori.
Studi precedenti hanno riportato biomarcatori mitocondriali associati alla DN, tra cui OPA1, MFN2, DRP1, PGC-1α e SOD2. I nostri risultati su CAT e MAOA integrano questa letteratura esistente evidenziando vie perossisomiali e della monoammina ossidasi che hanno ricevuto minore attenzione nel contesto mitocondriale della DN. In particolare, mentre SOD2 e GPX1 sono enzimi classici che eliminano le ROS, CAT agisce specificamente sull'H2O2 perossisomiale, suggerendo un compartimento subcellulare distinto nella regolazione dello stress ossidativo.
Come flavonoide naturale, si è dimostrato che la taxifolina (TA) riduce significativamente i livelli ematici di glucosio, acido urico, creatinina e insulina nei ratti diabetici, mitigando contemporaneamente le alterazioni patologiche renali in questi animali50. Il β-sitosterolo potrebbe migliorare la DN indirettamente regolando l'equilibrio lipidico ed esercitando effetti antinfiammatori. I componenti di β-sitosterolo nella decotto Huangqi Gegen (HGD) partecipano a vie metaboliche associate alla DN, agendo su molecole come il fattore di crescita dell'endotelio vascolare A (VEGFA) e l'interleuchina-6 (IL-6). Questi effetti includono azioni antinfiammatorie, antiapoptotiche, antiossidanti e di autofagia, che riducono la fibrosi renale e i danni alla corteccia renale e migliorano la funzione renale, ritardando infine la progressione della DN51. L'eriodictiolo, un altro flavonoide naturale, si è dimostrato in grado di proteggere contro l'ictus ischemico (IS) bilanciando lo stress ossidativo e l'infiammazione52. Sebbene gli studi sull'eriodictiolo nel contesto della DN siano limitati, data l'associazione della malattia con infiammazione e stress ossidativo, si ipotizza che possa attenuare la DN attraverso meccanismi simili. Le previsioni farmacologiche di questo studio suggeriscono inoltre che taxifolina, β-sitosterolo ed eriodictiolo possano avere effetti terapeutici potenziali nella DN. Il docking molecolare predice possibili conformazioni di legame e affinità, ma non stabilisce il legame al bersaglio in vivo, la biodisponibilità o l'attività farmacologica. Tali risultati devono essere interpretati come generazione di ipotesi piuttosto che come conferma.
Studi precedenti di farmacologia delle reti sulla nefropatia diabetica (DN) si sono concentrati principalmente su singoli percorsi di segnalazione (ad esempio, AGE-RAGE, PI3K-AKT e MAPK) e non hanno preso in considerazione la disfunzione mitocondriale né impiegato modelli multipli di apprendimento automatico per stabilire una gerarchia di biomarcatori. Il nostro studio introduce tre avanzamenti metodologici e biologici: (1) l'integrazione di geni differenzialmente espressi a livello trascrittomico (DEG) con set genici mitocondriali e previsioni di interazione farmaco-target; (2) l'applicazione di quattro distinti modelli di apprendimento automatico con validazione incrociata tra dataset per identificare candidati robusti; e (3) l'individuazione di percorsi perossosomiali (CAT) e della monoammina ossidasi (MAOA/MAOB)—meno studiati nei contesti mitocondriali della DN—come assi terapeutici candidati.
La mancanza di cambiamenti statisticamente significativi nell'espressione di MaoB e Fabp1 nel rene del topo potrebbe essere dovuta a diversi fattori. In primo luogo, i due dataset del Gene Expression Omnibus (GEO) utilizzati per la priorizzazione dei geni candidati derivavano da campioni renali umani (rene intero e glomerulo, rispettivamente), mentre il nostro esperimento animale ha utilizzato tessuto renale murino. Differenze specifiche della specie nella regolazione genica potrebbero influenzare i livelli basali di espressione e la risposta ai farmaci. In secondo luogo, la dimensione relativamente ridotta del campione (n = 6 per gruppo) potrebbe aver limitato la potenza statistica necessaria per rilevare effetti di entità moderata. In terzo luogo, il tessuto è stato raccolto 8 settimane dopo il trattamento, un intervallo che potrebbe non aver colto la finestra ottimale per rilevare cambiamenti trascrittomici in MaoB e Fabp1, poiché questi geni potrebbero essere regolati a livello proteico o di attività piuttosto che a livello di mRNA. In quarto luogo, l'eterogeneità del tessuto—tra rene intero e compartimenti specifici—potrebbe contribuire a tali discrepanze. Ulteriori indagini su queste possibilità sono necessarie.
Questo studio ha utilizzato un approccio integrato di bioinformatica e apprendimento automatico per identificare CAT, FABP1, MAOA e MAOB come geni candidati mitocondriali potenziali per la LLF nel DN. Esperimenti in vivo hanno confermato che la LLF regola significativamente verso l'alto CAT e MAOA nel tessuto renale, suggerendo che questi geni rappresentano bersagli promettenti per ulteriori indagini meccanistiche e terapeutiche. Al contrario, MAOB e FABP1 hanno mostrato tendenze non significative nella stessa direzione, sottolineando l'importanza della validazione sperimentale nella priorizzazione delle previsioni computazionali. Questi risultati forniscono una base razionale per studi futuri volti a esplorare strategie terapeutiche legate ai mitocondri nel DN.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Desideriamo esprimere la nostra sincera gratitudine a tutte le persone e organizzazioni che ci hanno sostenuto e assistito durante questa ricerca. Questo studio è stato sostenuto dal National Natural Science Foundation of China (n. 81973486 e 82173974), dai progetti di ricerca dell'Amministrazione della Medicina Tradizionale Cinese della provincia dello Shanxi (n. 2024ZYYA021), dal progetto disciplinare dell'Università di Medicina Cinese dello Shanxi (n. 2026XK24) e dal progetto del fondo per la ricerca scientifica dell'Università di Medicina Cinese dello Shandong (n. KYZK2024Q13). Ringraziamo Qinqing Li, Professore Associato presso l'Università di Medicina Cinese dello Shanxi, che ha autenticato il materiale botanico.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Soluzione fissativa per tessuti al 4% di paraformaldeide | Saiyin Biotechnology Co., Ltd. | 71033600 | |
| Etilene al 100% | Sinopharm Chemical Reagent Co., Ltd. | 10009218 | |
| Glucometro | Sinocare Inc. | GA-3 | |
| Kit per saggio dell'azoto ureico nel sangue (BUN) | Nanjing Jianwei Bioengineering Institute | C03-2-1 | |
| Topi C57BLKS/J db/db | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Topi C57BLKS/J db/m | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Centrifuga | Hunan Xiangyi Laboratory Instrument Development Co., Ltd. | HI650 | |
| Idrato di cloralio | Shanghai Aladdin Biochemical Technology Co., Ltd. | 302-17-0 | |
| Cytoscape (v3.9.0) | https://cytoscape.org | ||
| Database per la previsione della modificazione m6A | http://www.cuilab.cn/sramp/ | ||
| Database degli ingredienti attivi nella medicina tradizionale cinese | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | https://starbase.sysu.edu.cn/ | ||
| Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/ | ||
| Kit per colorazione con ematossilina ed eosina (HE) | Servicebio | C0105S | |
| Centrifuga ad alta velocità | Labnet, USA | C2500-R-230V | |
| Strumento per l'analisi dell'infiltrazione immunitaria | https://cibersort.stanford.edu/ | ||
| Ligustri Lucidi Fructus | Sichuan Quanyirun Biotechnology Co., Ltd. | 20240506 | |
| Agitatore magnetico | Jintan Zhongtian Instrument Factory, Jiangsu | T8-1 | |
| Microscopio | Olympus | BX53 | |
| Microtomo | Leica, Germany | RM 2016 | |
| Spettrofotometro a microvolume | Hangzhou Aosheng Instrument Co., Ltd. | Nano-300 | |
| miRNet | https://www.mirnet.ca | ||
| MitoCarta 3.0 | https://www.broadinstitute.org/mitocarta | ||
| Pacchetto R per l'interpretazione del modello | https://cran.r-project.org/package=DALEX | ||
| Piattaforma di docking molecolare | http://clab.labshare.cn/cb-dock/ | ||
| Kit ELISA per microalbuminuria murina | Fine Test | EM0632 | |
| Striscia reattiva per microalbuminuria murina | Guangzhou Huadu Gaoerbao Biotechnology Co., Ltd. | 20211203 | |
| Kit ELISA per creatinina sierica murina | Abmart | AB5990A | |
| MSigDB | https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| Ciclatore termico PCR | Roche | Roche LightCycler 480 | |
| Software R (v4.2.2) + pacchetti R | https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | https://www.rcsb.org | ||
| Kit per estrazione dell'RNA | Beijing Jumei Biotech Co., Ltd. | MF-036-01 | |
| RPISeq | http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| Kit RT-qPCR | Beijing Jumei Biotech Co., Ltd. | MF949-T | |
| Salidroside | Sichuan Quanyirun Biotechnology Co., Ltd. | 20211009 | |
| Kit per saggio della creatinina sierica | Nanjing Jianwei Bioengineering Institute | C011-2-1 | |
| Struttura per animali SPF | Shanxi University of TCM | ||
| SRAMP | http://www.cuilab.cn/sramp/ | ||
| STRING | https://cn.string-db.org/ | ||
| SwissTargetPrediction | http://www.swisstargetprediction.ch/ | ||
| TCMSP | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| Tezhi Pigan | Sichuan Quanyirun Biotechnology Co., Ltd. | 20210602 | |
| Bacinella galleggiante per tessuti | Wuhan Junjie | JK-6 |
Riferimenti
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.