Questo studio analizza i comportamenti decisionali e di revisione di studenti di lingua inglese impegnati nella traduzione di narrazioni incentrate sulla Cina, integrando registrazioni di battute da tastiera e un corpus di danmu per evidenziare come la rilevanza testuale influenzi lo sforzo cognitivo e la qualità della traduzione.
Articolo di ricerca
Processo decisionale e comportamento di revisione nella traduzione dal cinese all'inglese: prove basate su studenti di lingue inglesi che traducono narrazioni focalizzate sulla Cina
In questo articolo
Sommario
Abstract
Mentre le narrazioni incentrate sulla Cina entrano sempre più nel circuito internazionale, la traduzione dal cinese all'inglese si è trasformata in un ambito di negoziazione del significato piuttosto che in un semplice trasferimento linguistico. Per gli studenti traduttori, la sfida principale va oltre la scelta lessicale; riguarda la decisione su come rendere riferimenti carichi di cultura, posizioni valutative e posizionamenti narrativi per lettori esterni al contesto originario. Questo studio analizza i processi decisionali in tempo reale e i comportamenti di revisione di 72 studenti di lingua inglese impegnati nella traduzione di narrazioni incentrate sulla Cina. Attraverso un disegno di ricerca basato su processo e prodotto, la ricerca integra dati raccolti mediante registrazione delle battute a video con Translog-II, valutazioni del prodotto traduttivo e un corpus ausiliario di danmu (commenti sincronizzati temporali) considerato come un livello di rilevanza percepita dal pubblico, piuttosto che come misura diretta della difficoltà linguistica a livello di segmento. I processi traduttivi sono stati analizzati in base alla durata delle pause, alla frequenza delle revisioni, alla posizione delle revisioni e alla distribuzione per fasi, mentre la qualità del prodotto è stata valutata tramite giudizi esperti e codifica mirata dei segmenti legati alla cultura. Un corpus di 18.642 commenti danmu provenienti da 24 video su Bilibili è stato utilizzato per identificare temi narrativi e espressioni culturalmente sensibili rilevanti per il pubblico. I risultati mostrano che segmenti ricchi di contenuti culturali e densi di valutazione hanno provocato pause più lunghe, un aumento delle revisioni ricorsive e una maggiore frequenza di riformulazioni durante il processo. Traduzioni di qualità superiore si sono associate a revisioni selettive e strategicamente tempistiche a livello discorsivo e di adattamento culturale, piuttosto che a un numero complessivo maggiore di revisioni. La sovrapposizione tra i trigger narrativi rilevanti nei danmu e i segmenti di traduzione ad alto sforzo è interpretata come evidenza convergente della rilevanza percepita dal pubblico e della pressione cognitiva subita dal traduttore, non come prova di causalità. Lo studio contribuisce all'avanzamento della ricerca sui processi traduttivi collegando il comportamento di revisione alla traduzione di narrazioni profondamente radicate nella cultura e offrendo spunti per la formazione dei traduttori nella comunicazione interculturale.
Introduzione
Negli ultimi anni, la traduzione dei testi relativi alla Cina è passata da una questione relativamente specializzata a un tema centrale nella comunicazione internazionale1. In gioco non vi è semplicemente il trasferimento di contenuti proposizionali, ma la riarticolazione di narrazioni pubbliche portatrici di posizionamenti politici, cornici culturali e progettazione del pubblico. Gli studi sulla traduzione del discorso politico cinese hanno reso sempre più evidente questo aspetto: quando i testi vengono tradotti per lettori al di fuori della Cina, le scelte riguardo al lessico, alla modalità e all'enfasi testuale diventano anche scelte su come la Cina viene raccontata e interpretata all'estero2. Una volta impostato il problema in questi termini, un approccio basato esclusivamente sul prodotto finale risulta insufficiente. Una traduzione ultimata può mostrare cosa è stato scelto, ma non può rivelare quando è emersa l'incertezza, dove è iniziata la riformulazione o come sono state testate e abbandonate soluzioni alternative3.
Queste limitazioni aiutano a spiegare perché la ricerca empirica sui processi traduttivi è diventata un aspetto importante negli studi traduttivi, utilizzando strumenti di tracciamento del processo per registrare pause, cancellazioni, inserimenti e la struttura temporale del processo decisionale, invece di dedurli indirettamente dal testo finale4. Questo non sostituisce gli approcci basati sul prodotto, di tipo sociologico, culturale o su corpora; piuttosto, aggiunge evidenze riguardo alla formazione momento per momento delle decisioni traduttive. Lavori recenti sono passati dalla descrizione di pause isolate alla modellizzazione della traduzione come attività strutturata temporalmente. La tassonomia incertezza-ricerca-flusso, ad esempio, interpreta il comportamento traduttivo come un'alternanza ordinata tra incertezza, ricerca e produzione fluente, spiegando perché determinati tratti di un compito diventano instabili e innescano riformulazioni5. Questo cambiamento è particolarmente rilevante nella traduzione degli studenti, in cui competenza linguistica, conoscenza della materia e controllo strategico si stanno ancora sviluppando contemporaneamente6.
Le evidenze derivanti dalla combinazione di eye-tracking e registrazione delle pressioni dei tasti mostrano che i traduttori principianti non distribuiscono l'attenzione in modo uniforme e che la produzione del testo obiettivo diventa spesso un importante punto di carico cognitivo durante la traduzione dal cinese all'inglese7. Di conseguenza, ciò che appare come un problema locale di formulazione nel prodotto potrebbe riflettere in realtà una più ampia riorganizzazione dell'attenzione e dello sforzo durante il processo in tempo reale8. Evidenze recenti suggeriscono inoltre che gli studenti traduttori possono produrre testi con un'adeguatezza superficiale simile, pur differendo notevolmente per quanto riguarda lo sforzo, l'incertezza e l'autosorveglianza richiesti. Una resa finale soddisfacente potrebbe comunque basarsi su un percorso decisionale fragile o inefficiente, che può essere catturato solo attraverso misure sensibili al processo9. Inoltre, studi comparativi indicano che l'esperienza nella traduzione implica un controllo metacognitivo stabile su quando fermarsi, cercare informazioni, proseguire la stesura o tornare indietro per revisionare10.
La revisione è il punto esatto in cui questo processo cognitivo nascosto diventa più evidente. È il momento in cui i traduttori tornano alle formulazioni precedenti, provano alternative e decidono se un problema sia lessicale, sintattico, discorsivo o culturale. Di conseguenza, la revisione non dovrebbe essere considerata un semplice passaggio finale di rifinitura, ma un indicatore fondamentale dello sviluppo del traduttore. Risultati migliori sono associati al modo in cui le alternative vengono consolidate durante la produzione, dimostrando che una revisione efficace è selettiva, opportunamente calibrata nei tempi e orientata alle esigenze complessive del testo, piuttosto che una semplice accumulazione di modifiche11,12,13.
La complessità del processo decisionale e della revisione diventa più evidente quando il testo sorgente è una narrazione incentrata sulla Cina piuttosto che un passaggio informativo neutro. Tali testi si basano spesso su assunzioni fortemente cariche di contenuti culturali, espressioni inserite in un contesto storico e indizi valutativi il cui significato dipende da conoscenze condivise piuttosto che da un'esposizione esplicita14,15,16. La difficoltà del testo modifica la stessa granularità dell'elaborazione; testi narrativi ricchi di contenuti culturali o valutativi costringono i traduttori a operare con unità più piccole, a compiere operazioni non lineari e a impegnarsi in continui ripensamenti locali8. Per gli studenti traduttori, il problema principale consiste nel decidere quanto di quel contesto implicito debba essere esplicitato o riorganizzato per lettori esterni alla comunità discorsiva originaria, senza appiattire la specificità culturale.
Tre lacune specifiche motivano il presente studio. In primo luogo, le metriche del processo traduttivo, come la durata delle pause, la frequenza delle lunghe pause, le interruzioni del cursore e la consultazione del dizionario, vengono spesso esaminate separatamente dalle tipologie di revisione, rendendo difficile comprendere come la pressione decisionale si manifesti successivamente attraverso riformulazioni. In secondo luogo, le categorie narrative specifiche di un contesto culturale hanno ricevuto minore attenzione basata sui processi rispetto ai testi accademici o espositivi generali, nonostante le narrazioni incentrate sulla Cina richiedano spesso ai traduttori di gestire contemporaneamente il carico culturale, la densità valutativa e le implicazioni contestuali condensate14,15,16. In questo studio, per carico culturale si intende la densità di riferimenti legati alla cultura e di presupposti condivisi; per densità valutativa si intende l'assunzione di posizioni esplicite o implicite, l'intensità affettiva e la valutazione implicita nel quadro interpretativo; per compressione narrativa si intende il grado in cui informazioni di sfondo, relazioni causali o posizionamenti sociali sono condensati in brevi tratti testuali. In terzo luogo, i compiti di traduzione sono solitamente progettati esclusivamente sulla base di un'analisi interna al testo, senza considerare sufficientemente se i segmenti identificati come difficili corrispondano ai punti che attirano l'attenzione del pubblico nella circolazione digitale. I danmu (commenti sincronizzati nel video) possono funzionare come paratesto e come discorso partecipativo, evidenziando ciò che il pubblico nota, contesta e reinterpret17,18; tuttavia, la rilevanza dei danmu deve essere considerata un indicatore, a livello semantico, dell'engagement del pubblico, piuttosto che un sostituto diretto della difficoltà linguistica a livello di segmento.
Per colmare queste lacune, il presente studio analizza come gli studenti di lingua inglese prendono decisioni e procedono alle revisioni durante la traduzione di testi narrativi incentrati sulla Cina dal cinese all'inglese. Integrando i dati relativi al processo traduttivo e al discorso digitale del pubblico in un unico quadro analitico, lo studio mira a spiegare non solo in quali punti i traduttori studenti incontrano difficoltà, ma anche perché tali difficoltà si concentrano attorno a particolari tipi di significato narrativo.
In particolare, questo studio affronta quattro domande di ricerca: (1) Quali schemi decisionali caratterizzano la traduzione dall'italiano all'inglese di testi narrativi incentrati sulla Cina da parte di studenti di lingua inglese? (2) In che modo i comportamenti di revisione variano tra segmenti con diversi livelli di carico culturale e densità narrativa? (3) Quali aspetti del comportamento di revisione sono associati a una qualità superiore della traduzione? e (4) I punti culturalmente rilevanti identificati nel discorso danmu coincidono con i segmenti che richiedono il maggiore sforzo cognitivo durante la traduzione?
Di conseguenza, lo studio verifica quattro ipotesi collegate in un'unica sequenza analitica: l'ipotesi H1 prevede che segmenti con un carico culturale maggiore provocheranno pause più lunghe, maggiore incertezza decisionale e revisioni più frequenti rispetto a segmenti con carico culturale inferiore; l'ipotesi H2 distingue due percorsi, prevedendo che la densità valutativa aumenterà le revisioni differite, mentre la compressione narrativa aumenterà la riformulazione a livello discorsivo; l'ipotesi H3 prevede che la qualità della traduzione sarà spiegata più fortemente dalla selettività e dal tempismo delle revisioni piuttosto che dal solo numero totale di revisioni; e l'ipotesi H4 prevede che i segmenti salienti per i danmu si sovrapporranno ai segmenti di traduzione ad alto sforzo, indicando una convergenza associativa tra rilevanza del pubblico e pressione cognitiva del traduttore.
Protocollo
Tutti i metodi che coinvolgevano soggetti umani sono stati condotti nel rispetto delle linee guida istituzionali e sono stati approvati dal comitato etico istituzionale (IRB) o dal comitato per l'etica nella ricerca umana dell'Università Normale di Hanshan. Il consenso informato è stato ottenuto da tutti i partecipanti prima dell'inizio dell'esperimento.
Quadro concettuale e progettazione della ricerca
Questo studio ha adottato un disegno di ricerca di tipo processo-prodotto con un livello discorsivo ausiliario per esaminare in che modo i commenti danmu generati dal pubblico influenzano la traduzione dei sottotitoli. Il quadro analitico integrava caratteristiche testuali, indicatori del processo traduttivo e risultati relativi alla qualità della traduzione. In particolare, è stato indagato se l'attenzione del pubblico, riflessa dalla densità dei danmu, indirizzasse le risorse cognitive dei traduttori verso specifiche caratteristiche testuali e se tale allocazione dell'attenzione influisse successivamente sulla qualità della traduzione.
Per applicare questo quadro concettuale, lo studio ha innanzitutto definito caratteristiche testuali a livello di segmento basate su quattro dimensioni: carico culturale, densità valutativa, compressione narrativa e rilevanza dei danmu. Il carico culturale indicava la presenza di riferimenti specifici di carattere culturale che richiedevano adattamento o spiegazione. La densità valutativa misurava la concentrazione di linguaggio carico di emozioni o giudizi all'interno di un segmento. La compressione narrativa esprimeva il grado in cui il contenuto semantico veniva condensato a causa dei vincoli dei sottotitoli. La rilevanza dei danmu rappresentava il livello di attenzione del pubblico rivolto a ciascun segmento sottotitolato, quantificato in base al volume dei commenti danmu sincronizzati. A differenza delle misurazioni convenzionali della difficoltà di traduzione, la rilevanza dei danmu rifletteva un'attenzione socialmente distribuita piuttosto che una complessità testuale intrinseca. Un segmento che riceve un'intensa interazione da parte del pubblico non è necessariamente più difficile da tradurre; piuttosto, rappresenta un punto di particolare rilevanza comunicativa all'interno dell'esperienza visiva.
Il framework analitico comprendeva tre set di dati interconnessi. Il dataset a livello di partecipante includeva le caratteristiche demografiche individuali e il livello di competenza nella traduzione. Il dataset processo-prodotto collegava ogni segmento dei sottotitoli a indicatori comportamentali estratti dalla registrazione delle pressioni sui tasti, insieme a valutazioni esperte della qualità della traduzione. Il dataset danmu conteneva commenti sincronizzati del pubblico allineati ai tempi dei sottotitoli, a partire dai quali sono stati calcolati i valori di rilevanza (salience) dei danmu. Questi set di dati sono stati collegati tramite identificatori di partecipante e di segmento, consentendo un'analisi simultanea di ogni segmento di sottotitolo tradotto in relazione alle caratteristiche del traduttore, al comportamento cognitivo durante l'elaborazione, all'attenzione del pubblico e ai risultati della traduzione. L'archivio finale integrato comprendeva 216 sessioni complete di traduzione e 3.168 osservazioni partecipante-testo-segmento, fornendo la base empirica per le successive analisi processo-prodotto.
Selezione dei partecipanti e caratterizzazione anamnestica
Il campione era composto da 72 studenti di lingua inglese reclutati presso un'università pubblica del sud della Cina, distribuiti equamente tra il secondo, terzo e quarto anno del corso di laurea (24 partecipanti per ogni anno accademico). Tutti i partecipanti erano madrelingua cinesi che ricevevano un'istruzione formale nella scrittura e nella traduzione in inglese. Per garantire la comparabilità all'interno della popolazione di traduttori in formazione, sono stati esclusi coloro che avevano risieduto in un paese anglofono per più di 6 mesi o che possedevano una certificazione professionale di traduttore. I partecipanti non sono stati suddivisi in gruppi sperimentali distinti in base all'esperienza di traduzione, alla familiarità culturale o alla competenza nella seconda lingua. Al contrario, sono stati registrati il livello accademico, i punteggi più recenti nei test di competenza in inglese, i corsi precedenti di traduzione, il grado di familiarità autovalutato con argomenti culturali legati alla Cina e l'impegno medio settimanale in attività bilingue, e questi dati sono stati inclusi nei modelli statistici come covariate a livello individuale. Questa precisazione risolve anche l'incongruenza nel numero di partecipanti sollevata durante la revisione paritaria: sia il manoscritto che il dataset di replica includono 72 partecipanti, 216 sessioni di compito e 3.168 osservazioni a livello di segmento.
Selezione del testo sorgente e costruzione del compito
I materiali di traduzione consistevano in tre testi narrativi contemporanei focalizzati sulla Cina, sviluppati appositamente per questo studio per rispecchiare un discorso pubblico autentico ed evitare la riproduzione di materiali protetti da copyright. Ogni testo conteneva da 205 a 225 caratteri cinesi, ma differiva sistematicamente per le sue caratteristiche interne. Il testo A presenta una narrazione sul ritorno a casa per la Festa di Primavera, con un carico culturale moderato e una sintassi relativamente semplice. Il testo B racconta un ricordo legato alla Festa delle Barche del Drago e contiene una maggiore densità di espressioni specifiche della cultura e conoscenze contestuali implicite. Il testo C descrive una narrazione sul live streaming e sul commercio elettronico in ambito rurale, caratterizzata da un linguaggio valutativo denso e da una posizione narrativa compressa.
I testi sono stati suddivisi sistematicamente utilizzando i confini delle proposizioni, seguiti dai confini delle unità di significato, ottenendo 44 unità analizzabili nei tre compiti di traduzione (Tabella 1). Prima della codifica formale, un manuale di codifica ha definito carico culturale, densità valutativa e compressione narrativa mediante scale ordinali da 1 a 5. Uno studio pilota, che ha coinvolto 12 studenti non partecipanti all'esperimento principale, ha confermato la calibrazione della difficoltà prevista, la chiarezza delle istruzioni del compito e la stabilità dei confini dei segmenti per l'allineamento delle battute della tastiera.
Costruzione del corpus ausiliario e mappatura della rilevanza
Per identificare gli indizi narrativi salienti a livello pubblico, è stato compilato un corpus ausiliario di danmu a partire da 24 video di Bilibili caricati tra gennaio 2023 e dicembre 2025. I video sono stati inclusi soltanto se corrispondevano a uno dei tre domini semantici rappresentati nei testi sorgente, avevano raggiunto più di 50.000 visualizzazioni, presentavano un'interazione densa sotto forma di danmu e permettevano l'esportazione e la mappatura tematica dei commenti sincronizzati temporalmente. Dopo la rimozione dei duplicati e il filtraggio di emoji, onomatopee di riempimento e frammenti irrilevanti, il corpus finale comprendeva 18.642 commenti.
Le parole chiave sono state standardizzate e raggruppate utilizzando ancoraggi basati su parole chiave correlate al testo sorgente. A ogni segmento del testo sorgente è stato quindi assegnato un punteggio di rilevanza continua dei danmu, basato su una combinazione ponderata della frequenza normalizzata dei cluster di parole chiave, della concentrazione dei commenti all'interno del cluster tematico corrispondente e dell'intensità valutativa media. Questa procedura consente confronti tra lo sforzo cognitivo del traduttore e la rilevanza percepita dal pubblico a livello di cluster semantico, piuttosto che attraverso un semplice abbinamento lessicale diretto. Poiché i danmu riflettono le reazioni del pubblico ai video online e non il compito sperimentale di traduzione in sé, la rilevanza dei danmu è interpretata come un indicatore esterno dell'engagement del pubblico, piuttosto che come una prova diretta della difficoltà linguistica di un segmento sorgente.
Procedura sperimentale e acquisizione dei dati
Le sessioni di traduzione sono state condotte individualmente in un laboratorio informatico controllato, in condizioni standardizzate di hardware, software e accesso a internet (Figura 2). Dopo un'orientamento della durata di cinque minuti, incentrato sulla produzione di un inglese leggibile per un pubblico internazionale, i partecipanti hanno completato un riscaldamento di tre minuti di digitazione in inglese per ridurre al minimo gli effetti dell'abituazione alla tastiera. I tre compiti di traduzione sono stati somministrati in sequenza utilizzando Translog-II, con l'ordine dei compiti bilanciato secondo uno schema a quadrato latino, al fine di distribuire in modo uniforme tra i partecipanti gli effetti potenziali della fatica e dell'ordine. Ai partecipanti è stato assegnato un tempo massimo di 20 minuti per ciascun testo, intervallati da pause di riposo di cinque minuti.
Sebbene fosse consentito l'uso del dizionario bilingue integrato, erano vietati i sistemi di traduzione automatica e i motori di ricerca esterni. Tutte le pressioni dei tasti, le pause e i movimenti del cursore sono stati registrati automaticamente e integrati da registrazioni sincrone dello schermo per verificare gli episodi di revisione non lineari. Al termine di ogni compito, i partecipanti hanno compilato un'autovalutazione della difficoltà, utilizzata esclusivamente per supportare l'interpretazione dei casi limite nella codifica.
Misurazione del processo e codifica delle variabili
I record dei tasti premuti sono stati allineati con la struttura predefinita dei segmenti. Un episodio di allineamento iniziava con il primo tasto premuto nella lingua bersaglio corrispondente a un segmento e terminava quando il partecipante avanzava definitivamente al segmento successivo. Le revisioni sovrapposte sono state riassegnate utilizzando i record cronologici del tracciamento del cursore.
Il comportamento decisionale è stato quantificato mediante cinque indicatori: la durata della prima pausa prima della traduzione del segmento iniziale, la durata media delle pause all'interno dei segmenti, la frequenza delle pause superiori a due secondi, il numero di consultazioni del dizionario e il numero di interruzioni basate sul cursore, che indicano deviazioni dalla stesura lineare (Tabella 2). Il comportamento di revisione è stato classificato secondo due dimensioni: tempistica e funzione. La tempistica distingueva le revisioni locali immediate da quelle differite, effettuate dopo che la stesura era progredita oltre il segmento corrente. La codifica funzionale ha classificato le revisioni come revisioni superficiali (correzioni a livello formale senza cambiamento semantico), revisioni di significato (modifiche lessicali o sintattiche), revisioni a livello discorsivo (aggiustamenti delle relazioni tra proposizioni o della coerenza) e revisioni di adattamento culturale (riformulazioni orientate al pubblico target). Due codificatori addestrati hanno analizzato indipendentemente ciascun episodio di revisione prima della risoluzione congiunta e hanno assegnato una singola categoria funzionale primaria a ciascun evento. L'affidabilità tra i valutatori è risultata elevata per tutte le misure codificate. L'indice kappa di Cohen ha indicato un accordo sostanziale per la codifica categorica delle funzioni di revisione (ĸ = 0.84, p < 0.001). Per le variabili ordinali a livello testuale, i coefficienti di correlazione intraclasse (ICC, modello a effetti misti bidirezionale, accordo assoluto) hanno dimostrato un'elevata affidabilità per il carico culturale (ICC = 0.86), la densità valutativa (ICC = 0.78) e la compressione narrativa (ICC = 0.82). Eventuali discrepanze iniziali nella codifica sono state successivamente risolte mediante adjudicazione congiunta.
Valutazione della qualità della traduzione
La qualità della traduzione è stata valutata in modo indipendente dai dati del processo da due valutatori con formazione a livello di dottorato ed ampia esperienza nell'insegnamento della traduzione. In cieco rispetto alle identità dei partecipanti e alle misure di processo, i valutatori hanno applicato una griglia di valutazione su 100 punti, distribuita equamente su cinque dimensioni: accuratezza semantica, fluidità linguistica, coerenza narrativa, resa culturale e adeguatezza del registro (Tabella 3). Le discrepanze nei punteggi superiori agli otto punti hanno innescato una revisione congiunta e una rivalutazione concordata, utilizzando la media concordata come punteggio finale di qualità della traduzione. I punteggi registrati prima della mediazione sono stati conservati per facilitare una rendicontazione trasparente dell'affidabilità tra i valutatori nei materiali di replica.
Modellizzazione statistica
Le analisi sono state condotte in tre fasi sequenziali. In primo luogo, sono state calcolate statistiche descrittive per riassumere tutte le variabili attraverso i diversi gruppi d'età e i tipi di testo. In secondo luogo, lo sforzo di elaborazione a livello di segmento è stato analizzato mediante modelli di regressione a effetti misti, al fine di tenere conto della struttura annidata dei segmenti all'interno dei testi e delle osservazioni ripetute provenienti dai singoli partecipanti. Le variabili dipendenti, tra cui la durata della prima pausa e la frequenza di revisione, sono state modellate come funzioni del carico culturale, della densità valutativa, della compressione narrativa e della rilevanza dei danmu, controllando al contempo per la competenza dei partecipanti. Sono state incluse correlazioni tra predittori, diagnosi dell'inflazione della varianza, intervalli di confidenza al 95%, stime dell'entità dell'effetto e indici di adattamento del modello per migliorare la trasparenza statistica.
Infine, la qualità della traduzione è stata modellata per valutare i contributi predittivi del momento della revisione e della funzione della revisione rispetto alla frequenza complessiva delle revisioni. L'overlapping tra i segmenti salienti dei danmu e i segmenti di traduzione ad alto sforzo è stato valutato utilizzando il quintile superiore di ciascuna distribuzione, un indice composito standardizzato di sforzo e un'analisi di sovrapposizione casuale. Non è stata effettuata alcuna analisi fattoriale esplorativa né modellazione tramite equazioni strutturali. Di conseguenza, le figure allegate sono presentate esclusivamente come sommari concettuali, descrittivi o basati su regressione.
Risultati
Profilo generale delle sessioni di traduzione
Tutti i 72 partecipanti hanno completato le tre attività di traduzione in condizioni sperimentali standardizzate, ottenendo 216 sessioni di traduzione complete. Dopo l'allineamento dei segmenti, il dataset analitico finale comprendeva 3.168 osservazioni di segmenti di testo per partecipante. Il tempo medio di completamento dell'attività nel campione è stato di 998,4 s per testo, con differenze evidenti tra i gruppi di studenti e i testi di partenza (Tabella 4; Figura 3). Di conseguenza, sia il manoscritto che i dati allegati supportano coerentemente una numerosità campionaria di n = 72 partecipanti; tutte le figure che riassumono sottogruppi devono identificare esplicitamente tali sottogruppi.
Gli studenti del quarto anno hanno completato i compiti di traduzione più rapidamente e con meno interruzioni rispetto agli studenti del secondo anno. Questa differenza ha riguardato non solo la velocità di elaborazione. Il gruppo del quarto anno ha mostrato anche una durata media delle prime pause più breve, un numero minore di pause lunghe e un numero totale inferiore di revisioni, ottenendo al contempo i punteggi più elevati per la qualità della traduzione. Al contrario, gli studenti del secondo anno hanno prodotto il maggior numero di revisioni, la maggior parte delle quali costituite da modifiche superficiali e correzioni locali immediate. Gli studenti avanzati hanno dimostrato una proporzione maggiore di revisioni differite e di revisioni relative all'adattamento culturale, indicando che una prestazione superiore nella traduzione era associata a strategie selettive di revisione piuttosto che a un volume maggiore di revisioni.
Le differenze tra i tre testi sorgenti erano altrettanto marcate. Il testo A ha prodotto i tempi di completamento più brevi, il minor numero di pause lunghe e la densità di revisione più bassa. I testi B e C hanno entrambi imposto maggiori richieste di elaborazione, sebbene attraverso meccanismi diversi. Il testo B ha provocato il numero più elevato di eventi di revisione legati alla cultura, mentre il testo C ha determinato la frequenza più alta di revisioni a livello discorsivo e la durata media delle pause all'interno dei segmenti più lunga. Pertanto, la fonte della difficoltà di elaborazione differiva tra i testi. Nel testo B, la difficoltà si concentrava principalmente sui riferimenti legati alla cultura e sulle assunzioni implicite dello sfondo, mentre nel testo C era associata principalmente alla compressione narrativa e alla posizione valutativa.
Un'analisi della varianza a un fattore ha confermato differenze significative tra i gruppi di studenti dei diversi anni accademici per quanto riguarda la qualità complessiva della traduzione, F (2, 69) = 31,84, p < 0,001, con un effetto di grande entità (η2 ≈ 0,48 calcolato in base ai punteggi medi a livello di partecipante). Confronti post hoc hanno mostrato che gli studenti del quarto anno hanno ottenuto punteggi significativamente più elevati rispetto agli studenti del terzo anno, i quali a loro volta hanno superato gli studenti del secondo anno. Lo stesso andamento è stato osservato per la durata della prima pausa, la frequenza di pause lunghe e il rapporto di revisione ritardata. Nel complesso, questi risultati preliminari stabiliscono due punti importanti per le analisi successive. In primo luogo, i tre testi sorgente differivano per difficoltà di elaborazione e non semplicemente per contenuto tematico. In secondo luogo, una qualità di traduzione più elevata era associata a una riorganizzazione dei processi traduttivi piuttosto che a una semplice riduzione dello sforzo cognitivo.
Effetti della rilevanza testuale sul processo decisionale e sui comportamenti di revisione
Per determinare se le proprietà testuali a livello di segmento prevedessero lo sforzo di elaborazione, sono stati stimati modelli a effetti misti per la durata della prima pausa, la frequenza di pause lunghe, la densità totale di revisioni e la densità di revisioni ritardate. Sono stati inseriti come effetti fissi il carico culturale, la densità valutativa, la compressione narrativa e la salienza dei danmu, con partecipante e segmento inclusi come intercette casuali (Tabella 5; Figura 4). L'analisi preliminare dei predittori ha confermato l'assenza di multicollinearità problematica, con tutti i valori del fattore di inflazione della varianza (VIF) ben al di sotto della soglia conservativa di 2,5 (VIF massimo = 1,45). Per valutare l'adattamento del modello e la proporzione di varianza spiegata, sono stati calcolati sia i valori marginali che condizionali di R2 per tutti i modelli a effetti misti (R2 marginale compreso tra 0,08 e 0,19; R2 condizionale compreso tra 0,46 e 0,64). I componenti completi della varianza per gli effetti casuali (intercette per partecipante e segmento) e gli indici corrispondenti di adattamento del modello sono riportati in Tabella 5. Le stime dei coefficienti vengono interpretate insieme ai rispettivi intervalli di confidenza al 95%, piuttosto che in base ai soli valori di p.
Il carico culturale ha mostrato l'effetto più forte e più costante in tutti i modelli. Nel modello della prima pausa, ogni incremento di un'unità nel punteggio del carico culturale era associato a un aumento di 0,91 s nella durata della prima pausa (b = 0,91, SE = 0,12, IC 95% [0,67, 1,15], p < 0,001). Il carico culturale ha inoltre aumentato significativamente la frequenza delle pause lunghe (b = 0,19, SE = 0,04, IC 95% [0,11, 0,27], p < 0,001) e la densità totale di revisione (b = 0,27, SE = 0,06, IC 95% [0,15, 0,39], p < 0,001). Pertanto, i segmenti con carico culturale non solo ritardavano l'elaborazione iniziale, ma aumentavano anche la probabilità di successiva riformulazione.
La compressione narrativa ha dimostrato un modello di effetti altrettanto robusto ma distinto. È risultata un forte predittore della revisione a livello discorsivo (b = 0.31, SE = 0.07, IC 95% [0.17, 0.45], p < .001) e ha aumentato in modo significativo la durata media delle pause all'interno dei segmenti (b = 0.58, SE = 0.14, IC 95% [0.31, 0.85], p < .001). In termini pratici, i segmenti che condensavano informazioni contestuali ampie in brevi tratti testuali avevano meno probabilità di indurre sostituzioni lessicali immediate e maggiori probabilità di richiedere una revisione strutturale più ampia.
La densità valutativa ha contribuito in modo significativo, anche se il suo effetto principale si è manifestato sulla revisione differita piuttosto che sulla latenza della decisione iniziale. Nel modello di revisione differita, la densità valutativa ha prodotto un coefficiente positivo (b = 0.23, SE = 0.05, IC 95% [0.13, 0.33], p < .001). Il suo effetto sulla durata della prima pausa è stato relativamente modesto (b = 0.34, SE = 0.13, IC 95% [0.09, 0.59], p = 0.010). Questi risultati indicano che gli indicatori valutativi non venivano sempre riconosciuti come colli di bottiglia nell'elaborazione durante la traduzione iniziale. Al contrario, spesso diventavano problematici solo dopo la stesura di una prima bozza, inducendo i traduttori a riconsiderare questioni relative al punto di vista, al tono o all'appropriatezza narrativa.
La rilevanza del danmu è rimasta un predittore significativo anche dopo aver controllato le variabili interne al testo. Ha predetto in modo significativo sia la durata della prima pausa (b = 0.36, SE = 0.14, IC 95% [0.09, 0.63], p = 0.011) sia la densità totale di revisione (b = 0.17, SE = 0.06, IC 95% [0.05, 0.29], p = 0.006). Sebbene la sua entità dell'effetto fosse inferiore rispetto a quella del carico culturale e della compressione narrativa, il suo contributo costante suggerisce che i segmenti che attirano maggiore attenzione pubblica nel corpus del danmu tendono anche a richiedere uno sforzo maggiore di elaborazione durante la traduzione. Questo risultato è interpretato come una prova convergente della rilevanza semantica, piuttosto che come evidenza che la frequenza del danmu causi direttamente difficoltà di traduzione.
Comportamento durante la revisione e qualità della traduzione
Le analisi successive hanno esaminato se la qualità della traduzione fosse meglio spiegata dalla quantità complessiva di revisioni o dalle loro caratteristiche temporali e funzionali. Il modello di qualità (Tabella 5) ha prodotto un chiaro schema di risultati. Il numero totale di revisioni non ha predetto in modo significativo la qualità della traduzione (b = 0,04, IC 95% [-0,06, 0,14], p = 0,412), mentre sia il momento temporale delle revisioni sia la loro funzione si sono rivelati predittori significativi. In particolare, il rapporto tra revisioni differite (b = 1,12, IC 95% [0,39, 1,85], p = 0,003), le revisioni a livello discorsivo (b = 1,76, IC 95% [0,96, 2,56], p < 0,001) e le revisioni di adattamento culturale (b = 2,04, IC 95% [1,14, 2,94], p < 0,001) erano tutti positivamente associati alla qualità della traduzione. Al contrario, le revisioni superficiali hanno mostrato una piccola ma statisticamente significativa associazione negativa (b = -0,63, IC 95% [-1,18, -0,08], p = 0,028).
Questi risultati indicano che la quantità di revisioni da sola non può distinguere una riformulazione produttiva da una stesura instabile (Figura 5). L'analisi qualitativa degli script di traduzione ha confermato questa interpretazione. Nelle traduzioni con punteggio più basso, le revisioni tendevano ad accumularsi intorno a sostituzioni lessicali locali e correzioni grammaticali, senza risolvere discrepanze più profonde tra gli indizi narrativi cinesi e la struttura retorica inglese. Nelle traduzioni con punteggio più alto, le revisioni ritardate coinvolgevano spesso la riorganizzazione della struttura informativa, l'introduzione di esplicitazioni selettive o l'adeguamento del linguaggio valutativo per migliorare la comprensibilità per un pubblico internazionale. Commenti danmu tradotti rappresentativi — tra cui «questa espressione è molto cinese», «il contesto va spiegato» e «il pubblico straniero potrebbe non comprendere questo riferimento» — illustrano i tipi di preoccupazioni culturalmente rilevanti del pubblico associate ai corrispondenti gruppi di segmenti. Questi esempi sono presentati esclusivamente per facilitare l'interpretazione e non devono essere interpretati come prova delle intenzioni dei partecipanti.
Sovrapposizione tra la rilevanza dei danmu e i collo di bottiglia nella traduzione
L'analisi finale ha esaminato se i segmenti particolarmente evidenti nei corpus dei danmu coincidessero con quelli che generavano il maggiore sforzo di elaborazione durante la traduzione. Un indice composito di sforzo è stato calcolato per ogni segmento standardizzando e sommando la durata della prima pausa, la frequenza delle pause lunghe e la densità di revisioni. I primi il 20% dei segmenti, in base a questo indice composito di sforzo, sono stati quindi confrontati con il 20% superiore classificato per rilevanza dei danmu.
L'overlapping è stato consistente: sei dei nove segmenti con il maggiore impegno sono comparsi anche tra i nove segmenti più salienti per i danmu, corrispondenti a un tasso di sovrapposizione del 66,7%. Poiché il confronto basato sul quintile superiore includeva soltanto nove segmenti, l'intervallo di confidenza di Wilson era relativamente ampio (IC 95% circa 35,4%–87,9%). Tuttavia, un'analisi esatta di sovrapposizione casuale ha indicato che una sovrapposizione di sei o più segmenti sarebbe risultata improbabile in caso di assegnazione casuale (p ≈ ,001). A livello di segmento, la salienza dei danmu è risultata positivamente correlata con l'indice composito di impegno (rho di Spearman ρ = 0,41, p = 0,006). La maggior parte dei segmenti sovrapposti si è verificata nei Testi B e C, concentrata su riferimenti culturalmente radicati, imprenditoria digitale e posizionamenti valutativi. Questi risultati suggeriscono che il discorso pubblico funge da indicatore esterno dei punti in cui il significato narrativo diventa particolarmente evidente, sebbene la relazione rimanga di tipo correlazionale e non causale.
Nel complesso, questi risultati dimostrano che lo sforzo di elaborazione nella traduzione di narrazioni incentrate sulla Cina è specifico per segmento ed è principalmente determinato dal carico culturale, dalla compressione narrativa e dalla densità valutativa. La qualità della traduzione non dipende dal volume complessivo di revisione, ma da strategie di revisione differite, sensibili al discorso e orientate alla cultura. Infine, l'allineamento osservato tra segmenti di traduzione ad alto sforzo e punti narrativi rilevanti per i danmu sostiene un'associazione tra rilevanza del pubblico e sforzo di elaborazione del traduttore, senza implicare che la rilevanza dei danmu in sé causi difficoltà di traduzione.
DISPONIBILITÀ DEI DATI:
Tutti i dati grezzi, i file di registrazione dei tasti premuti, le osservazioni elaborate a livello di segmento e a livello di sessione, i metadati dei video con danmu e i primi 5.000 commenti danmu visualizzati sono forniti nella cartella di lavoro del dataset di replica. Il file completo dei commenti danmu contiene 18.642 commenti ed è depositato insieme al pacchetto del dataset. Il dataset è accessibile tramite il repository Zenodo all'indirizzo https://doi.org/10.5281/zenodo.19289665.
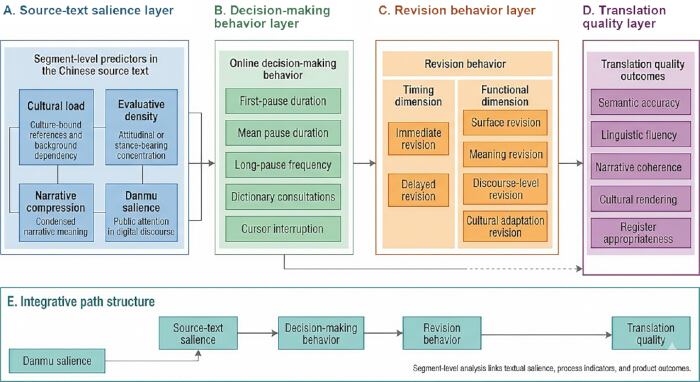
Figura 1: Quadro concettuale dello studio. (A) Predittori testuali a livello di segmento, inclusi carico culturale, densità valutativa, compressione narrativa e rilevanza dei danmu. (B) Indicatori di processo utilizzati per operazionalizzare il comportamento decisionale online, inclusi la durata della prima pausa, la durata media delle pause, la frequenza delle pause lunghe, le consultazioni del dizionario e le interruzioni del cursore. (C) Classificazione bidimensionale del comportamento di revisione in base al momento della revisione e alla funzione della revisione. (D) Cinque dimensioni utilizzate per valutare la qualità della traduzione: accuratezza semantica, fluidità linguistica, coerenza narrativa, resa culturale e appropriatezza del registro. (E) Quadro analitico complessivo che mostra le relazioni tra rilevanza del testo sorgente, comportamento decisionale, comportamento di revisione e qualità della traduzione, con la rilevanza dei danmu che funge da indicatore esterno della rilevanza semantica del pubblico. Nessuna analisi fattoriale esplorativa (EFA) né modellazione dell'equazione strutturale (SEM) è stata eseguita o è presentata in questo studio. Cliccare qui per visualizzare una versione ingrandita di questa figura.
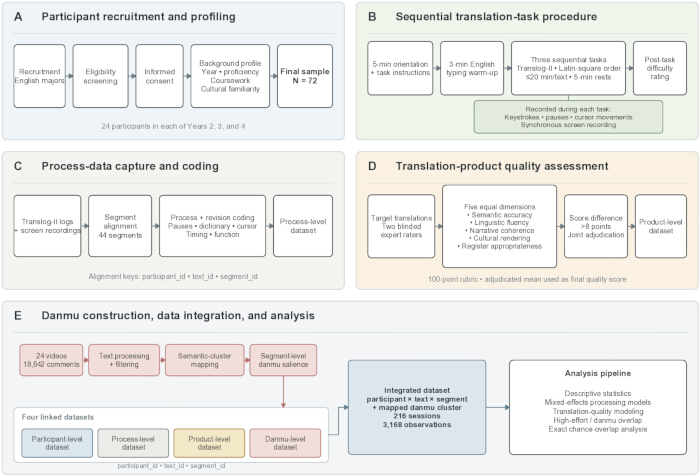
Figura 2: Flusso di lavoro per la raccolta e l'allineamento dei dati. (A) Reclutamento dei partecipanti, valutazione dell'idoneità, consenso informato e raccolta di informazioni preliminari. (B) Somministrazione delle tre attività di traduzione in Translog-II in condizioni sperimentali standardizzate. (C) Raccolta dei dati di processo, inclusi battute, pause, movimenti del cursore, episodi di revisione e registrazioni sincronizzate dello schermo. (D) Valutazione cieca da parte di esperti dei prodotti traduttivi, seguita da risoluzione delle discrepanze nei punteggi. (E) Costruzione del corpus ausiliario danmu e il suo allineamento con i dataset a livello di partecipante, testo, segmento, processo e prodotto per generare il dataset finale integrato utilizzato per le analisi inferenziali. Cliccare qui per visualizzare una versione ingrandita di questa figura.
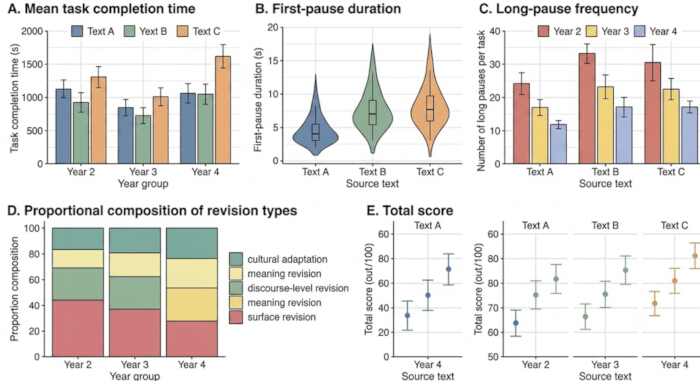
Figura 3: Distribuzione delle misure di processo e di prodotto tra i diversi gruppi annuali e i testi sorgente. (A) Tempo medio di completamento del compito in base al testo sorgente e al gruppo annuale. (B) Distribuzione della durata della prima pausa nei tre testi sorgente. (C) Frequenza delle pause lunghe in base al testo sorgente e al gruppo annuale. (D) Distribuzione proporzionale delle categorie di revisione tra i diversi gruppi annuali, inclusi revisioni di superficie, revisioni di significato, revisioni a livello discorsivo e revisioni di adattamento culturale. (E) Punteggi totali di qualità della traduzione per gruppo annuale e per ciascun testo sorgente. Nel complesso, i grafici mostrano che i livelli scolastici superiori sono associati a minori interruzioni nel processo cognitivo, strategie di revisione più selettive e una qualità della traduzione più elevata, mentre i Testi B e C richiedono uno sforzo di elaborazione maggiore rispetto al Testo A. Cliccare qui per visualizzare una versione ingrandita di questa figura.
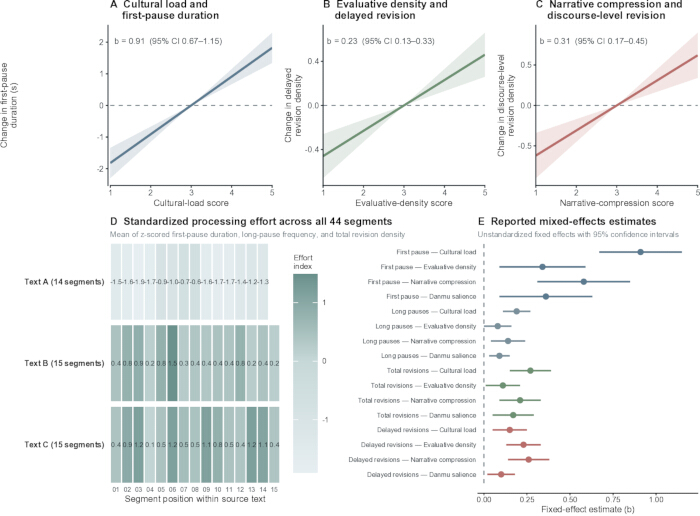
Figura 4: Effetti della rilevanza testuale a livello di segmento sul comportamento durante il processo di traduzione. (A) Effetto marginale stimato del carico culturale sulla durata della prima pausa. (B) Effetto marginale stimato della densità valutativa sulla densità delle revisioni ritardate. (C) Effetto marginale stimato della compressione narrativa sulla densità delle revisioni a livello discorsivo. (D) Mappa termica dell'indice standardizzato dello sforzo di elaborazione in tutti i segmenti del testo sorgente, raggruppati per testo sorgente. (E) Coefficienti standardizzati ad effetti fissi stimati dai modelli di regressione a effetti misti. La figura dimostra che diverse caratteristiche testuali attivano percorsi di elaborazione distinti, con il carico culturale, la densità valutativa e la compressione narrativa che contribuiscono all'esitazione e alla revisione attraverso meccanismi in parte diversi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
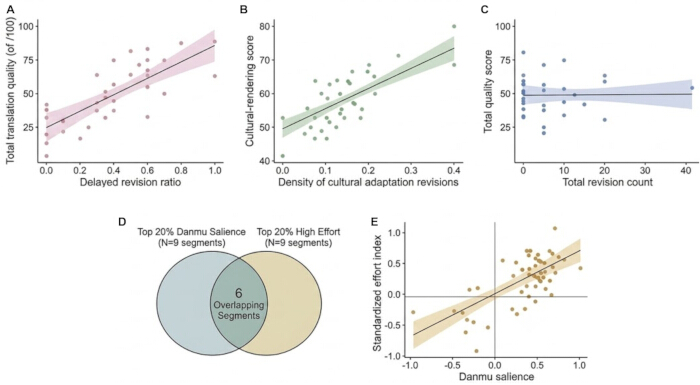
Figura 5: Relazioni tra processo di traduzione, qualità della traduzione e rilevanza dei danmu. (A) Associazione tra la percentuale di revisioni differite e il punteggio totale di qualità della traduzione. (B) Relazione tra le revisioni relative all'adattamento culturale e il punteggio di resa culturale. (C) Associazione tra il numero totale di revisioni e la qualità complessiva della traduzione, che evidenzia il valore predittivo limitato della quantità di revisioni presa singolarmente. (D) Sovrapposizione tra il 20% superiore dei segmenti con maggiore rilevanza nei danmu e il 20% superiore dei segmenti di traduzione ad alto sforzo. (E) Associazione a livello di segmento tra la rilevanza dei danmu e l'indice standardizzato di sforzo di elaborazione. Nel complesso, i pannelli mostrano che il successo della traduzione è associato a revisioni tempestive e mirate funzionalmente, piuttosto che semplicemente al volume di revisioni, e che i segmenti narrativi più rilevanti pubblicamente tendono a coincidere con collo di bottiglia nella traduzione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| ID del testo | Argomento narrativo | Caratteri cinesi | Numero di segmenti | Punteggio di carico culturale (1–5) | Punteggio di densità valutativa (1–5) | Punteggio di compressione narrativa (1–5) | Difficoltà prevista | Nota di validazione |
| Testo A | Narrazione sul ritorno a casa per la Festa di Primavera | 212 | 14 | 3 | 2 | 3 | Moderata | Test pilota effettuato con 12 studenti non partecipanti |
| Testo B | Narrazione di ricordi sulla Festa delle barche del drago | 219 | 15 | 5 | 3 | 4 | Alta | Test pilota effettuato con 12 studenti non partecipanti |
| Testo C | Narrazione sullo streaming rurale e lo sviluppo del paese d'origine | 223 | 15 | 4 | 5 | 4 | Alta | Test pilota effettuato con 12 studenti non partecipanti |
Tabella 1: Profilo del testo sorgente e struttura dei segmenti.
| Variabile | Livello | Definizione operativa | Unità di misura |
| Durata della prima pausa | Segmento | Tempo trascorso dall'inizio del segmento fino alla prima pressione di un tasto nella lingua bersaglio rilevante | Secondi |
| Durata media delle pause all'interno del segmento | Segmento | Durata media di tutte le pause all'interno del segmento | Secondi |
| Frequenza delle pause lunghe | Segmento | Numero di pause superiori a 2 secondi | Conteggio |
| Consultazioni del dizionario | Segmento | Numero di attivazioni della finestra del dizionario durante l'elaborazione del segmento | Conteggio |
| Interruzioni del cursore | Segmento | Numero di uscite basate sul cursore dalla stesura lineare prima del completamento stabile | Conteggio |
| Revisione immediata | Segmento | Revisione effettuata prima che la stesura proceda oltre l'area di testo locale corrente | Conteggio / densità |
| Revisione differita | Segmento | Revisione effettuata dopo che la stesura è progredita verso una sezione successiva del testo | Conteggio / densità |
| Revisione a livello formale | Funzione di revisione | Correzione a livello formale senza cambiamento semantico | Conteggio / densità |
| Revisione del significato | Funzione di revisione | Modifica lessicale o sintattica che influisce sull'espressione del significato | Conteggio / densità |
| Revisione a livello discorsivo | Funzione di revisione | Modifica delle relazioni tra proposizioni, della coerenza o dell'ordine delle informazioni | Conteggio / densità |
| Revisione di adattamento culturale | Funzione di revisione | Riformulazione o esplicitazione orientata al pubblico destinatario di significati legati alla cultura | Conteggio / densità |
| Indice composito dello sforzo | Segmento | Composito standardizzato della durata della prima pausa, della frequenza delle pause lunghe e della densità delle revisioni | punteggio z |
| Salienza dei Danmu | Segmento / cluster semantico | Indicatore ponderato del cluster semantico basato sulla frequenza normalizzata dei cluster di parole chiave, sulla concentrazione dei commenti e sull'intensità valutativa | Punteggio continuo |
Tabella 2: Definizioni operative delle variabili di processo.
| Dimensione | Intervallo del punteggio | Focus della valutazione |
| Accuratezza semantica | 1-20 | Fedeltà al significato della fonte, precisione del contenuto trasferito e assenza di distorsioni significative |
| Fluenza linguistica | 1-20 | Correttezza grammaticale, naturalezza, idiomaticità e leggibilità a livello di frase |
| Coesione del testo | 1-20 | Flusso delle informazioni, collegamento delle proposizioni, progressione logica e stabilità del testo |
| Rendizione culturale | 1-20 | Trattamento dei riferimenti legati alla cultura, esplicitazione, inquadramento e accessibilità interpretativa |
| Adeguatezza del registro | 1-20 | Adattamento al pubblico previsto, idoneità stilistica e controllo del tono |
Tabella 3: Schema di valutazione della qualità della traduzione.
| Sezione | Variabile | Anno 2 (n = 24), media ± DS | Anno 3 (n = 24), media ± DS | Anno 4 (n = 24), media ± DS |
| Profilo della sessione a livello di partecipante | Tempo di completamento del compito (sec) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Profilo della sessione a livello di partecipante | Durata media della prima pausa (sec) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| Profilo della sessione a livello di partecipante | Frequenza di pause lunghe per compito | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| Profilo della sessione a livello di partecipante | Numero totale di revisioni per compito | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| Configurazione delle revisioni | Rapporto di revisione posticipata | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| Configurazione delle revisioni | Rapporto di revisione a livello discorsivo | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| Configurazione delle revisioni | Rapporto di revisione per adattamento culturale | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| Configurazione delle revisioni | Rapporto di revisione superficiale | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| Qualità del prodotto | Punteggio totale di qualità | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| Qualità del prodotto | Punteggio di resa culturale | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
Tabella 4: Statistiche descrittive per le variabili di processo e di prodotto.
| Variabile risultato | Predittore | b | SE | IC 95% | t/z | p |
| Durata della prima pausa | Carico culturale | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Durata della prima pausa | Densità valutativa | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Durata della prima pausa | Compressione narrativa | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Durata della prima pausa | Salienza Danmu | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Frequenza delle pause lunghe | Carico culturale | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Frequenza delle pause lunghe | Densità valutativa | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Frequenza delle pause lunghe | Compressione narrativa | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Frequenza delle pause lunghe | Salienza Danmu | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Densità totale di revisione | Carico culturale | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Densità totale di revisione | Densità valutativa | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Densità totale di revisione | Compressione narrativa | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Densità totale di revisione | Salienza Danmu | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Densità di revisione ritardata | Carico culturale | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Densità di revisione ritardata | Densità valutativa | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Densità di revisione ritardata | Compressione narrativa | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Densità di revisione ritardata | Salienza Danmu | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Punteggio totale di qualità | Revisioni totali | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Punteggio totale di qualità | Rapporto di revisione ritardata | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Punteggio totale di qualità | Revisioni a livello discorsivo | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Punteggio totale di qualità | Revisioni di adattamento culturale | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Punteggio totale di qualità | Revisioni superficiali | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Punteggio totale di qualità | Gruppo d'anno | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabella 5: Modelli a effetti misti per la previsione del comportamento del processo a livello di segmento e della qualità della traduzione.
Discussione
I risultati attuali dimostrano che la difficoltà nella traduzione dal cinese all'inglese di narrazioni incentrate sulla Cina non è distribuita in modo uniforme all'interno di un testo. Al contrario, si concentra in segmenti in cui riferimenti culturali, posizioni valutative e significati narrativi compressi convergono. Questo conferma un approccio basato sui processi, piuttosto che su una semplice carenza lessicale, per comprendere la difficoltà traduttiva. La ricerca empirica sui processi traduttivi sottolinea che la traduzione è un'attività organizzata temporalmente, in cui esitazione, orientamento e produzione sono distribuiti in modo disomogeneo19. La concentrazione di sforzo osservata in questo studio riflette come segmenti specifici esercitino una maggiore pressione interpretativa, interrompendo la stesura lineare in misura più profonda rispetto ad altri. Il test delle ipotesi può essere riassunto come segue: l'ipotesi H1 è stata confermata poiché il carico culturale ha aumentato l'esitazione iniziale e la densità di revisione; l'ipotesi H2 è stata perfezionata poiché la densità valutativa e la compressione narrativa agiscono attraverso percorsi di revisione differenti; l'ipotesi H3 è stata confermata poiché il momento temporale e la funzione delle revisioni predicono la qualità in modo più forte rispetto al numero totale di revisioni; e l'ipotesi H4 è stata confermata come sovrapposizione associativa tra la rilevanza dei danmu e i segmenti ad alto sforzo, e non come relazione causale.
Per quanto riguarda il comportamento di revisione, i dati mostrano che il numero totale di revisioni non predice la qualità della traduzione; piuttosto, le revisioni differite, a livello discorsivo e di adattamento culturale sono i fattori principali che determinano prestazioni migliori. Questa distinzione suggerisce che la revisione è produttiva solo quando viene eseguita come una rivalutazione strutturata, piuttosto che come ripetute correzioni locali. In linea con le ricerche basate sul tracciamento oculare e sulla registrazione delle pressioni dei tasti, che indicano come i traduttori principianti allocchino lo sforzo in modo diverso quando i compiti diventano difficili, gli studenti più bravi in questo studio non sono stati semplicemente più attivi7. Essi hanno interrotto selettivamente le soluzioni provvisorie, le hanno rivalutate in fasi successive e hanno indirizzato le revisioni verso la coerenza narrativa o culturale. Di conseguenza, i punteggi del prodotto finale da soli non sono sufficienti a spiegare le prestazioni del traduttore, poiché punteggi finali simili spesso derivano da traiettorie procedurali profondamente diverse9.
Questo fenomeno è meglio comprensibile attraverso la lente della conversione dello sforzo. Nelle traduzioni con punteggio più basso, lo sforzo cognitivo rimaneva confinato a livello locale: gli studenti facevano pause, sostituivano elementi lessicali o modificavano articoli, ma non riuscivano a risolvere incoerenze più profonde tra le implicazioni del testo sorgente e la struttura del testo di arrivo. Al contrario, negli elaborati con punteggio più alto lo sforzo veniva convertito in decisioni strutturali che ottimizzavano il testo per il lettore di destinazione. In parallelo con la ricerca sulle prestazioni degli studenti nella post-editing, questi risultati confermano che lo sforzo del processo non è automaticamente vantaggioso; il suo valore dipende dalla sua conversione in un miglioramento testuale interpretabile20.
Inoltre, diverse proprietà testuali attivano meccanismi di elaborazione distinti. Il carico culturale aumenta in modo affidabile l'esitazione iniziale e la densità di revisione, mentre la compressione narrativa predice in modo significativo la revisione a livello discorsivo. Questa distinzione chiarisce perché i segmenti difficili si manifestano in modo diverso durante il processo traduttivo: alcuni interrompono l'accesso cognitivo nella fase iniziale di formulazione, mentre altri diventano problematici soltanto durante il mantenimento della coerenza su porzioni più ampie di discorso. In linea con studi che mostrano come testi difficili producano unità di elaborazione più piccole e interruzioni più dense, questi risultati sottolineano come significati culturali e valutativi compressi costringano i traduttori a oscillare tra l'espressione locale e l'inquadramento narrativo globale8.
Un importante contributo metodologico di questo studio è l'integrazione della rilevanza del danmu come livello del discorso del pubblico. La notevole sovrapposizione tra segmenti di traduzione ad alto sforzo e segmenti con elevata rilevanza del danmu indica che i colli di bottiglia incontrati dagli studenti coincidono spesso con punti che attirano una maggiore attenzione del pubblico nella circolazione digitale. Ciò collega la difficoltà di traduzione al discorso partecipativo senza confondere i due costrutti. I commenti danmu rivelano ciò che il pubblico nota o contesta nella circolazione mediata dal video, mentre i dati relativi ai battiti dei tasti e alle revisioni mostrano come gli studenti traduttori elaborano segmenti semanticamente correlati del testo sorgente. L'interpretazione più plausibile è quindi quella basata su stimoli comuni: riferimenti carichi di contenuto culturale, assunzioni implicite condensate e posizionamenti valutativi possono contemporaneamente attirare l'attenzione del pubblico e aumentare la pressione cognitiva sui traduttori21.
Da un punto di vista pedagogico, questa sovrapposizione suggerisce che le narrazioni incentrate sulla Cina circolano in contesti in cui il significato viene negoziato pubblicamente e rapidamente, regolato da priorità contrastanti come immediatezza, intelligibilità e allineamento con il pubblico22. Di conseguenza, la formazione dei traduttori deve spostarsi dalla concezione della revisione come fase generica di correzione, per privilegiare interventi funzionali e strategicamente temporali. Gli intoppi osservati raramente erano causati unicamente dalla terminologia; emergevano piuttosto là dove il significato narrativo dipendeva da presupposti culturalmente radicati, da inquadrature relazionali e da un accesso selettivo del pubblico. Analogamente alla diffusione della letteratura narrativa etnica cinese, la trasposizione di queste narrazioni richiede di andare oltre la fedeltà lessicale, per determinare come il significato culturale locale debba essere riorganizzato al fine di una più ampia circolazione globale23. Il metodo può essere applicato nella formazione dei traduttori utilizzando registrazioni delle battute digitate, registrazioni dello schermo ed esempi di discorso rivolti al pubblico, per aiutare gli studenti a identificare quando un segmento richieda esplicitazione, riordinamento, inquadramento culturale o adeguamento del registro, piuttosto che una semplice sostituzione lessicale.
Diversi limiti condizionano l'interpretazione di questi risultati. In primo luogo, la rilevanza del danmu è un indicatore basato su cluster semantici per l'engagement del pubblico, non una misura diretta della difficoltà linguistica, e il presente disegno correlazionale non consente di stabilire un rapporto di causalità tra rilevanza pubblica e sforzo di traduzione. Studi futuri potrebbero manipolare sperimentalmente il carico culturale, la densità valutativa e la compressione narrativa per verificare i percorsi causali. In secondo luogo, il campione è limitato a traduttori in formazione di un'unica università, e l'esperienza dei partecipanti, la familiarità culturale e la competenza nella lingua secondaria sono state controllate statisticamente piuttosto che mediante un campionamento pienamente stratificato. Una replica con traduttori professionisti, studenti di diverse istituzioni e fasce più ampie di competenza rafforzerebbe la generalizzabilità. In terzo luogo, i testi di partenza sono stati costruiti dai ricercatori e sottoposti a test pilota per calibrare il compito, ma studi futuri dovrebbero includere ulteriori validazioni mediante testi pubblici autentici e gruppi indipendenti per lo sviluppo del materiale. In quarto luogo, la codifica del carico culturale, della densità valutativa, della compressione narrativa e delle funzioni di revisione si basa su definizioni operative trasparenti, registrazioni di codificatori indipendenti e affidabilità inter-codificatore verificabile, insieme al file di codifica concordato. Ricerche future potrebbero inoltre combinare la registrazione delle battute a macchina con l'eye-tracking, interviste retrospettive, protocolli verbali simultanei o compiti di post-modifica per triangolare i meccanismi cognitivi alla base delle decisioni di revisione.
In definitiva, questo studio chiarisce le basi procedurali delle prestazioni degli studenti nella traduzione dall'italiano all'inglese di narrazioni incentrate sull'Italia. Collegando i dati di registrazione dei battiti sulla tastiera, la valutazione del prodotto finale e il discorso digitale del pubblico, i risultati dimostrano che i colli di bottiglia nella traduzione si verificano in corrispondenza di significati narrativi carichi di implicazioni pubbliche. Il fattore determinante nella traduzione interculturale non è il semplice volume delle revisioni, bensì la capacità del traduttore di riconoscere i segmenti che richiedono un ripensamento interpretativo e di ritardare strategicamente la chiusura del processo finché non si è formulata una soluzione stabile e adeguata al pubblico di riferimento.
Dichiarazioni
Gli autori non hanno nulladadichiarare.
Contributi degli autori
Weijia Chen: Concettualizzazione, metodologia, analisi formale, indagine, stesura della bozza originale.
Chunming Wu: Progettazione dello studio, guida sull'analisi formale e sulle procedure di gestione dei dati, revisione e feedback sui rivedimenti in risposta ai commenti dei revisori.
Ringraziamenti
Questa ricerca è stata finanziata da due borse provenienti dall'Università Normale di Hanshan. In particolare, costituisce un risultato parziale del programma del 2023 per Corsi di Laurea di Prima Classe (Corsi di Prima Classe in presenza) dedicato a "Teoria e Pratica della Traduzione Cinese–Inglese II" (Numero di approvazione: YHS [2023] 172). Inoltre, lo studio è stato sostenuto dal Progetto per la Qualità dell'Insegnamento e la Riforma Didattica del 2025, designato come Corso Modello per l'Educazione Ideologica e Politica basata sui programmi didattici per "Traduzione Cinese–Inglese" (Numero di approvazione: YHSJ〔2025〕126). Gli autori ringraziano sentitamente l'istituzione per il supporto fornito al completamento di questa ricerca.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Corpus di danmu di Bilibili | Bilibili | 24 video; 18.642 commenti;https://www.bilibili.com | Costruzione del corpus ausiliario di danmu e calcolo della rilevanza dei segmenti di danmu |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Pulizia dei dati, organizzazione della codifica e gestione preliminare dei dati |
| R | Fondazione R per il Calcolo Statistico | R 4.3.1;https://www.r-project.org | Modellazione a effetti misti, analisi delle correlazioni e generazione di figure |
| Software di registrazione dello schermo | Postazione di lavoro del laboratorio | Utilità della postazione locale; nessun numero di catalogo | Verifica degli episodi di revisione non lineari e backup dei dati di processo |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Statistica descrittiva, ANOVA e analisi statistiche di base |
| Translog-II | Scuola Superiore di Economia di Copenaghen / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Registrazione delle battute a macchina e dei dati relativi a pause, movimenti del cursore ed episodi di revisione durante i compiti di traduzione |
Riferimenti
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.