Questo metodo presenta un framework basato sull'intelligenza artificiale spiegabile (XAI) completo per consentire la migrazione sicura dei dati sanitari nel cloud, sfruttando un dataset sanitario sintetico all'interno di un ambiente cloud controllato. Il risultato è un prototipo che combina sicurezza basata sul modello zero-trust, controllo degli accessi basato sul tempo e rilevamento spiegabile delle anomalie per supportare trasparenza e sicurezza nella migrazione.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Un protocollo sperimentale per la migrazione sicura di dati in cloud guidata dall'IA spiegabile utilizzando dati sanitari sintetici
In questo articolo
Sommario
Abstract
Nei sistemi sanitari, si assiste a un crescente ricorso alla migrazione dei dati nel cloud, ma ciò comporta anche una modifica dei momenti in cui il trasferimento dei dati rappresenta probabilmente il rischio maggiore in termini di sicurezza. Questo articolo descrive un protocollo riproducibile per la migrazione sicura di dati nel cloud basato sull'intelligenza artificiale spiegabile (XAI), utilizzando un dataset sanitario sintetico e un ambiente cloud controllato. Il framework sviluppato integra l'architettura zero-trust, il principio del privilegio minimo temporale, la comunicazione crittografata, il monitoraggio centralizzato e il rilevamento spiegabile delle anomalie per garantire una migrazione più sicura, trasparente e verificabile. I test sono stati effettuati su un dataset di 10 GB di cartelle cliniche elettroniche sintetiche, costituito da circa 20 milioni di record distribuiti in 28 tabelle relazionali. Il processo di migrazione è stato eseguito su Amazon Web Services (AWS) utilizzando database PostgreSQL e reti virtuali private. Per il rilevamento delle anomalie è stato impiegato Isolation Forest, mentre le spiegazioni additive di Shapley (SHAP) sono state utilizzate per l'interpretazione sicura degli eventi. Il framework è stato valutato su dieci tentativi distinti di migrazione, utilizzando metriche come la durata dell'esposizione delle credenziali, il tempo di rilevamento degli incidenti, l'accuratezza del rilevamento delle anomalie, la latenza della migrazione e l'integrità dei dati. Nella configurazione testata, l'esposizione delle credenziali è stata ridotta da 24 ore a 1 ora (una riduzione del 95,8%), l'accuratezza del rilevamento delle anomalie è stata del 97,4%, il tempo di rilevamento degli incidenti è stato ridotto a circa 15 minuti e l'integrità dei dati è stata preservata al 100% mediante convalida tramite checksum. Tuttavia, le misure di sicurezza più rigorose hanno determinato un aumento medio della latenza di migrazione del 11%. Questi risultati dimostrano il potenziale dell'integrazione tra intelligenza artificiale spiegabile e flussi di lavoro per la migrazione sicura nel cloud nella gestione dei dati sanitari.
Introduzione
Il cloud computing è ormai parte integrante dei sistemi sanitari in tutto il mondo, offrendo spazio di archiviazione scalabile, risorse computazionali e la possibilità di scambiare cartelle cliniche, supportare sistemi di decisione e abilitare analisi sanitarie attraverso il cloud1,2,3. Con molte istituzioni sanitarie che stanno aggiornando i propri sistemi informativi, il passaggio al cloud è diventato un passo fondamentale per trasferire i dati sanitari sensibili conservati nei vecchi sistemi on-premise al cloud4. Una corretta migrazione consente un recupero più semplice dei dati, un funzionamento più efficiente delle operazioni e un supporto alle analisi con livelli più elevati di intelligenza; tuttavia, non si possono ignorare i rischi significativi per la sicurezza e la privacy che comporta lo spostamento dei dati da un luogo all'altro5.
La fase di migrazione è un momento notoriamente vulnerabile nel ciclo di vita dei dati, poiché i dati sanitari vengono attivamente trasferiti tra sistemi e reti per natura del processo6. Inoltre, le organizzazioni possono essere esposte a minacce come il hacking delle credenziali, l'accesso non autorizzato, l'intercettazione dei dati, la manipolazione di schemi e persino la perdita di dati durante la fase di migrazione6,7. Gli ambienti sanitari sono meno immuni a questi rischi poiché le informazioni dei pazienti sono altamente sensibili e richiedono pertanto il più alto livello di conformità alle misure regolatorie e di sicurezza8,9. In assenza di tali garanzie, non è possibile assicurare la riservatezza, l'integrità e la responsabilità dei dati se il flusso di lavoro di migrazione non è protetto e reso osservabile10,11.
Sono stati sviluppati diversi framework e standard di sicurezza per migliorare la sicurezza nel cloud. Ad esempio, l'architettura Zero Trust del National Institute of Standards and Technology (NIST) si basa sulla verifica continua di utenti, dispositivi e servizi12, mentre i framework per l'adozione del cloud forniscono indicazioni su governance, gestione delle identità, crittografia e monitoraggio13. In effetti, i metodi attuali di sicurezza nel cloud si concentrano sull'automazione, sull'infrastruttura-come-codice e sul monitoraggio continuo14,15. Sebbene tali approcci si fondino su principi di sicurezza validi, in larga misura essi riguardano ambienti generali di distribuzione e operativi nel cloud piuttosto che il processo di migrazione stesso16. In realtà, raramente presentano procedure dettagliate, passo dopo passo e riproducibili per eseguire flussi di lavoro sicuri di migrazione dei dati sanitari nel cloud che combinino gestione delle identità, trasferimento sicuro dei dati, convalida, monitoraggio e consolidamento post-migrazione17.
L'individuazione automatica delle anomalie basata sul machine learning è stata riconosciuta come una tecnologia utile per il monitoraggio della sicurezza negli ambienti cloud. Essa rileva attività anomale del sistema nonché possibili incidenti di sicurezza18. Tuttavia, molti metodi di rilevamento delle anomalie sono sistemi chiusi che non forniscono spiegazioni sulle motivazioni alla base dell'identificazione di un evento di sicurezza19. L'incapacità di spiegare le decisioni prese dal sistema riduce la credibilità degli amministratori, rende difficoltoso il controllo e riduce il valore delle decisioni di sicurezza automatizzate negli ambienti sanitari altamente regolamentati20. Metodi di intelligenza artificiale spiegabile (XAI), come SHapley Additive exPlanations (SHAP) e Local Interpretable Model-agnostic Explanations (LIME), non solo forniscono spiegazioni chiare sulle previsioni del machine learning, ma migliorano anche la comprensione, la responsabilità e la fiducia nei sistemi di monitoraggio della sicurezza21,22.
Nonostante i notevoli progressi compiuti nella sicurezza del cloud e nell'intelligenza artificiale spiegabile, esiste ancora una scarsità di protocolli sperimentali riproducibili che combinino controlli di migrazione sicuri con un monitoraggio della sicurezza spiegabile ai fini dell'integrazione23. La ricerca esistente affronta principalmente singoli componenti, come crittografia, controllo degli accessi, rilevamento di anomalie o governance del cloud, e non fornisce alcun metodo integrato che possa essere implementato, valutato e riprodotto sistematicamente24. In aggiunta, pochissimi studi hanno cercato di integrare in un unico flusso di lavoro per la migrazione cloud nel settore sanitario i principi di sicurezza zero-trust, il privilegio minimo temporale, l'osservabilità centralizzata e il rilevamento spiegabile delle anomalie25,26.
Questo articolo presenta un framework basato sull'intelligenza artificiale interpretabile (Explainable AI) per la migrazione sicura dei dati nel cloud nei sistemi sanitari, al fine di colmare questa lacuna. L'architettura proposta utilizza un modello zero-trust, accesso temporaneamente limitato, comunicazione sicura, registrazione centrale e monitoraggio, nonché rilevamento interpretabile delle anomalie basato su SHAP, all'interno di un processo di migrazione ben strutturato27,28. Il protocollo costituisce una guida passo dopo passo per l'implementazione, il monitoraggio e la valutazione della migrazione sicura dei dati sanitari in condizioni sperimentali. Unendo controlli di sicurezza a un monitoraggio interpretabile basato sull'intelligenza artificiale, il framework proposto mira ad aumentare il livello di trasparenza, verificabilità e sicurezza lungo l'intero ciclo di vita della migrazione29,30.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato un dataset sanitario completamente sintetico, generato per la valutazione sperimentale della migrazione sicura dei dati nel cloud. Non sono stati utilizzati dati reali di pazienti, informazioni sanitarie protette (PHI) né record sanitari identificabili. Pertanto, non è stata richiesta l'approvazione del comitato etico né il consenso informato. Tutti i materiali utilizzati in questo studio sono riportati nella Tabella dei materiali.
1. Panoramica
- Configurare un ambiente sicuro per la migrazione al cloud composto da un livello sorgente, un livello hub di migrazione, un livello di destinazione, un livello di rete, un livello di gestione dell'identità e dell'accesso, un livello di osservabilità e un livello di intelligenza artificiale spiegabile.
- Distribuire tutti i componenti all'interno di ambienti cloud isolati per supportare la migrazione sicura dei dati sanitari. Stabilire canali di comunicazione crittografati tra tutti i componenti del sistema.
- Eseguire il protocollo attraverso la preparazione del dataset, la configurazione dell'ambiente, il deployment dell'architettura, la migrazione sicura, il monitoraggio delle anomalie e la validazione post-migrazione. L'architettura generale del framework proposto per la migrazione sicura di dati nel cloud basato su intelligenza artificiale spiegabile è illustrata in Figura 1.
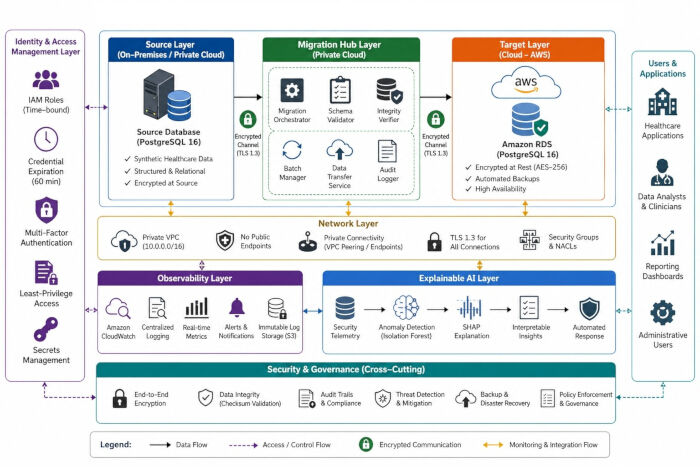
Figura 1: Architettura generale del framework sicuro di migrazione dei dati nel cloud abilitato all'intelligenza artificiale spiegabile (XAI) per i sistemi sanitari. Il framework comprende il livello di gestione dell'identità e dell'accesso, il livello del database sorgente, il livello del centro di migrazione, il livello del database cloud di destinazione, il livello di sicurezza della rete, il livello di osservabilità, il livello di monitoraggio con intelligenza artificiale spiegabile e i servizi trasversali di sicurezza e governance. L'architettura integra il controllo degli accessi temporale con privilegi minimi, comunicazioni crittografate con TLS 1.3, verifica dell'integrità basata su checksum, monitoraggio continuo della sicurezza e spiegabilità basata su SHAP, per garantire una migrazione sicura, trasparente e riproducibile dei database sanitari. Questa figura è stata creata dagli autori utilizzando Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
2. Configurazione dell'ambiente computazionale
- Configurare l'ambiente computazionale
- Preparare le risorse computazionali necessarie per la migrazione sicura dei dati nel cloud e il monitoraggio basato su intelligenza artificiale spiegabile.
- Installare e configurare tutto l'hardware, il software, i servizi cloud, i database, gli strumenti di sicurezza e le librerie di apprendimento automatico elencati nella Tabella dei Materiali. Verificare che tutti i componenti richiesti siano operativi prima di avviare l'esperimento di migrazione.
- Configurare l'ambiente cloud
- Impostare un ambiente cloud sicuro per la migrazione dei dati sanitari. Configurare una VPC privata per consentire una comunicazione fluida tra il sistema sorgente, il centro di migrazione e i sistemi di destinazione. Utilizzare una crittografia robusta non solo per i dati a riposo, ma anche per i dati in transito.
- Preparare il database di destinazione e i servizi di migrazione secondo le indicazioni riportate nella Tabella dei Materiali.
- Configurare la gestione delle identità e degli accessi. Configurare i servizi di monitoraggio e registrazione.
3. Preparazione e descrizione del set di dati
- Generare un dataset sanitario sintetico utilizzando la libreria Python Faker elencata nella Tabella dei Materiali. Configurare gli attributi demografici, inclusi età, sesso, etnia e localizzazione geografica del paziente, utilizzando distribuzioni di probabilità predefinite.
- Generare informazioni cliniche, inclusi diagnosi, risultati di laboratorio, farmaci, allergie, procedure e ricoveri ospedalieri, mantenendo relazioni cliniche realistiche.
- Generare visite longitudinali per paziente assegnando più visite a singoli pazienti in base a distribuzioni di frequenza delle visite predefinite.
- Generare timestamp per ricoveri, indagini di laboratorio, somministrazione di farmaci, riassunti di dimissione e registri di audit rispettando un ordine cronologico degli eventi.
- Introdurre valori mancanti clinicamente realistici, record duplicati e osservazioni anomale secondo distribuzioni di qualità dei dati predefinite.
- Sostituire tutte le informazioni personalmente identificabili con valori sintetici generati mediante la libreria Faker. Verificare l'integrità referenziale e la coerenza logica prima dell'esportazione del dataset. Esportare il dataset convalidato in formato SQL compatibile con PostgreSQL. Configurare il dataset per supportare scenari realistici di migrazione sanitaria. Le caratteristiche del dataset generato sono riassunte nella Tabella 1.
- Definire le relazioni del database. Assegnare Patient_ID come chiave primaria per la tabella dei pazienti. Stabilire relazioni chiave esterna tra le tabelle paziente, visita, laboratorio, farmaci e registri di audit. Verificare l'integrità referenziale tra tutte le tabelle prima di avviare la migrazione.
- Simulare caratteristiche realistiche dei dati sanitari. Generare età dei pazienti utilizzando una distribuzione normale. Generare frequenze di visita utilizzando una distribuzione di Poisson. Introdurre valori mancanti con una frequenza del 5% per simulare l'incompletezza reale dei fascicoli sanitari elettronici. Sostituire tutti gli identificatori dei pazienti con valori hash prima della migrazione. Verificare che tutti i record generati rispettino i vincoli dello schema predefiniti.
- Convalidare il dataset generato verificando la coerenza dello schema, l'integrità referenziale, i valori mancanti, i record duplicati e i vincoli di qualità predefiniti prima della migrazione.
| Parametro | Valore |
| Tipo di dataset | Dataset sintetico di cartelle cliniche sanitarie |
| Dimensione del dataset | 10 GB |
| Numero totale di record | 20 milioni |
| Numero di tabelle | 5 tabelle principali - 28 tabelle relazionali |
| Record dei pazienti | 5.000.000 |
| Record delle visite | 10.000.000 |
| Risultati di laboratorio | 4.000.000 |
| Record dei farmaci | 3.000.000 |
| Log di audit | 5.000.000 |
| Chiave primaria | Patient_ID |
| Tasso di valori mancanti | 5% |
| Distribuzione dell'età | Distribuzione normale |
| Frequenza delle visite | Distribuzione di Poisson |
| Soglia di integrità | <0,1% violazioni |
Tabella 1: Caratteristiche del dataset sanitario sintetico utilizzato per la validazione del protocollo. La tabella fornisce una panoramica del dataset, come la dimensione del database, il numero di tabelle relazionali, il numero totale di record, gli attributi dei pazienti, le variabili cliniche e le caratteristiche di validazione necessarie per riprodurre gli esperimenti di migrazione sicura.
4. Distribuzione dell'architettura del sistema
- Implementare l'architettura sicura di migrazione al cloud composta dal livello sorgente, dal livello hub di migrazione, dal livello di destinazione, dal livello di sicurezza di rete, dal livello di osservabilità e dal livello di intelligenza artificiale interpretabile. L'architettura di sistema implementata in questo studio è illustrata in Figura 2.
- Il framework è composto da sei livelli operativi, che durante il processo di migrazione svolgono le proprie funzioni uno dopo l'altro. Il primo livello, il Livello Sorgente, è quello che contiene il database sanitario sintetico.
- L'Hub di Migrazione è responsabile dell'estrazione dello schema, del trasferimento dei dati cifrati, della validazione dell'integrità e dell'orchestrazione della migrazione. Il livello di destinazione è dove il database migrato viene archiviato in Amazon RDS PostgreSQL.
- Il livello di sicurezza di rete protegge tutte le comunicazioni mediante l'uso di endpoint VPC privati, crittografia TLS 1.3, gruppi di sicurezza e liste di controllo di accesso alla rete.
- Il livello di osservabilità è quello che raccoglie continuamente log di autenticazione, log di migrazione, log delle attività del database ed eventi di sicurezza grazie ad Amazon CloudWatch.
- Il livello di intelligenza artificiale interpretabile riceve i dati telemetrici di sicurezza raccolti, li elabora attraverso un algoritmo Isolation Forest e genera spiegazioni basate su SHAP per le anomalie rilevate. Tutti i livelli architetturali comunicano tra loro tramite canali di rete privati autenticati durante l'intero flusso di lavoro di migrazione.
- Implementare e verificare l'ambiente del database sorgente per garantire accesso sicuro e disponibilità dei dati prima della migrazione.
- Configurare un database PostgreSQL 16 con il dataset sanitario sintetico. Mantenere nel database sorgente le informazioni sui pazienti, i dettagli delle visite, i risultati dei test di laboratorio, i record dei farmaci e i log di audit.
- Limitare l'accesso al database ai soli servizi di migrazione autorizzati e agli utenti amministrativi. Verificare la disponibilità e la connettività del database prima di avviare le operazioni di migrazione.
- Configurare l'hub di migrazione per coordinare l'estrazione dello schema, il trasferimento dei dati cifrati e l'orchestrazione della migrazione.
- Implementare un server di migrazione dedicato all'interno del Virtual Private Cloud (VPC) privato. Configurare i servizi di orchestrazione della migrazione per coordinare l'estrazione dello schema, il trasferimento dei dati e le attività di validazione.
- Attivare i servizi di validazione dello schema per verificare la compatibilità tra ambienti sorgente e di destinazione. Attivare i servizi di verifica dell'integrità per validare i dati migrati durante e dopo il trasferimento. Verificare la comunicazione tra l'hub di migrazione e i sistemi di database prima di eseguire le attività di migrazione.
- Implementare il Livello di Destinazione. Distribuire Amazon RDS PostgreSQL 16 come ambiente del database di destinazione. Abilitare i servizi di backup e ripristino automatici. Attivare la crittografia AES-256 per i dati archiviati all'interno del database di destinazione.
- Configurare la sicurezza di rete. Disabilitare tutti gli indirizzi IP pubblici associati alle risorse di migrazione. Consentire la comunicazione solo attraverso endpoint privati all'interno del VPC. Configurare le liste di controllo di accesso alla rete (NACLs) e i gruppi di sicurezza. Abilitare la crittografia TLS 1.3 per tutte le comunicazioni tra i componenti del sistema. Verificare che non rimangano endpoint pubblicamente accessibili attivi.
- Configurare il monitoraggio centralizzato per raccogliere continuamente eventi di sicurezza, log di migrazione e metriche di prestazione del sistema.
- Abilitare i servizi di logging e monitoraggio di Amazon CloudWatch. Raccogliere log di autenticazione, log di migrazione, log delle attività del database e log degli eventi di sicurezza. Configurare la conservazione dei log per 365 giorni. Abilitare l'archiviazione immutabile dei log per soddisfare i requisiti di audit e conformità. Verificare la raccolta in tempo reale delle metriche e la generazione di avvisi.
- Configurare l'ambiente di intelligenza artificiale interpretabile per eseguire il rilevamento in tempo reale delle anomalie e generare spiegazioni di sicurezza interpretabili.
- Implementare i servizi di rilevamento delle anomalie all'interno dell'ambiente di monitoraggio. Configurare il framework di intelligenza artificiale interpretabile per elaborare i dati telemetrici di sicurezza generati durante la migrazione. Collegare i flussi di dati telemetrici provenienti dalla sorgente, dall'hub di migrazione, dal database di destinazione e dai servizi di monitoraggio.
- Abilitare il rilevamento in tempo reale delle anomalie e la generazione di spiegazioni basate su SHAP. Verificare l'avvenuta acquisizione dei dati telemetrici prima di avviare gli esperimenti di migrazione.
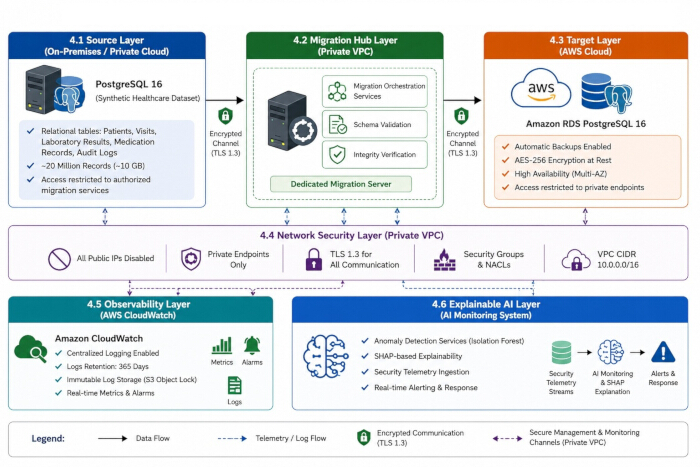
Figura 2: Architettura di distribuzione del framework sicuro per la migrazione cloud nel settore sanitario. L'ambiente di distribuzione illustra il database sorgente PostgreSQL contenente il dataset sanitario sintetico, l'hub di migrazione dedicato all'interno di una rete privata virtuale (VPC), il database di destinazione Amazon RDS PostgreSQL, il livello di sicurezza della rete, l'osservabilità centralizzata tramite Amazon CloudWatch e il livello di monitoraggio basato su Intelligenza Artificiale Spiegabile. Tutte le comunicazioni avvengono attraverso endpoint privati protetti da crittografia TLS 1.3. Questa figura è stata creata dagli autori utilizzando Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
5. Flusso di lavoro per la migrazione sicura
NOTA: Eseguire il flusso di lavoro di migrazione sicura effettuando modellazione delle minacce, trasferimento dello schema, migrazione sicura dei dati, convalida della migrazione e consolidamento post-migrazione.
- Identificare le minacce alla sicurezza potenziali e mappare i controlli di mitigazione appropriati prima di avviare il processo di migrazione.
- Identificare le risorse da migrare, i potenziali vettori di attacco e scenari realistici di attacco informatico.
- Valutare il furto di credenziali derivante da token di autenticazione compromessi, attacchi da parte di insider che comportano accessi amministrativi non autorizzati, attacchi di ripetizione (replay) mirati a richieste di autenticazione precedentemente intercettate, attacchi man-in-the-middle (MITM) volti a intercettare canali di comunicazione crittografati, manomissioni dello schema finalizzate a modificare le strutture del database durante la migrazione e attacchi di elevazione dei privilegi mirati ad ottenere permessi amministrativi non autorizzati.
- Verificare che l'utilizzo della gestione temporanea delle credenziali con privilegi minimi sia sufficiente a prevenire il furto di credenziali e gli attacchi di elevazione dei privilegi. Verificare che la comunicazione crittografata con TLS 1.3 protegga da attacchi di ripetizione e attacchi man-in-the-middle.
- Verificare che le politiche di gestione delle identità e degli accessi (IAM) impediscano accessi amministrativi non autorizzati. Verificare che la registrazione continua degli audit conservi un registro di tutte le attività di migrazione relative alla sicurezza. Assicurarsi che il controllo mediante checksum SHA-256 sia in grado di rilevare modifiche non autorizzate allo schema o ai dati.
- Verificare che il framework di rilevamento degli anomaly spiegabile sia in grado di individuare attività di migrazione insolite e di fornire spiegazioni di sicurezza interpretabili. Creare una mappa dei controlli di sicurezza per ciascuna minaccia identificata. Verificare che tutte le minacce identificate siano adeguatamente mitigate prima di iniziare la migrazione del database. Gli autori hanno riassunto il modello di minaccia e i controlli di sicurezza nella Tabella 2.
- Trasferire lo schema del database. Estrarre le definizioni dello schema dal database PostgreSQL di origine. Verificare la compatibilità dello schema con l'ambiente del database di destinazione. Verificare le strutture delle tabelle, le chiavi primarie, le chiavi esterne, gli indici e i vincoli. Distribuire le definizioni dello schema validate al database di destinazione. Confermare il corretto completamento della distribuzione dello schema prima del trasferimento dei dati.
- Migrare i dati sanitari in modo sicuro attraverso canali di comunicazione crittografati, monitorando continuamente le attività di migrazione.
- Configurare la dimensione del lotto di migrazione a 10.000 record per transazione. Stabilire canali di comunicazione crittografati utilizzando TLS 1.3. Trasferire i dati attraverso endpoint di rete privati all'interno della cloud privata virtuale (VPC).
- Abilitare tentativi di ripetizione automatici con un massimo di tre tentativi per le transazioni fallite.
Mantenere il throughput del trasferimento dati tra 100 MB/s e 150 MB/s. Monitorare continuamente le attività di migrazione durante tutto il processo di trasferimento. Registrare tutti gli eventi di migrazione nei log di audit centralizzati.
- Verificare completezza e integrità della migrazione confrontando checksum, conteggi di record e strutture del database.
- Generare valori hash SHA-256 per tutte le tabelle di origine prima della migrazione e valori hash SHA-256 per tutte le tabelle di destinazione dopo la migrazione. Confrontare i valori di checksum di origine e di destinazione. Verificare incrociando il numero di righe per i database di origine e di destinazione. Controllare la coerenza degli schemi, delle relazioni tra tabelle e dei vincoli del database. Considerare la migrazione come riuscita solo quando i valori di checksum, i conteggi dei record e le strutture dello schema sono identici.
- Rimuovere i privilegi temporanei e completare i controlli di sicurezza al termine con successo della migrazione dei dati.
- Revocare immediatamente tutte le credenziali temporanee di migrazione al termine della migrazione. Rimuovere i privilegi elevati di migrazione dagli account di servizio. Archiviare i log di audit e i record di monitoraggio della sicurezza.
- Verificare il corretto completamento delle procedure di backup. Dismettere i server temporanei di migrazione e le risorse di supporto. Effettuare una revisione finale della sicurezza dell'ambiente migrato. Documentare i risultati della migrazione e i risultati della validazione. L'intero flusso di lavoro di migrazione sicura utilizzato in questo studio è illustrato nella Figura 3.
| Scenario di minaccia | Controllo di sicurezza | Metodo di rilevamento | Mitigazione |
| Furto di credenziali | Privilegio temporale minimo (TLP) | Log IAM | Revoca automatica delle credenziali |
| Attacco da insider | Controllo degli accessi basato sui ruoli (RBAC) | Log di audit + SHAP | Terminazione della sessione |
| Attacco di ripetizione (replay attack) | Crittografia TLS 1.3 + convalida del nonce | Monitoraggio della rete | Rifiuto delle richieste duplicate |
| Attacco Man-in-the-Middle (MITM) | Crittografia TLS 1.3 | Convalida del certificato | Comunicazione crittografata |
| Manomissione dello schema | Checksum SHA-256 + convalida dello schema | Verifica dell'integrità | Ripristino dello schema convalidato |
| Elevazione dei privilegi | Applicazione delle policy IAM | Log di sicurezza | Revoca dei privilegi |
Tabella 2: Modello di minaccia e relative misure di sicurezza adottate nel framework di migrazione proposto. La tabella descrive le principali minacce alla sicurezza rappresentative e i corrispondenti meccanismi di mitigazione basati sui principi di sicurezza zero-trust, crittografia, gestione delle identità, verifica dell'integrità, monitoraggio e rilevamento spiegabile delle anomalie.
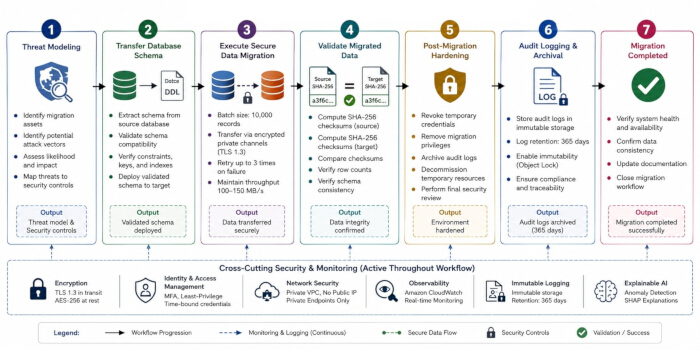
Figura 3: Flusso di lavoro del protocollo proposto per la migrazione sicura del database nel cloud. Il protocollo comprende sette fasi sequenziali: modellazione delle minacce, trasferimento dello schema, migrazione sicura del database, convalida dei dati migrati, consolidamento post-migrazione, registrazione e archiviazione delle verifiche, e completamento della migrazione. Durante l'intero flusso di lavoro di migrazione vengono mantenuti il monitoraggio della sicurezza, la comunicazione crittografata, la gestione delle identità, la registrazione immutabile e il rilevamento spiegabile delle anomalie. Questa figura è stata creata dagli autori utilizzando Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
6. Configurare il monitoraggio dell'intelligenza artificiale interpretabile
NOTA: La struttura del processo è la seguente: identificare le caratteristiche di sicurezza della migrazione, costruire un modello per rilevare anomalie, riconoscere quando le azioni di migrazione sono sospette e produrre risultati interpretabili mediante metodi di interpretazione SHAP.
- Estrarre e preelaborare le caratteristiche di telemetria di sicurezza necessarie per il rilevamento di anomalie e l'analisi dell'interpretabilità.
- Raccogliere i log di sicurezza dai server di database, dai server di autenticazione, dai server applicativi e dai sistemi di monitoraggio di rete. Aggregare tutti gli eventi relativi alla migrazione in un repository centralizzato di log. Rimuovere record duplicati e voci incomplete. Sincronizzare i timestamp provenienti da tutte le fonti di log utilizzando l'ora coordinata universale (UTC).
- Calcolare la frequenza di accesso per ogni utente durante le operazioni di migrazione. Registrare il numero di tentativi di accesso falliti associati a ciascun account. Monitorare i cambiamenti negli indirizzi IP sorgente durante le sessioni di migrazione.
- Misurare la durata della sessione utente dall'avvio alla terminazione dell'accesso. Calcolare i volumi di trasferimento dati in entrata e in uscita durante le attività di migrazione. Normalizzare tutte le caratteristiche estratte utilizzando la normalizzazione Min-Max.
- Tabella 3 riassume le caratteristiche di sicurezza utilizzate per il rilevamento di anomalie e l'analisi dell'interpretabilità.
- Addestrare e convalidare il modello Isolation Forest utilizzando il dataset preparato di caratteristiche di sicurezza.
- Dividere il dataset. Suddividere casualmente il dataset in set di addestramento (70%), set di convalida (15%) e set di test (15%). Mantenere una distribuzione costante di eventi normali e anomali in tutti i sottoinsiemi.
- Selezione del modello di intelligenza artificiale interpretabile. Selezionare l'algoritmo Isolation Forest poiché rileva in modo efficiente attività di migrazione anomale senza richiedere dati di addestramento etichettati. Utilizzare l'algoritmo per isolare osservazioni anomale tramite partizionamento casuale ricorsivo dello spazio delle caratteristiche.
- Applicare SHAP TreeExplainer per quantificare il contributo di ciascuna caratteristica di sicurezza alla previsione di anomalie e migliorare la trasparenza del processo di monitoraggio della sicurezza.
- Configurare il modello di rilevamento delle anomalie. Inizializzare un modello Isolation Forest. Configurare il modello utilizzando i parametri elencati in Tabella 4.
- Definire la formulazione matematica utilizzata per calcolare i punteggi di anomalia e spiegare i contributi delle caratteristiche.
- Definire il vettore di caratteristiche di sicurezza per ciascun evento di migrazione come mostrato nell'Equazione 1.
xi = [x1 , x2, x3, x4, x5 ] (1)
dove x1 indica la frequenza di accesso, x2 indica il numero di tentativi di accesso falliti, x3 indica la frequenza di cambio dell'indirizzo IP, x4 indica la durata della sessione e x5 indica il volume di trasferimento dati. - Estrarre le caratteristiche di sicurezza dai log di migrazione. Normalizzare tutti i valori delle caratteristiche prima dell'addestramento del modello. Calcolare il punteggio di anomalia Isolation Forest per ciascun evento di migrazione utilizzando l'Equazione 2.
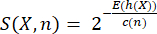 (2)
dove S(X,n) indica il punteggio di anomalia dell'osservazione X, X indica il vettore di caratteristiche di sicurezza, E(h(X)) è la lunghezza media del percorso dell'osservazione X, c(n) è la lunghezza media del percorso delle ricerche non riuscite in un albero binario di ricerca e n è il numero totale di campioni di addestramento. Il fattore di normalizzazione è calcolato come mostrato nell'Equazione 3.
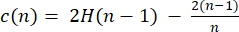 (3)
dove H(n-1) indica l'(n-1)-esimo numero armonico. - Classificare gli eventi di migrazione con punteggi di anomalia superiori alla soglia di decisione predefinita come anomali.
- Applicare SHAP (SHapley Additive exPlanations) per spiegare il contributo di ciascuna caratteristica di sicurezza alla previsione di anomalie. Calcolare il valore SHAP per la caratteristica i utilizzando l'Equazione 4.
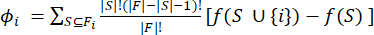 (4)
dove (F) indica l'insieme completo delle caratteristiche, (S) indica un sottoinsieme di caratteristiche e (f(.)) indica la funzione di previsione di Isolation Forest. - Calcolare l'importanza globale delle caratteristiche calcolando il valore assoluto medio di SHAP utilizzando l'Equazione 5.
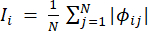 (5)
dove (N) indica il numero totale di eventi di migrazione. - Ordinare le caratteristiche di sicurezza in base ai loro valori assoluti medi di SHAP. Generare grafici riepilogativi SHAP, grafici di dipendenza e grafici a forza per visualizzare l'importanza globale e locale delle caratteristiche.
- Definire il vettore di caratteristiche di sicurezza per ciascun evento di migrazione come mostrato nell'Equazione 1.
- Addestrare il modello Isolation Forest utilizzando il dataset di addestramento. Valutare le prestazioni del modello utilizzando il dataset di convalida. Se necessario, modificare le soglie di contaminazione. Conservare la configurazione del modello che ottiene le migliori prestazioni. Convalidare le prestazioni del modello. Determinare metriche come accuratezza, precisione, richiamo, punteggio F1 e ROC-AUC. Registrare le misure di prestazione del modello per confronti successivi.
- Applicare il modello addestrato per identificare eventi di migrazione anomali e classificare attività sospette.
- Eseguire la previsione di anomalie. Applicare il modello Isolation Forest addestrato al dataset di test. Generare punteggi di anomalia per tutti gli eventi di migrazione.
- Identificare attività sospette. Determinare se gli eventi di migrazione sono tipici o anomali. Contrassegnare come sospetti quegli eventi che superano i livelli di anomalia predeterminati. Produrre documentazione sulle anomalie per l'analisi di sicurezza.
- Il completamento del processo di rilevamento delle anomalie produce punteggi di anomalia, etichetta gli eventi di migrazione come normali o anomali, misura l'efficacia del rilevamento tramite analisi ROC e individua le principali anomalie di sicurezza. Alcuni esempi di output prodotti dal processo progettato sono mostrati in Figura 4.
- Categorizzare le anomalie rilevate. Classificare le anomalie in anomalie di autenticazione, anomalie di rete, anomalie di sessione e anomalie di trasferimento dati. Conservare le etichette delle anomalie per l'analisi esplicativa.
- Valutare le prestazioni del rilevamento. Verificare gli incidenti di sicurezza registrati fino a oggi. Quindi, utilizzandoli come riferimento, valutare le anomalie rilevate e determinare quali di queste siano effettivamente anomalie reali. Determinare il tasso di rilevamento delle anomalie e il tasso di falsi positivi. Redigere un documento ufficiale che documenti l'accuratezza del rilevamento, in modo da poterlo riprodurre.
- Generare spiegazioni basate su SHAP per interpretare il contributo delle singole caratteristiche di sicurezza alle previsioni di anomalie.
- Configurare l'ambiente SHAP. Caricare il modello Isolation Forest addestrato. Inizializzare SHAP TreeExplainer. Verificare l'integrazione corretta tra il modello di rilevamento delle anomalie e il framework di interpretabilità.
- Selezionare campioni di riferimento. Selezionare casualmente 1.000 campioni rappresentativi dal dataset di addestramento. Utilizzare i campioni selezionati come dataset di riferimento SHAP. Calcolare i valori SHAP. Calcolare i valori SHAP per tutte le anomalie rilevate. Misurare i contributi individuali delle caratteristiche alle previsioni di anomalie. Conservare gli output SHAP per ulteriori analisi.
- Generare spiegazioni globali. Creare grafici riepilogativi SHAP che mostrino l'importanza complessiva delle caratteristiche. Generare istogrammi SHAP basati sui valori assoluti medi di SHAP. Produrre grafici di dipendenza SHAP per le caratteristiche più influenti.
- Generare spiegazioni locali. Selezionare eventi di migrazione anomali rappresentativi. Creare grafici a forza SHAP e grafici a cascata. Visualizzare i contributi delle caratteristiche responsabili di ciascuna anomalia.
- Gli output rappresentativi di interpretabilità generati durante il processo di interpretazione sono mostrati in Figura 5. Queste visualizzazioni mostrano l'importanza globale delle caratteristiche, i ranghi di contributo delle caratteristiche, le relazioni di dipendenza tra le caratteristiche di sicurezza più influenti e spiegazioni locali per singole anomalie di migrazione.
- Ordinare le caratteristiche di sicurezza. Calcolare i valori assoluti medi di SHAP per tutte le caratteristiche. Ordinare le caratteristiche in base al loro contributo al rilevamento delle anomalie. Identificare gli indicatori di sicurezza più influenti che influenzano la sicurezza della migrazione. Tabella 5 riassume i ranghi di importanza delle caratteristiche basati su SHAP.
- Verificare la coerenza delle spiegazioni. Ripetere l'analisi SHAP in cinque esecuzioni sperimentali indipendenti. Misurare la stabilità e la coerenza delle spiegazioni. Verificare che i ranghi delle caratteristiche rimangano stabili in analisi ripetute.
NOTA: Tabella 6 fornisce problemi comuni riscontrati durante il rilevamento di anomalie interpretabili e le azioni correttive raccomandate.
| Caratteristica | Descrizione | Scopo |
| Frequenza di accesso | Numero di richieste di accesso da parte degli utenti durante la migrazione | Rilevare comportamenti di accesso anomali |
| Numero di accessi falliti | Numero di tentativi di autenticazione non riusciti | Identificare tentativi di accesso non autorizzati o attacchi di forza bruta |
| Cambiamenti dell'indirizzo IP | Frequenza dei cambiamenti dell'indirizzo IP di origine | Rilevare comportamenti di rete sospetti |
| Durata della sessione | Durata delle sessioni utente durante la migrazione | Identificare attività anomale nelle sessioni |
| Volume del trasferimento dati | Quantità di dati trasferiti durante la migrazione | Rilevare movimenti insoliti di dati o esfiltrazione |
Tabella 3: Funzionalità di telemetria di sicurezza utilizzate per il rilevamento di anomalie spiegabile. La tabella presenta le caratteristiche di sicurezza che sono state monitorate durante la migrazione del database, il loro significato, i metodi con cui sono state misurate e il modo in cui hanno contribuito all'analisi del rilevamento delle anomalie e della spiegabilità.
| Parametro | Valore | Descrizione |
| Algoritmo | Isolation Forest | Modello di rilevamento delle anomalie |
| n_estimators | 100 | Numero di alberi di isolamento |
| contamination | 0,02 | Proporzione attesa di anomalie |
| max_samples | Auto | Campioni utilizzati per ogni albero |
| random_state | 42 | Valore iniziale per la riproducibilità |
| bootstrap | False | Campionamento senza reinserimento |
| Training Set | 70% | Dati per l'addestramento del modello |
| Validation Set | 15% | Validazione degli iperparametri |
| Testing Set | 15% | Valutazione finale del modello |
Tabella 4: Configurazione della foresta isolante utilizzata per rilevare anomalie durante la migrazione sicura del database. Questa tabella illustra le configurazioni degli iperparametri del modello di foresta isolante per l'addestramento, come la suddivisione del dataset, il livello di contaminazione, il numero di stimatori, il seme casuale e l'allestimento della valutazione.
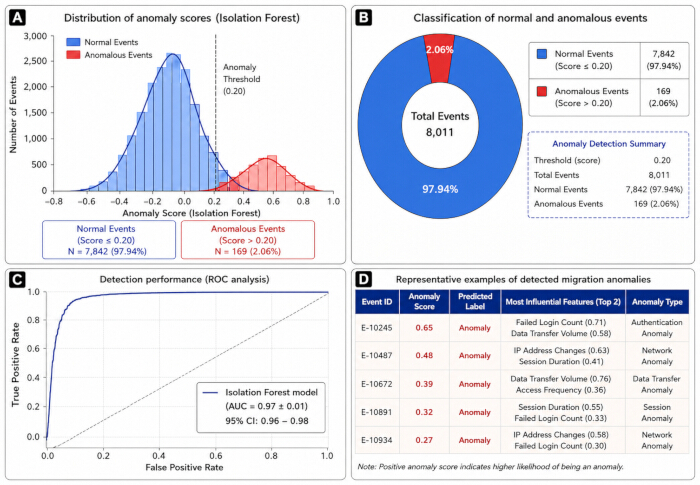
Figura 4: Risultati rappresentativi del framework di rilevamento delle anomalie durante la migrazione sicura dei dati nel cloud. (A) Distribuzione dei punteggi di anomalia dell'Isolation Forest con indicazione della soglia di anomalia. (B) Classificazione degli eventi di migrazione in categorie normali e anomale. (C) Curva caratteristica operativa del ricevitore (ROC) che mostra le prestazioni del modello Isolation Forest (AUC = 0,97 ± 0,01). (D) Eventi di migrazione anomali rappresentativi, con indicazione dei punteggi di anomalia, delle etichette previste, delle caratteristiche di sicurezza influenti e delle categorie di anomalia. Questa figura è stata generata dagli autori utilizzando Python 3.11 (Matplotlib 3.9) e formattata con Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
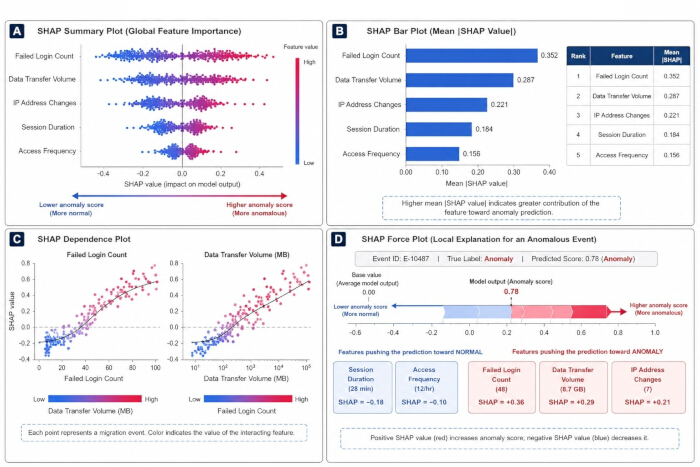
Figura 5: Esempi di output basati su SHAP per l'interpretazione delle anomalie. (A) Grafico riepilogativo SHAP che evidenzia le caratteristiche più importanti a livello globale. (B) Classificazione delle caratteristiche di sicurezza in base al valore assoluto medio di SHAP. (C) Grafici di dipendenza SHAP che mostrano come il numero di accessi non riusciti e il volume del trasferimento dati influenzino la previsione di anomalie. (D) Grafico a forza SHAP che fornisce una spiegazione locale per un tipico evento di migrazione anomala. Questi grafici illustrano l'interpretabilità globale e locale del modello proposto per il rilevamento delle anomalie. Questa figura è stata generata dagli autori utilizzando Python 3.11 (Matplotlib 3.9) e formattata con Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Posizione | Caratteristica | Valore Assoluto Medio SHAP | Interpretazione |
| 1 | Numero di Tentativi di Accesso Falliti | 0.352 | Indicatore più influente di attività anomala |
| 2 | Volume di Trasferimento Dati | 0.287 | Contributo significativo al rilevamento di anomalie |
| 3 | Cambiamenti Indirizzo IP | 0.221 | Indica comportamenti di rete sospetti |
| 4 | Durata della Sessione | 0.184 | Associata a sessioni utente anomale |
| 5 | Frequenza di Accesso | 0.156 | Riflette schemi di accesso insoliti |
Tabella 5: Punteggi di importanza delle caratteristiche SHAP relativi ai dati di telemetria sulla sicurezza. La tabella mostra il ranking delle caratteristiche di sicurezza in base ai valori assoluti medi di SHAP e delinea i rispettivi contributi alla previsione di anomalie.
| Problema | Causa possibile | Soluzione consigliata |
| Rilevate poche anomalie | Parametro di contaminazione troppo basso | Aumentare la soglia di contaminazione e rieseguire il training del modello. |
| Alto tasso di falsi positivi | Log di migrazione rumorosi o incoerenti | Pulire i dati dei log e normalizzare le caratteristiche di sicurezza prima del training del modello. |
| Spiegazioni SHAP instabili | Numero insufficiente di campioni di riferimento | Aumentare il numero di campioni di riferimento rappresentativi utilizzati da SHAP. |
| Scarsa accuratezza nel rilevamento delle anomalie | Squilibrio delle caratteristiche o pre-elaborazione inadeguata | Applicare normalizzazione delle caratteristiche, bilanciamento e procedure di controllo qualità. |
| Convergenza lenta del modello | Dataset di grandi dimensioni o risorse computazionali limitate | Ottimizzare gli iperparametri o utilizzare GPU/elaborazione parallela. |
| Guasti nella comunicazione | Instabilità della rete durante il monitoraggio | Verificare i canali di comunicazione sicura e ripetere la sincronizzazione. |
| Caratteristiche di sicurezza mancanti | Raccolta dei log incompleta | Convalidare le fonti dei log prima dell'estrazione delle caratteristiche e rigenerare il dataset delle caratteristiche. |
Tabella 6: Guida alla risoluzione dei problemi per la migrazione sicura di database basata su Intelligenza Artificiale Spiegabile. Questa tabella fornisce un riepilogo dei problemi tipici di implementazione, delle possibili cause, degli indicatori diagnostici, delle azioni consigliate e dei risultati previsti come conseguenza dell'esecuzione del protocollo e della sua riproducibilità.
7. Valutazione delle prestazioni
NOTA: questa sezione descrive la procedura sperimentale utilizzata per confrontare il framework di migrazione di base con il framework di migrazione proposto basato su intelligenza artificiale spiegabile e zero trust. La valutazione delle prestazioni include sicurezza, capacità di rilevamento delle anomalie, efficienza della migrazione e validazione statistica in condizioni sperimentali identiche.
- Configurare sia l'ambiente di base che quello proposto in condizioni identiche per consentire un confronto equo delle prestazioni.
- Configurare l'ambiente di migrazione convenzionale. Impostare credenziali statiche a lungo termine con una validità superiore a 24 ore. Abilitare endpoint di rete pubblici per l'accesso al database. Disabilitare i meccanismi di rilevamento delle anomalie e di spiegabilità basati sull'intelligenza artificiale. Monitorare manualmente le attività di migrazione utilizzando log di sicurezza convenzionali. Registrare gli eventi di migrazione per il successivo confronto delle prestazioni.
- Configurare il framework di migrazione Zero-Trust. Abilitare credenziali temporanee con privilegi minimi e scadenza automatica al termine della migrazione. Disabilitare tutti gli endpoint di rete pubblici. Abilitare la comunicazione su rete privata mediante canali sicuri.
- Implementare il modello addestrato di rilevamento delle anomalie Isolation Forest. Abilitare SHAP TreeExplainer per l'interpretazione del modello. Configurare il monitoraggio automatico della sicurezza durante l'intero processo di migrazione. Verificare la comunicazione sicura tra tutti i componenti della migrazione prima dell'esecuzione.
- Eseguire esperimenti ripetuti di migrazione in condizioni controllate per valutare la riproducibilità del framework.
- Eseguire un esperimento di migrazione. Condurre dieci esperimenti di migrazione indipendenti sia per l'ambiente di base che per quello proposto. Mantenere configurazioni hardware, software e di rete identiche in tutti gli esperimenti.
- Migrare 10 GB di dati sanitari durante ogni esecuzione sperimentale. Ripetere tutti gli esperimenti in condizioni di carico identiche. Registrare eventi di sicurezza, log di migrazione, output del rilevamento delle anomalie e tempi di esecuzione durante ogni esperimento.
- Verificare l'integrità della migrazione. Calcolare gli hash SHA-256 prima e dopo la migrazione. Verificare l'integrità completa dei dati al termine di ogni esperimento di migrazione. Documentare i risultati della convalida degli hash.
- Calcolare metriche quantitative di sicurezza, migrazione e rilevamento delle anomalie per la valutazione comparativa.
- Misurare le prestazioni in termini di sicurezza. Misurare la durata di esposizione delle credenziali. Calcolare il numero di credenziali esposte durante la migrazione. Misurare il tempo di rilevamento degli incidenti. Registrare la durata dell'esposizione alla rete pubblica.
- Valutare le prestazioni del rilevamento delle anomalie. Calcolare accuratezza, precisione, richiamo (recall), punteggio F1 e area sotto la curva caratteristica operativa del ricevitore (AUC). Valutare le prestazioni della migrazione. Misurare la latenza totale della migrazione e calcolare la velocità di trasferimento (throughput). Registrare l'overhead di comunicazione introdotto dai meccanismi di sicurezza.
- Eseguire la convalida statistica. Calcolare la media e la deviazione standard per tutte le metriche di prestazione. Calcolare gli intervalli di confidenza al 95%. Eseguire test t di Student appaiati per confrontare i framework di base e proposto. Considerare statisticamente significativo un valore di p < 0,05. I risultati rappresentativi della valutazione delle prestazioni ottenuti durante il confronto sperimentale sono mostrati in Figura 6.
- Tabella 7 riassume il confronto quantitativo delle prestazioni tra il framework di base e quello proposto per la migrazione.
Tabella 8 riassume i problemi comuni di implementazione riscontrati durante la migrazione sicura del database, le possibili cause e le azioni correttive raccomandate.
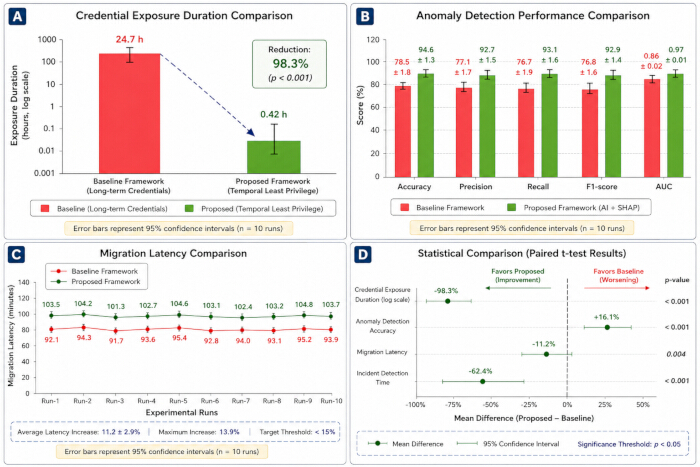
Figura 6: Confronto delle prestazioni tra il framework di migrazione di base e il framework proposto per la migrazione sicura nel cloud basato su zero trust e intelligenza artificiale interpretabile. (A) Confronto della durata dell'esposizione delle credenziali utilizzando credenziali a lungo termine e credenziali temporanee con privilegi minimi. (B) Confronto delle metriche di prestazione per il rilevamento delle anomalie, inclusi accuratezza, precisione, richiamo (recall), punteggio F1 e AUC. (C) Confronto della latenza di migrazione su dieci esecuzioni sperimentali indipendenti, che mostra come l'aumento della latenza sia rimasto al di sotto della soglia di accettazione predefinita. (D) Confronto statistico delle metriche chiave di prestazione mediante test t di Student appaiati, che mostra le differenze medie e gli intervalli di confidenza al 95%. I barretti di errore rappresentano gli intervalli di confidenza al 95% ottenuti da dieci esecuzioni sperimentali indipendenti. Questa figura è stata generata dagli autori utilizzando Python 3.11 (Matplotlib 3.9) e formattata con Microsoft PowerPoint (Microsoft 365). Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Metrica di prestazione | Framework di base (Media ± DS) | Framework proposto (Media ± DS) | Miglioramento | Intervallo di confidenza al 95% | p-valore |
| Durata di esposizione delle credenziali (h) | 24,70 ± 1,32 | 0,42 ± 0,18 | riduzione del 98,3% | 23,6–24,9 | <0,001 |
| Precisione nel rilevamento delle anomalie (%) | 72,4 ± 2,1 | 94,6 ± 1,3 | +22,2% | 20,8–23,5 | <0,001 |
| Precisione (%) | 68,1 ± 2,5 | 92,7 ± 1,5 | +24,6% | 23,1–26,0 | <0,001 |
| Sensibilità (%) | 70,3 ± 2,4 | 93,1 ± 1,6 | +22,8% | 21,4–24,2 | <0,001 |
| Punteggio F1 (%) | 69,2 ± 2,2 | 92,9 ± 1,4 | +23,7% | 22,3–25,0 | <0,001 |
| AUC | 0,78 ± 0,03 | 0,97 ± 0,01 | +0,19 | 0,17–0,21 | <0,001 |
| Latenza di migrazione (min) | 87,6 ± 3,2 | 97,4 ± 2,9 | sopraccarico dell'11,2% | 8,9–10,7 | 0,002 |
| Integrità dei dati (%) | 99,8 | 100,0 | miglioramento dello 0,2% | N/D | 0,031 |
| Esposizione alla rete pubblica | Abilitata | Eliminata | eliminata al 100% | N/D | <0,001 |
Tabella 7: Confronto delle prestazioni tra i framework di migrazione del database sicuro esistenti e proposti. La tabella mostra la durata dell'esposizione delle credenziali, l'efficacia del rilevamento delle anomalie, la latenza di migrazione, l'integrità dei dati e i miglioramenti della sicurezza valutati quantitativamente durante la validazione del protocollo.
| Problema | Causa possibile | Soluzione consigliata |
| Errore di autenticazione durante la migrazione | Credenziali temporanee scadute o non valide | Rigenerare le credenziali temporanee e verificare le policy IAM prima di riavviare la migrazione. |
| Elevata latenza della migrazione | Congestione della rete o larghezza di banda insufficiente | Ottimizzare il routing di rete, pianificare la migrazione in periodi di traffico ridotto e verificare la connettività degli endpoint. |
| Avvisi di anomalia falsi positivi | Soglia di contaminazione impropria nell'Isolation Forest | Regolare il parametro di contaminazione utilizzando il dataset di validazione e rieseguire l'addestramento del modello. |
| Spiegazioni SHAP instabili | Campioni di background insufficienti o non rappresentativi | Aumentare la dimensione del campione di background per SHAP e assicurarsi che il campionamento sia rappresentativo. |
| Discordanza nell'integrità dei dati | Migrazione interrotta o trasferimento dati corrotto | Rieseguire la migrazione dopo aver verificato i valori di checksum SHA-256 e la coerenza tra sorgente e destinazione. |
| Errore di connessione all'endpoint sicuro | Errori di configurazione del firewall o del protocollo TLS | Verificare i certificati SSL/TLS, le regole del firewall e la configurazione dell'endpoint privato. |
| Bassa accuratezza nel rilevamento delle anomalie | Estrazione delle caratteristiche incompleta o preelaborazione inadeguata | Rivedere l'ingegnerizzazione delle caratteristiche, normalizzare le caratteristiche di sicurezza e rieseguire l'addestramento del modello. |
| Problemi di convergenza del modello | Parametri iperottimizzati inadeguati | Regolare i parametri di apprendimento e validare le prestazioni del modello prima del rilascio. |
Tabella 8: Guida alla risoluzione dei problemi per la migrazione sicura del database sanitario. La tabella elenca gli errori frequenti durante la migrazione, le possibili cause, le misure correttive consigliate e i risultati attesi per garantire un'esecuzione affidabile del protocollo di migrazione sicura.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Panoramica sperimentale
Il protocollo proposto per la migrazione sicura di dati nel cloud abilitato da intelligenza artificiale spiegabile (XAI) è stato valutato utilizzando un dataset sanitario sintetico composto da circa 20 milioni di record di cartelle cliniche elettroniche (EHR) distribuiti su 28 tabelle di database relazionali, per un totale di 10 GB. Gli esperimenti sono stati condotti in un ambiente cloud Amazon Web Services (AWS) mediante Amazon RDS PostgreSQL 16, rete...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
In questa ricerca, è stato sviluppato un protocollo riproducibile e sicuro per la migrazione di database cloud che incorpora principi di sicurezza basati sul modello zero-trust, controllo degli accessi basato sul tempo e sul privilegio minimo, intelligenza artificiale spiegabile (XAI) e monitoraggio continuo della sicurezza, il tutto all'interno di un contesto sperimentale limitato. L'obiettivo di questo articolo non era l'uso di un nuovo algoritmo di migrazione; pertanto, gli autori presentano principalmente un flusso d...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto, rapporti commerciali o relazioni personali che avrebbero potuto influenzare il lavoro descritto in questo studio. Gli autori non hanno conflitti di interessi da dichiarare. Tutti i materiali necessari per riprodurre la metodologia presentata in questo studio sono disponibili pubblicamente in un repository GitHub. Il repository è disponibile all'indirizzo: https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration. Il repository contiene esclusivamente dati sintetici generati per benchmark e non include informazioni reali sui pazienti, informazioni sanitarie protette o record sanitari identificabili.
Ringraziamenti
Gli autori ringraziano il supporto istituzionale fornito dalle rispettive istituzioni di appartenenza durante lo sviluppo e la valutazione di questo protocollo. Gli autori ringraziano inoltre l'utilizzo delle strutture computazionali istituzionali e delle risorse di calcolo cloud che hanno supportato la validazione sperimentale del framework proposto per la migrazione sicura dei dati nel cloud.
Questa ricerca non ha ricevuto finanziamenti esterni. Lo studio è stato condotto utilizzando strutture di ricerca istituzionali e risorse computazionali fornite dalle istituzioni di appartenenza degli autori. Non sono stati ricevuti finanziamenti o supporto economico da alcuna agenzia pubblica, commerciale o senza scopo di lucro.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Crittografia AES | NIST | AES-256 | Crittografia dei dati a riposo |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | Database di destinazione |
| Piattaforma cloud | Amazon Web Services | AWS | Infrastruttura cloud |
| CloudWatch | Amazon Web Services | Ultima versione stabile | Monitoraggio e registrazione |
| Docker | Docker Inc. | 27.0 | Containerizzazione |
| Faker | Sviluppatori di Faker | 30.0 | Generazione di dati sintetici |
| GPU | NVIDIA | RTX 4090 | 24 GB di VRAM |
| Matplotlib | Sviluppatori di Matplotlib | 3.9 | Visualizzazione |
| NumPy | Sviluppatori di NumPy | 1.26 | Elaborazione numerica |
| Sistema operativo | Canonical | Ubuntu 22.04 LTS | Ambiente di sistema |
| Pandas | PyData | 2.2 | Elaborazione dati |
| PostgreSQL | PostgreSQL Global Development Group | 16 | Database sorgente |
| Python | Python Software Foundation | 3.11 | Linguaggio di programmazione |
| Scikit-learn | Sviluppatori di Scikit-learn | 1.5 | Apprendimento automatico |
| SHAP | Sviluppatori di SHAP | 0.46 | Intelligenza artificiale interpretabile |
| Terraform | HashiCorp | 1.8 | Provisioning dell'infrastruttura |
| TLS | IETF | TLS 1.3 | Crittografia dei dati in transito |
| Cloud privato virtuale | Amazon Web Services | VPC | Ambiente di rete privata |
| Workstation | Dell/HP | NA | Intel Xeon Gold 6226R, 64 GB di RAM, SSD da 1 TB |
Riferimenti
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.