Questo studio ha integrato la farmacologia delle reti, il docking molecolare, la dinamica molecolare e il metodo MM-PBSA per identificare le interazioni proteiche potenziali dei profarmaci in grado di intrappolare siti apurinici/abasici sensibili al glutatione nel carcinoma polmonare non a piccole cellule (NSCLC). Il composto 5 è stato selezionato per ulteriori studi su MMP9 e SRC; tuttavia, questi rimangono candidati computazionali. I risultati generano ipotesi che richiedono una validazione biochimica e mediante modelli cellulari.
Articolo di ricerca
Prioritizzazione in silico delle potenziali interazioni proteiche per profarmaci a intrappolamento di siti abasici responsivi al glutatione nel carcinoma polmonare non a piccole cellule
In questo articolo
Sommario
Abstract
Il carcinoma polmonare non a piccole cellule (NSCLC) rimane una causa importante di mortalità correlata al cancro, e l'efficacia del trattamento è spesso limitata dalla resistenza acquisita e dalla tossicità sistemica. I profarmaci sensibili al glutatione che intrappolano siti apurinici/apirimidinici hanno mostrato un'attività antitumorale selettiva in precedenti studi sperimentali, ma non è ancora stato stabilito se i loro metaboliti rilasciati interagiscano significativamente con proteine rilevanti per il cancro. In questo studio, è stato utilizzato un flusso di lavoro integrato in silico, che combina farmacologia delle reti, docking molecolare, dinamica molecolare (MD) e analisi dell'area superficiale di Poisson-Boltzmann mediante meccanica molecolare (MM-PBSA), per identificare ipotesi testabili riguardo alle interazioni proteiche di due profarmaci sensibili al glutatione (Composto 1 e Composto 2), dei loro prodotti contenenti gruppi aminossidrilici (Composto 4 e Composto 5) e di una coppia di controllo non intrappolante (Composto 3 e Composto 6). Sono stati identificati ventuno bersagli comuni associati ai composti e alla malattia, e AKT serina/treonina chinasi 1 (AKT1), recettore del fattore di crescita epidermico (EGFR), fattore di necrosi tumorale (TNF), metalloproteasi della matrice 9 (MMP9) e proto-oncogene SRC, tirosina chinasi non recettoriale (SRC) sono stati selezionati in base alla topologia delle interazioni proteina-proteina. Il Composto 5 ha ottenuto il punteggio AutoDock Vina più favorevole con MMP9 (-8,418 kcal·mol⁻1) e ha mostrato pose derivate dal docking relativamente persistenti lungo le traiettorie MD di MMP9 e SRC. Tuttavia, la posa principale con MMP9 non ha mostrato un coordinamento diretto con l'ione Zn2⁺ catalitico né un'interazione diretta con His401, Glu402, His405 o His411, pertanto non può essere assegnata a una modalità di legame inibitoria canonica per MMP9. Le analisi MD e MM-PBSA descrivono soltanto il comportamento delle traiettorie e il ranking energetico relativo di questi complessi; non dimostrano un'interazione intracellulare con il bersaglio, un'inibizione enzimatica o una regolazione del percorso metabolico. L'attività intrappolante dei siti apurinici/apirimidinici già dimostrata e le nuove interazioni proteiche previste sono quindi considerate come ipotesi distinte e potenzialmente parallele, piuttosto che come una catena meccanicistica dimostrata. Nel complesso, i risultati identificano coppie specifiche composto-bersaglio da testare in futuro, ma non dimostrano un meccanismo antitumorale multibersaglio contro il NSCLC.
Introduzione
Il carcinoma polmonare non a piccole cellule (NSCLC) è il sottotipo istologico più comune di cancro del polmone e continua a rappresentare una causa importante di mortalità correlata al cancro a livello mondiale1. Sebbene siano stati compiuti notevoli progressi nella terapia mirata e nell'oncologia di precisione, l'efficacia del trattamento a lungo termine è spesso compromessa dalla resistenza acquisita, dalla limitata durata della risposta e dalla tossicità associata al trattamento2. Gli agenti mirati al recettore del fattore di crescita epidermico (EGFR) hanno migliorato gli esiti nei pazienti selezionati a livello molecolare, tuttavia quasi inevitabilmente si sviluppa resistenza durante il trattamento, creando un'urgente necessità di strategie terapeutiche che agiscano attraverso meccanismi alternativi o complementari3,4. La chemioterapia convenzionale a base di platino rimane un componente importante del trattamento, ma il suo beneficio clinico è limitato dalla tossicità cumulativa e dalla resistenza che si sviluppa con l'uso prolungato5,6. Nel complesso, queste limitazioni evidenziano la necessità di identificare agenti antitumorali che siano sia meccanicamente distinti sia selettivamente attivati nell'ambiente tumorale.
Tra le lesioni del DNA endogeno, i siti apurinici o apirimidinici sono estremamente abbondanti e hanno conseguenze biologiche rilevanti, con migliaia di lesioni generate ogni giorno in ogni cellula7. Quando queste lesioni non vengono riparate in modo efficiente, possono trasformarsi in rotture del filamento, che possono favorire l'instabilità genomica e la morte cellulare8,9. L'endonucleasi apurinica/apyrimidinica 1 è un enzima centrale nel percorso di riparazione mediante escissione della base, poiché scinde i siti apurinici e permette il successivo processo di riparazione10,11. Questa dipendenza dalla riparazione ha reso i danni associati ai siti apurinici un bersaglio interessante per lo sviluppo di farmaci antitumorali12. Sulla base di questa ipotesi, sono stati precedentemente sviluppati profarmaci sensibili al glutatione in grado di intrappolare i siti apurinici, sfruttando l'ambiente ricco di glutatione delle cellule tumorali. I prodotti attivati dal glutatione contengono una funzionalità aminossidrilica in grado di intrappolare i siti apurinici di tipo aldeidico, e studi sperimentali precedenti hanno dimostrato una citotossicità selettiva, l'arresto del ciclo cellulare e l'apoptosi nelle cellule H129913. Questi dati supportano il componente del design del composto basato sull'intrappolamento delle lesioni del DNA. Tuttavia, non dimostrano che MMP9, SRC, EGFR, AKT1 o TNF siano regolati a valle dell'intrappolamento dei siti apurinici. Ogni interazione proteina-compound identificata nell'analisi computazionale qui presentata deve pertanto essere considerata un'ipotesi distinta, a meno che entrambi i processi non vengano dimostrati nello stesso sistema biologico.
Lo studio attuale è stato progettato sulla base di questa distinzione. Il primo livello della logica biologica è rappresentato dalla chimica precedentemente stabilita di rilascio sensibile al glutatione e di intrappolamento nei siti apurinici14. Il secondo livello, esaminato nel presente lavoro, è una domanda esplorativa: se i profarmaci parentali o i loro prodotti rilasciati siano compatibili dal punto di vista computazionale con proteine selezionate associate al cancro. È stata utilizzata la farmacologia di rete per individuare le proteine candidato da prioritizzare, seguita da analisi di docking, dinamica molecolare (MD) e MM-PBSA per esaminare complessi proteina-ligando selezionati15,16. Questi calcoli non avevano lo scopo di dimostrare che le proteine predette mediassero il fenotipo noto di danno al DNA, né di stabilire un legame causale tra l’intrappolamento nei siti apurinici e la segnalazione oncogenica. Piuttosto, il flusso di lavoro è stato impiegato per generare un insieme ordinato di ipotesi sperimentalmente verificabili, che potranno essere successivamente valutate mediante saggi di legame diretto, attività enzimatica, analisi di pathway, danno al DNA e fenotipo.
Protocollo
L'approvazione del comitato etico istituzionale non era richiesta poiché questo studio era interamente computazionale e non prevedeva partecipanti umani, animali vertebrati, campioni biologici derivati da pazienti o dati personali identificabili. Il consenso informato non era pertanto applicabile. Tutti i database, i pacchetti software, i campi di forza e le risorse computazionali utilizzati in questo protocollo sono elencati nella Tabella dei Materiali.
Composti in studio e flusso di lavoro analitico
In precedenza erano stati utilizzati composti in grado di intrappolare siti apurinici sensibili al glutatione come molecole di studio17. Il Composto 1 e il Composto 2 sono stati selezionati come profarmaci di partenza poiché la scissione indotta dal glutatione genera i prodotti contenenti il gruppo aminossidrilico, rispettivamente il Composto 4 e il Composto 5. Il Composto 4 e il Composto 5 sono stati scelti per l'analisi strutturale poiché rappresentano le specie rilasciate che conservano il gruppo aminossidrilico reattivo verso i siti apurinici. Il Composto 3 è stato incluso come controllo strutturale abbinato sensibile al glutatione; il suo prodotto di scissione, il Composto 6, manca della funzionalità aminossidrilica necessaria per l'intrappolamento covalente degli aldeidi dei siti apurinici. Di conseguenza, i Composti 1–3 sono stati inclusi nella previsione inversa del bersaglio per confrontare gli scaffolds di partenza, i Composti 4 e 5 sono stati valutati rispetto alle proteine prioritarie, e il Composto 6 è stato utilizzato come ligando di controllo negativo nel confronto MD con SRC. La traiettoria SRC–Composto 6 è stata inclusa per fornire un comparatore strutturale abbinato al sistema del Composto 5 contenente il gruppo aminossidrilico, e non come prova che il gruppo aminossidrilico stesso determini il legame con SRC. Le strutture chimiche e le relazioni di attivazione dei Composti 1–6 sono mostrate in Figura 1. Questa progettazione mantiene intenzionalmente separata la chimica consolidata per l'intrappolamento delle lesioni del DNA dall'analisi generatrice di ipotesi riguardo a possibili interazioni proteiche.
Predizione di bersagli associati a composti
Le strutture bidimensionali del Composto 1, del Composto 2 e del Composto 3 sono state salvate in formato MDL MOL e convertite in stringhe canoniche del sistema semplificato per l'input molecolare (SMILES) utilizzando Open Babel versione 3.1.1 con il formato di output SMILES canonico18. Ogni stringa esportata è stata reimportata e la struttura rigenerata è stata verificata visivamente rispetto alla corrispondente struttura bidimensionale prima dell'invio a SwissTargetPrediction, con la specie limitata a Homo sapiens19. Sono stati mantenuti i target predetti con valori di probabilità diversi da zero. Gli elenchi di target ottenuti per i tre composti sono stati uniti, sono state rimosse le voci duplicate e i target rimanenti sono stati standardizzati ai simboli ufficiali dei geni umani prima di ulteriori analisi. Le coppie standardizzate composto-target sono state importate nel software di visualizzazione e analisi di reti come tabella di rete, con i composti e i target predetti rappresentati come nodi e le relazioni composto-target rappresentate come archi, al fine di visualizzare le relazioni predette tra i target20.
Recupero di bersagli correlati a malattie e identificazione di bersagli comuni
I bersagli associati alla malattia sono stati recuperati dal database GeneCards utilizzando il termine di ricerca “lung cancer H1299”21. È stata applicata una soglia del punteggio di rilevanza superiore a 0,27 per mantenere i geni con una rilevanza maggiore rispetto a questa query. I simboli genici sono stati standardizzati e le voci duplicate sono state rimosse manualmente. L'intersezione tra i bersagli predetti dal composto e i bersagli associati alla malattia è stata identificata mediante l'utilizzo di uno strumento online per l'analisi di diagrammi di Venn/intersezione22. Solo i bersagli intersecanti sono stati mantenuti per le analisi successive di interazione proteina-proteina (PPI), arricchimento e priorizzazione dei bersagli.
Analisi dell'interazione proteina-proteina e screening dei bersagli principali
Gli elementi bersaglio interagenti sono stati sottoposti allo strumento di ricerca per il recupero di geni/proteine interagenti (STRING) versione 11.5, con la specie limitata a Homo sapiens e il punteggio minimo di interazione richiesto impostato a 0,40023. I dati PPI risultanti sono stati importati in Cytoscape versione 3.10.0 per la visualizzazione e l'analisi della topologia. All'interno di un'analisi della topologia della rete plugin, grado, centralità di betweenness e centralità di vicinanza sono stati calcolati per ciascun nodo nella rete originale di interazione proteina-proteina (PPI) composta da 21 nodi; i valori ottenuti sono stati quindi utilizzati per il filtraggio sequenziale basato sulla mediana descritto di seguito24. Sono state calcolate metriche di centralità sulla rete originale di interazione proteina-proteina (PPI) composta da 21 nodi e successivamente utilizzate per un filtraggio sequenziale. Il grado mediano della rete originale era 12 e sono stati mantenuti i nodi con grado ≥ 12, ottenendo 13 candidati. Tra questi 13 candidati, la centralità mediana di betweenness era 0,031293, mentre la centralità mediana di closeness era 0,769231. Il secondo filtro ha mantenuto i nodi con centralità di betweenness ≥ 0,031293 e centralità di closeness ≥ 0,769231. > 0,769231, ottenendo cinque candidati hub: AKT1, EGFR, TNF, MMP9 e SRC. I valori di centralità riportati sono stati mantenuti dalla rete originale di 21 nodi, anziché essere ricalcolati dopo la selezione del sottogruppo. I cinque candidati hub finali sono stati utilizzati per l'analisi strutturale successiva. Le metriche topologiche originali corrispondono a una rete PPI non diretta composta da 21 nodi e 116 archi.
Analisi dell'arricchimento per Gene Ontology e Kyoto Encyclopedia of Genes and Genomes
Le intersezioni degli obiettivi sono state sottoposte ad analisi di arricchimento Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) utilizzando il Database for Annotation, Visualization and Integrated Discovery (DAVID), con la specie limitata a Homo sapiens25. L'arricchimento GO è stato valutato per processo biologico (BP), componente cellulare (CC) e funzione molecolare (MF), oltre che per i percorsi di segnalazione KEGG. Per questa analisi esplorativa, è stato adottato un valore nominale di p < 0,10 come soglia di inclusione per mantenere le voci di arricchimento; i valori di p aggiustati con il metodo di Benjamini, i valori di Bonferroni, i tassi di falsa scoperta e i valori del test esatto di Fisher sono riportati nelle tabelle supplementari ma non sono stati utilizzati per definire l'insieme delle voci mantenute. Le voci mantenute sono state ordinate in base al valore di p nominale. Per la visualizzazione e l'interpretazione successiva, sono stati mantenuti i primi 20 percorsi KEGG e i primi 10 termini di ciascuna categoria GO. Grafici a barre e grafici a bolle sono stati generati utilizzando uno strumento online per la visualizzazione bioinformatica.
Preparazione di recettori e ligandi per il docking molecolare
Le strutture cristalline delle proteine prioritizzate sono state recuperate dal RCSB Protein Data Bank (PDB): AKT1, ID PDB 3O96; EGFR, ID PDB 5UWD; TNF, ID PDB 2AZ5; MMP9, ID PDB 1GKC; e SRC, ID PDB 2H8H. Le strutture proteiche utilizzate per il docking sono state preparate mediante software di visualizzazione molecolare rimuovendo i ligandi co-cristallizzati e le molecole d'acqua, seguite da un'elaborazione con software di preparazione per il docking. Per MMP9, una copia non modificata del PDB 1GKC è stata mantenuta separatamente come riferimento cristallografico per l'ambiente del Zn2⁺ catalitico e per la modalità di legame del N2-[(2R)-2-{[formil(idrossi)ammino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinammide (NFH). Nella catena A del 1GKC, il Zn2⁺ catalitico è coordinato da His401, His405 e His411 a distanze di 2,21, 2,23 e 2,22 Å, rispettivamente, mentre i due atomi di ossigeno del NFH coordinano il Zn2⁺ a 2,07 e 2,38 Å; Glu402 è il residuo acido/base catalitico. Questi contatti cristallografici sono stati utilizzati come riferimento strutturale positivo per valutare la mappa delle interazioni di docking del Composto 5. Per SRC, il PDB 2H8H è stato utilizzato per i calcoli di dinamica molecolare (MD) di SRC. Questi confronti strutturali sono stati utilizzati esclusivamente per l'interpretazione e non sono stati considerati prove di inibizione enzimatica o di interazione con il bersaglio intracellulare.
Le strutture tridimensionali del Composto 4 e del Composto 5 sono state ottenute da PubChem e ottimizzate mediante minimizzazione dell'energia in un software di modellistica molecolare26. I ligandi sono stati protonati in condizioni fisiologiche e minimizzati utilizzando il campo di forza molecolare Merck 94 (MMFF94) fino a quando il gradiente energetico è risultato inferiore a 0,01 kcal·mol⁻1·Å⁻1. Sono stati aggiunti atomi di idrogeno, sono state assegnate cariche di Gasteiger e sono stati definiti i legami rotabili nel software di preparazione per il docking. Il Composto 6, prodotto della scissione del glutathione del controllo costituito dal Composto 3 non intrappolante, è stato preparato seguendo lo stesso protocollo ed è stato ancorato alla SRC soltanto per generare la posa iniziale per la traiettoria di dinamica molecolare di controllo abbinata. Pertanto, il Composto 6 non è stato né introdotto come ulteriore ligando terapeutico predetto né utilizzato per supportare un meccanismo a multi-target.
Procedura di docking molecolare
Il docking molecolare è stato eseguito utilizzando un software di docking molecolare in base a un protocollo di docking semiflessibile, mantenendo i recettori rigidi e consentendo ai ligandi di rimanere flessibili27,28. Per ciascun recettore, la scatola di docking è stata centrata sulla posizione del ligando co-cristallizzato in modo che la regione di ricerca corrispondesse alla tasca di legame definita sperimentalmente. Le dimensioni della scatola di docking sono state impostate a 24 Å × 24 Å × 24 Å per AKT1, EGFR e SRC, a 26 Å × 26 Å × 26 Å per MMP9 e a 28 Å × 28 Å × 28 Å per TNF. L'esauribilità è stata impostata a 32, il numero di conformazioni in uscita a 20 e il range energetico a 4 kcal·mol⁻1. La conformazione con il punteggio più alto ottenuta da ciascun docking è stata conservata per l'analisi delle interazioni.
Per valutare l'affidabilità interna della configurazione del docking, ciascun ligando co-cristallizzato è stato riposizionato (redocked) nel relativo sito recettoriale utilizzando gli stessi parametri, adottando una deviazione quadratica media (RMSD) degli atomi pesanti inferiore a 2,0 Å come criterio di accettazione. Le pose finali sono state esaminate mediante software di visualizzazione molecolare. Per il complesso MMP9–Composto 5, la mappa delle interazioni conservata è stata analizzata in particolare per verificare il coordinamento diretto annotato del ligando con l'ione Zn2⁺ catalitico e per le interazioni con His401, Glu402, His405 e His411, e la posizione del ligando è stata confrontata con la posa cristallografica di NFH nel PDB 1GKC. Una distanza quantitativa di coordinazione metallica è stata riportata solo quando il coordinamento diretto tra ligando e Zn2⁺ era evidente nella posa conservata; in caso contrario, è stata indicata come non applicabile piuttosto che dedotta. Pertanto, una posa di docking per MMP9 priva di queste caratteristiche canoniche del sito catalitico è stata classificata come non canonica e non è stata interpretata come evidenza di inibizione enzimatica di MMP9. Più in generale, i punteggi di AutoDock Vina e le pose di docking sono stati utilizzati per un'ordinamento relativo e la generazione di ipotesi, non come prova dell'affinità di legame o dell'interazione con il bersaglio intracellulare.
Protocollo di dinamica molecolare
I complessi proteina-ligando selezionati per l'analisi di dinamica molecolare (MD) sono stati costruiti a partire dalle pose di legame ottenute dal docking. I calcoli di dinamica molecolare sono stati eseguiti con GROMACS29. Le proteine sono state parametrizzate utilizzando il campo di forza CHARMM36, mentre i tipi di atomi e i parametri del ligando sono stati assegnati mediante il campo di forza General Amber Force Field di seconda generazione (GAFF2)30,31. Le cariche parziali AM1-BCC (Austin Model 1-bond charge correction) sono state generate attraverso strumenti di parametrizzazione di piccole molecole e di generazione della topologia del ligando; un software specifico ha quindi generato i file di topologia del ligando compatibili con GROMACS32,33,34. Ciascun complesso è stato posizionato in una scatola d'acqua TIP3P in condizioni al contorno periodiche, con una distanza minima tra il soluto e il bordo della scatola di 1,0 nm. Sono stati aggiunti ioni sodio e cloruro per neutralizzare la carica netta di ciascun sistema, e ulteriore NaCl è stato aggiunto per raggiungere una forza ionica finale di 0,15 M.
La minimizzazione dell'energia è stata eseguita utilizzando l'algoritmo del gradiente ripido fino a quando la forza massima è scesa al di sotto di 1000 kJ·mol⁻1·nm⁻1. I sistemi minimizzati sono stati quindi equilibrati in condizioni di numero costante di particelle, pressione e temperatura (NPT) a 310 K e 1 bar, applicando vincoli di posizione al tratto principale della proteina. La temperatura è stata controllata mediante il termostato V-rescale, e la pressione mediante il barostato di Parrinello-Rahman. Le interazioni elettrostatiche a lungo raggio sono state calcolate utilizzando il metodo particle mesh Ewald. La soglia per le interazioni elettrostatiche a corto raggio e la soglia per le interazioni di van der Waals sono state entrambe impostate a 1,0 nm, e tutti i legami che coinvolgono atomi di idrogeno sono stati vincolati utilizzando l'algoritmo linear constraint solver (LINCS). Sono state generate traiettorie di produzione per 150 ns con un passo di integrazione di 2 fs, e le coordinate sono state salvate ogni 10 ps per analisi successive.
Analisi della traiettoria
Le analisi delle traiettorie sono state eseguite sulle porzioni equilibrate delle traiettorie di produzione. L'RMSD del tratto principale della proteina e l'RMSD del ligando sono stati calcolati dopo un adattamento ai minimi quadrati alla conformazione iniziale di riferimento. I valori di fluttuazione quadratica media (RMSF) sono stati calcolati su base per residuo utilizzando gli atomi Cα. L'analisi dei legami a idrogeno tra ciascun ligando e il suo recettore è stata effettuata utilizzando una distanza limite donatore-accettore di 3,5 Å e un angolo limite donatore-idrogeno-accettore di 30°. L'occupazione del legame a idrogeno è stata definita come la proporzione di frame analizzati in cui un determinato legame a idrogeno era presente. Queste metriche sono state utilizzate per caratterizzare la stabilità strutturale, la flessibilità a livello di residuo e la persistenza dei contatti intermolecolari lungo le tre traiettorie di dinamica molecolare.
Calcolo dell'energia libera di legame mediante il metodo meccanico molecolare Poisson-Boltzmann surface area (MM-PBSA)
L'energia libera di legame è stata calcolata utilizzando il metodo MM-PBSA implementato con il software di analisi MM-PBSA su segmenti equilibrati delle traiettorie di dinamica molecolare35. Per ciascun complesso proteina-ligando, gli ultimi 50 ns della traiettoria di produzione di 150 ns sono stati utilizzati per l'analisi dell'energia libera. Un totale di 500 fotogrammi equidistanti è stato campionato a intervalli di 100 ps da 100,0 ns a 149,9 ns; l'istante finale di 150,0 ns è stato escluso dall'insieme campionato. L'energia libera totale di legame è stata calcolata come somma dei contributi dell'energia di van der Waals, dell'energia elettrostatica, dell'energia di solvatazione polare e dell'energia di solvatazione non polare:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Non è stata applicata alcuna correzione entropica. Le energie libere medie di legame e le deviazioni standard sono state calcolate su tutti i fotogrammi campionati.
Riproducibilità e controlli di convalida computazionale
Tutti i nomi genici utilizzati nei passaggi di previsione dei target, recupero dei target associati alle malattie e analisi delle intersezioni sono stati standardizzati in simboli genici umani ufficiali prima dell'analisi successiva. Sono stati mantenuti parametri di docking identici per tutte le coppie recettore-legante. L'allestimento del docking è stato verificato tecnicamente reinserendo il legante co-cristallizzato corrispondente all'interno della tasca di ciascun recettore utilizzando le stesse impostazioni di ricerca e la soglia prespecificata di RMSD per gli atomi pesanti accettata a <2,0 Å. Il complesso cristallografico MMP9–NFH è stato mantenuto come riferimento strutturale positivo per l'ambiente del Zn2⁺ catalitico, mentre SRC–Compound 6 è servito come comparatore abbinato non intrappolante per l'analisi della traiettoria di SRC. Le traiettorie di dinamica molecolare (MD) sono state esaminate per verificarne la stabilità di temperatura e pressione e l'assenza di deriva anomala del volume della scatola prima dell'inclusione nelle analisi successive. Tutti i file di input, le strutture dei recettori, i file di topologia dei leganti, i file di configurazione del docking, i file di parametri per la MD e i record di selezione dei fotogrammi per l'analisi MM-PBSA sono stati archiviati per supportare la riproducibilità computazionale.
Risultati
Predizione delle proteine bersaglio associate al composto e identificazione delle proteine bersaglio comuni
La previsione inversa dei bersagli per i composti 1–3 ha prodotto 212 potenziali bersagli umani. Parallelamente, il recupero di bersagli associati alla malattia da GeneCards, utilizzando la parola chiave "carcinoma polmonare H1299" e una soglia di punteggio di rilevanza superiore a 0,27, ha identificato 188 bersagli associati al NSCLC. L'analisi dell'intersezione tra i bersagli predetti dai composti e il pool di bersagli associati alla malattia ha rivelato 21 bersagli comuni, che sono stati mantenuti per tutte le analisi successive. L'overlapping tra i due insiemi di bersagli è mostrato in Figura 2. Questi risultati indicano che i composti oggetto dello studio si sono concentrati su un sottoinsieme ristretto di bersagli pertinenti alla malattia, piuttosto che su uno spazio di bersagli diffuso e non specifico.
Analisi dell'interazione proteina-proteina e screening dei bersagli principali
I 21 bersagli intersecanti sono stati importati in STRING per costruire una rete di interazioni proteina-proteina (PPI). La rete risultante conteneva 21 nodi e 116 archi. I valori del grado dei nodi in Tabella supplementare 1 ammettono un totale di 232, coerente con 116 archi non orientati. Sono stati calcolati i valori di centralità per questa rete originale. Il grado mediano era 12; applicando un grado ≥ 12 sono stati mantenuti 13 candidati. Tra questi 13 candidati, la centralità di betweenness mediana era 0,031293, e la centralità di closeness mediana era 0,769231. Applicando una centralità di betweenness ≥ 0,031293 insieme a una centralità di closeness ≥ 0,769231 > 0,769231 ha individuato cinque candidati hub: AKT1, EGFR, TNF, MMP9 e SRC. I valori mostrati per i sottoinsiemi conservati corrispondono alle metriche di centralità della rete originale a 21 nodi, mantenute durante il filtraggio; tali valori non sono stati ricalcolati per le sottoreti a 13 o a 5 nodi. La centralità nella rete è stata utilizzata esclusivamente per ordinare i candidati da sottoporre a una successiva valutazione basata sulla struttura, e non deve essere interpretata come evidenza del fatto che questi siano target biologici dei composti. Tabella supplementare 1, Tabella supplementare 2, e Tabella supplementare 3 riportare le metriche per la rete iniziale di 21 nodi, per i 13 candidati mantenuti dopo il primo passaggio di screening e per i cinque candidati hub finali, rispettivamente. Lo screening sequenziale della rete di interazioni proteina-proteina e i cinque candidati hub finali sono mostrati in Figura 3A, Figura 3B, Figura 3C, e Figura 3D.
Analisi dell'arricchimento dell'ontologia genica e dell'Enciclopedia di Kyoto di geni e genomi
L'analisi di arricchimento funzionale dei 21 bersagli comuni ha identificato 121 percorsi KEGG che soddisfano i criteri di inclusione nominali di p < 0,10. I 20 percorsi con il rango più alto sono mostrati in Figura 4A. Tra questi, resistenza agli endocrini, percorsi del cancro, proteoglicani nel cancro, resistenza agli inibitori della tirosina chinasi EGFR e il percorso di segnalazione ErbB si sono rivelati particolarmente rilevanti. Questi percorsi sono strettamente correlati alla proliferazione tumorale, alla sopravvivenza, all'invasione e alla resistenza al trattamento nel NSCLC. Le statistiche complete di arricchimento per tutti e 121 i percorsi KEGG conservati che soddisfano il valore nominale di p < 0,10 sono fornite in Tabella Supplementare 4.
L'analisi di arricchimento GO ha inoltre identificato 177 termini BP, 29 termini CC e 61 termini MF che soddisfano lo stesso valore nominale p < 0,10 criterio di inclusione. I 10 termini con rango più alto di ogni categoria sono mostrati in Figura 4B, Figura 4C, e Figura 4DI principali processi biologici comprendevano la regolazione positiva della proliferazione delle cellule muscolari lisce associate ai vasi sanguigni, la transizione G2/M del ciclo cellulare mitotico, la trasduzione del segnale mediata dal recettore del fattore di crescita simile all'insulina, la fosforilazione delle proteine, la regolazione negativa dell'apoptosi e la trasduzione del segnale. I principali termini relativi ai componenti cellulari erano nucleo, zattere lipidiche della membrana, adesione focale, membrana plasmatica e regione telomerica del cromosoma. Al contrario, i principali termini relativi alla funzione molecolare mostrati in Figura 4D attività di proteina chinasi, attività di proteina serina chinasi, legame all'ATP, attività di proteina serina/treonina chinasi, attività di proteina tirosina chinasi, attività di chinasi del ripetuto eptapeptide CTD della RNA polimerasi II, attività di chinasi, attività di chinasi dell'istone H2AXY142, attività di chinasi dell'istone H3Y41 e legame a proteine identiche. Le statistiche complete di arricchimento per BP, CC e MF sono fornite in Tabella supplementare 5, Tabella supplementare 6, e Tabella supplementare 7Nel complesso, questi risultati di arricchimento indicano che l'insieme di geni sovrapposti è concentrato in processi di segnalazione, regolazione della sopravvivenza e risposta oncogenica rilevanti per la progressione del carcinoma polmonare non a piccole cellule (NSCLC).
Selezione basata sul docking molecolare di complessi metabolita-target
È stato eseguito un docking molecolare tra il Composto 4 e il Composto 5 e le cinque proteine selezionate in base alla topologia della rete. I valori riportati nella Tabella 1 corrispondono ai punteggi di docking di AutoDock Vina e non rappresentano energie libere di legame misurate sperimentalmente. Il Composto 5 ha prodotto il punteggio singolo più favorevole con MMP9 (-8,418 kcal·mol⁻1), seguito dal Composto 4 con MMP9 (-7,840 kcal·mol⁻1). Il Composto 5 ha ottenuto punteggi anche più favorevoli rispetto al Composto 4 per AKT1 ed EGFR, mentre il Composto 4 ha ottenuto punteggi leggermente più favorevoli per SRC (-6,549 contro -6,204 kcal·mol⁻1) e TNF (-5,436 contro -5,299 kcal·mol⁻1). Pertanto, il Composto 5 non ha mostrato un vantaggio uniforme nei punteggi rispetto alle cinque proteine. I risultati del docking sono stati utilizzati esclusivamente per selezionare i complessi rappresentativi da sottoporre ad analisi strutturale ulteriore.
Sono mostrate conformazioni di docking rappresentative in Figura 5. Nella mappa delle interazioni MMP9–Composto 5 meglio classificata, i contatti visualizzati erano localizzati vicino ad Ala417 e Pro421, con distanze di circa 3,0 Å e 2,4 Å, rispettivamente. Nella mappa delle interazioni della posa principale conservata non è stata annotata alcuna coordinazione diretta tra il Composto 5 e lo ione ZN2⁺, né sono stati osservati contatti diretti con His401, Glu402, His405 o His411. Questo risultato contrasta con il riferimento cristallografico 1GKC, in cui His401, His405 e His411 coordinano lo ione ZN2⁺ catalitico a distanze di 2,21, 2,23 e 2,22 Å, e l'inibitore di tipo idrossamato inverso NFH coordina lo stesso ione ZN2⁺ attraverso due atomi di ossigeno a 2,07 e 2,38 Å. Poiché non è stata annotata alcuna coordinazione diretta tra il Composto 5 e lo ione ZN2⁺ nella mappa delle interazioni conservata, non è stata assegnata alcuna distanza di coordinazione Composto 5-ZN2⁺; ciò va interpretato come assenza di evidenza di coordinazione diretta nella mappa conservata, piuttosto che come un valore misurato di separazione tra il metallo e il composto. Un confronto tridimensionale con il riferimento cristallografico MMP9–NFH è mostrato in Figura Supplementare 1. La geometria, pertanto, differisce da un modo canonico di legame inibitorio dipendente dallo zinco, e il risultato del docking attuale non supporta la classificazione del Composto 5 come inibitore di MMP9. MMP9 è stato mantenuto per l'analisi di dinamica molecolare (MD) unicamente per determinare se questa specifica geometria di docking non canonica persistesse durante la traiettoria. Per gli altri complessi, il Composto 5 ha mostrato contatti predetti con AKT1 e SRC, mentre il Composto 4 ha formato interazioni definite di docking con MMP9 e SRC. In accordo con Figura 5F, queste osservazioni descrivono interazioni predette e punteggi relativi di docking, non affinità verificate sperimentalmente.
Sono stati selezionati tre complessi per l'analisi di dinamica molecolare (MD) a scopo comparativo, piuttosto che confermativo. Il complesso MMP9–Compound 5 è stato scelto perché presentava il punteggio di docking singolo più favorevole, ma con un orientamento non canonico di MMP9 che richiedeva un attento seguito strutturale. Il complesso SRC–Compound 5 è stato selezionato come secondo complesso candidato, mentre il complesso SRC–Compound 6 è stato incluso come traiettoria di controllo corrispondente senza intrappolamento. Le conformazioni iniziali corrispondenti sono mostrate in Figura 6A, Figura 6B, e Figura 6C. Questo disegno sperimentale ha permesso di confrontare la persistenza delle geometrie di docking selezionate senza considerare la stabilità della dinamica molecolare come prova di interazione con il bersaglio o di regolazione funzionale.
Analisi della dinamica molecolare
Per confrontare la persistenza di geometrie selezionate ottenute dal docking in condizioni dinamiche acquose, sono state generate traiettorie di dinamica molecolare (MD) di 150 ns per i complessi MMP9–Composto 5 e SRC (PDB 2H8H)–Composto 5, includendo SRC (PDB 2H8H)–Composto 6 come traiettoria di controllo negativo abbinata. Le conformazioni iniziali sono mostrate in Figura 6A, Figura 6B, e Figura 6C. Lungo queste traiettorie, il Composto 5 ha mostrato un RMSD del ligando inferiore (Figura 6D) nei sistemi MMP9 e SRC rispetto al Composto 6 in SRC. La traiettoria MMP9–Composto 5 ha raggiunto un regime caratterizzato da fluttuazioni relativamente basse, la traiettoria SRC–Composto 5 si è stabilizzata dopo un periodo iniziale di adattamento, mentre la traiettoria SRC–Composto 6 ha mostrato fluttuazioni maggiori. Queste differenze indicano una maggiore persistenza delle pose di docking del Composto 5 selezionate durante la dinamica molecolare. Tali risultati non dimostrano che il Composto 5 si leghi a MMP9 o SRC nelle cellule, e la traiettoria di MMP9 non compensa l'assenza di un ZN catalitico canonico2⁺ interazione nella posizione iniziale.
L'RMSD del tracciato proteico ha mostrato un andamento comparativo simile. La traiettoria di MMP9–Compound 5 è entrata in un regime relativamente stabile del tracciato dopo circa 30 ns, mentre la traiettoria di SRC–Compound 5 ha mostrato un plateau successivo, e la traiettoria di SRC–Compound 6 ha presentato fluttuazioni maggiori. Queste osservazioni descrivono esclusivamente il comportamento delle traiettorie. Un tracciato proteico stabile o una traiettoria del ligando non possono confermare l'occupazione del bersaglio intracellulare, l'inibizione enzimatica o la modulazione del segnale. I profili di RMSD del tracciato proteico per tutti e tre i sistemi sono riportati nella Supplementary Figure 2.
Analisi della traiettoria
Le analisi dell'occupazione dei legami a idrogeno e della fluttuazione dei residui sono state utilizzate per descrivere la persistenza dei contatti all'interno delle traiettorie di dinamica molecolare (MD) (Figura 7A). Il composto 5 ha mostrato un legame a idrogeno ad alta occupazione con Arg95 nella traiettoria MMP9 (>85%) e un'interazione ricorrente con Leu325 nella traiettoria SRC (>70%), mentre i contatti rappresentativi nel controllo SRC–Composto 6 presentavano occupazioni più basse. Questi residui non sono presentati come prova di una modulazione funzionale del bersaglio; i valori di occupazione indicano soltanto la frequenza con cui i contatti specificati si sono verificati durante le traiettorie analizzate.
L'analisi RMSF dei residui della tasca di legame ha mostrato differenze specifiche del sistema nella flessibilità locale (Figura 7B). La traiettoria di SRC–Composto 6 ha mostrato diverse fluttuazioni locali maggiori rispetto alla traiettoria di SRC–Composto 5, mentre la traiettoria di MMP9–Composto 5 ha mostrato un profilo di fluttuazione relativamente contenuto all'interno del proprio insieme di residui della tasca di legame. Poiché MMP9 e SRC sono proteine diverse, i loro valori RMSF a livello di residuo non sono stati interpretati come un confronto diretto residuo per residuo. Insieme all'occupazione dei legami a idrogeno, questi risultati caratterizzano la persistenza dei contatti e la flessibilità locale, aiutando a stabilire una gerarchia tra i complessi per i test sperimentali. Tali risultati non identificano MMP9 o SRC come target intracellulari né dimostrano che una di queste proteine medi il fenotipo anticancro dei composti.
Calcolo dell'energia libera di legame mediante meccanica molecolare e area superficiale Poisson-Boltzmann
Le stime di MM-PBSA calcolate dai segmenti della traiettoria equilibrata sono mostrate in Figura 8. Il complesso MMP9–Composto 5 ha prodotto una stima di ΔG_bind di -19,65 ± 6,43 kcal·mol⁻1, il complesso SRC–Composto 5 ha prodotto -17,72 ± 6,84 kcal·mol⁻1 e il controllo SRC–Composto 6 ha prodotto -10,37 ± 5,61 kcal·mol⁻1. All'interno di questo protocollo computazionale, il ranking energetico relativo è stato quindi MMP9–Composto 5, seguito da SRC–Composto 5 e SRC–Composto 6. Questi valori sono stime dipendenti dal metodo, derivate da un segmento finito di traiettoria, e non è stata applicata alcuna correzione entropica. Sono stati pertanto utilizzati esclusivamente per confronti all'interno dello studio e non devono essere interpretati come affinità di legame misurate sperimentalmente o come evidenza di una modulazione funzionale delle proteine.
Sulla base di docking, analisi di dinamica molecolare, occupazione dei contatti, fluttuazione dei residui e calcoli MM-PBSA, il Composto 5 è stato selezionato computazionalmente per ulteriori studi nei complessi MMP9 e SRC. La convergenza tra questi calcoli rafforza la giustificazione per la scelta di queste coppie per esperimenti successivi, ma non conferma MMP9 o SRC come target intracellulari diretti. In particolare, la conformazione non canonica di MMP9 e l'assenza di coordinamento dimostrato con lo ione ZN2⁺ escludono l'inferenza di un meccanismo inibitorio canonico di MMP9 a partire dai dati strutturali attuali.
Conclusioni derivanti dai risultati
Il flusso di lavoro computazionale ha individuato 21 bersagli associati alla malattia con sovrapposizione, identificando AKT1, EGFR, TNF, MMP9 e SRC come candidati principali in posizione centrale nella topologia. Analisi basate sulla struttura hanno ulteriormente privilegiato il Composto 5 per il successivo esame sperimentale nei complessi MMP9 e SRC. Questi risultati non dimostrano un legame diretto con i bersagli, l'inibizione di MMP9 o SRC, la regolazione del percorso metabolico, né una connessione meccanicistica causale tra le interazioni proteiche e l'effetto di intrappolamento del sito apurinico precedentemente stabilito. Lo studio supporta quindi un insieme di ipotesi computazionali verificabili, piuttosto che un meccanismo sperimentale multi-bersaglio contro il NSCLC.
DISPONIBILITÀ DEI DATI:
Il set di dati che supporta i risultati di questo studio è disponibile pubblicamente in Wang X, Peng Z, Xing Y, Xue L. In silico prioritization of potential protein interactions for glutathione-responsive abasic site-trapping prodrugs in non-small cell lung cancer [dataset]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
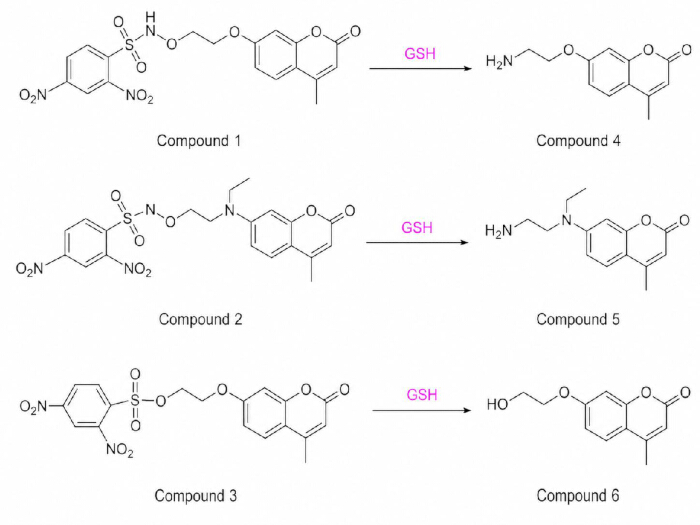
Figura 1: Strutture chimiche e relazioni di conversione attivate dal glutatione dei composti oggetto dello studio. Il Composto 1 e il Composto 2 sono profarmaci sensibili al glutatione che rilasciano i metaboliti contenenti gruppo aminossi, rispettivamente Composto 4 e Composto 5. Il Composto 3 è un controllo strutturale abbinato sensibile al glutatione che genera il Composto 6, privo della funzionalità di intrappolamento del sito apurinico/apirimidinico mediante gruppo aminossi. I Composti da 1 a 3 sono stati utilizzati per la previsione inversa del bersaglio, i Composti 4 e 5 per il docking con il bersaglio centrale (hub-target), e il Composto 6 come ligando di controllo negativo nel confronto della dinamica molecolare di SRC. Abbreviazioni: SRC, proto-oncogene SRC, tirosina chinasi non recettoriale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
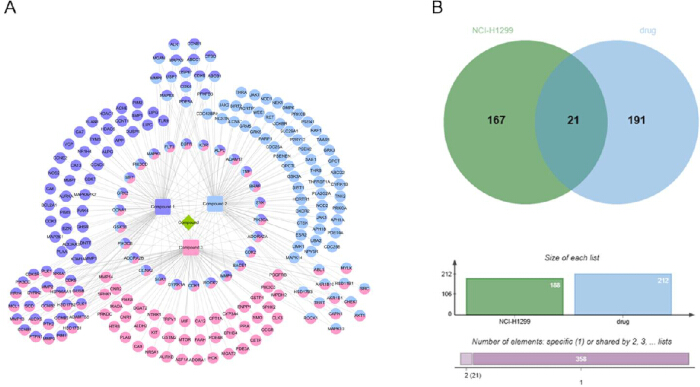
Figura 2: Intersezione tra i bersagli predetti dal composto e i bersagli associati al carcinoma polmonare non a piccole cellule. (A) Rete composto-bersaglio generata dai risultati della previsione inversa dei bersagli per i Composti 1–3. (B) Diagramma di Venn che mostra l'overlapping tra i bersagli predetti dal composto e i bersagli associati alla malattia, ottenuti mediante la query sul cancro al polmone H1299. I 21 bersagli comuni sono stati mantenuti per l'analisi delle interazioni proteina-proteina, l'analisi di arricchimento e la successiva priorizzazione basata sulla struttura. Cliccare qui per visualizzare una versione ingrandita di questa figura.
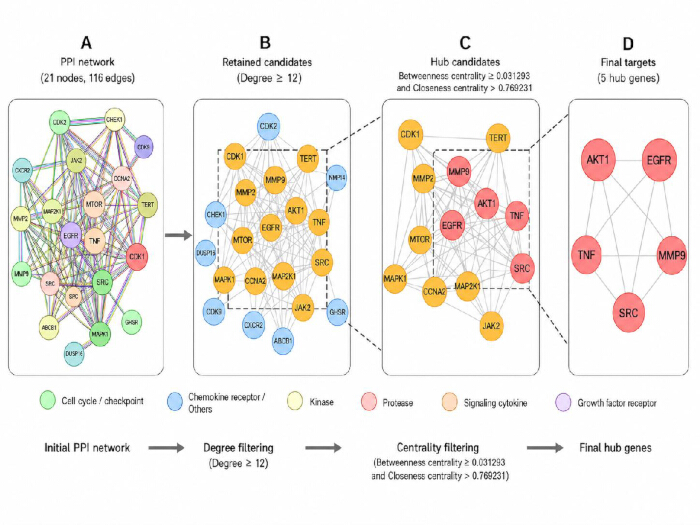
Figura 3: Rete di interazioni proteina-proteina e screening dei target principali. (A) Rete di interazioni proteina-proteina dei 21 target comuni (116 connessioni). (B) Primo passaggio di screening mediante Degree ≥ 12, che ha selezionato 13 candidati. (C) Secondo screening dei 13 candidati selezionati utilizzando la centralità di betweenness ≥ 0,031293 e la centralità di closeness > 0,769231, che ha identificato cinque candidati hub. (D) I cinque candidati hub finali: AKT1, EGFR, TNF, MMP9 e SRC. I valori di centralità utilizzati per i filtri sequenziali sono stati calcolati sulla rete originale composta da 21 nodi e 116 connessioni e mantenuti invariati, piuttosto che essere ricalcolati dopo la formazione di ciascun sottoinsieme. Abbreviazioni: AKT1, chinasi serina/treonina AKT 1; EGFR, recettore del fattore di crescita epidermico; TNF, fattore di necrosi tumorale; MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
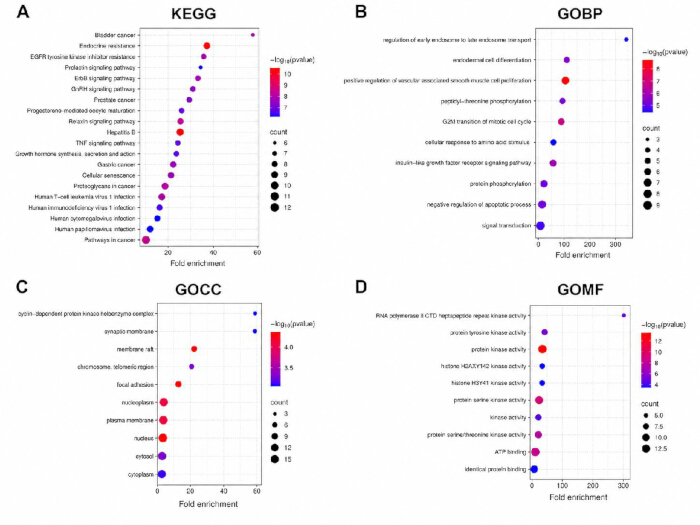
Figura 4: Analisi di arricchimento funzionale delle intersezioni tra i bersagli. (A) Diagramma a bolle dei primi 20 percorsi arricchiti dell'Enciclopedia di Kyoto dei Geni e dei Genomi (KEGG). (B) Diagramma a barre dei primi 10 termini arricchiti del processo biologico nell'ontologia genica (Gene Ontology). (C) Diagramma a barre dei primi 10 termini arricchiti del componente cellulare nell'ontologia genica. (D) Diagramma a barre dei primi 10 termini arricchiti della funzione molecolare nell'ontologia genica. L'asse x della rappresentazione finale mostra il fold di arricchimento; la dimensione delle bolle nel pannello A riflette il numero di geni. Tutte le voci KEGG e GO riportate nelle Tabelle Supplementari 4–7 soddisfano il criterio nominale di inclusione p < 0,10; i percorsi/termini rappresentati sono quelli con il valore di p nominale più basso. I valori corretti per confronti multipli sono riportati nelle tabelle supplementari, ma non sono stati utilizzati ai fini dell'inclusione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
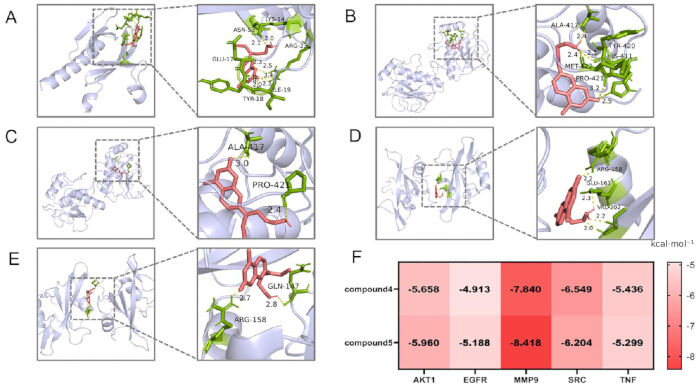
Figura 5: Posizioni di docking molecolare e punteggi di AutoDock Vina del Composto 4 e del Composto 5 con le proteine prioritizzate. (A) Posizione di docking prevista del Composto 5 con AKT1. (B) Posizione di docking prevista del Composto 4 con MMP9. (C) Posizione prevista con punteggio più alto del Composto 5 con MMP9; i contatti mostrati sono vicini ad Ala417 e Pro421, mentre non sono annotati né coordinamento diretto con lo ione ZN2⁺ catalitico né contatti diretti con His401, Glu402, His405 o His411. La posizione non è quindi presentata come una modalità canonica di legame inibitorio per MMP9. Un confronto di riferimento con la mappa delle interazioni della struttura cristallina di MMP9 legata a NFH (PDB 1GKC), inclusa la distanza di coordinazione cristallografica dello ione ZN2⁺, è riportato nella Figura Supplementare 3. (D) Posizione di docking prevista del Composto 4 con SRC. (E) Posizione di docking prevista del Composto 5 con SRC. (F) Mappa termica dei punteggi di docking di AutoDock Vina (kcal·mol⁻1) del Composto 4 e del Composto 5 nei confronti delle cinque proteine prioritizzate. Valori più negativi indicano punteggi Vina più favorevoli all'interno di questo protocollo di docking; non si tratta di affinità di legame misurate sperimentalmente. Abbreviazioni: AKT1, chinasi della serina/treonina AKT 1; MMP9, metalloproteasi della matrice 9; NFH, N2-[(2R)-2-{[formil(idrossi)ammino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinammide; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, istidina; e Glu, glutammato. Cliccare qui per visualizzare una versione ingrandita di questa figura.
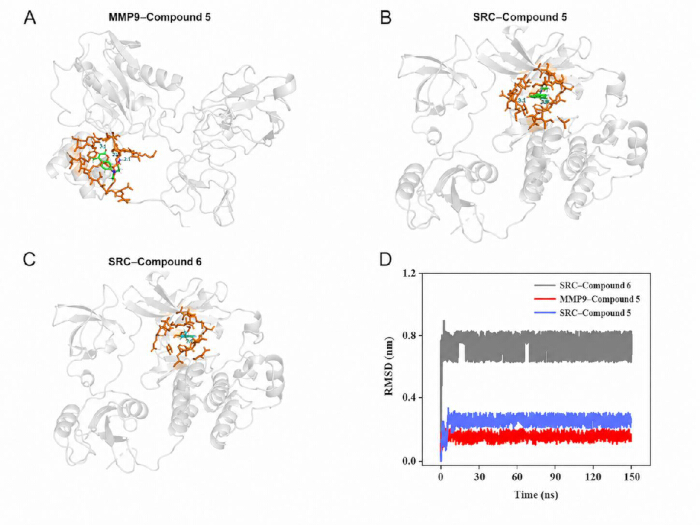
Figura 6: Panoramica strutturale e analisi della stabilità del ligando nei complessi di dinamica molecolare (MD). (A) Conformazione iniziale del docking del Composto 5 con MMP9, utilizzata come struttura iniziale per la dinamica molecolare. (B) Conformazione iniziale del docking del Composto 5 con SRC (PDB 2H8H). (C) Conformazione iniziale del docking del Composto 6 con SRC (PDB 2H8H); il Composto 6 è il prodotto della scissione del glutatione del Composto 3 di controllo e manca della funzionalità aminossidica in grado di intrappolare siti apurinici/apirimidinici. (D) Deviazione quadratica media (RMSD) del ligando rispetto alla posa iniziale di docking lungo le traiettorie di 150 ns per MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6. Il pannello confronta la persistenza della posa durante la dinamica molecolare e non dimostra il legame con il bersaglio intracellulare. Abbreviazioni: MD, dinamica molecolare; MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; PDB, Protein Data Bank; RMSD, deviazione quadratica media. Cliccare qui per visualizzare una versione ingrandita di questa figura.
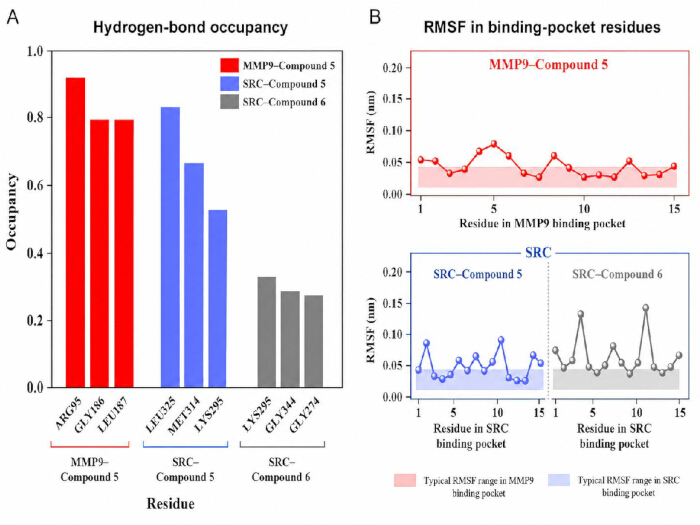
Figura 7: Caratteristiche dell'interazione dinamica durante l'analisi della dinamica molecolare. (A) Occupazione di legami a idrogeno rappresentativi tra ligando e proteina durante le traiettorie di 150 ns per MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6. (B) Fluttuazione quadratica media dei residui della tasca di legame. Il profilo di MMP9 è interpretato all'interno del sistema MMP9, mentre i profili di SRC–Composto 5 e SRC–Composto 6 forniscono un confronto diretto e abbinato all'interno di SRC. Queste analisi descrivono la persistenza dei contatti e la flessibilità locale durante la dinamica molecolare e non dimostrano il legame intracellulare al bersaglio né la modulazione funzionale di MMP9 o SRC. Abbreviazioni: MD, dinamica molecolare; MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; RMSF, fluttuazione quadratica media. Cliccare qui per visualizzare una versione ingrandita di questa figura.
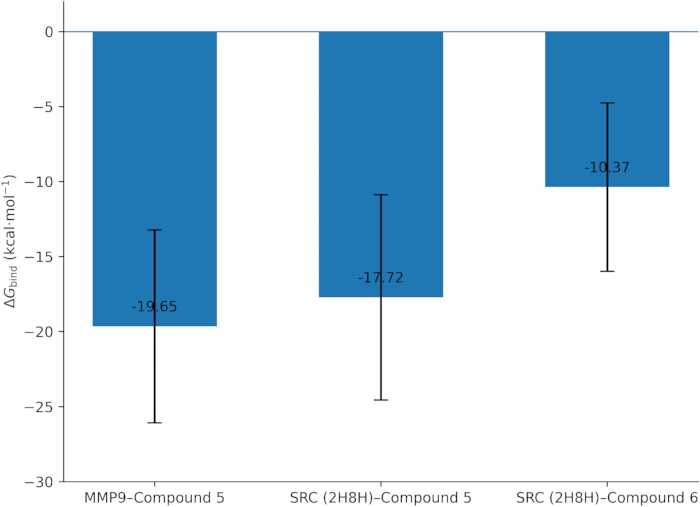
Figura 8: Stime energetiche del metodo meccanica molecolare superficie di Poisson-Boltzmann per i complessi analizzati. Valori di ΔG_bind stimati ottenuti mediante il metodo meccanica molecolare superficie di Poisson-Boltzmann a partire dai segmenti di traiettoria equilibrati dei complessi MMP9–Composto 5, SRC (PDB 2H8H)–Composto 5 e SRC (PDB 2H8H)–Composto 6. I valori sono espressi come media ± deviazione standard e sono utilizzati per confronti relativi all'interno dello studio piuttosto che come affinità di legame misurate sperimentalmente. La Figura 8 utilizza l'etichetta dell'asse y ΔG_bind (kcal·mol⁻1), coerentemente con l'equazione e la terminologia usate nella sezione Metodi e Risultati. Abbreviazioni: MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; PDB, Protein Data Bank; ΔG_bind, energia libera di legame; MM-PBSA, meccanica molecolare superficie di Poisson-Boltzmann. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Composto | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Composto 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Composto 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabella 1: Punteggi di docking di AutoDock Vina per il Composto 4 e il Composto 5 nei confronti delle cinque proteine prioritarie. Punteggi di docking di AutoDock Vina (kcal·mol⁻1) per il Composto 4 e il Composto 5 con AKT1, EGFR, MMP9, SRC e TNF. Valori più negativi indicano punteggi più favorevoli all'interno del protocollo di docking specificato. Questi valori sono punteggi computazionali e non devono essere descritti come energie libere di legame o affinità misurate sperimentalmente. Abbreviazioni: AKT1, chinasi della serina/treonina AKT 1; EGFR, recettore del fattore di crescita epidermico; MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; TNF, fattore di necrosi tumorale.
Figura supplementare 1: Confronto strutturale tra il riferimento cristallografico MMP9–NFH e la posa di docking più favorita per MMP9–Composto 5. (A) Ambiente del ZN2⁺ catalitico del complesso di riferimento MMP9–NFH (PDB 1GKC), che mostra His401, His405, His411, Glu402 e le distanze di coordinazione di NFH indicate. (B) Posa di docking più favorita del Composto 5, che mostra i contatti con Ala417 e Pro421 indicati. (C) Vista tridimensionale alternativa della stessa posa di docking del Composto 5. Il confronto è fornito come riferimento strutturale e non dimostra l'inibizione di MMP9. Abbreviazioni: MMP9, metalloproteasi della matrice 9; NFH, N2-[(2R)-2-{[formil(ossi)ammino]metil}-4-metilpentanoil]-N,3-dimetil-L-valinammide; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, istidina; Glu, glutammato.Cliccare qui per scaricare questo file.
Figura supplementare 2: Deviazione standard quadratica media del tratto principale della proteina durante l'analisi della dinamica molecolare. Profili della deviazione standard quadratica media del tratto principale della proteina per i sistemi MMP9–Composto 5, SRC (PDB 2H8H)–Composto 5 e SRC (PDB 2H8H)–Composto 6 lungo l'intera traiettoria di dinamica molecolare. L'ultimo grafico utilizza le etichette standardizzate MMP9–Composto 5, SRC–Composto 5 e SRC–Composto 6, con assi riportati come RMSD (nm) e Tempo (ns). I profili descrivono il comportamento conformazionale dipendente dal tempo durante la dinamica molecolare e non devono essere interpretati come evidenza di legame cellulare o regolazione proteica. Abbreviazioni: MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale; PDB, Protein Data Bank; RMSD, deviazione standard quadratica media; MD, dinamica molecolare.Cliccare qui per scaricare questo file.
Figura supplementare 3: Confronto dell'ambiente del ZN2⁺ catalitico di MMP9 nel complesso di riferimento 1GKC-NFH e nella posa di docking meglio classificata del Composto 5. Nel complesso di riferimento cristallografico MMP9–NFH (PDB 1GKC), His401, His405 e His411 coordinano il ZN2⁺ catalitico a 2,21, 2,23 e 2,22 Å, rispettivamente, e due atomi di ossigeno di NFH coordinano il ZN2⁺ a 2,07 e 2,38 Å; Glu402 è il residuo acido/base catalitico. Al contrario, la mappa delle interazioni conservata per il Composto 5 mostra contatti con Ala417 (3,0 Å) e Pro421 (2,4 Å), ma nessuna coordinazione diretta annotata con ZN2⁺ né contatti diretti con His401, Glu402, His405 o His411. Di conseguenza, nessuna distanza di coordinazione tra Composto 5 e ZN2⁺ è stata assegnata. Questo confronto supporta la classificazione della posa del Composto 5 come associazione prevista non canonica piuttosto che come modalità canonica di legame inibitorio dipendente dallo zinco. Abbreviazioni: MMP9, metalloproteasi della matrice 9; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, istidina; Glu, glutammato.Cliccare qui per scaricare questo file.
Tabella Supplementare 1: Metriche topologiche della rete iniziale di interazioni proteina-proteina composta da 21 nodi e 116 archi. Parametri topologici relativi ai 21 nodi corrispondenti ai bersagli comuni prima dello screening basato sulla centralità, inclusi la lunghezza media del cammino più breve, la centralità di betweenness, la centralità di vicinanza, il coefficiente di clustering, il grado, l'eccentricità, la connettività del vicinato, la radialità, lo stress e il coefficiente topologico. La somma dei gradi dei nodi è pari a 232, valore corrispondente a 116 archi non orientati.Cliccare qui per scaricare il file.
Tabella Supplementare 2: Metriche topologiche della rete originale per i 13 candidati mantenuti dopo il filtraggio basato sul grado. Parametri topologici per i 13 nodi mantenuti dopo aver applicato il criterio del grado alla rete iniziale composta da 21 nodi e 116 collegamenti. Questi valori corrispondono alle metriche della rete originale di 21 nodi e 116 collegamenti, riportate in avanti per la successiva fase di filtraggio basata sulla centralità per betweenness e per vicinanza; non sono stati ricalcolati su una sottorete di 13 nodi.Cliccare qui per scaricare il file.
Tabella supplementare 3: Metriche topologiche della rete originale per i cinque candidati hub finali mantenuti dopo il filtraggio sequenziale. Parametri topologici originali della rete composta da 21 nodi e 116 collegamenti per i cinque candidati hub finali, AKT1, EGFR, TNF, MMP9 e SRC, mantenuti dopo il filtraggio sequenziale. Questi valori riportati supportano esclusivamente la priorizzazione basata sulla rete e non rappresentano metriche ricalcolate su una sottorete di cinque nodi né indicano che le proteine siano bersagli farmacologici validati sperimentalmente. Abbreviazioni: AKT1, chinasi 1 della serina/treonina AKT; EGFR, recettore del fattore di crescita epidermico; TNF, fattore di necrosi tumorale; MMP9, metalloproteasi della matrice 9; SRC, proto-oncogene SRC, tirosina chinasi non recettoriale.Cliccare qui per scaricare il file.
Tabella supplementare 4: Risultati completi dell'arricchimento del Kyoto Encyclopedia of Genes and Genomes per 121 percorsi che soddisfano il criterio nominale di inclusione p < 0,10. Statistiche complete dell'arricchimento del Kyoto Encyclopedia of Genes and Genomes per tutti i 121 percorsi conservati tra i 21 bersagli intersecanti (valore nominale p < 0,10), inclusi rapporto genico, conteggi genici, totali dell'elenco, riscontri nella popolazione, totali della popolazione, valori p, valori di Benjamini, arricchimento di fold, valori di Bonferroni, tassi di falsa scoperta e valori del test esatto di Fisher. I 20 percorsi con il punteggio più alto sono visualizzati nella Figura 4A. Il criterio del valore p nominale ha definito l'inclusione; i valori di Benjamini, Bonferroni e del tasso di falsa scoperta sono riportati per trasparenza e non sono stati utilizzati per definire l'insieme conservato.Cliccare qui per scaricare il file.
Tabella supplementare 5: Risultati completi dell'arricchimento dei processi biologici della Gene Ontology (177 termini che soddisfano il valore nominale p < 0.10). Statistiche complete di arricchimento per tutti i 177 termini del processo biologico della Gene Ontology mantenuti (p nominale < 0,05) < 0,10), inclusi rapporto genico, numero di geni, totale della lista, riscontri nella popolazione, totale della popolazione, pvalore, valore di Benjamini, arricchimento rispetto al controllo, valore di Bonferroni, tasso di falsa scoperta e valore del test esatto di Fisher. I 10 termini con il punteggio più alto sono visualizzati nella Figura 4B. Il valore nominale pil criterio basato sul valore p ha definito l'inclusione; i valori aggiustati sono riportati per trasparenza e non sono stati utilizzati per definire l'insieme selezionato.Fare clic qui per scaricare questo file.
Tabella Supplementare 6: Risultati completi dell'arricchimento dei componenti cellulari della Gene Ontology (29 termini che soddisfano il valore nominale di p < 0,10). Statistiche complete di arricchimento per tutti i 29 termini dei componenti cellulari della Gene Ontology mantenuti (valore nominale di p < 0,10), inclusi rapporto genico, conteggio genico, totale dell'elenco, riscontri nella popolazione, totale della popolazione, valore di p, valore di Benjamini, arricchimento fold, valore di Bonferroni, tasso di falsa scoperta e valore del test esatto di Fisher. I 10 termini con il punteggio più alto sono visualizzati nella Figura 4C. Il criterio del valore di p nominale ha definito l'inclusione; i valori corretti sono riportati per trasparenza e non sono stati utilizzati per definire l'insieme mantenuto.Cliccare qui per scaricare il file.
Tabella Supplementare 7: Risultati completi dell'arricchimento delle funzioni molecolari della Gene Ontology (61 termini che soddisfano il valore nominale di p < 0,10). Statistiche complete di arricchimento per tutti i 61 termini di funzione molecolare della Gene Ontology mantenuti (valore nominale di p < 0,10), inclusi rapporto genico, conteggio genico, totale dell'elenco, riscontri nella popolazione, totale della popolazione, valore di p, valore di Benjamini, arricchimento fold, valore di Bonferroni, tasso di falsa scoperta e valore del test esatto di Fisher. I 10 termini con il punteggio più alto sono visualizzati nella Figura 4D. Il criterio del valore di p nominale ha definito l'inclusione; i valori corretti sono riportati per trasparenza e non sono stati utilizzati per definire l'insieme mantenuto.Cliccare qui per scaricare il file.
Discussione
Lo studio attuale deve essere interpretato all'interno di un quadro meccanicistico a due livelli. Il primo livello si basa su precedenti lavori sperimentali: l'attivazione sensibile al glutatione rilascia una specie contenente aminossi che può intrappolare siti apurinici aldeidici, e la classe di composti ha mostrato citotossicità selettiva, effetti sul ciclo cellulare e apoptosi nelle cellule H1299. Il secondo livello è esplorativo ed è l'obiettivo del presente lavoro: previsioni computazionali dei bersagli e analisi basate sulla struttura suggeriscono che la stessa serie chimica potrebbe essere compatibile anche con alcune proteine associate al cancro. Nessun esperimento di questo studio dimostra che le interazioni proteiche previste avvengano effettivamente nelle cellule o che siano conseguenze a valle dell'intrappolamento dei siti apurinici. I due livelli sono pertanto mantenuti intenzionalmente separati, piuttosto che essere combinati in un meccanismo multi-bersaglio dimostrato.
A livello di rete, le 21 intersezioni risultanti sono risultate arricchite in vie metaboliche associate al cancro e alla resistenza, e le proteine AKT1, EGFR, TNF, MMP9 e SRC occupavano posizioni centrali nella rete di interazione proteina-proteina (PPI). Questi risultati sono utili per la priorizzazione dei candidati, ma la centralità nella rete e l'arricchimento non dimostrano che un composto interagisca fisicamente con una proteina o modifichi una via metabolica. Le proteine hub dovrebbero pertanto essere considerate candidati per una validazione mirata. La conferma di un ruolo funzionale richiederebbe esperimenti di perturbazione diretta o di interazione con il bersaglio, effettuati nella stessa linea cellulare di NSCLC utilizzata per misurare il fenotipo cellulare.
MMP9 illustra perché questa distinzione è importante. Il composto 5 ha ottenuto il punteggio di docking singolo più favorevole con MMP9, ma la mappa delle interazioni della posa principale conservata non indicava un coordinamento diretto con l'ione Zn2+ catalitico né un coinvolgimento diretto di His401, Glu402, His405 o His411. Nel riferimento cristallografico 1GKC, His401, His405 e His411 coordinano lo Zn2+ a 2,21, 2,23 e 2,22 Å, mentre i due atomi di ossigeno NFH coordinano lo Zn2+ a 2,07 e 2,38 Å; Glu402 è il residuo acido/base catalitico. La mappa del composto 5 mostrava invece contatti vicini ad Ala417 e Pro421. Figura supplementare 3 presenta il confronto tra le mappe di interazione di riferimento. Poiché non è stato annotato un coordinamento diretto tra il composto 5 e lo Zn2+, non è stata assegnata alcuna distanza di coordinamento tra composto 5 e Zn2+. Di conseguenza, il risultato strutturale attuale è meglio descritto come un'associazione prevista non canonica con MMP9, e non come prova di inibizione del sito catalitico. La successiva traiettoria di dinamica molecolare verifica soltanto se quella specifica posa di docking rimane stabile nel tempo; non può trasformare una geometria di docking non canonica in una dimostrazione di inibizione enzimatica36,37. MMP9 dovrebbe quindi rimanere un candidato per test biochimici, piuttosto che un bersaglio principale o validato. MMP9 è stato ampiamente discusso in relazione all'invasione tumorale, al rimodellamento del microambiente tumorale e alle strategie terapeutiche dirette contro MMP938,39.
Si applica lo stesso limite di evidenza anche all'SRC. La traiettoria di SRC–Composto 5 ha mostrato contatti più persistenti rispetto al controllo SRC–Composto 6, ma la stabilità ottenuta con la dinamica molecolare non equivale al legame al bersaglio all'interno della cellula40,41. L'uso del Composto 6 consente un confronto strutturale appropriato con il prodotto di scissione non intrappolante e rafforza il confronto interno, ma non dimostra che la funzionalità aminossidrilica sia responsabile del legame all'SRC o che la segnalazione dell'SRC sia alterata nelle cellule. Sarebbero necessarie valutazioni dirette dell'SRC totale, del rapporto p-SRC/SRC, dei marcatori della segnalazione a valle e di misurazioni ortogonali dell'interazione con il bersaglio per sostenere tale affermazione.
MM-PBSA fornisce inoltre una stima energetica relativa per le traiettorie campionate, piuttosto che una misura sperimentale dell'affinità. Le stime più favorevoli per MMP9–Compound 5 e SRC–Compound 5 rispetto a SRC–Compound 6 sono coerenti con le osservazioni comparative delle traiettorie, ma i calcoli sono sensibili alle conformazioni campionate e alle approssimazioni metodologiche, e l'analisi attuale non ha incluso una correzione entropica. L'accordo tra docking, dinamica molecolare e MM-PBSA aumenta quindi soltanto la coerenza computazionale interna; non stabilisce una modulazione funzionale di MMP9 o SRC.
Il rapporto tra il trattenimento dei siti apurinici e le interazioni proteiche previste rimane irrisolto. Una possibilità è che lo scheletro aminossidrilico rilasciato dal glutatione mantenga la sua attività consolidata di intrappolamento delle lesioni del DNA, oltre a interagire in modo indipendente e parallelo con proteine selezionate. Un'altra possibilità è che alcune interazioni proteiche previste non si verifichino a concentrazioni biologicamente rilevanti o non contribuiscano al fenotipo. I dati attuali non permettono di distinguere tra queste ipotesi. Dimostrare un collegamento meccanicistico richiederebbe la misurazione simultanea delle risposte al danno del DNA e dei cambiamenti nei percorsi proteici dopo il trattamento con il composto, seguita da esperimenti di perturbazione che dimostrino come la modulazione di un bersaglio candidato alteri il fenotipo antitumorale.
La validazione sperimentale futura dovrebbe essere eseguita in cellule H1299, lo stesso modello cellulare utilizzato nella precedente caratterizzazione sperimentale di questa serie chimica. Una strategia articolata prevede innanzitutto il confronto tra il Composto 5 e il veicolo nonché il composto di controllo non intrappolante Composto 6, mediante saggi di risposta concentrazione-viabilità, apoptosi, ciclo cellulare, migrazione/invasione e γH2AX, al fine di definire il contesto fenotipico e di danno al DNA42. Successivamente, l'MMP9 dovrebbe essere analizzata mediante zimografia su gelatina e studio dell'espressione proteica, mentre il segnale SRC dovrebbe essere valutato misurando i livelli totali di SRC e di SRC fosforilato in Tyr416, utilizzando il rapporto p-SRC/SRC come parametro principale di lettura del segnale. L'associazione diretta tra composto e proteina dovrebbe essere valutata in modo indipendente mediante un metodo ortogonale di engagement del bersaglio, come la risonanza plasmonica di superficie43. Un'interazione candidata dovrebbe essere considerata supportata sperimentalmente soltanto quando le evidenze di legame diretto siano concordanti con il corrispondente risultato funzionale cellulare. Una perturbazione genetica o farmacologica di MMP9 o SRC fornirebbe un ulteriore test per verificare se uno dei due candidati contribuisca causalmente al fenotipo osservato in H1299. Questo schema articolato mantiene distinta l'attività di intrappolamento del sito apurinico precedentemente dimostrata dalle ipotesi di interazione MMP9/SRC ottenute per via computazionale, definendo al contempo un percorso diretto per ulteriori verifiche sperimentali.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto né altri conflitti di interessi relativi a questo lavoro. I finanziatori non hanno avuto alcun ruolo nella progettazione dello studio; nella raccolta, analisi o interpretazione dei dati; nella stesura del manoscritto; né nella decisione di pubblicare i risultati.
Ringraziamenti
Questo lavoro è stato sostenuto dal Progetto Giovani del Dipartimento Provinciale dell'Istruzione del Liaoning (JYTQN2023441), dal Progetto di Avvio della Ricerca Dottorale del Fondo Congiunto Provinciale del Dipartimento della Scienza e Tecnologia del Liaoning (2023-BSBA-151) e dal Progetto di Sostegno ai Giovani Talenti Scientifici e Tecnologici dell'Università Medica di Jinzhou (JYQT202305). ChatGPT (OpenAI) è stato utilizzato durante la revisione del manoscritto per supporto nella correzione linguistica, nell'organizzazione e nella revisione. Gli autori hanno esaminato e verificato il contenuto scientifico, l'interpretazione dei dati e la formulazione finale, assumendosi piena responsabilità per il manoscritto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| ACPYPE | ACPYPE developers / Bio2Byte | Versione 2023.11.14 | Generazione e conversione di file di topologia di ligandi a piccole molecole in formato compatibile con GROMACS. |
| AmberTools (Antechamber) | Squadra di sviluppo AMBER | AmberTools 23.3 | Assegnazione di cariche parziali AM1-BCC e generazione di parametri del ligando con GAFF2. |
| AutoDock Vina | Forli Lab, Scripps Research | Versione 1.2.5 | Docking molecolare e generazione di pose ordinate di complessi proteina-ligando. |
| AutoDockTools (MGLTools) | Centro per la Biologia Strutturale Computazionale, Scripps Research | Versione 1.5.7 | Preparazione di recettore e ligando, assegnazione di cariche di Gasteiger, definizione di legami rotabili e conversione in formato PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Versione 2025 | Visualizzazione delle pose di docking e analisi delle interazioni proteina-ligando. |
| Campo di forza CHARMM36 | MacKerell Laboratory / Sviluppatori del campo di forza CHARMM | CHARMM36 | Parametrizzazione delle proteine per calcoli di dinamica molecolare; CHARMM36 è stato utilizzato in modo coerente durante tutto lo studio (non CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Versione 22.2 | Minimizzazione dell'energia del ligando utilizzando il campo di forza MMFF94. |
| Composti 1–6 | Sintetizzati in precedenza come descritto in Li et al., ACS Chemical Biology (2022) | N/A | Profarmaci parentali sensibili al glutatione, prodotti rilasciati e coppia di controllo non intrappolante utilizzati nel flusso di lavoro computazionale. |
| cytoHubba | Sviluppatori di cytoHubba / Cytoscape App Store | Versione 0.1 | Analisi di grado, centralità di betweenness e centralità di vicinanza per la priorizzazione di target hub. |
| Cytoscape | Consorzio Cytoscape | Versione 3.10.0 | Visualizzazione e analisi topologica di reti composti-target e interazioni proteina-proteina (PPI). |
| Risorse Bioinformatiche DAVID | Laboratorio di Retrovirologia Umana e Immunoinformatica, Frederick National Laboratory for Cancer Research | Risorsa web | Analisi di arricchimento Gene Ontology e KEGG; è stato utilizzato un valore p nominale < 0,10 come criterio esplorativo di inclusione; i valori corretti sono stati riportati ma non sono stati utilizzati per definire l'insieme selezionato. |
| GAFF2 | Squadra di sviluppo AMBER | GAFF2 | Parametrizzazione del campo di forza per ligandi. |
| GeneCards Human Gene Database | GeneCards Suite / LifeMap Sciences, Inc. / Weizmann Institute of Science | Risorsa web | Recupero di target associati a malattie utilizzando la query 'cancro del polmone H1299'. |
| gmx_MMPBSA | Squadra di sviluppo gmx_MMPBSA | Versione 1.6.3 | Calcoli dell'energia libera di legame MM-PBSA a partire da traiettorie di dinamica molecolare GROMACS; sono stati campionati 500 frame da 100,0–149,9 ns a intervalli di 100 ps, escludendo il punto finale a 150,0 ns; non è stata applicata alcuna correzione entropica. |
| GROMACS | Squadra di sviluppo GROMACS | Versione 2024.4 | Generazione e analisi di traiettorie di dinamica molecolare. |
| Piattaforma online di visualizzazione Microbioinfo | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Risorsa web | Generazione di grafici a barre di arricchimento e grafici a bolle. |
| Open Babel | Squadra di sviluppo Open Babel | Versione 3.1.1 | Conversione di file strutturali in SMILES canonici per l'input in SwissTargetPrediction. |
| PubChem | National Center for Biotechnology Information, U.S. National Library of Medicine, NIH | Risorsa web | Recupero di strutture tridimensionali di ligandi. |
| PyMOL Molecular Graphics System | Schrödinger, LLC | Versione 2.5.4 | Preparazione delle proteine, visualizzazione strutturale e analisi delle pose di docking. |
| RCSB Protein Data Bank | Research Collaboratory for Structural Bioinformatics (RCSB) | PDB IDs: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Recupero delle strutture proteiche per AKT1, EGFR, TNF, MMP9 e SRC, rispettivamente. |
| STRING | Consorzio STRING | Versione 11.5 | Costruzione della rete di interazioni proteina-proteina; Homo sapiens; punteggio minimo richiesto per l'interazione 0,400; le metriche topologiche originali corrispondono alla rete PPI non diretta con 21 nodi e 116 archi. |
| SwissTargetPrediction | Gruppo di Modellistica Molecolare, Università di Losanna / SIB Swiss Institute of Bioinformatics | Risorsa web | Predizione inversa dei target per i Composti 1–3; specie limitata a Homo sapiens. |
| Modello d'acqua TIP3P | Implementato in GROMACS | TIP3P | Modello d'acqua esplicito a tre siti utilizzato per solvatizzare complessi proteina-ligando. |
| Venny | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Versione 2.1 | Intersezione tra liste di target predetti dai composti e target associati a malattie. |
Riferimenti
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.