Questo protocollo presenta un flusso di lavoro basato sul deep learning, riproducibile, che utilizza dati ciclici multicanale e caratteristiche progettate per prevedere lo stato di salute, la vita utile residua e le prestazioni di accumulo energetico delle batterie agli ioni di litio.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Un flusso di lavoro di deep learning riproducibile per la previsione delle prestazioni delle batterie agli ioni di litio utilizzando dati di ciclaggio multicanale
In questo articolo
Sommario
Abstract
Questo protocollo presenta un flusso di lavoro basato sul deep learning, riproducibile, per la previsione delle prestazioni delle batterie agli ioni di litio mediante l'utilizzo di dati di ciclaggio multicanale. Per affrontare le limitazioni dei modelli basati sui dati esistenti relative all'integrazione di informazioni multisorgente e alla rappresentazione delle caratteristiche, il metodo utilizza cinque dataset pubblici disponibili sulle batterie. Gli ingressi includono segnali operativi grezzi, come tensione, corrente, capacità, temperatura, resistenza interna ed efficienza coulombica ed energetica, insieme a caratteristiche derivate, come capacità incrementale, tensione differenziale e energia totale scaricata. Il protocollo descrive procedure standardizzate di pre-elaborazione per costruire tensori temporali a livello di batteria su diverse finestre di osservazione. Per migliorare la riproducibilità, il flusso di lavoro valuta architetture candidate di reti neurali, tra cui reti neurali profonde, reti neurali convoluzionali (CNN), reti a memoria a lungo breve termine (LSTM), modelli ibridi CNN–LSTM e modelli basati su trasformatori, utilizzando semi casuali fissi, esecuzioni di valutazione ripetute e tracciamento dell'ambiente. I risultati rappresentativi hanno dimostrato che l'architettura CNN–LSTM, con dati multicanale integrati e caratteristiche derivate, ha ottenuto prestazioni predittive favorevoli tra i modelli valutati. La configurazione selezionata ha raggiunto un errore assoluto medio di 0,024 e un valore di R2 pari a 0,955 nella stima dello stato di salute, mantenendo nel contempo elevate prestazioni predittive nella stima della vita utile residua e dell'energia scaricabile. Analisi di ablazione e di robustezza hanno ulteriormente dimostrato il contributo dell'integrazione delle caratteristiche multicanale e la stabilità del flusso di lavoro focalizzato sulla riproducibilità attraverso valutazioni ripetute. Questa metodologia standardizzata fornisce un quadro riproducibile per la gestione del ciclo di vita delle batterie e la modellizzazione predittiva in condizioni operative diverse.
Introduzione
Le batterie agli ioni di litio sono fondamentali per la transizione globale verso fonti di energia rinnovabile grazie alla loro elevata densità energetica, alla lunga vita in termini di cicli e ai bassi tassi di autoscarica in applicazioni che vanno dall'elettronica portatile ai sistemi di accumulo di energia su scala di rete. Tuttavia, un funzionamento prolungato porta inevitabilmente a un graduale degrado della capacità e a un aumento della resistenza interna1. Questo calo prestazionale non solo riduce la sostenibilità economica, ma introduce anche gravi rischi per la sicurezza, inclusa la corsa termica. Con l'accelerazione continua nell'implementazione di sistemi di accumulo di energia su larga scala, la gestione del ciclo di vita delle batterie è diventata sempre più complessa2. I tradizionali protocolli di monitoraggio basati su soglie e ispezioni manuali risultano insufficienti in ambienti operativi dinamici3. Inoltre, fare affidamento su un singolo parametro non è adeguato per prevedere con precisione lo stato di salute (SOH) o la vita utile residua (RUL) della batteria in condizioni di carica e scarica variabili, temperature ambientali fluttuanti e variazioni della tensione di scarica4. Sebbene il flusso di lavoro attuale sia stato principalmente validato utilizzando dataset di ciclaggio controllati in laboratorio, l'architettura multicanale e il framework di modellazione temporale potrebbero supportare futuri adattamenti a condizioni operative dinamiche riscontrate nelle applicazioni veicoli elettrici e in ambienti ambientali variabili.
Il degrado delle batterie è un processo elettrochimico altamente complesso e non lineare, determinato dalla crescita dell'interfase solido-elettrolita, dalla perdita di litio attivo e dal deterioramento strutturale dei materiali degli elettrodi. Storicamente, la stima dello stato si è basata su modelli a circuito equivalente o su equazioni differenziali parziali (PDE) elettrochimiche e fisiche5. Sebbene questi modelli fisici offrano preziose informazioni meccanicistiche, presentano notevoli oneri computazionali e difficoltà nell'identificazione dei parametri durante l'elaborazione di segnali accoppiati multicanale. Di conseguenza, la loro implementazione in tempo reale nei sistemi di gestione delle batterie (BMS) è fortemente limitata dalla complessità della cinetica di diffusione e dalla variabilità ambientale in condizioni di scarica ad alta velocità6. Al contrario, il flusso di lavoro basato sull'apprendimento profondo (DL) concentra la maggior parte del carico computazionale nella fase di addestramento offline, mentre il modello addestrato effettua inferenze relativamente rapide durante il funzionamento. Questo approccio potrebbe quindi supportare future implementazioni in BMS con risorse limitate e in ambienti di calcolo edge.
Recentemente, gli approcci basati sui dati del deep learning (DL) si sono affermati come potenti strumenti grazie alle loro eccezionali capacità di adattamento non lineare. Tuttavia, le attuali metodologie di DL presentano due limitazioni principali. In primo luogo, molti approcci si basano principalmente su singole curve di degrado della capacità o su specifiche soglie di tensione in scarica, trascurando le intrinseche correlazioni spaziotemporali tra le risposte cicliche multicanale, come tensione, corrente e temperatura. Questa limitazione riduce la robustezza del modello in scenari operativi multicondizione7. Studi precedenti hanno dimostrato che trascurare gli stati termici durante operazioni complesse può accelerare l'accumulo di errori predittivi8,9. In secondo luogo, nella machine learning (ML) applicata sussiste una persistente difficoltà di riproducibilità. Le variazioni nelle condizioni sperimentali, le procedure di preelaborazione descritte in modo insufficiente e i parametri iperparametrici della rete neurale scelti in modo arbitrario causano spesso il fallimento di modelli altrimenti robusti durante la validazione incrociata tra dataset10. Per ridurre il rischio di perdita di informazioni durante il preelaborazione e la previsione nei primi cicli, il flusso di lavoro proposto ricava i fattori di scala per la normalizzazione e le basi per le caratteristiche ingegnerizzate esclusivamente dai dataset di addestramento, prima della validazione esterna e della valutazione incrociata tra dataset.
Per affrontare queste lacune fondamentali, l'obiettivo generale di questo protocollo è presentare un flusso di lavoro basato sul deep learning (DL), automatizzato e altamente riproducibile, per la previsione delle prestazioni di accumulo energetico delle batterie agli ioni di litio mediante l'uso di dati di ciclaggio multicanale. La logica sottostante questo metodo consiste nell'acquisire esplicitamente le complesse dipendenze a lungo termine associate al degrado delle batterie, integrando dati multicanale di serie temporali all'interno di un'architettura di rete neurale ad alta dimensionalità. Un vantaggio chiave di questo protocollo rispetto agli approcci esistenti basati sulla fisica o sul DL è la sua standardizzazione olistica, che stabilisce una pipeline completa che comprende la pre-elaborazione dei segnali grezzi, l'ingegnerizzazione delle caratteristiche, l'addestramento del modello e la valutazione dell'incertezza. Sebbene architetture ibride di reti neurali siano state precedentemente studiate, il presente flusso di lavoro pone l'accento sull'integrazione standardizzata multicanale, allineando le variabili elettrochimiche di ciclaggio con caratteristiche ingegnerizzate di degrado all'interno di un framework di addestramento focalizzato sulla riproducibilità. A differenza di molti flussi di lavoro precedentemente descritti, questo protocollo incorpora configurazioni standardizzate di parametri, semi casuali fissi, esecuzioni ripetute della valutazione e un monitoraggio completo dell'ambiente al fine di migliorare la riproducibilità su dataset eterogenei di batterie e in diversi contesti di laboratorio. Inoltre, il flusso di lavoro confronta sistematicamente diverse architetture di reti neurali per valutare la stabilità predittiva e le prestazioni in diverse configurazioni di input. All'interno dei dataset valutati e delle impostazioni sperimentali, l'architettura rete neurale convoluzionale–memoria a breve termine lunga (CNN–LSTM) ha dimostrato prestazioni predittive favorevoli rispetto ai modelli CNN autonomi e basati su trasformatori valutati, combinando l'estrazione di caratteristiche locali con la modellizzazione di sequenze temporali a lungo raggio, mantenendo al contempo una complessità computazionale moderata. Questo protocollo è particolarmente adatto a ricercatori e ingegneri che intendono sviluppare modelli predittivi riproducibili e adattabili all'ambiente per la gestione del ciclo di vita delle batterie.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
L'approvazione etica da parte dell'istituto non è stata richiesta per questo studio perché la ricerca ha utilizzato esclusivamente set di dati pubblici sul ciclo delle batterie agli ioni di litio e non ha coinvolto partecipanti umani, soggetti animali o campioni biologici.
1. Acquisizione e organizzazione dei dati
- Ottenere dataset multicanale di cicli di carica
- Scaricare dataset di cicli di batterie agli ioni di litio da repository pubblici contenenti registrazioni di cicli di carica-scarica. Ottenere i dataset CALCE, SANYO, PANASONIC, KOKAM e GOTION direttamente dai rispettivi repository ad accesso aperto istituzionali o tramite link di identificatore di oggetto digitale per mantenere la coerenza della versione del dataset.
- Selezionare campioni di batterie che contengano il numero completo di cicli, misurazioni della capacità e almeno una curva continua di carica-scarica. Verificare la continuità confermando che non si verifichino interruzioni superiori a due ore all’interno di un singolo ciclo e che siano registrate completamente sia le fasi a corrente costante che a tensione costante.
- Filtrare i record grezzi dei cicli
- Filtrare i record grezzi dei cicli per conservare i campioni contenenti misurazioni di temperatura, resistenza interna, efficienza coulombica ed efficienza energetica. Escludere le celle di batteria che non dispongono di questi canali di stato obbligatori dal flusso di analisi, poiché la successiva fusione di caratteristiche multicanale richiede un insieme completo di variabili fisiche in ingresso.
- Rimuovere i cicli contenenti record incompleti, timestamp inconsistenti, procedure di test non definite o condizioni di terminazione della carica-scarica non chiare. Definire cicli anomali quelli che mostrano brusche riduzioni di capacità superiori al 5% tra cicli adiacenti, misurazioni di tensione al di fuori del range operativo specifico per la chimica o intervalli di timestamp non monotoni.
- Costruire un database temporale della batteria
- Organizzare cronologicamente i record di cicli conservati per costruire un database temporale a livello di batteria.
- Memorizzare i dataset elaborati utilizzando il formato dati gerarchico versione 5 (HDF5). Mantenere una struttura di directory standardizzata organizzata per fonte del dataset, sistema chimico e identificativo individuale della cella della batteria.
- Assegnare identificatori univoci alle singole celle della batteria prima della suddivisione del dataset. Implementare il raggruppamento basato sull’identificativo della cella della batteria durante la suddivisione in training e test per garantire che tutti i cicli sequenziali di una singola batteria fisica rimangano esclusivamente all’interno di un singolo sottoinsieme del dataset.
NOTA: Conservare separatamente i dataset grezzi originali prima della pre-elaborazione, normalizzazione, ricampionamento o ingegnerizzazione delle caratteristiche.
- Definire finestre di osservazione
- Costruire finestre di osservazione multicanale utilizzando i primi 50 cicli, i primi 100 cicli e i primi il 20% della vita totale della batteria. Calcolare la soglia del 20% della vita utile moltiplicando la vita totale in cicli prima del degrado di capacità a fine vita per 0,2.
- Allineare le misurazioni di tensione, corrente, capacità, temperatura, resistenza interna ed efficienza all’interno di ciascuna finestra di osservazione prima della costruzione del tensore.
- Formattare la struttura finale di ingresso come un tensore tridimensionale costituito dalla lunghezza della finestra di osservazione, 128 punti di campionamento standardizzati all’interno del ciclo e l’insieme ordinato di caratteristiche multicanale.
2. Preelaborazione dei dati e ingegneria delle caratteristiche
- Preelaborare i dati grezzi dei cicli
- Eseguire una preelaborazione uniforme sui dataset grezzi dei cicli per standardizzare la qualità dei dati provenienti da tutte le fonti di batterie. Eseguire tutte le procedure di preelaborazione, sincronizzazione e standardizzazione utilizzando Python 3.10 con la libreria Pandas per la manipolazione delle serie temporali e SciPy per l'interpolazione numerica.
- Rimuovere gli outlier, rilevare i valori mancanti, calibrare i timestamp, identificare le fasi di carica e scarica e normalizzare le frequenze di campionamento prima dell'analisi successiva. Applicare un metodo di sogliatura basato sul punteggio Z modificato con un criterio di scarto superiore a 3,0 per il rilevamento di anomalie.
- Rilevare automaticamente i valori mancanti mediante l'identificazione del flag NaN in tutti gli array numerici. Distinguere le fasi di carica e scarica in base alla polarità della corrente, assegnando valori di corrente positivi ai cicli di carica e valori negativi ai cicli di scarica.
- Ricostruire i segmenti del segnale mancanti utilizzando polinomi interpolanti cubici di Hermite a tratti per preservare la dinamica elettrochimica temporale durante l'allineamento delle transizioni di fase.
- Ricampionare le curve di ciclo
- Ricampionare le curve di ciclo quando vengono rilevate variazioni nella densità di campionamento o deriva del segnale tra i diversi dataset. Attivare automaticamente il ricampionamento ogni volta che l'intervallo tra misurazioni consecutive si discosta di oltre il 10% rispetto alla frequenza mediana di campionamento della fase di ciclo corrispondente.
- Standardizzare il numero di punti di campionamento all'interno di ogni ciclo per ridurre le variazioni legate alla piattaforma di registrazione. Riportare tutte le sequenze temporali su una griglia spaziale fissa mediante interpolazione lineare unidimensionale.
- Comprimere o espandere ogni profilo di carica-scarica in esattamente 128 punti di campionamento equidistanti prima della costruzione del tensore.
- Normalizzare le variabili continue
- Normalizzare tutte le variabili continue prima dell'addestramento del modello per stabilizzare la convergenza della rete e ridurre i bias legati alla scala. Applicare la scalatura Min-Max per trasformare tutte le variabili continue in un intervallo numerico compreso tra 0 e 1.
- Calcolare tutti i parametri di normalizzazione esclusivamente a partire dal dataset di addestramento. Applicare i parametri di scalatura congelati ai dataset di validazione e di test per ridurre il rischio di perdita anticipata di informazioni temporali durante la previsione dei cicli iniziali.
- Costruire tensori di input multicanale
- Dividere i record continui dei cicli di ogni batteria in segmenti temporali di lunghezza fissa. Strutturare i segmenti temporali in base alle finestre di osservazione predefinite corrispondenti ai primi 50 cicli, ai primi 100 cicli o al primo 20% del ciclo di vita della batteria.
- Allineare le misurazioni di tensione, corrente, capacità, temperatura, resistenza interna ed efficienza all'interno di ogni segmento temporale prima della costruzione del tensore.
- Concatenare le matrici di caratteristiche allineate in un tensore tridimensionale nel formato (N × 128 × C), dove N rappresenta la lunghezza della finestra di osservazione, 128 indica i punti di campionamento intra-ciclo standardizzati e C rappresenta il numero totale di canali di caratteristiche fisiche e ingegnerizzate.
- Estrarre caratteristiche ingegnerizzate
- Estrarre caratteristiche elettrochimiche ingegnerizzate dai segnali grezzi dei cicli per migliorare l'identificazione dei modelli di degrado. Calcolare le caratteristiche di capacità incrementale e di tensione differenziale computando dQ/dV e dV/dQ sulla griglia di campionamento standardizzata.
- Applicare il filtro di Savitzky–Golay per generare curve di capacità incrementale e tensione differenziale smussate.
- Estrarre indicatori di degrado, inclusi spostamenti del picco di tensione, differenze di tensione nelle transizioni di fase e variazioni del rendimento energetico da ciclo a ciclo, dalle caratteristiche elettrochimiche filtrate.
3. Costruzione e addestramento del modello DL
- Costruire modelli predittivi candidati
- Costruire un framework standardizzato per l'addestramento e la valutazione di tutti i modelli predittivi mostrati in Figura 1A. Implementare il flusso di lavoro DL utilizzando PyTorch versione 2.0 o superiore.
- Eseguire il flusso di lavoro di addestramento mediante script Python modulari per il caricamento dei dati, l'inizializzazione del modello, l'ottimizzazione e la valutazione.
- Preparare modelli di riferimento ML tradizionali, inclusi modelli di regressione lineare, foresta casuale e alberi decisionali con boosting del gradiente. Configurare il modello di foresta casuale con 100 alberi e una profondità massima di 10.
- Configurare il framework degli alberi decisionali con boosting del gradiente utilizzando una velocità di apprendimento di 0,1 e una profondità massima dell'albero di 5 attraverso la libreria Scikit-learn.
- Preparare architetture DL candidate, tra cui percettrone multistrato, CNN unidimensionale, rete LSTM, CNN–LSTM e modelli basati su transformer.
- Standardizzare gli iperparametri principali per tutte le architetture DL applicando l'ottimizzatore AdamW, funzioni di attivazione Gaussian Error Linear Unit, una dimensione nascosta di 128 e una percentuale di dropout dello 0,2.
- Configurare l'architettura CNN–LSTM
- Configurare l'architettura CNN–LSTM per fondere informazioni multicanale sui cicli provenienti dai tensori in ingresso (Figura 1B). Costruire l'architettura ibrida collegando in cascata l'estrazione delle caratteristiche convoluzionali a due livelli ricorrenti sovrapposti, ciascuno contenente 128 unità nascoste.
- Terminare l'architettura con tre testate di regressione completamente connesse e parallele per la predizione simultanea di SOH, RUL e energia scaricabile.
- Elaborare i tensori di ingresso multicanale attraverso tre livelli convoluzionali unidimensionali consecutivi con dimensioni del kernel di 3, 5 e 7 per estrarre caratteristiche localizzate a diverse scale.
- Applicare la normalizzazione del batch dopo ogni livello convoluzionale per migliorare la stabilità del gradiente durante l'ottimizzazione.
- Riordinare le mappe delle caratteristiche convoluzionali in sequenze temporali continue prima della modellazione sequenziale.
- Alimentare le sequenze temporali codificate nei livelli ricorrenti sovrapposti per catturare dipendenze di degrado a lungo raggio all'interno delle finestre di osservazione predefinite.
- Partizionare i dataset per l'addestramento del modello
- Dividere i dataset di celle batteria elaborati in sottoinsiemi di addestramento, validazione e test utilizzando un rapporto 70:15:15. Eseguire la suddivisione del dataset utilizzando un valore fisso di seme casuale pari a 42.
- Applicare un campionamento stratificato basato sulla chimica della batteria per mantenere distribuzioni di degrado bilanciate in tutti i sottoinsiemi del dataset.
- Eseguire la partizione del dataset esclusivamente a livello di cella batteria, piuttosto che randomizzando cicli individuali, per preservare le traiettorie sequenziali di degrado.
- Mantenere ogni cella batteria come unità indivisibile durante la partizione, per evitare perdite di informazioni tra i dataset.
- Verificare programmaticamente l'isolamento dei dataset calcolando l'intersezione degli identificatori delle celle batteria tra i sottoinsiemi di addestramento, validazione e test e confermando l'assenza di sovrapposizioni.
- Compilare un dataset di test esterno utilizzando il dataset completo GOTION di litio ferro fosfato (LFP) per la valutazione fuori distribuzione e la valutazione della generalizzazione incrociata tra dataset.
- Rendere disponibili pubblicamente il codice sorgente, i file di configurazione dell'ambiente e le partizioni del dataset elaborato attraverso un'apposita repository GitHub per supportare la trasparenza metodologica e la riproducibilità.
- Inizializzare l'addestramento del modello
- Impostare la funzione di perdita per la regressione come errore quadratico medio prima dell'addestramento. Calcolare l'obiettivo globale di addestramento aggregando i valori di perdita da ciascuna variabile predittiva utilizzando pesi uguali.
- Impostare la velocità di apprendimento iniziale a 1 × 10⁻³ e scegliere una dimensione del batch pari a 32 o 64 in base alle dimensioni del dataset.
- Utilizzare una dimensione del batch di 64 per dataset contenenti più di 5.000 cicli per migliorare l'utilizzo dell'hardware. Utilizzare una dimensione del batch di 32 per dataset più piccoli per migliorare la stabilità dell'ottimizzazione.
NOTA: Selezionare questi iperparametri mediante una valutazione preliminare di ricerca su griglia per bilanciare velocità di convergenza e stabilità del gradiente attraverso diverse finestre di osservazione.
- Applicare controlli durante l'addestramento
- Applicare un programma dinamico di aggiustamento della velocità di apprendimento basato sulle variazioni della perdita di validazione. Ridurre la velocità di apprendimento di un fattore 0,5 se la perdita di validazione non migliora per 5 epoche consecutive.
- Mantenere una soglia minima della velocità di apprendimento di 1 × 10⁻⁵ durante l'ottimizzazione.
- Interrompere l'addestramento del modello dopo un massimo di 100 epoche per ridurre l'overfitting.
- Applicare l'arresto anticipato se la perdita di validazione non diminuisce per 15 epoche consecutive. Ripristinare i pesi del modello corrispondenti all'iterazione di validazione con le prestazioni migliori.
- Mantenere registrazioni per la riproducibilità
- Impostare un valore fisso di seme casuale pari a 42 prima dell'inizializzazione e dell'addestramento del modello.
- Applicare il seme casuale fisso in modo coerente nei moduli random di Python, NumPy e nel backend di PyTorch, disabilitando contemporaneamente le operazioni CUDA non deterministiche.
- Registrare l'ambiente software, le versioni delle dipendenze, le impostazioni dei parametri, le partizioni dei dati e gli output di addestramento per ogni esecuzione sperimentale.
- Eseguire tutti i flussi di lavoro DL utilizzando Ubuntu 22.04 con accelerazione CUDA 11.8 su una workstation dotata di una GPU NVIDIA RTX 3090 o hardware equivalente.
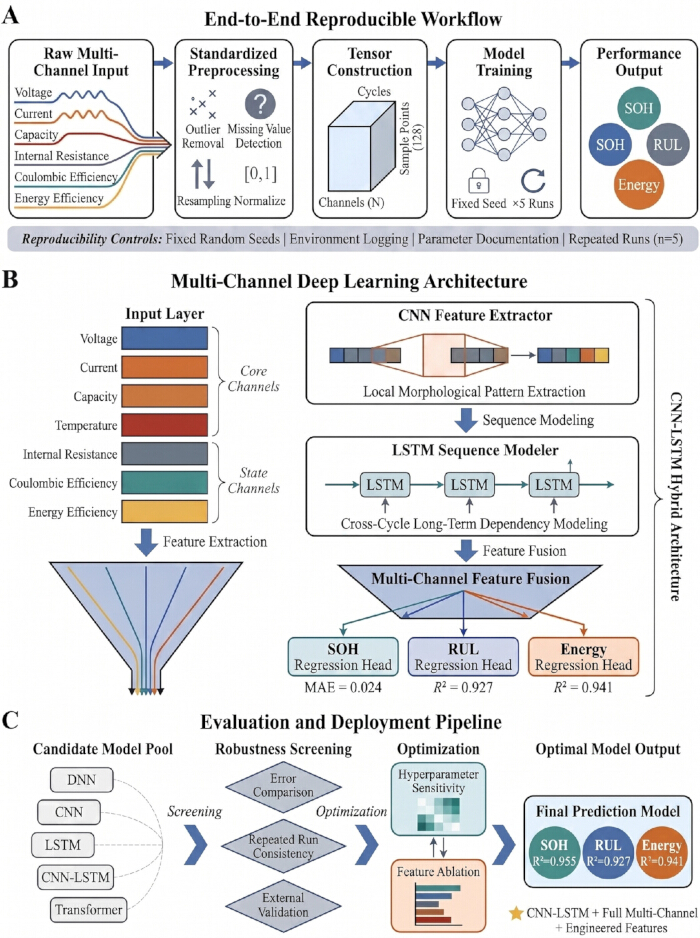
Figura 1. Flusso di lavoro riproducibile di apprendimento profondo (DL) per la previsione delle prestazioni delle batterie al litio multicanale. (A) Flusso di lavoro riproducibile end-to-end che illustra l'acquisizione dei dati multicanale, la pre-elaborazione standardizzata, la costruzione di tensori, l'addestramento del modello e la previsione degli indicatori di prestazione della batteria. I controlli di riproducibilità includono l'uso di semi casuali fissi, ripetizioni multiple dell'addestramento, il tracciamento dei parametri e la registrazione dell'ambiente. (B) Architettura ibrida CNN–LSTM utilizzata per l'estrazione di caratteristiche multicanale, la modellazione di sequenze temporali, la fusione delle caratteristiche e la previsione dello stato di salute (SOH), della vita utile residua (RUL) e dell'energia scaricabile. (C) Pipeline di valutazione e implementazione che mostra la selezione iniziale dei modelli candidati, la valutazione della robustezza, l'ottimizzazione degli iperparametri e la selezione finale del modello. Cliccare qui per visualizzare una versione ingrandita di questa figura.
4. Valutazione del modello e previsione del target
- Generare le previsioni del modello
- Elaborare i dataset di prova della batteria di test attraverso ciascun modello addestrato. Caricare i dataset di prova preelaborati come tensori serializzati di PyTorch prima dell'inferenza.
- Eseguire il passaggio di inferenza in avanti utilizzando un gestore di contesto che disabilita i gradienti per evitare aggiornamenti indesiderati dei parametri durante la valutazione.
- Generare previsioni simultanee per ciascun indicatore di prestazione utilizzando i moduli di regressione addestrati.
- Estrarre in uscita simultaneamente i risultati dai tre moduli di regressione paralleli configurati per la previsione di SOH, RUL e energia scaricabile.
- Calcolare i valori effettivi da prevedere
- Calcolare lo stato di salute (SOH) confrontando la capacità disponibile attuale con la capacità iniziale della batteria.
- Definire la capacità iniziale della batteria come la massima capacità di scarica registrata durante i primi tre cicli di stabilizzazione.
- Calcolare il SOH come rapporto tra la capacità del ciclo attuale e la capacità iniziale di riferimento stabilita.
- Stimare la vita utile residua (RUL) identificando la soglia operativa al di sotto della quale la capacità della batteria cessa di essere stabile.
- Definire la fine della vita (end of life) come il numero di ciclo al quale la capacità della batteria diminuisce irreversibilmente al di sotto dell'80% della capacità nominale.
- Calcolare il RUL come il numero di cicli rimanenti dal punto di osservazione corrente fino alla soglia di fine vita definita.
- Prevedere l'energia scaricabile a partire dalle condizioni di scarica registrate.
- Calcolare il valore reale di riferimento dell'energia scaricabile integrando numericamente il prodotto tra tensione di scarica e corrente di scarica sull'intervallo di scarica, utilizzando il metodo di integrazione trapezoidale.
- Valutare le prestazioni predittive
- Calcolare l'errore assoluto medio (MAE), l'errore quadratico medio (RMSE), l'errore percentuale assoluto medio (MAPE) e il coefficiente di determinazione (R2) per ciascun valore da prevedere.
- Calcolare tutte le metriche di valutazione utilizzando il modulo di metriche di Scikit-learn con formulazioni statistiche standardizzate.
- Applicare calcoli identici per ciascuna metrica a tutti i modelli, dataset e configurazioni di ingresso per mantenere la coerenza della valutazione.
- Raggruppare tutte le metriche di prestazione sui campioni di batterie aggregati all'interno del dataset di test indipendente per valutare la generalizzazione complessiva del modello.
- Segnalare le prestazioni stratificate
- Calcolare la media e la deviazione standard per ciascuna metrica di valutazione su ripetute esecuzioni sperimentali.
- Derivare le misure statistiche riportate da cinque inizializzazioni indipendenti del modello.
- Indicare gli intervalli di confidenza al 95% insieme alle metriche medie di prestazione per quantificare l'incertezza predittiva.
- Confrontare le prestazioni del modello in base a diverse lunghezze della finestra di osservazione e configurazioni dei canali di ingresso.
- Stratificare l'analisi comparativa utilizzando finestre di osservazione corrispondenti a 50 cicli, 100 cicli e 200 cicli.
- Valutare le prestazioni predittive in diverse configurazioni di ingresso, che vanno da ingressi basati esclusivamente sulla capacità fino all'integrazione completa di tensori multicanale. Fare riferimento a Figura 1C per il flusso di lavoro di valutazione, screening di robustezza e selezione per l'implementazione.
5. Analisi di Riproducibilità, Robustezza e Sensibilità
- Verificare la riproducibilità e la robustezza
- Mantenere partizioni identiche dei dati, flussi di lavoro di pre-elaborazione e procedure sperimentali in tutte le valutazioni di riproducibilità mostrate in Figura 2A.
- Calcolare il coefficiente di variazione delle metriche principali di valutazione ripetendo le prove per valutare la coerenza della riproducibilità.
- Ripetere tutte le procedure di valutazione utilizzando lo stesso flusso di lavoro standardizzato per l'addestramento e il test.
- Inizializzare ogni valutazione ripetuta con pesi di rete randomizzati, mantenendo però procedure deterministiche di caricamento e mescolamento dei dati.
- Eseguire esperimenti ripetuti di addestramento
- Addestrare ripetutamente i modelli predittivi in condizioni sperimentali identiche, utilizzando valori predefiniti fissi del seme casuale per garantire un'inizializzazione riproducibile dei pesi.
- Eseguire cinque cicli indipendenti di addestramento utilizzando partizioni identiche del dataset per ridurre la variabilità legata ai dati.
- Calcolare le metriche finali di prestazione facendo la media delle metriche di valutazione ottenute dai cinque cicli ripetuti di addestramento.
- Aggregare le metriche finali di robustezza utilizzando i punteggi medi di valutazione, piuttosto che combinando i tensori grezzi delle predizioni.
- Valutare la sensibilità agli iperparametri
- Modificare singolarmente il tasso di apprendimento, la dimensione del batch, la dimensione del layer nascosto e il rapporto di dropout durante l'analisi di sensibilità.
- Valutare tassi di apprendimento compresi tra 1 × 10⁻⁴ e 1 × 10⁻², dimensioni del batch comprese tra 32 e 128, dimensioni nascoste comprese tra 32 e 256 e rapporti di dropout compresi tra 0,1 e 0,5.
- Registrare i corrispondenti cambiamenti nell'accuratezza predittiva dopo ogni modifica degli iperparametri.
- Quantificare la variazione delle prestazioni predittive utilizzando RMSE e R2.
- Eseguire l'analisi di ablazione delle caratteristiche
- Rimuovere canali di input selezionati, tra cui temperatura, resistenza interna e vettori di caratteristiche progettate, dal flusso di input multicanale.
- Eseguire l'ablazione delle caratteristiche utilizzando una strategia leave-one-out, rimuovendo un gruppo di caratteristiche alla volta, mantenendo inalterata la struttura multicanale residua dell'input.
- Confrontare le prestazioni predittive risultanti dopo ogni esperimento di rimozione delle caratteristiche per valutare il contributo di ciascun gruppo di caratteristiche alla stabilità e all'accuratezza del modello.
- Quantificare il contributo relativo di ciascun gruppo di caratteristiche calcolando l'aumento percentuale dell'errore assoluto medio rispetto al modello di riferimento multicanale completamente integrato. Fare riferimento a Figura 2B per il flusso di lavoro di valutazione della robustezza e di analisi della sensibilità.
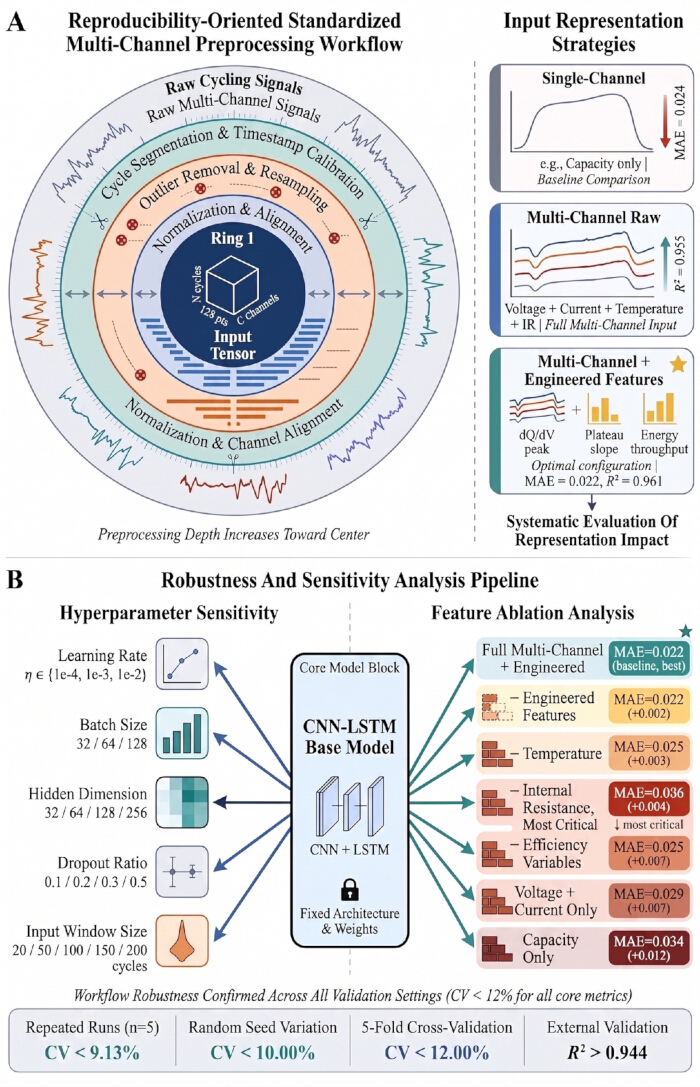
Figura 2. Flusso di lavoro standardizzato di pre-elaborazione, valutazione della robustezza e analisi della sensibilità. (A) Flusso di lavoro standardizzato di pre-elaborazione multicanale che illustra l'elaborazione del segnale ciclico grezzo, la calibrazione dei timestamp, la rimozione degli outlier, il ricampionamento, la normalizzazione, l'allineamento dei canali e la costruzione del tensore. Le strategie di rappresentazione dell'input confrontano input a singolo canale, input multicanale grezzi e input multicanale combinati con caratteristiche ingegnerizzate. (B) Pipeline di analisi della robustezza e della sensibilità che mostra la perturbazione sistematica degli iperparametri, la valutazione mediante esecuzioni ripetute, l'analisi di ablazione delle caratteristiche, la validazione incrociata e la validazione esterna del flusso di lavoro CNN-LSTM. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Segnali Multicanale di Ciclismo e Distribuzione dei Dati
I segnali rappresentativi del ciclo multicanale e le distribuzioni di prestazione sono stati analizzati per caratterizzare il comportamento di risposta al ciclo delle batterie agli ioni di litio. Lo studio ha utilizzato cinque dataset di batterie agli ioni di litio rappresentanti diversi sistemi chimici, inclusi l'ossido di litio e cobalto (LCO), l'ossido di nichel, cobalto e alluminio (NCA), l'ossido di nichel, manganes...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Il flusso di lavoro DL riproducibile descritto in questo protocollo ha dimostrato una previsione accurata delle prestazioni delle batterie agli ioni di litio utilizzando dati di ciclaggio multicanale. Il flusso di lavoro ha raggiunto un errore medio assoluto (MAE) di 0,024 e un valore di R2 pari a 0,955 per la stima dello stato di salute (SOH) nelle condizioni sperimentali valutate, sostenendo la sua potenziale utilità per la gestione del ciclo di vita delle batterie e per applicazioni di monitoraggio dell'acc...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto né conflitti di interesse.
Ringraziamenti
Gli autori ringraziano il sostegno istituzionale fornito dal Dipartimento di Fisica della Southern University of Science and Technology e dal Homerton College dell'Università di Cambridge, che hanno messo a disposizione l'ambiente accademico e le risorse computazionali necessarie per questa ricerca. Gli autori ringraziano inoltre le istituzioni di ricerca e i collaboratori che hanno reso disponibili pubblicamente i dataset open-access sulle batterie agli ioni di litio, inclusi CALCE, SANYO, PANASONIC, KOKAM e GOTION, consentendo così questa analisi multicanale completa.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Dati della batteria CALCE | Centro per l'Ingegneria del Ciclo di Vita Avanzata (CALCE), Università del Maryland | https://calce.umd.edu/battery-data | Fonte di dati multicanale sul ciclo di vita delle batterie agli ioni di litio per l'addestramento e la validazione del modello |
| CUDA Toolkit | NVIDIA | Versione 11.8 | Accelerazione GPU per l'addestramento del modello di apprendimento profondo |
| Dati GOTION IFP20100140A | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Validazione esterna e analisi della degradazione della batteria multicanale |
| Dati KOKAM SLPB533459H4 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Modellazione e validazione della degradazione della batteria multicanale |
| Matplotlib | Squadra di sviluppo di Matplotlib | Versione 3.7.1 | Visualizzazione delle prestazioni del modello, analisi della sensibilità e risultati di riproducibilità |
| NumPy | Sviluppatori di NumPy | Versione 1.24.3 | Calcolo numerico e costruzione di tensori |
| Dati PANASONIC NCR18650BD | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Fonte di dati ciclici multicanale ed estrazione di caratteristiche progettate |
| Pandas | Sviluppatori di Pandas | Versione 2.0.3 | Organizzazione dei dati, preelaborazione e gestione di dati tabulari |
| PyTorch | Fondazione PyTorch | Versione 2.0.1 | Costruzione e addestramento di architetture di apprendimento profondo, inclusi modelli CNN–LSTM |
| Python | Fondazione Software Python | Versione 3.10.12 | Preelaborazione dei dati, ingegnerizzazione delle caratteristiche, addestramento e valutazione del modello |
| Dati SANYO UR18650E | Archivio Dati Prognostici NASA | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Fonte di dati ciclici multicanale per la valutazione della riproducibilità e la validazione del modello |
| Scikit-learn | Sviluppatori di Scikit-learn | Versione 1.2.2 | Implementazione del modello di riferimento, partizionamento del dataset e calcolo delle metriche di prestazione |
Riferimenti
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.