Il framework proposto MSCNN-LSTM integra l'estrazione di caratteristiche spaziali multiscala con la modellazione di sequenze temporali per il riconoscimento di azioni nei video sportivi, catturando caratteristiche spaziali finemente dettagliate e modelli di movimento temporali, raggiungendo al contempo prestazioni competitive nella classificazione su dataset di riferimento per azioni sportive.
Articolo di ricerca
Riconoscimento delle azioni in video sportivi mediante reti convoluzionali multiscala con modellazione temporale basata su Long Short-Term Memory (LSTM)
In questo articolo
Sommario
Abstract
Il riconoscimento di azioni nei video sportivi rimane una sfida a causa della complessa dinamica del movimento, delle occlusioni e dell'elevata variabilità intra-classe. Sebbene gli attuali approcci basati sul deep learning, inclusi modelli CNN-BiLSTM e basati sul trasferimento dell'apprendimento, abbiano dimostrato efficacia nel riconoscimento delle attività umane, le loro prestazioni possono risultare limitate in scenari sportivi caratterizzati da movimenti rapidi e diversificati. Molti metodi esistenti si basano su filtri convoluzionali a singola scala, che potrebbero non catturare efficacemente sia le caratteristiche di movimento fini sia quelle grossolane simultaneamente. Per affrontare questa limitazione, questo studio propone una rete neurale convoluzionale a multi-scala (MSCNN) integrata con una rete Long Short-Term Memory (LSTM) per il riconoscimento di azioni nei video sportivi. L'MSCNN estrae rappresentazioni spaziali a partire da diversi campi recettivi attraverso kernel convoluzionali in parallelo, consentendo l'apprendimento di caratteristiche di movimento dettagliate e contestuali. Queste caratteristiche vengono successivamente elaborate dall'LSTM per catturare le dipendenze temporali e la continuità del movimento tra frame consecutivi. La valutazione sperimentale è stata condotta sui dataset di riferimento UCF11, UCF Sports e JHMDB. Il modello MSCNN-LSTM proposto ha raggiunto accuratezze di classificazione rispettivamente del 98,3%, 95,4% e 81,7%, superando gli approcci comparativi valutati in questo studio. Uno studio di ablazione ha ulteriormente dimostrato il contributo dell'estrazione di caratteristiche a multi-scala e della modellazione temporale alle prestazioni complessive. Questi risultati evidenziano il potenziale del framework proposto nell'unire informazioni spaziali e temporali per il riconoscimento di azioni nei video sportivi.
Introduzione
Il riconoscimento delle attività umane ha ampie applicazioni in vari ambiti del mondo reale, tra cui la sorveglianza intelligente, il rilevamento di anomalie, il recupero audiovisivo basato sull'azione e il monitoraggio dei pazienti in ambito sanitario1,2. Il riconoscimento di azioni, in particolare nei flussi video provenienti da sistemi di sorveglianza e piattaforme di social media, ha un potenziale significativo per il rilevamento di anomalie e la comprensione degli eventi3. Le azioni umane vengono identificate nell'analisi video osservando diverse parti del corpo, come mani e gambe. A differenza delle immagini statiche, un singolo fotogramma spesso non è sufficiente per rappresentare un'azione4. Ad esempio, la posa iniziale di attività come il calcio e il salto della corda può apparire simile in un singolo fotogramma. Le differenze tra queste azioni diventano evidenti quando vengono osservate attraverso una sequenza di fotogrammi che catturano i modelli di movimento e le interazioni del corpo umano con l'ambiente circostante5,6,7. Le abbreviazioni utilizzate in tutto il manoscritto sono riassunte nella Tabella 1 per migliorare la leggibilità e garantire coerenza nella terminologia.
| Abbreviazione | Forma Completa |
| AI | Intelligenza Artificiale |
| AUC | Area Sottesa alla Curva |
| BiLSTM | Memoria a Lungo e Breve Termine Bidirezionale |
| CNN | Rete Neurale Convoluzionale |
| CUDA | Architettura Unificata per Dispositivi di Calcolo |
| F1-score | Media Armonica tra Precisione e Richiamo |
| GPU | Unità di Elaborazione Grafica |
| HAR | Riconoscimento dell'Attività Umana |
| JHMDB | Base di Dati sul Moto Umano Congiunto |
| LSTM | Memoria a Lungo e Breve Termine |
| mAP-T | Precisione Media Temporale |
| MCC | Coefficiente di Correlazione di Matthews |
| MSCNN | Rete Neurale Convoluzionale Multiscala |
| ROC | Caratteristica Operativa del Ricevitore |
| TSI | Indice di Stabilità Temporale |
| UCF | Università della Florida Centrale |
| VRAM | Memoria ad Accesso Casuale per Video |
Tabella 1: Elenco di abbreviazioni utilizzate nel manoscritto. Abbreviazioni e acronimi comuni utilizzati nell'intero studio e le relative forme estese.
Una classificazione rapida e accurata dei video sportivi è importante per un'ampia gamma di applicazioni8,9,10, tra cui l'analisi sportiva, il rilevamento di eventi, il recupero basato sui contenuti e i sistemi di raccomandazione11,12,13. Con la rapida crescita dei contenuti video legati allo sport, i limiti dei precedenti framework analitici sono diventati sempre più evidenti14. Di conseguenza, esiste una crescente richiesta di approcci robusti in grado di affrontare la complessità e la natura dinamica delle attività sportive. I metodi tradizionali di classificazione dei video sportivi si sono basati principalmente su descrittori progettati manualmente, come il flusso ottico e l'istogramma dei gradienti orientati (HOG), per caratterizzare i modelli di movimento e le attività nei video sportivi15.
Le ConvNets, che hanno ottenuto notevoli successi nella classificazione di immagini statiche, sono state applicate anche all'analisi video. Tuttavia, il riconoscimento di azioni rimane più complesso poiché i video contengono informazioni spaziotemporali dinamiche. Gli attuali approcci basati sul deep learning possono generalmente essere suddivisi in tre categorie: reti a due flussi16, reti convoluzionali 3D e architetture computazionalmente efficienti. Per apprendere informazioni temporali dal flusso ottico, le reti a due flussi utilizzano una ConvNet aggiuntiva17,18, anche se questo approccio è oneroso dal punto di vista computazionale. Mentre architetture convoluzionali 3D come C3D, I3D e R3D possono modellare direttamente le informazioni temporali, esse aumentano sostanzialmente il numero di parametri, rendendo l'ottimizzazione più complessa. I metodi computazionalmente efficienti cercano di ridurre la complessità del modello esplorando operazioni 3D scomposte.
Inoltre, poiché le CNN possono estrarre caratteristiche spaziali locali e gli LSTM possono catturare informazioni contestuali temporali, i modelli ibridi possono apprendere efficacemente modelli di movimento spaziotemporali dai segnali provenienti dai sensori. Studi recenti che combinano architetture CNN e reti neurali ricorrenti hanno prodotto risultati incoraggianti18,19,20. Tuttavia, poiché gli LSTM comprimono le informazioni durante l'elaborazione delle sequenze, il rumore introdotto durante l'estrazione delle caratteristiche può influire sulle prestazioni di riconoscimento. Per affrontare questo problema, diversi studi hanno integrato meccanismi di attenzione21,22. I meccanismi di attenzione consentono al modello di concentrarsi sulle caratteristiche più rilevanti per il compito di riconoscimento, migliorando così le prestazioni di classificazione.
Sebbene i modelli LSTM bidirezionali profondi combinati con l'estrazione di caratteristiche basata su CNN abbiano ottenuto risultati promettenti per il riconoscimento dell'attività umana, permangono diverse sfide nell'estendere questi framework al riconoscimento di azioni nei video sportivi. In primo luogo, le attuali architetture CNN-LSTM spesso utilizzano un'estrazione di caratteristiche convoluzionali a singola scala, il che potrebbe limitare la loro capacità di catturare azioni che si verificano a diverse risoluzioni spaziali e temporali, come il movimento simultaneo di giocatori e oggetti nelle scene sportive. Le reti convoluzionali multi-scala, tra cui le CNN 3D23 e le CNN a due flussi, hanno dimostrato l'importanza di rilevare indizi spaziali e di movimento a scale diverse, anche se questo concetto è stato meno esplorato nei sistemi ibridi basati su LSTM. In secondo luogo, la maggior parte dei precedenti modelli CNN-BiLSTM24 si concentra principalmente sulle dipendenze temporali a breve termine, mentre la continuità del movimento su lungo raggio e le interazioni tra oggetti comuni negli sport di squadra potrebbero non essere adeguatamente rappresentate. Molti approcci basati sul trasferimento di apprendimento, come MobileNetV2 e ResNet, si affidano a caratteristiche di fotogrammi statici e non sfruttano appieno meccanismi di attenzione temporale o la fusione adattativa di caratteristiche multi-scala25. Inoltre, la maggior parte dei modelli esistenti è stata valutata principalmente su dataset di riferimento come UCF11 e JHMDB. Dataset più recenti specifici per lo sport, che catturano complessi movimenti della telecamera e schemi di attività, come SoccerNet e FineGym, rimangono poco esplorati. Queste limitazioni evidenziano la necessità di un framework di estrazione di caratteristiche convoluzionali multi-scala integrato con moduli di memoria temporale, come reti LSTM o BiLSTM, per catturare in modo più efficace sia rappresentazioni spaziali dettagliate sia dipendenze temporali su lungo raggio nel riconoscimento di azioni nei video sportivi.
Inoltre, le CNN possono estrarre caratteristiche spaziali locali, mentre le LSTM possono modellare il contesto temporale. Di conseguenza, architetture ibride CNN-RNN hanno dimostrato prestazioni promettenti nel riconoscimento delle attività umane26,27. Studi recenti hanno esteso i tradizionali framework CNN-LSTM integrando strategie di apprendimento complementari per migliorare il riconoscimento delle attività umane. Ad esempio, sono stati introdotti meccanismi di attenzione per enfatizzare le caratteristiche rilevanti per il compito e sopprimere rappresentazioni meno informative, migliorando così le prestazioni di riconoscimento28. Altri approcci hanno adottato l'apprendimento multi-task per ottimizzare congiuntamente il riconoscimento delle azioni e i compiti di segmentazione temporale, aumentando l'efficienza dell'apprendimento e la rappresentazione delle caratteristiche29. Nonostante questi progressi, i metodi esistenti potrebbero ancora avere una capacità limitata di distinguere azioni visivamente simili, poiché le caratteristiche spaziali e temporali finemente dettagliate non vengono sempre catturate in modo efficace. Tabella 2 riassume i punti di forza e le limitazioni degli approcci esistenti30.
| Riferimento / Anno | Metodo utilizzato | Dataset | Metriche di prestazione | Punti di forza principali | Limitazioni |
| Hassan et al. (2024)1 | KFDI (Immagine Dinamica dei Frame Chiave) | UCF11 | Accuratezza: 85,3% | Selezione efficiente dei frame chiave e rappresentazione migliorata dell'immagine dinamica. | Sensibile agli errori nella selezione dei frame; modellazione temporale limitata. |
| Zhou et al. (2023)24 | CNN dilatata + BiLSTM + Blocco residuo | UCF11, UCF Sports | Accuratezza: UCF11: 89% e UCF Sports: 92,2% | Integra apprendimento spaziale e temporale; cattura informazioni multi-scala. | Elevato costo computazionale; rischio di overfitting su dataset ridotti. |
| Ullah et al. (2025)34 | Caratteristiche locale-globale + QSVM | UCF11 | Accuratezza: 82,6% | Combina caratteristiche progettate manualmente e caratteristiche profonde per un riconoscimento robusto. | Richiede taratura manuale; scalabilità limitata. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 e JHMDB | Accuratezza: UCF11: 97,73%; UCF50: 98,81%; UCF101: 98,46%; JHMDB: 83,38% | Cattura dipendenze spaziali e temporali a lungo raggio. | Elevato costo computazionale e richieste di dati. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Accuratezza: 85,1% | Apprendimento end-to-end delle caratteristiche spaziotemporali. | Elevati requisiti di memoria e GPU. |
| Karuppannan et al. (2024)35 | Autoencoder profondo + CNN | UCF11 | Accuratezza: 96,2% | Apprende rappresentazioni compatte delle caratteristiche. | Modellazione temporale a lungo termine limitata. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101 e HMDB51 | Accuratezza: KTH: 97,67%; UCF Sports: 95,00%; JHMDB: 73,13%; UCF101: 92,97%; HMDB51: 69,74% | Apprendimento temporale efficace basato sulla profondità. | Richiede una stima accurata della profondità e un'ampia pre-elaborazione. |
Tabella 2: Confronto tra i metodi esistenti di apprendimento profondo per il riconoscimento di azioni nei video sportivi. Sintesi degli approcci rappresentativi di apprendimento profondo, inclusi dataset, caratteristiche metodologiche, vantaggi e limitazioni, con evidenziazione dei vuoti di ricerca affrontati dal framework proposto MSCNN-LSTM.
È stato proposto un framework per l'animazione facciale guidata dalla sincronizzazione audio, che combina un modello di denoising facciale (FDM) con un modello di diffusione latente da locale a globale (LG-LDM) per generare animazioni facciali espressive dal punto di vista emotivo. È stato impiegato un autoencoder variazionale quantizzato in vettori centrato sulle emozioni (EVQ-VAE) per ricostruire la geometria facciale tridimensionale dettagliata e le variazioni espressive sottili31. Inoltre, è stato sviluppato un framework per la presa robotica consapevole delle occlusioni basato sulla visione stereoscopica binoculare, in grado di eseguire segmentazione del bersaglio, localizzazione, inferenza delle occlusioni e stima della posa di presa per più bersagli in condizioni di occlusione32. In aggiunta, è stato introdotto un framework a due stadi per l'estrazione del terreno da nuvole di punti, basato sulla proiezione su griglia e sulla divisione adattiva di bin, in cui probabilità di elevazione e di curvatura sono state utilizzate per affinare i confini tra terreno e ostacoli dopo un'estrazione grossolana tramite analisi delle caratteristiche basata su griglia33.
Nonostante i notevoli progressi compiuti nel riconoscimento delle azioni basato sul deep learning, i metodi esistenti hanno ancora difficoltà a gestire l'elevata variabilità e complessità dei video sportivi, inclusi i movimenti rapidi, il movimento della telecamera e le interazioni tra più giocatori. Molti modelli tradizionali basati su CNN o LSTM operano su una singola scala spaziale e potrebbero quindi avere difficoltà a catturare efficacemente sia i pattern di movimento locali che globali. Inoltre, mantenere la coerenza temporale in sequenze di lunga durata o con azioni sovrapposte rimane una sfida. Sebbene i metodi di apprendimento per trasferimento abbiano migliorato l'estrazione delle caratteristiche, la loro adattabilità a dataset specifici per lo sport è stata relativamente poco esplorata.
Questo studio mira a sviluppare e valutare un framework Multi-Scale Convolutional Neural Network–Long Short-Term Memory (MSCNN-LSTM) per il riconoscimento di azioni nei video sportivi, integrando l'estrazione di caratteristiche spaziali multiscala con una modellazione temporale basata su LSTM, al fine di catturare sia caratteristiche spaziali dettagliate sia dipendenze temporali a lungo termine. Il framework proposto utilizza kernel convoluzionali complementari e fusione di caratteristiche a più livelli per migliorare la rappresentazione di azioni sportive complesse in condizioni difficili. Le prestazioni sono state valutate sui dataset di riferimento UCF11, UCF Sports e JHMDB mediante accuratezza, precisione, richiamo, punteggio F1, media della precisione media nel tempo (mAP-T), indice di stabilità temporale (TSI), coefficiente kappa di Cohen (κ), coefficiente di correlazione di Matthews (MCC) e area sotto la curva ROC (AUC). I risultati sperimentali hanno dimostrato prestazioni competitive rispetto ai metodi valutati nello studio, evidenziando il potenziale del framework per l'analisi sportiva, il monitoraggio della prestazione degli atleti, il rilevamento automatico di eventi e la comprensione dei video sportivi.
Protocollo
Questo studio ha impiegato un framework di apprendimento profondo in due fasi per il riconoscimento delle azioni nei video sportivi, che integra una rete neurale convoluzionale multiscala (MSCNN) con una rete Long Short-Term Memory (LSTM). Sono stati utilizzati dataset di benchmark pubblicamente disponibili, in particolare UCF11, UCF Sports e JHMDB, per lo sviluppo e la valutazione del modello. Non sono stati raccolti nuovi dati da partecipanti umani, né sono state accessibili o elaborate informazioni personalmente identificabili. Poiché lo studio prevedeva l'analisi secondaria di dataset anonimi e pubblicamente disponibili e non prevedeva la partecipazione diretta di esseri umani, non è stato richiesto il parere etico istituzionale né il consenso informato.
Il flusso di lavoro ha previsto il campionamento dei fotogrammi e la normalizzazione temporale, seguiti dall'estrazione delle caratteristiche mediante il modulo MSCNN. Le caratteristiche estratte sono state successivamente elaborate utilizzando una rete LSTM per la modellazione temporale e quindi trasmesse a un livello di classificazione multiclasse. Infine, il modello è stato addestrato e valutato utilizzando i set di dati di riferimento selezionati. Figura 1 illustra l'architettura complessiva del framework proposto.
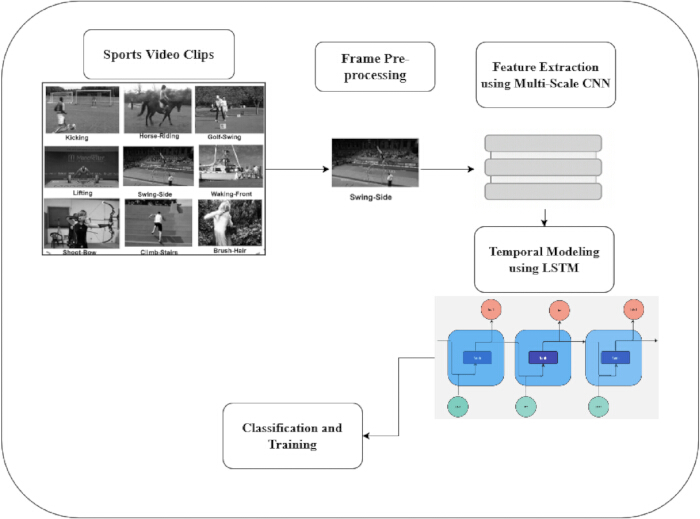
Figura 1: Schema proposto MSCNN-LSTM per il riconoscimento delle azioni nei video sportivi. Flusso di lavoro generale che illustra la pre-elaborazione del video, l'estrazione delle caratteristiche spaziali multi-risoluzione, l'apprendimento della sequenza temporale e la classificazione delle azioni. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura 1 illustra il flusso di lavoro del framework proposto per il riconoscimento di azioni nei video sportivi, basato su un'architettura ibrida MSCNN-LSTM. Il processo inizia con clip video sportivi contenenti varie azioni atletiche, tra cui calci, equitazione e swing nel golf. I video grezzi sono stati scomposti in singoli fotogrammi durante la fase di preelaborazione, in cui i fotogrammi vengono ritagliati, standardizzati e preparati per l'ingresso nel modello. I fotogrammi preelaborati sono quindi stati inseriti nel modulo MSCNN per l'estrazione delle caratteristiche. L'architettura convoluzionale multiscala cattura caratteristiche spaziali in diversi campi recettivi, consentendo l'estrazione di informazioni sia locali che contestuali dai fotogrammi dei video sportivi. I vettori di caratteristiche estratti sono stati quindi elaborati dalla rete LSTM per modellare le dipendenze temporali e l'evoluzione del movimento tra fotogrammi consecutivi. Infine, il modulo di classificazione e addestramento ha utilizzato le rappresentazioni spaziotemporali apprese per prevedere la categoria dell'azione per ciascuna clip video. Il framework proposto comprende quattro passaggi sequenziali, a partire dalla raccolta dei dati e dalla preelaborazione mediante i dataset di riferimento UCF11 (YouTube Actions), UCF Sports e JHMDB. Ciascun video sportivo è stato convertito in una sequenza di fotogrammi, che sono stati ridimensionati, normalizzati e aumentati mediante rotazione, inversione e ritaglio per migliorare la robustezza alle variazioni ambientali. I fotogrammi preelaborati sono stati quindi elaborati dalla rete neurale convoluzionale multiscala proposta (MSCNN), in cui rami convoluzionali paralleli con kernel 3 × 3, 5 × 5 e 7 × 7 estraggono caratteristiche spaziali locali e contestuali complementari. Queste caratteristiche multiscala sono state concatenate e affinate mediante normalizzazione del batch e max pooling per generare rappresentazioni compatte delle caratteristiche. Le caratteristiche risultanti a livello di fotogramma sono state successivamente fornite a una rete Long Short-Term Memory (LSTM) per modellare le dipendenze temporali tra fotogrammi consecutivi. Gli output finali dell'LSTM sono stati appiattiti e passati attraverso strati completamente connessi con attivazione ReLU, seguiti da un classificatore Softmax per prevedere la categoria dell'azione. La rete è stata addestrata utilizzando l'ottimizzatore Adam con una funzione di perdita di entropia incrociata e regolarizzazione con dropout per ridurre l'overfitting. Le prestazioni del modello sono state infine valutate sui dataset di riferimento UCF11, UCF Sports e JHMDB utilizzando accuratezza, precisione, richiamo e punteggio F1.
1. Raccolta e pre-elaborazione dei dati
In questo studio sono stati utilizzati tre dataset di riferimento disponibili pubblicamente per lo sport e l'azione umana. Questi dataset contengono filmati reali di sport con diversi movimenti della telecamera, punti di vista e complessità dello sfondo. In particolare, lo studio ha utilizzato UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), che comprende 11 categorie di azioni raccolte da 1.168 video di YouTube registrati da circa 25 individui, con più campioni per ogni azione. Il Joint-Annotated Human Motion Database (JHMDB)34,35 contiene 21 classi di azioni e 928 video annotati. Il dataset UCF Sports comprende 10 classi di azioni e 150 sequenze video acquisite da fonti di trasmissione con una risoluzione di 720 × 480 pixel (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Nel complesso, questi set di dati coprono sia sport individuali che sport di squadra e offrono una variazione nella durata temporale e nella scala visiva per valutare il framework proposto di riconoscimento delle azioni MSCNN-LSTM. Come parte del processo di controllo della qualità dei dati, i set di dati UCF11, UCF Sports e JHMDB sono stati esaminati alla ricerca di video corrotti, file duplicati e clip con annotazioni incomplete. Non sono stati identificati campioni che soddisfano questi criteri di esclusione; pertanto, tutti i video disponibili sono stati mantenuti per le analisi successive. I set di dati sono stati quindi suddivisi in sottoinsiemi di addestramento (70%), validazione (15%) e test (15%) utilizzando una strategia di suddivisione casuale coerente. Figura 2 presenta immagini rappresentative utilizzate per l'addestramento e la valutazione.
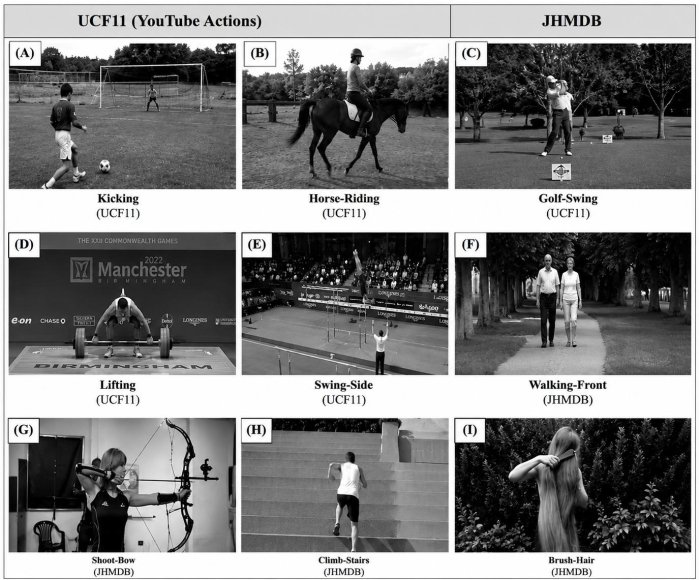
Figura 2: Fotogrammi rappresentativi dei dataset di riferimento per il riconoscimento delle azioni sportive. I pannelli (A–D) mostrano esempi del dataset UCF11 (YouTube Actions), i pannelli (E–H) del dataset UCF Sports e i pannelli (I–L) del dataset JHMDB. I fotogrammi illustrano le variazioni tra classi di azioni, punti di vista, sfondi, condizioni di illuminazione e complessità del movimento. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Il modello proposto per il riconoscimento di azioni è stato valutato sui dataset di riferimento UCF11, UCF Sports e JHMDB, come riassunto nella Tabella 3. Questi dataset rappresentano schemi di movimento diversificati e condizioni ambientali complesse. Il dataset UCF11 (YouTube Actions) contiene azioni sportive appartenenti a 11 classi, acquisite in condizioni variabili di illuminazione, punto di vista e sfondo. Il dataset UCF Sports comprende 150 video di sport di campo tratti da trasmissioni professionali, caratterizzati da sequenze di movimento realistiche. Il dataset JHMDB fornisce annotazioni dettagliate del movimento umano per 21 categorie di azioni finemente suddivise ed è utilizzato come dataset di riferimento per il riconoscimento spaziotemporale delle azioni. Complessivamente, questi dataset sono stati impiegati per valutare le prestazioni del modello in scenari relativi a sport e azioni umane. La rete è stata addestrata utilizzando l'ottimizzatore Adam per 100 epoche, con una dimensione del batch pari a 32, un tasso di apprendimento iniziale di 0,001 e una funzione di perdita basata sull'entropia incrociata. Il modello con la perdita di validazione più bassa è stato selezionato per la valutazione finale. Tutti gli esperimenti hanno utilizzato un seme casuale fisso pari a 42. Sono state applicate l'arresto anticipato e la riduzione del tasso di apprendimento in corrispondenza di plateau al fine di migliorare la convergenza, mentre durante l'addestramento dell'LSTM è stato utilizzato il clipping del gradiente con una soglia di 5,0 per prevenire gradienti esplosivi. Il modello MSCNN-LSTM proposto include circa 15 milioni di parametri addestrabili. La configurazione hardware e software utilizzata per l'implementazione è riassunta nella Tabella 4. Poiché le distribuzioni delle classi erano sufficientemente bilanciate, non sono state applicate ulteriori procedure di pesatura delle classi o di ricampionamento. I modelli comparatori sono stati implementati utilizzando gli iperparametri riportati negli studi originali, con impostazioni di addestramento armonizzate laddove possibile. I valori di prestazione sono stati riportati come media ± deviazione standard ottenuti da cinque esecuzioni indipendenti con diverse inizializzazioni casuali. Le differenze tra il modello proposto e i modelli comparatori sono state valutate mediante test t appaiati con una soglia di significatività di p < 0,05.
| Dataset | Numero di classi | Numero di video | Risoluzione (px) | Fonte | Descrizione |
| UCF11 (YouTube Actions) | 11 | 1168 | Variabile (≈ 320×240) | University of Central Florida | Comprende 11 azioni umane legate allo sport (ad esempio, tiro in basket, tuffi, swing nel golf, palleggio nel calcio). I video sono stati raccolti da YouTube con elevate variazioni di illuminazione, punto di vista e sfondo. |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | Contiene attività sportive come tuffi, equitazione, swing nel golf, corsa e sollevamento pesi, registrate da veri filmati trasmessi in TV (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | Comprende attività quotidiane e sportive come afferrare, saltare, pettinarsi, sparare e correre, con annotazioni articolari per l'analisi del movimento e della postura. |
Tabella 3: Caratteristiche dei dataset di riferimento utilizzati per l'addestramento e la valutazione. Panoramica dei dataset UCF11, UCF Sports e JHMDB, inclusi il numero di classi di azioni, campioni video, caratteristiche del dataset e i loro ruoli nell'addestramento, nella validazione e nel test del modello.
| Parametri utilizzati | Descrizione |
| Linguaggio di programmazione | Python 3.8.18 [4] |
| Framework di deep learning | TensorFlow 2.15.0 [1] |
| Acceleratore GPU | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3.5 GHz × 16 core |
| Sistema operativo | Windows 11 |
| Memoria (RAM) | 64 GB DDR4 |
| Ottimizzatore | Adam (learning rate = 0.001) |
| Dimensione del batch | 32 |
| Numero di epoche | 100 |
| Funzioni di attivazione | ReLU (strati CNN), Softmax (strato di output) |
| Tasso di dropout | 0.5 |
Tabella 4: Configurazione dell'ambiente di simulazione e degli iperparametri del modello MSCNN-LSTM proposto. Specifiche hardware, ambiente software, impostazioni dell'ottimizzatore, tasso di apprendimento, dimensione del batch, numero di epoche, dimensioni di input e altri iperparametri utilizzati durante l'addestramento e la valutazione del modello.
2. Pre-elaborazione
Prima dell'addestramento, ogni video grezzo è stato convertito in una sequenza di fotogrammi ordinata nel tempo, quindi normalizzata, campionata temporalmente e aumentata. Ogni video in ingresso V è stato innanzitutto convertito in una sequenza di fotogrammi e rappresentato come un tensore 4D V ∈ RT×H×W×C, dove T è il numero di fotogrammi, H × W i indica l'indice del fotogramma e C indica il numero di canali colore (3 per RGB). La procedura di preelaborazione comprendeva l'estrazione dei fotogrammi, il ridimensionamento spaziale seguito da ritaglio centrale o casuale a una risoluzione fissa (H′, W′), la normalizzazione dell'intensità per pixel e un eventuale aumento dei dati, inclusi inversione casuale, ridimensionamento e variazione casuale del colore, prima dell'estrazione delle caratteristiche. In particolare, la normalizzazione dell'intensità è stata implementata come normalizzazione per punteggio standard come nell'Eq. (1).
 (1)
dove μ, σ sono rispettivamente le medie e le deviazioni standard dei canali calcolate sull'insieme di addestramento, oppure come normalizzazione min-max come nell'Eq. (2).
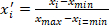 (2)
Dopo la normalizzazione, ogni fotogramma è stato rappresentato come F̃t ∈ RH′×W′×C′ e il tensore video risultante è stato rappresentato come V′ ∈ RT×H′×W′×C. In un frontend convoluzionale multi-risoluzione, vengono ottenute più mappe di caratteristiche spaziali con campi recettivi diversi applicando diverse convoluzioni 2D (o 3D per le prime convoluzioni spaziotemporali) con dimensioni di kernel differenti; successivamente viene generata una rappresentazione delle caratteristiche temporali per ogni fotogramma o breve clip video, che viene poi inviata al modulo LSTM. L'articolo originale utilizza MobileNetV2 seguito da Deep BiLSTM per la modellazione temporale; la stessa identica pipeline di preelaborazione sopra descritta è completamente compatibile con una sostituzione basata su convoluzione multi-risoluzione più LSTM.
3. Campionamento e normalizzazione temporale
Poiché la durata dei video T varia tra diversi set di dati e all'interno di ciascun set, campioniamo in modo uniforme o risempiamo temporalmente i fotogrammi per fornire alla convoluzione multiscala + LSTM una lunghezza d'ingresso fissa N in termini di fotogrammi o brevi frammenti. Gli indici dei fotogrammi uniformi possono essere calcolati come nell'Eq. (3),
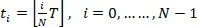 (3)
quindi, la sequenza di fotogrammi campionati è Vs = {F̃t0, …, F̃tN−1}. Quando è richiesta una maggiore fedeltà temporale, si esegue un'interpolazione temporale lineare: per ogni istante frazionario ricampionato τ ∈ [0, T−1] calcolato come nell'Eq. (4).
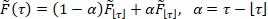 (4)
in modo che la sequenza ricampionata Vs abbia esattamente N fotogrammi e preservi un movimento fluido. In alternativa, il campionamento mediante brevi clip contigue (lunghezza della finestra temporale w con passo s) produce un insieme di tensori di clip in cui ogni clip Cj ∈ RT×H′×W′×C e j = 0, …, ⌊(T − w)/s⌋. Per la normalizzazione temporale all'interno della rete, un semplice pooling temporale su più scale risulta efficace: data una sequenza di caratteristiche temporali X = {x1, …, xN} generata da convoluzioni multiscala, applicare le caratteristiche raggruppate come nell'Eq. (5).
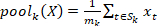 (5)
dove Sk è il supporto temporale per la scala k (ad esempio, Sk può essere costituito da blocchi non sovrapposti o da indici dilatati) e mk = |Sk|.
Prima dell'estrazione delle caratteristiche, tutti i video sono stati ridimensionati a 224 × 224 pixel e campionati a 25 fotogrammi al secondo. Ogni esperimento ha utilizzato una lunghezza costante della sequenza di 32 fotogrammi. Tra le tecniche di aumento dei dati vi erano il ritaglio casuale (scala = 0,8–1,0), la rotazione casuale (±15°), il ribaltamento orizzontale casuale (probabilità = 0,5) e la modifica della luminosità (±20%). I valori medi di ImageNet [0,485, 0,456, 0,406] e le deviazioni standard [0,229, 0,224, 0,225] sono stati utilizzati per standardizzare i valori dei pixel. Per ogni sequenza video, è stato utilizzato un campionamento temporale con selezione uniforme dei fotogrammi. I filmati più lunghi sono stati tagliati o campionati uniformemente per mantenere una lunghezza di sequenza costante, mentre i video con meno di 32 fotogrammi sono stati riempiti con zeri. Queste impostazioni sono state utilizzate costantemente durante l'addestramento e la valutazione.
4. Estrazione delle caratteristiche mediante MSCNN
È stata impiegata una rete neurale convoluzionale multiscala (MSCNN) per migliorare la rappresentazione spaziale delle azioni nei video sportivi. Le reti neurali convoluzionali convenzionali che si basano su una singola dimensione del kernel possono avere capacità limitata nel catturare caratteristiche a diverse scale spaziali. Poiché alcune azioni sportive presentano caratteristiche visive simili, potrebbe risultare difficile per un'architettura convoluzionale monoscala catturare contemporaneamente caratteristiche locali e globali. Per superare questo limite, il framework proposto utilizza kernel convoluzionali di dimensioni diverse per eseguire l'estrazione multiscala delle caratteristiche e la fusione delle caratteristiche.
Nell'architettura di rete proposta, i kernel di convoluzione 1 × 1 sono stati utilizzati per organizzare le informazioni tra i canali e per ridurre la dimensionalità delle mappe delle caratteristiche in ingresso. Inoltre, questi strati aumentano la capacità espressiva della rete introducendo ulteriori trasformazioni delle caratteristiche e rappresentazioni non lineari. Kernel di convoluzione di dimensioni diverse permettono l'estrazione di informazioni spaziali a più scale. La normalizzazione sequenziale viene eseguita dopo la fusione pesata delle caratteristiche multiscala per migliorare la stabilità dell'addestramento. Al fine di attenuare i problemi di scomparsa e di esplosione del gradiente durante l'addestramento di reti profonde, l'architettura proposta utilizza connessioni residue e modellazione temporale basata su LSTM.
La progettazione multiscala migliora la capacità della rete di acquisire caratteristiche a diverse risoluzioni spaziali e potenzia la capacità di rappresentazione delle caratteristiche. Inoltre, il kernel di convoluzione convenzionale N × N viene scomposto in operazioni di convoluzione N × 1 e 1 × N. Le convoluzioni N × 1 e 1 × N impiegate nel modulo MSCNN sono progettate per acquisire caratteristiche spaziali multiscala e direzionali complementari dai singoli fotogrammi video. Queste operazioni convoluzionali migliorano la rappresentazione delle caratteristiche spaziali estraendo pattern a diverse scale di campo recettivo. Le relazioni temporali tra fotogrammi consecutivi sono successivamente modellate dal modulo LSTM, che elabora la sequenza di caratteristiche estratte da MSCNN per apprendere dipendenze temporali a lungo termine finalizzate al riconoscimento delle azioni.
Ogni video sportivo V = {F1, F2, …, FT} viene scomposto in T fotogrammi. Per codificare le variazioni spaziali, ad esempio la posa del giocatore, il motion blur e la traiettoria della palla, rami convoluzionali a tre scale diverse operano con s ∈ {1, 2, 3}, corrispondenti a dimensioni del kernel di 3 × 3, 5 × 5 e 7 × 7. Ogni ramo estrae mappe di caratteristiche come indicato nell'Eq. (6):
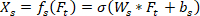 (6)
Dove Ws e bs sono i pesi e i bias della convoluzione alla scala s, e σ è l'attivazione ReLU. Il livello di fusione multi-scala aggrega le caratteristiche come nell'Eq. (7):
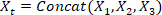 (7)
Questo tensore di caratteristiche fuso incorpora sia segnali di movimento finemente dettagliati sia informazioni contestuali su larga scala, come le attività di gruppo. Figura 3 illustra soltanto il modulo di estrazione delle caratteristiche MSCNN. Il livello LSTM (256 unità nascoste), il livello denso (128 neuroni) e il livello dropout (0,5) utilizzati per la modellazione temporale e la classificazione sono presentati separatamente nella Figura 4.
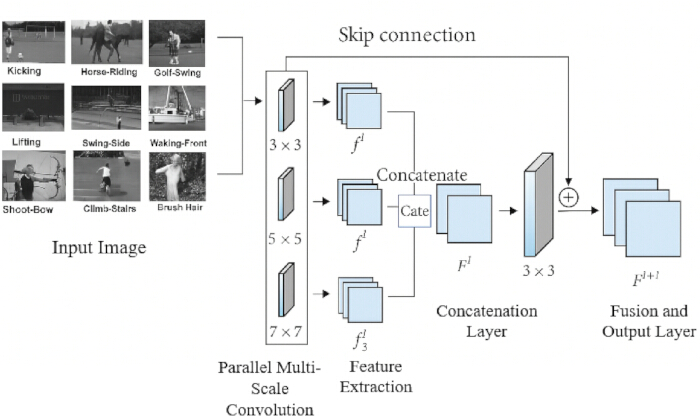
Figura 3: Modulo proposto per l'estrazione di caratteristiche della rete neurale convoluzionale multiscala (MSCNN). Tre rami convoluzionali paralleli con dimensioni dei kernel di 3 × 3, 5 × 5 e 7 × 7 estraggono caratteristiche spaziali multiscala complementari, che vengono fuse prima della modellizzazione temporale da parte della rete LSTM. Cliccare qui per visualizzare una versione ingrandita di questa figura.
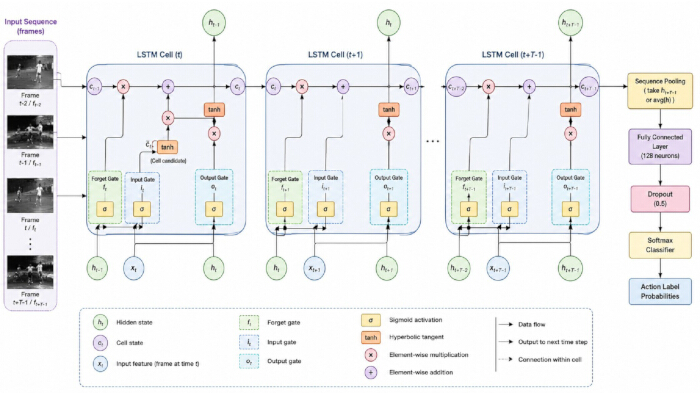
Figura 4: Architettura LSTM proposta per il riconoscimento delle azioni nei video sportivi. Il modulo LSTM modella le dipendenze temporali attraverso operazioni dei gate di input, di dimenticanza e di output su frame video consecutivi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura 3 illustra il modulo proposto di estrazione delle caratteristiche basato su una rete neurale convoluzionale multiscala (MSCNN) per il riconoscimento delle azioni nei video sportivi. I fotogrammi video di ingresso sono stati elaborati in parallelo attraverso tre rami convoluzionali con dimensioni dei kernel di 3 × 3, 5 × 5 e 7 × 7, ciascuno contenente 64 filtri per acquisire caratteristiche spaziali fini e grossolane complementari. Gli output sono stati affinati mediante normalizzazione del batch, attivazione ReLU e pooling massimo 2 × 2, quindi concatenati e fusi tramite una convoluzione 1 × 1 con 128 filtri. Una connessione residua di salto ha preservato le informazioni spaziali di basso livello e migliorato il flusso del gradiente. Le mappe delle caratteristiche fuse sono state appiattite e trasmesse a un livello LSTM con 256 unità nascoste per la modellazione temporale, seguito da un livello completamente connesso con 128 neuroni, attivazione ReLU e un tasso di dropout pari a 0,5 prima della classificazione finale mediante un livello Softmax. Le mappe delle caratteristiche multiscala (f1l, f2l e f3l) sono state concatenate per formare la rappresentazione fusa (Fl), ulteriormente affinata da una convoluzione 3 × 3 per generare la mappa delle caratteristiche in uscita per il livello successivo. Questa architettura gerarchica ha permesso l'apprendimento di caratteristiche spaziali complementari in diversi campi recettivi, migliorando le prestazioni nel riconoscimento delle azioni sportive.
5. Modellizzazione temporale mediante LSTM
Al fine di modellare l'evoluzione temporale lungo i bordi del video, la sequenza di caratteristiche aggregata è stata fornita al sistema LSTM per catturare le dipendenze dinamiche e la continuità del movimento. Per ogni video in ingresso, abbiamo innanzitutto estratto caratteristiche CNN multiscala per ogni fotogramma. Siano i fotogrammi del video I1, …, IT. Per ogni fotogramma t e ogni scala s, l'encoder convoluzionale multiscala produce un vettore di caratteristiche ft(s) ∈ Rd. Successivamente, le scale vengono fuse in un singolo descrittore del fotogramma mediante proiezione + concatenazione oppure somma pesata, come nell'Eq. (8):
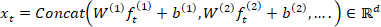 (8)
Successivamente, inserire la sequenza {xt}tT=1 in un LSTM per modellare la dinamica temporale. Nella notazione standard LSTM, al tempo t le porte e gli stati sono descritti dalle equazioni (9) a (13):
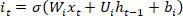 (9)
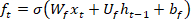 (10)
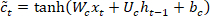 (11)
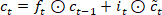 (12)
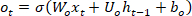 (13)
Qui σ è l'attivazione sigmoidea, ⊙ è la moltiplicazione elemento per elemento. Sebbene architetture LSTM bidirezionali possano essere utilizzate per catturare sia il contesto temporale passato che futuro, il framework proposto impiega un LSTM standard per modellare le dipendenze temporali tra fotogrammi video sequenziali. Questa scelta progettuale è coerente con l'architettura MSCNN-LSTM presentata in questo studio. Dopo l'elaborazione del clip, si ottiene una rappresentazione del clip (ad esempio, ultimo stato nascosto o pooling temporale): z = Poolt(vt).
Figura 4 illustra il flusso di lavoro dell'architettura LSTM proposta per il riconoscimento delle azioni sportive. La rete ha ricevuto una sequenza di fotogrammi video o caratteristiche estratte da una CNN e li ha elaborati in successivi passi temporali (t−2, t−1 e t). Ogni cella LSTM comprendeva un gate di ingresso, un gate di dimenticanza e un gate di uscita, che regolavano il flusso di informazioni attraverso la rete. Il gate di ingresso incorporava nuove informazioni nello stato della cella, il gate di dimenticanza eliminava informazioni temporali irrilevanti e il gate di uscita generava lo stato nascosto propagato al passo temporale successivo. Lo stato della cella preservava dipendenze temporali a lungo termine, mentre lo stato nascosto catturava informazioni temporali a breve termine. Dopo l'elaborazione sequenziale, gli output LSTM venivano raggruppati per generare una rappresentazione delle caratteristiche temporali, che veniva poi trasmessa a un layer completamente connesso e a un classificatore Softmax per prevedere l'azione sportiva corrispondente. La rete è stata addestrata utilizzando l'ottimizzatore Adam per 100 epoche con una dimensione del batch di 32, un tasso di apprendimento iniziale di 0,001 e una funzione di perdita di entropia incrociata. Il modello con la perdita di validazione più bassa è stato selezionato per la valutazione finale. Per garantire la riproducibilità, tutti gli esperimenti sono stati condotti utilizzando un seme casuale fisso pari a 42. Sono state impiegate l'arresto anticipato e la riduzione del tasso di apprendimento in corrispondenza di un plateau per migliorare la convergenza, ed è stata applicata la limitazione del gradiente con una soglia di 5,0 durante l'addestramento LSTM per prevenire gradienti esplosivi. Il modello MSCNN-LSTM proposto conteneva circa 15 milioni di parametri addestrabili.
I punteggi finali delle classi e la probabilità utilizzano un livello lineare + softmax come nell'Eq. (14):
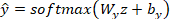 (14)
Eseguire l'addestramento minimizzando la perdita di entropia incrociata sui clip etichettati come nell'Eq. (15):
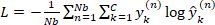 (15)
dove Nb è la dimensione del batch, C il numero di classi e y(n) è la verità effettiva in formato one-hot. Si applica la regolarizzazione (dropout sugli output di xt/LSTM, riduzione dei pesi) e il clipping del gradiente per migliorare la stabilità nelle sequenze sportive lunghe.
Risultati
Il modello proposto MSCNN-LSTM è stato addestrato e valutato sui dataset UCF11 (YouTube Actions), UCF Sports e JHMDB, che includevano diverse azioni sportive, punti di vista e schemi di movimento. Poiché le distribuzioni delle classi erano sufficientemente bilanciate, non sono state applicate ulteriori procedure di pesatura delle classi o ricampionamento. I modelli comparatori sono stati implementati utilizzando gli iperparametri riportati nei rispettivi studi originali, con impostazioni di addestramento armonizzate laddove possibile. I risultati sono stati riportati come media ± deviazione standard ottenuta da cinque esecuzioni indipendenti con diverse inizializzazioni casuali. Le differenze tra il modello proposto e i modelli comparatori sono state valutate mediante test t appaiati con una soglia di significatività di p < 0,05.
Figura 5 confronta l'accuratezza di classificazione tra i tre dataset. Il modello MSCNN-LSTM ha ottenuto l'accuratezza più elevata, raggiungendo il 98,3% su UCF11, il 95,4% su UCF Sports e l'81,7% su JHMDB. Questi valori superano quelli ottenuti dai modelli Dilated CNN–BiLSTM, Two-Stream LSTM e ViT-ReT. L'accuratezza inferiore su JHMDB riflette la maggiore difficoltà nel riconoscere azioni finemente dettagliate in video a risoluzione più bassa.
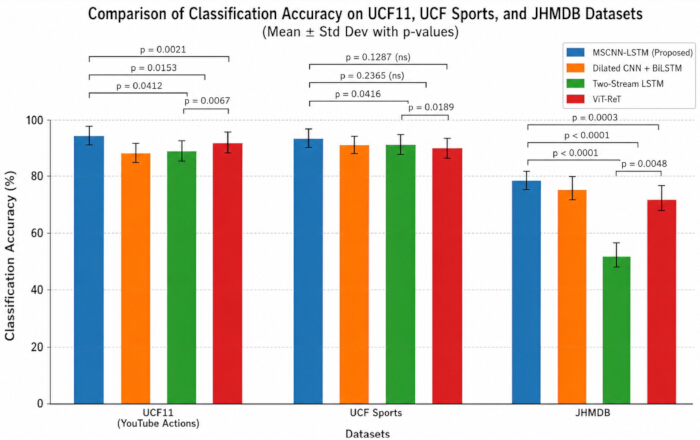
Figura 5: Confronto dell'accuratezza di classificazione (%) di diversi modelli di apprendimento profondo su dataset di video sportivi. Accuratezza di classificazione di MSCNN-LSTM, ViT-ReT, Two-Stream LSTM e Dilated CNN + BiLSTM sui dataset UCF11, UCF Sports e JHMDB. I risultati sono riportati come media ± DS da cinque esecuzioni indipendenti (n = 5). Le barre di errore rappresentano una deviazione standard. La significatività statistica è stata valutata mediante test t appaiati a due code (p < 0,05). Cliccare qui per visualizzare una versione ingrandita di questa figura.
Il modello proposto ha inoltre ottenuto la precisione più elevata su tutti i dataset, con valori di circa il 96% su UCF11, il 93% su UCF Sports e il 78% su JHMDB (Figura 6). I valori di richiamo sono stati rispettivamente di circa il 95%, il 94% e il 77% (Figura 7), mentre i corrispondenti punteggi F1 sono stati di circa il 95,5%, il 93,5% e il 77,5% (Figura 8). Questi risultati indicano che il modello mantiene un equilibrio favorevole tra l'identificazione corretta delle classi di azione e la limitazione delle predizioni false positive.
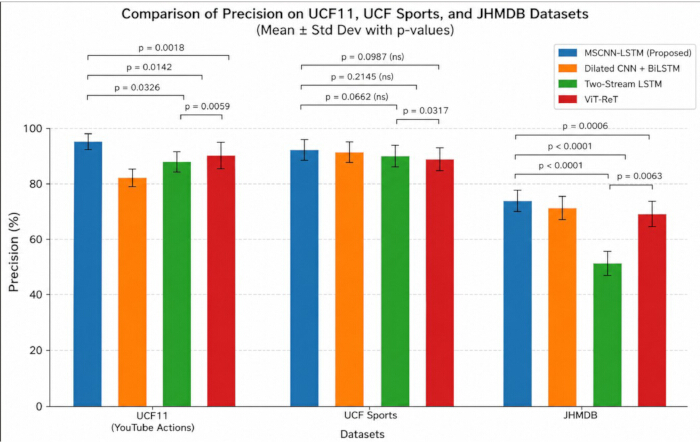
Figura 6: Confronto della precisione (%) di diversi modelli di apprendimento profondo su dataset di video sportivi. I valori di precisione sono riportati come media ± DS di cinque esecuzioni indipendenti (n = 5). Le barre di errore rappresentano una deviazione standard. La significatività statistica è stata valutata mediante test t appaiati a due code (p < 0,05). Cliccare qui per visualizzare una versione ingrandita di questa figura.
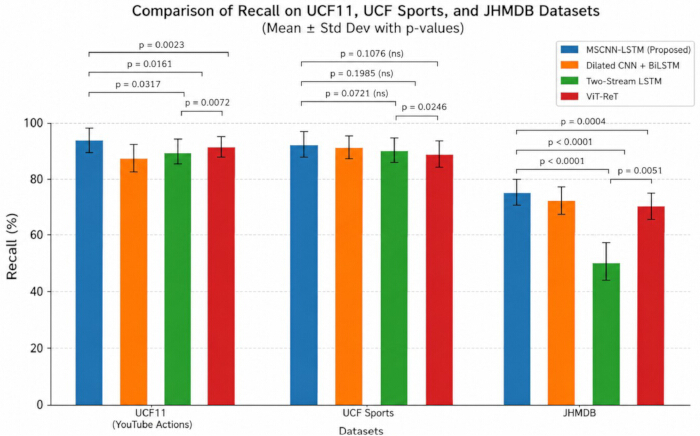
Figura 7: Confronto della percentuale di richiamo (%) di diversi modelli di apprendimento profondo su dataset video sportivi. I valori di richiamo sono riportati come media ± DS di cinque esecuzioni indipendenti (n = 5). Le barre di errore rappresentano una deviazione standard. La significatività statistica è stata valutata mediante test t appaiati a due code (p < 0,05). Cliccare qui per visualizzare una versione ingrandita di questa figura.
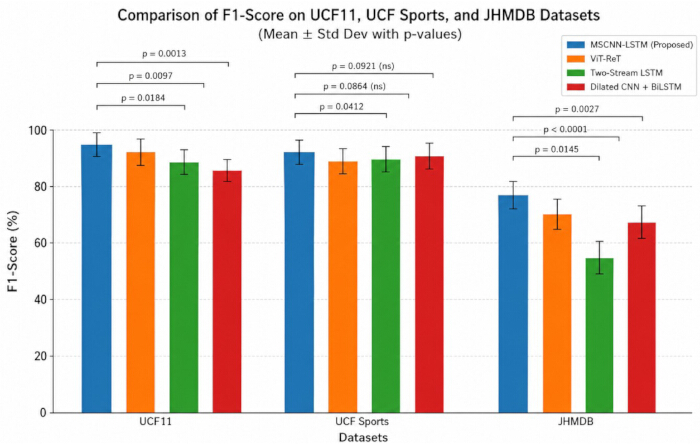
Figura 8: Confronto del punteggio F1 (%) di diversi modelli di apprendimento profondo su dataset di video sportivi. I punteggi F1 sono riportati come media ± DS di cinque esecuzioni indipendenti (n = 5). Le barre di errore rappresentano una deviazione standard. La significatività statistica è stata valutata mediante test t appaiati a due code (p < 0,05). Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella 5 presenta i risultati del kappa di Cohen e del coefficiente di correlazione di Matthews. Su UCF11, il modello proposto ha raggiunto κ = 0,96 e MCC = 0,96, rispetto ai valori κ/MCC di 0,92/0,92 per ViT-ReT, 0,90/0,90 per Two-Stream LSTM e 0,87/0,87 per Dilated CNN–BiLSTM. Su UCF Sports, MSCNN-LSTM ha ottenuto κ = 0,95 e MCC = 0,94, superando i valori corrispondenti ottenuti da ViT-ReT (0,90/0,90), Two-Stream LSTM (0,88/0,89) e Dilated CNN–BiLSTM (0,84/0,85). Su JHMDB, il modello proposto ha raggiunto κ = 0,83 e MCC = 0,84, rispetto a 0,74/0,75 per ViT-ReT, 0,70/0,71 per Two-Stream LSTM e 0,71/0,72 per Dilated CNN–BiLSTM. Questi risultati hanno mostrato un accordo maggiore tra le etichette predette e quelle reali per il modello proposto.
| Modello | Dati | Kappa di Cohen (κ) | Coefficiente di Correlazione di Matthews (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube Actions) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube Actions) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube Actions) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| MSCNN–LSTM proposto | UCF11 (YouTube Actions) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabella 5: Confronto tra il kappa di Cohen (κ) e il coefficiente di correlazione di Matthews (MCC) in diversi modelli di deep learning. Confronto delle prestazioni di MSCNN-LSTM, ViT-ReT, Two-Stream LSTM e Dilated CNN + BiLSTM sui dataset UCF11, UCF Sports e JHMDB. Valori più elevati indicano un accordo maggiore tra le etichette previste e quelle reali e una maggiore affidabilità della classificazione. I valori sono riportati come media ± DS da cinque esecuzioni indipendenti (n = 5).
Figura 9 mostra le curve caratteristiche operative del ricevitore. L'MSCNN-LSTM proposto ha raggiunto valori di AUC di 0,975 su UCF11, 0,961 su UCF Sports e 0,937 su JHMDB. I valori di AUC costantemente elevati indicano una forte capacità di discriminazione tra le classi di azioni attraverso dataset di diversa complessità.
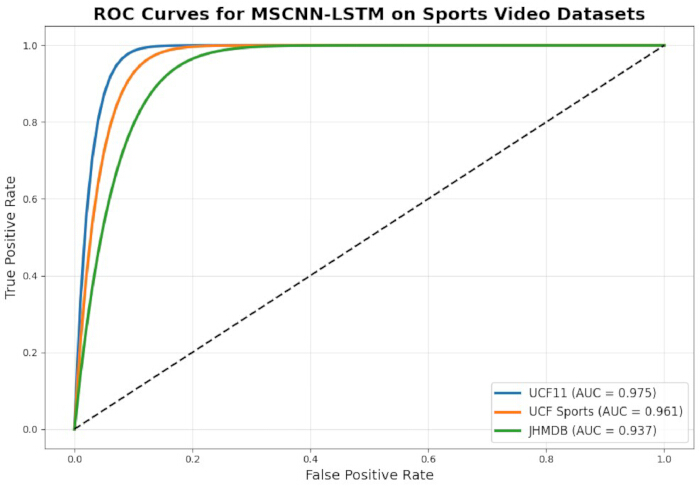
Figura 9: Curve caratteristiche operative del ricevitore (ROC) del modello MSCNN-LSTM proposto. Curve ROC per i dataset UCF11, UCF Sports e JHMDB che illustrano il compromesso tra il tasso di veri positivi e il tasso di falsi positivi. L'area sotto la curva (AUC) riassume le prestazioni discriminative del modello attraverso diverse soglie di classificazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
I risultati delle prestazioni temporali sono riassunti nella Tabella 6. Su UCF11, il modello proposto ha raggiunto un mAP-T del 98,3%, un'accuratezza a livello di frame del 96,5% e un TSI di 0,95. Su UCF Sports, i valori corrispondenti erano rispettivamente 95,4%, 94,0% e 0,93. Su JHMDB, il modello ha ottenuto un mAP-T dell'81,7%, un'accuratezza a livello di frame del 78,9% e un TSI di 0,88 (Tabella 7). Questi valori sono risultati superiori rispetto a quelli ottenuti dai modelli comparatori e indicano una maggiore coerenza temporale e stabilità delle previsioni sia in sequenze di azioni brevi che di lunga durata.
| Metodo | Dataset | mAP-T (%) | Accuratezza a Livello di Frame (%) | Indice di Stabilità Temporale (TSI) |
| Dilated CNN + BiLSTM4 | UCF11 (YouTube Actions) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| Two-Stream LSTM38 | UCF11 (YouTube Actions) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF11 (YouTube Actions) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (YouTube Actions) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tabella 6: Confronto delle metriche temporali di prestazione per il riconoscimento delle azioni nei video sportivi. Risultati sperimentali della media della Precisione Media su Segmenti Temporali (mAP-T), dell'accuratezza a livello di fotogramma e dell'Indice di Stabilità Temporale (TSI) per diversi modelli di apprendimento profondo sui dataset di riferimento. I valori sono riportati come media ± DS da cinque esecuzioni indipendenti (n = 5).
| Configurazione | CNN Multiscala (MSCNN) | LSTM | Precisione (%) | F1-Score (%) | mAP-T (%) |
| Baseline solo CNN | ✗ | ✗ | 90,4 ± 1,2 | 89,8 ± 1,3 | 88,9 ± 1,4 |
| CNN + LSTM | ✗ | ✓ | 93,1 ± 0,9 | 92,4 ± 1,0 | 91,7 ± 1,1 |
| Solo MSCNN | ✓ | ✗ | 94,2 ± 0,8 | 93,6 ± 0,9 | 92,8 ± 1,0 |
| MSCNN-LSTM proposto | ✓ | ✓ | 98,3 ± 0,5 | 97,8 ± 0,6 | 97,1 ± 0,6 |
Tabella 7: Studio di ablazione del framework proposto MSCNN-LSTM. Contributo delle prestazioni dei componenti MSCNN e LSTM in condizioni identiche di addestramento e valutazione. I valori sono riportati come media ± DS da cinque esecuzioni indipendenti (n = 5).
Figura 10, Figura 11, Figura 12 mostrano le matrici di confusione normalizzate per riga rispettivamente per UCF11, UCF Sports e JHMDB. Tutte e tre le matrici hanno mostrato una chiara predominanza diagonale, indicando che la maggior parte delle classi di azioni è stata correttamente identificata. Si sono verificati errori limitati fuori dalla diagonale, principalmente tra azioni con caratteristiche visive o di movimento simili. La matrice di JHMDB ha mostrato una confusione tra classi relativamente maggiore, coerente con le prestazioni quantitative inferiori osservate su questo dataset più complesso.
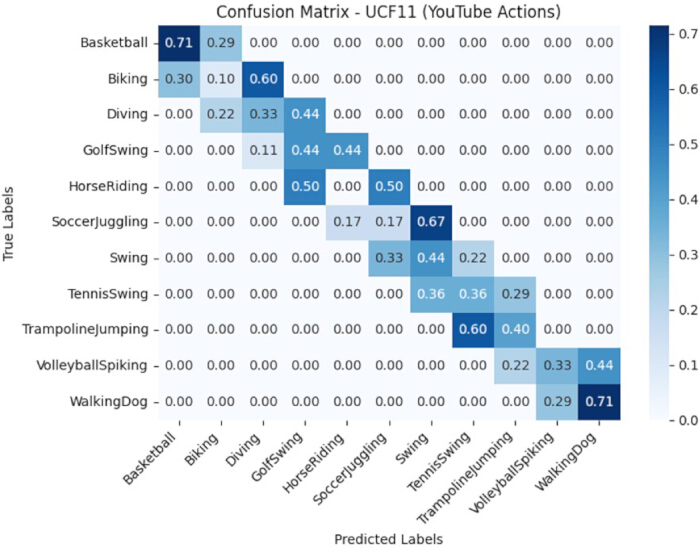
Figura 10: Matrice di confusione normalizzata per riga del modello MSCNN-LSTM proposto sul dataset UCF11. Ogni riga è normalizzata a uno, e le voci diagonali rappresentano il richiamo specifico per classe piuttosto che l'accuratezza complessiva della classificazione, che viene riportata separatamente. Cliccare qui per visualizzare una versione ingrandita di questa figura.
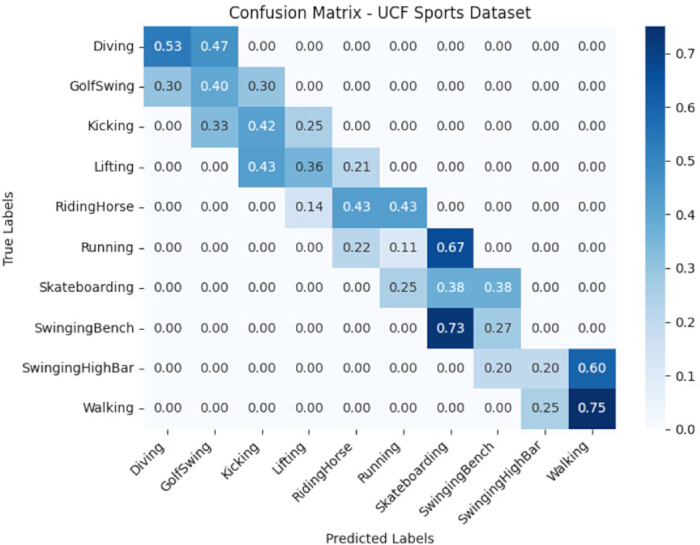
Figura 11: Matrice di confusione normalizzata per riga del modello MSCNN-LSTM proposto sul dataset UCF Sports. Ogni riga è normalizzata a uno, e le voci diagonali rappresentano il richiamo specifico per classe piuttosto che l'accuratezza complessiva della classificazione, che è riportata separatamente. Cliccare qui per visualizzare una versione ingrandita di questa figura.
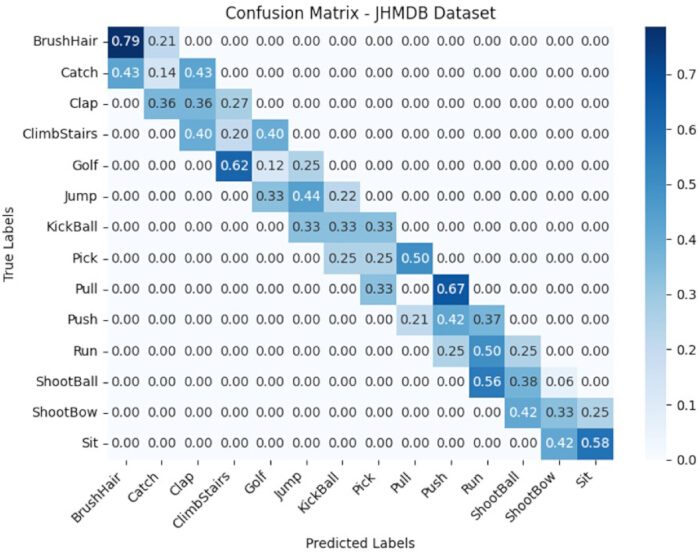
Figura 12: Matrice di confusione normalizzata per riga del modello MSCNN-LSTM proposto sul dataset JHMDB. Ogni riga è normalizzata a uno, e le voci sulla diagonale rappresentano il richiamo specifico per classe piuttosto che l'accuratezza complessiva della classificazione, che viene riportata separatamente. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Complessivamente, il framework proposto MSCNN-LSTM ha superato in modo costante i modelli comparatori valutati in termini di classificazione, accordo, discriminazione e misure di stabilità temporale. I risultati hanno confermato l'ipotesi secondo cui la combinazione dell'estrazione multi-scala delle caratteristiche spaziali con la modellizzazione temporale basata su LSTM migliora il riconoscimento delle azioni sportive su dataset con diversa complessità di movimento, qualità delle immagini e condizioni di punto di vista.
DISPONIBILITÀ DEI DATI:
I set di dati analizzati durante lo studio attuale sono disponibili pubblicamente dalle seguenti fonti: il dataset UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) e il dataset UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Per supportare la riproducibilità di questo studio, la pipeline di preelaborazione, la suddivisione del dataset (generazione della suddivisione in training/validation/test), i file di implementazione, i file di configurazione e la documentazione di supporto utilizzati negli esperimenti sono stati depositati nel repository Zenodo e sono disponibili pubblicamente all'indirizzo https://doi.org/10.5281/zenodo.21020947.
Discussione
Il framework proposto MSCNN-LSTM ha superato costantemente gli approcci valutati nei dataset di benchmark UCF11, UCF Sports e JHMDB. Metodi precedenti basati su Dilated CNN–BiLSTM, architetture Vision Transformer e CNN 3D hanno dimostrato un'apprendimento efficace delle caratteristiche spaziotemporali, ma potrebbero essere limitati da un'elevata complessità computazionale, da sostanziali requisiti di addestramento o da una rappresentazione insufficiente di modelli di movimento fine23,24,25. Al contrario, il framework proposto integra l'estrazione multi-scala delle caratteristiche spaziali con una modellazione temporale basata su LSTM, consentendo di catturare sia dettagli locali del movimento sia dipendenze temporali a lungo raggio. Questa integrazione ha migliorato il riconoscimento di azioni sportive complesse, ridotto la confusione tra classi e aumentato la coerenza temporale, in particolare sul dataset JHMDB, più complesso. Questi risultati indicano che il framework proposto fornisce una rappresentazione equilibrata delle informazioni spaziali e temporali rispetto agli approcci basati su CNN, reti ricorrenti e transformer valutati.
Dal punto di vista teorico, il framework MSCNN-LSTM ha fornito un approccio unificato alla fusione di caratteristiche multiscala e all'apprendimento temporale sequenziale36,37. L'uso di campi recettivi gerarchici ha permesso l'estrazione di informazioni spaziali a diverse scale, mentre l'LSTM ha modellato le dipendenze tra fotogrammi video consecutivi. Questa architettura ha esteso la classica pipeline CNN-LSTM preservando le informazioni spaziali locali e contestuali prima della modellazione temporale. Le prestazioni costanti su dataset contenenti diverse classi di azioni, schemi di movimento e punti di vista della telecamera hanno ulteriormente confermato la robustezza dell'architettura proposta.
Da un punto di vista pratico, il framework ha mostrato un potenziale per l'analisi automatizzata degli sport, la valutazione della prestazione degli atleti, il rilevamento di eventi e la comprensione dei video sportivi. Tuttavia, è necessaria un'ulteriore validazione in condizioni operative reali prima del suo utilizzo. Sebbene l'architettura abbia raggiunto prestazioni di riconoscimento elevate, la sua idoneità per dispositivi con risorse limitate o piattaforme analitiche basate su cloud dovrebbe essere confermata attraverso una valutazione aggiuntiva del costo computazionale, del tempo di inferenza, dei requisiti di memoria e del consumo energetico.
Lo studio di ablazione ha dimostrato i contributi complementari dei componenti MSCNN e LSTM. La MSCNN ha migliorato l'estrazione delle caratteristiche spaziali apprendendo rappresentazioni a diverse scale di campo recettivo, mentre l'LSTM ha potenziato la modellizzazione temporale catturando le dipendenze di movimento tra frame consecutivi. La configurazione completa MSCNN-LSTM ha ottenuto le prestazioni migliori, indicando che l'estrazione multi-scala delle caratteristiche spaziali e la modellizzazione delle sequenze temporali hanno contribuito congiuntamente al miglioramento osservato nel riconoscimento delle azioni.
Nel complesso, il framework proposto MSCNN-LSTM ha combinato in modo efficace l'apprendimento della rappresentazione spaziale e temporale per il riconoscimento di azioni nei video sportivi. La valutazione sui dataset UCF11, UCF Sports e JHMDB ha mostrato un miglioramento delle prestazioni rispetto agli approcci di deep learning valutati. Questi risultati supportano l'ipotesi secondo cui l'integrazione di caratteristiche convoluzionali multi-risoluzione con una modellizzazione temporale basata su LSTM migliora il riconoscimento di azioni sportive complesse. Tuttavia, è necessaria una validazione su dataset più ampi, diversificati e cross-domain per stabilire la generalizzabilità e l'applicabilità nel mondo reale.
Vanno considerati diversi limiti. In primo luogo, la valutazione si è limitata a dataset di benchmark disponibili pubblicamente e potrebbe non rappresentare appieno la diversità e la complessità degli ambienti sportivi reali. In secondo luogo, sebbene siano state utilizzate partizioni fisse per il training, la validazione e il test, non è stato possibile escludere del tutto il bias del dataset e possibili fughe involontarie di dati. In terzo luogo, le prestazioni riportate potrebbero variare in base alla composizione del dataset, all'inizializzazione del modello, alle procedure di pre-elaborazione e alle impostazioni di addestramento. Inoltre, i componenti per la modellazione convoluzionale e temporale multi-risoluzione hanno aumentato i requisiti computazionali, il che potrebbe influire sullo sviluppo su dispositivi con risorse limitate. Il framework inoltre non è stato valutato utilizzando dataset esterni o scenari di produzione in tempo reale.
I modelli video basati su transformer hanno mostrato prestazioni elevate su dataset di riconoscimento di azioni su larga scala, ma spesso richiedono risorse computazionali sostanziali e grandi quantità di dati per l'addestramento. Il framework proposto MSCNN-LSTM offre un approccio alternativo combinando l'estrazione di caratteristiche spaziali multi-risoluzione con un modello ricorrente per la modellizzazione temporale. Lavori futuri dovrebbero indagare la validazione incrociata tra dataset, l'inferenza in tempo reale, l'ottimizzazione computazionale, la stima dell'incertezza e architetture ibride che integrino meccanismi di attenzione basati su transformer con il framework proposto di CNN-LSTM multi-risoluzione38.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Questa ricerca è stata condotta presso il Center of Artificial Intelligence Technology (CAIT), Faculty of Information Science and Technology, Universiti Kebangsaan Malaysia. Gli autori ringraziano sentitamente per il supporto istituzionale e le strutture di ricerca fornite. Questo lavoro non ha ricevuto finanziamenti specifici da alcuna agenzia pubblica, commerciale o senza scopo di lucro.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| GPU GeForce RTX 3090 | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Utilizzato per l'addestramento e l'inferenza del modello di apprendimento profondo |
| Processore Intel Core i9 | Intel Corporation | 16 core, 3,5 GHz | Utilizzato per la preelaborazione dei dati e il calcolo |
| Memoria di sistema | Generico | 64 GB di RAM DDR4 | Supporta l'elaborazione video su larga scala |
| Linguaggio di programmazione Python | Fondazione Python Software | Versione 3.8.18 | Linguaggio di programmazione principale per l'implementazione |
| TensorFlow | Versione 2.15 | Framework di apprendimento profondo utilizzato per lo sviluppo del modello | |
| Sistema operativo | Microsoft Corporation | Windows 11 | Sviluppo del modello e sperimentazione |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | Accelerazione GPU per l'addestramento del modello |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Libreria di accelerazione per reti neurali profonde |
| OpenCV | Open Source | Versione 4.8.1 | Estrazione e preelaborazione dei fotogrammi video |
| NumPy | Open Source | Versione 1.24.4 | Calcolo numerico ed elaborazione di array |
| Scikit-learn | Open Source | Versione 1.3.2 | Valutazione delle prestazioni e analisi statistica |
| Matplotlib | Open Source | Versione 3.7.5 | Visualizzazione dei risultati sperimentali |
| Dataset UCF11 | Università della Florida Centrale | Dataset pubblico | Dataset di riferimento per il riconoscimento delle azioni sportive |
| Dataset UCF Sports | Università della Florida Centrale | Dataset pubblico | Dataset di riferimento per il riconoscimento delle azioni sportive |
| Dataset JHMDB | Istituto Max Planck per l'Informatica | Dataset pubblico | Dataset di riferimento per il riconoscimento del movimento e delle azioni umane |
Riferimenti
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543