Questo studio propone un algoritmo che accoppia strettamente le caratteristiche visive gerarchiche catturate da un encoder gerarchico a finestra spostata con la profondità precedente della scatola delimitante 3D Manhattan generata dal rilevamento di segmenti di linea, ottenendo così una ricostruzione semantica ad alta precisione di scene interne complesse.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Un metodo di analisi semantica per immagini di scene interne basato su conoscenze pregresse della struttura degli edifici
In questo articolo
Sommario
Abstract
Per affrontare le discontinuità di previsione semantiche e le distorsioni fisiche dei confini causate dall'occlusione dei mobili in scene interne complesse, questo articolo propone un metodo di analisi semantica che sfrutta i priors della struttura degli edifici. Lo schema utilizza un codificatore gerarchico a finestra spostata per estrarre caratteristiche visive multiscala e combina un algoritmo di rilevamento di segmenti di linea a consistenza in direzione di gradiente per costruire una scatola delimitante 3D Manhattan. Questa scatola di delimitazione viene trasformata in un campo di distanza segnato (SDF) prima di codificare contorni geometrici discreti in un campo potenziale fisico continuo. Un meccanismo di attenzione incrociata guidato dalla struttura costringe i segnali visivi ad allinearsi con i confini geometrici ortogonali 3D reali, ripristinando la continuità delle caratteristiche nelle aree occluse. Un grafo di adiacenza spaziale costruito da nodi superpixel alimenta una Rete Convoluzionale di Grafi (GCN) per aggregare le caratteristiche, garantendo la coerenza semantica macroscopica all'interno del piano fisico portante del carico. Una combinazione di perdita di entropia incrociata a livello di pixel e di una perdita di coerenza strutturale progettata su misura rafforza i vincoli, penalizzando le previsioni fuori limite. Esperimenti su più corse indipendenti mostrano che l'intersezione media sull'unione (mIoU) raggiunge il 68,7% con una deviazione standard dello 0,2%, e il punteggio F1 del confine strutturale raggiunge il 76,4% con una deviazione standard dello 0,3%, confermando la robustezza delle prestazioni dei moduli proposti. Con una dimensione di un singolo nodo immagine di 256, il tempo medio di inferenza rimaneva a 61 ms.
Introduzione
L'analisi semantica delle immagini di scene interne occupa una posizione centrale nei compiti di cognizione spaziale tridimensionale e ragionamento spazialeintelligente 1,2. L'estrazione delle caratteristiche visive in ambienti fisici reali è spesso gravemente ostacolata da disposizioni spazialicomplesse 3. Risolvere la discontinuità semantica e la distorsione fisica dei confini della struttura delle fondazioni dell'edificio causata dall'occlusione di mobili su larga scala è importante per la ricerca sulla cognizionespaziale 4,5. Rimuovere con precisione le interferenze da oggetti ingombranti e ripristinare la continuità fisica dello stesso muro e pavimento determinerà direttamente l'accuratezza della ricostruzione tridimensionale della scena e dell'analisi globale della logicaspaziale 6. La discontinuità semantica causata dall'occlusione su larga scala dei mobili e l'effetto di riparazione strutturale della guida proposta per il preavviamento edilizio sono illustrati nella Figura 1, dove l'input occluto rosso verde blu (RGB) nella Tabella 1A, la distorsione della maschera di base nella Figura 1B e il risultato di riparazione strutturale nella Figura 1C sono confrontati sotto la stessa condizione della scena interna.
Per soddisfare i requisiti di accuratezza del ragionamento logico spaziale, le attuali reti visive guidate da pixel si trovano ad affrontare molteplici ostacoli quando si confrontano con ambienti interni complessi 7,8. Gli spazi interni sono spesso riempiti da mobili densi e mobili disordinati, causando una significativa perdita dei segnali di confine visivi a basso livello nelle immagini9. I meccanismi convenzionali di estrazione delle caratteristiche si basano eccessivamente su risposte bidimensionali locali di colore e texture, prive di una comprensione macroscopica delle rigide leggi ortogonali delle strutture tridimensionali createdall'uomo 10. Questa limitazione del campo ricettivo locale rende la propagazione delle caratteristiche facilmente interrotta, rendendo difficile estendere la topologia globale attraverso leocclusioni 11. Attualmente, è urgente risolvere il problema centrale delle discontinuità nella predizione semantica e delle gravi distorsioni dei confini fisici causate da occlusione einterferenza 12.
Per affrontare i difetti strutturali nelle fondamenta degli edifici causati da occlusione e interferenze, la comunità accademica ha sviluppato una varietà di misure di interventomirate 13. Le reti di aggregazione di caratteristiche cross-modali compensano efficacemente le carenze intrinseche di una singola modalità visiva nella percezione spaziale introducendo mappe di profondità o priori testuali per aiutare con immagini rosso-verde-blu (RGB) 14,15. I framework di percezione dei contorni e selezione adattiva del contesto inseriscono strategie di miglioramento fisico dei contorni nella fase di decodifica delle caratteristiche, migliorando notevolmente l'adattamento dei bordi dei risultati di previsione in scenecomplesse 16,17. I modelli di inferenza basati su GCN e meccanismi di interazione con le caratteristiche migliorano significativamente la fluidità delle caratteristiche e la coerenza macro-semantica in regioni omogenee costruendo connessioni a livello dinodo 18,19. Integrare i prior strutturali espliciti di Manhattan nella pipeline di estrazione delle caratteristiche visive impone confini di coerenza geometrica, che affrontano le sfide di discontinuità delle caratteristiche causate dall'estesa occlusione degli oggetti in primopiano 20.
Per affrontare la sfida centrale dei guasti di predittione semantica e delle gravi distorsioni dei confini fisici associati all'infrastruttura costruttiva, viene proposto un quadro di parsing semantico basato su un meccanismo di accoppiamento a anello chiuso che incorpora priori architettonici. Questo quadro trascende le pipeline ingegneristiche ingenue stabilendo un allineamento bidirezionale di mappa tra campi potenziali geometrici continui e varietà di caratteristiche visive discrete, formando una sinergia non banale che corregge gli errori di occlusione attraverso leggi strutturali. Questo schema si basa su una rete di backbone visiva multiscala e su un algoritmo di rilevamento dei segmenti di linea basato sulla stima del punto di fuga per acquisire caratteristiche di aspetto locale e priors ortogonali degli spigoli che rappresentano in parallelo la delimitazione 3D di Manhattan, per poi trasformarli in un SDF. L'algoritmo impiega un meccanismo di attenzione incrociata guidato dalla struttura, utilizzando caratteristiche visive come vettori di query e trattando le caratteristiche SDF come chiavi e valori per i calcoli del prodotto scalare, costringendo così il segnale visivo ad allinearsi con il confine geometrico 3D reale nello spazio delle caratteristiche. Un grafo di adiacenza spaziale costruito a partire da nodi superpixel e caratteristiche di bordo di coplanarità spaziale viene inserito in un GCN per eseguire aggregazione di caratteristiche cross-node e passaggio di messaggi. Il processo di ottimizzazione end-to-end dei parametri impiega congiuntamente l'entropia incrociata a livello di pixel e una funzione di perdita di coerenza strutturale personalizzata, che limita e penalizza rigorosamente i pixel previsti che attraversano il confine edificio-prior. L'intera pipeline di analisi semantica è riassunta nella Figura 2, che collega l'ingresso delle immagini RGB, l'estrazione geometrica dei priori, l'allineamento di attenzioni incrociate, il ragionamento dei grafi superpixel e la decodifica delle maschere semantiche all'interno di un'architettura unificata.
Le prime reti di parsing delle scene si basavano su operazioni convoluzionali per catturare le texture dell'aspetto locale, ma a causa delle limitazioni nei campi ricettivi locali, mostravano una coerenza semantica insufficiente di bersaglisu larga scala 21,22. Studi precedenti hanno applicato il modulo di autoattenzione dell'architettura visiva Transformer per estrarre informazioni contestuali globali e costruire caratteristiche di associazione a pixel a lungadistanza 23,24. Le strategie di aggregazione di caratteristiche multi-modalità multi-modalità estraggono le caratteristiche spaziali geometriche tridimensionali della scena fondendo nubi di punti della depth map e input di comandostestuali 25,26. I meccanismi di attenzione ibridi per la fusione delle caratteristiche che mira a domini specifici sono gradualmente maturati. Costruendo ponti di interazione delle caratteristiche, hanno ridotto significativamente la perdita di energia e la scarsità delle caratteristiche nella trasmissione multi-scala di segnali visivi e hanno migliorato la robustezza dell'analisi sintetica a strutture complesse. I progetti di encoder all'avanguardia integrano e inferiscono congiuntamente dettagli spaziali in dominio ad alta frequenza insieme a caratteristiche globali e locali, rafforzando la capacità della rete di distinguere categorie semantiche a grana fine con alta somiglianza e migliorando la precisione dell'analisi sintattica interna27,28. I recenti progressi nelle architetture di segmentazione semantica forniscono preziosi riferimenti per ottimizzare l'efficienza computazionale e la percezione spaziale. I modelli progettati per la previsione densa e l'aggregazione contestuale su scala multipla estraggono caratteristiche geometriche a grana fine da sfondi complessi. Le strategie di deaccoppiamento delle caratteristiche e fusione sinergica affrontano l'ambiguità semantica nelle regioni di confine. Meccanismi di attenzione leggeri e moduli di aggregazione a gate ottimizzano la distribuzione dei parametri, accelerando così l'inferenza preservando i dettagli strutturali locali. L'implementazione di questi progetti architettonici efficienti offre una guida teorica per ridurre il sovraccarico computazionale delle operazioni di inferenza topologica non euclideane nell'analisi sintetica delle scene al chiuso.
I precedenti della struttura degli edifici e la stima del layout 3D sono utilizzati per correggere gli errori di analisi visivalocale 29. Studi precedenti hanno estratto caratteristiche geometriche ortogonali e parallele degli edifici interni come vincoli di inferenza per ridurre il bias di previsione della rete causato da sfondi internisovraccarichi 30,31. Gli schemi esistenti utilizzano algoritmi di rilevamento dei segmenti di linea e tecniche di analisi puntuale di ablazione delle immagini per generare scatole delimitanti 3D Manhattan per mappare i confini fisici delle stanze e assistere nella localizzazione delle caratteristiche visivesottostanti 32. L'architettura congiunta del modulo di consapevolezza dei contorni e del contesto multiscala incorpora implicitamente informazioni strutturali precedenti nel processo di decodifica delle caratteristiche ad alta dimensione, costringendo la rete a produrre maschere semantiche che corrispondano strettamente ai contorni fisici reali, migliorando efficacemente la frastaglia e la sfocatura dei bordi degli oggetti33. Sono stati ampiamente esplorati progetti di funzioni di perdita semi-supervisionate o debolmente supervisionate con proprietà di potenziamento dei confini. Basandosi su formule matematiche rigorose per punire comportamenti indipendenti di classificazione dei pixel che violano le regole topologiche spaziali, la fluidità geometrica e l'integrità strutturale del risultato finale della segmentazione sono garantite dalla fonte dell'ottimizzazione delgradiente 34.
Alcuni studi hanno utilizzato reti neurali a grafo per eseguire aggregazioni trasversali di caratteristiche visive e ragionamento sulle relazioni topologiche nello spazio ad altadimensione 35. L'algoritmo di segmentazione superpixel preaggrega blocchi di pixel adiacenti con caratteristiche simili di risposta cromatica e texture in nodi connessi e indipendenti. L'algoritmo di segmentazione superpixel comprime la ridondanza computazionale della struttura del grafo a livello di immagine e preserva la topologia geometrica di base dell'immagine36. Il GCN costruito sul vettore di caratteristiche nodali ad alta dimensione, e la matrice di adiacenza che rappresenta la prossimità spaziale guida la trasmissione direzionale efficiente e la fusione interattiva di informazioni visive multi-scala lungo il grafo fisicamente connesso nel dominiospaziale 37,38. L'applicazione del modulo di potenziamento temporale delle informazioni e del meccanismo ibrido di connessione a salto multiscala sopprime l'eccessivo smoothing e l'omogeneizzazione delle caratteristiche dei nodi generate nel processo di passaggio profondo multilivello39. La tecnologia di trasformata a wavelet di grafo multiscala e la strategia di ottimizzazione dell'apprendimento pseudo-etichetta ottimizzano il meccanismo anti-rumore di fondo della formula di aggiornamento delle caratteristiche dei nodi, così che le caratteristiche con gli stessi attributi semantici mantengano una modalità di risposta cooperativa nella topologia complessivadella rete 40. Il meccanismo di ragionamento basato su grafi mappa griglie di pixel regolari a spazi topologici non euclidei per eseguire calcoli di aggregazione di caratteristiche di strutture edificiali irregolari e componentiinterne 41.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
I dataset di scene RGB interne e le loro annotazioni semantiche sono stati preparati prima dell'addestramento alla rete. Il dataset 3D indoor su larga scala e il dataset RGB-D di scene interne (vedi la Tabella dei Materiali) sono stati ottenuti dai loro repository ufficiali. Le scene di acquisizione interne contenenti occlusione dei mobili, variazioni di illuminazione, interruzione dei confini muri e complessi layout spaziali sono state mantenute per adattarsi allo scenario di analisi del bersaglio. Le etichette semantiche furono convertite in maschere di annotazione PNG a canale singolo indicizzato, e tutte le immagini RGB e le maschere semantiche furono ridimensionate a 512 × 512 pixel. Durante l'addestramento è stato applicato l'aumento dei dati online, con inversione orizzontale casuale a probabilità di 0,5, scala casuale della luminosità tra 0,8 e 1,2, e rotazione casuale tra −10° e +10° per ampliare la distribuzione strutturale. I canali RGB sono stati normalizzati con valori medi di 0,485, 0,456 e 0,406 e valori di deviazione standard di 0,229, 0,224 e 0,225. Il benchmark 3D indoor su larga scala ha seguito la divisione ufficiale del rilascio utilizzata in questo studio, con 1201 scene di addestramento e 312 scene di validazione per lo sviluppo e la validazione del modello. Il benchmark RGB-D per la scena indoor ha seguito il protocollo ufficiale di valutazione, con 795 immagini di addestramento e 654 immagini di test. Non è stata applicata alcuna ulteriore suddivisione percentuale a questi due parametri di riferimento pubblici.
Una rete visiva di backbone gerarchica a trasformatori a finestra spostata (vedi la Tabella dei Materiali) fu inizializzata come backbone degli encoder a trasformatori a finestra mobile. La dimensione dell'embedding della patch era configurata come 4 x 4 pixel. Le dimensioni di embedding dei quattro stadi gerarchici furono impostate a 128, 256, 512 e 1024, e il numero di blocchi trasformatori nei quattro stadi fu impostato a 2, 2, 18 e 2. La dimensione della finestra di attenzione locale fu impostata a 7 x 7, e il numero di teste di attenzione fu impostato a 4, 8, 16 e 32 per le quattro fasi gerarchiche. Funzioni di attivazione continua non lineari venivano utilizzate all'interno di tutti gli strati di percettrone multistrato. Il downsampling spaziale veniva eseguito tramite operazioni di patch-merging con un passo di 2 dopo ogni fase gerarchica. L'architettura di rete centrale e gli iperparametri del modulo di inferenza convoluzionale sono stati riassunti nella Tabella 1.
L'estrazione delle caratteristiche di autoattenzione a finestra spostata veniva quindi eseguita sulle mappe delle caratteristiche di input. Ogni mappa delle caratteristiche era suddivisa in finestre locali non sovrapposte con dimensioni spaziali di 7 × 7. L'attenzione regolare delle finestre e quella delle finestre spostate venivano alternate tra i blocchi adiacenti dei trasformatori a finestra spostata. La distanza di spostamento ciclico fu impostata a 3 pixel e fu applicata una codifica relativa al bias posizionale all'interno di ogni finestra di attenzione locale. Le caratteristiche visive locali sono state aggregate tramite auto-attenzione multi-testa per generare rappresentazioni gerarchiche e su scala multipla.
I precedenti strutturali di Manhattan sono stati estratti da immagini RGB interne. I segmenti di bordo strutturale sono stati rilevati utilizzando un algoritmo di rilevamento dei segmenti di linea con direzione e coerenza gradiente. Le direzioni strutturali dominanti sono state raggruppate tramite un algoritmo di consenso casuale per campioni (RANSAC) (vedi la Tabella dei Materiali) basato sulla stima del punto di fuga. Tre direzioni Manhattan mutuamente ortogonali furono ricostruite per generare la rappresentazione della scatola delimitante 3D di Manhattan. Il confine strutturale ricostruito è stato convertito in una mappa SDF calcolando la distanza euclidea minima da ogni pixel al segmento di linea di confine più vicino.
Le caratteristiche di attenzione incrociata guidate dalla struttura sono state generate dopo che le caratteristiche visive e i precedenti SDF erano stati ottenuti. La varietà di caratteristiche visive è stata mappata al tensore di interrogazione Q attraverso la matrice di trasformazione lineare W subelemento Q del cappuccio a doppio coniuto R alla matrice di formazione W subelemento Q del cappuccio a doppio coniuto R alla matrice 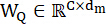 di formazione. Il campo di distanza continua a priori è stato mappato al tensore chiave K e il tensore di valore V attraverso le matrici
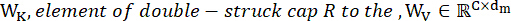 di trasformazione , e la dimensione del modello è stata impostata a 512. La modulazione multi-head divise lo spazio di proiezione in 8 sottospazi indipendenti, ciascuna con una dimensione di 64. La disposizione spaziale precedente proiettava coordinate discrete dei pixel in un campo potenziale continuo e generava la matrice di affinità strutturale S come esplicito bias spaziale additivo per modulare la matrice di similarità a prodotto scalare. Il tensore delle caratteristiche visive è stato utilizzato come sorgente della query perché l'analisi semantica richiede che ogni posizione visiva recuperi attivamente prove strutturalmente coerenti dallo spazio geometrico di prior. Il precedente SDF è stato utilizzato come fonte chiave e di valore perché memorizza la distanza continua dei confini e le indicazioni strutturali interno-esterno derivate dalla disposizione Manhattan. Il termine prodotto scalare misurava la compatibilità tra l'aspetto semantico e il prior geometrico, mentre il termine strutturale additivo λS spostava i pesi dell'attenzione verso i pixel sullo stesso piano fisico o vicino allo stesso contorno architettonico. Il coefficiente λ rappresentava la fiducia nel prior strutturale estratto e controllava fino a che punto i vincoli ortogonali rigidi venivano incorporati nella distribuzione dell'attenzione. Questa formulazione riduceva la diffusione delle caratteristiche transfrontaliere causata dall'occlusione dei mobili e manteneva il rilassamento adattivo nei layout non Manhattan. La distribuzione dell'attenzione guidata dalla struttura è stata calcolata secondo l'Equazione 1.
Equazione 1: 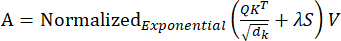
dove A indica la matrice di aggregazione dell'attenzione guidata dalla struttura, Q indica il tensore di query generato dalle caratteristiche visive, K indica il tensore chiave generato da caratteristiche precedenti SDF, V indica il tensore di valore generato da rappresentazioni priori strutturali, dk indica la dimensione delle caratteristiche del tensore chiave, λ indica il coefficiente di ponderazione strutturale adattivo usato per identificare la fiducia geometrica delle regioni locali e rilassare i vincoli ortogonali rigidi in spazi non Manhattan layout, e S indica la matrice di affinità SDF. La divisione per dk stabilì la scala dei logit di attenzione e impediva che grandi dimensioni di caratteristiche producessero pesi di attenzione eccessivamente concentrati. La funzione esponenziale normalizzata (vedi la Tabella dei Materiali) trasformava i punteggi di somiglianza modulati in una distribuzione spaziale normalizzata, permettendo a ogni pixel di aggregare informazioni a priori strutturali basate sulla consistenza semantica e geometrica. Questo design spiega perché l'aspetto visivo e i priori di confine architettonico sono fusi a livello di attenzione piuttosto che tramite concatenazione diretta di caratteristiche.
Il grafo topologico superpixel è stato costruito dalla mappa delle caratteristiche allineate alla struttura. La mappa delle caratteristiche è stata segmentata utilizzando un algoritmo di generazione di regioni spaziali. Il numero di superpixel fu impostato a 256, il coefficiente di compattezza a 10, il coefficiente di levigatura gaussiano a 1,0 e il numero di iterazione a 10. I vincoli di prossimità spaziale venivano imposti impostando il peso metrico della distanza a un rapporto costante di 1,0 rispetto alla distanza colore-spazio delle caratteristiche durante il clustering, mantenendo così una generazione uniforme dei nodi lungo i confini di clutter denso. I pixel con risposte semantiche omogenee venivano aggregati in nodi superpixel. Gli archi dei grafi sono stati costruiti in base alle relazioni di adiacenza spaziale, alla forza di affinità SDF e ai vincoli di coerenza geometrica coplanare. Il processo di costruzione della matrice di affinità strutturale e della connettività topologica è mostrato nella Figura 3, che mostra come la guida SDF sia stata trasformata in relazioni spaziali a livello di grafo.
La formulazione grafica è stata introdotta per convertire il ragionamento denso pixel a pixel in ragionamento spaziale nodo su regioni strutturali omogenee. Ogni nodo superpixel rappresentava una regione locale con risposta semantica e continuità spaziale simili, mentre ogni arco rappresentava un percorso affidabile per la trasmissione di caratteristiche soggetto a vincoli di adiacenza, affinità di campo di distanza e coerenza coplanare. Questo design ridusse l'influenza di pixel rumorosi isolati e permise a aree occlute di pareti, pavimenti e soffitti di ricevere messaggi da nodi fisicamente adiacenti. La costruzione degli archi, quindi, fungeva da ponte matematico tra la guida SDF continua e il ragionamento discreto a grafo non euclideo.
Una rete di ragionamento convoluzionale a tre livelli a grafo era configurata con dimensioni nascoste di caratteristiche 512, 256 e 128. Il livello convoluzionale del grafo eseguiva il livellamento delle caratteristiche sulla struttura del grafo basato sulle relazioni spaziali dei nodi. L'adiacenza a auto-anello manteneva lo stato originale di ciascun nodo durante il passaggio del messaggio, impedendo che le caratteristiche di una piccola regione strutturale venissero cancellate dalle grandi regioni circostanti. La normalizzazione simmetrica scalava gli elementi della matrice di adiacenza tramite il prodotto delle radici quadrate inverse dei gradi dei nodi, in modo che nodi di alto grado e basso grado contribuissero sotto magnitudini numeriche comparabili durante la propagazione. La propagazione in avanti ha eseguito un'aggregazione spaziale localizzata, in cui ogni stato del nodo ha assorbito caratteristiche ad alta dimensione da cluster coplanari adiacenti prima che fosse applicata la funzione di rettificazione non lineare elemento per elemento. Questa formulazione faceva sì che lo strato di convoluzione del grafo approssimassasse la diffusione semantica lungo piani interni fisicamente significativi, piuttosto che un levigamento illimitato attraverso i confini di oggetti non correlati. Le caratteristiche dei nodi del grafo sono state valutate secondo l'Equazione 2.
Equazione 2: 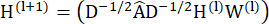
La proiezione dalle caratteristiche dense dei pixel ai nodi superpixel, il passaggio di messaggi a convoluzione di grafo e la retroproiezione delle coordinate sono presentate nella Figura 4, chiarendo il percorso di aggregazione delle caratteristiche dalle griglie d'immagine regolari a una topologia non euclidea e poi di nuovo a una rappresentazione semantica densa. La proiezione dalle caratteristiche di pixel densi nella Figura 4A ai nodi superpixel nella Figura 4B, il passaggio di messaggi a convoluzione grafica nella Figura 4C e la retroproiezione delle coordinate nella Figura 4D chiariscono il percorso di aggregazione di caratteristiche dalle griglie d'immagine regolari a una topologia non euclidea e poi di nuovo a una rappresentazione semantica densa.
dove H(l) indica il tensore delle caratteristiche del nodo del l-esimo strato di convoluzione del grafo, Â indica la matrice di adiacenza con connessioni auto-loop, D indica la matrice dei gradi corrispondente alla matrice di adiacenza, W(l) indica la matrice di pesi apprendibile dello strato di convoluzione del grafo l-esimo, e σ indica la funzione di attivazione dell'Unità Lineare Rettificata. Il termine ÂH(l) aggregava le caratteristiche dei nodi superpixel adiacenti, mentre D−1/2 e D−1/2 bilanciavano il contributo dei nodi con densità di connessione diverse. La matrice apprendibile W(l) proiettava le caratteristiche aggregate del nodo in un nuovo spazio semantico, permettendo al livello del grafo di distinguere la consistenza strutturale dalla vicidità spaziale ordinaria. L'attivazione non lineare ha preservato la differenza nelle risposte tra regioni coplanari e non coplanari dopo l'aggregazione delle caratteristiche.
Le caratteristiche di segmentazione semantica sono state decodificate dopo il ragionamento dei grafi. Il decodificatore è stato costruito utilizzando tre stadi di upsampling di interpolazione bilineare e operazioni di fusione con connessione saltata cross-layer. Le caratteristiche superficiali degli encoder spaziali venivano concatenate con caratteristiche semantiche di alto livello tramite fusione canale per canale. La risoluzione delle caratteristiche è stata ripristinata alla dimensione originale dell'immagine e la mappa finale di previsione semantica della probabilità è stata generata tramite uno strato convoluzionale 1 × 1.
La rete semantica completa di parsing è stata addestrata utilizzando un ottimizzatore di decadimento peso disaccoppiato (vedi la Tabella dei Materiali). Il tasso di apprendimento iniziale è stato impostato a 0,0001, il coefficiente di decadimento del peso a 0,01 e la dimensione del lotto a 8 per entrambi i benchmark pubblici. Il primo tasso di decadimento momentaneo fu impostato a 0,9, il secondo tasso di decadimento a 0,999 e il coefficiente numerico di stabilità epsilon fu impostato a 1 × 10⁻8. La perdita di validazione veniva monitorata alla fine di ogni epoca e i checkpoint venivano salvati quando il mIoU sul set di validazione aumentava. La rete è stata addestrata per 300 epoche utilizzando una strategia di decadimento del tasso di apprendimento polinomiale con una potenza di decadimento di 0,9. Sono state condotte cinque corse di addestramento indipendenti utilizzando diverse inizializzazioni a semi casuali per stabilire una base di valutazione statisticamente rigorosa. La rete è stata ottimizzata congiuntamente utilizzando la perdita di entropia incrociata a livello di pixel e la perdita di coerenza strutturale. Tutti gli esperimenti sono stati condotti su una piattaforma di calcolo equipaggiata con hardware di calcolo parallelo ad alta memoria, e le informazioni hardware dettagliate sono state riportate nella Tabella dei Materiali.
L'ottimizzazione congiunta ha imposto l'allineamento geometrico dei confini calcolando la grandezza del gradiente spaziale del tensore di probabilità di classe. La perdita di coerenza strutturale veniva utilizzata come regolarizzatore, moltiplicando la norma dei gradienti di previsione spaziale per i valori continui di SDF. La logica matematica era che i cambiamenti semantici delle categorie dovessero concentrarsi vicino ai contorni architettonici reali, dove la SDF si avvicina a zero, mentre gli interni piani di pareti, pavimenti e soffitti dovessero mantenere risposte semantiche fluide. Quando un grande gradiente di previsione appariva lontano da un confine strutturale, il termine del campo di distanza aumentava la penalità e scoraggiava le false transizioni semantiche all'interno di un piano fisico omogeneo. Quando appariva un gradiente di previsione vicino a un contorno di distanza zero, la penalità rimaneva limitata e preservava le legittime transizioni di classe lungo i confini architettonici. Le regioni di transizione semantiche erano vincolate ad allinearsi con i contorni a distanza zero dell'SDF, come indicato dall'Equazione 3.
Equazione 3: 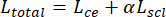
dove Ltotale indica la funzione obiettivo finale di ottimizzazione, Lce indica la perdita di entropia incrociata a livello di pixel, Lscl indica la perdita di penalità di coerenza strutturale e α indica il coefficiente di pesatura della perdita strutturale. Il termine a entropia incrociata forniva una supervisione semantica a livello di pixel tramite maschere di annotazione, mentre il termine di coerenza strutturale imponeva una regolarizzazione geometrica usando priori architettonici. Il coefficiente di pesatura α il riconoscimento bilanciato delle categorie e l'allineamento dei bordi, impedendo all'ottimizzazione di sovraattaccare sia l'accuratezza locale dell'etichetta sia i contorni strutturali rigidi. Questo obiettivo congiunto collegava semantica visiva, coerenza fisica dei confini e parametri di rete addestrabili all'interno di un obiettivo di ottimizzazione unificato.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Configurazione sperimentale
Questo studio ha utilizzato due dataset standard di analisi delle scene interne, un dataset 3D indoor su larga scala e un dataset RGB-D per scene interne, per valutare le prestazioni e perfezionare il modello. Il dataset 3D interno su larga scala contiene scene fisiche complesse scansionate realisticamente e viste RGB ad alta risoluzione, fornendo etichette semantiche 3D punt-cloud ad alta precisione, pixel per pixe...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
L'algoritmo di questo articolo accoppia strettamente le caratteristiche visive gerarchiche catturate da un encoder gerarchico a finestra spostata con la profondità precedente della scatola delimitante 3D Manhattan generata dal rilevamento di segmenti di linea, ottenendo così una ricostruzione semantica ad alta precisione di scene interne complesse. Un meccanismo di attenzione incrociata guidato dalla struttura costringe il segnale visivo ad allinearsi con il vero confine geometrico calib...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interesse finanziari.
Ringraziamenti
Finanziamento: Programma Chiave di Ricerca e Sviluppo dello Shaanxi (Programma n. 2024CY2-GJHX-76).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Riferimenti
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.