Questo protocollo descrive l'implementazione di una piattaforma web interoperabile che integra dati clinici basati su FHIR con la generazione migliorata mediante recupero e modelli linguistici di grandi dimensioni multi-agente per il supporto alle decisioni cliniche. Il flusso di lavoro consente un'implementazione riproducibile, l'integrazione standardizzata dei dati e la valutazione dell'analisi dei dati medici assistita da intelligenza artificiale (AI).
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Piattaforma Web Interoperabile Basata su Large Language Models per l'Analisi di Dati Medici: Un Protocollo per il Supporto alle Decisioni Cliniche
In questo articolo
Sommario
Abstract
Il processo decisionale clinico è spesso ostacolato da cartelle cliniche elettroniche frammentate e da una limitata interoperabilità tra sistemi eterogenei di informazione sanitaria. Questo articolo presenta un protocollo passo dopo passo per l'implementazione di una piattaforma web interoperabile che integra dati clinici attraverso lo standard Fast Healthcare Interoperability Resources (FHIR), insieme alla generazione potenziata da recupero (Retrieval-Augmented Generation, RAG), modelli linguistici di grandi dimensioni (Large Language Models, LLMs) e un framework di ragionamento clinico basato su più agenti, al fine di supportare l'analisi dei dati medici e l'assistenza decisionale clinica. Il protocollo descrive l'intero flusso di lavoro, inclusa la configurazione dell'ambiente computazionale, la pre-elaborazione dei dataset clinici, l'integrazione dei dati basata su FHIR, la costruzione di un database vettoriale, la configurazione del recupero, l'ingegnerizzazione dei prompt, l'orchestrazione multi-agente e la valutazione del sistema. I risultati rappresentativi dimostrano la capacità della piattaforma di generare risposte clinicamente rilevanti e coerenti contestualmente, migliorando nel contempo l'interoperabilità semantica tra fonti di dati eterogenee. Le prestazioni del sistema sono state valutate utilizzando metriche quantitative e semantiche complementari, tra cui BLEU, ROUGE, BERTScore e similarità coseno. È stata condotta una valutazione qualitativa mediante l'uso di dataset sanitari di riferimento pubblicamente disponibili e completamente anonimizzati, al fine di valutare la riproducibilità del flusso di lavoro metodologico proposto. L'architettura proposta combina l'interoperabilità sanitaria standardizzata con modelli linguistici potenziati dal recupero, per migliorare il ragionamento contestuale, ridurre le allucinazioni e supportare flussi di lavoro clinici assistiti dall'intelligenza artificiale riproducibili. Questo protocollo fornisce un quadro scalabile e riproducibile per ricercatori e sviluppatori che intendono implementare sistemi sanitari intelligenti, interoperabili e attenti alla privacy, destinati all'assistenza decisionale clinica, all'analisi dei dati medici e alla ricerca traslazionale futura.
Introduzione
Le informazioni sanitarie vengono generate regolarmente in ospedali, centri diagnostici, laboratori e cliniche ambulatoriali, spesso rimanendo distribuite tra sistemi eterogenei di informazione. Questa frammentazione limita l'interoperabilità e restringe l'accesso tempestivo a cartelle cliniche complete, creando sfide persistenti per l'assistenza clinica, l'integrazione dei dati e la gestione sanitaria1,2,3,4.
Le conseguenze di questa frammentazione diventano particolarmente evidenti nei flussi di lavoro clinici che dipendono da un accesso tempestivo alle informazioni del paziente. Quando i professionisti sanitari non riescono a recuperare cartelle cliniche complete e integrate, la valutazione clinica diventa più difficile, aumentando il rischio di decisioni non complete e riducendo l'efficienza dell'erogazione delle cure, in particolare in contesti di emergenza5,6.
I recenti sviluppi nell'intelligenza artificiale (AI), in particolare nei modelli linguistici di grandi dimensioni (LLMs), hanno ampliato l'insieme degli approcci computazionali disponibili per applicazioni nel settore sanitario. Questi modelli sono stati studiati in compiti come l'assistenza diagnostica, il triage clinico e il supporto decisionale. Ad esempio, Jahan et al.5 hanno valutato l'uso dei LLM in compiti biomedici, mentre Taylor et al.7 hanno analizzato modelli affinati per lo screening digitale della salute mentale, riportando risultati incoraggianti in contesti clinici specializzati.
L'applicazione dei modelli linguistici di grandi dimensioni (LLM) si è inoltre estesa a domini clinici più specializzati. Song et al. 49 ne hanno esplorato l'uso nella diagnosi della pneumoconiosi, mentre Chien et al.8 hanno applicato questi modelli per analizzare i modelli di carico di lavoro tra i caregiver informali. In oftalmologia, Xue et al.9 hanno proposto un sistema di risposta a domande per la diagnosi del glaucoma, mentre Tan et al.3 e Wu et al.10 hanno riportato l'uso degli LLM in sistemi diagnostici ibridi e nelle consulenze di medicina tradizionale cinese.
L'uso dei modelli linguistici di grandi dimensioni (LLM) non si limita alle applicazioni cliniche dirette. Zhang et al.11 ne hanno esaminato l'applicazione al riconoscimento delle emozioni in contesti legati alla salute mentale, mentre Sarzaeim et al.12 hanno analizzato sistemi di polizia intelligenti che potrebbero contribuire anche ad analisi relative alla salute pubblica. Questi studi illustrano l'ampia applicabilità degli approcci basati su LLM in diversi ambiti connessi all'assistenza sanitaria.
Sebbene i modelli linguistici di grandi dimensioni (LLM) abbiano ampliato le possibilità di applicazione nel settore sanitario, la loro integrazione negli ambienti clinici è ancora associata a importanti sfide tecniche, organizzative e normative. Il deployment pratico richiede un'adeguata infrastruttura computazionale, una governance efficace dei dati e la conformità a quadri normativi come il Regolamento Generale sulla Protezione dei Dati (GDPR) e la Legge brasiliana generale sulla protezione dei dati (LGPD). Questi quadri normativi stabiliscono requisiti per l'elaborazione sicura ed etica delle informazioni sanitarie sensibili, affrontando al contempo questioni relative alla privacy, all'affidabilità e ai bias algoritmici nei sistemi sanitari assistiti dall'intelligenza artificiale13,14 .
L'interoperabilità tra fonti eterogenee di dati sanitari, inclusi i record sanitari elettronici (EHR), i sistemi di imaging medico e i dispositivi dell'Internet delle Cose (IoT), continua a rappresentare una sfida tecnica significativa per il deployment di soluzioni sanitarie assistite dall'intelligenza artificiale. In questo contesto, framework standardizzati per l'interoperabilità come HL7 FHIR forniscono un meccanismo strutturato per lo scambio di informazioni cliniche tra sistemi diversi, mantenendo la coerenza semantica e supportando un'integrazione scalabile.
Questo lavoro presenta una piattaforma web interoperabile che integra modelli linguistici di grandi dimensioni con standard di interoperabilità sanitaria per supportare l'analisi dei dati medici in ambienti clinici eterogenei. L'architettura proposta combina l'integrazione dei dati basata su HL7 FHIR con la generazione potenziata da recupero (RAG) e un framework di elaborazione multi-agente per fornire un'analisi assistita da intelligenza artificiale sensibile al contesto, mantenendo al contempo l'allineamento con i requisiti applicabili in materia di protezione dei dati, inclusa la Legge brasiliana generale sulla protezione dei dati (LGPD).
Questo protocollo descrive un'architettura interoperabile per l'integrazione di dati clinici eterogenei mediante standard consolidati di interoperabilità sanitaria. Illustra inoltre l'implementazione di una pipeline di elaborazione multi-agente basata su modelli linguistici grandi e piccoli (LLMs e SLMs), insieme a un framework di valutazione che combina metriche quantitative e analisi qualitative per valutare il comportamento della piattaforma proposta.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio non ha previsto il reclutamento di partecipanti umani, l'accesso a record pazienti identificabili o esperimenti che coinvolgono animali. Il protocollo è stato sviluppato e valutato esclusivamente utilizzando set di dati pubblicamente disponibili e completamente anonimizzati, a scopo di validazione metodologica. Non è stata acceduta né elaborata alcuna informazione sanitaria personale. Pertanto, non è stata richiesta l'approvazione da parte di un Comitato Etico (IRB) o di un Comitato per l’Etica della Ricerca. Il protocollo è stato elaborato in conformità con i principi applicabili in materia di protezione dei dati, incluso il Regolamento Generale sulla Protezione dei Dati brasiliano (LGPD), al fine di supportare future applicazioni che coinvolgano dati clinici.
Selezione e preelaborazione del set di dati
Il protocollo proposto è stato valutato utilizzando set di dati clinici pubblici e completamente anonimizzati, comprendenti record elettronici sanitari strutturati (EHR), dati per la risposta a domande cliniche e set di dati di immagini mediche, per la validazione metodologica. Prima dell'integrazione nella piattaforma, i set di dati hanno subito procedure standardizzate di preelaborazione, incluse la normalizzazione dei dati, la rimozione di record incoerenti o incompleti, la mappatura su risorse HL7 FHIR, la pulizia del testo, la suddivisione in blocchi per il recupero e la generazione di embedding per l'indicizzazione vettoriale. Questi passaggi di preelaborazione hanno garantito coerenza semantica tra fonti di dati eterogenee, facilitando l'interoperabilità e permettendo la riproducibilità del flusso di lavoro proposto, mantenendo al contempo la conformità ai principi applicabili in materia di privacy dei dati.
I set di dati sono stati ottenuti da repository di benchmark pubblicamente disponibili, comunemente utilizzati nella ricerca sull'intelligenza artificiale e sulla salute digitale. Sono stati selezionati per rappresentare informazioni cliniche eterogenee, incluse cartelle cliniche elettroniche strutturate (EHR), narrazioni cliniche non strutturate, compiti di risposta a domande cliniche e metadati di immagini mediche. Piuttosto che valutare una specifica coorte clinica, il protocollo si concentra sulla dimostrazione di un flusso di lavoro implementativo riproducibile, adattabile a diversi set di dati sanitari. La diversità di questi set di dati di benchmark consente la validazione della pipeline di interoperabilità, della Generazione con Recupero Aumentato (RAG) e del framework di ragionamento multi-agente attraverso molteplici modalità di dati clinici.
Configurazione dell'ambiente sperimentale
L'ambiente sperimentale è stato configurato per valutare la piattaforma interoperabile in condizioni controllate e riproducibili. L'architettura comprende moduli di acquisizione dati, livelli di interoperabilità, modelli linguistici di grandi dimensioni (LLM) e componenti di valutazione organizzati in una singola pipeline di elaborazione per l'analisi dei dati medici. Figura 1 illustra l'intero flusso di lavoro, dall'acquisizione dei dati clinici alla generazione degli output diagnostici.
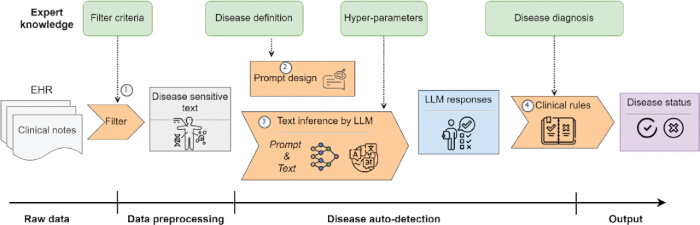
Figura 1: Flusso di lavoro complessivo del sistema che illustra la pipeline di elaborazione dai dati clinici grezzi all'output dello stato della malattia. Il processo inizia con l'acquisizione dei record elettronici di salute (EHR), seguita da filtraggio e pre-elaborazione dei dati per estrarre informazioni sensibili alla malattia. Una fase di progettazione strutturata dei prompt integra conoscenze esperte, definizioni delle malattie e iperparametri, consentendo un'interazione efficace con il modello linguistico di grandi dimensioni (LLM). L'LLM esegue un'inferenza testuale per generare risposte consapevoli del contesto, che vengono successivamente valutate attraverso regole cliniche per determinare lo stato finale della malattia. Il flusso di lavoro evidenzia l'integrazione del pre-elaborazione dei dati, dell'impiego di prompt guidati dalla conoscenza e dell'inferenza basata sull'intelligenza artificiale per supportare il processo decisionale clinico. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Architettura dell'interoperabilità sanitaria
L'infrastruttura backend adotta un'architettura modulare basata su API RESTful per supportare la comunicazione tra i componenti della piattaforma (Figura 2). Questa architettura accoglie informazioni cliniche eterogenee, inclusi referti elettronici strutturati (EHR), annotazioni dei medici e metadati derivati da sistemi di imaging medico. Poiché questi dati provengono da molteplici fonti e formati, l'interoperabilità viene garantita attraverso modelli di dati standardizzati, in particolare il framework Fast Healthcare Interoperability Resources (FHIR)15,16,17.. L'adozione di FHIR favorisce lo scambio strutturato di informazioni preservando scalabilità e flessibilità negli ambienti sanitari distribuiti. Sono stati inoltre integrati meccanismi di comunicazione basati su HL7 per facilitare l'integrazione con sistemi clinici obsoleti, ancora ampiamente utilizzati nelle istituzioni sanitarie16,17.
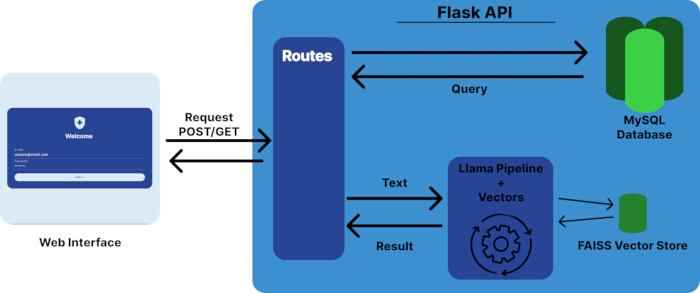
Figura 2: Architettura del sistema della piattaforma interoperabile proposta. L'interfaccia web comunica con il backend attraverso un'API Flask utilizzando richieste HTTP POST/GET. L'API gestisce il routing, l'elaborazione delle query e l'interazione con fonti di dati strutturate e non strutturate. Un database MySQL memorizza i dati clinici strutturati, mentre un archivio vettoriale basato su FAISS supporta la ricerca per similarità nelle operazioni di recupero. La pipeline basata su LLaMA elabora input testuali e genera risposte utilizzando rappresentazioni vettoriali, abilitando la generazione aumentata da recupero (Retrieval-Augmented Generation, RAG). L'architettura evidenzia l'integrazione di servizi web, gestione di database, recupero vettoriale e inferenza di modelli linguistici di grandi dimensioni in un sistema unificato. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Configurazione del flusso di lavoro multi-agente
L'architettura multi-agente è organizzata in agenti funzionali specializzati, ciascuno responsabile di una fase distinta del flusso di lavoro. Un agente di preelaborazione esegue la normalizzazione dei dati e il mapping FHIR, seguito da un agente di recupero incaricato della ricerca semantica all'interno del database vettoriale. Un agente di ragionamento integra il contesto recuperato con il modello linguistico di grandi dimensioni (LLM) per generare risposte, mentre un agente di validazione verifica la coerenza e la formattazione dell'output prima che la risposta finale venga restituita. La coordinazione tra agenti segue una strategia di orchestrazione sequenziale in cui l'output di ciascun agente funge da input per la fase successiva, garantendo un'implementazione riproducibile e modulare.
Integrazione dei dati clinici
Il livello di integrazione dei dati aggrega informazioni da più fonti cliniche e le prepara per l'elaborazione successiva. La preelaborazione include la normalizzazione dei dati, la tokenizzazione e l'allineamento delle entità per migliorare la coerenza semantica tra dataset eterogenei. Poiché le informazioni cliniche presentano variazioni nella struttura e nella qualità, queste operazioni contribuiscono a ridurre il rumore e a facilitare l'interazione con i modelli di intelligenza artificiale. Sono state inoltre applicate strategie di mappatura strutturata per armonizzare i diversi formati dei dati e mantenere la compatibilità con la pipeline di elaborazione, come illustrato in Figura 315,16,17.
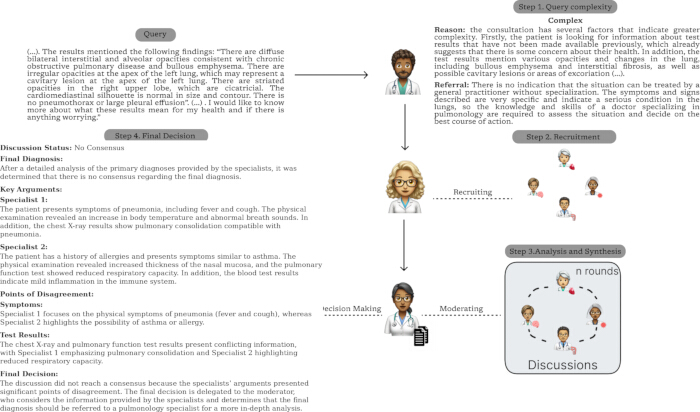
Figura 3: Esempio dettagliato del processo di ragionamento clinico multi-agente. La figura illustra come una richiesta clinica venga analizzata attraverso diverse fasi, tra cui la valutazione della complessità, il reclutamento di specialisti, la discussione collaborativa e la presa finale della decisione. Questo processo dimostra la capacità del sistema di adattare dinamicamente le strategie di ragionamento in base alla complessità della richiesta, migliorando sia l'efficienza che l'accuratezza diagnostica negli scenari di supporto alle decisioni cliniche. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Configurare la pipeline di generazione aumentata dal recupero
La generazione aumentata con recupero (Retrieval-Augmented Generation, RAG) viene integrata per fornire un'analisi consapevole del contesto combinando il recupero delle informazioni con le capacità generative dei modelli linguistici di grandi dimensioni. Le query degli utenti vengono convertite in rappresentazioni vettoriali mediante modelli di embedding e confrontate con il database vettoriale utilizzando una ricerca semantica basata sulla similarità per recuperare i passaggi contestuali più rilevanti. I documenti recuperati vengono quindi combinati con la query originale prima dell'inferenza da parte del modello linguistico (LLM). Questa strategia contribuisce a fornire informazioni contestuali durante la generazione delle risposte ed è associata a una maggiore coerenza fattuale e a una riduzione delle allucinazioni in applicazioni ad alta intensità di conoscenza, come quelle nel settore sanitario18,19. Figura 1 e Figura 3 illustrano il flusso di lavoro complessivo del recupero e il corrispondente processo di ragionamento.
Per ogni richiesta dell'utente, il prompt finale viene costruito dinamicamente combinando la query originale con i passaggi contestuali più rilevanti recuperati dal database vettoriale. Le informazioni recuperate vengono incorporate come evidenza contestuale prima dell'inferenza, consentendo al modello linguistico di generare risposte basate sulle conoscenze sanitarie recuperate, preservando al contempo la coerenza semantica e riducendo le generazioni non supportate.
Progettazione dei prompt e ragionamento multi-agente
Il protocollo incorpora strategie di sollecitazione strutturate per migliorare l'interpretazione contestuale durante la generazione delle risposte. Queste tecniche di sollecitazione, insieme a meccanismi di inferenza avanzati, aiutano a guidare il processo di ragionamento in scenari clinici complessi e sono in linea con i recenti sviluppi riportati in letteratura20.
L'architettura comprende un framework multi-agente composto da moduli specializzati che svolgono funzioni distinte all'interno della pipeline di elaborazione, tra cui convalida dei dati, filtraggio del contesto, supporto al ragionamento clinico e verifica dell'output. L'organizzazione modulare consente l'esecuzione delle attività in modo sequenziale o parallelo, offrendo flessibilità per diverse esigenze di elaborazione (Figura 4). La distribuzione di queste attività su più agenti riduce la dipendenza da un singolo modello linguistico e favorisce un flusso di lavoro di elaborazione più robusto. Questa strategia architetturale è in linea con i recenti sviluppi nell'intelligenza artificiale distribuita e nella progettazione di sistemi intelligenti21,22.
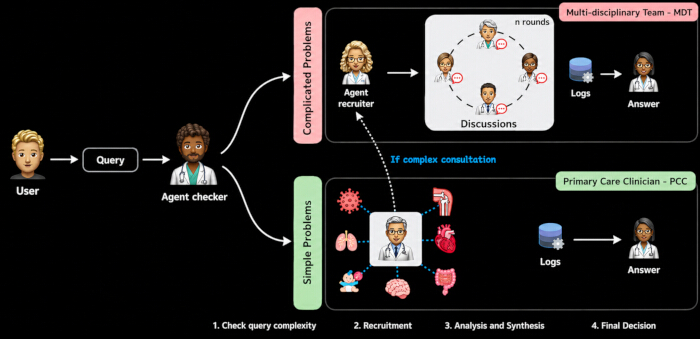
Figura 4: Architettura decisionale multi-agente per il ragionamento clinico. Il processo inizia con una richiesta da parte dell'utente, che viene valutata da un agente verificatore incaricato di determinare la complessità della richiesta. Nei casi complessi, il sistema recluta dinamicamente un team multidisciplinare (MDT) composto da agenti specializzati, che svolgono round iterativi di discussione per analizzare il problema e sintetizzare le conoscenze prima di produrre una decisione finale. Nei casi più semplici, la richiesta viene gestita da un agente medico di medicina generale (PCC), consentendo una risposta più rapida. Questa architettura adattativa bilancia efficienza e profondità analitica, migliorando la qualità delle decisioni e la scalabilità del sistema nelle applicazioni sanitarie. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Valutazione delle prestazioni
Le prestazioni del sistema sono state valutate utilizzando metriche complementari che riflettono sia la qualità linguistica sia la coerenza semantica degli output generati. Il punteggio BLEU è stato applicato per misurare la similarità sintattica in base all'overlap di n-grammi23, mentre ROUGE ha valutato il richiamo e la copertura dei contenuti, in particolare nei compiti di sintesi e estrazione delle informazioni24. La similarità semantica è stata valutata con BERTScore, che utilizza incorporamenti contestuali derivati da modelli basati su transformer per confrontare i testi generati e i testi di riferimento25. Analisi aggiuntive hanno incluso la perplessità e la similarità coseno per esaminare rispettivamente la sicurezza del modello e la coerenza semantica26,27.
Le metriche di valutazione selezionate forniscono prospettive complementari sulle prestazioni del sistema combinando analisi lessicali e semantiche. Questa combinazione è particolarmente rilevante nelle applicazioni sanitarie, dove l'interpretazione contestuale è altrettanto importante della similarità lessicale. La piattaforma è stata valutata in un ambiente computazionale controllato che supporta sia il deployment basato su cloud che quello locale. L'esecuzione locale dei modelli linguistici di grandi dimensioni (LLM) è stata inclusa come opzione per soddisfare i requisiti di privacy dei dati e ridurre la dipendenza da servizi esterni durante l'elaborazione di informazioni cliniche sensibili. Questa strategia di deployment è compatibile con i framework di protezione dei dati ed è adattabile a diversi ambienti operativi4.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Le prestazioni del sistema sono state valutate utilizzando metriche quantitative complementari insieme a un'analisi qualitativa per esaminare sia l'accuratezza linguistica che la coerenza semantica degli output generati. Questa strategia di valutazione combina misure lessicali e semantiche per fornire una caratterizzazione più ampia del comportamento del modello nei compiti di generazione del linguaggio relativi all'assistenza sanitaria.
Tabella 1 presenta i risultati quantita...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
La valutazione presentata in questo studio rappresenta una validazione metodologica effettuata utilizzando set di dati sanitari di riferimento disponibili pubblicamente e completamente anonimizzati. Non è stata condotta alcuna validazione clinica prospettica che coinvolgesse professionisti sanitari o reclutamento di pazienti, poiché l'obiettivo di questo lavoro è dimostrare un protocollo di implementazione riproducibile piuttosto che l'efficacia clinica.
I risultati di questo studio suggerisco...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto né relazioni personali che potrebbero aver influenzato il lavoro descritto nel presente manoscritto. Gli strumenti di intelligenza artificiale generativa (AI) sono stati utilizzati esclusivamente per assistere nella revisione linguistica, nella correzione grammaticale e nel miglioramento della leggibilità del manoscritto. Tutti i contenuti scientifici, la progettazione dello studio, la metodologia, l'analisi dei dati, l'interpretazione dei risultati e le decisioni editoriali sono stati sviluppati, verificati e approvati dagli autori, che si assumono la piena responsabilità del contenuto del presente manoscritto.
Ringraziamenti
Gli autori desiderano ringraziare il Laboratorio di Sistemi Embedded e Distribuiti (LESC), dell'Università Federale del Ceará (UFC), per aver fornito l'ambiente di ricerca e le discussioni tecniche che hanno sostenuto lo sviluppo di questo lavoro. Gli autori ringraziano inoltre gli sviluppatori e i responsabili della manutenzione del software open source, degli standard di interoperabilità e dei set di dati disponibili pubblicamente utilizzati durante questo studio.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Versione 1.8.0 | Database vettoriale utilizzato per la ricerca di similarità nella pipeline di Generazione Aumentata da Recupero (RAG). |
| Standard FHIR | HL7 International | Rilascio 4 (R4) | Standard di interoperabilità sanitaria adottato per lo scambio strutturato di dati clinici. |
| Flask | Pallets Projects | Versione 3.0.3 | Framework web Python utilizzato per implementare l'API backend RESTful. |
| Standard HL7 | HL7 International | Versione 2.x | Protocollo di messaggistica legacy utilizzato per l'interoperabilità con i sistemi informativi ospedalieri. |
| API REST HTTP | Implementazione personalizzata | N/D | Strato di comunicazione RESTful tra frontend, backend, database e servizi di intelligenza artificiale. |
| LangChain | LangChain Inc. | Versione 0.3.x | Framework utilizzato per integrare modelli linguistici di grandi dimensioni (LLM), ingegneria dei prompt e flussi di lavoro di Generazione Aumentata da Recupero. |
| LangGraph | LangChain Inc. | Versione 0.2.x | Framework utilizzato per orchestrare il flusso di lavoro di ragionamento clinico multi-agente. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Versione 3.1 | Modello linguistico di grandi dimensioni impiegato per il ragionamento clinico e la generazione di linguaggio naturale. |
| MySQL Community Server | Oracle Corporation | Versione 8.0 | Database relazionale utilizzato per memorizzare dati clinici strutturati. |
| Ollama | Ollama Inc. | Versione 0.9.x | Motore di inferenza locale utilizzato per eseguire modelli linguistici di grandi dimensioni preservando la privacy dei pazienti. |
| Python | Python Software Foundation | Versione 3.11 | Linguaggio di programmazione utilizzato per implementare l'intera piattaforma. |
| PyTorch | Linux Foundation | Versione 2.4 | Framework di apprendimento profondo utilizzato per l'inferenza di modelli linguistici di grandi dimensioni. |
| Pipeline di Generazione Aumentata da Recupero (RAG) | Implementazione personalizzata | N/D | Framework di intelligenza artificiale che combina recupero semantico e inferenza di modelli linguistici per la generazione di risposte consapevoli del contesto. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Modello di embedding utilizzato per generare rappresentazioni vettoriali dense a fini di recupero semantico dei documenti. |
| Ubuntu Linux | Canonical Ltd. | Versione 24.04 LTS | Sistema operativo utilizzato per lo sviluppo e la valutazione sperimentale. |
| Visual Studio Code | Microsoft Corporation | Versione 1.100 | Ambiente di sviluppo integrato utilizzato per l'implementazione e il debug del software. |
Riferimenti
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.