Questo studio presenta un framework a due stadi per la classificazione del land-cover basato su dati iperspettrali e LiDAR, che utilizza l'estrazione di caratteristiche mediante MetaFormer e un allineamento incrociato multimodale basato sul flusso bidirezionale prima della fusione. La valutazione su tre dataset pubblici di riferimento dimostra prestazioni competitive nella classificazione secondo protocolli di benchmark fissati.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Apprendimento continuo di campi vettoriali cross-modali per la classificazione della copertura del suolo tramite dati iperspettrali e LiDAR
In questo articolo
Sommario
Abstract
La classificazione multimodale mediante telerilevamento svolge un ruolo importante in applicazioni come la mappatura urbana e il monitoraggio ambientale. Tuttavia, le distribuzioni eterogenee delle caratteristiche tra le diverse modalità di rilevamento possono causare un allineamento improprio delle caratteristiche e un'incoerenza semantica, limitando l'efficacia della fusione multimodale. Gli approcci esistenti per la fusione multimodale, inclusi metodi basati su convoluzione, su grafi, su meccanismi di attenzione, contrastivi, orientati al trasporto e basati su sequenze, possono sfruttare informazioni complementari ma potrebbero non allineare adeguatamente le distribuzioni delle caratteristiche specifiche di ciascuna modalità. Questo studio propone FlowErs, un framework per la classificazione multimodale in due fasi che affronta questa sfida attraverso l'abbinamento di flussi multimodali. L'ipotesi operativa è che ridurre le discrepanze tra le distribuzioni delle caratteristiche associate prima della fusione delle caratteristiche migliori la classificazione del land-cover secondo protocolli di benchmark fissi. Nella prima fase, encoder MetaFormer specifici per ciascuna modalità estraggono rappresentazioni gerarchiche da dati di imaging iperspettrale (HSI) e di rilevamento luminoso e telemetria (LiDAR). Un modulo di abbinamento di flussi multimodali impara quindi campi di velocità condizionati al tempo per trasportare le distribuzioni delle caratteristiche associate verso una rappresentazione latente condivisa, utilizzando un obiettivo bidirezionale basato sull'errore quadratico medio. Nella seconda fase, il modulo di allineamento preaddestrato viene riutilizzato per allineare le rappresentazioni multimodali prima che una testa di fusione leggera esegua la classificazione pixel per pixel. La valutazione su tre dataset pubblici di benchmark ha dimostrato un'accuratezza complessiva massima (OA) del 97,56% con suddivisioni fisse del benchmark. Le prestazioni sono variate tra le singole classi di land-cover, e lo studio discute le limitazioni specifiche per classe e l'influenza dello squilibrio tra classi sulle metriche aggregate. L'attuale valutazione è limitata a esperimenti con suddivisioni fisse, senza analisi statistica ripetuta né profili computazionali. Lavori futuri indagheranno la robustezza statistica, l'efficienza computazionale e la generalizzazione su diverse regioni.
Introduzione
Una classificazione precisa dell'uso e del tipo di copertura del suolo (LULC) mediante immagini telerilevate è fondamentale per un'ampia gamma di applicazioni pratiche, tra cui lo sviluppo urbano, il monitoraggio ambientale, la gestione dei disastri e lo sviluppo sostenibile1. Negli ultimi anni, i dati telerilevati multimodali, inclusi quelli da immagini iperspettrali (HSI), da rilevamento luminoso e da misurazione della distanza (LiDAR) e da radar a sintesi d'apertura (SAR), sono diventati sempre più disponibili. Questa maggiore disponibilità ha ampliato notevolmente le capacità del telerilevamento per la classificazione dettagliata della copertura del suolo2. Queste modalità di rilevamento acquisiscono caratteristiche distinte ma complementari della superficie terrestre. L'HSI fornisce informazioni spettrali ricche per la caratterizzazione della composizione dei materiali, mentre il LiDAR fornisce informazioni strutturali ed altimetriche accurate3. L'integrazione di queste fonti di dati eterogenee può produrre rappresentazioni di caratteristiche più discriminanti, tolleranti al rumore e semanticamente più complete rispetto a quelle ottenibili con ciascuna singola modalità4.
Tuttavia, lo sfruttamento efficace dei dati multimodali rimane una sfida di lunga data5. Una difficoltà principale deriva dall'eterogeneità intrinseca delle modalità sensoriali, che differiscono per risoluzione spaziale, caratteristiche del rumore, distribuzioni statistiche e semantica delle caratteristiche6. Ad esempio, lo stesso oggetto di copertura del suolo può essere rappresentato come una firma spettrale ad alta dimensionalità nell'HSI e come strutture geometriche sparse nel LiDAR7. Di conseguenza, le caratteristiche specifiche di ciascuna modalità risiedono spesso in varietà di caratteristiche diverse, rendendo inefficiente o potenzialmente fuorviante la fusione diretta delle caratteristiche. Inoltre, molti approcci esistenti di fusione multimodale, inclusi metodi basati su convoluzione, attenzione e Transformer, assumono implicitamente che le caratteristiche estratte da sensori diversi siano già allineate spazialmente e semanticamente8. Tuttavia, tale assunzione spesso non è valida nelle applicazioni pratiche. Una semplice concatenazione delle caratteristiche o una fusione pixel per pixel non riesce a catturare adeguatamente le discrepanze intermodali, con il rischio di un'ottimizzazione instabile e di una ridotta capacità di generalizzazione. Inoltre, sebbene i metodi di fusione basati sull'attenzione migliorino l'interazione tra caratteristiche, potrebbero offrire una modellizzazione limitata delle dipendenze intermodali a lungo raggio necessarie per la classificazione della copertura del suolo su larga scala o ad alta risoluzione9. Di conseguenza, l'allineamento efficace delle rappresentazioni eterogenee delle caratteristiche rimane una sfida fondamentale nel telerilevamento multimodale, poiché embedding incompatibili possono limitare l'integrazione di informazioni complementari.
Per affrontare questa sfida, l'allineamento multimodale viene formulato come un problema di trasporto di caratteristiche condizionale. Il flow matching fornisce un quadro matematicamente fondato per apprendere mappe continue e invertibili tra distribuzioni di caratteristiche eterogenee10. Esso trasporta una distribuzione verso un’altra attraverso un campo di velocità dipendente dal tempo, parametrizzato da un’equazione differenziale ordinaria (ODE), promuovendo così trasformazioni continue tra varietà di caratteristiche11. A differenza dei modelli basati sulla diffusione, che si affidano a perturbazioni stocastiche di rumore o al confronto implicito delle distribuzioni tramite addestramento avversario, il flow matching apprende trasformazioni deterministiche e biunivoche tra spazi strutturati di caratteristiche12. Queste caratteristiche rendono il flow matching particolarmente adatto al telerilevamento multimodale, in cui HSI, LiDAR e SAR rappresentano ciascuno varietà di caratteristiche ad alta dimensione che catturano proprietà complementari della superficie terrestre13. Di conseguenza, il flow matching offre un approccio rigoroso per stabilire corrispondenze tra modalità diverse mediante il trasporto continuo di caratteristiche, promuovendo al contempo la coerenza geometrica durante l’allineamento delle caratteristiche. Sotto appropriate ipotesi di regolarità, un flusso ODE può fornire una mappa invertibile; tuttavia, l’invertibilità esatta e l’interpretabilità fisica non sono state valutate empiricamente nel presente studio. L’ipotesi di lavoro è che ridurre le discrepanze tra distribuzioni di caratteristiche accoppiate prima della fusione delle caratteristiche migliori la classificazione complessiva del tipo di copertura del suolo in scenari di benchmark fissati.
Motivati da queste considerazioni, il framework proposto, FlowErs, incorpora una fase di allineamento basata sui flussi all'interno di un'architettura a due stadi. Nel primo stadio, una rete bidirezionale di flussi viene addestrata per allineare le varietà di caratteristiche di ciascuna modalità. In particolare, architetture MetaFormer specifiche per ogni modalità estraggono rappresentazioni gerarchiche delle caratteristiche, e un obiettivo di corrispondenza del flusso viene ottimizzato per trasportare campioni tra le distribuzioni di caratteristiche specifiche per modalità. Questo processo fornisce una trasformazione liscia e invertibile tra gli spazi delle caratteristiche, favorendo un allineamento più stretto delle rappresentazioni appartenenti alla stessa classe semantica all'interno di un dominio latente condiviso. Nel secondo stadio, l'allineatore di flusso preaddestrato viene bloccato e nuovi ingressi multimodali vengono trasformati prima di essere fusi da un classificatore leggero. Questa strategia di addestramento disaccoppiata separa l'allineamento geometrico dalla classificazione semantica, consentendo ai due stadi di ottimizzare obiettivi complementari. Il modulo di allineamento ha lo scopo di ridurre le discrepanze tra le distribuzioni delle caratteristiche prima della fusione delle caratteristiche e non afferma una garanzia dimostrata di conservazione del volume. Inoltre, FlowErs fornisce una formulazione esplicita per il trasporto delle caratteristiche nella fusione multimodale, sebbene la robustezza agli errori di registrazione non sia stata valutata separatamente nel presente studio.
I principali contributi di questo studio sono riassunti come segue. Viene introdotto FlowErs come un framework in due fasi per la classificazione multimodale del land-cover. Nel framework proposto, le caratteristiche specifiche di ciascuna modalità vengono innanzitutto estratte utilizzando encoder di tipo MetaFormer e successivamente allineate attraverso un modulo basato sui flussi, prima di una fusione leggera delle caratteristiche. Questo design disaccoppiato supporta un'ottimizzazione efficiente mantenendo al contempo flessibilità tra diverse modalità di rilevamento. Inoltre, questo studio analizza il conditional flow matching come meccanismo di trasporto delle caratteristiche per l'allineamento incrociato di coppie di caratteristiche multimodali nel telerilevamento. Il modulo di flusso bidirezionale predice obiettivi di velocità opposti per le rappresentazioni in coppia delle caratteristiche prima della fusione, fornendo così una strategia esplicita di allineamento precedente all'integrazione multimodale. Inoltre, il framework proposto viene valutato su tre dataset pubblici di riferimento, raggiungendo un'accuratezza complessiva massima (OA) del 97,56% nei fissi suddivisori di benchmark forniti. Vengono inoltre documentati esplicitamente i limiti a livello di classe e l'ambito della valutazione attuale.
I recenti progressi nel campo del flow matching lo hanno affermato come un potente framework per la modellazione generativa, in grado di unificare modelli basati su diffusione, energia e trasporto. A differenza dei modelli a diffusione, che simulano traiettorie stocastiche, il flow matching apprende un'ODE deterministica che trasporta una semplice distribuzione a priori, come un rumore gaussiano, verso la distribuzione dei dati target attraverso un campo di velocità apprendibile15. Questa formulazione collega direttamente la stima del punteggio (score) all'evoluzione della densità, producendo traiettorie probabilistiche più lisce e una dinamica di addestramento più stabile. Un vantaggio fondamentale del flow matching è la sua formulazione deterministica ed efficiente dal punto di vista computazionale. I modelli a flusso rettificato16 semplificano ulteriormente le traiettorie di trasporto rendendole quasi lineari, migliorando la stabilità numerica e permettendo la generazione di campioni di alta qualità con un numero relativamente ridotto di passi di integrazione. Studi successivi, tra cui i modelli di coerenza (consistency models)17, hanno integrato obiettivi ispirati alla diffusione in architetture compatte basate sul flusso, ottenendo una qualità del campionamento paragonabile o migliore con un'inferenza efficiente. Inoltre, l'addestramento basato sul flusso può sfruttare architetture preaddestrate di tipo diffusivo, facilitando l'uso di priori generativi su larga scala riducendo al contempo i costi di campionamento. Ricerche recenti hanno esteso il flow matching a un'ampia gamma di applicazioni. Ad esempio, Hu et al.18 hanno studiato architetture transformer e manipolazioni nello spazio latente per un editing di immagini controllabile e componibile mediante flow matching. Altre applicazioni includono la sintesi di immagini19, la diagnostica dei guasti nei cuscinetti20 e la saldatura robotica multimateriale e multigiunto21. Nel complesso, questi studi dimostrano che il flow matching è applicabile non solo alla sintesi di immagini ad alta risoluzione e condizionata, ma offre anche una solida base teorica con potenziale di generalizzazione a diversi domini. Apprendendo mappe di trasporto continue e deterministiche, il flow matching garantisce un equilibrio tra efficienza, controllabilità e fedeltà generativa. La sua formulazione basata su ODE fornisce una visione unificata della modellazione generativa moderna e costituisce una base teorica per applicazioni che coinvolgono la rappresentazione di dati multimodali e l'allineamento delle caratteristiche.
La classificazione multimodale tramite telerilevamento mira a superare i limiti delle singole modalità di rilevamento integrando informazioni complementari provenienti da HSI, immagini multispettrali, LiDAR e SAR. Gli approcci di fusione precoce si basavano su caratteristiche progettate manualmente o su algoritmi basati su kernel, come le macchine a vettori di supporto (SVM), ma erano limitati dall'elevata dimensionalità e da un'interazione insufficiente tra le modalità22. I progressi nell'apprendimento profondo hanno reso possibili strategie di fusione strutturate, comprese la fusione precoce, intermedia e tardiva, con la fusione a livello di caratteristiche che offre un equilibrio pratico tra integrazione delle informazioni e complessità computazionale23. Le reti neurali convoluzionali (CNN) catturano efficacemente informazioni spaziali e spettrali locali, mentre le architetture basate su Transformer modellano dipendenze a lungo raggio a un costo computazionale maggiore24. Di conseguenza, le architetture ibride CNN–Transformer sono diventate sempre più popolari poiché combinano i punti di forza complementari di entrambi gli approcci. Esempi rappresentativi includono metodi di fusione a scale adiacenti che potenziano le informazioni contestuali attraverso interazioni tra scale diverse25 e framework multilivello che combinano caratteristiche CNN superficiali con rappresentazioni profonde basate su Transformer mediante meccanismi di attenzione adattivi26. Nel complesso, questi studi evidenziano l'importanza di un'efficace interazione tra scale e modalità diverse per ridurre la ridondanza delle caratteristiche e migliorare la rappresentazione semantica.
Sviluppi recenti hanno inoltre esplorato strategie complementari per l'apprendimento multimodale. Ad esempio, metodi di rappresentazione a rango ridotto, come il framework guidato dalla curva di Ebbinghaus, riducono l'overfitting preservando la struttura della varietà mentre sopprimono informazioni ridondanti27. Parallelamente, è stato studiato l'apprendimento multimodale distribuito per affrontare vincoli di privacy e comunicazione nelle applicazioni pratiche. Ad esempio, FedFusion proietta caratteristiche superficiali in sottospazi a rango ridotto per consentire l'apprendimento multimodale federato28. Nel complesso, questi studi illustrano tre direzioni di ricerca complementari: architetture ibride CNN–Transformer per bilanciare la modellizzazione delle caratteristiche locali e globali, apprendimento a rango ridotto per ridurre ridondanza e rumore, e apprendimento distribuito per un'implementazione scalabile e riservata. Tuttavia, permangono sfide importanti, tra cui lo squilibrio tra modalità, la limitata disponibilità di dati etichettati e il compromesso tra compressione del modello e accuratezza della classificazione. Queste sfide hanno motivato ulteriori ricerche su framework di fusione multimodale leggeri e generalizzabili. Approcci recenti di allineamento multimodale hanno inoltre incorporato attenzione incrociata, apprendimento contrastivo, fusione basata su grafi, adattamento del dominio e strategie di abbinamento delle distribuzioni. Al contrario, FlowErs formula l'allineamento multimodale come un trasporto di caratteristiche accoppiate e condizionato al tempo, ed è presentato come una strategia di allineamento complementare piuttosto che come una sostituzione universale degli approcci esistenti.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato esclusivamente set di dati di riferimento disponibili pubblicamente (Houston2013, Augsburg e MUUFL) per la classificazione del land-cover mediante telerilevamento. Non sono stati coinvolti partecipanti umani, esperimenti su animali o campioni biologici appena raccolti. Pertanto, non è stata richiesta l'approvazione etica da parte dell'istituto.
Panoramica dello studio
Il framework proposto FlowErs esegue la classificazione multimodale del land-cover attraverso una strategia di apprendimento in due fasi. Il flusso di lavoro complessivo è illustrato in Figura 1A–C. Il framework comprende tre componenti principali: (i) encoder basati su MetaFormer che estraggono rappresentazioni gerarchiche delle caratteristiche da modalità sensoriali eterogenee, (ii) un modulo di corrispondenza del flusso multimodale (MFM) che allinea esplicitamente le distribuzioni delle caratteristiche intermodali e (iii) un head di classificazione leggero che predice le categorie di land-cover a partire dalle rappresentazioni delle caratteristiche fuse. Il flusso di lavoro complessivo estrae innanzitutto caratteristiche specifiche per ogni modalità, successivamente allinea tali caratteristiche all'interno di uno spazio latente condiviso mediante corrispondenza del flusso condizionale e infine esegue la classificazione del land-cover a livello di pixel utilizzando le rappresentazioni multimodali allineate.
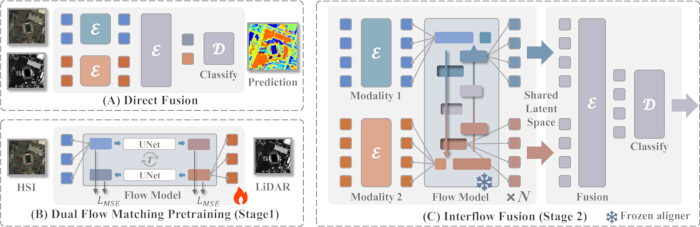
Figura 1: Panoramica del framework FlowErs proposto per la classificazione multimodale del land-cover. (A) Fusione diretta convenzionale di caratteristiche, in cui le caratteristiche specifiche della modalità estratte da immagini iperspettrali (HSI) e dati di rilevamento luminoso e distanza (LiDAR) vengono concatenate direttamente prima della classificazione. (B) Fase 1: Pre-addestramento bidirezionale con abbinamento del flusso multimodale. Una U-Net condizionata al tempo apprende il trasporto continuo bidirezionale tra rappresentazioni di caratteristiche specifiche della modalità utilizzando una perdita del tipo errore quadratico medio per allineare distribuzioni di caratteristiche eterogenee. (C) Fase 2: Fusione Interflow. Il modulo pre-addestrato per l'abbinamento del flusso viene congelato e riutilizzato per allineare le rappresentazioni di caratteristiche specifiche della modalità prima della fusione leggera delle caratteristiche e della classificazione del land-cover a livello di pixel. E, encoder; D, decoder; T, embedding temporale; , perdita del tipo errore quadratico medio; S, rappresentazione latente condivisa. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Il framework proposto separa l'allineamento delle caratteristiche dalla classificazione semantica attraverso una strategia di addestramento in due fasi. Nella prima fase, il modulo MFM viene addestrato per apprendere il trasporto bidirezionale delle caratteristiche tra varietà di caratteristiche specifiche per ciascuna modalità. Nella seconda fase, il modulo di allineamento preaddestrato viene bloccato e riutilizzato per allineare le rappresentazioni delle caratteristiche multimodali prima della fusione leggera e della classificazione. Questo design disaccoppiato consente al modulo di allineamento e alla rete di classificazione di ottimizzare obiettivi complementari riducendo al contempo le discrepanze nella distribuzione delle caratteristiche prima della fusione multimodale.
Panoramica teorica
L'abbinamento di flusso è un paradigma di modellazione generativa recentemente proposto che apprende una trasformazione deterministica continua tra due distribuzioni di probabilità. A differenza dei modelli basati sulla diffusione, che introducono stocasticità attraverso perturbazioni di rumore, l'abbinamento di flusso parametrizza direttamente un campo di velocità apprendibile che trasporta in modo continuo una distribuzione di probabilità verso un'altra. Questa formulazione di trasporto continuo consente l'allineamento delle caratteristiche attraverso un'ODE, permettendo alle rappresentazioni delle caratteristiche accoppiate provenienti da diverse modalità sensoriali di evolvere lungo una traiettoria condivisa prima della fusione delle caratteristiche. Nel presente studio, l'abbinamento di flusso condizionato viene adottato per apprendere il trasporto bidirezionale delle caratteristiche tra incorporamenti specifici della modalità estratti dai codificatori MetaFormer. Il modello viene addestrato utilizzando un obiettivo condizionato di abbinamento di flusso che minimizza la discrepanza tra i campi di velocità previsti e quelli target su rappresentazioni delle caratteristiche interpolate. La formulazione matematica completa, la derivazione teorica, le equazioni di governo e l'obiettivo di addestramento sono forniti nel Supplementary File 1.
Formulazione del problema
La classificazione della copertura del suolo a partire da dati telerilevati multimodali implica l'apprendimento di rappresentazioni semantiche da modalità di rilevamento eterogenee, come l'HSI e il LiDAR. Queste modalità presentano caratteristiche di rilevamento distinte. L'HSI acquisisce informazioni spettrali ricche con centinaia di canali ( ), mentre il LiDAR fornisce informazioni strutturali dettagliate con un numero relativamente ridotto di canali (
 ). Questo squilibrio tra ricchezza spettrale e sparsità strutturale crea un significativo divario di dominio nelle distribuzioni delle caratteristiche, rendendo la fusione diretta delle caratteristiche subottimale e potenzialmente instabile.
Formalmente, data una coppia di input multimodali, 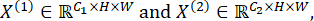 l'obiettivo è prevedere una mappa semantica a livello di pixel secondo Equation 1:
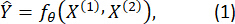
Qui, 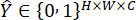 è il tensore delle etichette codificate in modalità one-hot, C indica il numero totale di categorie di copertura del suolo e θ rappresenta tutti i parametri apprendibili del modello. Il dataset Houston2013 ha una dimensione dell'immagine di 349 × 1905 pixel con 144 bande iperspettrali (HSI) e 1 banda LiDAR. Il dataset Augsburg ha una dimensione dell'immagine di 1152 × 480 pixel con 224 bande HSI e 1 banda LiDAR. Il dataset MUUFL ha una dimensione dell'immagine di 325 × 220 pixel con 64 bande HSI e 2 bande LiDAR. Per tutti i dataset, le porzioni d'immagine in ingresso sono state ridimensionate a 32 × 32 pixel prima dell'addestramento.
Gli approcci multimodali convenzionali fondono caratteristiche specifiche delle singole modalità mediante concatenazione o meccanismi di attenzione, assumendo implicitamente che le diverse modalità risiedano in uno spazio di caratteristiche compatibile. Tuttavia, questa ipotesi raramente è valida per i dati telerilevati, poiché le distribuzioni statistiche specifiche delle modalità e le caratteristiche spettrali-spaziali differiscono notevolmente.
Per colmare esplicitamente questa discrepanza, viene introdotto un modulo di abbinamento del flusso,  . Il modulo è parametrizzato da
 e apprende trasformazioni continue bidirezionali tra varietà di caratteristiche specifiche per modalità. In particolare (Equazione 2),
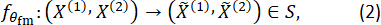
Qui, S indica lo spazio latente condiviso in cui le rappresentazioni delle caratteristiche specifiche per ogni modalità sono allineate geometricamente. Successivamente, le rappresentazioni delle caratteristiche allineate vengono fuse e classificate secondo Equazione 3 come segue:
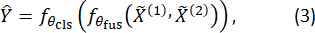
Qui,  e
 indicano rispettivamente i moduli di fusione delle caratteristiche e di classificazione. Questa formulazione definisce l'intero framework FlowErs. Piuttosto che basarsi esclusivamente su una fusione statistica implicita delle caratteristiche, il framework proposto introduce un meccanismo esplicito di allineamento basato sui flussi, che trasporta continuamente le rappresentazioni delle caratteristiche specifiche per ogni modalità in uno spazio latente condiviso, prima della fusione multimodale delle caratteristiche e della previsione semantica.
Codificatore MetaFormer
FlowErs esegue l'allineamento delle caratteristiche cross-modale utilizzando encoder leggeri specifici per ogni modalità, che apprendono rappresentazioni di caratteristiche informative e geometricamente coerenti da ciascuna modalità di rilevamento. Come illustrato nella Figura 2, ciascuna modalità viene elaborata da un encoder indipendente basato sull'architettura MetaFormer. MetaFormer generalizza il design fondamentale del Transformer separando il mescolamento dei token dalla trasformazione dei canali, senza calcolare esplicitamente l'auto-attenzione. Questa architettura consente un'elaborazione efficiente di HSI ad alta dimensione, mantenendosi adattabile a modalità con pochi canali come LiDAR.
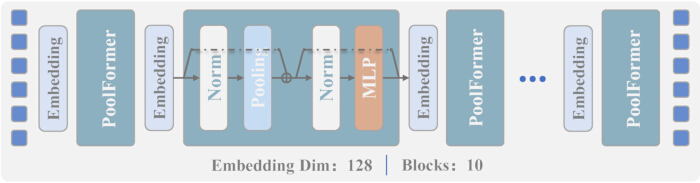
Figura 2: Architettura dell'encoder MetaFormer specifico per modalità utilizzato nel framework proposto FlowErs. L'encoder trasforma gli ingressi specifici per modalità in rappresentazioni gerarchiche di caratteristiche attraverso ripetuti blocchi di embedding e blocchi PoolFormer. Ogni blocco PoolFormer è composto da normalizzazione, mescolamento di token basato sul pooling, aggiunta residuale, normalizzazione e un percettrone multistrato (MLP). Le rappresentazioni gerarchiche di caratteristiche risultanti vengono inviate al modulo di abbinamento del flusso multimodale per l'allineamento delle caratteristiche tra modalità. Norm, normalizzazione; MLP, percettrone multistrato. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Per ogni modalità  , l'encoder MetaFormer
 , trasforma l'ingresso
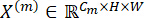 in una gerarchia di rappresentazioni latenti delle caratteristiche (Equation 4):
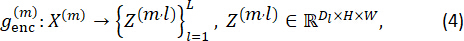
In questo caso, L indica il numero totale di stadi dell'encoder e Dl indica la dimensione dell'embedding nello stadio l. L'encoder MetaFormer comprende tre stadi (N = 3) con dimensioni di embedding rispettivamente di 64, 128 e 256. I corrispondenti numeri di blocchi PoolFormer in ciascuno stadio sono 2, 6 e 2, seguendo l'architettura gerarchica progressiva descritta nel manoscritto.
Ogni encoder inizia con una convoluzione 1 × 1 che proietta i canali di ingresso in uno spazio di embedding comune (Equazione 5):
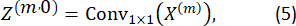
A questo strato di proiezione seguono L blocchi MetaFormer impilati. Ciascun blocco comprende due operazioni residue: (i) mescolamento dei token mediante pooling spaziale per aggregare le informazioni contestuali e (ii) trasformazione dei canali tramite un percettrone multistrato (MLP) per affinare le rappresentazioni delle caratteristiche spettrali e spaziali. Queste operazioni sono espresse mediante le Equazioni 6 e 7 come segue:
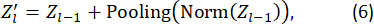

Qui, Pooling(·) indica l'aggregazione del contesto spaziale basata sul raggruppamento medio e MLP(·) indica una rete feed-forward convoluzionale a due strati che incorpora l'attivazione GELU e la regolarizzazione tramite dropout.
L'encoder segue un'architettura gerarchica in cui la dimensione dell'embedding aumenta progressivamente attraverso le fasi successive (ad esempio, 64  128 256). Questo design progressivo consente ai livelli più profondi di codificare informazioni spaziali e spettrali sempre più ricche, migliorando al contempo la capacità rappresentativa delle caratteristiche apprese. L'implementazione utilizza un kernel di pooling 3 × 3, una dimensione nascosta dell'MLP pari a 128 e una percentuale di dropout pari a 0,1. Tutti i livelli convoluzionali all'interno dell'encoder MetaFormer utilizzano kernel 1 × 1 con uno stride pari a 1 e senza padding. L'operatore di pooling utilizza un pooling medio 3 × 3 con uno stride pari a 1 e un padding pari a 1. La normalizzazione del batch (BatchNorm2d) viene utilizzata in tutto l'encoder. L'MLP ha una dimensione nascosta di 128, impiega la funzione di attivazione GELU e utilizza una percentuale di dropout pari a 0,1. Le tre fasi dell'encoder contengono rispettivamente 2, 6 e 2 blocchi PoolFormer, e queste impostazioni architetturali vengono applicate in modo coerente in tutte le fasi.
Rispetto agli encoder basati su Transformer, l'encoder MetaFormer elimina il costo computazionale quadratico associato all'autoattenzione, riducendo al contempo il bias specifico della modalità durante l'estrazione delle caratteristiche. Il suo miscelatore di token basato su pooling aggrega in modo efficiente il contesto spaziale locale, mentre l'allineamento multimodale viene successivamente eseguito dal modulo di corrispondenza del flusso. Di conseguenza, le rappresentazioni delle caratteristiche di livello più elevato prodotte dall'encoder forniscono input semanticamente informativi e geometricamente coerenti per l'allineamento delle caratteristiche multimodali.
Corrispondenza Multimodale del Flusso
La sfida principale successiva all'estrazione delle caratteristiche è l'allineamento di rappresentazioni eterogenee delle caratteristiche provenienti da diverse modalità sensoriali che risiedono su varietà di caratteristiche differenti. La concatenazione diretta di  e
 spesso dà prestazioni scadenti a causa di distribuzioni delle caratteristiche non coerenti e di bias specifici della modalità. FlowErs affronta esplicitamente questa sfida introducendo un modulo MFM che apprende trasformazioni continue e bidirezionali tra i due spazi delle caratteristiche, come illustrato concettualmente nella Figura 1B.
Sia 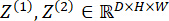 a indicare le rappresentazioni delle caratteristiche estratte dagli encoder MetaFormer. Un campo di flusso continuo parametrizzato dal tempo di interpolazione
 viene definito utilizzando l'Equazione 8 come segue:
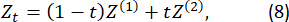
In questo caso, t = 0 corrisponde alla modalità sorgente e t = 1 corrisponde alla modalità bersaglio.
Il modello di corrispondenza del flusso, , è implementato come una U-Net condizionata al tempo che predice il campo di velocità istantaneo che governa la trasformazione lungo questa traiettoria di interpolazione. Ogni predittore di flusso comprende tre blocchi di sottocampionamento (64 128 256 512) e tre corrispondenti blocchi di sovracampionamento (512 256 128 64) che utilizzano convoluzioni 3 × 3, normalizzazione del batch e attivazione mediante unità lineare rettificata (ReLU). Gli embedding intermedi temporali hanno rispettivamente dimensioni 128, 256, 512, 256 e 128. L'embedding temporale utilizza una codifica posizionale sinusoidale fissa. L'integrazione dell'ODE viene eseguita mediante il metodo di Eulero in avanti con un passo fisso. Durante l'addestramento, il numero di passi di integrazione è stato impostato a 6, mentre durante l'inferenza sono stati utilizzati per impostazione predefinita 5 passi di integrazione. Il numero effettivo di iterazioni del ciclo di integrazione è calcolato come 
Il campo di velocità previsto è dato dalla Equazione 9 come segue:
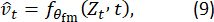
Qui,  indica la velocità istantanea predetta. Il modello apprende ad approssimare lo spostamento
 incoraggiando così trasformazioni continue tra spazi di caratteristiche specifici per ciascuna modalità. L'obiettivo di apprendimento è formulato come una perdita bidirezionale condizionata al tempo basata sull'errore quadratico medio (MSE), come segue (Equazione 10):
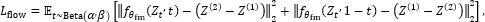 (10)
Il campionamento di t a partire dalla distribuzione Beta specificata espone il modello a stati intermedi di interpolazione, ma non stabilisce una consistenza esatta del ciclo. A differenza dei metodi di allineamento basati sulla diffusione, la formulazione proposta di corrispondenza del flusso è deterministica, non richiede campionamento stocastico durante l'inferenza ed è addestrabile sia con dati etichettati che non etichettati.
Un modello di flusso addestrato funge successivamente da operatore di allineamento deterministico che proietta le rappresentazioni delle caratteristiche specifiche della modalità in uno spazio latente condiviso S. Le rappresentazioni allineate si ottengono come segue (Equazione 11):
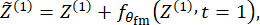
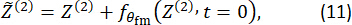
Qui,  e
 indicano le rappresentazioni delle caratteristiche allineate. L'allineamento basato sul flusso viene applicato alle rappresentazioni intermedie delle caratteristiche provenienti dalle prime due fasi dell'encoder (Fasi 1 e 2), con dimensioni dell'embedding rispettivamente di 64 e 128. Le caratteristiche dell'encoder di livello più alto (Fase 3, dimensione dell'embedding 256) non vengono elaborate dal modulo di corrispondenza del flusso. Invece, queste caratteristiche vengono concatenate direttamente e trasmesse al classificatore per la previsione multimodale.
Questo meccanismo di allineamento bidirezionale trasporta progressivamente le rappresentazioni delle caratteristiche specifiche per ogni modalità verso uno spazio latente condiviso attraverso un campo di flusso continuo. Di conseguenza, e risultano più strettamente allineati prima della fusione delle caratteristiche multimodali, fornendo rappresentazioni di caratteristiche semanticamente coerenti e geometricamente compatibili per la classificazione successiva.
Percorso di formazione
FlowErs sfrutta sia dati etichettati che non etichettati mantenendo un allineamento stabile tra le modalità attraverso una strategia di addestramento in due fasi, come illustrato in Figura 1(B,C). Durante la prima fase, un modulo di allineamento invariante rispetto alla modalità viene appreso mediante abbinamento di flusso non supervisionato. Durante la seconda fase, viene effettuata una classificazione supervisionata utilizzando le rappresentazioni latenti allineate, riutilizzando al contempo il modulo di allineamento del flusso preaddestrato.
Fase 1: Preaddestramento senza supervisione basato sul flusso
Dati coppie di immagini multimodali,  rappresentazioni delle caratteristiche specifiche della modalità,
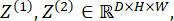 sono estratte utilizzando gli encoder MetaFormer. Le rappresentazioni intermedie delle caratteristiche sono generate mediante l'interpolazione definita nell'Equazione 8, dove
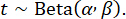 Il modulo di corrispondenza del flusso,
 , viene ottimizzato minimizzando l'obiettivo condizionato bidirezionale definito nell'Equazione 10, senza utilizzare etichette di classe. In questa fase, vengono aggiornati soltanto i parametri della corrispondenza del flusso,
 , consentendo al modello di apprendere corrispondenze consapevoli della geometria sia da campioni etichettati che non etichettati, prima della classificazione supervisionata. La Fase 1 (pre-addestramento della corrispondenza del flusso) è stata eseguita utilizzando l'ottimizzatore AdamW con un tasso di apprendimento di 1 × 10⁻4, un decadimento del peso di 1 × 10⁻2 e un programma di annealing coseno per il tasso di apprendimento. Sono state utilizzate dimensioni di batch pari a 16 per i dataset Houston2013 e Trento, mentre dimensioni di batch pari a 32 sono state utilizzate per i dataset Augsburg e MUUFL. Il modulo di corrispondenza del flusso è stato pre-addestrato per 2.000 epoche utilizzando sia campioni etichettati che non etichettati. Il seme casuale è stato fissato a 3407. Tutti gli esperimenti sono stati condotti utilizzando PyTorch su una singola GPU NVIDIA A100 (80 GB di memoria).
Fase 2: Classificazione supervisionata con un allineatore condiviso
Il modulo preaddestrato di corrispondenza del flusso viene riutilizzato durante l'addestramento supervisionato ed è applicato alle prime due fasi dell'encoder anziché a tutti i livelli di caratteristiche. Le rappresentazioni delle caratteristiche allineate vengono successivamente fuse utilizzando il classificatore finale per generare previsioni a livello di pixel. L'ottimizzazione supervisionata minimizza la perdita di entropia incrociata mascherata (Equazione 12):
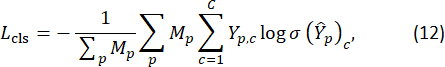
Qui, M indica la maschera delle etichette, Y indica le etichette di verità fondamentale codificate in formato one-hot e σ(·) indica la funzione softmax. Durante la Fase 2 (addestramento supervisionato), il modulo preaddestrato per il matching del flusso è rimasto completamente congelato e ha funto da operatore fisso di allineamento cross-modale. I suoi pesi preaddestrati sono stati caricati all'inizio della Fase 2 e non sono stati aggiornati durante l'addestramento supervisionato. Sono stati ottimizzati solo i parametri dell'encoder MetaFormer e del classificatore. L'addestramento supervisionato è stato eseguito utilizzando l'ottimizzatore AdamW con tassi di apprendimento specifici per ciascun dataset: 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) e 1 × 10⁻5 (Trento). Il decay del peso è stato impostato a 1 × 10⁻2 per tutti i dataset, tranne che per MUUFL, per il quale è stato utilizzato un valore di 5 × 10⁻2. Sono state utilizzate dimensioni del batch pari a 16 o 32, a seconda del dataset. I modelli sono stati addestrati per 100 epoche (Houston2013 e MUUFL), 200 epoche (Augsburg) e 20 epoche (Trento) mediante una pianificazione del tasso di apprendimento con annealing coseno. È stata utilizzata CrossEntropyLoss con riduzione media come funzione di perdita. Non è stato applicato alcun arresto anticipato; invece, è stato selezionato come modello finale il checkpoint del modello che ha raggiunto la massima accuratezza complessiva (OA) sul test set. Il flusso di lavoro completo dell'implementazione della procedura di addestramento in due fasi è riassunto in File Supplementare S1 (Algoritmo S1).
Questa strategia di addestramento disaccoppiata separa l'allineamento geometrico dalla discriminazione semantica. Nella Fase 1, il modello apprende mapping bidirezionali di caratteristiche continue utilizzando l'obiettivo di corrispondenza del flusso. Nella Fase 2, il modulo di allineamento preaddestrato fornisce un'operazione comune di trasporto delle caratteristiche prima della fusione delle caratteristiche multimodali, mentre la rete di classificazione apprende rappresentazioni discriminative per classe dallo spazio latente allineato. Il riutilizzo dell'allineatore preaddestrato favorisce un allineamento coerente delle caratteristiche prima della fusione, ma non è presentato come una garanzia indipendente di un miglioramento della generalizzazione.
Set di dati sperimentali
Il framework proposto è stato valutato utilizzando tre dataset di riferimento multimodali di telerilevamento: Houston201329, Augsburg30 e MUUFL31.
Il dataset Houston2013 è stato rilasciato nell'ambito del concorso IEEE GRSS Data Fusion Contest. Esso rappresenta un paesaggio urbano diversificato a Houston, Stati Uniti, e contiene 15 classi di copertura del suolo, tra cui aree residenziali, strade, vegetazione e corpi idrici. Il dataset comprende immagini spettrali iperspettrali (HSI) con 144 bande spettrali che coprono lo spettro dal visibile al vicino infrarosso, insieme a un modello digitale della superficie (DSM) derivato da dati LiDAR a banda singola, con una risoluzione spaziale di 2,5 m. Le complesse texture urbane e la notevole variabilità spettrale all'interno delle classi rendono questo dataset particolarmente impegnativo per una classificazione accurata della copertura del suolo.
Il dataset di Augsburg è stato acquisito su un'area urbana densamente edificata in Germania. Comprende immagini iperspettrali con 224 bande spettrali che coprono l'intervallo di lunghezze d'onda da 400 a 1000 nm, insieme a dati di elevazione LiDAR co-registrati. Il dataset contiene 17 classi di copertura del suolo annotate, tra cui strutture edificate, suolo nudo, asfalto, vegetazione e ombra, con una risoluzione spaziale di 2 m. Rispetto a Houston2013, Augsburg presenta correlazioni spettrali più forti e una maggiore diversità tra le classi, offrendo una sfida significativa per la valutazione dell'allineamento delle caratteristiche cross-modali e della capacità di generalizzazione.
Il dataset MUUFL Gulfport è stato raccolto all'interno di un campus universitario e rappresenta un ambiente semi-urbano contenente vegetazione abbondante insieme a piccole strutture artificiali. Il dataset comprende immagini iperspettrali denoizzate a 64 bande, insieme a misurazioni LiDAR a doppia banda che includono informazioni sull'elevazione e sull'intensità. Contiene 11 classi di copertura del suolo ed evidenzia dettagli spaziali fini, pixel misti e condizioni di illuminazione variabili, rendendolo particolarmente adatto per valutare la fusione di caratteristiche multimodali nella classificazione di piccoli oggetti.
Nel complesso, questi tre dataset di riferimento comprendono una notevole variazione nella risoluzione spaziale (1–2,5 m), nella dimensionalità spettrale (64–224 bande), nella complessità della scena e nella composizione del land-cover. Di conseguenza, offrono un insieme eterogeneo di dati di riferimento per valutare l'efficacia e la generalizzabilità dei metodi di classificazione multimodale del land-cover. Le caratteristiche principali dei dataset sono riassunte nella Tabella 1. Le suddivisioni training/test per tutti e tre i dataset corrispondono alle partizioni ufficiali fornite dagli enti originari di riferimento. In particolare, il dataset Houston2013 utilizza la partizione ufficiale del concorso IEEE GRSS Data Fusion del 2013, composta da 2.832 campioni di addestramento e 12.197 campioni di test. Il dataset Augsburg utilizza le annotazioni ufficiali mask_train e mask_test, ottenendo 4.538 campioni di addestramento e 47.896 campioni di test. Il dataset MUUFL utilizza la partizione ufficiale train_test_gt.mat, contenente 28.645 campioni di addestramento e 24.283 campioni di test. Per ciascun dataset, è stata estratta una finestra immagine di 32 × 32 pixel centrata su ciascun pixel etichettato, utilizzata come campione singolo di addestramento o di test. Non è stata effettuata alcuna ulteriore suddivisione o ricampionamento dei dati.
| Proprietà | Houston2013 | Augsburg | MUUFL |
| Dimensione dell'immagine IAS (pixel) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Dimensione dell'immagine LiDAR (pixel) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Bande spettrali IAS | 144 | 224 | 64 |
| Bande LiDAR | 1 | 1 | 2 |
| Intervallo di lunghezza d'onda IAS | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| Intervallo di lunghezza d'onda LiDAR | Non applicabile | Non applicabile | Non applicabile |
| Risoluzione spaziale (IAS) | 2,5 m | 2,0 m | 0,54 m × 1,00 m |
| Risoluzione spaziale (LiDAR) | 2,5 m | 2,0 m | 0,60 m × 0,78 m |
| Numero di classi di copertura del suolo | 15 | 17 | 11 |
Tabella 1: Caratteristiche dei tre dataset di telerilevamento multimodale utilizzati per la valutazione. La tabella riassume le dimensioni delle immagini, le caratteristiche spettrali, le risoluzioni spaziali e il numero di classi di copertura del suolo per i dataset di riferimento Houston2013, Augsburg e MUUFL utilizzati per valutare il framework FlowErs proposto.
Dettagli di Implementazione
Il framework FlowErs è stato implementato in PyTorch e addestrato e valutato utilizzando un'unità di elaborazione grafica (GPU) con 80 GB di memoria. L'addestramento è stato eseguito per 100 epoche con una dimensione del batch di 16. È stato utilizzato l'ottimizzatore AdamW con un tasso di apprendimento iniziale di 1 × 10⁻⁴ e un weight decay di 1 × 10⁻². Per aggiornare il tasso di apprendimento durante l'addestramento è stato impiegato un scheduler del tasso di apprendimento basato su annealing coseno. È stato applicato un tasso di dropout pari a 0,1 per migliorare la capacità di generalizzazione del modello e ridurre l'overfitting. Per l'ottimizzazione supervisionata è stata utilizzata la funzione di perdita cross-entropy. Per garantire la riproducibilità, tutti gli esperimenti sono stati inizializzati utilizzando un seed casuale fisso pari a 3407. Sono state utilizzate le partizioni di training/test fornite, senza creare un'ulteriore suddivisione per la validazione. Ogni patch di input è stata ridimensionata a 32 × 32 pixel prima dell'addestramento. Non è stata applicata alcuna aumentazione dei dati, correzione esplicita di registrazione delle immagini o ulteriore normalizzazione nel data-loader. I pixel associati a etichette negative sono stati esclusi dal calcolo della perdita supervisionata. La gestione di pixel mancanti o rumorosi non è stata valutata separatamente.
Parametri di valutazione
Per valutare le prestazioni della classificazione sono state utilizzate tre metriche di valutazione ampiamente adottate: accuratezza complessiva (OA), accuratezza media (AA) e coefficiente Kappa (k). L'OA misura la proporzione di campioni correttamente classificati rispetto al totale dei campioni, l'AA rappresenta l'accuratezza media della classificazione su tutte le classi di copertura del suolo, mentre il coefficiente Kappa quantifica l'accordo tra le classificazioni previste e quelle di riferimento, corretto per l'accordo casuale. Valori più elevati per ciascuna delle tre metriche indicano prestazioni migliori nella classificazione. Tutti i valori riportati nelle Tabelle 2–6 sono stime puntuali a divisione fissa ottenute utilizzando il seme casuale 3407. Non sono riportati intervalli di confidenza, test di significatività statistica né valori p.
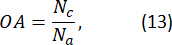
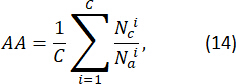
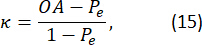
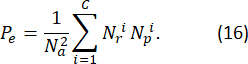
In questo caso, Nc e Na indicano rispettivamente il numero totale di campioni classificati correttamente e il numero totale di campioni valutati.  e
 indicano rispettivamente il numero di campioni classificati correttamente e il numero totale di campioni per la i-esima classe. Nel calcolo del coefficiente Kappa, Pe indica la probabilità di accordo dovuto al caso, e
 e
 indicano rispettivamente il numero di campioni di riferimento e il numero di campioni predetti per la i-esima classe.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Il flusso di lavoro complessivo di valutazione del framework proposto FlowErs è illustrato nella Figura 1, che riassume la strategia di classificazione multimodale in due fasi. Il processo di estrazione delle caratteristiche specifiche per ciascuna modalità, basato sull'encoder MetaFormer, è mostrato nella Figura 2, mentre le caratteristiche principali dei tre dataset di riferimento utilizzati per la valutazione sono riassunte nella Tabella 1. L...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Lo studio attuale presenta FlowErs, un framework multimodale di telerilevamento che separa l'allineamento delle caratteristiche cross-modali dalla classificazione semantica attraverso una strategia di apprendimento in due fasi. Piuttosto che fondere direttamente caratteristiche eterogenee specifiche delle singole modalità, il framework proposto allinea innanzitutto le rappresentazioni delle caratteristiche utilizzando il conditional flow matching, prima della fusione multimodale e della classificazione. Questo design aff...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Conflitto di interessi:
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Questo lavoro è stato finanziariamente sostenuto dal Progetto del Fondo per la Ricerca Scientifica della provincia di Shaanxi A&Università #38;F (concessione n. ZK25-38) e Dipartimento dell'Istruzione della Provincia di Shaanxi (concessione n. 24JK0734).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| ottimizzatore AdamW | Fondazione PyTorch | Incluso in PyTorch | Utilizzato per l'ottimizzazione del modello. È stata utilizzata PyTorch 2.5.0. |
| Set di dati di riferimento Augsburg | Hu J et al. (Earth System Science Data, 2022); Tecnologia del Telerilevamento, LMU Monaco | https://doi.org/10.5281/zenodo.7185498 | Dataset pubblico di riferimento multimodale di telerilevamento utilizzato per la valutazione dei modelli. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Utilizzato per l'addestramento e l'inferenza del modello accelerati tramite GPU. |
| unità di elaborazione grafica (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Utilizzato per il training e la valutazione del modello. |
| dataset di riferimento Houston2013 | Concorso sulla fusione dei dati della IEEE Geoscience and Remote Sensing Society | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Dataset pubblico di immagini iperspettrali e dati LiDAR utilizzato per la valutazione del modello. |
| Dataset di riferimento MUUFL Gulfport | Università della Florida (Gader P et al., Rapporto Tecnico REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Dataset pubblico di immagini iperspettrali e dati LiDAR utilizzato per la valutazione del modello. |
| Sistema operativo | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Ambiente computazionale utilizzato per lo sviluppo, l'addestramento e la valutazione del modello. |
| PyTorch | Fondazione PyTorch | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Framework di apprendimento profondo utilizzato per implementare, addestrare e valutare il modello FlowErs. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Linguaggio di programmazione utilizzato per implementare ed eseguire il flusso di lavoro computazionale. |
Riferimenti
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.