Questo studio integra trascrittomica pediatrica pubblica della polmonite, sequenziamento dell'RNA a singola cellula del polmone murino, screening di composti derivati da Paeonia, docking molecolare e simulazioni di dinamica molecolare per identificare bersagli infiammatori associati ai neutrofili e le previste interazioni con la catechina da validare in futuro.
Articolo di ricerca
Effetti della catechina derivata da Paeonia sull'infiammazione associata ai neutrofili nella polmonite
In questo articolo
Sommario
Abstract
La polmonite nei bambini è spesso accompagnata da risposte infiammatorie eccessive e da una disregolazione immunitaria, che possono portare a esiti clinici gravi. La catechina ha mostrato attività anti-infiammatoria in diversi contesti patologici, ma il suo ruolo e i suoi meccanismi molecolari nella polmonite rimangono poco chiari. Sono stati analizzati dati pubblici di sequenziamento dell'RNA totale da polmonite pediatrica (GSE261482) e dati pubblici di sequenziamento dell'RNA a singola cellula da un modello sperimentale di polmonite murina (GSE295484), utilizzando l'analisi della rete di co-espressione genica pesata, l'analisi dell'espressione differenziale, l'annotazione dei tipi cellulari e l'analisi dell'arricchimento dei set genici. Le interazioni tra catechina e proteine selezionate sono state valutate mediante docking molecolare e simulazioni di dinamica molecolare. È stato identificato un modulo genico chiave associato a tratti legati alla polmonite, e sono stati selezionati 18 geni candidati, principalmente arricchiti in percorsi infiammatori e immunitari. L'analisi a singola cellula ha mostrato che questi geni erano prevalentemente arricchiti nei neutrofili e nei macrofagi alveolari, con un aumento della proporzione di neutrofili in condizioni infiammatorie. MMP9, PYGL e GADD45A sono stati selezionati come geni candidati. Le simulazioni di docking e di dinamica molecolare hanno confermato interazioni stabili previste tra la catechina e queste proteine selezionate. La catechina potrebbe essere associata ai percorsi infiammatori legati alla polmonite modulando i percorsi associati ai neutrofili e interagendo con proteine chiave coinvolte nella risposta immunitaria. Questo studio fornisce una visione a livello di sistema dell'azione della catechina nella polmonite e individua potenziali bersagli per ulteriori validazioni sperimentali.
Introduzione
La polmonite è una malattia respiratoria comune e potenzialmente grave nei bambini, causata principalmente da agenti infettivi come Mycoplasma pneumoniae. Rappresenta una componente importante della polmonite acquisita nella comunità ed è associata a una significativa morbilità a causa di risposte infiammatorie eccessive e di una disregolazione immunitaria1,2. Sempre più evidenze indicano che le citochine infiammatorie, tra cui il fattore di necrosi tumorale-α (TNF-α) e l'interleuchina-6 (IL-6), svolgono un ruolo fondamentale nell'evoluzione della malattia promuovendo il reclutamento delle cellule immunitarie, il danno tissutale e la disfunzione polmonare3. Nonostante i progressi nella terapia antimicrobica, i meccanismi molecolari che guidano l'infiammazione nella polmonite pediatrica non sono ancora completamente compresi4.
I flavonoidi hanno attirato notevole attenzione a causa delle loro proprietà anti-infiammatorie e antiossidanti5. La catechina, un polifenolo presente naturalmente e ampiamente diffuso nel tè e negli alimenti di origine vegetale, è stata segnalata per attenuare lo stress ossidativo e le risposte infiammatorie in vari modelli di malattia6. Studi precedenti hanno dimostrato che la catechina può inibire cascate di segnalazione pro-infiammatorie, tra cui le vie MAPK e NF-κB, e regolare l'espressione delle citochine, alleviando così l'infiammazione e il malfunzionamento metabolico7. Tuttavia, la maggior parte degli studi esistenti si concentra su malattie metaboliche o cardiovascolari, mentre il ruolo della catechina nelle malattie infiammatorie respiratorie, in particolare nella polmonite, rimane poco esplorato. Inoltre, i bersagli molecolari e i meccanismi alla base della protezione mediata dalla catechina nella polmonite non sono ancora chiari.
Questo studio si proponeva di indagare i possibili meccanismi molecolari della catechina nella polmonite. Si ipotizzava che la catechina potesse attenuare le risposte infiammatorie interagendo con proteine chiave e vie di segnalazione coinvolte nella regolazione immunitaria. Per verificare questa ipotesi, sono state integrate analisi di farmacologia in rete, docking molecolare, simulazione di dinamica molecolare e sequenziamento dell'RNA a singola cellula al fine di identificare sistematicamente geni candidati e valutarne le interazioni con la catechina. È stata inoltre analizzata la distribuzione delle cellule immunitarie e i profili di espressione genica per esplorare il ruolo dei neutrofili e dei macrofagi nell'evoluzione della malattia.
I risultati hanno mostrato un legame previsto stabile tra la catechina e le proteine selezionate, inclusi PYGL, MMP9 e GADD45A, con stabilità strutturale mantenuta durante le simulazioni di dinamica molecolare. Inoltre, l'analisi a singola cellula ha rivelato alterazioni significative nelle proporzioni delle cellule immunitarie, in particolare dei neutrofili, in condizioni infiammatorie. Questi risultati suggeriscono che la catechina potrebbe essere associata a meccanismi anti-infiammatori che coinvolgono la funzione delle cellule immunitarie e vie di segnalazione chiave. Questo studio fornisce una visione a livello sistemico dei potenziali meccanismi associati alla catechina nella polmonite e sostiene ulteriori validazioni della catechina come composto candidato nella ricerca sulle malattie respiratorie infiammatorie.
Protocollo
Questo studio ha comportato un'analisi secondaria di set di dati pubblicamente disponibili e anonimizzati provenienti dal database Gene Expression Omnibus. Per questo studio non sono stati reclutati, raccolti o generati nuovi partecipanti umani, esperimenti su animali o campioni clinici. L'approvazione etica e il consenso informato relativi ai set di dati originali erano di competenza degli studi originali che avevano generato i dati. Pertanto, non è stata richiesta un'ulteriore approvazione da parte del comitato etico per l'analisi secondaria qui presentata.
Raccolta ed elaborazione preliminare dei dati
I dati di sequenziamento dell'RNA in bulk (RNA-seq) sono stati ottenuti dal set di dati Gene Expression Omnibus (GEO) GSE2614828. La matrice di espressione utilizzata in questo studio conteneva 177 campioni di sangue intero, inclusi 139 campioni di polmonite pediatrica e 38 campioni di controllo sani. I metadati disponibili includevano sesso, classificazione eziologica, tipo di provetta per il prelievo, lotto e condizione della malattia. I campioni di polmonite sono stati annotati come batterici definiti (DB), virali definiti (DV), batterici probabili (PB), virali probabili (PV) o sconosciuti (U), in base all'annotazione del set di dati originale.
I dati di sequenziamento dell'RNA a singola cellula (scRNA-seq) sono stati ottenuti dal set di dati GEO GSE2954849, derivato da tessuti polmonari di topi C57BL/6 di tipo selvaggio in un modello sperimentale di polmonite. Il set di dati includeva topi neonati (PND05) e topi giovanili (PND12) esposti ad aria ambiente, PBS o E. coli, raccolti a 48 h o 96 h dopo l'aspirazione.
Analisi della rete di co-espressione genica pesata (WGCNA)
Per la costruzione della rete di co-espressione, la matrice di espressione è stata inizialmente filtrata per rimuovere i geni con espressione bassa. Dopo l'eliminazione dei geni con espressione ridotta, la variabilità è stata valutata mediante la deviazione media assoluta (MAD). I 5.000 geni con i valori più alti di MAD sono stati selezionati per l'analisi della rete di co-espressione genica pesata (WGCNA) in R. È stata applicata una potenza di soglia morbida pari a 15, poiché soddisfa il criterio di topologia libera da scala con R2> 0,8. Questa soglia è stata utilizzata per costruire la matrice di adiacenza pesata, successivamente trasformata in una matrice di sovrapposizione topologica (TOM). I moduli genici sono stati quindi identificati a partire dall'albero di clustering gerarchico basato sulla TOM. Per individuare i moduli associati a tratti legati alla polmonite, sono stati calcolati gli eigengeni dei moduli e ne è stata testata la correlazione con lo stato di malattia e l'eziologia.
Analisi dell'espressione differenziale
I gruppi con polmonite e i controlli sani sono stati confrontati utilizzando il pacchetto R limma per identificare i geni differenzialmente espressi. La correzione per i test multipli è stata eseguita mediante il metodo di Benjamini-Hochberg. I geni sono stati considerati differenzialmente espressi solo se soddisfacevano entrambi i criteri: |log2 fold change| > 1 e valore p aggiustato < 0,05.
Identificazione di Paeoniacomposti attivi derivati e previsione del bersaglio
Per identificare in modo sistematico i composti bioattivi presenti in Paeonia e i loro potenziali bersagli biologici, è stata adottata una strategia di integrazione multi-database per garantire affidabilità e completezza, seguendo consolidate metodologie di farmacologia in rete. In primo luogo, i composti attivi di Paeonia sono stati recuperati dal Traditional Chinese Medicine Systems Pharmacology Database (TCMSP, https://tcmsp-e.com) e da altri database pubblici, tra cui ETCM e fonti letterarie. I composti sono stati selezionati in base a parametri farmacocinetici, inclusa la biodisponibilità orale (OB ≥ 30%) e la somiglianza ai farmaci (DL ≥ 0,18), al fine di identificare ingredienti bioattivi candidati.
I potenziali bersagli proteici sono stati previsti utilizzando approcci basati sul ligando complementari. SwissTargetPrediction (http://www.swisstargetprediction.ch) è stato utilizzato per identificare i probabili bersagli umani confrontando le strutture dei composti con ligandi di attività nota, e sono state mantenute solo le previsioni con una probabilità ≥ 0,1. Per ampliare la copertura dei bersagli, è stato impiegato anche il Similarity Ensemble Approach (SEA, http://sea.bkslab.org) per eseguire uno screening di possibili associazioni fuori bersaglio (off-target) all'interno delle famiglie proteiche, inclusi interazioni non catturate dalle previsioni canoniche dei bersagli. Per integrare ulteriormente la previsione basata sul ligando, è stato utilizzato il PharmMapper Server (http://lilab.ecust.edu.cn/pharmmapper/) per l'analisi inversa del farmacoforo su un database completo di proteine umane, selezionando i bersagli con punteggi di adattamento normalizzati ≥ 0,7. Inoltre, sono state raccolte interazioni sperimentali confermate tra composti e bersagli da database pubblici, tra cui DrugBank e BindingDB, al fine di migliorare l'affidabilità dell'identificazione dei bersagli. Tutti i bersagli previsti sono stati successivamente standardizzati in simboli genici ufficiali utilizzando il database UniProt (https://www.uniprot.org), limitando l'organismo a “Homo sapiens”. Sono state rimosse le voci duplicate per garantire l'accuratezza dei dati. L'insieme integrato di bersagli è stato definito come l'unione di tutti i bersagli previsti e confermati per Paeonia, rappresentando la base molecolare potenziale dei suoi effetti farmacologici. Poiché la catechina è stata identificata come uno dei composti attivi derivati da Paeonia e possiede un'attività antinfiammatoria ben documentata, è stata selezionata come composto rappresentativo per le successive simulazioni di docking molecolare e dinamica molecolare.
Analisi del arricchimento funzionale
L'arricchimento funzionale è stato valutato per i processi biologici dell'Ontologia Genica (GO) e per i percorsi della Kyoto Encyclopedia of Genes and Genomes (KEGG) utilizzando il pacchetto R clusterProfiler. I termini arricchiti sono stati mantenuti quando il tasso di scoperte false (FDR) era < 0,05.
Analisi di sequenziamento dell'RNA a singola cellula e analisi successiva
I dati di sequenziamento dell'RNA a singola cellula sono stati elaborati in Seurat. Per le analisi successive è stata utilizzata la matrice GSE295484 già elaborata, senza applicare ulteriori filtri a livello cellulare dopo l'importazione. La matrice elaborata conteneva 90.883 cellule e 26.511 geni. Per i grafici di controllo qualità sono stati utilizzati come riferimento soglie di 200 e 8.000 geni rilevati per cellula e letture mitocondriali pari al 1,4%. I dati sono stati normalizzati, scalati e sottoposti ad analisi delle componenti principali (PCA). Successivamente è stata effettuata la clusterizzazione cellulare e l'approximazione uniforme di varietà (UMAP) è stata utilizzata per visualizzare le popolazioni cellulari in uno spazio ridotto dimensionalmente. Le identità cellulari sono state assegnate in base ai geni marcatore canonici. I geni marcatore sono stati identificati utilizzando FindAllMarkers con only.pos = TRUE, min.pct = 0,25 e logfc.threshold = 0,25.
Per valutare l'attività di insiemi di geni candidati a livello singola cellula, è stata eseguita un'analisi AUCell utilizzando il pacchetto R AUCell. Le cellule sono state valutate in base all'espressione di firme geniche predefinite, e i modelli di arricchimento sono stati visualizzati su grafici UMAP. Per GSE295484, le proporzioni delle popolazioni di cellule immunitarie, inclusi macrofagi alveolari e neutrofili, sono state calcolate nei gruppi aria ambiente, PBS ed E. coli a 48 h e 96 h dopo l'aspirazione. Le differenze tra i gruppi sono state valutate utilizzando test statistici non parametrici. I geni marcatore dei neutrofili sono stati identificati dal dataset a singola cellula e incrociati con i geni candidati precedentemente identificati per ottenere i principali geni associati ai neutrofili da sottoporre ad ulteriore analisi.
Docking molecolare
Il docking molecolare è stato eseguito utilizzando AutoDock Vina, con la preparazione del recettore e del ligando effettuata mediante AutoDock Tools. Le strutture cristalline delle proteine bersaglio sono state ottenute dal Protein Data Bank (PDB), inclusi GADD45A (PDB ID: 2KG4), MMP9 (PDB ID: 6ESM) e PYGL (PDB ID: 3DDS). Le strutture proteiche sono state pretrattate prima del docking rimuovendo le molecole d'acqua e i ligandi co-cristallizzati. Sono stati quindi aggiunti gli atomi di idrogeno polari ed assegnate le cariche di Gasteiger.
La struttura tridimensionale della catechina è stata ottenuta da PubChem e preparata in AutoDock Tools. Successivamente, AutoDock Vina è stato utilizzato per effettuare il docking della catechina con ciascuna proteina bersaglio e valutare l'affinità di legame prevista e il relativo modello di interazione. I parametri della griglia di docking erano i seguenti: GADD45A-catechina, center_x = 0,131, center_y = -0,002, center_z = -0,018, size_x = 47,25, size_y = 47,25, size_z = 47,25; MMP9-catechina, center_x = -0,434, center_y = 43,036, center_z = 14,868, size_x = 47,25, size_y = 47,25, size_z = 47,25; PYGL-catechina, center_x = 88,408, center_y = -80,795, center_z = 105,959, size_x = 100,45, size_y = 100,45, size_z = 100,45.
Simulazione di dinamica molecolare
Il campo di forze AMBER14SB è stato utilizzato per i componenti proteici. I parametri del ligando sono stati generati mediante il campo di forze GAFF2 attraverso sobtop_1.0 (dev3.1), e sono state assegnate cariche RESP. L'acqua TIP3P è stata utilizzata per solvatare ciascun complesso proteina-ligando all'interno di una scatola di simulazione cubica. L'aggiunta di ioni Na⁺ e Cl⁻ ha permesso di neutralizzare il sistema e raggiungere una concentrazione ionica di 0,15 M. Il metodo particle mesh Ewald (PME) è stato impiegato per le interazioni elettrostatiche a lungo raggio con un cutoff di 1 nm. I vincoli sui legami sono stati applicati utilizzando l'algoritmo LINCS. Per eliminare gli scontri sterici, è stata effettuata una minimizzazione dell'energia mediante i metodi dello steepest-descent e del gradiente coniugato.
Dopo l'equilibrazione, le simulazioni di dinamica molecolare in condizioni di produzione sono state eseguite in condizioni NPT a 310 K e 1 bar, controllate dal termostato di Nosé–Hoover e dal barostato di Parrinello–Rahman. Ogni simulazione è stata eseguita per 100 ns con un passo temporale di 2 fs.
Analisi statistica
Tutte le analisi statistiche sono state eseguite utilizzando il software R. Le analisi di correlazione sono state condotte con metodi di Pearson o Spearman, a seconda delle esigenze. I confronti tra gruppi sono stati effettuati mediante test non parametrici, inclusi il test di Kruskal–Wallis. Un valore di p < 0,05 è stato considerato statisticamente significativo.
Risultati
Identificazione di un modulo genico chiave associato alla polmonite pediatrica mediante WGCNA
Per identificare i moduli genici associati alla polmonite pediatrica, è stata eseguita un'analisi WGCNA su dati trascrittomici ottenuti da sangue intero di pazienti con polmonite e di controlli sani. L'analisi di clustering dei campioni non ha rivelato outlier evidenti, indicando una buona qualità dei dati per le analisi successive (Figura 1A). L'analisi PCA ha ulteriormente mostrato una chiara separazione tra i gruppi di polmonite e quelli sani, suggerendo profili trascrittomici distinti tra le due condizioni (Figura 1B). Per costruire una rete priva di scala (scale-free), i geni sono stati ordinati in base alla deviazione media assoluta; i 5.000 geni con maggiore variabilità sono stati selezionati per la costruzione della rete, e il parametro di soglia morbida (soft-thresholding power) è stato impostato a 15, in base al criterio di aderenza alla topologia priva di scala (indice di adattamento R2 > 0,8), mantenendo al contempo una connettività media relativamente bassa (Figura 1C). Utilizzando questa soglia, il clustering gerarchico ha identificato diversi moduli genici con pattern di espressione distinti (Figura 1D). L'analisi delle correlazioni tra moduli e tratti fenotipici clinici ha rivelato che diversi moduli erano significativamente correlati ai fenotipi clinici. In particolare, il modulo blu ha mostrato una forte correlazione sia con lo stato della malattia (polmonite vs. sano) sia con la classificazione eziologica, suggerendo un possibile ruolo nel decorso della malattia e nella risposta dell'ospite (Figura 1E).
Inoltre, l'analisi tramite diagramma di dispersione dell'appartenenza al modulo rispetto al significato genico all'interno del modulo blu ha dimostrato una forte correlazione positiva (cor = 0,6, p = 2,1e−35), indicando che i geni altamente connessi all'interno del modulo erano anche fortemente associati al tratto clinico (Figura 1F).
Associazione del modulo blu con l'eziologia della polmonite batterica
Per approfondire le differenze di espressione genica tra le diverse eziologie della polmonite, è stata eseguita un'analisi WGCNA utilizzando diverse classificazioni cliniche, incluse le categorie di controllo (C), batterica definitiva (DB), virale definitiva (DV), batterica probabile (PB), virale probabile (PV) e sconosciuta (U). L'analisi delle correlazioni tra moduli e tratti ha rivelato che diversi moduli presentavano significative associazioni con specifici sottotipi eziologici. In particolare, il modulo blu ha mostrato la correlazione positiva più forte con il gruppo DB, suggerendo un possibile coinvolgimento nelle risposte dell'ospite specifiche per l'infezione batterica (Figura 2A).
Il dendrogramma di raggruppamento genico e l'assegnazione corrispondente dei moduli hanno ulteriormente confermato la robustezza della costruzione dei moduli e la chiara separazione dei cluster genici (Figura 2B). All'interno del modulo blu, l'analisi dell'appartenenza al modulo rispetto alla significatività genica ha dimostrato una correlazione positiva significativa (cor = 0,41, p = 7,8e−14), suggerendo che i geni altamente connessi all'interno di questo modulo erano anche fortemente associati al tratto eziologico (Figura 2C).
Inoltre, il confronto dell'espressione dell'eigengene modulare tra diversi gruppi eziologici ha rivelato differenze significative nel modulo blu (test di Kruskal-Wallis, p = 1,5e−13). In particolare, il modulo blu ha mostrato un'espressione aumentata nei gruppi con polmonite batterica, specialmente nel sottogruppo DB, rispetto ad altre categorie eziologiche (Figura 2D).
Diciotto geni candidati associati a composti derivati da Paeonia identificati mediante analisi integrata in relazione alla polmonite pediatrica
Per identificare geni candidati associati alla polmonite pediatrica e potenziali bersagli legati a Paeonia, è stata inizialmente eseguita un'analisi dell'espressione differenziale tra pazienti affetti da polmonite e controlli sani. Applicando questi criteri, sono stati identificati 1.110 geni differenzialmente espressi (DEG) tra campioni di pazienti con polmonite e controlli sani, inclusi 524 geni upregolati e 586 geni downregolati. I 524 DEG upregolati sono riportati nel Supplementary Table S1 (vedi anche Figure 3A). Per affinare ulteriormente l'identificazione dei geni chiave, i DEG associati alla polmonite sono stati incrociati con i geni associati al fenotipo DB e con i bersagli predetti di Paeonia. Questa analisi integrata ha prodotto 18 geni sovrapposti, suggerendone il potenziale ruolo nella progressione della malattia e nelle risposte associate a Paeonia (Figure 3B).
È stata costruita una rete di interazione tra composti e target per visualizzare le relazioni tra i componenti attivi della Paeonia e i geni candidati identificati, rivelando un'ampia connettività tra composti e target (Tabella Supplettiva S2 e Figura 3C). Per esplorare le funzioni biologiche di questi 18 geni, sono state effettuate analisi di arricchimento funzionale. L'arricchimento dei processi biologici secondo la Gene Ontology (GO) ha associato i geni candidati principalmente a funzioni immunitarie e infiammatorie, inclusa la regolazione della risposta infiammatoria, la risposta agli ormoni peptidici, la regolazione positiva del metabolismo delle specie reattive dell'ossigeno e la regolazione della segnalazione mediata dall'interferone di tipo II (Figura 3D). L'analisi KEGG ha inoltre mostrato che i geni erano arricchiti in vie metaboliche legate all'infiammazione e all'immunità, come le vie di segnalazione di IL-17 e NF-κB, nonché in vie metaboliche ed endocrine, tra cui la segnalazione del glucagone e la biosintesi degli ormoni steroidei (Figura 3D).
Arricchimento dei geni candidati nei neutrofili e nei macrofagi alveolari nell'analisi trascrittomica a singola cellula
Per indagare la distribuzione cellulare dei geni candidati in un contesto sperimentale di polmonite, è stato analizzato il dataset di sequenziamento dell'RNA a singola cellula (scRNA-seq) del polmone murino GSE295484. È stata effettuata un'analisi di controllo qualità per valutare l'affidabilità dei dati. Le distribuzioni del numero di geni rilevati, dei conteggi UMI e delle percentuali di geni mitocondriali e ribosomiali hanno indicato dati di singola cellula di complessiva alta qualità nella matrice processata (Figura 4A). I grafici a dispersione mostravano le soglie di riferimento per il rilevamento dei geni e il contenuto mitocondriale utilizzate nella visualizzazione del controllo qualità (Figura 4B).
Dopo la normalizzazione e la riduzione della dimensionalità, le cellule sono state raggruppate e visualizzate utilizzando UMAP. Sono state identificate popolazioni cellulari distinte, tra cui neutrofili, macrofagi alveolari, monociti, cellule epiteliali e altri tipi cellulari immunitari e stromali, dimostrando l'eterogeneità cellulare del microambiente polmonare durante la polmonite (Figura 4C). Per valutare l'attività dei 18 geni candidati a livello singola-cellula, è stata eseguita un'analisi AUCell. I risultati hanno mostrato che la firma genica era prevalentemente arricchita nei neutrofili e nei macrofagi alveolari, come indicato da punteggi AUC più elevati in queste popolazioni cellulari (Figura 4D).
Geni infiammatori associati ai bersagli di composti derivati da Paeonia in un modello murino di polmonite batterica
Per approfondire la dinamica delle cellule immunitarie nel modello sperimentale murino di polmonite, le proporzioni di macrofagi alveolari e neutrofili sono state analizzate nei gruppi esposti all'aria ambiente, al PBS e a E. coli a 48 h e 96 h dall'aspirazione. A 48 h, i macrofagi alveolari hanno mostrato una marcata riduzione in seguito all'infezione da E. coli rispetto alle condizioni di aria e PBS, mentre i neutrofili hanno evidenziato un notevole aumento della loro proporzione cellulare (Figura 5A). Una tendenza simile è stata osservata a 96 h, con la proporzione di neutrofili ancora elevata in risposta alla stimolazione con E. coli, mentre i macrofagi alveolari presentavano livelli relativamente più bassi. Questi risultati indicano un'espansione significativa dei neutrofili durante l'infezione batterica. Per esplorare le caratteristiche funzionali dei neutrofili, sono stati identificati geni marcatore specifici per i neutrofili ed è stata effettuata un'analisi di arricchimento funzionale. L'arricchimento KEGG ha associato i geni marcatore dei neutrofili a segnalazioni infiammatorie, comprese le vie del TNF, della MAPK e dei recettori di tipo lectina C (Figura 5B). Anche i termini GO relativi ai processi biologici si sono concentrati in funzioni legate alla risposta immunitaria, come la migrazione dei leucociti, l'adesione cellula-cellula tra leucociti, la regolazione positiva della risposta difensiva e la risposta a molecole di origine batterica (Figura 5B). Per identificare i geni chiave che collegano l'attività dei neutrofili, la polmonite e i bersagli di Paeonia, i geni marcatore dei neutrofili sono stati incrociati con i 18 geni candidati precedentemente identificati. Questa analisi ha individuato tre geni sovrapposti: MMP9, PYGL e GADD45A (Tabella Supplementare S3 e Figura 5C). Infine, la visualizzazione dell'espressione genica a singola cellula ha mostrato che questi tre geni erano prevalentemente espressi nelle popolazioni di neutrofili (Figura 5D), ulteriormente confermando il loro potenziale ruolo nelle risposte infiammatorie mediate dai neutrofili.
Affinità di legame prevista della catechina con proteine selezionate nell'analisi di docking molecolare
Per ulteriormente valutare le possibili interazioni tra catechina e proteine, è stata eseguita un'analisi di docking molecolare tra le proteine selezionate (MMP9, PYGL e GADD45A) e la catechina, un composto attivo derivato da Paeonia. Le strutture cristalline di GADD45A, MMP9 e PYGL sono state ottenute dal Protein Data Bank, mentre la struttura tridimensionale della catechina è stata recuperata dal database PubChem. I risultati del docking hanno indicato che la catechina potrebbe legarsi ai siti di tutte e tre le proteine selezionate, con energie di legame di −6,3 kcal/mol per GADD45A, −7,6 kcal/mol per MMP9 e −8,0 kcal/mol per PYGL (Figura 6). Tra queste proteine selezionate, la catechina ha mostrato l'affinità di legame prevista più elevata con PYGL, seguita da MMP9 e GADD45A, suggerendo un'interazione potenzialmente preferenziale con una proteina legata al metabolismo.
A livello molecolare, la catechina ha formato numerosi legami a idrogeno e interazioni idrofobiche con residui amminoacidici chiave in ciascuna proteina. In GADD45A, la catechina ha interagito con residui come GLN33 e TRP135. In MMP9, sono stati osservati legami a idrogeno stabili con residui inclusi GLN227, TYR248 e HIS236. Analogamente, in PYGL, la catechina ha formato numerosi legami a idrogeno con residui come LYS554 e ASN631, contribuendo alla stabilità del legame. Oltre ai legami a idrogeno, l'analisi delle interazioni ha rivelato forze di van der Waals e interazioni di tipo π, indicando un modello di legame multiplo che migliora la stabilità dei complessi ligando–proteina predetti. Nel complesso, questi risultati suggeriscono che la catechina può formare complessi predetti stabili con MMP9, PYGL e GADD45A. Tuttavia, la rilevanza terapeutica di queste interazioni richiede ulteriore validazione sperimentale.
Interazioni stabili previste tra catechina e proteine selezionate
Sulla base delle conformazioni ottenute dal docking molecolare, sono state effettuate simulazioni di dinamica molecolare della durata di 100 ns per valutare ulteriormente la stabilità dei complessi catechina-proteina. L'analisi del RMSD ha mostrato che tutti e tre i complessi proteina-ligando hanno raggiunto l'equilibrio durante il periodo di simulazione. Tra questi, i complessi PYGL–catechina e MMP9–catechina hanno mostrato fluttuazioni RMSD relativamente stabili, mentre il complesso GADD45A–catechina ha presentato fluttuazioni leggermente maggiori, pur rimanendo entro un intervallo accettabile (Figura 7A). L'analisi del Rg ha indicato che tutti i complessi hanno mantenuto una compattità strutturale stabile per tutta la durata della simulazione, con variazioni minime nel tempo (Figura 7B). Analogamente, l'analisi del SASA ha mostrato livelli di esposizione stabili per tutti i complessi, ulteriore conferma della loro stabilità strutturale (Figura 7C). L'analisi dei legami a idrogeno ha rivelato interazioni persistenti tra la catechina e le proteine selezionate. Il complesso PYGL–catechina ha mantenuto nel tempo un numero maggiore di legami a idrogeno rispetto ai complessi MMP9 e GADD45A, suggerendo interazioni di legame più forti e più stabili (Figura 7D).
La flessibilità a livello di residuo è stata valutata utilizzando l'RMSF. I risultati hanno mostrato che la maggior parte dei residui presentava basse fluttuazioni, con solo alcune regioni che mostravano una maggiore flessibilità, indicando che il legame del ligando non ha indotto un'instabilità strutturale significativa nelle proteine (Figura 7E). Nel complesso, questi risultati suggeriscono che la catechina forma complessi previsti stabili con MMP9, PYGL e GADD45A, con la maggiore stabilità osservata nell'interazione tra PYGL e catechina. Questi risultati supportano interazioni previste stabili tra la catechina e le proteine selezionate, fornendo evidenze computazionali per ulteriori conferme sperimentali.
Disponibilità dei dati:
In questo studio sono stati analizzati dataset pubblicamente disponibili. Il dataset di RNA-seq su campione bulk è disponibile nell'archivio Gene Expression Omnibus (GEO) con il numero di accessione GSE261482 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482), e il dataset di scRNA-seq del polmone murino è disponibile con il numero di accessione GSE295484 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484). Gli output elaborati utilizzati nell'articolo sono forniti come Tabella Supplementare S1, Tabella Supplementare S2 e Tabella Supplementare S3.
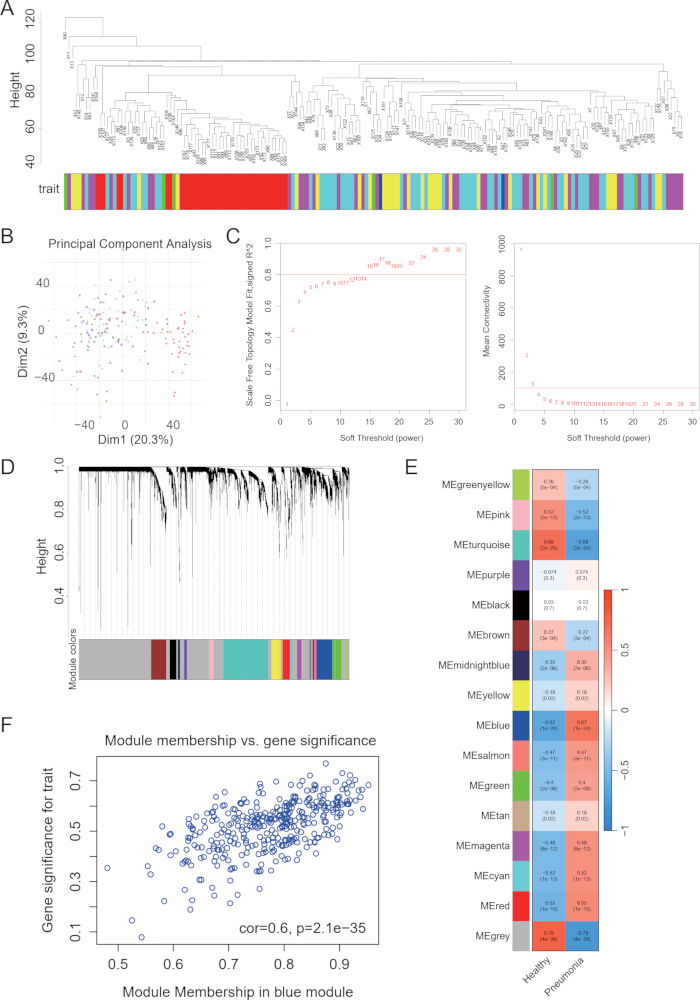
Figura 1. Costruzione della WGCNA e identificazione dei moduli associati alla malattia (A) Il raggruppamento dei campioni è stato eseguito a partire dai profili di espressione genica, e le relative annotazioni fenotipiche sono mostrate al di sotto del dendrogramma. (B) L'analisi delle componenti principali mostra la distribuzione dei campioni lungo le prime due componenti principali. (C) La potenza di soglia morbida è stata valutata utilizzando l'indice di adattamento alla topologia senza scala e la connettività media. (D) I geni sono stati raggruppati in base all'overlap topologico, e le assegnazioni ai moduli sono indicate con colori diversi. (E) Le correlazioni tra gli eigengeni dei moduli e i tratti clinici sono mostrate sotto forma di mappa termica. (F) La relazione tra l'appartenenza al modulo e la significatività del gene è mostrata per i geni del modulo blu. Cliccare qui per visualizzare una versione ingrandita di questa figura.
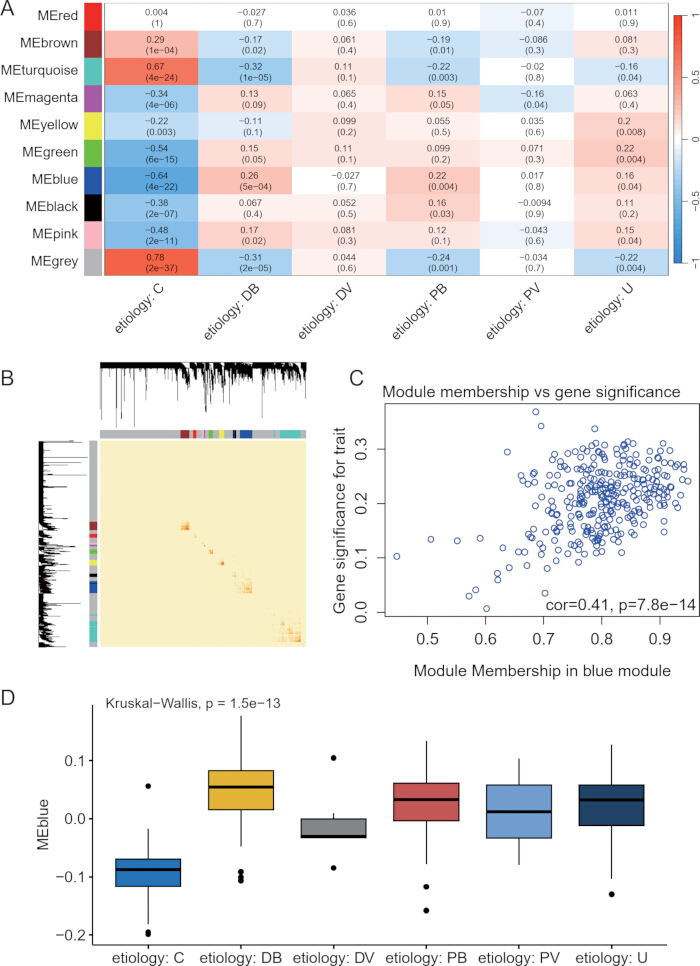
Figura 2. Analisi WGCNA basata sull'eziologia della polmonite. (A) Le correlazioni tra eigengeni dei moduli sono mostrate per i gruppi eziologici, inclusi controllo, batterico definitivo, virale definitivo, batterico probabile, virale probabile e sconosciuto. (B) I moduli genici sono stati assegnati dal dendrogramma di clustering basato sull'overlap topologico. (C) Appartenenza al modulo e significatività genica sono riportate per il modulo blu. (D) L'espressione dell'eigengene del modulo blu viene confrontata tra i gruppi eziologici. Abbreviazioni: WGCNA = analisi della rete di co-espressione genica pesata; C = controllo; DB = batterico definitivo; DV = virale definitivo; PB = batterico probabile; PV = virale probabile; U = sconosciuto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
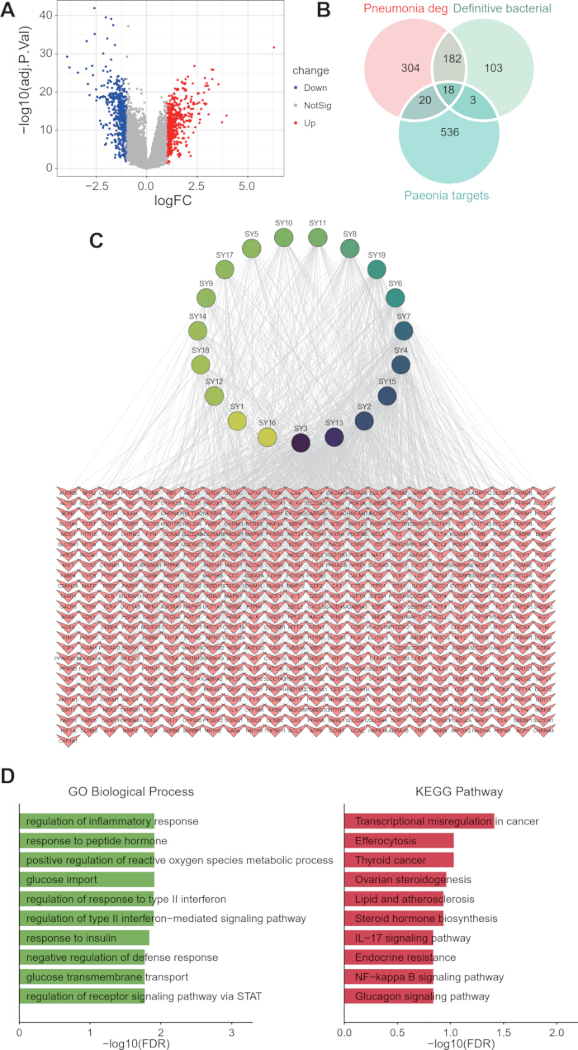
Figura 3. Identificazione e analisi funzionale dei geni candidati. (A) Diagramma a vulcano che mostra i geni differenzialmente espressi tra campioni di polmonite e controlli. (B) Diagramma di Venn che mostra l'intersezione tra i geni differenzialmente espressi nella polmonite, i geni associati a batteri definitivi e i geni bersaglio di Paeonia. (C) Rete di interazione tra composti e bersagli tra i componenti attivi di Paeonia e i geni candidati. (D) Istogrammi che mostrano l'arricchimento dei processi biologici secondo la Gene Ontology (a sinistra) e l'arricchimento dei percorsi metabolici secondo KEGG (a destra) per i geni sovrapposti. Cliccare qui per visualizzare una versione ingrandita di questa figura.
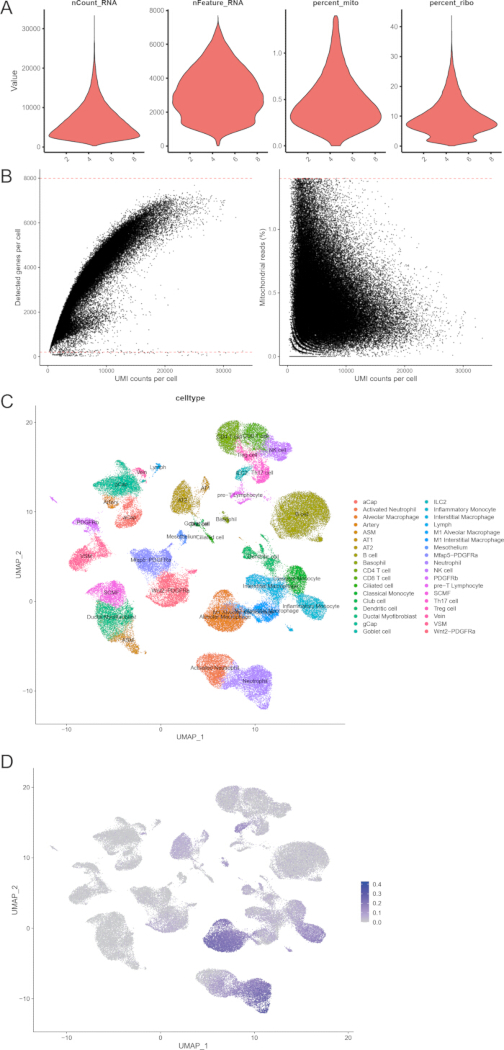
Figura 4. Analisi trascrittomica a singola cellula della polmonite. (A) I grafici a violino riassumono le metriche di controllo qualità, inclusi nCount_RNA, nFeature_RNA, percentuale di geni mitocondriali e percentuale di geni ribosomiali. (B) Grafici a dispersione che mostrano le relazioni tra i conteggi UMI, i geni rilevati per cellula e la percentuale di geni mitocondriali. (C) Visualizzazione UMAP dei cluster cellulari annotati per tipo cellulare. (D) Grafico UMAP che mostra i punteggi AUCell per la firma genica candidata attraverso le singole cellule. Cliccare qui per visualizzare una versione ingrandita di questa figura.
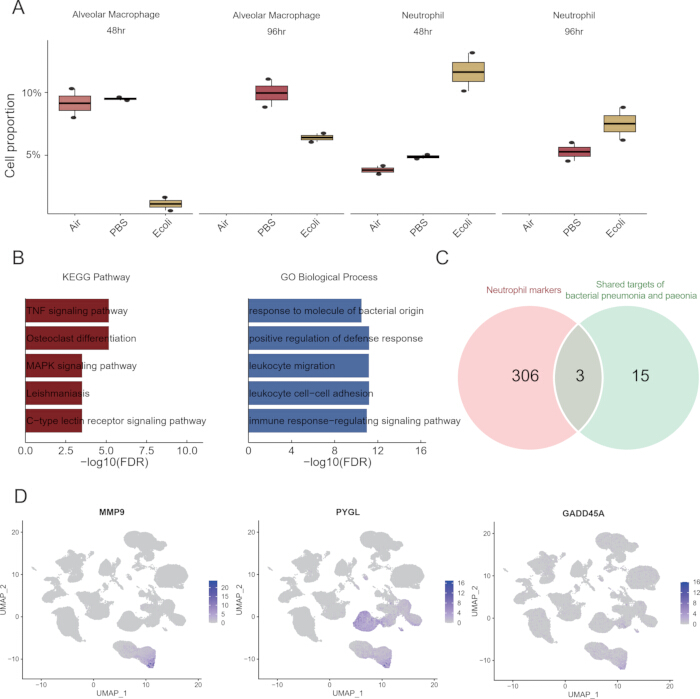
Figura 5. Dinamiche dei neutrofili e identificazione dei geni chiave. (A) Boxplot che mostrano le proporzioni cellulari di macrofagi alveolari e neutrofili in diverse condizioni (aria, PBS e E. coli) a 48 h e 96 h. (B) Istogrammi che mostrano l'arricchimento del percorso KEGG (sinistra) e l'arricchimento del processo biologico GO (destra) per i geni marcatore dei neutrofili. (C) Diagramma di Venn che mostra l'intersezione tra i geni marcatore dei neutrofili e le proteine bersaglio condivise dalla polmonite batterica e Paeonia. (D) Grafici UMAP che mostrano i modelli di espressione di MMP9, PYGL e GADD45A nelle diverse popolazioni cellulari. Cliccare qui per visualizzare una versione ingrandita di questa figura.
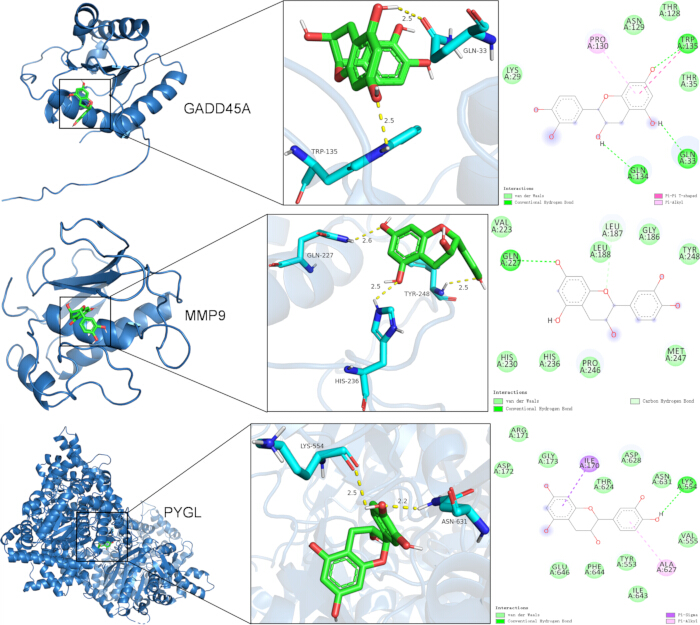
Figura 6. Docking molecolare della catechina con proteine selezionate. Strutture tridimensionali di complessi proteina-ligando che mostrano il legame della catechina con GADD45A (in alto), MMP9 (al centro) e PYGL (in basso). I riquadri ingranditi mostrano le regioni di legame e i contatti con i principali residui amminoacidici. I diagrammi bidimensionali illustrano i legami a idrogeno e altre interazioni tra la catechina e le proteine selezionate. Cliccare qui per visualizzare una versione ingrandita di questa figura.
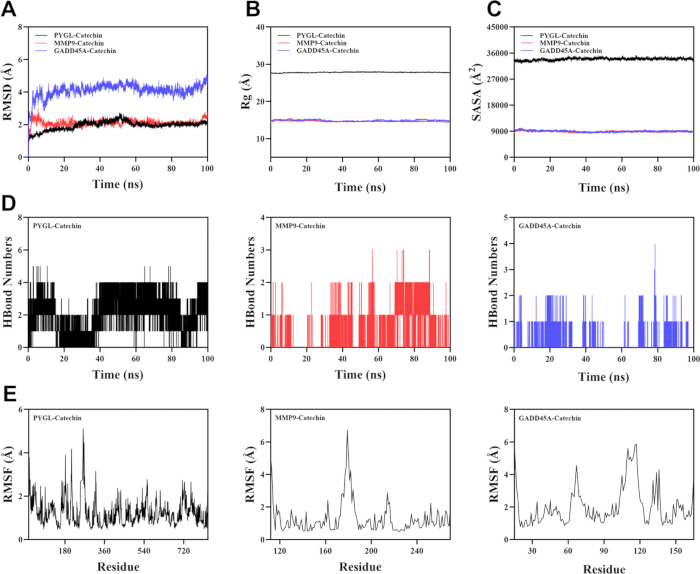
Figura 7. Simulazioni di dinamica molecolare di complessi proteina-ligando. (A) Deviazione quadratica media dei complessi durante la simulazione. (B) Variazioni del raggio di ghirigoro nel tempo. (C) Area superficiale accessibile al solvente durante la simulazione. (D) Numero di legami a idrogeno tra la catechina e le proteine bersaglio nel tempo. (E) Fluttuazione quadratica media dei residui proteici in ciascun complesso. Abbreviazioni: RMSD = deviazione quadratica media; Rg = raggio di ghirigoro; SASA = area superficiale accessibile al solvente; RMSF = fluttuazione quadratica media. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella Supplementare S1. Geni differenzialmente espressi upregolati nei campioni pediatrici di polmonite rispetto ai campioni di controllo sani, inclusi i simboli genici, i cambiamenti del log2 rispetto al controllo, i valori P, i valori P aggiustati e le relative statistiche limma. Cliccare qui per scaricare il file.
Tabella Supplementare S2. Tabella delle interazioni composti-target per Paeonia utilizzata per l'analisi di rete, contenente identificatori dei composti, nomi dei composti e geni target associati. Cliccare qui per scaricare questo file.
Tabella supplementare S3. Tabella dei geni marcatore da singola cellula da GSE295484, inclusi valori P, log2 fold change medi, percentuali di espressione, valori P aggiustati, annotazioni dei cluster cellulari e simboli dei geni. Cliccare qui per scaricare il file.
Discussione
La polmonite è una delle principali cause globali di malattia e mortalità nei neonati e nei bambini piccoli, determinando un notevole carico per la salute pubblica1. La patogenesi della polmonite pediatrica è complessa e coinvolge numerosi processi interconnessi, tra cui risposte infiammatorie eccessive, stress ossidativo e disregolazione delle vie immunitarie e metaboliche2,10,11. Studi precedenti hanno suggerito che l'attivazione incontrollata delle cellule immunitarie innate, in particolare neutrofili e macrofagi, contribuisce al danno del tessuto polmonare attraverso il rilascio di citochine pro-infiammatorie, enzimi proteolitici e specie reattive dell'ossigeno (ROS)12. Nonostante i progressi nelle terapie antimicrobiche e di supporto, strategie efficaci mirate a questi meccanismi molecolari sottostanti rimangono limitate. Pertanto, identificare nuovi agenti terapeutici in grado di modulare l'infiammazione e ripristinare l'omeostasi immunitaria riveste grande importanza.
I fitochimici, in particolare le catechine, hanno attirato un'attenzione crescente a causa delle loro proprietà anti-infiammatorie, antiossidanti e immunomodulanti ben documentate13,14,15. Tuttavia, i precisi meccanismi molecolari attraverso cui la catechina esercita i suoi effetti protettivi nella polmonite rimangono in gran parte poco chiari. Questo studio ha esplorato sistematicamente i potenziali meccanismi associati alle catechine nella polmonite pediatrica, utilizzando un approccio integrato che combina trascrittomica, sequenziamento dell'RNA a singola cellula, docking molecolare e simulazioni di dinamica molecolare.
In linea con l'ipotesi iniziale, i risultati hanno dimostrato che il modulo blu identificato mediante WGCNA era significativamente associato sia allo stato della malattia sia alla classificazione eziologica, suggerendo che questo modulo rappresenti un programma trascrizionale centrale coinvolto nella polmonite pediatrica. L'ulteriore integrazione dell'analisi dell'espressione differenziale e della previsione dei bersagli di Paeonia ha rivelato 18 geni sovrapposti, arricchiti in percorsi correlati al sistema immunitario, tra cui la risposta infiammatoria, il metabolismo delle specie reattive dell'ossigeno e la segnalazione dell'interferone di tipo II16,17. Questi risultati ulteriormente sostengono l'idea che risposte immunitarie disregolate e lo stress ossidativo siano i principali fattori alla base della progressione della malattia.
L'analisi del sequenziamento dell'RNA a singola cellula ha ulteriormente rivelato che il set di geni candidati era prevalentemente arricchito nei neutrofili e nei macrofagi alveolari, evidenziando il ruolo centrale delle cellule immunitarie innate nella progressione della polmonite. Le proporzioni di neutrofili sono aumentate significativamente in seguito alla stimolazione con E. coli, in particolare a 48 h e 96 h, indicando un'attivazione prolungata durante l'infiammazione acuta, il che è coerente con il loro ruolo duplice nella rimozione dei patogeni e nel danno tissutale mediato da fattori infiammatori e specie reattive dell'ossigeno (ROS)18. Un'analisi più approfondita ha identificato tre geni chiave—MMP9, PYGL e GADD45A—come possibili collegamenti tra risposte immunitarie, regolazione metabolica e stress cellulare. Mentre MMP9 è coinvolta nel rimodellamento della matrice extracellulare e nell'infiltrazione infiammatoria19, e GADD45A regola le risposte allo stress e immunitarie, PYGL suggerisce un ruolo del riprogrammamento metabolico nell'attivazione immunitaria20,21. Simulazioni di docking molecolare e dinamica molecolare hanno indicato un legame previsto stabile della catechina con queste proteine selezionate, supportato da energie di legame favorevoli e profili stabili di RMSD, Rg e SASA, insieme a legami idrogeno persistenti e valori bassi di RMSF. Questi risultati suggeriscono che la catechina potrebbe essere associata a questi bersagli infiammatori e metabolici, ma effetti regolatori diretti richiedono ulteriori conferme sperimentali22.
Oltre ai suoi effetti antinfiammatori, la catechina può esercitare anche ruoli protettivi modulando lo stress ossidativo e l'equilibrio metabolico. L'arricchimento di percorsi correlati alle ROS suggerisce che la catechina possa attenuare i danni ossidativi aumentando la capacità antiossidante, in accordo con precedenti studi sulle proprietà antiossidanti delle catechine. Inoltre, il coinvolgimento di enzimi metabolici come PYGL evidenzia un potenziale ruolo della catechina nella regolazione dell'immunometabolismo, un concetto emergente nelle malattie infiammatorie.
Diversi limiti di questo studio devono essere riconosciuti. In primo luogo, lo studio si è basato principalmente su set di dati trascrittomici disponibili pubblicamente e su analisi computazionali, e i meccanismi predetti non sono ancora stati validati sperimentalmente. Sebbene il docking molecolare e le simulazioni di dinamica molecolare abbiano suggerito interazioni stabili tra la catechina e le proteine bersaglio candidate, questi risultati non dimostrano un'inibizione funzionale, un'attivazione o un'efficacia terapeutica. Sono necessari ulteriori saggi biochimici, esperimenti cellulari e studi in vivo per validare gli effetti regolatori della catechina su MMP9, PYGL e GADD45A e per determinarne la rilevanza terapeutica nella polmonite. In secondo luogo, le informazioni cliniche disponibili per il dataset sulla polmonite pediatrica erano limitate. Il dataset GSE261482 forniva dati trascrittomici da sangue intero di pazienti pediatrici con polmonite e controlli sani, insieme a metadati che includevano sesso, classificazione eziologica, tipo di provetta per il prelievo, lotto e condizione della malattia.
Tuttavia, variabili cliniche dettagliate, inclusa l'età individuale, la gravità della polmonite, lo stato di trattamento al momento del campionamento e altre informazioni sul decorso della malattia, non erano completamente disponibili nei metadati GEO utilizzati in questo studio. Pertanto, non è stato possibile eseguire ulteriori analisi stratificate in base alla gravità clinica, alla fase del trattamento o al sottogruppo di età. In terzo luogo, i dataset di RNA-seq su popolazione totale e di RNA-seq a singola cellula derivavano da contesti biologici diversi. GSE261482 è stato ottenuto da campioni di sangue intero di pazienti pediatrici, mentre GSE295484 è stato ottenuto da tessuti polmonari di topi C57BL/6 di tipo selvaggio in un modello sperimentale di polmonite. Di conseguenza, i risultati ottenuti a livello di singola cellula devono essere interpretati come evidenze di supporto nel contesto cellulare riguardo alle popolazioni di cellule infiammatorie e alla distribuzione dei geni candidati, piuttosto che come una validazione diretta nella polmonite pediatrica umana. Inoltre, il modello di polmonite murino indotta da E. coli non rappresenta pienamente le eterogenee eziologie della polmonite pediatrica, tra cui cause batteriche, virali, probabilmente batteriche, probabilmente virali e di origine sconosciuta.
Infine, la selezione di MMP9, PYGL e GADD45A si è basata su uno screening bioinformatico integrativo e sulla nota rilevanza biologica, ma i loro ruoli precisi nell'infiammazione associata ai neutrofili e nella regolazione mediata dalle catechine devono ancora essere confermati. Sono necessari studi futuri che utilizzino coorti cliniche pediatriche, dataset umani a singola cellula, saggi funzionali specifici per bersaglio e modelli sperimentali di polmonite per validare questi risultati e chiarire il potenziale traslazionale delle catechine.
In sintesi, questo studio suggerisce che la catechina potrebbe essere associata a risposte infiammatorie correlate ai neutrofili e a geni selezionati coinvolti nella regolazione immunitaria, nello stress ossidativo e nelle vie metaboliche nella polmonite. Mediante un'analisi integrata di sequenziamento RNA su popolazione cellulare, sequenziamento RNA a singola cellula, docking molecolare e simulazioni di dinamica molecolare, questo studio ha identificato un modulo genico associato alla malattia e ha selezionato MMP9, PYGL e GADD45A per le analisi di docking e simulazione con la catechina. L'arricchimento dei geni candidati nei neutrofili e nei macrofagi alveolari, insieme alle interazioni previste stabili osservate tra la catechina e le proteine selezionate, supporta un meccanismo potenziale da validare sperimentalmente. Nel complesso, questi risultati offrono una prospettiva a livello di sistema sui possibili meccanismi associati alla catechina nella polmonite, ma ulteriori studi sperimentali e clinici sono necessari per confermare tali osservazioni e chiarirne la rilevanza terapeutica.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Campo di forze AMBER14SB Tipo: Campo di forze | Campo di forze proteico per simulazioni di dinamica molecolare | ||
| Pacchetto R AUCell Tipo: Pacchetto R | Valutazione dell'attività di geni in singole cellule | ||
| AutoDock Tools Tipo: Software | Preparazione di recettore e ligando | ||
| AutoDock Vina Tipo: Software | Docking molecolare | ||
| BindingDB Tipo: Database | BindingDB | Interazioni sperimentali tra composti e bersagli; URL/versione non forniti nel manoscritto | |
| Pacchetto R clusterProfiler Tipo: Pacchetto R | Analisi di arricchimento GO e KEGG | ||
| DrugBank Tipo: Database | DrugBank | Interazioni sperimentali tra composti e bersagli; URL/versione non forniti nel manoscritto | |
| Database ETCM Tipo: Database | ETCM | Selezione di composti attivi della Paeonia; URL/versione non forniti nel manoscritto | |
| Campo di forze GAFF2 Tipo: Campo di forze | Campo di forze per ligandi nelle simulazioni di dinamica molecolare | ||
| GROMACS 2022 Tipo: Software | GROMACS | Simulazione di dinamica molecolare | |
| GSE261482 Tipo: Dataset pubblico di RNA-seq bulk | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482 | Dati di espressione da sangue intero di pazienti pediatrici con polmonite e controlli sani |
| GSE295484 Tipo: Dataset pubblico di scRNA-seq | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484 | Dati di sequenziamento dell'RNA a singola cellula da polmone di topo in un modello sperimentale di polmonite |
| Pacchetto R limma Tipo: Pacchetto R | Analisi di espressione differenziale | ||
| Server PharmMapper Tipo: Database/strumento | PharmMapper | http://lilab.ecust.edu.cn/pharmmapper/ | Mappatura farmacoforica inversa |
| Protein Data Bank (PDB) Tipo: Database | Protein Data Bank | Strutture proteiche per GADD45A (2KG4), MMP9 (6ESM) e PYGL (3DDS) | |
| Database PubChem Tipo: Database | PubChem | Struttura tridimensionale della catechina | |
| Software R Tipo: Software | R Project | Analisi statistiche | |
| Pacchetto R Seurat Tipo: Pacchetto R | Controllo qualità, normalizzazione, clustering, visualizzazione UMAP e annotazione cellulare nei dati di RNA-seq a singola cellula | ||
| Similarity Ensemble Approach (SEA) Tipo: Database/strumento | SEA | http://sea.bkslab.org | Predizione di interazioni potenziali fuori bersaglio |
| sobtop_1.0 (dev3.1) Tipo: Software | Generazione di parametri per ligandi | ||
| SwissTargetPrediction Tipo: Database/strumento | SwissTargetPrediction | http://www.swisstargetprediction.ch | Predizione dei bersagli di un composto |
| Modello d'acqua TIP3P Tipo: Modello d'acqua | Solvatazione di complessi proteina-ligando | ||
| Traditional Chinese Medicine Systems Pharmacology Database (TCMSP) Tipo: Database | TCMSP | https://tcmsp-e.com | Selezione di composti attivi della Paeonia |
| Database UniProt Tipo: Database | UniProt | https://www.uniprot.org | Standardizzazione dei simboli genici |
| Pacchetto R WGCNA Tipo: Pacchetto R | Analisi di reti di co-espressione genica pesata |
Riferimenti
- Chen L, Chen Y, Huang J, Zhang J. LncRNA LINC00707 serves as a sponge of miR-382-5p to alleviate lipopolysaccharide (LPS)-induced WI-38 cell injury through upregulating NKAP in infantile pneumonia. Autoimmunity. 2022;55(5):328-38.
- Li S et al. miRNA-302e attenuates inflammation in infantile pneumonia through the RelA/BRD4/NF-κB signaling pathway. Int J Mol Med. 2019;44(1):47-56.
- Kennedy II DE et al. Contribution of Puma to inflammatory resolution during early pneumococcal pneumonia. Front Cell Infect Microbiol. 2022;12:886901.
- Wang C et al. Suppressing neutrophil itaconate production attenuates Mycoplasma pneumoniae pneumonia. PLoS Pathog. 2024;20(11):e1012614.
- Shen N et al. Plant flavonoids: classification, distribution, biosynthesis, and antioxidant activity. Food Chem. 2022;383:132531.
- Peng X, McClements DJ, Liu X, Liu F. EGCG-based nanoparticles: synthesis, properties, and applications. Crit Rev Food Sci Nutr. 2025;65(12):2177-98.
- Li T et al. Synergistic anti-inflammatory effects of quercetin and catechin via inhibiting activation of TLR4-MyD88-mediated NF-κB and MAPK signaling pathways. Phytother Res. 2019;33(3):756-67.
- Viz-Lasheras S et al. A diagnostic host-specific transcriptome response for Mycoplasma pneumoniae pneumonia to guide pediatric patient treatment. Nat Commun. 2025;16(1):673.
- Michki SN et al. Age-dependent immune responses and resident cell dynamics in young mice following pneumonia. iScience. 2026;29(1):114219.
- Jin M et al. Catechin-functionalized cationic lipopolymer based multicomponent nanomicelles for lung-targeting delivery. Adv Mater. 2024;36(17):e2302985.
- Shin-Ya M et al. Effects of tea, catechins and catechin derivatives on Omicron subvariants of SARS-CoV-2. Sci Rep. 2023;13(1):16577.
- Zheng Q, Li J, Yang L. Systematic investigation of catechin/cyclodextrin encapsulated polymeric nanospheres for the treatment and nursing care of pediatric pneumonia-causing human pathogens. Microb Pathog. 2025;205:107524.
- Zhang Y et al. Anti-inflammatory effect of chlorogenic acid in Klebsiella pneumoniae-induced pneumonia by inactivating the p38MAPK pathway. Int J Med Microbiol. 2023;313(2):151576.
- Gleeson K, Reynolds HY. Life-threatening pneumonia. Clin Chest Med. 1994;15(3):581-602.
- Ross SM. Resveratrol: the anti-inflammatory effects of a phytochemical compound on pneumonia, respiratory syncytial virus, and severe acute respiratory syndrome (SARS-CoV-2). Holist Nurs Pract. 2023;37(2):110-2.
- Hu H et al. Hybrid biomimetic membrane coated particles-mediated bacterial ferroptosis for acute MRSA pneumonia. ACS Nano. 2023;17(12):11692-712.
- Dong L et al. A ROS-responsive nanoprodrug-engineered phage biotherapy for precision treatment of multidrug-resistant Gram-negative bacterial pneumonia. J Control Release. 2025;382:113708.
- Wiegman CH et al. Oxidative stress in ozone-induced chronic lung inflammation and emphysema: a facet of chronic obstructive pulmonary disease. Front Immunol. 2020;11:1957.
- Jiang T et al. Dual role of Baimao-Longdan-Congrong-Fang in inhibiting Staphylococcus aureus virulence factors and regulating TNF-α/TNFR1/NF-κB/MMP9 axis. Phytomedicine. 2025;139:156477.
- Zhang H et al. The attenuated Mycoplasma bovis strain promotes apoptosis of bovine macrophages by upregulation of CHOP expression. Front Microbiol. 2022;13:925209.
- Borella R et al. Metabolic reprograming shapes neutrophil functions in severe COVID-19. Eur J Immunol. 2022;52(3):484-502.
- Xu Y et al. Exosomal miR-155-5p drives widespread macrophage M1 polarization in hypervirulent Klebsiella pneumoniae-induced acute lung injury via the MSK1/p38-MAPK axis. Cell Mol Biol Lett. 2023;28(1):92.