Questo protocollo di scienze comportamentali e valutazione psicologica standardizza la somministrazione online di questionari, la valutazione dei punteggi, il controllo della qualità dei dati e l'analisi riproducibile per valutare la dipendenza da internet e le difficoltà di regolazione emotiva tra gli studenti universitari.
Articolo metodologico
Un protocollo di questionario standardizzato per la valutazione della dipendenza da Internet e della regolazione emotiva negli studenti universitari
In questo articolo
Sommario
Abstract
L'uso di Internet è profondamente radicato nella vita universitaria, ma l'uso problematico di Internet non può essere valutato adeguatamente solo in base al tempo di esposizione. Evidenze indicano che modelli di uso maladattivo o compulsivo di Internet sono associati a difficoltà nella regolazione delle emozioni, tuttavia, incongruenze nell'ordine dei questionari, nei criteri di idoneità, nelle soglie di screening, nelle procedure di punteggio e nella presentazione analitica dei dati continuano a limitare il confronto tra studi. Questo articolo metodologico presenta un protocollo standardizzato di somministrazione di questionari per studi di scienze comportamentali e valutazioni psicologiche che indagano la dipendenza da Internet e le difficoltà nella regolazione delle emozioni tra studenti universitari. Il flusso di lavoro comprende una sequenza fissa di questionari, criteri di idoneità predeterminati, impostazioni obbligatorie di risposta, soglie di tempo di completamento basate su test preliminari, screening sequenziale della qualità dei dati, calcolo standardizzato del punteggio del test sulla dipendenza da Internet e della scala a 16 voci sulle difficoltà nella regolazione delle emozioni, nonché analisi descrittive, correlate e di regressione multivariata riproducibili. Il protocollo prevede inoltre l'archiviazione delle risposte grezze, dei registri di screening, dei file README/manuali del codice e del dataset finale pronto per l'analisi. Viene riportata un'implementazione rappresentativa per dimostrare l'esecuzione del protocollo, piuttosto che per validare gli strumenti o stabilire la prevalenza. In tale implementazione, sono stati invitati 520 studenti e sono state raccolte 480 risposte. Dopo l'esclusione sequenziale di sottomissioni duplicate, risposte troppo rapide, fallimento dei controlli di attenzione, modelli di risposta sistematici, incongruenze logiche e dati mancanti essenziali, sono state conservate 452 risposte valide. La dimostrazione analitica predefinita ha esaminato l'associazione tra il punteggio totale del test sulla dipendenza da Internet e il punteggio totale della scala sulle difficoltà nella regolazione delle emozioni. Il campione conservato ha mostrato un punteggio medio totale di 51,94 nel test sulla dipendenza da Internet e un punteggio medio totale di 35,95 nella scala sulle difficoltà nella regolazione delle emozioni. La difficoltà nella regolazione delle emozioni è aumentata attraverso i gruppi di gravità della dipendenza da Internet e l'associazione è rimasta evidente anche dopo aggiustamento per covariate demografiche e comportamentali. Questo protocollo fornisce un flusso di lavoro trasparente che può essere ripetuto, verificato e adattato per futuri studi trasversali, ripetuti nel tempo o longitudinali in popolazioni universitarie.
Introduzione
L'uso di Internet è diventato una parte ordinaria della vita universitaria, inclusi il lavoro accademico, la comunicazione sociale, l'intrattenimento, la ricerca di informazioni e la gestione emotiva. Per questo motivo, il comportamento degli studenti riguardo a Internet non dovrebbe essere interpretato semplicemente come esposizione allo schermo o tempo trascorso online. Evidenze precedenti hanno mostrato che un uso problematico di Internet era già osservabile tra giovani e studenti universitari prima che l'ambiente basato su piattaforme mobili diventasse altamente diffuso1. Studi più recenti condotti nell'ambiente universitario indicano inoltre che l'uso problematico di Internet è abbastanza frequente da richiedere una valutazione sistematica piuttosto che una descrizione informale2.
Gli studenti universitari rappresentano una popolazione particolarmente rilevante per la valutazione standardizzata poiché pressioni accademiche, transizioni sociali, vita indipendente e maggiore autonomia si verificano spesso nella stessa fase dello sviluppo. Queste esigenze sono spesso gestite attraverso gli stessi dispositivi digitali e piattaforme che possono anche risultare difficili da regolare. Una revisione metanalitica ha mostrato che l'uso problematico di internet tra gli studenti è associato a numerosi esiti legati alla salute mentale, sostenendone l'interpretazione come preoccupazione comportamentale e psicologica più ampia piuttosto che come un semplice problema legato all'uso della tecnologia3. Lo stress percepito è stato inoltre associato a modelli di dipendenza da internet tra gli studenti universitari, suggerendo che pressioni emotive e contestuali dovrebbero essere prese in considerazione quando si progettano studi basati su questionari in questo campo4.
Il presente protocollo utilizza il termine «dipendenza da internet» quando si riferisce specificamente al costrutto misurato dal test sulla dipendenza da internet e dalle sue categorie di punteggio stabilite. Il termine più ampio «uso problematico di internet» viene impiegato quando si discute della letteratura più generale sui comportamenti maladattivi, eccessivi o che compromettono la funzionalità legati all'uso di internet. L'espressione «uso compulsivo di internet» è utilizzata soltanto quando la letteratura citata enfatizza la perdita di controllo, le impulsi o l'uso ripetitivo nonostante le conseguenze negative. Questi termini sono pertanto correlati, ma non vengono considerati del tutto intercambiabili. Quando il protocollo viene applicato con il Test sulla dipendenza da internet, si mantiene il termine «dipendenza da internet» come terminologia specifica dello strumento; quando vengono utilizzati strumenti alternativi o modificati, la terminologia dovrebbe essere allineata alle etichette del costrutto e alle assunzioni diagnostiche dello strumento selezionato.
La regolazione delle emozioni rappresenta un punto di ingresso psicologico plausibile per comprendere perché alcuni studenti passano da un uso frequente a un uso maladattivo di internet. Uno studio prospettico di un anno ha mostrato che la difficoltà nella regolazione delle emozioni è correlata sia all'insorgenza successiva sia alla remissione della dipendenza da internet tra gli studenti universitari5. Questo risultato è importante per la progettazione del protocollo, poiché la regolazione delle emozioni non è semplicemente un fattore associato aggiuntivo; potrebbe influenzare il modo in cui gli studenti utilizzano internet per evitare, ridurre o gestire lo stato di disagio. Allo stesso tempo, rimane rilevante la funzione sociale. L'uso problematico di internet è stato associato alle capacità sociali tra gli studenti universitari, indicando che fattori interpersonali ed emotivi dovrebbero essere valutati insieme alle variabili relative all'uso digitale6. Durante il periodo della pandemia da COVID-19, l'uso problematico di internet si è verificato contemporaneamente ad altre difficoltà psicologiche più ampie tra gli studenti universitari cinesi, ulteriormente confermando la necessità di una valutazione strutturata nei contesti universitari7.
Un'ulteriore sfida è che il comportamento digitale è eterogeneo. Gli studenti possono utilizzare piattaforme digitali per studio, contatti sociali, intrattenimento, informazioni sanitarie o sollievo emotivo temporaneo, e non tutto l'uso ad alta frequenza è dannoso. Una revisione sistematica sull'uso digitale correlato alla salute mentale negli studenti universitari ha mostrato che l'interazione digitale può svolgere molteplici funzioni psicologiche8. È quindi necessario sviluppare procedure in grado di distinguere un uso comune ad alta frequenza da un uso problematico o disregolato. Evidenze recenti sull'uso problematico dello smartphone negli studenti universitari suggeriscono in modo analogo che il rischio dipenda dal modello comportamentale, dalla funzione e dal contesto, piuttosto che dalla durata dell'uso da sola9. Per questo motivo, il presente protocollo combina durata dell'uso di internet, utilizzo notturno, attività online principale e punteggio sintomatologico standardizzato, invece di basarsi su un singolo indicatore di esposizione.
La misurazione rappresenta un'altra importante fonte di incoerenza. Il test per la dipendenza da Internet rimane uno degli strumenti più utilizzati per valutare i sintomi di tale dipendenza, ma la sua dimensionalità e interpretazione sono variate in diversi contesti. Evidenze psicometriche sistematiche indicano che lo strumento è stato ampiamente impiegato, pur sollevando continuamente interrogativi riguardo alla struttura fattoriale e all'interpretazione del punteggio10. Preoccupazioni simili sono state riportate in campioni di studenti universitari, nei quali l'ampio utilizzo della scala non ha completamente risolto l'incertezza riguardo al costrutto misurato11. Studi di validazione in popolazioni universitarie spagnole e peruviane mostrano anche che lo strumento può funzionare adeguatamente, ma che il suo comportamento psicometrico dovrebbe essere valutato all'interno della popolazione target in cui viene applicato12,13.
Il protocollo è quindi progettato per essere stabile nel flusso di lavoro, ma adattabile nella scelta dello strumento. Il test sull'addiction da Internet viene utilizzato in questo contesto a causa del suo utilizzo storico, delle soglie disponibili e della confrontabilità con ricerche precedenti condotte su studenti universitari. Tuttavia, il protocollo non richiede che il test sull'addiction da Internet rimanga indefinitamente lo strumento preferito. Se i framework diagnostici evolvono o se strumenti più recenti risultano più appropriati per una specifica popolazione, lo stesso flusso di lavoro può essere mantenuto sostituendo il modulo specifico per la scala, l'intervallo dei punteggi, le soglie di gravità, le voci del codice e la documentazione README. Ogni sostituzione di questo tipo deve essere effettuata prima dell'inizio della raccolta formale dei dati e deve essere riportata come una modifica al protocollo piuttosto che come un cambiamento analitico ad hoc.
Il problema metodologico affrontato da questo articolo non è semplicemente che gli studi sulla dipendenza da internet e sulla regolazione emotiva giungano a conclusioni diverse. Piuttosto, molti studi differiscono per la sequenza dei questionari, i criteri di idoneità, le impostazioni della piattaforma di indagine, la gestione delle risposte duplicate, le procedure di controllo dell'attenzione, le soglie di tempo di completamento, le regole per i dati mancanti, la verifica dei punteggi e la segnalazione dei file pronti per l'analisi. Queste differenze rendono difficile confrontare, riprodurre e includere i risultati in successive sintesi delle evidenze. Il presente protocollo risponde a questa lacuna stabilendo in modo fisso la sequenza di somministrazione, la logica di screening, la struttura di punteggio e il percorso analitico, in modo che possano essere ripetuti, verificati e modificati in maniera trasparente. Il suo contributo è quindi orientato al protocollo: fornisce un flusso di lavoro riproducibile per studi osservazionali di scienze comportamentali e di valutazione psicologica in popolazioni universitarie, piuttosto che proporre un nuovo costrutto psicologico o presentare uno studio di prevalenza come risultato principale.
Protocollo
Lo studio, intitolato «Un protocollo standardizzato di questionario per la valutazione della dipendenza da Internet e della regolazione emotiva negli studenti universitari», è stato esaminato e approvato dal Comitato Etico e Accademico dell'Università di Economia e Commercio di Zhengzhou con il numero di approvazione 20260113004 prima dell'inizio del reclutamento dei partecipanti14. Lo studio ha adottato un disegno trasversale, anonimo e basato su un questionario online rivolto a studenti universitari a tempo pieno di età compresa tra 18 e 24 anni ed è stato condotto in conformità ai requisiti etici istituzionali e alla Dichiarazione di Helsinki. Il consenso informato elettronico è stato ottenuto prima dell'accesso al questionario. Ai partecipanti è stata fornita una scheda informativa elettronica contenente finalità dello studio, procedure, natura volontaria della partecipazione e misure di protezione dei dati, e hanno potuto ritirarsi in qualsiasi momento senza alcuna penalizzazione. Nessuna informazione personale direttamente identificabile, inclusi nome, numero di identificazione dello studente, indirizzo esatto, numero di telefono, indirizzo e-mail personale o account di social media, è stata raccolta nel file principale del sondaggio. Gli identificatori generati dalla piattaforma sono stati utilizzati esclusivamente per il controllo delle risposte duplicate e sono stati rimossi prima dell'analisi del dataset. Tutti i dati sono stati archiviati in modo sicuro e analizzati in forma anonima. Questo flusso di lavoro del questionario non è stato registrato preventivamente prima dell'inizio del reclutamento dei partecipanti. Tuttavia, tutti i componenti principali del protocollo, inclusa la versione definitiva del questionario, il file README/manuale delle codifiche, il registro di screening, le regole di punteggio, la sintassi di analisi e i file del flusso di lavoro pronti per l'analisi, sono stati archiviati e forniti come materiali supplementari del flusso di lavoro al fine di garantire riproducibilità e verificabilità.
Gli identificatori di risposta generati dalla piattaforma e gli identificatori tecnici limitati al dispositivo o all'account sono stati utilizzati esclusivamente per lo screening delle risposte duplicate e sono stati rimossi dal set di dati analitici finale anonimizzato. Le variabili principali e le regole di punteggio sono riassunte nella Tabella 1, mentre il dizionario completo delle variabili è fornito nella Tabella Supplementare 1. I file del questionario, il codebook, il registro di screening, il piano di output e i materiali del flusso di lavoro pronti per l'analisi sono forniti nel File Supplementare 1.
| Domini | Variabile | Codifica/Valutazione | Ruolo nel protocollo |
| Idoneità | Età | Anni; intervallo idoneo 18–24 | Variabile di idoneità e covariata |
| Dati anagrafici | Sesso | 1 = maschio; 2 = femmina; 3 = preferisco non rispondere | Variabile descrittiva e covariata nella regressione |
| Dati anagrafici | Anno accademico | 1 = primo anno; 2 = secondo anno; 3 = terzo anno; 4 = quarto anno o superiore; 5 = postlaurea | Variabile descrittiva |
| Dati anagrafici | Categoria disciplinare | 1 = scienze umanistiche e sociali; 2 = scienze e ingegneria; 3 = economia e gestione; 4 = arti e design; 5 = altro | Variabile descrittiva |
| Dati anagrafici | Tipo di residenza | 1 = dormitorio in campus; 2 = affitto fuori campus; 3 = casa familiare; 4 = altro | Variabile descrittiva |
| Dati anagrafici | Spese mensili di vita | 1 = <1.000 CNY; 2 = 1.000–1.999 CNY; 3 = 2.000–2.999 CNY; 4 = ≥3.000 CNY | Variabile descrittiva |
| Comportamento nell'uso di Internet | Uso di Internet nei giorni feriali | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariata comportamentale |
| Comportamento nell'uso di Internet | Uso di Internet nei fine settimana | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Covariata comportamentale |
| Comportamento nell'uso di Internet | Attività online principale | 1 = studio; 2 = social media; 3 = gaming; 4 = intrattenimento/video; 5 = shopping; 6 = uso misto; 7 = altro | Variabile descrittiva |
| Comportamento nell'uso di Internet | Dispositivo principale di accesso | 1 = smartphone; 2 = tablet; 3 = laptop/desktop; 4 = dispositivi misti | Variabile descrittiva |
| Comportamento nell'uso di Internet | Uso notturno dopo le 23:00 | 1 = mai; 2 = meno di una volta a settimana; 3 = 1–2 notti/settimana; 4 = 3–5 notti/settimana; 5 = quasi ogni notte | Covariata comportamentale e variabile di controllo logico |
| Scala principale | Punteggio totale IAT | Somma di 20 elementi; ogni elemento valutato da 1 a 5; intervallo totale 20–100 | Variabile indipendente principale |
| Scala principale | Gruppo di gravità IAT | 20–39 = uso normale; 40–69 = uso problematico; 70–100 = uso problematico grave | Variabile di raggruppamento |
| Scala principale | Punteggio totale DERS-16 | Somma di 16 elementi dopo la necessaria inversione di codifica; intervallo totale 16–80 | Variabile dipendente principale |
| Scala principale | Sottoscale DERS-16 | Calcolate secondo la chiave di valutazione fissa del DERS-16 | Esiti descrittivi della regolazione emotiva |
| Covariata | Durata del sonno | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Variabile di aggiustamento |
| Covariata | Attività fisica settimanale | 0 = nessuna; 1 = 1–2 sessioni; 2 = 3–4 sessioni; 3 = ≥5 sessioni | Variabile di aggiustamento |
| Covariata | Stress accademico | 1 = basso; 2 = moderato; 3 = alto | Variabile di aggiustamento |
| Controllo di qualità | Verifica dell'attenzione | 1 = superato; 0 = non superato | Criterio di esclusione |
| Controllo di qualità | Tempo di completamento | Durata del completamento in secondi | Variabile di screening basata sul tempo |
| Controllo di qualità | Numero di risposte in sequenza lunga | Lunghezza massima di risposte identiche consecutive nei 36 elementi della scala valutati | Variabile di screening per risposte strutturate |
| Controllo di qualità | Deviazione standard intra-individuale | Deviazione standard intra-individuale nei 36 elementi della scala valutati | Variabile di screening per risposte invariabili |
| Controllo di qualità | Indicatore di coerenza logica | 0 = nessuna incoerenza; 1 = incoerenza rilevata | Variabile di screening per coerenza logica |
Tabella 1: Variabili principali, struttura di codifica e regole di punteggio utilizzate nel protocollo standardizzato del questionario. Questa tabella riassume le variabili principali di eleggibilità, demografiche, relative all'uso di internet, scale, covariate e di controllo qualità utilizzate nel flusso di lavoro principale. Include i valori di codifica, gli intervalli di punteggio, le regole di punteggio e i ruoli delle variabili principali impiegate per la somministrazione del questionario, la selezione, il calcolo del punteggio e l'analisi. Abbreviazioni: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Cliccare qui per scaricare questa tabella.
1. Configurare la popolazione di studio, la struttura del questionario e il flusso dell'indagine
- Definire la popolazione target e il campione valido
- Reclutare studenti universitari e post-laurea a tempo pieno di età compresa tra 18 e 24 anni in grado di compilare autonomamente il questionario su un telefono cellulare o un computer. Registrare la versione linguistica del questionario e utilizzare versioni di scale validate o adeguatamente adattate per la popolazione studentesca target.
- Documentare eventuali modifiche per l'accessibilità o linguistiche prima della raccolta dei dati, quando si includono studenti internazionali, studenti con disabilità o gruppi di studenti multilingui.
- Limitare la partecipazione a una sola risposta completata per partecipante. Utilizzare, se disponibile, la funzione del piattaforma del sondaggio per limitare il dispositivo, l'account, i cookie o un link autenticato.
NOTA: Quando lo stesso account partecipante genera risposte da più dispositivi, identificare e risolvere tali record durante la verifica dei duplicati utilizzando l'identificatore limitato all'account, il timestamp, lo stato del questionario e la somiglianza nei modelli di risposta. - Fissare il campione finale minimo valido a 450 questionari e continuare il reclutamento finché il dataset pulito rimanga al di sopra di questa soglia dopo la verifica.
NOTA: Quando l'obiettivo principale dell'analisi è un sottogruppo ridotto, come l'uso problematico grave di internet, stabilire un obiettivo di reclutamento più ampio prima dell'inizio della raccolta dati. - Registrare il numero di persone invitate, il numero di risposte restituite, il numero di esclusioni a ciascun passaggio prefissato di screening e il numero finale di partecipanti inclusi, in modo da poter successivamente riassumere il flusso dei partecipanti in Figura 1.
- Costruire il questionario in un ordine fisso
- Organizzare il questionario nella seguente sequenza: consenso informato, informazioni demografiche, comportamento nell'uso di internet, Test per la dipendenza da internet, Scala breve per le difficoltà nella regolazione emotiva, durata del sonno, attività fisica settimanale e stress accademico percepito. Mantenere questo ordine invariato per tutti i partecipanti. Non randomizzare l'ordine delle scale principali.
- Registrare età, sesso, anno accademico, categoria disciplinare, tipo di residenza e spese mensili di vita utilizzando categorie di risposta a scelta chiusa. Contrassegnare tutti gli elementi demografici come obbligatori.
NOTA: Per il sesso, includere maschio, femmina e preferisco non rispondere. Mantenere "preferisco non rispondere" nelle analisi descrittive. Nelle analisi di regressione, codificare il sesso utilizzando variabili indicatrici con maschio come categoria di riferimento, includendo indicatori separati per femmina e preferisco non rispondere. Non escludere partecipanti esclusivamente perché selezionano "preferisco non rispondere". - Registrare la durata dell'uso di internet nei giorni feriali, la durata dell'uso di internet nei fine settimana, l'attività online principale, il dispositivo principale di accesso e l'uso notturno di internet dopo le 23:00. Codificare l'uso notturno come 1 = mai, 2 = meno di una volta alla settimana, 3 = 1–2 notti alla settimana, 4 = 3–5 notti alla settimana e 5 = quasi ogni notte.
- Registrare il periodo accademico in cui viene somministrato il questionario. Nell'implementazione rappresentativa, il sondaggio è stato somministrato durante un normale semestre didattico, al di fuori delle settimane degli esami finali, specificamente durante le settimane 6–7 del semestre.
- Somministrare e calcolare i punteggi degli strumenti principali
- Somministrare il Test per la dipendenza da internet a 20 domande come scala obbligatoria e assegnare a ciascun elemento un punteggio da 1 a 5. Sommare tutti e 20 gli elementi per ottenere un punteggio totale compreso tra 20 e 100, quindi classificare 20–39 come uso normale, 40–69 come uso problematico e 70–100 come uso problematico grave15.
- Utilizzare il termine "dipendenza da internet" quando si riportano punteggi e gruppi di gravità basati sull'IAT. Utilizzare "uso problematico di internet" solo quando ci si riferisce alla letteratura più ampia o a costrutti non basati sull'IAT.
- Somministrare immediatamente dopo il test per la dipendenza da internet la Scala breve a 16 elementi per le difficoltà nella regolazione emotiva e assegnare a ciascun elemento un punteggio da 1 a 5. Codificare in senso inverso gli elementi 1, 6 e 8 prima della sommatoria, quindi calcolare un punteggio totale compreso tra 16 e 80, dove punteggi più alti indicano una maggiore difficoltà nella regolazione emotiva16.
- Generare cinque punteggi di sottoscale per non accettazione, obiettivi, impulsi, strategie e chiarezza dopo aver verificato la codifica inversa.
- Ricontrollare la direzione di codifica di tutti gli elementi invertiti prima di calcolare i punteggi totali e di sottoscala. Utilizzare la stessa chiave di punteggio DERS-16 per ogni partecipante e documentare la chiave di punteggio nel README/codice.
- Quando si utilizza uno strumento alternativo o rivisto per la dipendenza da internet, sostituire il modulo specifico della scala prima dell'inizio della raccolta dati e aggiornare i nomi degli elementi, l'intervallo di punteggio, le soglie di gravità, la sintassi di codifica, il README/codice, gli screenshot del questionario e Tabella dei Materiali.
- Aggiungere covariate e un elemento di controllo dell'attenzione
- Registrare la durata del sonno come <6 h, 6–6,9 h, 7–7,9 h e ≥8 h. Registrare la frequenza settimanale di attività fisica come 0, 1–2, 3–4 e ≥5 sessioni. Registrare lo stress accademico percepito come basso, moderato o alto. Definire una sessione di attività fisica come ≥20 min di attività moderata o intensa.
- Inserire un elemento di controllo dell'attenzione con risposta diretta nella sezione comportamentale e richiedere che il partecipante selezioni una specifica opzione di risposta. L'elemento di controllo dell'attenzione utilizzato nell'implementazione rappresentativa era: “Per confermare che stai leggendo con attenzione, seleziona ‘3 = a volte’ per questo elemento”. Contrassegnare per l'esclusione durante la pulizia qualsiasi questionario che non superi questo elemento17.
PASSO CRITICO: Non modificare la formulazione dell'elemento, gli ancoraggi di risposta, l'ordine della scala, le soglie di esclusione, le impostazioni della piattaforma del sondaggio, le regole di codifica o le regole di analisi statistica dopo l'inizio formale della raccolta dati.
NOTA: Riassumere le variabili principali, i valori di codifica, gli intervalli di punteggio e le regole di punteggio in Tabella 1. Fornire il dizionario completo delle variabili, i campi di stato del file, i flag di screening, i campi di identificatori tecnici, le variabili di tracciamento del dataset, i nomi dei file e le versioni del software in Tabella Supplementare 1 e nel README/codice.
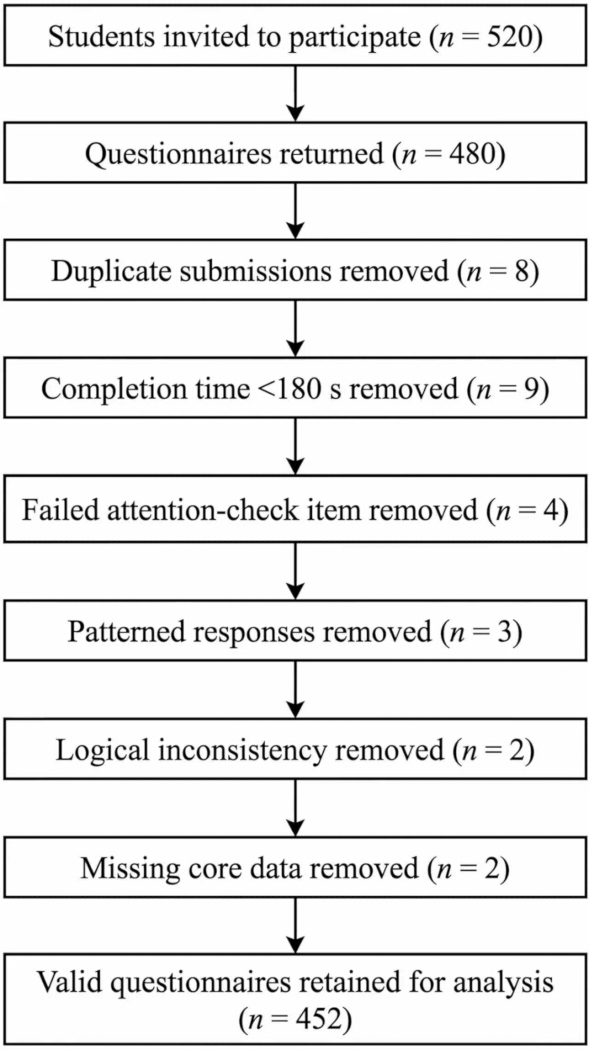
Figura 1: Flusso del questionario per reclutamento, screening, esclusione e mantenimento finale per l'analisi. Questo diagramma di flusso illustra il percorso dagli studenti invitati ai questionari restituiti, attraverso uno screening sequenziale della qualità dei dati e l'esclusione in base a criteri predeterminati, fino al mantenimento finale dei questionari validi per l'analisi. La figura mostra il numero di studenti invitati, di questionari restituiti, di record esclusi a ogni fase di screening e della popolazione finale utilizzata per l'analisi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
2. Eseguire un test pilota del questionario e bloccare la versione finale per il campo
- Effettuare un test pilota del questionario completo
- Somministrare il questionario completo a 20–30 studenti che soddisfano i criteri formali di inclusione, ma che non verranno inclusi nel dataset finale.
- Registrare il tempo di completamento e il feedback scritto riguardo chiarezza, carico di risposta, accesso tecnico, ordine degli elementi, comprensione dei controlli attentivi e qualsiasi ambiguità nelle opzioni di risposta demografiche o comportamentali.
- Registrare la dimensione del campione pilota, il tempo mediano di completamento, l'intervallo interquartile, il tempo minimo e massimo di completamento, e tutte le modifiche al testo apportate dopo il test pilota.
- Nell'implementazione rappresentativa, il test pilota ha incluso 25 studenti, il tempo mediano di completamento è stato di 540 s e il tempo previsto di completamento è stato fissato a 6–8 min.
- Rivedere le formulazioni ambigue, i significati duplicati, le opzioni di risposta poco chiare o i problemi di visualizzazione software individuati durante il test pilota, quindi bloccare la versione finale del questionario prima della pubblicazione formale.
NOTA: Se lo studio include studenti multilingui, adulti anziani, adolescenti o studenti con disabilità, effettuare ulteriori test cognitivi o test pilota su sottogruppi prima della pubblicazione formale.
- Fissare le impostazioni operative e le regole di esportazione
- Creare un nuovo progetto di indagine nella piattaforma online selezionata. Inserire la pagina del consenso come prima pagina e impostare l'elemento di consenso come elemento obbligatorio per il ramo successivo.
- Configurare l'indagine in modo che i partecipanti che non forniscono consenso escano automaticamente dall'indagine senza visualizzare il corpo del questionario.
- Inserire tutti gli elementi demografici, sull'uso di internet, IAT, DERS-16, covariate e di controllo attentivo utilizzando le formulazioni e gli ancoraggi di risposta bloccati. Impostare tutti gli elementi principali come obbligatori.
- Attivare la registrazione automatica dell'orario di inizio, dell'orario di fine, della durata del completamento, dello stato di risposta e dell'identificativo di risposta generato dalla piattaforma.
- Abilitare i controlli per una risposta per partecipante quando disponibili, inclusi link all'indagine autenticati, restrizioni per dispositivo, prevenzione delle ripetizioni basata su cookie, prevenzione basata su account o impostazioni per la revisione delle risposte duplicate. Registrare i controlli abilitati nel file README/codice.
- Disattivare la raccolta di identificatori diretti non necessari. Se la piattaforma registra l'indirizzo IP per impostazione predefinita, disattivare l'archiviazione dell'IP o sostituirlo con un campo non identificativo per il controllo dei duplicati, quando consentito dalla politica istituzionale.
NOTA: Quando gli indirizzi IP o i metadati del dispositivo sono temporaneamente conservati per il controllo dei duplicati, archiviarli esclusivamente nel file grezzo cifrato, limitarne l'accesso all'analista dello studio e rimuoverli prima di produrre il dataset analitico finale. - Specificare se è consentito interrompere e riprendere l'indagine. In questo protocollo, non è abilitata una funzione formale di salvataggio e ripresa in sessioni diverse. I partecipanti possono interrompere solo all'interno della stessa sessione del browser aperta, e il tempo di completamento registrato include l'intero tempo trascorso.
- Esportare il file grezzo dei dati in formato foglio di calcolo e in formato di valori separati da virgola (CSV) al termine dell'indagine18. Esportare inoltre un file da indagine a documento o una copia in PDF/A contenente il testo finale del questionario, l'ordine degli elementi, le impostazioni di ramificazione, le impostazioni degli elementi obbligatori e la struttura di codifica. Salvare questi file con nomi controllati per versione.
- Calcolare il tempo mediano di completamento del test pilota e fissare la soglia minima di completamento valido a circa un terzo di tale valore. Fissare la soglia finale inferiore a 180 s e applicarla uniformemente durante la selezione formale.
- Poiché questa soglia è derivata dal campione pilota, ridefinirla quando il protocollo viene implementato in una popolazione sostanzialmente diversa, su una piattaforma diversa, in una versione linguistica diversa o in un contesto istituzionale differente.
NOTA: Archiviare screenshot finali del questionario, esportazione finale del questionario, README/codice, registro del test pilota, testo dei controlli attentivi, modello del registro di selezione, impostazioni di esportazione e sintassi statistica come file supplementari o per audit.
3. Rilasciare il questionario e conservare il set di dati grezzo
- Reclutare i partecipanti attraverso canali fissi
- Distribuire un invito standardizzato attraverso gruppi di comunicazione studenteschi, canali delle classi o liste di posta istituzionali durante una finestra di raccolta fissa di 14 giorni.
- Indicare nello stesso invito e nella pagina di consenso la finalità dello studio, il tempo previsto per il completamento (6–8 min), il trattamento anonimo dei dati, la natura volontaria della partecipazione e l'assenza di penalità o ricompense accademiche per la mancata partecipazione.
- Visualizzare la pagina di consenso prima che appaia qualsiasi domanda del questionario e richiedere un accordo attivo prima dell'accesso. Non consentire l'accesso al corpo del questionario senza una risposta affermativa al consenso.
- Indicare nella pagina di consenso che i partecipanti possono interrompere il questionario prima dell'invio finale e che le risposte incomplete non saranno utilizzate nell'analisi finale.
- Utilizzare la stessa versione bloccata del questionario in tutti i canali di reclutamento. Se vengono utilizzati più canali di reclutamento, registrare il canale soltanto quando è stato specificato a priori come variabile dello studio.
- Conservare il file originale delle risposte
- Conservare tutti i record ricevuti, inclusi i moduli incompleti e quelli successivamente esclusi, nel file di esportazione originale. Esportare l'intero set di dati immediatamente dopo la chiusura del sondaggio e archiviarlo come raw_returns_YYYYMMDD.csv e raw_returns_YYYYMMDD.xlsx.
- Conservare nel file originale l'orario di invio, la durata del completamento, lo stato della risposta, l'identificativo della risposta generato dalla piattaforma e l'identificativo tecnico limitato al dispositivo o all'account. Non sovrascrivere questi campi durante le fasi successive di pulizia.
- Salvare una copia sola lettura del set di dati originale prima dell'inizio della selezione. Archiviare il file originale, il registro di selezione e il set di dati analitico finale in cartelle separate. Limitare l'accesso al file originale contenente gli identificativi tecnici al solo personale autorizzato dello studio.
ATTENZIONE: Non raccogliere informazioni direttamente identificabili, come nome completo, numero di identificazione dello studente, indirizzo esatto del dormitorio, numero di telefono personale, indirizzo email personale o account di social media, nel file principale del sondaggio.
NOTA: Interrompere il flusso di lavoro dopo l'esportazione originale, salvare una copia sola lettura del set di dati originale e riprendere la pulizia dei dati solo da questa copia preservata.
4. Esaminare i questionari restituiti e generare il set di dati analitici finale
- Applicare la sequenza di screening in un ordine fisso
- Ordinare tutti i record restituiti in base all'identificativo limitato al dispositivo, all'identificativo limitato all'account (se disponibile), al timestamp, allo stato del questionario e alla somiglianza delle risposte. Identificare innanzitutto le sottomissioni duplicate. Conservare il record completo più precoce quando due o più sottomissioni provengono dallo stesso partecipante all'interno dello stesso ciclo di raccolta.
- Se vengono rilevate più sottomissioni dallo stesso account autenticato ma da dispositivi diversi, trattarle come sottomissioni duplicate dello stesso partecipante. Conservare il record completo più precoce ed escludere i record completi successivi. Se il record più precoce è incompleto e un record successivo è completo, conservare il record completo più precoce.
- Eliminare i record con un tempo di completamento <180 s, esaminare i record completati in 180–240 s ed eliminare i record che non superano il quarto elemento di controllo dell'attenzione a risposta diretta. Documentare il numero di record rimossi a ogni passaggio nel file screening_log_v1.xlsx19.
- Per i record completati in 180–240 s, effettuare una revisione manuale utilizzando il risultato del controllo dell'attenzione, il flag di risposta a catena lunga, la deviazione standard intra-individuo e il flag di coerenza logica.
- Conservare un record con velocità limite solo se non è presente alcun ulteriore indicatore di scarsa qualità dei dati. Registrare ogni decisione relativa a una velocità limite nel registro di screening.
- Eliminare i record con modelli ripetitivi, inconsistenti o incompleti
- Eliminare tutti i questionari che mostrano risposte a catena lunga, definite come 18 o più risposte identiche consecutive tra i 36 elementi della scala valutati, oppure una deviazione standard intra-individuo ≤0,25 su tali elementi.
- Eliminare qualsiasi questionario che presenti combinazioni comportamentali impossibili. Definire “la categoria di risposta più alta su quasi tutti gli elementi del test per la dipendenza da Internet” come un punteggio pari a 5 su almeno 18 degli elementi del test IAT su 20.
NOTA: La regola di inconsistenza logica si attiva quando un rispondente dichiara sia l'uso di Internet nei giorni feriali che nei weekend nella categoria di durata più bassa (<2 h al giorno), l'uso notturno di Internet codificato come “quasi ogni notte” e un punteggio pari a 5 su almeno 18 degli elementi del test IAT su 20. Applicare questa regola solo dopo aver completato lo screening per duplicati, tempo di completamento, controllo dell'attenzione e risposte ripetitive. - Eliminare tutti i questionari con valori mancanti in qualsiasi elemento IAT, in qualsiasi elemento DERS-16 o in qualsiasi covariata prestabilita.
NOTA: Questa regola basata sui casi completi viene utilizzata perché il questionario online prevede elementi principali obbligatori e perché il modello di regressione rappresentativo richiede un insieme fisso di covariate. Quando i dati mancanti sulle covariate superano il 5%, utilizzare un metodo prespecificato alternativo per i dati mancanti, come l'imputazione multipla. - Assegnare un ID di studio anonimo a ciascun record conservato e salvare il file rimanente come analytic_dataset_v1.csv e analytic_dataset_v1.xlsx.
- Eliminare dagli identificativi di risposta generati dalla piattaforma, dagli identificativi limitati al dispositivo, dagli identificativi limitati all'account, dagli indirizzi IP (se conservati durante lo screening), dai timestamp e dalle note testuali della revisione dal dataset analitico finale. Conservare solo l'ID di studio anonimo e le variabili di analisi.
PASSO FONDAMENTALE: Applicare la sequenza di screening nello stesso ordine a ogni record e non reinserire casi precedentemente esclusi in fasi successive. Assegnare come motivo principale di esclusione il primo criterio di esclusione attivato e registrare eventuali ulteriori flag solo come note nel registro di screening.
NOTA: Riassumere i conteggi finali delle esclusioni per motivo in Tabella 2 e mantenere questi conteggi identici al flusso dei partecipanti riportato successivamente in Figura 1.
| Ordine di screening | Elemento di screening | Regola operativa | Azione di screening | Regola di documentazione |
| Passo 1 | Preservazione del file grezzo esportato | Esportare immediatamente tutti i record restituiti al termine del sondaggio e salvarli come raw_returns_YYYYMMDD.csv e raw_returns_YYYYMMDD.xlsx | Preservare una copia di sola lettura prima di iniziare qualsiasi pulizia | Archiviare nella cartella raw-data |
| Passo 2 | Verifica del consenso e dell'accesso | Identificare i record privi di consenso informato elettronico attivo prima dell'accesso al questionario | Escludere dal flusso analitico i record privi di consenso | Registrare nel file screening_log_v1.xlsx i record esclusi o non accessibili, qualora siano mantenuti nell'esportazione della piattaforma |
| Passo 3 | Screening per duplicati | Identificare i record che condividono lo stesso identificatore limitato al dispositivo o all'account all'interno dello stesso ciclo di raccolta e che corrispondono per sesso, età, anno accademico e almeno l'80% delle risposte al questionario | Mantenere il record completo più precoce ed escludere tutti i duplicati successivi | Registrare nel file screening_log_v1.xlsx il numero di record esclusi e i valori di raw_record_id interessati; assegnare primary exclusion_reason = 1 |
| Passo 4 | Riconciliazione di duplicati su più dispositivi | Identificare più invii completi provenienti dallo stesso account partecipante autenticato su dispositivi diversi | Trattare questi record come invii duplicati; mantenere il record completo più precoce | Registrare nel file screening_log_v1.xlsx l'identificatore limitato all'account e il raw_record_id mantenuto; assegnare ai record successivi primary exclusion_reason = 1 |
| Passo 5 | Screening basato sul tempo di completamento | Identificare tutti i questionari con tempo di completamento <180 s | Escludere automaticamente tutti questi record | Registrare il numero di esclusi nel file screening_log_v1.xlsx; assegnare primary exclusion_reason = 2 |
| Passo 6 | Revisione dei tempi di completamento limite | Identificare tutti i questionari con tempo di completamento compreso tra 180 e 240 s | Esaminare manualmente ogni record utilizzando indicatori di attenzione, stringhe lunghe, deviazione standard intra-soggetto e incongruenze logiche; mantenere solo i record privi di ulteriori segnalazioni | Registrare ogni caso come retained_after_manual_review = 1 o excluded_after_manual_review = 1 nel file screening_log_v1.xlsx |
| Passo 7 | Screening per controllo dell'attenzione | Identificare tutti i record che non superano l'item di controllo dell'attenzione con risposta diretta | Escludere tutti i record non superati, se non già esclusi in un passo precedente | Registrare il numero di esclusi nel file screening_log_v1.xlsx; assegnare primary exclusion_reason = 3 |
| Passo 8 | Screening per risposte ripetitive | Identificare i record con 18 o più risposte consecutive identiche tra i 36 item di scala valutati, oppure con deviazione standard intra-soggetto ≤0,25 su tali item | Escludere tutti questi record, se non già esclusi in un passo precedente | Registrare il numero di esclusi nel file screening_log_v1.xlsx; assegnare primary exclusion_reason = 4 |
| Passo 9 | Screening per coerenza logica | Identificare i record che mostrano una combinazione comportamentale impossibile predefinita: weekday_internet_use e weekend_internet_use entrambi codificati come <2 h, late_night_use codificato come quasi ogni notte, e un punteggio di 5 su almeno 18 dei 20 item IAT | Escludere tutti questi record, se non già esclusi in un passo precedente | Registrare il numero di esclusi e una nota di revisione nel file screening_log_v1.xlsx; assegnare primary exclusion_reason = 5 |
| Passo 10 | Screening per dati mancanti nei campi principali | Identificare i record con valore mancante in IAT_1–IAT_20, DERS_1–DERS_16, age, sex, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity o academic_stress; la risposta "prefer not to say" per sex è considerata valida, non come dato mancante | Escludere tutti questi record, se non già esclusi in un passo precedente | Registrare il numero di esclusi nel file screening_log_v1.xlsx; assegnare primary exclusion_reason = 6 |
| Passo 11 | Assegnazione dell'esclusione primaria | Identificare i record che soddisfano più di un criterio di esclusione | Assegnare come motivo primario di esclusione il primo criterio attivato nella sequenza predefinita di screening | Registrare i flag secondari solo nelle note di revisione; non assegnare più di un motivo primario |
| Passo 12 | Rimozione degli identificatori tecnici | Identificare gli identificatori di risposta generati dalla piattaforma, gli identificatori limitati al dispositivo o all'account, i timestamp e qualsiasi metadato tecnico temporaneamente conservato nel file pulito | Rimuovere questi campi dal dataset analitico finale dopo il completamento dello screening | Documentare la rimozione nel file screening_log_v1.xlsx |
| Passo 13 | Mantenimento finale | Mantenere tutti i record che superano tutti i passi di screening precedenti | Assegnare un ID di studio anonimo a ciascun record mantenuto | Salvare come analytic_dataset_v1.csv e analytic_dataset_v1.xlsx |
| Passo 14 | Riepilogo dello screening | Contare il numero di record rimossi a ogni passo e il numero finale mantenuto | Riassumere i conteggi finali per la segnalazione nel manoscritto | Assicurarsi che i conteggi in Tabella 2 corrispondano a quelli in Figura 1 |
| Passo 15 | Preservazione della traccia di audit | Conservare il file grezzo, il registro di screening e il dataset analitico finale come file separati | Non sovrascrivere, unire né modificare manualmente i file sorgente archiviati | Conservare separatamente nelle cartelle raw-data, screening e analytic |
Tabella 2: Sequenza predeterminata di screening, soglie di esclusione, azioni di screening e regole di documentazione per la pulizia del questionario. Questa tabella riassume l'ordine fisso di screening utilizzato per pulire i questionari restituiti, inclusi i controlli di consenso e accesso, lo screening per duplicati, la conciliazione tra dispositivi multipli, lo screening del tempo di compilazione, la revisione per velocità limite, il mancato superamento dei controlli di attenzione, le risposte ripetitive, le incoerenze logiche, la mancanza di dati fondamentali, la rimozione degli identificatori tecnici, la conservazione finale e la conservazione della traccia di audit. Abbreviazioni: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Cliccare qui per scaricare questa tabella.
5. Valutare le variabili, verificare l'affidabilità e preparare il file pronto per l'analisi
- Generare punteggi totali, punteggi delle sottoscale e variabili categoriali derivate
- Sommare i punteggi dei 20 elementi del test sull'uso di Internet (IAT) per ottenere il punteggio totale relativo alla dipendenza da Internet, quindi salvare sia il punteggio continuo sia la classe di gravità a tre livelli nel file pronto per l'analisi.
- Invertire la codifica degli elementi 1, 6 e 8 del DERS-16, calcolare il punteggio totale e i cinque punteggi delle sottoscale, quindi aggiungere tutte le variabili derivate allo stesso dataset a livello di partecipante.
- Eseguire un controllo dell'intervallo prima del calcolo dei punteggi. Verificare che tutti i valori degli elementi dell'IAT e del DERS-16 siano compresi tra 1 e 5, che tutti i valori invertiti siano compresi tra 1 e 5, che i punteggi totali dell'IAT siano compresi tra 20 e 100 e che i punteggi totali del DERS-16 siano compresi tra 16 e 80. Registrare l'output del controllo dell'intervallo nel registro di calcolo dei punteggi.
- Ricodificare le covariate in categorie analitiche fisse
- Ricodificare la durata dell'uso di Internet nei giorni feriali e nei fine settimana come <2 h, 2–3,9 h, 4–5,9 h e ≥6 h. Ricodificare l'uso notturno di Internet come mai, <1 notte/settimana, 1–2 notti/settimana, 3–5 notti/settimana e quasi ogni notte.
- Ricodificare la durata del sonno, la frequenza dell'attività fisica e lo stress accademico percepito utilizzando le regole categoriali predefinite indicate nella Sezione 1.4 e salvare i valori ricodificati con nomi di variabili fissi nello stesso dataset.
- Ricodificare il sesso ai fini della regressione utilizzando due variabili indicatrici: femmina rispetto a maschio e preferisco non rispondere rispetto a maschio. Riportare la codifica nella nota a piè di tabella e nel file README/codice.
- Verificare l'integrità del calcolo dei punteggi e la coerenza interna
- Calcolare l'alfa di Cronbach per il punteggio totale dell'IAT e per il punteggio totale del DERS-16 prima dell'analisi inferenziale. Ricontrollare la codifica degli elementi, la codifica inversa e gli intervalli di valore impossibili se uno dei due valori di alfa è <0,7020. Riportare i valori dell'alfa di Cronbach nella sezione Risultati Rappresentativi.
- Calcolare le correlazioni tra ogni elemento e il punteggio totale o i valori di alfa-se-l'elemento-è-rimosso se una delle due scale mostra una coerenza interna inaspettatamente bassa. Non rimuovere elementi dalla scala nell'analisi primaria a meno che la rimozione non sia stata predefinita o lo studio non sia esplicitamente progettato come uno studio di validazione psicometrica.
- Salvare il dataset finale pronto per l'analisi insieme a un file README che elenchi i nomi delle variabili, le regole di codifica, le soglie di esclusione, i nomi dei file, le versioni del software, la versione del questionario, la sintassi per il calcolo dei punteggi, la specifica del modello di regressione e le procedure necessarie per rigenerare lo stesso dataset.
6. Analizzare i dati e conservare gli output riproducibili
- Generare statistiche descrittive e confronti tra gruppi
- Presentare le variabili continue come media ± deviazione standard e le variabili categoriche come frequenza e percentuale. Riassumere le caratteristiche demografiche, il comportamento nell'uso di internet e i punteggi delle scale utilizzando la struttura di output predefinita.
- Indicare la numerosità campionaria utilizzata per ogni analisi. Utilizzare il campione analitico conservato come denominatore, salvo diversa indicazione esplicita in una tabella.
- Confrontare i punteggi totali e quelli dei sottoscale del DERS-16 tra i tre gruppi di gravità dell'IAT e utilizzare test a due code con α = 0,05 per le analisi principali. Riportare dimensioni dell'effetto standardizzate quando appropriato.
NOTA: Per i confronti tra gruppi, riportare η2 o η2 parziale per l'analisi della varianza, oppure una misura equivalente non parametrica della dimensione dell'effetto se viene utilizzato un test non parametrico. Interpretare con cautela i confronti tra sottogruppi con uso problematico grave quando il sottogruppo è di piccole dimensioni. - Calcolare la correlazione di Pearson tra il punteggio totale dell'IAT e il punteggio totale del DERS-16 quando entrambe le variabili mostrano un comportamento distributivo accettabile; in caso contrario, utilizzare la correlazione di Spearman come analisi di sensibilità. Riportare n, r o ρ, intervallo di confidenza al 95% se generato dal software statistico, p valore e interpretazione dell'entità dell'effetto.
- Applicare il modello di regressione aggiustato e archiviare gli output
- Utilizzare il punteggio totale del DERS-16 come variabile dipendente e il punteggio totale dell'IAT come variabile indipendente principale. Inserire età, sesso, uso di internet nei giorni feriali, uso di internet nei fine settimana, durata del sonno, attività fisica e stress accademico percepito come covariate. Questo modello rappresenta la dimostrazione analitica predefinita del flusso di lavoro standardizzato.
- Prima di interpretare il modello di regressione aggiustato, valutare le assunzioni della regressione e la stabilità del modello. Esaminare i grafici dei residui rispetto ai valori previsti per verificare linearità e omoschedasticità, analizzare un grafico Q-Q o un test di normalità per la distribuzione dei residui e calcolare i fattori di inflazione della varianza per valutare la multicollinearità.
- Riportare queste diagnosi nella sezione Risultati Rappresentativi o negli output delle analisi supplementari.
- Se viene rilevata eteroschedasticità nei residui, riportare errori standard robusti all'eteroschedasticità come analisi di sensibilità.
- Se sono presenti osservazioni influenti, indicare se il coefficiente principale relativo al punteggio totale dell'IAT rimane sostanzialmente invariato dopo le analisi di influenza. Non rimuovere osservazioni influenti a meno che non sia soddisfatta una regola predefinita di qualità dei dati.
- Riportare i coefficienti non standardizzati, gli errori standard, i coefficienti standardizzati, p valori, R2 del modello, R2 aggiustato, statistica F del modello e intervallo dei VIF per il modello aggiustato. Includere la numerosità campionaria nel titolo della tabella o in una nota a piè di tabella.
- Se vengono testate interazioni, effetti di sottogruppo o percorsi di mediazione, specificare tali analisi prima della raccolta dei dati oppure etichettarle come esplorative. Il protocollo principale non richiede il test di interazioni, a meno che le differenze tra sottogruppi non siano un obiettivo predefinito dello studio.
- Salvare tutto il codice statistico, le tabelle di output, i grafici dei residui, gli output dei VIF, gli output di affidabilità e le figure generate con nomi di file soggetti a controllo di versione. Rigenerare tutti gli output riportabili direttamente da analytic_dataset_v1, piuttosto che da file modificati manualmente.
NOTA: Mantenere il testo del protocollo focalizzato sulla replicabilità del flusso di lavoro. Presentare le statistiche rappresentative dettagliate, le figure per sottogruppi, le diagnosi di regressione, la valutazione della multicollinearità e gli output del modello nella sezione Risultati Rappresentativi.
Risultati
Flusso dello studio e mantenimento analitico finale
I risultati dimostrano l'esecuzione del flusso di lavoro standardizzato del questionario, piuttosto che una validazione indipendente del test per la dipendenza da Internet o del DERS-16. Durante il periodo di rilevazione della durata di 14 giorni, sono stati invitati a partecipare 520 studenti universitari e sono stati restituiti 480 questionari. Lo screening è stato effettuato secondo l'ordine prestabilito. In primo luogo, sono state eliminate 8 sottomissioni duplicate, seguite da 9 questionari con un tempo di compilazione inferiore a 180 s, 4 questionari che non hanno superato l'elemento di controllo dell'attenzione basato su risposte direzionate, 3 questionari con risposte in schema ricorrente, 2 questionari con incoerenze logiche e 2 questionari con dati fondamentali mancanti. Al termine dell'intera sequenza di screening, sono stati conservati 452 questionari validi nel set di dati analitico finale. Il tasso finale di conservazione è stato del 94,2% tra i questionari restituiti e dell'86,9% tra gli studenti invitati. Il flusso del questionario, dall'invito alla conservazione analitica finale, è presentato in Figura 1.
Caratteristiche dei partecipanti
Il campione analitico finale includeva 452 studenti, con un'età media di 20,41 ± 1,58 anni. Le rispondenti di sesso femminile costituivano la quota maggiore del campione, comprendendo 279 studentesse, 167 studenti maschi e 6 studenti che hanno scelto l'opzione «preferisco non rispondere». I partecipanti provenivano da tutti gli anni accademici e da diverse discipline, con studenti del secondo e del terzo anno che rappresentavano le proporzioni più elevate. La maggior parte dei rispondenti viveva in dormitori universitari, e le spese mensili per il mantenimento si concentravano nelle categorie 1.000–1.999 e 2.000–2.999. Il campione selezionato mostrava inoltre un'elevata esposizione abituale a internet. Nei giorni feriali, la distribuzione era principalmente concentrata nelle categorie 2–3,9 h e 4–5,9 h, mentre l'utilizzo nei fine settimana risultava maggiore, con 322 studenti su 452 che riportavano almeno 4 ore al giorno. L'accesso tramite smartphone era la modalità predominante. Le attività online principali più frequentemente segnalate erano i social media, l'intrattenimento/video e l'utilizzo a scopo di studio. L'utilizzo notturno dopo le 23:00 era comune, con 228 studenti su 452 che riportavano un utilizzo notturno in almeno 3 notti alla settimana. La durata del sonno si concentrava tra 6 e 7,9 ore, l'attività fisica ricadeva più spesso nella categoria 1–2 sessioni alla settimana e la risposta modale riguardava uno stress accademico moderato. Il profilo demografico e comportamentale del campione selezionato è riportato nella Tabella 3.
| Caratteristica | Categoria | n | % |
| Sesso | Maschio | 167 | 36,9 |
| Femmina | 279 | 61,7 | |
| Preferisco non rispondere | 6 | 1,3 | |
| Anno accademico | Primo anno | 88 | 19,5 |
| Secondo anno | 124 | 27,4 | |
| Terzo anno | 131 | 29 | |
| Quarto anno o superiore | 79 | 17,5 | |
| Postlaurea | 30 | 6,6 | |
| Categoria disciplinare | Scienze umane e sociali | 118 | 26,1 |
| Scienze e ingegneria | 96 | 21,2 | |
| Business e gestione | 104 | 23 | |
| Arte e design | 82 | 18,1 | |
| Altro | 52 | 11,5 | |
| Tipo di residenza | Dormitorio in campus | 301 | 66,6 |
| Affitto fuori campus | 79 | 17,5 | |
| Casa familiare | 58 | 12,8 | |
| Altro | 14 | 3,1 | |
| Spese mensili di vita, CNY | <1.000 | 61 | 13,5 |
| 1.000–1.999 | 176 | 38,9 | |
| 2.000–2.999 | 149 | 33 | |
| ≥3.000 | 66 | 14,6 | |
| Utilizzo di internet nei giorni feriali | <2 h | 52 | 11,5 |
| 2–3,9 h | 157 | 34,7 | |
| 4–5,9 h | 166 | 36,7 | |
| ≥6 h | 77 | 17 | |
| <2 h | 29 | 6,4 | |
| 2–3,9 h | 101 | 22,3 | |
| 4–5,9 h | 178 | 39,4 | |
| ≥6 h | 144 | 31,9 | |
| Attività online principale | Studio | 74 | 16,4 |
| Media sociali | 126 | 27,9 | |
| Gioco | 61 | 13,5 | |
| Intrattenimento/video | 102 | 22,6 | |
| Acquisti | 28 | 6,2 | |
| Uso misto | 47 | 10,4 | |
| Altro | 14 | 3,1 | |
| Dispositivo principale di accesso | Smartphone | 323 | 71,5 |
| Tablet | 18 | 4 | |
| Portatile/fisso | 67 | 14,8 | |
| Dispositivi misti | 44 | 9,7 | |
| Utilizzo notturno dopo le 23:00 | Mai | 48 | 10,6 |
| Meno di una volta a settimana | 57 | 12,6 | |
| 1–2 notti/settimana | 119 | 26,3 | |
| 3–5 notti/settimana | 141 | 31,2 | |
| Quasi ogni notte | 87 | 19,2 | |
| Durata del sonno | <6 h | 83 | 18,4 |
| 6–6,9 h | 146 | 32,3 | |
| 7–7,9 h | 157 | 34,7 | |
| ≥8 h | 66 | 14,6 | |
| Attività fisica settimanale | Nessuna | 91 | 20,1 |
| 1–2 sessioni | 176 | 38,9 | |
| 3–4 sessioni | 128 | 28,3 | |
| ≥5 sessioni | 57 | 12,6 | |
| Stress accademico | Basso | 73 | 16,2 |
| Moderato | 241 | 53,3 | |
| Alto | 138 | 30,5 | |
| Età, anni | Media ± DS | 20,41 ± 1,58 | — |
Tabella 3: Caratteristiche demografiche e comportamentali di base del campione selezionato. Questa tabella presenta il profilo demografico e le caratteristiche d'uso di internet del campione finale selezionato dopo il controllo predefinito. Le variabili includono sesso, anno accademico, categoria disciplinare, tipo di residenza, spese mensili di mantenimento, uso di internet nei giorni feriali e nei fine settimana, attività online principale, dispositivo principale di accesso, uso notturno dopo le 23:00, durata del sonno, attività fisica settimanale, stress accademico ed età. Abbreviazioni: CNY = yuan cinese; SD = deviazione standard. Cliccare qui per scaricare questa tabella.
Gravità della dipendenza da internet, esiti nella regolazione delle emozioni e affidabilità
Nel campione completo trattenuto (n = 452), il punteggio medio totale del test sull'addiction da Internet è stato di 51,94 ± 16,58. In base alle soglie di gravità prestabilite, 200 rispondenti sono stati classificati come utenti normali, 239 come utenti problematici e 13 come utenti gravemente problematici, rendendo il gruppo di uso problematico il sottogruppo più numeroso. Il punteggio medio totale del DERS-16 nel campione trattenuto è stato di 35,95 ± 8,89. Il test sull'addiction da Internet ha mostrato una consistenza interna accettabile, con un alfa di Cronbach pari a 0,91, e anche il DERS-16 ha mostrato una consistenza interna accettabile, con un alfa di Cronbach pari a 0,88. Quando i punteggi totali del DERS-16 sono stati esaminati nei tre gruppi di gravità del test sull'addiction da Internet, il gruppo di uso normale ha mostrato la media più bassa, il gruppo di uso problematico una media più alta e il gruppo di uso gravemente problematico la media più elevata. Il confronto tra gruppi per il punteggio totale del DERS-16 è risultato statisticamente significativo nel campione trattenuto (n = 452; F = 72,80, p < 0,001; η2 = 0,245). Lo stesso andamento direzionale è emerso anche dalle sintesi delle sottoscale del DERS-16. Poiché il sottogruppo di uso gravemente problematico era di piccole dimensioni (n = 13), i valori di questo sottogruppo sono presentati come parte del modello distributivo complessivo piuttosto che come base per inferenze dettagliate sul sottogruppo grave. La gravità dell'addiction da Internet e gli esiti della regolazione emotiva sono riassunti nella Tabella 4.
| Misura | Uso normale | Uso problematico | Uso gravemente problematico | Totale |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| Punteggio totale IAT | 34,20 ± 3,90 | 65,33 ± 6,90 | 78,70 ± 6,20 | 51,94 ± 16,58 |
| Punteggio totale DERS-16 | 31,20 ± 7,10 | 39,24 ± 8,30 | 48,50 ± 9,60 | 35,95 ± 8,89 |
| DERS-16 nonaccettazione | 5,90 ± 1,90 | 7,29 ± 2,10 | 8,90 ± 2,40 | 6,72 ± 2,16 |
| DERS-16 obiettivi | 6,20 ± 1,80 | 7,82 ± 2,00 | 9,10 ± 2,30 | 7,14 ± 2,09 |
| DERS-16 impulso | 5,80 ± 1,70 | 7,72 ± 2,10 | 9,40 ± 2,50 | 6,92 ± 2,19 |
| DERS-16 strategie | 9,60 ± 2,90 | 12,29 ± 3,30 | 15,10 ± 3,80 | 11,18 ± 3,44 |
| DERS-16 chiarezza | 3,70 ± 1,30 | 4,18 ± 1,40 | 5,00 ± 1,60 | 3,99 ± 1,41 |
| IAT alfa di Cronbach | — | — | — | 0,91 |
| DERS-16 alfa di Cronbach | — | — | — | 0,88 |
| Confronto tra gruppi per il punteggio totale DERS-16 | — | — | — | F = 72,80; p < 0,001; η² = 0,245 |
| Correlazione di Pearson tra punteggio totale IAT e punteggio totale DERS-16 | — | — | — | n = 452; r = 0,524; IC 95%: 0,45–0,59; p < 0,001 |
Tabella 4: Gruppi di gravità della dipendenza da internet, esiti della regolazione emotiva, affidabilità e correlazione nel campione analitico finale. Questa tabella riporta i punteggi totali del test sulla dipendenza da internet (IAT), i punteggi totali della scala DERS-16 e i valori delle sottoscale DERS-16 nei gruppi di uso normale, uso problematico e uso problematico grave. Inoltre, vengono riportate le medie complessive del campione, i valori di alfa di Cronbach per l'IAT e il DERS-16, il confronto tra gruppi per il punteggio totale del DERS-16 e la correlazione di Pearson tra il punteggio totale dell'IAT e il punteggio totale del DERS-16. Abbreviazioni: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; CI = intervallo di confidenza; SD = deviazione standard. Cliccare qui per scaricare questa tabella.
Associazione tra dipendenza da internet e regolazione delle emozioni
È stata valutata l'associazione con punteggio continuo predefinita tra il punteggio totale del test IAT e il punteggio totale del DERS-16 nel campione analitico conservato (n = 452). La correlazione di Pearson tra il punteggio totale IAT e il punteggio totale DERS-16 è risultata positiva e di entità moderata (r = 0.524, 95% CI: 0.45–0.59, p < 0.001). Gli studenti con punteggi totali IAT più elevati, pertanto, tendevano a riportare una maggiore difficoltà complessiva nella regolazione delle emozioni. Questo risultato è coerente con la distribuzione per gruppi di gravità e non dipende esclusivamente dalla classificazione categoriale dell'IAT, come mostrato in Tabella 4.
Analisi di regressione multivariata
Il modello di regressione aggiustato includeva il campione analitico selezionato (n = 452). Il punteggio totale del DERS-16 è stato inserito come variabile dipendente, mentre il punteggio totale dell'IAT è stato inserito come variabile indipendente principale. Età, sesso, uso settimanale di internet, uso del fine settimana di internet, durata del sonno, attività fisica settimanale e stress accademico sono stati inclusi come covariate nello stesso modello. Il sesso è stato inserito utilizzando una codifica prespecificata con variabili indicatrici, con maschio come categoria di riferimento e indicatori separati per femmina e preferisco non rispondere. Dopo l'aggiustamento, il punteggio totale dell'IAT è rimasto positivamente associato al punteggio totale del DERS-16 (B = 0.21, SE = 0.02, β = 0.39, p < 0.001). Tra le covariate, lo stress accademico ha mostrato un'associazione positiva con il punteggio totale del DERS-16 (B = 2.36, β = 0.23, p < 0.001), mentre la durata del sonno (B = -1.12, β = -0.13, p < 0.001) e l'attività fisica settimanale (B = -0.84, β = -0.10, p = 0.003) erano negativamente associate al punteggio totale del DERS-16. L'uso di internet nei giorni feriali ha mantenuto un coefficiente positivo minore dopo l'aggiustamento (B = 0.71, β = 0.09, p = 0.015), mentre l'uso di internet nel fine settimana non è risultato statisticamente robusto nel modello aggiustato (B = 0.49, β = 0.07, p = 0.071). Età e entrambi gli indicatori di sesso non sono risultati predittori indipendenti significativi nella stessa specifica. Il modello ha spiegato il 39,8% della varianza del punteggio totale del DERS-16, con un R2 aggiustato di 0,386, e l'intero modello è risultato statisticamente significativo, F(9, 442) = 32,47, p < 0,001. La multicollinearità non era evidente, con fattori di inflazione della varianza compresi tra 1,03 e 1,42. I controlli sui residui non hanno mostrato violazioni importanti di linearità o omoschedasticità nell'analisi dei residui rispetto ai valori previsti. Il grafico Q-Q dei residui non ha mostrato deviazioni sostanziali dalla normalità approssimativa. Il test di Breusch-Pagan non è risultato statisticamente significativo, p = 0,214. La distanza massima di Cook è stata 0,18 e nessuna osservazione ha superato una distanza di Cook di 0,50. Il modello di regressione aggiustato è riportato nella Tabella 5.
| Predittore | B | SE | β | t | p | VIF |
| Costante | 18.42 | 2.11 | — | 8.73 | <0.001 | — |
| Punteggio totale IAT | 0.21 | 0.02 | 0.39 | 9.84 | <0.001 | 1.42 |
| Età | 0.18 | 0.11 | 0.03 | 1.64 | 0.102 | 1.08 |
| Sesso, femmina rispetto a maschio | 0.62 | 0.54 | 0.04 | 1.15 | 0.252 | 1.05 |
| Sesso, preferisco non rispondere rispetto a maschio | 0.28 | 1.89 | 0.01 | 0.15 | 0.882 | 1.03 |
| Utilizzo di internet nei giorni feriali | 0.71 | 0.29 | 0.09 | 2.45 | 0.015 | 1.36 |
| Utilizzo di internet nei fine settimana | 0.49 | 0.27 | 0.07 | 1.81 | 0.071 | 1.31 |
| Durata del sonno | -1.12 | 0.31 | -0.13 | -3.61 | <0.001 | 1.18 |
| Attività fisica settimanale | -0.84 | 0.28 | -0.1 | -3 | 0.003 | 1.12 |
| Stress accademico | 2.36 | 0.39 | 0.23 | 6.05 | <0.001 | 1.27 |
Tabella 5: Regressione lineare multivariabile del punteggio totale DERS-16 sul punteggio totale IAT e covariate nel campione analitico finale. Questa tabella presenta il modello di regressione aggiustato con il punteggio totale DERS-16 come variabile dipendente e il punteggio totale IAT come variabile indipendente principale. Sono state incluse come covariate l'età, il sesso, l'utilizzo settimanale di internet, l'utilizzo del fine settimana, la durata del sonno, l'attività fisica settimanale e lo stress accademico. Nella tabella sono riportati anche i coefficienti standardizzati, i fattori di inflazione della varianza e le diagnosi del modello. Abbreviazioni: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale; VIF = variance inflation factor. Cliccare qui per scaricare questa tabella.
Tabella supplementare 1: Dizionario completo delle variabili, presenza dei file, struttura di codifica e campi di gestione dati utilizzati nel flusso di lavoro del questionario standardizzato. Questa tabella supplementare fornisce il dizionario completo delle variabili per il protocollo, inclusi variabili relative all'etica e al consenso, variabili relative al contesto dell'indagine, variabili demografiche, variabili sull'uso di internet, indicatori di controllo qualità, elementi delle scale, punteggi derivati, covariate, campi identificativi tecnici, variabili di tracciamento del dataset, informazioni sullo stato dei file e regole di codifica. Abbreviazioni: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale.Cliccare qui per scaricare il file.
File supplementare 1: Materiali supplementari relativi al flusso di lavoro del questionario. Questo file supplementare contiene i file del questionario, il codice delle variabili, il registro di selezione, il piano di output e i materiali pronti per l'analisi utilizzati per riprodurre in modo standardizzato il flusso di lavoro di somministrazione del questionario, selezione, attribuzione del punteggio e analisi.Fare clic qui per scaricare questo file.
Discussione
Il contributo principale di questo articolo è il flusso di lavoro standardizzato del questionario, piuttosto che l'associazione rappresentativa osservata tra dipendenza da internet e difficoltà nella regolazione delle emozioni. L'implementazione ha dimostrato che una sequenza fissa di consenso elettronico, elementi demografici, comportamento nell'uso di internet, valutazione tramite IAT, valutazione tramite DERS-16, raccolta di covariate, screening sequenziale della qualità dei dati e analisi regressiva riproducibile può essere eseguita su un campione di studenti universitari. Questa enfasi procedurale è importante perché l'uso problematico di internet è spesso associato a disregolazione emotiva in letteratura, ma procedure inconsistenti di somministrazione e pulizia dei dati possono rendere difficile il confronto tra gli studi21. Il flusso di lavoro qui presentato, pertanto, favorisce la comparabilità rendendo espliciti l'ordine delle misurazioni, le regole di esclusione, i passaggi di calcolo dei punteggi e gli output analitici prima dell'inizio dell'interpretazione.
Diversi passaggi procedurali sono particolarmente critici per la riproducibilità. In primo luogo, il consenso elettronico deve essere completato prima dell'accesso al questionario, e gli identificatori tecnici utilizzati per lo screening delle duplicazioni devono essere separati dal dataset analitico finale anonimizzato. In secondo luogo, lo screening delle risposte duplicate deve precedere lo screening del tempo di completamento, la revisione dei controllo dell'attenzione, lo screening delle risposte strutturate, la verifica della coerenza logica e i controlli sulle risposte mancanti, poiché modificare quest'ordine potrebbe alterare il campione finale conservato. In terzo luogo, le procedure di calcolo del punteggio per il test IAT e per il DERS-16 devono essere definite prima della raccolta dei dati, inclusa la codifica inversa e la classificazione per gravità. Questi passaggi riducono le variazioni evitabili nella ricerca tramite sondaggi online e sono in linea con le più ampie considerazioni secondo cui i risultati relativi alla dipendenza da internet possono essere influenzati da fattori come lo stress, l'autocontrollo e l'ansia, oltre che da differenze nelle procedure di misurazione22.
Il protocollo richiede anche diversi controlli di risoluzione dei problemi durante l'implementazione. Se la piattaforma del sondaggio non può limitare i tentativi ripetuti, il controllo dei duplicati dovrebbe basarsi su una combinazione di identificatori limitati all'account, identificatori limitati al dispositivo, timestamp, stato del questionario e somiglianza nei modelli di risposta. Se molti record rientrano nel range di velocità limite, il risultato del controllo dell'attenzione, il numero di risposte con stringhe lunghe, la deviazione standard intra-individuale e l'indicatore di coerenza logica dovrebbero essere esaminati insieme, piuttosto che fare affidamento esclusivamente sul tempo di completamento. Se l'alfa di Cronbach risulta inaspettatamente basso, è necessario verificare la codifica degli elementi, la codifica inversa e gli intervalli dei punteggi prima di prendere qualsiasi decisione a livello di singolo elemento. Queste procedure sono particolarmente rilevanti perché i comportamenti legati all'uso online e agli smartphone sono associati ai processi di regolazione del sonno e delle emozioni, rendendo un controllo superficiale o un'errata codifica una possibile fonte di inferenze distorte23.
Le soglie di esclusione utilizzate nell'implementazione rappresentativa devono essere considerate standardizzate all'interno di questo flusso di lavoro, ma non universalmente fisse per tutte le popolazioni future. La soglia inferiore di 180 s per il tempo di completamento è stata ricavata da test pilota e dovrebbe essere ricalibrata quando il protocollo viene applicato a soggetti anziani, adolescenti, rispondenti multilingui, questionari adattati per l'accessibilità o piattaforme con formati di visualizzazione diversi. La regola relativa all'incoerenza logica e i criteri relativi alle risposte ripetitive potrebbero richiedere aggiustamenti anche quando la lunghezza della scala, l'ordine degli elementi o gli ancoraggi di risposta sono diversi. Analogamente, il sottogruppo piccolo ma con uso problematico grave riscontrato nell'implementazione rappresentativa indica che gli studi progettati per confronti tra sottogruppi dovrebbero aumentare gli obiettivi di reclutamento o utilizzare un campionamento stratificato prima della raccolta dei dati. Tale flessibilità è importante perché variabili comportamentali e dello stile di vita, inclusa l'attività fisica, potrebbero interagire con l'attenzione, la rimuginazione e l'autoregolazione in modi che variano tra i diversi gruppi di studenti24.
Nell'applicare questo protocollo, è necessario considerare diversi limiti. Il flusso di lavoro utilizza strumenti basati sull'autovalutazione, pertanto errori di memoria, distorsione dovuta alla desiderabilità sociale e varianza comune al metodo potrebbero influenzare sia le misurazioni dell'esposizione che degli esiti. Questi rischi possono essere ridotti, ma non eliminati, utilizzando un linguaggio neutro, un ordine fisso del questionario, verifiche dell'attenzione, covariate predefinite e una segnalazione trasparente delle mancanze e delle esclusioni. Studi futuri potrebbero inoltre integrare misurazioni oggettive del comportamento digitale, come registri del tempo di utilizzo dello schermo dello smartphone, cronologie d'uso delle app o riepiloghi dell'utilizzo forniti dalle piattaforme, al fine di rafforzare la validità costruttiva. Tuttavia, queste integrazioni richiedono clausole di consenso specifiche, misure di protezione della privacy, procedure di minimizzazione dei dati e regole per l'associazione dei dati. Dovrebbero pertanto essere aggiunte come estensioni pianificate del protocollo piuttosto che come integrazioni informali al flusso del questionario25.
Il protocollo è adattabile, ma non deve essere trasferito meccanicamente a ogni contesto. In popolazioni non universitarie, potrebbe essere necessario rivedere i criteri di idoneità, i canali di reclutamento, gli elementi relativi allo stress accademico e le categorie di utilizzo di internet. In studi multinazionali multicentrici, prima di aggregare i dati occorre documentare traduzione, adattamento culturale, equivalenza della piattaforma, gestione dei fusi orari, norme sulla protezione dei dati e monitoraggio a livello dei singoli siti. Se il test IAT viene sostituito da una misura più recente o specifica per la popolazione, il flusso di lavoro può comunque essere mantenuto, ma è necessario aggiornare prima della raccolta dati l'intervallo dei punteggi, le soglie di gravità, il codice, Tabella dei Materiali e il dizionario delle variabili supplementari. Questa distinzione tra durata dell'utilizzo di internet e uso disregolato è importante, perché il tempo trascorso online da solo potrebbe non cogliere lo stesso costrutto dell'uso problematico o compulsivo26.
Infine, l'implementazione rappresentativa era trasversale e non deve essere interpretata come prova di una direzione temporale. L'associazione osservata tra il punteggio totale del test IAT e il punteggio totale del DERS-16 illustra il funzionamento del percorso analitico, non se le difficoltà nella regolazione emotiva causino un uso problematico di internet o se l'uso problematico di internet peggiori la regolazione emotiva nel tempo. Sono stati riportati modelli trasversali simili in altri contesti universitari, ma sono necessarie applicazioni longitudinali o basate su misure ripetute per esaminare la direzionalità e il cambiamento27. Il valore del presente protocollo consiste nel fornire un flusso di lavoro di base stabile per futuri studi di questo tipo. Standardizzando consenso informato, somministrazione dei questionari, screening, calcolo dei punteggi, verifiche di affidabilità, diagnosi del modello, archiviazione dei file e documentazione supplementare, il protocollo può supportare studi trasversali più riproducibili ed essere esteso a disegni longitudinali o di intervento quando le domande temporali diventano l'obiettivo principale28. L'inclusione di un codebook, di un registro di screening, di un piano di output e di materiali per il flusso di lavoro pronti per l'analisi è inoltre coerente con i principi di documentazione del software e dei flussi di lavoro di ricerca orientati al FAIR29 e con le raccomandazioni più ampie della scienza aperta per una comunicazione trasparente e riproducibile30.
Dichiarazioni
L'autore non ha nulla da dichiarare.
Ringraziamenti
Questo lavoro è stato sostenuto dal Progetto di Scienza Morbida della Provincia di Henan 2025, “Ricerca sull’impatto e sul percorso di ottimizzazione dei cambiamenti nella popolazione in età scolastica sullo sviluppo di alta qualità dell’istruzione superiore privata nella Provincia di Henan” (Numero del Progetto 252400410490), e dal Progetto del Fondo per la Ricerca dei Dottorandi dell’Università di Economia e Commercio di Zhengzhou 2025, “Ricerca sul meccanismo di formazione e sul meccanismo di orientamento dell’opinione pubblica riguardo al comportamento in rete a cluster degli studenti universitari”. L'autore ringrazia l'Università di Economia e Commercio di Zhengzhou per il supporto istituzionale.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Dataset pronto per l'analisi | Documento interno specifico dello studio | analytic_dataset_v1.csv e analytic_dataset_v1.xlsx | Dataset finale anonimizzato utilizzato per tutte le analisi descrittive, di affidabilità, di correlazione e di regressione riportabili |
| Sintassi di analisi | Documento interno specifico dello studio | analysis_syntax_v1.R o file di script equivalente | Utilizzato per riprodurre la verifica del punteggio, i controlli di affidabilità, le statistiche descrittive, l'analisi di correlazione, la modellazione di regressione, il calcolo del VIF e l'output diagnostico |
| Formulazione dell'item di controllo dell'attenzione | Documento interno specifico dello studio | attention_check_v1.txt | Formulazione bloccata dell'item di controllo dell'attenzione a risposta diretta utilizzato durante la somministrazione del questionario |
| Questionario DERS-16 | Fonte originale della scala o versione del questionario autorizzata/adattata | 16-item Difficulties in Emotion Regulation Scale short form | Utilizzato per valutare le difficoltà nella regolazione delle emozioni; il punteggio segue la chiave di valutazione bloccata del DERS-16 documentata nel codebook |
| Scheda elettronica informativa e pagina di consenso | Documento interno specifico dello studio | consent_form_v1.pdf o pagina di consenso della piattaforma | Utilizzata per fornire informazioni sullo studio e ottenere il consenso informato elettronico prima dell'accesso al questionario |
| Scheda delle convenzioni di denominazione dei file | Documento interno specifico dello studio | file_naming_convention_v1.xlsx | Utilizzata per standardizzare i nomi dei file grezzi, puliti, analitici, del registro di screening, del codebook e degli output |
| Schermate finali del questionario | Documento interno specifico dello studio | questionnaire_screenshots_v1.pdf | Utilizzate per documentare la visualizzazione bloccata del sondaggio, l'ordine degli item, gli ancoraggi di risposta e le impostazioni degli item obbligatori |
| Ambiente di sviluppo integrato | Posit | RStudio Desktop | Utilizzato per gestire script, log e flussi di lavoro di analisi riproducibili |
| Questionario Internet Addiction Test | Fonte originale della scala o versione del questionario autorizzata/adattata | 20-item Internet Addiction Test | Utilizzato per valutare i sintomi di dipendenza da internet e classificare l'uso normale, l'uso problematico e l'uso gravemente problematico |
| Piattaforma online per sondaggi | Qualtrics | XM Platform; account istituzionale o con licenza | Utilizzata per creare il questionario, applicare gli item obbligatori, gestire l'accesso basato sul consenso, limitare le sottomissioni ripetute quando possibile ed esportare i dati delle risposte |
| Pacchetto statistico opzionale con interfaccia a menu | IBM | SPSS Statistics | Utilizzato quando è richiesto un flusso di lavoro di analisi basato su interfaccia grafica per statistiche descrittive, controlli di affidabilità o analisi di regressione |
| File README/codebook | Documento interno specifico dello studio | README_v1.txt o codebook_v1.xlsx | Utilizzato per documentare i nomi delle variabili, le regole di codifica, gli intervalli di punteggio, le regole di inversione della codifica, le soglie di esclusione, i nomi dei file e le versioni del software |
| Copia archiviata in sola lettura | Formato documento portatile | PDF/A o PDF archivio approvato dall'istituzione | Utilizzato per preservare lo strumento di indagine bloccato, la pagina di consenso e i documenti di supporto al protocollo |
| Cartella di lavoro del registro di screening | Documento interno specifico dello studio | screening_log_v1.xlsx | Utilizzata per documentare lo screening per duplicati, lo screening del tempo di completamento, i fallimenti del controllo dell'attenzione, le risposte modellate, le incongruenze logiche, i dati mancanti, le decisioni di revisione manuale e i conteggi finali conservati |
| Software per fogli di calcolo | Microsoft | Formato cartella di lavoro Microsoft Excel (.xlsx) | Utilizzato per i registri di screening, il dizionario delle variabili, i record di revisione manuale e la preparazione di cartelle supplementari |
| Ambiente di calcolo statistico | R Foundation / CRAN | R 4.5.3 | Utilizzato per la verifica del punteggio, le statistiche descrittive, i controlli di affidabilità, l'analisi di correlazione, l'analisi di regressione, il calcolo del VIF e l'output diagnostico |
| File Supplementare 1 | File supplementare specifico dello studio | Supplementary File 1.xlsx | Contiene materiali del flusso di lavoro del questionario, codebook, registro di screening, piano di output e materiali del flusso di lavoro pronti per l'analisi |
| Tabella Supplementare S1 | Tabella supplementare specifica dello studio | Supplementary Table S1 | Fornisce il dizionario completo delle variabili, la presenza nei file, la struttura di codifica, i campi identificativi tecnici, le variabili di screening e i campi di tracciamento del dataset |
| Documento di esportazione del sondaggio | Qualtrics | Esportazione da sondaggio a Word o esportazione in PDF | Utilizzata per archiviare la formulazione finale del questionario, l'ordine degli item, le impostazioni di ramificazione, le impostazioni degli item obbligatori e la codifica delle risposte |
| Formato di esportazione del sondaggio | Qualtrics | Esportazione CSV | Utilizzata per la conservazione dei dati grezzi e l'esportazione dei dati pronti per l'analisi |
Riferimenti
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.