Questo studio presenta un flusso di lavoro clinico retrospettivo per stimare il rischio di ipertensione polmonare in pazienti anziani ricoverati a causa di un'esacerbazione acuta della broncopneumopatia cronica ostruttiva, utilizzando variabili cliniche di routine e un modello predittivo basato su un nomogramma.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Nomograma basato su dati di routine per la stima del rischio di ipertensione polmonare in pazienti anziani con riacutizzazione acuta di bronchite ostruttiva cronica
In questo articolo
Sommario
Abstract
L'ipertensione polmonare è una complicanza clinicamente rilevante nei pazienti anziani ospedalizzati per esacerbazione acuta di broncopneumopatia cronica ostruttiva, ma la stima precoce del rischio rimane difficile nei contesti ospedalieri primari e con risorse limitate. Questo studio di coorte retrospettivo ha sviluppato e valutato internamente un nomogramma basato su dati di routine per la stima del rischio di ipertensione polmonare. Sono stati analizzati complessivamente 230 pazienti anziani ospedalizzati per esacerbazione acuta di broncopneumopatia cronica ostruttiva tra maggio 2023 e maggio 2025. I pazienti sono stati classificati nei gruppi ipertensione polmonare e non ipertensione polmonare in base ai risultati dell'ecocardiografia transtoracica. Sono state confrontate tra i gruppi le caratteristiche demografiche, le comorbidità, gli indici dell'emocromo completo, i marcatori della coagulazione, i marcatori infiammatori e i marcatori dello stress cardiaco. I predittori candidati sono stati selezionati mediante analisi univariata, valutazione della rilevanza clinica, analisi della ridondanza e regressione logistica multivariata. Quattro variabili—rapporto neutrofili-linfociti, peptide natriuretico di tipo B, D-dimero e anamnesi di asma—si sono dimostrate indipendentemente associate all'ipertensione polmonare e sono state incorporate nel nomogramma principale. Il modello ha mostrato una buona capacità discriminante, con un'area sotto la curva ROC (caratteristica operativa del ricevitore) pari a 0,82. L'analisi della curva decisionale ha indicato un potenziale beneficio netto per probabilità soglia comprese approssimativamente tra l'1% e il 70%. I risultati della calibrazione richiedono un'interpretazione cauta a causa di un residuo scostamento nella calibrazione. Questo flusso di lavoro fornisce un approccio pratico per la stratificazione precoce del rischio di ipertensione polmonare nei pazienti anziani ospedalizzati per esacerbazione acuta di broncopneumopatia cronica ostruttiva. Tuttavia, è necessaria una validazione esterna e una ricalibrazione del modello prima di un'implementazione clinica più ampia.
Introduzione
La malattia polmonare ostruttiva cronica è un disturbo respiratorio cronico comune, caratterizzato da una limitazione persistente del flusso aereo, sintomi respiratori e episodi ricorrenti di peggioramento clinico. Rimane una causa importante di morbosità, mortalità e onere sanitario a livello mondiale1. L'esacerbazione acuta della malattia polmonare ostruttiva cronica indica un peggioramento acuto dei sintomi respiratori, tra cui dispnea, tosse e produzione di catarro, ed è spesso innescata da infezioni, esposizione ambientale o altri eventi acuti avversi2. Nei pazienti anziani, le esacerbazioni acute si verificano spesso in presenza di multimorbidità, riserva cardiopolmonare compromessa, infiammazione sistemica e ridotta tolleranza fisiologica, aumentando la difficoltà della valutazione precoce del rischio.
L'ipertensione polmonare è una complicanza importante della malattia polmonare ostruttiva cronica, in particolare durante le riacutizzazioni acute. Il suo sviluppo è associato a ipossia cronica, rimodellamento vascolare polmonare, disfunzione endoteliale, attivazione infiammatoria e aumento del postcarico del ventricolo destro3. Un aumento della pressione arteriosa polmonare è stato osservato in pazienti con riacutizzazione acuta della malattia polmonare ostruttiva cronica e può peggiorare lo scompenso respiratorio, lo sforzo cardiaco destro, il carico ospedaliero e la sopravvivenza4. Questo impatto prognostico è particolarmente rilevante nei pazienti anziani e in quelli con malattia cardiorespiratoria avanzata5,6. L'identificazione precoce dei pazienti a rischio aumentato di ipertensione polmonare potrebbe quindi favorire un monitoraggio più stretto, una tempestiva valutazione ecocardiografica e il ricorso a ulteriori valutazioni cardiorespiratorie.
La cateterizzazione del cuore destro rimane lo standard di riferimento per confermare l'ipertensione polmonare; tuttavia, la sua invasività, il costo, i requisiti tecnici e la disponibilità limitata ne restringono l'uso come procedura iniziale di screening in molti ospedali primari e a livello comunale7. L'ecocardiografia transtoracica è ampiamente utilizzata come metodo di valutazione non invasivo, ma la sua affidabilità può essere influenzata dall'iperinflazione, da scarse finestre acustiche e da alterazioni enfisematose nei pazienti con malattia polmonare ostruttiva cronica8. Sebbene questi limiti non riducano il valore clinico dell'ecocardiografia, evidenziano la necessità di un flusso di lavoro semplice per la stima del rischio, applicabile prima o in parallelo alla valutazione basata sull'imaging.
Variabili cliniche e di laboratorio di routine possono contribuire a soddisfare questa esigenza. Il rapporto neutrofili-linfociti viene calcolato a partire dai risultati dell'emocromo completo e riflette l'equilibrio tra infiammazione mediata dai neutrofili e regolazione immunitaria correlata ai linfociti9. È stato associato all'attività della malattia e a esiti avversi in condizioni polmonari e cardiovascolari10. Il peptide natriuretico di tipo B è un marcatore facilmente disponibile dello stress parietale miocardico, del sovraccarico pressorio del ventricolo destro e della compromissione cardiorespiratoria11. Il D-dimero riflette l'attivazione della coagulazione e la fibrinolisi secondaria, e può aumentare durante le riacutizzazioni acute a causa di ipossiemia, infezione, danno endoteliale e ridotta mobilità12. Tuttavia, è improbabile che un singolo biomarcatore possa cogliere l'intero profilo di rischio dell'ipertensione polmonare in pazienti anziani con riacutizzazione acuta della broncopneumopatia cronica ostruttiva.
Un nomogramma fornisce un mezzo pratico per tradurre un modello di previsione multivariabile in una stima del rischio personalizzata. Rispetto alla sola segnalazione dei coefficienti di regressione, esso permette l'integrazione di multipli predittori a livello del paziente in uno strumento clinicamente interpretabile13. Studi precedenti di previsione clinica hanno utilizzato modelli basati su nomogrammi per supportare la stima del rischio al letto del paziente, ma la loro utilità dipende da una selezione trasparente dei predittori, da un'adeguata calibrazione, validazione e interpretazione prudente14. L'originalità del presente studio consiste nello sviluppo di un flusso di lavoro basato su dati di routine per pazienti anziani ricoverati per esacerbazione acuta della broncopneumopatia cronica ostruttiva, integrando informazioni infiammatorie, legate allo stress cardiaco, alla coagulazione e al fenotipo delle vie aeree in un nomogramma pratico. Lo studio mirava a identificare predittori clinici associati all'ipertensione polmonare definita tramite ecocardiografia e a costruire un modello validato internamente per la stratificazione precoce del rischio, piuttosto che per una diagnosi definitiva.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Il protocollo dello studio è stato esaminato e approvato dal Comitato Etico dell'Ospedale di Medicina Tradizionale Cinese della Contea di Santai nella Provincia di Mianyang, Sichuan (Numero di Approvazione: 2025003). Lo studio è stato condotto in conformità con i principi della Dichiarazione di Helsinki. Il consenso informato scritto è stato ottenuto da ciascun paziente o da un familiare di primo grado prima dell'inclusione nello studio. Questo studio retrospettivo di coorte ha esaminato le cartelle cliniche di pazienti anziani ricoverati per esacerbazione acuta della broncopneumopatia cronica ostruttiva (AECOPD) presso il Dipartimento di Medicina Respiratoria e di Terapia Intensiva dell'Ospedale di Medicina Tradizionale Cinese della Contea di Santai tra maggio 2023 e maggio 2025. Lo studio è stato progettato per identificare predittori clinici facilmente disponibili dell'ipertensione polmonare (PH) e per sviluppare un nomogramma per la stima personalizzata del rischio di PH. Gli strumenti di laboratorio, il sistema ecocardiografico, i materiali per il prelievo di sangue, gli strumenti per l'estrazione dei dati e il software statistico utilizzati in questo flusso di lavoro sono elencati nella Tabella dei Materiali.
1. Selezione del paziente e valutazione dell'idoneità
I pazienti ricoverati con una diagnosi di dimissione di AECOPD durante il periodo dello studio sono stati selezionati attraverso il sistema informatico delle cartelle cliniche ospedaliere. Ogni cartella è stata revisionata per confermare che il paziente avesse almeno 60 anni e che la diagnosi di malattia polmonare ostruttiva cronica fosse conforme ai criteri diagnostici del Global Initiative for Chronic Obstructive Lung Disease del 202115. L'AECOPD è stata definita come un peggioramento acuto dei sintomi respiratori che richiedeva il ricovero ospedaliero e un trattamento aggiuntivo. Per i pazienti con più di un ricovero per AECOPD durante il periodo dello studio, è stato incluso solo il primo ricovero idoneo.
I pazienti sono stati inclusi se soddisfacevano tutti i seguenti criteri: età di almeno 60 anni; ricovero per AECOPD tra maggio 2023 e maggio 2025; disponibilità di ecocardiografia transtoracica durante il ricovero indice; disponibilità del primo campione ematico venoso a digiuno dopo il ricovero; e informazioni cliniche, di laboratorio ed ecocardiografiche complete necessarie per la costruzione del modello. I pazienti sono stati esclusi se presentavano insufficienza epatica grave, malattia renale allo stadio terminale, neoplasia attiva, ipertensione polmonare attribuibile ad altre cause note, malattia cardiaca sinistra primaria, malattie del tessuto connettivo come la sclerosi sistemica, tubercolosi polmonare attiva o variabili chiave mancanti necessarie per la classificazione dell'esito o per la costruzione del modello.
Prima che i record fossero rimossi a causa di informazioni incomplete, sono stati verificati età, sesso, storia del fumo, storia dell'assunzione di alcol, storia di allergie ai farmaci, ipertensione, diabete mellito, malattia coronarica, asma, bronchiectasie, infezione polmonare, enfisema, insufficienza respiratoria, insufficienza cardiaca, stato di ipertensione polmonare all'ecocardiogramma, indici dell'emocromo completo, albumina, creatinina, proteina C-reattiva ad alta sensibilità, D-dimero, fibrinogeno, peptide natriuretico di tipo B e rapporto neutrofili-linfociti. Il numero di record esaminati ed esclusi, le motivazioni delle esclusioni e i casi finali inclusi sono stati registrati per costruire il diagramma di flusso della selezione dei pazienti (Figura 1).
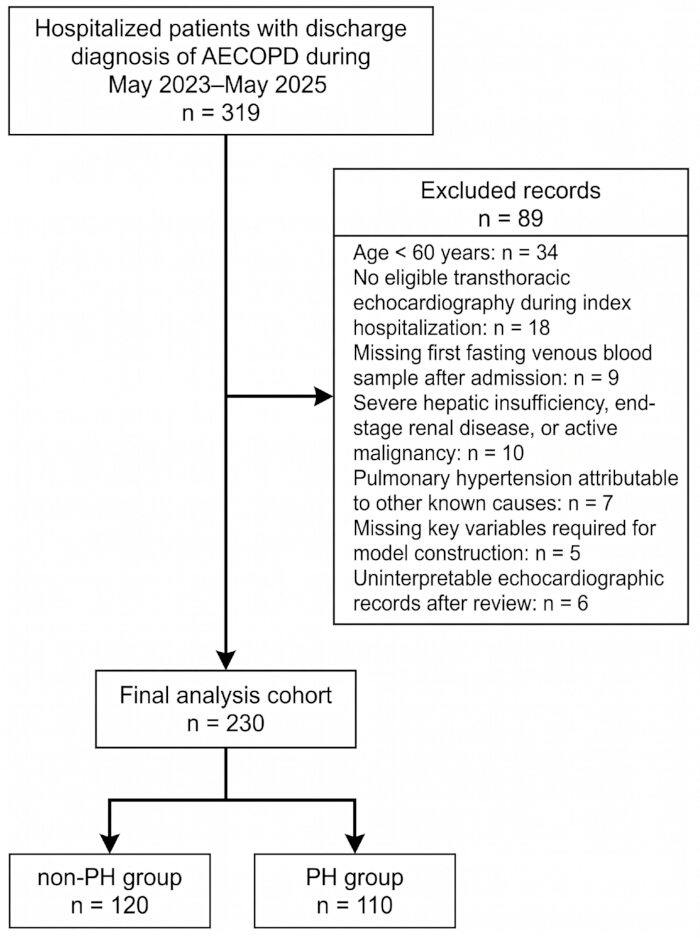
Figura 1: Selezione dei pazienti e costruzione della coorte. Il diagramma di flusso mostra l'identificazione dei record, la valutazione dell'idoneità, l'esclusione e il raggruppamento finale dei pazienti anziani ricoverati con AECOPD. I pazienti sono stati classificati nei gruppi non-PH o PH in base ai risultati dell'ecocardiografia transtoracica. Abbreviazioni: AECOPD, riacutizzazione acuta della malattia polmonare ostruttiva cronica; PH, ipertensione polmonare. Cliccare qui per visualizzare una versione ingrandita di questa figura.
2. Raggruppamento clinico e definizione diagnostica dell'ipertensione polmonare
I pazienti inclusi sono stati classificati in un gruppo senza ipertensione polmonare (non-IP) o in un gruppo con ipertensione polmonare (IP) in base ai risultati dell'ecocardiografia transtoracica effettuata durante il ricovero. Il criterio diagnostico si basava sulle linee guida del 2015 della Società Europea di Cardiologia/Società Europea di Pneumologia per l'ipertensione polmonare16. L'ecocardiografia transtoracica a riposo è stata utilizzata come base diagnostica in questo dataset retrospettivo. Gli esami sono stati eseguiti da medici ecocardiografi esperti mediante visualizzazioni standard parasternali, apicali e subcostali. L'interpretabilità ecocardiografica è stata valutata prima dell'assegnazione ai gruppi, poiché finestre acustiche scadenti sono comuni nei pazienti affetti da broncopneumopatia cronica ostruttiva. Un esame è stato considerato idoneo per la classificazione dell'IP quando il segnale Doppler del reflusso tricuspidale era misurabile oppure quando le dimensioni del ventricolo destro, lo spessore parietale e la funzione sistolica potevano essere valutati a partire da immagini cardiache interpretabili.
La pressione arteriosa polmonare sistolica è stata stimata utilizzando la velocità massima del reflusso tricuspidico e la pressione atriale destra stimata. La pressione atriale destra è stata stimata in base al diametro della vena cava inferiore e al collasso inspiratorio, quando entrambe le misurazioni erano disponibili. L'ipertensione polmonare (PH) è stata definita come una pressione arteriosa polmonare sistolica stimata di almeno 40 mmHg. Quando non è stato possibile stimare in modo affidabile la pressione arteriosa polmonare sistolica, la classificazione della PH richiedeva evidenze ecocardiografiche indirette di coinvolgimento del ventricolo destro, tra cui dilatazione del ventricolo destro, ipertrofia del ventricolo destro, disfunzione sistolica del ventricolo destro, appiattimento del setto interventricolare o dilatazione dell'arteria polmonare. I referti ecocardiografici con immagini non chiare, segnali Doppler del reflusso tricuspidico non tracciabili o risultati incoerenti del cuore destro sono stati riesaminati da un secondo medico ecocardiografista prima dell'assegnazione definitiva al gruppo. I referti che sono rimasti ininterpretabili dopo la revisione sono stati esclusi dall'analisi finale. Nel coorte finale, 230 pazienti anziani soddisfacevano i criteri di inclusione; 120 pazienti sono stati assegnati al gruppo senza PH e 110 pazienti al gruppo con PH.
3. Estrazione di variabili demografiche e cliniche
Tutti i dati clinici sono stati recuperati dal sistema elettronico delle cartelle cliniche ricoverate utilizzando un modulo standardizzato per la raccolta dei dati. Sono stati registrati sesso, età, anamnesi del fumo, anamnesi alcolica, anamnesi di allergia ai farmaci, ipertensione, diabete mellito, malattia coronarica, asma, bronchiectasie, infezione polmonare, enfisema, insufficienza respiratoria e insufficienza cardiaca. L’anamnesi del fumo è stata definita come un consumo cumulativo nella vita di almeno 100 sigarette, mentre l’anamnesi alcolica è stata definita come un consumo regolare di alcol di almeno due volte alla settimana.
L'infezione polmonare è stata diagnosticata integrando i sintomi respiratori, i segni fisici, gli esiti delle immagini toraciche e, quando disponibili, le evidenze microbiologiche. L'insufficienza cardiaca è stata diagnosticata in base alle manifestazioni cliniche, ai segni fisici, ai livelli del peptide natriuretico di tipo B e ai reperti ecocardiografici. Le informazioni relative alle comorbilità sono state verificate incrociando le diagnosi alla dimissione, le note di evoluzione, i referti di imaging, i referti di laboratorio e le cartelle delle consulenze specialistiche, quando disponibili.
4. Raccolta ed elaborazione delle variabili di laboratorio
Il primo campione di sangue venoso a digiuno, raccolto al mattino successivo al ricovero in ospedale, è stato utilizzato come fonte di dati di laboratorio. Questo momento corrispondeva al primo prelievo ematico del mattino dopo il ricovero e prima dell'aggiustamento della terapia diurna di routine, quando tali informazioni erano disponibili nel record medico. Gli indici dell'emocromo, gli indici biochimici, i marcatori della coagulazione, i marcatori infiammatori e i marcatori dello stress cardiaco sono stati estratti dal sistema informativo di laboratorio ospedaliero.
Il conteggio dei neutrofili, il conteggio dei linfociti, il conteggio delle piastrine, il volume medio piastrinico e il coefficiente di variazione dell'ampiezza della distribuzione dei globuli rossi sono stati registrati dal referto dell'emocromo completo. Il rapporto neutrofili/linfociti è stato calcolato come segue:
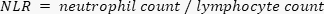
Albumina, creatinina, D-dimero, fibrinogeno, proteina C-reattiva ad alta sensibilità e peptide natriuretico di tipo B sono stati registrati dai relativi referti di laboratorio. Sono state utilizzate unità di misura coerenti in tutto il dataset: albumina in g/L, creatinina in µmol/L, proteina C-reattiva ad alta sensibilità in mg/L, D-dimero in µg/mL, fibrinogeno in g/L, conta dei neutrofili, conta dei linfociti e conta delle piastrine in ×109/L, volume medio piastrinico in fL e peptide natriuretico di tipo B in pg/mL.
5. Pulizia e preparazione dei dati
Il dataset è stato esaminato prima dell'analisi statistica. Ogni record incluso è stato verificato per quanto riguarda l'idoneità, l'assegnazione al gruppo, la completezza dei dati di laboratorio, l'interpretabilità ecocardiografica e la disponibilità dei predittori candidati. Gli identificatori personali diretti sono stati rimossi e a ogni paziente è stato assegnato un numero identificativo dello studio. I record duplicati, le ospedalizzazioni ripetute, le etichette di gruppo incoerenti, le date impossibili e i valori di laboratorio implausibili sono stati controllati confrontandoli con il record medico elettronico originale e con il referto di laboratorio. Non è stata effettuata alcuna imputazione per le variabili chiave dell'esito o dei predittori, poiché il modello finale si basava su un'analisi dei casi completi.
Le variabili continue sono state esaminate per le loro caratteristiche distributive. Le variabili con distribuzione normale sono state riassunte come media ± deviazione standard; quelle con distribuzione non normale come mediana con intervallo interquartile; e le variabili categoriche come frequenze assolute e percentuali. Prima della modellizzazione multivariata, le variabili clinicamente correlate sono state verificate per ridondanza. Il conteggio dei neutrofili e il conteggio dei linfociti sono stati esaminati insieme al rapporto neutrofili-linfociti; l'infezione polmonare è stata esaminata insieme al conteggio dei neutrofili, alla proteina C-reattiva ad alta sensibilità e al rapporto neutrofili-linfociti; lo scompenso cardiaco è stato esaminato insieme al peptide natriuretico di tipo B e ai reperti ecocardiografici cardiaci; la D-dimero e il fibrinogeno sono stati esaminati come variabili correlate alla coagulazione; e il conteggio delle piastrine, il volume medio piastrinico e il coefficiente di variazione dell'ampiezza della distribuzione eritrocitaria sono stati esaminati come variabili ematologiche.
6. Confronto univariato tra gruppi
Le caratteristiche demografiche, le comorbidità, gli indicatori di laboratorio e le variabili di raggruppamento ecocardiografico sono stati confrontati tra i gruppi senza ipertensione polmonare (non-PH) e con ipertensione polmonare (PH). Per le variabili continue con distribuzione normale è stato utilizzato il test t per campioni indipendenti. Per le variabili continue con distribuzione non normale è stato utilizzato il test U di Mann-Whitney. Per le variabili categoriche è stato impiegato il test χ2 o il test esatto di Fisher, a seconda dei conteggi attesi nelle celle. È stato considerato statisticamente significativo un valore P bilaterale inferiore a 0,05. Le variabili che presentavano differenze significative tra i gruppi sono state prese in considerazione per una valutazione multivariata insieme ai predittori clinicamente rilevanti.
7. Analisi di regressione logistica multivariata
È stata utilizzata una regressione logistica binaria per identificare i predittori indipendenti associati all'ipertensione polmonare (PH) in pazienti anziani con AECOPD. Lo stato di PH è stato utilizzato come variabile dipendente. I predittori continui sono stati inseriti nelle loro unità di misura originali, mentre i predittori categorici sono stati codificati come variabili binarie. Le variabili candidate sono state selezionate in base ai risultati univariati e alla rilevanza clinica. Le variabili con P < 0,05 nel confronto univariato sono state inizialmente identificate, quindi valutate per ridondanza, interpretabilità e sovrapposizione clinica.
Le variabili candidate iniziali includevano la proteina C-reattiva ad alta sensibilità, il D-dimero, il coefficiente di variazione dell'ampiezza di distribuzione dei globuli rossi, il conteggio delle piastrine, il volume medio piastrinico, il rapporto neutrofili-linfociti, il peptide natriuretico di tipo B, la cardiopatia coronarica e la storia di asma. Il conteggio dei neutrofili e il conteggio dei linfociti non sono stati inseriti contemporaneamente al rapporto neutrofili-linfociti poiché ne costituivano le componenti. L'infezione polmonare e lo scompenso cardiaco sono stati valutati durante la valutazione di ridondanza. Per verificare se la loro esclusione influenzasse l'interpretazione del modello, è stata eseguita un'analisi di sensibilità aggiungendo l'infezione polmonare e lo scompenso cardiaco all'insieme dei predittori principali. Le stime di regressione, la capacità discriminante, la calibrazione e il beneficio netto clinico sono stati confrontati tra i modelli principale e di sensibilità.
La multicollinearità tra i predittori candidati è stata valutata utilizzando i fattori di inflazione della varianza. Le variabili categoriche sono state codificate prima del calcolo, e le variabili continue sono state inserite nelle stesse unità utilizzate per la modellizzazione della regressione. Un fattore di inflazione della varianza inferiore a 5 è stato considerato indicativo di assenza di multicollinearità grave. Sono stati riportati i coefficienti di regressione, gli errori standard, i valori di Wald χ2, i rapporti di probabilità (odds ratios), gli intervalli di confidenza al 95%, i valori P e i fattori di inflazione della varianza per le variabili incluse nel modello multivariabile.
8. Costruzione del nomogramma
Il nomogramma è stato costruito a partire dai predittori indipendenti mantenuti nel modello di regressione logistica multivariata. I predittori finali erano il D-dimero, il rapporto neutrofili-linfociti, il peptide natriuretico di tipo B e la storia di asma. Il modello di regressione logistica è stato convertito in un nomogramma basato su punteggi utilizzando il software R e il pacchetto rms. È stato generato un oggetto di distribuzione dei dati per il dataset utilizzato nella modellizzazione, è stato adattato il modello di regressione logistica e i coefficienti di regressione sono stati utilizzati per assegnare i punteggi a ciascun predittore. Per ogni paziente, i punteggi relativi a D-dimero, rapporto neutrofili-linfociti, peptide natriuretico di tipo B e storia di asma sono stati sommati per ottenere un punteggio totale, che è stato quindi associato alla probabilità stimata di ipertensione polmonare (PH).
Il nomogramma è stato interpretato utilizzando procedure standard basate sui punti, descritte in precedenti studi sui modelli predittivi clinici17,18. Il valore del D-dimero del paziente, il rapporto neutrofili-linfociti, il valore del peptide natriuretico di tipo B e lo stato di asma sono stati individuati sui rispettivi assi. Da ciascun valore predittivo è stata tracciata una linea verticale fino alla scala dei punti. I punti sono stati sommati per ottenere il punteggio totale, e da questa scala è stata tracciata una linea verticale fino all'asse della probabilità predetta, per ottenere la probabilità stimata individualizzata di PH. Il paziente illustrativo utilizzato nel manoscritto è stato selezionato in base a valori interni o prossimi alla distribuzione clinica osservata nella coorte.
9. Valutazione delle prestazioni del modello
La discriminazione del modello è stata valutata mediante l'analisi della curva caratteristica operativa del ricevitore e dell'area sotto la curva. L'area sotto la curva è stata riportata con un intervallo di confidenza del 95%. Il nomogramma è stato confrontato con i singoli predittori e con un modello che combina marcatori di laboratorio quantitativi. La calibrazione è stata valutata confrontando le probabilità previste con gli esiti osservati di PH. È stata generata una curva di calibrazione utilizzando il ricampionamento bootstrap. Sono stati riportati l'intercetta di calibrazione, la pendenza della calibrazione, l'errore assoluto medio, il punteggio di Brier e il test di Hosmer-Lemeshow. Sono stati inoltre calcolati l'intercetta di calibrazione corretta con bootstrap e la pendenza di calibrazione corretta con bootstrap. Il test di Hosmer-Lemeshow è stato interpretato insieme alla curva di calibrazione e agli indici quantitativi di calibrazione.
L'utilità clinica è stata valutata mediante l'analisi della curva decisionale. Il beneficio netto è stato rappresentato graficamente in funzione delle probabilità soglia e confrontato con le strategie di riferimento "tratta-tutti" e "non-trattare-nessuno". È stato identificato l'intervallo di probabilità soglia in cui il modello offriva un beneficio netto superiore rispetto alle strategie di riferimento.
10. Validazione interna e riproducibilità
È stata eseguita una validazione interna mediante ricampionamento bootstrap con 1.000 ripetizioni. In ciascuna replica bootstrap, il modello è stato rielaborato e testato per stimare l'ottimismo nella prestazione del modello. Sono stati calcolati e riportati gli indici di discriminazione e calibrazione corretti per l'ottimismo, insieme alla prestazione apparente del modello.
Le analisi statistiche sono state eseguite utilizzando software statistico standard e R versione 4.5.2. I pacchetti di R sono stati utilizzati per la modellizzazione tramite regressione logistica, la costruzione del nomogramma, l'analisi della curva ROC (receiver operating characteristic), la valutazione della calibrazione, la validazione interna e l'analisi della curva decisionale. Il nomogramma è stato costruito utilizzando il pacchetto rms in R.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Caratteristiche dello screening dei pazienti e della coorte
Un totale di 230 pazienti anziani ricoverati per esacerbazione acuta della malattia polmonare ostruttiva cronica (AECOPD) hanno soddisfatto i criteri di inclusione ed sono stati inclusi nell'analisi finale. In base alla valutazione ecocardiografica transtoracica, 120 pazienti sono stati assegnati al gruppo senza ipertensione polmonare (non-IP), e 110 pazienti sono stati assegnati al gruppo con ipertensione polmonare (...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo studio ha sviluppato un nomogramma basato su dati di routine per stimare il rischio di ipertensione polmonare (PH) in pazienti anziani ricoverati per esacerbazione acuta della malattia polmonare ostruttiva cronica (AECOPD). Quattro variabili facilmente disponibili, ovvero il rapporto neutrofili-linfociti (NLR), il peptide natriuretico di tipo B (BNP), il D-dimero e la storia di asma, sono state mantenute nel modello principale. Il nomogramma ha mostrato una migliore capacità discriminante rispetto ai singoli marca...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto né altri conflitti di interesse relativi a questo lavoro.
Contributi degli autori
Mingfeng Wu: Progettazione dello studio, supervisione e attuazione, stesura e revisione del manoscritto, coordinamento delle responsabilità del team; Li Zhang: Raccolta e organizzazione dei dati, analisi statistica e stesura del manoscritto; Xiong Wang: Raccolta dei dati e stesura del manoscritto; Shaohua Xu: Analisi statistica e revisione del manoscritto; Li Xie: Revisione del manoscritto.
Ringraziamenti
Questo studio è stato sostenuto dai Progetti di Ricerca Scientifica dell'Amministrazione Provinciale di Medicina Tradizionale Cinese di Sichuan, tra cui Esplorazione Pratica della Costruzione di un Modello di Previsione dell’Ipertensione Polmonare per Pazienti Anziani con Malattia Polmonare Ostrettrica Cronica in Base al Rapporto NLR (Numero di Concessione 25MSZX321) e Costruzione di un Modello di Servizio di Laboratorio per la Comunità Medica di Contea e Ricerca sulle Risposte Politiche Basate su “Consegna con Droni + Diagnosi Assistita da Intelligenza Artificiale” (Numero di Concessione 25MSZX322). Gli autori ringraziano l’Ospedale di Medicina Tradizionale Cinese del Distretto di Santai per il sostegno allo studio.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Analizzatore automatizzato di chimica clinica | Mindray Bio-Medical Electronics Co., Ltd. | BS-480 | Utilizzato per misurare albumina sierica, creatinina e proteina C-reattiva ad alta sensibilità nei test di laboratorio clinico di routine. |
| Analizzatore automatizzato della coagulazione | Mindray Bio-Medical Electronics Co., Ltd. | C3510 | Utilizzato per misurare il D-dimero e il fibrinogeno nei test di coagulazione di routine. |
| Analizzatore automatizzato di ematologia | Mindray Bio-Medical Electronics Co., Ltd. | BC-5380 | Utilizzato per misurare il numero di neutrofili, il numero di linfociti, il numero di piastrine, il volume medio piastrinico e il coefficiente di variazione della larghezza della distribuzione dei globuli rossi. |
| Analizzatore per immunoanalisi chemiluminescente | Mindray Bio-Medical Electronics Co., Ltd. | CL-1200i | Utilizzato per misurare il peptide natriuretico di tipo B nei test di laboratorio clinico di routine. |
| Reagenti, calibratori e controlli per immunoanalisi chemiluminescente | Mindray Bio-Medical Electronics Co., Ltd. | Sistema di reagenti serie CL | Utilizzati per test di immunoanalisi chemiluminescente e controllo qualità. |
| Reagenti, calibratori e controlli per chimica clinica | Mindray Bio-Medical Electronics Co., Ltd. | Sistema di reagenti serie BS | Utilizzati per saggi di chimica clinica di routine eseguiti sull'analizzatore serie BS. |
| Calibratori e controlli per coagulazione | Mindray Bio-Medical Electronics Co., Ltd. | Specifica del prodotto* | Utilizzati per controllo qualità e calibrazione dei saggi della coagulazione. |
| Pacchetto dcurves | CRAN | dcurves | Utilizzato per eseguire l'analisi della curva decisionale e calcolare il beneficio clinico netto in corrispondenza di diverse probabilità soglia. |
| Provetta per prelievo venoso di sangue con EDTA | BD | Provetta Vacutainer K2EDTA (REF 367856) | Utilizzata per il test del conteggio ematico completo. |
| Sistema informatizzato della cartella clinica | Ospedale di Medicina Tradizionale Cinese del Distretto di Santai | Non applicabile | Utilizzato per recuperare le caratteristiche demografiche dei pazienti ricoverati, le cartelle di ammissione, le diagnosi alla dimissione, le comorbidità, le note di evoluzione, i referti di imaging, i referti di consulenza e gli esiti clinici. |
| Reagenti, calibratori e controlli per ematologia | Mindray Bio-Medical Electronics Co., Ltd. | Sistema di reagenti serie BC | Utilizzati per test di conteggio ematico completo di routine e controllo qualità dell'analizzatore. |
| IBM SPSS Statistics | IBM Corp. | Versione 26.0 | Utilizzato per statistiche descrittive, confronti tra gruppi e analisi preliminare di regressione logistica. |
| Sistema informativo di laboratorio | Ospedale di Medicina Tradizionale Cinese del Distretto di Santai | Non applicabile | Utilizzato per recuperare gli indici ematologici, gli indici biochimici, i marcatori della coagulazione, i marcatori infiammatori e i marcatori dello stress cardiaco. |
| Pacchetto pROC | CRAN | pROC | Utilizzato per l'analisi della curva ROC (caratteristica operativa del ricevitore) e la stima dell'area sotto la curva. |
| Software statistico R | Fondazione R per il Calcolo Statistico | Versione 4.5.2 | Utilizzato per la modellizzazione di regressione logistica, la costruzione di nomogrammi, l'analisi della curva ROC, la valutazione della calibrazione, la validazione interna con bootstrap e l'analisi della curva decisionale. |
| Pacchetto ResourceSelection | CRAN | ResourceSelection | Utilizzato per eseguire il test di bontà dell'adattamento di Hosmer-Lemeshow. |
| Pacchetto rms | CRAN (Frank E. Harrell Jr.) | rms | Utilizzato per la modellizzazione della regressione, la costruzione di nomogrammi, la valutazione della calibrazione e la validazione interna. |
| Provetta per prelievo venoso di sangue con separatore del siero | BD | Provetta Vacutainer SST (REF 367820) | Utilizzata per test biochimici del siero e marcatori infiammatori. |
| Provetta per prelievo venoso di sangue con citrato di sodio | BD | Provetta Vacutainer citrato (REF 363080) | Utilizzata per test della coagulazione, inclusi D-dimero e fibrinogeno. |
| Modulo standardizzato per l'estrazione dei dati clinici | Creato dal gruppo di studio | Non applicabile | Utilizzato per estrarre variabili demografiche, cliniche, di laboratorio ed ecocardiografiche predeterminate da cartelle cliniche retrospettive. |
| Sistema di ecocardiografia transtoracica | GE HealthCare | Vivid E95 | Utilizzato per stimare la pressione arteriosa polmonare sistolica e valutare le dimensioni del ventricolo destro, lo spessore della parete e la funzione sistolica. |
Riferimenti
- Adeloye D, et al. Global, regional, and national prevalence of, and risk factors for, chronic obstructive pulmonary disease (COPD) in 2019: a systematic review and modelling analysis. Lancet Respir Med. 2022;10:447-58.
- Chronic Obstructive Pulmonary Disease Group of Chinese Thoracic Society, Chronic Obstructive Pulmonary Disease Committee of Chinese Association of Chest Physician. Guidelines for the diagnosis and management of chronic obstructive pulmonary disease, revised version 2021. Chin J Tuberc Respir Dis. 2021;44:170-205.
- Johnson S, et al. Pulmonary hypertension: a contemporary review. Am J Respir Crit Care Med. 2023;208:528-48.
- Munshi RF, Pellegrini JR Jr, Patel P, Anjum F. Impact of pulmonary hypertension in patients with acute exacerbation of chronic obstructive pulmonary disease and its effect on healthcare utilization. Pulm Circ. 2021;11(3):20458940211046838.
- Prins KW, et al. Disproportionate right ventricular dysfunction and poor survival in group 3 pulmonary hypertension. Am J Respir Crit Care Med. 2018;197:1496-9.
- Andersen KH, et al. Prevalence, predictors, and survival in pulmonary hypertension related to end-stage chronic obstructive pulmonary disease. J Heart Lung Transplant. 2012;31:373-80.
- Chen Y, et al. Right heart catheterization-related complications: a review of the literature and best practices. Cardiol Rev. 2020;28:36-41.
- Younis M, et al. Echocardiography and pulmonary hypertension in patients with chronic obstructive pulmonary disease undergoing lung transplantation evaluation. Am J Med Sci. 2024;367:95-104.
- Pascual-González Y, López-Sánchez M, Dorca J, Santos S. Defining the role of neutrophil-to-lymphocyte ratio in COPD: a systematic literature review. Int J Chron Obstruct Pulmon Dis. 2018;13:3651-62.
- Lee SJ, et al. Usefulness of neutrophil to lymphocyte ratio in patients with chronic obstructive pulmonary disease: a prospective observational study. Korean J Intern Med. 2016;31:891-8.
- Leuchte HH, et al. Brain natriuretic peptide is a prognostic parameter in chronic lung disease. Am J Respir Crit Care Med. 2006;173:744-50.
- Husebø GR, et al. Coagulation markers as predictors for clinical events in COPD. Respirology. 2021;26:342-51.
- Iasonos A, Schrag D, Raj GV, Panageas KS. How to build and interpret a nomogram for cancer prognosis. J Clin Oncol. 2008;26:1364-70.
- Balachandran VP, Gonen M, Smith JJ, DeMatteo RP. Nomograms in oncology: more than meets the eye. Lancet Oncol. 2015;16(4):e173-e180.
- Global Initiative for Chronic Obstructive Lung Disease. Global Strategy for the Diagnosis, Management, and Prevention of Chronic Obstructive Pulmonary Disease: 2021 Report. Global Initiative for Chronic Obstructive Lung Disease; Fontana; 2021.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2016;37:67-119.
- Wu Z, Zhan S, Wang D, Tang C. A novel nomogram for predicting the risk of acute heart failure in intensive care unit patients with COPD. Chronic Obstr Pulm Dis. 2025;12(2):117-126.
- Cheng H, et al. A risk nomogram for predicting prolonged intensive care unit stays in patients with chronic obstructive pulmonary disease. Front Med. 2023;10:1177786.
- Zinellu A, et al. Clinical significance of the neutrophil-to-lymphocyte ratio and platelet-to-lymphocyte ratio in acute exacerbations of COPD: present evidence and future perspectives. Eur Respir Rev. 2022;31(166):220095.
- Jiang T, et al. Value of the neutrophil-to-lymphocyte ratio in chronic obstructive pulmonary disease complicated with pulmonary hypertension. J Int Med Res. 2023;51(1):3000605231200266.
- Hawkins NM, et al. B-type natriuretic peptides in chronic obstructive pulmonary disease: a systematic review. BMC Pulm Med. 2017;17:11.
- Hu G, et al. Prognostic role of D-dimer for in-hospital and 1-year mortality in exacerbations of COPD. Int J Chron Obstruct Pulmon Dis. 2016;11:2729-36.
- Zuo H, et al. Predictive value of novel inflammation-based biomarkers for pulmonary hypertension in the acute exacerbation of chronic obstructive pulmonary disease. Anal Cell Pathol (Amst). 2019;2019:5189165.
- Hayiroglu MI, Cicek V, Kilic S, Cinar T. Mean serum D-dimer level to predict in-hospital mortality in COVID-19 patients. Rev Assoc Med Bras (1992). 2021;67:1108-13.
- Guney BC, et al. Evaluation of N/LP ratio as a predictor of disease progression and mortality in COVID-19 patients admitted to the intensive care unit. Medeni Med J. 2021;36:241-8.
- Hayiroglu MI, Cinar T, Tekkesin AI. Fibrinogen and D-dimer variances and anticoagulation recommendations in COVID-19: current literature review. Rev Assoc Med Bras (1992). 2020;66:842-8.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162:55-63.
- Moons KGM, et al. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: explanation and elaboration. Ann Intern Med. 2015;162(1):W1-W73.
- Kalenderoglu K, et al. Heart rate variability nomogram predicts atrial fibrillation in patients with moderate to high burden of premature ventricular complexes. Medicina (Kaunas). 2026;62:243.
- Cicek V, et al. A new risk prediction model for the assessment of myocardial injury in elderly patients undergoing non-elective surgery. J Cardiovasc Dev Dis. 2025;12(1):6.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.