Questo studio retrospettivo monocentrico ha sviluppato e validato internamente un modello di regressione logistica per l'ischemia cerebrale ritardata dopo emorragia subaracnoidea aneurismatica. In 680 pazienti, sei variabili cliniche, di laboratorio e di imaging precoci hanno mostrato un valore predittivo preliminare. È richiesta un'ulteriore validazione esterna prima dell'uso clinico.
Articolo di ricerca
Validazione interna di un modello di previsione clinica per l'ischemia cerebrale ritardata dopo emorragia subaracnoidea aneurismatica
In questo articolo
Sommario
Abstract
L'ischemia cerebrale tardiva (DCI) è una causa importante di danno neurologico secondario dopo emorragia subaracnoidea aneurismatica (aSAH). Questo studio retrospettivo monocentrico ha sviluppato e valutato modelli predittivi per la DCI utilizzando dati provenienti da 680 pazienti adulti con aSAH trattati tra luglio 2022 e dicembre 2024. I pazienti sono stati suddivisi mediante una ripartizione stratificata per esito di 8:2 in una coorte di addestramento composta da 544 pazienti e una coorte di validazione interna distinta di 136 pazienti. La DCI si è verificata in 175 pazienti nella coorte di addestramento e in 42 pazienti nella coorte di validazione interna. La selezione dei predittori è stata effettuata nella coorte di addestramento mediante regressione con operatore di riduzione e selezione assoluta minima (LASSO) con validazione incrociata a 10 ripiegamenti. Sono state mantenute sei variabili: età, edema cerebrale, ipoalbuminemia, grado di Fisher modificato, grado di Hunt-Hess e grado della World Federation of Neurological Surgeons. Sono stati confrontati modelli di regressione logistica, boosting estremo del gradiente, macchina con boosting leggero del gradiente, macchina a vettori di supporto e vicini più prossimi (k-nearest neighbor). La regressione logistica ha mostrato un'area sotto la curva caratteristica operativa del ricevitore di 0,832 (intervallo di confidenza al 95%, 0,758–0,906) nella coorte di validazione interna. La sua pendenza di calibrazione, l'intercetta di calibrazione e il punteggio di Brier sono stati rispettivamente 0,98, 0,02 e 0,168, sebbene gli intervalli di confidenza per queste stime di calibrazione non fossero disponibili. I risultati rappresentano una prestazione preliminare in una singola coorte di validazione interna distinta. L'assenza di registrazioni completamente riproducibili, l'assenza dell'intercetta del modello, la mancanza di una correzione dell'ottimismo basata sul ricampionamento e l'assenza di una validazione esterna impediscono attualmente il calcolo delle probabilità a livello individuale e l'implementazione clinica.
Introduzione
Sono stati proposti diversi modelli predittivi per la DCI dopo aSAH, ma molti sono stati limitati da campioni di piccole dimensioni, valutazioni incomplete della calibrazione, una segnalazione insufficiente delle procedure di sviluppo del modello e dalla mancanza di una validazione esterna. Molti studi si sono concentrati principalmente sulla discriminazione, mentre la calibrazione, la riproducibilità e la valutazione dell'impatto clinico sono state riportate in modo meno coerente. Pertanto, le prestazioni del modello dovrebbero essere valutate utilizzando metodi trasparenti e interpretate con cautela quando la validazione è limitata a un singolo centro.
Lo scopo del presente studio era sviluppare e valutare internamente modelli predittivi per il DCI utilizzando variabili cliniche, di laboratorio e di imaging disponibili routine nei primi stadi. Cinque approcci modellistici sono stati confrontati utilizzando lo stesso insieme di predittori selezionati. Il punto temporale previsto per la predizione corrispondeva al periodo successivo al ricovero iniziale e alla valutazione di laboratorio e di imaging, ma precedente al periodo principale di rischio di DCI. I modelli sono stati sviluppati per la stima del rischio in ambito di ricerca e non avevano lo scopo di diagnosticare il DCI, sostituire il giudizio clinico o determinare autonomamente il trattamento. Prima di un utilizzo clinico, è necessaria una validazione esterna, una ricalibrazione e una valutazione dell’impatto clinico.
L'ischemia cerebrale tardiva (DCI) è uno di questi danni secondari che si è rivelato tra le condizioni più clinicamente significative e potenzialmente prevenibili dopo l'emorragia subaracnoidea aneurismatica (aSAH). La DCI è una complicanza che di solito insorge diversi giorni dopo l'ictus, tipicamente tra i 3 e i 14 giorni, ed è associata a un nuovo deficit neurologico focale, al peggioramento del livello di coscienza e/o all'insorgenza di infarto cerebrale riscontrabile nelle successive neuroimmagini. Sebbene esistano alcune differenze nelle pratiche diagnostiche tra diverse istituzioni, la DCI è sempre correlata a un lungo ricovero in terapia intensiva, a un elevato consumo di risorse e a una prognosi neurologica sfavorevole. L'incidenza riportata di DCI è tipicamente del 30–40 percento, a sottolineare la sua diffusione e il notevole impatto prognostico1,2,3,4,5,6. È importante notare che la DCI non è un processo a via unica. Sebbene l'attenzione sia sempre stata focalizzata sulla vasospasmo cerebrale dei grossi vasi, evidenze crescenti mostrano anche che il danno cerebrale precoce, la depolarizzazione diffusa corticale, la neuroinfiammazione, la microtrombosi, la disfunzione endoteliale, l'alterazione dell'autoregolazione e il fallimento della microcircolazione contribuiscono tutti al rischio ischemico. Questa patofisiologia multifattoriale aiuta a spiegare perché i trattamenti mirati al vasospasmo potrebbero non prevenire completamente l'infarto associato alla DCI e perché i pazienti ad alto rischio sono difficili da identificare nel normale contesto clinico.
La stratificazione del rischio di ICD dopo aSAH è una priorità perché, con un tempestivo riconoscimento dei pazienti ad alto rischio, potrebbe essere possibile monitorarli più attentamente e intensificare prontamente le misure preventive o di salvataggio7. I piani di monitoraggio nella pratica clinica possono prevedere l'uso di test neurologici più frequenti, ecografia Doppler transcranica, tecniche di imaging sofisticate, come la perfusione con tomografia computerizzata, ottimizzazione emodinamica e del volume intravascolare, rigorosa adesione alla terapia con nimodipina e riconoscimento precoce del deterioramento neurologico, come idrocefalo, re-emorragia, crisi convulsive, infezione o squilibrio metabolico. Tuttavia, le decisioni cliniche tendono a essere influenzate più da scale di gravità globale e dall'esperienza dei clinici che da stime personalizzate e basate sui dati della probabilità di ICD8,9,10. Un motivo è che la letteratura indica che i fattori di rischio sono eterogenei e che l'interazione tra fattori legati al paziente, carico emorragico, alterazioni fisiologiche e scale di valutazione neurologica può essere non lineare e complessa. Studi precedenti hanno analizzato potenziali predittori di ICD, tra cui età, ipertensione, stato neurologico basale, caratteristiche dell'aneurisma, indici di laboratorio (come sodio sierico e albumina), caratteristiche radiologiche indicative del carico emorragico e fattori perioperatori o legati al trattamento. Le tecniche convenzionali di regressione si sono rivelate utili, ma possono risultare limitate quando i predittori sono correlati, quando la relazione tra predittori e rischio è non lineare o quando esistono interazioni tra le variabili11. Parallelamente, sono stati proposti diversi strumenti (più comunemente nomogrammi) per valutare il rischio di ICD. Sebbene i nomogrammi siano fattibili e di facile interpretazione visiva, la maggior parte di essi si basa su campioni ridotti, include poche variabili e potrebbe essere sovradattata o scarsamente validata. Inoltre, modelli sviluppati e testati in un singolo centro potrebbero non essere facilmente trasferibili ad altre strutture a causa di differenze nella composizione dei pazienti, nell'interpretazione delle immagini, nei trattamenti e nelle soglie diagnostiche per l'ICD.
I metodi di apprendimento automatico (machine learning) possono integrare i modelli tradizionali di previsione clinica, poiché consentono di esplorare un numero maggiore di dimensioni nei dati clinici e di osservare tendenze più complesse, senza dover formulare assunzioni lineari rigide. Negli ultimi anni, i modelli predittivi basati sull'apprendimento automatico hanno trovato un'applicazione sempre più diffusa nel campo delle malattie cerebrovascolari, inclusa la previsione di esiti e complicanze, nonché il supporto decisionale.12,13,14Gli algoritmi di machine learning comunemente utilizzati includono metodi basati su alberi d'insieme come l'Extreme Gradient Boosting (XGBoost) e la Light Gradient Boosting Machine (LightGBM), classificatori basati su kernel come le macchine a vettori di supporto (SVM) e classificatori basati sulla distanza come il k-nearest neighbors (KNN). In linea di principio, questi modelli sono in grado di modellare nonlinearità. e le interazioni più approcci tradizionali15Tuttavia, sono presenti anche aspetti pratici legati ai modelli di apprendimento automatico, come il rischio di overfitting, la ridotta interpretabilità e la necessità di gestire pre-elaborazione, ottimizzazione, calibrazione, valutazione e validazione. È opportuno sottolineare che in un'ampia gamma di scenari clinici, una regressione logistica ben specificata può prestarsi altrettanto bene, o addirittura in modo più efficace, rispetto ad algoritmi più complessi, specialmente quando il numero di predittori è ridotto e il rapporto segnale-rumore è moderato. Pertanto, è necessaria un'analisi comparativa di diversi algoritmi mediante predittori e metriche di valutazione simili per identificare un modello che si correli con le prestazioni e l'applicabilità clinica16,17,18.
Sono stati precedentemente proposti diversi modelli predittivi per l'ischemia cerebrale ritardata; tuttavia, molti presentano limitazioni importanti, tra cui campioni di piccole dimensioni, valutazione limitata della calibrazione, mancanza di confronto diretto tra algoritmi e validazione insufficiente. Inoltre, studi precedenti spesso enfatizzano la capacità discriminante sottovalutando le metriche di calibrazione e di utilità clinica, che sono essenziali per l'applicabilità nella pratica reale. Il presente studio affronta queste lacune sviluppando un modello predittivo in una coorte relativamente ampia, implementando una selezione sistematica dei predittori mediante regressione con operatore di riduzione e selezione assoluta minima (LASSO), confrontando diversi algoritmi di apprendimento automatico all'interno di un framework modellistico unificato e valutando in modo completo le prestazioni discriminanti, di calibrazione e analitiche decisionali.
Sono stati proposti diversi modelli predittivi per il DCI dopo aSAH, ma molti presentano limitazioni importanti, tra cui coorti di piccole dimensioni, valutazione limitata della calibrazione, segnalazione incompleta dello sviluppo del modello e mancanza di validazione esterna o temporale. Inoltre, molti studi riportano solo la discriminazione, mentre la calibrazione e l'analisi della curva decisionale sono presentate in modo meno coerente. Lo studio attuale non risolve il problema della validazione esterna. Piuttosto, fornisce uno studio di sviluppo monocentrico e di validazione interna basato su variabili cliniche, di laboratorio e di imaging comunemente disponibili. L'uso previsto riguarda la stratificazione precoce del rischio dopo il ricovero e il trattamento iniziale dell'aneurisma, prima della finestra principale di rischio per il DCI. Il modello potrebbe aiutare i clinici a identificare i pazienti che necessitano di un monitoraggio neurologico più stretto, di un controllo vascolare con imaging, della correzione di anomalie fisiologiche e di una valutazione precoce da parte del team di neuroterapia intensiva. Non è inteso a sostituire il giudizio clinico, a diagnosticare il DCI o a guidare il trattamento senza una validazione esterna e test sull'impatto clinico. Studi precedenti hanno proposto diversi modelli per prevedere il DCI dopo aSAH, ma molti sono stati limitati da campioni di piccole dimensioni, segnalazione incompleta della calibrazione, confronti limitati tra metodi di modellizzazione o mancanza di validazione esterna. Lo studio attuale non afferma di fornire uno strumento decisionale clinicamente validato. Piuttosto, mira a sviluppare e validare internamente un modello predittivo utilizzando variabili cliniche, di laboratorio e di imaging precoci comunemente disponibili, provenienti da una coorte monocentrica. L'uso previsto riguarda la stratificazione precoce del rischio dopo il ricovero e il trattamento iniziale dell'aneurisma, prima del periodo principale di rischio per il DCI. In questo contesto, un rischio predetto elevato supporterebbe una valutazione neurologica più accurata, un monitoraggio vascolare, la correzione di anomalie fisiologiche e una revisione precoce da parte dell'assistenza neurocritica. Il modello non è destinato a diagnosticare il DCI né a sostituire il giudizio del clinico.
Protocollo
The study was approved by the Institutional Ethics Committee of Yulin First Hospital, Shaanxi Province, China. Because this was a retrospective analysis of routinely collected hospital data, and because all data were anonymized before analysis, the requirement for written informed consent was waived. The study was conducted in accordance with institutional data-protection requirements and the principles of the Declaration of Helsinki.
Data and Methods
Study Population and Design
This was a retrospective single-center cohort study conducted at Yulin First Hospital, Shaanxi Province, China. The hospital records of patients admitted with aSAH between July 2022 and December 2024 were screened. Eligible patients were adults aged 18 years or older with a diagnosis of aSAH confirmed by cranial and intracranial vascular imaging. Patients were required to have been admitted within 72 h after symptom onset and to have undergone aneurysm treatment during the index hospitalization.
Patients were excluded if they had traumatic subarachnoid hemorrhage, non-aneurysmal subarachnoid hemorrhage, severe pre-existing hematological disease, other major intracranial disease affecting outcome assessment, insufficient records for DCI evaluation, or in-hospital death before an adequate DCI assessment period. Excluding early in-hospital deaths may introduce survivorship bias because the most severe cases may be removed from analysis. Therefore, the findings should be interpreted as applying mainly to patients who survived long enough for DCI evaluation.
Data Collection
Clinical, laboratory, imaging, and treatment-related variables were extracted from the electronic medical record using a predefined data-extraction form. The extracted variables included demographic factors, medical history, aneurysm features, early neurological grade, early imaging findings, laboratory results, treatment approach, and hospital complications. The intended prediction time point was after completion of the initial admission and perioperative assessment, but before the main DCI risk window.
Age, sex, body mass index, smoking status, alcohol use, hypertension, diabetes, aneurysm size, aneurysm location, modified Fisher grade, Hunt-Hess grade, World Federation of Neurological Surgeons grade, intraventricular hemorrhage, and rebleeding were taken from admission records and initial imaging. Laboratory variables, including hemoglobin, serum albumin, and serum sodium, were obtained from the earliest available blood test prior to the prediction time point. Cerebral edema was assessed using baseline or immediate post-treatment imaging available before DCI diagnosis. Variables recorded only after DCI onset were not used for model development to reduce information leakage.
Anemia was defined as hemoglobin <110 g/L in female patients and <120 g/L in male patients. Hypoalbuminemia was defined as serum albumin <35 g/L. Hyponatremia was defined as serum sodium <130 mmol/L.
Patients were managed according to the institutional aSAH care pathway. Standard management included early aneurysm securing, neurological observation, blood pressure control, fluid and electrolyte management, and surveillance for complications including hydrocephalus, rebleeding, seizure, infection, vasospasm, and DCI. Nimodipine was used unless contraindicated. Vasospasm monitoring was performed using neurological examination, vascular imaging, and transcranial Doppler ultrasonography when clinically indicated. Hydrocephalus was managed with cerebrospinal fluid diversion when required. Hemodynamic optimization and rescue therapy were applied according to the treating team’s assessment. Because treatment intensity and rescue-therapy details were not completely captured in the retrospective dataset, these factors could not be fully adjusted in the model and were considered a limitation.
Diagnosis of DCI
DCI was defined as a new focal neurological impairment, a decrease in level of consciousness, or a new cerebral infarction on follow-up computed tomography or magnetic resonance imaging occurring during the expected DCI risk window and not explained by another cause. The DCI risk window was defined as days 3–14 after the hemorrhage ictus. Alternative explanations, including rebleeding, hydrocephalus, seizure, infection, metabolic disturbance, sedative effect, and procedure-related infarction, were reviewed before classifying an event as DCI.
Outcome adjudication was performed by two clinicians with experience in the management of aSAH, including one neurosurgeon and one neurologist/neurocritical care physician. The adjudicators reviewed clinical notes, neurological examinations, imaging reports, and follow-up imaging. They were blinded to the final model output during outcome assessment. Disagreements were resolved through consensus discussion with review of the relevant imaging and clinical timeline. Formal inter-rater agreement was not measured, and this limitation was added because DCI classification may involve clinical judgment.
Sample Size Calculation
The sample size was estimated using the 10-events-per-variable (EPV) rule of thumb11. With 20 candidate predictor variables and an expected DCI incidence of approximately 35%, a minimum sample size of 20 × 10 / 0.35 ≈ 572 patients was required. Our final cohort of 680 patients exceeded this requirement. Although the events-per-variable (EPV) rule was applied as a general guideline, modern predictive modeling, particularly machine learning algorithms, may require more flexible sample-size considerations. The final cohort size was considered adequate to ensure model stability, minimize the risk of overfitting, and enable reliable estimation of model performance metrics.
Model development and validation
Patients were allocated to a training cohort of 544 patients and a hold-out internal validation cohort of 136 patients using an outcome-stratified 8:2 split. Outcome stratification was used to maintain a similar proportion of DCI events in the two cohorts. DCI occurred in 175 of 544 patients in the training cohort and 42 of 136 patients in the internal-validation cohort. The 8:2 hold-out design was retained because it was the prespecified model-development strategy and provided a separate cohort for preliminary internal performance assessment.
Predictor selection was performed only in the training cohort using least absolute shrinkage and selection operator regression with 10-fold cross-validation. The selected penalty parameter was λ = 0.031. Six predictors were retained: age, cerebral edema, hypoalbuminemia, modified Fisher grade, Hunt-Hess grade, and World Federation of Neurological Surgeons grade.
Logistic regression, extreme gradient boosting, light gradient boosting machine, support vector machine, and k-nearest neighbor models were developed using the same set of selected predictors. All preprocessing, predictor selection, and model-development procedures were restricted to the training cohort. The internal-validation cohort was not used during predictor selection or model tuning and was evaluated only after model development.
The numerical random seed used for the original cohort allocation was not retained in the archived analysis records and could not be retrospectively verified. Bootstrap optimism correction and repeated k-fold internal validation were also not available. Therefore, the present analysis is described as a single hold-out internal validation rather than an optimism-corrected or repeated cross-validated performance assessment.
Machine-learning reproducibility
LASSO predictor selection used 10-fold cross-validation within the training cohort. Continuous predictors were standardized when required by the modeling algorithm, and categorical predictors were represented using predefined binary clinical categories. The validation cohort was not used for tuning or model selection.
The archived analysis materials did not retain the final tuning grids, selected hyperparameters, complete package versions, original random seed, or a confirmed class-imbalance procedure for XGBoost, LightGBM, SVM, and KNN. These settings were therefore not reconstructed or estimated. The machine-learning comparisons should consequently be interpreted as exploratory comparisons of algorithms rather than fully reproducible model-development experiments. Reproducibility information, both available and unavailable, should be summarized in Supplementary Table 1.
Bias Control & Sensitivity Analysis
Consecutive eligible patients were included to reduce selection bias. Standardized variable definitions and a structured data-extraction form were used to reduce information bias. Predictors were restricted to information available before the intended DCI prediction time point to reduce information leakage. Predictor selection, preprocessing, and model development were performed only in the training cohort.
Modified Fisher grade, Hunt-Hess grade, and WFNS grade represent related aspects of hemorrhage burden and neurological severity. Although all three variables were retained after LASSO selection, the numerical variance inflation factor values and the results from a sensitivity model excluding overlapping severity scales were not included in the archived analysis output. These analyses could not be reconstructed from the aggregate tables because patient-level correlations and fitted model outputs are required. Therefore, the individual coefficients of these severity measures were not interpreted as independent or causal effects. They were retained only as components of the prediction model selected in the training cohort.
Model Interpretability
Clinical applicability was believed to require model interpretability as a crucial element. In the most effective model, the effects of predictors were considered to assess the clinical plausibility and conformity with existing pathophysiological knowledge of delayed cerebral ischemia. This method enabled a clear assessment of model behavior and improved the potential for clinical translation.
Missing Data
Variable-level missingness was assessed during data preparation. However, the original pre-imputation missing counts and percentages for each candidate variable were not retained in the archived analysis records and could not be accurately reconstructed from the aggregate tables. Consequently, no assumption of complete data was made, and no unverified missingness percentages were reported.
A verified supplementary missing-data table should be generated directly from the original deidentified patient-level dataset. Supplementary Table 2 should report, for every candidate variable, the number and percentage of missing observations before data handling, the method used to address missingness, and the number of observations included in the final analysis. The inability to recover the original variable-specific missingness pattern was considered a limitation of the present report.
Statistical Analysis
Predictor selection was performed in the training cohort using LASSO regression with 10-fold cross-validation. Discrimination was assessed using the area under the receiver operating characteristic curve with 95% confidence intervals. Calibration was described using calibration plots and point estimates of the calibration slope, calibration intercept, and Brier score. Bootstrap confidence intervals for calibration measures were not available.
Threshold-dependent classification measures were calculated from the available internal-validation confusion matrices. The exact numerical probability threshold used to generate the archived confusion matrices was not retained and could not be verified. Therefore, these measures were interpreted descriptively and were not used as the primary basis for model selection. Decision-curve analysis was also considered exploratory because the exact prespecified threshold range and patient-level net-benefit output were not retained. A two-sided P value below 0.05 was considered statistically significant.
Risultati
Confronto delle caratteristiche alla baseline tra il gruppo di addestramento e il gruppo di validazione interna
Sono stati inclusi complessivamente 680 pazienti con aSAH. Il gruppo di addestramento comprendeva 544 pazienti, dei quali 175 hanno sviluppato DCI, mentre il gruppo di validazione interna comprendeva 136 pazienti, dei quali 42 hanno sviluppato DCI. La frequenza di eventi DCI è stata del 32,2% nel gruppo di addestramento e del 30,9% nel gruppo di validazione interna. Le caratteristiche basali sono riportate nella Tabella 1. Poiché alcune voci archiviate nella tabella presentavano incongruenze nei denominatori, la tabella dovrebbe essere verificata rispetto al set di dati originale a livello individuale prima della presentazione finale.
| Variabile | Cohorte di addestramento (n = 544) | Cohorte di validazione interna (n = 136) | t/χ²/Z | Valore P | SMD | Nota di correzione |
| Età, anni | 62,88 ± 9,41 | 63,25 ± 9,52 | 0,409 | 0,693 | 0,039 | |
| Sesso | 0,429 | 0,512 | 0,063 | |||
| Maschio | 180 (33,09) | 41 (30,15) | ||||
| Femmina | 364 (66,91) | 95 (69,85) | ||||
| BMI, kg/m² | 23,46 ± 3,56 | 23,61 ± 3,65 | 0,437 | 0,662 | 0,042 | |
| Storia del fumo | 0,118 | 0,731 | 0,033 | |||
| Sì | 101 (18,57) | 27 (19,85) | ||||
| No | 443 (81,43) | 109 (80,15) | ||||
| Consumo di alcol | 0,417 | 0,518 | 0,062 | |||
| Sì | 118 (21,69) | 33 (24,26) | ||||
| No | 426 (78,31) | 103 (75,74) | ||||
| Anamnesi di ipertensione | 0,348 | 0,555 | 0,057 | |||
| Sì | 329 (60,48) | 86 (63,24) | ||||
| No | 215 (39,52) | 50 (36,76) | ||||
| Anamnesi di diabete | 0,116 | 0,733 | 0,033 | Il conteggio di 'No' nella validazione è stato corretto per sommare a 136. | ||
| Sì | 70 (12,87) | 19 (13,97) | ||||
| No | 474 (87,13) | 117 (86,03) | ||||
| Diametro dell'aneurisma, mm | 0,213 | 0,645 | 0,044 | |||
| >10 | 288 (52,94) | 75 (55,15) | ||||
| ≤10 | 256 (47,06) | 61 (44,85) | ||||
| Localizzazione dell'aneurisma | 0,980 | 0,322 | 0,095 | |||
| Circolazione anteriore | 448 (82,35) | 107 (78,68) | ||||
| Circolazione posteriore | 96 (17,65) | 29 (21,32) | ||||
| Edema cerebrale | 0,612 | 0,434 | 0,075 | |||
| Sì | 125 (22,98) | 27 (19,85) | ||||
| No | 419 (77,02) | 109 (80,15) | ||||
| Basso emoglobina | 0,684 | 0,408 | 0,079 | Il conteggio di 'No' nella validazione è stato corretto per sommare a 136. Il conteggio di addestramento è in contrasto con la Tabella 2; verificare dal dataset finale. | ||
| Sì | 147 (27,02) | 32 (23,53) | ||||
| No | 397 (72,98) | 104 (76,47) | ||||
| Ipoalbuminemia | 0,367 | 0,545 | 0,058 | |||
| Sì | 115 (21,14) | 32 (23,53) | ||||
| No | 429 (78,86) | 104 (76,47) | ||||
| Iponatriemia | 0,186 | 0,666 | 0,041 | |||
| Sì | 331 (60,85) | 80 (58,82) | ||||
| No | 213 (39,15) | 56 (41,18) | ||||
| Grado di Fisher modificato | 0,249 | 0,618 | 0,048 | |||
| ≥III | 259 (47,61) | 68 (50,00) | ||||
| I–II | 285 (52,39) | 68 (50,00) | ||||
| Grado Hunt-Hess | 0,178 | 0,673 | 0,040 | Il conteggio di ≥III nella validazione è stato corretto da 53 a 63 per sommare a 136; verificare rispetto al dataset finale. | ||
| ≥III | 263 (48,35) | 63 (46,32) | ||||
| I–II | 281 (51,65) | 73 (53,68) | ||||
| Grado WFNS | 0,249 | 0,618 | 0,048 | |||
| ≥III | 277 (50,92) | 66 (48,53) | ||||
| I–II | 267 (49,08) | 70 (51,47) | ||||
| Approccio chirurgico | 0,717 | 0,397 | 0,081 | |||
| Trattamento endovascolare | 449 (82,54) | 108 (79,41) | ||||
| Clipaggio | 95 (17,46) | 28 (20,59) | ||||
| Tempo chirurgico, h | 2,78 ± 0,81 | 2,81 ± 0,79 | 0,388 | 0,698 | 0,037 | |
| Emorragia intraventricolare | 0,383 | 0,536 | 0,059 | |||
| Sì | 134 (24,63) | 37 (27,21) | ||||
| No | 410 (75,37) | 99 (72,79) | ||||
| Re-rottura | 0,784 | 0,376 | 0,085 | |||
| Sì | 98 (18,01) | 29 (21,32) | ||||
| No | 446 (81,99) | 107 (78,68) |
Tabella 1: Caratteristiche basali dei cohorti di addestramento e di validazione interna. Le variabili continue sono presentate come media ± deviazione standard e le variabili categoriche come n (%). I valori P e le differenze medie standardizzate confrontano le due coorti. Abbreviazioni: BMI, indice di massa corporea; SMD, differenza media standardizzata. Fare clic qui per scaricare questa Tabella.
Confronto delle caratteristiche alla baseline tra il gruppo senza DCI e il gruppo con DCI nel set di addestramento
Nel set di dati di addestramento, l'ischemia cerebrale ritardata (DCI) si è verificata in 175 pazienti (32,17%), mentre 369 pazienti (67,83%) non hanno sviluppato la DCI. L'incidenza di DCI nel gruppo di validazione interna era comparabile, indicando una prevalenza stabile degli esiti. Le analisi comparative tra i gruppi senza DCI e con DCI hanno rivelato diverse differenze statisticamente significative (Tabella 2). I pazienti che hanno sviluppato la DCI erano significativamente più anziani (P = 0,026), suggerendo una suscettibilità legata all'età nei confronti del danno ischemico secondario. L'evidenza radiologica di danno cerebrale precoce, in particolare l'edema cerebrale, era notevolmente più frequente nei pazienti con DCI (P = 0,001). Anomalie di laboratorio, inclusa l'ipoalbuminemia (P = 0,007), l'iponatriemia (P = 0,048) e livelli bassi di emoglobina (P < 0,001), erano significativamente associate alla comparsa della DCI. I marcatori di gravità neurologica hanno mostrato le associazioni più forti. Un punteggio modificato di Fisher elevato (≥III) era significativamente più frequente nei pazienti con DCI (P < 0,001), indicando una relazione solida tra carico emorragico e complicanze ischemiche ritardate. Analogamente, un punteggio più alto secondo la scala di Hunt–Hess e un punteggio più elevato secondo la World Federation of Neurological Surgeons (WFNS) erano fortemente associati allo sviluppo della DCI (entrambi P < 0,001). Al contrario, le variabili demografiche, i fattori legati allo stile di vita, la morfologia dell'aneurisma, l'approccio chirurgico e la durata dell'intervento non hanno mostrato differenze statisticamente significative.
| Variabile | Gruppo senza ICD (n = 369) | Gruppo ICD (n = 175) | t/χ²/Z | Valore P | Nota di correzione |
| Età, anni | 62,25 ± 9,54 | 64,22 ± 9,75 | 2,234 | 0,026 | |
| Sesso | 0,638 | 0,424 | |||
| Maschio | 118 (31,98) | 62 (35,43) | |||
| Femmina | 251 (68,02) | 113 (64,57) | |||
| IMC, kg/m² | 23,43 ± 3,56 | 23,52 ± 3,72 | 0,271 | 0,786 | |
| Anamnesi tabagica | 0,351 | 0,554 | |||
| Sì | 66 (17,89) | 35 (20,00) | |||
| No | 303 (82,11) | 140 (80,00) | |||
| Consumo di alcol | 0,046 | 0,837 | |||
| Sì | 81 (21,95) | 37 (21,14) | |||
| No | 288 (78,05) | 138 (78,86) | |||
| Anamnesi di ipertensione | 2,960 | 0,085 | |||
| Sì | 214 (57,99) | 115 (65,71) | |||
| No | 155 (42,01) | 60 (34,29) | |||
| Anamnesi di diabete | 0,463 | 0,496 | |||
| Sì | 45 (12,20) | 25 (14,29) | |||
| No | 324 (87,80) | 150 (85,71) | |||
| Diametro dell'aneurisma, mm | 0,380 | 0,538 | |||
| >10 | 192 (52,03) | 96 (54,86) | |||
| ≤10 | 177 (47,97) | 79 (45,14) | |||
| Localizzazione dell'aneurisma | 3,602 | 0,058 | |||
| Circolazione anteriore | 296 (80,22) | 152 (86,86) | |||
| Circolazione posteriore | 73 (19,78) | 23 (13,14) | |||
| Edema cerebrale | 10,410 | 0,001 | |||
| Sì | 70 (18,97) | 55 (31,43) | |||
| No | 299 (81,03) | 120 (68,57) | |||
| Basso livello di emoglobina | 23,965 | <0,001 | Il totale differisce dalla Tabella 1; verificare rispetto al dataset finale. | ||
| Sì | 122 (33,06) | 82 (46,86) | |||
| No | 247 (66,94) | 93 (53,14) | |||
| Ipoalbuminemia | 7,283 | 0,007 | |||
| Sì | 66 (17,89) | 49 (28,00) | |||
| No | 303 (82,11) | 126 (72,00) | |||
| Iponatriemia | 3,914 | 0,048 | |||
| Sì | 214 (57,99) | 117 (66,86) | |||
| No | 155 (42,01) | 58 (33,14) | |||
| Grado modificato di Fisher | 58,679 | <0,001 | |||
| ≥III | 134 (36,31) | 125 (71,43) | |||
| I–II | 235 (63,69) | 50 (28,57) | |||
| Grado di Hunt-Hess | 39,909 | <0,001 | |||
| ≥III | 144 (39,02) | 119 (68,00) | |||
| I–II | 225 (60,98) | 56 (32,00) | |||
| Grado WFNS | 28,137 | <0,001 | |||
| ≥III | 159 (43,09) | 118 (67,43) | |||
| I–II | 210 (56,91) | 57 (32,57) | |||
| Approccio chirurgico | 0,691 | 0,406 | |||
| Trattamento endovascolare | 308 (83,47) | 141 (80,57) | |||
| Clipaggio | 61 (16,53) | 34 (19,43) | |||
| Durata intervento chirurgico, h | 2,74 ± 0,82 | 2,85 ± 0,76 | 1,496 | 0,135 | |
| Emorragia intraventricolare | 0,163 | 0,687 | |||
| Sì | 89 (24,12) | 45 (25,71) | |||
| No | 280 (75,88) | 130 (74,29) | |||
| Riemorragia | 1,168 | 0,280 | |||
| Sì | 71 (19,24) | 27 (15,43) | |||
| No | 298 (80,76) | 148 (84,57) |
Tabella 2: Caratteristiche basali dei pazienti con e senza ischemia cerebrale ritardata nel gruppo di addestramento. Le variabili continue sono presentate come media ± deviazione standard e le variabili categoriche come n (%). I valori di p confrontano i pazienti con e senza DCI. Abbreviazioni: DCI, ischemia cerebrale tardiva; WFNS, World Federation of Neurological Surgeons. Fare clic qui per scaricare questa Tabella.
Distribuzione degli esiti nella coorte di validazione interna
Nella coorte di validazione interna (n = 136), l'ischemia cerebrale tardiva (DCI) si è verificata in 42 pazienti (30,9%), mentre 94 pazienti (69,1%) non hanno sviluppato la DCI. La prevalenza degli esiti era comparabile a quella osservata nel dataset di addestramento, il che supporta la stabilità della distribuzione degli eventi tra i diversi dataset.
Selezione delle caratteristiche
La selezione dei predittori è stata effettuata nella coorte di addestramento utilizzando una regressione LASSO con validazione incrociata a 10 ripetizioni. Il parametro di penalizzazione selezionato è stato λ = 0,031. Sei predittori hanno mantenuto coefficienti diversi da zero: età, edema cerebrale, ipoalbuminemia, grado di Fisher modificato, grado di Hunt-Hess e grado WFNS. Tutti i predittori selezionati erano disponibili prima del punto temporale previsto per la predizione. Figura 1A,B mostra i tracciati dei coefficienti e la curva di validazione incrociata utilizzati per la selezione dei predittori.
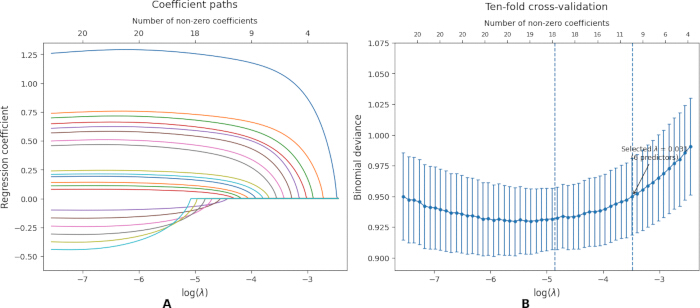
Figura 1: Selezione basata su LASSO dei predittori per l'ischemia cerebrale ritardata dopo emorragia subaracnoidea aneurismatica. (A) Traiettorie dei coefficienti dei predittori candidati in funzione dei valori di log(λ). Ogni curva rappresenta un predittore candidato, e i numeri sull'asse superiore indicano il numero di coefficienti non nulli mantenuti a ciascun valore di penalizzazione. (B) Curva di validazione incrociata a dieci ripetizioni per la devianza binomiale. I punti indicano la devianza media ottenuta con validazione incrociata, le barre di errore indicano gli errori standard e le linee verticali tratteggiate indicano i valori di penalizzazione con errore minimo e con un errore standard superiore. Il parametro di penalizzazione selezionato alla fine era λ = 0,031. LASSO, operatore di riduzione assoluta e selezione; DCI, ischemia cerebrale ritardata. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Sviluppo e valutazione del modello
Tutti e cinque i modelli sono stati sviluppati utilizzando gli stessi sei predittori selezionati. Nel coorte di validazione interna, la regressione logistica ha mostrato un AUC di 0,832 (IC 95%, 0,758–0,906), SVM ha mostrato un AUC di 0,811 (IC 95%, 0,729–0,893), XGBoost ha mostrato un AUC di 0,777 (IC 95%, 0,690–0,864), LightGBM ha mostrato un AUC di 0,755 (IC 95%, 0,672–0,838) e KNN ha mostrato un AUC di 0,708 (IC 95%, 0,613–0,803) (Tabella 3).
| Dataset | Modello | AUC | IC 95% | Accuratezza | Sensibilità | Specificità | Punteggio F1 | Nota di correzione |
| Training | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| Training | Regressione logistica | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| Training | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| Training | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| Training | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | L'AUC di KNN è stata corretta sulla base della legenda della Figura 2 per farla corrispondere al valore della tabella. |
| Validazione | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| Validazione | Regressione logistica | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | Le metriche di classificazione sono state ricalcolate sulla base della matrice di confusione della Tabella 6. |
| Validazione | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| Validazione | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | Le metriche di classificazione sono state ricalcolate sulla base della matrice di confusione della Tabella 6. |
| Validazione | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
Tabella 3: Prestazioni di discriminazione e classificazione dei modelli predittivi nelle coorti di addestramento e di validazione interna. I valori di AUC sono riportati con intervalli di confidenza al 95%. Accuratezza, sensibilità, specificità e punteggio F1 sono stati calcolati alla soglia di classificazione prestabilita. Abbreviazioni: AUC, area sotto la curva caratteristica operativa del ricevitore; CI, intervallo di confidenza; KNN, k-nearest neighbor (k-vicini più prossimi); LightGBM, light gradient boosting machine; SVM, support vector machine (macchina a vettori di supporto); XGBoost, extreme gradient boosting. Le misure di classificazione dipendenti dalla soglia non sono state utilizzate come base principale per il confronto dei modelli perché non è stato possibile verificare la soglia di probabilità esatta utilizzata nell'analisi archiviata. Fare clic qui per scaricare questa Tabella.
Gli intervalli di confidenza si sovrapponevano e la regressione logistica non è stata considerata statisticamente superiore agli altri modelli. La regressione logistica è stata mantenuta come modello principale perché ha fornito una discriminazione interna stabile e una struttura del modello direttamente interpretabile. I risultati rappresentano le prestazioni in un singolo gruppo interno di validazione escluso dall'addestramento e non costituiscono una validazione corretta per l'ottimismo, temporale o esterna (Figura 2A–D).
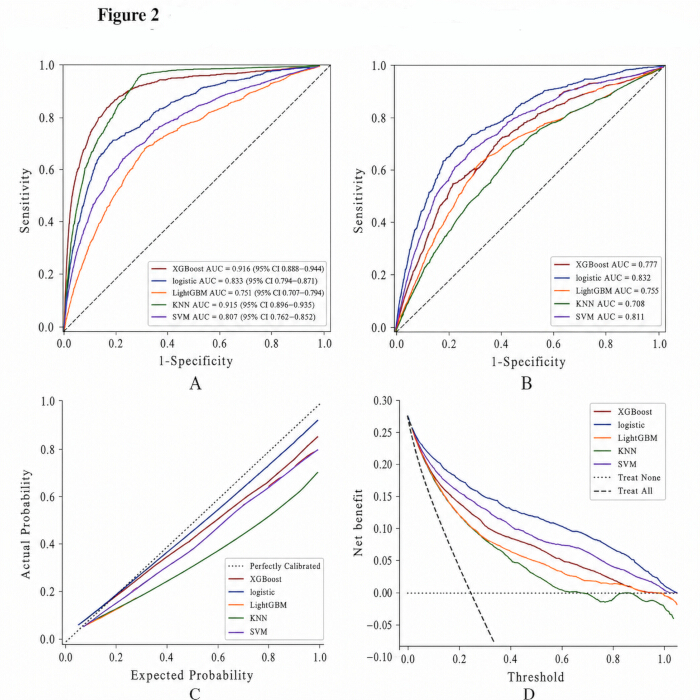
Figura 2: Prestazioni dei modelli predittivi in termini di discriminazione, calibrazione e analisi della curva decisionale.
(A) Curve caratteristiche operative del ricevitore (ROC) nella coorte di addestramento. (B) Curve caratteristiche operative del ricevitore (ROC) nella coorte di validazione interna. Le etichette delle curve indicano l'area sotto la curva ROC (AUC) con intervalli di confidenza al 95%. (C) Curve di calibrazione che confrontano le probabilità previste e osservate di ischemia cerebrale tardiva (DCI); la linea tratteggiata diagonale indica una calibrazione perfetta. (D) Analisi della curva decisionale che mostra il beneficio netto in funzione delle probabilità soglia. La linea tratteggiata orizzontale rappresenta la strategia di non trattamento, mentre la linea punteggiata rappresenta la strategia di trattamento universale. AUC, area sotto la curva caratteristica operativa del ricevitore; DCI, ischemia cerebrale tardiva; KNN, k-nearest neighbor; LightGBM, light gradient boosting machine; SVM, support vector machine; XGBoost, extreme gradient boosting. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Analisi esplorativa della curva decisionale
È stata eseguita un'analisi della curva decisionale come valutazione esplorativa del beneficio netto. Tuttavia, l'intervallo prespecificato di probabilità soglia e l'output del beneficio netto a livello del singolo paziente non sono stati conservati nei record archiviati dell'analisi. Di conseguenza, i risultati dell'analisi della curva decisionale non possono stabilire l'utilità clinica né definire una soglia di intervento clinicamente appropriata.
Qualsiasi vantaggio netto apparente rispetto alle strategie di trattamento universale o di nessun trattamento deve essere interpretato soltanto come un andamento preliminare all'interno del presente dataset interno. È richiesta una validazione esterna, una selezione prospettica delle soglie, una valutazione delle conseguenze cliniche e uno studio formale sull'impatto clinico prima che il modello possa essere considerato utile per le decisioni relative alla gestione dei pazienti (Figura 3).
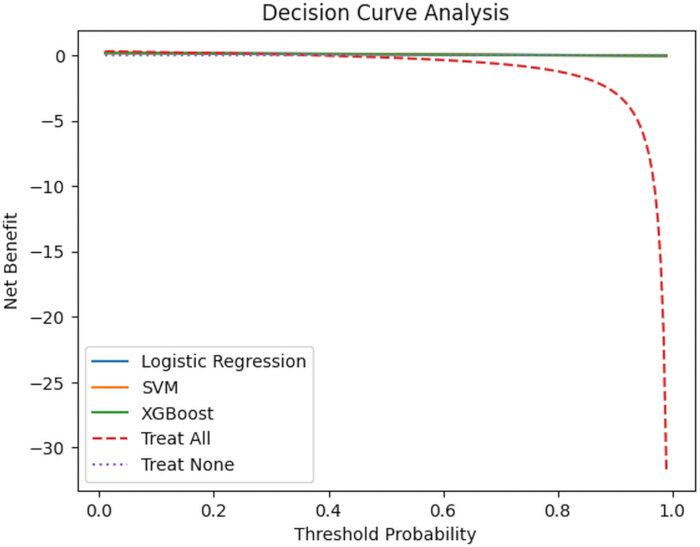
Figura 3: Analisi della curva decisionale dei modelli predittivi selezionati nella coorte di validazione interna. Il beneficio netto è riportato in funzione della probabilità soglia per i modelli di regressione logistica, SVM e XGBoost. La linea tratteggiata "tratta-tutti" rappresenta la strategia di monitorare tutti i pazienti, mentre la linea punteggiata "non-tratta-nessuno" rappresenta la strategia di non monitorare alcun paziente. Un modello è considerato clinicamente utile alle probabilità soglia in cui la sua curva di beneficio netto si trova al di sopra di entrambe le strategie di riferimento. SVM, macchina a vettori di supporto; XGBoost, boosting estremo del gradiente. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Modello di regressione logistica multivariabile
Il modello finale di regressione logistica includeva età, edema cerebrale, ipoalbuminemia, grado di Fisher modificato, grado di Hunt-Hess e grado WFNS. I coefficienti di regressione, le odds ratio, gli intervalli di confidenza al 95% e i valori P sono riportati nella Tabella 4. L'età presentava un coefficiente di 0,038, mentre i coefficienti per edema cerebrale, ipoalbuminemia, grado di Fisher modificato ≥ III, grado di Hunt-Hess ≥ III e grado WFNS ≥ III erano rispettivamente 0,842, 0,615, 1,274, 0,933 e 0,781.
| Predittore | Coefficiente β | Rapporto tra odds (OR) | IC 95% | Valore P | Nota interpretativa |
| Intercetta | [inserire dall'output del modello finale] | — | — | — | Necessaria per il calcolo del rischio a livello del paziente. |
| Età | 0.038 | 1.039 | 1.012–1.067 | 0.004 | Associazione predittiva soltanto; non causale. |
| Edema cerebrale | 0.842 | 2.321 | 1.541–3.496 | <0.001 | Misurato prima della diagnosi di DCI. |
| Ipoalbuminemia | 0.615 | 1.85 | 1.206–2.837 | 0.005 | Valore di albumina più precoce disponibile prima del punto temporale di previsione. |
| Grado di Modified Fisher ≥III | 1.274 | 3.575 | 2.401–5.324 | <0.001 | Indicatore di gravità; interpretare con cautela per collinearità. |
| Grado di Hunt-Hess ≥III | 0.933 | 2.542 | 1.674–3.861 | <0.001 | Indicatore di gravità; interpretare con cautela per collinearità. |
| Grado di WFNS ≥III | 0.781 | 2.184 | 1.447–3.298 | <0.001 | Indicatore di gravità; interpretare con cautela per collinearità. |
Tabella 4: Modello finale di regressione logistica multivariabile per la previsione dell'ischemia cerebrale ritardata. Sono riportati i coefficienti di regressione, le odds ratio, gli intervalli di confidenza al 95% e i valori P per i predittori mantenuti dopo la selezione LASSO. Tutti i predittori sono stati valutati prima del punto temporale previsto per la predizione. Abbreviazioni: CI, intervallo di confidenza; DCI, ischemia cerebrale ritardata; OR, odds ratio; WFNS, World Federation of Neurological Surgeons. L'intercetta numerica della regressione logistica non era disponibile nell'output archiviato del modello. Pertanto, i coefficienti riportati non possono essere utilizzati per calcolare probabilità predette individuali. I coefficienti rappresentano associazioni predittive e non devono essere interpretati come effetti causali indipendenti. Cliccare qui per scaricare questa tabella.
Questi coefficienti descrivono associazioni predittive all'interno del gruppo di sviluppo. Non devono essere interpretati come effetti causali indipendenti, poiché il modified Fisher grade, il Hunt-Hess grade e il WFNS grade rappresentano dimensioni sovrapposte della gravità della malattia e non erano disponibili diagnosi numeriche di collinearità. Le variabili sono state mantenute come componenti del modello predittivo piuttosto che confermate come fattori di rischio indipendenti.
Prestazioni della calibrazione
La calibrazione è stata riassunta nella coorte di validazione interna utilizzando stime puntuali della pendenza di calibrazione, dell'intercetta di calibrazione e del punteggio di Brier. La regressione logistica ha presentato una pendenza di calibrazione di 0,98, un'intercetta di calibrazione di 0,02 e un punteggio di Brier di 0,168. I valori corrispondenti erano 0,94, 0,05 e 0,182 per SVM; 0,88, 0,09 e 0,201 per XGBoost; 0,91, 0,07 e 0,194 per LightGBM; e 0,92, 0,06 e 0,190 per KNN (Tabella 5).
Gli intervalli di confidenza bootstrap per queste misure di calibrazione non erano disponibili perché le singole probabilità predette necessarie per il ricampionamento non erano state conservate nell'output dell'analisi archiviata. Pertanto, i risultati della calibrazione sono presentati come stime puntuali preliminari all'interno del coorte di validazione interna e non devono essere interpretati come evidenza di calibrazione in altre istituzioni o popolazioni di pazienti (Figura 4).
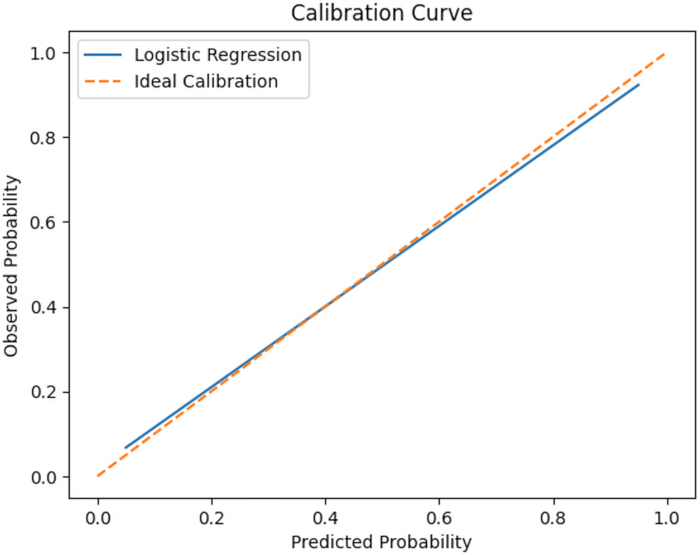
Figura 4: Calibrazione del modello di regressione logistica nella coorte di validazione interna. La linea continua mostra la relazione tra le probabilità previste e quelle osservate di ischemia cerebrale tardiva. La linea tratteggiata diagonale rappresenta una calibrazione perfetta; un accordo più stretto tra le due linee indica una migliore performance di calibrazione. DCI, ischemia cerebrale tardiva. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Modello | Pendenza della calibrazione | Intervallo di confidenza al 95% della pendenza di calibrazione | Intercetta della calibrazione | Intervallo di confidenza al 95% dell'intercetta di calibrazione | Punteggio Brier | Intervallo di confidenza al 95% del punteggio Brier | Nota di correzione |
| Regressione logistica | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | Aggiungere gli intervalli di confidenza bootstrap dall'analisi finale, se disponibili. |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
Tabella 5: Prestazioni di calibrazione dei modelli predittivi nella coorte di validazione interna. Una pendenza di calibrazione pari a 1,0 e un'intercetta di calibrazione pari a 0 indicano una calibrazione ideale. Valori più bassi del punteggio di Brier indicano una maggiore accuratezza complessiva della previsione. Abbreviazioni: KNN, k-nearest neighbor; LightGBM, light gradient boosting machine; SVM, support vector machine; XGBoost, extreme gradient boosting. La pendenza di calibrazione, l'intercetta di calibrazione e il punteggio di Brier sono riportati come stime puntuali. Gli intervalli di confidenza ottenuti con il metodo bootstrap non erano disponibili. Questi risultati descrivono esclusivamente una calibrazione preliminare all'interno della coorte di validazione interna trattenuta. Cliccare qui per scaricare questa tabella.
Metriche derivate dalla matrice di confusione.
La matrice di confusione per la validazione interna disponibile per la regressione logistica conteneva 30 veri positivi, 80 veri negativi, 14 falsi positivi e 12 falsi negativi. L'accuratezza ricalcolata era 0,809, la sensibilità era 0,714, la specificità era 0,851, il valore predittivo positivo era 0,682, il valore predittivo negativo era 0,870 e il punteggio F1 era 0,698.
Per la SVM, la matrice di confusione conteneva 29 veri positivi, 77 veri negativi, 17 falsi positivi e 13 falsi negativi. L'accuratezza ricalcolata era 0,779, la sensibilità era 0,690, la specificità era 0,819, il valore predittivo positivo era 0,630, il valore predittivo negativo era 0,856 e il punteggio F1 era 0,659 (Tabella 6).
| Metrica | Regressione logistica | SVM | Nota di calcolo |
| Vero positivo | 30 | 29 | Cohorte di validazione |
| Vero negativo | 80 | 77 | Cohorte di validazione |
| Falso positivo | 14 | 17 | Cohorte di validazione |
| Falso negativo | 12 | 13 | Cohorte di validazione |
| Accuratezza | 0.809 | 0.779 | (VP + VN) / totale |
| Sensibilità | 0.714 | 0.69 | VP / (VP + FN) |
| Specificità | 0.851 | 0.819 | VN / (VN + FP) |
| Valore predittivo positivo | 0.682 | 0.63 | VP / (VP + FP) |
| Valore predittivo negativo | 0.87 | 0.856 | VN / (VN + FN) |
| Punteggio F1 | 0.698 | 0.659 | 2VP / (2VP + FP + FN) |
Tabella 6: Misure di prestazione derivate dalla matrice di confusione per la regressione logistica e la macchina a vettori di supporto (SVM) nella coorte di validazione interna. Le metriche sono state calcolate a partire dalle matrici di confusione archiviate; tuttavia, la soglia esatta non è stata conservata. Indicare la soglia esatta nella nota a piè di tabella. Abbreviazioni: NPV, valore predittivo negativo; PPV, valore predittivo positivo; SVM, macchina a vettori di supporto. Le matrici di confusione sono state ottenute dalla coorte di validazione interna. L'accuratezza, la sensibilità, la specificità, il valore predittivo positivo, il valore predittivo negativo e il punteggio F1 della regressione logistica, ricalcolati, sono risultati rispettivamente 0,809, 0,714, 0,851, 0,682, 0,870 e 0,698. I corrispondenti valori per la SVM sono stati 0,779, 0,690, 0,819, 0,630, 0,856 e 0,659. La soglia esatta di classificazione utilizzata nell'analisi originale non è stata conservata e dovrebbe essere verificata prima dell'invio finale. Cliccare qui per scaricare questa tabella.
Questi valori sono stati ricalcolati direttamente dalle stesse matrici di confusione per garantire la coerenza numerica. Tuttavia, la soglia di probabilità esatta utilizzata nell'analisi di classificazione originale non è stata conservata. Pertanto, le misure dipendenti dalla soglia sono riportate in forma descrittiva e non dovrebbero essere utilizzate come base principale per il confronto dei modelli fino a quando la soglia non viene verificata a partire dal codice dell'analisi originale (Tabella 7).
| Sottogruppo | AUC (Regressione Logistica) |
| Età ≥65 anni | 0.821 |
| Età <65 anni | 0.836 |
| Modified Fisher ≥III | 0.844 |
| Modified Fisher I–II | 0.801 |
| Clipping | 0.825 |
| Trattamento endovascolare | 0.835 |
Tabella 7: Analisi esplorativa della discriminazione per sottogruppi del modello di regressione logistica. I valori di AUC sono riportati per età, grado di Fisher modificato e sottogruppo di trattamento. Queste analisi sono di tipo esplorativo e non devono essere interpretate come prova della generalizzabilità del modello. Aggiungere la dimensione campionaria del sottogruppo, il numero di eventi di ischemia cerebrale tardiva (DCI) e l'intervallo di confidenza al 95% per ciascun sottogruppo.
Abbreviazioni: AUC, area sotto la curva caratteristica operativa del ricevitore; DCI, ischemia cerebrale tardiva. Cliccare qui per scaricare questa tabella.
Valutazione Esplorativa dei Sottogruppi
L'output del sottogruppo archiviato conteneva stime puntuali dell'AUC in base all'età, al grado di Fisher modificato e all'approccio terapeutico. Tuttavia, non erano disponibili le dimensioni campionarie dei sottogruppi, i conteggi di eventi DCI nei sottogruppi, gli intervalli di confidenza al 95% e i test formali di interazione o eterogeneità. Pertanto, i risultati relativi ai sottogruppi sono stati considerati incompleti ed esplorativi. Non sono stati utilizzati per affermare che le prestazioni del modello fossero robuste, coerenti o generalizzabili tra i sottogruppi di pazienti.
Prestazioni nella stratificazione del rischio
L'output archiviato di stratificazione del rischio ha riportato percentuali osservate di ICD pari a 10,2%, 33,6% e 69,1% per le categorie proposte a basso, intermedio e alto rischio. Tuttavia, non erano disponibili i denominatori dei gruppi corrispondenti, i conteggi degli eventi di ICD, gli intervalli di confidenza e una giustificazione clinica o statistica predeterminata per le soglie di probabilità. Pertanto, l'analisi è stata considerata esplorativa e non è stata utilizzata per sostenere affermazioni riguardo a una separazione del rischio validata o alla applicabilità clinica (Tabella 8).
| Categoria di rischio | Intervallo di probabilità | Incidenza osservata di DCI |
| Basso rischio | <0.20 | 10,2% |
| Rischio intermedio | 0,20–0,50 | 33,6% |
| Alto rischio | >0,50 | 69,1% |
Tabella 8: Incidenza di ischemia cerebrale ritardata osservata nelle categorie di rischio derivate dal modello nella coorte di validazione interna. Le categorie di rischio sono state definite utilizzando le probabilità predette dal modello finale di regressione logistica. Cliccare qui per scaricare questa tabella.
Modello finale di regressione logistica
L'output di regressione archiviato conteneva i coefficienti per i sei predittori selezionati, ma non includeva l'intercetta numerica del modello. Poiché l'intercetta è necessaria per calcolare la probabilità predetta individuale, non è stato possibile riportare un'equazione completa di predizione a livello del paziente. L'equazione incompleta è stata quindi rimossa anziché completata utilizzando un valore ipotetico o ricostruito.
I coefficienti presentati nella Tabella 4 possono essere utilizzati per descrivere la direzione e l'entità relativa delle associazioni tra i predittori all'interno del modello adattato, ma non dovrebbero essere utilizzati per calcolare le probabilità di DCI a livello del singolo paziente. Un'equazione di previsione completa può essere fornita solo dopo aver recuperato l'intercetta dal modello adattato originale o averla rigenerata mediante la rivalutazione del set di dati autentico a livello del paziente.
Logit(DCI) = [intercetta] + 0,038 × età + 0,842 × edema cerebrale + 0,615 × ipoalbuminemia + 1,274 × grado di Fisher modificato ≥III + 0,933 × grado Hunt-Hess ≥III + 0,781 × grado della World Federation of Neurological Surgeons ≥III.
La probabilità prevista di DCI è stata calcolata come:
P(DCI) = 1 / [1 + esp(−Logit)].
I predittori binari sono stati codificati come 1 quando la condizione era presente e come 0 quando assente. Il punteggio modificato di Fisher ≥III, il punteggio di Hunt-Hess ≥III e il punteggio della World Federation of Neurological Surgeons ≥III sono stati codificati come 1 se il paziente raggiungeva la soglia, altrimenti come 0. L'intercetta non è riportata poiché necessaria per il calcolo della probabilità a livello individuale. Questa equazione dovrebbe essere utilizzata esclusivamente per l'interpretazione della ricerca fino al completamento della validazione esterna e della ricalibrazione.
Il grado di Fisher modificato, il grado di Hunt-Hess e il grado della World Federation of Neurological Surgeons riflettono tutti la gravità della malattia e possono in parte sovrapporsi nel significato clinico. Poiché non erano disponibili diagnosi di collinearità numerica e un modello di sensibilità completo esclusi i parametri di gravità sovrapposti, il manoscritto non interpreta queste variabili come predittori causali indipendenti. Vengono mantenute soltanto come componenti di un modello predittivo selezionato nel gruppo di addestramento. Questa limitazione riduce la certezza sul contributo indipendente di ciascuna scala di gravità e dovrebbe essere affrontata in futuri studi di convalida esterna.
DISPONIBILITÀ DEI DATI:
L'intero set di dati ospedalieri a livello di paziente non è disponibile pubblicamente perché contiene informazioni cliniche sensibili ed è soggetto a requisiti istituzionali in materia di etica e protezione dei dati. L'accesso a un set di dati analitici anonimizzato può essere concesso dal Comitato Etico Istituzionale dell'Ospedale di Primo Livello di Yulin previa presentazione di una proposta di ricerca giustificata dal punto di vista metodologico, della prova di approvazione etica e di un accordo appropriato sull'utilizzo dei dati. Il set di dati condiviso esclude nomi, numeri identificativi dell'ospedale, date esatte, informazioni di contatto e altri identificatori diretti o indiretti. Vengono forniti, nei limiti consentiti dalla politica istituzionale, un dizionario verificato delle variabili, gli script di analisi, Tabella Supplementare 1 che descrive lo sviluppo del modello e le informazioni sulla riproducibilità, e Tabella Supplementare 2 che riporta la mancanza specifica per ogni variabile. I set di dati dimostrativi o sintetici non rappresentano i dati originali dello studio clinico.
Tabella supplementare 1: Dettagli sulla riproducibilità e iperparametri finali per lo sviluppo del modello. Questa tabella riporta il seme casuale, le versioni del software e dei pacchetti, i passaggi di preelaborazione, la procedura di imputazione, l'approccio alla validazione incrociata, la griglia di ottimizzazione e gli iperparametri finali per XGBoost, LightGBM, SVM e KNN.Cliccare qui per scaricare il file.
Tabella supplementare 2: Riassunto dei dati mancanti e strategia di gestione per i predittori candidati. Per ciascun predittore candidato, vengono riportati il numero e la percentuale di osservazioni mancanti, il metodo di imputazione e l'indicazione se la variabile è stata mantenuta per l'analisi.Cliccare qui per scaricare il file.
Discussione
Questo studio ha sviluppato e validato internamente un modello predittivo per l'ischemia cerebrale tardiva (DCI) dopo emorragia subaracnoidea aneurismatica (aSAH), utilizzando variabili cliniche, di laboratorio e di imaging precoci. Sei variabili sono state mantenute dopo la selezione dei predittori: età, edema cerebrale, ipoalbuminemia, grado di Fisher modificato, grado di Hunt-Hess e grado della World Federation of Neurological Surgeons. Tra i modelli valutati, la regressione logistica ha mostrato una discriminazione interna stabile e una calibrazione accettabile. Poiché il gruppo di validazione è stato selezionato dalla stessa struttura e nello stesso periodo del gruppo di addestramento, i risultati devono essere interpretati come una validazione interna preliminare.
I predittori selezionati sono clinicamente plausibili nel contesto dell’emorragia subaracnoidea aneurismatica (aSAH). Un punteggio più alto secondo la scala modificata di Fisher riflette un carico emorragico maggiore, mentre i punteggi di Hunt-Hess e WFNS descrivono la gravità neurologica al momento della presentazione14,15. L’edema cerebrale potrebbe rappresentare un danno cerebrale precoce, mentre un’età avanzata potrebbe indicare una ridotta riserva fisiologica. L’ipalbuminemia potrebbe riflettere una malattia sistemica, l’infiammazione, lo stato nutrizionale o una maggiore vulnerabilità endoteliale19,20. Tuttavia, queste associazioni sono state identificate ai fini predittivi e non devono essere interpretate come causali. Inoltre, le scale modificata di Fisher, Hunt-Hess e WFNS misurano aspetti correlati della gravità della malattia. Poiché i valori di VIF e le analisi numeriche di sensibilità non erano disponibili, non è stato possibile determinare il contributo indipendente di ciascuna scala di valutazione.
Metodi di apprendimento automatico più complessi non hanno mostrato un vantaggio chiaro rispetto alla regressione logistica nel gruppo di validazione interna con metodo hold-out. La regressione logistica ha mostrato l'AUC di validazione più elevata, ma gli intervalli di confidenza si sovrapponevano a quelli degli altri modelli. Algoritmi complessi possono catturare schemi non lineari, ma potrebbero anche causare overfitting quando l'insieme di predittori è ridotto e i dati provengono da un singolo centro. La regressione logistica è stata pertanto mantenuta come modello principale grazie alla sua interpretabilità e alla discriminazione interna stabile. Tuttavia, la mancanza di informazioni complete sugli iperparametri e sulle versioni del software limita la riproducibilità dei confronti tra modelli di apprendimento automatico.
Il modello attuale non ha un ruolo clinico stabilito. Sebbene un rischio stimato più elevato potrebbe teoricamente giustificare un monitoraggio neurologico più ravvicinato o una valutazione specialistica precoce, al momento non è possibile calcolare le probabilità a livello del singolo paziente poiché l'intercetta del modello non è disponibile. Inoltre, l'intervallo della curva decisionale, le prestazioni nei sottogruppi e i risultati per categorie di rischio sono stati documentati in modo incompleto. Il modello non deve quindi essere utilizzato come strumento diagnostico autonomo, regola di monitoraggio o base per decisioni terapeutiche. Prima di poterne considerare l'implementazione, è necessaria una ricostruzione completa del modello, una validazione esterna, una ricalibrazione e una valutazione prospettica dell'impatto clinico.
Questo studio presenta diversi limiti. In primo luogo, lo studio era di tipo retrospettivo ed è stato condotto in un singolo centro, il che ne limita la generalizzabilità. In secondo luogo, le prestazioni del modello sono state valutate utilizzando una singola suddivisione di tipo hold-out 8:2 stratificata per esito. Non sono state disponibili la correzione dell'ottimismo mediante bootstrap, la validazione k-fold ripetuta, la validazione temporale e la validazione esterna. In terzo luogo, non sono stati conservati il seme casuale originale, gli iperparametri finali del modello di apprendimento automatico, le griglie di ottimizzazione, la procedura per il bilanciamento delle classi e le versioni complete dei pacchetti software, limitando così la riproducibilità computazionale. In quarto luogo, l'intercetta numerica della regressione logistica non era disponibile, impedendo il calcolo delle singole probabilità predette. In quinto luogo, il modified Fisher grade, il Hunt-Hess grade e il WFNS grade sono misure di gravità correlate, mentre non erano disponibili diagnosi di VIF e analisi di sensibilità numeriche, escludendo scale sovrapposte. In sesto luogo, non sono stati calcolati gli intervalli di confidenza per la pendenza di calibrazione, l'intercetta di calibrazione e il punteggio di Brier. In settimo luogo, non è stato possibile verificare la soglia esatta di classificazione e l'intervallo di soglia per l'analisi decisionale clinica (DCA). In ottavo luogo, le analisi per sottogruppi e di stratificazione del rischio non disponevano di denominatori completi, conteggi di eventi, intervalli di confidenza e test formali di interazione. In nono luogo, non è stato conservato il modello originale di mancata osservazione specifico per variabile. Infine, sono stati esclusi i decessi precoci in ospedale, il che potrebbe aver introdotto un bias di sopravvivenza. Questi limiti implicano che il modello debba essere considerato preliminare e non debba essere utilizzato per decisioni cliniche prima di un'analisi completa e di una validazione esterna indipendente.
Questo studio ha sviluppato e valutato modelli predittivi per l'ICD dopo aSAH utilizzando variabili cliniche, di laboratorio e di imaging precoci21. Sei predittori sono stati mantenuti dopo la selezione LASSO: età, edema cerebrale, ipoalbuminemia, grado di Fisher modificato, grado di Hunt-Hess e grado WFNS22,23,24,25,26,27,28,29. La regressione logistica ha raggiunto un AUC di 0,832 (IC 95%) nel gruppo di validazione interna tenuto in disparte e ha prodotto una struttura del modello interpretabile29,30. Tuttavia, l'analisi si è basata su un'unica suddivisione interna, e non erano disponibili una completa validazione basata su ricampionamento, una validazione esterna e informazioni sulla riproducibilità computazionale. I risultati dovrebbero pertanto essere interpretati come risultati preliminari dello sviluppo del modello piuttosto che come evidenza di uno strumento predittivo clinicamente validato.
Questo studio retrospettivo monocentrico ha sviluppato e valutato modelli predittivi per l'ICD dopo aSAH utilizzando sei variabili cliniche, di laboratorio e di imaging precoci. La regressione logistica ha mostrato una discriminazione preliminare in un'unica coorte di validazione interna tenuta in riserva, producendo una struttura del modello interpretabile31,32,33,34. Tuttavia, l'assenza di registrazioni complete sulla riproducibilità, di un'intercetta numerica, di una validazione basata su ricampionamento, di una valutazione completa dell'incertezza e di una validazione esterna impedisce il calcolo della probabilità a livello individuale e l'uso clinico. È necessaria una rivalutazione mediante il set di dati autentico a livello di singolo paziente, una completa rendicontazione delle impostazioni di sviluppo del modello e una validazione indipendente multicentrica.
Ringraziamenti
Gli autori riconoscono il supporto del personale della cartella clinica dell'Ospedale di Primo Livello di Yulin nel reperimento dei dati clinici anonimizzati. Questi membri del personale non hanno partecipato alla progettazione dello studio, alla valutazione degli esiti, alla modellizzazione statistica, all'interpretazione dei risultati, alla stesura del manoscritto o all'approvazione del manoscritto finale e, pertanto, non soddisfano i criteri per l'attribuzione dell'autorship.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Sistema elettronico delle cartelle cliniche | Yulin First Hospital | Non applicabile | Fonte dei dati clinici retrospettivi; la piattaforma commerciale esatta non è stata conservata nei record archiviati. |
| IBM SPSS Statistics | IBM Corporation | Versione 25.0 | Analisi statistica descrittiva e inferenziale. |
| Implementazione del K-nearest neighbor | Pacchetto/fonte non conservato | Non disponibile | Modello esplorativo di apprendimento automatico; il pacchetto e la versione esatti devono essere recuperati dall'ambiente originale del codice. |
| LightGBM | Microsoft / progetto open-source | Versione non disponibile | Modello esplorativo di gradient boosting; la versione esatta del pacchetto e gli iperparametri non sono stati conservati. |
| Software statistico R | R Foundation for Statistical Computing | Versione 4.3.2 | Modellazione statistica e valutazione delle prestazioni interne. |
| Implementazione della macchina a vettori di supporto | Pacchetto/fonte non conservato | Non disponibile | Modello esplorativo di apprendimento automatico; il pacchetto esatto, le impostazioni del kernel e la versione non sono stati conservati. |
| XGBoost | Progetto open-source | Versione non disponibile | Modello esplorativo di gradient boosting; la versione esatta del pacchetto e gli iperparametri non sono stati conservati. |
Riferimenti
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.