Questo studio presenta una pipeline bioinformatica riproducibile che integra trascrittomica, apprendimento automatico e analisi dell'infiltrazione immunitaria per identificare potenziali biomarcatori diagnostici e reti regolatorie nella malattia polmonare ostruttiva cronica (COPD).
Articolo di ricerca
UPP1 come biomarcatore diagnostico: approfondimenti dalle analisi di bioinformatica integrativa e di infiltrazione immunitaria nella BPCO
* These authors contributed equally
In questo articolo
Sommario
Abstract
La BPCO è un disturbo respiratorio progressivo caratterizzato da una limitazione persistente del flusso aereo e da infiammazione cronica, ma il ruolo della modificazione dell'RNA mediante N4-acetilcitidina (ac4C) nella sua patogenesi è rimasto finora ampiamente inesplorato. Questo studio si è proposto di effettuare una selezione sistematica di geni associati all'ac4C (ac4C-RGs) da un database pubblicato e di indagare le loro reti di regolazione nella BPCO, al fine di identificare potenziali biomarcatori per ulteriori studi meccanicistici, senza presupporre una relazione regolatoria diretta tra un gene specifico e la modificazione ac4C. I geni differenzialmente espressi (DEG) sono stati identificati a partire dai profili trascrittomici, ed è stata applicata un'analisi della rete di co-espressione genica pesata (WGCNA) per individuare i moduli principali di co-espressione. È stata condotta un'analisi incrociata tra DEG, moduli significativi e ac4C-RGs. I geni chiave sono stati selezionati mediante regressione LASSO, algoritmi XGBoost e random forest, seguita dalla costruzione di un modello diagnostico basato su regressione logistica. Le prestazioni del modello sono state valutate mediante analisi della curva ROC (caratteristica operativa del ricevitore), area sotto la curva (AUC) con intervalli di confidenza al 95%, valutazione della curva di calibrazione e analisi della curva decisionale (DCA). Sono stati identificati complessivamente 160 geni sovrapposti, e sei geni centrali (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2) sono stati selezionati in modo coerente da tutti e tre gli algoritmi di apprendimento automatico. Il modello diagnostico ha mostrato buone capacità discriminative, con valori di AUC pari a 0,766, 0,759 e 0,723 rispettivamente nei set di addestramento, di test interno e di validazione esterna. L'analisi delle reti regolatorie ha suggerito potenziali assi ceRNA e interazioni con fattori di trascrizione, mentre il profilo di infiltrazione immunitaria ha rivelato correlazioni significative tra i geni chiave e diversi sottoinsiemi di cellule immunitarie. L'analisi delle interazioni farmaco-gene e il docking molecolare hanno indicato che fluorouracile, capecitabina e 5-benzyloacilouridina potrebbero presentare affinità di legame predette favorevoli con UPP1. In conclusione, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2 sono stati identificati come potenziali biomarcatori associati all'ac4C nella BPCO, potenzialmente coinvolti nella regolazione immunitaria e metabolica, fornendo una base per future indagini funzionali ed esplorazioni terapeutiche.
Introduzione
La BPCO è un disturbo respiratorio cronico ed eterogeneo caratterizzato da una limitazione progressiva del flusso aereo risultante da anomalie nella struttura degli alveoli e delle vie aeree1,2. Uno squilibrio tra proteasi e antiproteasi, lo stress ossidativo, l'infiammazione cronica e la senescenza cellulare costituiscono i meccanismi fisiopatologici fondamentali della BPCO, portando alla distruzione strutturale e al deterioramento funzionale del tessuto polmonare3,4. Inoltre, la BPCO è influenzata da numerosi fattori di rischio, tra cui il fumo a lungo termine, l'inquinamento ambientale, l'esposizione occupazionale, le infezioni respiratorie e la predisposizione genetica5,6. La BPCO ha determinato un carico significativo sull'economia globale. Si prevede che rappresenti lo 0,111% del PIL mondiale ogni anno dal 2020 al 20507. Sebbene le attuali strategie terapeutiche, come broncodilatatori, corticosteroidi inalatori, riabilitazione polmonare e ossigenoterapia a lungo termine, possano alleviare i sintomi, arrestare la progressione della malattia rimane difficile. A causa dell'elevata eterogeneità clinica, gli esiti nei pazienti variano notevolmente8. Pertanto, sono urgentemente necessari nuovi biomarcatori diagnostici e indicatori prognostici per migliorare la gestione della BPCO e aumentare la sopravvivenza dei pazienti.
La modificazione dell'RNA si riferisce all'alterazione chimica delle molecole di RNA, che può modificare la struttura e la funzione dell'RNA per regolare l'espressione genica9,10. Le modificazioni comuni dell'RNA includono la N6-metiladenosina (m6A), la pseudouridina (Ψ), la 5-metilcitosina (m5C) e l'ac4C11. La modificazione ac4C svolge un ruolo cruciale nel mantenimento della stabilità dell'mRNA e nella promozione della traduzione dell'mRNA12,13. NAT10 è l'unica enzima eucariotica finora nota in grado di catalizzare la modificazione ac4C, e la sua attività è essenziale per la formazione di questa modificazione14. Studi hanno dimostrato una forte correlazione tra stress ossidativo, senescenza cellulare, infiammazione e modificazione ac4C. Ad esempio, i linfociti T CD4+ nei tessuti del colon di soggetti affetti da malattia infiammatoria intestinale (IBD) mostrano livelli notevolmente elevati di NAT1015. NAT10 potenzia l'acetilazione ac4C delle chemochine CCL2 e CXCL1, promuovendo così l'infiltrazione di macrofagi e neutrofili e aggravando i danni infiammatori16. La risposta cellulare allo stress ossidativo potrebbe coinvolgere la modificazione ac4C, come dimostrato dall'aumento marcato dei livelli di ac4C in condizioni di stress ossidativo. Inoltre, NAT10 promuove la fibrosi polmonare indotta da PM2.5 stabilizzando l'mRNA di TGFB1 mediante modificazione ac4C, innescando così la transizione epitelio-mesenchimale17. Tuttavia, il ruolo della modificazione ac4C nella BPCO rimane in gran parte inesplorato, evidenziando la necessità di ulteriori ricerche in questo campo.
Il database GEO è stato utilizzato in questo studio per identificare i geni differenzialmente espressi (DEG) tra pazienti con BPCO e controlli. Una lista pubblicata di geni regolatori dell'ac4C, compilata a partire da dati multi-omici18, è stata quindi integrata con i DEG per identificare candidati sovrapposti. Poiché si sa che la modificazione ac4C influenza l'infiammazione e lo stress ossidativo—processi chiave nella BPCO—abbiamo ipotizzato che i geni associati alla rete regolatoria dell'ac4C potessero essere disregolati nella BPCO. Tuttavia, i geni sovrapposti non sono stati considerati substrati diretti di NAT10 né geni direttamente regolati dall'ac4C; piuttosto, sono stati considerati candidati associati alla rete correlata all'ac4C. I geni chiave sono stati selezionati mediante l'utilizzo di diversi algoritmi di apprendimento automatico, seguiti dalla costruzione e validazione di un modello diagnostico. Successivamente, sono state determinate le vie biologiche pertinenti coinvolte nella patogenesi della BPCO e sono stati predetti potenziali farmaci mirati. Infine, sono stati eseguiti saggi di RT-qPCR per confermare i livelli di espressione dei geni chiave, fornendo informazioni preliminari sulla fisiopatologia della BPCO e potenziali percorsi per l'esplorazione terapeutica.
Protocollo
Dichiarazione del comitato etico
Lo studio è stato condotto in conformità con la Dichiarazione di Helsinki. Il protocollo è stato approvato dal Comitato Etico dell'Ospedale Shenzhen Luohu di Medicina Tradizionale Cinese (numero di approvazione 2024-LHQZYYYXLL-KY-039), e il consenso informato scritto è stato ottenuto da tutti i partecipanti prima dell'arruolamento. I dettagli degli strumenti e dei materiali di ricerca utilizzati in questo protocollo sono riportati nella Tabella dei Materiali.
Fonte dei dati ed elaborazione
I set di dati sull'espressione genica correlati alla BPCO sono stati ottenuti dal Gene Expression Omnibus (GEO). Il dataset GSE54837 è stato utilizzato come dataset del trascrittoma, mentre il dataset GSE112811 ha funto da set di validazione (Tabella 1). I geni ac4C-RG sono stati raccolti dalla letteratura18. I geni differenzialmente espressi (DEG) tra i gruppi BPCO e controllo sono stati identificati utilizzando il pacchetto R limma. I DEG sono stati considerati statisticamente significativi se |log2FC| > 0 e p < 0,05. Sono stati generati grafici a vulcano per visualizzare la distribuzione complessiva delle variazioni dell'espressione genica.
Costruzione di WGCNA
È stata eseguita un'analisi WGCNA sul set di dati GSE54837 utilizzando R per identificare moduli associati alla BPCO. Prima della costruzione della rete, i campioni outlier sono stati identificati ed eliminati mediante analisi di clustering gerarchico utilizzando la funzione hclust con metodo di collegamento medio e una metrica di distanza euclidea. È stata selezionata la potenza ottimale di soglia morbida (β = 10) per ottenere un indice di adattamento alla topologia libera da scala R2 ≥ 0,85, bilanciando topologia libera da scala e connettività media. È stata costruita una matrice di adiacenza e trasformata in una matrice di sovrapposizione topologica (TOM). I moduli genici sono stati identificati utilizzando l'algoritmo dinamico di taglio dell'albero (deepSplit = 2, minClusterSize = 50). I moduli con correlazioni di eigengene > 0,75 sono stati successivamente uniti utilizzando la funzione mergeCloseModules. Gli eigengene dei moduli sono stati quindi correlati con le caratteristiche cliniche (stato di BPCO, età, sesso e abitudine al fumo) mediante coefficienti di correlazione di Pearson per identificare i moduli associati alla BPCO da sottoporre ad analisi successive.
Selezione, analisi dell'arricchimento e analisi della rete PPI dei geni sovrapposti
È stato generato un diagramma di Venn utilizzando il pacchetto R ggvenn per identificare i geni sovrapposti tra i DEG, i geni del modulo MEsalmon e gli ac4C-RG. L'analisi di arricchimento funzionale dei geni sovrapposti è stata eseguita utilizzando le basi di dati Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) con il pacchetto R clusterProfiler. Le informazioni sulle interazioni proteina-proteina (PPI) sono state ottenute dal database STRING (https://string-db.org/) per analizzare le interazioni a livello proteico tra i geni sovrapposti. Il software Cytoscape è stato utilizzato per visualizzare la rete PPI risultante.
Identificazione di geni chiave mediante apprendimento automatico
Sono state applicate tre tecniche di machine learning: regressione con operatore di riduzione e selezione della norma L1 (LASSO), boosting estremo del gradiente (XGBoost) e foresta casuale (RF). La regressione LASSO è stata implementata utilizzando il pacchetto glmnet con validazione incrociata a 10 ripetizioni per determinare il parametro di penalizzazione ottimale λ. Il parametro type.measure è stato impostato su «deviance», e il parametro family su «binomial». Il valore ottimale di λ è stato selezionato mediante il criterio λmin, che minimizza la devianza ottenuta dalla validazione incrociata, producendo 17 geni. XGBoost è stato eseguito utilizzando il pacchetto xgboost con i seguenti iperparametri: nrounds = 100, max_depth = 6, eta = 0.3, subsample = 0.8, colsample_bytree = 0.8 e eval_metric = «logloss». L'importanza delle caratteristiche è stata ordinata in base alla metrica gain, selezionando i 30 geni più significativi. La foresta casuale è stata implementata utilizzando il pacchetto randomForest con ntree = 200. L'importanza delle caratteristiche è stata valutata in base alla riduzione media dell'indice di Gini, selezionando i 30 geni più importanti. I geni selezionati dai tre metodi di machine learning sono stati incrociati per identificare i geni chiave da utilizzare nelle analisi successive.
Costruzione e valutazione del modello di regressione logistica per la previsione del rischio
Il dataset GSE54837 è stato suddiviso casualmente in un insieme di addestramento (70%) e un insieme di test (30%). Un modello di regressione logistica è stato costruito sull'insieme di addestramento utilizzando la funzione glm del pacchetto MASS, con i livelli di espressione dei geni chiave come caratteristiche di input. Le prestazioni del modello sono state valutate mediante curve ROC generate con il pacchetto pROC. Gli intervalli di confidenza al 95% per l'AUC sono stati calcolati tramite 2.000 replicati bootstrap. La calibrazione del modello è stata valutata utilizzando curve di calibrazione generate con 1.000 ricampionamenti bootstrap (pacchetto rms). L'analisi decisionale clinica (DCA) è stata eseguita utilizzando il pacchetto dca per valutare il beneficio clinico netto in un intervallo di probabilità soglia. Un nomogramma è stato costruito utilizzando la funzione nomogram del pacchetto rms per facilitare la stima del rischio individualizzata.
L'equazione di regressione era:
logit(P) = 0,5823 + 0,6010 × UPP1 - 0,6563 × PTRF + 0,3853 × B4GALT2 - 0,3972 × FAM168B + 0,1848 × PRKCDBP - 0,4787 × TOR3A. (1)
In questo caso, P rappresenta la probabilità predetta di BPCO, e ciascun coefficiente rappresenta il contributo del corrispondente valore di espressione genica alle probabilità logaritmiche di BPCO.
Analisi dell'espressione, rete GeneMANIA e rete regolatoria molecolare
I livelli di espressione genica tra i gruppi COPD e di controllo nel dataset GSE54837 sono stati confrontati utilizzando il test della somma dei ranghi di Wilcoxon. I grafici a scatola (box plot) sono stati generati con il pacchetto ggplot2 per visualizzare la distribuzione dei livelli di espressione, con mediana, intervallo interquartile (IQR) e punti dati individuali sovrapposti. GeneMANIA è stato utilizzato per costruire reti geniche e prevedere interazioni funzionali. La ricerca è stata eseguita con parametri predefiniti: specie = Homo sapiens, geni correlati massimi = 20. La rete risultante è stata scaricata e visualizzata, con i colori dei collegamenti (edge) che indicano i tipi di interazione. È stata costruita una rete di RNA endogeno competitivo (ceRNA) per indagare i meccanismi regolatori post-trascrizionali. Le miRNA che bersagliano i sei geni chiave sono state previste utilizzando due database indipendenti: DIANA-microT (punteggio ≥ 0,8) e miRanda (punteggio ≥ 140, energia ≤ −20 kcal/mol). L'intersezione delle miRNA identificate da entrambi i database è stata utilizzata per costruire coppie miRNA-mRNA. Successivamente, le lncRNA che bersagliano queste miRNA sono state previste utilizzando il database StarBase. È stata costruita e visualizzata una rete regolatoria lncRNA-miRNA-mRNA mediante Cytoscape. Le relazioni regolatorie trascrizionali sono state previste utilizzando l'analisi di arricchimento ChIP-X Versione 3 (ChEA3). Per ciascun gene chiave con fattori trascrizionali (TF) previsti, sono stati selezionati i primi 10 fattori trascrizionali con i punteggi di arricchimento più elevati. Una rete regolatoria TF-target è stata costruita in Cytoscape.
Analisi dell'arricchimento di geni e valutazione dell'infiltrazione delle cellule immunitarie
È stata eseguita un'analisi di arricchimento dei set di geni (GSEA) utilizzando il pacchetto clusterProfiler per indagare le funzioni biologiche di ciascun gene chiave. Per ogni gene chiave, i campioni sono stati suddivisi in gruppi ad alta e bassa espressione in base al valore mediano. L'analisi dell'espressione differenziale tra i due gruppi è stata effettuata utilizzando limma, e l'elenco di geni risultante è stato ordinato in base al log₂ fold-change con segno. La GSEA è stata condotta utilizzando la funzione gseGO per i termini del processo biologico GO e la funzione gseKEGG per i percorsi KEGG, con i seguenti parametri: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05 e nPerm = 1.000. L'abbondanza relativa di 28 tipi di cellule immunitarie è stata stimata mediante analisi di arricchimento dei set di geni su singolo campione (ssGSEA) implementata nel pacchetto GSVA. Una matrice di firma di set di geni curata, comprendente geni marcatore per 28 tipi di cellule immunitarie, è stata ottenuta dalla letteratura precedente19. Per ciascun campione, è stata applicata la funzione gsva con method = "ssgsea", ssgsea.norm = TRUE e kcdf = "Gaussian". I coefficienti di correlazione di Spearman tra i punteggi di arricchimento ssGSEA e i livelli di espressione dei sei geni chiave sono stati calcolati utilizzando la funzione cor.test. I valori p sono stati corretti per i test multipli mediante il metodo di Benjamini-Hochberg. La matrice di correlazione è stata visualizzata come mappa termica (heatmap) utilizzando il pacchetto pheatmap.
Previsione di farmaci, docking molecolare e analisi dell'associazione con malattie
I composti terapeutici potenziali che bersagliano geni chiave sono stati identificati utilizzando il database DrugBank. È stata costruita in Cytoscape una rete di interazioni tra "farmaci che bersagliano geni chiave" per visualizzare le interazioni previste tra farmaci e geni. È stato eseguito il docking molecolare utilizzando la piattaforma CB-Dock2 per valutare le affinità di legame. La struttura proteica tridimensionale dell'UPP1 umano è stata ottenuta dal Protein Data Bank (PDB ID: 7B8T). Le strutture molecolari dei farmaci (formato SMILES) sono state recuperate da PubChem. Il docking è stato effettuato utilizzando il motore AutoDock Vina e i risultati sono stati ordinati in base all'energia libera di legame (ΔG, in kcal/mol). I complessi di docking sono stati visualizzati utilizzando PyMOL. Le associazioni tra geni chiave e malattie umane correlate a esposizioni ambientali sono state analizzate utilizzando il Comparative Toxicogenomics Database (CTD). Ogni gene è stato interrogato singolarmente ed è stato estratto il gruppo delle dieci malattie con associazione più forte, i cui dati sono stati rappresentati mediante grafici radar.
Protocollo di RT-qPCR
Sono stati raccolti campioni di sangue venoso periferico da otto pazienti affetti da BPCO e da otto controlli sani presso l'Ospedale Shenzhen Luohu di Medicina Tradizionale Cinese. La diagnosi di BPCO è stata stabilita in base ai criteri della Global Initiative for Chronic Obstructive Lung Disease (GOLD), definita come un rapporto VEMS/FVC post-broncodilatatore < 0,70. Il gruppo di controllo era composto da volontari sani abbinati per età e sesso, privi di anamnesi di malattie respiratorie e con test di funzionalità polmonare normali (VEMS% previsto ≥ 80% e VEMS/FVC ≥ 0,70). Le informazioni di base dei pazienti sono riportate nella Tabella 2. L'RNA totale è stato estratto dai campioni ematici dei pazienti con BPCO utilizzando un kit per l'estrazione di RNA da sangue. Per la sintesi di cDNA, 500 ng di RNA totale sono stati retrotrascritti utilizzando un kit per la sintesi di cDNA con rimozione del DNA genomico, seguendo il protocollo fornito. Il cDNA ottenuto è stato diluito a 150 ng/μL.
La RT-qPCR è stata eseguita utilizzando una miscela maestra per qPCR a base di SYBR Green su un sistema di PCR in tempo reale. Ogni reazione da 10 μL conteneva 5 μL di miscela maestra 2x SYBR Green, 0,5 μL ciascuno di primer diretto e inverso (10 μM), 1 μL di cDNA diluito (15 ng/μL) e 3 μL di acqua priva di nucleasi. Le condizioni di termociclaggio prevedevano una denaturazione iniziale a 95 °C per 5 min, seguita da 40 cicli di 95 °C per 10 s e 60 °C per 30 s, con un'analisi finale della curva di denaturazione da 60 °C a 95 °C per verificare la specificità dell'amplificazione. Tutte le reazioni sono state eseguite in triplicato tecnico. Il gene β-actina è stato utilizzato come gene di riferimento interno. L'efficienza dei primer per ciascun gene bersaglio è stata validata mediante serie di diluizioni per la curva standard ed è risultata compresa tra il 90% e il 110%. I livelli di espressione genica sono stati normalizzati rispetto a β-actina e l'espressione relativa è stata calcolata utilizzando il metodo 2-ΔΔCt. I confronti statistici tra i gruppi COPD e controllo sono stati effettuati utilizzando il test di Mann-Whitney U.
Analisi statistica
Le visualizzazioni della rete sono state create utilizzando Cytoscape e le analisi statistiche sono state eseguite con il software R. Se non indicato diversamente, il test U di Mann-Whitney è stato utilizzato per dati non distribuiti normalmente, mentre il test t di Student è stato utilizzato per dati distribuiti normalmente al fine di confrontare due gruppi. Un valore di p < 0,05 è stato considerato statisticamente significativo.
Risultati
Identificazione di geni sovrapposti, analisi dell'arricchimento e costruzione della rete di interazione proteina-proteina (PPI)
Dal dataset GSE54837 sono stati identificati 3.371 geni differenzialmente espressi (DEG), compresi 1.675 DEG upregolati e 1.696 DEG downregolati. I 10 geni con la maggiore significatività di upregolazione e downregolazione sono riportati in Figura 1A. È stata eseguita una clusterizzazione gerarchica dei dati GSE54837 (Figura supplementare 1A) ed è stata applicata una potenza di soft-thresholding pari a 10 per garantire una topologia di rete priva di scala (Figura 1B). I moduli di co-espressione genica sono stati costruiti utilizzando il metodo dynamic tree cut con una dimensione minima del modulo di 50 geni, e a ciascun modulo è stato assegnato un colore distinto (Figura supplementare 1B). Moduli con correlazioni di eigengene > 0,75 sono stati successivamente uniti (Figura supplementare 1C, Figura 1C), con un risultato di 14 moduli distinti. Sulla base dell'analisi della correlazione di Pearson tra gli eigengeni dei moduli e le caratteristiche cliniche, il modulo MEsalmon (composto da 5.226 geni) ha mostrato la correlazione positiva più significativa con la BPCO (r = 0,35, p = 7 x 10⁻8, Figura 1D). L'analisi di Venn ha identificato 160 geni sovrapposti tra i 3.371 DEG, i 5.226 geni del modulo MEsalmon e i 2.118 ac4C-RGFigura 1E). L'analisi di arricchimento funzionale di questi 160 geni ha mostrato che i termini GO significativi includevano legame all'RNA a filamento singolo, regolazione del processo metabolico dell'mRNA e via di segnalazione RIG-I (Figura 1F). Inoltre, l'analisi KEGG ha dimostrato che questi geni erano principalmente arricchiti nella fagocitosi mediata da Fc gamma R, nel percorso di controllo dell'mRNA e nell'adesione focale (Figura 1G). La rete di interazione proteina-proteina (PPI) dei geni sovrapposti comprendeva 118 nodi e 196 interazioni (Figura 1H).
Identificazione di sei geni chiave nella BPCO
Per identificare ulteriormente i potenziali geni chiave tra i 160 candidati sovrapposti, sono stati applicati tre algoritmi di apprendimento automatico. È stata innanzitutto applicata la regressione LASSO, utilizzando la validazione incrociata per determinare il parametro di penalizzazione ottimale (λ) ≈ 0,091 (Figura 2A). Il grafico del profilo dei coefficienti ha indicato che 17 geni sono stati mantenuti al valore ottimale di λ (Figura 2B). L'analisi XGBoost ha identificato i primi 30 geni con il guadagno più elevato, tra cui PTRF, WBP11 e LDOC1L hanno mostrato un alto valore predittivo (Figura 2C). Analogamente, l'algoritmo RF ha classificato i primi 30 geni in base ai loro punteggi di importanza Gini, con PTRF, RFX5 e PRKCDBP tra quelli con maggiore capacità predittiva (Figura 2D). L'analisi di intersezione dei geni selezionati dai tre metodi ha identificato sei geni chiave sovrapposti: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2 (Figura 2E).
Costruzione del modello diagnostico e analisi dell'espressione dei geni chiave
Utilizzando il 70% del dataset GSE54837 come insieme di addestramento, è stato sviluppato un modello di regressione logistica che include sei geni chiave. L'analisi della curva ROC ha indicato una capacità diagnostica moderata, con AUC di 0,766 (IC 95%: 0,691–0,8417), 0,759 (IC 95%: 0,6368–0,8817) e 0,723 (IC 95%: 0,6085–0,8596) rispettivamente per l'insieme di addestramento, il test interno e l'insieme di validazione esterna (Figura 3A–C). L'analisi di calibrazione ha confermato un'elevata affidabilità, mentre l'analisi DCA ha mostrato un chiaro beneficio clinico netto in un ampio intervallo di probabilità soglia sia negli insiemi di addestramento (Figura 3D–E) che di validazione (Figura 3F–G). È stato costruito un nomogramma per visualizzare il contributo di ciascun gene e facilitare la stima personalizzata del rischio (Figura 3H). L'analisi dell'espressione ha rivelato che B4GALT2, PRKCDBP e UPP1 erano significativamente sovraespressi nei campioni di BPCO, mentre FAM168B, PTRF e TOR3A erano sottoespressi (Figura 3I).
Rete regolatoria e analisi funzionale dei geni chiave nel BPCO
È stata costruita una rete di interazione funzionale comprendente i primi 20 geni più correlati ai geni hub identificati, utilizzando l'analisi GeneMANIA (Figura 4A). Le interazioni fisiche hanno costituito la maggioranza delle connessioni, seguite dalle correlazioni di co-espressione e dai domini proteici condivisi. L'annotazione funzionale ha indicato un arricchimento significativo in processi come il processo catabolico di piccole molecole contenenti nucleobasi, il processo catabolico dei nucleosidi e il raft della membrana plasmatica. La regolazione post-trascrizionale è stata indagata incrociando le previsioni di miRNA provenienti dai database DIANA-microT e miRanda, identificando otto miRNA sovrapposti (Figura 4B). Successivamente è stata costruita un'asse regolatoria lncRNA-miRNA-mRNA. Secondo il diagramma di Sankey, due dei miRNA identificati, entrambi associati alla regolazione di FAM168B, sono stati previsti come bersagli di sette lncRNA; non sono state identificate interazioni regolatorie di questo tipo per i restanti cinque geni hub (Figura 4C). La regolazione trascrizionale è stata ulteriormente esplorata utilizzando la piattaforma ChEA3, che ha previsto fattori di trascrizione (TFs) upstream per B4GALT2, UPP1, FAM168B e TOR3A. Sono stati selezionati i primi dieci TFs per ciascun gene al fine di costruire una rete regolatoria TF-target (Figura 4D). È stata eseguita un'analisi GSEA per indagare le funzioni biologiche dei sei geni chiave. UPP1 è risultato significativamente arricchito in processi biologici come il processo metabolico del diacilglicerolo e il processo biosintetico del trifosfato di nucleoside purinico, nonché in percorsi quali il proteasoma e il metabolismo di xenobiotici mediato dal citocromo P450 (Figura 4E–F). I risultati di arricchimento per i restanti cinque geni chiave sono riportati nella Figura supplementare 2A–J.
Infiltrazione immunitaria di UPP1 e previsione di bersagli farmacologici nella BPCO
I livelli di infiltrazione immunitaria di 28 tipi di cellule immunitarie sono stati valutati nei gruppi di controllo e nei pazienti con BPCO utilizzando l'algoritmo ssGSEA. Nei pazienti con BPCO, le cellule B della memoria, le cellule soppressorie di origine mieloide e le cellule dendritiche attivate hanno mostrato punteggi di arricchimento significativamente più elevati. Al contrario, le cellule T helper di tipo 1, le cellule B attivate e le cellule B immature hanno mostrato punteggi di arricchimento significativamente più bassi (Figura 5A). Va precisato che l'analisi ssGSEA fornisce stime relative dell'arricchimento delle cellule immunitarie basate su dati trascrittomici, piuttosto che misurazioni dirette delle proporzioni cellulari. L'analisi delle correlazioni ha rivelato che i sei geni chiave presentavano schemi di associazione differenziali con i sottoinsiemi di cellule immunitarie. In particolare, UPP1, PRKCDBP e B4GALT2 erano positivamente correlati con i livelli di infiltrazione delle cellule B della memoria, delle cellule dendritiche attivate e delle cellule soppressorie di origine mieloide (Spearman ρ > 0,4, p < 0,05), mentre PTRF, TOR3A e FAM168B mostravano correlazioni negative con le cellule T helper di tipo 1 e le cellule B attivate (Spearman ρ < −0,3, p < 0,05). La matrice completa delle correlazioni è presentata nella mappa termica (Figura 5B). L'analisi predittiva di farmaci ha identificato UPP1 come l'unico gene tra i sei candidati con interazioni previste con molecole di piccole dimensioni. Tre composti, tra cui fluorouracile, capecitabina e 5-benzilaciclouridina, sono stati identificati nel database come potenziali composti interagenti con UPP1 (Figura 5C). Questi composti sono utilizzati principalmente in ambito oncologico o in contesti sperimentali, e la loro rilevanza nella BPCO richiede ulteriori indagini. I calcoli dell'energia libera di legame hanno rivelato che la 5-benzilaciclouridina mostrava l'affinità di legame più elevata, suggerendo un'affinità di legame prevista relativamente più alta (Tabella 3). Le visualizzazioni del docking molecolare per tutti e tre i composti indicavano conformazioni di legame previste favorevoli con UPP1, coerenti con previsioni di docking computazionale piuttosto che con validazione sperimentale (Figura 5D–F). Inoltre, l'analisi CTD ha indicato che tutti e sei i geni chiave erano fortemente associati a diversi fenotipi di malattia, tra cui effetti ritardati dell'esposizione prenatale, perdita di peso, epatomegalia e infiammazione (Figura 5G–L).
Validazione mediante RT-qPCR di geni diagnostici chiave in campioni clinici
Per convalidare i livelli di espressione dei geni chiave, sono stati raccolti campioni di sangue da otto pazienti con BPCO e da otto soggetti di controllo, e questa analisi è stata considerata una convalida preliminare a causa della dimensione limitata del campione. Come mostrato in Figura 6A–F, PTRF, TOR3A e FAM168B erano significativamente downregolati, mentre PRKCDBP e UPP1 erano significativamente upregolati nei campioni di BPCO, coerentemente con le tendenze osservate nell'analisi bioinformatica. Al contrario, non è stata osservata alcuna differenza significativa per l'espressione di B4GALT2 tra i due gruppi. Questa discrepanza potrebbe essere attribuita alla dimensione limitata del campione o alle differenze nei tipi di campione tra i dataset e i campioni clinici.
DICHIARAZIONE SULLA DISPONIBILITÀ DEI DATI:
Tutti i dati di RNA-sequencing sono stati ottenuti dal database Gene Expression Omn游戏副本 (GEO, https://www.ncbi.nlm.nih.gov), con GSE54837 selezionato come set di addestramento e GSE112811 come set di validazione. Il codice utilizzato in questa analisi può essere ottenuto da https://doi.org/10.5281/zenodo.21771476.
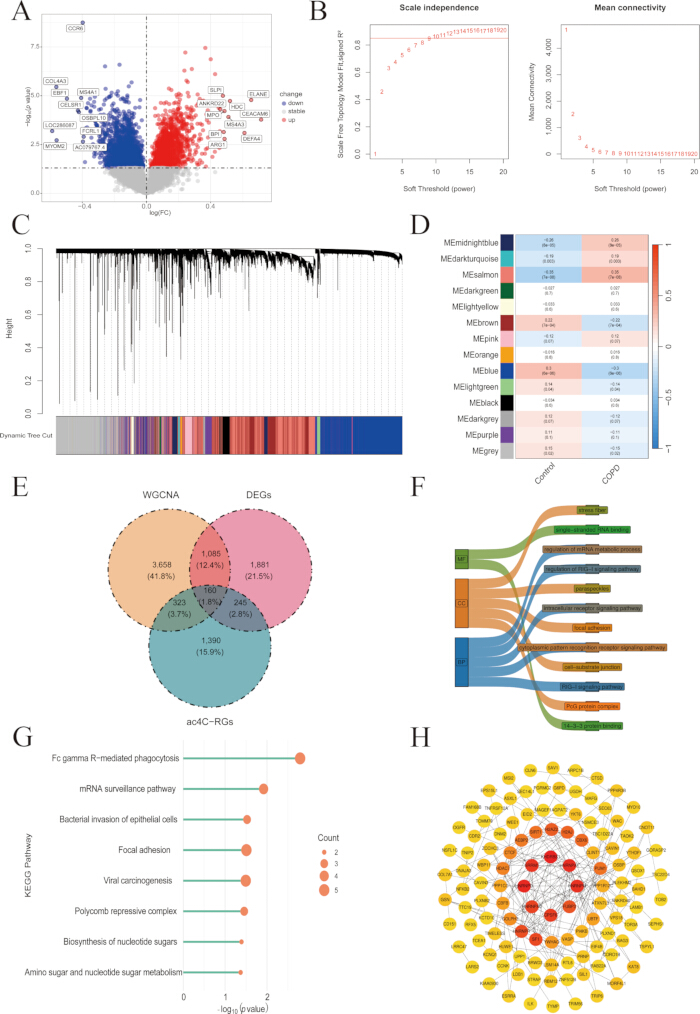
Figura 1: Identificazione dei geni sovrapposti, analisi di arricchimento e costruzione della rete PPI. (A) Grafico a vulcano dei geni differenzialmente espressi (DEG) nel dataset GSE54837. (B) Selezione della soglia morbida. (C) Dendrogramma del raggruppamento in moduli (dopo la fusione). (D) Mappa termica della correlazione tra moduli e caratteristiche. (E) Diagramma di Venn per l'identificazione dei geni sovrapposti. (F) Diagramma a mulino dell'analisi di arricchimento GO, che mostra i principali risultati di arricchimento dei geni intersezione in MF, CC e BP. (G) Diagramma a bastoncino dell'analisi di arricchimento del percorso di segnalazione KEGG, in cui la dimensione delle bolle rappresenta il numero di geni arricchiti. (H) Rete PPI dei geni sovrapposti; i nodi rappresentano proteine e i collegamenti rappresentano interazioni proteina-proteina. Abbreviazioni: DEGs = geni differenzialmente espressi; PPI = interazione proteina-proteina; GO = Gene Ontology; MF = funzione molecolare; CC = componente cellulare; BP = processo biologico; KEGG = Kyoto Encyclopedia of Genes and Genomes; ac4C-RGs = geni correlati all'N4-acetilcitosina. Cliccare qui per visualizzare una versione ingrandita di questa figura.
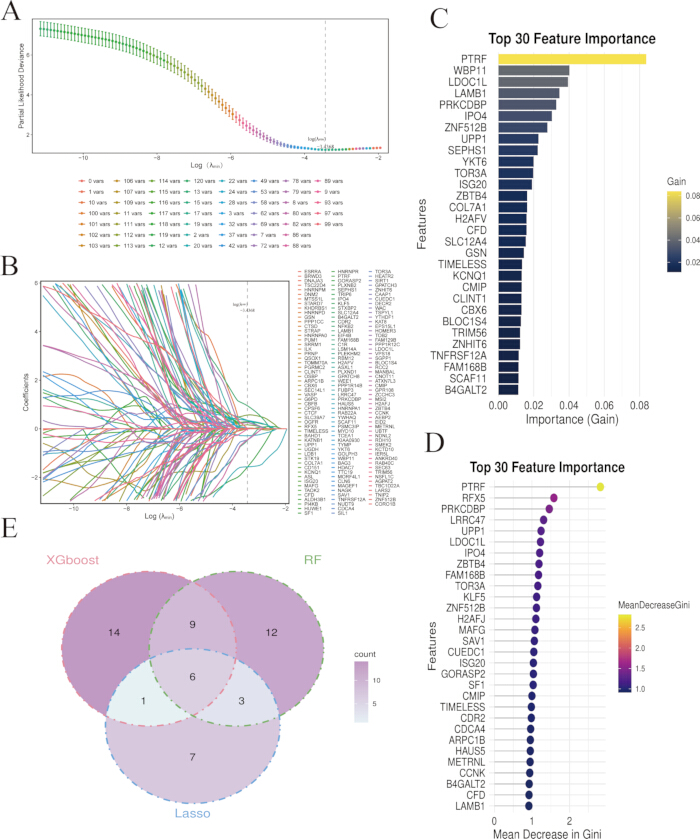
Figura 2: Identificazione di sei geni chiave nella BPCO. (A) Curva di validazione incrociata LASSO. (B) Diagramma del percorso dei coefficienti della regressione LASSO. All'aumentare di λ, i coefficienti dei geni non importanti convergono a 0. (C) Classificazione dell'importanza delle caratteristiche di XGBoost. L'asse x rappresenta il valore di guadagno, l'asse y rappresenta il nome del gene e l'intensità del colore rappresenta l'importanza. (D) Classificazione dell'importanza delle caratteristiche di RF. L'asse x rappresenta la riduzione media della Gini. (E) Diagramma di Venn dei geni sovrapposti ottenuti mediante analisi incrociata dei tre algoritmi. Abbreviazioni: LASSO = operatore di riduzione e selezione con norma L1; XGBoost = potenziamento del gradiente estremo; RF = foresta casuale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
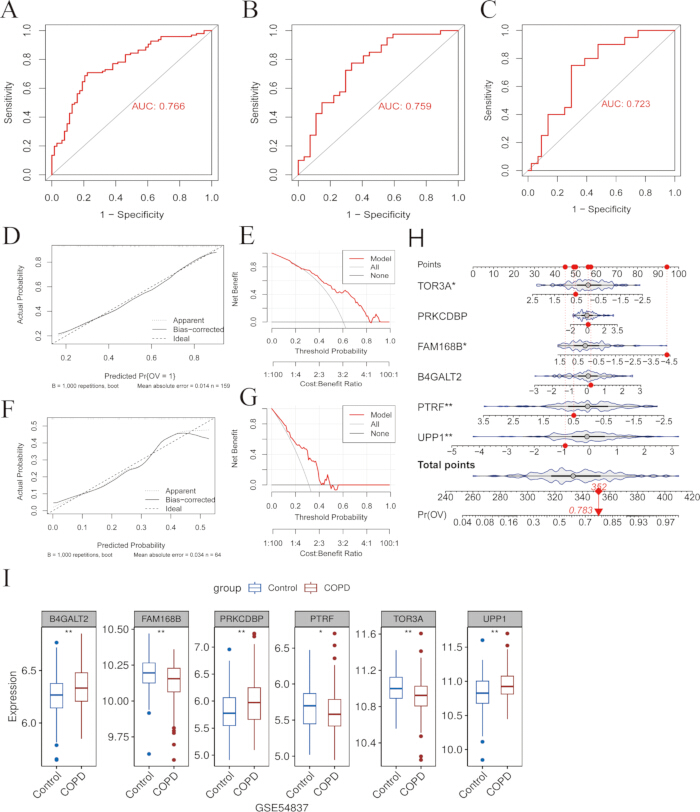
Figura 3: Costruzione di un modello diagnostico e analisi dell'espressione dei geni chiave. (A) Curva ROC del set di addestramento. (B) Curva ROC del set di test interno. (C) Curva ROC del set di validazione esterna. (D) Curva di calibrazione del set di addestramento. (E) Analisi della curva decisionale (DCA) del set di addestramento. (F) Curva di calibrazione del set di validazione esterna. (G) Analisi della curva decisionale (DCA) del set di validazione esterna. (H) Nomogramma dei sei geni chiave. Per la previsione del rischio individuale di BPCO, a ciascun gene viene assegnato un punteggio corrispondente. (I) Analisi dell'espressione dei sei geni chiave in campioni di BPCO e controlli del dataset GSE54837. Abbreviazioni: ROC = caratteristica operativa del ricevitore; AUC = area sotto la curva; DCA = analisi della curva decisionale; BPCO = malattia polmonare ostruttiva cronica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
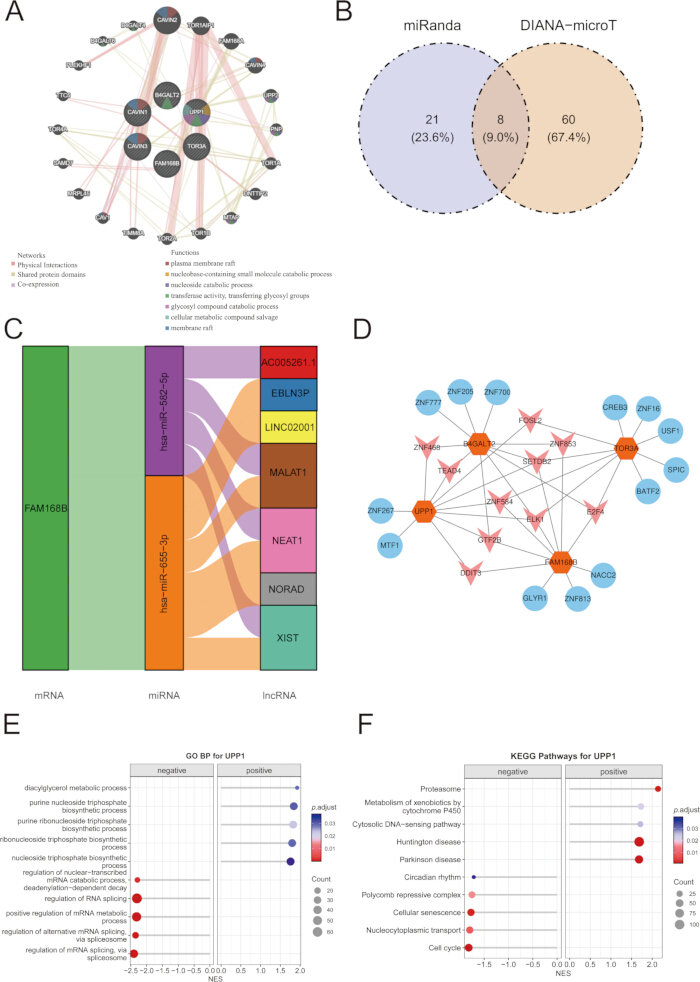
Figura 4: Rete regolatoria e significato funzionale dei geni chiave nel BPCO. (A) Risultati dell'analisi GeneMANIA per 6 geni chiave. Il colore delle linee indica la correlazione tra i geni, mentre il colore dei nodi indica diverse categorie funzionali. (B) Diagramma di Venn dell'analisi incrociata tra i database DIANA-microT e miRanda. (C) Diagramma a gelso della rete regolatoria ceRNA. (D) Rete regolatoria potenziale dei fattori trascrizionali. I nodi blu rappresentano i fattori trascrizionali, mentre i nodi arancioni rappresentano i geni bersaglio. (E) Analisi di arricchimento GSEA per singolo gene di UPP1, inclusa GO. (F) Analisi di arricchimento GSEA per singolo gene di UPP1, inclusa KEGG. Abbreviazioni: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Cliccare qui per visualizzare una versione ingrandita di questa figura.
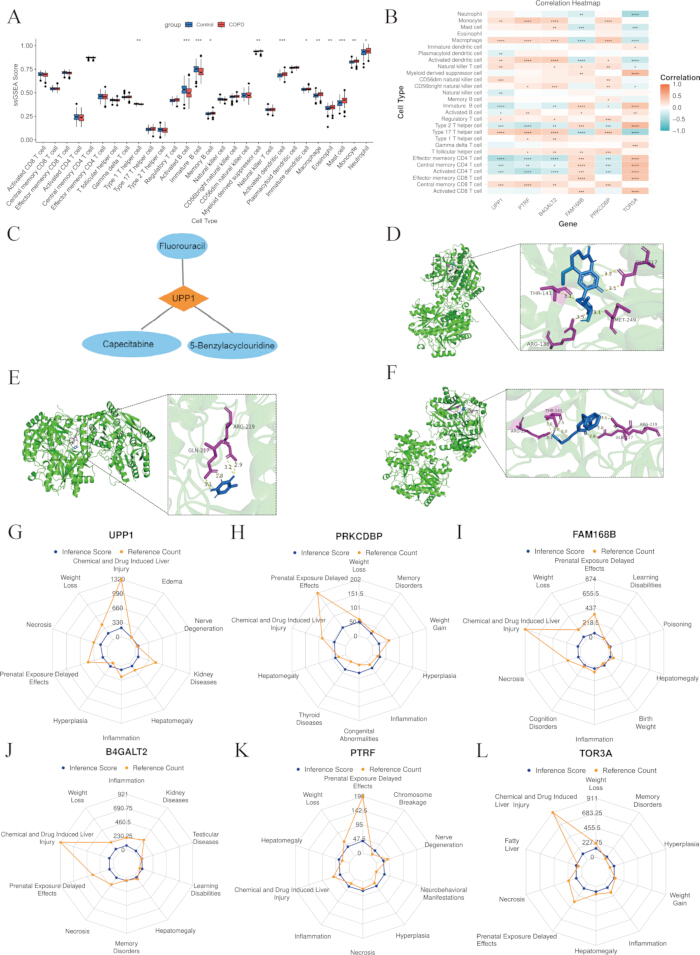
Figura 5: Infiltrazione immunitaria dei geni chiave e previsione di bersagli farmacologici nella BPCO. (A) Differenze nell'abbondanza delle cellule immunitarie tra i gruppi. (B) Mappa termica della correlazione tra cellule immunitarie e geni chiave. (C) Rete di interazione tra geni chiave e farmaci predetti. (D) Docking molecolare del fluorouracile con UPP1. (E) Docking molecolare della capecitabina con UPP1. (F) Docking molecolare del 5-benzilacilouridina con UPP1. Per ciascun composto, l'immagine a sinistra mostra la conformazione complessiva del docking, mentre l'immagine a destra mostra le interazioni locali di legame. (G) Analisi CTD di B4GALT2. (H) Analisi CTD di FAM168B. (I) Analisi CTD di PRKCDBP. (J) Analisi CTD di PTRF. (K) Analisi CTD di TOR3A. (L) Analisi CTD di UPP1. Cliccare qui per visualizzare una versione ingrandita di questa figura.
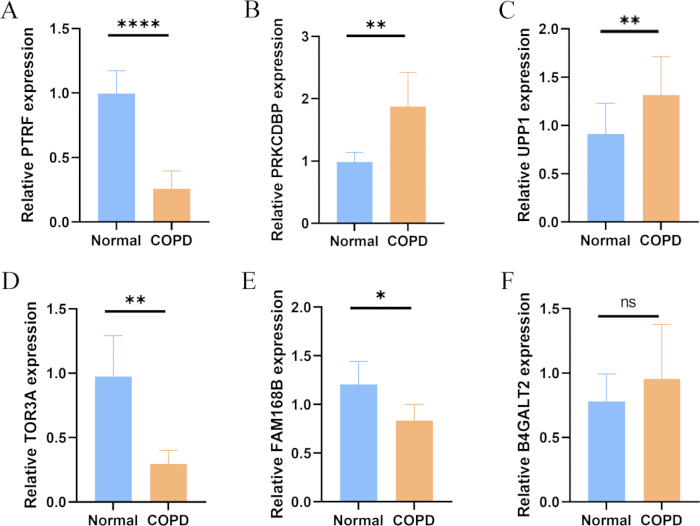
Figura 6: Validazione mediante RT-qPCR dell'espressione genica chiave in campioni con BPCO e controlli. (A) Espressione relativa di PTRF. (B) Espressione relativa di PRKCDBP. (C) Espressione relativa di UPP1. (D) Espressione relativa di TOR3A. (E) Espressione relativa di FAM168B. (F) Espressione relativa di B4GALT2. ns = non significativo, p > 0,05; * p < 0,05; ** p < 0,01; *** p < 0,001; **** p < 0,0001. Abbreviazione: RT-qPCR = reazione a catena della polimerasi quantitativa con trascrizione inversa. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura supplementare 1: Campioni del set di dati GSE54837 e raggruppamento in moduli genici. (A) Diagramma di raggruppamento dei campioni del set di dati GSE54837. (B) Dendrogramma di raggruppamento dei moduli prima della fusione. I geni sono stati raggruppati utilizzando il metodo di taglio dell'albero dinamico per identificare moduli distinti. (C) Dendrogramma di raggruppamento gerarchico degli eigengeni dei moduli. I moduli con pattern di espressione simili sono stati raggruppati in base alla somiglianza dei loro eigengeni.Cliccare qui per scaricare il file.
Figura supplementare 2: Analisi dell'arricchimento GSEA. (A) Analisi GO di PRKCDBP. (B) Analisi KEGG di PRKCDBP. (C) Analisi GO di PTRF. (D) Analisi KEGG di PTRF. (E) Analisi GO di TOR3A. (F) Analisi KEGG di TOR3A. (G) Analisi GO di FAM168B. (H) Analisi KEGG di FAM168B. (I) Analisi GO di B4GALT2. (J) Analisi KEGG di B4GALT2. Abbreviazioni: GO = Ontologia Genica; KEGG = Enciclopedia di Kyoto dei Geni e dei Genomi.Cliccare qui per scaricare il file.
| Dataset | Controlli | Pazienti | Piattaforma di sequenziamento |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabella 1: Set di dati sull'espressione genica utilizzati nello studio. Caratteristiche dei set di dati GSE54837 e GSE112811 utilizzati rispettivamente per lo sviluppo del modello/test interno e per la validazione esterna.
| Paziente | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Sesso (F/M) | M | M | M | F | M | M | M | M |
| Età (anni) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Condizione relativa al fumo | Sì | Sì | Ha smesso di fumare (2 anni) | No | Sì | Sì | Sì | Ha smesso di fumare (5 anni) |
| Anni-pacco | 20 al giorno / 30 anni | 15 al giorno / 35 anni | 20 al giorno / 50 anni | 20 al giorno / 40 anni | 30 al giorno / 40 anni | 15 al giorno / 40 anni | 20 al giorno / 30 anni | |
| Gruppo BPCO | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabella 2: Caratteristiche basali dei partecipanti allo studio. Caratteristiche demografiche e cliniche basali dei pazienti con BPCO e dei controlli sani inclusi nella validazione mediante RT-qPCR.
| Nome molecolare | Gene | Punteggio (kcal/mol) |
| 5-Benzilaciclouridina | UPP1 | -9.6 |
| Capecitabina | UPP1 | -6.1 |
| Fluorouracile | UPP1 | -5.5 |
Tabella 3: Risultati del docking molecolare per UPP1 e composti candidati.
Risultati predetti del docking molecolare per l'interazione di UPP1 con fluorouracile, capecitabina e 5-benzilaciclouridina, inclusa la loro affinità di legame.
Discussione
La modificazione conservata dell'RNA ac4C, che si verifica prevalentemente nell'RNA messaggero (mRNA) e nell'RNA di trasferimento (tRNA), aumenta la stabilità dell'mRNA e l'efficienza della traduzione20. NAT10 è l'unica acetiltransferasi dell'RNA nota per mediare la modificazione ac4C21. Studi hanno dimostrato che NAT10 è sovraespresso nelle cellule epiteliali polmonari di pazienti con BPCO. L'abbattimento di NAT10 altera la funzione mitocondriale e le risposte trascrittomiche22. Sulla base di un'analisi integrata di multi-omiche, questo studio ha identificato sei geni chiave strettamente associati alla BPCO e ha sviluppato un modello diagnostico, che ha mostrato prestazioni diagnostiche moderate e un potenziale valore per ulteriori indagini. Un'analisi ulteriore ha rivelato i ruoli fondamentali di questi geni nella regolazione trascrizionale, nelle reti ceRNA e nel microambiente immunitario. Inoltre, sono stati predetti farmaci potenzialmente mirati, fornendo nuove prospettive sulla patogenesi della BPCO e favorendo lo sviluppo di strategie terapeutiche personalizzate e di precisione. Abbiamo identificato geni che erano sia differenzialmente espressi nella BPCO sia presenti in una lista di geni precedentemente pubblicata associata all'ac4C, utilizzando l'analisi WGCNA e l'analisi di espressione differenziale. È importante notare che questi geni sono stati selezionati in base alla loro associazione con la rete di regolazione dell'ac4C, e non su dimostrati legami meccanicistici con NAT10 o con l'acetilazione ac4C, ottenendo un totale di 160 geni candidati. Sei geni chiave (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B e B4GALT2) sono stati identificati attraverso algoritmi di apprendimento automatico. Tra questi, PTRF svolge un ruolo fondamentale nell'infiammazione delle vie aeree indotta dagli acari della polvere domestica (HDM) regolando la necroptosi mediata da IL-33-ZBP1 nei macrofagi, suggerendo che potrebbe essere coinvolto in condizioni polmonari infiammatorie croniche come la BPCO23. Lai et al.24 hanno dimostrato che l'amministrazione esogena di uridina inibisce la ferroptosi nei macrofagi attraverso la via Nrf2/SLC7A11/GPX4, alleviando così il danno polmonare acuto causato dalla sepsi. Sebbene un aumento dell'espressione di UPP1, un enzima chiave nel metabolismo dell'uridina, sia stato osservato nei tessuti polmonari di modelli di danno polmonare acuto, il suo ruolo esatto—e se tale sovraespressione rappresenti una risposta protettiva o una conseguenza del danno tissutale—deve ancora essere chiarito. Tuttavia, questo risultato suggerisce che UPP1 potrebbe avere un'associazione potenziale con i processi fisiopatologici di malattie polmonari infiammatorie come la BPCO, giustificando ulteriori indagini. Gli altri quattro geni chiave sono stati studiati meno in relazione ai disturbi polmonari, ma sulla base delle loro funzioni in altre malattie e dei nostri attuali risultati, ipotizziamo potenziali vie attraverso cui potrebbero contribuire alla patogenesi della BPCO.
Sulla base dei sei geni chiave, abbiamo costruito un modello diagnostico per la BPCO e ne abbiamo convalidato l'ottima capacità predittiva. L'analisi dell'espressione ha mostrato che UPP1, B4GALT2 e PRKCDBP erano significativamente sovraespressi, mentre FAM168B, PTRF e TOR3A erano marcatamente sottoespressi nella BPCO. Sebbene B4GALT2 sia stato identificato come sovraespresso nell'analisi dei dataset, nessuna differenza significativa è stata osservata nella convalida mediante RT-qPCR. Tale discrepanza potrebbe essere attribuita alla dimensione limitata del campione, all'eterogeneità della coorte e alle differenze nelle fonti dei campioni tra i dataset pubblici e i campioni clinici di sangue. L'analisi dell'arricchimento dei set genici ha rivelato che questi geni chiave erano significativamente arricchiti nello splicing dell'RNA e nella maturazione dell'mRNA, nonché in vie come il ciclo cellulare e la dipendenza dalla nicotina. L'arresto irreversibile del ciclo cellulare è riconosciuto come un meccanismo primario alla base della senescenza cellulare, che potrebbe contribuire in modo sostanziale alla patofisiologia della BPCO25,26. Un'analisi ulteriore ha indicato che il fenotipo segretoio associato alla senescenza (SASP), indotto da danni al DNA, potrebbe favorire la progressione persistente della BPCO mantenendo l'infiammazione cronica e aggravando il danno al tessuto polmonare27. Uno studio precedente ha inoltre esaminato i legami genetici alla base della dipendenza dalla nicotina e della BPCO28. Sebbene il fumo sia il fattore di rischio principale per la BPCO, solo una piccola proporzione di fumatori sviluppa la malattia, suggerendo che i fattori genetici svolgano un ruolo importante sia nella BPCO che nella dipendenza dalla nicotina. Liu et al.29 hanno riassunto i ruoli delle proteine leganti l'RNA (RBPs) nella BPCO e nell'ipertensione polmonare (PH), sottolineandone il coinvolgimento nel rimodellamento vascolare polmonare e nelle risposte infiammatorie attraverso la regolazione dello splicing dell'mRNA e dell'espressione genica post-trascrizionale, evidenziandone così il potenziale come biomarcatori e target terapeutici. In sintesi, i geni chiave e le vie associate identificati in questo studio non solo approfondiscono la nostra comprensione della patogenesi della BPCO, ma forniscono anche una solida base per lo sviluppo di futuri biomarcatori diagnostici e strategie terapeutiche mirate.
La rete ceRNA coinvolge diverse specie di RNA, tra cui lncRNA, circRNA e mRNA, che si legano in modo competitivo a miRNA condivisi, formando così relazioni regolatorie reciproche e influenzando l'espressione genica30. Questa rete complessa partecipa a numerosi processi fisiologici e patologici e contribuisce a chiarire i meccanismi di regolazione genica e la patogenesi di malattie come il cancro e i disturbi infiammatori cronici. Ad esempio, Wang et al. hanno costruito una rete di coespressione ceRNA composta da 11 lncRNA, cinque miRNA e 16 mRNA, nella quale la sottorete centrale era associata a variazioni nella proporzione delle cellule immunitarie e nella funzione polmonare nella BPCO31. Analogamente, Zhang et al.32 hanno sviluppato una rete ceRNA circRNA-miRNA-mRNA basata su cellule mononucleate del sangue periferico di fumatori maschi, identificando circRNA deregolati e vie chiave associate alla BPCO. La nostra analisi della rete di coespressione ha rivelato che i geni chiave stabilivano principalmente connessioni funzionali attraverso interazioni fisiche, coespressione e domini proteici condivisi ed erano significativamente arricchiti in molteplici vie metaboliche. Sulla base di questi risultati, abbiamo ulteriormente costruito una rete regolatoria fattore di trascrizione (TF)-gene target e un asse regolatorio miRNA-lncRNA-mRNA. Questi risultati suggeriscono che i geni chiave potrebbero essere regolati in modo cooperativo attraverso meccanismi multilivello che coinvolgono lncRNA, fattori di trascrizione e miRNA nella BPCO.
L'infiltrazione immunitaria riflette lo stato immunitario indicando la distribuzione e l'attività delle cellule immunitarie nei tessuti o nel sangue. Sulla base di ciò, sono stati previsti potenziali farmaci candidati mediante screening computazionale, seguito da simulazioni di docking molecolare per valutare l'affinità di legame e la stabilità con le proteine bersaglio. Insieme, queste analisi facilitano l'identificazione di nuovi agenti terapeutici e forniscono approfondimenti più dettagliati sui meccanismi delle malattie. In questo studio, sei geni chiave sono risultati positivamente correlati con la maggior parte delle infiltrazioni di cellule immunitarie. La previsione farmacologica ha identificato potenziali interazioni tra UPP1 e fluorouracile, capecitabina e 5-benzilacilouridina, quest'ultima mostrando l'affinità di legame più elevata, come ulteriormente confermato dal docking molecolare. In particolare, fluorouracile e capecitabina sono principalmente utilizzati come agenti antitumorali e sono stati identificati in questo studio come composti predetti in database come interagenti con UPP1, piuttosto che come opzioni terapeutiche validate per la BPCO. Studi precedenti hanno riportato che l'amministrazione locale di fluorouracile potrebbe migliorare la pervietà delle vie aeree in casi di ostruzione severa33. Tuttavia, altre evidenze indicano che fluorouracile e capecitabina potrebbero indurre tossicità polmonare, in particolare nei pazienti con patologie polmonari preesistenti34. Pertanto, la loro eventuale rilevanza per la BPCO richiede ulteriori verifiche sperimentali e di sicurezza. Inoltre, l'analisi CTD ha indicato che tutti e sei i geni chiave erano associati a numerosi processi patologici. Complessivamente, l'analisi integrata dell'infiltrazione immunitaria, della previsione farmacologica e del docking molecolare fornisce nuovi bersagli molecolari e una base teorica per il trattamento di precisione della BPCO, promuovendo così lo sviluppo e la traduzione clinica di farmaci correlati.
Tuttavia, è necessario riconoscere diverse limitazioni. Lo studio si è basato su dataset pubblici con fonti di campioni relativamente limitate, il che potrebbe introdurre effetti di batch e un potenziale overfitting del modello. La validazione mediante RT-qPCR è stata effettuata su un piccolo coorte, e l'incoerenza osservata nell'espressione di B4GALT2 suggerisce una possibile eterogeneità del coorte. Inoltre, le analisi sull'infiltrazione immunitaria e sulla predizione di farmaci erano di natura computazionale e richiedono ulteriore validazione sperimentale. Inoltre, essendo un'indagine bioinformatica nella fase di scoperta, il nostro modello diagnostico è stato valutato principalmente mediante valori di AUC con intervalli di confidenza al 95%. Metriche di prestazione complete, come sensibilità, specificità, valori predittivi e statistiche dettagliate di calibrazione, non sono state pienamente valutate a causa della natura retrospettiva dei dataset pubblici e delle dimensioni limitate dei campioni. Pertanto, il nostro modello dovrebbe essere considerato uno strumento dimostrativo, e la sua utilità clinica richiede ulteriore validazione in coorti prospettiche più ampie.
Mediante analisi integrative di bioinformatica e apprendimento automatico, questo studio ha identificato sei geni chiave significativamente associati alla BPCO. È stato sviluppato un modello diagnostico robusto, che ha dimostrato prestazioni predittive affidabili in più coorti. Le analisi funzionali hanno rivelato che questi geni partecipano a reti regolatorie fondamentali coinvolgenti la regolazione trascrizionale e post-trascrizionale, l'infiltrazione di cellule immunitarie e vie associate alla dipendenza da nicotina e al ciclo cellulare. Le previsioni farmacologiche e le analisi di docking molecolare hanno evidenziato UPP1 come un promettente bersaglio terapeutico, con diversi composti candidati che mostrano forti affinità di legame. Nel complesso, questi risultati approfondiscono la nostra comprensione della fisiopatologia della BPCO e forniscono bersagli molecolari preziosi per lo sviluppo futuro di terapie e strategie di medicina di precisione.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi. Il consenso informato è stato ottenuto da tutti i soggetti coinvolti nello studio.
Ringraziamenti
Ringraziamo l'Ospedale Shenzhen Luohu di Medicina Tradizionale Cinese per aver fornito le strutture cliniche e il supporto amministrativo essenziali per questo studio. Infine, siamo grati a tutti i pazienti e ai volontari sani che hanno partecipato a questa ricerca; il loro contributo è stato indispensabile per questo lavoro. Questo lavoro è stato sostenuto dal Sanming Project of Medicine a Shenzhen (n. SZZYSM202401018), dai Fondi per le Specialità Prioritarie del Distretto di Luohu (n. LX202402021) e dai Fondi per le Specialità Prioritarie del Distretto di Luohu (n. LX202302064).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| β-actin primers | Tsingke | N/A | Forward: 5’-CATGTACGTTGCTATCCAGGC-3’ Reverse: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| Primers B4GALT2 | Tsingke | N/A | Forward: 5’-GGGCAGACTGCTGATCGAG-3’ Reverse: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | Simulazione di docking molecolare |
| clusterProfiler | Bioconductor | v4.14.6 | Analisi di arricchimento |
| Cytoscape | Consortium Cytoscape | v3.8.3 | Visualizzazione di reti |
| DrugBank | Università dell'Alberta | Online | Predizione farmacologica |
| Primers FAM168B | Tsingke | N/A | Forward: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Reverse: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | Regressione LASSO |
| GSVA | Bioconductor | v1.52.3 | Analisi ssGSEA |
| Hifair III 1st Strand cDNA Synthesis Supermix | YEASEN | 11141ES | Sintesi di cDNA |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | Amplificazione qPCR |
| limma | Bioconductor | v3.54.0 | Espressione differenziale |
| LightCycler 480 II System | Roche | LightCycler 480 II | PCR in tempo reale |
| Primers PTRF | Tsingke | N/A | Forward: 5’-GGGCCGTAGACCAGATCCA-3’ Reverse: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| Primers PRKCDBP | Tsingke | N/A | Forward: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Reverse: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| Software R | Fondazione R | v4.4.2 | Calcolo statistico |
| randomForest | CRAN | v4.7 | Random Forest |
| RNA isolater MolPure Blood RNA Kit | YEASEN | 19241ES50 | Estrazione di RNA |
| Database STRING | EMBL | Online | Rete PPI |
| Primers TOR3A | Tsingke | N/A | Forward: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Reverse: 5’-CCCGTCCCGATACAGGTTC-3’ |
| Primers UPP1 | Tsingke | N/A | Forward: 5’-CTGTCAGTCATGGTATGGGCA-3’ Reverse: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | Rete di co-espressione |
| xgboost | CRAN | v1.7 | Algoritmo XGBoost |
Riferimenti
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.