Questo protocollo integra dati trascrittomici multidimensionali con l'apprendimento automatico per identificare geni legati all'invecchiamento e ai mitocondri nella cardiomiopatia dilatativa, al fine di scoprire biomarcatori e sottotipi molecolari.
Articolo di ricerca
Identificazione di geni hub legati all'invecchiamento e ai mitocondri nella cardiomiopatia dilatativa
In questo articolo
Sommario
Abstract
La cardiomiopatia dilatativa (DCM) è caratterizzata da dilatazione del ventricolo sinistro e disfunzione sistolica ed è associata a disfunzione mitocondriale e attivazione immuno-infiammatoria. Tuttavia, le firme molecolari legate all'invecchiamento e i percorsi regolatori mitocondriali nella DCM non sono ancora completamente compresi. Questo studio ha analizzato sei dataset trascrittomici bulk e un dataset di sequenziamento dell'RNA a singola cellula provenienti dal database Gene Expression Omnibus. Dopo normalizzazione dei dati, correzione del batch e annotazione dei tipi cellulari, i geni candidati legati all'invecchiamento e ai mitocondri sono stati identificati mediante analisi dell'espressione differenziale, analisi della rete di co-espressione genica pesata e costruzione della rete di interazione proteina-proteina. I geni centrali sono stati ulteriormente selezionati utilizzando la regressione con operatore di riduzione e selezione assoluta minima, la foresta casuale e l'eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto. Sono state effettuate analisi sull'infiltrazione di cellule immunitarie, sulla comunicazione intercellulare e sul sottotipaggio molecolare per caratterizzare il microambiente immunitario cardiaco nella DCM. Un totale di 66 geni legati all'invecchiamento e 16 geni legati ai mitocondri sono risultati associati alla DCM ed erano principalmente arricchiti nei percorsi di segnalazione del fattore inducibile da ipossia-1, nella fosforilazione ossidativa e nei percorsi correlati alla sintasi dell'ossido nitrico. Le analisi mediante apprendimento automatico e sequenziamento dell'RNA a singola cellula hanno identificato SERPINE1, TGFB2, CYBB e TLR2 come geni centrali. CYBB e TLR2 erano altamente espressi nei monociti e nei macrofagi, mentre SERPINE1 e TGFB2 erano prevalentemente espressi nelle cellule stromali. L'analisi del paesaggio immunitario ha mostrato un aumento dell'attivazione dei macrofagi pro-infiammatori e una alterata comunicazione intercellulare nei campioni di DCM. Sulla base dell'espressione dei geni centrali, i campioni di DCM sono stati suddivisi in due sottotipi molecolari associati rispettivamente alla segnalazione del fattore di crescita endoteliale vascolare e alla biosintesi degli acidi biliari primari. Questo protocollo fornisce un quadro integrato per l'identificazione di biomarcatori candidati e sottotipi molecolari nella DCM.
Introduzione
La cardiomiopatia dilatativa (DCM) è un disturbo miocardico caratterizzato da dilatazione del ventricolo sinistro e compromissione della funzione sistolica. È la terza causa più comune di scompenso cardiaco e l'indicazione principale per il trapianto cardiaco a livello mondiale1. Studi basati sulla popolazione stimano una prevalenza di circa 1 caso ogni 250 adulti, con una prevalenza maggiore nei maschi e una percentuale significativa di casi attribuibili a varianti monogeniche2. Questi risultati indicano che sia la predisposizione genetica sia i fattori ambientali contribuiscono all'insorgenza e alla progressione della DCM.
La patogenesi della miocardiopatia dilatativa coinvolge processi interconnessi, tra cui l'attivazione infiammatoria, lo stress ossidativo, l'apoptosi dei cardiomiociti e una segnalazione profibrotica disregolata. Polimorfismi genetici infiammatori, inclusi varianti del promotore del fattore di necrosi tumorale-α, sono stati associati alla suscettibilità alla miocardiopatia dilatativa di origine virale3. Un aumento dello stress ossidativo è stato inoltre associato alla morte dei cardiomiociti e al malfunzionamento del ventricolo sinistro nei sottotipi umani di miocardiopatia dilatativa4. Inoltre, l'attivazione anomala della via di segnalazione Wnt/β-catenina e della via calcineurina/fattore nucleare delle cellule T attivate promuove l'ipertrofia miocardica e la fibrosi interstiziale, contribuendo così alla progressione della malattia5,6. La disfunzione mitocondriale rappresenta un altro componente importante della miocardiopatia dilatativa, poiché i cardiomiociti presentano elevate richieste energetiche. Il deterioramento della biogenesi mitocondriale, dell'omeostasi del calcio, della mitofagia e dell'integrità del DNA mitocondriale può compromettere la fosforilazione ossidativa e contribuire a un malfunzionamento cardiaco progressivo7,8,9,10.
Nonostante questi risultati meccanicistici, rimangono lacune conoscitive importanti. In particolare, le relazioni temporali e causali tra il rimodellamento strutturale dei mitocondri e la disfunzione bioenergetica durante l'insorgenza e la progressione della miocardiopatia dilatativa non sono state completamente definite11. Sono state esplorate diverse strategie terapeutiche. La terapia con cellule staminali ha mostrato potenziale rigenerativo grazie a effetti paracrini, citoprotettivi e immunomodulatori, ma è ancora necessaria l'ottimizzazione delle fonti cellulari, delle vie di somministrazione e della sopravvivenza post-trapianto12. Anche gli approcci della terapia genica, inclusa la somministrazione basata su virus adeno-associati e la modifica del genoma basata su ripetizioni palindrome corte interspaziate e raggruppate (CRISPR), offrono potenziali strategie terapeutiche di precisione. Tuttavia, limitazioni legate alla tropismo cardiaco, all'immunogenicità del vettore e alla sicurezza a lungo termine rimangono irrisolte13.
I set di dati trascrittomici pubblici provenienti da archivi come il Gene Expression Omnibus (GEO) sono ampiamente utilizzati per la scoperta di biomarcatori nella MCD. Queste risorse forniscono accesso a coorti cliniche multicentriche, supportano indagini economiche e riproducibili e possono migliorare la potenza statistica attraverso l'integrazione incrociata dei dataset14. Il profilo trascrittomico consente inoltre lo screening genomica di geni candidati, la sottotipizzazione molecolare e l'analisi a livello di percorsi biologici15. Tuttavia, i dataset pubblici presentano limitazioni intrinseche, tra cui effetti tecnici di lotto, eterogeneità clinica ed eziologica, capacità limitata di trarre inferenze causali e informazioni longitudinali o prognostiche incomplete16. Pertanto, i risultati ottenuti da dataset trascrittomici pubblici sono più adatti alla generazione di ipotesi e alla priorizzazione di biomarcatori candidati, e richiedono validazione in coorti indipendenti e modelli sperimentali.
Molti studi bioinformatici sulla miocardiopatia dilatativa (DCM) si basano principalmente sull'analisi dell'espressione differenziale, che può generare risultati falsi positivi e non caratterizza appieno le reti di co-espressione genica né l'eterogeneità cellulare all'interno del tessuto cardiaco. Per affrontare tali limitazioni, il presente studio ha adottato una strategia analitica integrata che combina metodi complementari. L'analisi trascrittomica su popolazione totale fornisce profili di espressione a livello tissutale, adatti per confronti caso-controllo. L'analisi delle reti pesate di co-espressione genica (WGCNA) identifica moduli genici associati a tratti fenotipici e consente di dare priorità a insiemi di geni funzionalmente correlati piuttosto che a singoli geni differenzialmente espressi. L'analisi della rete di interazione proteina-proteina (PPI) identifica geni altamente connessi sulla base della topologia della rete. Tre algoritmi di apprendimento automatico — regressione con operatore di selezione e riduzione assoluta minima (least absolute shrinkage and selection operator), foresta casuale (random forest) e macchina a vettori di supporto con eliminazione ricorsiva delle caratteristiche (support vector machine-recursive feature elimination) — sono stati utilizzati per identificare biomarcatori candidati nei dataset integrati¹⁷. Successivamente, il sequenziamento dell'RNA a singola cellula (scRNA-seq) è stato impiegato per esaminare i modelli di espressione specifici per tipo cellulare e le reti di comunicazione intercellulare18.
Sebbene la disfunzione mitocondriale e i cambiamenti molecolari legati all'invecchiamento siano stati ciascuno studiati nella miocardiopatia dilatativa (DCM), le loro associazioni combinate con modifiche trascrizionali correlate alla malattia rimangono poco esplorate. Lo studio attuale ha integrato diversi dataset trascrittomica bulk e scRNA-seq per identificare geni centrali (hub genes) legati all'invecchiamento e ai mitocondri nella DCM, caratterizzare il microambiente immunitario cardiaco ed esaminare sottotipi molecolari basati sui geni identificati. Questo approccio integrato è stato utilizzato per individuare biomarcatori candidati e fornire una base per successivi studi meccanicistici e di validazione.
Protocollo
Tutte le procedure sugli animali sono state esaminate e approvate dal Comitato Etico per la Sperimentazione Animale del Secondo Ospedale Affiliato dell'Università di Medicina Cinese del Henan (Numero di approvazione: HNSZYYYJS2023011150). Tutte le procedure sono state condotte in conformità con le Linee guida per la valutazione etica del benessere degli animali da laboratorio (GB/T 35892-2018) e con i principi 3R di Sostituzione, Riduzione e Perfezionamento. I reagenti, le basi di dati, il software e l'attrezzatura utilizzati in questo studio sono elencati nella Tabella dei materiali.
1. Risorse di dati e materiali sperimentali
Topi transgenici maschi di grado SPF CTNTR141W con un fenotipo di cardiomiopatia dilatativa (DCM) spontanea e un peso corporeo di 25 ± 2 g sono stati utilizzati come gruppo modello. Topi maschi di grado SPF C57BL/6J di pari età con un peso corporeo di 25 ± 2 g sono stati utilizzati come gruppo di controllo. Ogni gruppo comprendeva 12 topi. Tutti gli animali provenivano da istituzioni dotate di licenze valide per la produzione di animali da laboratorio ed erano allevati in un ambiente a barriera di grado SPF a 22 ± 2 °C e umidità relativa del 40%–60%, con un ciclo luce/buio di 12 h, con libero accesso a cibo e acqua sterilizzati. Dopo 1 settimana di ambientamento, tutti i topi sono stati mantenuti nelle stesse condizioni per ulteriori 4 settimane prima della valutazione della funzione cardiaca e del prelievo dei campioni. Tutti i topi avevano un'età compresa tra 6 e 8 settimane all'inizio dell'esperimento. I topi sono stati anestetizzati profondamente e soppressi mediante dislocazione cervicale.
Sette dataset trascrittomici pubblici di tessuto miocardico del ventricolo sinistro provenienti da pazienti con miocardiopatia dilatativa (DCM) sono stati recuperati dal database Gene Expression Omnibus (GEO)19. Questi dataset includevano sei dataset trascrittomici bulk e un dataset di sequenziamento dell'RNA a singola cellula (scRNA-seq), GSE145154. Nell'analisi sono state incluse sia le frazioni positive per CD45 che quelle negative per CD45. Le frazioni cellulari positive e negative per CD45 sono state combinate prima del raggruppamento. L'identità del campione è stata utilizzata come variabile principale di batch per l'integrazione con Harmony. Sono stati inclusi campioni normali del ventricolo sinistro e campioni di ventricolo sinistro con DCM da GSE145154, in particolare GSM4307515, GSM4307516, GSM4307520 e GSM4307521. I dataset utilizzati in questo studio sono stati GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 e GSE141910. Sono stati esclusi tutti i campioni non appartenenti alla DCM, e sono stati mantenuti solo i campioni di controllo (gruppo Controllo) e i campioni con DCM (gruppo DCM). Nessun campione è stato rimosso dopo il controllo di qualità. Le informazioni sui campioni dei dataset GEO inclusi sono riassunte di seguito: GSE5406 conteneva 102 campioni (16 di controllo e 86 con DCM); GSE42955 conteneva 17 campioni (5 di controllo e 12 con DCM); GSE57338 conteneva 231 campioni (136 di controllo e 95 con DCM); GSE79962 conteneva 20 campioni (11 di controllo e 9 con DCM); GSE116250 conteneva 51 campioni (14 di controllo e 37 con DCM); e GSE141910 conteneva 322 campioni (161 di controllo e 161 con DCM).
2. Pre-elaborazione dei dati del trascrittoma in bulk
Le matrici di espressione grezze e i file di annotazione clinica per i sei dataset in bulk sono stati scaricati utilizzando il pacchetto GEOquery20. Sono stati recuperati i file CEL grezzi per i dataset di microarray Affymetrix e le matrici di conteggio grezze per i dataset di RNA-seq. La correzione del fondo, la normalizzazione quantile e il calcolo dell'espressione per i dati di microarray sono stati eseguiti utilizzando l'algoritmo robust multi-array average implementato nel pacchetto affy21.
I dati di conteggio dell'RNA-seq sono stati normalizzati utilizzando il metodo della media trimmata dei valori M nel pacchetto edgeR22 e sono stati convertiti in valori log₂ trasformati di conteggi per milione. Gli identificatori delle sonde sono stati convertiti in simboli genici ufficiali utilizzando file di annotazione specifici della piattaforma. Quando più sonde corrispondevano allo stesso gene, è stato calcolato il valore medio di espressione.
Gli effetti tecnici di batch tra i dataset sono stati rimossi utilizzando l'algoritmo ComBat nel pacchetto sva23. La provenienza del dataset e la piattaforma di rilevamento sono state specificate come fattori di batch. È stata eseguita un'analisi delle componenti principali prima e dopo la correzione del batch per valutare l'efficacia della rimozione degli effetti di batch.
3. Pre-elaborazione dei dati del trascrittoma a singola cellula e annotazione cellulare
La matrice di espressione genica da GSE145154 è stata importata in Seurat per costruire un oggetto Seurat utilizzando Seurat versione 524. Le cellule di bassa qualità sono state escluse utilizzando le seguenti soglie: da 200 a 6.000 geni rilevati per cellula, conteggio totale di identificatori molecolari unici superiore a 500 e percentuale di geni mitocondriali inferiore al 25%. Le cellule al di fuori di queste soglie di controllo qualità sono state escluse in quanto di bassa qualità o rotte. Abbiamo escluso le cellule di bassa qualità utilizzando esclusivamente le soglie di controllo qualità descritte sopra.
La normalizzazione logaritmica è stata eseguita utilizzando la funzione NormalizeData con un fattore di scala di 10.000. I 3.000 geni altamente variabili sono stati selezionati utilizzando la funzione FindVariableFeatures con il metodo vst. I dati sono stati normalizzati utilizzando ScaleData, seguiti dall'analisi delle componenti principali per la riduzione lineare della dimensionalità.
Gli effetti di batch sono stati corretti utilizzando l'algoritmo Harmony25 mediante la funzione RunHarmony, specificando l'identità del campione come variabile di raggruppamento. I primi 15 componenti principali sono stati utilizzati per raggruppare le cellule mediante le funzioni FindNeighbors e FindClusters. Il raggruppamento è stato eseguito utilizzando l'algoritmo Leiden con una risoluzione di 0,15. La riduzione non lineare della dimensionalità e la visualizzazione sono state effettuate utilizzando l'approssimazione uniforme della varietà e la proiezione.
I tipi cellulari sono stati annotati utilizzando geni marcatore canonici insieme all'annotazione automatizzata mediante il pacchetto SingleR26. I geni marcatore erano i seguenti: cellule B, IGKC, MS4A1 e CD79A; cardiomiociti, TNNI3, MYL2 e ACTC1; cellule endoteliali, VWF, PECAM1 ed EGFL7; macrofagi, C1QC, C1QB e C1QA; monociti, S100A8, S100A9 e G0S2; cellule natural killer, NKG7, GNLY e CCL5; cellule muscolari lisce, MYL9, TAGLN e ACTA2; cellule stromali, FBLN1, LUM e DCN; e cellule T, CD3E, CD3G e CD3D.
4. Analisi dell'espressione differenziale e punteggio di arricchimento dei set genici
È stato costruito un modello lineare utilizzando il pacchetto limma27 per confrontare l'espressione genica tra i gruppi con miocardiopatia dilatativa (DCM) e i controlli sani. I geni con valore di P < 0,05 e un fold change assoluto maggiore di 1,5, corrispondente a un log₂ fold change assoluto maggiore di 0,58, sono stati definiti come espressi in modo significativamente differenziale.
È stata eseguita un'analisi di arricchimento dei set di geni su singolo campione per calcolare i punteggi di arricchimento per i set di geni associati all'invecchiamento e ai mitocondri in ciascun campione28. Le differenze nei punteggi di arricchimento tra i gruppi con miocardiopatia dilatativa e controlli sani sono state valutate mediante il test della somma dei ranghi di Wilcoxon, considerando statisticamente significativi i valori di P < 0,05.
A livello di singola cellula, i punteggi dei moduli legati all'invecchiamento e ai mitocondri sono stati calcolati utilizzando la funzione AddModuleScore in Seurat. Le differenze nei punteggi dei moduli tra i gruppi sono state valutate mediante il test della somma dei ranghi di Wilcoxon.
Le firme geniche associate all'invecchiamento sono state recuperate dal database CellAge (https://genomics.senescence.info/cells/) e i set genici mitocondriali sono stati ottenuti da GeneCards (https://www.genecards.org/). Gli elenchi completi dei geni utilizzati per il punteggio sono forniti nel File Supplementare 1.
5. Costruzione della rete di co-espressione genica pesata
Sono stati mantenuti i 5000 geni codificanti proteine con la maggiore varianza di espressione nei dati trascrittomici bulk per la costruzione della rete. È stata applicata la funzione pickSoftThreshold per calcolare l'indice di adattamento alla topologia senza scala a diverse potenze di soglia morbida. La soglia ottimale è stata determinata come la potenza minima che produce una rete senza scala con un valore di R2 superiore a 0,9. Di conseguenza, per le analisi successive della rete è stata adottata una potenza di soglia morbida pari a β = 5.
È stata costruita una rete di co-espressione pesata con segno utilizzando la funzione blockwiseModules con una dimensione minima del modulo pari a 30. Sono stati calcolati i coefficienti di correlazione di Pearson tra ogni eigengene del modulo e il punteggio di arricchimento legato all'invecchiamento o ai mitocondri. Sono stati considerati moduli significativamente associati quelli con un coefficiente di correlazione assoluto maggiore di 0,4 e P < 0,001.
I geni all'interno dei moduli significativamente associati sono stati incrociati con i geni differenzialmente espressi per identificare i geni candidati associati all'invecchiamento in DCM e i geni candidati associati ai mitocondri in DCM.
6. Analisi dell'arricchimento funzionale
Sono state condotte analisi dell'arricchimento funzionale, incluse le analisi dei percorsi dell'Ontologia Genica (GO) e dell'Enciclopedia di Kyoto dei Geni e dei Genomi (KEGG), sui geni candidati utilizzando il pacchetto clusterProfiler29. L'arricchimento GO ha riguardato le tre categorie standard: processo biologico, componente cellulare e funzione molecolare.
Tutte le analisi sono state eseguite con annotazione della specie umana, tasso di scoperte false (FDR) per la correzione del valore P e una soglia di q-value pari a 0,05. Gli insiemi genici sono stati limitati a un intervallo dimensionale di 10–500 geni e i termini con un FDR < 0,05 sono stati considerati statisticamente significativi. Infine, i risultati dell'arricchimento GO sono stati visualizzati tramite grafici a barre raggruppate, mentre i risultati dell'arricchimento KEGG sono stati mostrati utilizzando grafici a bolle.
7. Costruzione della rete PPI e identificazione dei geni hub
I geni candidati sono stati sottoposti al database STRING versione 11.530, con l'organismo impostato su Homo sapiens e la soglia di confidenza delle interazioni fissata a un punteggio combinato superiore a 0,7. I nodi disconnessi sono stati nascosti e i dati sulle interazioni sono stati esportati in formato di valori separati da tabulazione.
I dati di interazione sono stati importati in Cytoscape versione 3.9.1 per la visualizzazione31. I punteggi topologici dei nodi sono stati calcolati utilizzando il plugin CytoHubba32 con tre algoritmi: Degree, componente massima del vicinato e centralità della cricca massimale.
I moduli funzionali principali all'interno della rete sono stati identificati utilizzando il plugin MCODE33 con i seguenti parametri predefiniti: cutoff del grado, 2; k-core, 2; cutoff del punteggio del nodo, 0,2; e profondità massima, 100. I geni classificati tra i primi 10 da tutti e tre gli algoritmi topologici sono stati incrociati con i geni della sottorete principale MCODE per identificare i geni hub finali dell'interazione proteina-proteina.
8. Selezione dei geni centrali basata sull'apprendimento automatico e costruzione del modello diagnostico
Per garantire riproducibilità e una rappresentazione bilanciata, il dataset trascrittomico bulk integrato è stato suddiviso casualmente in set di addestramento e di validazione in un rapporto 7:3, utilizzando un seme casuale fisso (seed = 123456). La suddivisione è stata stratificata per gruppo di malattia (DCM vs. controllo) per mantenere proporzioni di classe costanti in entrambi i set. Prima della suddivisione, gli effetti di batch derivanti da diverse fonti di dataset sono stati corretti utilizzando il pacchetto sva, e i campioni integrati sono stati trattati come una singola coorte durante l'assegnazione casuale.
Tre algoritmi di apprendimento automatico sono stati applicati per analizzare i geni candidati. In primo luogo, è stata eseguita una regressione logistica LASSO tramite la funzione cv.glmnet nel pacchetto glmnet34È stato costruito un modello di classificazione binaria con validazione incrociata a 5 ripetizioni, adottando l'AUC come metrica di valutazione. I geni con coefficienti diversi da zero a lambda.min sono stati conservati come geni candidati.
In secondo luogo, è stato costruito un modello di classificazione basato su foresta casuale con 500 alberi decisionali utilizzando il pacchetto randomForest35. Il numero di variabili campionate per ogni suddivisione è stato impostato alla radice quadrata del numero totale di caratteristiche. L'importanza dei geni è stata quantificata in base al coefficiente di Gini e sono stati mantenuti i 10 geni con i punteggi di importanza più elevati.
In terzo luogo, l'analisi SVM-RFE è stata implementata utilizzando la funzione rfe nel pacchetto caret36. Il numero di caratteristiche è stato impostato in un intervallo da 1 a 10 e è stata adottata una cross-validation a 5 ripetizioni per l'addestramento del modello. Il sottoinsieme di geni con l'accuratezza ottimale nella cross-validation è stato infine selezionato.
I geni identificati da tutti e tre gli algoritmi sono stati definiti come i geni finali del nucleo associati all'invecchiamento e ai mitocondri nella MCD. Successivamente, sono stati costruiti modelli diagnostici utilizzando 10 algoritmi di classificazione: albero decisionale, macchina ad aumento del gradiente, modello lineare generalizzato potenziato, k-nearest neighbors, regressione logistica, rete neurale, minimi quadrati parziali, foresta casuale, macchina a vettori di supporto e boosting estremo del gradiente.
Le curve caratteristiche operative del ricevitore sono state generate utilizzando il pacchetto pROC37. L'area sotto la curva, l'accuratezza, la sensibilità e la specificità sono state calcolate per valutare le prestazioni diagnostiche negli insiemi di addestramento e di validazione.
È stata eseguita un'analisi SHapley Additive exPlanations per calcolare il contributo di ciascun gene fondamentale alle previsioni del modello38. Sono stati generati grafici riassuntivi e grafici a cascata per ogni campione. Un modello diagnostico finale con un'area sotto la curva maggiore di 0,8 nel set di validazione è stato considerato come avente una buona prestazione diagnostica.
9. Inferenza della comunicazione cellula-cellula
Le reti di comunicazione cellula-cellula nel microambiente cardiaco sono state inferite utilizzando il pacchetto CellChat39. È stato costruito un oggetto CellChat mediante il database CellChatDB.human. I ligandi e i recettori differenzialmente espressi sono stati identificati utilizzando identifyOverExpressedGenes, mentre le coppie di interazione significative sono state filtrate mediante identifyOverExpressedInteractions.
Le probabilità di comunicazione tra i tipi cellulari sono state calcolate utilizzando computeCommunProb. La rete globale di comunicazione a livello di tipo cellulare è stata aggregata utilizzando aggregateNet. Il numero di interazioni e l'intensità della comunicazione tra ogni coppia di tipi cellulari sono stati quantificati e visualizzati mediante mappe termiche e grafici a barre.
10. Quantificazione dell'infiltrazione delle cellule immunitarie
I punteggi di arricchimento per 28 tipi di cellule immunitarie sono stati calcolati per ogni campione bulk mediante l'analisi di arricchimento dell'insieme di geni da singolo campione28 e un insieme di geni specifici per le cellule immunitarie40. Per confrontare i punteggi di arricchimento delle cellule immunitarie tra il gruppo con miocardiopatia dilatativa e il gruppo di controllo sano è stato utilizzato il test della somma dei ranghi di Wilcoxon. Un valore di P < 0,05 è stato considerato statisticamente significativo.
È stata condotta un'analisi della correlazione di Pearson per valutare l'associazione tra i livelli di espressione dei geni fondamentali e i punteggi di arricchimento delle cellule immunitarie. Tutte le correlazioni con P < 0,05 sono state considerate statisticamente significative.
11. Clustering consensuale per la sottotipizzazione molecolare
Il clustering consensuale non supervisionato dei campioni di miocardiopatia dilatativa (DCM) è stato eseguito utilizzando i profili di espressione genica principali tramite il pacchetto ConsensusClusterPlus41I parametri di raggruppamento sono stati impostati con un numero massimo di cluster pari a 6, 1000 iterazioni di ricampionamento e una proporzione di ricampionamento dello 0,8. Per il raggruppamento è stato adottato il metodo di partizionamento attorno ai medoidi con distanza euclidea, e un seme casuale fisso è stato utilizzato per garantire la riproducibilità.
Il numero ottimale di sottotipi è stato determinato in base al grafico dell'area delta e ai punteggi di stabilità del cluster di consenso, con K = 2 identificato come valore finale. È stata inoltre eseguita un'analisi delle componenti principali per verificare la chiara separazione dei due sottotipi molecolari.
È stata applicata un'analisi della variazione dei set genici42 per calcolare i punteggi di arricchimento dei percorsi KEGG specifici per campione. Il pacchetto limma27 è stato utilizzato per rilevare l'attivazione differenziale dei percorsi tra i sottotipi, e un valore P inferiore a 0,05 è stato considerato statisticamente significativo.
12. Valutazione ecocardiografica della funzione cardiaca
I topi sono stati anestetizzati tramite iniezione intraperitoneale di pentobarbital sodico allo 1% (30 mg/kg) e posizionato in posizione supina su un tavolo operatorio termoregolato. Dopo la rimozione dei peli del torace, del gel ecografico è stato applicato uniformemente sulla regione precordiale.
È stata eseguita un'ecocardiografia M-mode guidata bidimensionale al livello dei muscoli papillari del ventricolo sinistro utilizzando un sistema ecografico per piccoli animali. Sono stati acquisiti tre cicli cardiaci stabili consecutivi per misurare il diametro del ventricolo sinistro in fine diastole, il diametro in fine sistole, la frazione di eiezione e la frazione di accorciamento. Tutte le valutazioni ecocardiografiche sono state effettuate in cieco da un ultrasonografista professionista.
Tre topi sono stati selezionati casualmente da ciascun gruppo per l'esame ecocardiografico, e questi 6 animali in totale sono stati successivamente sacrificati per la raccolta del tessuto miocardico e la misurazione mediante ELISA. Gli animali sperimentali rimanenti hanno subito ulteriori saggi di laboratorio paralleli, i cui dati non sono stati inclusi nel presente studio.
13. Raccolta del tessuto miocardico, estrazione delle proteine e saggio immunoenzimatico (ELISA)
Dopo la valutazione ecocardiografica, i topi sono stati sottoposti a eutanasia sotto anestesia profonda. I tessuti cardiaci sono stati rapidamente prelevati. tramite toracotomia mediana, e il miocardio del ventricolo sinistro è stato dissezionato su ghiaccio. I tessuti isolati sono stati accuratamente lavati con soluzione salina tamponata al fosfato fredda per eliminare il sangue intracardiaco residuo. Dopo aver asciugato il liquido in eccesso con carta filtrante sterile, i campioni sono stati immediatamente congelati rapidamente in azoto liquido e conservati a −80 °C per l'estrazione proteica successiva, evitando rigorosamente cicli ripetuti di congelamento-scongelamento.
I tessuti miocardici congelati sono stati pesati e tagliati in frammenti di circa 1 mm3 su ghiaccio. I tessuti sono stati lisati in tampone di lisi RIPA freddo contenente inibitori di proteasi e fosfatasi, in un rapporto standardizzato di 100 µL di tampone per 10 mg di tessuto. I campioni sono stati completamente omogeneizzati meccanicamente su ghiaccio e incubati per 30 min per ottenere una lisi cellulare completa.
I lisati sono stati centrifugati a 12.000 × g per 15 min a 4 °C. I soprannatanti ottenuti sono stati raccolti in provette prive di enzimi e la concentrazione totale di proteine è stata quantificata utilizzando un kit per saggio proteico con acido bicinconinico, seguendo i protocolli del produttore. Tutti i campioni sono stati normalizzati a una concentrazione proteica identica con il buffer di lisi.
I livelli di espressione proteica dei quattro geni hub nei lisati miocardici sono stati misurati utilizzando i corrispondenti kit per saggio immunoenzimatico (ELISA). Standard diluiti in serie e lisati di tessuto normalizzati sono stati aggiunti in duplicato (100 µL per pozzetto) su micropiastre pre-ricoperte. Le piastre sono state incubate per 2 h a temperatura ambiente e accuratamente lavate con il tampone di lavaggio fornito con il kit.
A ogni pozzetto è stato aggiunto un anticorpo coniugato con enzima ed è stato incubato per 1 h a temperatura ambiente, seguito da un lavaggio accurato. Successivamente è stata aggiunta la soluzione cromogenica del substrato e le piastre sono state incubate per 20 min a temperatura ambiente al buio. La reazione colorimetrica è stata interrotta con la soluzione di arresto e i valori di assorbanza sono stati misurati a 450 nm (lunghezza d'onda di riferimento: 570 nm) utilizzando un lettore di micropiastre a lunghezza d'onda completa.
14. Analisi statistica
Tutte le analisi statistiche e le rappresentazioni grafiche dei dati sono state eseguite utilizzando R versione 4.2.3. Per le misurazioni delle concentrazioni tramite ELISA di ciascun gene bersaglio (TGFB2, SERPINE1, CYBB, TLR2), è stato applicato inizialmente il test di Shapiro-Wilk per valutare la normalità dei dati nei gruppi Controllo e DCM separatamente. Successivamente, è stato utilizzato un test F per valutare l'omogeneità delle varianze tra i due gruppi. Il metodo per il confronto tra gruppi è stato determinato in base ai risultati del test di omogeneità delle varianze: se le varianze erano omogenee (P ≥ 0.05), è stato adottato un test t di Student non appaiato per confrontare i valori medi tra i gruppi; se le varianze erano eterogenee (P < 0.05), è stato utilizzato il test t di Welch corretto per l'analisi. Tutti i test erano a due code e la soglia di significatività statistica è stata fissata a P < 0.05. I dati sono stati rappresentati mediante boxplot sovrapposti a punti individuali dispersi (jittered). I valori di P di tutti i test e il tipo di test t utilizzato sono stati riportati in dettaglio su ciascun grafico.
Risultati
Pre-elaborazione dei dati e analisi dell'espressione differenziale
Tutti e sei i dataset trascrittomica bulk hanno subito una pre-elaborazione standardizzata e una correzione degli effetti di batch prima dell'analisi successiva. I dati di microarray sono stati normalizzati utilizzando l'algoritmo robust multi-array average, mentre i dati di conteggio da RNA-seq sono stati normalizzati mediante il metodo della media trimmata dei valori M. L'algoritmo ComBat è stato applicato per rimuovere gli effetti tecnici di batch associati alla provenienza del dataset e alla piattaforma di rilevamento. L'analisi delle componenti principali ha mostrato che i campioni si raggruppavano in base alla fonte del dataset prima della correzione, ma risultavano distribuiti in modo più uniforme dopo la correzione, senza alcuna separazione visibile per batch.
È stata eseguita un'analisi dell'espressione differenziale tra i gruppi con cardiomiopatia dilatativa (DCM) e controllo sano (HC) utilizzando il pacchetto limma. La mappa termica dei 20 geni maggiormente espressi in modo significativamente diverso ha mostrato una separazione dei profili di espressione tra i due gruppi (Figura 1A). Sono stati identificati complessivamente 1.473 geni con espressione differenziale, utilizzando come soglie un valore di P < 0,05 e un |cambio di trascrizione log₂| > 0,58. Di questi, 819 geni erano upregolati e 654 erano downregolati nei campioni miocardici con DCM (Figura 1B).
È stata quindi utilizzata un'analisi di arricchimento di geni su singolo campione per calcolare i punteggi di arricchimento per i gruppi di geni associati all'invecchiamento e ai mitocondri in ciascun campione. Entrambi i punteggi differivano in modo significativo tra i gruppi DCM e HC (Figura 1C).
Analisi della rete di co-espressione genica pesata
È stata eseguita un'analisi della rete di co-espressione genica pesata per identificare i moduli genici associati ai punteggi di invecchiamento e di arricchimento mitocondriale. Le 5.000 proteine codificanti con la maggiore varianza di espressione nel dataset bulk sono state utilizzate per costruire la rete. Con una potenza di soglia morbida di β = 5, l'indice di adattamento alla topologia senza scala ha superato R2 = 0,9, soddisfacendo il criterio della rete senza scala (Figura 1D).
Il clustering gerarchico e la fusione dei moduli hanno identificato tre moduli genici. Tutti e tre i moduli sono risultati significativamente correlati con il punteggio legato all'invecchiamento. Il modulo color turchese ha mostrato la correlazione più forte con il punteggio legato all'invecchiamento (r = 0,69, P < 0,001). Per quanto riguarda il punteggio mitocondriale, i moduli blu e grigio sono risultati significativamente correlati, con il modulo blu che presenta l'associazione più forte (r = 0,56, P < 0,001; Figura 1E). Il modulo turchese è stato quindi selezionato per lo screening dei geni legati all'invecchiamento, e il modulo blu è stato selezionato per lo screening dei geni legati ai mitocondri.
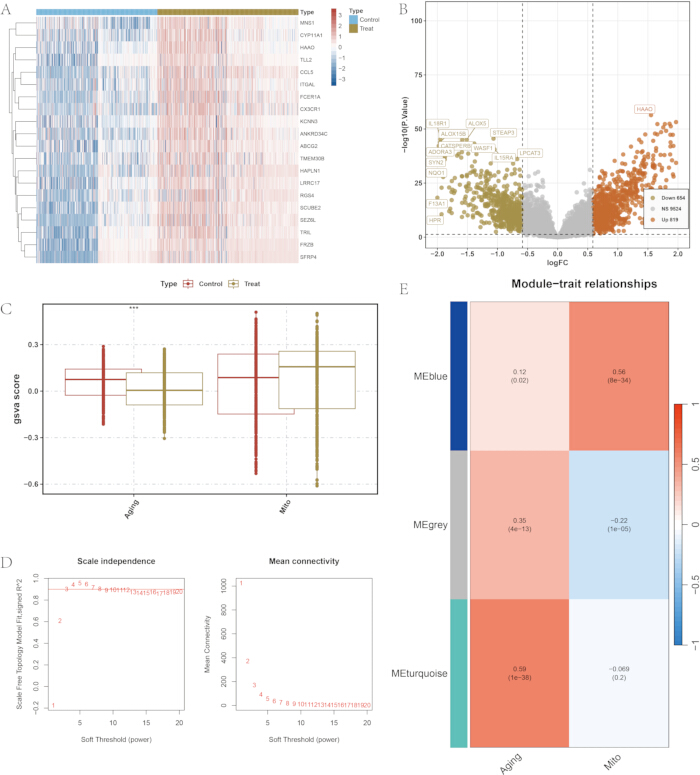
Figura 1Analisi dell'espressione differenziale e costruzione di una rete pesata di co-espressione genica (AMappa termica dei 20 geni con maggiore differenza significativa nell'espressione tra il gruppo con cardiomiopatia dilatativa (DCM) e il gruppo di controllo sano (HC).BGrafico a vulcano di tutti i geni espressi in modo differenziale. I geni in rosso indicano geni upregolati, i geni in verde indicano geni downregolati e i geni in grigio indicano geni non significativi. Le soglie erano un valore di P < 0,05 e un fold change |log₂(FC)| > 1. < 0,05 e |log₂ della variazione| > 0.58. (C) Box plot dei punteggi di analisi di arricchimento di set genici per singolo campione relativi ai set genici associati all'invecchiamento e ai mitocondri. (D) Selezione della soglia morbida per l'analisi della rete di co-espressione genica pesata, con indicazione dell'indice di adattamento alla topologia senza scala e della connettività media a diverse potenze di sogliatura morbida.EMappa termica delle correlazioni tra gli eigengeni dei moduli e i punteggi relativi all'invecchiamento e mitocondriali. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Identificazione di geni candidati associati all'invecchiamento e ai mitocondri
I geni candidati sono stati identificati attraverso l'intersezione tra geni differenzialmente espressi, geni nei moduli selezionati dell'analisi della rete di co-espressione genica pesata e i corrispondenti set di geni di riferimento. Questa analisi ha identificato 66 geni candidati associati all'invecchiamento in rapporto alla MCD (Figura 2A) e 16 geni candidati associati ai mitocondri in rapporto alla MCD (Figura 2B).
L'analisi di arricchimento della Gene Ontology ha mostrato che i geni candidati associati all'invecchiamento erano arricchiti in processi biologici, tra cui la biosintesi della sintasi dell'ossido nitrico e l'organizzazione della matrice extracellulare contenente collagene (Figura 2C). I geni candidati associati ai mitocondri erano arricchiti in termini legati al metabolismo energetico mitocondriale, tra cui la membrana interna mitocondriale e il complesso della catena respiratoria (Figura 2D).
L'analisi del Kyoto Encyclopedia of Genes and Genomes ha mostrato che i geni candidati associati all'invecchiamento erano arricchiti nei percorsi di segnalazione del fattore inducibile da ipossia-1, della fosfoinositide 3-chinasi-proteina chinasi B e dei prodotti finali della glicazione avanzata-recettore per i prodotti finali della glicazione avanzata (Figura 2E). I geni candidati associati ai mitocondri erano arricchiti in percorsi inclusa la fosforilazione ossidativa (Figura 2F).
I modelli di espressione differenziale dei 66 geni candidati associati all'invecchiamento tra i gruppi DCM e HC sono stati visualizzati mediante una mappa termica dell'espressione (Figura 2G). I modelli di espressione dei 16 geni candidati mitocondriali sono stati visualizzati mediante diagrammi a scatola con baffi (Figura 2H).
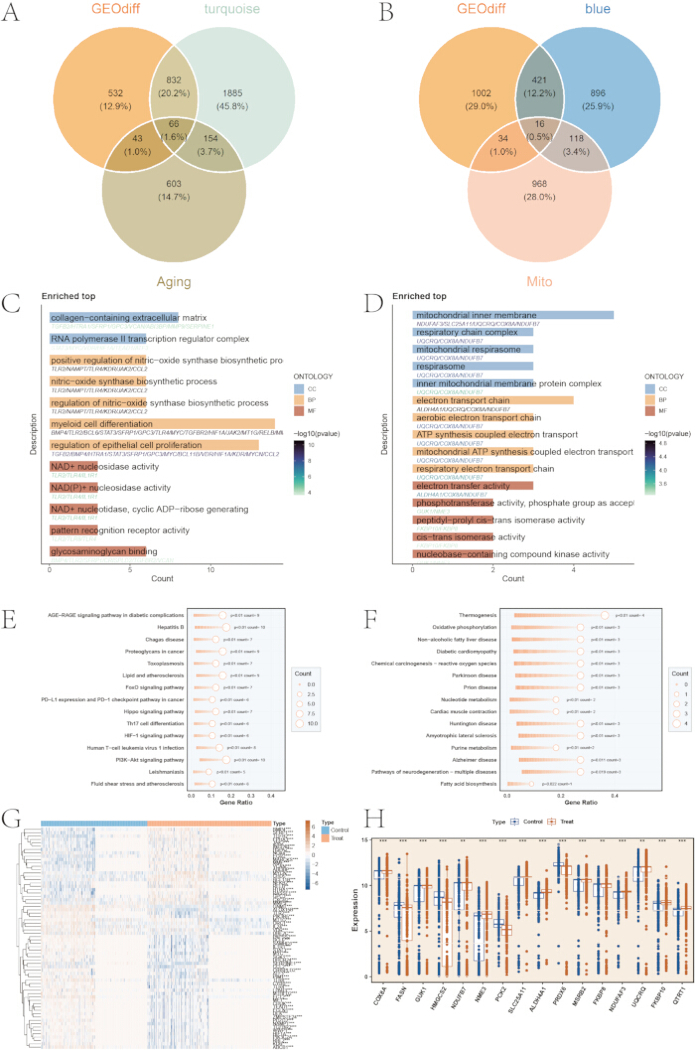
Figura 2: Analisi di screening e arricchimento funzionale dei geni candidati. (A) Diagramma di Venn che mostra l'intersezione tra i geni differenzialmente espressi, i geni dei moduli dell'analisi della rete di co-espressione genica pesata e il set di riferimento di geni associati all'invecchiamento. (B) Diagramma di Venn che mostra l'intersezione tra i geni differenzialmente espressi, i geni dei moduli dell'analisi della rete di co-espressione genica pesata e il set di riferimento di geni associati ai mitocondri. (C) Analisi di arricchimento dell'ontologia genica per i geni candidati legati all'invecchiamento. (D) Analisi di arricchimento dell'ontologia genica per i geni candidati legati ai mitocondri. (E) Analisi di arricchimento dei percorsi della Kyoto Encyclopedia of Genes and Genomes per i geni candidati legati all'invecchiamento. (F) Analisi di arricchimento dei percorsi della Kyoto Encyclopedia of Genes and Genomes per i geni candidati legati ai mitocondri. (G) Mappa termica dell'espressione dei 66 geni candidati legati all'invecchiamento nei gruppi DCM e HC. (H) Grafici a scatola dell'espressione dei 16 geni candidati legati ai mitocondri nei gruppi DCM e HC. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Assegnazione del tipo cellulare al dataset di sequenziamento dell'RNA a singola cellula
Il dataset di sequenziamento dell'RNA a singola cellula GSE145154 è stato utilizzato per la validazione a risoluzione singola di cellula. Dopo il filtraggio per controllo della qualità, la normalizzazione logaritmica e la correzione del batch con Harmony, le cellule provenienti da diversi campioni sono state distribuite nello spazio di proiezione e approssimazione della varietà uniforme senza una separazione visibile specifica per campione. Utilizzando i primi 15 componenti principali e una risoluzione di clustering di 0,15, le cellule sono state suddivise in 9 cluster (Figura 3A).
I geni marcatore canonici e l'annotazione automatizzata mediante SingleR hanno identificato 9 tipi cellulari principali: macrofagi, cellule natural killer, cellule T, cellule B, cellule endoteliali, cellule muscolari lisce, monociti, cellule stromali e cardiomiociti (Figura 3B). I profili di espressione dei geni marcatore specifici per tipo cellulare hanno confermato queste annotazioni (Figura 3C).
I punteggi del modulo mitocondriale sono stati calcolati per ogni cellula utilizzando la funzione AddModuleScore e differivano in modo significativo tra il gruppo con cardiomiopatia dilatativa e il gruppo di controllo sano (P < 2.22 × 10⁻16; Figura 3D). Anche i punteggi del modulo legato all'invecchiamento differivano in modo significativo tra i due gruppi (P < 2.22 × 10⁻16; Figura 3E). La proiezione dei punteggi mitocondriali nello spazio di approssimazione e proiezione della varietà uniforme ha mostrato che valori elevati erano osservati principalmente nei cardiomiociti (Figura 3F). Al contrario, punteggi elevati legati all'invecchiamento erano prevalentemente osservati nei macrofagi (Figura 3G).
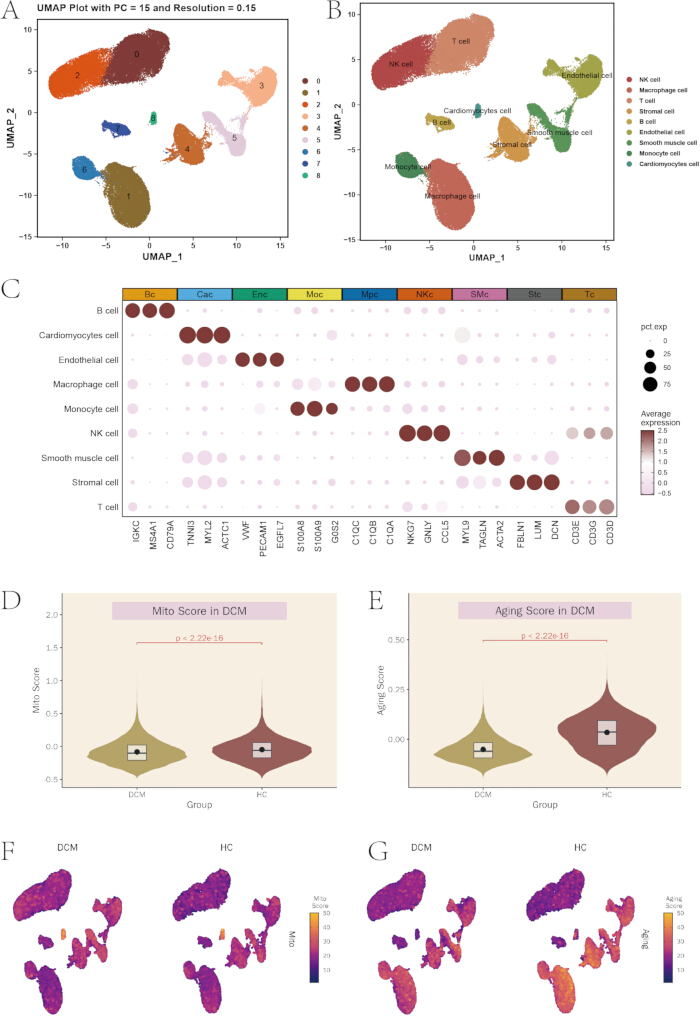
Figura 3: Annotazione del trascrittoma singola-cellula e analisi dei punteggi modulari. (A) Grafico di proiezione e approssimazione della varietà uniforme (UMAP) dei cluster cellulari generati utilizzando i primi 15 componenti principali e una risoluzione di clustering di 0,15. (B) Grafico UMAP dei tipi cellulari annotati. (C) Grafico a bolle che mostra l'espressione dei geni marcatore canonici tra i diversi tipi cellulari. (D) Grafico a violino dei punteggi dei moduli mitocondriali nei gruppi MCD e controllo sano (HC). (E) Grafico a violino dei punteggi dei moduli legati all'invecchiamento nei gruppi MCD e HC. (F) Grafico UMAP che mostra la distribuzione dei punteggi del modulo mitocondriale tra le cellule. (G) Grafico UMAP che mostra la distribuzione dei punteggi del modulo legato all'invecchiamento tra le cellule. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Costruzione della rete di interazione proteina-proteina
L'insieme combinato di 66 geni candidati correlati all'invecchiamento e di 16 geni candidati correlati ai mitocondri è stato sottoposto al database STRING versione 11.5 per costruire una rete di interazione proteina-proteina, utilizzando una soglia di alta affidabilità con punteggio combinato > 0,7. La rete è stata importata in Cytoscape per la visualizzazione e l'analisi topologica (Figura 4A).
Sono state utilizzate analisi di grado, centralità della clique massimale, componente del vicinato massimo e MCODE per identificare nodi altamente connessi e sottoreti centrali. Le sottoreti identificate da questi metodi sono mostrate in Figura 4B–E.
I 10 geni principali classificati in base al Degree, alla centralità del clique massimale e al componente del vicinato massimo sono stati incrociati con i geni nella sottorete principale di MCODE. Questa analisi ha identificato 10 geni candidati: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 e CXCR2.
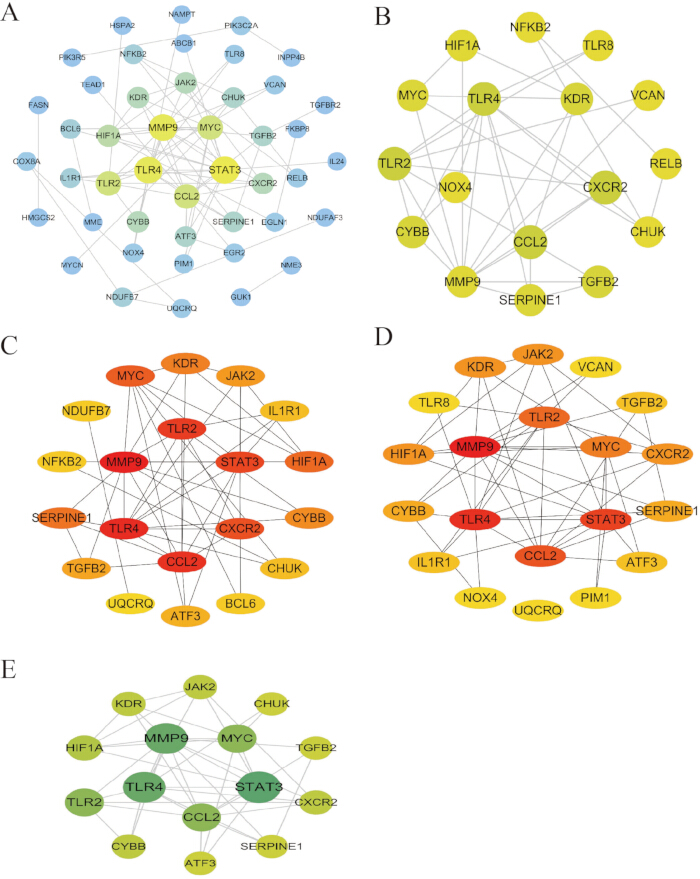
Figura 4Costruzione della rete di interazione proteina-proteina e identificazione dei geni hub
(A) Rete complessiva di interazioni proteina-proteina dei geni candidati.B) Sottorete principale identificata mediante MCODE.C) Sottorete principale identificata mediante centralità della massima clique. (D) Sottorete principale identificata mediante componente del massimo intorno. (E) Sottorete principale identificata mediante grado. Fare clic qui per visualizzare una versione ingrandita di questa figura.
Selezione di geni hub basata su apprendimento automatico
Sono stati applicati tre algoritmi di apprendimento automatico—regressione logistica con operatore di riduzione e selezione della norma L1 (LASSO), foresta casuale e macchina a vettori di supporto con eliminazione ricorsiva di caratteristiche (SVM-RFE)—per selezionare i geni hub tra i 10 candidati derivanti dall'interazione proteina-proteina. Tutte le analisi sono state eseguite utilizzando un seme casuale fisso (set.seed(12345)) e una validazione incrociata a 5 ripiegamenti. Nel modello LASSO, sono stati mantenuti come candidati i geni con coefficienti non nulli al valore ottimale di lambda (lambda.min) (Figura 5A).
Nel modello di support vector machine con eliminazione ricorsiva delle caratteristiche, è stata raggiunta la massima accuratezza della cross-validation pari a 0,859 quando erano incluse 10 caratteristiche (Figura 5B), con un tasso di errore minimo corrispondente di 0,141 (Figura 5C). Il modello random forest con 500 alberi decisionali ha mostrato una convergenza stabile del tasso di errore out-of-bag (Figura 5D). Il ranking dell'importanza genica basato sul coefficiente di Gini ha posizionato TGFB2, TLR2, SERPINE1 e CYBB tra i geni con punteggio più alto (Figura 5E). L'intersezione dei geni selezionati dai tre algoritmi ha prodotto quattro geni centrali finali: CYBB, SERPINE1, TGFB2 e TLR2 (Figura 5F).
È stata eseguita un'analisi SHapley Additive exPlanations per valutare il contributo di ciascun gene centrale alle previsioni del modello. TGFB2 ha mostrato il valore medio assoluto di SHapley Additive exPlanations più alto, pari a 0,249, seguito da SERPINE1 con 0,103, CYBB con 0,083 e TLR2 con 0,078 (Figura 6A). Il grafico riassuntivo ha mostrato la distribuzione e la direzione dei contributi genici nei diversi campioni (Figura 6B). I grafici di dipendenza hanno illustrato la relazione tra i valori individuali dei geni e i contributi al modello (Figura 6C), mentre i grafici a cascata per singolo campione hanno mostrato il contributo di ciascun gene alle previsioni individuali (Figura 6D).
Successivamente sono stati costruiti modelli di classificazione diagnostica basati sui quattro geni hub utilizzando 10 algoritmi di classificazione. Nel set di addestramento, la maggior parte degli algoritmi ha raggiunto valori dell'area sotto la curva superiori a 0,85 (Figura 6E). Nel set di validazione interna, la maggior parte degli algoritmi ha raggiunto valori dell'area sotto la curva superiori a 0,78 (Figura 6F).
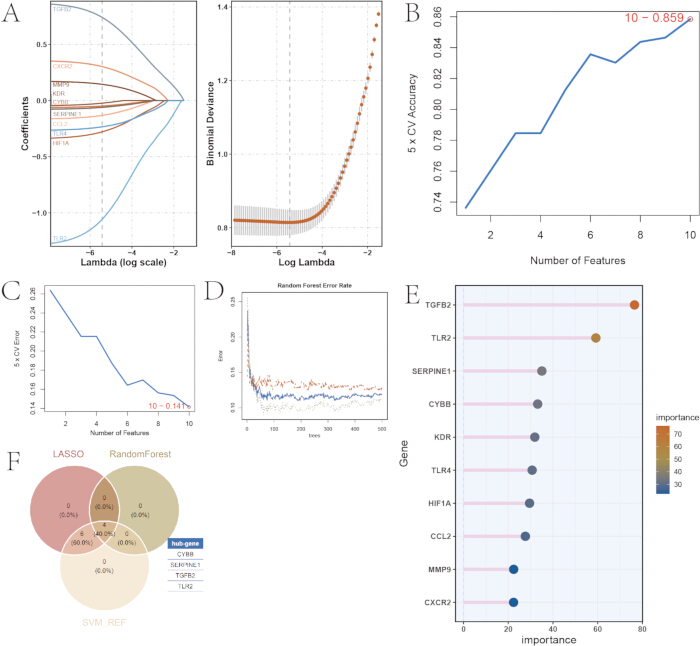
Figura 5: Selezione basata sul machine learning dei geni hub. (A) Traiettoria del coefficiente di regressione dell'operatore di riduzione e selezione con norma L1 e selezione del lambda ottimale. (B) Curva di accuratezza della validazione incrociata per il modello di eliminazione ricorsiva delle caratteristiche basato su macchine a vettori di supporto. (C) Curva dell'errore di validazione incrociata per il modello di eliminazione ricorsiva delle caratteristiche basato su macchine a vettori di supporto. (D) Curva del tasso di errore "out-of-bag" per il modello di random forest. (E) Classificazione dell'importanza dei geni in base al coefficiente di Gini nel modello di random forest. (F) Diagramma di Venn che mostra i geni hub identificati dai tre algoritmi di machine learning. Cliccare qui per visualizzare una versione ingrandita di questa figura.
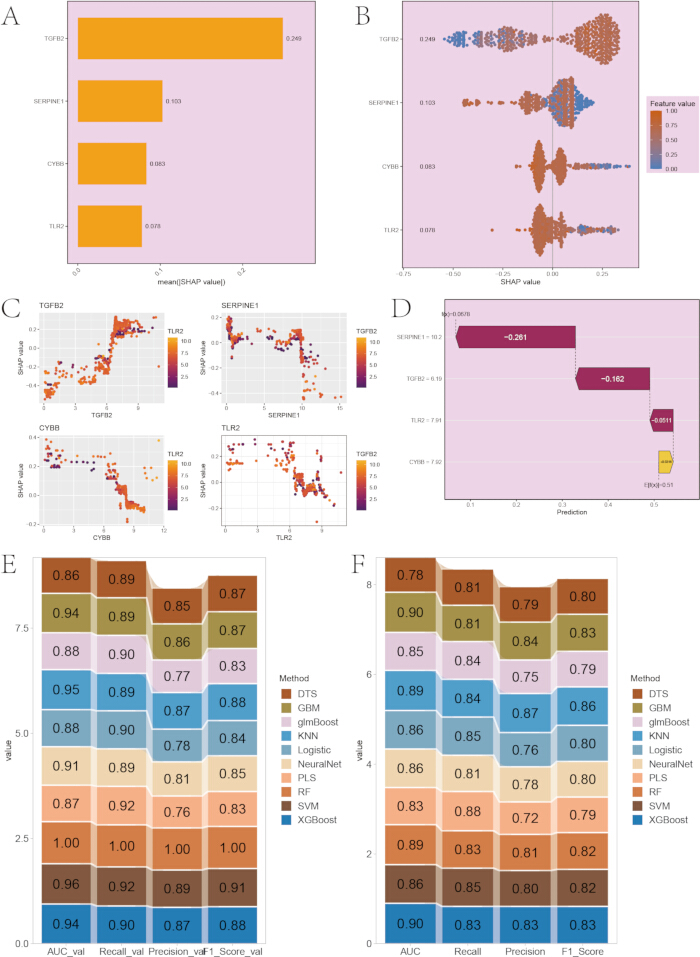
Figura 6: Valutazione del modello diagnostico e analisi SHapley Additive exPlanations (SHAP). (A) Valori medi assoluti SHapley Additive exPlanations per i quattro geni centrali. (B) Grafico riassuntivo SHapley Additive exPlanations che mostra la distribuzione e la direzione dei contributi genici. (C) Grafici di dipendenza SHapley Additive exPlanations per ciascun gene centrale. (D) Grafico a cascata SHapley Additive exPlanations per un campione rappresentativo. (E) Heatmap delle prestazioni diagnostiche di 10 algoritmi di classificazione nel set di addestramento. (F) Heatmap delle prestazioni diagnostiche di 10 algoritmi di classificazione nel set di validazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Validazione a livello di singola cellula e analisi della comunicazione intercellulare
I modelli di espressione dei quattro geni centrali sono stati valutati a livello di singola cellula. L'analisi della distribuzione per tipo cellulare ha mostrato che CYBB e TLR2 erano altamente espressi nei monociti e nei macrofagi, mentre SERPINE1 e TGFB2 erano prevalentemente espressi nelle cellule stromali (Figura 7A).
I grafici a violino hanno mostrato che l'espressione di CYBB differiva in modo significativo tra il gruppo con cardiomiopatia dilatativa e il gruppo di controllo sano (Figura 7B). Anche SERPINE1 (Figura 7C), TGFB2 (Figura 7D) e TLR2 (Figura 7E) differivano in modo significativo tra i gruppi. Tutti e quattro i geni erano significativamente upregolati nel gruppo con cardiomiopatia dilatativa rispetto ai controlli sani, con un valore di P < 0,0001 per ciascun confronto.
Le reti di comunicazione tra cellule nel microambiente cardiaco sono state dedotte utilizzando CellChat e un database di ligandi-recettori. Il numero e la forza complessiva delle interazioni tra cellule differivano tra il gruppo con cardiomiopatia dilatativa e il gruppo di controllo (Figura 7F). È stata osservata anche una differenza nella forza di comunicazione tra i tipi cellulari (Figura 7G). Monociti, macrofagi, cardiomiociti e cellule stromali erano i principali partecipanti alla rete di comunicazione.
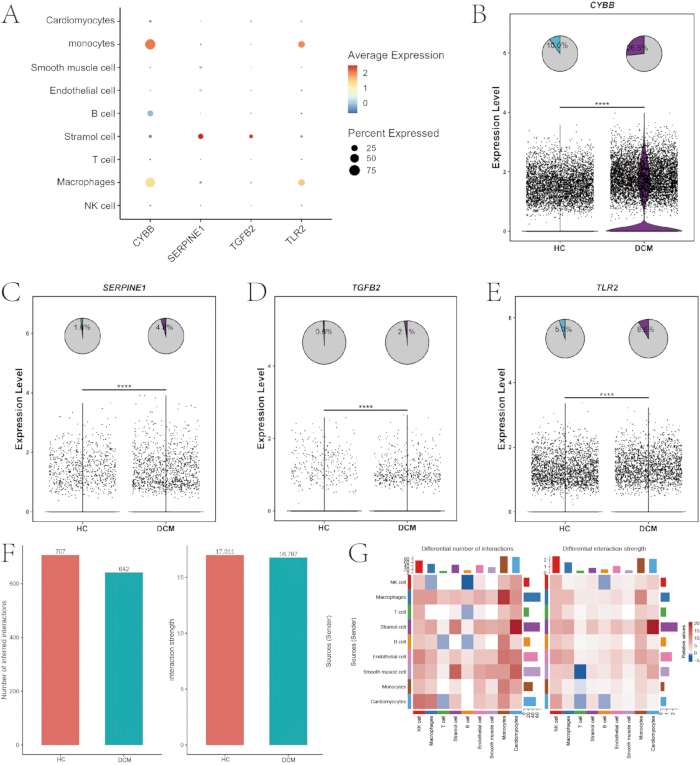
Figura 7: Validazione a singola cellula dei geni hub e analisi della comunicazione intercellulare. (A) Diagramma a bolle che mostra l'espressione dei quattro geni hub nei diversi tipi cellulari. (B) Diagramma a violino dell'espressione di CYBB nei gruppi DCM e HC. (C) Diagramma a violino dell'espressione di SERPINE1 nei gruppi DCM e HC. (D) Diagramma a violino dell'espressione di TGFB2 nei gruppi DCM e HC. (E) Diagramma a violino dell'espressione di TLR2 nei gruppi DCM e HC. (F) Diagramma a barre che mostra il numero e l'intensità complessiva delle interazioni intercellulari. (G) Mappa termica che mostra la differenza nell'intensità della comunicazione intercellulare tra i gruppi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Analisi dell'infiltrazione delle cellule immunitarie
I punteggi di arricchimento per 28 sottoinsiemi di cellule immunitarie sono stati calcolati per ciascun campione bulk mediante analisi di arricchimento dell'insieme di geni da singolo campione. L'abbondanza della maggior parte dei tipi di cellule immunitarie differiva in modo significativo tra i gruppi con miocardiopatia dilatativa e i controlli sani (Figura 8A).
È stata quindi eseguita un'analisi della correlazione di Pearson per valutare la relazione tra l'espressione dei geni hub e i punteggi di arricchimento delle cellule immunitarie. L'espressione di CYBB era significativamente correlata all'abbondanza di diversi tipi di cellule immunitarie (Figura 8B). Correlazioni simili sono state osservate per SERPINE1 (Figura 8C), TGFB2 (Figura 8D) e TLR2 (Figura 8E). CYBB, SERPINE1 e TLR2 hanno mostrato correlazioni positive con diverse popolazioni di cellule immunitarie innate, inclusi monociti e macrofagi.
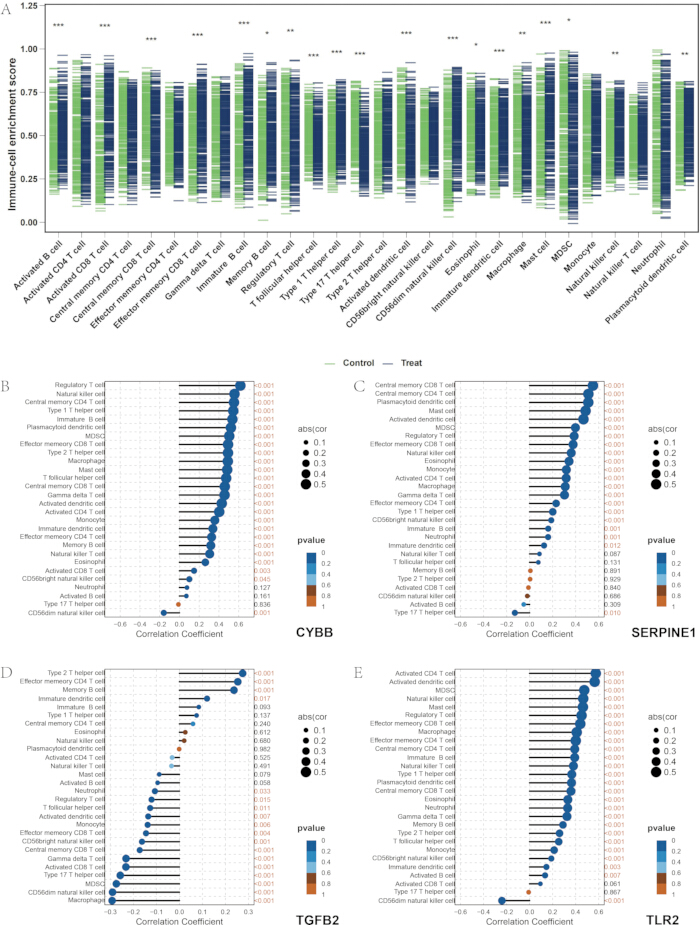
Figura 8: Infiltrazione delle cellule immunitarie e analisi della correlazione. (A) Diagrammi a scatola (box plot) dei punteggi di arricchimento per 28 tipi di cellule immunitarie nei gruppi DCM e HC. (B) Diagramma a bastoncino (lollipop plot) che mostra le correlazioni tra l'espressione di CYBB e l'abbondanza delle cellule immunitarie. (C) Diagramma a bastoncino (lollipop plot) che mostra le correlazioni tra l'espressione di SERPINE1 e l'abbondanza delle cellule immunitarie. (D) Diagramma a bastoncino (lollipop plot) che mostra le correlazioni tra l'espressione di TGFB2 e l'abbondanza delle cellule immunitarie. (E) Diagramma a bastoncino (lollipop plot) che mostra le correlazioni tra l'espressione di TLR2 e l'abbondanza delle cellule immunitarie. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Sottotipizzazione molecolare della cardiomiopatia dilatativa
È stato eseguito un clustering consensuale non supervisionato su campioni di cardiomiopatia dilatativa in base ai profili di espressione dei quattro geni hub. La matrice di clustering consensuale ha supportato la separazione a K = 2 (Figura 9A). Il grafico dell'area delta ha ulteriormente confermato K = 2 come numero ottimale di cluster, suddividendo i campioni in due sottotipi molecolari, C1 e C2 (Figura 9B).
I livelli di espressione di CYBB, SERPINE1 e TLR2 differivano significativamente tra i due sottotipi (Figura 9C). L'abbondanza di diversi sottogruppi di cellule immunitarie differiva inoltre tra i sottotipi (Figura 9D). L'analisi della variazione dei gruppi genici ha mostrato un'attivazione relativa della via di segnalazione del fattore di crescita endoteliale vascolare nel sottotipo C1, mentre la biosintesi degli acidi biliari primari e la biosintesi dei glicolipidi glicosfingolipidici erano arricchite nel sottotipo C2 (Figura 9E). L'analisi delle componenti principali ha evidenziato una separazione tra i campioni assegnati ai due sottotipi (Figura 9F).
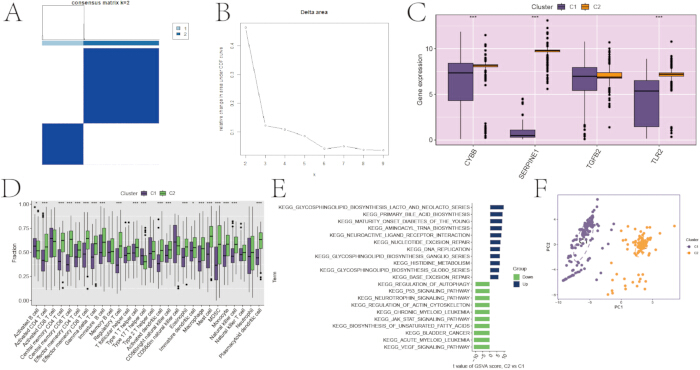
Figura 9: Clustering consensuale per la sottotipizzazione molecolare della cardiomiopatia dilatativa. (A) Matrice di clustering consensuale a K = 2. (B) Grafico dell'area delta utilizzato per determinare il numero ottimale di cluster. (C) Boxplot dell'espressione dei geni hub nei due sottotipi molecolari. (D) Boxplot dell'abbondanza delle cellule immunitarie nei due sottotipi molecolari. (E) Mappa termica dei percorsi arricchiti in modo differenziale nell'Enciclopedia dei Geni e dei Genomi di Kyoto (KEGG) tra i due sottotipi molecolari. (F) Grafico dell'analisi delle componenti principali (PCA) che mostra la separazione tra i due sottotipi molecolari. Cliccare qui per visualizzare una versione più grande di questa figura.
Validazione in vivo nel modello murino di cardiomiopatia dilatativa
Topi transgenici CTNTR141W con fenotipo spontaneo di cardiomiopatia dilatativa sono stati utilizzati per la validazione in vivo. Rispetto ai topi di controllo di tipo selvatico C57BL/6J di pari età, i topi transgenici hanno mostrato un diametro telediastolico del ventricolo sinistro significativamente aumentato e una frazione di eiezione del ventricolo sinistro ridotta, in accordo con dilatazione ventricolare e disfunzione sistolica (Figura 10A).
Le proteine totali sono state estratte dal tessuto miocardico del ventricolo sinistro e le concentrazioni delle quattro proteine codificate dai geni hub sono state misurate mediante saggio immunoenzimatico (ELISA) dopo la normalizzazione della proteina totale basata sull'acido bicinconinico. Tutti i saggi sono stati eseguiti in duplicato. Le curve standard presentavano coefficienti di correlazione (R2) ≥ 0,99 e i coefficienti di variazione tra pozzetti duplicati erano inferiori al 10%. La significatività statistica tra i gruppi Controllo e CMP è stata valutata utilizzando il test t di Student o il test t di Welch, a seconda dell'uguaglianza delle varianze verificata con il test F (la normalità è stata confermata mediante il test di Shapiro-Wilk). I livelli miocardici di proteina corrispondenti ai quattro geni hub erano significativamente aumentati nei topi con miocardiopatia dilatativa (CMP) rispetto ai controlli (Figura 10B). Per la validazione mediante ELISA, sono stati inclusi 3 replicati biologici (singoli topi) per ogni gruppo. Per la validazione mediante ELISA, sono stati inclusi tre replicati biologici indipendenti per gruppo. Questi risultati devono essere considerati preliminari e richiedono conferma in una coorte più ampia.
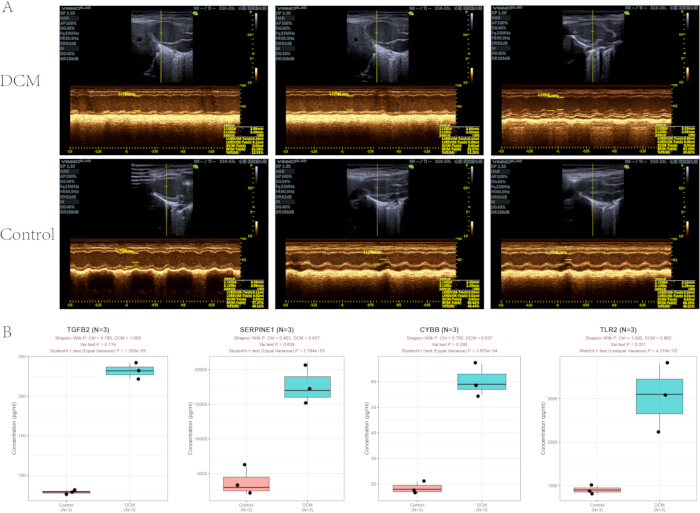
Figura 10: Validazione in vivo nel modello murino transgenico di cardiomiopatia dilatativa CTNTR141W. (A) Immagini ecocardiografiche rappresentative in modo M di topi transgenici CTNTR141W con cardiomiopatia dilatativa (CMPD) e topi di controllo di tipo selvatico. (B) Quantificazione mediante ELISA di quattro proteine derivate da geni hub nei tessuti miocardici del ventricolo sinistro di topo. I diagrammi a scatola e baffi mostrano le concentrazioni proteiche nei gruppi Controllo e CMPD (n = 3 repliche biologiche per gruppo). Per ciascun diagramma a scatola: la linea orizzontale continua all'interno della scatola indica il valore mediano; i margini superiore e inferiore della scatola rappresentano il 75° e il 25° percentile (intervallo interquartile, IQR); i baffi superiore e inferiore si estendono fino ai punti dati massimi e minimi non outlier entro 1,5 × IQR; i singoli punti neri corrispondono a repliche biologiche indipendenti ottenute da singoli animali. L'asse y indica la concentrazione assoluta della proteina: pg/mL per TGFB2 e CYBB, ng/mL per TLR2 e SERPINE1. I confronti statistici tra i due gruppi sono stati effettuati utilizzando il test t di Student (varianza uguale) o il test t di Welch (varianza disuguale), con normalità verificata mediante il test di Shapiro-Wilk e omogeneità della varianza valutata con il test F. Nota limitativa: i risultati dell'ELISA ottenuti da n = 3 repliche sono dati preliminari esplorativi, e una futura validazione con un campione di dimensioni maggiori è necessaria. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Disponibilità dei dati:
I sei dataset trascrittomici bulk e un dataset di sequenziamento dell'RNA monocellulare analizzati in questo studio sono disponibili pubblicamente nel database Gene Expression Omnibus con i numeri di accessione GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 e GSE145154. L'analisi monocellulare ha incluso i campioni GSM4307515, GSM4307516, GSM4307520 e GSM4307521 provenienti da GSE145154. Tutti gli altri dati generati o analizzati durante questo studio, insieme al codice computazionale, sono inclusi in questo articolo pubblicato e nei relativi file di informazioni supplementari. In particolare, File Supplementare 1 contiene gli elenchi completi dei geni legati all'invecchiamento e ai mitocondri, la firma immunitaria a 28 cellule, gli script analitici personalizzati, le matrici di dati trascrittomici normalizzati, i dati grezzi degli assay ELISA e i dati sorgente grezzi alla base di tutte le figure del manoscritto.
File Supplementare 1: Set di Geni Associati all'Invecchiamento e ai Mitochondri, Firme Immunitarie, Script di Analisi, Dati Trascrittomici Normalizzati e Dati Sorgente delle Figure. Cliccare qui per scaricare il file.
Discussione
Il flusso di lavoro integrato multilivello ha combinato meta-analisi trascrittomica su larga scala, costruzione di reti di co-espressione genica pesate, apprendimento automatico ensemble, validazione trascrittomica a singola cellula e verifica in vivo su modelli animali. Quattro geni centrali associati all'invecchiamento e ai mitocondri, CYBB, SERPINE1, TGFB2 e TLR2, sono stati identificati come biomarcatori diagnostici candidati per la cardiomiopatia dilatativa (DCM). L'integrazione di sei dataset trascrittomica del ventricolo sinistro indipendenti provenienti dal repository Gene Expression Omnibus, inclusi piattaforme di microarray e sequenziamento dell'RNA, ha ridotto il bias legato ai singoli dataset e aumentato la base statistica dell'analisi43,44,45. L'analisi delle reti pesate di co-espressione genica, combinata con set di geni mitocondriali e legati all'invecchiamento predefiniti, ha permesso di identificare moduli funzionali associati al tratto fenotipico, evitando di fare affidamento esclusivamente sull'analisi dell'espressione differenziale46. L'apprendimento automatico ensemble ha ridotto il bias specifico dell'algoritmo associato ai singoli metodi di selezione delle caratteristiche47,48, mentre l'analisi SHapley Additive exPlanations ha quantificato il contributo di ciascun gene centrale alle previsioni del modello49. La validazione su trascrittomi miocardici su larga scala, trascrittomi a singola cellula e un modello murino transgenico ha ulteriormente caratterizzato la distribuzione cellulare e i livelli proteici miocardici dei geni selezionati50.
La correzione del batch è stato un passaggio fondamentale nell'analisi integrata poiché le variazioni residue specifiche del dataset potrebbero influenzare l'analisi dell'espressione differenziale e le associazioni tra moduli e tratti. La provenienza del dataset e la piattaforma di rilevamento sono state quindi incluse come fattori di batch nel modello ComBat. Un raggruppamento residuo dipendente dal dataset nei grafici dell'analisi delle componenti principali indicherebbe una correzione incompleta e un potenziale bias sistematico44. Anche la potenza di soglia morbida (soft-thresholding) era importante per la costruzione della rete di co-espressione genica pesata. È stato selezionato il valore minimo che produceva un indice di adattamento alla topologia scale-free pari a R2 > 0,9, ottenendo β = 5. Un valore inferiore potrebbe produrre moduli frammentati o privi di significato funzionale, mentre un valore superiore potrebbe indebolire la connettività genica e ridurre la potenza statistica dell'analisi di correlazione tra moduli e tratti46. Le soglie di controllo qualità per singola cellula sono state adattate al tessuto cardiaco poiché i cardiomiociti presentano un'elevata attività metabolica. È stata implementata una strategia di filtraggio rigorosa con una soglia percentuale di geni mitocondriali inferiore al 25% e un intervallo di geni rilevati compreso tra 200 e 6.000 per rimuovere cellule rotte e di bassa qualità, mantenendo al contempo i cardiomiociti50. È stato utilizzato un seme casuale fisso, set.seed(12345), per la suddivisione del dataset, l'addestramento del modello e la validazione incrociata al fine di ridurre la variabilità tra analisi ripetute di apprendimento automatico47.
La conferma del genotipo, l'allevamento standardizzato e le misurazioni ecocardiografiche costanti sono state importanti per mantenere la stabilità fenotipica negli esperimenti sugli animali. I topi transgenici CTNTR141W sviluppano dilatazione del ventricolo sinistro e disfunzione sistolica dopo il periodo specificato di ambientamento e alimentazione51. È necessaria la verifica del genotipo prima del raggruppamento per escludere animali non transgenici e prevenire errori di classificazione fenotipica. Le misurazioni ecocardiografiche devono essere effettuate in modo costante a livello dei muscoli papillari del ventricolo sinistro, calcolando la media di tre cicli cardiaci stabili consecutivi. Le variazioni nella posizione di imaging o nella profondità dell'anestesia possono aumentare la variabilità delle misurazioni della frazione di eiezione del ventricolo sinistro51. La qualità del saggio immunoenzimatico (ELISA) è stata valutata mediante i coefficienti di correlazione della curva standard, con R2 ≥ 0,99, e coefficienti di variazione < 10% tra pozzetti duplicati. Una linearità scadente della curva standard o misurazioni duplicate non riproducibili possono introdurre errori sistematici nelle stime della concentrazione proteica.
Durante l'implementazione del flusso di lavoro possono sorgere diversi problemi analitici. Una separazione persistente tra i batch dopo la correzione con ComBat può indicare collinearità tra le variabili di batch e i fattori clinici, un filtraggio insufficiente dei geni a bassa espressione o una variazione tecnica non modellata. I covarianti clinici come età e sesso possono essere inclusi come variabili protette, se disponibili, e i geni con espressione nulla in più del 70% dei campioni possono essere rimossi per ridurre il rumore44. Una correzione supplementare con removeBatchEffect può essere presa in considerazione qualora persista una separazione residua. Un numero inaspettatamente elevato o ridotto di geni differenzialmente espressi potrebbe richiedere una valutazione dell'eterogeneità del campione, della normalizzazione, degli outlier e della scelta delle soglie27. Correlazioni basse tra modulo e tratto possono essere affrontate rivalutando la soglia di varianza, la potenza di soft-thresholding e i valori estremi del tratto. L'espansione da 5.000 a 7.500 geni con maggiore variabilità oppure la sostituzione dell'analisi di arricchimento di set di geni su singolo campione con l'analisi di variazione del set di geni può migliorare il rilevamento dei moduli46. Un numero eccessivo di nodi isolati nella rete di interazione proteina-proteina potrebbe richiedere un aggiustamento della soglia di confidenza di STRING o l'espansione dell'insieme di geni candidati30. Prestazioni scadenti nell'apprendimento automatico potrebbero riflettere differenze distribuzionali tra il set di addestramento e quello di validazione, ridondanza delle caratteristiche o squilibrio tra i gruppi. Campionamento stratificato, riduzione delle caratteristiche ridondanti o oversampling della classe minoritaria possono ridurre tali effetti47. Un clustering ambiguo a singola cellula potrebbe richiedere una rivalutazione della correzione con Harmony, della selezione delle componenti principali e dell'annotazione dei geni marcatore50.
Vanno considerate diverse limitazioni. I dataset trascrittomici sono stati ottenuti in modo retrospettivo da archivi pubblici, e non è stato possibile controllare i disegni originali degli studi né i fattori confondenti clinici. Le annotazioni cliniche erano incomplete tra i diversi dataset, e la maggior parte di essi non includeva informazioni dettagliate sull'eziologia, sulla storia farmacologica, sull'età dei pazienti e sugli esiti a lungo termine. Queste limitazioni hanno impedito la valutazione delle associazioni tra i geni selezionati e la prognosi, la risposta al trattamento o l'invecchiamento cronologico52. Potrebbe inoltre persistere una variabilità tecnica residua nonostante la correzione per batch. L'analisi si è basata principalmente sull'espressione dell'RNA messaggero e non ha incluso dati integrati di epigenomica, proteomica o metabolomica. Di conseguenza, non è stato possibile determinare l'attività proteica, la regolazione post-traduzionale e i meccanismi a monte. È stato incluso un solo dataset a singola cellula, il che ha limitato la valutazione dell'eterogeneità cellulare tra le diverse eziologie della miocardiopatia dilatativa50. Il modello transgenico CTNTR141W rappresenta principalmente la forma ereditaria della miocardiopatia dilatativa associata a una mutazione della troponina T cardiaca e potrebbe non riprodurre le forme idiopatiche, virali o ischemiche della malattia51. Le differenze tra specie nei topi e negli esseri umani limitano inoltre la traducibilità diretta in ambito clinico. La validazione a livello proteico si è limitata al tessuto miocardico di topi, e non sono stati effettuati studi su ampie coorti cliniche né confronti con biomarcatori consolidati. I quattro geni hub non sono specifici per la miocardiopatia dilatativa e potrebbero essere alterati anche in altre condizioni cardiovascolari o infiammatorie. Inoltre, la selezione dei candidati si è basata su set genici mitocondriali e legati all'invecchiamento predefiniti. Questa strategia ipotetica potrebbe escludere geni al di fuori dei set di riferimento selezionati, mentre l'intersezione tra tre algoritmi di apprendimento automatico potrebbe omettere geni identificati da un solo metodo48.
Il framework analitico potrebbe supportare futuri studi di sottotipizzazione molecolare, validazione di biomarcatori e studi multi-omici nella miocardiopatia dilatativa (DCM). Il pannello di quattro geni potrebbe essere valutato in coorti indipendenti di sangue periferico o miocardio prima della sua valutazione come strumento diagnostico o di sottotipizzazione. I sottotipi C1 e C2 hanno mostrato profili diversi nei percorsi immunitari e metabolici, fornendo una base per la successiva validazione di caratteristiche biologiche specifiche dei sottotipi15. I geni selezionati potrebbero inoltre essere esaminati in studi di docking molecolare, cellulari e funzionali. TLR2 e CYBB sono associati alla segnalazione infiammatoria e alla produzione di specie reattive dell'ossigeno, mentre TGFB2 e SERPINE1 sono associati alla fibrosi e al rimodellamento cardiaco53. L'integrazione con dati proteomici, metabolomici, epigenomici, di associazione su scala genomica e di randomizzazione mendeliana potrebbe aiutare a valutare le relazioni regolatorie e le possibili associazioni causali54. Il flusso di lavoro potrebbe inoltre essere adattato a studi trascrittomica della miocardiopatia ipertrofica, della miocardiopatia ischemica e dell'insufficienza cardiaca sostituendo i set di dati specifici della malattia e i set di geni di riferimento45. L'eventuale integrazione futura di saggi single-cell per la sequenza del cromatina accessibile alla transposasi e della trascrittomica spaziale potrebbe fornire ulteriori informazioni sulla regolazione cellulare e sull'espressione spaziale. L'arricchimento osservato di firme legate all'invecchiamento nei macrofagi e di firme mitocondriali nei cardiomiociti era coerente con precedenti rapporti sui processi infiammatori e mitocondriali nelle malattie cardiache55,56,57.
Questo studio presenta diverse limitazioni che dovrebbero essere riconosciute. In particolare, i kit ELISA commerciali utilizzati per la quantificazione delle proteine sono stati ufficialmente validati per il rilevamento delle proteine bersaglio in campioni di siero. Nel presente studio, invece del siero, è stata adottata come matrice di rilevamento la lisati di tessuto miocardico. Sebbene siano state rigorosamente applicate procedure di pretrattamento dei campioni e di esecuzione sperimentale uniformi per garantire l'affidabilità e la confrontabilità dei dati sperimentali, l'assenza di una validazione ufficiale da parte del produttore per l'uso di questi kit ELISA su campioni di lisati di tessuto miocardico potrebbe determinare lievi deviazioni nei risultati quantitativi delle proteine. Pertanto, l'utilizzo di kit ELISA specifici per il siero su lisati di tessuto miocardico rappresenta una limitazione metodologica del presente studio.
Dichiarazioni
L'autore dichiara di non avere interessi concorrenti.
Ringraziamenti
Si ringraziano per i dati pubblicamente disponibili forniti attraverso il database Gene Expression Omnibus. Si ringraziano inoltre i revisori e gli editori per i loro commenti costruttivi sul manoscritto. Questo lavoro è stato sostenuto dal Progetto Scientifico di Ricerca a Livello Provinciale (Grant No. 2021JDZX2026), “Meccanismo della Formula Yiqi Huoxue nell'Attenuare il Rimodellamento Vascolare Aterosclerotico mediante la Regolazione Infiammatoria mediata da KLF2-Nrf2”.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Gel ecografico Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | Utilizzato per l'imaging ecocardiografico in piccoli animali. |
| Kit per saggio BCA delle proteine | Thermo Fisher Scientific | 23227 | Rilevamento a 562 nm; intervallo, 20–2.000 µg/mL; utilizzato per la quantificazione totale delle proteine nei lisati cardiaci di topo. |
| Database CellAge | Risorse genomiche per l'invecchiamento umano | https://genomics.senescence.info/cells/ | Fonte di firme geniche correlate all'invecchiamento. |
| CytoHubba, plugin per Cytoscape | Negozio di applicazioni Cytoscape | Versione 0.1 | Utilizzato per il punteggio topologico dei nodi nelle reti di interazione proteina-proteina. |
| Cytoscape | Consorzio Cytoscape | Versione 3.9.1 | Utilizzato per la visualizzazione delle reti di interazione proteina-proteina. |
| Lettore a microplacca a spettro completo | Thermo Fisher Scientific | Multiskan FC | Utilizzato per misurare l'assorbanza nei saggi ELISA. |
| Gene Expression Omnibus | Centro nazionale per le risorse di biotecnologia | https://www.ncbi.nlm.nih.gov/geo/ | Repositorio pubblico utilizzato per ottenere set di dati trascrittomici. |
| GeneCards | Istituto Weizmann di Scienze | https://www.genecards.org/ | Fonte di set genici mitocondriali. |
| Cocktail inibitore di proteasi e fosfatasi Halt, 100×, privo di EDTA | Thermo Fisher Scientific | 78441 | Conservato a 4 °C; aggiunto al buffer RIPA a 10 µL/mL immediatamente prima dell'uso. |
| Azoto liquido | Fornitore locale di gas per laboratorio | Non applicabile | Utilizzato per il congelamento rapido del tessuto miocardico. |
| Topi maschi C57BL/6J di grado SPF, 6–8 settimane di età, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Non applicabile | Numero di licenza per la produzione di animali da laboratorio SCXK (Jing) 2021-0006; utilizzati come controlli normali. |
| Topi maschi transgenici DCM CTNTR141W di grado SPF, 6–8 settimane di età, 25 ± 2 g | Istituto di Scienze degli Animali da Laboratorio, Accademia cinese delle scienze mediche | Non applicabile | Numero di licenza per la produzione di animali da laboratorio SCXK (Jing) 2021-0065; utilizzati come modello spontaneo di miocardiopatia dilatativa (DCM). |
| MCODE, plugin per Cytoscape | Negozio di applicazioni Cytoscape | Versione 2.0.2 | Utilizzato per identificare le sottoreti funzionali principali nelle reti di interazione proteina-proteina. |
| Kit ELISA per CYBB murino | Biogradetech | A-QEK09250-96wells | Utilizzato in questo studio per misurare CYBB nei lisati di tessuto miocardico murino. |
| Kit ELISA per PAI-1 murino | EK-BIO | ML30970 | Utilizzato in questo studio per misurare PAI-1, la proteina codificata da SERPINE1, nei lisati di tessuto miocardico murino. |
| Kit ELISA per TGF-β2 murino | ElaBoX | SEKM-0036 | Utilizzato in questo studio per misurare TGF-β2 nei lisati di tessuto miocardico murino. |
| Kit ELISA per TLR-2 murino | Solarbio | SEKM-0163 | Utilizzato in questo studio per misurare TLR-2 nei lisati di tessuto miocardico murino. |
| Soluzione salina tamponata al fosfato, pH 7,4, priva di calcio e magnesio | Biological Industries | 02-024-1ACS | Soluzione sterile 1×; conservata a 4 °C; utilizzata per il lavaggio e la diluizione del tessuto. |
| Pacchetto R: caret | CRAN | Versione 6.0-94 | Utilizzato per l'eliminazione ricorsiva delle caratteristiche mediante macchina a vettori di supporto. |
| Pacchetto R: CellChat | Sviluppatori di CellChat | Versione 1.6.1 | Utilizzato per l'inferenza delle comunicazioni intercellulari dai dati di sequenziamento dell'RNA a singola cellula. |
| Pacchetto R: clusterProfiler | Bioconductor | Versione 4.8.3 | Utilizzato per l'analisi di arricchimento funzionale. |
| Pacchetto R: ConsensusClusterPlus | Bioconductor | Versione 1.64.0 | Utilizzato per il clustering consensuale non supervisionato. |
| Pacchetto R: edgeR | Bioconductor | Versione 3.42.4 | Utilizzato per la normalizzazione dei dati di sequenziamento dell'RNA con il metodo della media trimmata dei valori M. |
| Pacchetto R: GEOquery | Bioconductor | Versione 2.68.0 | Utilizzato per scaricare dati dal Gene Expression Omnibus. |
| Pacchetto R: glmnet | CRAN | Versione 4.1-8 | Utilizzato per la regressione logistica con operatore di riduzione e selezione assoluta minima. |
| Pacchetto R: limma | Bioconductor | Versione 3.56.2 | Utilizzato per l'analisi dell'espressione differenziale e la modellizzazione statistica. |
| Pacchetto R: pROC | CRAN | Versione 1.18.5 | Utilizzato per l'analisi della curva ROC (caratteristica operativa del ricevitore). |
| Pacchetto R: randomForest | CRAN | Versione 4.7-1.2 | Utilizzato per l'apprendimento automatico con alberi decisionali casuali (random forest). |
| Pacchetto R: Seurat | CRAN | Versione 5.0.1 | Utilizzato per l'analisi dei dati di sequenziamento dell'RNA a singola cellula. |
| Pacchetto R: SingleR | Bioconductor | Versione 2.2.0 | Utilizzato per l'annotazione automatica dei tipi cellulari. |
| Pacchetto R: sva | Bioconductor | Versione 3.48.0 | Utilizzato per la correzione degli effetti di batch con ComBat. |
| Centrifuga refrigerata | Sigma-Aldrich | SIGMA 3-K | Utilizzata per la centrifugazione dei lisati di tessuto miocardico. |
| Buffer di lisi ed estrazione RIPA | Thermo Fisher Scientific | 89900 | Soluzione pronta all'uso 1×; conservata a 4 °C; integrata con inibitori di proteasi e fosfatasi prima dell'uso. |
| Sistema di imaging ecografico per piccoli animali | VINNO Technology Co., Ltd. | VINN06LAB | Utilizzato per la valutazione ecocardiografica della funzione cardiaca. |
| Pentobarbital sodico | Sinopharm Chemical Reagent Co. | 20040428 | Preparato come soluzione al 1%, 10 mg/mL, in soluzione salina sterile; utilizzato per l'anestesia intraperitoneale a 30 mg/kg. |
| Database STRING | Consorzio STRING | Versione 11.5 | Utilizzato per la costruzione di reti di interazione proteina-proteina. |
| Omogeneizzatore tissutale TGrinder H24 | TIANGEN | OSE-TH-01 | Utilizzato per omogeneizzare il tessuto miocardico murino nel buffer RIPA a 6,0 m/s per 30–60 s in 2–3 cicli. |
| Piattaforma termoregolata/tavolo operatorio riscaldato per piccoli animali | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Utilizzata per mantenere i topi a 37 °C durante l'ecocardiografia; intervallo operativo, da temperatura ambiente a 50 °C. |
Riferimenti
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740