Questo studio presenta RareCode, un framework di apprendimento profondo non supervisionato che rileva anomalie nelle immagini istopatologiche del cancro del colon-retto analizzando la rarità di attivazione del codice (CAR), con la potenzialità di assistere il pre-screening senza l'uso di dati di addestramento etichettati.
Articolo di ricerca
RareCode: Un framework di deep learning non supervisionato per il rilevamento di anomalie in immagini istopatologiche di cancro colorettale
In questo articolo
Sommario
Abstract
Il rilevamento non supervisionato di anomalie nelle immagini istopatologiche è stato ampiamente studiato mediante approcci basati sulla ricostruzione che misurano gli errori di ricostruzione, tuttavia tali metodi spesso non riescono a cogliere variazioni patologiche sottili a livello semantico a causa dell'eterogeneità intrinseca delle trame dei tessuti. Per affrontare questa limitazione, questo studio presenta RareCode, un framework basato sulla quantizzazione vettoriale che estende il paradigma di rilevamento oltre la ricostruzione a livello di pixel, incorporando un'analisi delle attivazioni del codice semantico. L'innovazione principale è il punteggio di rarità dell'attivazione del codice (CAR, Codebook Activation Rarity), che profila la frequenza di attivazione di ciascuna voce del codice durante l'addestramento esclusivamente su campioni normali e segnala le attivazioni infrequenti come indicatori di anomalie nel momento dell'inferenza, integrando così gli errori di ricostruzione con una discriminazione a livello semantico. Sulla base di questo meccanismo CAR a singola scala, viene ulteriormente introdotto un modulo di codice gerarchico multi-scala (MHC, Multi-scale Hierarchical Codebook), che utilizza codici di dimensioni variabili con pesi di fusione apprendibili per catturare modelli patologici che spaziano da strutture grossolane a livello di tessuto a dettagli fini a livello cellulare. Sfruttando la progettazione multi-scala, vengono generate mappe termiche gerarchiche di anomalie per ogni granularità del codice, fornendo ai patologi indizi visivi interpretabili e multidimensionali che indicano sia la posizione sia il livello strutturale in cui si verificano le anomalie. Una validazione incrociata a cinque ripetizioni su un dataset di immagini istopatologiche di cancro del colon-retto clinicamente annotate, ottenuto dall'Ospedale Popolare di Shenzhen, dimostra che RareCode raggiunge un'area sotto la curva (AUC) del 96,82%, superando i metodi di base. L'analisi per classe ha mostrato prestazioni migliori nel rilevamento del cancro (AUC = 99,44%, specificità = 94,21%) rispetto al rilevamento dell'infiammazione (AUC = 94,30%, specificità = 60,44%). Questi risultati suggeriscono che l'analisi CAR potrebbe offrire un approccio non supervisionato promettente per il rilevamento di anomalie istopatologiche, potenzialmente utile per lo screening clinico preliminare nella diagnosi del cancro del colon-retto.
Introduzione
Il screening istopatologico affidabile per il cancro del colon-retto rimane limitato dalla necessità di annotazioni effettuate da esperti e dalla revisione manuale, specialmente quando lesioni infiammatorie e neoplasie mostrano una morfologia sovrapposta1,2. Queste limitazioni spingono verso approcci computazionali non supervisionati, in grado di apprendere dal tessuto normale senza richiedere annotazioni complete di anomalie3,4.
L'urgenza clinica dello screening istopatologico automatizzato è evidenziata dal crescente squilibrio tra la domanda diagnostica e la disponibilità di esperti in anatomia patologica, con il carico di lavoro diagnostico per patologo negli Stati Uniti aumentato di oltre il 40% in un solo decennio mentre il numero di patologi continua a diminuire5. Nel cancro del colon-retto (CRC), i programmi organizzati di screening sono stati associati a riduzioni della mortalità comprese tra il 29% e il 68%6, tuttavia la capacità di revisione patologica manuale rimane limitata dalla disponibilità di personale specializzato. Un sistema automatizzato di pre-screening in grado di identificare in modo affidabile i casi sospetti per una revisione prioritaria potrebbe contribuire ad alleviare questo carico e migliorare i tempi di risposta diagnostica. Tuttavia, l'implementazione di tali sistemi richiede un'elevata sensibilità per evitare di non rilevare veri positivi e una specificità adeguata per prevenire un eccesso di falsi allarmi7.
Il rilevamento automatico di anomalie (UAD) ha assunto un'importanza crescente nell'analisi delle immagini mediche8 poiché è in grado di modellare le distribuzioni dei tessuti normali senza richiedere etichette di addestramento per casi anomali3,9,10. I modelli basati sulla ricostruzione, tra cui autoencoder, autoencoder variazionali, reti generative avversarie e varianti potenziate con memoria, identificano le anomalie attraverso gli errori di ricostruzione, ma i decoder ad alta capacità possono comunque ricostruire le regioni anomale con elevata fedeltà11,12,13,14,15,16,17. I metodi basati sulle caratteristiche, come PatchCore e PaDiM, utilizzano rappresentazioni preaddestrate, anche se le caratteristiche apprese da immagini naturali potrebbero non cogliere appieno le atipie microscopiche in istopatologia18,19,20,21. I modelli fondamentali specifici per la patologia e i rilevatori di anomalie basati sulla diffusione offrono alternative potenti, ma i loro requisiti di dati o i costi computazionali potrebbero limitarne l'uso diretto nello screening ad alto rendimento22,23. Metodi recenti automatizzati ed evolutivi, come EvoAAE24 e MoARNN-AM25, illustrano ulteriormente il valore dell'ottimizzazione adattativa del modello per il rilevamento delle anomalie, sebbene i loro contesti applicativi differiscano dall'analisi delle immagini istopatologiche. Al contrario, i metodi basati sulla quantizzazione vettoriale (VQ) impongono vincoli discreti di codebook che possono ridurre il mapping identitario; tuttavia, gli approcci VQ esistenti si basano ancora principalmente sugli errori di ricostruzione spaziale e sfruttano in modo insufficiente le informazioni semantiche contenute nei modelli di attivazione del codebook26,27.
Sebbene i metodi sopra menzionati dimostrino prestazioni promettenti in domini generali, la loro applicazione a scenari istopatologici complessi incontra sfide specifiche. Le immagini istopatologiche sono caratterizzate da un'eterogeneità tissutale complessa su più livelli strutturali28. In pratica, l'analisi delle immagini opera tipicamente su porzioni locali estratte da sezioni di tessuto, e la diagnosi patologica è intrinsecamente multiscale: i patologi valutano la morfologia ghiandolare e tissutale a basso ingrandimento, mentre esaminano il pleomorfismo nucleare e le figure mitotiche ad alto ingrandimento29. Identifichiamo tre limitazioni principali degli attuali approcci: in primo luogo, le anomalie patologiche e i tessuti normali mostrano un'elevata somiglianza nelle caratteristiche visive di basso livello, come gli stili di colorazione e le texture locali, causando il fallimento dei metodi basati sulla ricostruzione nel rilevare anomalie sottili, poiché sia i campioni normali che quelli anomali possono produrre una qualità di ricostruzione simile a livello semantico. In secondo luogo, la maggior parte dei metodi esistenti impiega un'estrazione delle caratteristiche a singola scala, rendendo difficile catturare simultaneamente le caratteristiche anomale a livello tissutale e cellulare30,31. In terzo luogo, sebbene i metodi principali possano generare mappe di calore a livello di pixel, spesso non riescono a rappresentare in modo intuitivo gli attributi gerarchici delle anomalie, limitando l'utilità di tali modelli come ausili diagnostici clinici.
Per affrontare le sfide sopra menzionate, proponiamo RareCode, un framework UAD che esplora i modelli di attivazione del codebook e la rappresentazione gerarchica delle caratteristiche a più livelli di astrazione. Il framework introduce tre componenti principali: (1) Meccanismo di Assegnazione del Punteggio di Rarità dell'Attivazione del Codebook (CAR), che calcola punteggi di rarità in base alle frequenze di attivazione delle voci, addestrate esclusivamente su campioni normali, distinguendo campioni normali da campioni anomali a livello semantico e fornendo segnali discriminatori complementari rispetto agli errori tradizionali di ricostruzione spaziale. (2) Architettura di Fusione del Codebook Gerarchico Multiscalare (MHC), che cattura caratteristiche patologiche a diversi livelli di granularità — dai modelli strutturali grossolani ai dettagli cellulari fini — impiegando codebook con capacità variabili, con una fusione adattativa ottenuta attraverso pesi apprendibili. (3) Modulo di Localizzazione Gerarchica Interpretabile, che sfrutta l'architettura multiscala per generare mappe di calore delle anomalie a diverse granularità, fornendo ai patologi riferimenti diagnostici semantici interpretabili a più scale.
L'ipotesi principale di questo studio era che i profili di frequenza di attivazione dei codici, derivati da codici addestrati esclusivamente su immagini istopatologiche normali del colon-retto, avrebbero codificato informazioni semantiche rilevanti per l'anomalia al di là dell'errore di ricostruzione a livello di pixel, e che l'integrazione multiscala di questi segnali complementari avrebbe migliorato la capacità di discriminare immagini contenenti tessuto canceroso o infiammatorio da immagini normali rispetto ai metodi rappresentativi di UAD, valutata principalmente tramite AUC. Per verificare questa ipotesi, abbiamo valutato RareCode mediante una cross-validation a 5 ripetizioni su un dataset CRC clinicamente annotato ed eseguito analisi di ablazione e di localizzazione per esaminare i contributi e l'interpretabilità dei suoi componenti principali.
Protocollo
This study was approved by the Clinical Research Ethics Committee of Shenzhen People's Hospital (Approval No. LL-KY-2025300-01). The requirement for informed consent was waived by the ethics committee because this retrospective study used existing histopathological images and clinical materials without direct patient contact or intervention. All clinical data and histopathological images were de-identified before analysis, and no personally identifiable information was used in this study. All data used in this research were handled in accordance with the ethical standards of the institutional and national research committees.
Framework overview
The overall architecture of the proposed UAD framework, RareCode, is illustrated in Figure 1. The framework employs a parallel dual-branch architecture. For each 512 x 512 input image, non-overlapping 32 x 32 and 64 x 64 patches are extracted as fine- and coarse-scale inputs, respectively. The 64 x 64 patches are resized to 32 x 32 before being passed to the network so that both branches share the same encoder-decoder input size while preserving different receptive fields. Encoders in each branch map the extracted features into a latent space, where the MHC module imposes discretization constraints. Subsequently, decoders reconstruct the image from quantized features to compute spatial-domain reconstruction errors. The CAR mechanism then measures the degree of semantic-level anomaly by profiling codebook activation frequencies. Finally, the model fuses reconstruction scores and CAR scores through a weighted combination to obtain image-level anomaly scores. The RareCode framework is trained end-to-end using only normal samples, requiring no anomaly annotations. The dual-branch design was used to capture both local cellular features and broader glandular structures. The MHC module was used to model these features with codebooks of different capacities.
Encoder-decoder architecture
RareCode constructs structurally independent encoders and decoders for the fine- and coarse-scale branches. Each branch uses the same encoder-decoder design but does not share parameters. The encoder consists of four convolutional blocks, each including a 3 x 3 convolution, batch normalization, ReLU activation, and dropout. The channel width increases from 64 to 128, then to 256, and the final feature map is flattened and projected into a 64-dimensional latent embedding. The decoder mirrors the encoder with a fully connected projection layer followed by four transposed convolution layers, reconstructing each patch to the original input size of the network. Reconstruction error is calculated as the mean squared error between the input and reconstructed patches. By combining this encoder-decoder structure with discrete codebook constraints, RareCode learns compact representations of normal tissue and measures deviations during inference.
Multi-scale hierarchical codebook
To capture pathological features at multiple levels of abstraction—from broad tissue patterns to localized cellular variations—the MHC module employs K discrete codebooks  with varying capacities n1, n2, ..., nK. In the final FourScales configuration, each branch contains four codebooks with 64, 128, 256, and 512 entries, respectively, and each codebook entry has a 64-dimensional embedding. For each encoded patch feature, the nearest codebook entry is selected according to Euclidean distance. The quantized outputs from different codebooks are then fused using learnable weights normalized across codebooks. Smaller codebooks, due to stronger compression constraints, are expected to encode coarse-grained prototypical patterns that abstract away local variations, whereas larger codebooks preserve finer-grained features that capture more specific structural characteristics. For each codebook
 , where ek(i)
 Rd denotes the i-th embedding vector in the k-th codebook, continuous features are mapped to the discrete codebook space via nearest neighbor lookup (Eq. 1 and 2):
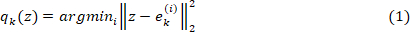

To achieve adaptive fusion of multi-scale features, we introduce learnable weights . After softmax normalization, weighted summation is performed over the quantized outputs from each codebook (Eq. 3):
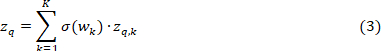
where σ(·) denotes the softmax function, ensuring that weights satisfy Σk σ(wk) = 1. This design enables the model to automatically adjust the contribution ratios of codebooks at different granularities based on the semantic content of the input features.
To optimize codebook learning, we adopt the standard VQ loss function (Eq. 4):
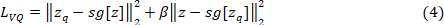
where sg[·] denotes the stop-gradient operation, and β = 0.25 is the commitment loss weight coefficient. The first term encourages codebook vectors to move toward encoder outputs, while the second term encourages encoder outputs to remain consistent with their corresponding codebook vectors. The complete mechanism of multi-scale VQ is illustrated in Figure 2.
Codebook activation rarity scoring
CAR measures semantic-level anomalies based on codebook activation statistics estimated from normal training samples. After model training, all normal training images were passed through the encoder and MHC module without data augmentation. For each branch and each codebook, the assignment index of every patch feature was recorded, and the number of assignments to each codebook entry was counted. The counts were then normalized to obtain the activation-frequency distribution for that codebook (Eq. 5):

During inference, each test image was processed through the same patch extraction, encoding, and nearest-neighbor codebook assignment procedure. For each assigned codebook entry, the rarity score is calculated as the negative logarithm of its activation frequency in the normal training set (Eq. 6):

where ε is a small constant used for numerical stability. A low-frequency codebook entry, therefore, receives a higher rarity score, suggesting that the corresponding patch feature is less consistent with the learned normal-tissue distribution. Patch-level rarity scores were averaged within each image and across the fine- and coarse-scale branches to obtain an image-level rarity response.
To complement activation-frequency rarity, we also compute a percentile-based quantization distance score (Eq. 7):
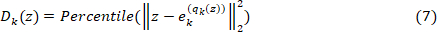
This score is derived from the Euclidean distance between each encoded feature vector and its nearest codebook entry. The distance distribution is estimated from normal training samples, and test-sample distances are converted into percentile scores. Larger percentile scores indicate that the encoded feature is more difficult to represent using the learned normal codebook prototypes.
The final CAR score combines activation rarity and quantization distance across all codebooks using the learnable codebook weights (Eq. 8):
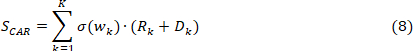
The same normalized codebook weights used for multi-scale feature fusion are applied to score-level fusion, maintaining consistency between representation learning and anomaly scoring. The resulting CAR score is calculated at the image level and is then combined with the reconstruction score to obtain the final anomaly score. The overall CAR scoring mechanism is illustrated in Figure 3.
Final anomaly score computation
We fuse spatial-domain reconstruction errors with semantic-level CAR scores. Before fusion, both scores are separately normalized using percentile-based min-max normalization to reduce the influence of extreme outliers. The final image-level anomaly score is then defined as (Eq. 9):
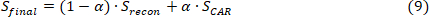
where Srecon denotes the normalized mean squared reconstruction error, reflecting sample reconstruction quality in pixel space; SCAR is the CAR score described above, capturing degrees of semantic-level anomaly. The hyperparameter α [0,1] controls the relative weighting between the two components, with optimal values determined on validation sets.
Training objective
The RareCode framework is trained end-to-end using only normal samples. The total training loss comprises the following components (Eq. 10):

Each term is defined as follows: Reconstruction Loss: 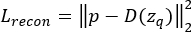 , measuring the mean squared error between input patches p and reconstructed patches D(zq) after quantization. This loss is applied separately to the 32 × 32 patch branch (
 ) and 64 × 64 patch branch (
 ) to ensure effective learning of features at both spatial scales.
Dataset description
To evaluate RareCode, experiments were conducted on a clinically annotated CRC histopathological image dataset comprising images of colorectal tissue sections stained with hematoxylin and eosin (H&E), obtained from Shenzhen People's Hospital. All images in this dataset originate from real clinical cases. Images were digitized at 40x magnification with an original resolution of 1024 × 1024 pixels. To ensure annotation reliability and quality, all sample category labels were jointly reviewed and confirmed by two or more senior professional pathologists following a double-blind protocol.
Based on histopathological characteristics, the dataset was categorized into three classes: normal tissue (1,226 images), cancer (1,215 images), and inflammation (1,214 images). In the binary UAD setting, cancer and inflammation samples were treated as anomalous, while normal samples served as the reference distribution. This formulation reflects the intended triage task of separating cases requiring further pathological review from those that are morphologically normal.
All H&E-stained images were resized to 512 × 512 pixels before being used as network input. Stratified 5-fold cross-validation was used for evaluation. In each fold, the normal samples were first divided into training, validation, and held-out test subsets. RareCode was trained only on the training normal samples. The validation subset, which also contained only normal samples, was used for model selection, hyperparameter tuning, and selection of the fusion weight α. The held-out test set, consisting of unseen normal samples and anomalous samples including cancer and inflammation, was used only for final performance evaluation and was not used for model training, hyperparameter selection, or α selection. The representative categories, dataset structure, and validation protocol are shown in Figure 4.
Implementation details
The proposed RareCode framework and comparison baselines were implemented using PyTorch. All experiments were conducted on a workstation equipped with a single NVIDIA GeForce RTX 4060 Ti GPU (16 GB). For network architecture configuration, to capture features at different spatial extents, the dual-branch architecture processes non-overlapping patches at two scales: 32 × 32 pixels (smaller receptive field, capturing local texture patterns) and 64 × 64 pixels (larger receptive field, capturing broader spatial context), respectively. The continuous feature embedding dimension produced by both branch encoders is uniformly set to 64. In the MHC module, we configure four codebooks with different capacities for each branch, with discrete prototype quantities of 64, 128, 256, and 512, respectively.
During optimization, the network was trained end-to-end for 50 epochs with a batch size of 8. We employ the AdamW optimizer for weight updates, with an initial learning rate of 5 × and weight decay of to prevent overfitting. Additionally, to ensure smooth training convergence, a cosine annealing learning rate schedule was used, enabling finer optimization in later training stages. Patch sizes and codebook sizes were selected to balance multi-scale representation and computational cost. The final FourScales configuration was supported by ablation analysis, and α was selected on the validation set before test-set evaluation.
For the decoder-complexity ablation, a complex-decoder variant was implemented based on the FourScales configuration. This variant used the same data split, codebook sizes, training epochs, optimizer, learning rate, validation-based α selection, and evaluation metrics as the FourScales model. The basic decoder was replaced with an EMCAD-style decoder containing multi-scale depthwise convolution blocks and Convolutional Block Attention Modules (CBAM). After each of the first three transposed-convolution upsampling stages, parallel 3 × 3, 5 × 5, and 7 × 7 depthwise convolutions were applied, followed by 1 × 1 pointwise fusion, batch normalization, ReLU activation, a residual connection, and CBAM attention. CBAM included channel attention based on average- and max-pooling descriptors and spatial attention using a 7 × 7 convolution. The final stage used transposed convolution and sigmoid activation to reconstruct 32 × 32 patches.
Risultati
Confronto con i metodi di base
Per valutare il framework RareCode, sono stati selezionati diversi metodi rappresentativi di UAD come basi di confronto, comprendendo metodi basati sulla ricostruzione (CAE32, VAE12, SAE33, MAE34, PatchSAE35), ricostruzione con memoria aumentata (MemAE36), distillazione della conoscenza (STFPM37), generazione sintetica di anomalie (DRAEM38) ed estrazione di caratteristiche preaddestrate (PatchCore18). La selezione dei metodi di base si è concentrata su approcci addestrabili o applicabili con budget computazionali e assunzioni sui dati comparabili (accesso esclusivamente a campioni normali non etichettati per l'addestramento), garantendo così che le differenze di prestazione riflettano contributi metodologici piuttosto che disparità nella scala dei dati di preaddestramento. Per assicurare un confronto equo, tutti i metodi sono stati valutati utilizzando le stesse suddivisioni dei dati in 5 gruppi, la stessa pipeline di preelaborazione, le stesse metriche di valutazione e lo stesso ambiente computazionale. I modelli sono stati addestrati seguendo lo stesso protocollo UAD utilizzando soltanto campioni normali per l'addestramento, con iperparametri e soglie selezionati sul set di validazione e le prestazioni finali valutate esclusivamente sul set di test trattenuto. Tabella 1 riassume i risultati della validazione incrociata in 5 gruppi, mentre Figura 5 fornisce confronti sotto forma di grafici radar multimetrichi.
Come mostrato in Tabella 1 e Figura 5, RareCode raggiunge prestazioni di rilevamento favorevoli e una stabilità statistica elevata nel dataset CRC. In termini di AUC, RareCode (96,82 ± 0,23%) supera diversi modelli di base basati sulla ricostruzione, inclusi MemAE (94,97 ± 0,81%). L'analisi statistica conferma che RareCode supera tutti i modelli di riferimento basati sulla ricostruzione (test t appaiati, p < 0,05), con un miglioramento rispetto a MemAE che raggiunge la significatività statistica (p < 0,01). RareCode mostra una bassa varianza di prestazione (deviazione standard dello 0,23%), indicativa di una stabilità costante tra le diverse suddivisioni incrociate. L'efficacia limitata di DRAEM, basato su anomalie sintetiche, probabilmente riflette il fatto che semplici strategie di sovrapposizione di texture non riescono a simulare adeguatamente l'atipia patologica complessa.
Per quanto riguarda la specificità, RareCode raggiunge un valore del 58,24 ± 5,99%, superando tutti i metodi di confronto nella riduzione dei tassi di falsi positivi. Questo risultato rappresenta un miglioramento di circa 25 punti percentuali rispetto al modello di riferimento basato esclusivamente sulla ricostruzione (NoCAR, 33,76%), dimostrando il contributo del meccanismo CAR nella riduzione dei falsi positivi. La specificità più bassa di STFPM e PatchCore, che si basano su caratteristiche preaddestrate su immagini naturali, potrebbe riflettere parzialmente il divario tra i domini delle immagini naturali e quelle istopatologiche. Da notare che STFPM e DRAEM mostrano una varianza elevata nella specificità (±33,53% e ±7,09%), con valori di specificità per ciascun fold compresi tra livelli prossimi allo zero e livelli moderati, sollevando preoccupazioni riguardo all'affidabilità del loro utilizzo pratico.
Prestazioni di rilevamento per classe
L'analisi per classe è stata condotta confrontando separatamente i campioni di cancro e di infiammazione con i campioni normali (Tabella 2). RareCode ha ottenuto prestazioni superiori nel rilevamento del cancro (AUC = 99,44 ± 0,12%, recall = 98,13 ± 0,29%, specificità = 94,21 ± 2,22%) rispetto al rilevamento dell'infiammazione (AUC = 94,30 ± 0,44%, recall = 96,55 ± 0,78%, specificità = 60,44 ± 4,34%). Questi risultati suggeriscono che RareCode possa mostrare una maggiore capacità discriminatoria per anomalie maligne rispetto a modificazioni infiammatorie, mentre il confine tra infiammazione e stato normale sembra contribuire in modo significativo alla ridotta specificità complessiva.
Studio di ablazione
Per analizzare i contributi dei componenti chiave all'interno del framework RareCode, sono stati condotti esperimenti di ablazione al fine di valutare l'impatto del meccanismo CAR e del modulo MHC sulle prestazioni di rilevamento. I risultati sono riportati in Tabella 3. Come mostrato in Figura 6A, l'aggiunta di CAR al baseline basato esclusivamente sulla ricostruzione ha migliorato l'AUC dal 92,81% al 95,92%, e la fusione del codebook a più scale ha ulteriormente aumentato l'AUC al 96,82%. Figura 6B mostra che il CAR ha migliorato anche la specificità, aumentandola dal 33,76% del baseline NoCAR al 58,24% nel modello completo FourScales. Questi risultati confermano il valore complementare della rarità nell'attivazione del codebook e della fusione a più scale.
Inoltre, è stata effettuata un'analisi di ablazione relativa alla complessità del decodificatore utilizzando la configurazione FourScales. Come mostrato nella Tabella 3, la variante con decodificatore complesso, dotata di blocchi di convoluzione depthwise multi-risoluzione e moduli di attenzione basati su convoluzioni (CBAM), ha ottenuto un AUC inferiore rispetto al modello FourScales di base (95,17 ± 0,44% contro 96,82 ± 0,23%). Questo risultato suggerisce che, nell'ambito dell'attuale impostazione RareCode basata su VQ-AE, l'aumento della capacità del decodificatore non ha migliorato le prestazioni nel rilevamento delle anomalie e potrebbe ridurre l'efficacia della rappresentazione vincolata dalla codebook.
Analisi gerarchica della risposta spaziale
Per esaminare le risposte spaziali generate da RareCode, gli errori di ricostruzione a livello di patch e le mappe di rarità del codebook sono stati aggregati a livello di immagine e confrontati tra campioni normali e anomali. Il rapporto energetico, la d di Cohen e l'AUC sono stati utilizzati per quantificare la separazione della risposta a livello di immagine. I risultati dettagliati sono presentati nella Tabella 4 e nella Figura 7 e Figura 8.
I risultati mostrano che i punteggi di rarità del codebook a tutte le scale presentano un aumento della risposta su campioni anomali (rapporti energetici > 1). I codebook con capacità inferiore (Codebook 64) raggiungono una discriminazione più forte a livello di localizzazione (AUC del 78,79%), in linea con l'aspettativa che tassi di compressione più elevati favoriscano l'apprendimento di modelli prototipici più astratti, maggiormente sensibili alle deviazioni dai prototipi normali dei tessuti. L'errore di ricostruzione da solo offre una notevole capacità di rilevamento delle anomalie (AUC del 93,31%), mentre i punteggi CAR forniscono segnali complementari derivanti dalla dimensione della frequenza semantica.
L'esame qualitativo di Figura 7 ha mostrato che le risposte elevate nei campioni tumorali si sovrapponevano a ghiandole irregolari e affollate, ingrandimento nucleare, ipercromasia, pseudostratificazione e perdita della polarità epiteliale. Nei campioni infiammatori, risposte più intense sono state osservate intorno a cripte distorti e infiltrati densi di cellule infiammatorie. Le codice a capacità inferiore tendevano a catturare deviazioni architetturali più ampie, mentre le codice a capacità superiore producevano risposte più localizzate a livello cellulare. Questi risultati forniscono un'interpretazione morfologica qualitativa, ma non una validazione a livello di pixel.
Analisi dei parametri di fusione
Il peso di fusione α bilancia i contributi dell'errore di ricostruzione spaziale e del punteggio CAR nel punteggio di anomalia finale. I valori ottimali di α per ciascun fold sono stati determinati mediante una ricerca a griglia (dimensione del passo 0,05) sui set di validazione, con i risultati presentati nella Tabella 5 e Figura 9. I valori ottimali di α si concentrano principalmente nell'intervallo 0,85-0,95, con una media di 0,90 ± 0,05. In condizioni ottimali, il modello raggiunge un AUC medio del 96,82 ± 0,23% sui set di test. Pesi ottimali più elevati (circa 0,90) indicano che i punteggi CAR contribuiscono maggiormente al rilevamento finale rispetto all'errore di ricostruzione, mentre l'errore di ricostruzione fornisce vincoli locali ausiliari. Rispetto al caso α = 0 nell'analisi di sensibilità (AUC = 93,29%), l'impostazione di fusione selezionata tramite validazione ha migliorato l'AUC di circa 3,53 punti percentuali.
Per riassumere, questo studio presenta il framework RareCode per il rilevamento non supervisionato di anomalie in immagini istopatologiche, con l'obiettivo di mitigare il problema dell'identity-mapping riscontrato dai modelli generativi tradizionali. Il meccanismo CAR riduce l'eccessiva dipendenza dagli errori di ricostruzione a livello di pixel, mentre il modulo MHC fornisce rappresentazioni gerarchiche delle caratteristiche a diverse granularità, consentendo una discriminazione complementare delle anomalie a diversi livelli di astrazione. Gli esperimenti effettuati sul dataset CRC dimostrano che RareCode raggiunge un AUC del 96,82%, con un'analisi per classe che mostra un efficace rilevamento del cancro (AUC = 99,44%) e una discriminazione più forte per il cancro rispetto all'infiammazione, suggerendo che l'overlap tra infiammazione e normale rimane una sfida significativa. Gli studi di ablazione confermano che l'integrazione di caratteristiche semantiche discrete da VQ con rappresentazioni morfologiche del tessuto a più scale migliora le prestazioni di rilevamento. L'elevato richiamo (recall) di RareCode (98,40%) e la specificità moderata (58,24%) indicano il suo potenziale come strumento di pre-screening per la selezione di immagini istopatologiche sospette; tuttavia, il suo effetto reale sul carico di lavoro del patologo richiederà una valutazione prospettica del flusso di lavoro.
Disponibilità dei dati:
Il dataset di immagini istopatologiche di CRC utilizzato in questo studio è stato ottenuto dall'Ospedale Popolare di Shenzhen in base all'approvazione etica istituzionale (Numero di approvazione LL-KY-2025300-01). A causa della privacy dei pazienti e delle politiche istituzionali sulla condivisione dei dati, il dataset non è disponibile pubblicamente. L'accesso può essere concesso previa richiesta motivata all'autore corrispondente, soggetto all'approvazione istituzionale e a accordi sull'utilizzo dei dati. Il codice sorgente del framework RareCode è disponibile pubblicamente all'indirizzo https://github.com/XL-alg/RareCode.
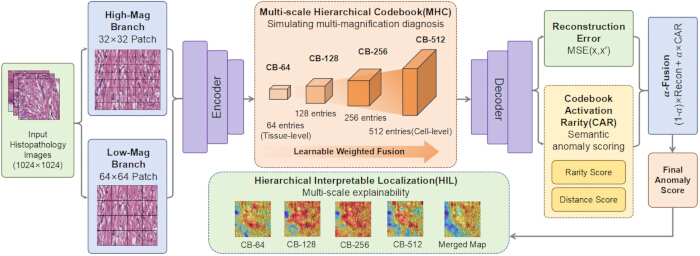
Figura 1: Architettura generale e flusso dei dati del framework RareCode. A 512 × 512 H&L'immagine istopatologica colorata con ematossilina ed eosina viene suddivisa in 32 aree non sovrapposte × 32 e 64 × 64 patch come input a scala fine e grossolana. I due rami codificano i patch in embedding latenti, applicano la discretizzazione mediante Codebook Gerarchica Multiscala (MHC) e ricostruiscono i patch per calcolare i punteggi di errore di ricostruzione. In parallelo, il meccanismo di Rarità dell'Attivazione del Codebook (CAR) stima la rarità semantica a partire dai profili di frequenza di attivazione del codebook appresi dai campioni normali di addestramento. I punteggi di ricostruzione e CAR, opportunamente normalizzati, vengono quindi combinati per generare il punteggio finale di anomalia a livello di immagine, mentre le risposte a livello di patch vengono proiettate nuovamente sul piano dell'immagine per una localizzazione gerarchica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
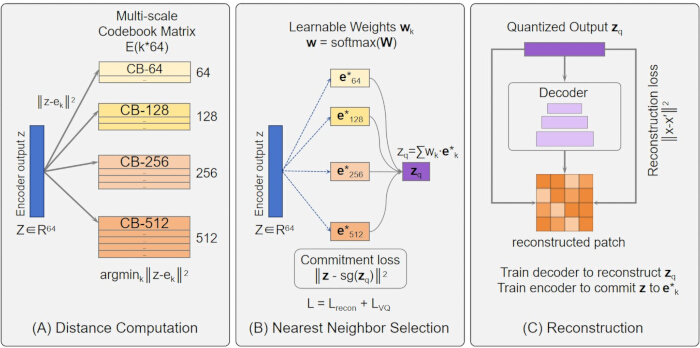
Figura 2: Meccanismo di quantizzazione vettoriale multiscala. (A) Calcolo della distanza tra le caratteristiche in uscita dall'encoder e i vettori di incorporamento del codebook. (B) Selezione del vicino più prossimo e fusione pesata attraverso codebook con capacità di 64, 128, 256 e 512. (C) Ricostruzione a partire da caratteristiche quantizzate mediante un decoder convoluzionale trasposto. Cliccare qui per visualizzare una versione ingrandita di questa figura.
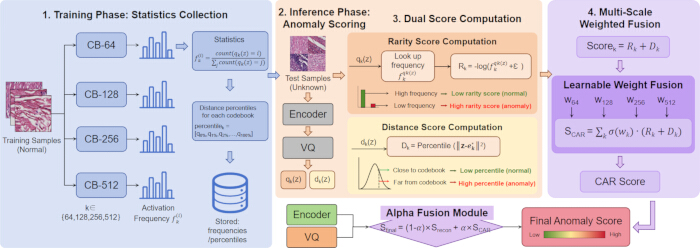
Figura 3: Meccanismo di calcolo del punteggio CAR. Questa figura illustra quattro fasi: Fase 1: le statistiche sulla frequenza di attivazione vengono calcolate esclusivamente su campioni normali di addestramento. Fase 2: i campioni di test ottengono indici di attivazione e distanze attraverso l'encoder e la quantizzazione vettoriale. Fase 3: vengono calcolati punteggi di rarità e punteggi di distanza in base ai profili di frequenza del set di addestramento. Fase 4: i punteggi provenienti da ciascuna scala della codebook vengono combinati mediante pesi apprendibili per produrre il punteggio CAR finale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
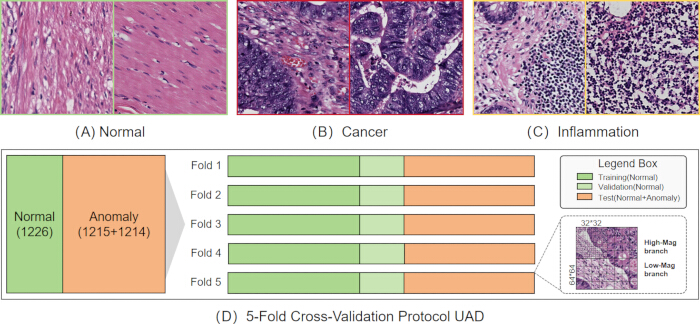
Figura 4: Composizione del dataset CRC e protocollo sperimentale. (A–C) Esempio di H&Immagini istopatologiche colorate con ematossilina ed eosina (H&E) di tessuto colorettale normale, cancro del colon-retto e infiammazione colorettale.DProtocollo di cross-validation a 5 ripetizioni per UAD, in cui i campioni normali sono stati utilizzati per l'addestramento e la validazione, mentre i campioni normali e anomali tenuti in riserva sono stati utilizzati per il test. Le immagini sono state digitalizzate a un ingrandimento di 40x e suddivise in ritagli di dimensioni 32 x 32 e 64 x 64. Il verde, il verde chiaro e l'arancione indicano rispettivamente i set di addestramento, validazione e test. Cliccare qui per visualizzare una versione ingrandita di questa figura.
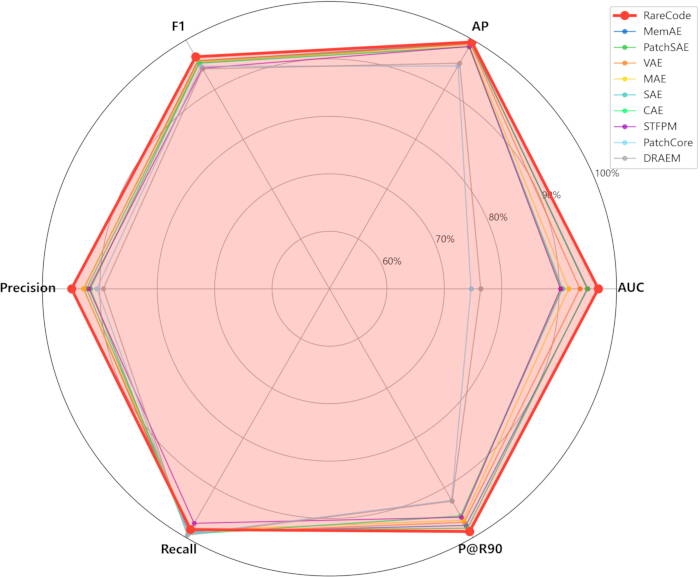
Figura 5: Grafico a ragnatela con confronto multiplo tra metodi di rilevamento delle anomalie. Grafico a ragnatela che confronta RareCode con metodi di riferimento in base ad AUC, precisione media (AP), punteggio F1, precisione, richiamo e precisione al 90% di richiamo (P@R90). Tutti i valori rappresentano la prestazione media ottenuta con una validazione incrociata a 5 ripiegamenti. Cliccare qui per visualizzare una versione ingrandita di questa figura.
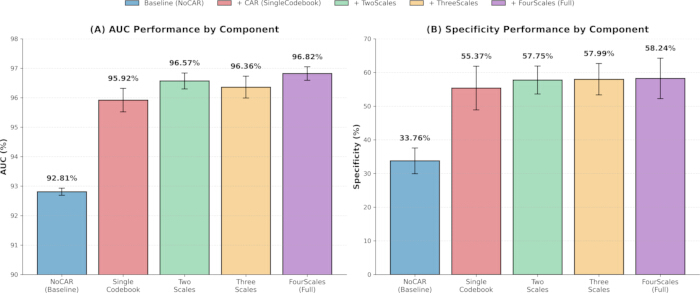
Figura 6: Analisi del contributo incrementale dei componenti dello studio di ablazione. (A) Confronto delle prestazioni in termini di AUC che mostra il miglioramento progressivo dalla baseline basata esclusivamente sulla ricostruzione (NoCAR) fino alle configurazioni con codebook singolo e multi-scala. (B) Confronto delle prestazioni in termini di specificità che dimostra l'effetto del meccanismo CAR sulla riduzione dei falsi positivi. Tutte le barre di errore rappresentano la deviazione standard (SD) calcolata su una validazione incrociata a 5 ripetizioni. Cliccare qui per visualizzare una versione ingrandita di questa figura.
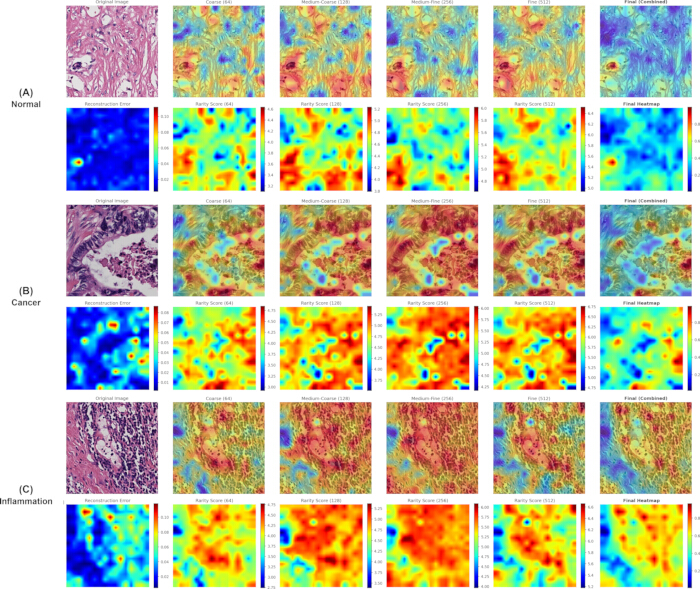
Figura 7: Mappe termiche gerarchiche di localizzazione basate su codebook multi-livello. Sono mostrati esempi rappresentativi per campioni di tipo (A) normale, (B) tumorale e (C) infiammatorio. Ogni riga include l'immagine originale, la sovrapposizione, la mappa dell'errore di ricostruzione, le mappe del punteggio di rarità provenienti da codebook di diverse capacità (64, 128, 256 e 512) e la mappa finale di localizzazione fusa. I codebook con capacità inferiore evidenziano pattern a grana più grossolana grazie a un'astrazione più spinta derivante dalla compressione, mentre i codebook con capacità maggiore preservano dettagli strutturali più fini. Le regioni con risposta elevata corrispondono qualitativamente a caratteristiche istopatologiche associate al cancro o all'infiammazione, ma non sono state validate mediante annotazioni esperte a livello di pixel. Cliccare qui per visualizzare una versione ingrandita di questa figura.
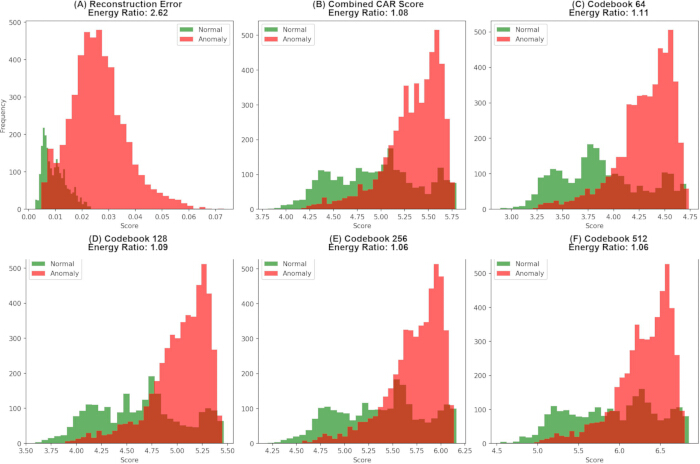
Figura 8: Istogrammi di distribuzione di diversi tipi di punteggio. Gli istogrammi confrontano le distribuzioni dei punteggi tra campioni normali e anomali per (A) errore di ricostruzione, (B) punteggio CAR combinato, (C) Codebook 64, (D) Codebook 128, (E) Codebook 256 e (F) Codebook 512. Gli istogrammi verdi e rossi indicano rispettivamente campioni normali e anomali. Cliccare qui per visualizzare una versione ingrandita di questa figura.
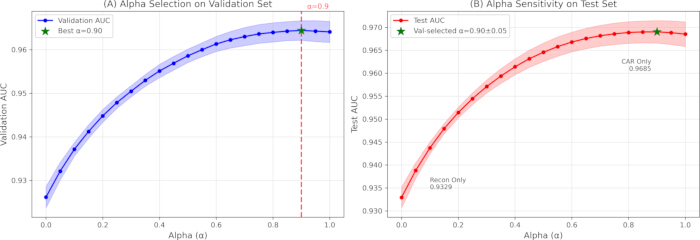
Figura 9: Analisi della sensibilità del parametro alfa. (A) AUC del set di validazione utilizzata per la selezione di α. (B) AUC del set di test in corrispondenza di diversi valori di α. I valori di α selezionati mediante validazione sono compresi tra 0,85 e 0,95, con una media di 0,90 ± 0,05, coerentemente con quanto riportato nella Tabella 5. La variazione dell’AUC è rimasta inferiore allo 0,5% quando α è variato nell’intervallo [0,70, 1,00], indicando una prestazione stabile su un ampio intervallo di parametri. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Metodo | AUC (%) | AP (%) | F1 (%) | Precisione (%) | Recupero (%) | Specificità (%) | P@R90 (%) |
| CAE | 90,37 ± 0,94 | 98,62 ± 0,18 | 95,34 ± 0,15 | 91,64 ± 0,40 | 99,35 ± 0,22 | 28,14 ± 3,88 | 95,66 ± 0,32 |
| SAE | 90,58 ± 0,94 | 98,66 ± 0,18 | 95,34 ± 0,15 | 91,67 ± 0,40 | 99,32 ± 0,24 | 28,46 ± 3,97 | 95,71 ± 0,30 |
| VAE | 93,60 ± 0,82 | 99,13 ± 0,12 | 95,86 ± 0,19 | 92,81 ± 0,49 | 99,12 ± 0,29 | 39,07 ± 4,70 | 96,94 ± 0,43 |
| MAE | 91,65 ± 2,75 | 98,76 ± 0,50 | 95,61 ± 0,60 | 92,87 ± 1,56 | 98,55 ± 0,55 | 39,74 ± 14,32 | 96,55 ± 0,97 |
| MemAE | 94,97 ± 0,81 | 99,35 ± 0,11 | 95,78 ± 0,33 | 92,82 ± 1,07 | 98,95 ± 0,60 | 39,15 ± 9,99 | 97,57 ± 0,33 |
| PatchSAE | 94,86 ± 0,36 | 99,34 ± 0,05 | 95,39 ± 0,13 | 92,32 ± 0,27 | 98,67 ± 0,12 | 34,91 ± 2,57 | 98,13 ± 0,24 |
| STFPM | 90,23 ± 3,05 | 98,70 ± 0,44 | 94,32 ± 0,21 | 91,90 ± 3,51 | 97,14 ± 3,38 | 29,82 ± 33,53 | 95,93 ± 1,96 |
| DRAEM | 76,34 ± 2,82 | 95,34 ± 0,90 | 94,19 ± 0,07 | 89,39 ± 0,65 | 99,56 ± 0,65 | 6,19 ± 7,09 | 92,69 ± 0,57 |
| PatchCore | 74,64 ± 1,82 | 94,76 ± 0,55 | 94,73 ± 0,05 | 90,52 ± 0,15 | 99,36 ± 0,12 | 17,49 ± 1,54 | 92,54 ± 0,15 |
| RareCode | 96,82 ± 0,23 | 99,59 ± 0,03 | 96,63 ± 0,15 | 94,93 ± 0,67 | 98,40 ± 0,48 | 58,24 ± 5,99 | 98,80 ± 0,10 |
Tabella 1: Risultati del confronto con i metodi di base (convalida incrociata a 5 fold). Prestazioni di rilevamento di RareCode e di nove metodi UAD di base sul dataset CRC. Le metriche includono AUC, precisione media (AP), richiamo, specificità, punteggio F1, precisione al 90% di richiamo (P@R90) e precisione. Tutti i valori rappresentano la media ± DS calcolata sulla convalida incrociata a 5 fold. I valori in grassetto indicano le migliori prestazioni per ciascuna metrica.
| Categoria | AUC (%) | AP (%) | F1 (%) | Richiamo (%) | Specificità (%) |
| Cancro | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| Infiammazione | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
Tabella 2: Prestazioni di rilevamento per classe attraverso i sottotipi di anomalie. Valutazione separata delle prestazioni di rilevamento di RareCode per campioni di cancro e infiammazione rispetto ai campioni normali. Le metriche per classe, incluse AUC, AP, punteggio F1, richiamo e specificità, sono state calcolate utilizzando soglie ottimali specifiche per ciascuna classe.
| Varianti | Configurazione del codebook | CAR | AUC (%) | AP (%) | F1 (%) | Specificità (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| SingleCodebook | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| TwoScales | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| ThreeScales | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| FourScales | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + decodificatore complesso | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
Tabella 3: Risultati dello studio di ablazione. Confronto delle prestazioni delle configurazioni di RareCode con aggiunta progressiva di componenti: baseline basata solo sulla ricostruzione (NoCAR), CAR con un singolo codebook (SingleCodebook) e configurazioni multi-risoluzione (TwoScales, ThreeScales, FourScales). È inclusa anche un'ulteriore analisi di ablazione sulla complessità del decodificatore utilizzando la configurazione FourScales. Le metriche includono AUC, precisione media (AP), punteggio F1, specificità e precisione al 90% di richiamo (P@R90).
| Tipo di punteggio | Rapporto energetico | d di Cohen | AUC (%) |
| Errore di ricostruzione | 2.623 | 2.006 | 93.31 |
| CAR combinato | 1.078 | 1.002 | 74.85 |
| Codebook 64 | 1.109 | 1.207 | 78.79 |
| Codebook 128 | 1.085 | 1.067 | 76.19 |
| Codebook 256 | 1.065 | 0.916 | 72.80 |
| Codebook 512 | 1.064 | 0.833 | 70.38 |
Tabella 4: Analisi a livello di immagine delle risposte derivate dalla localizzazione. Gli errori di ricostruzione mediati sull'immagine e le risposte di rarità del codice sono stati confrontati tra campioni normali e anomali utilizzando il rapporto energetico, il d di Cohen e l'AUC.
| Piega | α ottimale | AUC di validazione (%) | AUC di test (%) |
| 1 | 0.95 | 96,22 | 96,91 |
| 2 | 0,9 | 96,38 | 96,39 |
| 3 | 0,85 | 96,71 | 96,82 |
| 4 | 0,85 | 96,22 | 96,93 |
| 5 | 0,95 | 96,72 | 97,05 |
| Media | 0,90 ± 0,05 | 96,45 ± 0,23 | 96,82 ± 0,23 |
Tabella 5: Valori ottimali di alpha nei diversi fold. Valore ottimale del peso di fusione alpha determinato tramite ricerca a griglia (dimensione del passo 0.05) sui set di validazione per ciascun fold della cross-validazione, con statistiche di media e deviazione standard.
Discussione
I risultati suggeriscono che i modelli di attivazione del codebook potrebbero fornire informazioni complementari rispetto agli errori di ricostruzione spaziale. Il miglioramento ottenuto passando da NoCAR al modello completo FourScales supporta il potenziale contributo del punteggio CAR, mentre i pesi di fusione selezionati indicano che la rarità semantica potrebbe svolgere un ruolo importante nel punteggio di anomalia finale. Una possibile spiegazione è che le anomalie associate al carcinoma del colon-retto (CRC) possono interessare diverse scale morfologiche, dalla atipia nucleare fino alla alterazione architetturale delle ghiandole, e quindi potrebbero trarre beneficio da rappresentazioni delle caratteristiche a diverse granularità14. Il modello attuale cattura diverse estensioni spaziali utilizzando porzioni di 32 × 32 e 64 × 64 alla stessa potenza di ingrandimento; un'integrazione futura con framework di elaborazione delle immagini a intera diapositiva (WSI) potrebbe ulteriormente favorire un'analisi gerarchica a livello di diapositiva39.
Dal punto di vista clinico, RareCode può essere considerato meglio come uno strumento di triage preliminare piuttosto che come un sistema diagnostico autonomo. L'elevato richiamo (98,40%) suggerisce un rischio relativamente basso di mancare casi anomali40, mentre la specificità moderata (58,24%) riflette probabilmente la difficoltà di distinguere i cambiamenti infiammatori dal tessuto normale in un contesto non supervisionato. L'elevata specificità specifica per il cancro (94,21%) suggerisce ulteriormente che i falsi allarmi potrebbero essere meno frequenti per il sottotipo clinicamente più critico. Queste caratteristiche prestazionali sostengono l'eventuale utilizzo di RareCode come strumento di pre-screening per prioritizzare i casi che richiedono una valutazione specialistica e per ottimizzare la revisione anatomopatologica5,6.
I risultati per classe possono ulteriormente sostenere il potenziale ruolo di RareCode nel triage. La prestazione relativamente migliore per il cancro rispetto all'infiammazione potrebbe riflettere le alterazioni architetturali e citologiche più marcate spesso osservate nei tessuti maligni, inclusa la perdita di polarità, il pleomorfismo nucleare e la desmoplasia stromale14,39. Al contrario, le alterazioni infiammatorie potrebbero sovrapporsi più strettamente alle variazioni del tessuto benigno, il che potrebbe in parte spiegare la minore specificità per l'infiammazione. Pertanto, la specificità complessiva andrebbe interpretata con cautela, considerando il rilevamento del cancro come un caso d'uso clinicamente rilevante piuttosto che una diagnosi autonoma definitiva.
I potenziali modi di fallimento di RareCode devono essere interpretati nel contesto del suo obiettivo di apprendimento monoclasse. Poiché il modello apprende i modelli di tessuto normale piuttosto che categorie specifiche di malattia, alterazioni non neoplastiche come epitelio rigenerativo, fibrosi, necrosi o infiammazione marcata possono anch'esse ricevere punteggi di anomalia elevati. Al contrario, displasie lievi o carcinomi ben differenziati con architettura ghiandolare quasi normale possono produrre risposte più deboli. Fattori tecnici, inclusa la variabilità della colorazione, pieghe del tessuto, artefatti di sezionamento, sfocatura e compressione dell'immagine, possono inoltre influenzare gli errori di ricostruzione e le frequenze di attivazione del codebook. Queste considerazioni suggeriscono che la traduzione clinica richiederebbe un controllo della qualità delle immagini, un'armonizzazione della colorazione, una calibrazione specifica per lo scanner e una validazione multicentrica39,41.
Ambito dei confronti di base. La valutazione sperimentale di questo studio si concentra su metodi che operano sotto ipotesi di dati e calcolo comparabili, in particolare metodi che possono essere addestrati end-to-end utilizzando esclusivamente campioni normali non etichettati su piccola scala, senza richiedere corpora esterni per il preaddestramento. Questo ambito comprende i principali paradigmi nel rilevamento anomalo non supervisionato: basati sulla ricostruzione (CAE, VAE, SAE, MAE, PatchSAE), potenziati con memoria (MemAE), basati sulla distillazione della conoscenza (STFPM), con aumento sintetico (DRAEM) e con abbinamento di caratteristiche preaddestrate (PatchCore). Riconosciamo che due categorie di metodi non sono state incluse come basi di confronto dirette. In primo luogo, i modelli fondamentali specifici per la patologia (UNI, CONCH, CTransPath) sfruttano il preaddestramento su milioni di immagini patologiche curate, e i loro vantaggi prestazionali sono attribuibili principalmente alla scala e alla diversità dei dati di preaddestramento piuttosto che al meccanismo di rilevamento delle anomalie; un confronto diretto confonderebbe quindi il contributo dei dati di preaddestramento con quello della metodologia di rilevamento. La prestazione subottimale di STFPM e PatchCore—entrambi che utilizzano architetture preaddestrate su ImageNet—illustra empiricamente l'impatto del divario di dominio quando caratteristiche preaddestrate generiche vengono applicate a scenari istopatologici, suggerendo che un preaddestramento specifico per la patologia potrebbe colmare tale divario. In secondo luogo, i metodi di rilevamento delle anomalie basati sulla diffusione, sebbene promettenti, impongono un sovraccarico computazionale notevolmente maggiore durante l'inferenza (richiedendo tipicamente centinaia di passaggi iterativi di denoising), limitandone l'applicabilità in flussi di lavoro clinici ad alto rendimento in cui l'efficienza di elaborazione è un requisito pratico. Lavori futuri indagheranno se l'integrazione di codificatori preaddestrati specifici per la patologia nell'architettura RareCode—sostituendo l'attuale codificatore addestrato end-to-end—possa ulteriormente migliorare le prestazioni di rilevamento mantenendo i vantaggi interpretativi del meccanismo CAR.
Vanno riconosciute diverse limitazioni. In primo luogo, la validazione si è limitata a un dataset di CRC monocentrico, ed è necessaria un'ulteriore valutazione multicentrica tra diverse istituzioni, scanner e protocolli di colorazione. In secondo luogo, sebbene la specificità per il cancro fosse incoraggiante, la specificità complessiva è rimasta influenzata dal confine tra infiammazione e tessuto normale. In terzo luogo, non erano disponibili annotazioni esperte a livello di pixel; pertanto, non è stato possibile calcolare l'indice di Dice e l'indice di sovrapposizione (IoU), e la valutazione della localizzazione si è limitata alla visualizzazione qualitativa e all'analisi a livello di immagine delle risposte spaziali aggregate. In quarto luogo, sono ancora necessari studi formali con lettori per determinare se le mappe di calore gerarchiche possano migliorare l'accuratezza diagnostica o l'efficienza della revisione. Infine, attualmente RareCode esegue analisi a livello di patch e di immagine, e un'implementazione a livello di WSI richiederebbe l'integrazione con ulteriori framework di elaborazione39,41,42.
Lavori futuri dovrebbero valutare RareCode su benchmark pubblici e coorti multicentriche dopo l'integrazione con framework per l'elaborazione di WSI. Studi prospettici con lettori potrebbero aiutare a valutarne l'impatto potenziale sull'accuratezza diagnostica, sul tempo di revisione e sull'accordo inter-osservatore42. Altre direzioni includono il miglioramento dell'efficienza computazionale, l'estensione del modello verso la sottotipizzazione multiclasse delle anomalie e l'integrazione dell'apprendimento basato su più istanze per la diagnosi a livello di vetrino28,39.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari concorrenti noti o relazioni personali che potrebbero aver influenzato il lavoro descritto in questo articolo. Durante la preparazione di questo lavoro, abbiamo utilizzato ChatGPT per migliorare il linguaggio e la leggibilità del manoscritto e per assistere nella generazione del codice per la visualizzazione dei dati. Dopo aver utilizzato questo strumento, abbiamo rivisto e modificato i contenuti secondo necessità e assumiamo piena responsabilità per l'articolo pubblicato.
Ringraziamenti
Questa ricerca è stata sostenuta dalla Yong Dai Academician's Workstation (Tecnologia Diagnostica per le Malattie Autoimmuni) (Wan Ke Science and Technology [2023] n. 317), dal Progetto del Fondo per l'Innovazione dei Dottorandi del Centro Nazionale di Ricerca di Hefei per la Salute e il Centro di Ricerca Congiunto per la Medicina del Lavoro e la Salute Fondo Aperto (n. OMH-2023-04), e dal Progetto di Ricerca Clinica e Traduzionale della Provincia di Anhui (n. 202427610020132).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| GPU GeForce RTX 4060 Ti | NVIDIA | N/A | 16 GB VRAM; singola GPU utilizzata per tutti gli esperimenti (RRID:SCR_022858) |
| Matplotlib | Squadra di sviluppo di Matplotlib | Versione 3.8.4 | Visualizzazione dei dati e generazione di figure (RRID:SCR_008624) |
| NumPy | Sviluppatori di NumPy | Versione 1.26.4 | Calcolo numerico e operazioni su array (RRID:SCR_008633) |
| pandas | Squadra di sviluppo di pandas | Versione 2.2.3 | Organizzazione dei dati ed elaborazione dei risultati tabulari (RRID:SCR_018214) |
| Pillow | Contributori della Python Imaging Library / Pillow | Versione 10.3.0 | Caricamento e preelaborazione delle immagini |
| Python | Fondazione Python Software | Versione 3.12.3 | Linguaggio di programmazione utilizzato per lo sviluppo del modello e l'analisi dei dati (RRID:SCR_008394) |
| PyTorch | Meta Platforms, Inc. | Versione 2.7.0+cu118 | Framework di apprendimento profondo utilizzato per l'implementazione e l'addestramento del modello (RRID:SCR_018536) |
| scikit-learn | Sviluppatori di scikit-learn | Versione 1.4.2 | Validazione incrociata, suddivisione training-test e metriche di valutazione (RRID:SCR_002577) |
| SciPy | Sviluppatori di SciPy | Versione 1.13.1 | Analisi statistica (RRID:SCR_008058) |
| torchvision | Progetto PyTorch | Versione 0.22.0+cu118 | Preelaborazione delle immagini e trasformazione dei dati |
| tqdm | Sviluppatori di tqdm | Versione 4.66.4 | Monitoraggio dell'avanzamento durante l'addestramento e la valutazione |
Riferimenti
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.