Questo protocollo illustra un flusso di lavoro strutturato e verificabile per l'elaborazione di dati anonimizzati provenienti da questionari sulla salute psicofisica di studenti universitari, partendo dall'esportazione grezza e dalla selezione delle risposte fino al calcolo dei punteggi per ciascuna scala, al controllo dell'affidabilità, alle diagnosi di regressione, alla verifica delle fonti delle figure e alla produzione di output analitici pronti per la visualizzazione.
Articolo metodologico
Un flusso di lavoro strutturato per lo screening, la valutazione e la visualizzazione dei dati di questionari sul benessere degli studenti universitari
In questo articolo
Sommario
Abstract
Gli studi basati su questionari sono ampiamente utilizzati per esaminare il benessere degli studenti, ma il percorso procedurale che va dalle risposte grezze a variabili analizzabili, tabelle statistiche e output visivi è spesso documentato in modo insufficiente. Questo protocollo illustra un flusso di lavoro strutturato e verificabile per l'elaborazione di dati anonimi provenienti da un questionario sul benessere degli studenti universitari, raccolti mediante sezioni con scale di tipo Likert multiple. Il flusso di lavoro inizia con l'approvazione etica, la documentazione del consenso, la configurazione del questionario e l'esportazione dei dati grezzi, per poi procedere con la verifica delle risposte, la revisione delle risposte duplicate, la gestione dei dati mancanti, la codifica degli elementi, la riscalatura inversa, la valutazione dell'affidabilità, l'analisi descrittiva, l'analisi delle correlazioni, il confronto tra gruppi contrastanti, la modellazione della regressione, i controlli diagnostici e la preparazione delle fonti per le visualizzazioni. Il questionario di esempio utilizza sezioni di scala documentate alla fonte e adattate allo studio, basate sulle Depression Anxiety Stress Scales-21, sulla Tuckman Procrastination Scale, sulla Psychological Sense of School Membership Scale, sulla letteratura relativa alla misurazione del pensiero di ordine superiore e sulla documentazione delle scale del benessere soggettivo. Emozione negativa, procrastinazione accademica, senso di appartenenza scolastica, pensiero di ordine superiore e benessere soggettivo sono utilizzati come variabili esemplificative a livello di scala per mostrare come le risposte a livello di singolo elemento possano essere trasformate in output analitici tracciabili. Gli output rappresentativi includono una tabella del flusso di screening, un riepilogo demografico, statistiche descrittive e di verifica degli intervalli, stime di coerenza interna, una matrice delle correlazioni, risultati del confronto contrastivo, coefficienti di regressione, diagnosi sui residui e sull'influenza e file sorgente per le figure. Il protocollo sottolinea regole decisionali predeterminate, una mappa delle scale collegata, un registro di screening predisposto all'analisi, la verifica della riscalatura inversa e la verifica numerica delle fonti per le figure. Piuttosto che proporre una nuova scala psicometrica, validare un modello di misurazione o stabilire relazioni causali, questo metodo fornisce una procedura pratica e verificabile per ricercatori che devono esaminare, assegnare punteggi, analizzare e visualizzare dati sul benessere degli studenti universitari raccolti tramite questionario. Il flusso di lavoro può essere adattato a studi simili basati su questionario, a condizione che la mappa delle scale, l'approvazione etica, le regole di punteggio, le soglie di screening delle risposte e i file sorgente per le visualizzazioni siano definiti prima dell'analisi.
Introduzione
Il benessere soggettivo è un risultato importante nella ricerca sugli studenti perché riflette come gli studenti valutano le proprie vite, le esperienze emotive, le relazioni sociali e il funzionamento quotidiano all'interno degli ambienti di apprendimento. Nell'istruzione superiore, il benessere degli studenti è multidimensionale e non si limita alla soddisfazione della vita o al disagio psicologico1. I dati ricavati dai questionari, pertanto, rimangono utili quando i ricercatori devono esaminare esperienze emotive, comportamentali, sociali, cognitive e relative al benessere all'interno dello stesso quadro analitico.
Il valore dei dati raccolti tramite questionario dipende non solo dalle costruzioni selezionate, ma anche dal modo in cui le risposte grezze vengono convertite in variabili analitiche. Molti studi riportano punteggi di scala, matrici di correlazione, confronti tra gruppi o modelli di regressione senza mostrare le decisioni intermedie che collegano i dati grezzi alle tabelle e figure finali. Le risposte mancanti possono essere gestite in modo non uniforme, gli elementi invertiti nel punteggio possono essere codificati erroneamente, le sottomissioni duplicate possono rimanere nel dataset e le risposte distratte possono essere considerate osservazioni valide. Le decisioni riguardo ai dati mancanti dovrebbero pertanto essere pianificate, documentate e riportate, piuttosto che trattate come un passaggio post hoc invisibile2. I dati dei questionari online richiedono inoltre regole esplicite sulla qualità delle risposte, poiché la velocità eccessiva, la compilazione lineare (straight-lining), le risposte incoerenti e altri schemi di basso impegno possono alterare le statistiche descrittive, le stime di affidabilità e le associazioni osservate3.
La novità di questo protocollo risiede nel suo tracciamento collegato, che va dall'esportazione grezza del questionario ai risultati statistici e visivi finali. In particolare, il flusso di lavoro include una mappa delle scale completate, un registro di controllo preliminare all'analisi, un controllo per la riassegnazione dei punteggi, un registro di verifica del punteggio, la verifica della fonte numerica delle figure e un tracciamento contabile che collega ogni tabella o figura al relativo file sorgente. Questo aspetto differenzia il metodo dalle pratiche standard di pulizia dei dati, attribuzione del punteggio alle scale, verifica dell'affidabilità o visualizzazione. Piuttosto che affermare semplicemente che i dati del questionario sono stati puliti e analizzati, il protocollo specifica quale file è bloccato, quale file viene esaminato, quali regole vengono applicate, quali punteggi di scala vengono generati e quale tabella numerica verificata viene utilizzata per creare ogni output visivo.
Il flusso di lavoro viene illustrato mediante dati anonimizzati ottenuti da un questionario somministrato a studenti universitari, contenente cinque variabili su scala: emozione negativa, procrastinazione accademica, senso di appartenenza scolastico, pensiero di ordine superiore e benessere soggettivo. Queste costruzioni sono state selezionate per fornire esempi di tipo emotivo, comportamentale, contestuale-scolastico, cognitivo e orientati al risultato all'interno di un unico flusso di lavoro strutturato e verificabile. La procrastinazione accademica è stata associata a successive difficoltà di salute mentale tra gli studenti universitari, inclusi esiti legati a depressione, ansia e stress4. Il senso di appartenenza scolastico e il benessere soggettivo sono anch'essi strettamente correlati nelle popolazioni studentesche, il che giustifica l'inclusione di misure relative all'appartenenza e al benessere all'interno dello stesso quadro di elaborazione dei questionari5. Tuttavia, nel presente protocollo, queste costruzioni vengono utilizzate per illustrare il flusso di lavoro piuttosto che per stabilire un modello psicologico causale.
Un aspetto fondamentale del protocollo è la separazione tra le decisioni relative all'elaborazione dei dati e l'interpretazione sostanziale. La mappa della scala viene preparata prima dell'analisi, i criteri di qualità delle risposte vengono fissati prima del calcolo del punteggio della scala, la verifica del reverse scoring viene completata prima dei test statistici e le figure vengono generate solo dopo aver controllato le tabelle numeriche di origine. Questa sequenza è importante perché le scale di risposta di tipo Likert richiedono un allineamento accurato tra la formulazione degli elementi, gli ancoraggi di risposta, la direzione del punteggio e il trattamento statistico6. Il protocollo dà inoltre priorità alla complessità del modello rispetto a una preelaborazione trasparente e alla verifica del punteggio. Modelli predittivi o multivariabili possono essere utili nella ricerca studentesca7, e i riassunti grafici possono migliorare l'interpretazione quando rimangono collegati a matrici numeriche verificate8, ma entrambi dipendono da una preparazione trasparente delle variabili di ingresso. Per questo motivo, il flusso di lavoro utilizza l'analisi delle correlazioni, il confronto comparativo tra gruppi, la modellizzazione della regressione, i controlli diagnostici e la visualizzazione come moduli esemplificativi, piuttosto che come affermazioni sostanziali obbligatorie.
Questo protocollo è destinato a ricercatori che necessitano di un flusso di lavoro pratico per l'elaborazione di questionari contenenti dati anonimi sul benessere degli studenti. È adatto quando le risposte ai singoli item del questionario vengono esportate da una piattaforma online, occorre calcolare variabili a livello di scala a partire da item di tipo Likert e l'obiettivo è produrre output descrittivi, correlazionali, di confronto tra gruppi, di regressione, diagnostici e pronti per la visualizzazione in forma trasparente. Non è progettato per stabilire relazioni causali, validare nuove scale, sostituire l'analisi fattoriale confermativa, sostituire i test di invarianza di misura o per l'analisi degli item o la modellizzazione a variabili latenti. Il suo contributo è di natura procedurale: rende visibile, ripetibile e verificabile il percorso dai dati raccolti tramite questionario alle tabelle e figure riportate. Questo approccio è coerente con le attuali preoccupazioni riguardo alla qualità dei dati provenienti da sondaggi online9, alla verifica delle regressioni e delle influenze statistiche10 e ai flussi di analisi basati su questionari verificabili11.
Protocollo
Questo studio che coinvolge partecipanti umani è stato esaminato e approvato dal Comitato Etico del College of Aeronautics, Guizhou Open University (Numero di approvazione: GZOU-EDU-2024-015). Il comitato ha stabilito che lo studio rientra nei casi di esenzione etica poiché utilizza procedure di compilazione anonima e volontaria del questionario e non comporta rischi superiori a quelli minimi per i partecipanti. Tutti i partecipanti hanno fornito il consenso informato in forma elettronica prima di compilare il questionario e potevano interrompere la compilazione in qualsiasi momento senza alcuna penalizzazione. Poiché diversi quesiti riguardavano emozioni negative, stress, solitudine, impotenza, insoddisfazione o esperienze correlate al benessere, nella pagina del consenso e nell'ultima pagina del questionario sono state fornite le informazioni di contatto del ricercatore e dell'istituzione per i partecipanti che avessero provato disagio. Il set di dati utilizzato in questo protocollo è stato anonimizzato prima della selezione, della valutazione, dell'analisi e della visualizzazione. Il questionario completo è fornito come File Supplementare 1.
1. Preparare il questionario, i documenti etici e gli elaborati del flusso di lavoro
- Definire la popolazione idonea, l'ambiente dello studio, le costruzioni del questionario e gli output analitici previsti prima della programmazione del questionario.
- Preparare una domanda per l'approvazione etica che includa la popolazione target, il canale di reclutamento, il contenuto del questionario, il tempo stimato per il completamento, la protezione dell'anonimato, la conservazione dei dati, la procedura di ritiro, le informazioni di supporto per i partecipanti e le analisi previste.
- Conservare nel cartella del progetto il documento di approvazione o esenzione etica, il testo del consenso informato, il testo di reclutamento, la versione del questionario, le informazioni di supporto per i partecipanti e il flusso di lavoro previsto prima dell'inizio della raccolta dati.
- Definire la popolazione target come studenti universitari a tempo pieno di almeno 18 anni, attualmente iscritti a un corso di studi universitario, in grado di comprendere il questionario e di fornire un consenso informato.
- Definire i criteri di esclusione prima del reclutamento. Escludere i rispondenti che rifiutano il consenso, che non soddisfano la definizione della popolazione target, che inviano risposte duplicate, che superano la soglia di dati mancanti o che soddisfano i criteri combinati di risposta non valida descritti al Passo 1.4.
- Posizionare l'informativa sul consenso informato all'inizio del questionario. Indicare lo scopo dello studio, la natura volontaria della partecipazione, il tempo approssimativo di completamento di 12 minuti, la protezione dell'anonimato, il diritto di ritiro, il piano di utilizzo dei dati, le informazioni di contatto del ricercatore e le informazioni di contatto per il supporto.
- Non raccogliere informazioni direttamente identificabili, tra cui numeri di identificazione dello studente, numeri di identificazione nazionali, numeri di telefono cellulare, indirizzi email personali, indirizzi di dormitorio o altri identificatori personali.
- Organizzare il questionario nell'ordine seguente: consenso informato, informazioni demografiche, elementi relativi alle emozioni negative, elementi relativi alla procrastinazione accademica, elementi relativi al senso di appartenenza scolastico, elementi relativi al pensiero di ordine superiore e elementi relativi al benessere soggettivo.
- Selezionare gli strumenti di riferimento prima della programmazione del questionario. In questo protocollo, le emozioni negative sono state valutate mediante la scala Depression Anxiety Stress Scales-21 a 21 elementi, la procrastinazione accademica mediante la Tuckman Procrastination Scale a 16 elementi, il senso di appartenenza scolastico mediante la Psychological Sense of School Membership Scale a 18 elementi, il pensiero di ordine superiore mediante un insieme di 20 elementi adattato dalla letteratura esistente sulla misurazione del pensiero di ordine superiore e il benessere soggettivo mediante una scala di 20 elementi per la ricerca sugli studenti universitari12,13,14,15,16.
- Preparare una mappa delle scale bloccata prima della programmazione del questionario. Includere il nome della costruzione, il nome originale della scala, la citazione originale, la versione linguistica, lo stato di autorizzazione o permesso, la procedura di traduzione o adattamento, il codice dell'elemento, il testo dell'elemento, l'intervallo di risposta, gli estremi di risposta, la direzione del punteggio, lo stato di inversione del punteggio, la variabile finale a livello di scala e la regola di calcolo del punteggio.
- Descrivere un insieme di elementi come scala validata solo quando lo strumento di riferimento, la citazione, le evidenze di validazione e lo stato di adattamento o traduzione sono documentati. Identificare qualsiasi insieme di elementi sviluppato dall'autore o specifico dello studio in Tabella 1 e in File Supplementare 1.
- Bloccare il quadro di misurazione prima della raccolta dati. Per strumenti tradotti o adattati, completare traduzione, revisione, riconciliazione e verifica pilota prima dell'inizio del reclutamento.
- Preparare un pacchetto di audit del flusso di lavoro che includa il file del questionario bloccato, la mappa delle scale, il controllo per l'esportazione dei dati grezzi, il registro di screening, il registro di verifica del punteggio, il registro delle analisi, il modello di tabella delle fonti delle figure e il file di sintassi o script di analisi.
- Utilizzare nomi di file con versione per tutti gli artefatti del flusso di lavoro.
- Definire le colonne richieste per ogni file di audit.
- Il registro di screening include ID del record, criterio di screening, stato del flag, stato di esclusione, motivo dell'esclusione, data della decisione e iniziali del revisore.
- La mappa delle scale include nome della costruzione, fonte della scala, codice dell'elemento, testo dell'elemento, intervallo di risposta, estremi di risposta, stato di inversione del punteggio, nome finale della variabile, regola di calcolo del punteggio e stato di autorizzazione o adattamento.
- Il registro di verifica del punteggio include codice dell'elemento, intervallo di valori originale, intervallo di valori ricodificato, formula di inversione del punteggio, risultato del controllo dell'intervallo, stato di discrepanza, correzione effettuata e data della correzione.
- La tabella delle fonti delle figure include il numero della figura, il numero del pannello, la tabella di origine, le variabili rappresentate, la statistica visualizzata, la dimensione del campione e lo stato di verifica.
- Definire il flusso di lavoro analitico prima della programmazione del questionario: somministrazione del sondaggio, esportazione dei dati grezzi, screening delle risposte, calcolo del punteggio delle scale, valutazione dell'affidabilità, analisi descrittiva, analisi delle correlazioni, confronto tra gruppi ad alto e basso punteggio, modellazione di regressione, controlli diagnostici e preparazione delle visualizzazioni17.
- Strutturare il protocollo attorno a decisioni, operazioni e output di verifica piuttosto che ai percorsi dei menu software.
- Fornire risorse per il flusso di lavoro quando consentito dalle politiche istituzionali e editoriali, inclusi il file del questionario, la mappa delle scale, il modello del registro di screening, il modello del registro di calcolo del punteggio, il file di sintassi o script di analisi e le tabelle delle fonti delle figure.
NOTA: Figura 1 mostra il percorso dalla preparazione del questionario all'esportazione dei dati grezzi, allo screening delle risposte, al calcolo del punteggio delle scale, all'analisi statistica, ai controlli diagnostici e all'output delle visualizzazioni. Tabella 1 riporta lo strumento di riferimento, il numero di elementi, l'intervallo di risposta, il quadro di calcolo del punteggio, la regola di inversione del punteggio, lo stato di autorizzazione o adattamento e la variabile finale a livello di scala per ciascuna costruzione.
2. Configurare e distribuire il questionario
- Verificare che la piattaforma del questionario supporti il controllo del consenso, gli elementi obbligatori, la revisione dei doppioni, l'acquisizione del timestamp e la registrazione della durata delle risposte.
- Creare il questionario utilizzando la piattaforma di sondaggio online indicata nella Tabella dei Materiali. Programmare il questionario secondo la mappa delle scale bloccata.
- Confrontare il questionario programmato con la mappa delle scale bloccata, elemento per elemento, prima di diffondere il link del sondaggio. Registrare eventuali correzioni nel registro dello studio.
- Impostare l'elemento relativo al consenso informato come primo elemento obbligatorio. Interrompere automaticamente il questionario quando un partecipante seleziona “Non acconsento a partecipare”.
- Programmare le sezioni demografiche e quelle relative alle scale psicologiche secondo l'ordine stabilito al Passaggio 1.8. Utilizzare codici degli elementi coerenti con la mappa delle scale.
- Impostare gli elementi delle scale psicologiche come obbligatori solo se consentito dall'approvazione etica o dall'esenzione e quando i partecipanti possono ritirarsi senza penalità. Se le risposte forzate non sono consentite, registrare la regola per i dati mancanti prima della raccolta dei dati.
- Visualizzare gli estremi di risposta prima di ogni sezione della scala e mantenere coerenti gli estremi all'interno di ciascuna scala18.
- Disabilitare le sottomissioni ripetute quando la piattaforma del sondaggio offre questa funzione. Conservare tutti gli identificatori anonimi del dispositivo, del browser, della piattaforma o della sottomissione necessari per la revisione delle risposte duplicate.
- Abilitare la registrazione automatica dell'orario di invio e della durata del completamento.
- Impostare il periodo di apertura del questionario su 7 giorni solari, oppure utilizzare la finestra di raccolta approvata dal comitato etico.
- Inviare il link del questionario attraverso il canale istituzionale di reclutamento approvato. Fornire a tutti i partecipanti le stesse istruzioni scritte.
- Chiudere il questionario al termine della finestra di raccolta prestabilita.
NOTA: Conservare nel registro dello studio la formulazione del reclutamento, il link del questionario, le date di apertura e chiusura, le impostazioni della piattaforma, la formulazione del consenso, la versione finale del questionario e le impostazioni di esportazione della piattaforma.
3. Esportare e proteggere i dati grezzi
- Esportare immediatamente le risposte al questionario completato come file di foglio di calcolo al termine del periodo di raccolta.
- Salvare il primo file esportato come dataset grezzo bloccato. Non modificare questo file.
- Creare una copia di lavoro per la selezione, la valutazione e l'analisi. Assegnare al file un nome contenente la data, il numero di versione e l'identificativo del progetto.
- Verificare che il file esportato contenga una riga per ogni rispondente e una colonna per ogni variabile demografica, voce del questionario, variabile di timestamp, variabile della piattaforma o campo derivato della piattaforma.
- Archiviare il dataset grezzo bloccato, la copia di lavoro, la mappa delle scale, il file del questionario, il registro dello studio, il registro di selezione, il registro di verifica della valutazione, il registro di analisi, le tabelle sorgenti delle figure e il file di sintassi o script in una cartella del progetto protetta da password.
- Verificare che il dataset non contenga informazioni direttamente identificabili. Rimuovere eventuali campi identificabili imprevisti dalla copia di lavoro prima dell'analisi e registrare nel registro dello studio il nome del campo, il motivo della rimozione, la data della rimozione e le iniziali del revisore responsabile.
- Verificare l'identificabilità indiretta prima di condividere o pubblicare dati a livello di partecipante. Esaminare le piccole categorie demografiche create dalle combinazioni di sesso, età, anno accademico, categoria dell'istituzione e categoria della disciplina accademica. Se una categoria include meno di cinque rispondenti, unire le categorie, eliminare la categoria o fornire soltanto dati aggregati.
- Registrare nello studio il livello di disponibilità dei dati, specificando se i dati a livello di partecipante sono disponibili, limitati a causa di requisiti etici o di privacy, oppure sostituiti da un dataset aggregato del flusso di lavoro.
- Creare un registro di selezione prima della pulizia dei dati. Registrare la dimensione campionaria grezza, il criterio di selezione, il numero di record segnalati, il numero di record rimossi, il numero di record mantenuti, il motivo dell'esclusione, la data della decisione e le iniziali del revisore.
- Creare un file di tracciamento dell'analisi prima dell'analisi statistica. Registrare il nome del software, la versione del software, il sistema operativo, i nomi dei file, la versione dei dati, la versione dello script o della sintassi e la data di ogni esecuzione dell'analisi.
NOTA: Utilizzare il dataset grezzo bloccato soltanto per verifica. Eseguire tutte le operazioni di selezione, valutazione e analisi utilizzando la copia di lavoro.
4. Analizzare le risposte e costruire il set di dati analitico
- Applicare regole predefinite di esclusione e controllo qualità prima di calcolare qualsiasi punteggio a livello di scala.
- Applicare le regole di screening alla copia di lavoro in questo ordine: stato del consenso, idoneità, sottomissioni duplicate, dati mancanti, durata della risposta, risposte lineari continue, valori fuori intervallo e indicatori combinati di qualità della risposta.
- Dopo ogni operazione di screening, registrare il numero di record segnalati, rimossi e mantenuti nel registro di screening. Non sovrascrivere versioni precedenti del file di lavoro.
- Eliminare tutti i record in cui l'elemento relativo al consenso informato è segnato come “No” o lasciato senza risposta.
- Eliminare tutti i record che non soddisfano i criteri di inclusione definiti nel Passaggio 1.4.
- Verificare la presenza di sottomissioni duplicate utilizzando identificatori anonimi di risposta, orario di sottomissione, segnalazioni automatiche di sottomissione duplicata da parte della piattaforma e modelli di risposta ripetuti.
- Mantenere la prima sottomissione completa quando vengono rilevate voci duplicate, a meno che non vi sia una motivazione documentata a sostegno del mantenimento di una sottomissione completa successiva.
- Correggere tutte le regole relative alla qualità delle risposte prima di calcolare i punteggi delle scale. Tabella 2 riassume le soglie di esclusione, le soglie di segnalazione, la motivazione, il supporto letterario e il piano di analisi di sensibilità utilizzati nel flusso di lavoro.
- Verificare la presenza di dati mancanti. Rimuovere un rispondente quando mancano più del 20% di tutti gli elementi della scala. Sostituire un singolo elemento mancante con il punteggio medio del rispondente per la stessa scala solo se almeno l’80% di tale scala è stato completato. Non imputare variabili demografiche a meno che la variabile non venga utilizzata in alcuna analisi.
- Registrare il numero di rispondenti esclusi per più del 20% di elementi della scala mancanti e il numero di rispondenti ai quali è stata applicata l’imputazione del valore medio all’interno della scala. Nel dataset attuale, 4 rispondenti sono stati esclusi per più del 20% di elementi della scala mancanti, e 21 rispondenti hanno ricevuto l’imputazione del valore medio all’interno della scala per 37 elementi isolati mancanti.
- Verificare la durata della risposta. Segnalare le risposte completate in meno di 180 s. Trattare questo valore come un indicatore di velocità eccessiva piuttosto che come una regola automatica di esclusione.
- Verificare la presenza di risposte lineari continue. Segnalare una risposta quando la stessa opzione viene selezionata per più del 90% di tutti gli elementi della scala Likert. Trattare questo valore come un indicatore di modello di risposta piuttosto che come una regola automatica di esclusione.
- Verificare ulteriori indicatori di basso impegno, inclusa evidenza di sottomissioni duplicate, timestamp impossibili, stringhe di risposta ripetute in sottomissioni distinte o incongruenze tra i metadati della piattaforma e il contenuto del questionario.
- Eliminare una risposta segnalata solo quando almeno due indicatori di controllo qualità suggeriscono una risposta non valida, come ad esempio un tempo di completamento estremamente breve combinato a risposte lineari continue, evidenza di sottomissione duplicata o metadati della piattaforma impossibili19.
- Registrare tutti i record segnalati, anche quando vengono mantenuti. Nel dataset attuale, 19 risposte sono state segnalate per una durata di completamento < 180 s, 8 risposte sono state segnalate per risposte lineari continue >90%, e 13 record sono stati esclusi perché soddisfacevano due o più indicatori di qualità della risposta.
- Verificare la presenza di valori fuori intervallo. Confermare che gli elementi relativi alle emozioni negative rientrino nell’intervallo 1–4, quelli relativi alla procrastinazione accademica, al senso di appartenenza scolastico e al pensiero di ordine superiore rientrino nell’intervallo 1–5, e quelli relativi al benessere soggettivo rientrino nell’intervallo 1–6.
- Correggere un valore solo quando l’esportazione originale mostra chiaramente un errore di formattazione. Non modificare punteggi psicologici validi solo perché appaiono insolitamente alti o bassi.
- Generare una tabella del flusso di screening che riporti i questionari sottomessi, le esclusioni per consenso e idoneità, le esclusioni per duplicati, le esclusioni per dati mancanti, le segnalazioni per qualità della risposta, le esclusioni combinate per controllo qualità, le imputazioni per singoli elementi isolati, i casi analitici mantenuti e la dimensione finale del campione analitico.
- Completare la tabella del flusso di screening utilizzando il registro di screening bloccato e conservare una registrazione esportata delle decisioni di screening. Nel dataset attuale, il flusso di screening è stato il seguente: questionari sottomessi, n = 448; esclusioni per consenso o idoneità, n = 6; sottomissioni duplicate rimosse, n = 5; record esclusi per >20% di elementi della scala mancanti, n = 4; record esclusi per due o più indicatori di qualità della risposta, n = 13; dataset analitico finale, n = 420.
- Salvare i record mantenuti come dataset analitico. Utilizzare un nuovo nome di file con versione e conservare il registro di screening insieme al dataset analitico.
NOTA: Mantenere punteggi estremi validi a meno che non sia presente un problema documentato di qualità della risposta.
5. Valutare le scale psicologiche
- Convertire le risposte a livello di item in variabili a livello di scala solo dopo aver completato la verifica delle risposte e salvato il dataset analitico.
- Codificare tutti gli item di tipo Likert secondo gli estremi di risposta presenti nel questionario bloccato e secondo le regole di punteggio indicate nella mappa della scala.
- Mantenere inalterate le variabili originali degli item. Creare variabili derivate distinte per gli item ricodificati o con punteggio invertito.
- Calcolare il punteggio di ciascuna scala secondo la mappa della scala bloccata e lo strumento originale o il manuale di punteggio corrispondente.
- Invertire il punteggio degli item specificati di benessere soggettivo prima di calcolare il punteggio complessivo di benessere soggettivo. Per la scala di risposta da 1 a 6, calcolare ciascun item invertito come 7 meno il punteggio originale e aggiungere _R al nome della variabile derivata.
- Utilizzare le variabili con punteggio invertito, e non quelle originali, nel calcolo del benessere soggettivo.
- Calcolare ciascun punteggio a livello di scala come media aritmetica dei suoi item conservati: emozione negativa, procrastinazione accademica, senso di appartenenza scolastica, pensiero di ordine superiore e benessere soggettivo.
- Denominare le variabili finali a livello di scala come Emozione negativa, Procrastinazione accademica, Senso di appartenenza scolastica, Pensiero di ordine superiore e Benessere soggettivo.
- Verificare il valore minimo e massimo di ciascuna variabile a livello di scala rispetto al suo intervallo teorico di risposta. Rivedere la codifica, l'inversione del punteggio e la gestione dei valori mancanti se uno qualsiasi dei punteggi rientra al di fuori dell'intervallo atteso.
- Verificare il verso di ciascuna scala rispetto alla mappa della scala prima dell'analisi inferenziale. Punteggi più elevati devono riflettere il verso inteso della costruzione.
- Eseguire un controllo di audit sull'inversione del punteggio prima dell'analisi. Ricalcolare gli item con punteggio invertito per un sottoinsieme casuale di record o per tutti gli item con punteggio invertito quando possibile, e registrare il risultato dell'audit nel registro di verifica del punteggio.
- Se viene rilevato un errore di punteggio, correggere la variabile derivata, rigenerare il punteggio di scala interessato, aggiornare il registro di verifica del punteggio e rieseguire tutte le analisi successive e le tabelle sorgenti delle figure basate sul dataset analitico corretto.
NOTA: Considerare l'inversione del punteggio e la verifica dell'intervallo come controlli obbligatori prima dell'analisi delle correlazioni, del confronto tra gruppi, della modellazione di regressione o della visualizzazione.
6. Valutare la coerenza interna e le proprietà descrittive
- Calcolare la coerenza interna, le correlazioni corrette tra item e punteggio totale, e le statistiche descrittive per ciascuna scala utilizzando le variabili degli item definite nella mappa di scala bloccata.
- Registrare l'alpha di Cronbach, il numero di item, la dimensione campionaria valida, le correlazioni corrette tra item e punteggio totale e i valori di alpha-se-l'item-fosse-eliminato per ciascuna scala.
- Utilizzare un valore di alpha di Cronbach pari a 0,70 come soglia minima accettabile di affidabilità per questo flusso di lavoro. Prima di rimuovere qualsiasi item, verificare la formulazione dell'item, la direzione del punteggio, la codifica inversa, l'allineamento al costrutto e la documentazione dello strumento originale20.
- Calcolare l'omega di McDonald come stima supplementare dell'affidabilità quando l'ambiente di analisi lo consente. Riportare l'omega insieme all'alpha di Cronbach quando le due stime portano a interpretazioni diverse dell'affidabilità.
- Esaminare attentamente ogni item con una correlazione corretta tra item e punteggio totale negativa o molto bassa prima di considerarne la rimozione. Considerare inizialmente tale situazione come un possibile problema di codifica, di punteggio inverso o di allineamento al costrutto.
- Non rimuovere un item soltanto per aumentare l'alpha di Cronbach. La rimozione di un item deve essere giustificata dal manuale di correzione, dalla formulazione dell'item, dalla correlazione corretta tra item e punteggio totale, dall'adeguatezza concettuale e dalla verifica documentata della codifica.
- Calcolare le statistiche descrittive per tutte e cinque le variabili a livello di scala, inclusi media, deviazione standard, valore minimo, valore massimo, asimmetria (skewness) e curtosi (kurtosis).
- Verificare la presenza di concentrazioni ai valori estremi registrando la proporzione di rispondenti che hanno ottenuto i punteggi minimi e massimi possibili per ciascuna scala.
- Registrare nel registro di analisi le stime di affidabilità, le diagnosi relative agli item e al punteggio totale, le statistiche descrittive e ogni decisione relativa alla correzione.
NOTA: L'alpha di Cronbach viene utilizzato come controllo dell'affidabilità, non come procedura completa di validazione psicometrica. Quando è richiesta una valutazione formale della misurazione, integrare questo flusso di lavoro con l'omega di McDonald, l'analisi fattoriale confermativa, i test di invarianza di misura, la modellazione della risposta all'item o altri metodi basati su variabili latenti.
7. Eseguire l'analisi di correlazione
- Utilizzare le cinque variabili verificate a livello di scala: emozione negativa, procrastinazione accademica, senso di appartenenza scolastica, pensiero di ordine superiore e benessere soggettivo.
- Prima di calcolare le correlazioni di Pearson, esaminare le distribuzioni e i diagrammi di dispersione bivariati per ogni coppia di variabili a livello di scala.
- Valutare se le variabili mostrano una variazione approssimativamente continua dei punteggi, asimmetrie marcate, relazioni non lineari o schemi anomali influenti.
- Calcolare i coefficienti di correlazione di Pearson e i valori p a due code per tutte le coppie di variabili a livello di scala quando le assunzioni sono accettabili per un'analisi descrittiva dell'associazione.
- Registrazione del coefficiente di correlazione, pvalore, dimensione del campione e direzione dell'associazione per ogni coppia di variabili.
- Riportare i coefficienti di correlazione con tre cifre decimali.
- Confrontare la direzione di ciascun coefficiente con la mappa della scala. Verificare nuovamente la valutazione degli elementi se un coefficiente contraddice la direzione prevista del costrutto.
- Salvare la matrice di correlazione verificata come tabella numerica sorgente per la mappa termica delle correlazioni nella sezione Risultati Rappresentativi.
- Quando le distribuzioni sono fortemente asimmetriche, è richiesta una sensibilità su scala ordinale o i diagrammi di dispersione suggeriscono associazioni monotone ma non lineari, ripetere l'analisi utilizzando la correlazione di Spearman e confrontare la direzione e l'entità relativa delle associazioni.
- Registrare se i risultati di Pearson e Spearman hanno portato alla stessa interpretazione sostanziale.
NOTA: Utilizzare l'analisi della correlazione sia come verifica descrittiva dell'associazione sia come controllo della direzione dei punteggi.
8. Creare gruppi con elevato e ridotto benessere soggettivo
- Utilizzare il dataset analitico pulito e punteggiato. Non tornare all'esportazione grezza per la costruzione dei gruppi.
- Utilizzare il punteggio continuo di benessere soggettivo come esito primario per la modellazione della regressione. Utilizzare il raggruppamento alto-basso solo per il confronto descrittivo dei profili.
- Ordinare i rispondenti in base al punteggio di benessere soggettivo, dal più alto al più basso.
- Applicare la regola prespecificata del 27% per i gruppi estremi per definire i gruppi di alto e basso benessere soggettivo. Documentare la motivazione di questa soglia in Tabella 2 e nel registro di analisi.
- Assegnare i rispondenti al 27% superiore al gruppo di alto benessere soggettivo e quelli al 27% inferiore al gruppo di basso benessere soggettivo.
- Mantenere il 46% centrale nel dataset analitico completo per le statistiche descrittive, l'analisi delle correlazioni, il confronto per sesso e la modellazione della regressione, ma escludere questi casi dal confronto alto-basso.
- Creare una variabile di raggruppamento denominata Gruppo di benessere soggettivo. Codificare il gruppo superiore come Alto, il gruppo inferiore come Basso e i restanti rispondenti come Medio.
- Verificare che i gruppi alto e basso contengano il numero previsto di casi. Se si verificano punteggi pari al limite del 27%, applicare la regola prespecificata per la gestione dei pareggi e registrare la decisione nel registro di analisi.
- Eseguire un controllo di sensibilità quando il limite del 27% determina un'instabilità nell'appartenenza ai gruppi a causa di punteggi pari o di una dimensione campionaria ridotta. Utilizzare una regola alternativa prespecificata, come il raggruppamento in terzili, e riportare se l'interpretazione rimane invariata.
NOTA: Il raggruppamento alto-basso è una procedura descrittiva di confronto. Non deve sostituire il punteggio continuo di benessere soggettivo nel modello primario di regressione.
9. Confronta i gruppi con elevato e basso benessere soggettivo
- Filtra il dataset analitico per mantenere solo i rispondenti classificati come Alto o Basso nella variabile di raggruppamento relativa al benessere soggettivo.
- Confrontare i gruppi alto e basso per quanto riguarda le emozioni negative, la procrastinazione accademica, il senso di appartenenza scolastico e il pensiero di ordine superiore.
- Prima del confronto tra gruppi, esaminare le distribuzioni specifiche per gruppo, le dimensioni campionarie e l'uguaglianza delle varianze per ciascuna variabile.
- Utilizzare un campione indipendente t-test quando le assunzioni di distribuzione e di varianza sono accettabili. Utilizzare il test di Welch t-test quando l'assunzione di omogeneità della varianza non è soddisfatta.
- Registrare le medie dei gruppi, le deviazioni standard, le differenze tra le medie tvalori p, gradi di libertà p-valori e intervalli di confidenza al 95%.
- Calcolare la d di Cohen per ogni differenza tra gruppi e interpretare l'entità dell'effetto insieme al valore p.
- Verificare se la direzione di ciascuna differenza tra gruppi è coerente con le definizioni del costrutto e con la matrice di correlazione.
- Salvare la tabella verificata di confronto tra gruppi come fonte numerica per qualsiasi visualizzazione del confronto tra gruppi.
- Riportare questa analisi come un confronto tra profili estremi di benessere soggettivo.
NOTA: Non interpretare il confronto tra alto e basso come una prova di causalità.
10. Esaminare le differenze di sesso
- Rimuovere il filtro del gruppo alto-basso e tornare al set completo di dati analitici.
- Utilizzare il sesso come variabile descrittiva di raggruppamento piuttosto che come esposizione causale.
- Confrontare i rispondenti di sesso femminile e maschile per quanto riguarda le emozioni negative, la procrastinazione accademica, il senso di appartenenza scolastico, il pensiero di ordine superiore e il benessere soggettivo.
- Prima del confronto, esaminare le dimensioni campionarie specifiche per gruppo, la presenza di dati mancanti, le distribuzioni e l'uguaglianza delle varianze.
- Utilizzare un test t per campioni indipendenti quando le assunzioni sono accettabili. Utilizzare il test t di Welch quando l'assunzione di uguaglianza delle varianze non è supportata.
- Registrare le medie dei gruppi, le deviazioni standard, le differenze tra medie, i valori t, i gradi di libertà, i valori p, gli intervalli di confidenza al 95% e i valori di d di Cohen.
- Interpretare le differenze di sesso in modo descrittivo e riportare le dimensioni dell'effetto insieme ai valori p.
- Non utilizzare i risultati del confronto per sesso per giustificare esclusioni a posteriori, modifiche della scala o interpretazioni causali.
NOTA: I confronti per sesso sono inclusi come verifiche descrittive di sottogruppi all'interno di questo flusso di lavoro basato su questionario trasversale.
11. Stimare il modello di regressione
- Utilizzare il benessere soggettivo come variabile dipendente.
- Utilizzare l'emozione negativa, la procrastinazione accademica, il senso di appartenenza scolastica e il pensiero di ordine superiore come predittori simultanei a livello di scala21.
- Utilizzare le variabili continue a livello di scala create durante il calcolo del punteggio della scala. Non sostituire il punteggio continuo di benessere soggettivo con la variabile categorizzata in gruppi alto-basso.
- Adattare il modello principale utilizzando una regressione lineare multipla con inserimento simultaneo.
- Registrare i coefficienti non standardizzati, i coefficienti standardizzati, gli errori standard, i valori t, i valori p, gli intervalli di confidenza al 95%, R2, R2 aggiustato, la tolleranza e il fattore di inflazione della varianza.
- Utilizzare valori del fattore di inflazione della varianza inferiori a 5,00 come soglia per l'assenza di multicollinearità grave.
- Esaminare i diagrammi di dispersione bivariati, i diagrammi di regressione parziale o i diagrammi componente-più-residuo per valutare se le associazioni tra i predittori e il benessere soggettivo siano approssimativamente lineari.
- Valutare l'indipendenza dei residui utilizzando la statistica di Durbin-Watson.
- Valutare la normalità dei residui utilizzando un diagramma Q-Q dei residui e un test formale di normalità, quando appropriato rispetto alla dimensione del campione.
- Valutare l'omoschedasticità utilizzando un diagramma dei residui standardizzati rispetto ai valori predetti standardizzati.
- Salvare i residui standardizzati, i valori predetti standardizzati, i valori di leva (leverage) e la distanza di Cook per i controlli diagnostici.
- Stimare un modello aggiuntivo corretto che includa i quattro predittori psicologici e le variabili demografiche riportate nella descrizione del campione, tra cui sesso, età, livello d'anno, categoria dell'istituzione e categoria dell'indirizzo accademico, quando queste variabili sono disponibili e adeguatamente distribuite.
- Confrontare il modello principale con il modello aggiuntivo corretto. Registrare se direzione, entità e interpretazione statistica dei quattro predittori psicologici rimangano stabili dopo la correzione demografica.
- Salvare i coefficienti standardizzati verificati e gli intervalli di confidenza al 95% del modello principale come tabella numerica di riferimento per il grafico dei coefficienti nella sezione Risultati Rappresentativi22.
NOTA: Interpretare i coefficienti di regressione come associazioni condizionali, non come effetti causali. Il modello corretto per le variabili demografiche viene utilizzato in un'analisi di sensibilità per valutare se le conclusioni del flusso di lavoro rimangano stabili dopo aver tenuto conto delle variabili contestuali disponibili.
12. Diagnosticare il modello di regressione
- Esaminare i residui standardizzati del modello di regressione stimato. Contrassegnare i casi con residui standardizzati in valore assoluto superiori a 3,00.
- Esaminare i valori di leva (leverage) e la distanza di Cook per identificare osservazioni influenti.
- Contrassegnare le osservazioni con distanza di Cook superiore a 4/n come potenzialmente influenti, dove n rappresenta la dimensione campionaria analitica. Considerare una distanza di Cook superiore a 1,00 come soglia di riferimento per un'influenza severa, piuttosto che come unico criterio di screening.
- Esaminare il grafico dei residui rispetto ai valori predetti per verificare la presenza di non linearità, varianza non uniforme e raggruppamenti insoliti.
- Esaminare il grafico Q-Q dei residui e il risultato del test di normalità dei residui. Registrare se la valutazione di normalità supporta l'uso del modello lineare per l'analisi descrittiva delle associazioni.
- Registrare la statistica di Durbin-Watson e determinare se l'indipendenza dei residui è accettabile.
- Rivedere tutti i casi contrassegnati in base al registro di screening, al registro di verifica della codifica e ai criteri di idoneità.
- Mantenere i casi contrassegnati quando rappresentano osservazioni valide e non riflettono errori di immissione dati, errori di codifica, sottomissioni duplicate, violazioni dei criteri di idoneità o problemi documentati di qualità delle risposte.
- Correggere o rimuovere un caso contrassegnato solo quando la traccia di verifica (audit trail) evidenzia un errore documentato relativo a procedure, idoneità, codifica, punteggio o immissione dati.
- Rieseguire il modello di regressione dopo eventuali correzioni documentate e confrontare i coefficienti, gli intervalli di confidenza, R2, R2 aggiustato e gli output diagnostici con il modello originale.
- Eseguire un controllo di sensibilità all'influenza ricalibrando il modello escludendo i casi con distanza di Cook superiore a 4/n. Riportare se l'interpretazione sostanziale cambia.
- Registrare la decisione diagnostica finale nel registro di analisi, includendo il numero di casi contrassegnati dai residui standardizzati, il numero contrassegnato da distanza di Cook superiore a 4/n, la distanza massima di Cook, la statistica di Durbin-Watson e la conclusione derivante dai controlli di normalità e linearità dei residui.
NOTA: Non rimuovere casi influenti esclusivamente per migliorare l'adattamento del modello. La rimozione o correzione deve basarsi su una motivazione documentata nella traccia di verifica.
Risultati
Set di dati analitico generato dopo la selezione in base alla risposta
Il flusso di lavoro di selezione delle risposte ha prodotto un set di dati analitico composto da 420 record anonimi di studenti, provenienti da 448 questionari sottoposti. Il registro di selezione ha documentato ogni punto decisionale. Sono stati rimossi sei record perché non erano stati soddisfatti i requisiti di consenso o di idoneità, cinque sottomissioni duplicate sono state eliminate, quattro record sono stati esclusi poiché presentavano più del 20% di elementi mancanti in tutte le scale e 13 record sono stati esclusi perché soddisfacevano due o più indicatori di qualità della risposta. Diciannove risposte sono state segnalate per una durata di compilazione <180 s, otto risposte sono state segnalate per una risposta lineare >90%, e a 21 rispondenti è stata applicata un'imputazione della media all'interno della scala per 37 elementi mancanti isolati. Il set di dati analitico finale non conteneva informazioni direttamente identificabili sui partecipanti, nessun caso incluso superava la soglia di esclusione per dati mancanti e tutte le risposte agli elementi incluse rientravano negli intervalli di risposta predeterminati. Il flusso di selezione è riassunto nella Tabella 3.
Il campione selezionato comprendeva 275 rispondenti di sesso femminile e 145 rispondenti di sesso maschile, pari rispettivamente al 65,5% e al 34,5% del set di dati analitico. L'età media era di 20,1 ± 1,2 anni. I rispondenti erano distribuiti tra quattro livelli accademici universitari, con il primo, il secondo, il terzo e il quarto anno che rappresentavano rispettivamente il 27,1%, il 27,4%, il 25,5% e il 20,0% del campione. Il set di dati includeva inoltre tre categorie istituzionali e cinque categorie di indirizzi di studio. Dopo la revisione delle categorie, nessuna cella demografica pubblicata conteneva meno di cinque rispondenti. Le caratteristiche demografiche del set di dati analitico sono riassunte nella Tabella 4.
Costruzione della scala, verifica dell'intervallo e esempi di flusso di lavoro subottimale
Dopo la codifica degli elementi e la rivalutazione inversa, sono state calcolate cinque variabili a livello di scala: emozione negativa, procrastinazione accademica, senso di appartenenza scolastica, pensiero di ordine superiore e benessere soggettivo. Ciascun punteggio è rimasto entro il proprio intervallo teorico di risposta. I punteggi relativi all'emozione negativa variavano da 1,048 a 3,143 su una scala da 1 a 4. La procrastinazione accademica, il senso di appartenenza scolastica e il pensiero di ordine superiore variavano rispettivamente da 1,312 a 4,250, da 2,333 a 4,444 e da 2,350 a 4,850 sulle rispettive scale da 1 a 5. Il benessere soggettivo variava da 2,000 a 5,300 su una scala da 1 a 6. La verifica della rivalutazione inversa non ha rilevato discrepanze tra le variabili ottenute con punteggio invertito e la regola di punteggio bloccata nel set di dati analitico finale. Questi controlli hanno confermato che la codifica degli elementi, la rivalutazione inversa, la gestione degli elementi mancanti e l'aggregazione dei punteggi sono stati completati senza errori rilevabili di intervallo.
Il flusso di lavoro ha inoltre prodotto esempi di audit subottimali che illustrano come vengano rilevati errori o risultati discutibili prima dell'analisi finale. Durante un audit, è stato individuato un valore invertito di benessere soggettivo calcolato in modo errato, poiché il registro di verifica del punteggio ha confrontato il valore originale, la formula attesa «punteggio invertito = 7 - punteggio originale», il valore derivato e l'intervallo finale della scala. La variabile derivata è stata corretta, il punteggio di benessere soggettivo è stato rigenerato e tutti i risultati successivi di analisi descrittiva, correlazione, confronto, regressione, diagnosi e figure sono stati rieseguiti. In un altro file di lavoro intermedio, un valore di item fuori intervallo è stato identificato durante la verifica dell'intervallo ed è stato attribuito alla gestione del foglio elettronico piuttosto che all'esportazione grezza bloccata. La copia di lavoro è stata corretta e documentata senza modificare alcuna risposta estrema valida. È stata inoltre esaminata un'avvertenza relativa all'affidabilità quando un item ha mostrato una correlazione corretta item-totale inferiore rispetto agli altri item della stessa scala; poiché la formulazione dell'item, la direzione del punteggio e l'allineamento al costrutto erano corretti, l'item è stato mantenuto. È stato identificato un errore nella visualizzazione preliminare quando una figura non corrispondeva alla tabella numerica verificata; la figura è stata rigenerata a partire dalla tabella verificata e il registro fonte-figura è stato aggiornato. Questi esempi dimostrano che il flusso di lavoro non solo genera risultati validi, ma rileva anche errori di codifica, problemi di intervallo, avvertenze sull'affidabilità, discrepanze tra figure e fonti e questioni relative alla qualità delle risposte attraverso la traccia di audit.
Proprietà descrittive e coerenza interna
Le cinque variabili a livello di scala hanno mostrato una variazione utilizzabile. Il punteggio medio relativo alle emozioni negative era di 2,099 ± 0,391, mentre il punteggio medio relativo alla procrastinazione accademica era di 2,639 ± 0,484. Il senso di appartenenza scolastica e il pensiero di ordine superiore hanno mostrato valori medi moderatamente elevati, rispettivamente di 3,343 ± 0,390 e 3,627 ± 0,418. Il punteggio medio del benessere soggettivo era di 3,784 ± 0,543. Nessuna scala ha mostrato un evidente pattern di pavimento o soffitto, e la proporzione di rispondenti al valore teorico minimo o massimo era inferiore al 2,0% per ciascuna scala.
La coerenza interna era accettabile per tutte e cinque le scale. I valori dell'alfa di Cronbach variavano da 0,834 a 0,899, superando la soglia predeterminata di 0,70. L'emozione negativa mostrava la più elevata coerenza interna, con un alfa di Cronbach di 0,899, seguita dal benessere soggettivo con un valore di 0,895. I valori dell'omega di McDonald variavano da 0,842 a 0,906 e le stime dell'omega non hanno modificato l'interpretazione dell'affidabilità. La revisione delle correlazioni corrette tra item e punteggio totale non ha identificato alcun item da rimuovere. Le statistiche descrittive e le stime di affidabilità sono riportate nella Tabella 5.
Struttura delle correlazioni tra le variabili a livello di scala
La matrice di correlazione è stata utilizzata come misura descrittiva dell'associazione e per verificare la direzione dei punteggi. Prima del calcolo delle correlazioni di Pearson, sono state esaminate le distribuzioni delle scale e i diagrammi di dispersione bivariati. Nessuna variabile ha mostrato asimmetria o curtosi elevate, e nessun grafico bivariato ha evidenziato un forte andamento non lineare tale da invalidare l'analisi descrittiva della correlazione di Pearson. Il benessere soggettivo era correlato negativamente con le emozioni negative (r = -0.496) e con la procrastinazione accademica (r = -0.294), e positivamente con il senso di appartenenza scolastica (r = 0.481) e con il pensiero di ordine superiore (r = 0.386). Le restanti associazioni seguivano la stessa logica di punteggio: le emozioni negative erano associate positivamente alla procrastinazione accademica (r = 0.270) e negativamente al senso di appartenenza scolastica (r = -0.346) e al pensiero di ordine superiore (r = -0.205); la procrastinazione accademica era associata negativamente al senso di appartenenza scolastica (r = -0.222) e al pensiero di ordine superiore (r = -0.134); infine, il senso di appartenenza scolastica era associato positivamente al pensiero di ordine superiore (r = 0.310). La matrice completa delle correlazioni di Pearson è riportata nella Tabella 6.
Un controllo di sensibilità di Spearman ha prodotto la stessa interpretazione direzionale per tutte le coppie di variabili. Le correlazioni di Spearman tra benessere soggettivo e i quattro predittori erano ρ = -0,502 per l'emozione negativa, ρ = -0,301 per la procrastinazione accademica, ρ = 0,477 per il senso di appartenenza scolastico e ρ = 0,392 per il pensiero di ordine superiore. La matrice di Pearson verificata è stata utilizzata come tabella numerica sorgente per la visualizzazione. Figura 2A presenta la mappa termica completa delle correlazioni tra le cinque variabili a livello di scala. Figura 2B mostra le quattro correlazioni con il benessere soggettivo.
Dimostrazione comparativa mediante gruppi con elevato e ridotto benessere soggettivo
La regola del 27% è stata utilizzata come dimostrazione di un approccio comparativo, piuttosto che come classificazione effettiva di profili di benessere nel mondo reale. Tale regola ha prodotto due gruppi di uguale dimensione: 113 rispondenti nel gruppo con elevato benessere soggettivo e 113 nel gruppo con ridotto benessere soggettivo. I 194 rispondenti centrali sono stati mantenuti nel dataset analitico completo, ma esclusi da questo confronto comparativo. Nessun valore soglia ha modificato l'assegnazione ai gruppi.
Questo modulo ha mostrato che il flusso di lavoro può generare una variabile di raggruppamento predefinita, filtrare il dataset analitico, calcolare statistiche descrittive specifiche per gruppo, eseguire confronti tra gruppi appropriati in base alle assunzioni, ed esportare una tabella sorgente verificata per la visualizzazione. Il gruppo con elevato benessere soggettivo ha mostrato emozioni negative inferiori rispetto al gruppo con basso benessere soggettivo (1,864 ± 0,358 contro 2,335 ± 0,343; differenza media = -0,472) e una minore procrastinazione accademica (2,455 ± 0,476 contro 2,801 ± 0,483; differenza media = -0,346). Il senso di appartenenza scolastico e il pensiero di ordine superiore erano più elevati nel gruppo con elevato benessere soggettivo, con differenze medie rispettivamente di 0,454 e 0,351. Tutti e quattro i confronti sono risultati significativi (p < 0,001), con valori di d di Cohen pari a -1,346 per le emozioni negative, -0,722 per la procrastinazione accademica, 1,279 per il senso di appartenenza scolastico e 0,860 per il pensiero di ordine superiore. Il test t di Welch è stato utilizzato quando l'assunzione di omogeneità della varianza non era soddisfatta; in caso contrario, è stato mantenuto il classico test t per campioni indipendenti. Questi risultati non devono essere interpretati come evidenza che i predittori selezionati definiscano profili reali di benessere degli studenti nel mondo reale, poiché i gruppi sono stati creati a partire dalla variabile dipendente e successivamente confrontati su variabili correlate. Il confronto tra gruppi alto e basso è riassunto nella Tabella 7.
Confronto descrittivo per sesso
Il sesso è stato esaminato come variabile descrittiva di raggruppamento. I punteggi medi delle emozioni negative erano leggermente più elevati nei rispondenti di sesso femminile rispetto a quelli di sesso maschile (2.129 ± 0.380 contro 2.042 ± 0.407). Tale differenza era statisticamente significativa, ma di entità ridotta (p = 0.033; d di Cohen = 0.224). La procrastinazione accademica, il senso di appartenenza scolastico, il pensiero di ordine superiore e il benessere soggettivo non hanno mostrato differenze significative in base al sesso. I valori medi del benessere soggettivo erano quasi identici tra rispondenti di sesso femminile e maschile (3.781 ± 0.521 contro 3.789 ± 0.583; p = 0.887; d di Cohen = -0.015). Verifiche di sensibilità mediante il test t di Welch non hanno modificato l'interpretazione dei risultati relativi al confronto per sesso. I risultati sulle differenze di sesso sono riportati nella Tabella 8.
Modello di regressione come esempio di generazione del modello e verifica diagnostica
Il modello di regressione lineare multipla è stato utilizzato come esempio per generare, diagnosticare e verificare un modello a partire da dati ottenuti da un questionario punteggiato. Il benessere soggettivo è stato inserito come variabile dipendente, mentre emozione negativa, procrastinazione accademica, senso di appartenenza scolastico e pensiero di ordine superiore sono stati inseriti contemporaneamente come predittori a livello di scala. Lo scopo di questo modulo era dimostrare l'estrazione dei coefficienti, i controlli sulla multicollinearità, le diagnosi dei residui, la valutazione dell'influenza, un'analisi di sensibilità aggiustata per variabili demografiche e la preparazione di figure e codice sorgente.
Il modello ha spiegato una proporzione moderata della varianza nel benessere soggettivo, con R2 = 0.411 e R2 aggiustato = 0.406. L'emozione negativa ha mostrato il coefficiente standardizzato più basso (B = -0.450, β standardizzato = -0.324). La procrastinazione accademica ha mostrato anch'essa un coefficiente negativo (B = -0.130, β standardizzato = -0.116). L'appartenenza scolastica e il pensiero di ordine superiore hanno mostrato coefficienti standardizzati positivi rispettivamente pari a β = 0.275 e β = 0.218. Tutti e quattro i predittori erano statisticamente significativi nel modello stimato: emozione negativa, appartenenza scolastica e pensiero di ordine superiore con p < 0.001, e procrastinazione accademica con p = 0.004. Non è stata rilevata multicollinearità, poiché tutti i valori del fattore di inflazione della varianza erano inferiori a 1,24. Questi risultati della regressione rappresentano output di verifica del modello, non una spiegazione psicologica definitiva del benessere degli studenti. Tabella 9 riporta l'output completo della regressione.
È stato stimato un modello supplementare aggiustato per le variabili demografiche aggiungendo sesso, età, anno accademico, categoria dell'istituzione e categoria del corso di studi ai quattro predittori psicologici. Il modello aggiustato ha spiegato una proporzione simile di varianza, con R2 = 0.427 e R2 aggiustato = 0.414. La direzione e l'interpretazione statistica dei quattro predittori psicologici sono rimaste invariate dopo l'aggiustamento demografico. Il modello di sensibilità aggiustato per le variabili demografiche è riassunto in Tabella 10. Figura 3A mostra i coefficienti standardizzati e gli intervalli di confidenza al 95% per i quattro predittori. Figura 3B presenta la rappresentazione diagnostica basata sui valori predetti standardizzati, sui residui standardizzati e sulla distanza di Cook.
Diagnostica della regressione e conservazione del modello
La diagnostica della regressione non ha indicato che il modello adattato fosse influenzato da un singolo dato influente. I grafici bivariati e di regressione parziale non hanno mostrato una forte non linearità. Il grafico dei residui rispetto ai valori predetti non ha evidenziato un'eteroschedasticità grave né un raggruppamento insolito. La statistica di Durbin-Watson era pari a 1.93, indicativa di un'accettabile indipendenza dei residui. Il grafico Q-Q dei residui non ha mostrato forti deviazioni dalla normalità. Un test formale di normalità dei residui è risultato statisticamente significativo, W = 0.992, p = 0.031, ma il grafico Q-Q e la dimensione del campione hanno supportato la conservazione del modello lineare per l'analisi descrittiva dell'associazione.
Due record presentavano residui standardizzati assoluti maggiori di 3,00. Nessun record presentava una distanza di Cook superiore a 1,00. Utilizzando la soglia più sensibile della distanza di Cook >4/n, in cui n = 420 e 4/n = 0,0095, 17 record sono stati identificati come potenzialmente influenti. La massima distanza di Cook è stata 0,037. I casi con residui e influenza segnalati sono stati esaminati in base al registro di screening, al registro di verifica della valutazione e ai criteri di idoneità. Nessuno di essi presentava evidenze di errori nella digitazione dei dati, valutazioni errate, risposte duplicate, mancata idoneità o problemi documentati relativi alla qualità delle risposte; pertanto, questi casi sono stati mantenuti nel modello finale. È stata effettuata una verifica della sensibilità all'influenza, escludendo i casi con distanza di Cook >4/n, ha prodotto un'interpretazione del flusso di lavoro identica a quella del modello principale. La variazione massima assoluta nei coefficienti standardizzati è stata di 0,026, e l'aggiustato R2 cambiato da 0,406 a 0,405. I risultati relativi alla diagnosi e alla sensibilità sono riassunti in Tabella 11.
Verifica interna della pipeline analitica
Il flusso di lavoro è stato ripetuto a partire dal dataset analitico pulito e punteggiato, utilizzando le stesse regole di punteggio, soglie decisionali e file di tracciamento dell'analisi. Sono state ripetute l'analisi della coerenza interna, le statistiche descrittive, l'analisi delle correlazioni, i confronti tra gruppi ad alto e basso punteggio, i confronti per sesso, la modellazione regressiva, i controlli diagnostici e la preparazione delle fonti per la visualizzazione. Gli output ripetuti corrispondevano alle statistiche descrittive originali, alla matrice di correlazione, ai valori dei confronti tra gruppi, ai coefficienti di regressione, agli output diagnostici e ai file sorgente per la visualizzazione. Ciò ha confermato la stabilità computazionale della pipeline analitica quando applicata allo stesso dataset analitico bloccato. Questo controllo non costituisce una riproducibilità procedurale indipendente, che richiederebbe invece un analista indipendente per applicare l'intero flusso di lavoro a partire dall'esportazione grezza bloccata e ottenere gli stessi output documentati.
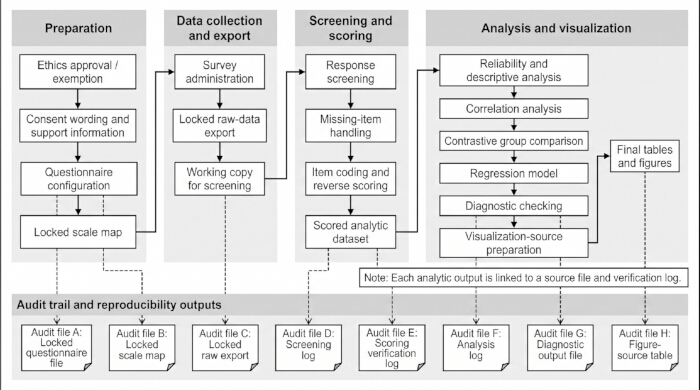
Figura 1: Flusso di lavoro per l'elaborazione dei dati soggettivi sul benessere basati su questionario. Lo schema mostra la sequenza del protocollo e i principali risultati della verifica, inclusa la preparazione etica, la configurazione del questionario, la somministrazione del sondaggio, l'esportazione dei dati grezzi, la mappa delle scale, il registro di screening, il dataset analitico punteggiato, le tabelle di analisi verificate, le diagnosi di regressione, i file sorgente delle figure e gli output di visualizzazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
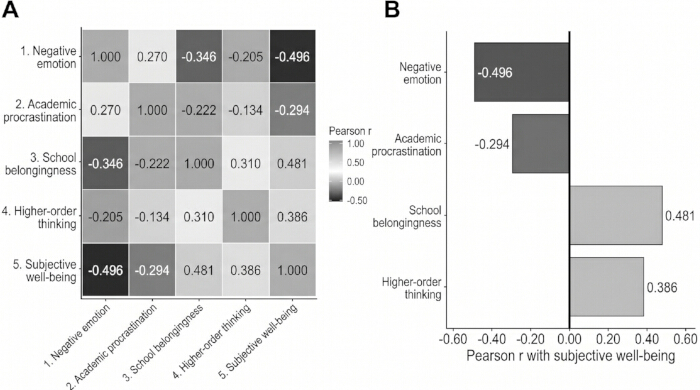
Figura 2: Struttura delle correlazioni tra le variabili a livello di scala. (A) Mappa termica delle correlazioni di Pearson generata a partire dalla matrice di correlazione verificata riportata nella Tabella 6. (B) Profilo delle correlazioni centrato sul benessere soggettivo, generato dalla stessa tabella sorgente verificata. Sono mostrate tutte e cinque le variabili a livello di scala: emozione negativa, procrastinazione accademica, senso di appartenenza scolastica, pensiero di ordine superiore e benessere soggettivo. Cliccare qui per visualizzare una versione ingrandita di questa figura.
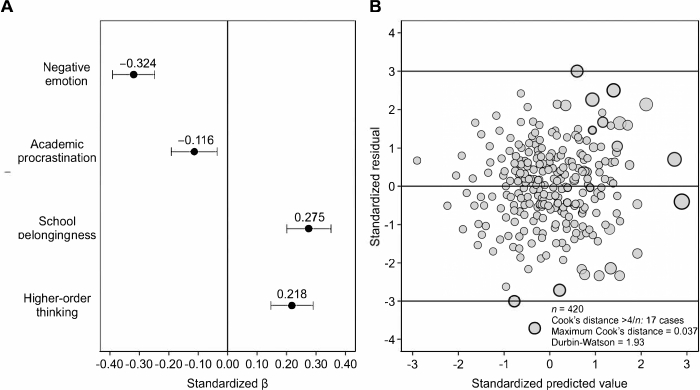
Figura 3: Visualizzazione dei coefficienti di regressione e dei risultati diagnostici. (A) Coefficienti di regressione standardizzati e intervalli di confidenza al 95% ottenuti dall'output principale della regressione riportato nella Tabella 9. (B) Rappresentazione diagnostica della regressione generata a partire dai valori predetti standardizzati, dai residui standardizzati e dai valori della distanza di Cook riassunti nella Tabella 11. Valori più elevati della distanza di Cook indicano osservazioni con un'influenza potenzialmente maggiore sul modello stimato. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella 1: Struttura del questionario e schema di punteggio delle scale. Questa tabella riassume il quadro di misurazione, inclusi il nome della costruzione, lo strumento di origine, la citazione della fonte, lo stato di adattamento o documentazione, il numero di elementi, l'intervallo di risposta, la direzione del punteggio, la necessità di inversione del punteggio, il metodo di calcolo del punteggio, la variabile finale a livello di scala e il ruolo nel protocollo. Cliccare qui per scaricare questa tabella.
Tabella 2: Criteri di screening delle risposte e criteri decisionali analitici. Questa tabella elenca i criteri predeterminati per lo screening del consenso, lo screening dell'idoneità, la revisione delle risposte duplicate, la gestione dei dati mancanti, l'individuazione della durata delle risposte, il rilevamento di risposte lineari continue, gli intervalli validi delle risposte, la valutazione dell'affidabilità, la classificazione nei gruppi alto-basso, la diagnostica della regressione e i controlli di sensibilità. Cliccare qui per scaricare questa tabella.
Tabella 3: Flusso di screening dai questionari sottoposti al dataset analitico finale. Questa tabella riporta il numero di questionari sottoposti, record segnalati, record rimossi, record conservati e fonti di verifica in ciascun passaggio di screening. La durata del completamento e le risposte lineari continue sono state considerate indicatori di qualità della risposta piuttosto che criteri automatici di esclusione. Cliccare qui per scaricare questa tabella.
Tabella 4: Caratteristiche demografiche del dataset analitico. Questa tabella riassume i record anonimi degli studenti conservati dopo la verifica delle risposte, inclusi sesso, età, anno accademico della laurea triennale, categoria dell'istituzione e categoria del corso di laurea. Le celle demografiche sono state esaminate per valutare il rischio di identificabilità indiretta prima della pubblicazione. Cliccare qui per scaricare questa tabella.
Tabella 5: Statistiche descrittive, verifica dell'intervallo e coerenza interna delle cinque variabili a livello di scala. Questa tabella riporta il numero di item, l'intervallo teorico, l'intervallo osservato, la media, la deviazione standard, l'alfa di Cronbach, l'omega di McDonald e la concentrazione ai valori estremi per emozione negativa, procrastinazione accademica, senso di appartenenza scolastico, pensiero di ordine superiore e benessere soggettivo. Cliccare qui per scaricare questa tabella.
Tabella 6: Matrice di correlazione di Pearson delle variabili a livello di scala. Questa tabella presenta i coefficienti di correlazione di Pearson tra emozione negativa, procrastinazione accademica, senso di appartenenza scolastico, pensiero di ordine superiore e benessere soggettivo. La matrice è stata utilizzata come output descrittivo delle associazioni e come passaggio di verifica della direzione dei punteggi. Cliccare qui per scaricare questa tabella.
Tabella 7: Confronto contrastivo tra gruppi con elevato e ridotto benessere soggettivo. Questa tabella confronta emozioni negative, procrastinazione accademica, senso di appartenenza scolastica e pensiero di ordine superiore tra i rispondenti appartenenti al 27% superiore e al 27% inferiore dei punteggi di benessere soggettivo. Il confronto illustra il flusso di lavoro relativo alla suddivisione in gruppi e al confronto, piuttosto che una classificazione sostanziale di profili di benessere. Cliccare qui per scaricare questa tabella.
Tabella 8: Confronto descrittivo per sesso. Questa tabella riporta confronti descrittivi delle emozioni negative, della procrastinazione accademica, del senso di appartenenza scolastica, del pensiero di ordine superiore e del benessere soggettivo in base al sesso. Il sesso è stato trattato come una variabile descrittiva di raggruppamento. Cliccare qui per scaricare questa tabella.
Tabella 9: Modello primario di regressione lineare multipla per la previsione del benessere soggettivo. Questa tabella presenta il modello di regressione primario in cui il benessere soggettivo era la variabile dipendente, mentre emozione negativa, procrastinazione accademica, senso di appartenenza scolastica e pensiero di ordine superiore sono state inserite contemporaneamente come predittori a livello di scala. Sono inclusi i valori di errore standard, intervallo di confidenza e fattore di inflazione della varianza. Cliccare qui per scaricare questa tabella.
Tabella 10: Modello di sensibilità della regressione aggiustato per variabili demografiche che predice il benessere soggettivo. Questa tabella riporta i quattro predittori psicologici dopo aggiustamento per sesso, età, anno accademico del corso di laurea, categoria dell'istituzione e categoria della disciplina accademica. Le variabili demografiche categoriali sono state inserite utilizzando la codifica dummy. Sono inclusi i valori di errore standard, intervallo di confidenza e fattore di inflazione della varianza. Cliccare qui per scaricare questa tabella.
Tabella 11: Diagnostica della regressione e verifiche della sensibilità all'influenza. Questa tabella riassume gli output relativi ai residui, all'influenza e alla diagnostica del modello, inclusi i residui standardizzati, la distanza di Cook > 1,00, la distanza di Cook > 4/n, la distanza massima di Cook, la statistica di Durbin-Watson, il grafico quantile-quantile (Q-Q) dei residui, il test di normalità dei residui, il grafico dei residui rispetto ai valori predetti, la verifica della linearità e l'analisi della sensibilità all'influenza. Cliccare qui per scaricare questa tabella.
File supplementare 1: Struttura del questionario, provenienza delle scale e documentazione del punteggio. Questo file supplementare fornisce l'ordine di somministrazione del questionario, il testo del consenso informato, le variabili demografiche, la documentazione degli strumenti di origine, i codici degli elementi, gli ancoraggi di risposta, le informazioni sull'adattamento e sullo stato della documentazione, la direzione di punteggio, le regole di inversione del punteggio, la costruzione finale delle variabili a livello di scala, le regole di gestione degli elementi mancanti, i campi di collegamento alla qualità della risposta, le regole di verifica dell'intervallo e i collegamenti di riferimento per i cinque costrutti del questionario. Funge da supplemento del questionario/libro codici per documentare la programmazione, il punteggio e la verifica delle scale nel flusso di lavoro. Cliccare qui per scaricare il file.
Discussione
Questo protocollo standardizza un processo comune ma spesso sottovalutato negli studi basati su questionari sul benessere: il passaggio dai record grezzi delle risposte a dati selezionati, variabili di scala punteggiate, output statistici e file pronti per la visualizzazione. Il contributo non consiste nello sviluppo di una nuova teoria sul benessere soggettivo né nella proposta di un modello causale. Piuttosto, il flusso di lavoro fornisce un percorso verificabile per la configurazione del questionario, la selezione delle risposte, il calcolo dei punteggi delle scale, il controllo dell'affidabilità, l'analisi descrittiva, l'analisi delle associazioni, la diagnostica della regressione e la verifica delle fonti delle figure. Questa distinzione è importante perché la verificabilità nella ricerca basata su questionari dipende da decisioni procedurali che spesso vengono prese prima dell'interpretazione statistica, tra cui quali record vengono mantenuti, come vengono gestiti gli elementi mancanti, come vengono elaborati gli elementi con punteggio inverso e come vengono collegati i tavoli numerici sorgente agli output visivi. Rendere esplicite queste decisioni riduce pratiche discutibili nella misurazione della ricerca basata su scale23 e favorisce una cultura della ricerca più trasparente24.
Una caratteristica centrale del protocollo è l'utilizzo di artefatti concreti di audit piuttosto che esclusivamente descrizioni verbali. Il flusso di lavoro rivisto collega ogni costrutto allo strumento di origine, all'intervallo degli elementi, agli ancoraggi di risposta, alla direzione del punteggio, alla regola di inversione del punteggio, alla variabile finale a livello di scala e alle informazioni sullo stato di adattamento o documentazione. La traccia di audit comprende il file del questionario bloccato, la mappa delle scale bloccata, l'esportazione grezza bloccata, il registro di screening, il registro di verifica del punteggio, il registro di analisi, il file di output diagnostico e la tabella delle fonti delle figure. Questi file chiariscono quale versione del questionario è stata somministrata, quali record sono stati esclusi o mantenuti, come sono stati calcolati i punteggi e quale tabella verificata è stata utilizzata per creare ciascuna figura. Quando i dati a livello di partecipante non possono essere condivisi pubblicamente, un dataset sintetico con la stessa struttura delle variabili e con registri di screening/punteggio completati può consentire ai lettori di testare il flusso di lavoro computazionale senza accedere a record identificabili o indirettamente identificabili. Questa struttura basata su artefatti è coerente con il principio FAIR secondo cui output di ricerca riutilizzabili richiedono provenienza, struttura e condizioni di accesso chiare25.
I risultati rappresentativi devono essere interpretati come output del flusso di lavoro piuttosto che come evidenza sostanziale sui determinanti psicologici del benessere degli studenti. Il confronto tra alto e basso livello di benessere soggettivo è stato incluso per mostrare come una regola di raggruppamento prefissata possa essere implementata, verificata e riportata; non deve essere interpretato come una classificazione reale di profili di benessere. Analogamente, il modello di regressione illustra come i dati ottenuti da questionari punteggiati possano essere modellati, verificati per multicollinearità, valutati mediante analisi dei residui e dei punti influenti, e collegati a una tabella verificata delle fonti delle figure. Tuttavia, ciò non dimostra che emozioni negative, procrastinazione accademica, senso di appartenenza scolastica o pensiero di ordine superiore determinino causalmente il benessere soggettivo. Poiché tutte le variabili principali sono state raccolte attraverso lo stesso questionario auto-somministrato in un unico momento temporale, non è possibile escludere un bias del metodo comune, effetti dello stile di risposta e un contesto condiviso di misurazione26.
Questo flusso di lavoro inoltre non sostituisce una completa validazione psicometrica. L'alfa di Cronbach, l'omega di McDonald, i controlli dell'intervallo osservato, la revisione degli elementi totali e la verifica del punteggio inverso sono passaggi utili di controllo qualità per un flusso di lavoro di punteggio verificabile, ma non stabiliscono la validità fattoriale, l'invarianza di misura, le proprietà di risposta agli elementi o la comparabilità tra gruppi. Gli studi che utilizzano il questionario per verificare teorie sostanziali dovrebbero condurre un'analisi fattoriale confermativa, test di invarianza di misura tra gruppi demografici o istituzionali rilevanti e ulteriori controlli di validità quando appropriato27. Pertanto, il presente protocollo dovrebbe essere inteso come un quadro verificabile per l'elaborazione e la presentazione dei dati, non come uno studio di validazione completo per le costruzioni incluse.
Il flusso di lavoro è stato dimostrato su un campione costituito da un singolo studente universitario, utilizzando dati provenienti da un questionario auto-somministrato raccolti in un unico momento temporale, senza validazione esterna. Non si deve presumere che sia trasferibile ad altre popolazioni, discipline, istituzioni, lingue e contesti culturali. Se il flusso di lavoro viene riutilizzato in un altro contesto, la mappa delle scale dovrebbe essere ricostruita piuttosto che copiata meccanicamente. I ricercatori dovrebbero esaminare l'origine degli elementi, lo stato di traduzione o adattamento, la dipendenza culturale e contestuale degli indicatori del benessere, gli ancoraggi di risposta, le regole di inversione del punteggio, l'interpretazione dei punteggi e i requisiti etici locali. Le procedure di traduzione e adattamento richiedono una documentazione esplicita, anziché semplici modifiche informali del testo28, e l'interpretazione dei punteggi di test psicologici ed educativi dovrebbe rimanere legata alle evidenze relative all'uso previsto e alla popolazione target29.
In pratica, il protocollo è particolarmente utile come struttura verificabile per l'elaborazione e la presentazione dei dati nella ricerca sul benessere basata su questionari. Aiuta i ricercatori a rendere esplicite le decisioni relative alla pulizia, al punteggio, alle analisi diagnostiche e alla visualizzazione dei dati prima di iniziare l'interpretazione. Applicazioni future dovrebbero testare il flusso di lavoro su campioni indipendenti, diversi contesti istituzionali, disegni longitudinali e squadre di analisti replicate in modo indipendente. Una validazione esterna, regole decisionali preregistrate, set di dati sintetici condivisi, registri di esempio completati per la selezione e il punteggio, e la replica da parte di analisti indipendenti rafforzerebbero ulteriormente la portabilità e l'affidabilità del flusso di lavoro.
Dichiarazioni
Gli autori non hanno conflitti di interessi da dichiarare.
Ringraziamenti
Gli autori ringraziano gli studenti universitari che hanno partecipato al sondaggio tramite questionario per il loro supporto durante la raccolta dei dati. Gli autori ringraziano inoltre gli istruttori competenti e gli assistenti di ricerca per l'assistenza fornita nella distribuzione dei questionari, nell'organizzazione dei dati, nella verifica dei risultati e nella preparazione di tabelle e figure. Questo lavoro non ha ricevuto finanziamenti specifici.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Pacchetto R broom | CRAN | Pacchetto R | Utilizzato per convertire gli output di regressione in tabelle strutturate di coefficienti e riepilogo del modello. |
| Pacchetto R car | CRAN | Pacchetto R | Utilizzato per la verifica del fattore di inflazione della varianza e il supporto diagnostico per la regressione. |
| Documentazione originale delle Depression Anxiety Stress Scales-21 | Fondazione di Psicologia dell'Australia | Lovibond e Lovibond, 1995 | Documentazione originale per la sezione relativa alle emozioni negative. Il flusso di lavoro ha utilizzato una formulazione adattata allo studio, allineata alla valutazione recente degli stati emotivi negativi. |
| Pacchetto R dplyr | CRAN | Pacchetto R | Utilizzato per filtrare i dati, ricodificarli, raggrupparli, generare riepiloghi del flusso di screening e preparare tabelle analitiche. |
| Pacchetto R ggplot2 | CRAN | Pacchetto R | Utilizzato per generare la mappa termica delle correlazioni, il grafico delle correlazioni del benessere soggettivo, il grafico dei coefficienti di regressione e la visualizzazione diagnostica. |
| Documentazione originale per la misurazione del pensiero di ordine superiore | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Documentazione originale per la sezione relativa al pensiero di ordine superiore. Il flusso di lavoro ha utilizzato un insieme di elementi adattato allo studio, allineato al pensiero analitico, valutativo, riflessivo, integrativo e basato sulle evidenze. |
| IBM SPSS Statistics | IBM Corp. | Versione 29.0.2.0 | Utilizzato per statistiche descrittive, alfa di Cronbach’s, correlazione di Pearson, test t per campioni indipendenti e test t di Welch’s, regressione lineare multipla, statistica di Durbin-Watson, residui standardizzati, valori di leva, distanza di Cook’s e fattori di inflazione della varianza. |
| Pacchetto R psych | CRAN | Pacchetto R | Utilizzato per riepiloghi psicometrici, verifica dell'alfa di Cronbach’s e omega di McDonald’s. |
| Documentazione originale della Psychological Sense of School Membership Scale | Wiley | Psychol Sch. 1993;30(1):79-90 | Documentazione originale per la sezione relativa all'appartenenza scolastica. Il flusso di lavoro ha utilizzato una formulazione adattata allo studio, allineata all'accettazione percepita, alla connessione, al supporto e al senso di appartenenza nell'ambiente scolastico. |
| Ambiente statistico R | Fondazione R per il Calcolo Statistico | Versione 4.4.2 | Utilizzato per la verifica analitica secondaria, omega di McDonald’s, verifiche di sensibilità di Spearman, preparazione degli output di regressione e diagnostica, e preparazione delle fonti per la visualizzazione. |
| Pacchetto R readxl | CRAN | Pacchetto R | Utilizzato per importare esportazioni di questionari in formato foglio elettronico nel flusso di verifica in R. |
| Documentazione originale della Subjective Well-being Scale for Chinese Citizens | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Documentazione originale per la sezione relativa al benessere soggettivo. Il flusso di lavoro ha utilizzato una formulazione adattata allo studio e elementi con punteggio invertito, allineati alla soddisfazione della vita, al senso, al supporto, al progresso, all'insoddisfazione, all'impotenza e alle esperienze di benessere correlate allo stress. |
| File Supplementare 1: Struttura del questionario e documentazione delle scale | Autori | File Supplementare 1 | Fornisce la struttura del questionario somministrato, l'ordine delle costruzioni, la provenienza delle scale, i codici degli elementi, gli ancoraggi di risposta, la direzione di punteggio, le regole di punteggio invertito, la costruzione del punteggio a livello di scala e le informazioni sullo stato della documentazione. |
| Documentazione originale della Tuckman Procrastination Scale | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Documentazione originale per la sezione relativa alla procrastinazione accademica. Il flusso di lavoro ha utilizzato una formulazione adattata allo studio, allineata al ritardo accademico e al comportamento di posticipazione dei compiti. |
| Piattaforma online per questionari Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | Piattaforma basata sul web | Utilizzata per il consenso elettronico, la programmazione del questionario, la raccolta delle risposte agli elementi, l'acquisizione del timestamp, la registrazione della durata del completamento, la revisione dei tentativi di invio duplicati e l'esportazione delle risposte grezze. |
Riferimenti
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.