Questo studio presenta un framework collaborativo cyber-fisico per l'Industria 5.0 basato sull'intelligenza artificiale spiegabile, che utilizza una CNN-transformer e SHAP per il rilevamento di anomalie acustiche industriali sul dataset MIMII. L'integrazione del calcolo edge supporta una manutenzione predittiva interpretabile e centrata sull'essere umano.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Collaborazione cyber-fisica supportata da AI spiegabile per la produzione sostenibile nell'Industria 5.0
In questo articolo
Sommario
Abstract
In questo studio, presentiamo un approccio innovativo per la produzione sostenibile di componenti industriali, basato su un sistema collaborativo cyber-fisico con intelligenza artificiale spiegabile (XAI) per l'Industria 5.0. I sistemi cyber-fisici umani (CPHS) attuali risultano integrare l'intelligenza artificiale solo in misura limitata e spesso mancano di spiegabilità. Di conseguenza, vi è la necessità di migliorarne la scalabilità e la flessibilità, in linea con i principi dell'Industria 5.0: resilienza, sostenibilità a lungo termine e centralità dell'essere umano. Per affrontare queste carenze, introduciamo un'architettura che integra l'apprendimento profondo e l'intelligenza artificiale spiegabile nell'ecosistema del sistema cyber-fisico (CPS), abilitando decisioni intelligenti e interpretabili. In particolare, utilizziamo il dataset MIMII (Malfunctioning Industrial Machine Investigation and Inspection) per il rilevamento di guasti nelle macchine a partire da segnali acustici. I segnali audio subiscono una trasformazione spettrale per generare immagini di spettrogrammi, che vengono successivamente elaborate da una rete neurale convoluzionale (CNN) per l'estrazione di caratteristiche spaziali e da un codificatore transformer per le caratteristiche temporali. Per migliorare la trasparenza e facilitare la collaborazione uomo-nel-ciclo, l'approccio basato su spiegazioni additive di Shapley (SHAP) aiuta gli operatori a comprendere il processo decisionale del sistema evidenziando le caratteristiche in ingresso che influenzano le previsioni del modello. Inoltre, il framework viene applicato in un sistema cyber-fisico basato su elaborazione edge per ottenere una latenza ridotta e un basso consumo energetico, garantendo al contempo risposte tempestive e contribuendo così a un ambiente produttivo sostenibile. I risultati sperimentali mostrano che l'architettura proposta CNN-Transformer raggiunge un'accuratezza del 98,5% e supera le prestazioni dei sistemi CPHS esistenti mantenendo una latenza ridotta. L'uso dell'intelligenza artificiale spiegabile in un sistema di collaborazione cyber-fisico di questo tipo aumenta notevolmente la fiducia degli operatori e consente una collaborazione fluida tra uomo e macchina.
Introduzione
La transizione dall'Industria 4.0, che ha enfatizzato tecnologia, meccanizzazione e comunicazione, al nuovo modello dell'Industria 5.0, che combina progresso tecnologico con adattabilità, sviluppo sostenibile e centralità dell'essere umano, ha influenzato l'evoluzione dinamica dei sistemi industriali1,2. La Commissione Europea definisce l'Industria 5.0 come un paradigma incentrato non solo su produttività ed efficienza, ma anche sui tre pilastri della centralità umana, della sostenibilità e della resilienza. È importante notare che ricerche recenti hanno evidenziato il ruolo dei sistemi di intelligenza artificiale, della cooperazione uomo-macchina e della produzione sostenibile come principali motori degli ambienti dell'Industria 5.03,4. I metodi tradizionali di manutenzione non sono più sufficienti in questo contesto industriale in evoluzione. Per garantire resilienza in contesti complessi e instabili, la manutenzione deve evolvere verso una forma più adattabile e sistemica5. Dal 2011, l'Industria 4.0 è stato il modello dominante per la trasformazione industriale in Europa, incoraggiando la trasformazione digitale delle imprese per migliorare le operazioni e massimizzare le risorse disponibili4. È quindi fondamentale aumentare l'efficienza senza eliminare il lavoro umano nella produzione, proteggendo al contempo la salute e la sicurezza dei lavoratori. Per questo motivo, aziende e accademici hanno iniziato a definire i principi del paradigma dell'Industria 5.05,6,7, in parte motivati dal concetto giapponese di Society 5.08,9,10,11. Nonostante l'attenzione crescente alla manutenzione sostenibile nella letteratura recente, la maggior parte delle valutazioni sistematiche esistenti rimane frammentata o specifica per settore, mancando di un quadro complessivo che integri resilienza, sostenibilità e intelligenza artificiale. Ad esempio, gli autori esaminano pratiche di manutenzione sostenibile per sistemi o strategie specifiche, tra cui la manutenzione produttiva totale sostenibile (STPM), mentre altri ricercatori parlano di integrazione di temi di sostenibilità nelle tecniche di manutenzione12,13,14. L'autore ha condotto una valutazione completa dei criteri di adozione della sostenibilità, evidenziando i fattori tecnologici che permettono all'industria manifatturiera di avere un impatto sostenibile positivo15. Tuttavia, all'interno del paradigma dell'Industria 5.0, sostenibilità, resilienza e processo decisionale basato sull'intelligenza artificiale non sono pienamente integrati in nessuno di questi lavori. Di conseguenza, metodi di manutenzione separati affrontano spesso la sostenibilità in modo isolato. SHAP si distingue tra le altre tecniche di intelligenza artificiale interpretabile (XAI) grazie al suo metodo teoricamente solido di attribuzione delle caratteristiche16,17,18.
L'adozione di decisioni basate sui dati è resa possibile dall'intelligenza artificiale, ma modelli accurati richiedono spesso grandi quantità di dati. Le tecniche convenzionali di apprendimento automatico (ML), come gli alberi decisionali, la regressione logistica e la regressione lineare, spesso hanno prestazioni scadenti in situazioni altamente non lineari poiché presuppongono distribuzioni dei dati relativamente semplici19. Attraverso l'apprendimento di rappresentazioni complesse delle caratteristiche a partire da grandi insiemi di dati, le reti neurali profonde (DNN) superano tali limitazioni20. Studi indicano che reti più profonde spesso superano le architetture poco profonde in compiti decisionali complessi21, ma l'aumento della profondità e della complessità dei parametri rende il modello meno interpretabile22.
Un sistema cibernetico-fisico (CPS) è una tecnologia abilitante fondamentale per la produzione Industry 5.0 poiché combina intelligenza distribuita, computer integrati, processi fisici e comunicazione. Per consentire operazioni industriali flessibili, intelligenti e in tempo reale, i moderni CPS stanno integrando rapidamente il calcolo edge, l'intelligenza artificiale edge e l'Internet delle cose verde (G-IoT)23,24. Negli ultimi studi su Maintenance 4.0 e manutenzione intelligente sono state evidenziate sostenibilità e resilienza. Mentre lavori precedenti hanno esaminato il ruolo della tecnologia Maintenance 4.0 nella produzione sostenibile e proposto framework di modellazione per la manutenzione sostenibile, studi bibliometrici e sistematici hanno valutato le tecnologie di manutenzione intelligente25,26,27,28. Ulteriori ricerche hanno indagato l'integrazione della manutenzione sostenibile negli ambienti Industry 4.0 e nei sistemi produttivi orientati alla sostenibilità29,30,31,32. Il concetto di Operator 4.033, i framework umano-centrici per Industry 5.034 e le prospettive socioeconomiche35 hanno attirato notevole attenzione sulla manutenzione centrata sull'uomo. Inoltre, negli ultimi studi sono state sottolineate le innovazioni nella manutenzione digitale36, nella manutenzione predittiva e prescrittiva37,38 e nelle strategie di manutenzione sostenibile39,40. Nonostante questi progressi, la ricerca rimane frammentata e pochi studi offrono un paradigma coerente che integri intelligenza artificiale spiegabile, sostenibilità, resilienza e cooperazione cibernetico-fisica centrata sull'uomo. I sistemi cibernetico-fisici (CPS) non hanno ancora raggiunto l'autonomia completa nonostante il loro crescente utilizzo, e il paradigma Industry 5.0 non lo favorisce. Industry 5.0, al contrario, pone maggiore enfasi sulla supervisione, cooperazione e presa di decisione umana. Integrando il pensiero e la cooperazione umana nei processi cibernetico-fisici, sistemi cibernetico-umani come i CPS con l'uomo nel ciclo (HiLCPSs)41, i CPS centrati sull'uomo (HCPSs)42,43 e i sistemi cibernetico-fisici umani (CPHSs)44 estendono i tradizionali CPS. Questa integrazione migliora adattabilità, trasparenza, sicurezza e resilienza, consentendo una collaborazione in tempo reale tra sistemi intelligenti e operatori umani45,46.
Il rilevamento di anomalie audio industriali è stato notevolmente migliorato da nuove architetture, tra cui Vision Transformer (ViT), Audio Spectrogram Transformer (AST), Conformer e apprendimento auto-sorvegliato; tuttavia, la loro integrazione con sistemi cyber-fisici interpretabili per l'Industria 5.0 rimane limitata. Senza integrare interpretabilità, distribuzione sul bordo della rete (edge deployment) e supporto alle decisioni con coinvolgimento umano in un unico framework, la ricerca attuale si concentra principalmente sull'accuratezza nella classificazione o sull'interpretabilità post hoc basata su XAI. Questo studio propone una nuova architettura collaborativa cyber-fisica CNN-Transformer abilitata da intelligenza artificiale interpretabile (XAI), che combina elaborazione edge, modellazione delle dipendenze temporali, interpretabilità basata su SHAP, apprendimento delle caratteristiche spaziali e supporto decisionale centrato sull'essere umano, al fine di abilitare una produzione sostenibile nell'Industria 5.0 e superare tali limitazioni.
Pertanto, permane un notevole deficit di ricerca. Le attuali tecniche di rilevamento acustico di anomalie basate su CNN/Transformer privilegiano le prestazioni di classificazione ma mancano di cooperazione cibernetico-fisica e interpretabilità. Sebbene i framework Industry 5.0 offrano modelli concettuali centrati sull'essere umano, questi non integrano l'apprendimento profondo interpretabile, l'intelligenza periferica e il processo decisionale assistito dall'operatore in un unico sistema; le tecniche di manutenzione predittiva basate su XAI aumentano la trasparenza ma operano in modo indipendente dalle architetture CPHS. Di conseguenza, risulta ancora assente un singolo sistema cibernetico-fisico umano Industry 5.0 che integri un rilevamento preciso delle anomalie uditive, un'interpretabilità basata su SHAP, un'implementazione abilitata al perimetro di rete e una cooperazione con l'operatore nel ciclo decisionale.
Questo articolo propone un nuovo paradigma collaborativo cyber-fisico basato su intelligenza artificiale interpretabile (Explainable AI) che integra CNN e Transformer per l'Industria 5.0, al fine di superare tali limitazioni. L'architettura proposta combina l'implementazione del calcolo edge, l'estrazione di caratteristiche spaziali basata su CNN, l'apprendimento delle dipendenze temporali basato su Transformer, l'interpretabilità basata su SHAP e il supporto alle decisioni con coinvolgimento umano in un unico framework CPHS. A differenza dei metodi attuali, che affrontano questi aspetti in modo indipendente, il framework proposto offre una soluzione integrata che migliora contemporaneamente le prestazioni nel rilevamento delle anomalie, la trasparenza del modello, l'efficienza operativa e la collaborazione centrata sull'essere umano per una produzione sostenibile.
L'obiettivo principale di questo studio è creare un sistema cibernetico-fisico umano abilitato all'intelligenza artificiale spiegabile (CPHS) per una produzione sostenibile nell'Industria 5.0, combinando un approccio ibrido basato su CNN e Transformer per il rilevamento di anomalie acustiche con spiegabilità basata su SHAP, elaborazione edge e supporto alle decisioni con il coinvolgimento dell'operatore umano. In particolare, il framework proposto mira a migliorare l'accuratezza del rilevamento delle anomalie fornendo previsioni chiare e comprensibili, facilitando un'efficace implementazione edge e promuovendo un processo decisionale collaborativo tra sistemi intelligenti e operatori umani. Raggiungendo contemporaneamente elevate prestazioni di rilevamento, spiegabilità, funzionamento a bassa latenza e collaborazione cibernetico-fisica centrata sull'uomo, questa architettura integrata affronta le limitazioni dei correnti approcci per il rilevamento acustico di anomalie, la manutenzione predittiva basata su XAI e i framework CPHS.
L'architettura proposta presenta un sistema cibernetico-fisico umano (CPHS) unificato abilitato da un'intelligenza artificiale interpretabile per l'Industria 5.0, in contrasto con le attuali tecniche di rilevamento di anomalie acustiche, che si concentrano principalmente sull'accuratezza di classificazione. All'interno di un'unica architettura, combina l'estrazione di caratteristiche spaziali basata su CNN, la modellazione temporale basata su Transformer, l'interpretabilità basata su SHAP, il calcolo edge e il supporto decisionale con l'operatore nel ciclo. L'architettura proposta affronta questioni fondamentali relative a trasparenza, assistenza all'operatore e cooperazione cibernetico-fisica integrando un rilevamento preciso delle anomalie con un processo decisionale comprensibile e un'implementazione edge in tempo reale. Il principale contributo scientifico di questo lavoro è l'integrazione a livello di sistema, che distingue l'approccio proposto dalle ricerche precedenti incentrate singolarmente sul rilevamento di anomalie, sull'intelligenza artificiale interpretabile o sui framework per l'Industria 5.0.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
La metodologia proposta utilizza un approccio basato su sistema Industry 5.0 Cyber-physical human system (CPHS) che combina un apprendimento profondo interpretabile con un framework di collaborazione cyber-fisica abilitato dal calcolo edge per supportare processi produttivi sostenibili. In primo luogo, il problema viene affrontato riconoscendo alcune limitazioni delle attuali soluzioni CPHS, come la mancanza di intelligenza basata sull'IA, interpretabilità e collaborazione centrata sull'uomo. Per affrontare queste sfide, la soluzione proposta sfrutta il dataset MIMII per il monitoraggio dello stato delle macchine industriali mediante elaborazione di segnali acustici.
Il framework proposto inizia inviando gli spettrogrammi generati a un modello CNN che estrae caratteristiche spaziali riconoscendo i pattern di frequenza significativi associati a diverse condizioni della macchina. Le caratteristiche spaziali estratte verranno convertite in sequenze e fornite a un modulo codificatore transformer per catturare le dipendenze temporali tramite l'auto-attenzione. La rappresentazione delle caratteristiche trasformata viene successivamente trasmessa a un modulo classificatore completamente connesso per classificare gli stati della macchina come normali o anomali. Inoltre, per garantire trasparenza e facilitare decisioni centrate sull'essere umano, viene impiegato l'approccio esplicativo SHAP per spiegare le previsioni selezionando le regioni tempo-frequenza significative nell'output del modello. Il modello progettato sarà implementato in un contesto CPS abilitato all'edge, consentendo inferenze in tempo reale con bassa latenza computazionale ed elevata efficienza energetica. In aggiunta, verrà integrato uno schema con interazione umana per consentire agli operatori di convalidare i risultati utilizzando le informazioni esplicative. Le prestazioni vengono validate mediante accuratezza, precisione, richiamo e punteggio F1, oltre ad altre metriche a livello di sistema come latenza ed efficienza energetica.
Il framework proposto è un meccanismo CPHS guidato da XAI per la produzione sostenibile nel contesto dell'Industria 5.0, e il suo flusso di lavoro è presentato come una pipeline che va dall'acquisizione dei dati alla decisione intelligente e all'esecuzione, come mostrato in Figura 1. Nella fase iniziale della procedura di acquisizione dei dati, segnali acustici vengono raccolti da macchinari industriali come motori, pompe e cuscinetti, utilizzando dataset tra cui MIMII. I segnali dati così ottenuti vengono inviati alla fase successiva, denominata preelaborazione dei dati, in cui subiscono filtraggio, normalizzazione e segmentazione. I segnali dati segmentati vengono infine convertiti in uno spettrogramma mediante la trasformata di Fourier a tempo breve (STFT) nel livello di rappresentazione delle caratteristiche.
Successivamente, il livello del modello di intelligenza artificiale utilizza le immagini spettrogramma per estrarre caratteristiche tramite il modulo CNN, identificando modelli spaziali e anomalie. Le caratteristiche estratte vengono quindi riorganizzate e inserite nell'encoder transformer, che apprende le dipendenze temporali e le relazioni a lungo raggio attraverso meccanismi di auto-attenzione. I vettori di caratteristiche risultanti vengono classificati come normali o anomali mediante il livello di classificazione. Per garantire trasparenza nel processo di previsione, il livello di spiegabilità utilizza SHAP per evidenziare le regioni tempo-frequenza significative nello spettrogramma.
Inoltre, è presente un processo con interazione umana in cui gli operatori interpretano e forniscono un feedback sui risultati del modello. Nel livello di distribuzione, il modello viene eseguito su un'infrastruttura CPHS basata su edge, garantendo un'inferenza rapida e un basso consumo energetico, mentre opzionalmente interagisce con sistemi cloud per esigenze di archiviazione o analisi avanzate. Nel complesso, il framework assicura un rilevamento preciso dei guasti, spiegabilità e un'operazione efficiente in tempo reale, in linea con i requisiti dell'Industria 5.0.
Definizione del problema e analisi dei requisiti
I sistemi cibernetico-fisici umani (CPHS) in contesti Industry 5.0 promettono intelligenza, sostenibilità e centralità dell'essere umano. Tuttavia, le attuali architetture per la realizzazione di CPHS sono ostacolate da una mancanza di capacità avanzate abilitate dall'IA, da una ridotta spiegabilità e da un supporto inadeguato alla collaborazione uomo-macchina. In effetti, i CPHS convenzionali si basano su modelli basati su regole o non interpretabili, che ostacolano l'adattamento a condizioni industriali in evoluzione e limitano la fiducia degli operatori nell'automazione. Inoltre, i CPHS convenzionali non riescono ad analizzare efficacemente dati altamente complessi, come i segnali acustici industriali contenenti componenti sia spaziali (ovvero, frequenza) sia dipendenti dal tempo, che sono importanti per la manutenzione predittiva. È quindi necessario creare un'architettura in grado di rilevare anomalie nelle macchine con elevata precisione, fornire spiegazioni e operare al bordo della rete (edge), abilitando così i sistemi cibernetico-fisici (CPS).
Qui x(t) è il segnale acustico in ingresso, S(f,t) è la rappresentazione spettrogramma del segnale,  è l'etichetta e θ è l'insieme dei parametri dell'architettura CNN-Transformer. I simboli utilizzati nelle equazioni successive vengono introdotti subito dopo la loro prima comparsa al fine di preservare la correttezza matematica.
Da un punto di vista matematico, il compito può essere formalizzato come un problema di apprendimento supervisionato. Sia il segnale acustico industriale indicato con x(t). La STFT di x(t) viene calcolata secondo la formula:
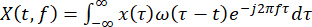 (1)
dove ω(.) è la funzione finestra e f è la frequenza. Il sonogramma generato 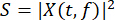 funge da input per l'algoritmo di apprendimento profondo. L'obiettivo è addestrare la funzione di mappatura
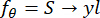 (2)
dove è l'etichetta della classe (normale o anomala), e dove S è l'ingresso dello spettrogramma, y è l'etichetta predetta in uscita e θ è l'insieme dei parametri apprendibili dell'architettura CNN-Transformer. Il problema di ottimizzazione è formulato come la minimizzazione della perdita di classificazione:
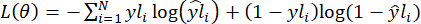 (3)
soggetto ai vincoli di latenza minima  , efficienza energetica
 e interpretabilità, in cui l'explicazione ∅(SHAP) cattura l'importanza delle caratteristiche nel processo di previsione,
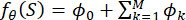 (4)
dove  è il contributo di ciascuna singola caratteristica. In linea con quanto sopra, i requisiti di progettazione includono i seguenti: (i) rilevamento affidabile delle anomalie basato su apprendimento profondo ibrido, (ii) output interpretabili per l'intervento umano e (iii) implementazione in un framework CPS potenziato per dispositivi periferici.
Acquisizione e preelaborazione del set di dati
A questo riguardo, per valutare il framework CPHS basato sull'Intelligenza Artificiale Spiegabile proposto, è stato selezionato il MIMII Dataset13. Questo dataset è un termine di paragone ampiamente utilizzato per rilevare anomalie nelle macchine industriali mediante segnali acustici. Questa base di dati contiene registrazioni sonore di diverse macchine, come guide scorrevoli, ventilatori, pompe e valvole, in condizioni di funzionamento sia normali che difettose. Per ogni macchina, le registrazioni variano in base a diverse configurazioni e ambienti rumorosi. Ciò lo rende adatto per l'addestramento e la valutazione di modelli in condizioni industriali in tempo reale.
Mentre il dataset MIMII è ampiamente utilizzato negli studi di rilevamento di anomalie non supervisionato che si basano esclusivamente su campioni normali durante l'addestramento, esso include annotazioni esplicite sia di stati normali che anomali della macchina. Il problema è formulato come un'attività di classificazione binaria supervisionata per verificare la capacità dell'architettura proposta basata su CNN-Transformer con intelligenza artificiale interpretabile di distinguere tra stati sani e difettosi della macchina. In particolare, vengono utilizzate le etichette ufficiali MIMII, assegnando l'etichetta di classe 0 ai campioni normali e l'etichetta di classe 1 ai campioni anomali.
Tabella 1 mostra i dettagli descrittivi del dataset. Nella presente ricerca sono stati considerati circa 12.000 registrazioni di segnali acustici, comprendenti sia il funzionamento normale che difettoso delle macchine. Come richiesto, tutte le registrazioni di questo studio sono state acquisite a 16 kHz e hanno una durata di 10 s. Sebbene il dataset contenga circa 12.000 registrazioni, per visualizzare la matrice di confusione è stato selezionato un sottoinsieme bilanciato di 2.000 registrazioni di test. Tutte le metriche di prestazione riportate sono state calcolate utilizzando l'intero insieme di test (circa 2.400 registrazioni). Inoltre, i campioni di addestramento e di test sono stati separati in un rapporto 80:20 per l'addestramento del modello. Questo database è particolarmente adatto per applicazioni nell'Industria 5.0 poiché include condizioni di rumore in tempo reale. La distribuzione delle registrazioni utilizzata in questo studio è riportata in Tabella 2. Da questo dataset sono state selezionate circa 12.000 registrazioni, che coprono tutti i tipi di macchine e le condizioni di rapporto segnale-rumore (SNR), per esperimenti di classificazione binaria supervisionata, utilizzando una suddivisione 80:20 tra dati di addestramento e test; tale tabella mostra i tipi di macchine industriali, gli ID delle macchine corrispondenti, il numero totale di registrazioni acustiche normali e anomale, le condizioni di SNR e la suddivisione sperimentale addestramento/test impiegata per la classificazione binaria supervisionata.
L'esperimento è stato condotto utilizzando il dataset MIMII (Malfunctioning Industrial Machine Investigation and Inspection) versione 1.0, che comprende quattro tipi di macchine industriali: ventilatori, pompe, valvole e guide scorrevoli. I dati sono stati raccolti da diversi identificativi di macchina (ID00–ID06, a seconda del tipo di macchina) e in diverse condizioni. Il database MIMII comprende dati acquisiti a rapporti segnale-rumore (SNR) di −6 dB, 0 dB e +6 dB. I dati normali corrispondono allo stato sano della macchina industriale, mentre i dati anomali corrispondono a una condizione anomala. Le classi sono state etichettate in base all'annotazione del database, con i dati normali etichettati come classe 0 e i dati anomali etichettati come classe 1.
Una procedura di valutazione equa richiedeva che la suddivisione tra set di addestramento e set di test avvenisse a livello delle registrazioni audio originali, prima di qualsiasi suddivisione, aumento o creazione di spettrogrammi. Di conseguenza, segmenti audio provenienti dalla stessa registrazione non potevano comparire sia nel set di addestramento che in quello di test. Per l'esperimento di valutazione, sono state utilizzate registrazioni con diversi rapporti segnale-rumore (−6 dB, 0 dB e +6 dB), il che ha permesso di valutare il framework proposto in varie condizioni industriali.
Per evitare perdite di dati, la suddivisione in set di addestramento e di test è stata effettuata utilizzando il file audio originale come base, prima di qualsiasi segmentazione o generazione di spettrogrammi. I segmenti provenienti dalla stessa registrazione audio di 10 s sono stati assegnati esclusivamente o al set di addestramento o a quello di test, senza che alcun segmento fosse presente in entrambi i set. Successivamente, gli spettrogrammi sono stati generati e aumentati separatamente per ciascun dataset. In questo modo, si evita il problema della perdita di dati, prevenendo così una valutazione troppo ottimistica delle prestazioni.
Preelaborazione del set di dati
I segnali acustici non elaborati del dataset MIMII vengono quindi processati per migliorare la qualità del segnale e consentire un'efficace estrazione delle caratteristiche. Il segnale in ingresso è indicato con x(t), dove t rappresenta il tempo. Il primo processo è il filtraggio del rumore, mediante il quale i rumori di fondo vengono filtrati attraverso una funzione di filtraggio tale che:
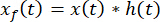 (5)
dove ∗ rappresenta il processo di convoluzione e h(t) è la risposta all'impulso del filtro. Questo processo migliora la chiarezza del segnale acustico e riduce al minimo gli effetti del rumore, spesso prevalente negli ambienti industriali. La normalizzazione del segnale viene utilizzata per garantire che le ampiezze di tutti i segnali audio siano confrontabili prima di essere inserite nel modello di apprendimento profondo. Il segnale normalizzato, indicato come xn(t), viene calcolato come:
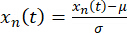 (6)
dove μ e σ sono rispettivamente il valore medio e la deviazione standard del segnale in ingresso. Tutti i segnali in ingresso sono garantiti avere media nulla e varianza unitaria grazie a questa procedura. Infine, ai fini dell'elaborazione, il segnale in ingresso normalizzato viene suddiviso in più frammenti molto piccoli. Considerando che la lunghezza dell'intero segnale è T, esso viene suddiviso in N frame sovrapposti, ciascuno di lunghezza L, mediante una funzione finestra scorrevole:
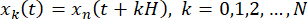 (7)
dove H è la dimensione del passo. Il spettrogramma può essere definito dalla formula seguente:
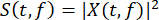 (8)
Gli spettrogrammi ottenuti in questo modo vengono inseriti nel framework basato su CNN e trasformatore per estrarre caratteristiche spaziali e temporali finalizzate a un efficace rilevamento delle anomalie. Figura 2 mostra la pipeline di preelaborazione.
Figura 2 illustra una pipeline di preelaborazione verticale che può essere utilizzata per dati acustici acquisiti nell'industria. In primo luogo, i segnali audio grezzi vengono estratti dal dataset MIMII e inviati alla fase di rimozione del rumore per ridurre il rumore. Successivamente, il segnale viene normalizzato per eliminare le incongruenze di ampiezza, garantendo una coerenza del segnale. Il segnale viene poi suddiviso in sezioni più piccole e sovrapposte. Dopo la segmentazione, verranno applicate trasformate STFT ai dati per convertire i segnali nel dominio del tempo in segnali nel dominio tempo-frequenza. Quindi, lo spettro di potenza viene calcolato come parte della generazione del sonogramma del segnale. I sonogrammi preelaborati saranno pertanto l'output generato nel processo e verranno utilizzati nel modello proposto basato su CNN-transformer.
Generazione del spettrogramma
Dopo la normalizzazione e la segmentazione dei dati, i segnali acustici vengono convertiti in una rappresentazione tempo-frequenza mediante la trasformata di Fourier a breve termine (STFT). Il relativo spettrogramma fornisce una rappresentazione grafica delle variazioni nella composizione in frequenza nel periodo di analisi. In ambito industriale, i guasti delle macchine si manifestano solitamente come schemi di frequenza, rendendo gli spettrogrammi più utili per rilevare anomalie nei macchinari.
I dati elaborati risultanti vengono quindi convertiti in immagini di spettrogrammi per distinguere tra istanze normali e anomale all'interno delle macchine. I dati audio verranno convertiti in numerosi spettrogrammi per consentire al modello di apprendimento di analizzare le componenti frequenziali locali e le variazioni temporali nel processo della macchina. Queste immagini vengono utilizzate come dati di ingresso per il modello CNN-transformer, in cui la CNN gestisce i modelli spaziali (frequenziali) mentre i Transformer gestiscono le relazioni temporali.
Algoritmo 1: Generazione di spettrogrammi da segnali acustici
Input: segnale audio grezzo x(t)
Output: Spettrogramma S(t, f)
Passaggio 1: Caricare il segnale audio x(t)
Passaggio 2: Applicare il filtraggio del rumore
Passaggio 3: Normalizzare il segnale xn(t)
Passaggio 4: Suddividere il segnale in frame:
per k = 1 a N eseguire
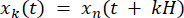
fine per
Passaggio 5: Applicare una finestra temporale w(t) a ciascun segmento
Passaggio 6: Calcola la STFT:
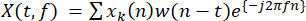 (9)
Passaggio 7: Calcolare l'ampiezza:
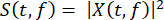 (10)
Passaggio 8: Archiviare lo spettrogramma S(t, f)
Passaggio 9: Restituire il set di dati del spettrogramma
Il processo di generazione dei spettrogrammi inizia con l'acquisizione del segnale audio originale, seguito da passaggi di pre-elaborazione come la riduzione del rumore e la normalizzazione del segnale per garantire l'integrità e la qualità del segnale. Successivamente, l'audio normalizzato viene suddiviso in diverse finestre sovrapposte per catturare le caratteristiche temporali sia di periodi brevi che lunghi. Per evitare il leakage spettrale, ciascuna delle suddivisioni viene moltiplicata per una funzione finestra prima di essere elaborata tramite la Trasformata di Fourier a Tempo Ridotto. In seguito, il segnale trasformato è rappresentato come una funzione a valori complessi nel dominio della frequenza, e i suoi moduli vengono elevati al quadrato. In questo modo, l'energia delle frequenze nel periodo temporale considerato è rappresentata dai spettrogrammi. Infine, questi vengono memorizzati come dati simili a immagini ed elaborati dalla rete neurale per l'addestramento.
Estrazione di caratteristiche spaziali mediante CNN
Dopo il processo di creazione dei sonogrammi, le immagini tempo-frequenza risultanti vengono utilizzate come ingressi e fornite a una rete neurale convoluzionale (CNN). Supponendo che il sonogramma in ingresso sia  , dove H rappresenta il dominio della frequenza e W il dominio del tempo. L'obiettivo dell'uso della CNN in questo contesto è apprendere caratteristiche spaziali discriminanti dal sonogramma in ingresso. Queste caratteristiche spaziali discriminanti permetteranno di distinguere tra un comportamento normale e anomalo della macchina in un ambiente industriale.
Un'operazione fondamentale eseguita dalla rete neurale convoluzionale (CNN) è la convoluzione. La convoluzione con un filtro dato  è definita come:
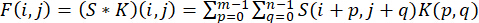 (11)
L'operazione descritta sopra consente alla rete neurale di identificare caratteristiche spaziali locali, come bordi, frequenze e contenuto armonico, nello spettrogramma. Questo avviene attraverso numerose operazioni di filtraggio che generano diverse rappresentazioni delle caratteristiche, producendo diverse mappe di caratteristiche. Alla convoluzione segue una funzione di attivazione non lineare, come mostrato di seguito:
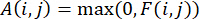 (12)
Questa non linearità consente alla rete di catturare e rappresentare relazioni complesse tra le variabili. La fase successiva in una rete neurale convoluzionale prevede l'applicazione di operazioni di pooling. La tecnica comune del max pooling è espressa matematicamente come segue:
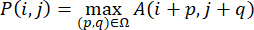 (13)
dove Ω indica la finestra di pooling. Il pooling contribuisce a ottenere l'invarianza rispetto alla traslazione e a mantenere solo le informazioni rilevanti, eliminando le ridondanze. A partire da variabili di basso livello, come le frequenze, fino a comportamenti complessi della macchina, caratteristiche di livello superiore possono essere estratte in modo gerarchico mediante una rete neurale convoluzionale. Di conseguenza, le mappe delle caratteristiche possono essere utilizzate per rappresentare l'output finale della rete:
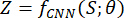 (14)
dove rappresenta i parametri apprendibili della CNN. Le mappe delle caratteristiche contengono informazioni spaziali ricche e vengono trasformate in sequenze per fungere da input per l'encoder transformer nella fase successiva. Il processo di estrazione delle caratteristiche spaziali sopra descritto è fondamentale per consentire al modello di rilevare anomalie minime nei segnali acustici industriali.
Figura 3 illustra come le caratteristiche spaziali vengano estratte orizzontalmente dall'ingresso del sonogramma utilizzando un modello CNN. Il processo inizia con il sonogramma in ingresso, che codifica le proprietà tempo-frequenza del segnale audio in forma pittorica. Il sonogramma in ingresso viene quindi elaborato attraverso un livello convoluzionale, nel quale diversi tipi di filtri estraggono caratteristiche spaziali come bande di frequenza, bordi e texture, producendo così delle mappe delle caratteristiche. Successivamente, le mappe delle caratteristiche estratte vengono sottoposte a una funzione di attivazione non lineare, detta unità lineare rettificata (ReLU), che permette alla rete neurale di rilevare dipendenze nei dati in ingresso. Le mappe delle caratteristiche vengono quindi trasmesse a un livello di pooling, nel quale le dimensioni della mappa vengono ridotte mantenendone le caratteristiche più importanti. Questo processo di livelli convoluzionali, di attivazione e di pooling si ripete più volte, creando una gerarchia di rappresentazione delle caratteristiche che inizia con caratteristiche semplici ed evolve verso caratteristiche più sofisticate relative alle operazioni della macchina.
Modellizzazione temporale mediante l'uso di un codificatore transformer
Una volta estratte le caratteristiche spaziali mediante la CNN, il passo successivo consiste nel ricavare mappe di caratteristiche ad alto livello che catturino i modelli basati sulla frequenza appresi dallo spettrogramma. Le mappe di caratteristiche risultanti vengono quindi appiattite e riorganizzate in sequenze per catturare l'informazione temporale nel segnale acustico. Assumendo che le mappe di caratteristiche siano rappresentate da 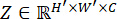 , dove H', W', e C indicano rispettivamente altezza, larghezza e canali, si ottiene la seguente sequenza:
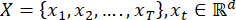 (15)
dove T rappresenta la lunghezza della sequenza e d è la dimensione della caratteristica. Il Transformer utilizza quindi la sequenza sopra descritta per modellare dipendenze a lungo termine mediante un meccanismo di auto-attenzione. A differenza dei modelli ricorrenti convenzionali, il modello Transformer elabora ogni elemento della sequenza in parallelo e utilizza pesi di attenzione per determinare la rilevanza relativa di ciascun elemento. Il funzionamento del meccanismo di attenzione si basa sull'uso di vettori Query Q, Key K e Value V generati per ogni ingresso xt secondo la seguente relazione:
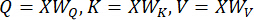 (16)
dove WQ, WK, WV sono pesi addestrabili. Le somiglianze tra gli elementi sono determinate mediante:
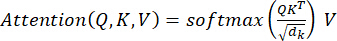 (17)
dk è la dimensione importante dei vettori. Questa procedura facilita l'apprendimento da parte del modello delle dipendenze provenienti da passi temporali distanti nel segnale e permette di concentrarsi solo sui segmenti temporali pertinenti. Per aumentare la capacità di apprendimento della rete, si utilizza l'attenzione multi-testa, che indica il processo mediante il quale più testine di attenzione apprendono in parallelo dall'ingresso:
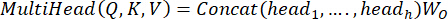 (18)
Ogni testa presta attenzione a caratteristiche distinte della sequenza temporale in ingresso. A ciò seguono reti neurali feed-forward e connessioni residue:
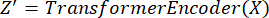 (19)
La sequenza codificata risultante cattura sia le caratteristiche spaziali che temporali dell'input. Questa sequenza viene inviata al livello classificatore per rilevare anomalie.
Figura 4 mostra il processo complessivo di modellazione temporale mediante un encoder basato su trasformatori applicato a caratteristiche estratte da una CNN. In primo luogo, vengono utilizzate le mappe di caratteristiche estratte dalla CNN, che contengono informazioni spaziali dallo spettrogramma. Le mappe di caratteristiche vengono appiattite in una sequenza, in cui ogni elemento corrisponde a un istante temporale. Successivamente, la sequenza passa attraverso una trasformazione lineare che mappa i dati in vettori di una dimensione specifica. Poiché i modelli basati su trasformatori non sono in grado di catturare autonomamente le dipendenze temporali, viene aggiunta anche una codifica posizionale ai vettori incorporati (embedding) per preservare la struttura temporale della sequenza. Infine, la sequenza attraversa un encoder basato su trasformatori, costituito da un insieme di strati sovrapposti, all'interno dei quali viene impiegato un meccanismo di auto-attenzione multi-testa che consente al modello di apprendere le relazioni tra gli istanti temporali nella sequenza. Una rete neurale feed-forward migliora ulteriormente questi embedding, mentre i collegamenti residui garantiscono una propagazione efficiente dei gradienti. Il processo viene ripetuto attraverso gli strati sovrapposti dell'encoder basato su trasformatori, che catturano interazioni temporali via via più complesse. Alla fine, gli embedding della sequenza vengono combinati in una rappresentazione di lunghezza fissa mediante un'operazione di pooling (ad esempio, average pooling o il token di classificazione (CLS)), ottenendo così una rappresentazione globale delle caratteristiche temporali.
Livello di classificazione
Dopo la codifica temporale effettuata dal codificatore transformer, gli output saranno una sequenza di vettori codificati, ciascuno con caratteristiche relative sia agli aspetti spaziali che temporali del segnale in ingresso. Il primo passo verso la classificazione a partire dagli output codificati consiste nell'aggregare tutte queste caratteristiche in un singolo vettore. Questo risultato si ottiene applicando un'operazione di media (mean pooling) sulla sequenza dei vettori di caratteristiche oppure utilizzando il cosiddetto «token di classificazione». Supponiamo che l'output del Transformer sia 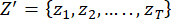 , dove ciascun
 . La caratteristica aggregata h viene calcolata come:
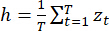 (20)
Successivamente, il vettore caratteristico aggregato h rappresenta l'ingresso in forma compatta e funge da input per il classificatore. La parte di classificazione comprende uno o più strati densi, che trasformano la rappresentazione appresa nello spazio di uscita. Uno strato denso implementa una trasformazione definita come segue:
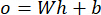 (21)
dove o è l'output (logits), b è il vettore di bias e W è la matrice dei pesi. Questi ultimi rappresentano i punteggi delle classi in forma non normalizzata. Per introdurre non linearità nel modello, si utilizzano spesso funzioni di attivazione come ReLU. Infine, viene applicata una funzione di attivazione softmax ai logits per ottenere una probabilità per ciascuna classe:
 (22)
dove C rappresenta il numero di classi (C = 2; normale e anomalo). La previsione della classe sarà basata sul valore di probabilità massimo. Durante l'addestramento, i valori ottimali dei parametri del modello vengono ottenuti minimizzando la perdita di entropia incrociata tra le etichette effettive e quelle previste, consentendo così una classificazione accurata degli stati della macchina. In sintesi, il livello di classificazione svolge una funzione essenziale nel trasformare le caratteristiche temporali estratte mediante l'architettura Transformer in decisioni pratiche. Attraverso una corretta discriminazione tra stati sani e difettosi della macchina, la rilevazione delle anomalie e il processo decisionale intelligente diventano possibili nel paradigma Industry 5.0.
Figura 5 mostra il funzionamento del livello di classificazione, che segue l'Encoder Transformer. Il processo inizia con l'output della sequenza codificata, in cui ogni vettore contiene informazioni temporali apprese dall'input. Questi vettori vengono combinati in un singolo vettore, noto come vettore delle caratteristiche globali. Il passo successivo consiste nel far passare il vettore delle caratteristiche globali attraverso diversi strati di reti neurali dense. In ogni strato denso vengono eseguite operazioni di moltiplicazione matriciale per creare combinazioni lineari degli input. Successivamente, può essere applicata una funzione di attivazione non lineare, come ReLU, per aumentare la flessibilità nell'apprendimento dei confini decisionali. Alla fine dell'ultimo strato denso, sono presenti punteggi logit per ogni classe. Questi punteggi logit possono essere utilizzati nella funzione Softmax per calcolare i punteggi di probabilità per ciascuna classe. Tali punteggi di probabilità vengono impiegati per determinare se l'input appartiene alla Classe 0 (Normale) o alla Classe 1 (Anomalo).
Spiegabilità mediante SHAP
Dopo che il modello classifica i segnali in ingresso, vengono generate previsioni in base al funzionamento normale o anomalo della macchina. Tuttavia, nell'ambiente Industry 5.0, produrre semplicemente previsioni non è sufficiente; il sistema deve inoltre garantire trasparenza e interpretabilità per supportare il processo decisionale umano. Il framework seguente utilizza SHAP, un modello basato sulla teoria dei giochi che quantifica l'importanza di ciascuna caratteristica nel determinare la previsione. In questo modo, SHAP assegna pesi alle caratteristiche, consentendo di valutare l'importanza relativa delle diverse sezioni del segnale spettrale in ingresso rispetto alla previsione complessiva.
La formulazione matematica di SHAP si basa su una decomposizione del modello f(x):
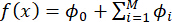 (23)
dove ∅0 è il valore di base (output medio del modello), ∅i è l'effetto della i-esima caratteristica e M è il numero di caratteristiche in ingresso. Ai fini di questo studio, le caratteristiche sono i bin temporali e frequenziali dello spettrogramma. I valori SHAP sono positivi se contribuiscono alla probabilità dello stato anomalo e negativi in caso contrario. Questa formulazione garantisce una spiegazione univoca e localmente coerente per ogni previsione. Il metodo SHAP può essere applicato a un modello CNN-transformer addestrato per fornire una spiegazione basata sull'importanza delle caratteristiche. La rappresentazione visiva mostrerà i bin temporali e frequenziali più importanti nello spettrogramma che influenzano il processo decisionale. Ad esempio, un comportamento anomalo dell'equipaggiamento può generare determinate bande di frequenza ad alta energia che il framework SHAP identifica come contributi significativi al processo decisionale.
Inoltre, SHAP può favorire la collaborazione tra persone e macchine in un contesto cibernetico-fisico. Ciò avviene perché le previsioni possono essere spiegate mediante visualizzazioni intuitive, consentendo agli operatori e ai sistemi decisionali di verificarle, analizzare il problema e intraprendere le azioni opportune. Questo non aumenta soltanto la fiducia, ma rende anche i processi produttivi basati sull'intelligenza artificiale affidabili e responsabili. Integrando algoritmi di apprendimento profondo che soddisfano gli attuali standard prestazionali con SHAP, che fornisce spiegabilità, l'architettura proposta soddisfa i requisiti dell'Industria 5.0.
Algoritmo 2: Spiegabilità basata su SHAP per la previsione del modello
Input: modello addestrato f(x), spettrogramma in ingresso S
Output: valori SHAP  e mappa esplicativa
Passaggio 1: Inserire lo spettrogramma S in un modello addestrato
Passaggio 2: Calcola la previsione: y = f(S)
Passaggio 3: Inizializzare un'analisi SHAP orientata al deep learning
Passaggio 4: Calcolare i valori SHAP:
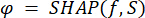
Passaggio 5: Per ogni caratteristica i in S:
Calcola il contributo 
Passaggio 6: Generare la mappa esplicativa:
Evidenziare le regioni con alta 
Passaggio 7: Visualizzare l'importanza delle caratteristiche (mappa termica)
Passaggio 8: Restituire i valori SHAP e la mappa esplicativa
L'algoritmo di spiegabilità basato su SHAP inizia ottenendo un'immagine di spettrogramma preelaborata come input e la immette nell'architettura CNN-transformer addestrata per effettuare previsioni (ad esempio, condizione normale o anomala della macchina). Dopo aver effettuato le previsioni utilizzando l'architettura addestrata, il metodo SHAP viene utilizzato per interpretare il modello. In particolare, i valori SHAP (ϕ) vengono calcolati per ogni caratteristica in ingresso al fine di determinare quali componenti tempo-frequenza dell'input contribuiscono maggiormente alla previsione. Per calcolare questi valori, è necessario confrontare le uscite del modello per input con e senza determinate caratteristiche.
Dopo aver calcolato i valori SHAP per ogni caratteristica, la sua influenza sulla previsione può essere valutata in base al segno e all'entità del valore SHAP. Ad esempio, le caratteristiche con valori SHAP più elevati hanno maggiori probabilità di influenzare il risultato, e un segno positivo o negativo indica rispettivamente che la caratteristica spinge la previsione verso la classe normale o anomala. Sulla base dei risultati, può essere creato un mappa esplicativa sotto forma di mappa termica.
Infine, l'algoritmo produce sia i valori SHAP sia le visualizzazioni, fornendo informazioni su come gli esseri umani possono analizzare la decisione del modello. La tecnica rende il processo più trasparente e consente agli esseri umani di partecipare al processo decisionale, assicurando così che nell'industria basata sull'intelligenza artificiale si raggiungano sia le previsioni dell'algoritmo sia la sua affidabilità. Sono stati selezionati campioni rappresentativi dai casi anomali diagnosticati correttamente in vari tipi di macchine, al fine di migliorare l'affidabilità dell'analisi dell'interpretabilità. Mentre l'analisi globale dell'importanza delle caratteristiche tramite SHAP è stata eseguita aggregando i valori SHAP su tutto il set di dati di test per identificare le posizioni nel dominio tempo-frequenza costantemente influenti, sono state generate spiegazioni SHAP locali per questi casi rappresentativi. Senza richiedere annotazioni da esperti, questa analisi integrata locale e globale offre un'interpretazione affidabile delle previsioni del modello.
Integrazione CPS abilitata al bordo
Questa soluzione proposta viene utilizzata all'interno di sistemi ciber-fisici abilitati al bordo (edge-enabled CPS), che mirano a raggiungere efficienza, sostenibilità e operazioni industriali in tempo reale. Una volta che il modello è stato addestrato, la rete CNN-transformer verrà distribuita mediante un approccio di edge computing. Il livello di edge computing in questione si trova vicino ai dispositivi dell'Internet industriale delle cose (IIoT), inclusi sensori e macchinari. Invece di trasmettere tutti i dati raccolti al cloud, il dispositivo edge esegue l'inferenza sul segnale acustico in arrivo senza trasferirlo preventivamente. Pertanto, il sistema può rilevare anomalie nei macchinari quasi istantaneamente e intraprendere le azioni necessarie prima che la situazione peggiori ulteriormente. Un altro vantaggio di questo approccio abilitato al bordo è una minore latenza e una maggiore efficienza, poiché i dati vengono analizzati vicino al punto in cui vengono generati. In altre parole, a differenza dell'approccio basato su cloud, dove il tempo di inferenza Tinf
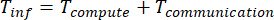 (24)
La latenza, in generale, sarà notevolmente ridotta grazie a una diminuzione di Tcommunication. Un altro vantaggio è la riduzione del consumo di larghezza di banda e dell'energia spesa durante la trasmissione continua dei dati. Questo sistema è quindi scalabile e sostenibile per impianti industriali di grandi dimensioni con numerosi dispositivi connessi. Inoltre, il CPS consente l'interazione con il livello fisico (macchine), l'IA (livello computazionale) e il livello umano.
Collaborazione con la partecipazione umana
Un componente fondamentale del CPS proposto per l'Industria 5.0, che prevede operatori umani attivamente coinvolti nel processo decisionale insieme a modelli di intelligenza artificiale, è la collaborazione con l'essere umano nel ciclo. In particolare, secondo il framework progettato, il sistema non diventa una scatola nera autonoma, ma consente agli operatori di interagire con esso e di osservare risultati predittivi spiegabili sotto forma di spiegazioni SHAP. Le predizioni in questione si riferiscono agli esiti (normale/anomalo), accompagnati da visualizzazioni di parti degli spettrogrammi utilizzati per effettuarle.
Un'interazione di questo tipo aiuta gli operatori a comprendere meglio come viene formulata la previsione e quali fattori contribuiscono a essa. La partecipazione umana implica la verifica dei risultati del sistema e consente agli operatori di annullarli quando necessario, in base al loro giudizio professionale. La collaborazione con gli operatori umani rende il sistema più affidabile, efficiente, sicuro e robusto, contribuendo a prevenire errori.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Il sistema di collaborazione cibernetico-fisico integrato con intelligenza artificiale interpretabile presentato è stato testato sperimentalmente su circa 12.000 registrazioni audio del MIMII Dataset, che contiene sia condizioni normali che anomale delle macchine. Il dataset di addestramento era composto da circa 9.600 record di dati, mentre il dataset di test includeva circa 2.400 campioni audio. Sulla base dei risultati, il modello proposto basato su CNN e trasformatore ha raggiunto un'accuratezza di classificazione de...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
I risultati sperimentali dimostrano che l'architettura proposta basata su CNN e trasformatori supera gli algoritmi individuali integrando efficacemente l'apprendimento delle caratteristiche spaziali e temporali. Secondo lo studio di ablazione, sebbene la CNN estragga caratteristiche discriminanti basate sulla frequenza dai spettrogrammi, l'encoder trasformatore migliora le prestazioni del modello catturando dipendenze temporali a lungo raggio nei segnali acustici. Inoltre, la matrice di confusione mostra un numero molto ...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Uno strumento di intelligenza artificiale (ChatGPT) è stato utilizzato esclusivamente per assistere nella revisione linguistica e nel miglioramento della grammatica, della chiarezza e della leggibilità. Gli strumenti di intelligenza artificiale non sono stati utilizzati per generare dati scientifici, eseguire esperimenti, analizzare risultati, interpretare dati o trarre conclusioni scientifiche. Tutti i contenuti scientifici, l'analisi dei dati, le interpretazioni e la versione finale del manoscritto sono stati esaminati, verificati e approvati in modo indipendente dagli autori, i quali si assumono piena responsabilità per l'accuratezza e l'integrità del lavoro. Gli autori dichiarano di non avere conflitti di interessi da segnalare.
Ringraziamenti
FINANZIAMENTO: Questo lavoro è stato sostenuto dal Progetto Chiave sulla Riforma dell'Insegnamento Universitario nella Provincia di Shaanxi (Progetto n. 23BG053); dalla Fondazione per la Ricerca Scientifica per i Talenti di Alto Livello dell'Università Politecnica di Shaanxi (Progetto n. BSJ-2023-08); e dal Progetto di Ricerca Scientifica dell'Università Politecnica di Shaanxi (Progetto n. 2024YKYB-006). Gli autori ringraziano sinceramente l'Università Politecnica di Shaanxi, Xianyang, Cina, e l'Università di Ingegneria del Traffico di Xi’an, Xi’an, Cina, per aver fornito le strutture e il supporto istituzionale che hanno reso possibile questa ricerca.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Scala del Supporto Sociale | Scala accademica pubblicata; originariamente sviluppata da Park e successivamente rivista/arricchita da Kim | versione a 25 voci; formato di risposta Likert a 5 punti; nessun numero di catalogo commerciale | Misura il supporto sociale percepito tra futuri insegnanti della prima infanzia in relazione al Supporto Emotivo, Supporto Informativo, Supporto Materiale e Supporto Valutativo. Cronbach complessivo’s alpha = 0,96. |
| Scala dell'Autoefficacia del Docente | Scala accademica pubblicata; originariamente sviluppata da Enochs e Riggs; versione adattata per lo studio in cinese | versione a 25 voci; formato di risposta Likert a 5 punti; nessun numero di catalogo commerciale | Valuta l'efficacia insegnante nel contesto cinese della formazione pre-servizio nell'educazione della prima infanzia, attraverso la Scala Generale di Autoefficacia Insegnante e la Scala di Autoefficacia Insegnante Personale. Cronbach complessivo’s alpha = 0,96. |
| Scala di Interazione tra Insegnante e Bambino | Scala accademica pubblicata; sviluppata da Lee e rivista dal comitato di esperti dello studio per l'uso in Cina | versione da 30 elementi; formato di risposta Likert a 5 punti; nessun numero di catalogo commerciale | Valuta la competenza autodichiarata dell'insegnante nell'interazione con il bambino, piuttosto che la qualità osservata dell'interazione in classe. Comprende Interazione Emotiva, Interazione Verbale e Interazione Comportamentale; coefficiente alfa di Cronbach complessivo’s alfa = 0,94. |
| Modulo Informativo Demografico | Team di ricerca, collaborazione tra l'Università delle Arti e delle Scienze del Sichuan e l'Università di Daegu | Sezione personalizzata del questionario di studio; nessun numero di catalogo commerciale | Caratteristiche raccolte dei partecipanti, incluse genere, livello di istruzione, categoria professionale, luogo dello stage, durata dello stage, tipo di stage e tipo di asilo nido. |
| Informazioni per il partecipante e modulo di consenso informato | Team di ricerca; approvato dal Comitato Etico per la Ricerca dell'Università di Daegu | Numero di approvazione etica: XXX; documento di approvazione locale da verificare | Utilizzato prima della distribuzione del questionario per spiegare lo scopo dello studio e il contenuto del sondaggio e per ottenere il consenso informato dai partecipanti, futuri insegnanti di educazione della prima infanzia. |
| Pacchetto del questionario per il sondaggio pilota | Team di ricerca e panel di esperti | Versione pilota utilizzata a giugno 1–5, 2024; nessun numero di catalogo commerciale | Ha verificato sperimentalmente la chiarezza e l'adeguatezza della Scala delle Percezioni Professionali, della Scala del Supporto Sociale, della Scala dell'Autoefficacia dell'Insegnante, della Scala dell'Interazione Insegnante-Bambino e degli elementi demografici su 50 futuri insegnanti di educazione della prima infanzia. |
| Procedura di Revisione da Parte di un Comitato di Esperti | Squadra di ricerca; panel di esperti composto da due professori di educazione della prima infanzia, un direttore di asilo nido, tre supervisori di tirocinio e la squadra di ricerca | Revisione del contenuto basata sul consenso; nessun numero di modello commerciale | Utilizzato per rivedere gli elementi della scala in merito ad ambiguità, appropriatezza, chiarezza semantica, adeguatezza allo sviluppo e pertinenza culturale prima dell'indagine formale. |
| Moduli stampati per questionari compilati in loco | Squadra di ricerca; forniture per indagini istituzionali locali | Moduli cartacei per sondaggi; nessun numero di catalogo commerciale | Utilizzato per la somministrazione dei questionari in loco. Nel campione finale, sono stati ottenuti 336 questionari validi in loco prima della combinazione con i questionari online. |
| Tencent | Applicazione mobile WeChat; la versione deve essere verificata in base al dispositivo/record dell'app utilizzato nel mese di giugno–Luglio 2024 | Utilizzato come canale di distribuzione online per la somministrazione del questionario; sono stati raccolti 27 questionari compilati online attraverso la piattaforma online/WeChat. | |
| Procedura di reclutamento telefonico e di persona | Team di ricerca | Procedura standardizzata di reclutamento; nessun numero di catalogo commerciale | Utilizzato per contattare istituzioni/partecipanti, spiegare lo scopo dello studio e il contenuto del questionario, e supportare il consenso informato prima della somministrazione del questionario. |
| SPSS Statistics | IBM | Versione 27.0 | Utilizzato per statistiche descrittive, coefficienti di correlazione di Pearson, Cronbach’analisi dell'affidabilità alfa s, verifiche di normalità mediante asimmetria (skewness) e curtosi, e Harman’un test a fattore singolo per il bias del metodo comune. |
| SPSS Amos | IBM | Versione 26.0 | Utilizzato per l'analisi fattoriale confermativa, la modellizzazione con equazioni strutturali, la verifica dell'invarianza di misura in più gruppi, il test bootstrap degli effetti indiretti e il confronto tra modelli alternativi. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel o versione di Excel installata localmente; verificare l'esatta versione locale prima dell'invio | Ambiente di lavoro consigliato/utilizzato per organizzare i dati del questionario codificati, il dizionario dei dati, le tabelle supplementari e la Tabella dei Materiali di JoVE. La versione locale esatta deve essere verificata dagli autori. |
| Criteri degli Indici di Adattamento per la Modellizzazione dell'Equazione Strutturale | Linee guida metodologiche pubblicate; riferimenti di Schreiber et al. e Kline citati nel manoscritto | Nessun numero di catalogo commerciale; criteri applicati nel piano di analisi statistica | Definisce e riporta gli indici di adattamento del modello, inclusi la statistica chi-quadro, il chi-quadro diviso per i gradi di libertà, l'Indice di Tucker-Lewis, l'Indice di Adattamento Comparativo, l'Indice di Adattamento della Bontà Aggiustato, l'Indice di Adattamento Incrementale, l'Errore Quadratico Medio di Approssimazione e il Residuo Standardizzato della Radice della Media dei Quadrati. |
| Procedura di Test della Mediazione con il Metodo Bootstrap | SPSS Amos / piano di analisi statistica del gruppo di ricerca | 5.000 campioni bootstrap; intervalli di confidenza al 95% corretti per il bias | Utilizzato per verificare associazioni indirette attraverso l'efficacia dell'insegnante. Gli effetti indiretti sono stati considerati significativi quando l'intervallo di confidenza corretto per il bias al 95% non includeva lo zero. |
| Procedura di verifica dell'invarianza di misura | SPSS Amos / piano di analisi statistica del gruppo di ricerca | Analisi fattoriale confermativa multigruppo ΔCFI &< .010 e ΔRMSEA &< .015 criteri | Utilizzato per valutare l'invarianza configurale, metrica e scalare in base al genere, al tipo di programma, alla durata del tirocinio e all'istituzione, prima di interpretare le stime combinate di SEM. |
Riferimenti
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.