Questo studio propone un modello ibrido di previsione dei costi per le reti elettriche che combina quote di costo fisiche con aggiustamenti dinamici di tipo macroeconomico/tecnologico e compensazione residua basata su XGBoost. Raggiungendo un MAPE del 2,34%, il modello bilancia accuratezza e interpretabilità, soddisfacendo le esigenze di trasparenza regolatoria nella definizione delle tariffe.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Previsione retrospettiva mediante l'utilizzo di dati a griglia provinciale e un modello ibrido fisico-IA basato su quote
In questo articolo
Sommario
Abstract
La transizione energetica globale e le continue riforme del mercato elettrico richiedono alle aziende di rete elettrica di bilanciare un approvvigionamento energetico affidabile con regolamentazioni tariffarie di trasmissione e distribuzione sempre più rigorose. I metodi tradizionali di budgeting basati sull'estrapolazione storica spesso non riescono a riflettere la base fisica delle operazioni delle attività, mentre i modelli di apprendimento automatico basati sui dati raggiungono un'elevata accuratezza predittiva ma mancano della trasparenza necessaria per la verifica regolatoria dei costi. Per affrontare il compromesso tra accuratezza delle previsioni e interpretabilità, questo studio propone un modello ibrido di previsione dei costi basato su quote di costo. Il quadro metodologico utilizza quote operative standardizzate come base fisica per il budgeting e incorpora un meccanismo dinamico di evoluzione delle quote guidato dalle condizioni macroeconomiche e dal progresso tecnologico. L'Extreme Gradient Boosting (XGBoost) viene impiegato per catturare i residui non lineari al di là delle stime basate sulle quote, mentre SHAP (Shapley Additive exPlanations) viene utilizzato per interpretare il contributo dei principali fattori di costo. Il modello è stato valutato utilizzando 16 anni di dati operativi anonimizzati provenienti da una rete elettrica provinciale in Cina. Ha raggiunto un errore percentuale assoluto medio (MAPE) del 2,34%, riducendo gli errori di previsione rispettivamente del 61,8%, del 46,6% e del 34,1% rispetto ai modelli SARIMAX, XGBoost autonomo e Attention-LSTM. Il framework proposto integra i principi ingegneristici delle quote di costo con l'intelligenza artificiale interpretabile, fornendo sia previsioni accurate dei costi a lungo termine sia uno strumento decisionale trasparente per la verifica dei costi ammessi dalla regolamentazione.
Introduzione
La transizione energetica globale sta ridefinendo la gestione delle infrastrutture e le pratiche operative delle reti elettriche attraverso l'integrazione di sistemi di generazione rinnovabile distribuiti, l'aumento degli eventi meteorologici estremi e la diffusione capillare delle tecnologie IoT, tutti fattori che richiedono una maggiore flessibilità operativa e risorse per la manutenzione al fine di garantire l'affidabilità del sistema1,2. Allo stesso tempo, i regolatori dell'energia elettrica hanno rafforzato la supervisione delle tariffe per la trasmissione e la distribuzione attraverso quadri normativi come il RIIO del Regno Unito e le revisioni del tasso di rendimento della Federal Energy Regulatory Commission statunitense, sottolineando la trasparenza nella giustificazione dei costi3. Anche la Cina ha adottato un meccanismo regolatorio basato sul "costo ammesso più un rendimento ragionevole", richiedendo alle aziende di servizio di dimostrare chiari collegamenti tra le attività ingegneristiche e le spese finanziarie4. Tuttavia, spesso le aziende di servizio non dispongono di strumenti quantitativi trasparenti in grado di collegare le operazioni fisiche delle infrastrutture ai previsioni di costo, limitando l'efficacia della verifica regolatoria dei costi5.
Gli approcci di previsione esistenti presentano limitazioni importanti in questo contesto6. I metodi tradizionali, tra cui la pianificazione incrementale del budget e i modelli basati su ARIMA, presuppongono schemi storici relativamente stabili e spesso hanno prestazioni scadenti in presenza di cambiamenti strutturali causati da fluttuazioni economiche o condizioni meteorologiche estreme7. Al contrario, i modelli moderni di apprendimento automatico, come le architetture LSTM e Transformer, offrono un'elevata accuratezza predittiva per previsioni a breve termine, ma mancano dell'interpretabilità ingegneristica necessaria per prendere decisioni regolatorie8,9. Sebbene recenti approcci ibridi di previsione combinino tecniche statistiche e di apprendimento automatico, in generale trascurano le quote standardizzate di costo ingegneristico alla base dei sistemi contabili delle reti elettriche10. Per affrontare tali limitazioni, questo studio propone un framework ibrido guidato da quote che combina l'evoluzione dinamica delle quote con una correzione residua basata sull'apprendimento automatico, mantenendo l'interpretabilità ingegneristica e migliorando al contempo l'accuratezza delle previsioni.
Una delle principali direzioni di ricerca deriva dalla regolamentazione degli incentivi nei settori caratterizzati da monopolio naturale, tra cui il meccanismo RPI-X del Regno Unito e il quadro cinese di verifica dei costi ammissibili11. Tali studi valutano principalmente l'efficienza operativa ricorrendo all'analisi delle envelopment dei dati (Data Envelopment Analysis, DEA) e all'analisi stocastica del fronte produttivo (Stochastic Frontier Analysis, SFA)12. Ricerche precedenti hanno esaminato le relazioni a lungo termine tra spese in conto capitale (CAPEX), spese operative (OPEX) ed efficienza dei costi, al fine di supportare la regolamentazione delle tariffe13,14. Sebbene questi approcci forniscono informazioni preziose dal punto di vista macroeconomico, i loro risultati sono generalmente espressi come punteggi di efficienza relativa piuttosto che come previsioni monetarie adatte alla pianificazione del bilancio annuale15,16. Inoltre, i modelli basati sul fronte produttivo assumono in genere strutture fisiche delle attività e condizioni operative relativamente stabili, limitando così la loro capacità di cogliere variazioni improvvise dei costi determinate dall'invecchiamento delle attività, dalla sostituzione delle infrastrutture o da una rapida crescita della domanda17,18.
Una seconda direzione di ricerca si concentra su modelli previsionali basati su statistica e intelligenza artificiale. Negli studi iniziali sono state impiegate la regressione lineare multipla e modelli autoregressivi integrati a media mobile con variabili esogene (ARIMAX) per la previsione dei costi19. Più di recente, la regressione con vettori di supporto, le foreste casuali, i modelli XGBoost, LSTM e Transformer hanno notevolmente migliorato le prestazioni previsionali sfruttando relazioni non lineari e spazi di caratteristiche ad alta dimensionalità20,21,22. Questi approcci incorporano spesso indicatori macroeconomici come la domanda di elettricità, gli indici dei prezzi alla produzione (PPI) e variabili climatiche23. Tuttavia, i costi operativi della rete elettrica derivano da attività ingegneristiche, dal deterioramento delle infrastrutture, dalla pianificazione della manutenzione e da decisioni gestionali, e non soltanto da variabili macroeconomiche24. Di conseguenza, i modelli puramente basati sui dati spesso funzionano come "scatole nere", rendendo difficile spiegare i costi previsti durante le revisioni regolatorie o la verifica dei costi ammissibili25,26.
La gestione delle quote di costo ingegneristiche rappresenta una possibile soluzione a questa sfida27. Il costing basato sulle attività (ABC) si è a lungo basato su quote operative standardizzate per stimare i requisiti di manodopera, materiali, attrezzature e manutenzione per le operazioni di rete di routine28. Le principali utility cinesi hanno sviluppato database completi di quote che coprono attività di ispezione, manutenzione, collaudo, riparazione e sostituzione di apparecchiature. Tuttavia, questi standard ingegneristici vengono utilizzati principalmente per il collaudo dei progetti e per verifiche contabili, piuttosto che per previsioni dinamiche a lungo termine29,30. Inoltre, gli standard delle quote vengono tipicamente rivisti solo ogni diversi anni, risultando quindi insufficientemente reattivi rispetto ai cambiamenti nei prezzi delle materie prime, ai progressi tecnologici e alle pratiche operative31. L'applicazione di sistemi di quote su milioni di asset distribuiti pone inoltre notevoli sfide computazionali per le previsioni su larga scala32.
Nonostante i notevoli progressi nella previsione statistica, nell'apprendimento automatico e nella gestione ingegneristica dei costi, nessun framework esistente integra efficacemente i parametri standardizzati di costo ingegneristico, l'adeguamento dinamico della macroeconomia e un apprendimento automatico interpretabile in un unico modello previsionale per la verifica dei costi regolatori. Si è ipotizzato che la combinazione di parametri di costo dinamici con un apprendimento residuo basato su XGBoost possa migliorare l'accuratezza delle previsioni a lungo termine, mantenendo al contempo la trasparenza ingegneristica necessaria per le decisioni regolatorie. Per verificare questa ipotesi, è stato sviluppato un framework ibrido guidato dai parametri che integra la modellizzazione fisica dei costi, meccanismi di adeguamento macroeconomico e tecnologico, compensazione residua basata su XGBoost e interpretazione del modello basata su SHAP. L'approccio proposto mira a fornire sia previsioni accurate dei costi a lungo termine sia evidenze trasparenti per supportare la verifica dei costi ammissibili nell'ambito della regolamentazione moderna del mercato elettrico.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato dati operativi e finanziari anonimizzati raccolti da una rete elettrica provinciale nell'est della Cina. Tutti i dati sono stati aggregati e depurati da informazioni identificabili prima dell'analisi, e non sono state incluse informazioni personali identificabili o sensibili a livello individuale. Pertanto, non era richiesta l'approvazione etica. L'accesso ai dati e la loro analisi hanno rispettato le normative vigenti in materia di protezione dei dati e gli accordi istituzionali che regolano le informazioni del settore energetico.
Panoramica del framework di previsione
Per integrare approcci previsionali basati sulla fisica e approcci basati sui dati, è stato sviluppato un framework ibrido che combina quote di costo ingegneristiche con l'apprendimento automatico. Piuttosto che semplicemente combinare più algoritmi, il framework segue il principio secondo cui i modelli fisici stabiliscono la previsione di base, mentre l'apprendimento automatico compensa gli errori residui. Questa progettazione garantisce che il processo di previsione sia basato sui meccanismi fisici sottostanti alle attività di produzione e gestione della rete elettrica, anziché basarsi esclusivamente sull'estrapolazione dei costi storici.
Il framework stabilisce innanzitutto una mappatura gerarchica tra le risorse della rete elettrica, le attività operative standardizzate e i relativi conti di costo finanziario. I costi di produzione e di esercizio sono considerati rappresentazioni monetarie delle risorse consumate dalle infrastrutture fisiche—tra cui sottostazioni, linee di trasmissione, alimentatori di distribuzione, dispositivi di misurazione e apparecchiature digitali per ispezioni—durante le attività di routine come ispezione, manutenzione, collaudo, riparazione e sostituzione. Le quote di costo fungono da collegamento tra carichi di lavoro ingegneristici misurabili e le corrispondenti spese finanziarie.
Come illustrato nella Figura 1, i parametri di costo funzionano come unità contabili standardizzate incorporate in tutto il processo di esercizio e manutenzione delle attività, piuttosto che come regole astratte di allocazione finanziaria. I carichi di lavoro relativi alle attività a livello più basso vengono convertiti in parametri operativi standardizzati e successivamente associati a categorie di costo, tra cui manodopera, materiali, attrezzature per la costruzione, servizi esterni e forniture di emergenza. Questo mapping gerarchico preserva l'interpretabilità ingegneristica e la tracciabilità normativa durante l'intero processo di previsione, fornendo al contempo la base fisica per la costruzione del modello statico di riferimento dei parametri.
Panoramica del flusso di lavoro metodologico
Il framework di previsione proposto si compone di tre fasi sequenziali: (1) costruzione di una baseline fisica utilizzando quote di carico di lavoro a livello di asset, (2) evoluzione dinamica delle quote di costo mediante aggiustamenti macroeconomici e tecnologici, e (3) compensazione basata sull'apprendimento automatico per catturare gli effetti sistematici non lineari. Come illustrato in Figura 1, il framework stabilisce un mapping gerarchico dagli asset e dalle attività operative standardizzate di livello inferiore fino alle previsioni dei costi di produzione e di esercizio. I dettagli implementativi di ciascuna fase sono descritti nei sottoparagrafi seguenti.
Modello di costo base fisico basato sui carichi di lavoro a livello di asset
La produzione e il costo operativo di una rete elettrica, Ctotal, comprendono spese associate a numerose attività commerciali, tra cui l'esercizio della sottostazione, la manutenzione delle linee di trasmissione, la gestione della rete di distribuzione, il servizio clienti e i sistemi di supporto. In questo studio, si assume che il costo operativo di base sia determinato dal carico di lavoro generato da ciascuna attività operativa standardizzata e dalla relativa quota di costo.
Il costo statico di base è calcolato come:
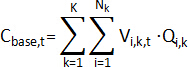 (1)
dove Vi,k,t indica il carico di lavoro associato all'attività operativa o all'asset i-esimo all'interno della categoria aziendale k durante il periodo t, e Qi,k rappresenta il corrispondente costo unitario standardizzato definito dal sistema di quotazione dei costi ingegneristici. La categoria aziendale comprende le principali funzioni operative come la manutenzione delle sottostazioni, l'ispezione delle linee di trasmissione, l'esercizio della rete di distribuzione e il servizio al cliente. La doppia sommatoria aggrega i costi di tutte le attività operative standardizzate per stimare la spesa teorica di base necessaria a mantenere il normale funzionamento della rete.
L'equazione (1) stabilisce la relazione fisica tra carichi di lavoro ingegneristici e spese finanziarie, associando direttamente attività operative standardizzate a conti di costo. A differenza dei modelli puramente statistici di previsione, questa formulazione fornisce una base ingegneristica interpretabile, che costituisce il fondamento per successivi aggiustamenti dinamici delle quote e correzioni residue basate sull'apprendimento automatico. L'equazione è stata sviluppata a partire dalle pratiche operative e dal sistema di quote di costo adottato dalle imprese provinciali di rete elettrica in Cina. Tabella 1 riassume la notazione utilizzata nell'equazione (1), inclusi il carico di lavoro (Vi,k,t), il costo unitario standardizzato (Qi,k), il numero di attività operative (Nk) e l'indice di categoria aziendale (k).
Meccanismo di evoluzione dinamica delle quote in presenza di perturbazioni ambientali esterne
I parametri di costo standardizzati (Qi,k) forniscono una base di riferimento fisicamente interpretabile, ma non tengono conto dei cambiamenti nelle condizioni macroeconomiche né dei progressi tecnologici. Per migliorarne l'applicabilità a lungo termine, è stato introdotto un meccanismo di evoluzione dinamica per aggiustare i parametri di riferimento in risposta sia all'inflazione dei prezzi sia ai guadagni di efficienza legati al progresso tecnologico.
La prima correzione tiene conto delle variazioni dei costi di approvvigionamento derivanti dall'inflazione macroeconomica. Il funzionamento e la manutenzione della rete elettrica dipendono fortemente da materiali in massa, tra cui rame, alluminio e acciaio al silicio, i cui prezzi sono strettamente correlati alle fluttuazioni dell'Indice dei Prezzi alla Produzione (PPI). Poiché  è un indice con valore base pari a 100, viene inizialmente convertito in un tasso di inflazione standardizzato:
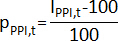 (2)
Sulla base di ciò, la funzione di correzione del prezzo  è definita come:
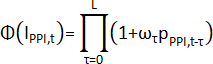 (3)
dove  è un vettore di pesi ritardati di lunghezza L che soddisfa
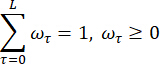
La struttura di ritardo rappresenta la trasmissione ritardata dell'inflazione macroeconomica ai costi di approvvigionamento all'interno della catena di fornitura della rete elettrica. La conversione dell'indice PPI in un tasso d'inflazione standardizzato preserva l'effetto cumulativo delle variazioni di prezzo, evitando al contempo i bias di scala associati all'uso diretto dei valori dell'indice. Le equazioni (2) e (3) sono adattate da modelli consolidati di aggiustamento dell'inflazione macroeconomica, con la struttura di ritardo calibrata per i cicli di approvvigionamento del settore energetico33,34.
I progressi tecnologici sono stati incorporati attraverso un fattore di riduzione dei costi che riflette i miglioramenti nell'efficienza operativa derivanti da avanzamenti come l'ispezione mediante veicoli aerei senza pilota, la robotica intelligente e le tecnologie digitali di manutenzione. Il fattore di aggiustamento tecnologico è definito come:
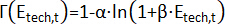 (4)
In questa parte, α e β sono coefficienti empirici di elasticità stimati a partire da dati storici panel mediante il metodo dei minimi quadrati non lineari. Per garantire che il fattore di progresso tecnologico rappresenti sempre una riduzione ragionevole del costo unitario del preventivo, il processo di stima dei parametri impone il vincolo 0 < Γ(Etech,t) ≤ 1. Va osservato che questo fattore riflette principalmente il miglioramento dell'efficienza a lungo termine derivante dalla sostituzione con tecnologie mature. L'equazione (4) è originale di questo studio e adatta il concetto di curva di apprendimento presente nella letteratura sui costi delle tecnologie energetiche35,36 alle operazioni di manutenzione della rete. I costi aggiuntivi che possono emergere nella fase iniziale di implementazione di apparecchiature digitali, come l'esercizio parallelo di sistemi vecchi e nuovi, l'integrazione delle piattaforme, i test di comunicazione e la manutenzione supplementare, non vengono sottratti forzatamente dal preventivo di base; piuttosto, vengono identificati dal successivo modulo di compensazione dei residui basato sull'apprendimento automatico:
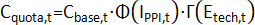 (5)
dove Cbase,t indica il costo statico di base calcolato a partire dai carichi di lavoro delle risorse di livello inferiore e dalle quote standardizzate dei costi operativi; rappresenta l'effetto di trasmissione delle fluttuazioni macroeconomiche sui prezzi di materiali, attrezzature e servizi esterni; e Γ(Etech,t) riflette la riduzione dei costi operativi e di manutenzione per unità ottenuta grazie all'efficienza raggiunta con la maturazione tecnologica. Attraverso questo meccanismo di evoluzione dinamica, la base della quota non rimane più su una semplice base contabile statica, ma può adattarsi in modo dinamico ai cambiamenti nelle condizioni economiche e tecnologiche. L'equazione (5) è originale di questo studio e rappresenta l'innovativa integrazione delle correzioni per prezzi e tecnologia all'interno del quadro di riferimento della quota.
Cattura sistematica di residui non lineari sotto vincoli di quota
Nonostante complesse correzioni evolutive, il modello delle quote genera inevitabilmente deviazioni sistematiche quando si confronta con interruzioni meteorologiche imprevedibili legate a disastri e con direttive politiche improvvise, come l'aumento dei costi di gestione dei reclami dei clienti durante periodi temporanei di riduzione delle tariffe. Questa deviazione costituisce il termine residuo su entrambi i lati dell'equazione:
Rt=Cactual,t-Cquota,t (6)
Poiché le regole fisiche convenzionali non riescono a spiegare questo aspetto, il machine learning può superare tali limitazioni. Per evitare la maledizione della dimensionalità causata da caratteristiche ad alta dimensionalità, questo studio utilizza l'algoritmo XGBoost basato su insiemi di alberi decisionali per modellare la relazione non lineare Rt37,38. Viene definita una matrice di caratteristiche con forti perturbazioni Xt, comprendente parametri meteorologici come i giorni estremi di gelo annuale Dice e l'intensità delle politiche macroeconomiche.
Per un compensatore non lineare composto da alberi di regressione, la logica di generazione del residuo predetto  può essere espressa come39:
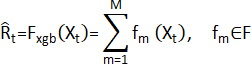 (7)
dove F indica lo spazio di tutte le possibili strutture degli alberi di classificazione e regressione. Per bilanciare l'accuratezza di adattamento e la prevenzione dell'overfitting, viene costruita e minimizzata nell'm-esima iterazione una funzione obiettivo regolarizzata contenente un termine di penalizzazione per la complessità strutturale:
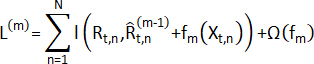 (8)
dove  è una funzione di perdita convessa che misura la differenza tra il residuo reale e il residuo previsto. In questo articolo viene adottata la perdita di Huber per migliorare la robustezza del modello nei confronti di picchi di spesa anomali. Il termine di regolarizzazione
 viene utilizzato per limitare la complessità della struttura dell'albero ed è definito come:
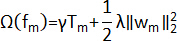 (9)
dove Tm rappresenta il numero di nodi foglia nell'albero m-esimo, wm rappresenta il corrispondente vettore dei pesi delle foglie, e γ e λ indicano rispettivamente il coefficiente di penalizzazione del numero di nodi foglia e il coefficiente di regolarizzazione del peso.
L'equazione finale di previsione è:
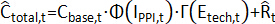 (10)
Espanso ulteriormente come:
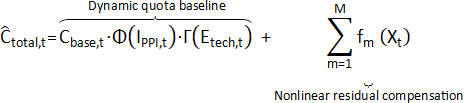 (11)
La formula sopra rappresenta matematicamente la struttura ad anello chiuso del modello di previsione proposto. La domanda finale relativa ai costi di produzione e di esercizio non è generata direttamente dal modello di apprendimento automatico; piuttosto, si ottiene sovrapponendo la compensazione residua non lineare identificata dal modulo di apprendimento automatico alla baseline dinamica della quota. Tra questi componenti, i fattori di prezzo e tecnologia riflettono principalmente l'evoluzione dinamica della baseline della quota, mentre fattori difficili da caratterizzare esplicitamente tramite regole, come gli shock climatici, le perturbazioni politiche e gli aumenti improvvisi degli interventi di riparazione, sono catturati dal modulo di compensazione residua basato sull'apprendimento automatico. Le equazioni (10) e (11) sono originali di questo studio e integrano la baseline fisica con la cattura residua basata sull'apprendimento automatico in un framework unificato di previsione.
Figura 2 mostra che i risultati di previsione del modello proposto esibiscono una chiara logica gerarchica di generazione. Da un lato, la quota di base fornisce una solida base fisica, trasparente e verificabile per la domanda di costi; dall'altro lato, gli aggiustamenti dei prezzi, gli effetti tecnologici e i residui degli shock esterni consentono al modello di adattarsi ai cambiamenti dinamici in ambienti complessi. Rispetto ai modelli a scatola nera che producono direttamente valori predetti, questa struttura di decomposizione può rivelare chiaramente "perché i costi aumentano o diminuiscono", migliorando così l'interpretabilità dei risultati del modello nella revisione del bilancio e nella regolamentazione delle tariffe di trasmissione e distribuzione.
Fonti dei dati e procedure di raccolta
I modelli teorici devono essere rigorosamente validati attraverso dati empirici per dimostrare la loro utilità pratica. Poiché i dati finanziari fondamentali del settore energetico contengono informazioni sensibili relative alle operazioni delle infrastrutture nazionali, questo studio estrae dati contabili mensili ad alta precisione e anonimizzati da una tipica rete elettrica provinciale nella Cina orientale, indicata per comodità come E-Grid, che coprono 16 anni solari consecutivi dal 2010 al 2025. Questa provincia ha attraversato un ciclo economico tipico, passando da una crescita trainata dalle tradizionali industrie pesanti a una manifatturiera di alto livello, con un tasso di crescita annuo composto della scala delle attività della rete pari al 7,4%. L'evoluzione complessa della sua struttura dei costi, pertanto, potrebbe essere rilevante anche per altri sistemi di rete in rapido sviluppo. I dati provengono da tre fonti principali: (1) registri interni di esercizio e manutenzione che documentano i carichi di lavoro a livello di attività, le frequenze di ispezione e gli interventi di riparazione; (2) sistemi contabili finanziari che forniscono estratti conto mensili relativi a costi per manodopera, materiali, attrezzature e servizi esternalizzati; e (3) basi di dati ambientali esterne, incluse le registrazioni meteorologiche dell'Amministrazione Meteorologica Cinese e gli indicatori macroeconomici dell'Ufficio Nazionale di Statistica.
Controllo della qualità e trattamento dei dati mancanti
Per oltre 130 indicatori iniziali integrati da sistemi multi-fonte, è stata implementata una rigorosa procedura di controllo qualità. I dati mancanti, che rappresentano meno del 3% del totale delle osservazioni, sono stati gestiti mediante interpolazione lineare per le variabili continue con andamenti temporali e mediante imputazione della moda per gli indicatori categorici. Gli outlier sono stati identificati utilizzando il metodo dell'intervallo interquartile (IQR); i valori superiori a 3,0 volte l'IQR rispetto al terzo quartile sono stati winsorizzati al 99° percentile per preservare l'integrità dei dati e ridurre al minimo la distorsione causata da valori estremi.
Considerazioni sulla dimensione del campione
Il set di dati comprende 192 osservazioni mensili (gennaio 2010 – dicembre 2025), con 156 osservazioni (2010–2022) assegnate per l'addestramento e la validazione e 36 osservazioni (2023–2025) riservate per il test su campioni esterni. Sebbene questa dimensione campionaria sia relativamente modesta per applicazioni di deep learning, è adeguata per l'algoritmo XGBoost, progettato specificamente per prestazioni elevate con set di dati tabulari di dimensioni ridotte o medie grazie ai suoi meccanismi di regolarizzazione e potatura degli alberi. Per ridurre al minimo i rischi di overfitting, (1) sono state applicate penalità rigorose di regolarizzazione (γ = 0,1, λ = 1,0), (2) è stato utilizzato l'arresto anticipato con una tolleranza di 50 cicli e (3) sono state imposte restrizioni conservative sulla profondità degli alberi (profondità massima = 5). Queste misure garantiscono collettivamente stabilità e capacità di generalizzazione del modello nonostante la dimensione limitata del campione.
Segmentazione dei dati e integrazione eterogenea multiprovenienza
Per un test rigoroso, i dati da gennaio 2010 a dicembre 2022 sono stati assegnati all'intervallo di addestramento e validazione, contenente 156 osservazioni, utilizzato per addestrare i fattori di evoluzione della quota e la rete residua di compensazione della quota. Il periodo da gennaio 2023 a dicembre 2025 è riservato come insieme di test fuori campione trattenuto, contenente 36 osservazioni. Perché questo periodo è stato scelto come fase finale di verifica? Il motivo è che questi tre anni hanno coinciso con l'accelerazione della costruzione di un nuovo tipo di sistema elettrico, aggravata da eventi su larga scala di temperature elevate legati a fenomeni estremi di El Niño e dalla crescita rapida e disomogenea della generazione distribuita di energia rinnovabile. La rete elettrica ha affrontato pressioni senza precedenti nelle catene di approvvigionamento di materiali e nell'allocazione della manodopera per le riparazioni.
La selezione scientifica e la definizione quantitativa dei fattori determinanti i costi costituiscono la base per garantire che la rete residuale di apprendimento automatico possa catturare efficacemente le fluttuazioni sistematiche. Sulla base della logica gestionale dei costi operativi standard nei sistemi elettrici, questo studio supera la singola dimensione della previsione finanziaria tradizionale, basata esclusivamente sui flussi di cassa storici, ricostruendo l'ingegnerizzazione delle caratteristiche a partire da quattro confini fondamentali: dimensione delle attività fisiche, condizioni di esercizio e manutenzione, evoluzione macroeconomica e ambiente climatico esterno, utilizzando registri operativi originali e contabilità di sistemi esterni. Nel processo effettivo di modellazione, per oltre 130 indicatori originali derivanti dall'integrazione di sistemi multi-sorgente, lo studio impiega test di correlazione di Pearson per eliminare le variabili ridondanti fortemente collineari, con una soglia di |r| > 0,85. Sulla base delle conoscenze pregresse di esperti senior di reti elettriche, vengono infine selezionate 42 caratteristiche principali di ingresso per formare la matrice delle caratteristiche Xt. Per presentare chiaramente la struttura e la distribuzione sottostante dei dati nel tensore di ingresso, Tabella 2 seleziona 12 caratteristiche principali rappresentative dalle quattro dimensioni di valutazione sopra indicate e ne riassume le statistiche descrittive nel periodo di osservazione.
Per illustrare ulteriormente la base spaziale e topologica del sistema di caratteristiche multiprovenienza, Figura 3 presenta una topologia schematica anonimizzata della rete elettrica provinciale oggetto di studio. La figura sovrappone sottostazioni per livello di tensione, corridoi di trasmissione, cluster distribuiti di fonti rinnovabili, centri di carico e zone rappresentative di disturbi ambientali. La topologia aiuta a spiegare perché i costi di produzione e di esercizio sono influenzati congiuntamente dalla scala delle infrastrutture, dalla struttura della rete, dall'intensità degli interventi di riparazione d'emergenza e dagli shock climatici esterni. Inoltre, fornisce una base di interpretazione spaziale per le variabili trainanti i residui utilizzate nel modulo di compensazione XGBoost.
Tabella 2 mostra che le variabili esplicative appartenenti a diverse dimensioni aziendali presentano forme statistiche nettamente differenti. Le variabili relative alle risorse fisiche, che rappresentano la dinamica endogena dello sviluppo aziendale, come la capacità delle sottostazioni e la lunghezza delle linee, presentano deviazioni standard relativamente stabili e valori di asimmetria concentrati tra 0,1 e 0,8. La struttura complessiva dei dati è approssimativamente distribuita in modo normale, riflettendo oggettivamente l'attributo di uno sviluppo stabile della rete elettrica nel ciclo di costruzione delle infrastrutture. In netto contrasto si collocano le variabili meteorologiche e relative agli agenti esterni di disturbo riportate in fondo alla tabella. Ad esempio, il numero cumulativo di giorni con temperature di livello di allerta negli ultimi 90 giorni e l'indice di impatto dei distacchi delle linee mostrano un'elevata asimmetria verso destra, con valori di asimmetria pari a 2,15 e 2,45 rispettivamente. Questa tipica distribuzione a coda pesante conferma un punto critico oggettivo, impossibile da ignorare nella gestione reale della manutenzione della rete elettrica: sebbene i disastri causati dal maltempo estremo si verifichino relativamente di rado nel corso dell'anno, una volta innescati provocano spesso un aumento esponenziale dell'impegno di manodopera per le riparazioni e del consumo di ricambi. Da un altro punto di vista, l'elevata non uniformità e l'asimmetria verso valori estremi nella distribuzione di queste caratteristiche provenienti da fonti multiple rivelano i limiti teorici dei tradizionali modelli lineari di serie temporali, come ARIMAX, basati sull'ipotesi di normalità ed omoschedasticità, quando si tratta di modellare costi complessi della rete elettrica. Questo non solo rafforza ulteriormente la ragionevolezza dell'introduzione di un modulo basato sull'apprendimento automatico al di là della contabilità fisica di base, ma fornisce anche un solido supporto statistico alla scelta, da parte di questo articolo, del modello ad alberi XGBoost, in grado di gestire efficacemente distribuzioni sparse di caratteristiche e mappe non lineari per approssimare i residui di costo.
Configurazione del sistema di ottimizzazione e valutazione degli iperparametri
Dopo aver determinato lo spazio di ingresso delle caratteristiche, l'impostazione degli iperparametri del modello influenza direttamente le prestazioni di adattamento della rete di approssimazione residua. Poiché la rete di compensazione XGBoost comprende numerosi parametri, tra cui la profondità dell'albero (max depth), il tasso di apprendimento e i termini di penalizzazione per la regolarizzazione, e poiché tali parametri presentano interazioni non lineari, la ricerca a griglia convenzionale non solo comporta un'elevata complessità computazionale, ma tende anche a rimanere intrappolata in minimi locali negli spazi ad alta dimensione. Pertanto, questo studio introduce l'Estimatore di Parzen ad Albero (Tree-structured Parzen Estimator, TPE), un metodo di ottimizzazione bayesiana, nel processo di taratura dei parametri. L'algoritmo TPE può guidare dinamicamente le successive direzioni di campionamento sfruttando il feedback della funzione di perdita ottenuto dalle valutazioni precedenti. Costruendo una stima della densità kernel a posteriori (KDE) della variabile obiettivo, restringe in modo adattivo lo spazio di ricerca dei parametri, consentendo al modello di avvicinarsi alla configurazione ottimale globale degli iperparametri senza incorrere in costi computazionali elevati. L'obiettivo dell'ottimizzazione TPE era minimizzare l'RMSE di validazione su 100 iterazioni, con interruzione anticipata dopo 50 cicli senza miglioramenti.
Dopo aver completato l'ottimizzazione dei parametri sul set di validazione interno, per valutare oggettivamente le prestazioni finali di ciascun modello sul set di test fuori campione e soddisfare i requisiti di valutazione quantitativa degli enti regolatori per la verifica dei costi, questo studio utilizza l'errore percentuale assoluto medio (MAPE) per quantificare la deviazione relativa nella sequenza predetta. Nel frattempo, per affrontare l'esigenza pratica di controllare i gravi errori di previsione dei costi nelle operazioni, viene introdotto anche l'errore quadratico medio (RMSE), che impone penalità maggiori agli errori più grandi. Infine, il coefficiente di determinazione, R2, quantifica il potere esplicativo complessivo della regressione rispetto alla varianza reale del bersaglio.
Le definizioni matematiche degli indicatori sono le seguenti:
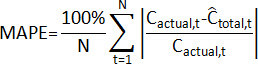 (12)
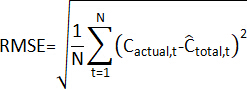 (13)
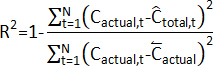 (14)
dove  rappresenta il costo effettivo di produzione e di esercizio nel periodo t,
 rappresenta il costo previsto dal modello,
 rappresenta il costo effettivo medio nel campione di prova e N è il numero di campioni nel set di prova.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Confronto panoramico con riduzione della dimensionalità dell'accuratezza delle previsioni
Quando tutti i modelli ottimizzati mediante l'Estimatore Parzen ad Albero (TPE) sono stati valutati sul set di test fuori campione 2023–2025, che includeva fluttuazioni legate alla ripresa post-pandemica ed eventi di temperatura estremamente elevata, è stato possibile confrontare oggettivamente le prestazioni degli algoritmi di previsione più diffusi. Per effettuare una valutazione rigoro...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo studio dimostra che l'integrazione di quote di costo industriali con il machine learning fornisce un quadro interpretabile e accurato per le previsioni a lungo termine dei costi della rete elettrica. I risultati mostrano che le variabili legate al clima, in particolare i giorni con temperature estreme elevate e gli indici di impatto dei disservizi delle linee, sono i principali fattori determinanti dei residui di costo, evidenziando l'importanza crescente delle perturbazioni esterne sulle spese delle aziende elett...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Tutti gli autori dichiarano di non avere conflitti di interessi.
CONTRIBUTO DEGLI AUTORI:
Xiaohui Wang ha concepito e progettato lo studio, sviluppato la metodologia, effettuato l'analisi formale e redatto il manoscritto originale. Tong Li ha contribuito alla cura dei dati, all'implementazione del software e alla validazione. Yanchao Lu ha contribuito allo sviluppo della metodologia, all'indagine e all'interpretazione dei dati. Quanfeng Lv ha fornito risorse, supervisionato l'acquisizione dei dati e revisionato criticamente il manoscritto. Fan Liu ha supervisionato il progetto, contribuito alla concettualizzazione e all'interpretazione dei risultati, ottenuto il finanziamento e revisionato criticamente il manoscritto. Tutti gli autori hanno esaminato e approvato la versione finale del manoscritto
Ringraziamenti
Questo lavoro è stato sostenuto dal Progetto Tecnologico della State Grid Corporation of China, con il nome di "Ricerca sull'Analisi dell'Allocazione dei Costi di Produzione e di Esercizio e sulla Tecnologia di Ottimizzazione Asincrona" (Numero del Progetto:520600250029-183-ZN).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Dataset anonimizzato di contabilità mensile E-Grid | Griglia elettrica provinciale nella Cina orientale | N/A | Dataset anonimizzato di produzione e costi operativi mensili (2010–2025) composto da 192 osservazioni, inclusi dati su beni fisici, manutenzione e operazioni, dati macroeconomici e ambientali. Utilizzato per lo sviluppo del modello (156 osservazioni) e per i test fuori campione (36 osservazioni). |
| Libreria di plotting Matplotlib | Squadra di sviluppo di Matplotlib | 3.5.2 | Utilizzata per generare figure del manoscritto e output grafici, inclusi grafici delle prestazioni del modello, visualizzazioni della topologia, diagnosi dei residui, grafici radar e riepiloghi visivi relativi a SHAP. |
| Libreria di calcolo numerico NumPy | Sviluppatori di NumPy | 1.22.3 | Utilizzata per operazioni numeriche su array, calcoli matriciali e controllo della riproducibilità. Un seme casuale fisso pari a 42 è stato applicato quando rilevante. |
| Libreria di manipolazione dati Pandas | Squadra di sviluppo di pandas | 1.4.2 | Utilizzata per importazione, integrazione, ristrutturazione, filtraggio e pre-elaborazione dei dati, inclusa l'imputazione dei valori mancanti, l'allineamento delle serie temporali e la preparazione delle variabili di input del modello. |
| Ambiente di programmazione Python | Fondazione Python Software | 3.9.13 | Ambiente di programmazione utilizzato per implementare l'intero flusso di lavoro di previsione, inclusi pre-elaborazione dei dati, ingegnerizzazione delle caratteristiche, addestramento del modello, ottimizzazione degli iperparametri, previsione, test statistici e valutazione delle prestazioni. |
| Libreria di apprendimento automatico Scikit-learn | Collaboratori di scikit-learn | 1.0.2 | Utilizzata per la pre-elaborazione dei dati, la suddivisione in training e validazione, la valutazione di modelli ausiliari e procedure statistiche, inclusa l'analisi della correlazione di Pearson e il calcolo di metriche di prestazione selezionate. |
| Libreria di calcolo scientifico SciPy | Collaboratori di SciPy | 1.9.0 | Utilizzata per calcoli statistici, inclusa l'analisi della correlazione di Pearson e procedure di supporto per il trattamento degli outlier e la winsorizzazione. |
| Implementazione dell'Estimatore Parzen ad Albero | Collaboratori di Optuna | 3.1.0 | Implementazione di ottimizzazione bayesiana utilizzata per regolare gli iperparametri di XGBoost, inclusa la profondità massima dell'albero, il tasso di apprendimento e i parametri di regolarizzazione. L'Estimatore Parzen ad Albero è stato implementato tramite il pacchetto open source Optuna. |
| Libreria software XGBoost | DMLC / Collaboratori XGBoost | 1.7.1 | Libreria di apprendimento ensemble basata su alberi decisionali utilizzata per la compensazione non lineare dei residui. Il modello ha implementato una funzione obiettivo regolarizzata con perdita Huber e penalità per la complessità dell'albero, come descritto nelle Equazioni 7–9. |
Riferimenti
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.