Questo protocollo descrive un flusso di lavoro ibrido quanto-classico riproducibile per classificare il morbo di Parkinson a partire da registrazioni vocali umane, inclusi la pre-elaborazione dei dati, l'implementazione dei circuiti quantistici, l'addestramento del modello e la validazione incrociata per replicazioni indipendenti.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Un protocollo ibrido quantistico-classico riproducibile per classificare la malattia di Parkinson a partire da registrazioni vocali umane
In questo articolo
Sommario
Abstract
Il morbo di Parkinson è un disturbo neurodegenerativo progressivo per il quale i metodi di screening accessibili e a basso costo restano limitati. Le registrazioni vocali sostenute contengono biomarcatori acustici misurabili associati alla disfonia correlata a malattie che possono essere acquisiti senza apparecchiature specializzate. Questo protocollo descrive una rete neurale convoluzionale ibrida quanto-classica a quattro qubit (QI-HCNN) che combina un circuito quantistico parametrizzato con uno strato di classificazione classica superficiale per classificare la malattia di Parkinson utilizzando caratteristiche vocali acustiche ridotte in dimensioni ridotte. Il protocollo confronta inoltre l'approccio proposto con una rete neurale classica abbinata alla dimensionalità e con classificatori ad albero potenziati da gradiente addestrati sia su feature set ridotto che completo. Utilizzando un dataset pubblicamente disponibile e de-identificato comprensivo di 195 registrazioni vocali di 31 individui, il QI-HCNN ha raggiunto un'area sotto la curva di funzionamento del ricevitore di 0,78 utilizzando la validazione incrociata stratificata a tre punti, rispetto a 0,87 per la rete neurale classica abbinata e 0,94–0,95 per le basi potenziate dal gradiente addestrate rispettivamente sui feature set ridotti e completi. Un'analisi di ablazione controllata ha dimostrato che una delle due operazioni di entanglement nel circuito non poteva influenzare l'output misurato per progetto, mentre la restante operazione di entanglement ridusse, anziché migliorata, le prestazioni di classificazione rispetto a una variante non entangled. La validazione incrociata tra pazienti ha inoltre mostrato che le stime delle prestazioni variavano sostanzialmente a seconda degli individui assegnati al set di test, riflettendo la dimensione limitata della coorte. Questo protocollo fornisce quindi una base quantistica-classica pienamente specificata e indipendentemente riproducibile, insieme a una valutazione supportata dai dati dei punti di forza e dei limiti del progetto attuale del circuito, fornendo una base metodologica per future indagini piuttosto che sostenere affermazioni di prontezza diagnostica.
Introduzione
Il morbo di Parkinson è un disturbo neurodegenerativo cronico causato dalla progressiva perdita di neuroni dopaminergici nella substantia nigra, che colpisce più di 10 milioni di persone in tutto il mondo e rappresenta un onere significativo e crescente per la salutepubblica 1. La malattia produce sia sintomi motori, tra cui tremori, rigidità e bradicinesia, sia sintomi non motori come disturbi del sonno e anosmia. La diagnosi clinica si basa principalmente su esame neurologico utilizzando scale motorie standardizzate, integrate quando disponibili, da imaging con trasportatori di dopamina; Tuttavia, entrambi gli approcci richiedono competenze specialistiche e infrastrutture non uniformi accessibili, e la valutazione clinica nelle fasi iniziali rimanesoggettiva 2. Poiché attualmente non è disponibile alcuna terapia modificante della malattia, la diagnosi precoce è preziosa principalmente perché consente una gestione più precoce dei sintomi e un monitoraggio longitudinale. Questa necessità ha motivato lo sviluppo di approcci di screening a basso costo, scalabili e non invasivi che possano integrare, piuttosto che sostituire, la valutazione clinica.
Il deficit vocale è uno dei primi cambiamenti misurabili associati al morbo di Parkinson e spesso precede i sintomi motorievidenti 3. La fonazione sostenuta di una vocale tenuta fornisce un segnale controllato da cui si possono estrarre caratteristiche acustiche, tra cui jitter, scintillio, rapporto armonico-rumore, entropia di densità di periodo di ricorrenza e analisi delle fluttuazioni detrendate. Queste caratteristiche sono state ripetutamente dimostrate contenere informazioni diagnosticamente rilevanti e possono essere acquisite utilizzando apparecchiature di registrazione di livelloconsumer 4,5. Un dataset di benchmark pubblicamente disponibile derivato da tali registrazioni è diventato un banco di prova standard per questo compito, e i metodi classici di apprendimento automatico applicati all'intero set di caratteristiche, inclusi macchine a vettori di supporto, foreste casuali e alberi con gradiente aumentati, hanno riportato valori di area sotto la curva di funzionamento del ricevitore che si avvicinano a 0,99 6,7,8, suggerendo che il compito di classificazione è vicino alla risoluzione quando si utilizzano l'intero set di caratteristiche e le strategie appropriate per gestire lo squilibrio di classe. Il machine learning quantistico è emerso come paradigma computazionale alternativo per compiti di classificazione biomedica, in cui circuiti quantistici parametrizzati utilizzano sovrapposizione ed entanglement per rappresentare interazioni di caratteristiche con relativamente pochi parametri addestrabili, e i gradienti di circuito possono essere calcolati analiticamente usando la regola dello spostamento dei parametri piuttosto che approssimazioni a differenzafinita 9. Tuttavia, molti studi pubblicati che descrivono reti neurali "quantistiche" o "ispirate al quantismo" per applicazioni biomediche implementano architetture interamente classiche che adottano formalismi matematici ispirati al quantismo senza eseguire un vero circuito quantistico parametrizzato né su un simulatore né su hardwarequantistico 10. Gli sviluppi recenti nella rilevazione del morbo di Parkinson hanno incluso anche architetture ibride di reti neurali convoluzionali-trasformatori11, metodi di deep learning basati sull'attenzione per l'imaging a risonanza magnetica (MRI)12, e reti neurali convoluzionali leggere progettate per la diagnosicomputazionalmente efficiente 13, illustrando la rapida espansione degli approcci all'intelligenza artificiale su molteplici modalità di dati. Più in generale, la diagnosi assistita da computer non invasiva è stata estesa con successo ad altre applicazioni biomediche, inclusi pipeline ibridi di machine learning e deep learning per l'imagingmedico 14. Le valutazioni comparative delle architetture di deep learning sullo stesso dataset di voce pubblica dimostrano ulteriormente le solide prestazioni raggiungibili utilizzando modelli classici convenzionali a piena funzionalità15.
Questi sviluppi evidenziano una specifica necessità metodologica di un modello riproducibile di rete neurale convoluzionale ibrida quanto-classica (QI-HCNN) che (i) eseguisca un circuito quantistico parametrizzato autentico e completamente specificato; (ii) viene valutato utilizzando caratteristiche di input identiche sia rispetto a una rete neurale classica architettonicamente abbinata sia a una solida linea di base classica; e (iii) viene valutato utilizzando un protocollo che esamina esplicitamente le principali fonti di bias in piccoli dataset biomedici, inclusi squilibri di classe, confusione demografica e fuga di dati a livello di paziente durante la convalidazione incrociata.
L'obiettivo generale di questo protocollo è fornire un flusso di lavoro QI-HCNN completamente riproducibile per la classificazione della Malattia di Parkinson utilizzando registrazioni vocali umane. Il protocollo descrive un circuito quantistico parametrizzato a quattro qubit che impiega codifica angolare, due strati di entanglement basati su NOT controllati e uno strato variazionale addestrabile ottimizzato con la regola dello spostamento dei parametri, abbinato a una testa di classificazione classica poco profonda e applicato a una rappresentazione principale-componente a quattro componenti di un dataset pubblico di registrazione vocale. Il workflow specifica, a un livello sufficiente per la replica indipendente, tutte le procedure di pre-elaborazione, la costruzione completa del circuito, la configurazione classica dell'addestramento e le procedure di valutazione, inclusi confronti con una rete neurale classica abbinata alla dimensionalità, basi di albero con affinità di dimensionalità e gradiente potenziato per tutte le caratteristiche, ablazioni controllate a componenti del circuito, validazione incrociata raggruppata tra pazienti per valutare la sensibilità ai partecipanti in attesa e statistica esplicita Test di significatività. Piuttosto che presentare solo risultati favorevoli, il protocollo è progettato per riportare in modo trasparente quando i singoli componenti del circuito non migliorano misurabilmente le prestazioni, fornendo così un quadro metodologico riproducibile che possa informare lo sviluppo futuro dell'architettura QI-HCNN per compiti di classificazione biomedica a piccoli gruppi.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo protocollo utilizza un dataset di registrazione vocale di terze parti, de-identificato e pubblicamente disponibile. Non sono stati raccolti nuovi dati umani dagli autori e non è stata richiesta alcuna approvazione aggiuntiva da parte del comitato di revisione istituzionale (IRB) per questo studio. Il dataset descritto nella sottosezione Acquisizione del Dataset e Gestione dei Dati a Livello di Partecipante è stato originariamente raccolto sotto approvazione etica istituzionale da Little et al.3, non contiene informazioni direttamente identificative sui partecipanti (solo identificatori anonimi di registrazione) ed è pubblicamente disponibile per l'uso di ricerca. Conferma, secondo le vostre politiche istituzionali, se l'analisi secondaria di questo dataset pubblicamente disponibile richiede una revisione etica. Presso l'istituzione degli autori, l'analisi secondaria retrospettiva di questo dataset completamente de-identificato e archiviato pubblicamente è stata ritenuta esente dalla revisione completa dell'IRB.
Acquisizione di dataset e gestione dei dati a livello di partecipante
Il dataset della Classificazione del Morbo di Parkinson (UCI Machine Learning Repository, Dataset ID 174), originariamente descritto da Little et al.3, è stato scaricato. Il dataset conteneva 195 registrazioni di fonazione vocalica sostenuta /a/ provenienti da 31 individui (23 diagnosticati con morbo di Parkinson e 8 controlli sani; fascia d'età, 46–85 anni). Poiché il repository non fornisce un DOI versionato, la data esatta di download è stata registrata e riportata nella Tabella dei Materiali. Il dataset era fornito come un file CSV (parkinsons.csv). Non era necessaria alcuna decompressione o conversione di file, e il file veniva importato direttamente utilizzando la funzione read_csv dalla libreria Pandas (vedi Tabella dei Materiali).
Il dataset scaricato è stato verificato contenere 195 righe e 24 colonne comprendenti una colonna identificativa di registrazione (formato: phon_R01_S soggetto 
 _ registrazione), 22 colonne continue di caratteristiche acustiche (Tabella 1) e una colonna binaria di etichetta di classe (stato: 1 = morbo di Parkinson; 0 = controllo sano). La Tabella 1 veniva utilizzata come riferimento per tutte le caratteristiche acustiche e le categorie di caratteristiche lungo tutto il protocollo.
| Categoria | Caratteristiche rappresentative | Significato clinico |
| Frequenza fondamentale | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Frequenza media, massima e minima fondamentale della fonazione; riflette la stabilità della vibrazione delle corde vocali. |
| Jitter (perturbazione in frequenza) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Variazione ciclico a ciclo del periodo di intonazione, riflettendo compromesso il controllo motorio laringeo. |
| Shimmer (perturbazione dell'ampiezza) | MDVP: Shimmer, MDVP: Shimmer(dB), Shimmer: APQ3, Shimmer: APQ5, MDVP: APQ, Shimmer: DDA | Variazione da ciclo a ciclo nell'ampiezza del segnale, riflettendo una fonazione soffocata o instabile. |
| Misure di rumore | NHR, HNR | Rapporto tra rumore e componenti armoniche (tonali) del segnale vocale. |
| Dinamica non lineare / scalatura frattale | RPDE, D2, DFA, spread1, spread2, PPE | Misure della dinamica vocale non lineare, della periodicità e delle correlazioni temporali a lungo raggio associate alla vibrazione delle corde vocali. |
Tabella 1: Categorie di caratteristiche acustiche utilizzate per la classificazione del morbo di Parkinson. Le 22 caratteristiche vocali acustiche estratte dal dataset della Classificazione del Morbo di Parkinson sono raggruppate in cinque categorie di caratteristiche: frequenza fondamentale, jitter, scintillio, misure di rumore e dinamica non lineare. Le caratteristiche rappresentative per ogni categoria sono elencate insieme al loro relativo significato clinico. MDVP, Programma Vocale Multidimensionale; RAP, perturbazione media relativa; PPQ, quoziente di perturbazione del periodo di intonazione; APQ, quoziente di perturbazione di ampiezza; DDP, differenza di differenze periodali; DDA, differenza assoluta media delle ampiezze; NHR, rapporto rumore/armonici; HNR, rapporto armonici/rumore; RPDE, entropia di densità di periodi di ricorrenza; D2, dimensione di correlazione; DFA, analisi delle fluttuazioni detrendate; DPE, entropia del periodo di intonazione.
Per ogni registrazione veniva estratto un identificatore del partecipante analizzando la sottostringa precedente al sottolineamento finale nel nome della registrazione. Ad esempio, phon_R01_S01_1 e phon_R01_S01_2 sono stati assegnati al partecipante S01. Gli identificatori dei partecipanti, anziché quelli di registrazione, sono stati successivamente utilizzati per tutte le procedure di validazione raggruppate o lascia fuori un partecipante descritte nella sottosezione Evaluation Protocol perché le registrazioni ottenute dallo stesso partecipante sono acusticamente correlate. Dopo l'estrazione, è stata generata e ispezionata una tabella delle frequenze degli identificatori per confermare che tutte le 195 registrazioni siano state assegnate esattamente a 31 partecipanti unici, che nessuna registrazione sia rimasta non assegnata e che il numero di registrazioni per partecipante corrispondesse alla documentazione del dataset sorgente.
La distribuzione delle classi è stata tabulata sia a livello di registrazione (147 registrazioni per la malattia di Parkinson, 75,4%; 48 registrazioni di controllo sano, 24,6%) sia a livello di partecipante (23 su 31 partecipanti, 74,2%, diagnosticati con malattia di Parkinson). Entrambe le distribuzioni sono state riportate perché lo squilibrio tra la registrazione e quello tra la classe a livello di partecipante non è identico e influenza la valutazione a valle.
L'assenza di gruppi di Parkinson e di controllo sani abbinati per età o sesso nel dataset sorgente è stata documentata come limitazione dello studio e portata avanti nella Discussione perché questa caratteristica riflette la raccolta originale dei dati e non può essere corretta tramite preprocessing a valle.
Preprocessing Pipeline
Tutte le procedure di preprocessing sono state eseguite indipendentemente all'interno di ciascuna fase di addestramento della procedura di validazione incrociata descritta nella sottosezione Evaluation Protocol . Sia i passaggi di normalizzazione Min–Max sia l'analisi delle componenti principali (PCA) sono stati adattati utilizzando solo la partizione di addestramento di ciascuna piegatura. Le trasformazioni adattate venivano successivamente applicate alla corrispondente partizione di test tenuta senza riadattamento per evitare la perdita di informazioni dalla partizione di test ai parametri di preelaborazione.
Le 22 caratteristiche acustiche grezze in ogni partizione di addestramento sono state normalizzate usando uno scaler Min–Max con un intervallo di uscita di [0, π]. Lo scaler adattato veniva poi applicato sia alle partizioni di addestramento che a quelle di prova della piega corrispondente (Equazione 1). L'equazione 1 segue la formulazione standard di normalizzazione Min–Max ed è stata definita per il protocollo attuale. La normalizzazione Min–Max è stata eseguita utilizzando la classe MinMaxScaler di scikit-learn (versione 1.8.0) con feature_range=(0, π), copy=True e clip=False.
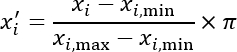 (1)
Un modello PCA con n_components = 4 è stato installato utilizzando solo i dati di addestramento normalizzati. La trasformazione PCA adattata è stata poi applicata sia alle partizioni di addestramento che a quelle di test. La proporzione della varianza totale spiegata dai quattro componenti principali mantenuti è stata registrata per ciascun fold. Attraverso le analisi riportate qui, le quattro componenti principali mantenute spiegavano l'81,5% della varianza totale (rispettivamente 50,3%, 16,3%, 9,4% e 5,5%). La PCA veniva eseguita usando la classe PCA con n_components=4, svd_solver="pieno", whiten=Falso, e random_state=42.
Poiché PCA può generare punteggi di componente a valori negativi, è stato installato un secondo scaler Min–Max con un intervallo di output di [0, π] utilizzando la partizione di addestramento trasformata in PCA. Successivamente, lo scaler montato fu applicato sia alle partizioni di addestramento che a quelle di prova. Qualsiasi valore trasformato della partizione di test che usciva dall'intervallo [0, π] veniva tagliato al confine più vicino perché lo scaler era stato adattato usando solo la partizione di addestramento. Non erano presenti caratteristiche a zero varianza nel dataset. La varietà di ogni feature in tutte le 195 registrazioni era strettamente positiva; pertanto, non si presentava alcuna condizione di divisione per zero. Ciò fu confermato verificando che l'output scalato non contenesse né NaN né valori infiniti.
Le quattro componenti principali rinormalizzate sono state assegnate sequenzialmente come angoli di rotazione per i qubit 0, 1, 2 e 3 durante la procedura di codifica angolare descritta nella sottosezione Costruzione dei Circuiti Quantistici . La prima componente principale fu assegnata al qubit 0, la seconda al qubit 1, la terza al qubit 2 e la quarta al qubit 3. Questo completò la pipeline di preprocessing e trasferì le caratteristiche classiche elaborate al circuito quantistico. Dopo il secondo passaggio di scaling Min–Max, tutti i valori di output sono stati confermati all'interno dell'intervallo [0, π]. I valori della partizione di test che erano leggermente fuori da questo intervallo a causa dell'arrotondamento in virgola mobile venivano tagliati al confine più vicino usando la funzione di clip di NumPy (versione 2.4.4). Questa procedura garantiva che tutti e quattro gli ingressi dello strato di codifica angolare fossero angoli di rotazione validi all'interno dell'intervallo [0, π].
Costruzione di circuiti quantistici
Il circuito a quattro qubit è stato costruito utilizzando il simulatore di vettore di stato elencato nella Tabella dei Materiali e nella sequenza di porte descritta di seguito. Il Supplementary Coding File 1 fu utilizzato come implementazione completa del circuito eseguibile, includendo tutte le funzioni helper per la costruzione delle porte e il calcolo del gradiente di spostamento dei parametri. La Figura 1 mostra il flusso di lavoro completo dalla pre-elaborazione della registrazione vocale attraverso i quattro strati di circuito, la classica testa di post-elaborazione e la classificazione finale.
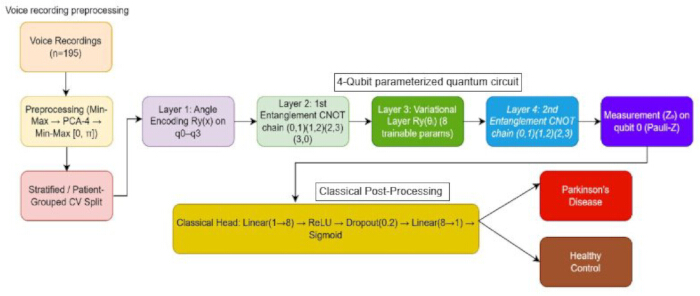
Figura 1. Architettura di sistema e flusso di lavoro dei circuiti quantistici. Flusso di lavoro per la classificazione del morbo di Parkinson da registrazioni vocali umane. Il diagramma mostra pre-elaborazione della registrazione vocale, validazione stratificata o incrociata per pazienti, esecuzione di circuiti quantistici parametrizzati a quattro qubit, misurazione Pauli-Z a qubit singolo su qubit 0, post-processing classico e classificazione binaria finale come morbo di Parkinson o controllo sano. CNOT, porta controllata NOT; PCA, analisi dei componenti principali; ReLU, unità lineare rettificata. Clicca qui per visualizzare una versione più grande di questa figura.
Un registro a quattro qubit veniva inizializzato nello stato base computazionale ∣0000.
Per lo strato di codifica angolare, è stata applicata una porta di rotazione Ry (xi) al qubit i, dove i = 0,1,2,3, utilizzando i quattro angoli prodotti dalla pipeline di preprocessing (Equazione 2). L'equazione 2 descrive la procedura standard di codifica angolare utilizzata nei circuiti quantistici parametrizzati, coerente con il framework di apprendimento dei circuiti quantistici parametrizzati di Mitarai et al.9, ed è stata applicata qui nella configurazione specifica a quattro qubit definita per il protocollo attuale.
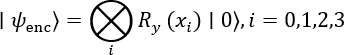 (2)
Per il primo strato di entanglement, è stata applicata una catena circolare di porte controllate-NOT nel seguente ordine controllato-bersaglio: (0,1), (1,2), (2,3) e (3,0).
Per lo strato variazionale, gli otto parametri addestrabili w0 fino a w 7 sono stati inizializzati tramite campionamento indipendente da una distribuzione normale con media pari a 0 e deviazione standard di 0,3. Il seme casuale utilizzato è stato registrato nella Tabella dei Materiali. Gli otto parametri quantistici variazionali sono stati inizializzati usando numpy.random.default_rng(42 + fold_index).normal(0, 0,3, dimensione = 8), dove fold_index è il numero di pieghe basato su zero, fornendo così inizializzazioni specifiche ma riproducibili per la piegatura. Per ogni qubit i = 0,1,2 e 3, veniva applicata una porta R z(wi), seguita da una portaR y(w i+4) (Equazione 3). L'equazione 3 descrive uno strato quantistico variazionale (addestrabile) coerente con il quadro generale di apprendimento dei circuiti quantistici parametrizzati introdotto da Mitarai et al.9 ed è stata istianziata qui utilizzando la specifica sequenza di gate e parametrizzazione definita per il protocollo presente.
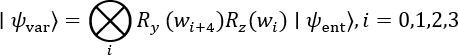 (3)
Per il secondo strato di entanglement, è stata applicata una catena aperta di porte controlled-NOT nel seguente ordine controll-target: (0,1), (1,2) e (2,3). Questa catena non fu chiusa fino al qubit 0.
Il valore atteso dell'operatore di Pauli- solo sul qubit 0,  , è stato calcolato usando un prodotto interno di vettore di stato. L'esecuzione del circuito utilizzava un simulatore di vettore di stato personalizzato implementato utilizzando operazioni standard di array numerico (Supplementary Coding File 1; qhcnn.py). La precisione Complex128 (numpy.complex128) è stata utilizzata ovunque. I valori di attesa venivano calcolati analiticamente dal prodotto scalo del vettore di stato; pertanto, non è stato effettuato alcun campionamento basato su shot. Non era necessario alcun framework di calcolo quantistico di terze parti. Se fosse stato utilizzato un simulatore basato su campionamento o un dispositivo quantistico al posto del simulatore di vettore di stato, sarebbero state effettuate misurazioni ripetute a base computazionale del qubit 0 e le frequenze di bit risultanti sarebbero state convertite in un valore atteso (Equazione 4). L'equazione 4 è la formula standard di valore atteso quantistico ed è stata applicata qui all'osservabile di Pauli a qubit singolo definito per il protocollo attuale. Poiché non è stato effettuato alcun campionamento basato su colpi, non è stata necessaria alcuna mitigazione degli errori di misurazione. Il simulatore utilizzava indicizzazione di qubit big-endian, con il qubit 0 corrispondente al bit più significativo dell'indice del vettore di stato. Questa convenzione è stata esplicitamente considerata nella costruzione dell'osservabile di Pauli- per assicurarsi che il valore atteso corretto fosse misurato.
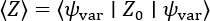 (4)
Il gradiente di rispetto a ciascuno degli otto parametri variazionali veniva calcolato usando la regola dello spostamento dei parametri. Il circuito veniva valutato due volte per ogni parametro durante ogni calcolo del gradiente, una volta a θ + π/2 e una volta a θ - π/2 (Equazione 5). L'equazione 5 è la regola standard dello spostamento dei parametri introdotta da Mitarai et al.9 ed è stata applicata qui senza modifiche.
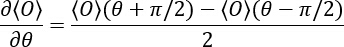 (5)
Il secondo strato di entanglement, come specificato sopra, non applicava mai una porta controlled-NOT con qubit 0 come bersaglio. Poiché una porta controlled-NOT lascia invariato lo stato ridotto del suo qubit di controllo, il secondo strato di entanglement non poteva modificare , indipendentemente dai valori dei parametri allenabili. Per permettere al secondo strato di entanglement di influenzare l'output misurato in un protocollo modificato, il qubit 0 dovrebbe essere incluso come bersaglio, ad esempio chiudendo la catena con una porta controlled-NOT aggiuntiva (3,0), oppure dovrebbe essere misurato un osservabile multiqubit invece di un valore di attesa a qubit singolo. Il secondo strato di entanglement originariamente specificato è stato mantenuto in questo protocollo, e il suo contributo misurato è stato riportato esplicitamente nella sezione Risultati invece che corretto silenziosamente perché questo comportamento del circuito fa parte dei risultati attuali.
Livello classico di post-elaborazione
La fase classica di post-elaborazione consisteva in una rete neurale feed-forward implementata utilizzando le operazioni numeriche standard basate su array elencate nella Tabella dei Materiali. L'uscita del circuito scalare singolo,  , è stata mappata su otto unità nascoste usando uno strato completamente connesso, seguita da un'attivazione di unità lineari rettificate (ReLU). Durante l'addestramento, è stato applicato uno strato di dropout con probabilità di retention di 0,8 (tasso di abbandono = 0,2). Le otto unità nascoste venivano quindi mappate su una singola unità di uscita usando un secondo strato completamente connesso, e veniva applicata una funzione di attivazione sigmoide per generare la probabilità finale di classe, ŷ (Equazione 6). L'Equazione 6 definisce l'architettura classica specifica di post-elaborazione utilizzata nel presente protocollo e comprende operazioni lineari standard, unità lineari rettificate (ReLU) e sigmoide.
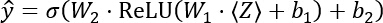 (6)
Le matrici di peso del primo e secondo livello sono state inizializzate tramite campionamento indipendente da una distribuzione normale con media pari a 0 e deviazione standard di 0,5, mentre tutti i termini di bias sono stati inizializzati a 0. La stessa istanza e seed di generatore di numeri casuali usati per l'inizializzazione dei parametri variazionali quantistici venivano utilizzati anche per il livello classico per garantire la riproducibilità run-to-run. In particolare, le matrici classiche di pesi venivano inizializzate usando numpy.random.default_rng(42 + fold_index).normal(0, 0,5, size=...), mentre tutti i termini di bias venivano inizializzati a zero. Un'unica istanza di generatore di numeri casuali seeded, inizializzata con 42 + fold_index, veniva creata all'inizio di ogni fold di validazione incrociata e riutilizzata sequenzialmente per l'inizializzazione dei parametri quantistici, l'inizializzazione classica a peso, il mini-batch shuffling e la generazione di maschere dropout, invece di utilizzare flussi seed indipendenti separati per ogni processo.
Durante l'addestramento, il dropout veniva applicato generando una nuova maschera binaria campionata ad ogni passaggio in avanti utilizzando la convenzione inverted-dropout, in cui le unità sopravvissute venivano scalate di 1/0,8. Durante la validazione e i test, il dropout veniva completamente disabilitato e la rete completa e non scalata veniva utilizzata per l'inferenza.
Il modello combinato QI-HCNN conteneva 33 parametri addestrabili: otto parametri variazionali quantistici dal circuito quantistico e 25 parametri classici. La componente classica comprendeva otto pesi e otto bias nel primo strato completamente connesso, insieme a otto pesi e un bias nel secondo strato completamente connesso. Le dimensioni del tensore di peso e bias erano 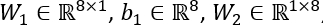 e
 . Il classico livello di post-elaborazione era implementato interamente utilizzando operazioni standard di array numerico senza un framework aggiuntivo di apprendimento automatico. Tutti i calcoli classici venivano eseguiti utilizzando l'aritmetica float64 (doppia precisione).
Addestramento al modello
Il circuito quantistico descritto nella sottosezione Costruzione dei Circuiti Quantistici e il livello classico di post-elaborazione descritto nella sottosezione Livello Classico di Post-Elaborazione furono combinati in un unico modello addestrabile end-to-end. Tutti e 33 i parametri addestrabili furono ottimizzati congiuntamente usando l'ottimizzatore Adam con un tasso di apprendimento iniziale di 0,01 e un decadimento del peso, implementato come penalità L2 di , applicata solo alle matrici di pesi classiche. L'ottimizzatore Adam veniva implementato manualmente utilizzando operazioni standard di array numerico con le seguenti impostazioni: tasso di apprendimento = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸ e decadimento del peso = 1 × 10⁻⁴, applicati solo alle matrici di pesi classiche e non ai termini di bias o ai parametri variazionali quantistici.
L'entropia binaria incrociata veniva utilizzata come funzione di perdita. Per la procedura di bilanciamento delle classi post-split descritta nella sottosezione Protocollo di Valutazione, il contributo alla perdita di ogni campione di addestramento è stato ponderato dalla frequenza inversa della sua classe all'interno della partizione di addestramento della piega corrente. Per il protocollo sbilanciato, sono stati assegnati pesi campionari uniformi. L'entropia binaria incrociata veniva calcolata come la perdita media su tutti i campioni all'interno di ogni mini-batch utilizzando la formulazione standard binaria a entropia incrociata.
Il modello è stato addestrato per 30 epoche utilizzando mini-lotti di 16 campioni. I campioni di addestramento venivano mescolati casualmente all'inizio di ogni epoca utilizzando numpy.random.default_rng(42 + fold_index).permutazione(n) per generare un ordine casuale del campione. Quando il numero di campioni di addestramento non era divisibile uniformemente per 16, il mini-batch finale più piccolo veniva trattenuto e processato alla sua dimensione reale invece di essere scartato.
Durante la formazione veniva applicato un programma di apprendimento a passaggi. Il tasso di apprendimento veniva moltiplicato per 0,7 ogni 10 epoche completate, in particolare all'inizio delle epoche 11 e 21.
I gradienti per gli otto parametri variazionali quantistici sono stati calcolati utilizzando la regola dello spostamento dei parametri descritta nella sottosezione Costruzione dei Circuiti Quantistici . I gradienti per i 25 parametri classici venivano calcolati utilizzando la differenziazione standard in modalità inversa attraverso il livello classico. L'uscita del circuito quantistico, , e i suoi gradienti di spostamento parametrico servivano da interfaccia tra il circuito quantistico e lo strato classico. Tutti e 33 i parametri sono stati aggiornati utilizzando la stessa istanza dell'ottimizzatore Adam.
Non è stata utilizzata la convalida basata sulla fermata precoce. Ogni modello veniva addestrato per il calendario fisso di 30 epoche, e le prestazioni di test tenute in sospeso venivano riportate dopo il completamento dell'ultima epoca. Tutti i parametri del modello (parametri variazionali quantistici, matrici classiche di peso e termini di bias) venivano riinizializzati indipendentemente all'inizio di ogni piega di validazione incrociata, utilizzando il seme casuale specifico del fold (42 + fold_index). I parametri non venivano condivisi tra pieghe o corse di baseline.
L'ambiente computazionale, inclusi processore, memoria, versioni software e il tempo approssimativo di addestramento dell'orologio a parete per piega, era registrato nella Tabella dei Materiali.
Protocollo di valutazione
Le prestazioni del modello sono state valutate utilizzando procedure di validazione incrociata sia a livello di registrazione che a livello di partecipante, insieme a confronti tra modelli di base, analisi di bilanciamento delle classi, esperimenti di ablazione di circuiti, test di significatività statistica e analisi di importanza delle caratteristiche.
Per la valutazione primaria, le 195 registrazioni vocali sono state suddivise in tre pieghe stratificate utilizzando un seme casuale fisso, preservando il rapporto di registrazione a livello di morbo di Parkinson/controllo sano del 75,4%/24,6% all'interno di ciascuna piega. Il modello descritto nelle sezioni precedenti veniva addestrato usando due pieghe e verificato sulla piega rimanente tenuta in testa, e questa procedura veniva ripetuta fino a quando ogni piega non aveva servito una volta come partizione di test. Accuratezza, precisione, richiamo, punteggio F1 e area sotto la curva caratteristica operativa del ricevitore (AUC–ROC) sono stati calcolati per ogni piega e riportati come la deviazione media ± standard tra le tre pieghe. La validazione stratifica stratificata primaria a tre livelli è stata implementata utilizzando la classe StratifiedKFold con n_splits=3, shuffle=True e random_state=42.
Le previsioni di classe binaria venivano generate applicando una soglia di probabilità fissa di 0,50 alla probabilità di classe prevista, ŷ, prodotta dal classico strato di post-elaborazione. Accuratezza, precisione, richiamo e punteggio F1 sono stati calcolati a partire da queste previsioni a soglia, mentre AUC–ROC è stato calcolato direttamente dai valori di probabilità continua senza soglia di sogliazione. Precisione, richiamo e punteggio F1 venivano calcolati utilizzando le funzioni metriche con zero_division=0, assegnando un valore 0,0 a qualsiasi metrica indefinita. Non si sono verificate tali condizioni indefinite durante gli esperimenti riportati.
I modelli di base sono stati valutati utilizzando le identiche partizioni di piegatura e la rappresentazione identica delle caratteristiche preprocessate a quattro componenti generata dalla pipeline di preprocessing. Un perceptrone classico multilayer contenente uno strato nascosto di otto unità attivate da ReLU, architettonicamente adattato alla componente classica del modello ibrido ma senza il circuito quantistico, è stato addestrato usando l'ottimizzatore Adam con una penalità L2 di 1 × 10⁻⁴. Un classificatore ad albero con gradiente è stato anche addestrato utilizzando la stessa rappresentazione a quattro componenti con 200 alberi, una profondità massima di 3, un tasso di apprendimento di 0,1 e una pesatura di classe pari all'inversa frequenza di classe all'interno di ogni fold di addestramento. Inoltre, un secondo classificatore ad albero potenziato con gradiente è stato addestrato utilizzando la rappresentazione completa a 22 caratteristiche generata dopo la normalizzazione iniziale Min–Max, senza applicare PCA o codifica quantistica delle caratteristiche. Questo modello utilizzava 300 alberi, una profondità massima di 4, un tasso di apprendimento di 0,05 e la stessa strategia inversa di pesatura delle classi di training fold. La classica linea di base del perceptrone multilayer è stata implementata usando MLPClassifier con hidden_layer_sizes=(8,), activation="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, shuffle=True e random_state=42. È stata utilizzata l'inizializzazione uniforme predefinita del peso Glorot (Xavier) fornita dall'implementazione. Le basi dell'albero potenziate dal gradiente sono state implementate usando XGBoost 3.3.0 con obiettivo = "binario:logistico", eval_metric = "logloss", tree_method = "auto", sottocampione = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 e random_state = 42.
Per valutare l'effetto dell'equilibrio post-divisione delle classi, la procedura primaria di validazione incrociata è stata ripetuta per il modello QI-HCNN con la pesatura del campione abilitata. I pesi di bilanciamento venivano calcolati esclusivamente dalla partizione di addestramento di ciascuna piega dopo la suddivisione train/test e non venivano calcolati dalla corrispondente partizione di test tenuta.
Gli esperimenti di ablazione dei componenti del circuito sono stati eseguiti ripetendo quattro volte l'intero flusso di preelaborazione, addestramento e valutazione modificando solo i due strati di entanglement del circuito quantistico. Le quattro varianti di circuito comprendevano: (i) il circuito completo contenente entrambi gli strati di entanglement; (ii) il circuito con il primo strato di entanglement rimosso e il secondo trattenuto; (iii) il circuito con il primo strato di entanglement mantenuto e il secondo rimosso; e (iv) il circuito con entrambi gli strati di entanglement rimossi. Partizioni di pieghe identiche, semi casuali e configurazioni di addestramento sono state mantenute in tutti e quattro gli esperimenti, in modo che eventuali differenze di prestazioni osservate potessero essere attribuite esclusivamente alla configurazione dello strato di entanglement.
Come valutazione della robustezza, la validazione incrociata dei partecipanti è stata effettuata suddividendo i 31 partecipanti, anziché le 195 registrazioni, in cinque gruppi con sei o sette partecipanti ciascuno. Durante ogni iterazione, il modello veniva addestrato utilizzando registrazioni dei partecipanti di quattro gruppi e valutato utilizzando registrazioni dei partecipanti del gruppo rimanente, assicurandosi che nessun partecipante contribuisse con registrazioni sia alle partizioni di addestramento che di test dello stesso fold. Accuratezza, precisione, richiamo, punteggio F1 e AUC–ROC sono stati riportati come media ± deviazione standard tra le cinque pieghe raggruppate dai partecipanti per il modello QI-HCNN, il classico percettrone multistrato e la base a quattro caratteristiche aumentata dal gradiente. La validazione incrociata raggruppata per partecipanti veniva implementata utilizzando la classe GroupKFold con n_splits=5, dove gli identificatori dei partecipanti fungevano da variabile di raggrupamento. Poiché GroupKFold non mescola i gruppi, i partecipanti sono stati assegnati secondo l'ordine deterministico predefinito dell'implementazione, risultando in fold contenenti sei o sette partecipanti ciascuno.
La significatività statistica è stata valutata applicando test Wilcoxon a rango con segno accoppiato ai valori AUC–ROC per fold ottenuti per i modelli di valutazione primaria e di baseline. Sono stati riportati valori p esatti e il corrispondente numero di osservazioni accoppiate perché la potenza statistica di questo test è limitata quando sono disponibili solo un piccolo numero di pieghe. Quattro confronti AUC–ROC a coppie sono stati definiti a priori: (1) QI-HCNN contro il perceptrone multistrato classico; (2) QI-HCNN rispetto alla base dell'albero potenziato gradiente abbinato alla PCA; (3) il classico perceptrone multistrato contro la base dell'albero potenziato gradiente abbinato alla PCA; e (4) il modello QI-HCNN sbilanciato rispetto al modello QI-HCNN post-split-bilanciato. Non è stata applicata alcuna correzione a confronto multiplo perché le analisi erano esplorative e il numero limitato di pieghe ha ridotto sostanzialmente il potere statistico.
L'analisi di importanza delle caratteristiche è stata effettuata utilizzando il classificatore ad albero potenziato con gradiente addestrato sulla rappresentazione completa a 22 caratteristiche. Sono stati estratti punteggi basati sul guadagno per l'importanza delle caratteristiche e classificati per tutte le caratteristiche acustiche originali. Separatamente, la PCA è stata adattata all'intero dataset solo a scopo di reportistica e non è stata utilizzata durante la valutazione del modello. Per ogni caratteristica acustica originale, i carichi assoluti tra i quattro componenti principali mantenuti venivano sommati e le caratteristiche venivano classificate in base a questi valori. Sono stati riportati entrambi i metodi di classificazione e la loro sovrapposizione. Per l'analisi di importanza delle caratteristiche basata sul guadagno, l'implementazione dell'albero con gradiente aumentato ha prodotto valori unici di guadagno in virgola mobile e non si sono verificati pareggi. Per le classifiche di carico per componenti principali, i pareggi nei valori di carico assoluti sommati sono stati risolti secondo l'ordine originale delle colonne di caratteristiche nel dataset.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Tutti i valori numerici riportati nel testo sono riconciliati e identici a quelli presentati nelle Figure 2–8 e nelle Tabelle 2–4. Ogni figura è stata generata direttamente dal codice fornito nel Supplementary Coding File 1 invece che preparata manualmente, garantendo coerenza tra i valori numerici riportati e i dati tracciati.
Prestazioni di validazione incrociata primaria
Secondo il proto...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo protocollo specifica un'architettura QI-HCNN completamente riproducibile per la classificazione della malattia di Parkinson a partire da registrazioni vocali, in cui ogni gate, scelta di inizializzazione dei parametri, passaggio di preelaborazione e procedura di valutazione viene descritto a un livello sufficiente per un'implementazione indipendente. Il circuito proposto viene valutato utilizzando caratteristiche di ingresso identiche e partizioni di piega a validazione incrociata...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Conflitto di Interessi:
Gli autori dichiarano di non avere interessi finanziari o non finanziari concorrenti legati a quest'opera.
Ringraziamenti
Questo lavoro non è stato finanziato da alcuna agenzia o organizzazione, né tecnicamente né finanziariamente. Gli autori ringraziano i manutentori del Repository di Machine Learning UCI per aver fornito accesso pubblico al dataset di registrazione vocale utilizzato in questo studio.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Adam optimizer | Implementazione standard di ottimizzazione numerica | Implementazione personalizzata; NumPy 2.4.4 | Ottimizzazione congiunta di parametri quantistici e classici; Addestramento del modello |
| Implementazione della perdita di cross-entropy binaria | Implementazione personalizzata con NumPy | NumPy 2.4.4; perdita media (riduzione media) in ciascun mini-batch | Funzione di perdita di addestramento; Addestramento del modello |
| Classificatore ad alberi gradient-boosted | Libreria open-source XGBoost per il gradient-boosting | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | Blocchi di base classici matchati con PCA e a piene funzionalità; Protocollo di valutazione |
| Libreria di apprendimento automatico | Libreria open-source scikit-learn per l'apprendimento automatico | scikit-learn 1.8.0 | Scalatura Min–Max, analisi dei componenti principali, validazione incrociata stratificata, validazione incrociata raggruppata per partecipanti, baseline del percettrone multistrato e metriche di valutazione |
| Libreria di calcolo numerico | Libreria open-source di calcolo numerico NumPy | NumPy 2.4.4 | Operazioni su array di base, simulazione dello statevector, inizializzazione dei parametri e calcolo manuale dei gradienti |
| Dataset di classificazione della Malattia di Parkinson | Little, McSharry, Roberts, Costello e Moroz; distribuito attraverso il repository di apprendimento automatico UCI | ID Dataset UCI 174; 195 registrazioni di 31 partecipanti; consultato il 19 giugno 2025 | Dataset di registrazione vocale di vocali sostenute; https://archive.ics.uci.edu/dataset/174 |
| Libreria di calcolo scientifico | Libreria open-source di calcolo scientifico SciPy | SciPy 1.17.1 | Test di significatività statistica Wilcoxon a segni con valori in coppia; Protocollo di valutazione |
| Simulatore di statevector | Simulatore di statevector personalizzato (File di codifica supplementare 1; qhcnn.py) | Implementazione NumPy pura; precisione complex128 (double); nessun backend esterno richiesto | Esecuzione del circuito quantistico a quattro qubit; Costruzione del circuito quantistico |
| Libreria per dati tabulari | Libreria open-source di analisi dati Pandas | Pandas 3.0.2 | Caricamento del dataset, ispezione e manipolazione tabulare |
| Ambiente computazionale della workstation | Workstation CPU locale (contenitore Linux ospitato su cloud) | CPU x86_64; Ubuntu Linux; Python 3; nessun hardware GPU o quantistico utilizzato; tempo di addestramento approssimativo di 30–60 secondi per ogni piega | Ambiente computazionale utilizzato per tutto l'addestramento e la valutazione; Simulazione dello statevector basata su CPU; nessun hardware GPU o quantistico richiesto |
Riferimenti
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.