Questo studio indaga la relazione tra lupus eritematoso sistemico e perdite di gravidanza ricorrenti e identifica IFI27 come biomarcatore candidato per future ricerche.
Articolo di ricerca
La randomizzazione mendeliana e la bioinformatica identificano IFI27 come potenziale biomarcatore per la perdita ricorrente della gravidanza nel lupus eritematoso sistemico
* These authors contributed equally
In questo articolo
Sommario
Abstract
Il lupus eritematoso sistemico (SLE) è associato a esiti avversi della gravidanza, ma la sua relazione causale con l'abortività ricorrente (RPL) e le loro caratteristiche molecolari condivise rimangono poco chiare. Questo studio ha integrato analisi bidirezionali di randomizzazione mendeliana (MR) a due campioni e analisi bioinformatiche trascrittomiche per indagare tale relazione e identificare potenziali biomarcatori condivisi. FinnGen e UK Biobank sono stati selezionati perché forniscono statistiche riassuntive di studi d'associazione sull'intero genoma (GWAS) di grandi dimensioni, non sovrapposte e di popolazione di origine europea. I geni differenzialmente espressi (DEG) sono stati identificati da GSE61635 (sangue; |log₂ fold change| > 1) e GSE165004 (endometrio; |log₂ fold change| > 0,5) utilizzando un valore di P aggiustato < 0,05, seguiti da arricchimento funzionale, analisi delle interazioni proteina-proteina (PPI), screening di geni hub, regressione con operatore di riduzione e selezione per minimo valore assoluto (LASSO), validazione esterna mediante GSE50772 e GSE198700, analisi della curva operativa del ricevitore (ROC) e analisi di arricchimento dei set genici mediante singolo campione (ssGSEA). L'SLE predetto geneticamente era associato a un aumento statisticamente significativo ma quantitativamente modesto di aborti spontanei (odds ratio [OR] pesato per la varianza inversa [IVW] = 1,01, intervallo di confidenza al 95% [CI] = 1,00–1,02; P < 0,001). La forza degli strumenti era adeguata e le analisi di sensibilità non hanno rilevato eterogeneità rilevante, pleiotropia direzionale o singole varianti influenti. Cinquantanove DEG condivisi erano arricchiti in risposte immunitarie antivirali, adesione cellulare e processi legati all'apoptosi. IFI27 risultava costantemente sovraespresso nel sangue degli individui con SLE, ma sottoespresso nell'endometrio e nei villi coriali dei casi di RPL, mentre CXCL11 non ha mostrato una validazione esterna coerente. Analisi ROC retrospettive hanno prodotto aree sotto la curva (AUC) pari a 0,822 per l'SLE e 0,872 per la RPL. I punteggi ssGSEA inferiti computazionalmente hanno mostrato correlazioni tra l'espressione di IFI27 e diverse firme di cellule immunitarie, inclusi i linfociti T helper 2 (Th2). Questi risultati identificano IFI27 come un potenziale biomarcatore condiviso da SLE e RPL; tuttavia, studi clinici e sperimentali prospettici sono necessari per validarne il significato biologico e clinico.
Introduzione
Il lupus eritematoso sistemico (LES) è una malattia autoimmune complessa caratterizzata da coinvolgimento multisistemico e disregolazione cronica del sistema immunitario1. Le alterazioni patologiche nel LES sono attribuite principalmente a risposte immunitarie adattative compromesse e al deposito di complessi antigene-anticorpo, che portano a lesioni tissutali autoimmuni e danni d'organo2,3. L'incidenza globale del LES è di circa 5,14 (1,4–15,13) casi per 100.000 anni-persona, con un'incidenza stimata di 8,82 (2,4–25,99) casi per 100.000 anni-persona tra le donne4. Il LES colpisce individui di tutte le età, ma si verifica prevalentemente in donne in età riproduttiva5,6. Le pazienti in gravidanza con LES presentano un rischio aumentato di esiti avversi della gravidanza, tra cui aborto ricorrente, morte intrauterina, parto pretermine e restrizione della crescita intrauterina7,8. La perdita ripetuta di gravidanza (RPL) è definita come due o più aborti spontanei prima delle 20–24 settimane di gestazione9. La sua prevalenza riportata è di circa il 2,6%10, rendendola una complicanza riproduttiva clinicamente significativa. Circa il 20% delle pazienti in gravidanza con LES sperimenta aborto spontaneo11, e il LES è riconosciuto come un importante fattore di rischio per la RPL12. I meccanismi proposti includono alterazioni ormonali e disregolazione immunitaria. Biomarcatori come gli anticorpi anticardiolipina e l'anticoagulante del lupus sono stati studiati come potenziali predittori di esiti avversi della gravidanza nelle pazienti con LES11. Questi autoanticorpi possono legare le cellule trofoblastiche placentari, alterare il segnale, la proliferazione e l'invasione trofoblastica, modulare la secrezione di ormoni e citochine e aumentare l'apoptosi, contribuendo così a esiti di gravidanza compromessi13. Inoltre, la beta-2 glicoproteina I (β2-GPI), un antigene principale nel sindrome da anticorpi antifosfolipidi, è espressa nel tessuto placentare. Il legame degli anticorpi anti-β2-GPI alla β2-GPI inibisce la crescita e la differenziazione del trofoblasto, causando difetti placentari. Questa interazione promuove anche un ambiente pro-infiammatorio caratterizzato dalla produzione di citochine distruttive e dall'attivazione del complemento, contribuendo alla trombosi placentare e all'aborto ricorrente14,15. Tuttavia, studi precedenti hanno spesso omesso analisi complete dei tessuti riproduttivi locali, come la decidua, limitando la possibilità di correlare biomarcatori sistemici con alterazioni patologiche locali. Inoltre, la gestione della gravidanza complicata da LES e la prevenzione di esiti avversi della gravidanza rimangono problematiche. La predisposizione genetica contribuisce allo sviluppo del LES, e la variabilità genetica è stata implicata anche nella patogenesi della RPL16,17. Tuttavia, se esista una relazione causale tra LES e RPL, nonché i meccanismi molecolari e i geni condivisi alla base della loro coesistenza, rimane poco chiaro.
La randomizzazione mendeliana (MR) è un approccio consolidato per l'inferenza causale che utilizza varianti genetiche come variabili strumentali per stimare gli effetti causali di fattori di esposizione su esiti di malattia18. Sfruttando la relazione tra genotipo e fenotipo, la MR riduce i bias dovuti a fattori di confondimento e causalità inversa rispetto agli studi osservazionali convenzionali. Parallelamente, i progressi nelle piattaforme genomiche a microarray e nel sequenziamento ad alto rendimento hanno reso possibile l'analisi bioinformatica per identificare biomarcatori diagnostici candidati e bersagli terapeutici mediante profilazione trascrittomica. L'integrazione di questi approcci complementari potrebbe fornire una comprensione più completa della relazione tra lupus eritematoso sistemico (SLE) e abortività ricorrente (RPL), combinando evidenze genetiche causali con modelli di espressione genica associati alla malattia. Pertanto, questo studio si è proposto di indagare la potenziale relazione causale tra SLE e RPL, identificare biomarcatori e percorsi biologici condivisi e selezionare bersagli da validare in futuro. Per raggiungere questi obiettivi, il flusso analitico è stato predeterminato come segue: MR bidirezionale per valutare la direzione causale; analisi indipendenti di espressione genica differenziale seguite da integrazione trascrittomica; analisi della rete di interazione proteina-proteina (PPI) e regressione con operatore di riduzione e selezione per minimizzazione del valore assoluto (LASSO) per la selezione dei biomarcatori; validazione esterna dell'espressione e analisi della curva ROC (receiver operating characteristic); e analisi di arricchimento dei set genici su singolo campione (ssGSEA) per valutare le associazioni con i profili delle cellule immunitarie. Questo flusso di lavoro progressivo è riassunto in Figura 1.
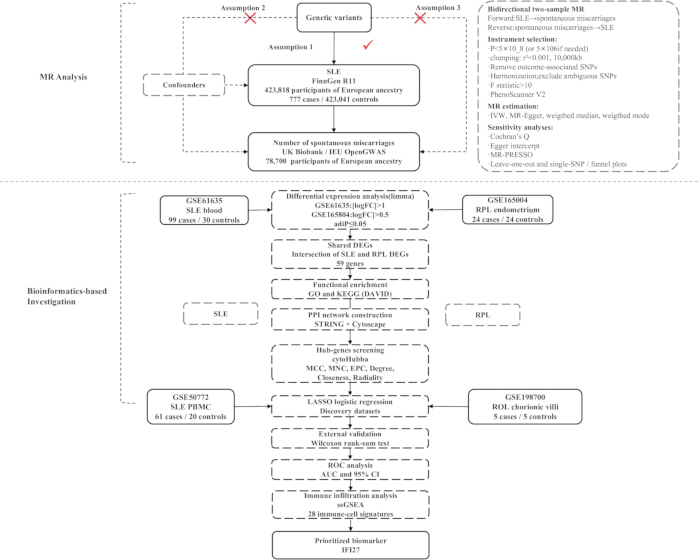
Figura 1. Progettazione dello studio e flusso analitico.
Il pannello superiore illustra l'analisi di randomizzazione mendeliana (MR) bidirezionale su due campioni volta a valutare l'associazione tra lupus eritematoso sistemico (SLE) e il numero di aborti spontanei, utilizzando statistiche riassuntive di studi di associazione sull'intero genoma (GWAS). Vengono riassunti la selezione degli strumenti, la riduzione per disequilibrio di linkage, le analisi di randomizzazione mendeliana (MR) e le analisi di sensibilità. Il pannello inferiore descrive il flusso di lavoro bioinformatico, comprendente l'analisi dell'espressione differenziale, l'identificazione di geni differenzialmente espressi (DEG) condivisi, l'analisi di arricchimento funzionale, la costruzione della rete di interazione proteina-proteina (PPI), la selezione dei geni hub, la regressione con operatore di riduzione e selezione per minimo valore assoluto (LASSO), la validazione esterna, l'analisi delle caratteristiche operative del ricevitore (ROC), l'analisi di arricchimento dei set genici a singolo campione (ssGSEA) e la priorizzazione del biomarcatore candidato IFI27. IVW, pesato per la varianza inversa; KEGG, Enciclopedia di Kyoto sui Geni e sui Genomi; GO, Ontologia Genica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Protocollo
L'approvazione etica non è stata richiesta per il presente studio perché ha coinvolto soltanto analisi secondarie di statistiche riassuntive di studi di associazione sull'intero genoma (GWAS) e set di dati trascrittomici pubblicamente disponibili e anonimizzati. Non sono stati reclutati nuovi partecipanti, non sono stati raccolti campioni biologici e non è stato consultato alcun dato identificabile a livello individuale. Gli studi originali di FinnGen, UK Biobank e Gene Expression Omnibus hanno dichiarato che l'approvazione etica e il consenso informato erano stati ottenuti in conformità con i rispettivi requisiti istituzionali, nazionali e specifici delle banche dati. Tutti i set di dati utilizzati nel presente studio sono stati consultati e analizzati in conformità con le politiche di utilizzo delle banche dati applicabili, le condizioni di accesso ai dati e le linee guida etiche. Gli autori non hanno tentato di reidentificare alcun partecipante. Pertanto, non è stato necessario ottenere un consenso informato scritto aggiuntivo per questa analisi secondaria. Il contenuto di questo studio comprende due parti: analisi MR e analisi bioinformatica (Figura 1). Questo studio è stato interamente computazionale e ha utilizzato set di dati riassuntivi GWAS e trascrittomici pubblicamente disponibili. Non sono stati utilizzati reagenti né materiali di consumo per laboratorio sperimentale.
Analisi MR
Fonti dei dati, acquisizione e pre-elaborazione delle statistiche riassuntive di GWAS:
Le statistiche riassuntive di GWAS per il lupus eritematoso sono state ottenute da FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), una coorte finlandese basata sulla popolazione. Il fenotipo è stato definito utilizzando il codice ICD-10 L93 ed includeva 423.818 partecipanti, composti da 777 casi e 423.041 controlli. Il file delle statistiche riassuntive di FinnGen è stato scaricato dal portale pubblico dei dati di FinnGen in formato tabulato compresso ed importato in R utilizzando la funzione read_exposure_data() o read_outcome_data() in TwoSampleMR, a seconda che il set di dati fosse utilizzato come esposizione o esito. Sono stati mantenuti rsID, cromosoma, posizione genomica, allele d'effetto, altro allele, frequenza dell'allele d'effetto, coefficiente beta, errore standard e valore P dell'associazione.
Le statistiche riassuntive relative al numero di aborti spontanei sono state ottenute dalla UK Biobank tramite la risorsa IEU OpenGWAS (ukb-b-419; RRID:SCR_012815), comprendente 78.700 partecipanti. Nell'analisi diretta, le associazioni tra i polimorfismi a singolo nucleotide (SNP) selezionati da FinnGen e l'esito sono state recuperate utilizzando extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). Nell'analisi inversa, gli SNP associati al lupus eritematoso sono stati recuperati mediante extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), dopodiché le corrispondenti associazioni SNP sono state estratte dal file delle statistiche riassuntive della UK Biobank. Le caratteristiche dei set di dati GWAS utilizzati nelle analisi MR bidirezionali sono riassunte nella Tabella 1.
| Carattere | Dimensione del campione | Ascendenza | Consorzio | Anno | Identificatore del dataset GWAS |
| Lupus eritematoso | 4,23,818 | Europea | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Numero di aborti spontanei | 78.700 | Europea | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabella 1: Statistiche riassuntive degli studi di associazione sull'intero genoma (GWAS) utilizzate per l'analisi di randomizzazione mendeliana bidirezionale.
La tabella riassume i set di dati pubblicamente disponibili degli studi di associazione sull'intero genoma utilizzati come fonti di esposizione e di outcome per le analisi di randomizzazione mendeliana diretta e inversa, inclusi la dimensione del campione, l'origine ancestrale, la fonte dei dati, l'anno di rilascio dei dati e l'identificatore del dataset.
FinnGen e UK Biobank sono stati selezionati perché forniscono dataset ampi e accessibili al pubblico, prevalentemente di origine europea, derivati da popolazioni di origine non sovrapposte e con copertura sufficiente di varianti per l'analisi MR a due campioni. Non è stato riportato alcun sovrapposizione tra i campioni relativi all'esposizione e all'esito. Poiché sono stati utilizzati esclusivamente dati riassuntivi, non è stato effettuato l'accesso a dati genotipici a livello individuale, non è stata eseguita alcuna ulteriore normalizzazione a livello dei partecipanti e nessun partecipante è stato escluso dagli attuali ricercatori. Ci siamo basati sulle procedure di controllo qualità a livello campione e a livello variante implementate dai consorzi GWAS originali. Durante l'analisi attuale, è stato effettuato un ulteriore controllo qualità a livello di variante mediante filtraggio per significatività, raggruppamento per disequilibrio di associazione (linkage disequilibrium clumping), armonizzazione degli alleli, valutazione della forza dello strumento e screening della pleiotropia, come descritto di seguito.
FinnGen Release 11 riporta le posizioni genomiche in base a GRCh38/hg38, mentre i set di dati armonizzati di IEU OpenGWAS e la risorsa di riferimento per il disequilibrio di associazione utilizzano annotazioni di varianti compatibili con GRCh37. Pertanto, le varianti di esposizione e di esito sono state abbinate principalmente tramite rsID stabili piuttosto che attraverso coordinate cromosoma-posizione. Non è stato effettuato alcun abbinamento posizionale diretto tra diversi build. Le varianti prive di un rsID inequivocabile o con informazioni sugli alleli incoerenti tra i set di dati sono state escluse prima dell'analisi MR. Le statistiche riassuntive di FinnGen Release 11 utilizzano GRCh38, mentre i dati di OpenGWAS sono armonizzati alla convenzione della sequenza di riferimento usata per il Build 37. L'abbinamento tramite rsID è quindi fondamentale quando si combinano queste due risorse.
Progettazione dello studio di MR:
Abbiamo seguito rigorosamente le linee guida STROBE-MR (File Supplementare 1)19. È stato utilizzato un disegno MR bidirezionale a due campioni per valutare la relazione tra lupus eritematoso predetto geneticamente e il numero di aborti spontanei. Nell'analisi diretta, il lupus eritematoso è stato considerato come esposizione e il numero di aborti spontanei come esito. Nell'analisi inversa, esposizione ed esito sono stati scambiati, e l'intero processo di selezione degli strumenti, raggruppamento per disaccoppiamento del linkage disequilibrium, armonizzazione dei dati, stima causale e analisi di sensibilità è stato ripetuto. Sono stati utilizzati polimorfismi a singolo nucleotide (SNP) come variabili strumentali (IV). L'intero flusso di lavoro è stato eseguito nell'ordine seguente: acquisizione e formattazione delle statistiche riassuntive di GWAS; selezione di SNP associati all'esposizione; rimozione di varianti duplicate o non completamente annotate; raggruppamento per linkage disequilibrium; estrazione delle associazioni corrispondenti all'esito; esclusione di SNP direttamente associati all'esito; armonizzazione degli alleli di esposizione e di esito; calcolo della forza dello strumento; screening per fenotipi di confondimento potenziali; stima degli effetti causali; valutazione dell'eterogeneità e della pleiotropia orizzontale; rilevamento di outlier con il metodo Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO); e analisi di sensibilità leave-one-out e basate su singoli SNP. Tutte le analisi MR sono state eseguite utilizzando R versione 4.4.2 (RRID:SCR_001905), TwoSampleMR versione 0.6.6 (RRID:SCR_019010), MRPRESSO versione 1.0 (RRID:SCR_023697) e forestploter versione 1.1.2. L'analisi MR si basa su tre assunzioni fondamentali. Primo, secondo l'assunzione di rilevanza, gli SNP selezionati devono essere fortemente associati all'esposizione. Secondo, secondo l'assunzione di indipendenza, gli SNP selezionati non devono essere influenzati da fattori che confondono l'associazione tra esposizione ed esito. Terzo, secondo l'assunzione di esclusione, gli SNP selezionati devono influenzare l'esito esclusivamente attraverso l'esposizione20 (Figura 1).
Metodi di selezione degli SNP:
La selezione degli strumenti è stata eseguita nel seguente ordine: (1) selezionare gli SNP associati all'esposizione con P < 5 × 10⁻⁸; quando il numero di strumenti non era sufficiente, utilizzare P < 5 × 10⁻⁶; (2) utilizzare la funzione clump_data() per eseguire il raggruppamento per disaccoppiamento dell'equilibrio genico (linkage disequilibrium clumping) con R2 < 0,001 e una distanza genetica di 10.000 kb, allentando i criteri a R2 < 0,01 entro 5.000 kb solo se necessario per mantenere un insieme di strumenti analizzabili; (3) escludere gli SNP significativamente associati all'esito utilizzando una soglia di P = 5 × 10⁻⁵; (4) utilizzare la funzione harmonise_data() per armonizzare gli alleli dell'esposizione e dell'esito ed escludere varianti palindromiche o altrimenti ambigue; (5) calcolare la potenza dello strumento come F = β2/SE2 ed escludere gli SNP con F < 10; e (6) esaminare gli SNP rimanenti in PhenoScanner V2 per identificare fenotipi che potrebbero confondere la relazione tra lupus eritematoso sistemico (SLE) e perdita gestazionale21. Gli anticorpi antifosfolipidi (aPL) potrebbero rappresentare un fattore di rischio condiviso tra SLE e il numero di aborti spontanei. Ciascun SNP è stato ricercato singolarmente in PhenoScanner V2. Tutti gli SNP candidati sono stati interrogati in PhenoScanner V2 utilizzando il catalogo GWAS predefinito per recuperare tutte le associazioni riportate negli studi di associazione a livello genoma (GWAS). La soglia di significatività è stata impostata a P < 1 × 10⁻5 ed è stato utilizzato il riferimento predefinito del genoma (GRCh37). Poiché la popolazione dello studio era di origine europea, è stata abilitata la ricerca di varianti proxy utilizzando il pannello di riferimento europeo (proxies = "EUR"), con una soglia di disaccoppiamento dell'equilibrio genico (LD) di R2 > 0,8 entro una finestra di 1.000 kb. Tutti gli altri parametri di ricerca sono stati mantenuti ai valori predefiniti. Gli SNP che mostravano associazioni significative con il fattore di confondimento predeterminato, gli anticorpi antifosfolipidi (aPL), sono stati considerati potenzialmente pleiotropici ed esclusi dall'insieme finale di variabili strumentali per minimizzare la violazione dell'assunzione di esclusione nella randomizzazione mendeliana. Gli SNP strumentali mantenuti per le analisi MR diretta e inversa sono elencati rispettivamente nelle Tabelle Supplementari 1 e 2.
Analisi statistica:
Dopo la selezione degli strumenti e l'armonizzazione degli alleli, le stime causali sono state calcolate utilizzando la funzione mr() in TwoSampleMR. Il flusso di lavoro analitico è stato eseguito secondo l'ordine seguente. Innanzitutto, l'effetto causale complessivo è stato stimato mediante quattro metodi MR: pesatura per la varianza inversa (IVW), regressione MR-Egger, mediana pesata e moda pesata. Le stime dell'effetto per il numero di aborti spontanei e il lupus eritematoso sistemico (SLE) sono state riportate come odds ratio con i corrispondenti intervalli di confidenza al 95% e valori P. Il metodo IVW è stato designato come analisi principale poiché fornisce un’elevata potenza statistica quando tutti i SNP inclusi sono validi strumenti instrumental variables e non è presente pleiotropia orizzontale. Tuttavia, la stima IVW può risultare distorta in presenza di pleiotropia orizzontale22. La regressione MR-Egger è stata utilizzata principalmente per valutare le inferenze causali in presenza di pleiotropia orizzontale potenziale23. L'approccio della mediana pesata richiede che almeno il 50% del peso analitico derivi da strumenti validi (IVs). Questo metodo è ottimale quando è presente eterogeneità ma non pleiotropia orizzontale24. La moda pesata identifica gruppi di strumenti con effetti causali simili e stima l'effetto dal gruppo più numeroso25. Le stime dell'effetto ottenute con i quattro metodi MR sono presentate in Figura 2. In secondo luogo, l'eterogeneità tra le stime causali specifiche per SNP è stata valutata mediante il test Q di Cochran, implementato attraverso la funzione mr_heterogeneity(). La statistica Q rappresenta la somma pesata dei quadrati delle deviazioni delle stime individuali per SNP dalla stima causale complessiva. Un valore P del test Q < 0,05 è stato considerato indicativo di eterogeneità, nel qual caso è stato applicato un modello IVW a effetti random. In assenza di eterogeneità significativa, è stato utilizzato un modello IVW a effetti fissi26. In terzo luogo, la pleiotropia orizzontale direzionale è stata valutata mediante il test dell'intercetta MR-Egger, implementato con la funzione mr_pleiotropy_test(). Un'intercetta significativamente diversa da zero con P < 0,05 è stata considerata evidenza di pleiotropia orizzontale direzionale. In quarto luogo, la procedura MR-PRESSO è stata eseguita utilizzando la funzione mr_presso() nel pacchetto MRPRESSO (RRID:SCR_023697) per rilevare SNP con effetti pleiotropici anomali27. Quando sono stati rilevati valori anomali, questi sono stati rimossi e l'analisi causale è stata ripetuta utilizzando i restanti strumenti. Il test globale MR-PRESSO è stato impiegato per valutare la pleiotropia orizzontale complessiva, mentre il test di distorsione è stato considerato per stabilire se la rimozione degli outlier abbia modificato in modo significativo la stima causale. In quinto luogo, è stata effettuata un'analisi di sensibilità leave-one-out utilizzando la funzione mr_leaveoneout(). In questa analisi, ogni SNP è stato escluso in modo sequenziale e la stima causale aggregata è stata ricalcolata utilizzando i SNP rimanenti. I risultati sono stati visualizzati mediante mr_leaveoneout_plot() per determinare se l'associazione complessiva fosse eccessivamente influenzata da un singolo strumento. In sesto luogo, sono state generate stime specifiche per singolo SNP utilizzando la funzione mr_singlesnp(). Queste stime sono state utilizzate per costruire grafici a imbuto (funnel plot) con mr_funnel_plot() al fine di valutare visivamente eventuali asimmetrie attribuibili alla pleiotropia orizzontale direzionale. Sono stati generati grafici a foreste riassuntivi mediante forestploter (versione 1.1.2) per mostrare le stime dell'effetto e gli intervalli di confidenza ottenuti dai diversi metodi MR. Il grafico a dispersione della MR diretta, il grafico a foreste specifico per SNP, l'analisi leave-one-out e il grafico a imbuto sono presentati rispettivamente nelle Figure Supplettive 1–4.
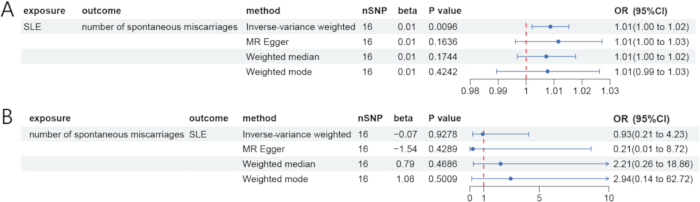
Figura 2. Risultati dell'analisi di randomizzazione mendeliana bidirezionale.
(A) Grafico a foreste dell'analisi di randomizzazione mendeliana (MR) diretta con il lupus eritematoso sistemico (SLE) come esposizione e il numero di aborti spontanei come risultato. (B) Grafico a foreste dell'analisi MR inversa con il numero di aborti spontanei come esposizione e il SLE come risultato. Le stime dell'effetto sono presentate come rapporti di probabilità (OR) con intervalli di confidenza al 95% (IC) per i metodi weighted inverse variance, MR-Egger, mediana pesata e moda pesata. SNP, polimorfismo a singolo nucleotide. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Si è ritenuto che un'associazione causale fosse supportata quando la stima IVW risultava statisticamente significativa con P < 0,05, le stime ottenute con MR-Egger, mediana pesata e moda pesata mostravano una direzione coerente con quella della stima IVW e i risultati non venivano sostanzialmente modificati dalla eterogeneità, dalla pleiotropia, dalle analisi di sensibilità MR-PRESSO o dalle analisi di tipo leave-one-out. Tutti i test statistici erano a due code.
Analisi bioinformatica
Dati di microarray:
I set di dati trascrittomici sono stati ottenuti dal database Gene Expression Omnibus (GEO; RRID:SCR_005012)28. Sono stati scaricati i file Series Matrix elaborati, i metadati dei campioni e i file di annotazione della piattaforma per GSE61635, GSE165004, GSE50772 e GSE198700. La piattaforma, la fonte del tessuto, la dimensione del campione e la categoria di analisi di ciascun set di dati sono riassunti in Tabella 2. Poiché i set di dati sono stati generati da tessuti diversi e da piattaforme di microarray differenti, ciascun set di dati è stato preelaborato e analizzato in modo indipendente. Le matrici di espressione provenienti da set di dati diversi non sono state unite direttamente e non è stata applicata alcuna correzione batch tra piattaforme. L'integrazione tra set di dati è stata effettuata esclusivamente a livello di simbolo genico, solo dopo che l'analisi dell'espressione differenziale era stata completata in modo indipendente all'interno di ciascun set di dati di scoperta.
| Set di dati GEO | Malattia | Piattaforma | Tessuto (Homo sapiens) | Casi | Controlli | Tipo di esperimento | Contributore | Categoria del set di dati |
| GSE61635 | Lupus eritematoso sistemico (SLE) | GPL570 | Sangue intero | 99 | 30 | Microarray di espressione | Greidinger EL | Set di dati di scoperta |
| GSE165004 | Abortività ricorrente (RPL) | GPL16699 | Endometrio | 24 | 24 | Microarray di espressione | Keleş ID29 | Set di dati di scoperta |
| GSE50772 | Lupus eritematoso sistemico (SLE) | GPL570 | Cellule mononucleate del sangue periferico (PBMCs) | 61 | 20 | Microarray di espressione | Kennedy WP30 | Set di dati di convalida |
| GSE198700 | Abortività ricorrente (RPL) | GPL13534 | Villi coriali | 5 | 5 | Microarray di espressione | Li Y31 | Set di dati di convalida |
Tabella 2: Set di dati trascrittomici utilizzati per le analisi bioinformatiche.
La tabella riassume i set di dati trascrittomici del Gene Expression Omnibus (GEO) inclusi nelle analisi di scoperta e di validazione, comprensivi di malattia, piattaforma di microarray, origine del tessuto, dimensione del campione, tipo di esperimento, ricercatore responsabile dello studio originale e categoria del set di dati.
GSE61635 è stato generato utilizzando la piattaforma Affymetrix Human Genome U133 Plus 2.0 Array (GPL570) e comprendeva 99 array di sangue intero provenienti da pazienti con lupus eritematoso sistemico (SLE), inclusi controlli ripetuti di alcuni pazienti, e 30 array provenienti da controlli sani indipendenti. La matrice di espressione depositata era stata sottoposta a correzione di fondo mediante robust multiarray average, normalizzazione quantile, sintesi dei probe-set e trasformazione log2 da parte degli investigatori originali. Pertanto, non è stata eseguita alcuna ulteriore correzione di fondo né normalizzazione quantile. Gli identificatori dei pazienti sono stati estratti dai metadati GEO e mantenuti per la modellizzazione di misure ripetute.
GSE165004 è stato generato utilizzando la piattaforma di microarray Agilent SurePrint G3 Human Gene Expression v2 8×60K (GPL16699). Il set completo di dati conteneva 24 controlli fertili, 24 pazienti con abortività ricorrente (RPL) e 24 pazienti con infertilità inspiegata. Sono stati inclusi soltanto i 24 campioni di RPL e i 24 campioni di controllo fertile raccolti nei giorni 19–21 del ciclo mestruale; i 24 campioni di infertilità inspiegata sono stati esclusi poiché non rientravano nel confronto predefinito29. È stata utilizzata la matrice di espressione normalizzata dal depositante e non è stata applicata alcuna ulteriore normalizzazione tra array, dopo aver confermato la comparabilità delle distribuzioni campionarie mediante box plot e density plot.
GSE50772 è stato utilizzato come dataset di validazione indipendente per il LES e include campioni di cellule mononucleate del sangue periferico provenienti da 61 pazienti con LES e 20 controlli sani, generati utilizzando GPL57030. GSE198700 è stato generato utilizzando GPL13534 e contiene campioni di villi coriali provenienti da cinque pazienti con abortività ricorrente e da cinque controlli sottoposti ad aborto elettivo31. La matrice di espressione depositata è stata importata integralmente e trasformata una sola volta utilizzando log2(x + 1), poiché i valori di espressione depositati erano forniti su scala non logaritmica. Questa trasformazione è stata applicata all'intera matrice di espressione prima del controllo qualitativo a livello di campione, dell'annotazione delle sonde, della sintesi a livello genico, della validazione dei geni candidati, dell'analisi di espressione differenziale, dei test di confronto tra gruppi e dell'analisi ROC. I geni candidati non sono stati trasformati separatamente e nessuna ulteriore trasformazione logaritmica è stata effettuata durante le analisi di validazione successive. Per tutti i dataset, le identità dei campioni, lo stato patologico, l'origine tissutale e le etichette dei gruppi sono stati verificati incrociandoli con i metadati GEO corrispondenti prima dell'analisi. Il controllo di qualità ha incluso la valutazione delle dimensioni delle librerie o delle distribuzioni di espressione, boxplot per campione, analisi delle componenti principali, clustering gerarchico e mappe termiche delle distanze tra campioni. Nessun campione aggiuntivo è stato escluso dopo la valutazione del controllo di qualità.
Analisi dell'espressione differenziale:
Le analisi dell'espressione differenziale sono state condotte separatamente per GSE61635 e GSE165004 utilizzando limma versione 3.60.6 (RRID:SCR_010943). Tutte le matrici di espressione sono state organizzate con i geni disposti in righe e i campioni in colonne. La soglia per l'espressione differenziale è stata stabilita a |log₂ fold change| > 1 per GSE61635 e |log₂ fold change| > 0.5 per GSE165004, con un valore di P corretto con il metodo di Benjamini–Hochberg (BH) < 0,05. I grafici a vulcano sono stati generati utilizzando ggplot2 versione 3.5.1 (RRID:SCR_014601). Le mappe termiche dei 50 geni con espressione differenziale più significativi (DEG), ordinati in base al valore di P corretto, sono state generate utilizzando pheatmap versione 1.0.12 (RRID:SCR_016418). I DEG comuni sono stati identificati intersecando i simboli ufficiali dei geni presenti negli elenchi significativi di DEG per SLE e RPL mediante la funzione base R intersect() e sono stati visualizzati utilizzando ggvenn versione 0.1.16 (RRID:SCR_025300). Le mappe termiche dell'espressione differenziale, i grafici a vulcano e l'intersezione degli elenchi di DEG per SLE e RPL sono riportati in Figura 3.
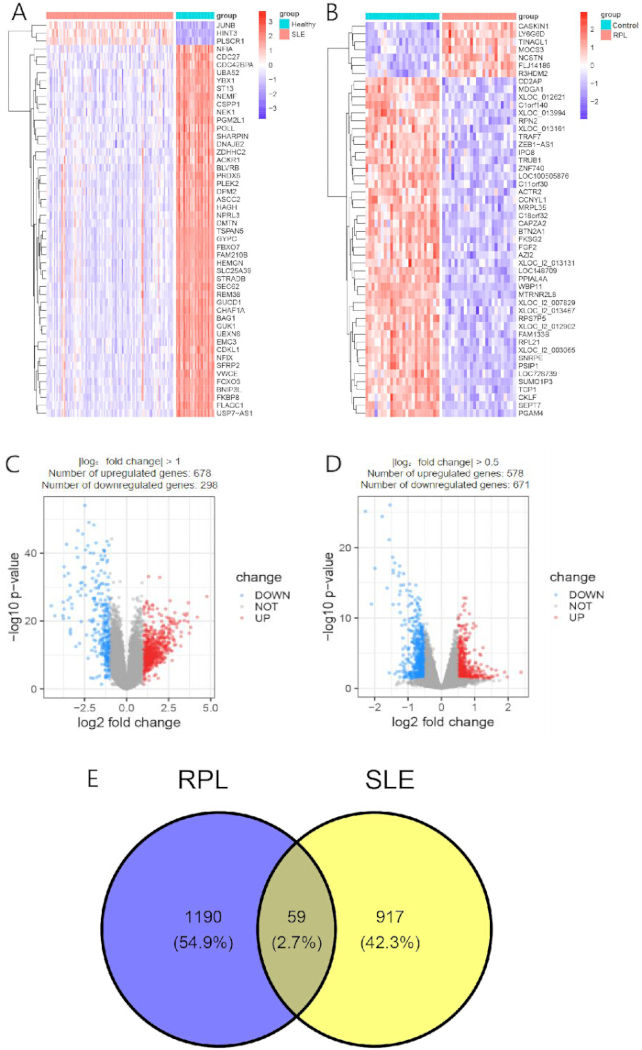
Figura 3. Geni differenzialmente espressi nel lupus eritematoso sistemico e nell'abortività ricorrente.
(A) Mappa termica dei 50 geni differenzialmente espressi (DEG) più significativi tra pazienti con lupus eritematoso sistemico (LES) e controlli sani nel dataset GSE61635. (B) Mappa termica dei 50 DEG più significativi tra pazienti con abortività ricorrente (AR) e controlli fertili nel dataset GSE165004. (C) Diagramma a vulcano dell'espressione genica differenziale nel dataset GSE61635. (D) Diagramma a vulcano dell'espressione genica differenziale nel dataset GSE165004. (E) Diagramma di Venn che mostra l'intersezione tra gli elenchi di DEG significativi ottenuti dai dataset di scoperta per LES e AR. DEG, geni differenzialmente espressi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Analisi di arricchimento funzionale dei DEG nell'intersezione:
Per l'analisi a livello molecolare delle funzioni dei DEG, lo strumento online DAVID (versione 2021; RRID:SCR_001881)32 è stato utilizzato per eseguire analisi di arricchimento funzionale Gene Ontology (GO) e analisi di arricchimento dei percorsi della Kyoto Encyclopedia of Genes and Genomes (KEGG). Sono stati caricati i simboli ufficiali dei geni umani come tipo di identificatore e Homo sapiens è stato selezionato come specie. La popolazione di riferimento personalizzata era costituita dall'intersezione di tutti i geni che avevano superato l'annotazione delle sonde e il controllo di qualità ed erano misurabili sia in GSE61635 che in GSE165004. La soglia minima per il numero di geni è stata impostata a 2, mentre il punteggio EASE massimo, che rappresenta il valore P esatto di Fisher unilaterale modificato di DAVID, è stato impostato a 0,05. Il controllo per confronti multipli è stato effettuato mediante la procedura di Benjamini–Hochberg riportata nella colonna "Benjamini" di DAVID. I termini funzionali sono stati considerati statisticamente significativi quando il punteggio EASE era < 0,05 e il valore P aggiustato con Benjamini era < 0,05. L'output completo di DAVID, compresi i nomi dei termini, i conteggi dei geni, i punteggi EASE, i valori P aggiustati con Benjamini, le associazioni dei geni in ingresso e le associazioni dei geni di riferimento, è stato esportato come file delimitato da tabulazioni. Il sito web CNSknowall è stato utilizzato per visualizzare i risultati filtrati di DAVID. I risultati di arricchimento GO e KEGG sono presentati in Figura 4A.
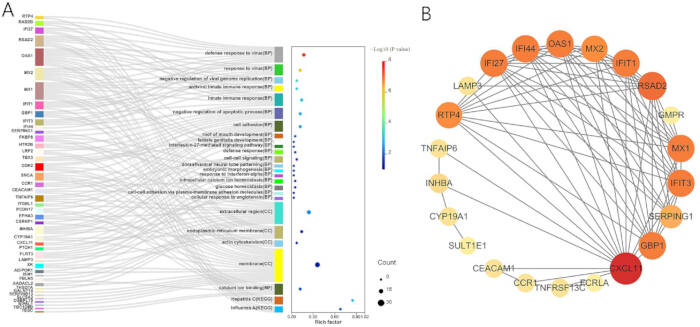
Figura 4. Analisi di arricchimento funzionale e rete di interazione proteina-proteina dei geni differenzialmente espressi condivisi.
(A) Analisi di arricchimento Gene Ontology (GO) e Kyoto Encyclopedia of Genes and Genomes (KEGG) dei 59 geni differenzialmente espressi (DEG) condivisi. Il diagramma di Sankey illustra le relazioni tra i geni e i termini GO arricchiti, mentre il grafico a bolle riassuntivo mostra i termini GO e KEGG arricchiti in base al fattore di ricchezza, al numero di geni e alla significatività statistica. (B) Rete di interazione proteina-proteina (PPI) costruita a partire dai 59 DEG condivisi utilizzando STRING e visualizzata in Cytoscape. La dimensione e il colore dei nodi riflettono la connettività della rete, mentre i bordi indicano associazioni proteina-proteina predette. BP, processo biologico; CC, componente cellulare; MF, funzione molecolare. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Rete PPI e identificazione dei geni centrali:
I DEG condivisi sono stati caricati su STRING versione 11.0 (RRID:SCR_005223)33 selezionando Homo sapiens come organismo (identificatore tassonomico: 9606). È stata utilizzata la rete STRING completa, consentendo sia associazioni proteiche funzionali che fisiche. Sono stati abilitati tutti i canali di evidenza disponibili, inclusi evidenze sperimentali, basi di dati curate, co-espressione, text mining, vicinanza genica, fusione genica e co-occorrenza genica.
Il punteggio minimo richiesto per l'interazione è stato impostato a 0,400, corrispondente a una fiducia media. Non sono stati aggiunti ulteriori interattori del primo o del secondo guscio; pertanto, la rete conteneva solo le proteine codificate dai DEG condivisi inviati. I collegamenti della rete sono stati visualizzati utilizzando la modalità di fiducia ed esportati in un file di valori separati da tabulazioni contenente le proteine interagenti e i punteggi STRING combinati. I punteggi di fiducia STRING rappresentano la probabilità che un'associazione esista, piuttosto che l'entità o la forza di legame dell'interazione.
Il file della rete STRING è stato importato in Cytoscape versione 3.10.0 (RRID:SCR_003032)34. I nodi privi di interazioni con un'altra proteina sottoposta sono stati rimossi prima dell'analisi della topologia della rete35. La rete rimanente è stata trattata come una rete non diretta. I punteggi combinati di STRING sono stati mantenuti come attributi degli archi per la visualizzazione, mentre le classifiche generate da cytoHubba sono state ottenute utilizzando le definizioni topologiche predefinite non pesate. La rete PPI risultante è presentata in Figura 4B.
I geni hub sono stati classificati utilizzando cytoHubba versione 0.1 (RRID:SCR_017677) con sei algoritmi: centralità della cricca massimale (Maximal Clique Centrality, MCC), componente massimo del vicinato (Maximum Neighborhood Component, MNC), componente percolato dagli archi (Edge Percolated Component, EPC), grado (Degree), vicinanza (Closeness) e radialità (Radiality)36. Per ciascun algoritmo, i geni sono stati ordinati in modo decrescente e sono stati mantenuti i primi 10 geni. I candidati geni hub della rete sono stati definiti utilizzando l'intersezione rigorosa delle sei liste dei primi 10 geni. Pertanto, un gene è stato considerato un hub della rete solo se è risultato tra i primi 10 geni identificati da tutti e sei gli algoritmi. Le classifiche e la procedura di intersezione sono state esportate e archiviate. I primi 10 geni identificati da ciascun algoritmo cytoHubba sono riportati in Tabella 3.
| Rank | Centralità della Cricca Massimale (MCC) | Componente Massima del Vicinato (MNC) | Componente di Percolazione degli Archi (EPC) | Grado | Prossimità | Radialità |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabella 3: Primi 10 geni hub identificati da sei algoritmi di classificazione cytoHubba.
I geni differenzialmente espressi condivisi sono stati classificati utilizzando sei algoritmi di topologia di rete implementati nel plugin cytoHubba di Cytoscape. I primi 10 geni classificati generati da ciascun algoritmo sono presentati per confronto tra Massima Centralità della Cricca (MCC), Massima Componente del Vicinato (MNC), Componente di Percolazione degli Archi (EPC), Grado, Vicinanza e Radialità.
Regressione LASSO per l'identificazione dei geni centrali:
È stata eseguita una regressione logistica LASSO separatamente nei set di dati di scoperta per SLE e RPL utilizzando glmnet versione 4.1-8 (RRID:SCR_015505). La matrice predittiva era composta dai valori di espressione normalizzati dei candidati hub della rete, con i campioni disposti per righe e i geni per colonne. Lo stato di malattia è stato codificato come 1 e lo stato di controllo come 0. È stato adattato un modello lineare generalizzato binomiale con una penalizzazione puramente LASSO, utilizzando family = "binomial" e alpha = 1. Le variabili predittive sono state standardizzate internamente mediante standardize = TRUE, ed è stato incluso un termine noto. Assegnazioni stratificate per classe in 10 gruppi sono state generate separatamente per i set di dati SLE e RPL mediante codice R personalizzato. All'interno di ciascuno strato di stato di malattia, gli indici dei campioni sono stati permutati casualmente e distribuiti in modo il più uniforme possibile tra i 10 gruppi utilizzando sample(rep(seq_len(10), length.out = n)). È stato impostato un seme casuale pari a 123 prima della generazione delle assegnazioni di gruppo per ciascun set di dati, al fine di garantire la riproducibilità. Poiché ciascun gruppo di stato di malattia comprendeva più di 10 campioni, ogni fold della validazione incrociata includeva sia casi che controlli. I vettori interi risultanti (foldid_sle e foldid_rpl) sono stati forniti all'argomento foldid di cv.glmnet(), e le stesse assegnazioni di gruppo sono state utilizzate per tutti i valori di λ valutati all'interno del corrispondente set di dati.
I modelli sono stati adattati utilizzando family = "binomial", alpha = 1, nfolds = 10, type.measure = "deviance", standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7, e maxit = 100000. Il parametro di penalizzazione è stato selezionato utilizzando lambda.min, definito come il valore di lambda che produce la devianza binomiale minima media ottenuta mediante cross-validazione. Il valore più conservativo lambda.1se, definito come il valore più grande di lambda entro un errore standard del minimo errore di cross-validazione, è stato registrato come risultato di sensibilità. La procedura LASSO è stata applicata separatamente ai dataset GSE61635 e GSE165004. I geni con coefficienti non nulli in entrambi i modelli specifici per la malattia sono stati definiti geni candidati condivisi selezionati mediante LASSO. Introducendo il termine di regolarizzazione L1, il metodo riduce efficacemente a zero i coefficienti dei geni meno informativi, eseguendo così una selezione delle caratteristiche37. I profili dei coefficienti e le curve di cross-validazione a 10 ripetizioni per i dataset di scoperta relativi al LES e all'RPL sono presentati in Figura 5.
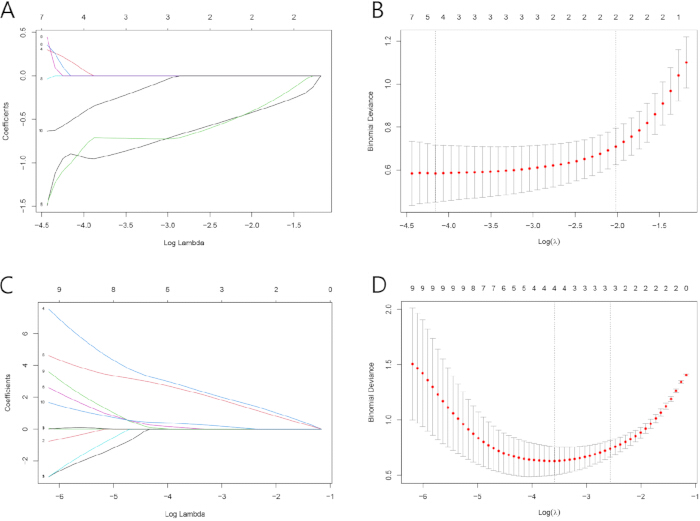
Figura 5. Analisi di regressione con operatore di riduzione e selezione della norma L1 per i geni centrali della rete.
(A) Profili dei coefficienti ottenuti mediante regressione logistica con operatore di riduzione e selezione della norma L1 (LASSO) per il set di dati di scoperta del lupus eritematoso sistemico (SLE) (GSE61635). (B) Curva di validazione incrociata a dieci ripetizioni utilizzata per determinare il parametro di penalizzazione ottimale (λ) per il modello SLE. (C) Profili dei coefficienti ottenuti mediante regressione logistica LASSO per il set di dati di scoperta della perdita ricorrente di gravidanza (RPL) (GSE165004). (D) Curva di validazione incrociata a dieci ripetizioni utilizzata per determinare il parametro di penalizzazione ottimale (λ) per il modello RPL. I numeri lungo l'asse x superiore indicano il numero di coefficienti di regressione diversi da zero per ciascun valore di λ. Le linee tratteggiate verticali indicano λ_min e λ_1se. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Convalida del valore diagnostico dei geni principali:
I modelli di espressione dei geni candidati selezionati tramite LASSO sono stati valutati nel set di dati indipendente su SLE GSE50772 e nel set di dati indipendente su RPL GSE198700. I set di dati esterni sono stati utilizzati solo dopo che la selezione dei geni candidati era stata completata nei set di dati GSE61635 e GSE165004. Nessuna ulteriore selezione di caratteristiche o adattamento del modello è stato effettuato nei set di dati di convalida. L'espressione dei geni candidati è stata confrontata tra casi e controlli utilizzando il test della somma dei ranghi di Wilcoxon bilaterale. Quando più di un gene candidato è stato testato all'interno di un singolo set di dati, i valori di P risultanti sono stati corretti mediante la procedura di Benjamini–Hochberg. Un gene candidato è stato considerato replicato esternamente quando la sua espressione differiva in modo significativo tra casi e controlli dopo la correzione per confronti multipli e la direzione della differenza era coerente con quella osservata nel corrispondente set di dati di scoperta. I modelli di espressione dei geni candidati nei set di dati di scoperta e di convalida sono riportati in Figura 6.
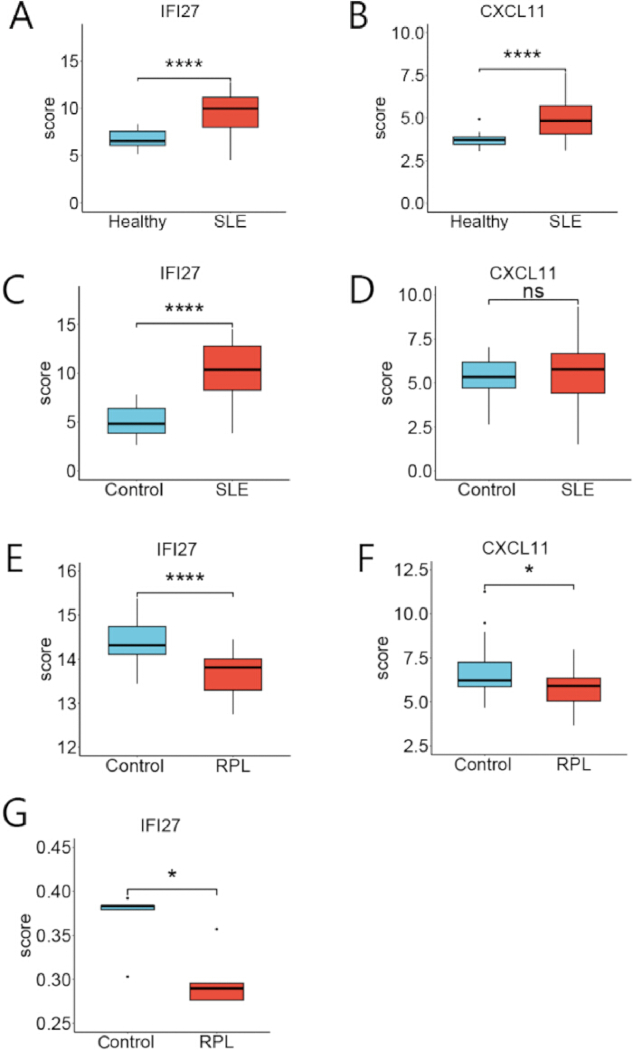
Figura 6. Espressione di IFI27 e CXCL11 nei set di dati di scoperta e di convalida.
(A,B) Espressione di IFI27 e CXCL11, rispettivamente, nel set di dati di scoperta del lupus eritematoso sistemico (LES) (GSE61635). (C,D) Espressione di IFI27 e CXCL11, rispettivamente, nel set di dati di convalida indipendente del LES (GSE50772). (E,F) Espressione di IFI27 e CXCL11, rispettivamente, nel set di dati di scoperta della perdita ricorrente di gravidanza (RPL) (GSE165004). (G) Espressione di IFI27 nel set di dati di convalida indipendente della RPL (GSE198700). L'espressione genica è stata confrontata tra i gruppi utilizzando il test di Wilcoxon rank-sum bilaterale. I valori di P sono stati corretti utilizzando il metodo di Benjamini–Hochberg quando sono stati testati più geni candidati all'interno dello stesso set di dati. P < 0,05; **** P < 0,0001; ns, non significativo. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Sono state effettuate analisi delle curve ROC (receiver operating characteristic) utilizzando pROC versione 1.18.5 (RRID:SCR_024286)38. Per ciascun gene candidato in ciascun dataset di scoperta sono state generate curve ROC separate. L'area sotto la curva ROC (AUC) e il relativo intervallo di confidenza bilaterale al 95% sono state calcolate mediante il metodo di DeLong. Il cutoff diagnostico esplorativo è stato determinato utilizzando l'indice di Youden massimo. Gli intervalli di confidenza per il cutoff, la sensibilità e la specificità sono stati calcolati mediante 2.000 replicati bootstrap stratificati, con il seme casuale impostato a 123. L'AUC è stata utilizzata come misura indipendente dalla soglia della capacità discriminante39. Poiché i dataset erano retrospettivi e generati utilizzando tessuti, piattaforme e procedure di normalizzazione differenti, i cutoff derivati dall'indice di Youden sono stati calcolati separatamente all'interno di ciascun dataset e sono stati considerati soglie esplorative specifiche per dataset. Tali cutoff non sono stati considerati soglie cliniche standardizzate e non sono stati trasferiti direttamente tra piattaforme. I risultati ROC esterni rappresentano una validazione trascrittomica piuttosto che una validazione clinica prospettica. pROC supporta intervalli di confidenza di DeLong per le AUC e l'ottimizzazione tramite indice di Youden attraverso la funzione coords(), mentre gli intervalli di confidenza per le coordinate ROC possono essere stimati mediante ricampionamento bootstrap stratificato. Le curve ROC e i riassunti della capacità discriminante dei geni candidati nei dataset di scoperta per SLE e RPL sono presentati in Figura 7.
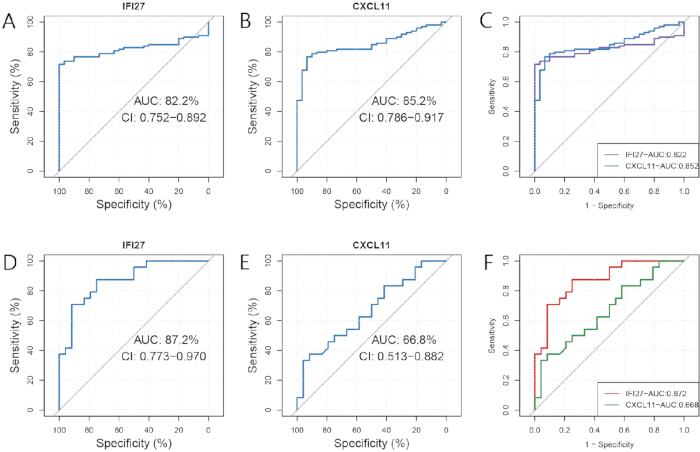
Figura 7. Analisi della caratteristica operativa del ricevitore dei geni candidati.
(A) Curva ROC (receiver operating characteristic) per IFI27 nel set di dati di scoperta del lupus eritematoso sistemico (SLE). (B) Curva ROC per CXCL11 nel set di dati di scoperta del SLE. (C) Riassunto delle prestazioni diagnostiche di IFI27 e CXCL11 nel set di dati di scoperta del SLE. (D) Curva ROC per IFI27 nel set di dati di scoperta della perdita ricorrente della gravidanza (RPL). (E) Curva ROC per CXCL11 nel set di dati di scoperta del RPL. (F) Riassunto delle prestazioni diagnostiche di IFI27 e CXCL11 nel set di dati di scoperta del RPL. I valori dell'area sotto la curva (AUC) sono riportati con intervalli di confidenza al 95% (CIs). Cliccare qui per visualizzare una versione ingrandita di questa figura.
Infiltrazione immunitaria mediante ssGSEA:
Considerando il ruolo della disregolazione delle cellule immunitarie nella patogenesi del LES e dell'RPL40,41, l'arricchimento delle cellule immunitarie è stato inferito computazionalmente nei set di dati di scoperta GSE61635 e GSE165004. L'analisi è stata eseguita separatamente all'interno di ciascun set di dati, e i set non sono stati uniti. La raccolta di firme geniche per le cellule immunitarie comprendeva i set di geni marcatore per 28 popolazioni di cellule immunitarie descritte da Charoentong et al.42. La tabella originale supplementare delle firme geniche è stata convertita in un elenco di set di geni denominati utilizzando i simboli ufficiali dei geni umani. I simboli duplicati all'interno di ciascun set di geni sono stati rimossi. I geni assenti dalla corrispondente matrice di espressione sono stati scartati, e i set di geni contenenti meno di cinque geni corrispondenti dopo il mappaggio degli identificatori sono stati esclusi da quel set di dati. L'analisi di arricchimento dei set di geni su singolo campione (ssGSEA) è stata eseguita utilizzando GSVA versione 1.52.3 (RRID:SCR_021058) e GSEABase versione 1.66.0. Nella versione 1.52.3 di GSVA, è richiesto un oggetto di parametri specifico del metodo. Sono stati utilizzati i seguenti parametri: minSize = 5, maxSize = 500, alpha = 0.25, normalize = TRUE e checkNA = "yes”.
Il parametro alpha è stato impostato a 0,25 e l'normalizzazione finale del punteggio ssGSEA è stata abilitata. Gli insiemi genici sono stati limitati a 5–500 geni dopo l'abbinamento alla matrice di espressione. È stata utilizzata un'esecuzione a singolo thread per garantire un calcolo coerente tra i diversi sistemi. Il parametro kcdf non è stato utilizzato poiché non è un parametro della procedura ssgseaParam() nella versione 1.52.3 di GSVA. L'analisi ssGSEA produce punteggi di arricchimento degli insiemi genici a livello di campione relativi, piuttosto che conteggi sperimentali di cellule immunitarie o frazioni cellulari assolute43. Il flusso di lavoro GSVA 1.52.3 richiede un oggetto parametro specifico del metodo, e i parametri ssGSEA includono alpha, normalizzazione del punteggio e limiti di dimensione degli insiemi genici.
Per ogni profilo delle cellule immunitarie, i punteggi ssGSEA sono stati confrontati tra i gruppi malati e di controllo utilizzando il test della somma dei ranghi di Wilcoxon a due code. I valori P per i 28 confronti tra tipi cellulari sono stati corretti separatamente all'interno di ciascun dataset mediante il metodo di Benjamini–Hochberg. I profili delle cellule immunitarie con un valore P corretto < 0,05 sono stati considerati differenzialmente arricchiti.
Sono state calcolate le correlazioni dei ranghi di Spearman tra l'espressione dei geni candidati e il punteggio ssGSEA di ciascuna firma delle cellule immunitarie all'interno di ogni dataset. I valori P di correlazione sono stati corretti utilizzando il metodo di Benjamini–Hochberg su tutte le combinazioni gene candidato–cellula immunitaria all'interno di quel dataset. Le correlazioni sono state considerate statisticamente significative per un valore P corretto < 0,05. Le matrici di correlazione sono state visualizzate utilizzando ggcorrplot versione 0.1.4.1, mentre i grafici di confronto tra gruppi sono stati generati con ggplot2 versione 3.5.1.
I punteggi ssGSEA normalizzati grezzi sono stati utilizzati per tutti i test statistici. Le mappe termiche e le visualizzazioni sovrapposte sono state utilizzate esclusivamente per la presentazione descrittiva. I punteggi non sono stati descritti come proporzioni dirette di cellule immunitarie, e le associazioni osservate sono state interpretate come correlazioni computazionali piuttosto che interazioni sperimentali tra cellule e geni. I profili di arricchimento delle firme delle cellule immunitarie, i confronti tra gruppi e le correlazioni con l'espressione dei geni candidati sono presentati in Figura 8.
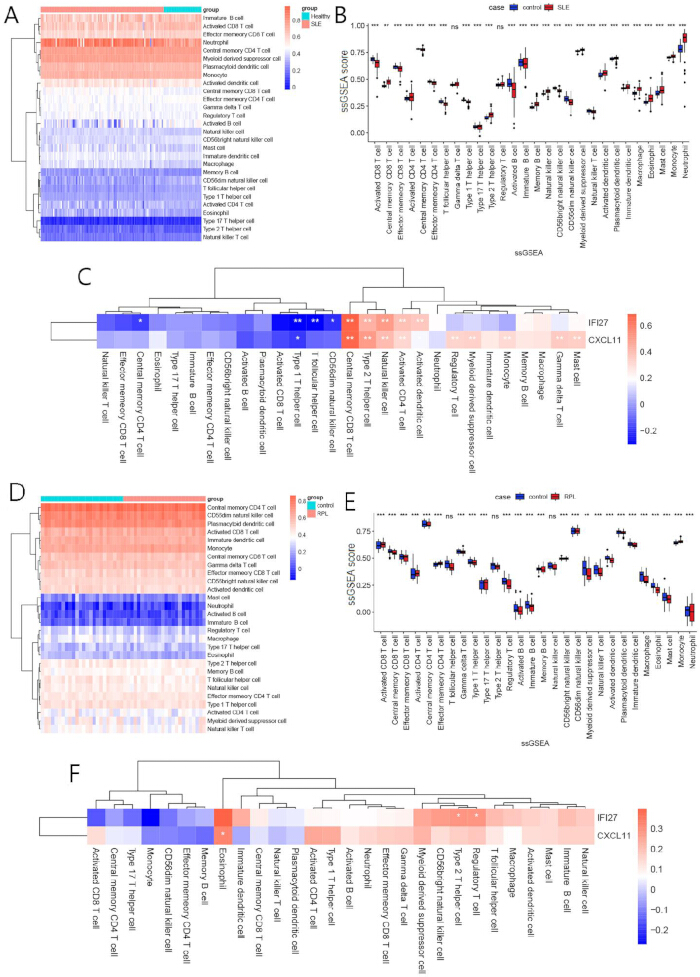
Figura 8. Arricchimento delle firme delle cellule immunitarie e correlazioni con i geni candidati comuni nel lupus eritematoso sistemico e nell'abortività ricorrente.
(A) Mappa termica di clustering gerarchico dei punteggi di analisi dell'arricchimento dell'insieme genico da singolo campione (ssGSEA) per 28 firme di cellule immunitarie nel set di dati di scoperta del lupus eritematoso sistemico (SLE). (B) Confronto dei punteggi ssGSEA delle firme delle cellule immunitarie tra pazienti con SLE e controlli sani. (C) Mappa termica di correlazione di Spearman che mostra le associazioni tra l'espressione di IFI27 e CXCL11 e i punteggi ssGSEA delle 28 firme delle cellule immunitarie nel set di dati di scoperta SLE. (D) Mappa termica di clustering gerarchico dei punteggi ssGSEA per 28 firme di cellule immunitarie nel set di dati di scoperta dell'abortività ricorrente (RPL). (E) Confronto dei punteggi ssGSEA delle firme delle cellule immunitarie tra pazienti con RPL e controlli fertili. (F) Mappa termica di correlazione di Spearman che mostra le associazioni tra l'espressione di IFI27 e CXCL11 e i punteggi ssGSEA delle 28 firme delle cellule immunitarie nel set di dati di scoperta RPL. Le correlazioni sono state calcolate utilizzando il coefficiente di correlazione dei ranghi di Spearman e i valori P sono stati corretti con il metodo di Benjamini–Hochberg. P < 0,05; ** P < 0,01; *** P < 0,001; ns, non significativo. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Risultati
Analisi MR
Dopo la selezione degli strumenti e l'armonizzazione dei dati, sono stati mantenuti 16 SNP per l'analisi MR diretta, in cui il lupus eritematoso sistemico (SLE) è stato considerato come esposizione e il numero di aborti spontanei come outcome. Informazioni dettagliate sulle variabili strumentali sono riportate nella Tabella Supplementare 1. Tutti gli SNP mantenuti presentavano valori di statistica F superiori a 10, indicando che era improbabile un bias dovuto a strumenti deboli. Ogni SNP mantenuto è stato inoltre analizzato mediante PhenoScanner V2, e non è stato identificato alcun SNP associato agli anticorpi antifosfolipidi (aPL). L'analisi MR-PRESSO non ha rilevato outlier. Il test Q di Cochran non ha evidenziato eterogeneità significativa tra le stime specifiche per SNP (Q = 16,12, P = 0,31); pertanto, è stato applicato un modello IVW a effetti fissi. Il test dell'intercetta MR-Egger non ha indicato pleiotropia orizzontale direzionale (P = 0,69). L'analisi IVW ha mostrato un'associazione positiva statisticamente significativa ma quantitativamente modesta tra SLE predetto geneticamente e numero di aborti spontanei (odds ratio [OR] = 1,01, intervallo di confidenza al 95% [CI] = 1,00–1,02, P < 0,01; Figura 2A). Le stime dell'effetto ottenute mediante regressione MR-Egger (OR = 1,01, 95% CI = 1,00–1,03, P = 0,16), il metodo della mediana pesata (OR = 1,01, 95% CI = 1,00–1,02, P = 0,17) e il metodo della moda pesata (OR = 1,01, 95% CI = 0,99–1,03, P = 0,42) erano concordi in direzione con la stima IVW, sebbene nessuna raggiungesse individualmente la significatività statistica. L'analisi leave-one-out ha mostrato che l'esclusione di un singolo SNP non modificava in modo sostanziale la stima aggregata, e il grafico a imbuto approssimativamente simmetrico non forniva evidenze visive che il risultato fosse determinato da una marcata pleiotropia direzionale. Il grafico a dispersione corrispondente, il grafico a foreste specifico per SNP, l'analisi leave-one-out e il grafico a imbuto sono presentati nelle Figure Supplementari 1–4.
Nell'analisi MR inversa, 16 SNP sono stati mantenuti dopo la selezione dello strumento, e tutti presentavano valori di statistica F superiori a 10 (Tabella Supplementare 2). L'analisi MR-PRESSO non ha identificato valori anomali. Il test Q di Cochran non ha evidenziato eterogeneità significativa (Q = 13,41, P = 0,50), e il test dell'intercetta MR-Egger non ha fornito evidenza di pleiotropia orizzontale direzionale (P = 0,41). La stima IVW non ha sostenuto un'associazione tra il numero di aborti spontanei predetto geneticamente e il rischio di LES (OR = 0,93, IC 95% = 0,21–4,23, P = 0,93; Figura 2B). Nel complesso, i risultati dell'MR supportano un'associazione modesta nella direzione diretta, da LES predetto geneticamente al numero di aborti spontanei, mentre l'analisi inversa non ha sostenuto un'associazione dal numero di aborti spontanei predetto geneticamente al rischio di LES.
Analisi bioinformatica
Analisi dell'espressione differenziale:
L'analisi dell'espressione differenziale di GSE61635 ha identificato 976 geni differenzialmente espressi (DEG) tra i gruppi di SLE e controlli sani, inclusi 678 geni upregolati e 298 geni downregolati (Figura 3C). L'analisi di GSE165004 ha identificato 1.249 DEG tra i gruppi di RPL e controlli, inclusi 578 geni upregolati e 671 geni downregolati (Figura 3D). Le mappe termiche che mostrano i 50 DEG più significativi nei due dataset di scoperta sono presentate in Figura 3A e Figura 3B. Inoltre, sono stati identificati 59 DEG comuni tra i due dataset (Figura 3E). Questi DEG condivisi hanno fornito il set genico utilizzato per le successive analisi di arricchimento funzionale e di rete.
Analisi di arricchimento funzionale dei DEG in comune:
I 59 DEG condivisi sono stati sottoposti ad analisi di arricchimento GO e dei percorsi KEGG utilizzando DAVID. Nella categoria processo biologico, i DEG condivisi mostravano arricchimento nella risposta di difesa contro i virus, risposta ai virus, regolazione negativa della replicazione del genoma virale, risposta immunitaria innata antivirale, regolazione negativa del processo apoptotico e adesione cellulare. I termini arricchiti relativi al componente cellulare includevano regione extracellulare, membrana del reticolo endoplasmatico, citoscheletro di actina e membrana. Il legame con ioni calcio è stato identificato tra i termini arricchiti di funzione molecolare. L'analisi KEGG ha mostrato un arricchimento nei percorsi relativi all'epatite C e all'influenza A (Figura 4A). Questi risultati indicano che i DEG condivisi erano prevalentemente associati a processi biologici legati alla risposta antivirale e immunitaria, fornendo un contesto funzionale ai geni comuni ai dataset di scoperta di LES e RPL.
Rete PPI e identificazione dei geni hub
I 59 DEG condivisi sono stati caricati su STRING per costruire una rete PPI utilizzando un punteggio di confidenza minimo per l'interazione pari a 0,400. La rete risultante comprendeva 59 nodi e 80 archi. La rete è stata importata in Cytoscape versione 3.10.0 per la visualizzazione, e i nodi isolati sono stati rimossi prima dell'analisi topologica (Figura 4B). Il ranking dei geni hub è stato effettuato utilizzando il plugin cytoHubba. Sono stati applicati sei algoritmi: Massima Centralità della Clique (MCC), Componente Massima del Vicinato (MNC), Componente di Percolazione degli Archi (EPC), Grado (Degree), Vicinanza (Closeness) e Radialità (Radiality). Gli stessi 10 geni sono stati identificati tra i geni con i punteggi più alti ottenuti dai sei algoritmi: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 e CXCL11 (Tabella 3). Questi geni sono stati pertanto mantenuti come candidati hub della rete per la successiva regressione LASSO.
La regressione LASSO ha identificato IFI27 e CXCL11 come geni candidati condivisi
I 10 geni candidati hub sono stati sottoposti ad analisi di regressione LASSO nei set di dati di scoperta relativi al LES e all'RPL. Nel set di dati del LES, quattro geni hanno mantenuto coefficienti diversi da zero al valore lambda selezionato: IFIT3, IFI27, IFI44 e CXCL11, con coefficienti rispettivamente pari a 2,575, 0,057, 2,359 e 0,307 (Figura 5A,B). Nel set di dati dell'RPL, quattro geni hanno mantenuto coefficienti diversi da zero: IFI27, GBP1, OAS1 e CXCL11, con coefficienti rispettivamente pari a −0,897, 0,167, −1,007 e −0,519 (Figura 5C,D). Il confronto tra i geni selezionati dai due modelli specifici per malattia ha identificato IFI27 e CXCL11 come geni candidati condivisi selezionati dalla regressione LASSO. Questi due geni sono stati successivamente valutati nei set di dati di scoperta e di validazione esterna.
Convalida esterna dell'espressione di IFI27 e CXCL11
I profili di espressione dei due geni candidati sono stati valutati utilizzando i set di dati indipendenti di convalida GSE50772 e GSE198700 ottenuti dal database GEO. Nel set di dati GSE61635, sia IFI27 che CXCL11 risultavano significativamente sovraespressi nel gruppo di pazienti con SLE rispetto ai controlli sani (Figura 6A,B). Nel set di dati indipendente di convalida per il lupus eritematoso sistemico (GSE50772), IFI27 manteneva una sovraespressione significativa (Figura 6C), mentre per CXCL11 non si osservavano differenze significative tra i gruppi (Figura 6D). Nel set di dati di scoperta per la RPL (GSE165004), sia IFI27 che CXCL11 risultavano significativamente sottoespressi nel gruppo RPL rispetto ai controlli (Figura 6E,F). Nel set di dati indipendente di convalida per la RPL (GSE198700), IFI27 manteneva una significativa sottoespressione nel gruppo RPL (Figura 6G), mentre CXCL11 non è stato rilevato. Nel complesso, IFI27 ha mostrato un'espressione differenziale coerente in tutti i set di dati di scoperta e di convalida per SLE e RPL. Al contrario, l'espressione di CXCL11 non è stata riprodotta in modo consistente nei set di dati esterni di convalida. Pertanto, IFI27 è stato selezionato come biomarcatore candidato comune per le analisi successive.
Valutazione esplorativa della discriminazione diagnostica
È stata eseguita un'analisi delle curve ROC (receiver operating characteristic) per valutare la capacità dell'espressione di IFI27 e CXCL11 di distinguere campioni di pazienti da controlli nei set di dati trascrittomica retrospettivi analizzati. Per il LES, IFI27 ha prodotto un'area sotto la curva ROC (AUC) pari a 0,822 (IC 95% = 0,752–0,892; Figura 7A), mentre CXCL11 ha prodotto un AUC di 0,852 (IC 95% = 0,786–0,917; Figura 7B). Un confronto tra le curve ROC dei due geni candidati nel set di dati del LES è mostrato in Figura 7C. Per la RPL, IFI27 ha prodotto un AUC di 0,872 (IC 95% = 0,773–0,970; Figura 7D), mentre CXCL11 ha prodotto un AUC di 0,668 (IC 95% = 0,513–0,882; Figura 7E). Un confronto tra le curve ROC dei due geni candidati nel set di dati della RPL è mostrato in Figura 7F. IFI27 ha mostrato valori di AUC superiori a 0,80 in entrambi i set di dati delle malattie ed ha evidenziato una validazione esterna più coerente rispetto a CXCL11 attraverso i diversi set di dati di espressione. Questi risultati supportano IFI27 come biomarcatore candidato da sottoporre a ulteriore valutazione. Tuttavia, poiché le analisi ROC sono state effettuate utilizzando set di dati trascrittomica pubblici e retrospettivi, i risultati devono essere interpretati come evidenza esplorativa di discriminazione trascrittomica piuttosto che come validazione diagnostica clinica prospettica.
Valutazione computazionale dell'infiltrazione immunitaria
È stata eseguita un'analisi ssGSEA per valutare l'arricchimento di 28 firme di cellule immunitarie nei set di dati di scoperta GSE61635 e GSE165004. Le mappe termiche di arricchimento delle cellule immunitarie per i set di dati SLE e RPL sono mostrate rispettivamente in Figura 8A,D, mentre i corrispondenti confronti tra gruppi dei punteggi ssGSEA sono presentati in Figura 8B,E. Nel set di dati SLE, molte firme di cellule immunitarie differivano in modo significativo tra pazienti con SLE e controlli sani, inclusi i profili relativi a cellule T CD8+, cellule T CD4+, cellule B, cellule dendritiche, cellule T helper di tipo 1 (Th1), cellule T helper di tipo 2 (Th2), cellule T helper di tipo 17 (Th17), cellule natural killer, macrofagi, eosinofili, mastociti, monociti e neutrofili (Figura 8B). Nel set di dati RPL, i punteggi ssGSEA per le cellule T CD8+ attivate, le cellule T CD4+ attivate, le cellule T CD4+ della memoria effettore, le cellule Th17 e i monociti erano più elevati nel gruppo RPL rispetto al gruppo di controllo. Al contrario, i punteggi ssGSEA per le cellule T regolatorie (Treg) e i macrofagi erano più bassi nel gruppo RPL rispetto al gruppo di controllo (Figura 8E). L'analisi della correlazione ha mostrato che, nel set di dati SLE, l'espressione di IFI27 e CXCL11 era positivamente correlata ai punteggi ssGSEA delle cellule T CD4+ attivate, delle cellule natural killer, delle cellule Th2 e delle cellule T CD8+ della memoria centrale, e negativamente correlata al punteggio ssGSEA delle cellule Th1 (Figura 8C). Nel set di dati RPL, l'espressione di IFI27 era positivamente correlata ai punteggi ssGSEA di Treg e cellule Th2, mentre l'espressione di CXCL11 era positivamente correlata al punteggio ssGSEA degli eosinofili (Figura 8F).
Disponibilità dei dati:
Nessun nuovo dato primario da partecipanti umani è stato generato in questo studio. Tutte le analisi si sono basate esclusivamente su statistiche riassuntive di studi di associazione sull'intero genoma (GWAS) e su set di dati trascrittomici disponibili pubblicamente. Le statistiche riassuntive GWAS per il lupus eritematoso sistemico (SLE) sono state ottenute da FinnGen Release 11 (accession: finngen_R11_L12_LUPUS). Le statistiche riassuntive relative al numero di aborti spontanei sono state ottenute dalla risorsa IEU OpenGWAS (accession: ukb-b-419), basata sui dati del UK Biobank. I set di dati trascrittomici sono stati ottenuti dal National Center for Biotechnology Information Gene Expression Omnibus (GEO) con i numeri di accessione GSE61635, GSE165004, GSE50772 e GSE198700. I set di dati disponibili pubblicamente possono essere consultati nei seguenti archivi:
-- FinnGen Rilascio 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
I dati elaborati che supportano i risultati di questo studio sono inclusi nell'articolo e nei suoi Materiali Supplementari. Non sono stati consultati né conservati dati a livello individuale o identificabili personalmente dei partecipanti. Il flusso di lavoro analitico è stato eseguito utilizzando software e pacchetti disponibili pubblicamente, come descritto nel Protocollo.
File supplementare 1. Checklist completata del modulo di segnalazione STROBE-MR.
Checklist completata di Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization (STROBE-MR) che indica in quale sezione del manoscritto viene affrontato ciascun elemento raccomandato per la segnalazione. Cliccare qui per scaricare il file.
Figura supplementare 1. Diagramma a dispersione dell'analisi di randomizzazione mendeliana diretta.
Diagramma a dispersione che mostra le associazioni tra gli effetti genetici dei polimorfismi a singolo nucleotide (SNP) strumentali sul lupus eritematoso sistemico (LES) e il numero di aborti spontanei. Ogni punto rappresenta un SNP, con barre di errore orizzontali e verticali che indicano gli errori standard delle stime dell'effetto SNP. Le linee di regressione corrispondono ai metodi di randomizzazione mendeliana pesati per l'inverso della varianza, MR-Egger, mediana pesata e moda pesata. Cliccare qui per scaricare il file.
Figura supplementare 2. Stime causali specifiche per polimorfismo a singolo nucleotide ottenute dall'analisi di randomizzazione mendeliana diretta.
Grafico a foreste che mostra la stima dell'effetto causale per ciascun polimorfismo a singolo nucleotide (SNP) strumentale sull'associazione tra lupus eritematoso sistemico (SLE) e il numero di aborti spontanei. I punti neri rappresentano le stime dell'effetto specifiche per SNP con intervalli di confidenza al 95%. I punti rossi rappresentano le stime complessive dell'effetto causale ottenute mediante i metodi weighted inverse-variance e MR-Egger. La linea verticale tratteggiata indica l'assenza di effetto. Cliccare qui per scaricare il file.
Figura supplementare 3. Analisi di sensibilità leave-one-out dell'analisi di randomizzazione mendeliana diretta.
Grafico a foreste che mostra i risultati dell'analisi di sensibilità leave-one-out volta a valutare l'associazione tra lupus eritematoso sistemico (LES) e il numero di aborti spontanei. Ogni punto nero rappresenta la stima complessiva dell'effetto causale pesata per l'inverso della varianza ottenuta dopo l'esclusione sequenziale di un singolo polimorfismo a singolo nucleotide (SNP) strumentale, con linee orizzontali che indicano i corrispondenti intervalli di confidenza al 95%. Il punto rosso rappresenta la stima complessiva pesata per l'inverso della varianza ottenuta utilizzando tutti gli SNP strumentali. La linea verticale tratteggiata indica l'assenza di effetto. Cliccare qui per scaricare il file.
Figura supplementare 4. Grafico a imbuto dell'analisi di randomizzazione mendeliana diretta.
Grafico a imbuto che mostra la distribuzione delle stime dell'effetto causale specifiche per ciascun SNP per l'associazione tra lupus eritematoso sistemico (SLE) e il numero di aborti spontanei. Ogni punto rappresenta un singolo polimorfismo del nucleotide singolo (SNP) strumentale. Le linee verticali indicano le stime complessive dell'effetto causale ottenute mediante i metodi weighted inverse-variance e MR-Egger. L'asse y rappresenta l'inverso dell'errore standard (1/SE). Cliccare qui per scaricare il file.
Tabella supplementare 1. Polimorfismi del singolo nucleotide strumentali selezionati per l'analisi di randomizzazione mendeliana diretta.
La tabella elenca i polimorfismi del singolo nucleotide (SNP) strumentali utilizzati per l'analisi di randomizzazione mendeliana diretta tra il lupus eritematoso sistemico e il numero di aborti spontanei, inclusi il gene annotato più vicino, il cromosoma, la posizione genomica, l'allele d'effetto, la frequenza dell'allele d'effetto, l'entità dell'effetto (Beta), l'errore standard (SE), il valore P e la statistica F. Le posizioni cromosomiche si basano sull'assemblaggio del genoma di riferimento utilizzato nello studio di associazione su tutto il genoma. La statistica F è stata calcolata come Beta2/SE2. Cliccare qui per scaricare il file.
Tabella supplementare 2. Polimorfismi del singolo nucleotide strumentali selezionati per l'analisi di randomizzazione mendeliana inversa.
La tabella elenca i polimorfismi del singolo nucleotide (SNP) strumentali utilizzati per l'analisi di randomizzazione mendeliana inversa, in cui il numero di aborti spontanei è l'esposizione e il lupus eritematoso sistemico è l'esito, inclusi il gene annotato più vicino, il cromosoma, la posizione genomica, l'allele d'effetto, la frequenza dell'allele d'effetto, l'entità dell'effetto (Beta), l'errore standard (SE), il valore P e la statistica F. Le posizioni cromosomiche si basano sull'assemblaggio del genoma di riferimento utilizzato nello studio di associazione su tutto il genoma. La statistica F è stata calcolata come Beta2/SE2. Cliccare qui per scaricare il file.
Discussione
Mediante un'analisi di MR bidirezionale combinata con analisi bioinformatiche multidimensionali, questo studio ha identificato un'associazione causale positiva tra lupus eritematoso sistemico (SLE) e abortività ricorrente (RPL), eseguendo al contempo una selezione sistematica di biomarcatori trascrittomici condivisi. Per quanto ne sappiamo, questo è il primo studio che integra MR bidirezionale, analisi trascrittomica e analisi di infiltrazione immunitaria per indagare questa relazione. Sebbene l'entità dell'effetto osservata nell'MR fosse modesta (OR IVW = 1,01), l'associazione è stata costantemente supportata da diversi metodi MR complementari e da analisi di sensibilità, senza evidenza di eterogeneità sostanziale, pleiotropia orizzontale o outlier influenti, suggerendo che la relazione osservata è statisticamente robusta ma quantitativamente piccola. Pertanto, i risultati attuali devono essere interpretati come evidenza a sostegno di un modesto contributo genetico dello SLE alla suscettibilità all'RPL, piuttosto che di un ampio effetto clinico. Integrando inferenza causale, convalida trascrittomica e analisi di infiltrazione immunitaria, questo studio fornisce un quadro riproducibile per la priorizzazione di biomarcatori candidati in disturbi riproduttivi complessi mediati dal sistema immunitario. Uno studio condotto in Egitto tra il 2007 e il 2021, che ha incluso 123 donne con SLE e un totale di 201 gravidanze, ha riportato che il 20,4% delle gravidanze in donne con SLE si è concluso con una perdita fetale44. Studi precedenti hanno analogamente suggerito che lo SLE rappresenta un importante fattore di rischio per l'RPL poiché una disregolazione immunitaria può aumentare la probabilità di perdita della gravidanza12.
Le analisi di bioinformatica hanno rivelato che i 59 geni differenzialmente espressi (DEG) condivisi erano principalmente arricchiti in vie metaboliche associate alle risposte immunitarie antivirali, all'adesione cellulare e alla regolazione dell'apoptosi. L'infezione virale potrebbe contribuire alla patogenesi del lupus eritematoso sistemico (SLE). I pazienti con SLE spesso presentano un malfunzionamento sia delle risposte immunitarie innate che di quelle adattative45,46, rendendoli più suscettibili alle infezioni virali. Questa maggiore suscettibilità potrebbe contribuire alla perdita gestazionale attraverso meccanismi come l'infiammazione placentare e il danno alle cellule placentari47. In quanto componente essenziale della placenta, alterazioni nell'autofagia e nel comportamento biologico delle cellule trofoblastiche sono state inoltre associate all'insorgenza dell'abortività ricorrente di primo trimestre (RPL)48,49. Nel complesso, queste osservazioni suggeriscono che la disregolazione immunitaria associata all'SLE potrebbe influenzare l'esito della gravidanza alterando la funzione delle cellule trofoblastiche. Ulteriori analisi hanno identificato IFI27 e CXCL11 come geni centrali candidati condivisi da SLE e RPL. Tuttavia, IFI27 è stato privilegiato per le analisi successive poiché ha dimostrato una maggiore coerenza biologica attraverso dataset indipendenti. Sebbene entrambi i geni fossero stati selezionati dal modello LASSO, solo IFI27 ha mostrato un'espressione differenziale costante sia nel dataset di scoperta che in quelli di validazione esterna, mentre CXCL11 non è stato replicato in modo coerente nei dataset di validazione. Inoltre, IFI27 ha mostrato una migliore capacità discriminatoria diagnostica per la RPL ed è rimasto significativamente deregolato in dataset di sangue e di tessuti riproduttivi. Nel complesso, questi risultati supportano IFI27 come biomarcatore candidato più solido rispetto a CXCL11, anche se è necessaria una ulteriore validazione sperimentale. La validazione effettuata utilizzando il dataset SLE GSE50772 e il dataset RPL GSE198700 ha dimostrato che l'espressione di IFI27 è rimasta costantemente deregolata nei dataset di validazione. In particolare, IFI27 era sovraespresso nei campioni ematici dei pazienti con SLE, in accordo con studi precedenti50, ma era sottoespresso nei campioni di endometrio e di villi coriali dei pazienti con RPL. Questo modello contrastante potrebbe riflettere le differenze tra la disregolazione immunitaria sistemica e l'ambiente immunitario locale all'interfaccia materno-fetale nell'SLE complicato da RPL.
IFI27 è un gene stimolato dall'interferone coinvolto nell'immunità antivirale, nella segnalazione dell'interferone e nelle risposte immunitarie dell'ospite in seguito a infezione virale51,52. Nella gravidanza normale, l'espressione di IFI27 è marcatamente aumentata nelle cellule trofoblastiche53, suggerendo un ruolo fisiologico importante nel mantenimento della funzione trofoblastica. Al contrario, le nostre analisi hanno dimostrato una ridotta espressione di IFI27 nell'endometrio e nei villi coriali di pazienti con abortività ricorrente (RPL). Sebbene questo risultato differisca da alcuni precedenti studi54, va interpretato con cautela poiché il presente studio ha integrato dataset trascrittomici derivati da tessuti diversi piuttosto che da campioni appaiati madre-feto. Una possibile spiegazione è che l'attivazione cronica sistemica del tipo I di interferone nel lupus eritematoso sistemico (SLE) induca una segnalazione interferonica persistente nelle cellule immunitarie circolanti, promuovendo contemporaneamente una desensibilizzazione recettoriale, un'esaurimento immunitario o meccanismi compensatori di feedback negativo all'interfaccia materno-fetale. In alternativa, una regolazione epigenetica specifica del tessuto o differenze nella composizione cellulare tra sangue periferico e tessuti riproduttivi potrebbero sopprimere l'espressione locale di IFI27 nonostante l'attivazione sistemica dell'interferone. Queste ipotesi rimangono speculative e richiedono una validazione meccanicistica mediante l'uso di campioni appaiati di sangue materno, tessuto endometriale e trofoblasti, idealmente a livello singola-cellula, per distinguere i meccanismi regolatori specifici del tessuto e del tipo cellulare55.
L'analisi dell'infiltrazione immunitaria ha indicato differenze significative nei profili delle cellule immunitarie sia nel lupus eritematoso sistemico (SLE) che nell'abortività ricorrente (RPL), caratterizzate principalmente da alterazioni nelle popolazioni correlate ai linfociti T CD4+. L'espressione di IFI27 è risultata positivamente correlata all'arricchimento delle cellule Th2 in entrambe le malattie; tuttavia, questi risultati rappresentano correlazioni computazionali derivate dall'analisi ssGSEA piuttosto che interazioni biologiche verificate sperimentalmente. Studi precedenti hanno mostrato che il sangue periferico di pazienti con SLE contiene proporzioni ridotte di cellule Th1 e Treg ma proporzioni aumentate di cellule Th256,57, risultati che sono in accordo con i nostri dati. Durante una gravidanza normale, l'equilibrio immunitario Th1/Th2 all'interfaccia materno-fetale si sposta verso uno stato dominato da Th258. Pertanto, una ridotta espressione di IFI27 nei tessuti riproduttivi potrebbe riflettere alterazioni nell'omeostasi immunitaria locale associata a un'alterata tolleranza materno-fetale, anche se rimane da determinare sperimentalmente se IFI27 regoli direttamente questo processo.
Diversi limiti devono essere riconosciuti. In primo luogo, sebbene le analisi di MR abbiano supportato un'associazione causale, l'effetto genetico stimato era relativamente piccolo, suggerendo che il LES rappresenti soltanto un componente della patogenesi multifattoriale dell'AR. In secondo luogo, l'integrazione trascrittomica ha incluso dataset generati da diversi tessuti (sangue periferico, endometrio e villi coriali), piattaforme di microarray e coorti indipendenti, il che potrebbe introdurre eterogeneità biologica e tecnica nonostante la validazione coerente di IFI27. In terzo luogo, la coorte di validazione esterna per i villi coriali includeva un numero limitato di campioni, il che potrebbe aver ridotto la potenza statistica e la generalizzabilità. In quarto luogo, poiché i dataset pubblicamente disponibili contenevano informazioni cliniche limitate, fattori importanti, tra cui l'attività della malattia, lo stato degli anticorpi antifosfolipidi, l'esposizione a farmaci, lo stadio della gravidanza e altri covarianti clinici, non sono potuti essere completamente valutati. Infine, sebbene lo screening con PhenoScanner abbia minimizzato il possibile confondimento pleiotropico nelle analisi di MR, non si può escludere del tutto un residuo confondimento.
Da un punto di vista traslazionale, IFI27 dovrebbe attualmente essere considerato un biomarcatore candidato piuttosto che un marcatore diagnostico clinicamente validato. Prima dell'implementazione clinica, sono necessari studi prospettici multicentrici per convalidare le sue prestazioni diagnostiche in popolazioni diverse, stabilire piattaforme analitiche standardizzate e soglie diagnostiche, e determinare in che modo lo stadio della gravidanza, l'attività della malattia e il trattamento immunosoppressivo influenzano l'espressione di IFI27. Esperimenti funzionali, insieme ad analisi di trascrittomica spaziale e trascrittomica a singola cellula, saranno inoltre essenziali per chiarire se IFI27 contribuisca attivamente alla regolazione immunitaria materno-fetale o semplicemente rifletta un'attivazione immunitaria indotta dall'interferone.
Dichiarazioni
Conflitto di interessi:
Gli autori dichiarano di non avere interessi finanziari o non finanziari in conflitto.
Ringraziamenti
Questo lavoro è stato sostenuto dal Progetto Chiave Integrato di Medicina Tradizionale Cinese e Medicina Occidentale per Malattie Gravi e Complesse dell'Amministrazione Municipale di Pechino per la Medicina Tradizionale Cinese (2023BJSZDYNJBXTGG-003), dal Fondo Nazionale di Ricerca Scientifica Pubblica per le Attività di Base di Ricerca degli Istituti (ZZ16-XRZ-038) e dal Progetto di Promozione degli Ospedali di Alta Qualità in Medicina Cinese (HLCMHPP2023087). Le fonti di finanziamento non hanno avuto alcun ruolo nella progettazione dello studio, nella raccolta dei dati, nell'analisi dei dati, nell'interpretazione dei dati, nella preparazione del manoscritto né nella decisione di sottoporre il manoscritto alla pubblicazione. Gli autori ringraziano i ricercatori e i partecipanti dello studio FinnGen, la UK Biobank e il Gene Expression Omnibus (GEO) del National Center for Biotechnology Information per aver reso disponibili pubblicamente i loro set di dati. Gli autori riconoscono inoltre il consorzio FinnGen, che integra campioni provenienti dalle biobanche finlandesi con dati provenienti dai registri sanitari nazionali grazie a collaborazioni tra istituzioni di ricerca finlandesi, biobanche e partner internazionali.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Collezione di 28 firme geniche di cellule immunitarie | Risorsa supplementare pubblicata sulle firme geniche | Elenco supplementare di geni marcatore delle cellule immunitarie descritto da Charoentong et al. (Riferimento 42) | Non applicabile RRID: Non disponibile Scopo / note: Firme delle cellule immunitarie utilizzate per l'analisi ssGSEA. |
| CNSknowall | piattaforma web CNSknowall | File di output di DAVID | Non applicabile RRID: Non disponibile Scopo / note: Visualizzazione dei risultati filtrati dell'arricchimento funzionale. |
| Postazione di lavoro informatica | Ambiente informatico istituzionale | Non applicabile | Non applicabile RRID: Non applicabile Scopo / note: Analisi computazionali. |
| Materiali di consumo | Non applicabile | Non applicabile | Non applicabile RRID: Non applicabile Scopo / note: Nessun materiale di consumo per laboratorio umido è stato utilizzato. |
| Cytoscape | Consorzio Cytoscape | Non applicabile | 3.10.0 RRID: SCR_003032 Scopo / note: Proteina–visualizzazione e analisi della topologia della rete di interazione proteica |
| cytoHubba | Negozio di app Cytoscape | Non applicabile | 0.1 RRID: SCR_017677 Scopo / note: Classificazione dei geni hub mediante MCC, MNC, EPC, Degree, Closeness e Radiality. |
| Strumento di annotazione funzionale DAVID | Istituti Nazionali di Sanità / Istituto Nazionale del Cancro | Elenco di geni differenzialmente espressi (DEG) e liste di geni di background condivisi caricati | 2021 RRID: SCR_001881 Scopo / note: Analisi di arricchimento del Gene Ontology e dei percorsi metabolici KEGG. |
| Pannello di riferimento europeo per il disequilibrio di associazione | Progetto 1000 Genomi / IEU OpenGWAS | Pannello europeo di fase 3 (varianti compatibili con GRCh37) | Fase 3 RRID: Non riportato Scopo / note: Clumping per disequilibrio di associazione mediante il flusso di lavoro OpenGWAS/TwoSampleMR. |
| FinnGen | Consorzio FinnGen | finngen_R11_L12_LUPUS | Rilascio 11 RRID: SCR_022254 Scopo / note: Statistiche riassuntive di studi GWAS per il lupus eritematoso. |
| forestploter | CRAN | Non applicabile | 1.1.2 RRID: Non disponibile Scopo / note: Visualizzazione grafica a foresta delle stime di randomizzazione mendeliana |
| Gene Expression Omnibus (GEO) | Centro Nazionale per l'Informazione sulla Biotecnologia | GSE61635; GSE165004; GSE50772; GSE198700 | Non applicabile RRID: SCR_005012 Scopo / note: Fonte dei set di dati trascrittomici per la scoperta e la validazione. |
| Gene Ontology | Consorzio Gene Ontology | Termini GO accessati tramite DAVID | annotazioni DAVID 2021 RRID: SCR_002811 Scopo / note: Annotazione del processo biologico, della componente cellulare e della funzione molecolare |
| ggcorrplot | CRAN | Non applicabile | 0.1.4.1 RRID: Non disponibile Scopo / note: Visualizzazione del gene candidato–matrici di correlazione delle cellule immunitarie |
| ggplot2 | CRAN | Non applicabile | 3.5.1 RRID: SCR_014601 Scopo / note: Istogrammi a vulcano, diagrammi a scatola e altri grafici statistici. |
| ggvenn | CRAN | Non applicabile | 0.1.16 RRID: SCR_025300 Scopo / note: Visualizzazione dei geni differenzialmente espressi condivisi. |
| glmnet | CRAN | Non applicabile | 4.1-8 RRID: SCR_015505 Scopo / note: Regressione logistica LASSO e validazione incrociata. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Matrice delle serie elaborate RRID: SCR_005012 Scopo / note: Set di dati di scoperta dell'endometrio RPL |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Matrice delle serie elaborate RRID: SCR_005012 Scopo / note: Dataset di validazione indipendente di villi coriali RPL |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Matrice delle serie elaborate RRID: SCR_005012 Scopo / note: Dataset di convalida indipendente di cellule mononucleate del sangue periferico da pazienti con lupus eritematoso sistemico |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Matrice di serie elaborata RRID: SCR_005012 Scopo / note: Dataset scoperta su sangue intero di LES |
| GSEABase | Bioconductor | Non applicabile | 1.66.0 RRID: Non disponibile Scopo / note: Gestione dei set genici delle cellule immunitarie per ssGSEA. |
| GSVA | Bioconductor | Non applicabile | 1.52.3 RRID: SCR_021058 Scopo / note: Analisi di arricchimento di set di geni da singolo campione (ssGSEA). |
| IEU OpenGWAS | Unità di Epidemiologia Integrata MRC | ukb-b-419; finngen_R11_L12_LUPUS | Non applicabile RRID: Non riportato Scopo / note: Recupero di statistiche riassuntive di GWAS e dati armonizzati di associazione genetica. |
| Enciclopedia di Kyoto dei Geni e dei Genomi (KEGG) | Kanehisa Laboratories | Percorsi KEGG accessibili tramite DAVID | annotazioni DAVID 2021 RRID: SCR_012773 Scopo / note: Annotazione dell'arricchimento di percorsi biologici. |
| limma | Bioconductor | Non applicabile | 3.60.6 RRID: SCR_010943 Scopo / note: Analisi dell'espressione differenziale |
| MRPRESSO | Verbanck et al. | Non applicabile | 1 RRID: SCR_023697 Scopo / note: Rilevamento della pleiotropia orizzontale e delle variabili strumentali anomale. |
| pheatmap | CRAN | Non applicabile | 1.0.12 RRID: SCR_016418 Scopo / note: Mappe termiche di espressione. |
| PhenoScanner V2 | PhenoScanner Consortium | Interrogazioni fenotipiche a livello di SNP | Versione 2 RRID: Non disponibile Scopo / note: Selezione delle SNP conservate per possibili associazioni fenotipiche di confondimento. |
| pROC | CRAN | Non applicabile | 1.18.5 RRID: SCR_024286 Scopo / note: Curve ROC, AUC, intervalli di confidenza di DeLong, cutoff dell'indice di Youden e intervalli di confidenza ottenuti con il metodo bootstrap. |
| R | Fondazione R per il Calcolo Statistico | Non applicabile | 4.4.2 RRID: SCR_001905 Scopo / note: Ambiente informatico per l'analisi statistica. |
| Reagenti | Non applicabile | Non applicabile | Non applicabile RRID: Non applicabile Scopo / note: Nessun reagente di laboratorio umido è stato utilizzato. |
| STRING | Consorzio STRING | Homo sapiens (taxon 9606); punteggio minimo di interazione 0,400 | 11 RRID: SCR_005223 Scopo / note: Proteina–costruzione della rete di interazione proteica |
| TwoSampleMR | Unità di Epidemiologia Integrata MRC | Non applicabile | 0.6.6 RRID: SCR_019010 Scopo / note: Randomizzazione mendeliana bidirezionale a due campioni, estrazione dei dati, armonizzazione, stima del rapporto causale e analisi di sensibilità. |
| UK Biobank | UK Biobank | ukb-b-419 | Dataset riassuntivo 2018 RRID: SCR_012815 Scopo / note: Statistiche riassuntive di GWAS per il numero di aborti spontanei |
Riferimenti
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.