Questo articolo studia un algoritmo di ottimizzazione della pianificazione dinamica che integra Transformer e l'apprendimento per rinforzo PPO, concentrandosi sui frequenti conflitti di risorse e sui ritardi di risposta nella pianificazione delle attività sindacali.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Algoritmo di pianificazione dinamica e ottimizzazione delle risorse per le attività sindacali mediante l'integrazione di Transformer e apprendimento per rinforzo
In questo articolo
Sommario
Abstract
Per affrontare il problema della ridotta efficienza organizzativa causato dai frequenti conflitti nell'allocazione delle risorse e dai ritardi nelle risposte di pianificazione nella gestione delle attività sindacali, questo articolo propone un algoritmo di pianificazione dinamica che integra Transformer e PPO (Proximal Policy Optimization). Nell'implementazione specifica, viene innanzitutto progettata una struttura modellistica unificata per gli scenari di pianificazione, in grado di convertire gli stati di attività, personale e risorse in ingressi tensoriali, realizzando così un'integrazione multidimensionale dei vincoli. Successivamente, si utilizza il meccanismo di attenzione multi-testa del Transformer per codificare le serie temporali delle richieste storiche di attività e dello stato delle risorse, estrarre caratteristiche spaziotemporali multidimensionali e potenziare la percezione dei rischi di conflitto. In seguito, sulla base dei risultati della codifica e della rete strategica PPO, vengono generate azioni di pianificazione a partire dallo stato corrente, migliorando l'adattabilità della strategia a ambienti complessi. Infine, grazie al meccanismo di aggiornamento con potatura e alla correzione della funzione di vantaggio, si garantisce la stabilità della strategia durante l'iterazione e si migliora la prestazione di pianificazione. Gli esperimenti hanno mostrato che, con una densità di compiti pari a 1000, il tempo medio di decisione dell'algoritmo di pianificazione è di 0,72 s e il ritardo medio di risposta è di 1,59 s, indicando un'elevata velocità di risposta e un'efficienza decisionale. In sette tipologie e livelli di complessità di attività, il tasso di conflitto delle risorse è compreso tra 0,05 e 0,12; il tasso medio di utilizzo delle risorse è compreso tra 0,75 e 0,86; l'indice di stabilità della pianificazione è compreso tra 0,8 e 0,91, riducendo efficacemente i frequenti conflitti nell'allocazione delle risorse e raggiungendo un'elevata stabilità di pianificazione. In condizioni di alta concorrenza, l'indice di bilanciamento delle risorse e l'indice di robustezza del trasferimento della strategia sono rispettivamente 0,88 e 0,85, indicando una buona adattabilità ai carichi di compiti concorrenti.
Introduzione
Le attività sindacali implicano una pianificazione complessa di molteplici compiti e risorse, richiedendo che il sistema possieda capacità di risposta dinamica efficienti1,2. I requisiti delle attività cambiano frequentemente e la distribuzione del personale e delle risorse relative alle sedi è complessa, il che può facilmente portare a conflitti di pianificazione e spreco di risorse3,4. Catturare con precisione la cronologia delle attività e lo stato attuale delle risorse, oltre a migliorare la capacità di identificare e rispondere ai potenziali conflitti, è fondamentale per aumentare l'efficienza operativa dell'organizzazione5,6. L'integrazione di tecnologie avanzate di modellazione di serie temporali e algoritmi di apprendimento per rinforzo può consentire una comprensione approfondita e un'ottimizzazione intelligente in ambienti di pianificazione complessi, contribuendo a massimizzare l'utilizzo delle risorse, accelerare la reattività della pianificazione e promuovere l'aggiornamento intelligente della gestione delle attività sindacali.
Tuttavia, gli approcci di pianificazione esistenti nella pratica sono in gran parte basati su regole e statici, e non riescono ad adattarsi ai frequenti cambiamenti delle attività e alle fluttuazioni delle risorse, il che spesso comporta tempi di risposta prolungati e gravi conflitti di risorse. Nella pianificazione delle attività sindacali, i tipi di attività sono estremamente diversificati; l'utilizzo delle risorse è fortemente vincolato e cambia frequentemente; e le dipendenze tra le attività e la competizione tra le risorse costituiscono una mappa di pianificazione complessa7,8. Nella pratica, la pianificazione delle attività non può essere efficientemente abbinata alle finestre temporali disponibili delle risorse, come il personale e le sedi9,10, e spesso si verificano conflitti, indebolendo la coerenza complessiva delle operazioni organizzative11,12. Il sistema di pianificazione non si trova di fronte a un singolo obiettivo di ottimizzazione, ma piuttosto a un equilibrio tra indicatori multidimensionali, come la minimizzazione dei conflitti di risorse, la massimizzazione della velocità di risposta, la stabilità della strategia di pianificazione e il tasso di completamento delle attività13,14, che mostrano caratteristiche tipiche di ottimizzazione multi-obiettivo. Inoltre, le attività sindacali presentano fasi e cicli distinti, e le strategie di pianificazione devono adattarsi dinamicamente alle diverse strutture di domanda di risorse nei vari stadi delle attività. Piani statici generati una tantum non possono supportare un ambiente operativo soggetto a cambiamenti ad alta frequenza15,16. La logica di pianificazione esistente non esplora in profondità il comportamento storico delle attività e i modelli di variazione dello stato delle risorse. Non è in grado di fornire previsioni accurate e deduzioni strategiche per il futuro17,18. La strategia di pianificazione del sistema risponde lentamente a compiti improvvisi e a cambiamenti temporanei delle risorse, influenzando la sostenibilità complessiva dell'operazione19,20. La realizzazione di un sistema di pianificazione dotato di prevedibilità, flessibilità e stabilità è diventata una richiesta tecnica fondamentale nelle applicazioni pratiche. Ciò richiede che il modello possieda capacità di percezione dell'informazione ad alta dimensione, memoria sequenziale e migrazione strategica, e mantenga decisioni robuste e un equilibrio delle risorse in un ambiente multi-task, consentendo così una coordinazione intelligente e ottimale della pianificazione delle attività sindacali.
Numerosi studi hanno proposto diverse soluzioni al problema della pianificazione dinamica. Tra queste, la combinazione di apprendimento profondo e apprendimento per rinforzo si è dimostrata particolarmente adattabile e capace di ottimizzazione. Alcuni ricercatori utilizzano l'LSTM (Long Short-Term Memory)21,22 per modellare dati in serie temporale e combinano strategie di apprendimento per rinforzo per ottimizzare il comportamento di pianificazione, ottenendo risultati significativi. Un altro filone di ricerca impiega metodi euristici basati su algoritmi greedy, sottolineando la semplicità ed efficienza delle decisioni di pianificazione, adatti a scenari con regole ben definite23,24. Altri studi hanno esplorato l'applicazione delle reti Q profonde (DQN) alla pianificazione, migliorando le strategie attraverso l'approssimazione della funzione di valore25,26. Tuttavia, questi metodi presentano problemi come una cattura insufficiente delle dipendenze a lungo termine, aggiornamenti instabili delle strategie e notevoli ritardi di risposta quando si trovano ad affrontare scenari complessi e in continua evoluzione, rendendo difficile soddisfare le esigenze di pianificazione in presenza di attività ad alta densità e diversificate. Pertanto, la progettazione di un algoritmo di pianificazione dotato di capacità efficienti di estrazione delle caratteristiche e di aggiornamento stabile delle strategie rappresenta un collo di bottiglia da superare nella ricerca attuale.
Nella ricerca sulla pianificazione multi-dominio, l'architettura Transformer è stata applicata a diverse attività di previsione di serie temporali e di ottimizzazione della pianificazione grazie al suo meccanismo di auto-attenzione multi-testa, che cattura efficacemente le dipendenze temporali a lungo raggio27,28. Quando combinata con l'algoritmo PPO nell'apprendimento per rinforzo, la strategia viene aggiornata in modo stabile ed efficiente mediante il taglio della funzione obiettivo, e questo approccio ha dimostrato buone prestazioni in campi come il controllo robotico e la produzione intelligente29,30,31. Alcuni studi hanno tentato di integrare il Transformer con l'apprendimento per rinforzo per la pianificazione complessa delle risorse32. Tuttavia, nella pianificazione dinamica delle attività sindacali, pochi studi affrontano la combinazione di diversi tipi di attività e vincoli complessi sulle risorse. Alcuni studi hanno utilizzato reti neurali su grafi per modellare la relazione tra risorse e attività, migliorando così l'accuratezza nell'identificazione dei conflitti33,34. Alcuni ricercatori hanno ottimizzato la pianificazione delle risorse basandosi sul calcolo edge per migliorare l'efficienza e le prestazioni del modello35,36. Tuttavia, tali metodi presentano ancora capacità limitate nella modellazione del contesto temporale. Sulla base di ciò, questo articolo propone l'uso di un Transformer per codificare le sequenze storiche degli stati delle attività e delle risorse, combinato con una rete politica PPO, al fine di ottenere un'elevata percezione dei rischi di conflitto e un aggiornamento stabile delle strategie di pianificazione per far fronte alle esigenze di pianificazione mutevoli e complesse delle attività sindacali.
Studi più recenti hanno esplorato l'ottimizzazione della pianificazione delle risorse da diverse prospettive, come la consolidazione delle macchine virtuali per l'efficienza energetica nel cloud computing37, algoritmi di autenticazione nelle reti cellulari38, consolidamento avanzato delle macchine virtuali con migrazione in tempo reale per un cloud computing sostenibile39, ottimizzazione del traffico mediante previsione dell'attesa e algoritmi evolutivi40, e archiviazione cloud basata su blockchain con ottimizzazione avanzata e preservazione dell'integrità41. Sebbene questi lavori offrano spunti preziosi sugli algoritmi di allocazione e ottimizzazione delle risorse, si concentrano principalmente su infrastrutture cloud, sistemi di telecomunicazione o di archiviazione, e non affrontano specificamente i vincoli relativi ad attività di diverso tipo, i conflitti dinamici tra risorse umane e sedi, e le esigenze di pianificazione in tempo reale intrinseche alla gestione delle attività sindacali. Tale differenza sottolinea ulteriormente la necessità di un framework specifico per la pianificazione, progettato appositamente per il contesto organizzativo delle attività sindacali.
I metodi di pianificazione esistenti per le attività sindacali spesso non riescono a cogliere le dipendenze spaziotemporali a lungo termine e a mantenere la stabilità delle politiche di fronte a cambiamenti dinamici, causando tempi di risposta lenti e un elevato numero di conflitti per le risorse. Per colmare queste lacune nella ricerca, nello studio viene proposto un modello di ottimizzazione della pianificazione basato sul principio secondo cui l'attenzione multi-testa del Transformer può codificare efficacemente le sequenze storiche ai fini della previsione dei conflitti, e che l'ottimizzazione della politica prossimale (Proximal Policy Optimization, PPO) con un obiettivo limitato garantisce aggiornamenti della politica stabili e adattivi. In particolare, il Transformer viene applicato per codificare le sequenze di stato delle attività e delle risorse, estrarre caratteristiche spaziotemporali chiave e migliorare la previsione dei conflitti, mentre il PPO viene integrato per generare in modo efficiente le azioni di pianificazione e garantire aggiornamenti stabili. Viene progettata una matrice unificata di vincoli per mappare attività, personale e sedi, migliorando il riconoscimento delle dipendenze complesse. Le principali innovazioni di questo lavoro includono: (1) l'integrazione della codifica temporale e dell'apprendimento per rinforzo specificamente per la pianificazione delle attività sindacali; (2) un meccanismo di attenzione consapevole dei conflitti che dà priorità alla percezione del rischio; e (3) un aggiornamento con potatura e correzione della funzione di vantaggio per garantire la robustezza della strategia in condizioni di elevata concorrenza. Ampi esperimenti condotti in scenari con diverse densità e complessità di compiti confermano il vantaggio del modello rispetto ai metodi esistenti in termini di velocità di risposta, utilizzo delle risorse e stabilità, fornendo una soluzione intelligente, pratica e scalabile per la gestione della pianificazione delle attività sindacali.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Figura 1 mostra la struttura di un sistema di pianificazione delle attività sindacali che integra modellazione di serie temporali e apprendimento per rinforzo. Il livello di input integra gli orari delle attività, la disponibilità delle risorse e le informazioni sulle finestre temporali del personale, costruendo una matrice multidimensionale di relazioni di conflitto tra compiti e risorse tramite il modulo del grafo dei vincoli. Il transformer esegue una codifica con attenzione multi-testa sulla sequenza storica degli stati delle attività e delle risorse, producendo stati nascosti con dipendenze temporali. Il modulo della politica utilizza i risultati della codifica per generare distribuzioni di azioni e stime di stato, ed esegue le decisioni di pianificazione dopo il campionamento delle azioni. I risultati dell'esecuzione vengono restituiti all'ambiente, aggiornando lo stato delle risorse e generando ricompense immediate. Su questa base, il modulo di ottimizzazione costruisce una funzione obiettivo con limitazione, valuta la funzione di vantaggio e corregge la stima della rete dei valori per limitare la deriva della politica e garantire aggiornamenti stabili dei comportamenti di pianificazione. Un ciclo chiuso di dati si forma tra i moduli per raggiungere una percezione altamente sensibile dei conflitti di risorse e aggiornamenti adattivi delle strategie in ambienti dinamici, migliorando così la capacità di risposta intelligente e l'efficienza nell'allocazione delle risorse del sistema di pianificazione delle attività sindacali in scenari con più compiti e forti vincoli.
Modellizzazione dello scenario per la pianificazione delle attività sindacali
Tutte le richieste di attività nel sistema di pianificazione sono organizzate in sequenze distinte in base a intervalli temporali discreti. Ogni attività è definita con orari di inizio e fine chiari, categorie di risorse, fasi e livelli di priorità. Lo stato di utilizzo del sito è modellato come una matrice bidimensionale di intervalli temporali, in cui l'asse orizzontale rappresenta l'unità temporale standardizzata e l'asse verticale rappresenta il numero della risorsa spaziale. Lo stato delle risorse è indicato come disponibile o occupato, formando una mappa iniziale di distribuzione delle risorse con una struttura statica. Le informazioni sulla pianificazione del personale sono espandibili nella dimensione tempo-identità per costruire un vettore temporale continuo, ciascuno dei quali registra lo stato di occupazione/riposo del personale e il numero del dipartimento. Tutte le informazioni di ingresso sono integrate in una struttura tensoriale tridimensionale, in cui denota l'intervallo temporale discreto, denota il numero di entità delle risorse e denota il codice dell'attributo di utilizzo della risorsa corrispondente (ad esempio, se è occupata, il numero dell'attività, la priorità d'uso, ecc.). Questa struttura consente al sistema di pianificazione di leggere la configurazione delle risorse in qualsiasi momento, garantendo una rappresentazione unificata dei diversi tipi di stato delle risorse.
Dopo che le informazioni sul compito vengono associate al modello, il vettore di intensità del compito viene impostato in base alla priorità dell'attività e al periodo di utilizzo della risorsa. Le combinazioni di compiti che potrebbero causare conflitti vengono contrassegnate mediante il metodo di rilevamento dell'overlap delle finestre temporali. Le combinazioni in conflitto vengono convertite in insiemi di nodi, e vengono costruiti insiemi di archi in base ai tipi e ai periodi di risorse condivise, per rappresentare esplicitamente le dipendenze implicite. Il grafo dei compiti così ottenuto contiene informazioni sui vincoli di sequenza temporale, sovrapposizione delle risorse o conflitti, fornendo una base strutturale per il successivo rilevamento dei conflitti e la generazione di strategie di pianificazione. Questa struttura mantiene la natura dinamica della pianificazione dei compiti e i cambiamenti continui dello stato delle risorse, supportando la percezione in tempo reale delle variazioni nei vincoli di pianificazione.
Il rilevamento dei conflitti utilizza le regioni sovrapposte sparse delle dimensioni temporali e delle risorse nella struttura tensoriale come condizioni iniziali per la valutazione. Implementa un'elaborazione di codifica statica delle relazioni per coppie di attività con obiettivi di pianificazione sovrapposti. Costruisce una struttura a grafo G=(V,E,C), in cui V rappresenta l'insieme dei nodi attivi, E rappresenta i collegamenti generati in base ai conflitti di risorsa e C è la matrice di codifica dei pesi di conflitto per i collegamenti. La funzione di peso del conflitto è definita nella seguente forma:
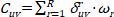 (1)
Tra questi, Cuv è il peso del conflitto tra le attività u e v; u, v sono gli indici delle attività; R è il numero totale di tipi di risorse; δuvr ∈ {0,1} indica se le finestre temporali delle attività u e v si sovrappongono sulla risorsa r; ωr è il peso della sensibilità al conflitto della risorsa r. Questa funzione esegue una somma pesata delle intensità di conflitto, tenendo conto delle differenze nell'importanza dei conflitti di risorsa sui risultati della pianificazione, mantenendo al contempo un'espressione quantificabile della distribuzione dell'intensità del conflitto.
La struttura del grafo dei conflitti sopra descritta viene convertita in una matrice dei vincoli attraverso una rappresentazione a matrice sparsa. Ogni elemento della matrice contiene il grado di conflitto tra le risorse. La matrice è integrata nel processo decisionale di pianificazione per determinare se le attività possono essere programmate in parallelo, mentre la logica di protezione delle azioni è presente nella rete delle politiche. Per gestire l'aggregazione periodica delle attività e i picchi ad alta densità di attività, viene implementato un meccanismo di aggiornamento dinamico che monitora i cambiamenti nello stato delle attività e modifica in tempo reale il contenuto della matrice man mano che le risorse vengono rilasciate o aggiunte, garantendo la continuità e la coerenza del vincolo di pianificazione durante l'evoluzione delle attività.
L'applicazione di questa struttura di grafo dei conflitti consente al sistema di pianificazione di modellare visivamente i potenziali colli di bottiglia delle risorse e i modelli di sovrapposizione dei compiti, migliorando così l'efficienza dell'analisi di disaccoppiamento della rete decisionale in scenari di vincoli complessi. Il comportamento della pianificazione non si basa più sull'abbinamento logico basato su regole, ma cerca il percorso ottimale nello spazio dei vincoli, potenziando la capacità di bilanciare dinamicamente i conflitti locali di risorse con la mappa globale dei compiti. Il sistema può mantenere la stabilità della pianificazione e la coerenza dei compiti in un ambiente in cui le risorse fluttuano e i compiti vengono aggiunti o rimossi frequentemente.
Figura 2 mostra un diagramma della struttura della rete basato sulla relazione ponderata del conflitto tra attività. Ogni nodo della figura rappresenta un'attività da pianificare, e le linee tra i nodi indicano conflitti nell'utilizzo delle risorse. Lo spessore del collegamento riflette l'intensità del conflitto: maggiore è la gravità del conflitto, più spessa è la linea. Il calcolo del peso integra l'overlapping delle risorse e combina la sensibilità al conflitto di diverse risorse per formare un'intensità composita di conflitto tra le attività. La struttura del grafo rivela che alcune attività formano aree densamente connesse, indicando una significativa competizione per l'utilizzo delle risorse. Questo fenomeno di aggregazione locale dei conflitti costituisce la causa principale di colli di bottiglia nelle risorse e ritardi nelle attività durante il processo di pianificazione, e l'algoritmo di scheduling può di conseguenza definire obiettivi prioritari di mediazione. La disposizione dei nodi adotta una strategia di layout basata su forze direzionate, che aggrega automaticamente le attività ad alto conflitto, consentendo al sistema di pianificazione di identificare gruppi chiave di attività e ottimizzare la distribuzione delle strategie, migliorando così la coerenza complessiva dello scheduling e la coordinazione delle risorse.
Codifica della sequenza degli stati storici
Sulla base del grafo dei conflitti costruito e della matrice dei vincoli, il passo successivo consiste nell'codificare le sequenze storiche di attività e gli stati delle risorse, in modo da poter estrarre i modelli temporali sottostanti a questi vincoli per le successive decisioni. Le informazioni fondamentali nello scenario di pianificazione comprendono richieste di attività, cambiamenti dello stato delle risorse e registrazioni del feedback sulle attività. Queste informazioni costituiscono molteplici serie temporali eterogenee, corrispondenti ad attributi quali istanti temporali degli eventi, identificatori di utilizzo delle risorse e stato di esecuzione delle attività. Per unificare la struttura di elaborazione, ciascun tipo di ingresso viene codificato come una sequenza vettoriale di uguale lunghezza, e viene stabilito un indice temporale unificato per garantire l'allineamento degli stati sotto sincronizzazione temporale. L'unità di ingresso in ogni istante è rappresentata dalla concatenazione di tre insiemi di vettori caratteristici: il vettore caratteristico dell'attività rappresenta il tipo di attività, la priorità e il numero di fase; il vettore caratteristico della risorsa registra l'occupazione attuale della risorsa, la capacità residua e la posizione della finestra disponibile; il vettore caratteristico del feedback descrive se l'attività è stata eseguita regolarmente nel momento precedente e se si è verificato un conflitto di risorse o un ritardo.
Tutte le caratteristiche vengono trasformate linearmente e mappate nello stesso spazio dimensionale per ottenere una matrice di embedding standardizzata X ∈ ℝT×d, dove T rappresenta il numero di passi temporali e d è la dimensione unificata dell'embedding. Per preservare la struttura temporale, la matrice di ingresso viene sommata elemento per elemento alla matrice di codifica della posizione P per formare l'ingresso consapevole della posizione:
Z = X + P (2)
Z è la sequenza di input finale, che funge da input per il successivo meccanismo di attenzione. La progettazione della codifica della posizione utilizza un modello fisso di funzioni seno e coseno per evitare perdite di informazioni future e garantire che i vincoli causali siano rigorosamente rispettati durante la codifica. La struttura sopra descritta consente al modello di percepire contemporaneamente le caratteristiche del compito, lo stato delle risorse e la posizione temporale. Dispone di una base di memoria di stato completa, fornendo una struttura unificata ad alta risoluzione per il successivo meccanismo di attenzione.
Il modulo di attenzione elabora la sequenza in ingresso per catturare le possibili relazioni tra più passi temporali. Vengono utilizzati più gruppi di testine di attenzione per elaborare la sequenza separatamente, aumentando la sensibilità del modello a diversi tipi di percorsi di evoluzione dello stato. Ogni testina di attenzione genera una matrice di query Q, una matrice di chiavi K e una matrice di valori V a partire dalla sequenza in ingresso, calcola la matrice di distribuzione dei pesi e genera una rappresentazione pesata. L'output di un'attenzione con singola testina è:
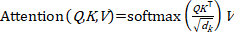 (3)
dk è il numero di dimensioni delle caratteristiche per ogni testa. In questa formula, QK⊤ rappresenta la similarità tra istanti temporali, √dk viene utilizzato per garantire la stabilità numerica e la funzione softmax assicura la normalizzazione dei pesi. Diverse teste di attenzione si concentrano su diverse combinazioni di passi temporali e le dipendenze dinamiche che catturano sono anch'esse diverse, contribuendo a rivelare regole implicite come precursori dei conflitti di attività, schemi di consumo delle risorse e tendenze anomale nei feedback.
Tutti gli output delle testine di attenzione vengono concatenati e passati attraverso un livello di trasformazione lineare per generare una sequenza codificata unificata, che funge da ingresso di stato per la rete di generazione della strategia di pianificazione. Questa sequenza incorpora la traiettoria del comportamento del compito, le caratteristiche delle variazioni delle risorse e l'impatto delle deviazioni precedenti nell'esecuzione all'interno della finestra di pianificazione corrente, affrontando efficacemente il problema dell'elevata dipendenza storica nel comportamento di pianificazione e della scarsa espressività delle caratteristiche. Moduli di connessione residua e normalizzazione del livello sono integrati nel livello di output della codifica per migliorare la stabilità dell'addestramento e le capacità di conservazione dell'espressione della rete profonda.
La sequenza degli stati nascosti in uscita non solo conserva le informazioni sull'evoluzione temporale, ma risponde anche ai cambiamenti derivanti da compiti improvvisi o da temporanee incoerenze nelle risorse, dimostrando una forte adattabilità. Questa progettazione strutturale evita la definizione esplicita di regole, permette una modellizzazione strutturata di ambienti di pianificazione dinamici e supporta i moduli di politica successivi nella generazione di soluzioni di pianificazione con coerenza globale e adattabilità locale in condizioni multi-obiettivo.
Generazione di strategie di pianificazione dinamica
Le sequenze di stati nascosti codificate, che incorporano sia le dipendenze temporali sia le informazioni sui conflitti di risorse, vengono quindi inserite nella rete della politica per generare azioni di pianificazione adattate all'ambiente corrente. La sequenza di stati nascosti prodotta dal modulo di codifica viene utilizzata come ingresso per la rete della strategia di pianificazione. L'insieme dei vettori di stato in ogni istante costituisce l'espressione corrente dell'osservazione dell'ambiente, comprendendo l'evoluzione delle caratteristiche del compito, le tendenze nell'uso delle risorse e le traiettorie del feedback storico. La dimensione della rappresentazione dello stato e la lunghezza della finestra temporale sono fisse, e la continuità dei cambiamenti di stato viene catturata attraverso un meccanismo di aggiornamento scorrevole. Prima che il vettore di stato venga inviato alla rete della politica, viene normalizzato e riorganizzato nelle caratteristiche, in modo da garantire che l'ingresso mantenga una distribuzione numerica stabile nello spazio ad alta dimensione, riducendo così l'esplosione del gradiente e le fluttuazioni nella convergenza.
La struttura della rete di politica adotta un modulo di uscita a doppio ramo, in cui un ramo genera la distribuzione delle azioni e l'altro produce la stima della funzione di valore di stato. Lo spazio delle azioni comprende tutti i compiti pianificabili e le risorse allocabili. Il meccanismo di selezione dei candidati filtra le combinazioni illegali o ridondanti di operazioni per formare un insieme limitato di azioni valide. Il ramo della politica produce una distribuzione di probabilità π(at|st), dove at rappresenta l'azione di pianificazione al passo temporale considerato e st è l'ingresso dello stato attuale. Viene utilizzata una strategia di campionamento gaussiano standardizzato o di campionamento softmax per selezionare le azioni dalla distribuzione ai fini della pianificazione effettiva. L'altro output è la stima della funzione di valore di stato, che rappresenta l'aspettativa di ricompensa a lungo termine nello stato dato ed è utilizzata per la valutazione e l'aggiornamento della politica.
Nella rete di politica, il livello nascosto applica funzioni di attivazione e normalizzazione del batch per migliorare l'espressività non lineare e accelerare la convergenza della rete. Nel processo decisionale, la priorità di esecuzione, il costo di pianificazione delle risorse e le prestazioni storiche di diverse attività sono considerati fattori di attenzione e applicati al meccanismo di selezione delle azioni tramite una specifica matrice di pesi, formando così un quadro di uscita della politica adattivamente regolabile. Questa progettazione evita la dipendenza da regole fisse, aumentando così la flessibilità della strategia nel gestire conflitti improvvisi e colli di bottiglia strutturali.
La strategia di pianificazione utilizza un meccanismo di campionamento casuale per generare la sequenza effettiva delle azioni. In ogni ciclo di pianificazione, un'azione eseguibile viene campionata dalla distribuzione corrente delle azioni, e lo stato delle risorse e il marcatore del nodo di attività vengono aggiornati. Dopo l'esecuzione dell'azione, il sistema calcola la ricompensa immediata in base ai cambiamenti delle risorse e ai risultati del progresso dell'attività, per misurare l'impatto di questo ciclo di pianificazione sull'obiettivo complessivo. La progettazione della ricompensa considera molteplici dimensioni, tra cui il tasso di completamento delle attività, l'efficienza nell'utilizzo delle risorse e il grado di soppressione dei conflitti. Tali informazioni vengono fornite al modulo di aggiornamento della strategia attraverso indicatori complessivi.
L'intero processo di pianificazione costruisce una catena di decisione markoviana e utilizza il metodo di campionamento empirico delle traiettorie per registrare la sequenza stato-azione-ricompensa, indicata come (st, at, rt, st+1). L'ottimizzazione della strategia si basa sulla costruzione della funzione di vantaggio, in cui la stima del vantaggio è definita nella seguente forma:
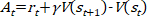 (4)
At rappresenta il valore del vantaggio, rt è la ricompensa istantanea corrente, γ è il fattore di sconto della ricompensa, mentre V(st) e V(st+1) sono rispettivamente gli output della funzione di valore di stato negli stati attuale e successivo. La funzione di vantaggio riflette il grado di superiorità dell'azione corrente rispetto alla prestazione media della strategia. Viene utilizzata per guidare il successivo miglioramento della strategia. Se At > 0, significa che l'azione corrente è migliore della previsione media e la sua probabilità dovrebbe essere aumentata; altrimenti, la sua propensione alla selezione dovrebbe essere ridotta.
Durante il processo di aggiornamento della strategia, per evitare oscillazioni causate da ampiezze eccessive di aggiornamento, viene applicato un meccanismo di troncamento della distribuzione obiettivo per limitare l'intervallo di variazione tra le nuove e le vecchie strategie, mantenendo così la continuità e la stabilità dell'output della rete. Viene stabilito un forte accoppiamento tra la distribuzione delle azioni e la ricompensa di feedback, consentendo alla strategia di reagire immediatamente ai cambiamenti nei vincoli complessi. Questo meccanismo mantiene la stabilità del processo decisionale e una pianificazione razionale delle risorse in situazioni in cui i compiti cambiano frequentemente o si verificano improvvisi squilibri di risorse, evitando efficacemente problemi come allocazioni duplicate, congestione delle risorse o accumulo nelle code dei compiti. Il sistema di pianificazione può mantenere uno stato operativo migliore in presenza di diverse densità di compiti e carenze di risorse, dimostrando forti capacità adattative.
Iterazione della strategia e meccanismo di aggiornamento stabile
Per garantire che le strategie di pianificazione generate rimangano stabili e non si degradino nel corso di ripetuti cicli di addestramento, in questo paragrafo viene introdotto un meccanismo di aggiornamento iterativo con limitazione (clipping) e correzione del vantaggio. L'intervallo di aggiornamento del troncamento tra le vecchie e le nuove strategie viene impostato, e la funzione obiettivo di limitazione (clipping) è utilizzata per contenere la deriva strategica, prevenendo così shock di pianificazione durante il processo di aggiornamento della strategia. La rete di valutazione viene corretta in combinazione con la funzione di vantaggio, al fine di migliorare l'accuratezza della pianificazione a lungo termine.
La distribuzione di probabilità dell'output delle azioni della rete politica è soggetta a forti fluttuazioni durante le iterazioni continue di pianificazione, il che può portare a un comportamento instabile o a un'allocazione disordinata delle risorse. Per attenuare lo shock di pianificazione causato dalla deriva della politica, viene progettato un intervallo di aggiornamento troncato per controllare l'entità del cambiamento tra le politiche nuova e vecchia, e viene costruito un termine di restrizione per affinare la funzione obiettivo. La probabilità della politica storica viene registrata nel ciclo di campionamento, e il termine di rapporto viene costruito utilizzando la probabilità della politica corrente. L'obiettivo di aggiornamento della politica è definito come:
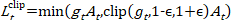 (5)
Qui, gt = πθ(at|st)/πθold(at|st) indica il rapporto di probabilità tra le nuove e le vecchie politiche; ε è la soglia di ritaglio che delimita l'intervallo di aggiornamento della politica. Quando il rapporto supera il limite, si utilizza invece il valore di ritaglio per impedire alla strategia di produrre gradienti eccessivi a partire da campioni estremi, assicurando che l'aggiustamento dei parametri della rete rimanga entro l'intervallo prestabilito. Questa struttura limita dinamicamente l'intervallo di variazione della strategia in uscita per ogni ciclo di pianificazione, mantenendo la regolarità e la coerenza dell'output strategico in presenza di distribuzioni dense di attività e riducendo significativamente la frequenza di oscillazione del comportamento di pianificazione.
La funzione obiettivo della politica viene arricchita con termini di regolarizzazione e di ricompensa per l'entropia durante il processo di aggiornamento, al fine di aumentare la diversità della distribuzione delle azioni e prevenire una convergenza precoce. Ogni ciclo di aggiornamento della politica utilizza più batch di campioni di traiettorie di esperienza per l'addestramento iterativo, mantenendo così un'ampia copertura dello spazio degli stati. Quando la distribuzione di probabilità della sequenza di azioni in uscita viene confrontata prima e dopo l'aggiornamento, si calcola il tasso di deviazione della distribuzione, e una soglia fissa filtra l'intervallo accettabile di perturbazione della politica. Questo meccanismo fornisce un controllo dei limiti per la migrazione delle politiche di scheduling tra cicli, sopprimendo così l'overfitting causato da cambiamenti bruschi nello stato delle risorse.
Gli aggiornamenti della strategia si basano sulla valutazione dello stato fornita dalla funzione di valore. Le deviazioni nella stima del valore dello stato possono influenzare direttamente la correttezza della funzione di vantaggio, alterando così la direzione dell'iterazione della strategia. Per migliorare l'accuratezza della valutazione, viene costruito un meccanismo di retrospettiva multiseriale, e il valore cumulativo scontato delle ricompense future viene utilizzato per correggere il valore dello stato corrente. La ricompensa retrospettiva adotta la struttura della Stima Generalizzata del Vantaggio (Generalized Advantage Estimation, GAE), definita come:
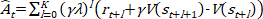 (6)
Ât è il valore corretto del vantaggio; λ è il coefficiente di bilanciamento del backtracking; rt+l rappresenta la ricompensa immediata del passo (t+l)-esimo; V(st+l) è il valore di stato prodotto dalla rete di valutazione. Questa struttura integra feedback immediati a breve termine e aspettative di stato a lungo termine per correggere le deviazioni nelle previsioni di risposta della strategia in caso di futuri conflitti di risorse, carichi di picco e accumulo di attività. λ controlla la profondità del backtracking e si aggiusta automaticamente durante periodi di forti fluttuazioni dinamiche delle risorse, migliorando la robustezza della risposta della rete di valutazione a eventi improvvisi.
La struttura multiscala dipendente dal tempo incorporata nella funzione di vantaggio consente alla rete di valutazione di modellare tendenze a lungo termine delle risorse. Nel rilevamento della deviazione dell'output della politica, l'indice di coerenza del comportamento della politica viene utilizzato per valutare se la rete manifesta una risposta eccessiva all'errore di valutazione. I termini residui della differenza di retroazione monitorano il comportamento dell'aggiornamento della politica, e l'obiettivo di addestramento e l'ampiezza dell'aggiornamento dei pesi della funzione di valore vengono corretti dinamicamente. La rete di valutazione e la rete della politica vengono ottimizzate congiuntamente per garantire che la stima del valore non si discosti dall'obiettivo di completamento del compito, prevenendo al contempo che la pianificazione ad alta frequenza possa fraintendere lo stato di conflitto delle risorse.
Questo meccanismo di aggiornamento della politica stabile può mantenere efficacemente la controllabilità e la coerenza degli aggiornamenti del comportamento della politica in un ambiente dinamico di compiti ad alta dimensionalità, migliorando l'efficienza della copertura dei compiti e la flessibilità nell'utilizzo delle risorse, e formando una struttura intelligente di pianificazione continuamente iterativa. Il comportamento di pianificazione evita di cadere in ottimalità locali durante l'evoluzione a lungo termine e potenzia l'adattabilità complessiva ai cambiamenti nei modelli di compito e alle fluttuazioni nei cicli di risorse.
Figura 3A mostra l'andamento del valore della funzione obiettivo in funzione del numero di iterazioni di addestramento in condizioni diverse di soglia di troncamento. L'asse orizzontale rappresenta il numero di iterazioni di addestramento, mentre l'asse verticale indica il valore numerico della funzione obiettivo troncata. Il parametro ε è impostato a 0,1, 0,2 e 0,3, rappresentando diversi livelli di intensità nel controllo della deriva della strategia. La curva corrispondente a un valore di ε più piccolo presenta oscillazioni ridotte e la funzione obiettivo rimane stabile. Quando ε = 0,1, il valore complessivo della funzione obiettivo si attesta tra 0,8 e 1, evidenziando la gradualità e la stabilità dell'aggiornamento della strategia. Tuttavia, un valore maggiore di ε provoca fluttuazioni più marcate. Quando ε = 0,3, il valore complessivo della funzione obiettivo varia tra 0,65 e 0,95, e la curva della funzione obiettivo mostra un'ampiezza di oscillazione maggiore, riflettendo il rischio di deviazioni significative nel processo di aggiornamento della strategia. Minore è la soglia, maggiore è la stabilità della strategia, il che la rende adatta ad ambienti di pianificazione ad alta restrizione. Figura 3B mostra le variazioni della stima del vantaggio generalizzato in funzione di diversi coefficienti di bilanciamento del backtracking. Il parametro λ è impostato rispettivamente a 0,8, 0,9 e 1,0, per controllare la profondità del backtracking delle ricompense future. La curva mostra che all'aumentare di λ, le fluttuazioni del GAE diminuiscono, la tendenza a lungo termine risulta più regolare e viene catturato con maggiore precisione l'impatto potenziale del comportamento di pianificazione dopo diversi passaggi. La curva con λ pari a 0,8 presenta fluttuazioni periodiche marcate, indicando una maggiore sensibilità alle ricompense immediate e una maggiore adattabilità a compiti a breve termine e improvvisi. Al contrario, un valore di λ pari a 1,0 si concentra maggiormente sulla modellazione della tendenza a lungo termine ed è più adatto a scenari con compiti periodici.
Analisi della complessità computazionale e della scalabilità
La complessità computazionale del framework Transformer-PPO proposto è determinata da due componenti principali: l'encoder Transformer e l'ottimizzazione della politica PPO.
Per l'encoder Transformer con L strati, H testine di attenzione, dimensione dell'embedding d e lunghezza della sequenza in ingresso T (la finestra temporale storica), la complessità temporale per passata in avanti è O(L·T2·d + L·T·d2), dove il termine T2 deriva dal meccanismo di auto-attenzione. Nell'implementazione, L = 3, H = 4, d = 128 e T è fissato a 100 passi temporali, il che comporta un sovraccarico computazionale gestibile. Per finestre storiche più lunghe, il termine quadratico T2 diventa il fattore dominante; tuttavia, nella pratica, la pianificazione delle attività sindacali coinvolge tipicamente orizzonti storici finiti (ad esempio finestre mobili trimestrali o annuali) e la risoluzione del passo temporale può essere regolata per bilanciare accuratezza ed efficienza.
Per il componente PPO, la rete di politica e la rete di valore sono MLP leggere (256 e 128 neuroni per strato nascosto), la cui complessità di inferenza è O(d·m), dove m rappresenta il numero di unità nascoste, trascurabile rispetto al codificatore Transformer. L'aggiornamento della politica durante l'addestramento prevede più epoche di aggiornamenti del gradiente su mini-batch, con complessità O(B·E·d2), dove B è la dimensione del batch e E è il numero di epoche di aggiornamento.
Per quanto riguarda la scalabilità, il framework presenta tre proprietà favorevoli. In primo luogo, il meccanismo di attenzione può essere parallelizzato lungo i passi temporali, consentendo un'efficiente accelerazione tramite GPU. In secondo luogo, le dimensioni del modello sono indipendenti dal numero di attività o risorse, poiché la matrice dei vincoli viene costruita dinamicamente ad ogni passo di pianificazione anziché essere incorporata come parametri fissi. Ciò consente di utilizzare lo stesso modello addestrato su insiemi di diverse dimensioni senza doverlo riaddestrare. In terzo luogo, per scenari di scala estremamente elevata, è possibile ridurre la lunghezza della finestra storica T e la dimensione dell'embedding d come compromesso, oppure adottare la variante con attenzione sparsa per ridurre la complessità da O(T2) a O(T log T) oppure a O(T).
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Dati sperimentali
Per valutare in modo esaustivo le prestazioni dell'algoritmo di pianificazione dinamica Transformer-PPO presentato in questo articolo, l'esperimento utilizza dati di gestione delle attività provenienti da un'ampia organizzazione aziendale relativi agli ultimi tre anni come dataset di riferimento. Questo dataset contiene oltre 5.000 registrazioni di attività, comprendenti diverse tipologie, tra cui riunioni, formazione e intrattenimento, con informazioni di pianificazione relative a ...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
I risultati sperimentali dimostrano che l'algoritmo proposto Transformer-PPO supera costantemente i metodi di riferimento (LSTM-PPO, ricerca greedy e DQN) in tutti i parametri di valutazione. Le prestazioni superiori possono essere attribuite a due fattori chiave. In primo luogo, il meccanismo di auto-attenzione multi-testa del Transformer cattura efficacemente le dipendenze temporali a lungo raggio nelle sequenze di attività e di stato delle risorse, consentendo l'individuazione proattiva di potenziali conflitti. Questo...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi finanziari.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Linguaggio di programmazione principale |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Framework per l'apprendimento profondo (implementazione Transformer/PPO) |
| NumPy 1.23 | Sviluppatori di NumPy | https://numpy.org/doc/stable/release/1.23.0-notes.html | Libreria per il calcolo numerico |
| Matplotlib 3.5 | Squadra di sviluppo di Matplotlib | https://matplotlib.org/stable/users/installing.html | Visualizzazione dei risultati |
| Dataset di pianificazione delle attività sindacali | Database interno di un'azienda collaboratrice (anonimizzato) | Non disponibile pubblicamente a causa di un accordo di riservatezza; i ricercatori possono contattare l'autore corrispondente per ottenere l'accesso | Oltre 5.000 record di attività (riunioni, formazione, intrattenimento) provenienti da un sindacato aziendale di grandi dimensioni su un periodo di tre anni |
| NVIDIA A100 GPU | |||
| PyTorch |
Riferimenti
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.