Questo studio analizza biomarcatori di elettroencefalografia per distinguere tra malattia di Alzheimer, demenza frontotemporale e controlli sani. Modelli di Random Forest basati su caratteristiche di root mean square, densità spettrale di potenza ed entropia sono stati interpretati mediante intelligenza artificiale spiegabile e analisi dell'effect size. L'eliminazione delle caratteristiche di entropia con basso impatto ha migliorato le prestazioni di classificazione, raggiungendo un'accuratezza del 94% nel test.
Articolo di ricerca
Fusione di biomarcatori elettroencefalografici multidominio per la classificazione della demenza basata sull'apprendimento automatico
In questo articolo
Sommario
Abstract
L'elettroencefalografia (EEG) è stata studiata come approccio non invasivo per caratterizzare l'attività cerebrale in condizioni neurodegenerative. Questo studio ha valutato se biomarcatori EEG multicanale potessero distinguere tra malattia di Alzheimer (AD), demenza frontotemporale (FTD) e controlli sani (HC). Il dataset pubblicamente disponibile conteneva registrazioni EEG a riposo, a occhi chiusi, di 88 partecipanti, inclusi 36 con AD, 23 con FTD e 29 controlli sani. Sono stati estratti biomarcatori EEG multicanale e caratteristiche demografiche per la classificazione mediante apprendimento automatico. Le caratteristiche derivate dall'EEG includevano la radice quadrata della media dei quadrati (RMS), la densità spettrale di potenza (PSD) e misure di entropia. È stato addestrato un classificatore Random Forest utilizzando l'insieme combinato di caratteristiche e interpretato mediante intelligenza artificiale spiegabile. Sono state eseguite analisi di stabilità delle caratteristiche e dell'effetto dimensionale di Cohen per valutare il contributo delle caratteristiche, seguite da un'analisi di ablazione. Le caratteristiche basate sull'entropia hanno mostrato il contributo più basso alla classificazione. Il modello completo multicanale ha raggiunto un'accuratezza di addestramento del 96% e un'accuratezza di test del 92%. Dopo la rimozione delle caratteristiche di entropia, l'accuratezza di test è aumentata al 94%. Questi risultati descrivono le prestazioni di classificazione delle caratteristiche EEG multicanale e demografiche selezionate all'interno del framework Random Forest.
Introduzione
La malattia di Alzheimer (AD) è una condizione neurologica progressiva associata al deterioramento delle funzioni cognitive e motorie. La sua prevalenza aumenta notevolmente con l'età e la demenza rappresenta una causa importante di morbosità e mortalità negli adulti anziani1,2,3,4,5. Poiché la diagnosi e la classificazione della malattia rimangono difficili, è stata condotta un'analisi dei segnali cerebrali al fine di caratterizzare i cambiamenti neurofisiologici associati alla demenza.
L'elettroencefalografia (EEG) è un metodo non invasivo per registrare l'attività elettrica del cervello ed è stata studiata nella malattia di Alzheimer e in altri disturbi neurologici6,7,8,9,10,11. I segnali EEG riflettono i potenziali elettrici generati dall'attività neuronale e vengono registrati in modo non invasivo da diverse posizioni del cuoio capelluto12,13,14. L'attività cerebrale viene comunemente caratterizzata mediante bande di frequenza delta, theta, alpha, beta e gamma15. La malattia di Alzheimer è stata associata a un rallentamento dell'EEG, ridotta complessità del segnale e alterata sincronizzazione16. Analisi spettrali hanno riportato un aumento dell'attività delta e theta, insieme a una riduzione dell'attività alpha e beta, in individui con AD rispetto ai controlli sani17,18,19. Studi precedenti di classificazione dell'EEG hanno riportato elevate prestazioni nel distinguere la AD dai controlli sani (HC) e la demenza frontotemporale (FTD) dai controlli sani. Al contrario, la discriminazione tra AD e FTD è generalmente risultata più complessa10,11.
I metodi di apprendimento automatico sono stati utilizzati per identificare schemi nei segnali EEG associati a malattie neurologiche20,21. L'estrazione di caratteristiche è quindi un componente importante della classificazione basata sull'EEG. Studi precedenti hanno analizzato caratteristiche spettrali, temporali, di complessità e di connettività funzionale in combinazione con modelli di apprendimento automatico3,15,22,23. Le caratteristiche spettrali sono particolarmente rilevanti perché quantificano le variazioni dipendenti dalla frequenza dell'attività cerebrale, inclusa la riduzione dell'attività alfa e l'aumento dell'attività theta riportate nell'AD23,24,25,26.
Diversi studi basati sull'EEG hanno valutato diverse combinazioni di caratteristiche, classificatori e strategie di validazione. L'analisi basata sulla connettività è stata utilizzata per distinguere tra AD, FTD e HC, con prestazioni di classificazione riportate che variano a seconda del confronto e della procedura di selezione delle caratteristiche27. Caratteristiche basate sulla trasformata di Fourier sono state anch'esse valutate per differenziare AD, lieve deterioramento cognitivo (MCI) e controlli sani, sebbene le limitazioni includessero un preprocessing limitato e un possibile overfitting associato alla strategia di validazione28. Misure non lineari della complessità dell'EEG hanno mostrato un potenziale discriminante per la classificazione dell'AD, con alcune che raggiungono un'elevata accuratezza, sensibilità e specificità, sebbene la loro applicabilità al MCI e alla discriminazione dello stadio della malattia rimanga limitata21.
Sono stati inoltre studiati metodi di apprendimento profondo basati su rappresentazioni temporali e spettrali dell'EEG per la classificazione multiclasse di AD, MCI e HC29. Sebbene siano stati riportati risultati di classificazione elevati, le limitazioni includono coorti ridotte o selezionate, squilibrio tra le classi, gravità eterogenea della malattia, mancanza di validazione esterna e ridotta interpretabilità del modello29. Anche la strategia di validazione rappresenta un aspetto metodologico importante. Approcci indipendenti dai partecipanti hanno dimostrato che la classica cross-validation a livello di epoche può sovrastimare le prestazioni quando epoche dello stesso partecipante compaiono sia nel set di addestramento che in quello di test30. Tale limitazione è particolarmente rilevante quando si confrontano risultati di classificazione tra studi che utilizzano schemi di validazione diversi.
Le misure di complessità e connettività sono state inoltre valutate mediante classificatori a vettori di supporto, mostrando la connettività basata sulla fase e l'entropia multiscala livelli variabili di prestazioni discriminative31,32. Altri studi che utilizzano caratteristiche derivate dalla trasformata di Fourier e dalla wavelet hanno riportato prestazioni variabili nei confronti tra AD, MCI e HC, con la classificazione multiclasse che in generale risulta più difficile rispetto alla classificazione binaria14. Approcci basati su entropia e sincronia hanno inoltre dimostrato la capacità di discriminare tra gruppi con AD e gruppi di controllo, sebbene le caratteristiche della popolazione di controllo possano influenzare l'entità dell'effetto osservato2.
Lo studio attuale valuta un insieme di caratteristiche multilivello comprendente la radice quadrata della media dei quadrati (RMS), la densità spettrale di potenza (PSD) e misure di entropia estratte dalle bande di frequenza dell'EEG, insieme all'età come variabile demografica. L'RMS rappresenta l'ampiezza del segnale all'interno di ciascuna banda di frequenza, mentre la PSD rappresenta la potenza nel dominio della frequenza. L'entropia è inclusa come misura della complessità del segnale. Queste caratteristiche forniscono descrizioni complementari dell'attività EEG e vengono valutate mediante un classificatore Random Forest. Lo studio analizza inoltre l'importanza delle caratteristiche, la loro stabilità, l'intelligenza artificiale interpretabile e l'analisi dell'effetto dimensionale per valutare il contributo relativo delle caratteristiche estratte. Lo studio attuale indaga l'efficacia di caratteristiche EEG multilivello, incluse misure basate su spettri, tempo e complessità, nel distinguere tra malattia di Alzheimer (AD), demenza frontotemporale (FTD) e soggetti controlli sani (HC) mediante l'apprendimento automatico. Esamina inoltre quali caratteristiche delle bande di frequenza EEG contribuiscono maggiormente alla classificazione quando si utilizzano misure di densità spettrale di potenza (PSD), radice quadrata della media dei quadrati (RMS) ed entropia. Inoltre, lo studio confronta i contributi delle caratteristiche basate sulla potenza, tra cui PSD e RMS, con quelli delle caratteristiche basate sull'entropia e valuta il contributo dell'età al modello di classificazione.
Protocollo
Una panoramica schematica del flusso di lavoro di pre-elaborazione dell'EEG, estrazione delle caratteristiche e classificazione è mostrata nella Figura 1. I materiali e il software utilizzati nello studio sono elencati nella Tabella dei materiali.
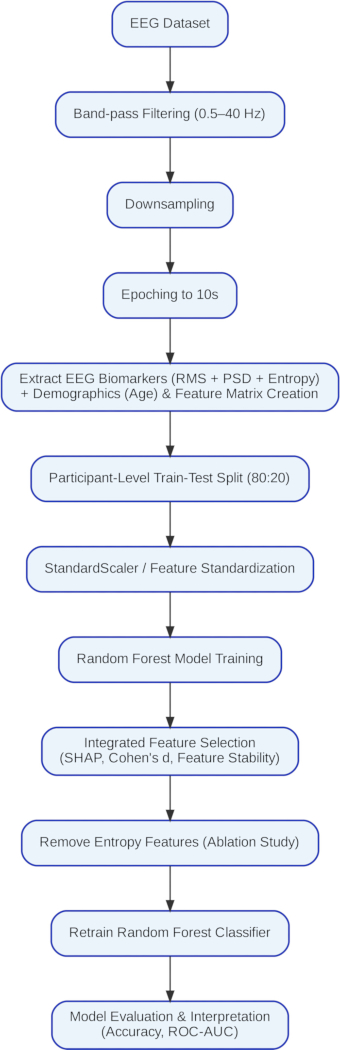
Figura 1: Flusso di lavoro della procedura di pre-elaborazione, estrazione delle caratteristiche e classificazione dell'EEG. Schema riassuntivo del flusso di lavoro dello studio, che include verifica dei dati EEG, filtraggio passa-banda e riferimento, estrazione delle caratteristiche di root mean square (RMS), densità spettrale di potenza (PSD) ed entropia, aggiunta dell'età, suddivisione in dati di addestramento e test, sviluppo del modello Random Forest, analisi della stabilità delle caratteristiche, analisi SHAP, analisi dell'effetto dimensionale di Cohen’s d, selezione integrata delle caratteristiche, ablazione delle caratteristiche di entropia, riaddestramento del modello e valutazione delle prestazioni. Cliccare qui per visualizzare una versione ingrandita di questa figura.
1. Acquisizione dei dati
Il set di dati EEG a riposo disponibile pubblicamente è stato ottenuto dal repository OpenNeuro (dataset ds004504, versione 1.0.9)33. Sono stati verificati i codici identificativi dei partecipanti e le informazioni demografiche. Il set di dati comprendeva 88 partecipanti, di cui 36 con malattia di Alzheimer (AD), 23 con demenza frontotemporale (FTD) e 29 controlli sani (HC).
2. Importazione della registrazione EEG
Per ogni partecipante, la registrazione EEG è stata caricata utilizzando la libreria MNE-Python. Ogni file EEG è stato verificato per confermare che fosse accessibile, potesse essere importato correttamente e contenesse un identificatore valido del partecipante. Le registrazioni con file mancanti o danneggiati sono state escluse. La frequenza di campionamento originale dell'EEG di 500 Hz è stata mantenuta in questa fase. I segnali sono stati sottocampionati per ridurre il carico computazionale preservando tutte le informazioni EEG clinicamente rilevanti per questo studio.
3. Filtraggio passa-banda
Le registrazioni EEG continue sono state filtrate utilizzando un filtro passa-banda del quarto ordine con una frequenza di taglio inferiore di 0,5 Hz e una frequenza di taglio superiore di 40 Hz.
4. Riferimento medio comune ed epoche
È stato applicato il riferimento medio comune (CAR) alle registrazioni EEG filtrate. In ogni campione temporale, è stato calcolato il segnale medio su tutti i canali EEG disponibili e sottratto da ciascun canale. I segnali EEG riferiti sono stati conservati per le analisi successive. Ogni registrazione EEG riferita è stata suddivisa in epoche di durata fissa utilizzando la funzione make_fixed_length_epochs() in MNE-Python. È stata utilizzata una durata dell'epoca di 10 s con sovrapposizione di 0 s.
5. Convalida delle epoche
Per ogni partecipante, sono state mantenute solo le epoche complete di 10 s. Ogni segmento EEG residuo più breve di 10 s alla fine di una registrazione è stato scartato. Ogni epoca mantenuta è stata successivamente utilizzata come campione singolo per l'estrazione delle caratteristiche.
6. Preparazione delle caratteristiche
Sebbene i dati del Mini-Mental State Examination (MMSE) fossero disponibili nel set di dati originale, sono stati esclusi dall'analisi attuale. Le caratteristiche estratte dall'EEG sono state unite alle informazioni demografiche dei partecipanti, inclusi l'età e le etichette diagnostiche, ottenute dal file di metadati participants.csv. L'identificatore del partecipante è stato utilizzato come chiave comune, e sono stati mantenuti solo i partecipanti con registrazioni delle caratteristiche EEG e le corrispondenti informazioni demografiche.
La matrice multidominio delle caratteristiche includeva cinque parametri di root mean square (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms e gamma_rms), cinque parametri di densità spettrale di potenza (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd e gamma_psd) e cinque parametri di entropia (delta_entropy, theta_entropy, alpha_entropy, beta_entropy e gamma_entropy). L'età è stata inclusa come variabile demografica complementare. Poiché le distribuzioni di età possono differire tra i gruppi diagnostici, non è stato possibile escludere completamente un confondimento demografico. Il gruppo diagnostico, definito come AD, HC o FTD, è stato assegnato come etichetta obiettivo.
7. Preelaborazione dei dati e suddivisione in training e test
Durante la preelaborazione, le registrazioni sono state sottocampionate da 500 Hz a 250 Hz per ridurre i requisiti computazionali mantenendo al contempo le informazioni sulle frequenze EEG di interesse.
Il dataset è stato suddiviso in sottoinsiemi di addestramento (80%) e di test (20%) a livello di soggetto, utilizzando una strategia di suddivisione raggruppata. Le previsioni a livello di soggetto sono state successivamente ottenute mediante voto maggioritario sui singoli intervalli temporali (epoch) predetti appartenenti a ciascun partecipante. La valutazione principale ha utilizzato una suddivisione train-test raggruppata a livello di soggetto, al fine di evitare che intervalli temporali dello stesso partecipante fossero presenti in entrambi i sottoinsiemi. Le previsioni a livello di soggetto sono state ottenute applicando il voto maggioritario sugli intervalli temporali predetti appartenenti a ciascun partecipante. Il dataset è stato esaminato alla ricerca di valori mancanti, e le osservazioni mancanti sono state rimosse o imputate secondo necessità. I label diagnostici sono stati codificati. Un StandardScaler è stato addestrato sui dati di training e successivamente applicato sia al dataset di addestramento che a quello di test.
8. Sviluppo del modello di foresta casuale
Un classificatore di foresta casuale è stato inizializzato utilizzando 80 alberi, una profondità massima dell'albero di 10, un massimo di quattro caratteristiche, un minimo di cinque campioni per foglia e un valore di randomizzazione pari a 42. Il classificatore è stato addestrato utilizzando il set di dati di addestramento standardizzato.
9. Valutazione del modello
Sono state previste le etichette delle classi sia per il set di dati di addestramento che per quello di test. È stata costruita una matrice di confusione e sono stati calcolati accuratezza, precisione, richiamo e punteggio F1 insieme al report di classificazione. Sono state registrate le accuratezze di addestramento e di test.
Per la valutazione per partecipante, assicurarsi che tutte le epoche di un determinato partecipante siano assegnate esclusivamente al sottoinsieme di addestramento o a quello di test. Il classificatore Random Forest è stato addestrato utilizzando gli stessi iperparametri dell'analisi primaria.
10. Validazione incrociata
Come procedura aggiuntiva di valutazione del modello, è stata eseguita una validazione incrociata stratificata a cinque ripetizioni utilizzando shuffle = True e random_state = 30. Sono stati calcolati la precisione media e la deviazione standard su cinque suddivisioni. Questa analisi è stata considerata separatamente rispetto alla valutazione primaria con campione trattenuto a livello di soggetto.
11. Analisi della stabilità delle caratteristiche
La stabilità delle caratteristiche è stata valutata ripetendo l'addestramento della foresta casuale 10 volte utilizzando semi casuali compresi tra 0 e 9. Per ogni esecuzione, sono stati registrati l'accuratezza nel test e i punteggi di importanza delle caratteristiche. Sono stati calcolati la media e la deviazione standard del punteggio di importanza delle caratteristiche per ogni predittore su tutte le 10 esecuzioni, e i predittori sono stati ordinati in base alla loro stabilità. Questa analisi è stata utilizzata per valutare la coerenza dei ranghi delle caratteristiche piuttosto che per sostituire la valutazione principale a livello di soggetto.
12. Analisi di intelligenza artificiale interpretabile
È stato applicato l'analizzatore SHAP TreeExplainer al modello Random Forest addestrato. I valori SHAP sono stati calcolati per stimare il contributo di ciascuna caratteristica alle previsioni del modello. Il valore assoluto medio di SHAP è stato calcolato per ogni caratteristica, e le caratteristiche sono state ordinate in base ai loro contributi SHAP. Sono state identificate le caratteristiche con valori SHAP costantemente bassi e confrontate con i risultati delle analisi di stabilità delle caratteristiche e di Cohen’s d. Le caratteristiche che mostravano contributi costantemente ridotti sono state selezionate per l'ablazione successiva e il riaddestramento del modello.
13. Analisi dell'entità dell'effetto statistico
È stato calcolato il valore d di Cohen per ciascun biomarcatore EEG nei confronti tra AD versus HC, AD versus FTD e FTD versus HC. L'entità degli effetti è stata interpretata utilizzando soglie pari a 0,20 per un effetto piccolo, 0,50 per un effetto medio e 0,80 per un effetto grande.
14. Selezione integrata delle caratteristiche
Sono stati confrontati i risultati dell'analisi dell'importanza delle caratteristiche mediante Random Forest, dell'analisi SHAP e dell'analisi di Cohen’s d. I predittori che hanno mostrato in modo costante un'importanza ridotta, un basso contributo SHAP e dimensioni dell'effetto piccole sono stati identificati come candidati per l'eliminazione.
15. Ablazione delle caratteristiche
Le caratteristiche di entropia sono state valutate mediante un'analisi esplorativa di ablazione, e una matrice ridotta di caratteristiche contenente RMS, PSD ed età è stata costruita. Il classificatore Random Forest è stato rieseguito con gli stessi iperparametri. L'addestramento del modello, la verifica, la validazione incrociata e l'analisi della curva operativa del ricevitore (ROC) sono stati ripetuti utilizzando l'insieme ridotto di caratteristiche.
16. Analisi ROC
Le probabilità delle classi sono state ottenute dal classificatore Random Forest ottimizzato. Le curve ROC multiclasse sono state generate utilizzando una strategia one-versus-rest. Sono stati calcolati i valori dell'area sotto la curva (AUC) specifici per classe e l'AUC medio.
17. Confronto delle prestazioni
Le prestazioni del modello completo di caratteristiche sono state confrontate con quelle del modello ridotto di caratteristiche ottenuto dopo l'ablazione delle caratteristiche in base all'entropia.
Risultati
Il modello Random Forest ha raggiunto un'accuratezza del 96% nel training e del 92% nel testing. Lo score F1 macro-medio è stato del 92%, mentre lo score F1 medio pesato è stato anch'esso del 92%, indicando una prestazione comparabile tra le tre classi, mentre lo score F1 medio pesato è stato anch'esso del 92%. La prestazione nella classificazione è stata più alta per la classe della malattia di Alzheimer (AD), mentre la classe della demenza frontotemporale (FTD) ha mostrato prestazioni relativamente inferiori, come presentato nella Tabella 1.
L'analisi della caratteristica operativa del ricevitore (ROC) è stata utilizzata per valutare la separazione delle classi attraverso diverse soglie di classificazione. Come mostrato in Figura 2, l'area sotto la curva ROC (AUC) ha superato 0,98 per tutte e tre le classi, indicando un'elevata separabilità tra i gruppi di AD, FTD e controllo sano (HC).
È stata eseguita un'analisi SHAP utilizzando TreeExplainer per valutare il contributo delle caratteristiche al modello di classificazione Random Forest. Il grafico a barre riassuntivo in Figura 3 ha mostrato il contributo relativo della densità spettrale di potenza (PSD), della radice quadrata media (RMS), dell'entropia e delle caratteristiche demografiche. Le caratteristiche con valori SHAP assoluti più elevati hanno contribuito in modo più significativo alle previsioni del modello, mentre le caratteristiche legate all'entropia hanno mostrato contributi relativamente bassi.
L'analisi di stabilità delle caratteristiche è stata eseguita ripetendo l'addestramento della foresta casuale (Random Forest) utilizzando i semi casuali specificati. Per ogni esecuzione sono stati registrati l'accuratezza nel test e i punteggi di importanza delle caratteristiche, calcolando quindi la media e la deviazione standard dell'importanza delle caratteristiche. In questa analisi, il modello ha raggiunto un'accuratezza media nella classificazione del 95%, con una deviazione standard dello 0,17%. Queste esecuzioni ripetute sono state utilizzate principalmente per valutare la coerenza dei ranghi delle caratteristiche e sono state considerate separatamente rispetto alla valutazione principale con dati trattenuti a livello di soggetto. L'età si è posizionata in alto nell'analisi di stabilità delle caratteristiche, come mostrato nella Tabella 2. Anche le caratteristiche theta_psd e theta_rms si sono posizionate in alto, mentre alpha_psd, alpha_rms, beta_psd e beta_rms hanno mostrato un'importanza moderata.
È stato calcolato il valore d di Cohen per valutare l'entità delle differenze tra i gruppi, come presentato nella Tabella 3. L'attenuazione nella banda alfa (alpha_rms, d = 0.97; alpha_psd, d = 0.87) e l'aumento dell'attività theta (theta_rms, d = 0.72) hanno mostrato le differenze maggiori riportate tra partecipanti con AD e controlli sani. Questi risultati erano coerenti con il rallentamento corticale riportato negli studi EEG sulla demenza34. Le caratteristiche basate sull'entropia hanno mostrato ampiezze di effetto relativamente più piccole. I confronti tra AD e FTD hanno prodotto prevalentemente ampiezze di effetto da piccole a moderate.
Le caratteristiche della banda alfa hanno mostrato ampie dimensioni dell'effetto nei confronti AD-versus-HC e FTD-versus-HC. Per AD versus HC, le dimensioni dell'effetto riportate sono state -0,87 per alpha_psd e -0,97 per alpha_rms. Per FTD versus HC, l'attenuazione della banda alfa è stata -0,73. La caratteristica theta_psd ha mostrato una dimensione dell'effetto di 0,61 per AD versus HC, mentre theta_rms ha mostrato una dimensione dell'effetto di 0,72. Differenze più piccole sono state osservate per AD versus FTD.
Le caratteristiche della banda beta hanno mostrato prevalentemente dimensioni dell'effetto di gruppo da piccole a moderate. Le dimensioni dell'effetto per beta_psd sono state di −0,35 per AD versus HC e di −0,41 per AD versus FTD, mentre beta_rms ha mostrato per lo più effetti piccoli. Le caratteristiche della banda gamma hanno mostrato effetti moderati in alcuni confronti. La dimensione dell'effetto per gamma_psd è stata di 0,47 per FTD versus HC e di 0,20 per AD versus HC, mentre gamma_rms ha mostrato una dimensione dell'effetto di 0,50 per FTD versus HC.
Il PSD Delta e il RMS hanno mostrato piccoli effetti positivi per AD versus HC (0,29 e 0,34, rispettivamente) e per FTD versus HC (0,25 e 0,25, rispettivamente). Le dimensioni dell'effetto per AD versus FTD erano prossime a zero. L'entropia Delta ha mostrato piccole dimensioni dell'effetto in tutti e tre i confronti (0,08, 0,20 e −0,11).
Le analisi di stabilità delle caratteristiche, SHAP e dell'entità dell'effetto hanno indicato contributi relativamente bassi da parte delle caratteristiche di entropia. Di conseguenza, è stata eseguita un'analisi di ablazione escludendo le caratteristiche di entropia e mantenendo RMS, PSD e l'età. Dopo l'ablazione delle caratteristiche, il modello Random Forest ha raggiunto un'accuratezza del 96% nel training e del 94% nel testing. Questo risultato è stato interpretato come un confronto esplorativo all'interno del framework valutato di selezione delle caratteristiche. Precisione, richiamo, punteggio F1 e supporto per le classi AD, HC e FTD sono riportati in Tabella 4.
Le prestazioni prima e dopo l'ablazione della caratteristica entropia sono confrontate nella Tabella 5. L'accuratezza nei test è aumentata dal 92% al 94% dopo la rimozione dell'entropia. Le variazioni per classe sono riportate nella Tabella 6. Per FTD, la precisione è aumentata del 4% e il punteggio F1 del 2%. Il richiamo per il gruppo HC è aumentato del 4%, mentre la precisione è diminuita del 2%. Le misure di prestazione macro-media e media pesata sono aumentate di circa l'1%–2% a seguito dell'ablazione della caratteristica.
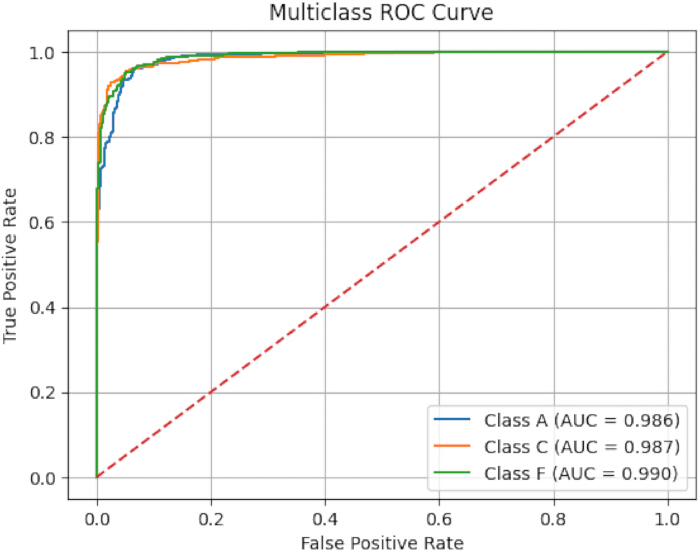
Figura 2Curve ROC per la malattia di Alzheimer, la demenza frontotemporale e i controlli sani. Curve ROC multiclasse generate utilizzando il metodo one-contro-strategia a riposo per la malattia di Alzheimer (classe A), la demenza frontotemporale (classe F) e i controlli sani (classe C). L'area sotto la curva (AUC) è stata calcolata per ciascuna classe. Cliccare qui per visualizzare una versione ingrandita di questa figura.
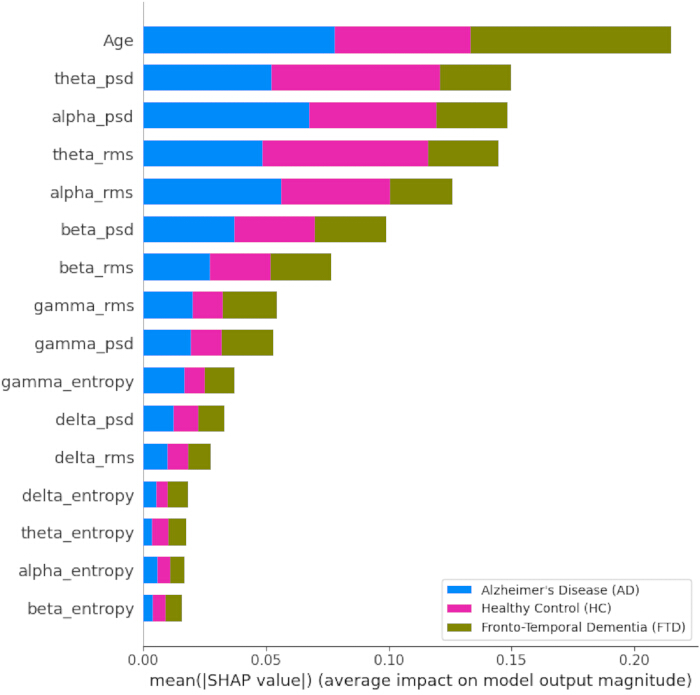
Figura 3: Analisi riassuntiva SHAP del modello Random Forest addestrato. Grafico a barre riassuntivo che mostra il contributo relativo delle caratteristiche derivate dall'EEG e delle caratteristiche demografiche al modello di classificazione Random Forest. I valori medi assoluti di SHAP sono stati utilizzati per ordinare i contributi delle caratteristiche relative alla radice quadrata della media dei quadrati (RMS), alla densità spettrale di potenza (PSD), all'entropia e all'età. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Precisione | Recupero | Punteggio F1 | Supporto | |
| Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Controllo | 0.93 | 0.92 | 0.93 | 480 |
| Demenza Frontotemporale | 0.93 | 0.87 | 0.9 | 314 |
| Media macro | 0.93 | 0.92 | 0.92 | 1373 |
| Media pesata | 0.93 | 0.92 | 0.92 | 1373 |
Tabella 1: Resoconto di classificazione sui dati di test. Precisione, richiamo, punteggio F1 e supporto per le classi relativa alla malattia di Alzheimer, controllo sano e demenza frontotemporale nel set di dati di test, insieme alle misure di prestazione medie globali e medie pesate.
| Caratteristica | Media | Deviazione standard |
| Età | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tabella 2: Classificazione della stabilità delle caratteristiche nel modello Random Forest. Valori medi dell'importanza delle caratteristiche e relativa variabilità ottenuti da ripetuti addestramenti del modello Random Forest utilizzando semi casuali compresi tra 0 e 9. Le caratteristiche sono state ordinate in base alla loro stabilità tra le diverse esecuzioni.
| Caratteristica | AD vs. HC | AD vs. FTD | FTD vs. HC |
| PSD Delta | 0.293 | -0.069 | 0.253 |
| PSD Theta | 0.612 | 0.23 | 0.355 |
| PSD Alpha | -0.869 | -0.219 | -0.64 |
| PSD Beta | -0.352 | -0.408 | 0.201 |
| PSD Gamma | 0.201 | -0.326 | 0.468 |
| Entropia Delta | 0.081 | 0.199 | -0.111 |
| Entropia Theta | 0.208 | 0.033 | 0.163 |
| Entropia Alpha | -0.061 | 0.071 | -0.137 |
| Entropia Beta | -0.37 | -0.042 | -0.332 |
| Entropia Gamma | -0.338 | 0.047 | -0.391 |
| RMS Delta | 0.342 | 0.041 | 0.251 |
| RMS Theta | 0.718 | 0.354 | 0.318 |
| RMS Alpha | -0.977 | -0.205 | -0.73 |
| RMS Beta | -0.494 | -0.365 | 0.015 |
| RMS Gamma | 0.187 | -0.33 | 0.5 |
Tabella 3: Confronto delle dimensioni dell'effetto di Cohen’s d tra i gruppi diagnostici. Valori di Cohen’s d per i biomarcatori EEG nei confronti tra malattia di Alzheimer versus controllo sano, malattia di Alzheimer versus demenza frontotemporale, e demenza frontotemporale versus controllo sano.
| Precisione | Recupero | Punteggio F1 | Supporto | |
| Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Controllo | 0.91 | 0.96 | 0.94 | 480 |
| Demenza Frontotemporale | 0.97 | 0.89 | 0.92 | 314 |
| Media macro | 0.94 | 0.93 | 0.93 | 1373 |
| Media pesata | 0.94 | 0.94 | 0.94 | 1373 |
Tabella 4: Resoconto di classificazione dopo l'eliminazione delle caratteristiche. Precisione, richiamo, punteggio F1 e supporto per le classi malattia di Alzheimer, controllo sano e demenza frontotemporale dopo la rimozione delle caratteristiche di entropia e il riaddestramento del modello Random Forest.
| Metrica | Prima dell'ablazione | Dopo l'ablazione | Variazione |
| Precisione nell'addestramento | 0.96 | 0.96 | 0% di variazione |
| Precisione nei test | 0.92 | 0.94 | +2% di miglioramento |
| Precisione Macro | 0.93 | 0.94 | +1% di miglioramento |
| Richiamo Macro | 0.92 | 0.93 | +1% di miglioramento |
| Punteggio F1 Macro | 0.92 | 0.93 | +1% di miglioramento |
| Precisione pesata | 0.93 | 0.94 | +1% di miglioramento |
| Richiamo pesato | 0.92 | 0.94 | +2% di miglioramento |
| Punteggio F1 pesato | 0.92 | 0.94 | +2% di miglioramento |
Tabella 5: Confronto delle prestazioni prima e dopo l'ablazione delle caratteristiche. Confronto delle metriche di prestazione del modello per l'insieme completo di caratteristiche multido-minio e l'insieme ridotto di caratteristiche ottenuto dopo la rimozione delle caratteristiche relative all'entropia.
DISPONIBILITÀ DEI DATI:
Il dataset CSV elaborato utilizzato per lo sviluppo e l'analisi del modello è fornito come File Supplementare 1. Il codice per la pre-elaborazione è disponibile in un notebook Python all'indirizzo https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, mentre il codice per la costruzione del modello e l'analisi è disponibile all'indirizzo https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. Il dataset CSV elaborato può inoltre essere rigenerato utilizzando il codice di pre-elaborazione fornito
| Classe | Metrica | Prima | Dopo | Variazione |
| Alzheimer | Precisione | 0.92 | 0.94 | 0.02 |
| Sensibilità | 0.95 | 0.95 | Nessuna variazione | |
| Punteggio F1 | 0.94 | 0.94 | Nessuna variazione | |
| Controllo | Precisione | 0.93 | 0.91 | −2% |
| Sensibilità | 0.92 | 0.96 | 0.04 | |
| Punteggio F1 | 0.93 | 0.94 | 0.01 | |
| FTD | Precisione | 0.93 | 0.97 | 0.04 |
| Sensibilità | 0.87 | 0.89 | 0.02 | |
| Punteggio F1 | 0.9 | 0.92 | 0.02 |
Tabella 6: Variazioni delle prestazioni per classe prima e dopo l'ablazione delle caratteristiche. Variazioni nella precisione, nel richiamo e nel punteggio F1 per le classi malattia di Alzheimer, controllo sano e demenza frontotemporale a seguito della rimozione delle caratteristiche di entropia.
File supplementare 1: Dataset elaborato di caratteristiche EEG a livello di epoca utilizzato per lo sviluppo e l'analisi del modello. Clicca qui per scaricare questo file.
Discussione
Il classificatore Random Forest è stato utilizzato per classificare i campioni di elettroencefalografia (EEG) nei gruppi di malattia di Alzheimer (AD), demenza frontotemporale (FTD) e controllo sano (HC), utilizzando caratteristiche multidominio, tra cui la densità spettrale di potenza (PSD), il valore efficace (RMS) e le misure di entropia. L'età è stata inclusa come variabile demografica complementare. Poiché le distribuzioni di età potrebbero differire tra i gruppi diagnostici, non è stato possibile escludere completamente un confondimento demografico, e quindi le prestazioni riportate riflettevano il contributo combinato di informazioni demografiche ed elettrofisiologiche. L'analisi ha esaminato la capacità delle caratteristiche EEG multidominio di discriminare tra i gruppi AD, FTD e HC, valutando il contributo delle caratteristiche delle bande delta, theta, alpha, beta e gamma alla classificazione35. Le analisi sulla stabilità delle caratteristiche e sull'entità dell'effetto hanno indicato che le caratteristiche basate sulla potenza, tra cui PSD e RMS, contribuivano in misura maggiore rispetto alle caratteristiche basate sull'entropia. I biomarcatori EEG estratti riflettevano inoltre schemi associati al rallentamento dei ritmi e alla riduzione dell'attività alpha.
Studi precedenti hanno valutato caratteristiche dell'EEG basate sull'entropia, sulla PSD e sul valore efficace (RMS) utilizzando diversi approcci di apprendimento automatico2,14,27,28,36,37. L'entropia era stata utilizzata per caratterizzare la complessità e l'irregolarità dell'EEG, mentre la PSD era stata impiegata per quantificare le caratteristiche spettrali2,14,27,28,36. Il valore efficace (RMS) era stato inoltre valutato come caratteristica relativa alle bande di frequenza37. Utilizzando lo stesso insieme di dati sottostante, lavori precedenti avevano applicato una classificazione binaria basata sulla PSD con validazione leave-one-subject-out33. L'analisi attuale invece combina RMS, entropia e PSD attraverso le bande alfa, beta, gamma, theta e delta all'interno di un framework di classificazione multiclasse. Un trasformatore leggero per l'EEG è stato valutato sullo stesso dataset utilizzando una strategia di classificazione binaria leave-one-subject-out. Un trasformatore leggero per l'EEG valutato sullo stesso dataset mediante una strategia di classificazione binaria leave-one-subject-out ha riportato un'accuratezza dell'83,28%. Il confronto numerico diretto con i risultati attuali va interpretato con cautela poiché il compito di classificazione e le procedure di validazione differivano38.
Le caratteristiche della banda alfa hanno mostrato gli effetti maggiori nel differenziare l'AD dall'HC e la FTD dall'HC, e un aumento dell'attività theta ha contribuito anche alla differenziazione dell'AD dall'HC. Le caratteristiche della banda beta hanno mostrato effetti minori tra i gruppi, mentre le caratteristiche basate sull'entropia hanno mostrato una capacità discriminatoria relativamente limitata. Le caratteristiche della banda gamma hanno mostrato effetti moderati in alcuni confronti, inclusa la FTD versus HC. Studi precedenti hanno riportato una riduzione della potenza alfa e alterazioni dell'attività theta nell'AD e in confronti diagnostici correlati23,25,39. L'entropia è stata inoltre descritta come un possibile biomarcatore informativo nelle malattie neurodegenerative36, indicando che il suo contributo potrebbe variare in base al dataset, alla definizione delle caratteristiche e all'approccio analitico.
Le macchine a vettori di supporto sono state utilizzate frequentemente in precedenti studi di classificazione dell'EEG3,21,24,37. Il classificatore Random Forest utilizzato nell'analisi attuale ha fornito stime sull'importanza delle caratteristiche ed è stato applicabile all'insieme strutturato di caratteristiche impiegato in questo studio40,41. Sono state ottenute accuratezze di training e di test pari al 96% e al 94%, rispettivamente, dopo l'eliminazione delle caratteristiche di entropia. La rimozione delle caratteristiche di entropia è stata associata a un miglioramento delle prestazioni del modello, confermando il minore contributo relativo osservato per queste caratteristiche nelle analisi di stabilità, SHAP e di dimensione dell'effetto. Sono state applicate anche approcci basati sul deep learning e sui transformer alla classificazione dell'EEG, sebbene tali approcci richiedano generalmente set di dati più ampi e siano progettati per rappresentazioni ad alta dimensionalità o sequenziali27,39,42,43,44,45.
I segnali EEG sono rumorosi e non stazionari, e modelli basati su alberi d'insieme possono offrire robustezza nell'analisi di rappresentazioni strutturate di caratteristiche. Nello studio attuale, RMS, PSD, entropia ed età sono stati valutati come input complementari per il modello Random Forest. L'RMS rappresentava l'ampiezza del segnale all'interno delle bande di frequenza, la PSD rappresentava la potenza spettrale e l'entropia rappresentava la complessità del segnale. I risultati hanno indicato che PSD e RMS hanno contribuito in misura maggiore rispetto all'entropia alla classificazione all'interno del framework valutato. L'età ha inoltre contribuito al modello, sebbene la sua inclusione abbia introdotto la possibilità di un confondimento demografico. Indagini future potrebbero valutare ulteriori variabili demografiche e approcci alternativi di machine learning o deep learning su dataset più ampi, al fine di valutare ulteriormente la generalizzabilità e le prestazioni di classificazione.
Dichiarazioni
Non sono stati dichiarati interessi finanziari concorrenti noti, relazioni personali, rapporti finanziari o altre attività che avrebbero potuto influenzare il lavoro riportato in questo studio.
Ringraziamenti
Si riconosce il contributo dei ricercatori che hanno reso disponibile il set di dati EEG utilizzato in questo studio e che lo hanno accessibile a fini di ricerca. Non è stato ricevuto alcun finanziamento specifico da agenzie pubbliche, commerciali o senza scopo di lucro.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Ambiente computazionale basato sul cloud utilizzato per eseguire i notebook di analisi | |
| MNE-Python | MNE-Python project | 1.12.1 | Utilizzato per la pre-elaborazione dell'EEG, il riferimento, il filtraggio e la segmentazione in epoche |
| NumPy | NumPy project | (2.0.2) | Utilizzato per calcoli numerici e operazioni basate su array |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | Dataset pubblico di EEG in stato di riposo contenente registrazioni di AD, FTD e HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Ambiente di programmazione utilizzato per l'elaborazione dei dati e lo sviluppo del modello |
| scikit-learn | scikit-learn project | 1.6.1 | Utilizzato per la pre-elaborazione, la suddivisione raggruppata dei dati, la classificazione con Random Forest e la valutazione delle prestazioni |
| SciPy | SciPy project | (1.16.3) | Utilizzato per l'elaborazione dei segnali e calcoli statistici |
| SHAP | SHAP project | 0.52.0 | Utilizzato per l'analisi di intelligenza artificiale interpretabile con TreeExplainer |
Riferimenti
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379