Questo studio identifica otto geni prognostici associati alla catastrofe mitotica (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) nel carcinoma polmonare a cellule adenocinomatose, stabilisce un modello di rischio con prestazioni predittive accettabili e rivela caratteristiche distinte del microambiente immunitario tra i gruppi a rischio.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Identificazione di geni prognostici correlati alla catastrofe mitotica nell'adenocarcinoma polmonare tramite analisi del trascrittoma
In questo articolo
Sommario
Abstract
Il carcinoma polmonare a cellule adenocarcinoma (LUAD), il sottotipo di cancro del polmone più comune, presenta una prognosi sfavorevole. Sebbene la catastrofe mitotica possa essere indotta nel LUAD, portando alla morte cellulare, il significato prognostico e biologico dei geni associati alla catastrofe mitotica (MCRGs) in questa malattia rimane poco chiaro. I geni differenzialmente espressi (DEGs) associati al LUAD sono stati selezionati dal cohort TCGA-LUAD, e i geni sovrapposti sono stati definiti attraverso l'intersezione tra DEGs e MCRGs. I geni prognostici candidati sono stati selezionati mediante apprendimento automatico, dopodiché è stato costruito un modello prognostico multigenico. È stata stabilita una firma prognostica composta da otto geni candidati: PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 e S100B, che ha dimostrato un'affidabilità predittiva accettabile nel set di addestramento, con aree sotto la curva (AUC) a 2, 3 e 5 anni rispettivamente di 0,723, 0,715 e 0,625 (C-index corretto con bootstrap: 0,699, IC 95%: 0,657-0,742), e una valida conferma nel set GSE31210 (AUC: 0,812, 0,766 e 0,814). I pazienti a basso rischio hanno mostrato esiti di sopravvivenza significativamente migliori, un maggiore infiltrato immunitario, punteggi immunitari e stromali più elevati, immunofenoscore aumentati e cicli di immunità antitumorale più attivi. Sono state osservate differenze significative nel carico di mutazioni tumorali e nella sensibilità ai farmaci tra i gruppi ad alto e basso rischio. La reazione a catena della polimerasi quantitativa (qPCR) ha confermato i profili trascrittomici di sei geni candidati correlati all'esito in campioni clinici. Un nomogramma che includeva il punteggio di rischio e lo stadio clinico ha mostrato buone prestazioni predittive. Questi risultati dimostrano che gli otto geni candidati legati ai MCRG hanno un forte potenziale nel prevedere gli esiti dei pazienti e nel stratificare il rischio nel LUAD, con caratteristiche distinte del microambiente immunitario tra i gruppi a diverso rischio.
Introduzione
Il cancro del polmone rimane tra i tumori più diffusi e letali a livello mondiale1,2. Il carcinoma polmonare non a piccole cellule (NSCLC) è dominato dal carcinoma polmonare adenocarcinoma (LUAD), che rappresenta circa il 40% di tutti i casi di cancro del polmone3,4. Sebbene siano stati compiuti notevoli progressi nelle procedure chirurgiche, nelle terapie mirate a livello molecolare, negli inibitori dei checkpoint immunitari e nei regimi combinati, la prognosi clinica per i pazienti affetti da LUAD rimane sfavorevole5,6. Sebbene approcci diagnostici basati su analisi istopatologiche e su immagini siano ampiamente utilizzati nel LUAD, presentano limitazioni intrinseche nella valutazione dell'eterogeneità tumorale e delle caratteristiche molecolari. Al contrario, l'analisi dei tessuti tumorali basata su biomarcatori molecolari può fornire informazioni più complete sulla biologia del tumore e potrebbe contribuire alla valutazione prognostica e a strategie terapeutiche personalizzate7. Pertanto, l'identificazione di biomarcatori molecolari affidabili rimane fondamentale per migliorare la previsione prognostica e la comprensione biologica del LUAD.
La mitosi, un meccanismo essenziale della replicazione cellulare, garantisce la corretta ripartizione dei cromosomi replicati tra due cellule figlie8. La disregolazione dei processi mitotici può favorire la proliferazione cellulare incontrollata, l'instabilità genomica e la progressione tumorale. La catastrofe mitotica (MC) definisce un percorso di morte cellulare innescato dal mancato completamento della mitosi, che si verifica tipicamente a seguito di danni all'apparato del fuso o a difetti nei punti di controllo del ciclo cellulare9. A livello morfologico, la MC si presenta con anomalie cellulari come multinucleazione, micronuclei, configurazioni del fuso multipolari e poliploidizzazione10. In quanto meccanismo per l'eliminazione di cellule con gravi difetti mitotici, la MC potrebbe contribuire alla soppressione della progressione tumorale9. L'eliminazione di p53 in cellule A549 di carcinoma polmonare a cellule adenocarcinomatose (LUAD) può indurre catastrofe mitotica e, in ultima analisi, morte cellulare11, suggerendo un potenziale legame tra MC e processi cellulari associati al LUAD. Tuttavia, il significato prognostico e le funzioni biologiche dei geni associati alla catastrofe mitotica (MCRGs) nel LUAD rimangono poco chiari.
In questo studio, l'importanza prognostica e la possibile rilevanza biologica dei MCRG nel carcinoma polmonare a cellule adenoidi (LUAD) sono state analizzate sistematicamente utilizzando dati provenienti da TCGA e GEO. I MCRG candidati sono stati inizialmente identificati mediante analisi di espressione differenziale e analisi di intersezione. Diversi approcci di apprendimento automatico hanno selezionato i geni candidati e stabilito una firma prognostica di rischio, successivamente validata esternamente. È stato inoltre sviluppato un nomogramma che integra il punteggio di rischio insieme alle caratteristiche cliniche per migliorare la previsione della sopravvivenza. In aggiunta, la caratterizzazione del microambiente immunitario, la valutazione delle mutazioni somatiche e l'analisi della chemosensibilità sono state effettuate per esaminare le implicazioni biologiche e l'utilità clinica dei geni identificati. Nel complesso, questi risultati dimostrano il potenziale prognostico dei MCRG nel LUAD e potrebbero contribuire allo sviluppo di biomarcatori e a una gestione personalizzata.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Lo studio è stato condotto in conformità con la Dichiarazione di Helsinki, e il protocollo è stato approvato dal Comitato Etico dell'Ospedale Toracico di Anhui (K2025-007) il 22 aprile 2025. Il consenso informato è stato ottenuto da tutti i soggetti coinvolti nello studio.
Estrazione e normalizzazione dei dati
I profili trascrittomici e i corrispondenti dataset clinici per il carcinoma polmonare a cellule adenoidi (LUAD) sono stati ottenuti dalle coorti TCGA e GEO. Il dataset TCGA-LUAD è stato designato come set di addestramento, mentre GSE72094, GSE31210 e GSE26939 sono stati utilizzati come coorti per la validazione esterna (Tabella 1). Inoltre, 900 geni correlati al metabolismo del colesterolo (MCRG) sono stati raccolti da uno studio precedente12 (Tabella Supplementare 1). I dati del trascrittoma sono stati annotati utilizzando GENCODE v36 o i file di annotazione della piattaforma GPL corrispondenti. Gli ID delle sonde sono stati convertiti in simboli genici, i geni duplicati sono stati uniti mediante la funzione avereps e sono stati conservati solo i geni codificanti proteine per generare matrici di espressione a livello genico. Per il set di addestramento TCGA-LUAD, i geni con Fragments per kilobase of exon model per million mapped fragments (FPKM) < 1 in più del 50% dei campioni sono stati eliminati, e i valori residui di espressione sono stati trasformati in log2 (log2[FPKM+1]). Per le coorti di validazione GEO, i dati grezzi di espressione sono stati scaricati, gli ID delle sonde sono stati mappati ai simboli genici utilizzando i file di annotazione della piattaforma corrispondente e le sonde multiple corrispondenti allo stesso gene sono state raggruppate calcolandone la media dei valori di espressione. Questi dataset sono stati trasformati in log2 quando necessario. Non è stata applicata alcuna correzione per l'effetto di lotto tra piattaforme diverse (TCGA e GEO), poiché abbiamo adottato una strategia di standardizzazione per coorte per garantire una comparabilità relativa. In particolare, per le coorti di addestramento e di validazione, i valori di espressione genica sono stati centrati e normalizzati (trasformazione z-score) utilizzando la media e la deviazione standard di ciascun dataset individualmente. Gli stessi coefficienti di regressione di Cox derivati dal set di addestramento sono stati quindi utilizzati per calcolare i punteggi di rischio per tutte le coorti. Per mantenere l'applicabilità clinica ed evitare l'overfitting su qualsiasi set di validazione, la mediana del punteggio di rischio della coorte di addestramento è stata utilizzata come soglia fissa per stratificare i pazienti in gruppi ad alto e basso rischio in tutte le coorti di validazione esterna. Le informazioni cliniche, incluse età, sesso, stadio patologico, stadio Tumor-Node-Metastasi (TNM), tipo istologico, tempo di sopravvivenza, stato di sopravvivenza e tipo di tessuto, sono state estratte quando disponibili. L'endpoint era la sopravvivenza complessiva (OS). Sono stati esclusi i campioni con informazioni incomplete sulla sopravvivenza o con tempo di sopravvivenza < 30 giorni. Il tempo di sopravvivenza è stato convertito in anni e lo stato di sopravvivenza è stato codificato come 0 per vivo e 1 per morto.
Identificazione e analisi funzionali di geni candidati
Il pacchetto Limma ha identificato i geni differenzialmente espressi (DEG) tra campioni tumorali e normali di adenocarcinoma polmonare (LUAD) nel set di addestramento13. I DEG sono stati definiti secondo i seguenti criteri: |log2FC| > 0,5 e valore p aggiustato < 0,05. Successivamente, l'algoritmo di clustering sfocato mfuzz nel pacchetto R ClusterGVis è stato utilizzato per suddividere i DEG in distinti cluster di espressione. È stata eseguita un'analisi dell'ontologia genica – processo biologico (GO-BP) sui cinque geni rappresentativi principali di ciascun cluster, in base ai loro punteggi di appartenenza. Un insieme di geni condivisi è stato ottenuto calcolando l'intersezione tra i DEG e i MCRG. Un'analisi di arricchimento funzionale mediante Ontologia Genica/Enciclopedia di Kyoto dei Geni e dei Genomi (GO/KEGG) ha valutato la rilevanza biologica dei geni sovrapposti. Le reti di interazione proteina-proteina (PPI) sono state ottenute dal database STRING14. Sono state mantenute solo le interazioni con punteggi di confidenza > 0,7 al fine di migliorare l'affidabilità della rete.
Selezione di geni prognostici
Il pacchetto Survival è stato utilizzato per effettuare un'analisi di regressione di Cox univariata al fine di identificare i geni probabilmente associati alla sopravvivenza complessiva nel carcinoma polmonare a cellule adenoidi (LUAD)15. I geni con un valore di p < 0,05 sono stati considerati possibili indicatori prognostici. La coorte di addestramento TCGA-LUAD comprendeva 500 pazienti con dati di sopravvivenza completi, tra cui 216 (43,2%) hanno avuto un evento di morte durante il follow-up. Il rapporto tra geni candidati (n = 108) ed eventi (n = 216) era di circa 1:2, valore accettabile per l'analisi di regressione di Cox. Successivamente, l'analisi di regressione con operatore di riduzione e selezione della norma L1 (LASSO) e il modello Extreme Gradient Boosting (XGBoost) hanno ulteriormente selezionato le caratteristiche. I modelli di rischio proporzionale di Cox sono stati costruiti con family = "cox" mediante la funzione cv.glmnet del pacchetto glmnet. Il parametro di regolarizzazione ottimale è stato identificato utilizzando una validazione incrociata a 10 ripiegamenti, in cui il valore λ.min rappresenta l'errore minimo di validazione incrociata ed è stato scelto come valore ottimale di λ. Sono stati estratti come caratteristiche candidati i geni con coefficienti di regressione diversi da zero. Per il modello XGBoost, il tempo di sopravvivenza e lo stato di sopravvivenza sono stati combinati in una singola variabile risultato, assegnando valori positivi agli eventi di morte e valori negativi ai casi censurati. I parametri sono stati impostati come objective = "survival: cox" e eval_metric = "cox-nloglik", con 100 iterazioni e un tasso di apprendimento di 0,1. Dopo l'addestramento del modello, i punteggi di importanza dei geni sono stati calcolati utilizzando i valori di guadagno delle caratteristiche. I primi 20 geni sono stati mantenuti ordinando i punteggi di importanza in ordine decrescente, al fine di ridurre la dimensionalità delle caratteristiche e la complessità del modello. I geni comuni ai risultati di LASSO e XGBoost sono stati identificati come geni prognostici candidati.
Costruzione e valutazione di un modello prognostico
È stato sviluppato un modello prognostico mediante analisi di regressione di Cox multivariata dei geni candidati identificati. I punteggi di rischio sono stati calcolati singolarmente come segue:
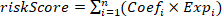 .
dove Coefi indica il coefficiente per il gene i e Expi indica il rispettivo valore di espressione genica. Gli individui sono stati successivamente suddivisi in due gruppi: ad alto rischio e a basso rischio, utilizzando il punteggio mediano di rischio come soglia di cutoff. Successivamente, sono state create curve ROC (receiver operating characteristic) dipendenti dal tempo. Per valutare il potenziale di overfitting, è stata eseguita una validazione interna con metodo bootstrap, comprensiva di 1.000 iterazioni di ricampionamento, al fine di calcolare l'indice C corretto per il bias e le AUC dipendenti dal tempo con intervalli di confidenza al 95%. Sono state generate curve di calibrazione per valutare la concordanza tra le probabilità di sopravvivenza previste e quelle osservate a 2, 3 e 5 anni. Inoltre, è stata effettuata un'analisi della curva decisionale (DCA) utilizzando il pacchetto ggDCA in R per valutare il beneficio clinico netto del modello ai tempi di 2, 3 e 5 anni, quantificando il potenziale valore del punteggio di rischio nel processo decisionale clinico in corrispondenza di diverse probabilità soglia. Le differenze di sopravvivenza tra i gruppi stratificati per rischio e tra altre categorie cliniche sono state confrontate mediante curve di sopravvivenza di Kaplan-Meier (KM) con test log-rank. Inoltre, per chiarire il contributo individuale dei geni alla performance del modello, è stata impiegata l'analisi SHAP (Shapley Additive exPlanations) per un'interpretazione esplicativa a posteriori.
Sviluppo e validazione esterna del nomogramma
Le relazioni tra i punteggi di rischio calcolati e diverse caratteristiche cliniche (inclusi sesso, età e stadio TNM) sono state analizzate mediante test di Wilcoxon rank-sum o test di Kruskal-Wallis per valutare l'applicabilità clinica del modello. Per verificare se il punteggio di rischio fungeva da fattore prognostico indipendente, le variabili cliniche insieme al punteggio di rischio sono state inserite in un modello di regressione di Cox multivariata. Successivamente, è stato costruito un nomogramma prognostico che combinava i fattori di rischio clinici indipendenti (ad esempio, Stadio) e il punteggio genetico di rischio, utilizzando il pacchetto R regplot, al fine di personalizzare le previsioni della probabilità di sopravvivenza. Le curve di calibrazione sono state utilizzate per valutare l'accordo tra la probabilità di sopravvivenza predetta dal nomogramma e gli esiti di sopravvivenza effettivi. Infine, la capacità predittiva finale e la generalizzabilità del sistema nomogramma integrato sono state rigorosamente validate mediante curve ROC dipendenti dal tempo e analisi comprehensive di sottogruppi clinici KM nelle coorti.
Analisi dell'infiltrazione immunitaria e dei sottotipi immunitari
È stato utilizzato CIBERSORT, con la matrice di firma genica dei leucociti (LM22), per stimare le proporzioni relative di 22 tipi di cellule immunitarie al fine di valutare l'infiltrazione di cellule immunitarie nei pazienti con adenocarcinoma polmonare (LUAD). Le relazioni tra i livelli di espressione genica prognostica e l'infiltrazione immunologica sono state valutate mediante analisi di correlazione di Spearman. I punteggi immunitario, stromale, di purezza del tumore e di stima (ESTIMATE) sono stati ottenuti tramite l'algoritmo ESTIMATE, e le differenze tra i gruppi a rischio sono state valutate con il test di Wilcoxon. I pazienti con LUAD sono stati assegnati a sei sottotipi immunitari utilizzando il pacchetto ImmuneSubtypeClassifier16. Il test di Wilcoxon è stato inoltre utilizzato per confrontare le distribuzioni dei sottotipi immunitari tra i gruppi a rischio.
Analisi dei checkpoint immunitari, del punteggio immunofenoscore e del ciclo dell'immunità antitumorale
In questo studio, il test del rango con segno di Wilcoxon è stato utilizzato per valutare 21 geni dei checkpoint immunitari17 in gruppi stratificati per rischio, al fine di caratterizzare il paesaggio immunitario del carcinoma polmonare a cellule non piccole di tipo adenocarcinoma (LUAD). La correlazione di Spearman ha collegato i geni prognostici candidati ai geni dei checkpoint immunitari. Per valutare le differenze nella risposta agli inibitori dei checkpoint immunitari (ICIs) nei pazienti con LUAD a diversi livelli di rischio, i dati del punteggio immunofenotipico (IPS) per i trattamenti anti-PD-1 e anti-CTLA-4 sono stati ottenuti da The Cancer Immunome Atlas (TCIA)18, e la base di dati Tracking Tumor Immunophenotype (TIP)19 è stata utilizzata per valutare l'attività del ciclo cancro-immunità, confrontando i punteggi corrispondenti tra i gruppi a rischio.
Analisi delle mutazioni somatiche e della sensibilità ai farmaci
Lo strumento TCGA mutations ha recuperato i profili di mutazioni somatiche per i casi TCGA-LUAD al fine di analizzare la variabilità nei modelli di mutazione tra i diversi gruppi di rischio. Il pacchetto maftools ha elaborato e visualizzato i dati sulle mutazioni. I livelli di carico mutazionale tumorale (TMB) sono stati determinati per ciascun campione e confrontati tra le due categorie di rischio. È stata condotta un'analisi della sensibilità farmacogenomica utilizzando il pacchetto pRRophetic in base al database Genomics of Drug Sensitivity in Cancer (GDSC)20. Sono stati predetti i valori di concentrazione inibitoria semimassimale (IC50) per farmaci antitumorali in ciascun paziente con LUAD, e le differenze tra i gruppi di rischio sono state quantificate mediante il test della somma dei ranghi di Wilcoxon.
Valutazione dei livelli di espressione dei geni prognostici
Ogni set di dati è stato utilizzato per valutare i livelli di trascritto di geni candidati selezionati correlati all'esito. Per collegare l'espressione genica alla prognosi del paziente, sono state determinate cutoff ottimali mediante la funzione surv_cutpoint nel pacchetto R survminer. Sulla base di queste soglie, i casi di LUAD sono stati suddivisi in sottogruppi ad alta e bassa espressione per l'analisi successiva della sopravvivenza.
Inoltre, sono stati ottenuti cinque campioni accoppiati di tumori di carcinoma polmonare a cellule adenocarcinoma (LUAD) e tessuti normali adiacenti dall'ospedale toracico dell'Anhui, e successivamente è stata eseguita la validazione mediante qPCR. Ogni partecipante ha fornito un consenso informato scritto. Sono stati selezionati sei geni prognostici candidati (PDGFB, LDHA, ZEB2, FKBP4, DMD e S100B) per la validazione mediante qPCR. L'RNA è stato estratto da campioni di tessuto omogeneizzati utilizzando un reagente per l'estrazione dell'RNA, seguito da estrazione con cloroformio e precipitazione con isopropanolo. Lo spettrofotometro ha permesso la misurazione della concentrazione e della purezza dell'RNA. La validazione mediante qPCR dei sei geni prognostici candidati è stata effettuata mediante mix master per PCR basato su SYBR Green su un sistema di PCR in tempo reale: denaturazione iniziale a 95 °C per 30 s, seguita da 40 cicli di 95 °C per 20 s, 55 °C per 20 s e 72 °C per 20 s. L'espressione relativa è stata calcolata e normalizzata rispetto a Glyceraldehyde-3-Phosphate Dehydrogenase (GAPDH) mediante la tecnica 2-ΔΔCt. I dettagli di tutti i reagenti e degli strumenti sono riportati nella Tabella dei Materiali.
Analisi statistica
Le analisi statistiche sono state condotte utilizzando software di calcolo e grafica statistica. La rete di interazioni proteina-proteina è stata visualizzata mediante software di analisi delle reti. Dopo la valutazione della normalità, il test t di Student è stato utilizzato per le variabili continue distribuite normalmente e il test U di Mann-Whitney per quelle non distribuite normalmente.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Identificazione del gene candidato e analisi funzionale
Sono stati rilevati complessivamente 4.915 DEG, inclusi 2.485 DEG down-regolati e 2.430 DEG up-regolati (Figura 1A). L'analisi del clustering in moduli funzionali ha classificato questi DEG in sei moduli di espressione (C1-C6), tra cui i moduli C1, C2, C3 e C5 hanno mostrato un'espressione relativamente più elevata nei campioni tumorali (Figura 1B). L'annotazione...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Il carcinoma polmonare a cellule squamose (LUAD) è tra le principali forme di cancro del polmone e continua a rappresentare un notevole onere per la salute pubblica21. La morte cellulare regolata (MC) è un processo legato alla morte cellulare che potrebbe contribuire all'eliminazione di cellule con gravi anomalie mitotiche e alla soppressione della progressione tumorale22. Pertanto, esplorare il potenziale ruolo dei geni associati alla MC (MCRGs) nel LUAD potrebbe aiutare a...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| ClusterGVis | CRAN | versione 0.1.2 | Clustering e visualizzazione dell'espressione genica |
| Cytoscape | Consorzio Cytoscape | versione 3.9.1 | Visualizzazione di reti di interazione proteica RRID:SCR_003032 |
| Sistema CFX384 di PCR quantitativa in tempo reale con fluorescenza | Bio-Rad | CFX384 Touch | Reagente qPCR |
| Primer DMD | Tsingke | N/D | Forward: 5’-GCTCAACCATCGATTTGCAGCC-3’ Reverse: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| Primer FKBP4 | Tsingke | N/D | Forward: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Reverse: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Strumento online | Ottenimento del set di dati esterno per la validazione di LUAD RRID:SCR_005012 |
| Primer GAPDH | Tsingke | N/D | Forward: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Reverse: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | versione 4.1-8 | Selezione delle caratteristiche nella regressione LASSO RRID:SCR_015505 |
| Primer LDHA | Tsingke | N/D | Forward: 5’-GGATCTCCAACATGGCAGCCTT-3’ Reverse: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | versione 3.60.6 | Selezione di geni differenzialmente espressi (DEG) RRID:SCR_010943 |
| maftools | Bioconductor | versione 2.20.0 | Visualizzazione di dati di mutazione somatica RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Predizione dei valori di IC50 dei farmaci RRID:SCR_024417 |
| Primer PDGFB | Tsingke | N/D | Forward: 5’-GAGATGCTGAGTGACCACTCGA-3’ Reverse: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | Reagente qPCR |
| Software R | Fondazione R | versione 4.2.2 | Analisi bioinformatica |
| regplot | CRAN | versione 1.1 | Creazione di grafici a linee |
| survival | CRAN | versione 3.8-3 | Analisi della sopravvivenza e regressione di Cox RRID:SCR_021137 |
| STRING | Consorzio STRING | Strumento online | Analisi della rete di interazione proteica RRID:SCR_005223 |
| Primer S100B | Tsingke | N/D | Forward: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Reverse: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | versione 0.5.0 | Rappresentazione grafica e ottimizzazione delle curve di sopravvivenza RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | Reagente qPCR |
| TCGA | NCI | Strumento online | Acquisizione di dati trascrittomici e clinici di LUAD RRID:SCR_003193 |
| Primer ZEB2 | Tsingke | N/D | Forward: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Reverse: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Riferimenti
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo