Questo protocollo fornisce un flusso di lavoro di modellazione strutturale di equazioni parziali a minima quadrata per valutare i percorsi di associazione tra esperienze di apprendimento online, bisogni psicologici di base e coinvolgimento dell'apprendimento negli studenti universitari, inclusi adattamento a questionari, screening, valutazione delle misurazioni, test di associazione indiretta, controlli di robustezza e record di riproducibilità.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Un sondaggio e protocollo per valutare l'esperienza di apprendimento online, i bisogni psicologici di base e l'impegno nell'apprendimento negli studenti universitari
In questo articolo
Sommario
Abstract
L'apprendimento online è integrato nell'istruzione superiore, ma le valutazioni spesso si basano su indicatori di accesso, soddisfazione o completamento che non identificano i problemi di coinvolgimento. Questo articolo presenta un sondaggio riproducibile in lingua inglese e un protocollo di modellazione strutturale delle equazioni dei minimi quadrati parziali per valutare i percorsi di associazione tra esperienze di apprendimento online, bisogni psicologici di base e coinvolgimento nell'apprendimento negli studenti universitari. L'esperienza di apprendimento online si misura attraverso l'usabilità della piattaforma, il supporto didattico, la qualità dell'interazione e la flessibilità dell'apprendimento; bisogni psicologici fondamentali attraverso autonomia, competenza e relazionalità; e l'impegno nell'apprendimento attraverso il coinvolgimento comportamentale, cognitivo ed emotivo. Il flusso di lavoro specifica mappatura element-sorgente, adattamento al questionario, revisione esperta, test pilota, consenso elettronico, screening di idoneità, controlli di qualità delle risposte, punteggio dei costrutti, diagnostica dei bias con metodi comuni, stima dei costrutti di ordine superiore, valutazione dei modelli di misurazione, test delle vie strutturali, analisi di associazioni indirette, analisi della sensibilità psicologica, controlli di robustezza basati su regressioni e blocco dei file di riproducibilità. I risultati rappresentativi di 386 risposte valide dimostrano un'affidabilità accettabile, correlazioni moderate tra i costrutti, qualità di misurazione mantenuta, un'associazione indiretta supportata attraverso bisogni psicologici di base, percorsi di controllo non significativi e punteggi dimensionali disuguali. Il protocollo supporta una diagnosi trasparente di come l'esperienza di apprendimento online sia associata alla soddisfazione e al coinvolgimento dei bisogni psicologici, evitando al contempo l'interpretazione causale dai dati di indagini trasversali.
Introduzione
L'apprendimento online è diventato parte dell'istruzione superiore di routine attraverso sistemi di gestione dell'apprendimento, piattaforme video, materiali registrati, sessioni sincrone e design di corsi misti. Tuttavia, molte valutazioni si basano ancora su log di accesso, valutazioni di soddisfazione o indicatori di completamento, che mostrano se gli studenti hanno utilizzato un corso online ma non chiariscono se un coinvolgimento più basso sia associato all'usabilità della piattaforma, al supporto didattico, alla qualità dell'interazione, alla flessibilità dell'apprendimento, alla soddisfazione psicologica dei bisogni o a una specifica dimensione dicoinvolgimento 1. L'esperienza di apprendimento online quindi non dovrebbe essere ridotta a un singolo punteggio di soddisfazione. Le ricerche precedenti sull'engagement online enfatizzano l'interazione tra contenuti e studenti come elementi importanti dell'esperienza di apprendimento onlinedegli studenti 2. L'attuale protocollo misura l'esperienza di apprendimento online attraverso l'usabilità della piattaforma, il supporto didattico, la qualità dell'interazione e la flessibilità dell'apprendimento.
Anche l'impegno nell'apprendimento è multidimensionale. Include la partecipazione comportamentale, l'investimento cognitivo e il coinvolgimento emotivo. Gli strumenti di coinvolgimento dei corsi online dimostrano che l'impegno non può essere pienamente rappresentato dalla partecipazione visibile o dal completamento dei compitida soli 3. Ricerche più ampie sulle tecnologie educative mostrano anche che il coinvolgimento comportamentale è spesso più facile da osservare rispetto all'impegno cognitivo oaffettivo 4. Per questo motivo, il protocollo misura l'impegno dell'apprendimento attraverso un coinvolgimento comportamentale, cognitivo ed emotivo, piuttosto che collassare l'impegno in un unico punteggio non differenziato.
La teoria dell'autodeterminazione fornisce la base teorica per collegare l'esperienza di apprendimento online all'impegno nell'apprendimento. La teoria dei bisogni psicologici di base identifica autonomia, competenza e relazionamento come condizioni centrali per la motivazione e l'aggiustamento5. Nell'apprendimento online, l'autonomia si riferisce alla scelta e al controllo percepiti, la competenza alla capacità percepita nel completare compiti di apprendimento e la relazione con la connessione sentita con insegnanti e compagni di corso. Studi precedenti sull'apprendimento online che utilizzano la teoria dell'autodeterminazione hanno collegato supporto contestuale, soddisfazione del bisogno, motivazione ecoinvolgimento 6,7. Questi risultati supportano l'esame dei bisogni psicologici di base come costrutto di associazione indiretta tra esperienza di apprendimento online e coinvolgimento nello apprendimento, evitando al contempo l'interpretazione causale perché i dati sono trasversali.
Un problema metodologico nella ricerca sull'engagement online è la mancanza di una struttura operativa coerente. Gli studi variano nel modo in cui definiscono le condizioni di apprendimento, misurano l'impegno e collegano l'ambiente di apprendimento all'esperienza psicologica deglistudenti 8. I sondaggi auto-riportati sono anche vulnerabili a risposte imprudenti, risposte modellate, esclusioni post hoc, decisioni basate su dati mancanti e bias di metodocomune 9. Pertanto, questo protocollo fissa la struttura del questionario in lingua inglese, la mappatura element-fonte, le regole di punteggio, la procedura di consenso elettronico, lo screening di idoneità, la regola del controllo dell'attenzione, la soglia del tempo di completamento, il criterio di lineamento retto, il controllo della risposta a stringhe lunghe, la gestione dei dati mancanti, la specifica del modello e la procedura di blocco del dataset prima che inizi l'analisi strutturale.
Il quadro concettuale specifica l'esperienza di apprendimento online come costrutto indipendente, i bisogni psicologici di base come costrutto di associazione indiretta e l'impegno nell'apprendimento come costrutto di risultato. Il percorso principale verifica se l'esperienza di apprendimento online è associata a bisogni psicologici di base, se i bisogni psicologici di base sono associati all'impegno nell'apprendimento e se l'esperienza di apprendimento online rimane direttamente associata all'impegno nell'apprendimento dopo aver tenuto conto dei bisogni psicologici fondamentali. Il protocollo è guidato da quattro domande di ricerca: se il protocollo di indagine strutturata possa misurare i tre costrutti con una qualità di risposta accettabile e affidabilità del costrutto; se l'esperienza di apprendimento online sia positivamente associata a bisogni psicologici di base e coinvolgimento nello apprendimento; se l'associazione tra esperienza di apprendimento online e coinvolgimento nell'apprendimento sia in parte svolta attraverso bisogni psicologici fondamentali come associazione indiretta; e se le analisi delle sottodimensioni con bisogni psicologici e i controlli di robustezza basati su regressione supportino la stessa interpretazione del flusso di lavoro primario PLS-SEM.
Questo articolo è presentato come un contributo focalizzato sul metodo piuttosto che come uno studio esplicativo convenzionale e a sezione trasversale. Il protocollo fornisce un flusso di lavoro riproducibile per l'adattamento del questionario, la revisione degli esperti, i test pilota, l'amministrazione di sondaggi, lo screening delle risposte, il punteggio dei costrutti, la valutazione dei modelli di misurazione, il test dei percorsi strutturali, l'analisi di associazioni indirette, l'analisi di sensibilità, il controllo della robustezza e il blocco dei file di riproducibilità. I flussi di lavoro di ricerca educativa trasparenti richiedono che le decisioni analitiche siano documentate prima dell'interpretazione finale del modello10. La modellazione delle equazioni strutturali a minima quadrata parziale è utilizzata perché permette di esaminare le componenti di misurazione e strutturali all'interno di un unico flusso di lavoro, con costrutti riflettivi del primo ordine e punteggi di costrutti di ordine superiore analiticamente derivati attraverso un approccio disgiunto a due fasi11. Studi precedenti sull'impegno degli studenti online, la presenza sociale, il supporto agli studenti e la fidelizzazione mostrano che comunicazione, supporto, connessione e progettazione inclusiva dei corsi contano oltre il semplice accesso oflessibilità 12,13. Le revisioni sistematiche indicano inoltre che il coinvolgimento comportamentale, cognitivo ed emotivo può rispondere in modo diverso alle condizioni di apprendimento online14. I risultati rappresentativi sono quindi utilizzati solo per dimostrare l'output del protocollo, non per rivendicare effetti causali dai dati di indaginetrasversale 15.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Il protocollo dello studio è stato esaminato e approvato dal Comitato Etico della Ricerca (Non Medico) dell'Università Malaya con il numero di approvazione UM. TNC (P&I)/UMREC_4892 il 7 agosto 2025. Svolgere tutte le procedure in conformità con le linee guida istituzionali per la ricerca che coinvolge partecipanti umani. Ottieni il consenso informato elettronico prima di somministrare il questionario. Utilizzare codici anonimi dei partecipanti durante il reclutamento, la selezione, il punteggio, l'analisi e l'archiviazione dei file. Gli strumenti e i software di ricerca sono elencati nella Tabella dei Materiali.
1. Definire il disegno dello studio e il quadro analitico
- Utilizzare un sondaggio quantitativo trasversale per valutare i percorsi di associazione tra esperienza di apprendimento online, bisogni psicologici di base e coinvolgimento dell'apprendimento negli studenti universitari.
- Definisci l'esperienza di apprendimento online come la costruzione latente indipendente, i bisogni psicologici di base come la costruzione latente di associazione indiretta, e l'impegno nell'apprendimento come il concetto latente risultato.
- Specifica i tre costrutti multidimensionali prima della raccolta dei dati. Rappresentare l'esperienza di apprendimento online tramite usabilità della piattaforma, supporto didattico, qualità dell'interazione e flessibilità di apprendimento; bisogni psicologici di base per autonomia, necessità di competenza e necessità di correlazione; e coinvolgimento nell'apprendimento tramite coinvolgimento comportamentale, cognitivo e coinvolgimento emotivo.
- Utilizzare la modellazione strutturale delle equazioni dei minimi quadrati parziali come metodo analitico principale per valutare la qualità della misurazione, i punteggi dei costrutti di ordine superiore, i percorsi strutturali e il percorso indiretto predefinito.
- Specificare il percorso principale prima dell'analisi: esperienza di apprendimento online → bisogni psicologici di base, bisogni psicologici di base → coinvolgimento dell'apprendimento e esperienza di apprendimento online → coinvolgimento nell'apprendimento.
- Considera tutti i percorsi strutturali come stime di associazione. Non interpretare nessun percorso come causale perché tutte le variabili vengono misurate in un unico momento. Effettua un controllo preliminare della dimensione del campione e della potenza prima del reclutamento. Utilizzare almeno 380 risposte valide come campione target e 350 risposte valide come campione minimo accettabile dopo lo screening.
- Presentare il flusso di lavoro del protocollo nella Figura 1, inclusi reclutamento, consenso, amministrazione del questionario, revisione di esperti, test pilota, screening delle risposte, bloccaggio del dataset, valutazione delle misurazioni, test strutturali, analisi di associazioni indirette, controllo della robustezza e preparazione dei file di riproducibilità.
NOTA: Mantieni invariati il modello concettuale e i percorsi strutturali dalla costruzione del questionario fino all'analisi finale.
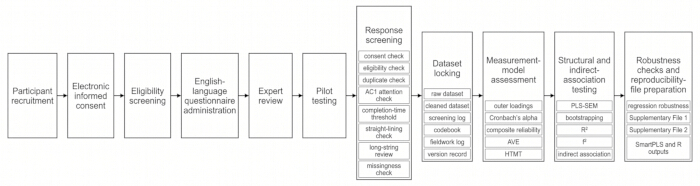
Figura 1: Flusso di lavoro operativo per valutare l'esperienza di apprendimento online, i bisogni psicologici di base e l'impegno nell'apprendimento. La figura mostra il flusso di lavoro del protocollo dal reclutamento, al consenso, all'amministrazione del questionario, alla revisione degli esperti, ai test pilota, allo screening delle risposte e al blocco del dataset fino alla valutazione delle misurazioni, test strutturali, analisi di associazioni indirette, controllo della robustezza e preparazione dei file di riproducibilità. Clicca qui per visualizzare una versione più grande di questa figura.
2. Reclutare partecipanti idonei
- Reclutare studenti universitari che abbiano partecipato ad almeno un corso online o misto durante il semestre accademico attuale o più recente.
- Includere partecipanti di età pari o superiore a 18 anni, attualmente iscritti come studenti universitari o post-laurea, esposti all'apprendimento online o misto, in grado di leggere il questionario in lingua inglese e disposti a fornire il consenso informato elettronico.
- Escludere le risposte quando il consenso non è confermato, i criteri di idoneità non sono soddisfatti, l'item di controllo di attenzione è fallito, si rileva una presentazione duplicata, il tempo di completamento è inferiore alla soglia preimposta, si rileva un lineamento diretto o si presenta un'incoerenza di idoneità non risolta.
- Reclutare partecipanti tramite piattaforme universitarie, gruppi di comunicazione per i corsi, liste email degli studenti e canali istituzionali per gli studenti.
- Non raccogliere identificatori diretti, inclusi nomi, numeri di identificazione degli studenti, numeri di telefono, indirizzi email privati, indirizzi residenziali esatti, indirizzi IP, identificatori di dispositivi o identificatori di account.
- Registra le date di reclutamento, i canali di reclutamento, le risposte inviate, il conteggio delle esclusioni per categoria, le risposte trattenute e la dimensione finale valida del campione nel registro di lavoro sul campo e nel registro di screening.
PUNTO DI PAUSA: Verifica i progressi del reclutamento settimanali. Rivedi solo il numero di risposte, la copertura del canale di reclutamento e il tasso preliminare di esclusione. Non ispezionare punteggi di costrutto, correlazioni o stime dei percorsi durante il reclutamento.
3. Costruire il questionario
- Prepara un questionario strutturato in inglese con consenso informato elettronico, screening dell'idoneità, informazioni di base sui partecipanti, elementi della scala sostanziale e un item di controllo dell'attenzione basato sull'istruzione.
- Usa una scala di risposta di Likert a 5 punti per tutti gli elementi sostanziali: 1 = fortemente in disaccordo, 2 = in disaccordo, 3 = neutrale, 4 = d'accordo e 5 = fortemente d'accordo.
- Adatta gli elementi dell'esperienza di apprendimento online da precedenti misure di percezione dell'apprendimento online, supporto didattico, qualità dell'interazione, usabilità della piattaforma e flessibilità di apprendimento. Adatta gli elementi dei bisogni psicologici fondamentali dai criteri consolidati di autonomia, competenza e relazionalità. Adatta gli elementi di coinvolgimento dell'apprendimento da misure comportamentali, cognitive ed emotive già esistenti.
- Rivedi solo la formulazione degli item per adattarla ai contesti universitari online e di apprendimento misto. Usa formulazioni chiare e non suggestive ed evita formulazioni che implichino alta soddisfazione, alta soddisfazione dei bisogni psicologici o un alto coinvolgimento che ci si aspetta.
- Prepara una tabella di mappatura element-source prima dei test pilota. Registra codice dell'item, costrutto, dimensione, formulazione adattata, base della fonte, nota di adattamento, linguaggio del questionario e indicazioni di valutazione per ogni item sostanziale.
- Utilizzare 33 elementi sostanziali della scala Likert: 12 per l'esperienza di apprendimento online, nove per i bisogni psicologici di base e 12 per l'impegno all'apprendimento. Utilizzare tre elementi per ogni dimensione dell'esperienza di apprendimento online, tre elementi per ogni dimensione del bisogno psicologico di base e quattro elementi per ogni dimensione di coinvolgimento dell'apprendimento.
- Posiziona un elemento di controllo dell'attenzione basato sulle istruzioni dopo il blocco dei bisogni psicologici di base. Utilizzare questo item solo per lo screening della qualità della risposta ed escluderlo dal punteggio dei costrutti, dall'analisi dell'affidabilità, dall'analisi della validità, dalla stima PLS-SEM, dai test per associazioni indirette e dall'analisi della robustezza.
- Mantenere il tempo previsto per completare il questionario entro 8–12 minuti durante i test pilota. Usa la Tabella 1 per documentare domini di costruzione, dimensioni, codici di elemento, numero di elementi, scala di risposta, direzione di punteggio e base di adattamento. Usa il File Supplementare 1 per fornire il questionario completo, la mappatura element-sorgente, la codifica delle variabili e le regole di punteggio.
NOTA: Mantieni concettualmente distinti gli elementi predittivi, associazioni indirette e esiti.
Tabella 1: Costruisci domini, dimensioni, struttura del questionario e regole di punteggio. Questa tabella riassume la struttura del questionario, inclusi domini e dimensioni costruttate, codici e numeri di articolo, elementi di esempio, base di adattamento, scala di risposta e regole di punteggio. L'oggetto di controllo dell'attenzione è identificato come solo oggetto di screening. Clicca qui per scaricare questa tabella.
4. Condurre revisioni esperte e test pilota
- Invita da tre a cinque esperti in psicologia dell'educazione, apprendimento online, metodologia quantitativa, ricerca nell'istruzione superiore o progettazione di sondaggi a esaminare il questionario.
- Chiedi agli esperti di valutare la chiarezza degli elementi, costruire la rilevanza, la ridondanza di formulazione, il carico di risposta, l'adeguatezza culturale, la chiarezza linguistica e l'allineamento tra ogni item e la dimensione assegnata.
- Registra i risultati delle revisioni esperte in un registro di revisione degli elementi, inclusi la formulazione originale, la preoccupazione del revisore, la decisione di revisione, la formulazione finale e la motivazione della conservazione, revisione o rimozione.
- Rivedi le voci che sono ambigue, a doppio baro, eccessivamente simili, culturalmente inappropriate, debolmente allineate alla dimensione target o incoerenti con il contesto dell'indagine in lingua inglese.
- Condurre un test pilota con 30–50 studenti universitari che soddisfano gli stessi criteri di idoneità dello studio principale. Chiedi ai partecipanti al pilota di individuare formulazioni poco chiare, problemi tecnici di visualizzazione, lunghezza eccessiva, formulazioni ripetitive o disagio causati da qualsiasi elemento del questionario.
- Registra i tempi di completamento del pilota per ogni partecipante. Definire la soglia minima di tempo di completamento dello studio formale come il valore più grande compreso tra 3 minuti e un terzo del tempo mediano di completamento del pilota.
- Calcola la consistenza interna preliminare per ogni costrutto e ispeziona le correlazioni totali di elementi dopo i test pilota. Rivedi o rimuovi gli elementi deboli solo quando la cancellazione migliora la qualità delle misurazioni e non indebolisce la copertura costruttiva.
- Finalizza e blocca il questionario, il codebook, la mappatura delle fonti degli elementi, il registro delle revisioni degli esperti, il record del test pilota, la soglia del tempo di completamento, la regola di controllo dell'attenzione, la regola di rilevamento dei duplicati e i criteri di esclusione prima del reclutamento formale.
PUNTO DI PAUSA: Non iniziare il reclutamento formale finché tutti i questionari, i file di selezione e di codifica non saranno stati bloccati.
5. Somministrare il questionario online
- Costruisci il questionario in un sistema di sondaggio online che supporti la partecipazione anonima, la conferma del consenso, lo screening dell'idoneità, le impostazioni delle risposte obbligatorie, la registrazione dei tempi di risposta, la restrizione di invio duplicato non identificativo, la collocazione di controllo di attenzione e l'esportazione di fogli di calcolo.
- Inserisci il consenso informato elettronico prima dello screening di idoneità e degli elementi del questionario. Consentire ai partecipanti di procedere solo dopo aver confermato la partecipazione volontaria e presentare lo scopo dello studio in un linguaggio neutro. Dichiara che lo studio esamina le percezioni degli studenti sull'apprendimento online, la soddisfazione dei bisogni psicologici e l'impegno nell'apprendimento.
- Imposta come campi richiestosi il consenso, le domande di idoneità e tutti e 33 gli elementi sostanziali della scala Likert. Disabilita i campi per le informazioni di identificazione diretta. Non richiedere nomi, numeri di studenti, numeri di telefono, indirizzi email privati, indirizzi residenziali esatti, indirizzi IP, identificatori di dispositivi o identificatori di account.
- Consentire ai partecipanti di uscire dal questionario prima della presentazione finale senza penalità. Limitare le invii ripetuti solo tramite impostazioni non identificative della piattaforma di sondaggio, quando disponibili. Tieni il questionario aperto per 4–6 settimane. Monitorare i conteggi delle risposte due volte a settimana e documentare i progressi del reclutamento nel registro del lavoro sul campo.
NOTA: Non fornire feedback personale dopo l'invio del questionario.
6. Esportare e proteggere i dati grezzi
- Esporta tutte le risposte inviate in formati .xlsx e .csv immediatamente dopo la chiusura delle selezioni.
- Salva un file .xlsx inalterato come RawData_OnlineLearning_BPN_Engagement_YYYYMMDD.xlsx e uno .csv non modificato come RawData_OnlineLearning_BPN_Engagement_YYYYMMDD.csv.
- Crea una copia funzionante per screening, codifica e analisi. Chiamalo WorkingData_OnlineLearning_BPN_Engagement_YYYYMMDD.xlsx. Assegnare a ogni risposta inviata un codice partecipante anonimo nei formati P001, P002, P003 e così via.
- Memorizza il dataset grezzo in una cartella di sola lettura e crea un checksum, un record di versione del file o un record di cronologia delle versioni istituzionale prima che inizi lo screening.
- Conservare l'archivio grezzo dei dati inviati e i metadati di screening de-identificati nella cartella di verifica istituzionale protetta. Non includere registri grezzi esclusi, informazioni direttamente identificabili o dati grezzi a livello di partecipante nel manoscritto o nei file supplementari inviati per la pubblicazione.
PUNTO DI PAUSA: Non iniziare lo screening finché il file .xlsx grezzo, il file .csv grezzo, il registro di lavoro sul campo, il record versione dei dati grezzi e la cartella dei dati grezzi protetti non sono stati salvati.
7. Selezionare le risposte e applicare le regole di esclusione
- Applicare tutte le regole di esclusione prima di esaminare le correlazioni costruttici, i risultati dei modelli di misura, i percorsi strutturali o le stime di associazione indiretta. Rimuovere le risposte senza conferma del consenso o senza età, iscrizione, esposizione all'apprendimento online o idoneità alla lingua del questionario.
- Rimuovere le risposte duplicate secondo la regola predefinita di rilevamento dei duplicati. Identificare i possibili duplicati solo tramite segnalazioni di duplicati non identificanti della piattaforma di sondaggio e informazioni anonime sul modello di risposta. Conservare la risposta completa più precoce quando vengono identificate risposte duplicate.
- Rimuovere le risposte che non superano l'elemento di controllo di attenzione basato sulle istruzioni o che sono completate al di sotto della soglia minima di tempo di completamento dello studio formale. Definisci il straight-lining come la selezione della stessa opzione di risposta per almeno il 90% dei 33 elementi sostanziali della scala Likert. Rimuovi le risposte che soddisfano questo criterio.
- Segnalare i pattern di risposta a stringhe lunghe quando viene selezionata la stessa opzione di risposta perr 20 o più elementi sostanziali consecutivi in scala Likert. Rimuovere le risposte segnalate solo quando mostrano anche tempi di completamento implausibilmente brevi, fallimento di controllo di attenzione, lineamento dritto o un'altra violazione di qualità prespecificata.
- Segnalare risposte di background incoerenti quando il partecipante segnala di assenza di esposizione online o di apprendimento misto ma segnala ore settimanali di apprendimento online superiori a zero. Rimuovi le risposte con incoerenza di idoneità non risolta.
- Registra ogni caso escluso in un registro di screening de-identificato con codice anonimo del partecipante, categoria di esclusione, motivo di esclusione, data di screening e decisione di screening.
- Usa la Tabella 2 per documentare le risposte inviate, le categorie di esclusione, il conteggio delle esclusioni, le risposte trattenute e la dimensione finale valida del campione. Se i conteggi grezzi delle esclusioni non possono essere ricostruiti per il dataset rappresentativo, dichiararlo esplicitamente.
NOTA: Escludere i casi solo secondo regole predefinite su consenso, idoneità, duplicato, controllo di attenzione, tempo di completamento, schema di risposta, mancanza o coerenza. Non iniziare a programmare finché il dataset grezzo, il dataset pulito, il registro di screening, il file delle regole di esclusione, il registro del lavoro sul campo e il record delle versioni del dataset non sono stati salvati separatamente e bloccati.
Tabella 2: Screening delle risposte, regole di esclusione e decisioni sulla gestione dei dati. Questa tabella riassume le regole di screening predefinite e le decisioni di gestione dei dati per consentimento, idoneità, risposte duplicate, controllo dell'attenzione, tempo di completamento, controlli dei modelli di risposta, mancanza e bloccaggio del dataset. Le regole di esclusione vengono applicate prima di esaminare le correlazioni costruttici, i risultati dei modelli di misura, i percorsi strutturali o le stime di associazione indiretta. Ogni risposta esclusa viene registrata in un registro di screening de-identificato utilizzando il codice anonimo del partecipante, la categoria di esclusione, il motivo dell'esclusione, la data di screening e la decisione di screening. Clicca qui per scaricare questa tabella.
8. Gestione dei dati mancanti
- Evita la mancanza di valori nelle domande di consenso, nell'idoneità e nei 33 elementi sostanziali della scala Likert impostando questi campi come richiesto dal sistema di sondaggio. Ispeziona il dataset pulito per eventuali valori mancanti dopo lo screening.
- Considera i valori mancanti nelle variabili di background opzionali come "non segnalati". Non inserire variabili demografiche o di background opzionali.
- Escludere una variabile di fondo dall'analisi delle covariate se il suo tasso di mancanza supera il 10%. Mantenere una variabile di fondo come covariata solo quando il suo tasso mancante è del 10% o inferiore e la variabile è teoricamente rilevante.
- Non imputare valori mancanti nei 33 elementi sostanziali della scala Likert. Se viene rilevata mancanza di elementi sostanziali nonostante le impostazioni di risposta richiesta, si identifica se il problema è causato dall'esportazione del sondaggio, dalla logica del sondaggio o dalla gestione incompleta delle sottomissioni prima di finalizzare il dataset pulito.
NOTA: Registra il controllo dei dati mancanti. Segnala il numero di valori mancanti e il tasso mancante per il codice dei partecipanti, le variabili di fondo, gli elementi sostanziali della scala Likert, i punteggi dimensionali e i punteggi globali dei costrutti.
9. Codificare le variabili e calcolare i punteggi
- Codifica tutti gli elementi sostanziali della scala Likert da 1 a 5: 1 = fortemente in disaccordo, 2 = in disaccordo, 3 = neutrale, 4 = d'accordo e 5 = fortemente d'accordo. Genere del codice, livello accademico, anno di studio, categoria disciplinare, ore settimanali di apprendimento online e esperienza di apprendimento online precedente secondo il codebook bloccato.
- Ispezionare tutte le variabili per valori fuori intervallo prima di calcolare i punteggi delle dimensioni o dei costrutti globali.
- Calcola i punteggi delle dimensioni dell'esperienza di apprendimento online come media degli elementi: usabilità della piattaforma = media(OLE_PU1–OLE_PU3), supporto didattico = media(OLE_IS1–OLE_IS3), qualità dell'interazione = media(OLE_IQ1–OLE_IQ3) e flessibilità di apprendimento = media(OLE_LF1–OLE_LF3).
- Calcola i punteggi delle dimensioni dei bisogni psicologici di base come mezzi dell'item: bisogno di autonomia = media(BPN_AU1–BPN_AU3), bisogno di competenza = media(BPN_CO1–BPN_CO3) e bisogno di parentelo = medio(BPN_RE1–BPN_RE3).
- Calcola i punteggi delle dimensioni di coinvolgimento nell'apprendimento come medie degli item: coinvolgimento comportamentale = media(LE_BE1–LE_BE4), coinvolgimento cognitivo = medio(LE_CE1–LE_CE4) e coinvolgimento emotivo = medio(LE_EE1–LE_EE4).
- Calcolare i punteggi globali dei costrutti come medie dimensionali: esperienza di apprendimento online = media (usabilità della piattaforma, supporto didattico, qualità dell'interazione, flessibilità di apprendimento); Bisogni psicologici di base = media (bisogno di autonomia, bisogno di competenza, bisogno di correlazione); e coinvolgimento nell'apprendimento = media (coinvolgimento comportamentale, coinvolgimento cognitivo, coinvolgimento emotivo).
- Conservare dati a livello di item per la valutazione dei modelli di misura, punteggi dimensionali per la stima di costrutti di ordine superiore e analisi di sottodimensioni, e punteggi globali per statistiche descrittive, analisi di correlazione, controllo dei modelli strutturali e analisi di robustezza basata su regressione.
NOTA: Non includere l'elemento di controllo dell'attenzione in nessun punteggio, analisi dell'affidabilità, analisi di validità, stima PLS-SEM, analisi di associazioni indirette o analisi di robustezza. Non standardizzare i punteggi originali 1–5 prima dell'analisi descrittiva.
10. Controllare e valutare il bias comune del metodo
- Applicare i controlli procedurali prima dell'analisi utilizzando risposte anonime, formulazione neutra, blocchi costrutti separati, un elemento di controllo dell'attenzione basato sulle istruzioni, impostazioni di risposta richiesta e accesso limitato ai dati grezzi.
- Dopo lo screening delle risposte, si utilizza il test a singolo fattore di Harman per verificare se un fattore non ruotato tenga conto di una quota dominante della varianza degli oggetti. Considera accettabile il risultato quando il primo fattore non ruotato rappresenta meno del 50% della varianza totale.
- Calcola i valori completi del fattore di inflazione della varianza collinearità per i costrutti focali. Si considerano valori inferiori a 3,30 come indicazioni che un forte bias comune nel metodo è improbabile. Registra il bias del metodo comune come limitazione se il primo fattore non ruotato rappresenta il 50% o più della varianza totale o se qualsiasi fattore di inflazione della varianza collineare completa è 3,30 o superiore.
NOTA: Non dichiarare che il bias comune del metodo è assente. Specifica solo se la diagnostica indica evidenza grave di un fattore dominante del metodo comune.
11. Effettuare controlli descrittivi e preliminari
- Utilizzare R 4.4.1 per statistiche descrittive, controlli di distribuzione, analisi di correlazione e analisi di robustezza basata su regressione. Calcolare frequenze e percentuali per le caratteristiche categoriche dei partecipanti.
- Calcola media, deviazione standard, minimo, massimo, asimicolità e kurtosi per elementi sostanziali, punteggi dimensionali e punteggi globali dei costrutti.
- Ispezionare le distribuzioni di item e punteggi per effetti floor, ceiling effect e gravemente non normalità. Definire un potenziale effetto floor o ceiling come più del 20% dei partecipanti che sceglie l'opzione di risposta più bassa o più alta per un item sostanziale.
- Calcola le correlazioni di Pearson tra costrutti globali e punteggi dimensionali. Considerare le correlazioni solo come prove descrittive preliminari e non usarle come sostituto del modello strutturale predefinito.
NOTA: Registra gli effetti di fondo o tetto come caratteristiche di dato. Non eliminare i casi per motivi di distribuzione a meno che non violino anche regole predefinite sulla qualità delle risposte.
12. Stima del modello di misura di ordine superiore
- Usa Smart PLS 4.1 per l'analisi primaria PLS-SEM e importa il dataset a livello di item pulito. Specificare l'usabilità della piattaforma, il supporto didattico, la qualità dell'interazione, la flessibilità dell'apprendimento, il bisogno di autonomia, il bisogno di competenza, il bisogno di correlazione, l'impegno comportamentale, l'impegno cognitivo e l'impegno emotivo come costrutti riflessivi di primo ordine.
- Usa l'approccio disgiunto a due fasi. Nella prima fase, stimare i costrutti riflettivi del primo ordine e salvare i loro punteggi delle variabili latenti.
- Nella seconda fase, utilizzare punteggi variabili latenti di usabilità della piattaforma, supporto didattico, qualità dell'interazione e flessibilità di apprendimento per rappresentare l'esperienza di apprendimento online; i punteggi variabili latenti di bisogno di autonomia, necessità di competenza e correlazione devono rappresentare bisogni psicologici di base; e punteggi variabili latenti di coinvolgimento comportamentale, cognitivo ed emotivo per rappresentare l'impegno nell'apprendimento.
- Consideriamo i punteggi dei costrutti di ordine superiore come rappresentazioni analiticamente derivate di costrutti multidimensionali. Non descriverle come formative a meno che un modello formativo non sia esplicitamente specificato e giustificato. Salva le impostazioni della prima fase, delle impostazioni della seconda fase, i punteggi delle variabili latenti e i file di output modello nella cartella di verifica.
NOTA: Utilizzare la stessa procedura di costrutto di ordine superiore nel modello strutturale principale, analisi delle sottodimensioni del bisogno psicologico e analisi della robustezza basata sulla regressione.
13. Valutare il modello di misurazione
- Valuta il modello di misura prima di interpretare il modello strutturale. Esaminare i carichi esterni standardizzati per tutti i indicatori mantenuti. Mantenere indicatori con carichi di almeno 0,70 quando possibile.
- Rivedi gli indicatori con carichi compresi tra 0,40 e 0,70. Rimuovere un indicatore solo quando la cancellazione migliora l'affidabilità o la validità convergente e non indebolisce la copertura dei contenuti. Rimuovere indicatori inferiori a 0,40 a meno che una ragione teorica documentata non supporti la retenzione.
- Valutare la coerenza interna utilizzando l'affidabilità alfa e composita di Cronbach. Considera valori compresi tra 0,70 e 0,95 come accettabili. Valutare la validità convergente utilizzando la varianza media estratta. Considera valori di almeno 0,50 come accettabili.
- Valutare la validità discriminante utilizzando il rapporto eterotratto-monotratto. Usare 0,85 come soglia conservativa e 0,90 come soglia massima accettabile per costrutti teoricamente adiacenti.
- Indicatori di record retained (record retained indicators), carichi esterni standardizzati, alpha di Cronbach, affidabilità composita, varianza media estratta, valori eterotratto-monotratti e qualsiasi decisione di eliminazione di elementi nell'output del modello di misurazione bloccato.
NOTA: Non eliminare gli elementi solo per migliorare i valori statistici. Rimuovere un elemento solo quando sono documentate sia debolezze statistiche che ridondanza concettuale.
PUNTO DI PAUSA: Non iniziare i test strutturali finché indicatori conservati, valori di caricamento, valori di affidabilità, validità convergente, validità discriminante, voci del codebook e valori di output di misura non sono stati confrontati con i file di analisi bloccati.
14. Testare il modello strutturale e il percorso di mediazione
- Specifica tre percorsi strutturali: esperienza di apprendimento online → bisogni psicologici di base, bisogni psicologici di base → coinvolgimento nell'apprendimento e esperienza di apprendimento online → coinvolgimento nell'apprendimento.
- Includere ore settimanali di apprendimento online e esperienze di apprendimento online pregresse come variabili di controllo predefinite. Considerare genere, livello accademico, anno di studio e categoria disciplinare come variabili descrittive salvo inclusione in un modello di sensibilità predefinito.
- Esaminare la collinearità dei modelli strutturali prima di interpretare i coefficienti di cammino. Considerare i valori del fattore di inflazione della varianza inferiori a 3,30 come indicazioni che la collinearità dannosa è improbabile.
- Stima coefficienti di percorso standardizzati, valori t , valori p e intervalli di confidenza al 95% utilizzando 5.000 ricampionamenti bootstrap con test a due code. Utilizzare intervalli di confidenza corretti per bias quando disponibili.
- Stima il percorso indiretto dall'esperienza di apprendimento online all'impegno nell'apprendimento attraverso i bisogni psicologici di base. Considerare il percorso di associazione indiretta come supportato quando l'intervallo di fiducia bootstrap per l'effetto indiretto non include zero.
- Registra l'effetto diretto, l'effetto indiretto, l'effetto totale, i valori di R2 , i valori di R2 aggiustati, le dimensioni dell'effetto f2 , i valori del fattore di inflazione della varianza del modello strutturale e i percorsi delle variabili di controllo nell'output del modello strutturale bloccato. Interpretare tutte le stime strutturali come percorsi basati sull'associazione piuttosto che come effetti causali.
NOTA: Non rimuovere un percorso prespecificato perché non è significativo. Mantenere il modello prespecificato a meno che non venga identificato un errore di codifica o di specifica del modello.
15. Esaminare le sottodimensioni del bisogno psicologico
- Sostituire il costrutto globale dei bisogni psicologici fondamentali con il bisogno di autonomia, il bisogno di competenza e il bisogno di correlazione come costrutti paralleli di associazione indiretta. Stima separatamente i percorsi indiretti dall'esperienza di apprendimento online all'impegno nell'apprendimento attraverso il bisogno di autonomia, il bisogno di competenza e il bisogno di correlazione.
- Usa 5.000 ricampionamenti bootstrap per ogni percorso di subdimensione. Confronta la direzione, la grandezza e l'intervallo di confidenza di ciascun percorso indiretto di sottodimensione. Considera questa analisi come un'analisi di sensibilità piuttosto che come modello primario.
NOTA: Non reinterpretare l'analisi della sensibilità subdimensionale come un nuovo modello primario.
16. Condurre un'analisi di robustezza basata su regressione
- Esporta il dataset di costrutto del punteggio pulito e salvalo come ConstructScores_OnlineLearning_BPN_Engagement_YYYYMMDD.csv. Usa R 4.4.1 per regredire i bisogni psicologici globali di base sull'esperienza globale di apprendimento online, le ore settimanali di apprendimento online e l'esperienza di apprendimento online precedente.
- Rigredire l'impegno globale nell'apprendimento sull'esperienza globale di apprendimento online, sui bisogni psicologici di base globali, sulle ore settimanali di apprendimento online e sulle esperienze di apprendimento online precedenti. Stima il percorso indiretto utilizzando 5.000 ricampionamenti bootstrap.
- Confronta il percorso indiretto basato sulla regressione con il percorso indiretto PLS-SEM. Classifica il percorso come robusto solo quando la direzione rimane coerente e l'interpretazione sostanziale non cambia. Salva lo script R, le impostazioni di bootstrap e l'output di robustezza nella cartella di verifica.
PUNTO DI PAUSA: Non iniziare il blocco finale del file finché il modello strutturale, l'analisi delle sottodimensioni e l'analisi di robustezza basata su regressione non sono stati incrociati.
17. Gestire risultati analitici subottimali
- Se l'affidabilità alfa o composita di Cronbach è inferiore a 0,70, si ispezionano le correlazioni totali di elementi e i carichi esterni standardizzati. Se la varianza media estratta è inferiore a 0,50, si ispezionano gli indicatori conservati e si identifica se uno o più indicatori indeboliscono la validità convergente.
- Se i valori di eterotratto-monotratto superano la soglia prestabilita, si ispeziona la formulazione degli elementi per la sovrapposizione semantica tra costrutti teoricamente vicini. Rimuovi un elemento debole solo quando è statisticamente debole e concettualmente ridondante. Mantenere separati i costrutti teoricamente adiacenti quando li si uniscono ridurrebbe la chiarezza concettuale.
- Se il percorso indiretto non è supportato, si registra il risultato come un'associazione indiretta non supportata. Se le variabili di controllo mostrano associazioni non significative, registra i risultati senza sovrainterpretazioni.
NOTA: Non rivedere il modello teorico dopo l'analisi per forzare un supporto più forte.
18. Blocca output software e file di riproducibilità
- Crea una cartella finale di verifica istituzionale chiamata Verification_OnlineLearning_BPN_Engagement_YYYYMMDD.
- Salva l'archivio grezzo del dataset, il dataset pulito, il dataset costrutto-score, il codebook, il questionario, la tabella di mappatura element-source, il registro delle revisioni esperte, il record del test pilota, il log del lavoro sul campo, il registro di screening, il file delle regole di esclusione, il record soglia del tempo di completamento, gli output Smart PLS, gli script R, le tabelle di output R, il record versione software e il log delle modifiche di versione nella cartella di verifica.
- Salva file di progetto Smart PLS 4.1 e output di measurement-model, structural-model, bootstrap e heterotrait-monotrait esportati in una sottocartella chiamata SmartPLS_Output. Salva script R e tabelle di output R in una sottocartella chiamata R_Output. Salva il questionario, la mappatura element-source, la codifica delle variabili e le regole di punteggio come File Supplementare 1.
- Salva la verifica finale del dataset analitico, il riassunto dello screening, il record dei dati mancanti, la diagnostica del bias del metodo comune, i risultati del modello di misurazione, i risultati del modello strutturale, i risultati dell'associazione indiretta, l'analisi delle sottodimensioni, il record di robustezza basato sulla regressione, le impostazioni software e il record versione come File Supplementare 2.
- Non includere informazioni direttamente identificabili, record grezzi esclusi o dati grezzi a livello di partecipante nel manoscritto o nei file supplementari inviati per la pubblicazione. Blocca la cartella finale di verifica dopo il controllo di coerenza. Salva le correzioni successive come versioni nuove e datate e documenta il motivo nel registro delle modifiche di versione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Dataset analitico finale e caratteristiche dei partecipanti
Il dataset analitico finale includeva 386 studenti universitari. Il reclutamento formale si è svolto dal 18 agosto 2025 al 26 settembre 2025 tramite piattaforme universitarie, gruppi di comunicazione dei corsi, liste email studentesche e canali istituzionali per gli studenti. Sono state esaminate in totale 432 risposte inviate e 386 risposte sono state trattenute, con un tasso di vali...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo protocollo fornisce un flusso di lavoro metodologico riproducibile per valutare i percorsi di associazione tra l'esperienza di apprendimento online, i bisogni psicologici di base e l'impegno nell'apprendimento negli studenti universitari. Invece di trattare l'apprendimento online come una singola condizione, il protocollo separa l'ambiente di apprendimento percepito in usabilità della piattaforma, supporto didattico, qualità dell'interazione e flessibilità di apprendimento. Questa...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere relazioni finanziarie o personali che possano aver influenzato il lavoro riportato in questo articolo.
Ringraziamenti
Ringraziamo sinceramente tutti gli studenti partecipanti per il loro tempo, la collaborazione e le preziose risposte. Ringraziamo inoltre il personale accademico e amministrativo competente per il supporto fornito durante tutto il processo di sondaggio.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Qualtrics online survey platform | Qualtrics | Institutional account; version not applicable | Used to administer the anonymous English-language questionnaire, including consent confirmation, eligibility screening, required-response settings, AC1 attention-check item, response-time recording, and data export. |
| Microsoft Excel for Microsoft 365 | Microsoft Corporation | Microsoft 365 institutional version | Used to store the raw exported dataset, cleaned dataset, codebook, screening log, construct-score file, and verification records in .xlsx and .csv formats. |
| G*Power | Heinrich Heine University Düsseldorf | G*Power 3.1.9.7 | Used for a priori sample-size and power checking before recruitment. |
| SmartPLS | SmartPLS GmbH | SmartPLS 4.1 Professional | Used for the primary PLS-SEM workflow, including disjoint two-stage higher-order construct estimation, measurement-model assessment, structural-pathway testing, bootstrapping, R², f², and model-output export. |
| R statistical software | R Foundation / CRAN | R 4.4.1 | Used for descriptive statistics, Pearson correlations, common method bias diagnostics, and regression-based robustness analysis. |
| R package: psych | CRAN | psych 2.4.6 | Used for descriptive statistics, reliability checks, and psychometric summaries. |
| R package: boot | CRAN | boot 1.3-30 | Used for bootstrap-based regression robustness checks. |
| R package: semPlot | CRAN | semPlot 1.1.6 | Used only for optional path-diagram cross-checking when R-based visual verification is needed. |
| OneDrive for Business or SharePoint version history | Microsoft Corporation | Microsoft 365 institutional account | Used to store the verification folder and preserve version history for raw data, cleaned data, codebook, screening log, SmartPLS outputs, R scripts, and supplementary files. |
| Questionnaire and coding file | Author-prepared study file | Supplementary File 1 | Contains the final questionnaire, item-source mapping, variable names, coding rules, dimension-score formulas, global construct-score formulas, and data-handling rules. |
| Screening and reproducibility record | Author-prepared study file | Supplementary File 2 | Contains final dataset verification, screening checks, missing-data record, reliability results, common method bias diagnostics, measurement-model output, structural-model output, indirect-association results, sensitivity analysis, robustness record, and final consistency checklist. |
| Figure-preparation software | Adobe Illustrator or equivalent vector-editing software | Institutional version | Used to prepare publication-ready workflow and structural-model figures. |
Riferimenti
- Organization for Economic Co-operation and Development. OECD digital education outlook 2021: pushing the frontiers with artificial intelligence, blockchain and robots. Paris: OECD Publishing; 2021. doi:10.1787/589b283f-en.
- Martin F, Bolliger DU. Engagement matters: student perceptions on the importance of engagement strategies in the online learning environment. Online Learn. 2018;22(1):205-222. doi:10.24059/olj.v22i1.1092.
- Dixson MD. Measuring student engagement in the online course: the Online Student Engagement scale (OSE). Online Learn. 2015;19(4). doi:10.24059/olj.v19i4.561.
- Bond M, Buntins K, Bedenlier S, Zawacki-Richter O, Kerres M. Mapping research in student engagement and educational technology in higher education: a systematic evidence map. Int J Educ Technol High Educ. 2020;17(1):2. doi:10.1186/s41239-019-0176-8.
- Vansteenkiste M, Ryan RM, Soenens B. Basic psychological need theory: advancements, critical themes, and future directions. Motiv Emot. 2020;44(1):1-31. doi:10.1007/s11031-019-09818-1.
- Chen KC, Jang SJ. Motivation in online learning: testing a model of self-determination theory. Comput Human Behav. 2010;26(4):741-752. doi:10.1016/j.chb.2010.01.011.
- Chiu TKF. Applying the self-determination theory to explain student engagement in online learning during the COVID-19 pandemic. J Res Technol Educ. 2022;54(sup1):S14-S30. doi:10.1080/15391523.2021.1891998.
- Bedenlier S, Bond M, Buntins K, Zawacki-Richter O, Kerres M. Facilitating student engagement through educational technology in higher education: a systematic review in the field of arts and humanities. Australas J Educ Technol. 2020;36(4):126-150. doi:10.14742/ajet.5477.
- Ward MK, Meade AW. Dealing with careless responding in survey data: prevention, identification, and recommended best practices. Annu Rev Psychol. 2023;74:577-596. doi:10.1146/annurev-psych-040422-045007.
- Zawacki-Richter O, Kerres M, Bedenlier S, Bond M, Buntins K, editors. Systematic reviews in educational research: methodology, perspectives and application. Wiesbaden: Springer VS; 2020. doi:10.1007/978-3-658-27602-7.
- Hair JF, Hult GTM, Ringle CM, Sarstedt M. A primer on partial least squares structural equation modeling. 3rd ed. Thousand Oaks: Sage Publications; 2022.
- Wut TM, Ng PML, Low MP. Engaging university students in online learning: a regional comparative study from the perspective of social presence theory. J Comput Educ. 2024;11(3):763-789. doi:10.1007/s40692-023-00278-8.
- Stone C, O’Shea S. Older, online and first: recommendations for retention and success. Australas J Educ Technol. 2019;35(1):57-69. doi:10.14742/ajet.3913.
- Salas-Pilco SZ, Yang Y, Zhang Z. Student engagement in online learning in Latin American higher education during the COVID-19 pandemic: a systematic review. Br J Educ Technol. 2022;53(3):593-619. doi:10.1111/bjet.13190.
- Maxwell SE, Cole DA. Bias in cross-sectional analyses of longitudinal mediation. Psychol Methods. 2007;12(1):23-44. doi:10.1037/1082-989X.12.1.23.
- Richardson JC, Maeda Y, Lv J, Caskurlu S. Social presence in relation to students’ satisfaction and learning in the online environment: a meta-analysis. Comput Human Behav. 2017;71:402-417. doi:10.1016/j.chb.2017.02.001.
- Meade AW, Craig SB. Identifying careless responses in survey data. Psychol Methods. 2012;17(3):437-455. doi:10.1037/a0028085.
- Deci EL, Ryan RM. The “what” and “why” of goal pursuits: human needs and the self-determination of behavior. Psychol Inq. 2000;11(4):227-268. doi:10.1207/S15327965PLI1104_01.
- Fredricks JA, Blumenfeld PC, Paris AH. School engagement: potential of the concept, state of the evidence. Rev Educ Res. 2004;74(1):59-109. doi:10.3102/00346543074001059.
- Garrison DR, Anderson T, Archer W. Critical inquiry in a text-based environment: computer conferencing in higher education. Internet High Educ. 2000;2(2-3):87-105. doi:10.1016/S1096-7516(00)00016-6.
- Cole DA, Maxwell SE. Testing mediational models with longitudinal data: questions and tips in the use of structural equation modeling. J Abnorm Psychol. 2003;112(4):558-577. doi:10.1037/0021-843X.112.4.558.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903. doi:10.1037/0021-9010.88.5.879.
- Gašević D, Dawson S, Siemens G. Let’s not forget: learning analytics are about learning. TechTrends. 2015;59(1):64-71. doi:10.1007/s11528-014-0822-x.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo