Questo protocollo descrive come costruire, addestrare e valutare un framework multiview Vision Mamba U-Shaped Network per la segmentazione delle immagini mediche, consentendo la segmentazione riproducibile di lesioni cutanee e organi addominali attraverso la preparazione standardizzata di dataset, l'implementazione del modello e la valutazione delle prestazioni.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
Quadro di rete multi-vista Mamba a forma di U per la segmentazione delle immagini mediche
In questo articolo
Sommario
Abstract
La segmentazione delle immagini mediche richiede metodi computazionali che catturano con precisione il contesto globale, i confini locali e le strutture anatomiche su scala multipla, rimanendo pur riproducibili tra diverse applicazioni. Questo articolo presenta un protocollo per costruire, addestrare e valutare un framework Multi-view Vision Mamba U-Shaped Network per la segmentazione bidimensionale di immagini mediche. Il protocollo fornisce un flusso di lavoro riproducibile che include l'acquisizione di dataset pubblici, la pre-elaborazione di immagini e maschere, la costruzione di reti, l'addestramento del modello, la selezione dei checkpoint e la valutazione delle prestazioni quantitative e qualitative. Il framework incorpora la scansione delle feature multiview per catturare informazioni spaziali, di contorno, di scala e di confine complementari e applica la fusione delle feature multistadio all'interno di un'architettura encoder-decoder a forma di U per migliorare l'integrazione delle feature durante la segmentazione. Il protocollo viene dimostrato utilizzando dataset pubblici di segmentazione delle lesioni cutanee e degli organi addominali. Secondo il flusso di lavoro di implementazione descritto, il framework raggiunge prestazioni di segmentazione competitive utilizzando metriche di valutazione standard. Seguendo le procedure presentate in questo protocollo, i ricercatori possono riprodurre l'implementazione del modello, addestrare la rete utilizzando impostazioni sperimentali definite, valutare le prestazioni di segmentazione e adattare il flusso di lavoro per compiti correlati di segmentazione di immagini mediche che richiedono analisi riproducibili basate su deep learning.
Introduzione
La segmentazione delle immagini mediche è un compito fondamentale nei campi della visione artificiale e dell'analisi delle immaginimediche 1,2,3. Consiste nel partizionare un'immagine in più regioni o oggetti per ulteriori analisi e elaborazioni. Questa tecnologia è particolarmente importante nell'imaging medico perché aiuta i clinici a identificare e localizzare le regioni patologiche, migliorando così l'accuratezza diagnostica e la pianificazione del trattamento. Con il progresso delle tecnologie di imaging medico, come la risonanza magnetica (MRI), la tomografia computerizzata (TC) e la tomografia a emissione di positroni (PET), la domanda di tecniche accurate di segmentazione delle immagini mediche è continuata ad aumentare. I metodi attuali per la segmentazione delle immagini mediche possono essere ampiamente suddivisi in tre approcci principali: metodi basati su reti neurali convoluzionali (CNN) 4, metodibasati su Transformer 5 e metodi basati su modelli nello spazio di stati (SSM) 6,7. I metodi basati su CNN impiegano tipicamente architetture di rete a forma di U per la segmentazione delle immagini mediche. L'architettura più diffusa in questa categoria èU-Net 8, che ha dimostrato l'efficacia di un'architettura encoder–decoder a forma di U per la segmentazione delle immagini biomediche. U-Net3+ combina connessioni di salto dense da UNet++9 con connessioni di salto su larga scala per migliorare l'aggregazione di caratteristiche multiscala. Tuttavia, i metodi basati su CNN hanno una capacità limitata di catturare dipendenze a lungo raggio e, di conseguenza, potrebbero non modellare efficacemente le informazioni contestuali a lungo raggio.
I metodi basati su trasformatori catturano efficacemente le dipendenze a lungo raggio attraverso il meccanismo di auto-attenzione, che consente il calcolo parallelo e assegna diversi pesi di attenzione a diverse regioni di interesse. UNETR++10 introduce il modulo Efficient Pair Attention (EPA) per ridurre il numero di parametri e i costi computazionali. nnFormer11 combina operazioni convoluzionali intercalate e di auto-attenzione e introduce un meccanismo di auto-attenzione locale–globale basato su volume per l'apprendimento delle rappresentazioni volumetriche nella segmentazione tridimensionale (3D) di immagini mediche. H2Former12 propone un efficiente Transformation di Visione ibrido gerarchico che combina meccanismi di attenzione con l'estrazione di caratteristiche basata su CNN nell'encoder. Tuttavia, i metodi basati su Transformer mostrano complessità computazionale quadratica con l'aumento della lunghezza della sequenza, risultando in costi computazionali sostanzialmente superiori. La Figura 1 illustra la motivazione per MVM-UNet e confronta la strategia proposta di scansione multiview con i framework di segmentazione basati su SSM esistenti.
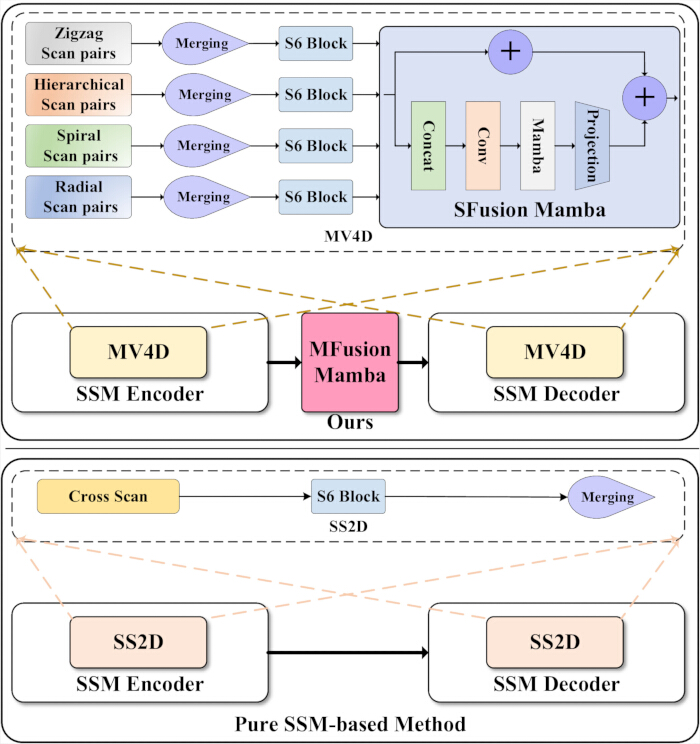
Figura 1. Confronto di MVM-UNet con le architetture di segmentazione basate su modello di spazio di stato puro (SSM) esistenti. Confronto tra un framework di segmentazione convenzionale basato su modello di spazio di stati puro (SSM) e l'architettura proposta Multi-View Mamba U-Net (MVM-UNet). Il pannello superiore illustra MVM-UNet, in cui il modulo Multi-View 4-Directional (MV4D) estrae caratteristiche complementari utilizzando coppie di scansione a zigzag, gerarchiche, a spirale e radiali integrate tramite Spatial Fusion Mamba (SFusion Mamba), mentre Multi-stage Fusion Mamba (MFusion Mamba) aggrega le caratteristiche degli encoder multiscala prima della decodifica. Il pannello inferiore mostra un'architettura rappresentativa basata su SSM puro utilizzando moduli Selective Scan 2-Dimensional (SS2D) con cross scanning. La figura evidenzia le differenze architettoniche tra le reti di segmentazione convenzionali basate su SSM e il proposto MVM-UNet. Clicca qui per visualizzare una versione più grande di questa figura.
I metodi basati su SSM combinano la capacità globale di modellazione dei Transformers con la complessità computazionale lineare. L'architettura Mamba elabora selettivamente le informazioni di input utilizzando un modello selettivo dello spazio degli stati (Selective-SSM), permettendo al modello di regolare dinamicamente i propri parametri in base all'input, filtrando le informazioni irrilevanti e enfatizzando le caratteristiche informative. Vim13 e VMamba14 adattano l'architettura Mamba per compiti di visione artificiale. U-Mamba15 impiega un'architettura ibrida CNN–SSM per esplorare l'applicazione degli SSM nella segmentazione delle immagini mediche, mentre Mamba-UNet16 adotta un'architettura encoder-decoder completamente basata su SSM per la segmentazione delle immagini mediche. Questi metodi raggiungono prestazioni competitive utilizzando parametri sostanzialmente inferiori. Tuttavia, i metodi attuali basati su SSM/Mamba estraggono principalmente le caratteristiche dell'immagine utilizzando semplici patch e strategie di scansione SS2D, che presentano diverse limitazioni per la segmentazione delle immagini mediche. Innanzitutto, le tecniche SS2D e basate su patch sono progettate principalmente per compiti generali di visione artificiale. Local Mamba17 e MotionMamba 18 hanno suggerito che la strategia di scansione SS2D sia insufficiente per tutti i compiti visivi perché diverse strategie catturano diversi tipi di informazioni visive. In secondo luogo, la strategia di scansione SS2D è relativamente semplice, basandosi solo su direzioni di scansione orizzontali e verticali. Di conseguenza, potrebbe non catturare adeguatamente relazioni spaziali complesse e dettagli strutturali fini. La segmentazione delle immagini mediche richiede la modellazione simultanea sia del contesto spaziale globale sia delle precise caratteristiche anatomiche locali. Inoltre, i metodi attuali basati su SSM/Mamba forniscono una fusione limitata delle caratteristiche tra encoder e decoder. Architetture come UNet++ e FATNet migliorano la precisione della segmentazione attraverso una fusione di funzionalità migliorata, evidenziando l'importanza di un'integrazione efficace delle funzionalità per la segmentazione delle immagini mediche.
Per affrontare queste limitazioni, questo articolo propone un nuovo framework di segmentazione delle immagini mediche basato su Mamba, denominato MVM-UNet. Come mostrato nella Figura 1, il modulo proposto Multi-View Four-Directional (MV4D) funge da componente centrale per l'estrazione delle caratteristiche di MVM-UNet ed è specificamente progettato per la segmentazione delle immagini mediche integrando informazioni provenienti da quattro strategie di scansione distinte. Ogni strategia di scansione estrae caratteristiche dell'immagine complementare e rappresenta una vista diversa dell'immagine di input. La scansionea zigzag 19 alterna la direzione di percorrenza alla fine di ogni riga o colonna, bilanciando così le informazioni spaziali locali e globali. Al contrario, gli schemi a scansione a spirale e radiale20 offrono una copertura completa estendendosi sia verso l'esterno dal centro sia verso l'interno dalla periferia. La scansione gerarchica18 cattura sia caratteristiche locali che globali su più scale. Per migliorare la robustezza di ogni strategia di scansione, le coppie di scansione vengono unite prima di essere inserite nel blocco S6. Il modulo Scan-view Fusion Mamba (SFusion Mamba) integra successivamente le caratteristiche estratte dalle quattro modalità di scansione. Per utilizzare efficacemente le funzionalità degli encoder multiscala, questo articolo propone inoltre un modulo di fusione Mamba multiscala (MFusion Mamba), che accumula e fonde le uscite di ogni stadio del codificatore prima di passare le caratteristiche fuse al decodificatore. MVM-UNet è stato valutato sui dataset ISIC 2017, ISIC 2018 e Synapse. I risultati sperimentali dimostrano che MVM-UNet raggiunge performance di segmentazione competitive sui dataset ISIC 2017, ISIC 2018 e Synapse.
Le architetture di segmentazione rappresentativa hanno ulteriormente avanzato la segmentazione delle immagini mediche. U-Net è stato applicato con successo anche a compiti di analisi delle immagini biomediche come il conteggio delle cellule, la rilevazione e lamorfometria 21. Le architetture CNN potenziate dall'attenzione, comeCA-Net 22, migliorano la rappresentazione delle caratteristiche attraverso meccanismi di attenzione completi. I framework rappresentativi di segmentazione basati su Transformer, tra cui TransUNet23, Pyramid MedicalTransformer 24, SwinU-Net 25, TransAttUNet26 eTransCUNet 27, dimostrano ulteriormente l'efficacia della modellazione globale delle caratteristiche basata sull'attenzione per la segmentazione delle immagini mediche.
La progettazione di MVM-UNet è motivata da due limitazioni dei metodi di segmentazione esistenti basati su SSM/Mamba. Innanzitutto, molti modelli attuali di Vision Mamba si basano su semplici strategie di scansione bidimensionale, che potrebbero essere insufficienti per immagini mediche con confini irregolari delle lesioni, piccole regioni bersaglio e strutture anatomiche multiscala. In secondo luogo, le architetture convenzionali encoder–decoder a forma di U trasferiscono principalmente caratteristiche attraverso le corrispondenti connessioni di salto, limitando l'uso diretto delle informazioni degli encoder multistadio durante la decodifica. Pertanto, MVM-UNet introduce MV4D per migliorare la modellazione spaziale multiview e MFusion Mamba per aggregare esplicitamente le caratteristiche degli encoder multistadio. Questo design è pensato per adattare la modellazione a lungo raggio basata su Mamba ai requisiti specifici della segmentazione delle immagini mediche.
Sebbene MVM-UNet sia costruito sul paradigma generale encoder–decoder e sulla modellazione di sequenze basata su Mamba, la sua novità risiede nel modo in cui questi componenti vengono adattati e integrati per la segmentazione delle immagini mediche. Piuttosto che semplicemente incorporare un blocco Mamba standard in una rete a forma di U, il framework proposto ridisegna il processo di modellazione spaziale attraverso più ramificazioni scan-pair orientate al compito, introduce SFusion Mamba per integrare rappresentazioni specifiche per la scansione, migliora il blocco MVV con percorsi residui e di proiezione, e inserisce MFusion Mamba tra encoder e decoder per aggregare le caratteristiche multistadio dell'encoder prima della decodifica. Questo design a livello architettonico mira ad affrontare i confini irregolari, le piccole regioni target e le strutture anatomiche multiscala comunemente osservate nelle immagini mediche.
Questo protocollo è più adatto per compiti di segmentazione che richiedono la modellazione simultanea di informazioni contestuali a lungo raggio, confini irregolari degli oggetti e strutture anatomiche multiscala in immagini mediche bidimensionali. Rispetto ai metodi di segmentazione basati su CNN, il design encoder–decoder basato su Mamba offre un meccanismo efficace di modellazione contestuale mantenendo un flusso di lavoro a forma di U familiare ai ricercatori di segmentazione delle immagini mediche. Rispetto ai metodi basati su Transformer, il framework proposto evita l'uso diretto dell'autoattenzione quadratica ed è destinato ai ricercatori che cercano modellazione contestuale globale utilizzando un meccanismo di modellazione di sequenza relativamente efficiente. Di conseguenza, questo protocollo è adatto per la segmentazione delle lesioni cutanee, la segmentazione degli organi addominali e compiti simili di segmentazione delle immagini mediche bidimensionali, in cui sono importanti sia le informazioni strutturali globali sia i dettagli dei confini locali.
Questo protocollo presenta anche delle limitazioni che dovrebbero essere considerate prima dell'utilizzo. Potrebbe non essere necessario per compiti di segmentazione relativamente semplici in cui una CNN leggera fornisce già prestazioni sufficienti. Inoltre, non è progettato direttamente per una segmentazione volumetrica tridimensionale completa senza un adattamento architettonico. I ricercatori con dati annotati molto limitati, risorse limitate per unità di elaborazione grafica (GPU) o requisiti di modelli classici altamente interpretabili dovrebbero considerare questi vincoli prima di applicare il protocollo. In generale, questo metodo è pensato per ricercatori che desiderano riprodurre e valutare un framework di segmentazione a forma di U basato su Mamba che bilancia la modellazione del contesto a lungo raggio, la rappresentazione locale dei confini e la fusione di caratteristiche multistadio.
I contributi chiave sono i seguenti:
1. Questo articolo presenta un nuovo framework di segmentazione delle immagini mediche basato su Mamba, denominato MVM-UNet. A differenza degli approcci che incorporano direttamente blocchi Mamba esistenti basati su SS2D o standard, MVM-UNet introduce MV4D per modellare le caratteristiche dell'immagine medica da quattro viste a coppie di scansione complementari, inclusi scansione a zigzag, gerarchica, a spirale e radiale.
2. Questo articolo progetta SFusion Mamba e il blocco MVV per integrare rappresentazioni specifiche per la scansione e migliorare la trasformazione delle caratteristiche. SFusion Mamba fonde le caratteristiche estratte da diversi rami di coppie di scansione, mentre i rami residui e quelli di proiezione Up-Down all'interno del blocco MVV forniscono percorsi complementari di caratteristiche che stabilizzano e arricchiscono le rappresentazioni delle caratteristiche.
3. Questo articolo introduce MFusion Mamba come modulo di fusione multistadio intermedio tra encoder e decoder. A differenza delle connessioni di salto convenzionali che trasferiscono principalmente caratteristiche dello stadio corrispondente, MFusion Mamba aggrega esplicitamente le caratteristiche dell'encoder multistadio tramite fusione da grossolano a fine e fornisce informazioni arricchite per la decodifica.
4. Ampi risultati sperimentali dimostrano che il proposto MVM-UNet raggiunge performance di segmentazione competitiva sui dataset ISIC 2017 e ISIC 2018 e forti prestazioni sul dataset di segmentazione multiorgano Synapse. Inoltre, studi di ablazione approfonditi validano il contributo di ciascun componente all'interno di MVM-UNet.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato solo dataset di immagini mediche pubblicamente disponibili e de-identificate, tra cui ISIC 2017, ISIC 2018 e Synapse. In questo studio non sono stati raccolti nuovi partecipanti umani, soggetti animali o cartelle cliniche private identificabili. Il dataset ISIC 2017 utilizzato in questo studio è stato il dataset di segmentazione delle lesioni cutanee ISIC 2017 Challenge, ottenuto dal repository ufficiale della International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). La versione del dataset utilizzata in questo studio corrisponde al compito di segmentazione delle lesioni ISIC 2017, inclusi le partizioni ufficiali di addestramento, validazione e test. Il dataset è stato scaricato il 15 marzo 2024. Il dataset ISIC 2018 utilizzato in questo studio è stato il dataset di segmentazione dei confini delle lesioni ISIC Challenge Task 1, ottenuto dal repository ufficiale di dati della International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). La versione del dataset utilizzata in questo studio corrisponde al Compito 1 ISIC 2018: Segmentazione dei confini delle lesioni. Il dataset è stato scaricato l'8 luglio 2024.
Il dataset Synapse utilizzato in questo studio è stato il multi-Atlas Labeling Beyond the Cranial Vault abdominal CT, ottenuto dal repository Synapse con l'identificativo di accessione syn3193805 (https://www.synapse.org/Synapse:syn3193805). Il dataset utilizzato in questo studio corrisponde al comune dataset di segmentazione multiorgano per TC addominale di 30 casi. L'archivio scaricato era Abdomen/RawData.zip, disponibile sotto accession syn3193805. Al momento del download non è stato fornito alcun numero di versione, etichetta di release o tag datato separato. A seguito della suddivisione degli standard adottata negli studi precedenti, 18 casi sono stati utilizzati per l'addestramento e 12 per i test. La suddivisione dei dati ha seguito la lista dei casi utilizzata da TransUNet23. In particolare, i casi di formazione erano case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 e case0037, mentre i casi di prova erano case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0003, case0001, case0004, case0025 e case0035. Il dataset è stato scaricato il 9 luglio 2024. Poiché questo studio utilizzava solo dataset pubblici e de-identificati e non prevedeva la raccolta di nuovi dati umani o informazioni private identificabili, non era richiesta l'approvazione del comitato di revisione istituzionale per gli esperimenti computazionali descritti in questo protocollo. Non è stata ottenuta alcuna determinazione formale scritta sull'esenzione istituzionale. Se richiesto dalla politica istituzionale locale, i ricercatori dovrebbero ottenere una determinazione di esenzione istituzionale prima di condurre analisi secondarie di dataset pubblicamente disponibili. Non era disponibile alcun numero di riferimento per l'esenzione etica istituzionale né documentazione formale di esenzione per questo studio.
1. Preparazione di dataset
- Scarica il dataset ISIC 2017 sulla segmentazione delle lesioni cutanee dall'archivio ufficiale della International Skin Imaging Collaboration. Usa le partizioni ufficiali di formazione, validazione e test. Verifica che il dataset contenga 2.000 immagini di addestramento, 150 immagini di validazione e 600 immagini di test.
- Scarica il dataset di segmentazione delle lesioni cutanee ISIC 2018 dal repository ufficiale della International Skin Imaging Collaboration. Usa le partizioni ufficiali di formazione, validazione e test. Verifica che il dataset di segmentazione contenga 2.594 immagini di addestramento, 100 immagini di validazione e 1.000 immagini di test.
- Scarica il dataset di segmentazione multiorgano Synapse. Utilizzare la divisione standard composta da 18 casi (2.212 fette assiali) per l'addestramento e 12 casi (1.567 fette assiali) per i test. Non introdurre un set di validazione separato.
- Riserva i 12 casi di test esclusivamente per la valutazione finale. Non utilizzare i casi di test per l'addestramento del modello, la sintonia degli iperparametri o la selezione del modello. Il compito di segmentazione comprende otto organi addominali: aorta, cistifellea, milza, rene sinistro, rene destro, fegato, pancreas e stomaco.
- Usa la seguente suddivisione del dataset Synapse. I 18 casi di formazione erano case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 e case0037. I 12 casi testati erano case 0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 e case0035.
- Organizza ogni dataset in cartelle separate per immagini e maschere. Assicurati che ogni immagine abbia una maschera di segmentazione corrispondente con lo stesso identificatore di caso.
- Converti ogni maschera di lesione cutanea in una mappa binaria di segmentazione in primo piano e sfondo. Mantenere le etichette originali multiclass per il dataset Synapse.
- Per i dataset ISIC 2017 e ISIC 2018, assegnare un valore di etichetta pari a 0 ai pixel di sfondo e 1 ai pixel della lesione (in primo piano) dopo la conversione della maschera binaria. I pixel con valori originali della maschera maggiori di 0 sono trattati come primo piano e convertiti in 1, mentre i pixel con valori originali uguali a 0 sono trattati come sfondo e mantenuti come 0. Per il dataset Synapse, mantenere i valori originali dell'etichetta intera, con 0 che rappresenta la classe di sfondo e 1–8 che rappresenta le otto classi di organi in primo piano.
- Ridimensionare le immagini e le maschere ISIC 2017 e ISIC 2018 a 256 × 256 pixel senza preservare il rapporto d'aspetto originale. Non applicare ritaglio o imbottitura.
- Ridimensiona ogni fetta Synapse CT e la corrispondente mappa di etichetta a 224 × 224 pixel. Utilizzare interpolazione bilineare per immagini RGB, interpolazione spline di terzo ordine per le fette CT e interpolazione del vicino più vicino per maschere di segmentazione.
- Ridimensiona le immagini in Python.
- Per i dataset ISIC 2017 e ISIC 2018, si utilizza la trasformata personalizzata myResize implementata in utils.py, che chiama torchvision.transforms.functional.resize per ridimensionare sia i tensori immagine che quelli della maschera a 256 × 256 pixel. Non specificare una modalità di interpolazione esplicita o un argomento di anti-aliasing in questa trasformazione.
- Per il dataset Synapse, usa scipy.ndimage.zoom in datasets/dataset.py. Ridimensionare le sezioni CT a 224 × 224 pixel usando interpolazione spline di terzo ordine (ordine = 3), e ridimensionare le mappe delle etichette usando interpolazione del vicino più prossimo (ordine = 0). Non applicare un'operazione separata di anti-aliasing o un'impostazione anti_aliasing=True durante il ridimensionamento.
- Normalizzare ogni immagine ISIC RGB prima della conversione del tensore usando la media e la deviazione standard (SD) specifiche del dataset usando l'Equazione 1 come segue:
 (1)
Successivamente riscala l'immagine normalizzata nell'intervallo 0–255 usando la normalizzazione min–max.- Utilizzare μ = 159,922 e σ = 28,871 per il set di addestramento ISIC 2017 e μ = 148,429 e σ = 25,748 per i set di validazione e test ISIC 2017. Usare μ = 157,561 e σ = 26,706 per il set di addestramento ISIC 2018 e μ = 149,034 e σ = 32,022 per i set di validazione e test ISIC 2018.
- Converti ogni immagine normalizzata in un tensore di forma 3 × 256 × 256. Converti ogni maschera binaria in un tensore di forma 1 × 256 × 256.
- Eseguire la normalizzazione min–max in modo indipendente per ogni immagine dopo la normalizzazione della media e della deviazione standard specifica del dataset. In particolare, sottrai la media specifica del dataset da ciascuna immagine e dividi per la corrispondente deviazione standard.
- Calcola i valori di intensità minima e massima dall'immagine normalizzata e riscala l'immagine nell'intervallo 0–255 usando questi valori minimi e massimi per immagine. Non utilizzare valori minimi e massimi a livello di dataset per questo passaggio di riscalatura min–max.
- Prepara ogni taglio Synapse CT come un'immagine bidimensionale in scala di grigi. Converti ogni fetta CT in float32 e aggiungi una dimensione di canale singolo per ottenere un tensore di input con forma 1 × 224 × 224.
- Mantenere ogni mappa di etichette Synapse come una maschera intera a canale singolo con forma 224 × 224. Non applicare ulteriori normalizzazioni media-SD a livello di dataset nel data loader.
- Usa i file Synapse preprocessati forniti in formato .npz per le slice di addestramento e in formato .npy.h5 per i volumi di test. Carica gli array di immagini e etichette direttamente da ogni file .npz durante l'addestramento e direttamente da ciascun file .npy.h5 durante i test. Non applicare ulteriore saturazione di intensità, finestre CT, normalizzazione a livello di dataset o ricampionamento a volume grezzo nel data loader rilasciato.
- Durante l'addestramento del modello, converti ogni fetta bidimensionale caricata in float32, ridimensionala alla dimensione spaziale target usando scipy.ndimage.zoom con ordine = 3 per le fette immagine e ordine = 0 per le mappe di etichette, e poi converti gli array ridimensionati in tensori con dimensione di canale singolo.
- Applica l'aumento dei dati solo al set di addestramento. Per ISIC 2017 e ISIC 2018, applicare il flipping orizzontale casuale (p = 0,5), il flipping verticale casuale (p = 0,5) e la rotazione casuale (p = 0,5) con un angolo campionato da 0° a 360°.
- Applica la stessa trasformazione geometrica a ogni coppia immagine-maschera. Durante la validazione e i test, applica solo ridimensionamento, normalizzazione e conversione del tensore.
- Per il dataset Synapse, applica rotazione casuale e flipping casuale durante l'addestramento. Ruota casualmente ogni coppia immagine-etichetta di k × 90°, dove k ∈ {0,1,2,3}, inverti casualmente la coppia immagine-etichetta lungo un asse spaziale, oppure ruota casualmente la coppia immagine-etichetta di un angolo campionato da −20° a 20°.
- Non applicare aumenti stocastici durante i test.
- Applicare l'aumento dei dati al dataset Synapse utilizzando i branch mutuamente esclusivi implementati nella trasformata RandomGenerator.
- Per ogni campione di addestramento, si valuta prima la condizione random.random() > 0,5. Se questa condizione è soddisfatta, applica random_rot_flip, costituita da una rotazione casuale di 90° (k = 0, 1, 2 o 3) seguita da un ribaltamento casuale lungo un asse spaziale.
- Se il primo ramo non è selezionato, si valuta una seconda condizione, random.random() > 0,5. Se questa condizione è soddisfatta, applica random_rotate usando un angolo di rotazione selezionato casualmente tra −20° e 20°. Se nessuna delle due condizioni è soddisfatta, non applicare l'aumento stocastico al campione.
- Applica la stessa trasformazione sia all'immagine di input che alla corrispondente mappa delle etichette.
- Imposta il seed casuale prima del caricamento del dataset, della preprocessing e dell'addestramento. Usa i semi casuali 1, 52 e 100 per gli esperimenti principali di confronto e usa il seme 100 per gli studi di ablazione, salvo diversa specificazione.
- Inizializzare i generatori casuali Python, NumPy, CPU PyTorch, CUDA PyTorch e cuDNN prima di costruire il data loader. Mantieni invariate le partizioni del dataset, le procedure di pre-elaborazione, le impostazioni di aumento, i parametri di normalizzazione, la strategia di ridimensionamento e la pre-elaborazione delle valutazioni in tutte le run seed.
- Impostare num_workers = 0 sia per gli esperimenti ISIC che per quelli Synapse per eseguire il carico dei dati nel processo principale. Prima di costruire il dataset e creare il DataLoader, inizializza il seed casuale globale usando la funzione set_seed per seed i generatori di numeri casuali Python, NumPy, CPU PyTorch, CUDA PyTorch e cuDNN. Non definire un generatore worker_init_fn separato o specifico per DataLoader, poiché questi non sono utilizzati nell'implementazione rilasciata.
2. Costruzione dell'architettura MVM-UNet
- Costruire il proposto Multi-view Vision Mamba UNet (MVM-UNet) utilizzando un'architettura encoder-decoder a forma di U.
- Imposta la dimensione dell'immagine di input su H × W × 3. Passa l'immagine di input attraverso il layer di embedding patch.
- Implementa il layer di embedding patch usando una convoluzione 2D con una dimensione kernel di 4 × 4, passo di 4, tre canali di ingresso e 96 canali di uscita.
- Trasformare la mappa delle caratteristiche di ingresso in una risoluzione spaziale di H/4 × W/4 con C = 96 canali di uscita.
- Costruisci quattro stadi encoder e quattro stadi decodifica. Riduci la risoluzione spaziale di metà e raddoppia la dimensione del canale dopo ogni stadio dell'encoder.
- Usa una configurazione encoder-decoder simmetrica. Imposta il numero di blocchi MVV sia nell'encoder che nel decoder a {2, 2, 2, 2}.
- Posizionare due blocchi MVV in ogni stadio encoder e due blocchi MVV in ciascun stadio decodificatore.
- Inserisci un blocco MVV in ogni stadio encoder e decoder. Usa il modulo MV4D come modulo principale di estrazione delle caratteristiche all'interno di ogni blocco MVV.
- Inserisci il modulo MFusion Mamba tra l'encoder e il decoder. Usa questo modulo per fondere le funzionalità dell'encoder multistadio prima della decodifica.
- Configura il flusso di lavoro complessivo MVM-UNet. Usa MV4D per l'estrazione delle caratteristiche in tutto l'encoder.
- Mantenere le uscite degli encoder come connessioni di salto. Passa le uscite degli encoder alle corrispondenti fasi del decodificatore.
- Passa le funzionalità dell'encoder a MFusion Mamba prima di decodificare. Campionare progressivamente la rappresentazione fusa tramite il decoder e generare la mappa di segmentazione finale usando la testa di segmentazione.
- Passa l'immagine di input I ∈ RB×H×W×3 attraverso il layer di embedding patch per ottenere
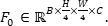 Qui, C = 96.
- Generare mappe di caratteristiche degli encoder: E1 ∈R B×H/4×W/4×C, E 2 ∈R B×H/8×W/8×2C, E3 ∈R B×H/16×W/16×4C ed E 4 ∈ RB×H/32×W/32×8C. Usa blocchi MVV contenenti MV4D in ogni stadio dell'encoder.
- Preserva ogni funzione del codificatore per la corrispondente connessione di saltare. Passa tutte le funzionalità dell'encoder a MFusion Mamba per la fusione delle feature multistage.
- Allinea le caratteristiche degli encoder a uno spazio comune delle caratteristiche prima della fusione grossolana e fine all'interno del MFusion Mamba. Passa la rappresentazione fusa al decodificatore.
- Campionare progressivamente la rappresentazione del decodificatore. Fusioni le caratteristiche del decodificatore con E3 a H/16 × W/16, E2 a H/8 × W/8 ed E1 a H/4 × W/4.
- Campiona la funzione finale del decodificatore alla risoluzione originale dell'immagine. Genera la mappa
 di previsione ∈ RB×H×W×K. Qui, K = 1 per la segmentazione binaria della lesione e K = 8 per la segmentazione multiorgano sinapsi.
- Consulta la Figura 2 per l'architettura di rete complessiva e la Tabella Supplementare 1 per la specifica completa dell'architettura layer per layer, inclusi le operazioni, i parametri principali e le dimensioni delle caratteristiche di uscita per ogni stadio
- Strati di transizione codificatore–decodificatore
- Downsample le funzionalità dell'encoder usando i livelli di transizione patch-merging. Per ogni transizione, campionare quattro gruppi di caratteristiche spazialmente intercalati da un quartiere 2 × 2, concatenarli lungo la dimensione del canale, applicare la Normalizzazione del Livello (LayerNorm) e proiettare la caratteristica risultante a 4C su canali 2C utilizzando uno strato lineare privo di bias. Questa operazione riduce la risoluzione spaziale di un fattore 2 raddoppiando la dimensione del canale.
- Upcampiona le funzionalità del decoder usando strati di transizione che espandono le patch. Applicare una proiezione lineare senza bias, riorganizzare le caratteristiche espanse spazialmente per aumentare la risoluzione di un fattore 2 e applicare LayerNorm dopo l'espansione spaziale. Ripeti questa operazione per ricostruire progressivamente le mappe di caratteristiche da H/32 × W/32 a H/16 × W/16, H/8 × W/8 e H/4 × W/4.
- Allinea le caratteristiche dell'encoder all'interno del modulo MFusion Mamba ridimensionandole alla risoluzione spaziale target tramite interpolazione bilineare (align_corners = Falso) e poi applicando una proiezione lineare di canale apprendibile prima della fusione delle caratteristiche.
- Testa di segmentazione
- Upcampiona la feature map finale del decoder da H/4 × W/4 alla risoluzione originale dell'immagine (H × W) usando lo strato finale di patch-expanding. Applicare la proiezione lineare, eseguire un riarrangiamento spaziale con un fattore di espansione pari a 4 e applicare LayerNorm.
- Proiettare la feature map ricostruita su K canali di uscita usando una convoluzione 1 × 1 dopo aver convertito il tensore in formato channel-first.
- Generare la previsione finale durante la valutazione applicando una funzione di attivazione sigmoide per la segmentazione binaria della lesione o un'attivazione softmax seguita da argmax per la segmentazione multiorgano Synapse. Non applicare una funzione di attivazione all'interno della testa di segmentazione stessa.
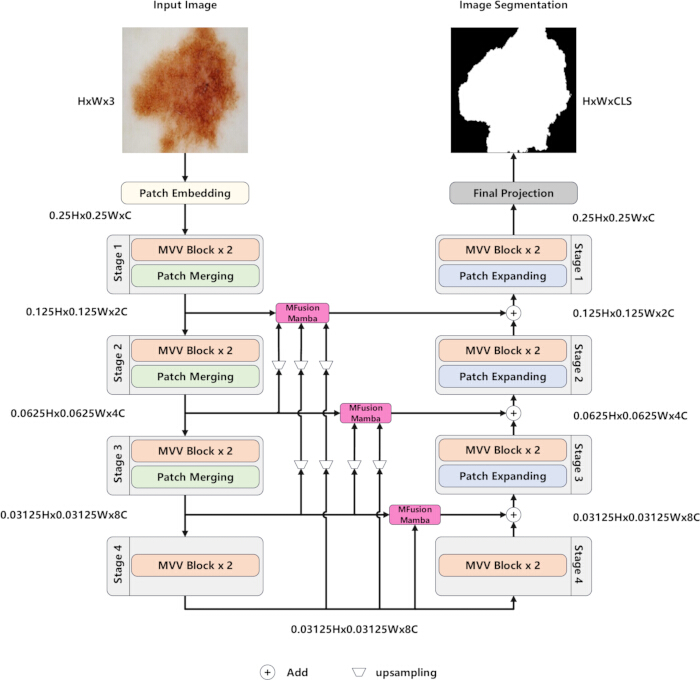
Figura 2. Architettura complessiva di Multi-View Mamba U-Net (MVM-UNet). Panoramica dell'architettura proposta Multi-View Mamba U-Net (MVM-UNet). L'immagine di input viene convertita in embeddings patch ed elaborata attraverso quattro stadi encoder composti da blocchi Multi-View Vision (MVV) separati da operazioni di patch-merging. Le caratteristiche degli encoder vengono aggregate tramite Multi-stage Fusion Mamba (MFusion Mamba) e propagate al decoder tramite connessioni saltate. Il decodificatore ripristina progressivamente la risoluzione spaziale utilizzando operazioni di patch-expanding e genera la mappa finale di segmentazione attraverso lo strato di proiezione. Clicca qui per visualizzare una versione più grande di questa figura.
3. Costruzione del modulo MV4D
- Usa il modulo MV4D come unità base di estrazione delle caratteristiche nel blocco MVV. Alimenta le patch delle funzionalità di input in quattro rami scan-pair. Consulta l'Algoritmo 1, File Supplementare 1 per il pseudocodice completo dell'appiattimento spaziale, costruzione di indici di scansione a coppie, raccolta di sequenze, elaborazione S6/Mamba, riordinamento spaziale inverso, fusione scan-pair, fusione SFusion Mamba, proiezione e rimodellazione di output.
- Utilizzare le procedure esatte di generazione di indici di scansione a zigzag, gerarchiche, a spirale e radiali implementate nei modelli/mvmunet/core.py. Per ogni strategia di scansione, si utilizza l'ordine di scansione diretta e il suo ordine inverso come una coppia di scansione bidirezionale.
- Costruisci la coppia di scansione a zigzag. Attraversa le caratteristiche dell'immagine in direzioni alterne alla fine di ogni riga o colonna. Usa questo schema di scansione per bilanciare le informazioni spaziali locali e globali.
- Costruisci la coppia di scansione gerarchica. Cattura le caratteristiche su più scale spaziali. Usa questo schema di scansione per rafforzare l'estrazione sia delle rappresentazioni locali che globali.
- Costruisci la coppia di scansione a spirale. Scansiona le caratteristiche dell'immagine dal centro verso il bordo o dal confine verso il centro. Utilizza questo schema di scansione per migliorare l'estrazione delle informazioni globali sui contorni.
- Costruisci la coppia di scansione radiale. Scansiona le caratteristiche dell'immagine lungo più direzioni radiali. Utilizza questo schema di scansione per migliorare l'estrazione dei dettagli locali dei confini e dei bordi.
- Unisci ogni coppia di scansione prima di inserire la sequenza unita nel blocco S6. Utilizzare il design abbinato per migliorare la robustezza di ogni strategia di scansione preservando l'efficienza computazionale.
- Alimenta la sequenza di uscita di ogni ramo scan-pair in un blocco S6. Ottieni quattro rappresentazioni di caratteristiche corrispondenti alle viste a zigzag, gerarchica, a spirale e radiale.
- Fuse le quattro rappresentazioni di caratteristiche estratte utilizzando il modulo SFusion Mamba. Usa due vie di fusione parallele. Nel primo percorso, integrare le quattro caratteristiche tramite aggiunta elemento-elemento.
- Nel secondo percorso SFusion Mamba, concatenare le quattro caratteristiche. Elabora la rappresentazione concatenata usando Conv1d e Mamba. Riduci la dimensione del canale usando uno strato di proiezione per corrispondere alla dimensione di uscita del blocco S6.
- Configura il blocco S6/Mamba usando la dimensione di caratteristica C come dimensione del modello. Usa uno strato di proiezione per mappare ogni caratteristica di coppie di scansione unite alla dimensione del canale C prima della fusione.
- In SFusion Mamba, esegui l'addizione elemento per elemento nel primo percorso. Concatena le quattro caratteristiche scan-view nel secondo percorso prima di Conv1d, Mamba e proiezione lineare. Utilizzare le operazioni di normalizzazione, proiezione lineare, convoluzione separabile in profondità e attivazione che circondano MV4D come descritto nel Passo 4.
- Si sommano le uscite dei due percorsi di fusione per ottenere l'output finale del modulo MV4D.
- Costruire quattro rami di scansione a coppia complementari invece di usare solo direzioni di scansione orizzontali e verticali. Utilizzare la scansione a zigzag per enfatizzare la traversata spaziale continua, la scansione gerarchica per rafforzare la rappresentazione multiscala, la scansione a spirale per catturare informazioni da centro a confine e la scansione radiale per migliorare l'estrazione dei dettagli locali orientata ai confini.
- Elaborare ogni ramo scan-pair in modo indipendente. Fondi le funzionalità risultanti usando SFusion Mamba. Mappare ogni sequenza elaborata al suo ordine spaziale originale prima della fusione.
- Data una mappa di caratteristiche in input X ∈ RB×H×W×C, appiattila in Xseq ∈ RB×L×C, dove L = H × W.
- Riordinare la sequenza appiattita secondo gli indici di scansione per ogni ramo di coppie di scansione. Processare ogni sequenza riordinata utilizzando il blocco S6. Ripristina la sequenza elaborata all'ordine spaziale originale.
- Fonde le quattro caratteristiche di scansione attraverso il percorso additivo e il percorso SFusion Mamba per ottenere l'output finale MV4D. Consulta la Figura 3 per l'architettura MV4D e l'Algoritmo 1, File Supplementare 1 per il flusso di lavoro completo di implementazione a livello di tensor.
- Usa l'implementazione software completa in models/mvmunet/core.py. Questo file contiene i generatori di scan-index, PairwiseScanMamba, SequenceS6, SFusion Mamba e il modulo wrapper MV4D.
- Generare indici di scansione multiview
- Genera gli indici di scansione seguendo l'implementazione rilasciata in models/mvmunet/core.py. Per una mappa di caratteristica di input di dimensione spaziale H × W, appiattire ogni posizione del pixel in un indice unidimensionale usando: indice = r × W + c, dove sono e c indicano rispettivamente le coordinate riga e colonna.
- Genera la scansione a zigzag attraversando diagonali dell'immagine con r + c costanti. Raccogli gli indici dei pixel validi per ogni diagonale e alterna la direzione di traversata invertendo l'ordine di ogni diagonale pari.
- Genera la scansione gerarchica dividendo ricorsivamente l'immagine in quattro quadranti. Visitare sequencialmente i quadranti in alto a sinistra, in alto a destra, in basso a sinistra e in basso a destra finché l'altezza o larghezza della sottoregione non supera i 2 pixel, quindi attraversa i pixel rimanenti in ordine di riga maggiore.
- Genera la scansione a spirale attraversando il confine esterno dell'immagine da sinistra a destra lungo la riga superiore, verso il basso lungo la colonna di destra, da destra a sinistra lungo la riga inferiore e verso l'alto lungo la colonna di sinistra mentre si restringe progressivamente il confine verso il centro dell'immagine.
- Genera la scansione radiale ordinando ogni pixel in base alla sua distanza quadrata dal centro dell'immagine e poi secondo il suo angolo polare calcolato usando la funzione atan2.
- Genera la scansione inversa per ogni strategia di scansione invertendo l'ordine corrispondente della scansione diretta. Combina le sequenze di scansione avanti e indietro per formare una coppia di scansione per ogni strategia di scansione prima di passare le coppie di scansione al modulo MV4D.
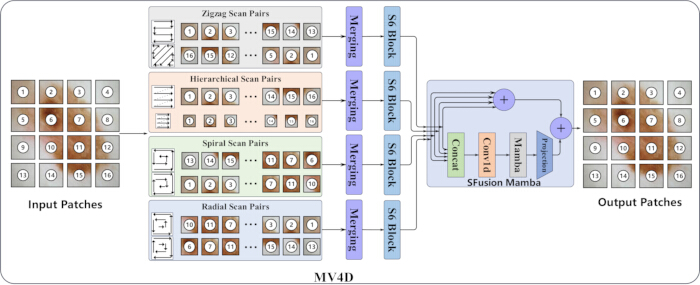
Figura 3. Architettura del modulo Multi-View 4-Directional (MV4D). Struttura del modulo di estrazione delle caratteristiche Multi-View 4-Directional (MV4D). Le patch di input vengono elaborate attraverso quattro rami di coppie di scansione complementari, inclusi scansione zigzag, gerarchica, a spirale e radiale. Le caratteristiche estratte dai quattro rami vengono unite, elaborate utilizzando blocchi dello spazio di stati e integrate tramite Spatial Fusion Mamba (SFusion Mamba) per generare la rappresentazione delle caratteristiche in uscita. Clicca qui per visualizzare una versione più grande di questa figura.
4. Costruzione del blocco MVV
- Costruisci il blocco MVV usando un ramo principale e due rami ausiliari. Usa la struttura complessiva mostrata nella Figura 4.
- Applicare la normalizzazione dei layer alla funzione di input nel ramo principale. Alimenta la caratteristica normalizzata in uno strato lineare. Passa la caratteristica trasformata alla convoluzione separabile per profondità.
- Elabora la caratteristica trasformata usando la convoluzione separabile in profondità. Applica la funzione di attivazione GELU. Inserisci la funzione attivata nel modulo MV4D.
- Costruire il primo ramo ausiliario come connessione residua identità. Collega la funzione di ingresso direttamente all'uscita finale. Usa questo ramo per preservare la rappresentazione originale e stabilizzare l'addestramento.
- Costruire il secondo ramo ausiliario come un ramo a proiezione verso il basso verso l'alto. Comprimi la funzione di input usando uno strato di proiezione verso il basso. Ripristina la dimensione delle feature utilizzando uno strato di up-project.
- Unisci le uscite del ramo principale e di entrambi i rami ausiliari. Ottieni l'output finale del blocco MVV. Consulta la Figura 4 per l'architettura completa.
- Imposta la dimensione nascosta del ramo principale uguale alla dimensione del canale di ingresso Cs. Applica LayerNorm(Cs) prima della proiezione lineare principale e usa un livello lineare con dimensioni Cs→C s. Usa una convoluzione separabile in profondità composta da una convoluzione 3×3 per profondità con riempimento 1, gruppi = Cs e nessun bias, seguita da una convoluzione punto a punto 1×1 senza bias.
- Applica la funzione di attivazione GELU dopo la convoluzione separabile in profondità. Inserire la caratteristica attivata in MV4D e applicare una proiezione lineare in uscita con dimensioni Cs→C s. Configura il ramo di proiezione down-up usando LayerNorm(Cs), un rapporto di proiezione di 4, una s→Cs/4 con proiezione verso il basso, attivazione GELU e una proiezione verso l'alto C s/4→Cs.
- Combinare il ramo identità, il ramo proiezione verso il basso verso l'alto e il ramo principale processato a caduta usando l'addizione elemento per elemento per ottenere l'output finale del blocco MVV.
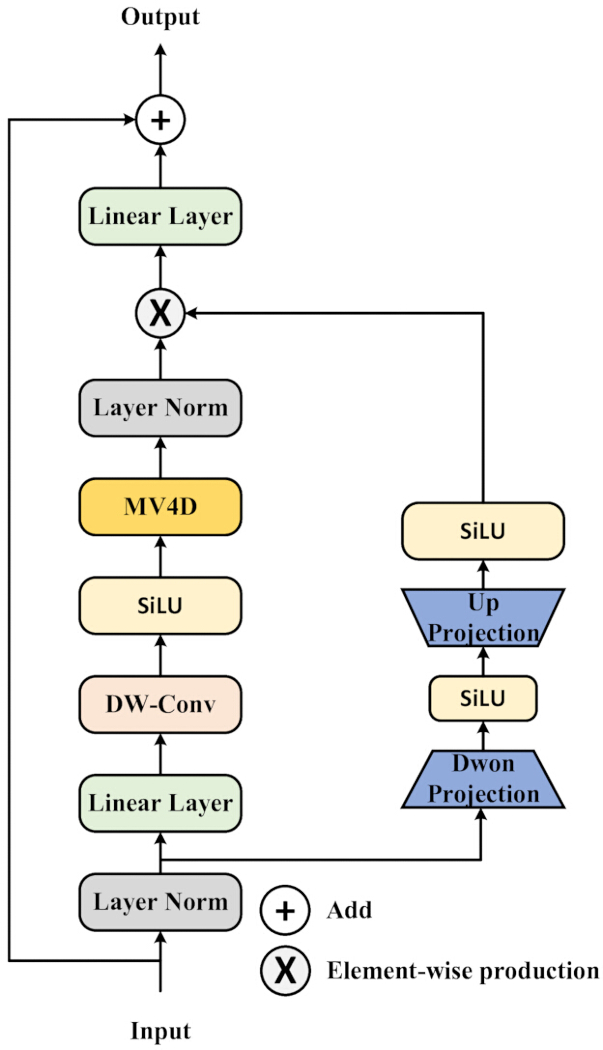
Figura 4. Architettura del blocco Multi-View Vision (MVV). Struttura del blocco Multi-View Vision (MVV). Il blocco consiste in un ramo principale di estrazione delle caratteristiche contenente il modulo Multi-View 4-Directional (MV4D) insieme a strati di convoluzione in profondità, normalizzazione e proiezione lineare. Un ramo ausiliario di proiezione su-giù fornisce modulazione a parametro tramite moltiplicazione elemento per elemento prima dell'addizione residua per generare la rappresentazione delle caratteristiche in uscita. Clicca qui per visualizzare una versione più grande di questa figura.
5. Costruzione della MFusion Mamba
- Raccogli le feature map di tutte le fasi degli encoder. Allinea le caratteristiche dell'encoder a uno spazio di rappresentazione unificato ridimensionandole o proiettandole quando necessario. Consulta l'Algoritmo 2, File Supplementare 1 per il flusso di lavoro completo di implementazione a livello di tensor.
- Ridimensionare le caratteristiche dell'encoder alla risoluzione spaziale target quando necessario. Progetti caratteristiche con diverse dimensioni di canale nella stessa dimensione di canale. Allinea tutte le caratteristiche dell'encoder prima della fusione multistadio.
- Inserire le caratteristiche dell'encoder allineato nel componente Coarse Fusion. Esegui la fusione grossolana utilizzando il prodotto di Hadamard. Genera la rappresentazione fusibile grossolana.
- Inserisce la rappresentazione fusa grossolana nel componente di fusione fine. Costruire due vie parallele di fusione fine. Elabora entrambi i percorsi in modo indipendente.
- Processa il primo percorso di fusione fine usando uno strato lineare. Elaborare il secondo percorso di fusione fine usando proiezione verso l'alto, Conv1d, Mamba e proiezione verso il basso. Ripristina la dimensione delle caratteristiche dopo la ridimensione della proiezione.
- Unisci le uscite dei due percorsi di fusione fine usando il prodotto di Hadamard. Applica lo strato lineare finale. Ottieni l'output MFusion Mamba.
- Alimenta l'uscita MFusion Mamba nel decoder. Decodifica la rappresentazione multistadio fusa insieme alle caratteristiche di salto codificatore-decodificatore. Genera la mappa di segmentazione finale.
- Allinea le caratteristiche degli encoder da diverse fasi in uno spazio di caratteristiche unificato prima della fusione grossolana. Elaborare le rappresentazioni delle caratteristiche allineate utilizzando gli stadi di fusione grossolana e fine. Consulta la Figura 5 per l'architettura MFusion Mamba e l'Algoritmo Supplementare 2 per il flusso di lavoro completo di implementazione a livello di tensor.
- Utilizza i parametri di implementazione di MFusion Mamba come segue. Per ogni caratteristica del codificatore Ei, si proietta la dimensione del canale da Ci a Ct. Ridimensionare le caratteristiche proiettate alla dimensione spaziale target usando interpolazione bilineare con align_corners=Falso quando necessario.
- Applicare il prodotto di Hadamard per eseguire la fusione grossolana attraverso le caratteristiche allineate dell'encoder. Configura il primo percorso di fusione fine usando uno strato lineare con dimensioni Ct → Ct. Configura il secondo percorso di Fusione Fine usando una proiezione ascendente Ct → 2Ct, Conv1d, un blocco Mamba/S6 con dimensione modello 2Ct, una direzione di scansione, dimensione di stato 16 e una proiezione verso il basso 2Ct → Ct.
- Fuse le uscite dei percorsi di fusione fine usando il prodotto di Hadamard. Applica una proiezione lineare finale con dimensioni Ct a Ct. Inserire la rappresentazione multistadio fusa nel decodificatore.
- Funde le funzionalità dell'encoder multistadio usando MFusion Mamba
- Raccogli le funzionalità del codificatore da tutti e quattro gli stadi (E1, E2, E3 edE 4) e usale come input al modulo MFusion Mamba. Non selezionare solo la caratteristica corrispondente del codificatore per la fusione del decodificatore.
- Allinea tutte le caratteristiche dell'encoder alla risoluzione spaziale richiesta per lo stadio attuale del decodificatore. Ridimensionare le caratteristiche dell'encoder alla risoluzione target e proiettarle alla dimensione del canale richiesta prima della fusione delle feature.
- Ripeti la procedura di allineamento delle caratteristiche per ogni stadio del decodificatore. Quando il decodificatore opera su H/16 × W/16, H/8 × W/8 e H/4 × W/4, ridimensiona e proietta E1, E2,E 3 ed E4 nello spazio delle caratteristiche target corrispondente.
- Fonde le caratteristiche allineate dell'encoder multistadio utilizzando le operazioni Coarse Fusion e Fine Fusion del modulo MFusion Mamba, e combina la rappresentazione fusa con le caratteristiche del decodificatore alla scala corrispondente.
- Esegui le operazioni di proiezione delle funzionalità, ridimensionamento e fusione secondo l'implementazione rilasciata in models/mvmunet/core.py.
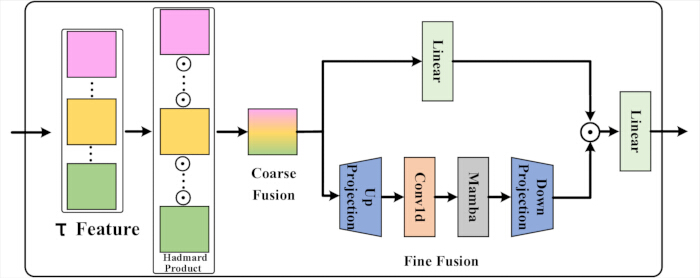
Figura 5. Architettura del modulo Multi-stage Fusion Mamba (MFusion Mamba). Struttura del modulo Multi-stage Fusion Mamba (MFusion Mamba). Le caratteristiche degli encoder multiscala vengono inizialmente combinate tramite fusione grossolana e successivamente raffinate attraverso il modulo Fine Fusion costituito da proiezione lineare, convoluzione unidimensionale (Conv1d), un blocco Mamba e strati di proiezione delle caratteristiche prima della generazione della rappresentazione delle caratteristiche fuse usata dal decodificatore. Clicca qui per visualizzare una versione più grande di questa figura.
6. Addestramento con modelli
- Addestra MVM-UNet su Ubuntu 22.04.1 con kernel Linux versione 6.8.0. Usa una workstation equipaggiata con una CPU Intel Core i9-13900K di 13ª generazione e una GPU NVIDIA A800. Usa la stessa configurazione hardware durante l'addestramento e la valutazione.
- Implementa e addestra il modello usando PyTorch 2.0.1 con CUDA 11.8. Installa tutte le dipendenze software necessarie prima della formazione.
- Usa l'ottimizzatore AdamW con un tasso di apprendimento iniziale di 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ e un decadimento in peso di 0,01. Imposta la dimensione del lotto a 32 a meno che non venga specificato diversamente.
- Addestra ogni modello per 300 epoche. Utilizzare un programma di apprendimento per ricottura coseno con ηmin = 1 × 10⁻⁵. Imposta la dimensione dell'immagine di input a 256 × 256 per ISIC 2017 e ISIC 2018 e a 224 × 224 per Synapse.
- Usa tre semi casuali indipendenti (1, 52 e 100) per gli esperimenti principali di confronto. Ripeti l'intera procedura di addestramento e valutazione per ogni testa. Riporta i risultati quantitativi finali come media ± SD nelle tre riprese.
- Usa un seed casuale fisso di 100 per tutti gli studi di ablazione, salvo diversa specificazione. Mantieni invariati le partizioni del dataset, la strategia di pre-elaborazione, l'architettura di rete, l'ottimizzatore, la velocità di apprendimento, la dimensione del lotto e il numero di epoche di addestramento in tutti gli esperimenti di ablazione.
- Utilizzare la perdita BCE-Dice per la segmentazione binaria della lesione su ISIC 2017 e ISIC 2018. Imposta i pesi di perdita BCE e di dadi a 1.0. Usa la perdita CE-Dice per Synapse e imposta sia il peso della perdita di entropia incrociata che quello di Dice a 1.0.
- Ridimensionare, normalizzare e ampliare le immagini di addestramento ISIC 2017 e ISIC 2018 utilizzando la procedura di preprocessing descritta nello Step 1. Applica ridimensionamento, rotazione casuale e flipping casuale alle immagini di allenamento Synapse come descritto nel Passo 1. Usa le stesse impostazioni di preprocessing durante tutte le esecuzioni di addestramento.
- Seleziona i checkpoint del modello secondo il protocollo di validazione specifico del dataset. Salva il checkpoint con le migliori prestazioni di validazione per ISIC 2017 e ISIC 2018, e effettua la validazione ogni 30 epoche. Allena Synapse per 300 epoche senza un set di validazione e usa il checkpoint finale di addestramento per i test.
- Usa il set ufficiale di validazione solo per la selezione dei modelli su ISIC 2017 e ISIC 2018. Non utilizzare il set di test Synapse per addestramento, accordatura degli iperparametri o selezione dei checkpoint. Riserva tutti i dati dei test esclusivamente per la valutazione finale.
- Usa i seguenti parametri di addestramento per la riproducibilità. Imposta la dimensione del batch a 32 per tutti i dataset. Usa AdamW con un tasso di apprendimento iniziale di 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, e un decadimento del peso di 1 × 10⁻².
- Configura lo scheduler di tasso di apprendimento per ricottura coseno con Tmax = 50 e ηmin = 1×10⁻⁵ per ISIC 2017 e ISIC 2018. Configura lo scheduler con Tmax = 100 e ηmin = 1×10⁻⁵ per Synapse. Mantieni invariata la configurazione dello scheduler per tutti gli esperimenti ripetuti.
- Addestra tutti i modelli usando l'aritmetica FP32 a piena precisione. Disattiva l'addestramento automatico a precisione mista. Non applicare il clipping del gradiente durante l'ottimizzazione.
- Mantieni invariate le impostazioni di precisione, la strategia di aggiornamento del gradiente, la configurazione dell'ottimizzatore, il programma della velocità di apprendimento e il protocollo a semi casuali in tutti gli esperimenti di confronto, gli studi di ablazione e le esecuzioni di riproducibilità.
- Seleziona il miglior modello di checkpoint
- Valutare il modello sul set di validazione dopo ogni epoca di addestramento per i dataset ISIC 2017 e ISIC 2018.
- Calcola la perdita binaria di Cross-Entropia (BCE)-Dice per ogni lotto di validazione e calcola la perdita media di validazione su tutto il set di validazione.
- Salva il modello attuale come miglior checkpoint quando la perdita media di validazione è inferiore alla perdita minima di validazione precedentemente registrata.
- Registrare l'intersezione media su Union (mIoU), il Coefficiente di Similarità dei Dadi (DSC), la precisione (Acc), la specificità (Spe) e la sensibilità (Sen) durante la validazione solo per il monitoraggio delle prestazioni. Non usare queste metriche come criterio di selezione dei checkpoint.
7. Valutazione del modello
- Valuta il modello addestrato utilizzando il set di test ufficiale per ogni dataset. Usa il set di test solo per la valutazione finale delle prestazioni.
- Per ISIC 2017 e ISIC 2018, calcola mIoU, DSC, Acc, Sen e Spe. Utilizzare veri positivi a livello di pixel (TP), falsi positivi (FP), veri negativi (TN) e falsi negativi (FN) per tutti i calcoli.
- Applicare una funzione di attivazione sigmoide all'output del modello per ISIC 2017 e ISIC 2018. Converti la mappa di probabilità in una maschera di segmentazione binaria usando una soglia di 0,5. Calcola le metriche di valutazione usando le Equazioni 2–6:
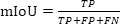 (2)
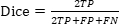 (3)
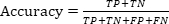 (4)
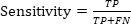 (5)
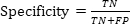 (6)
- Per Synapse, applica la funzione di attivazione softmax all'output del modello. Assegnare ogni pixel o voxel alla classe con la probabilità più alta usando l'operazione argmax. Calcola il DSC e la distanza di Hausdorff al 95° percentile (HD95) per ciascun organo in primo piano e riporta i valori medi di tutti i casi di test.
- Confronta MVM-UNet con metodi rappresentativi basati su CNN, basati su Transformer e basati su modelli nello spazio degli stati (SSM). Utilizzare partizioni di dataset identiche, procedure di preelaborazione, risoluzioni di input e metriche di valutazione per tutti i metodi.
- Utilizza le partizioni ufficiali di addestramento, validazione e test per ISIC 2017 e ISIC 2018. Usa la suddivisione standard di 18 casi di addestramento e 12 casi di test per Synapse. Imposta la risoluzione di input a per i dataset ISIC e per Synapse.
- Riprodursi i metodi di base utilizzando le loro implementazioni ufficiali quando disponibili. Riporta i risultati come media ± SD su ripetute riprese. Conservare i valori riportati dalla letteratura come pubblicati originariamente e distinguerli nelle corrispondenti note della tabella.
- Condurre studi di ablazione utilizzando il seme casuale fisso di 100, salvo diversa indicazione. Mantieni invariati le partizioni del dataset, la procedura di preelaborazione, la risoluzione degli input, l'ottimizzatore, il programma della velocità di apprendimento, la dimensione del lotto, il numero di epoche, la funzione di perdita e le metriche di valutazione in tutti gli esperimenti di ablazione.
- Valuta i contributi di MV4D, SFusion Mamba, il ramo Up-Down Projection nel blocco MVV, MFusion Mamba, la dimensione dell'immagine di input, il valore di dropout e la configurazione dello strato encoder-decoder. Modifica solo la componente o il parametro target in ogni esperimento di ablazione.
- Esegui il test Wilcoxon con rango segnato utilizzando risultati accoppiati per immagine per ISIC 2017 e ISIC 2018 e risultati accoppiati per caso per Synapse. Si consideri un p-valore inferiore a 0,05 per indicare la significanza statistica.
- Valutare l'efficienza computazionale utilizzando lo stesso ambiente hardware e la stessa risoluzione di input per tutti i metodi. Misurare il tempo di addestramento per epoca, il tempo di inferenza per immagine, l'uso massimo della memoria GPU durante l'addestramento, il numero di parametri del modello e le operazioni in virgola mobile (FLOP). Calcola i FLOP usando un singolo passaggio in avanti.
- Seleziona esempi qualitativi rappresentativi solo dal set di test dopo aver completato la valutazione del modello. Confronta l'immagine originale, la maschera di verità sul terreno e la maschera prevista usando casi di test identici in tutti i metodi. Seleziona esempi rappresentativi che includano piccoli bersagli, confini irregolari, confini ambigui e strutture multiorgan rappresentative.
- Calcolare metriche di valutazione ed eseguire analisi statistiche
- Calcola le metriche di segmentazione per i dataset ISIC 2017 e ISIC 2018 in Python usando NumPy e sklearn.metrics.confusion_matrix. Smettere la mappa di probabilità prevista a 0,5, ottenere i TP, FP, TN e FN a livello di pixel, e calcolare mIoU, DSC, Acc, Sen e Spe da questi valori.
- Calcola il DSC e l'HD95 per il dataset Synapse utilizzando rispettivamente medpy.metric.binary.dc e medpy.metric.binary.hd95. Applicare softmax seguito da argmax all'output del modello prima di calcolare le metriche di valutazione.
- Calcola il numero di FLOP e parametri praticabili usando thop.profile con un singolo passaggio in avanti.
- Esegui il test di segno Wilcoxon in Python usando scipy.stats.wilcoxon. Utilizzare valori di metriche per immagine abbinate per i dataset ISIC 2017 e ISIC 2018 e valori metrici accoppiati per caso per il dataset Synapse.
8. Definizione della funzione di perdita
- Utilizzare la perdita standard di Cross-Entropia (CE) per la segmentazione multiclasse e la perdita standard BCE per la segmentazione binaria. Usa la formulazione standard di perdita di dadi per la segmentazione. Le equazioni 7–11 definiscono le funzioni di perdita utilizzate in questo protocollo.
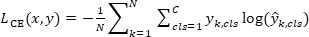 (7)
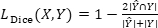 (8)
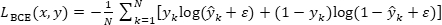 (9)
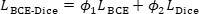 (10)
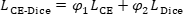 (11)
- Imposta i pesi di perdita BCE e Dice a 1.0 per ISIC 2017 e ISIC 2018, in modo che
 1 = 1.0 e 2 = 1.0. Imposta i pesi di perdita di CE e dado a 1,0 per Synapse, φ1 = 1,0 e φ2 = 1,0.
- Implementa le funzioni di perdita in utils.py. Usa nn. BCELoss per il termine BCE e nn. CrossEntropyLoss per il termine CE. Calcola la perdita binaria di Dadi appiattendo ogni maschera prevista e maschera di verità fondamentale, calcolando la perdita di Dadi per ogni campione e facendo la media della perdita su tutto il lotto. Calcola la perdita di dadi multiclasse convertendo la mappa dell'etichetta target in formato one-hot, applicando softmax all'output del modello, calcolando la perdita di dadi per ogni classe e facendo la media della perdita tra tutte le classi.
- Imposta la costante di smoothing a 1 per la perdita binaria dei Dadi e a 1×10⁻⁵ per la perdita multiclasse. Implementa la perdita BCE-Dice usando la classe BceDiceLoss con wb = 1 e wd = 1. Implementa la perdita CE-Dice usando la classe CeDiceLoss con loss_weight = [1, 1]. Mantieni invariate le costanti di smoothing, la strategia di riduzione e l'implementazione del software per tutti i dataset, seed casuali ed esperimenti.
- Configurare la riduzione delle perdite
- Istanzia, nn. BCELoss() e nn. CrossEntropyLoss() senza specificare esplicitamente l'argomento di riduzione.
- Usa l'impostazione predefinita di riduzione della perdita di PyTorch (riduzione = "media") per entrambe le funzioni di perdita. Non usare riduzione = "somma" o una perdita non ridotta.
9. Impostazioni di riproducibilità ed esecuzione
- Scarica l'implementazione rilasciata da https://github.com/LIXUEGUANG002/MVM-UNet. Utilizza il repository insieme ai pacchetti software, ai dataset, alle specifiche hardware e alle risorse computazionali elencate nella Tabella dei Materiali.
- Clona il repository e accedi alla directory del progetto eseguendo git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, seguito da cd MVM-Unet.
- Configura l'esperimento ISIC 2017 o ISIC 2018 impostando il nome del dataset, il percorso del dataset, la dimensione dell'input, la dimensione del lotto, il numero di epoche, la funzione di perdita, l'ottimizzatore, lo scheduler della velocità di apprendimento e il seed casuale nelle configurazioni/config_setting.py. Esegui lo script di addestramento dalla radice del repository usando train.py Python.
- Configura l'esperimento Synapse impostando il nome del dataset, il percorso dei dati di addestramento, il percorso del volume di test, la directory della lista, la dimensione dell'input, il numero di classi, la dimensione del batch, il numero di epoche, la funzione di perdita, l'ottimizzatore, lo scheduler della velocità di apprendimento e il seed casuale nelle configurazioni/config_setting_synapse.py. Esegui lo script di addestramento dalla radice del repository usando train_synapse.py python.
- Esegui una valutazione solo per inferenza impostando only_test_and_save_figs = Vero, best_ckpt_path al checkpoint addestrato e img_save_path alla directory di output nel corrispondente file di configurazione. Esegui train.py Python per ISIC 2017 o ISIC 2018, oppure usa train_synapse.py Python per Synapse per generare risultati di previsione e dati qualitativi.
- Usa la versione rilasciata dal codice sorgente
- Clona il repository GitHub rilasciato e controlla ee891b42c2f083c4990eed72f1d4463adc5e103e sul master branch prima di configurare dataset, script di addestramento e impostazioni di valutazione.
- Usa questo commit per riprodurre gli esperimenti riportati in questo studio. Al momento della revisione del manoscritto non era disponibile alcuna versione con tagg per il repository.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Risultati attesi e interpretazione
Quando questo protocollo viene implementato correttamente, il modello addestrato MVM-UNet dovrebbe produrre prestazioni di segmentazione stabili su esecuzioni ripetute, con solo piccole variazioni tra diversi semi casuali per la maggior parte delle metriche di valutazione. Per ISIC 2017 e ISIC 2018, i risultati positivi sono riflessi da alti valori di DSC, mIoU, Acc, Sen e Spe, insieme a maschere lesionistiche previste che seguono da...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo protocollo descrive MVM-UNet, un framework di segmentazione delle immagini mediche basato su Mamba. Il metodo è stato progettato per affrontare due limitazioni dei modelli di segmentazione esistenti. Innanzitutto, i metodi convenzionali basati su CNN hanno una capacità limitata di modellare dipendenze a lungo raggio e informazioni contestuali gerarchiche in immagini medichecomplesse 43. In secondo luogo, i metodi basati su Transformer possono modellare il c...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in competizione.
Ringraziamenti
Questa ricerca non ricevette finanziamenti esterni.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 con kernel Linux 6.8.0; Intel Core i9-13900K CPU; GPU NVIDIA A800; 128 GB di RAM; 512 GB di spazio di archiviazione locale. | Piattaforma di calcolo per l'addestramento, la convalida, il test, l'abolizione e gli esperimenti di sola inferenza. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | GPU NVIDIA A800 (80 GB di memoria). | Training e inferenza accelerati da GPU. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | CPU Intel Core i9-13900K di 13a generazione. | Processore host per il caricamento dei dati, la pre-elaborazione e l'esecuzione degli esperimenti. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB di RAM di sistema | Memoria per il caricamento dei dataset, la pre-elaborazione e l'addestramento. |
| Hardware - Storage | Institutional computing platform / local workstation | Unità a stato solido NVMe da 2 TB. | Spazio di archiviazione per dataset, checkpoint, log e figure di previsione generate. |
| Software environment - Operating system | Canonical Ltd. | Raccomandato: Ubuntu 22.04.1 LTS | Sistema operativo per l'ambiente di calcolo. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Nome dell'ambiente: mvmunet | Ambiente Python utilizzato per installare e isolare le dipendenze. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Lingua di programmazione utilizzata per l'implementazione e l'esecuzione degli esperimenti. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | Backend di calcolo GPU richiesto da PyTorch e pacchetti correlati a Mamba. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | Primitive di apprendimento profondo accelerate da GPU utilizzate tramite PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Framework di apprendimento profondo per l'addestramento del modello, il calcolo della perdita, l'ottimizzazione e l'inferenza. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Utilità di trasformazione delle immagini utilizzate nella pre-elaborazione e nell'aumento. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installato con l'ambiente PyTorch raccomandato. |
| Python package - timm | timm developers | timm == 0.4.12 | Dipendenza del componente del modello o dell'utilità elencata nelle istruzioni dell'ambiente del repository. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dipendenza utilizzata dai componenti di modellazione di sequenze accelerati da GPU. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Dipendenza di convoluzione causale efficiente richiesta dall'implementazione di Mamba. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Pacchetto di modellazione di sequenze statali utilizzato per i componenti relativi a Mamba/S6. |
| Python package - NumPy | NumPy developers | Versione di NumPy 1.24.3. | Operazioni di calcolo numerico e array. |
| Python package - SciPy | SciPy developers | Versione di SciPy 1.10.1. | Calcolo scientifico; scipy.ndimage.zoom è importato in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | Versione di SimpleITK 2.2.1. | Utilità di input/output e pre-elaborazione di immagini mediche importata in utils.py. |
| Python package - MedPy | MedPy developers | Versione di MedPy 0.4.0. | Pacchetto di calcolo delle metriche delle immagini mediche importato in utils.py. |
| Python package - scikit-image | scikit-image developers | Versione di scikit-image 0.21.0. | Dipendenza di elaborazione delle immagini elencata nel README. |
| Python package - scikit-learn | scikit-learn developers | Versione di scikit-learn 1.3.2. | Pacchetto di utilità di apprendimento automatico elencato nel README. |
| Python package - matplotlib | Matplotlib developers | Versione di Matplotlib 3.7.2. | Utilizzato per salvare figure di visualizzazione qualitative. |
| Python package - h5py | h5py developers | Versione di h5py 3.9.0. | Supporto per file HDF5 per i volumi di test Synapse. |
| Python package - thop | THOP developers | Versione di THOP 0.1.1.post2209072238. | Utilizzato nel calcolo dei FLOP e del costo computazionale relativo ai parametri. |
| Python package - packaging | Python Packaging Authority | Versione di packaging 23.1. | Dipendenza elencata nel README. |
| Python package - pytest | pytest developers | Versione di pytest 7.4.0. | Dipendenza elencata nel README. |
| Python package - chardet | chardet developers | Versione di chardet 5.2.0. | Dipendenza elencata nel README. |
| Python package - yacs | YACS developers | Versione di yacs 0.1.8. | Dipendenza dell'utilità di configurazione elencata nel README. |
| Python package - termcolor | termcolor developers | Versione di termcolor 2.3.0. | Dipendenza dell'utilità di log/terminale elencata nel README. |
| Python package - submitit | submitit developers | Versione di submitit 1.4.5. | Dipendenza dell'utilità di esperimento/lavoro elencata nel README. |
| Python package - tensorboardX | tensorboardX developers | Versione di tensorboardX 2.6.2.2. | Utilità di visualizzazione dei log di addestramento elencata nel README. |
| Python package - ml-collections | ml_collections developers | Versione di ml-collections 0.1.1. | Importato da configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | Dataset di segmentazione delle lesioni cutanee ISIC 2017 | Immagini e maschere di lesioni cutanee dermatoscopiche pubbliche e anonime utilizzate per la segmentazione binaria. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Segmentazione del contorno della lesione | Immagini e maschere di lesioni cutanee dermatoscopiche pubbliche e anonime utilizzate per la segmentazione binaria. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Identificatore di accesso: syn3193805 | Dataset pubblico di segmentazione multi-organo di TC addominale. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Cartella locale prevista con |
Riferimenti
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.