Questo studio presenta un framework leggero per ridurre le allucinazioni nei modelli linguistici di grandi dimensioni attraverso la verifica a livello di affermazione e una soglia statistica adattiva. Correggendo selettivamente le affermazioni non supportate mediante l'inferenza del linguaggio naturale, l'approccio migliora l'accuratezza fattuale mantenendo una bassa latenza di risposta e un'efficienza pratica per il deployment.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Verifica delle asserzioni guidata da NLI adattiva con modellazione decisionale statistica per la riduzione delle allucinazioni a bassa latenza nei Large Language Models
In questo articolo
Sommario
Abstract
I modelli linguistici di grandi dimensioni (LLM) mostrano una tendenza critica a generare output linguisticamente fluenti ma fattualmente errati – un fenomeno noto come allucinazione – che comporta rischi significativi in applicazioni che richiedono elevata precisione. Le attuali strategie di mitigazione, tra cui la generazione assistita da recupero e il campionamento della coerenza interna, introducono ritardi sostanziali nell'inferenza oppure dipendono da infrastrutture esterne di conoscenza, limitandone l'applicabilità in contesti di utilizzo in tempo reale. Questo articolo propone un framework leggero per la verifica delle affermazioni in due fasi, che scompone le risposte degli LLM in affermazioni fattuali atomiche e verifica autonomamente ciascuna affermazione estratta confrontandola con un testo di riferimento generato separatamente attraverso un prompt isolato di richiamo fattuale. Sebbene il generatore e il verificatore condividano lo stesso modello linguistico sottostante, separare la generazione della risposta dal richiamo fattuale riduce la condizionalità diretta della risposta e attenua il bias di conferma durante la verifica, utilizzando l'inferenza del linguaggio naturale (NLI) e applicando una soglia statistica adattiva – definita come τ = µ + kσ sulla distribuzione dei punteggi di confidenza NLI – per correggere selettivamente solo le affermazioni contraddette. A differenza dei metodi basati su NLI precedenti, che si affidano a soglie decisionali fisse, il framework proposto adatta dinamicamente la propria soglia di verifica alla distribuzione di confidenza di ciascuna risposta, mostrando prestazioni costanti su tutti i benchmark valutati senza richiedere il riaddestramento del modello. Valutato su TruthfulQA e FEVER, il framework riduce il tasso di allucinazione dal 28% al 9% su TruthfulQA – una riduzione relativa del 67,9% – con un sovraccarico di soli 160 ms di latenza aggiuntiva rispetto all'LLM di base, superando SelfCheckGPT e FActScore in accuratezza nel rilevamento delle allucinazioni. Questi risultati indicano che il framework può offrire un equilibrio favorevole tra affidabilità fattuale e latenza della risposta nei benchmark valutati, anche se ulteriori validazioni in diversi domini e contesti di utilizzo sono necessarie.
Introduzione
I modelli linguistici di grandi dimensioni (Large Language Models, LLM) si sono affermati come componenti fondamentali dei moderni sistemi di intelligenza artificiale, dimostrando capacità notevoli in un'ampia gamma di compiti di elaborazione del linguaggio naturale, tra cui la generazione di testo, la risposta a domande, la sintesi e il ragionamento complesso1La loro capacità di produrre risposte fluide e coerenti nel contesto ha accelerato l'adozione in settori ad alto impatto come il supporto alle decisioni cliniche, l'analisi giuridica, l'ingegneria del software e la tecnologia educativa2Tuttavia, una limitazione critica e persistente ne compromette l'affidabilità in questi contesti: le allucinazioni, fenomeno per cui i modelli generano risposte fluenti dal punto di vista linguistico ma fattualmente errate, prive di supporto o del tutto inventate 3. Studi empirici riportano tassi di allucinazione compresi tra il 15% e oltre il 40%, a seconda del compito e del modello, con sistemi all'avanguardia come GPT-4 che mostrano inconsistenze fattuali misurabili in valutazioni specifiche per dominio2,3Questa limitazione comporta rischi seri in applicazioni che richiedono elevata precisione, nelle quali output errati possono portare a informazioni fuorvianti, diagnosi sbagliate o decisioni basate su fondamenta errate.4Le allucinazioni derivano fondamentalmente dalla natura probabilistica della modellazione del linguaggio: i modelli linguistici di grandi dimensioni (LLM) generano token prevedendo continuazioni statisticamente probabili delle sequenze di input, piuttosto che recuperando o ragionando su conoscenze fattuali verificate.5Di conseguenza, gli output generati potrebbero includere affermazioni plausibili ma inaccurate, introdurre asserzioni non supportate o confondere concetti semanticamente correlati ma fattualmente distinti.6.
Le strategie di mitigazione esistenti affrontano questo problema attraverso diversi paradigmi, ciascuno con limitazioni significative. La generazione aumentata mediante recupero (Retrieval-Augmented Generation, RAG) riduce le allucinazioni basando le risposte su documenti recuperati esternamente, ma introduce un notevole sovraccarico di latenza, richiede l'accesso a basi di conoscenza aggiornate e rimane vulnerabile ai fallimenti di recupero in domini specializzati o con risorse limitate7,8,9.
Sebbene il generatore di risposte e il generatore di riferimenti siano istanziati utilizzando lo stesso modello sottostante GPT-3.5 Turbo, essi operano in base a obiettivi di prompt e contesti di esecuzione diversi. Il generatore di risposte produce una risposta illimitata alla richiesta dell'utente, mentre il generatore di riferimenti esegue un compito isolato di richiamo fattuale senza accesso alla risposta precedentemente generata. Questa separazione riduce gli effetti diretti di condizionamento della risposta e limita il bias di conferma durante la verifica delle affermazioni. Il framework tratta quindi il riferimento generato come proceduralmente indipendente, piuttosto che statisticamente indipendente.
Ricerche recenti hanno inoltre esplorato strategie di decodifica leggere per ridurre le allucinazioni nella generazione del testo senza fare affidamento su recupero esterno o verifica ripetuta. Un approccio rappresentativo è la Decodifica mediante Confronto tra Strati (Decoding by Contrasting Layers, DoLA), che migliora la veridicità confrontando le rappresentazioni provenienti da strati intermedi e finali del transformer durante la decodifica. A differenza dei framework di verifica successiva alla generazione, questi metodi intervengono direttamente durante la generazione dei token e ottimizzano quindi una fase diversa del processo di generazione del linguaggio. Queste strategie complementari dimostrano che la riduzione delle allucinazioni può essere ottenuta sia durante la decodifica sia mediante verifica successiva alla generazione, con ciascun approccio che presenta specifici compromessi in termini di sovraccarico computazionale, complessità di implementazione e affidabilità fattuale.
I metodi di autoconsistenza migliorano l'affidabilità fattuale campionando più risposte e selezionando l'output più frequente o coerente, ma il loro costo computazionale aumenta linearmente con il numero di campioni, rendendoli inadatti per implementazioni sensibili alla latenza8. Gli approcci di affinamento iterativo, che rivisitano ripetutamente gli output attraverso cicli di retroazione autonoma, riducono progressivamente i tassi di errore ma allungano sostanzialmente il tempo di inferenza ad ogni passaggio aggiuntivo9. I metodi di verifica basati sull'inferenza linguistica naturale (NLI) offrono un'alternativa più mirata valutando l'implicazione semantica tra affermazioni generate e testi di riferimento, ma le implementazioni esistenti si basano su soglie decisionali fisse che non riescono ad adattarsi a diverse distribuzioni di confidenza, domini o comportamenti del modello10,11. Nel complesso, questi approcci o impongono un sovraccarico computazionale inaccettabile, o dipendono da infrastrutture esterne, oppure mancano dell'adattabilità necessaria per un'implementazione generalizzata. Un confronto delle principali caratteristiche di questi approcci di verifica delle allucinazioni è riportato nella Tabella Supplementare 1.
Questo articolo propone un framework leggero per la verifica delle affermazioni in due fasi, progettato per ridurre le allucinazioni nelle uscite dei modelli linguistici di grandi dimensioni (LLM) mantenendo una bassa latenza di risposta. Nella prima fase, l'LLM genera una risposta iniziale, che viene quindi scomposta in affermazioni fattuali atomiche. Nella seconda fase, ciascuna affermazione viene verificata mediante inferenza linguistica naturale (NLI) confrontandola con un riferimento fattuale generato separatamente attraverso un passaggio di ragionamento isolato che non ha accesso alla risposta originale generata; un valore soglia di confidenza derivato statisticamente governa la decisione di accettazione o correzione a livello di singola affermazione. I principali contributi di questo lavoro sono i seguenti: (1) Una pipeline di verifica a livello di affermazione in due fasi che separa la generazione della risposta dalla validazione fattuale, consentendo una valutazione indipendente e mirata di ogni affermazione atomica senza richiedere il recupero esterno o la rigenerazione completa della risposta; (2) Un meccanismo adattivo di sogliatura statistica basato sulla distribuzione dei punteggi di confidenza NLI (τ = µ + kσ), che determina dinamicamente i limiti di accettazione e correzione anziché fare affidamento su regole decisionali fisse, migliorando la robustezza in presenza di distribuzioni di confidenza variabili; (3) Una strategia di correzione selettiva che limita la rigenerazione soltanto alle affermazioni classificate come contraddittorie, riducendo in modo significativo il carico computazionale rispetto agli approcci basati sulla riesecuzione completa della risposta o su raffinamenti iterativi; (4) Una valutazione empirica su un benchmark focalizzato sulle allucinazioni, che dimostra come il framework proposto riduca i tassi di allucinazione dal 28% al 9%, mantenendo al contempo la latenza della risposta entro limiti pratici per l'implementazione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio non ha coinvolto partecipanti umani, animali, campioni biologici o dati di pazienti. Pertanto, non era richiesta l'approvazione etica istituzionale né il consenso informato.
Panoramica del disegno dello studio
È stato implementato un framework di verifica in due fasi per migliorare l'affidabilità fattuale degli output dei modelli linguistici di grandi dimensioni (LLM). La procedura ha compreso la generazione di risposte, l'estrazione di affermazioni, la costruzione isolata di riferimenti, la verifica basata sull'inferenza del linguaggio naturale (NLI), un processo decisionale statistico adattivo, la correzione selettiva e l'assemblaggio finale della risposta. Il framework è stato valutato utilizzando i dataset di benchmark TruthfulQA e FEVER.
Flusso di lavoro complessivo
Query dell'utente → Generazione della risposta iniziale → Estrazione delle affermazioni → Generazione indipendente dei riferimenti → Verifica tramite inferenza linguistica naturale (NLI) → Calcolo della soglia statistica → Correzione delle affermazioni → Risposta finale verificata. Il flusso di lavoro complessivo del framework adattivo di verifica delle affermazioni è illustrato in Figura 1.
Preparazione del set di dati
Il dataset TruthfulQA12, contenente 817 domande orientate ai fatti, è stato scaricato e preparato per la valutazione. Il dataset FEVER13 comprende 185.445 affermazioni annotate, etichettate come Supportate, Refutate o Informazioni Non Sufficienti; per la valutazione sono stati utilizzati i dati di sviluppo etichettati con i relativi campi di affermazione, evidenza ed etichetta reale. Ogni affermazione è stata valutata rispetto all'evidenza fornita, mentre l'etichetta FEVER originale è stata mantenuta come risultato di riferimento per la verifica. Il dataset FEVER, che contiene coppie affermazione-evidenza per la verifica dei fatti, è stato ottenuto e preelaborato. Le domande e le affermazioni in ingresso sono state convertite in un formato testuale standardizzato. Prima degli esperimenti sono state rimosse le voci duplicate e i campioni incompleti. TruthfulQA è stato suddiviso in sottoinsiemi di validazione e di test. Circa il 20% dei campioni di TruthfulQA (164 domande) è stato utilizzato per l'ottimizzazione della soglia, mentre le rimanenti 653 domande sono state riservate per la valutazione delle prestazioni. Per FEVER, le affermazioni fornite dal benchmark sono state utilizzate direttamente come unità di verifica e non hanno subito la procedura di generazione della risposta ed estrazione dell'affermazione applicata a TruthfulQA. Le caratteristiche dei dataset di benchmark utilizzati per lo sviluppo e la valutazione del framework sono riassunte nella Tabella 1.
Generazione della risposta iniziale
A ciascuna query è stato sottoposto il modello linguistico di base. Le risposte sono state generate utilizzando il campionamento nucleus con una temperatura di 0,7 e un top-p di 0,9. La lunghezza massima dell'output è stata limitata a 256 token. Le risposte generate sono state archiviate senza alcun post-processing o modifica manuale. Il testo generato è stato inoltrato direttamente alla fase di estrazione delle affermazioni.
Estrazione delle affermazioni
Ogni risposta generata è stata scomposta in affermazioni fattuali indipendentemente verificabili. È stato utilizzato un prompt strutturato di scomposizione per identificare le affermazioni atomiche. Le affermazioni composte sono state separate in unità fattuali minime. Sono state rimosse opinioni soggettive, espressioni stilistiche e riempitivi conversazionali. Ogni affermazione estratta è stata archiviata come unità indipendente di verifica.
Esempio:
Risposta originale:
"Marie Curie era una fisica e chimica di origine polacca che condusse ricerche pionieristiche sulla radioattività."
Affermazioni estratte: (1) Marie Curie era di origine polacca; (2) Marie Curie era una fisica e chimica; (3) Marie Curie svolse ricerche sulla radioattività.
Costruzione del riferimento isolato:
Per ogni affermazione estratta, è stata generata una fonte fattuale indipendente. Il modello di verifica ha ricevuto soltanto la query originale dell'utente. L'accesso alla risposta generata originale è stato limitato per evitare bias di conferma. È stato utilizzato un prompt di richiamo fattuale per favorire risposte concise e basate su evidenze. Le fonti generate sono state archiviate per una successiva verifica.
Verifica dell'inferenza del linguaggio naturale
A ogni coppia di affermazione e riferimento è stato sottoposto un modello NLI pre-addestrato. Il modello NLI ha classificato la relazione come: Conferma, Neutro o Contraddizione. Sono state registrate le probabilità di confidenza per tutte e tre le classi. È stato assegnato un punteggio di verifica con segno: valore positivo per la conferma, zero per il neutro, o valore negativo per la contraddizione. Tutti i punteggi di verifica sono stati raccolti per il calcolo della soglia.
Calcolo adattivo della soglia statistica
La fiducia nella verifica prodotta dal modello NLI varia notevolmente tra le risposte, poiché query diverse generano un numero differente di affermazioni, un diverso livello di complessità semantica e diverse distribuzioni di fiducia. Una soglia globale fissa presuppone che tutte le risposte seguano un profilo di fiducia simile, ipotesi raramente riscontrata nella pratica. Per tenere conto di questa variabilità, il framework proposto stima il confine decisionale singolarmente per ogni risposta, utilizzando la media e la deviazione standard dei relativi punteggi di verifica. La media riflette il livello complessivo di fiducia della risposta, mentre la deviazione standard cattura la dispersione dei valori di fiducia tra le affermazioni estratte. Questa formulazione adattiva consente al criterio di accettazione di adattarsi all'incertezza specifica di ciascuna risposta, anziché fare affidamento su una singola soglia valida per tutti gli input.
Sono stati calcolati la media (µ) e la deviazione standard (σ) di tutti i punteggi di verifica con segno.
La soglia decisionale adattativa è stata calcolata come:

dove τ rappresenta la soglia adattativa, µ indica il punteggio medio di verifica, σ indica la deviazione standard e k rappresenta il parametro di sensibilità.
Il parametro di sensibilità è stato inizializzato a 0,7. Le affermazioni classificate come implicazione con punteggi maggiori o uguali a +τ sono state accettate. Le affermazioni classificate come contraddizione con punteggi minori o uguali a −τ sono state segnalate per la correzione. Le affermazioni con punteggi compresi nell'intervallo (−τ, +τ) sono state mantenute come neutre.
Correzione selettiva delle richieste
Una richiesta è stata inoltrata per la correzione solo quando il modello NLI ha classificato la coppia affermazione-riferimento come Contraddizione e il corrispondente punteggio di verifica con segno soddisfaceva il criterio della soglia adattiva si ≤ -τ. Pertanto, la decisione di correzione è stata determinata congiuntamente dall'etichetta della classe NLI e dalla soglia statistica specifica per la risposta. Le affermazioni classificate come Implicazione con si ≥ τ sono state accettate, mentre quelle ricadenti nell'intervallo -τ < si < τ sono state considerate neutrali e mantenute senza correzione. Questo criterio combinato ha garantito che la correzione fosse applicata soltanto alle affermazioni che mostravano sia una contraddizione semantica sia prove di verifica negativa sufficientemente forti.
Ricostruzione della risposta
Le richieste accettate e corrette sono state organizzate nella loro sequenza originale. I confini delle frasi sono stati ripristinati per mantenere la leggibilità. Sono state apportate piccole correzioni grammaticali quando necessario. L'output assemblato è stato archiviato come risposta finale verificata.
Valutazione delle prestazioni
Il framework è stato valutato utilizzando quattro metriche: (1) Accuratezza: la proporzione di risposte che sono rimaste fattualmente corrette dopo la verifica; (2) Punteggio F1: la media armonica tra precisione e richiamo nel rilevamento delle allucinazioni; (3) Latenza della risposta: il tempo totale di elaborazione dalla presentazione della query alla generazione della risposta verificata; (4) Tasso di allucinazione
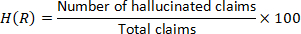
La latenza è stata riportata come tempo medio di esecuzione su misurazioni ripetute. Poiché i singoli valori di latenza per esecuzione non sono stati conservati, non sono state calcolate deviazioni standard né intervalli di confidenza.
Valutazione della correttezza specifica per il benchmark
Per TruthfulQA, la risposta finale verificata è stata confrontata con le risposte di riferimento validate dagli esseri umani del benchmark e con le liste di risposte errate. Una risposta è stata considerata corretta quando le sue affermazioni fattuali erano coerenti con le informazioni della risposta accettata e non contenevano contenuti corrispondenti ai modelli di risposta errata identificati. Per FEVER, ogni affermazione nell'output finale è stata valutata rispetto alle prove associate e all'annotazione FEVER originale; le affermazioni supportate sono state considerate verificate dal punto di vista fattuale, mentre quelle confutate sono state conteggiate come errate. I casi di tipo "Informazione non sufficiente" sono stati mantenuti come indeterminati, piuttosto che essere considerati prove fattuali positive. Le decisioni a livello di singola affermazione sono state aggregate per ciascun benchmark al fine di calcolare l'accuratezza e il tasso di allucinazioni riportati.
Ambiente sperimentale
Il framework è stato implementato utilizzando Python 3.9. Le operazioni di elaborazione dei dati sono state eseguite mediante librerie per l'analisi numerica e tabellare. Il modello NLI ha operato in modalità inferenza, senza ulteriore ottimizzazione. Gli esperimenti sono stati eseguiti su una workstation dotata di processore Intel Core i5, 16 GB di RAM e sistema operativo a 64 bit. Tutte le valutazioni sono state effettuate in un contesto di inferenza a singolo passaggio, al fine di garantire un funzionamento a bassa latenza. Tutti gli esperimenti sono stati condotti utilizzando configurazioni hardware e software identiche, per assicurare una valutazione coerente tra i diversi dataset e i metodi di riferimento.
Risultato previsto
Il protocollo è progettato per generare decisioni di verifica a livello di affermazione, identificando le affermazioni potenzialmente non supportate e inoltrando selettivamente quelle fortemente contraddette per la correzione. L'output previsto è una risposta verificata con ridotte incoerenze fattuali e un sovraccarico di elaborazione aggiuntivo limitato, in base alle prestazioni osservate durante la valutazione sperimentale.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Generazione della risposta iniziale
Il modello linguistico di base ha generato risposte fluide e contestualmente pertinenti per domande provenienti da entrambi i dataset di riferimento. Tuttavia, un'analisi dettagliata ha rivelato affermazioni infondate e fattualmente inaccurate in diverse risposte. Nel dataset TruthfulQA, il sistema di base ha mostrato un tasso di allucinazione del 28%, mentre è stato osservato un tasso di allucinazione del 26% nel dataset FEVER. Questi risul...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Il framework proposto ha migliorato le prestazioni nella verifica fattuale evitando campionamenti ripetuti e il ricorso a recupero esterno. Su TruthfulQA, la percentuale di allucinazioni è diminuita dal 28% del modello LLM di base al 9% con il framework completo, mentre l'accuratezza è aumentata da 0,72 a 0,87. Su FEVER, la percentuale di allucinazioni è scesa dal 26% al 10%, con un'accuratezza passata da 0,74 a 0,89. Questi confronti devono essere interpretati alla luce delle condizioni sperimentali e delle implementazi...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Gli autori desiderano esprimere la loro sincera gratitudine alla loro istituzione per aver fornito l'ambiente accademico e le risorse computazionali necessarie per condurre questa ricerca. Gli autori ringraziano inoltre gli sviluppatori e i responsabili della manutenzione dei dataset di benchmark disponibili pubblicamente utilizzati in questo studio, che hanno permesso una valutazione completa del framework proposto. Un particolare apprezzamento va ai colleghi e ai revisori per i loro commenti costruttivi, che hanno contribuito a migliorare la qualità e la chiarezza di questo lavoro. Gli autori riconoscono inoltre la comunità della ricerca open source per aver fornito le librerie software e gli strumenti che hanno facilitato l'esperimentazione, l'analisi dei dati e la visualizzazione dei risultati. I loro sforzi continui hanno notevolmente avanzato la ricerca nell'elaborazione del linguaggio naturale e nell'intelligenza artificiale affidabile. Gli autori dichiarano di non aver ricevuto alcun supporto finanziario esterno o finanziamenti per questa ricerca.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Insieme di dati di benchmark FEVER | Compito condiviso FEVER (Thorne et al.) | https://fever.ai/dataset/fever.html | Insieme di dati pubblicamente disponibile per la verifica di fatti, composto da coppie affermazione-evidenza, utilizzato per la valutazione |
| GPT-3.5 Turbo (modello linguistico di grandi dimensioni B10+2:12:12 | OpenAI | Model ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Utilizzato sia come generatore di risposte che come generatore di riferimenti indipendente, accessibile tramite l'API di OpenAI |
| NumPy | Sviluppatori di NumPy (open source) | https://numpy.org/ | Libreria per il calcolo numerico utilizzata per calcoli statistici, inclusi media e deviazione standard dei punteggi di verifica NLI |
| Openai (libreria client Python) | OpenAI | https://github.com/openai/openai-python | Libreria client Python utilizzata per inviare prompt e recuperare completamenti da GPT-3.5 Turbo |
| pandas | Squadra di sviluppo di pandas (open source) | https://pandas.pydata.org/ | Libreria per l'analisi di dati tabulari utilizzata per la pre-elaborazione del dataset e la gestione dei risultati |
| Modello preaddestrato di classificazione Natural Language Inference (NLI) | Hugging Face model hub (modello basato sull'architettura Microsoft DeBERTa-v3-large) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Utilizzato in modalità inferenza, senza ulteriore addestramento, per classificare ogni coppia affermazione-riferimento come implicazione, neutralità o contraddizione |
| Python | Fondazione Python | Versione 3.9; https://www.python.org/downloads/release/python-390/ | Linguaggio di programmazione principale utilizzato per implementare il framework di verifica |
| SciPy | Sviluppatori di SciPy (open source) | https://scipy.org/ | Libreria per il calcolo scientifico utilizzata per supportare l'analisi statistica dei risultati sperimentali |
| Transformers (libreria Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Libreria Python utilizzata per caricare ed eseguire il modello NLI preaddestrato |
| Insieme di dati di benchmark TruthfulQA | Originariamente pubblicato da Lin, Hilton ed Evans | https://github.com/sylinrl/TruthfulQA | Benchmark pubblicamente disponibile composto da 817 domande orientate ai fatti, utilizzato per la taratura delle soglie e la valutazione |
| Computer workstation | Non specificato nel manoscritto (si prega di verificare produttore/modello) | Processore Intel Core i5; 16 GB di RAM; sistema operativo a 64 bit | Hardware utilizzato per eseguire tutti gli esperimenti in configurazioni identiche |
| Nota: tutti gli URL elencati sopra sono stati verificati ed erano attivi alla data di compilazione di questa tabella. |
Riferimenti
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo