Questo articolo presenta un framework basato su CNN interpretabile per la classificazione delle lesioni cutanee che combina un'elevata accuratezza diagnostica con l'interpretabilità del modello. Esso classifica le immagini delle lesioni e genera spiegazioni visive per le sue previsioni. I risultati dimostrano prestazioni elevate e una maggiore trasparenza, sostenendo il processo decisionale clinico e assistendo i dermatologi nel rilevamento precoce delle malattie della pelle.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
Un framework assistito dal computer spiegabile per la classificazione delle lesioni cutanee mediante deep learning
In questo articolo
Sommario
Abstract
L'utilizzo di reti neurali profonde convoluzionali ai fini della diagnosi di malattie della pelle si è dimostrato in grado di raggiungere livelli di accuratezza simili a quelli ottenuti dai dermatologi in diversi studi. Tuttavia, permangono numerose sfide, tra cui il sottoutilizzo e una scarsa generalizzazione in alcuni casi, oltre a una bassa interpretabilità legata all'uso di modelli a scatola nera. Ciò crea ostacoli significativi per l'implementazione pratica, poiché è richiesta non solo una diagnosi accurata, ma anche una spiegazione chiara, rendendo necessario trovare una soluzione. Per superare le difficoltà menzionate, in questo studio è stato sviluppato un framework di apprendimento profondo interpretabile per la classificazione delle lesioni cutanee (EDLF-SLC). Il framework utilizza diverse metodologie di apprendimento automatico e di intelligenza artificiale interpretabile (XAI) per garantire miglioramenti sia in termini di accuratezza che di interpretabilità, seguendo un approccio in tre fasi. Nella prima fase, le rappresentazioni profonde estratte da diverse architetture di CNN preaddestrate vengono fuse al fine di preservare informazioni discriminative complementari apprese da diverse architetture di rete, prima della classificazione mediante un SVM con kernel a funzione di base radiale. Successivamente, classificatori Support Vector Machine (SVM) con kernel a funzione di base radiale vengono utilizzati per classificare le caratteristiche ottenute. Infine, le previsioni effettuate dal modello vengono interpretate attraverso spiegazioni locali interpretabili indipendenti dal modello (LIME). I risultati sperimentali mostrano che EDLF-SLC raggiunge un'accuratezza dell'88,0%, una precisione dell'89,0%, un richiamo dell'87,0% e un punteggio F1 dell'88,0%, dimostrando prestazioni competitive rispetto a diversi metodi recentemente riportati nelle condizioni sperimentali considerate in questo studio.
Introduzione
Le lesioni cutanee rappresentano un problema importante in dermatologia e oncologia poiché possono variare da anomalie benigne a tumori maligni come il melanoma, la forma più letale di cancro della pelle. Nel 2020, il melanoma ha causato circa 325.000 nuovi casi e oltre 57.000 decessi in tutto il mondo1. Sebbene i progressi nella diagnosi precoce e nel trattamento abbiano migliorato l'esito per i pazienti, la diagnosi ritardata e l'accesso limitato alle cure sanitarie continuano a contribuire all'elevata mortalità e alla perdita di anni di vita, in particolare tra le popolazioni più giovani2,3.
La diagnosi tradizionale si basa principalmente sull'esame visivo e sulla dermatoscopia, rendendo il processo dipendente dall'esperienza dei clinici e soggetto a variabilità inter-osservatore, biopsie non necessarie e tempi di esame prolungati4,5,6. Per affrontare questi limiti, l'apprendimento profondo, in particolare le CNN, si è affermato come una soluzione efficace per la classificazione automatizzata delle lesioni cutanee. I modelli basati su CNN, inclusi DDCNN-F7, YOLOv7-XAI8 e diverse altre architetture9,10,11,12,13, hanno dimostrato un'elevata accuratezza diagnostica apprendendo automaticamente caratteristiche discriminanti delle immagini. Nonostante i loro successi, la maggior parte dei modelli di apprendimento profondo funziona come una "scatola nera", limitando la fiducia dei clinici e ostacolando l'adozione nella pratica medica di routine. Di conseguenza, sono state introdotte tecniche di intelligenza artificiale spiegabile per migliorare la trasparenza del modello fornendo spiegazioni visive delle previsioni. Tra questi metodi, le Spiegazioni Locali Interpretabili Indipendenti dal Modello generano spiegazioni locali interpretabili identificando le regioni dell'immagine che influenzano maggiormente le decisioni del modello14.
La classificazione delle lesioni cutanee è evoluta dalla valutazione clinica tradizionale a sistemi diagnostici avanzati basati sull'intelligenza artificiale, spinta dalla necessità di una rilevazione accurata, affidabile e precoce del cancro della pelle. Questa evoluzione ha attraversato cinque fasi principali—metodi diagnostici tradizionali, diagnosi assistita da computer (CAD), apprendimento automatico (ML), apprendimento profondo (DL) e, più recentemente, intelligenza artificiale interpretabile (XAI) e apprendimento federato (FL)—riflettendo gli sforzi continui volti a migliorare l'accuratezza diagnostica, la coerenza, la scalabilità e l'affidabilità clinica, superando al contempo i limiti dell'esame convenzionale. I primi metodi computazionali cercavano di emulare il ragionamento clinico attraverso descrittori d'immagine progettati manualmente derivati dalla regola ABCD, inclusi asimmetria, irregolarità del bordo, variazione del colore e diametro della lesione. Queste caratteristiche venivano combinate con reti bayesiane, alberi decisionali, sistemi esperti e modelli di inferenza sfumata per supportare la diagnosi del melanoma, con diversi studi che riportavano accuratezze di classificazione superiori al 90%15,16,17. Nonostante abbiano fornito una base importante per la diagnosi assistita da computer, questi metodi dipendevano interamente da caratteristiche progettate manualmente e da regole diagnostiche predefinite. Di conseguenza, mostravano una robustezza limitata rispetto alle variazioni nella qualità delle immagini, nella morfologia delle lesioni, nell'illuminazione e nelle condizioni di acquisizione.
Per affrontare queste carenze, i sistemi classici di CAD emersero come passo intermedio tra l'analisi tradizionale delle immagini e le moderne architetture basate sull'intelligenza artificiale. I sistemi CAD combinavano l'estrazione manuale di caratteristiche con classificatori convenzionali per migliorare la coerenza diagnostica e supportare il processo decisionale clinico. Diversi approcci ibridi integrarono il clustering gerarchico con reti neurali ricorrenti e architetture a memoria a lungo e breve termine, raggiungendo accuratezze di classificazione prossime al 99,5%18. Altri framework basati su CAD incorporarono classificatori a potenziamento del gradiente con spiegazioni basate su SHAP, dimostrando un'accuratezza diagnostica competitiva pur migliorando la trasparenza del modello19. Sebbene questi sistemi rappresentassero un notevole miglioramento rispetto agli approcci puramente basati su regole, continuarono a dipendere fortemente dall'estrazione manuale di caratteristiche, da un'ampia pre-elaborazione, da dataset accuratamente annotati e da pipeline di elaborazione multistadio.
Le tecniche di apprendimento automatico hanno ulteriormente avanzato la classificazione automatizzata delle lesioni cutanee consentendo un apprendimento basato sui dati piuttosto che la progettazione esplicita di regole. Framework ibridi che combinano reti neurali convoluzionali con classificatori tradizionali di machine learning, tra cui regressione logistica e k-nearest neighbors, hanno dimostrato prestazioni elevate nella classificazione su dataset di riferimento, raggiungendo accuratezze superiori al 95%9. L'apprendimento multimodale auto-sorvegliato ha ulteriormente migliorato la rappresentazione delle caratteristiche sfruttando congiuntamente immagini dermoscopiche e cliniche, riducendo così la dipendenza da annotazioni manuali estese e migliorando al contempo le prestazioni di classificazione20. Altri studi hanno combinato CNN con analisi discriminante generalizzata, descrittori SURF e algoritmi di ottimizzazione per migliorare la discriminazione delle caratteristiche e l'accuratezza della classificazione21. Tecniche di selezione automatica delle caratteristiche che impiegano DenseNet-201, InceptionV3 e algoritmi di ottimizzazione ad albero binario hanno ulteriormente potenziato la rappresentazione delle caratteristiche mantenendo prestazioni diagnostiche competitive22. Approcci di transfer learning che utilizzano architetture pre-addestrate come AlexNet e GoogLeNet hanno mostrato anch'essi capacità promettenti di classificazione, nonostante una quantità limitata di dati di addestramento23. Tuttavia, la maggior parte dei metodi di ML continua a dipendere da procedure di pre-elaborazione accuratamente progettate, strategie di ottimizzazione manuali, dataset bilanciati ed estesi aggiustamenti degli iperparametri. La loro limitata validazione esterna e la sensibilità allo sbilanciamento delle classi hanno ulteriormente limitato l'applicabilità pratica in contesti clinici diversificati.
L'introduzione del DL ha trasformato in modo fondamentale la classificazione automatica delle lesioni cutanee, consentendo un apprendimento end-to-end diretto dai dati grezzi delle immagini. Le CNN hanno eliminato la necessità di un'ingegnerizzazione manuale delle caratteristiche, migliorando sostanzialmente le prestazioni diagnostiche su diversi dataset di riferimento. La maggior parte degli approcci basati su CNN ha dimostrato significativi miglioramenti nella classificazione delle lesioni attraverso architetture sempre più sofisticate. Modelli CNN sensibili alla simmetria hanno esplorato caratteristiche delle lesioni clinicamente rilevanti, ma hanno raggiunto solo una moderata accuratezza bilanciata24. Altri hanno integrato architetture EfficientNet con spiegazioni LIME e SHAP per migliorare l'interpretabilità, introducendo al contempo misure quantitative di affidabilità25. Sistemi ibridi di DL che combinano segmentazione delle lesioni, apprendimento in ensemble e CNN hanno ottenuto ottime prestazioni su diversi dataset ISIC, ma sono rimasti sensibili alla qualità della segmentazione e allo sbilanciamento delle classi26.
Più di recente, architetture ibride sempre più sofisticate hanno ulteriormente migliorato l'accuratezza della classificazione integrando tecniche complementari di apprendimento profondo. Reti avversarie generative condizionali combinate con YOLOv5 e analisi delle componenti indipendenti hanno raggiunto accuratezze di classificazione superiori al 99%, sebbene la loro complessità computazionale ne abbia limitato il deployment pratico 27. Analogamente, architetture ibride LSTM–ResNet hanno imparato efficacemente rappresentazioni spaziotemporali, ma hanno richiesto risorse computazionali notevolmente maggiori28. Modelli basati su trasformatori, inclusi Sap-Former, hanno sfruttato informazioni contestuali globali per potenziare la rappresentazione delle caratteristiche, ma hanno richiesto un preprocessing esteso, dataset annotati su larga scala e una notevole potenza computazionale29. Alternative leggere come S-MobileNet hanno cercato di bilanciare efficienza computazionale e accuratezza diagnostica30, mentre metodi di adattamento di dominio non supervisionati hanno migliorato la generalizzazione cross-dominio, nonostante una ridotta efficacia quando erano disponibili solo campioni di addestramento limitati31. Reti ibride potenziate dall'attenzione, che incorporano moduli di attenzione convoluzionali modificati e apprendimento con ensemble a istantanea, hanno mostrato prestazioni promettenti nella classificazione delle lesioni cutanee da vaiolo delle scimmie, anche se rimangono irrisolte sfide legate allo sbilanciamento delle classi, alla diversità delle immagini e alla limitata spiegabilità32. Architetture residue personalizzate, che impiegano progettazioni di reti più profonde e funzioni di perdita ibride, hanno ulteriormente migliorato l'accuratezza di classificazione oltre il 99%, ma con un sovraccarico computazionale e tempi di addestramento considerevolmente maggiori33. Studi di revisione esaustivi hanno concluso in modo coerente che l'apprendimento profondo supera sostanzialmente gli approcci tradizionali basati su caratteristiche manuali, imparando automaticamente rappresentazioni discriminative delle immagini, identificando al contempo sfide persistenti legate ad artefatti di imaging, variabilità dell'illuminazione, complessità computazionale e limitata generalizzazione clinica34.
Sebbene l'apprendimento profondo (DL) abbia notevolmente migliorato l'accuratezza diagnostica, le preoccupazioni riguardo alla trasparenza del modello, alla stima dell'incertezza e al suo utilizzo clinico affidabile hanno stimolato un crescente interesse verso l'XAI e l'apprendimento federato. Diversi studi hanno esaminato tecniche di quantificazione dell'incertezza, tra cui la previsione conforme, il dropout Monte Carlo e l'apprendimento profondo basato su evidenze, dimostrando che una stima affidabile della confidenza può migliorare in modo sostanziale il supporto decisionale, nonostante imponga vincoli aggiuntivi in termini computazionali e di dati35. Sono stati inoltre proposti framework basati su trasformatori per l'apprendimento collaborativo, volti a risolvere il problema dello sbilanciamento delle classi migliorando al contempo l'efficienza dell'apprendimento delle caratteristiche36. Altri approcci hanno combinato reti convoluzionali a risoluzione completa con tecniche di ottimizzazione basate su grafi per migliorare la segmentazione e la classificazione delle lesioni37, mentre framework ibridi di apprendimento profondo che integrano rappresentazioni di caratteristiche complementari hanno raggiunto accuratezze di classificazione prossime al 99,5%, sebbene richiedano un'ampia pre-elaborazione38.
Ricerche recenti si sono concentrate sempre di più sull'integrazione dell'interpretabilità direttamente nei framework di apprendimento profondo (DL) per aumentare la fiducia dei clinici e facilitare l'adozione clinica pratica. Sistemi interpretabili che impiegano diverse architetture di reti neurali convoluzionali insieme a Grad-CAM e Score-CAM hanno localizzato con successo le regioni delle lesioni clinicamente rilevanti mantenendo allo stesso tempo prestazioni competitive nella classificazione su dataset interni ed esterni39. Framework ibridi CNN–Transformer che combinano immagini dermoscopiche con metadati clinici hanno ulteriormente migliorato le prestazioni predittive utilizzando allo stesso tempo SHAP e Grad-CAM per generare spiegazioni visive clinicamente significative40. Altre architetture ibride basate su transformer, che integrano EfficientNetV2S, Swin Transformer, reti Xception modificate e meccanismi di attenzione su grafi, hanno catturato efficacemente caratteristiche complementari globali e locali delle lesioni, sebbene il loro elevato numero di parametri e le prestazioni limitate nelle classi minoritarie ne abbiano ostacolato il deployment pratico41. Analogamente, framework ibridi YOLOv8–Vision Transformer hanno dimostrato un miglioramento nella localizzazione delle lesioni, nella classificazione multiclasse e nell'interpretabilità visiva grazie a un'augmentazione adattiva unita a spiegazioni basate su SHAP e Grad-CAM; tuttavia, questi metodi continuano a basarsi principalmente su dataset di riferimento e mostrano robustezza limitata per le categorie di lesioni minoritarie42. Diversi articoli di revisione hanno riassunto questi sviluppi, sottolineando sia i notevoli progressi ottenuti dalle moderne tecniche di deep learning sia le sfide persistenti legate all'efficienza computazionale, all'interpretabilità, alla dipendenza dai dataset e alla validazione clinica43,44,45. Tabella 1 riporta un riepilogo di alcuni studi recentemente pubblicati che utilizzano algoritmi di deep learning per la classificazione delle lesioni cutanee.
Nonostante i notevoli progressi ottenuti dai recenti metodi di apprendimento profondo nella classificazione delle lesioni cutanee, la maggior parte degli approcci esistenti rimane limitata da un'elevata complessità computazionale, dalla dipendenza da grandi insiemi di dati annotati, da una limitata interpretabilità del modello e da una validazione insufficiente in diversi contesti clinici reali. Per superare questi limiti, questo articolo propone il framework EDLF-SLC, che integra caratteristiche complementari estratte da diverse architetture CNN con un classificatore SVM per una classificazione robusta e accurata. Il framework impiega inoltre un preprocessing avanzato per migliorare la qualità delle immagini e affrontare lo squilibrio tra le classi, integrando al contempo la tecnica LIME per fornire spiegazioni visive delle singole previsioni, aumentando così la trasparenza del modello e l'affidabilità clinica.
I contributi di questo studio sono triplici. In primo luogo, gli autori propongono un framework robusto, EDLF-SLC, che integra reti neurali convoluzionali avanzate (CNN) con un classificatore basato sulle macchine a vettori di supporto (SVM) per ottenere una classificazione precisa e affidabile delle lesioni cutanee. In secondo luogo, gli autori implementano tecniche avanzate di pre-elaborazione per affrontare lo squilibrio tra classi e ridurre il rumore nelle immagini, migliorando così la qualità delle immagini in ingresso e le prestazioni complessive del modello di classificazione. In terzo luogo, gli autori integrano il metodo Local Interpretable Model-agnostic Explanations (LIME) per visualizzare e interpretare le singole previsioni del modello, evidenziando le regioni dell'immagine che influenzano maggiormente le decisioni di classificazione, aumentando così la trasparenza e l'interpretabilità del framework proposto.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio non ha previsto il reclutamento di partecipanti umani né la raccolta di dati identificabili provenienti da pazienti. Tutti gli esperimenti sono stati condotti utilizzando il dataset pubblico di lesioni cutanee ISIC 2020 ottenuto dal repository Kaggle; pertanto, non è stata richiesta l'approvazione del comitato etico istituzionale né il consenso informato. Tutti i materiali utilizzati in questo studio sono riportati nella Tabella dei materiali.
Estrazione e fusione delle caratteristiche
Le immagini delle lesioni cutanee sono state elaborate mediante l'utilizzo di più modelli CNN preaddestrati. I vettori di caratteristiche profonde estratti dalle architetture CNN preaddestrate selezionate vengono concatenati per costruire una rappresentazione unificata delle caratteristiche per ciascuna immagine di lesione cutanea. La strategia di fusione adottata preserva le informazioni visive complementari apprese da diverse architetture CNN, consentendo al classificatore SVM successivo di sfruttare sia caratteristiche testurali di basso livello sia rappresentazioni semantiche di livello superiore. Sebbene tecniche di riduzione della dimensionalità, come l'analisi delle componenti principali o la selezione delle caratteristiche basata sull'informazione mutua, possano ridurre la dimensionalità delle caratteristiche, la rappresentazione fusa completa è stata intenzionalmente mantenuta poiché lo spazio delle caratteristiche fuse rimane computazionalmente trattabile per il classificatore RBF-SVM impiegato, preservando al contempo le informazioni diagnostiche complementari estratte dai diversi modelli CNN di base.
Classificazione
I vettori caratteristici fusi sono stati utilizzati per addestrare un classificatore SVM con un kernel RBF. Sono state impiegate tecniche di ottimizzazione degli iperparametri per determinare le impostazioni ottimali di classificazione. Il classificatore ha quindi categorizzato le lesioni cutanee nelle rispettive classi.
Spiegabilità
Per migliorare l'interpretabilità, è stato applicato LIME per generare spiegazioni visive che evidenziano le regioni dell'immagine che contribuiscono in modo più significativo ai risultati della classificazione. Queste spiegazioni aiuterebbero i clinici a comprendere e validare le decisioni del modello.
Piano di valutazione
Il framework proposto è stato valutato utilizzando un dataset di riferimento di lesioni cutanee. Le prestazioni sono state valutate mediante Accuracy, Precision, Recall e F1-Score. Sono stati condotti esperimenti comparativi rispetto ad approcci esistenti di machine learning e deep learning per dimostrare l'efficacia del framework proposto.
Risultati previsti
Si prevedeva che lo studio producesse un sistema di classificazione delle lesioni cutanee accurato e interpretabile. I risultati sperimentali preliminari indicano che EDLF-SLC raggiunge un'accuratezza dell'88,0%, una precisione del 89,0%, un richiamo (recall) dell'87,0% e un punteggio F1 dell'88,0%, superando diversi metodi concorrenti. Si prevedeva che l'integrazione di spiegazioni LIME aumentasse l'affidabilità e facilitasse l'adozione di sistemi diagnostici assistiti da intelligenza artificiale nella pratica clinica.
Significato
Questa ricerca contribuisce al crescente campo dell'intelligenza artificiale sanitaria interpretabile affrontando contemporaneamente le sfide relative alle prestazioni e alla trasparenza nella diagnosi delle lesioni cutanee. Il framework proposto potrebbe supportare i dermatologi nel formulare decisioni diagnostiche più affidabili e interpretabili, migliorando così l'assistenza ai pazienti. Inoltre, in questa sezione, gli autori forniscono informazioni sui materiali e sulla metodologia applicata nello studio. In particolare, gli autori iniziano descrivendo il dataset utilizzato negli esperimenti, per poi passare a una discussione dettagliata del Framework di Apprendimento Profondo Interpretabile per la Classificazione delle Lesioni Cutanee.
Set di dati
Il lavoro presentato si basa sul set di dati pubblicamente disponibile ISIC 2020 (International Skin Imaging Collaboration), accessibile sul sito web di Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). Il repository ISIC è riconosciuto come una delle migliori risorse nel campo dell'imaging dermatologico, poiché fornisce una vasta gamma di immagini dermatoscopiche di diversi tipi di lesioni cutanee, come mostrato in Figura 1. In particolare, il set di dati include immagini sia di condizioni benigne che maligne, rendendolo utile per eseguire compiti di classificazione binaria per il cancro della pelle 46. Il set di dati attuale comprende 3.297 immagini, di cui 1.800 sono benigne e 1.497 maligne. Per esperimenti più efficienti, i dati sono stati suddivisi in un insieme di addestramento e un insieme di test. In particolare, ci sono 2.637 immagini di addestramento, comprese 1.440 benigne e 1.197 maligne, mentre l'insieme di test è costituito da 660 immagini, di cui 360 sono benigne e 300 maligne. Un riepilogo del set di dati è mostrato in Tabella 2.
Il modello EDLF-SLC proposto
In questo articolo viene proposta una soluzione efficiente e comprensibile per classificare le lesioni cutanee in categorie benigne e maligne, utilizzando una nuova tecnica di apprendimento profondo interpretabile basata su un approccio ibrido che combina i vantaggi di più modelli di rete neurale convoluzionale preaddestrati. Le reti neurali convoluzionali si sono dimostrate altamente efficaci nell'estrarre caratteristiche semantiche di alto livello da immagini mediche. Sfruttando questa capacità, il framework di apprendimento profondo interpretabile proposto per la classificazione delle lesioni cutanee (EDLF-SLC) sfrutta più modelli CNN preaddestrati per ottenere prestazioni superiori. Per garantire la necessaria trasparenza del processo decisionale medico, nell'approccio proposto è stato adottato LIME al fine di generare spiegazioni locali comprensibili all'uomo per i risultati ottenuti. L'intero framework può essere suddiviso in tre fasi principali, illustrate in Figura 2, ossia: (1) preelaborazione dei dati, (2) estrazione delle caratteristiche e classificazione, e (3) interpretabilità.
Architettura del modello e integrazione
Come passo preliminare, sono stati selezionati e valutati separatamente su un dataset di validazione sette modelli popolari di apprendimento profondo (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge e MobileNet), scegliendo i quattro modelli più efficaci (ResNet50, EfficientNetB0, MobileNet e Xception) per la fase di estrazione delle caratteristiche. Nel framework proposto, ogni immagine in ingresso x viene elaborata in modo indipendente attraverso i modelli preaddestrati selezionati. L'ultimo strato completamente connesso è stato rimosso da ciascuno di questi modelli, e i vettori di caratteristiche sono stati ottenuti dai livelli precedenti. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) e fXception(x) indicano i vettori di caratteristiche in uscita da ciascuno dei modelli sopra menzionati. Concatenando tali vettori di caratteristiche, si ottiene un nuovo vettore di caratteristiche aggregato F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Successivamente, F(xi) è stato elaborato da un classificatore SVM con un kernel a funzione base radiale (RBF) per ottenere il risultato della classificazione. L'intero algoritmo del framework proposto è presentato nel Supplementary File 1.
Il framework proposto adotta una fusione diretta a livello di caratteristiche poiché ciascuna architettura CNN preaddestrata cattura caratteristiche discriminative diverse delle lesioni cutanee attraverso la propria architettura di rete distinta e gerarchia di caratteristiche appresa. Di conseguenza, concatenando queste rappresentazioni eterogenee di caratteristiche si preserva un'informazione complementare che contribuisce a una caratterizzazione più completa della lesione prima della classificazione. Sebbene tecniche di riduzione della dimensionalità come l'analisi delle componenti principali (PCA) o la selezione delle caratteristiche basata sull'informazione mutua possano ridurre la dimensionalità della rappresentazione fusa, il vettore completo di caratteristiche fuse è stato intenzionalmente mantenuto poiché la sua dimensionalità rimane computazionalmente gestibile per il classificatore RBF-SVM adottato, pur preservando le informazioni diagnostiche complementari estratte dai diversi backbone CNN. Questa progettazione, pertanto, dà priorità al mantenimento delle rappresentazioni profonde complementari piuttosto che all'eliminazione di caratteristiche potenzialmente informative prima della classificazione.
Preparazione dei dati
La preparazione dei dati ha incluso il preelaborazione e la suddivisione del set di dati in insiemi di addestramento e di test. Il preelaborazione ha lo scopo di migliorare la qualità dei dati eliminando incoerenze, rimuovendo elementi duplicati, formattando le immagini di ingresso ed eseguendo la riduzione delle caratteristiche per un addestramento stabile di un buon modello. Tutte le immagini sono state normalizzate all'intervallo [−1, 1] mediante la normalizzazione Z-score:
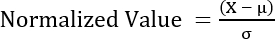 (2)
dove µ e σ indicano rispettivamente il valore medio e la deviazione standard dell'immagine corrispondente. Il set di dati è stato suddiviso in due sottoinsiemi, ovvero un set di addestramento (70,0%) e un set di test (30,0%).
Aumento dei dati
Per evitare l'overfitting e aumentare la capacità di generalizzazione del modello, sono state applicate alcune tecniche di aumento al set di addestramento. Le tecniche di aumento delle immagini prevedono la modifica delle immagini al fine di espandere artificialmente il dataset senza alterare le caratteristiche essenziali delle condizioni mediche. La pipeline di aumento è stata realizzata utilizzando l'API Sequenziale di Keras. Sono state impiegate trasformazioni come inversione orizzontale casuale, rotazione entro un angolo ridotto, ridimensionamento, scalatura, regolazione di luminosità/contrasto, zoom e alcuni piccoli spostamenti. Esempi rappresentativi di immagini aumentate sono illustrati in Figura 3.
Modelli preaddestrati
Diversi modelli di apprendimento profondo preaddestrati sono stati adottati nel framework proposto per estrarre caratteristiche dalle immagini in ingresso. Tali modelli includono MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 e MobileNetV2. MobileNet e MobileNetV2 sono modelli di apprendimento profondo leggeri progettati per calcoli efficienti mediante convoluzioni separabili per profondità. ResNet50 utilizza il meccanismo delle connessioni residue per l'addestramento del modello, evitando così il problema dei gradienti che svaniscono durante l'addestramento. EfficientNetB0 raggiunge un equilibrio tra efficienza e precisione attraverso l'approccio della scalatura composta. Xception estende la rete Inception utilizzando convoluzioni separabili per profondità. NASNetLarge impiega la ricerca di architetture neurali per costruire strutture ottimali di reti neurali profonde, mentre Inception-ResNet-v2 realizza un ibrido tra il modello Inception e il meccanismo delle connessioni residue. I vettori di caratteristiche estratti da ResNet50 (1.024 caratteristiche), EfficientNetB0 (1.280 caratteristiche), MobileNet (1.024 caratteristiche) e Xception (2.048 caratteristiche) vengono concatenati per produrre una rappresentazione unificata di 5.376 dimensioni. Questa strategia di fusione è stata scelta per preservare le rappresentazioni complementari apprese dalle diverse architetture CNN, piuttosto che ridurre la rappresentazione prima della classificazione. Il vettore di caratteristiche risultante viene successivamente fornito al classificatore RBF-SVM, che determina il confine di decisione non lineare ottimale all'interno dello spazio di caratteristiche fuso.
Modello di intelligenza artificiale interpretabile (LIME)
Al fine di fornire un'interpretazione locale delle previsioni del modello, gli autori adottano il metodo di generazione di spiegazioni locali comprensibili all'uomo per ciascuna singola previsione del modello, denominato LIME47. Per ogni immagine in ingresso, LIME la suddivide innanzitutto in unità più piccole chiamate superpixel. Successivamente vengono generate delle perturbazioni a partire dall'immagine originale e vengono stimate le previsioni del modello neurale profondo per ciascuna di queste perturbazioni. Quindi, un modello lineare pesato viene adattato alle perturbazioni utilizzando pesi che dipendono dalla loro vicinanza all'istanza originale di input. Dopo l'adattamento del modello lineare, vengono stimate le misure di importanza delle caratteristiche, che indicano il ruolo di ciascun superpixel nella previsione dell'etichetta finale. Questi punteggi di importanza vengono evidenziati visivamente nell'immagine finale di spiegazione. L'algoritmo LIME è illustrato nel File Supplementare 2.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
La valutazione delle prestazioni del framework di classificazione sviluppato si basa su misure di valutazione tradizionali derivate dalla matrice di confusione. Una matrice di confusione consente di ottenere una comprensione completa delle prestazioni del classificatore attraverso la rappresentazione del numero di classificazioni corrette e scorrette effettuate per ciascuna classe definita. In questo modo, tutti i tipi di errori possono essere analizzati. Ad esempio, sia i falsi positivi che i falsi negativi sono partico...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Il framework proposto di apprendimento profondo interpretabile per la classificazione delle lesioni cutanee (EDLF-SLC) dimostra che la combinazione di rappresentazioni di caratteristiche profonde complementari con intelligenza artificiale interpretabile può migliorare sia le prestazioni di classificazione sia la trasparenza del modello. Integrando diverse architetture di CNN preaddestrate (ResNet50, EfficientNetB0, MobileNet e Xception) per l'estrazione delle caratteristiche e utilizzando una macchina a vettori di suppor...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori dichiarano che non vi è alcun conflitto di interessi.
Ringraziamenti
Gli autori desiderano esprimere la loro sincera gratitudine all'Università di Taif per aver fornito l'ambiente di ricerca e il supporto istituzionale che hanno facilitato il completamento di questo lavoro.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Dataset sulle lesioni cutanee ISIC 2020 | Collaborazione internazionale per l'imaging cutaneo (ISIC) | Dataset della competizione ISIC 2020 | Dataset di immagini dermatoscopiche utilizzato per lo sviluppo e la valutazione del modello. |
| Keras | Squadra di Keras | Integrato con TensorFlow | Costruzione e addestramento di modelli di deep learning. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | Pacchetto Python | Generazione di spiegazioni visive locali per le previsioni del modello. |
| Matplotlib | Sviluppatori di Matplotlib | Ultima versione compatibile | Visualizzazione di curve di apprendimento, matrici di confusione e grafici di valutazione. |
| NumPy | Sviluppatori di NumPy | Ultima versione compatibile | Calcoli numerici e manipolazione di array. |
| GPU NVIDIA Tesla T4 | NVIDIA Corporation | 16 GB VRAM | Accelerazione dell'addestramento e dell'inferenza del modello. |
| Pandas | Squadra di sviluppo di Pandas | Ultima versione compatibile | Elaborazione dei dati e gestione dei risultati sperimentali. |
| Modelli CNN pre-addestrati | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | Estrazione di caratteristiche profonde da immagini dermatoscopiche. |
| Python | Fondazione Python Software | Versione 3.9 | Linguaggio di programmazione utilizzato per l'implementazione. |
| PyTorch | Fondazione PyTorch | Versione 2.3.1 | Framework di deep learning utilizzato per l'estrazione di caratteristiche e l'implementazione del modello. |
| Scikit-learn | Sviluppatori di Scikit-learn | Ultima versione compatibile | Macchina a vettori di supporto (SVM), metriche di valutazione e pre-elaborazione dei dati. |
| Macchina a vettori di supporto (kernel RBF) | Scikit-learn | SVC | Classificazione di rappresentazioni di caratteristiche profonde fuse. |
| TensorFlow | Google LLC | Versione 2.x | Framework di deep learning per l'addestramento e l'inferenza del modello. |
| Sistema operativo Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Ambiente operativo sperimentale. |
Riferimenti
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.