Questo articolo propone un modello innovativo, le reti neurali grafiche con attenzione lineare a slot con gate per la raccomandazione basata su sessione, che adotta un'attenzione lineare a slot con gate su un grafo di sessione costruito in modo duale. Il modello aumenta l'accuratezza e l'efficienza della raccomandazione e supera lo stato dell'arte (SOTA) su tre dataset pubblici.
Articolo di ricerca
Reti Neurali a Grafo con Attenzione Lineare a Slot Gated per la Raccomandazione Basata su Sessioni
In questo articolo
Sommario
Abstract
I sistemi di raccomandazione basati su sessione (SBR) mirano a prevedere l'elemento successivo con cui un utente è probabile che interagisca, sulla base della sequenza di comportamenti all'interno della sessione corrente. Approcci recenti che sfruttano il meccanismo d'attenzione Transformer (ad esempio, GC-SAN) hanno dimostrato prestazioni superiori rispetto ai metodi tradizionali; tuttavia, soffrono di un carico computazionale elevato e di una complessità spaziale dovuta al costo quadratico dell'auto-attenzione. Per affrontare questi limiti, viene proposto un nuovo modello denominato GSLA4Rec (reti neurali grafiche con attenzione lineare a slot con gate per la raccomandazione basata su sessione), che integra l'attenzione lineare con un meccanismo di gating apprendibile e una strategia di aggiornamento della memoria basata su slot ispirata all'attenzione a slot con gate. In particolare, GSLA4Rec costruisce innanzitutto due grafi: un grafo di sessione per catturare le transizioni tra elementi all'interno della sessione e un grafo globale di vicinato per codificare segnali collaborativi tra sessioni, modellando così informazioni contestuali sia locali che globali. L'approccio proposto si basa sul meccanismo di attenzione lineare a slot con gate, che (1) impiega unità di gating per sopprimere il rumore derivante da interazioni irrilevanti o ridondanti nelle sessioni lunghe, (2) utilizza unità di slot per memorizzare e aggiornare dinamicamente rappresentazioni compatte della sessione—riducendo il sovraccarico di memoria, e (3) sostituisce l'auto-attenzione con un'attenzione lineare per ottenere una complessità temporale lineare. Insieme, questi componenti migliorano significativamente l'accuratezza predittiva e l'efficienza del modello nel catturare gli interessi in evoluzione degli utenti. Ampi esperimenti su diversi dataset pubblici di riferimento, tra cui Diginetica, Tmall e NowPlaying, dimostrano che GSLA4Rec supera costantemente i metodi SBR all'avanguardia in termini di prestazioni raccomandative, confermando l'efficacia del meccanismo GSLA.
Introduzione
Con il rapido sviluppo dei servizi online (come l'e-commerce, le piattaforme di video brevi e i feed di notizie), il problema del sovraccarico informativo è diventato sempre più evidente e grave. I sistemi di raccomandazione1,2 forniscono servizi personalizzati e mirati di diffusione delle informazioni analizzando approfonditamente i dati comportamentali degli utenti. Tuttavia, in molte applicazioni pratiche caratterizzate da accesso anonimo, utenti non registrati, protezione della privacy e brevi durate di interazione, i metodi tradizionali di raccomandazione come il filtraggio collaborativo3 e la fattorizzazione della matrice4,5 limitano fortemente l'applicabilità degli algoritmi di raccomandazione. Per affrontare queste sfide, è emerso l'SBR6,7,8,9. L'SBR si concentra sui dati di sequenza delle interazioni all'interno della sessione corrente dell'utente per prevedere il prossimo possibile punto di interesse. Questo paradigma non solo evita la dipendenza dai dati storici a lungo termine degli utenti, ma coglie anche con precisione i cambiamenti dinamici di breve termine negli interessi, dimostrando così un valore applicativo unico in scenari come l'e-commerce, i video brevi, la raccomandazione musicale e simili.
I primi metodi si basavano principalmente sulle catene di Markov5,10,11,12 per modellare le probabilità di transizione tra elementi nelle sequenze di sessione. Sebbene tali metodi fossero in grado di catturare dipendenze sequenziali del primo ordine, la caratterizzazione di dipendenze complesse di ordine superiore e delle dinamiche non lineari degli interessi degli utenti rimane limitata, riducendo l'efficacia del modello in scenari complessi. Con lo sviluppo della tecnologia del Deep Learning13,14, i metodi basati su reti neurali sono stati ampiamente applicati nel SBR. GRU4REC15 è stato il primo a utilizzare reti neurali ricorrenti14 (RNNs) per la raccomandazione basata su sessione, catturando efficacemente le dipendenze temporali nelle sequenze; NARM16 ha ulteriormente migliorato la capacità di estrarre gli interessi principali degli utenti integrando meccanismi di attenzione con le RNN; STAMP17 ha utilizzato percettroni multistrato (MLP) combinati con meccanismi di attenzione per concentrarsi sulla cattura degli interessi a breve termine degli utenti. Sebbene questi metodi abbiano ottenuto alcuni progressi nella modellazione delle sequenze, hanno comunque affrontato sfide come la difficoltà nel gestire dipendenze a lungo termine e la sensibilità al rumore.
Negli ultimi anni, le reti neurali su grafi (Graph Neural Networks, GNN)18,19,20,21 hanno offerto una nuova prospettiva al compito di raccomandazione basata su sessioni (SBR). Modelli come SR-GNN22 modellano esplicitamente relazioni di transizione complesse costruendo un grafo di sessione (SG), ottenendo notevoli miglioramenti nell'accuratezza delle raccomandazioni. Tuttavia, la maggior parte dei metodi esistenti basati su GNN effettua la costruzione del grafo e il passaggio dei messaggi all'interno di sessioni individuali, senza sfruttare efficacemente le informazioni sulle correlazioni globali tra elementi. Per affrontare questo problema, GCE-GNN23 integra semantica globale e grafi di sessione mediante un meccanismo di auto-attenzione, pesando in modo adattivo l'importanza degli elementi attraverso la costruzione di un grafo globale di vicinato (NGG), ottenendo significativi miglioramenti nelle prestazioni. Tuttavia, i metodi esistenti basati su GNN devono ancora affrontare due principali limitazioni: in primo luogo, la complessità del meccanismo di auto-attenzione cresce quadraticamente con la lunghezza della sessione, causando un notevole carico computazionale nel trattamento di sessioni lunghe; in secondo luogo, le GNN tradizionali non sono in grado di regolare dinamicamente l'importanza degli elementi durante l'aggregazione delle informazioni, rendendo difficile distinguere tra comportamenti irrilevanti e comportamenti critici, il che compromette la qualità della rappresentazione.
Per affrontare queste sfide, questo articolo propone una rete neurale grafica basata sull'attenzione lineare con slot controllati per la raccomandazione basata su sessione (GSLA4Rec): (1) Progettazione di un meccanismo a slot controllati che filtra il rumore mediante una funzione di gating e memorizza informazioni semantiche chiave negli slot della sessione, migliorando la robustezza del modello e riducendo il sovraccarico di archiviazione; (2) Introduzione del meccanismo di attenzione lineare che riduce la complessità computazionale da O(N2) a O(N) dove N è la lunghezza della sessione), mantenendo al contempo la capacità di modellare dipendenze a lunga distanza; (3) Esecuzione di esperimenti approfonditi su tre dataset pubblici di riferimento (Diginetica, Tmall e NowPlaying), che mostrano come GSLA4Rec superi in modo significativo i metodi SOTA esistenti, dimostrando in particolare vantaggi evidenti in scenari con sessioni lunghe e dati sparsi.
Protocollo
Esperienza di raccomandazione basata su sessioni
La raccomandazione basata su sessione può essere esaminata da tre prospettive: SBR, apprendimento del contesto globale e GSLA (si veda la Tabella dei materiali). Nessun partecipante umano né animali sono stati coinvolti in questo studio. Tutti i dataset sperimentali utilizzati in questo lavoro sono disponibili pubblicamente e sono stati inviati come File supplementare: GSLA4Rec. zip.
Raccomandazione basata su sessione
Il sistema di raccomandazione basato sulle sessioni (SBR) era un sistema di intelligenza artificiale che interagiva con gli utenti attraverso dialoghi naturali in più turni per comprendere dinamicamente le preferenze degli utenti e fornire raccomandazioni personalizzate. L'SBR si è evoluto da metodi tradizionali ad approcci basati sul deep learning e ibridi, per poi progredire verso soluzioni basate su modelli linguistici di grandi dimensioni (LLM).
Raccomandazione tradizionale basata su sessioni
L'SBR tradizionale era tipicamente rappresentato da metodi basati su catene di Markov e filtraggio collaborativo. Il primo generava raccomandazioni decomponendo matrici di transizione probabilistiche specifiche per l'utente. Ad esempio, Guy Shani24 ha proposto un metodo di raccomandazione basato su processi decisionali di Markov che produceva raccomandazioni mediante la decomposizione di matrici corrispondenti; Wanrong Gu25 ha migliorato le prestazioni delle raccomandazioni integrando le catene di Markov con gli intervalli temporali di acquisto. Il secondo generava raccomandazioni estraendo relazioni sequenziali nascoste tra elementi interattivi adiacenti attraverso la fattorizzazione della matrice. Ad esempio, Sarwar B1 ha calcolato la similarità tra elementi in base ai comportamenti storici degli utenti (come valutazioni e clic) per raccomandare elementi coerenti con le preferenze passate degli utenti. Se l'utente A aveva gradito l'elemento a, e l'elemento c era molto simile ad a, il sistema raccomandava c all'utente A; Rendle S5 ha proposto FPMC, un modello di raccomandazione sequenziale che combina la fattorizzazione della matrice con le catene di Markov, per catturare le relazioni sequenziali nascoste tra elementi interattivi adiacenti. Tuttavia, tali approcci SBR tradizionali si concentravano sulle relazioni sequenziali tra elementi adiacenti, rendendo difficile modellare relazioni di dipendenza complesse.
Raccomandazione basata su sessioni mediante apprendimento profondo
La raccomandazione basata su sessioni mediante apprendimento profondo ha attraversato diverse fasi evolutive che hanno coinvolto reti neurali convoluzionali (CNN)26,27,28,29, reti neurali ricorrenti (RNN) e reti neurali grafiche (GNN). La SBR basata su CNN sfruttava operazioni come la convoluzione e il pooling per apprendere rappresentazioni di ciascun contesto di sessione, successivamente utilizzate per generare raccomandazioni. Caser30 convertiva gli L elementi più recenti con cui un utente aveva interagito in vettori d-dimensionali tramite un livello di incorporamento, formando una matrice di incorporamento trattata come un"immagine" mappata nel tempo e nello spazio latente. Successivamente, utilizzava tre filtri convoluzionali per modelli sequenziali — a livello puntuale, a livello di unione senza salto e a livello di unione con un salto — per apprendere modelli sequenziali e migliorare le prestazioni della SBR. Tuan et al.31 modellarono in modo uniforme i flussi di clic delle sessioni e le caratteristiche dei contenuti mediante kernel convoluzionali 3D, formando rappresentazioni congiunte spazio-temporali e basate sui contenuti.
Le RNN erano una classe di architetture di reti neurali progettate specificamente per elaborare dati sequenziali. L'idea fondamentale consisteva nel catturare le dipendenze temporali attraverso strutture ricorrenti come le reti a memoria a lungo e breve termine (LSTM)13 e le unità ricorrenti con porte (GRU)32, ed erano ampiamente utilizzate in campi come l'elaborazione del linguaggio naturale (NLP)33, il riconoscimento vocale34, la traduzione del testo35, i viaggi36,37, la criminalità38 e la previsione di tendenze future39 (ad esempio, traffico40, mercati azionari41,42 e meteorologia43). GRU4Rec, proposto da Hidasi et al., rappresentò una pietra miliare nella ricerca sui SBR e fu il primo a introdurre le RNN nei SBR, catturando i modelli comportamentali sequenziali degli utenti tramite GRU per ottenere raccomandazioni personalizzate.
I GNN44 hanno dimostrato un'elevata capacità espressiva nella modellizzazione di relazioni complesse all'interno di dati strutturati a grafo, e alcuni ricercatori hanno introdotto i GNN per modellare transizioni complesse all'interno o tra sessioni. A seconda delle diverse architetture dei modelli GNN, i metodi basati su GNN per la SBR sono generalmente suddivisi in reti neurali a grafo con porte (GGNN)45, reti di convoluzione su grafi (GCN)46 e reti di attenzione su grafi (GAT)47. SR-GNN è stato il primo a utilizzare i GNN per la SBR, rappresentando le sequenze di sessione come grafi diretti e impiegando GGNN per catturare relazioni complesse di transizione tra elementi all'interno delle sessioni, combinandoli con meccanismi di attenzione per ottenere l'embedding finale della sessione, migliorando così le prestazioni del sistema di raccomandazione. Chen L48 ha proposto un framework multivista basato su GNN che integra attributi strutturati e parole chiave non strutturate per modellare associazioni prodotto multidimensionali, aumentando l'accuratezza della SBR. Driss E49 ha progettato un innovativo sistema di raccomandazione di sessione che adotta reti neurali a capsula su grafi per catturare caratteristiche complesse degli elementi e migliorare l'accuratezza delle previsioni nella SBR.
Le tecniche di deep learning sopra menzionate avevano ampliato l'ambito di ricerca dell'SBR e migliorato in modo efficace le prestazioni, ma presentavano comunque alcune limitazioni, principalmente riscontrabili in: 1) Per elementi appena emergenti o sessioni molto sparse, era difficile per i modelli effettuare previsioni accurate a causa della mancanza di un contesto globale; 2) Non erano in grado di sfruttare i modelli globali presenti in tutte le sessioni storiche.
Raccomandazione ibrida basata su sessione
La raccomandazione ibrida basata sulle sessioni integra i punti di forza di diverse tecniche, come il filtraggio collaborativo, il Deep Learning e i meccanismi di attenzione, per migliorare le prestazioni della SBR. GC-SAN50 incorpora un meccanismo di auto-attenzione basato su SR-GNN per catturare in modo più efficace le informazioni di interazione degli elementi più importanti all'interno di una sessione. FGNN51 aggrega ulteriormente le informazioni provenienti dagli elementi vicini attraverso un meccanismo di attenzione multi-testa, imparando così le diverse relazioni dell'elemento target. SR-HetGNN52 appartiene alla raccomandazione basata sulle sessioni con grafi eterogenei; introducendo elementi di tipo diverso (utente, elemento, sessione) e archi multi-relazionali (clic, acquisto, co-occorrenza, associazione di attributi), costruisce una rete globale di conoscenza, superando il limite delle sequenze di elementi singoli ed emergendo come un metodo fondamentale per modellare il comportamento degli utenti anonimi e le associazioni di interesse tra sessioni negli ultimi anni. KGSR-SAP53 costruisce un grafo di conoscenza collegando elementi tramite archi di diverse relazioni, descrivendo così le varie interazioni tra utente ed elemento, risolvendo il problema della perdita di informazioni che si verifica quando il grafo globale contiene solo archi di un singolo tipo (interazione utente-elemento). Wang ZH54 ha proposto DiffSBR, un modello di raccomandazione basato sulle sessioni che utilizza un approccio di diffusione. Esso genera preferenze affidabili per l'elemento successivo simulando la rimozione del rumore, migliorando così la modellazione delle sequenze dinamiche di clic degli utenti. Qiao ST55 ha sviluppato un framework SBR che combina l'apprendimento delle intenzioni multi-vista e l'allineamento con modelli linguistici di grandi dimensioni (LLM). Esso estrae le intenzioni implicite degli utenti da diverse prospettive e sfrutta modelli linguistici per allineare le caratteristiche semantiche, migliorando ulteriormente le prestazioni della raccomandazione.
Contesto globale
Per superare il limite delle "sessioni di visualizzazione considerate in isolamento", i ricercatori hanno compreso che le informazioni globali potevano essere utilizzate per potenziare la capacità rappresentativa della sessione corrente, al fine di risolvere problemi come la scarsità di dati, il problema di avviamento a freddo e il divario semantico nei tradizionali sistemi di raccomandazione basati su sessione (SBR). Nel frattempo, nella costruzione del contesto globale, era necessario integrare le informazioni globali all'interno di una singola sessione minimizzando al contempo le interferenze di rumore. CSRM56 ha ottimizzato la rappresentazione a livello di sessione integrando informazioni collaborative tra la sessione corrente e le sessioni adiacenti, utilizzando un codificatore a memoria esterna (OME) per estrarre l'intento collaborativo dalle informazioni collaborative. CA-TCN57 ha proposto un modello di rete convoluzionale temporale con consapevolezza intersessione, costruendo grafi globali e grafi contestuali di sessione per simulare l'impatto delle transizioni intersessione sugli elementi e sulle sessioni; inoltre, la rete convoluzionale temporale (TCN) amplia il campo recettivo attraverso convoluzioni dilatate, con un numero di strati in grado di coprire sequenze di lunghezza esponenziale (campo recettivo = ), risolvendo così il problema della scomparsa del gradiente nei modelli RNN. Chen58 ha proposto un metodo SBR basato su reti neurali ipergrafo (SR-HGNNs), che integra propagazione di ordine misto (basso e alto ordine) e meccanismi di attenzione per risolvere il problema di eccessiva omogeneizzazione (over-smoothing) delle tradizionali GNN in sessioni brevi e per distinguere l'importanza di diversi ordini di propagazione, permettendo una cattura più accurata delle dipendenze e l'evitamento di interferenze di rumore. GCE-GNN ha utilizzato coppie di elementi co-occorrenti di ordine multiplo per costruire un grafo pesato non orientato, contando le frequenze di co-occorrenza degli elementi per rifletterne l'importanza all'interno della sessione; AGNN-GC59 ha utilizzato le relazioni di transizione tra elementi intersessione per costruire un grafo collaborativo globale, calcolando le probabilità di transizione degli elementi nel grafo globale per riflettere i cambiamenti di interesse all'interno della sessione; DA-GCN60 ha utilizzato il percorso più breve per aggiornare la matrice di adiacenza e costruire un grafo pesato dinamico, calcolando la frequenza di co-occorrenza nel grafo globale e la distanza del percorso tra gli elementi. Ispirati dai suddetti studi, in questo articolo si propone di costruire un grafo globale mediante un approccio basato sui vicini, ovvero utilizzando il coefficiente di similarità di Jaccard per calcolare le sessioni simili, sfruttando così le informazioni globali e al contempo filtrando il rumore (eliminando gli elementi irrilevanti), raggiungendo l'obiettivo di costruire in modo accurato il contesto globale e gettando solide basi per l'algoritmo SBR successivo.
Attenzione lineare con slot controllati
I tradizionali trasformatori61 presentano un'elevata complessità spaziotemporale a causa della necessità di operazioni di attenzione completamente connesse lungo l'intera sequenza, come segue:
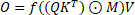 (1)
Dove Q, K, V ∈ RN×d erano trasformazioni lineari degli elementi in ingresso, M = {Mij = 1 se i ≥ j, altrimenti −∞ } era la maschera causale utilizzata per prevenire la fuoriuscita di informazioni future, ⊙ indicava il prodotto elemento per elemento e f indicava la funzione di attivazione softmax.
Per ottenere un'attenzione lineare62, l'idea più diretta era rimuovere la funzione di attivazione softmax. Tuttavia, se la funzione di attivazione softmax venisse rimossa direttamente, l'attenzione lineare porterebbe sicuramente a alcuni problemi potenziali: la perdita del potente potere espressivo delle reti neurali e l'incapacità di risolvere problemi complessi del mondo reale.
Attenzione lineare a slot con controllo a memoria limitata
Supponendo che fosse necessario mantenere la funzione di attivazione softmax, K e V sono state compresse separatamente in K̃, Ṽ ∈ Rm×d. Dal punto di vista della rete di memoria, K̃ e Ṽ possedevano slot di memoria la cui lunghezza aumentava con la sequenza, ovvero il numero di slot m = N. Se m era fissato, la linearizzazione era ovviamente possibile. Ispirandosi a Bounded-memory Control63, ogni token negli elementi in ingresso di lunghezza N doveva essere scritto in modo competitivo in m slot.
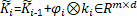 ,
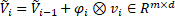 ,
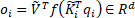 (2)
Dove f era la funzione di attivazione softmax e φi era il vettore per controllare l'ingresso efficace al fine di controllare il valore chiave ki come segue.
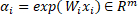 ,
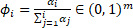 (3)
Qui, (φi)j rappresentava l'intensità di scrittura del token i-esimo nello slot j-esimo ed è stato ottenuto utilizzando una funzione softmax cumulativa.
Per ottenere un calcolo lineare efficiente, la formula (2) è stata riscritta come formula (4), che calcola οi da qi, ki e vi (Eq. 4) mediante {οi|i=1T, qi, ki, vi)|i=1T} e adotta un calcolo sequenziale in due passaggi:
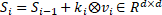 ,
 (4)
Pertanto, le operazioni SLA potrebbero essere derivate:
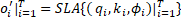 ,
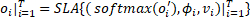 (5)
Dove oi′ ∈ ℝm, οi ∈ ℝd. Pertanto, l'SLA potrebbe acquisire un addestramento per blocchi efficiente dal punto di vista hardware e in tempo lineare64.
Attenzione lineare con slot controllati
L'attenzione lineare a slot con controllo a memoria limitata potrebbe ridurre la complessità computazionale e spaziale. Tuttavia, l'accumulo di informazioni potrebbe introdurre anche informazioni rumorose nell'interazione della sessione, quindi un decadimento dipendente dai dati era molto importante per conservare selettivamente e dimenticare le informazioni, e questo meccanismo selettivo era stato riesaminato nei recenti modelli selettivi dello spazio di stato65. GSLA con dipendenza dai dati poteva essere espresso come:
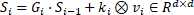 ,
 (6)
Qui le porte di decadimento sono state parametrizzate mediante una forma di prodotto esterno Gi = αi ⊗ βi, con αi, βi ∈ [0,1]d. Nei passaggi seguenti, GSLA può essere scritto anche nella seguente forma equivalente impostando tipicamente βt = 1 e utilizzando la moltiplicazione matriciale come in64:
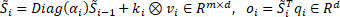 (7)
Dove αi e ki indicavano rispettivamente il cancello di dimenticanza e il cancello di ingresso, i due cancelli potevano essere accoppiati come ki = 1 − αi, ispirandosi alla letteratura sui RNN con cancelli. Era evidente che GSLA potesse essere formulato con un calcolo sequenziale a due passaggi, come mostrato nell'Equazione (8). La struttura del secondo ordine supportava un addestramento parallelo a blocchi per migliorare l'efficienza dell'addestramento, e l'inserimento dell'operazione softmax al centro della struttura del secondo ordine potenziava la capacità di modellazione della memoria a slot finiti.
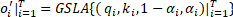 ,
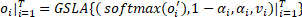 (8)
Trasformazione dei dati della sessione
Definizione del problema
Sia data la sequenza di sessione S = {v1s, v2s, ⋯, vns}, dove vis indica l'i-esimo elemento cliccato. Analizzando il comportamento dell'utente nei clic all'interno di questa sequenza, il sistema ha previsto l'elemento successivo che potrebbe interessare all'utente, vn+1s.
Costruzione del grafico
Costruzione del grafico di sessione
Per una sessione S = {v1s, v2s, ⋯, vns}, è stato costruito un grafo diretto Gs = (Vs, εs), in cui Vs rappresentava l'insieme di elementi della sessione data S, e εs = {eijlocal|vi, vj, vi, vj ∈ Vs} era l'insieme di archi della sessione data S. ε(vi-1s, vis) rappresentava gli elementi cliccati consecutivamente in questa sessione. L'arco eijlocal poteva essere suddiviso in quattro tipi: ein, eout, ein-out, eself. Poiché lo stesso elemento potrebbe apparire ripetutamente nella sequenza, il valore ponderato per ciascun arco è stato calcolato.
La sessione corrente s = [v1, v2, v4, v2, v3] è stata convertita in un SG, come mostrato in Figura 1A.
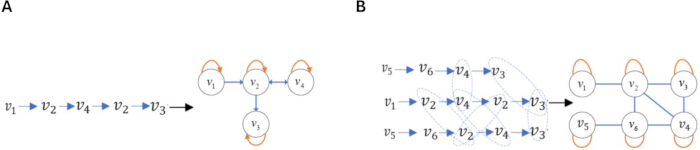
Figura 1: Trasformare gli elementi interattivi in strutture a grafo. (A) Illustrazione della costruzione del grafo di sessione (SG) mediante la trasformazione di una sessione in un grafo. (B) Illustrazione della costruzione del grafo globale dei vicini (NGG) combinando molte sessioni in un unico grafo. La figura è stata realizzata autonomamente tramite Visio con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright, pertanto non è stato necessario alcun permesso aggiuntivo da parte di terzi. Il copyright della figura appartiene agli autori e sarà conforme alle norme editoriali della rivista in caso di accettazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Costruzione del grafo globale dei vicini
Sulla base della sessione corrente S, è stato costruito il corrispondente NGG Gg = (Vg, εg) per arricchire l'apprendimento della rappresentazione della sessione corrente in modo intersessione. Vg era l'insieme degli elementi contenente tutti gli elementi in Gg, e εg = {eijglobal|vi, vj, vi, vj ∈ Vg} era l'insieme degli archi di Gg. ε(vi-1g, vig) rappresentava gli elementi interagenti direttamente vi-1g e vig nel NGG Gg. Questo processo comprendeva due fasi: acquisizione della sessione vicina e costruzione del NGG.
Acquisizione della sessione con il vicino
In tutto il set di dati, sono state cercate le sessioni con il numero massimo di elementi co-occorrenti rispetto alla sessione corrente. Sono state selezionate le prime N sessioni con i conteggi di co-occorrenza più elevati per costruire un insieme candidato di sessioni vicine S. Successivamente, il coefficiente di similarità di Jaccard è stato utilizzato per calcolare la similarità tra la sessione corrente cu e una sessione Sr ∈ S dell'insieme candidato S, come mostrato nell'Equazione (9).
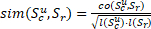 (9)
Qui, co(Scu, Sr) indica il numero di elementi che compaiono contemporaneamente sia in Scu che in Sr, mentre l(Scu) e l(Sr) rappresentano rispettivamente le lunghezze di Scu e Sr, e Scu e Sr indicano la sessione corrente e una sessione vicina. Le sessioni con una somiglianza inferiore a una certa soglia (impostabile come iperparametro) sono state eliminate, mentre le sessioni rimanenti costituiscono l'insieme delle sessioni vicine Ns per la sessione corrente.
Costruzione del grafo globale dei vicini
Sulla base dell'insieme di sessioni adiacenti Ns, è stato costruito il NGG, come illustrato in Figura 1B. Durante la costruzione della matrice di adiacenza, se due elementi (vi, vj) presentavano un'interazione, l'elemento corrispondente Aij veniva impostato a 1; in caso contrario, veniva impostato a 0. Inoltre, le interazioni tra gli elementi sono state trattate come non direzionate e sono state dotate di autoanelli, seguite da normalizzazione, come mostrato in Tabella 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabella 1: Matrice di adiacenza normalizzata del grafo globale dei vicini. La tabella presenta la matrice di adiacenza normalizzata che descrive le connessioni pesate tra i nodi nel grafo globale dei vicini costruito.
Progettazione di un algoritmo di raccomandazione basato su sessioni
Questa sezione illustra il modello innovativo proposto GSLA4Rec, che migliora le prestazioni di SBR introducendo il meccanismo GSLA sulla rappresentazione congiunta delle caratteristiche di SG e NGG.
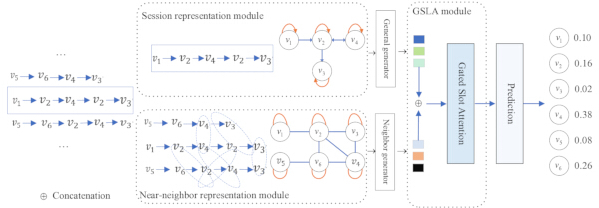
Figura 2: Schema del framework GSLA4Rec. Questo schema integrava l'apprendimento della struttura del grafo di sessione e del grafo globale dei vicini, filtrava il rumore delle interazioni mediante un meccanismo di gating, bilanciava memorizzazione ed efficienza con un meccanismo di memory slots e catturava la rilevanza degli elementi attraverso un meccanismo di attenzione lineare per prevedere la preferenza dell'utente per il prossimo clic. La figura è stata realizzata autonomamente tramite Visio con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright; pertanto, non è stato necessario alcun permesso aggiuntivo da parte di terzi. Il copyright della figura appartiene agli autori e sarà conforme alle norme editoriali della rivista in caso di accettazione. GSLA4Rec indica le reti neurali a grafo con attenzione lineare a slot con gating per il SBR. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura 2 mostra il framework di GSLA4Rec, composto da quattro componenti principali: 1) Rappresentazione degli elementi a livello di sessione. Utilizzava un modello GNN su SG per apprendere gli embedding degli elementi a livello di sessione all'interno della sessione corrente; 2) Rappresentazione degli elementi a livello globale dei vicini. Apprendeva gli embedding degli elementi a livello globale su tutte le sessioni impiegando una GRU per incorporare ricorsivamente gli embedding dei vicini di ciascun elemento in base a NGG; 3) GSLA. Modellava le preferenze dell'utente nella sessione corrente aggregando le rappresentazioni degli elementi apprese sia a livello di sessione che a livello globale; 4) Strato di previsione. Produceva le probabilità previste per gli elementi candidati. Le quattro componenti sono descritte in dettaglio di seguito.
Rappresentazione della sessione
In SBR, la comprensione dei comportamenti di interazione degli utenti era fondamentale. A tal fine, sono stati costruiti un SG e un NGG per l'apprendimento della rappresentazione delle sessioni, con l'obiettivo di comprendere in modo completo i comportamenti di interazione degli utenti e catturare così l'intento degli utenti in modo più autentico.
Rappresentazione degli elementi a livello di sessione
Sulla base del SG in Figura 1A, è stato impiegato un metodo di Attenzione su Grafo Bidirezionale Pesato (WBGAT) per estrarre le caratteristiche del SG. Questo metodo ha introdotto pesi sugli archi e direzionalità degli elementi (vicini in entrata e vicini in uscita) basandosi sul meccanismo standard GAT, ottenendo l'effetto di rafforzare gli archi importanti e catturare dipendenze bidirezionali, superando così i limiti del GAT tradizionale riguardo alle relazioni asimmetriche tra elementi e all'intensità delle interazioni. Il processo di calcolo è stato il seguente:
Innanzitutto, calcolo dei pesi di normalizzazione del grado in entrata degli elementi.
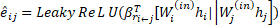 (10)
dove eij indicava il peso del vicino di primo ordine delle caratteristiche dell'elemento j rispetto all'elemento i,  era la relazione tra l'elemento i e l'elemento j, β* ∈ ℝd erano i vettori dei pesi, hi e hj erano rispettivamente le rappresentazioni dell'elemento i e dell'elemento j, Wi(in) ∈ ℝd*d e Wj(in) ∈ ℝd*d erano parametri addestrabili, || rappresentava l'operazione di concatenazione. Per distinguere le diverse relazioni di grado entrante, sono stati addestrati due vettori di peso, denominati rin e rin-self. È stata adottata la funzione di attivazione LeakyReLU.
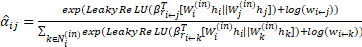 (11)
Per rendere i coefficienti confrontabili tra elementi diversi, i pesi di attenzione sono stati normalizzati mediante la funzione softmax. Dove Ni(in) era l'insieme dei vicini entranti di primo ordine dell'elemento i,  era il peso del vicino entrante del collegamento diretto (i←j) nel grafo SG, questo metodo ha permesso al modello di apprendere le correlazioni tra le caratteristiche degli elementi mantenendo al contempo le informazioni relative alla forza intrinseca delle connessioni nella struttura del grafo, prendendo il logaritmo dei pesi degli archi e aggiungendoli al punteggio di attenzione originale eij.
Secondo, calcolo dei pesi di normalizzazione del grado in uscita degli elementi.
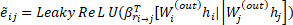 (12)
dove ẽij indicava il peso del primo ordine delle caratteristiche dell'elemento j rispetto all'elemento i,  era la relazione tra l'elemento i e j, sono stati addestrati due vettori di peso, denominati rout e rout-self.
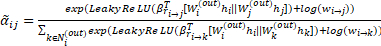 (13)
Dove Ni(out) era l'insieme dei vicini di primo ordine in uscita dell'elemento i,  era il peso del vicino in uscita del collegamento diretto (i→j) nel SG.
Terzo, aggregazione delle informazioni. L'embedding aggiornato dell'elemento può essere ottenuto dopo aver pesato e sommato gli embedding di primo ordine relativi al grado entrante e al grado uscente dell'elemento i.
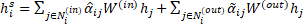 (14)
Dove  e α̃ij indicano rispettivamente i pesi del grado entrante e del grado uscente dell'elemento i,
 indica la rappresentazione aggiornata dell'elemento i.
Rappresentazione globale dell'elemento a livello di vicinato
Ricerche recenti hanno concordemente stabilito che la costruzione di un grafo globale potrebbe migliorare la rappresentazione dei dati e, di conseguenza, potenziare le prestazioni di SBR, il che era fuori discussione. Tuttavia, il potenziamento globale dei dati potrebbe introdurre anche informazioni irrilevanti, come rumore. Nel modello proposto, al fine di ottenere un'arricchimento globale dei dati riducendo al minimo il rumore per quanto possibile, è stato costruito un grafo globale basato su vicini prossimi.
Sulla base del NGG in Figura 1B e della matrice di adiacenza normalizzata in Tabella 1, la sessione attuale e le sessioni adiacenti sono state trasformate in un NGG, e un metodo GGNNs45 è stato applicato per estrarre le caratteristiche del NGG. Il processo di apprendimento dei vettori degli elementi nel NGG è mostrato nell'Equazione (15).
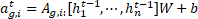
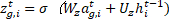
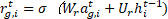
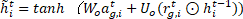
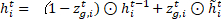 (15)
W ∈ ℝd×2d indicava i pesi di controllo, zg,i e rg,i rappresentavano rispettivamente il gate di aggiornamento e il gate di reset. [h1t-1, ⋯, hnt-1] rappresentava l'elenco di tutti i vettori degli elementi nella sessione s. σ(x) = 1/(1 + e-x) era la funzione sigmoidea logistica, ⊙ indicava la moltiplicazione elemento per elemento, e hi ∈ ℝd rappresentava il vettore dopo l'aggiornamento con gate. La matrice di adiacenza As ∈ ℝn×n indicava la connettività tra gli elementi nelle sessioni adiacenti, e As,i: ∈ ℝ1×n rappresentava un blocco di colonna di As corrispondente all'elemento vs,i nella matrice di adiacenza. Per la sessione corrente s = [v1, v2, v4, v2, v3], il NGG e la matrice di adiacenza normalizzata erano mostrati in Figura 1B e Tabella 1, rispettivamente.
Rappresentazione dell'elemento
La rappresentazione dell'elemento è stata ottenuta sommando il vettore dell'elemento a livello di sessione e il vettore dell'elemento a livello globale del vicino, come mostrato nell'Equazione (16):
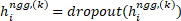
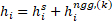 (16)
Dove è stato utilizzato il dropout sulle rappresentazioni degli elementi adiacenti a livello globale per attenuare l'overfitting.
Attenzione lineare con slot controllati
La gated-slot linear attention (GSLA) presentata in questo articolo integra l'attenzione lineare con un controllo a memoria limitata e un meccanismo di gating dipendente dai dati. Da un lato, eredita il meccanismo a slot di memoria finita del modello attention-based controller (ABC), comprimendo le coppie chiave-valore, che inizialmente crescevano con la lunghezza della sequenza, in un numero fisso di slot, ciascuno aggiornato tramite scrittura competitiva, risolvendo così il problema della complessità computazionale dell'attenzione globale del transformer. Dall'altro lato, introduce un meccanismo di gating fine-granulare simile a quello della GLA, in cui i dati in ingresso regolano dinamicamente il rapporto di mantenimento delle informazioni storiche attraverso un cancello di dimenticanza αi, risolvendo il problema del rumore causato dall'assenza di un meccanismo di dimenticanza nell'ABC.
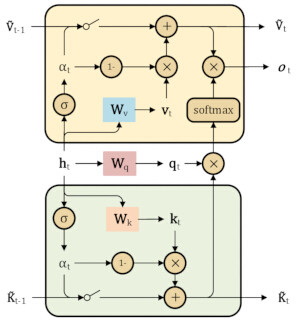
Figura 3: Diagramma schematizzato del GSLA. Il vettore di input è stato mappato rispettivamente nel vettore di query, nel vettore delle parole chiave e nel vettore dei valori, quindi elaborato mediante attenzione lineare con controllo della memoria limitata e un meccanismo di gating dipendente dai dati per ottenere il vettore di query aggiornato, il vettore delle parole chiave aggiornato, il vettore dei valori aggiornato e il vettore di output. Questa figura è stata disegnata autonomamente utilizzando Visio con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright; pertanto, non è stato necessario alcun permesso aggiuntivo per copyright di terze parti. Il copyright della figura appartiene agli autori e sarà conforme alle norme editoriali della rivista in caso di accettazione. GSLA indica attenzione lineare con slot a gate. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Come specificamente implementato in Figura 3, il vettore di ingresso è stato mappato separatamente nel vettore di interrogazione, nel vettore chiave e nel vettore di valore64:
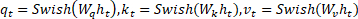 (17)
Dove Wq, Wk, Wv ∈ ℝd×d rappresentavano le matrici di peso della trasformazione corrispondenti rispettivamente alla query, alla chiave e al valore, e ht indicava il vettore di embedding al passo temporale t nella sequenza di input della sessione. La funzione Swish era definita come Swish(x) = x · σ(x) ed era una funzione di attivazione auto-gestita, in cui σ era la funzione Sigmoid; essa superava la tradizionale funzione di attivazione ReLU in numerosi compiti di apprendimento profondo.
GSLA ha utilizzato un gate di dimenticanza αi e un gate di ingresso 1 − αi, dipendenti dai dati in ingresso, per aggiornare dinamicamente le informazioni nello slot di memoria iesimo. Il processo era il seguente64:
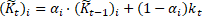 (18)
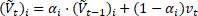 (19)
In questo caso, K̃t e Ṽt rappresentavano gli slot del vettore chiave e gli slot del vettore valore al passo temporale t, mentre K̃t-1 e Ṽt-1 rappresentavano gli slot del vettore chiave e gli slot del vettore valore al passo temporale t−1. Il gate di dimenticanza αi = σ(Wαht)1/τ, dove Wα ∈ ℝd era la matrice dei pesi di trasformazione, σ era la funzione sigmoidea e τ era il coefficiente di smorzamento (tipicamente impostato a 8), era utilizzato per controllare la morbidezza del gate di dimenticanza. Ciò permetteva a GSLA di regolare in modo continuo il tasso di dimenticanza delle informazioni storiche: maggiore era il valore di αi, maggiore era la dipendenza di GSLA dalle informazioni storiche; minore era il valore di αi, maggiore era l'attenzione di GSLA sull'input corrente.
Gli slot del vettore chiave K̃t e gli slot del vettore valore Ṽt degli slot al passo t-esimo sono stati scritti in forma matriciale, come mostrato65 nelle equazioni (20) e (21):
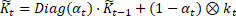 (20)
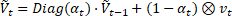 (21)
Successivamente, il GSLA con proprietà del secondo ordine (si veda l'Equazione (8)) è stato utilizzato per calcolare l'output oi |i=1T per ogni passo temporale i ∈ [1, …, T]. È stata applicata una trasformazione lineare all'output di ciascun passo temporale per ottenere il risultato h̃t. Infine, è stato calcolato il valore medio delle rappresentazioni di tutti gli elementi nella sequenza della sessione per generare l'embedding della sessione S̃e con aggiornamenti dinamici della memoria:
 (22)
 (23)
Qui, ot rappresentava l'output di Gated-Slot al passo temporale t, h̃t indicava il risultato dell'applicazione di una trasformazione lineare a ot. S̃e indicava il valore medio di h̃t in tutti i passi temporali.
Strato di previsione
Sulla base della rappresentazione della sessione ottenuta S̃e e dell'incorporamento iniziale dell'elemento i, è stata eseguita un'operazione di prodotto scalare per calcolare il punteggio di ciascun elemento candidato hi. Successivamente, la funzione softmax è stata utilizzata per ottenere le probabilità di raccomandazione dell'elemento candidato i:
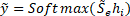 (24)
In questo caso, ỹ rappresentava le probabilità di raccomandazione dell'elemento candidato, hi indicava il vettore dell'elemento candidato e la funzione di perdita cross-entropia è stata utilizzata per l'addestramento del modello.
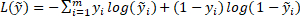 (25)
In questo caso, y era la rappresentazione one-hot encoded della verità fondamentale.
Risultati
Set di dati e preelaborazione
Negli esperimenti, sono stati selezionati tre dataset pubblici di SBR derivati da dati di transazione reali in scenari applicativi pratici per valutare le prestazioni del modello: Diginetica, estratto dalla competizione CIKM Cup 2016, che contiene i record di transazioni e clic degli utenti; Tmall, relativo ai log utente della piattaforma Tmall, che registra i comportamenti di navigazione e acquisto degli utenti; e Nowplaying, che include registrazioni musicali sulla cronologia di riproduzione degli utenti su piattaforme musicali. Questi dataset sono stati ampiamente utilizzati nella ricerca su SBR e permettono di valutare in modo completo l'efficacia e l'applicabilità del modello.
Nella fase di preelaborazione dei dati, i set di dati sono stati standardizzati per garantire coerenza nella qualità dei dati. In particolare, sono state eliminate tutte le sessioni di durata inferiore a 2 e gli elementi presenti meno di 5 volte sono stati rimossi. Inoltre, per ogni sessione S = {v1, v2, ..., vn}, sono state generate multiple sottosequenze per l'addestramento e il test del modello. Queste sottosequenze avevano la forma: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Dopo aver completato la preelaborazione sopra descritta, sono state condotte analisi statistiche sui set di dati, le cui informazioni dettagliate sono riportate nella Tabella 2.
| Dataset | Diginetica | Tmall | Nowplaying |
| clic | 982961 | 818479 | 1367963 |
| addestramento | 719470 | 351268 | 825304 |
| test | 60858 | 25898 | 60417 |
| elementi | 43097 | 40728 | 60417 |
| lunghezza media | 5.12 | 6.69 | 7.42 |
Tabella 2: Descrizione del dataset. La tabella riassume le statistiche dei dataset Diginetica, Tmall e Nowplaying, inclusi i numeri di clic, campioni di addestramento e di test, elementi e lunghezza media della sessione.
Impostazioni sperimentali
Configurazione dei parametri
Per garantire l'equità dell'esperimento, sono stati adottati metodi di preelaborazione per elaborare tre set di dati, preimpostando contemporaneamente i parametri del modello GSLA4Rec. Per i set di dati Diginetica e Nowplaying, la dimensione del batch è stata impostata a 150, e a 300 per il set di dati Tmall. I parametri di questo modello sono stati inizializzati utilizzando una distribuzione gaussiana con media 0 e deviazione standard 0,1, e la dimensione è stata impostata a 100; l'ottimizzatore utilizzato è stato Adam con un tasso di apprendimento iniziale pari a 0,001, il tasso di apprendimento è stato moltiplicato per 0,1 ogni 3 epoche, l'addestramento è stato eseguito per un totale di 30 epoche sulla GPU NVIDIA TITAN V e con PyTorch 1.11.0 con cu113 (fare riferimento alla Tabella dei Materiali) per selezionare il valore migliore, la soglia per il filtraggio delle sessioni vicine è stata impostata a 0,5, ed è stata applicata la regolarizzazione L2 nell'esperimento. Per ciascun set di dati, l'ultimo 10% dei dati ordinati per orario di transazione è stato selezionato come set di test, mentre il restante 10% e l'80% sono stati selezionati casualmente come set di validazione e di addestramento, rispettivamente. Il numero di slot di memoria in GSLA è stato impostato a un valore compreso nell'insieme {0, 1, 2, 3, 4, 5}.
Parametri di valutazione
Questo articolo ha adottato P@N (Precisione@N, N = 10/20) e MRR@N (Media del Rango Reciproco@N, N = 10/20). P@N è stato utilizzato per misurare la proporzione di raccomandazioni corrette tra i primi N risultati raccomandati, MRR@N è stato utilizzato per calcolare il rango reciproco medio dei progetti corretti; maggiore è il valore di MRR, migliore è la prestazione nell'ordinamento.
Analisi delle prestazioni
L'efficacia del modello GSLA4Rec è stata valutata rispetto a baseline rappresentative di diverse fasi di sviluppo tecnologico. Inizialmente, metodi di apprendimento automatico sono stati utilizzati per la SBR, ad esempio FPMC5 è stato impiegato per prevedere l'effetto sequenziale basandosi sulle catene di Markov. Successivamente, con lo sviluppo dell'intelligenza artificiale, l'apprendimento profondo è stato ampiamente applicato alla SBR: GRU4Rec10 si basava su reti neurali ricorrenti (RNN) che modellavano la SBR impilando più strati di GRU e progettavano funzioni di perdita specializzate per ottimizzare la SBR; NARM16 ha introdotto l'attenzione multipla (AM) per catturare gli interessi principali degli utenti e generare una rappresentazione finale incorporata dell'elemento raccomandabile successivo; STAMP17 ha utilizzato percettroni multistrato potenziati da AM per catturare simultaneamente l'interesse generale e l'interesse immediato degli utenti. Negli ultimi anni, le reti neurali su grafi sono state ampiamente impiegate nella SBR grazie alla loro potente capacità di apprendimento su dati non euclidei. Ad esempio, SR-GNN22 ha applicato per la prima volta le GNN alla SBR, ottenendo relazioni complesse di transizione tra elementi tramite GGNN e concentrandosi sugli interessi immediati degli utenti mediante AM; GCE-GNN23 ha utilizzato GAT per ottenere relazioni di trasferimento tra elementi nei contesti locale e globale, generando rappresentazioni delle sessioni attraverso RPE e AM soft; S2-DHCN66 ha trasformato i dati di sessione in ipergrafi e grafi di linea, sfruttando l'apprendimento auto-sorvegliato per migliorare la SBR.
Recentemente, è stato adottato un approccio completo per migliorare le prestazioni dell'SBR. Ad esempio, GC-SAN50 ha combinato reti neurali grafiche (GNN) con reti multilivello a auto-attenzione per potenziare le prestazioni di raccomandazione modellando dipendenze a breve e lungo termine; TASRec67 ha incorporato informazioni temporali costruendo una sequenza di istantanee di grafi dinamici in diversi momenti temporali; CT-GNN68 ha utilizzato GNN con informazioni temporali combinate per apprendere ulteriori associazioni temporali tra gli elementi; CORE69 ha fuso le informazioni di co-occorrenza e quelle temporali degli elementi per ottenere la rappresentazione finale della sessione; RESTC70 ha proposto modelli di interazione spazio-temporale ispirati alle proprietà di uniformità e allineamento dell'apprendimento contrastivo; COTRec66,71 ha adottato l'apprendimento auto-sorvegliato su due viste del grafo di sessione e un addestramento congiunto per risolvere la scarsità di dati nell'SBR; RAIN71 ha sfruttato la mascheratura degli archi e la ricostruzione strutturale, addestrando congiuntamente un indicatore di arco per identificare ed eliminare in modo esplicito gli archi rumorosi, migliorando così significativamente l'accuratezza e la robustezza dell'SBR.
| Set di dati | Diginetica | Tmall | Nowplaying | ||||||||||
| Classificazione dei metodi | Metriche | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Apprendimento automatico | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Apprendimento profondo | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Apprendimento profondo | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Apprendimento profondo | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNN | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNN | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN+Tem | CORE | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNN+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNN+ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN+Slot con porte | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| DS | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| valore p | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tinferenza | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Tabella 3: Confronto delle prestazioni su tre dataset. La tabella confronta GSLA4Rec con metodi di raccomandazione basati su machine learning, deep learning, GNN, meccanismi di attenzione, approcci temporali e altri metodi sui dataset Diginetica, Tmall e Nowplaying, utilizzando P@10, P@20, MRR@10 e MRR@20. Sono riportati anche SD e valori di p per GSLA4Rec.
Al fine di verificare le prestazioni del modello GSLA4Rec ed eliminare la casualità del miglioramento delle prestazioni causata da fattori aleatori, sono stati condotti sull'insieme di test multipli esperimenti di raggruppamento e analisi statistiche. In particolare, l'insieme di test è stato suddiviso in gruppi di 150 sessioni per batch e l'esperimento è stato ripetuto 30 volte utilizzando il metodo del seme casuale. I risultati medi e il tempo di esecuzione di tutti gli esperimenti raggruppati sono stati calcolati come prestazioni e tempo di inferenza del modello GSLA4Rec, rispettivamente. La deviazione standard (SD) e il test statistico di significatività t del modello GSLA4Rec sono stati calcolati per verificare ulteriormente la stabilità e la certezza del miglioramento delle prestazioni del modello GSLA4Rec. Tabella 3 riporta le prestazioni, la SD, il valore p e Tinference del modello di raccomandazione proposto, GSLA4Rec, confrontato con i modelli di base sui tre dataset. I valori sottolineati indicano il miglior metodo di base, mentre il modello con le migliori prestazioni corrispondente a ciascuna metrica di valutazione è indicato in grassetto nero.
Metodi di raccomandazione basati sul machine learning: nei compiti SBR, il metodo tradizionale FPMC ha mostrato le prestazioni peggiori, principalmente perché i modelli a catena di Markov non sono riusciti a catturare modelli di transizione complessi tra gli elementi. 2) Metodi di raccomandazione basati sul deep learning: modelli come GRU4REC, NARM e STAMP hanno adottato approcci di modellazione sequenziale ottenendo alcuni miglioramenti nelle prestazioni. Tra questi, NARM e STAMP hanno dimostrato risultati di raccomandazione migliori rispetto a GRU4REC, principalmente perché NARM ha introdotto un meccanismo di attenzione per catturare gli interessi principali degli utenti. 3) Metodi di raccomandazione basati su GNN: l'adozione delle GNN nell'SBR ha portato significativi miglioramenti nelle prestazioni. Ad esempio, SR-GNN, che ha introdotto per primo la conversione delle sequenze di sessione in strutture grafiche per catturare informazioni strutturali spaziali degli elementi, ha superato i metodi basati su deep learning rappresentati da STAMP con un miglioramento del 0,36–4,64%, dimostrando il vantaggio spaziale delle strutture grafiche nell'elaborazione di dati sequenziali. S2-DHCN ha adottato una convoluzione ipergrafica a doppio canale per catturare dipendenze di ordine superiore tra gli elementi e ha abbinato un apprendimento contrastivo auto-sorvegliato per potenziare le rappresentazioni, superando il limite delle GNN tradizionali nel modellare solo relazioni a coppie e nell'avere informazioni insufficienti; le sue prestazioni hanno superato i metodi basati su deep learning rappresentati da STAMP del 1,30–7,04%. GCE-GNN, integrando efficacemente informazioni di singola sessione e informazioni globali di sessione, ha superato i metodi basati su deep learning rappresentati da STAMP del 1,46–7,60% e ha superato SR-GNN dello 0,88–5,85%, indicando che i metodi basati su strutture grafiche che incorporano informazioni contestuali globali possono migliorare significativamente le prestazioni dell'SBR. 4) Metodi di raccomandazione basati su GNN + meccanismo di attenzione: TASRec mirava a catturare in modo più preciso le preferenze a breve e lungo termine nelle sequenze di comportamento degli utenti introducendo un meccanismo sensibile al tempo; le sue prestazioni hanno superato i metodi basati su deep learning del 0,73–5,91% e il modello SR-GNN dello 0,30–2,31%, ma sono risultate inferiori al modello GCE-GNN dello 0,59–3,84%. GC-SAN ha combinato strutture grafiche derivate da sequenze di sessione con meccanismi di auto-attenzione multi-testa per catturare con successo dipendenze locali e a lungo termine all'interno delle sessioni; le sue prestazioni sono risultate paragonabili o leggermente superiori a quelle del modello SR-GNN, ma inferiori sia a TASRec che a GCE-GNN. Ciò suggerisce che l'introduzione di meccanismi di attenzione può migliorare efficacemente le prestazioni dell'SBR, ma il miglioramento è meno significativo rispetto a quello ottenuto con informazioni globali, confermando nuovamente l'importanza delle informazioni contestuali globali. 5) Metodi di raccomandazione basati su GNN + codifica temporale: CT-GNN è stato il primo a combinare strutture grafiche con codifica temporale per catturare simultaneamente la "struttura spaziale" e la "dinamica temporale", superando il modello GC-SAN del 0,55–3,82%. CORE ha catturato preferenze a lungo termine e intenzioni a breve termine analizzando statisticamente le frequenze di co-occorrenza degli elementi nelle sessioni globali e progettando un pesaggio della posizione temporale per le sessioni correnti, rispettivamente, e ha fuso queste informazioni di co-occorrenza e temporali per ottenere la rappresentazione finale della sessione; le sue prestazioni hanno superato il modello TASRec dello 0,25–9,58% e il modello GC-SAN dello 0,67–11,56%, mostrando un miglioramento significativo del 3,64–5,74% rispetto al modello GCE-GNN sul dataset Tmall. RESTC ha introdotto un modello di apprendimento contrastivo basato su GNN spazio-temporali per affrontare problemi delle GNN tradizionali, come il concentrarsi esclusivamente su strutture grafiche spaziali, l'ignorare informazioni temporali e una fusione spazio-temporale insufficiente; le sue prestazioni hanno superato il modello CORE dello 0,39–3,31% e il modello GCE-GNN dello 0,28–7,56%, indicando che sia la codifica temporale che l'apprendimento contrastivo migliorano efficacemente le prestazioni dell'SBR. RAIN ha utilizzato tecniche di mascheramento degli archi e ricostruzione strutturale per addestrare congiuntamente un indicatore di arco al fine di identificare ed eliminare esplicitamente gli archi rumorosi, raggiungendo prestazioni vicine a quelle del modello RESTC.
Il modello proposto, GSLA4Rec, ha integrato informazioni contestuali globali e un meccanismo di attenzione lineare con slot a soglia per catturare efficacemente le informazioni contestuali degli utenti, filtrando al contempo il rumore e riducendo la complessità computazionale. Ha mostrato miglioramenti nelle prestazioni su tutti i dataset, superando i due modelli di riferimento con le migliori prestazioni: il modello RESTC del 0,54–2,31% e il modello GCE-GNN del 0,83–10,18%. Tale vantaggio è stato particolarmente evidente nel gestire le dipendenze sequenziali in scenari con sessioni lunghe nell'SBR (in particolare, miglioramenti del 10,18% e del 4,73% rispetto a GCE-GNN e del 1,44% e del 2,31% rispetto a RESTC sui dataset Tmall e Nowplaying, rispettivamente). In breve, il modello GSLA4Rec proposto ha incorporato una costruzione efficiente del grafo per catturare i contesti degli utenti e filtrare il rumore; le sue prestazioni hanno costantemente superato quelle dello stato dell'arte (SOTA) su tutti i dataset.
Analisi dell'efficienza
Come mostrato in Figura 4, i risultati sperimentali sul dataset Diginetica hanno dimostrato che il modello proposto GSLA4Rec ha raggiunto una velocità di addestramento più rapida rispetto ai modelli di riferimento in termini di tempo di addestramento per epoca, con tutti gli esperimenti eseguiti su una GPU NVIDIA TITAN V e un consumo di circa 9300 MB di memoria. I modelli basati su deep learning, tra cui STAMP, NARM e GRU4Rec, hanno funzionato in modo efficiente ma hanno ottenuto le prestazioni più scadenti; i modelli TASRec e GC-SAN, basati su GNN e meccanismo di auto-attenzione, hanno migliorato le prestazioni, ma hanno subito un notevole aumento del tempo di elaborazione. Sebbene S2-DHCN e CORE, basati su GNN, abbiano comportato un lieve incremento del tempo di calcolo, le prestazioni complessive hanno registrato un notevole miglioramento, in particolare il modello proposto GSLA4Rec, che ha mostrato un sostanziale avanzamento nelle prestazioni. Il motivo principale era che il modello GSLA4Rec impiegava meno tempo nella costruzione del grafo rispetto ai modelli di riferimento; inoltre, utilizzava un meccanismo di attenzione lineare con porte in due passaggi e slot di memoria fissi m, determinando una complessità temporale lineare O(Ldm). Questa architettura risultava significativamente più efficiente rispetto all'auto-attenzione standard O(L2d), mantenendo al contempo una forte capacità di memoria grazie alla lettura degli slot potenziata da softmax. Eseguendo esperimenti di test delle prestazioni sul set di test per sincronizzare il tempo di inferenza statistica, come mostrato nell'ultima riga di Tabella 3, si è dimostrato il vantaggio in efficienza del modello GSLA4Rec, evitando il fenomeno della "falsa alta accuratezza ma non disponibile" e raggiungendo effettivamente un compromesso tra efficacia ed efficienza.
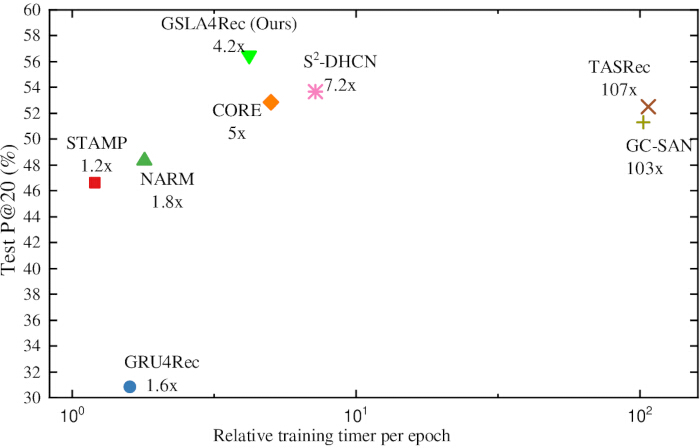
Figura 4: Prestazioni in funzione del tempo di esecuzione di GSLA4Rec su Diginetica. La figura ha mostrato che il nostro modello proposto GSLA4Rec e i modelli di riferimento sono stati eseguiti su GPU NVIDIA TITAN V utilizzando Diginetica per il tempo di addestramento relativo per epoca, e GSLA4Rec ha raggiunto una velocità di addestramento più elevata rispetto ai modelli di riferimento. Questa figura è stata realizzata autonomamente tramite OriginPro con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright, pertanto non è stato necessario alcun permesso aggiuntivo per diritti d'autore di terze parti. Il copyright della figura appartiene agli autori e sarà conforme alle regole editoriali della rivista in caso di accettazione. GSLA4Rec rappresenta le reti neurali grafiche con attenzione lineare a slot con gate per SBR. Cliccare qui per visualizzare una versione ingrandita di questa figura.
In sintesi, l'efficienza del modello proposto GSLA4Rec con attenzione lineare a slot con gate ha costantemente superato lo stato dell'arte (SOTA) su tutti i dataset. In particolare, GSLA4Rec ha ottenuto notevoli miglioramenti nelle prestazioni negli scenari di raccomandazione per sessioni lunghe sui dataset Tmall e Nowplaying, dimostrando una capacità superiore nella modellazione delle dipendenze sequenziali.
Analisi degli esperimenti di ablazione
Impatto di SG, NGG e GSLA
Per valutare l'impatto della SG, della NGG, del meccanismo di gating, degli slot di memoria e dell'attenzione lineare sull'attuale SBR, sono stati condotti studi di ablazione sui dataset Diginetica, Tmall e Nowplaying. GSLA4Rec‑NotSG escludeva la codifica delle caratteristiche SG mantenendo la codifica NGG, GSLA4Rec‑NotNGG eliminava la codifica NGG ed eseguiva l'estrazione delle caratteristiche esclusivamente sulla base di SG, GSLA4Rec‑NotGM rimuoveva soltanto il meccanismo di gating all'interno di GSLA, GSLA4Rec‑NotMS eliminava unicamente gli slot di memoria di GSLA, e GSLA4Rec‑NotLA ometteva solamente il modulo di attenzione lineare in GSLA.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Misure | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tabella 4: Prestazioni degli esperimenti di ablazione di GSLA4Rec. La tabella riporta le prestazioni di ablazione di GSLA4Rec dopo la rimozione di singoli componenti del modello sui dataset Diginetica, Tmall e Nowplaying, valutate utilizzando P@20 e MRR@20.
Tabella 4 mostrava i risultati dello studio di ablazione su diversi dataset: tutte le metriche di prestazione sono diminuite rispetto al modello completo. La riduzione delle prestazioni rimuovendo la codifica del grafo globale della sessione basata sui vicini più prossimi (GSLA4Rec-NotNGG) è stata maggiore rispetto alla rimozione della codifica delle caratteristiche del grafo della sessione (GSLA4Rec-NotSG). L'eliminazione di qualsiasi sottomodulo in GSLA avrebbe comportato un peggioramento delle prestazioni, il cui grado di riduzione è stato ordinato dal più alto al più basso in base all'attenzione lineare, agli slot di memoria e al meccanismo di gating. Il motivo era che l'importanza di ciascun elemento in SBR era sicuramente diversa, ed esisteva la necessità di una memoria associativa tra gli elementi. Si poteva osservare che GSLA rappresentava una componente fondamentale del modello proposto in questo articolo.
Impatto di diversi metodi di aggregazione
Per valutare l'impatto di diversi metodi di aggregazione delle informazioni sulle prestazioni del modello GSLA4Rec, sono stati analizzati i seguenti tre metodi classici di aggregazione: 1) Average Pooling: esecuzione di un'operazione di media sui vettori generati dal SG e dal NGG; 2) Concatenazione di vettori: concatenazione dei vettori generati da SG e NGG; 3) Somma di vettori: somma dei vettori generati da SG e NGG. I risultati sono mostrati nella Tabella 5. GSLA4Rec con Vec-Sum ha ottenuto le migliori prestazioni su Diginetica, Tmall e Nowplaying. Al contrario, Mean-pooling ha prodotto risultati scadenti su tutti i dataset. Le prestazioni inferiori dell'aggregazione media e dell'aggregazione per concatenazione potrebbero derivare da un overfitting causato da un eccesso di parametri, il che ha compromesso le prestazioni complessive del modello.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Misure | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Mean-Pooling | 45,26 | 15,63 | 38,84 | 16,3 | 23,56 | 7,55 |
| Vec-Concating | 51,77 | 17,24 | 39,83 | 18,24 | 24,06 | 8,88 |
| Vec-Sum | 56,47 | 19,98 | 43,6 | 19,96 | 27,1 | 9,32 |
Tabella 5: Effetti di diversi metodi di aggregazione. La tabella confronta gli effetti del pooling medio, della concatenazione di vettori e della somma di vettori sulle prestazioni di GSLA4Rec nei dataset Diginetica, Tmall e Nowplaying utilizzando P@20 e MRR@20.
Analisi delle impostazioni degli iperparametri
Effetti di diverse dimensioni degli slot di memoria
Gli slot di memoria conservavano informazioni provenienti da passi temporali precedenti, elemento particolarmente importante per compiti con dipendenze temporali. Questa sezione ha esaminato l'impatto delle dimensioni degli slot di memoria m = [0, 1, 2, 3, 4, 5] sulle prestazioni di SBR. I risultati sperimentali, mostrati nella Tabella 6, hanno indicato che quando le dimensioni degli slot di memoria m erano impostate a 3, le metriche P@20 e MRR@20 raggiungevano prestazioni ottimali su tutti e tre i dataset. Ciò suggerisce che dimensioni moderate degli slot di memoria migliorassero efficacemente l'accuratezza delle raccomandazioni e la qualità del posizionamento del modello; dimensioni più ridotte risultavano insufficienti nel memorizzare informazioni storiche adeguate e si concentravano maggiormente sugli interessi a breve termine degli utenti, mentre all'aumentare delle dimensioni degli slot di memoria a 4 o più, il modello accumulava informazioni storiche eccessive, portandolo a dipendere troppo dagli interessi passati trascurando informazioni in ingresso attuali più rilevanti, con conseguente peggioramento delle prestazioni di raccomandazione.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Misure | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53,40 | 17,60 | 38,05 | 15,65 | 22,55 | 7,40 |
| GSLA4Rec-m1 | 55,43 | 18,92 | 41,55 | 17,12 | 25,60 | 8,43 |
| GSLA4Rec-m2 | 56,02 | 19,35 | 42,90 | 18,25 | 26,62 | 8,95 |
| GSLA4Rec-m3 | 56,47 | 19,98 | 43,60 | 19,96 | 27,10 | 9,32 |
| GSLA4Rec-m4 | 53,96 | 19,25 | 43,06 | 19,09 | 26,34 | 8,35 |
| GSLA4Rec-m5 | 52,18 | 18,03 | 42,12 | 17,56 | 24,86 | 8,85 |
Tabella 6: Effetti di diverse dimensioni degli slot di memoria. La tabella riporta le prestazioni di GSLA4Rec con diverse configurazioni di slot di memoria (m0–m5) sui dataset Diginetica, Tmall e Nowplaying utilizzando P@20 e MRR@20.
Effetti di diversi rapporti di dropout
Per prevenire l'overfitting, è stata introdotta la regolarizzazione con dropout. Prima di sommare il vettore degli elementi a livello di sessione e il vettore globale degli elementi vicini, le uscite dei neuroni sono state eliminate casualmente nel vettore globale degli elementi vicini hingg,(k) per migliorare la robustezza e la capacità di generalizzazione del modello GSLA4Rec.
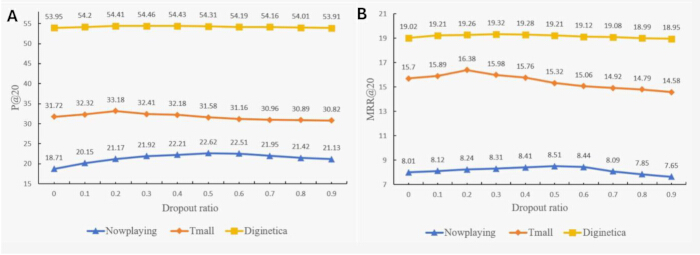
Figura 5: Prestazioni di GSLA4Rec con diversi rapporti di dropout. (A) P@20 e (B) MRR@20 di GSLA4Rec con diversi rapporti di dropout sui dataset Nowplaying, Tmall e Diginetica. Le prestazioni inizialmente sono aumentate e successivamente diminuite all’aumentare del rapporto di dropout, dimostrando la robustezza e la capacità di generalizzazione del modello. GSLA4Rec, reti neurali grafiche con attenzione lineare a slot con gate per la raccomandazione basata su sessione (SBR). Questa figura è stata realizzata autonomamente utilizzando OriginPro con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright; pertanto, non è richiesta alcuna licenza aggiuntiva per copyright di terze parti. Il copyright della figura appartiene agli autori e sarà conforme alle regole editoriali della rivista in caso di accettazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Figura 5A–B mostrava l'impatto di diversi rapporti di dropout nell'Equazione (16) sulle prestazioni del modello. I risultati sperimentali hanno indicato che il modello ha prestazioni scadenti quando il rapporto di dropout è basso; tuttavia, all'aumentare del rapporto di dropout, le prestazioni del modello sono gradualmente migliorate fino a raggiungere un livello ottimale. In particolare, il rapporto di dropout ottimale era 0,3 nel dataset Diginetica, 0,2 nel dataset Tmall e 0,5 nel dataset Nowplaying. Quando il rapporto di dropout superava questi valori ottimali, le prestazioni del modello iniziavano a diminuire, principalmente perché un'eccessiva disattivazione dei neuroni impediva al modello di apprendere efficacemente caratteristiche importanti dai dati della sessione.
Effetti delle diverse dimensioni dell'embedding
Per ridurre al minimo il carico computazionale il più possibile mantenendo al contempo prestazioni ottimali del modello, è stato analizzato l'impatto di diverse dimensioni dell'embedding d sulle prestazioni del modello GSLA4Rec. Come mostrato in Figura 6A–B, su tre dataset pubblici—Diginetica, Tmall e Nowplaying—il modello GSLA4Rec ha ottenuto scarse prestazioni quando la dimensione dell'embedding d era compresa tra 10 e 40; tuttavia, le prestazioni del modello sono aumentate rapidamente all'aumentare di d, tendendo a stabilizzarsi quando d era compresa tra 80 e 120. Successivamente, le prestazioni sono effettivamente diminuite all'ulteriore aumento di d, probabilmente a causa di un overfitting causato da una dimensione eccessiva dell'embedding. Pertanto, la dimensione del vettore di embedding degli elementi è stata infine impostata a 100.
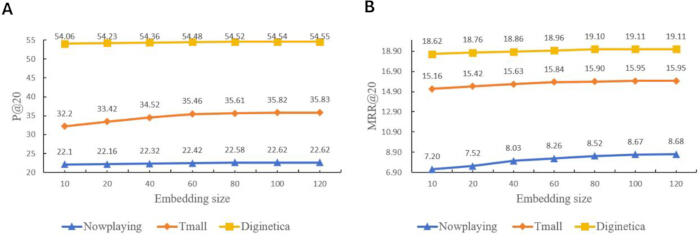
Figura 6: Prestazioni di GSLA4Rec con diverse dimensioni degli embedding. (A) P@20 e (B) MRR@20 di GSLA4Rec con diverse dimensioni degli embedding sui dataset Nowplaying, Tmall e Diginetica. Le prestazioni del modello sono aumentate progressivamente all’aumentare della dimensione dell’embedding e alla fine hanno raggiunto un plateau. GSLA4Rec, reti neurali grafiche con attenzione lineare a slot con porte per la raccomandazione basata su sessione (SBR). La figura è stata realizzata autonomamente utilizzando OriginPro con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright; pertanto, non è richiesta alcuna licenza aggiuntiva per copyright di terze parti. Il copyright della figura appartiene agli autori e sarà conforme alle regole editoriali della rivista in caso di accettazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Effetti di diverse durate delle sessioni
È noto che la durata di ciascuna sessione varia tra i tre dataset reali di SBR (Diginetica, Tmall e Nowplaying). Per verificare la robustezza del modello GSLA4Rec rispetto ai modelli di riferimento in funzione della lunghezza delle sessioni, tutte le sessioni di Diginetica e Tmall sono state suddivise in tre gruppi: gruppo breve (S), gruppo medio (M) e gruppo lungo (L), corrispondenti rispettivamente a sessioni da 1 a 6, da 7 a 12 e superiori a 12. È stato adottato MRR@20 per valutare le prestazioni dei metodi anziché P@20, poiché l'MRR riflette meglio la qualità del posizionamento dei risultati corretti. Figura 7A–B ha mostrato che il modello GSLA4Rec supera il modello di riferimento basato su sequenze NARM, il modello di riferimento basato su GNN SR-GNN, il modello di riferimento basato su GNN con apprendimento contrastivo S2-DHCN e il modello di riferimento spazio-temporale RESTC, in presenza di sessioni di diverse lunghezze. Nel contempo, si è osservato anche che le prestazioni di tutti i metodi diminuiscono all'aumentare della lunghezza della sequenza, poiché le transizioni tra elementi a lungo raggio rendono più difficile catturare le preferenze degli utenti; tuttavia, il modello proposto GSLA4Rec presenta la velocità di decremento più lenta rispetto ai modelli di riferimento, in quanto il meccanismo a slot con gate permette di filtrare gli elementi irrilevanti. Le prestazioni di GSLA4Rec hanno superato quelle del modello NARM rispettivamente di 6,3 e 8,85 nei gruppi lunghi di Diginetica e Tmall.
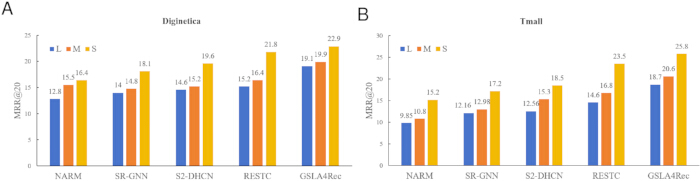
Figura 7: Prestazioni di GSLA4Rec in funzione di diverse lunghezze delle sessioni. Prestazioni di GSLA4Rec e dei modelli di riferimento in diversi gruppi di lunghezza delle sessioni sui dataset (A) Diginetica e (B) Tmall, valutate utilizzando MRR@20. I gruppi di lunghezza delle sessioni sono indicati come L, M e S. GSLA4Rec, reti neurali grafiche con attenzione lineare a slot con porte per la raccomandazione basata su sessione (SBR). Questa figura è stata realizzata autonomamente utilizzando OriginPro con elementi completamente personalizzati. Non sono state utilizzate risorse grafiche esterne protette da copyright; pertanto, non è richiesta alcuna licenza aggiuntiva di copyright da terzi. Il copyright della figura appartiene agli autori e sarà conforme alle norme editoriali della rivista in caso di accettazione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Conclusione
Questo articolo propone una rete globale di attenzione lineare con slot controllati dal contesto globale per SBR. Combinando SG e NGG e introducendo un meccanismo di attenzione lineare con slot controllati, questo metodo consente di concentrarsi sugli elementi chiave della sequenza della sessione, di catturare dipendenze a lungo e a breve termine, di ridurre efficacemente il rumore e di diminuire la complessità computazionale. I risultati sperimentali confermano che questo metodo mostra un'elevata accuratezza e efficienza raccomandativa su tre dataset pubblici, distinguendosi in particolare nei compiti di modellazione delle dipendenze a lungo termine.
DISPONIBILITÀ DEI DATI:
Tre dataset pubblici comuni (Diginetica, Tmall e Nowplaying, i cui URL sono disponibili nella Tabella dei Materiali) che supportano i risultati di questo studio sono liberamente accessibili su Internet. Allo stesso tempo, tre dataset pubblici ampiamente utilizzati e il codice sorgente di questo lavoro sono stati inviati come Cartella Supplementare: GSLA4Rec.zip. Cliccare qui per scaricare il file.
Discussione
Compared with baselines, the GSLA4Rec model achieves dual improvements in performance and efficiency for three core reasons. First, applying gating mechanisms to NGG alleviates data sparsity and filters noise effectively. Second, the memory slots mechanism balances storage capacity and efficiency via hyperparameter m adjustment. Third, the linear attention mechanism computes item correlations at an O(N) complexity, far lower than the O(N2)61. The GSLA4Rec model overly relies on users' interaction sequences and ignores the multimodal properties of items48. Meanwhile, the NGG construction uses a fixed Jaccard threshold without dynamic adjustment function, and the memory slots m cannot achieve adaptive adjustability65.
The GSLA4Rec model, which builds SG&NGG and adopts gated-slot linear attention, especially fits anonymous session recommendation39 across e-commerce and online streaming platforms. In e-commerce platforms, this model recommends matching products to users by capturing their browsing, clicking, or adding behaviors to their shopping cart, without relying on user characteristic attributes. The datasets Diginetica and Tmall used in this paper are e-commerce recommendation datasets. For short-video and music streaming platforms, this method analyzes users' playback sequences to infer their implicit preferences, updates content summaries to retain users, and extends viewing time. The dataset Nowplaying used in this paper is the music recommendation dataset.
There are alternative solutions that can replace the gated slot linear attention architecture. The emerging Mamba65 based state space model, as an alternative, has the characteristics of selective state storage space and linear computational complexity, balancing linear complexity and long sequence fitting ability, and combined with the LLM55 enhancement framework, it extracts the users' implicit intent from the original interaction log, thereby achieving good recommendation performance and efficiency. Future work can optimize GSLA4Rec from multiple perspectives: building dynamic NGG to replace fixed Jaccard filtering, implementing variable memory slots to automatically match sessions of different lengths, and incorporating user multimodal information to improve recommendation accuracy. In addition, with the help of LLM-augmented models55, users' implicit intentions can be mined from interaction sequences, and noisy conversation data can be filtered more accurately72.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari concorrenti noti o relazioni personali che potrebbero aver influenzato il lavoro descritto in questo articolo.
Ringraziamenti
L'autore ringrazia i revisori per i commenti e i suggerimenti costruttivi forniti durante il processo di revisione, e il Professor Jiang Nan, il mio supervisore di dottorato, per la sua attenta guida. Questo studio è stato in parte sostenuto dal National Science Foundation of China con il Grant No.6217072713 e il Grant No.62061019, e in parte da temi di ricerca aperti del centro di ricerca ingegneristica del sistema di sensori senza pilota e della tecnologia di intelligenza artificiale della provincia di Jiangxi nel 2025, e in parte dal Jiangxi Provincial Key Laboratory of Advanced Electronic Materials and Devices (No.2024SSY03012).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | NONE | CUDA 11.3 è una versione della piattaforma e modello di programmazione per il calcolo parallelo rilasciata da NVIDIA nel 2021, progettata per migliorare le prestazioni e la flessibilità di sviluppo delle applicazioni accelerate da GPU. |
| Diginetica | Diginetica | NONE | Diginetica è il dataset ufficiale della competizione CIKM (International Information Retrieval Conference) Cup del 2016, utilizzato nella competizione algoritmica CIKM per risolvere il problema del recupero personalizzato di prodotti nell'e-commerce in un contesto di ricerca. Attualmente è diventato il dataset di riferimento più diffuso nel campo della Session based Recommendation (SBR). |
| Nowplaying | Zenodo | NONE | È un dataset su larga scala relativo al comportamento di ascolto musicale, costruito sulla base dell'analisi dei tweet contenenti il tag "#nowplaying", utilizzato principalmente per la ricerca sulla raccomandazione musicale contestuale, sulla raccomandazione basata sul contesto e sull'analisi delle correlazioni di sentiment. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | NONE | OriginPro è un software commerciale professionale per la rappresentazione scientifica e l'analisi dati sviluppato da OriginLab Corporation, comunemente utilizzato per la creazione di grafici di qualità pubblicabile, statistiche dei dati, fitting di curve, elaborazione di segnali, ecc. In questo articolo, OriginPro viene utilizzato per generare grafici comparativi sperimentali, grafici a linee e istogrammi. |
| PyTorch 1.11.0 | PyTorch Foundation | NONE | PyTorch è un framework open source per il machine learning e il deep learning, rilasciato da Facebook nel 2016. Implementa principalmente la differenziazione automatica e introduce grafi di calcolo dinamici, rendendo la costruzione dei modelli più flessibile. |
| TITAN V GPU | NVIDIA | NONE | NVIDIA TITAN V è una scheda grafica di fascia alta lanciata da NVIDIA alla fine del 2017, rivolta principalmente ai settori del calcolo ad alte prestazioni e dell'intelligenza artificiale. |
| Tmall | Tmall | NONE | Proveniente dalla competizione di raccomandazione Alibaba Tmall del 2015 organizzata da IJCAI, Alibaba Tianchi ha reso pubblici log reali desensibilizzati di Tmall. È uno dei tre dataset standard nel campo della SBR (Diginetica, Yoocoose, Tmall) e l'insieme preferito per la valutazione negli scenari di e-commerce cinesi. |
| visio 2021 | Microsoft | NONE | Visio è un software di disegno vettoriale sviluppato da Microsoft, utilizzato per creare diagrammi di struttura di modelli, diagrammi di flusso, diagrammi di architetture, topologie di rete in articoli scientifici, e per produrre illustrazioni vettoriali per pubblicazioni |
Riferimenti
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.