Questo protocollo descrive la generazione di un dataset basato sulle condizioni meteorologiche e la valutazione sistematica di modelli di machine learning, deep learning e ibridi per la previsione dell'attenuazione atmosferica nelle comunicazioni ottiche in spazio libero in diverse condizioni ambientali irachene, inclusi temporali di sabbia, nebbia, pioggia e neve.
Articolo di ricerca
Il machine learning supera il deep learning nella previsione dell'attenuazione atmosferica nelle comunicazioni ottiche in spazio libero in condizioni meteorologiche irachene
In questo articolo
Sommario
Abstract
I sistemi di comunicazione ottica in spazio libero offrono elevate larghezze di banda, maggiore sicurezza e funzionamento senza licenza, ma sono fortemente influenzati da un degrado delle prestazioni dovuto all'attenuazione atmosferica causata da scattering e assorbimento. La previsione accurata dell'attenuazione è ancora più importante in Iraq, dove l'ambiente è caldo, polveroso, nebbioso e piovoso in modo casuale. L'obiettivo di questo studio è valutare le prestazioni di tecniche di apprendimento automatico, apprendimento profondo e modelli ibridi per la previsione dell'attenuazione atmosferica nei sistemi di comunicazione ottica in spazio libero in diverse condizioni meteorologiche irachene. È stato creato un dataset sintetico di 1500 campioni utilizzando consolidati modelli fisici di propagazione per cinque regimi meteorologici: cielo sereno, nebbia, pioggia, tempeste di sabbia e neve. Sono stati valutati sistematicamente quindici modelli predittivi, costituiti da sei tecniche di machine learning (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Regressione Lineare e K-Nearest Neighbors), sei architetture di deep learning (Perceptron Multistrato, Rete Neurale Profonda, Long Short-Term Memory [LSTM], Rete Neurale Convoluzionale Unidimensionale [CNN], CNN–LSTM e Rete basata sull'Attenzione) e tre approcci ibridi. I risultati hanno mostrato che RF ha ottenuto le migliori prestazioni (R2 = 0.9654, errore quadratico medio = 1.324 dB/km) rispetto agli approcci di deep learning (miglior R2 = 0.7766) e ai metodi ibridi (miglior R2 = 0.9571). L'analisi dell'importanza delle caratteristiche, effettuata tramite Shapley Additive exPlanations, ha rivelato che la concentrazione di polvere (67,3%) e la visibilità (21,2%) sono i fattori più influenti. Sebbene RF abbia mostrato tempi di addestramento e inferenza notevolmente più rapidi, test statistici non hanno rilevato differenze significative tra RF e il miglior approccio ibrido (p = 0,083). Si è dimostrato che le tecniche convenzionali di machine learning sono altamente efficienti per la stima dell'attenuazione atmosferica nei sistemi di comunicazione FSO in condizioni ambientali avverse, in accordo con consolidate teorie fisiche di propagazione. Tuttavia, sottolineiamo che queste conclusioni si basano su dati sintetici e devono essere validate da misurazioni atmosferiche reali prima di poter essere utilizzate in sistemi FSO operativi.
Introduzione
Le reti di comunicazione ottica in spazio libero (FSO) offrono generalmente una capacità maggiore e una sicurezza migliore, ma l'attenuazione atmosferica dovuta a scattering e assorbimento rappresenta un fattore limitante principale per la distanza di comunicazione1. In questo lavoro forniamo un'analisi dettagliata di approcci basati sull'apprendimento automatico, sull'apprendimento profondo e su metodi ibridi2 per valutare l'attenuazione del segnale FSO nell'ambiente complesso dell'Iraq, caratterizzato da alte temperature, tempeste di sabbia e precipitazioni irregolari.
I sistemi di comunicazione FSO si sono affermati come una delle soluzioni promettenti per la connettività wireless ad alta larghezza di banda3 con velocità di trasmissione superiori a 100 Gbps su distanze che vanno da alcune centinaia di metri a pochi chilometri4. I collegamenti FSO operano nello spettro visibile e infrarosso, a differenza dei sistemi convenzionali a radiofrequenza, offrendo vantaggi come l'assenza di necessità di licenze, immunità dalle interferenze elettromagnetiche, maggiore sicurezza grazie alla ridotta divergenza del fascio e elevata capacità di larghezza di banda5. Queste caratteristiche rendono la tecnologia FSO particolarmente attraente per applicazioni di backhaul, collegamenti tra edifici, reti per il recupero dopo disastri e connettività dell'ultimo miglio, dove il cablaggio in fibra risulta proibitivamente costoso6. Tuttavia, la comunicazione mediante scattering, deflessione del fascio e assorbimento7,8 dipende fortemente dalle condizioni ambientali in termini di disponibilità e prestazioni. Questa problematica rappresenta uno dei principali limiti dei sistemi di comunicazione ottica in spazio libero. Le condizioni meteorologiche provocano ampie variazioni nei livelli di attenuazione (dB/km). In condizioni di cielo sereno, l'attenuazione può essere inferiore a 0,5 dB/km, mentre in caso di nebbia intensa può raggiungere valori ≥50 dB/km a 1550 nm (utilizzando il modello di nebbia di Kim, che prevede valori di attenuazione fino a 50 dB/km per una visibilità inferiore a 50 m a 1550 nm)9,10 e forti piogge possono causare attenuazioni fino a 20–30 dB/km a seconda dell'intensità della pioggia (previsione del modello di Carbonneau)11. Pertanto, è necessaria una previsione accurata dell'attenuazione per una progettazione affidabile dei collegamenti, la pianificazione delle reti e strategie di trasmissione adattive. I metodi convenzionali si basano su modelli fisici di propagazione, come il modello di Kim per la nebbia12, il modello di Carbonneau per la pioggia13 e la teoria dello scattering di Mie per le particelle aerosol14. Tuttavia, sebbene questi modelli forniscano una solida base teorica, spesso richiedono parametri atmosferici precisi che in pratica non sono sempre disponibili e raramente considerano le complesse interazioni tra fenomeni meteorologici multipli e contemporanei15.
L'elevata variabilità ambientale in Iraq presenta notevoli sfide per il dispiegamento di sistemi di comunicazione ottica in spazio libero. Le condizioni di trasmissione sono ulteriormente complicate dalla scarsa piovosità e da episodi isolati di nebbia, mentre le temperature invernali possono scendere sotto lo zero e quelle estive superare i 50 °C16. In spettri comunemente utilizzati, come 1550 nm nelle lunghezze d'onda normali, le tempeste di sabbia, note localmente come "al-haboob", possono ridurre la visibilità a meno di 100 metri, causando valori di attenuazione superiori a 20 dB/km17. Per un efficace impiego dei sistemi FSO in Iraq e in altri paesi del Medio Oriente, è necessario sviluppare modelli predittivi affidabili in grado di stimare con precisione le prestazioni del sistema in queste diverse condizioni ambientali18.
I recenti sviluppi nell'apprendimento automatico offrono alternative valide alle tradizionali tecniche di modellazione basate sulla fisica. La capacità delle tecniche di apprendimento automatico di apprendere direttamente complesse correlazioni non lineari tra attenuazione e fattori atmosferici consente di rilevare interazioni minime che modelli analitici tradizionali potrebbero trascurare19. In diverse attività di previsione climatologica, le strategie basate su Random Forest (RF) e su boosting del gradiente hanno dimostrato prestazioni elevate20. Analogamente, le tecniche di apprendimento profondo hanno ottenuto notevoli successi nell'elaborazione del linguaggio naturale, nella visione artificiale e nella previsione di serie temporali21. Tuttavia, questi approcci sono poco esplorati per la previsione dell'attenuazione nei sistemi FSO, in particolare con dataset limitati e condizioni meteorologiche altamente variabili22. Per colmare questa lacuna, questo studio presenta un'analisi approfondita di approcci basati su apprendimento automatico, apprendimento profondo e metodi ibridi per la previsione dell'attenuazione del segnale FSO nelle condizioni atmosferiche irachene. Ciò viene realizzato costruendo un dataset sintetico ben progettato, basato su consolidati modelli fisici di propagazione23. Si ipotizza che, per dataset ambientali tabulari di dimensioni moderate e con poche variabili predittive dominanti, le prestazioni predittive dei metodi ensemble basati su alberi supereranno quelle delle architetture complesse di apprendimento profondo. Gli obiettivi principali sono: (1) stabilire una metodologia di riferimento per il confronto tra metodi di previsione in un ambiente di simulazione controllato, (2) identificare le migliori strategie algoritmiche per la previsione dell'attenuazione atmosferica e (3) valutare l'importanza delle caratteristiche e l'interpretabilità del modello per ottenere informazioni sui fattori ambientali che maggiormente influenzano l'attenuazione. In questo studio vengono utilizzati dati sintetici, ma si gettano le basi per una successiva validazione con misurazioni sperimentali nel mondo reale, prevista per lavori futuri. Inoltre, vengono integrati analisi sull'importanza delle caratteristiche e sull'interpretabilità del modello al fine di determinare i fattori ambientali più influenti sull'attenuazione.
Protocollo
Questo studio non ha coinvolto partecipanti umani né animali vertebrati, né il prelievo di tessuti. Tutti i dati utilizzati per questa ricerca sono stati generati sinteticamente mediante modelli fisici di propagazione e parametri meteorologici disponibili pubblicamente. Pertanto, non è stata necessaria alcuna approvazione etica da parte di un Comitato per la Revisione Istituzionale (IRB) o di un Comitato Istituzionale per la Cura e l'Uso degli Animali (IACUC).
Generazione del Dataset in Base alla Teoria Fisica della Propagazione. Il dataset è stato costruito per simulare le condizioni atmosferiche orarie in un sistema di comunicazione ottica in spazio libero per un intero anno solare (2024), in condizioni atmosferiche irachene. È stata creata una base di dati sintetica contenente 1.500 campioni per ora.
Innanzitutto, le condizioni meteorologiche sono state assegnate casualmente in base alle tendenze regionali: cielo sereno (54,3%), polvere (24,9%), nebbia (10,5%), pioggia (7,4%) e neve (2,8%). In secondo luogo, è stato applicato a ciascun campione il corrispondente modello fisico di attenuazione in base alla condizione meteorologica, ovvero la legge di Beer-Lambert per il cielo sereno, il modello Kim per la nebbia, la teoria di Carbonneau per la pioggia e la teoria dello scattering di Mie per le tempeste di sabbia. In terzo luogo, i parametri del sistema FSO sono stati impostati come segue: potenza trasmessa di 20 dBm, lunghezza d'onda di 1550 nm, distanza di trasmissione di 3 km, apertura di trasmissione di 2,5 cm e apertura ricevente di 20 cm. In quarto luogo, l'attenuazione è stata calcolata in dB/km per ogni campione. Infine, l'intero set di dati è stato suddiviso casualmente in 1.200 campioni di addestramento (80%) e 300 campioni di test (20%). Le condizioni simulate includono elevate concentrazioni di polvere associate a tempeste di sabbia, temporali e variazioni di temperatura comprese tra −4,89°C e 47,99°C. Le condizioni meteorologiche e le distribuzioni dei parametri sono state selezionate sulla base dei dati climatici iracheni registrati nel periodo 2020–2024. I cinque regimi meteorologici (cielo sereno, nebbia, pioggia, tempeste di sabbia e neve) sono stati scelti perché coprono l'intero spettro delle condizioni atmosferiche che influenzano l'attenuazione FSO in Iraq, con le tempeste di sabbia particolarmente diffuse nel Medio Oriente. I dati meteorologici storici raccolti nelle diverse regioni dell'Iraq sono stati utilizzati per creare la distribuzione di probabilità per ciascuna condizione meteorologica. La distribuzione risultante è la seguente: 54,3% di cielo sereno (lo stato predominante), 24,9% di polvere (a rappresentare il problema delle tempeste di sabbia in Iraq), 10,5% di nebbia (frequente negli inverni del nord dell'Iraq), 7,4% di pioggia (basse quantità di precipitazioni tipiche dell'Iraq) e 2,8% di neve (talvolta presente nelle zone montuose settentrionali). I parametri meteorologici rilevanti sono stati modellati utilizzando distribuzioni di probabilità per ciascuna condizione meteorologica come segue: la temperatura è stata modellata mediante una distribuzione normale (media 28,55±11,18°C) compresa tra −4,89°C e 47,99°C, in base agli estremi stagionali iracheni; l'umidità è stata modellata mediante una distribuzione uniforme (media 42,01±25,56%) da 0% a 100%; la visibilità è stata modellata mediante una distribuzione log-normale compresa tra 0,05 km e 29,99 km (media 13,10±10,91 km) per tenere conto degli eventi frequenti di bassa visibilità durante le tempeste di sabbia; la concentrazione di polvere è stata modellata mediante una distribuzione esponenziale compresa tra 0 e 4,96 mg/m3 (media 0,74±1,30 mg/m3), con probabilità più elevate per basse concentrazioni e code lunghe per eventi estremi di polvere.
Il sistema di comunicazione è stato progettato con una potenza di trasmissione di 20 dBm, una lunghezza d'onda di 1550 nm, una distanza di trasmissione fino a 3 km, un'apertura di trasmissione di 2,5 cm e un'apertura ricevente di 20 cm per compensare la perdita dovuta alla divergenza. I parametri del sistema FSO sono stati suddivisi in due gruppi: parametri fissi, che non sono cambiati per tutti i campioni, e parametri variabili, modificati durante la generazione del set di dati. Per tutti e 1.500 i campioni, i seguenti parametri sono stati mantenuti costanti: potenza di trasmissione (20 dBm), lunghezza d'onda operativa (1550 nm), apertura di trasmissione (diametro 2,5 cm, efficienza 0,7) e apertura ricevente (diametro 20 cm, efficienza 0,7). Questi parametri sono stati mantenuti fissi poiché rappresentano le specifiche fisiche dell'hardware del sistema FSO e non variano in base alle condizioni atmosferiche. Il set di dati è stato creato con 1.500 campioni, variando i seguenti parametri: temperatura (da −4,89°C a 47,99°C), umidità (da 0% a 100%), visibilità (da 0,05 km a 29,99 km), concentrazione di polvere (da 0 a 4,96 mg/m3) e condizione meteorologica (cielo sereno, nebbia, pioggia, polvere, neve). Questi parametri sono stati modificati in base a distribuzioni di probabilità ricavate dai dati climatici dell'Iraq registrati negli anni 2020–2024. Per ogni campione, il valore di attenuazione (dB/km) è stato calcolato utilizzando il corrispondente modello fisico di attenuazione, in base alla specifica combinazione di condizioni atmosferiche e parametri variabili.
L'attenuazione fisica è stata modellata utilizzando il modello Carbonneau per la pioggia, la legge di Beer-Lambert per condizioni di cielo sereno, la teoria dello scattering di Mie per la polvere e il modello Kim per la nebbia24. La legge di Beer-Lambert si applica in condizioni di cielo sereno, in cui l'attenuazione è dominata dalla diffusione molecolare e dall'assorbimento, che decrescono esponenzialmente con la distanza25. Il coefficiente di estinzione α a 1550 nm è dovuto allo scattering di Rayleigh causato dalle molecole d'aria e all'assorbimento da parte dei gas atmosferici26. Il modello Kim è un modello specifico per la nebbia che correla l'attenuazione alla visibilità attraverso coefficienti empirici derivati dalle distribuzioni dimensionali delle goccioline di nebbia. L'esponente dipendente dalla lunghezza d'onda q tiene conto dello scattering di Mie27. Il parametro principale del modello Carbonneau è l'intensità di pioggia R, poiché l'attenuazione causata dalla pioggia dipende dalle dimensioni e dalla densità delle gocce d'acqua, e i coefficienti sono stati derivati empiricamente a 1550 nm e calibrati specificamente per lunghezze d'onda ottiche28. La teoria dello scattering di Mie è applicabile alle condizioni di polvere, poiché le dimensioni delle particelle di polvere (raggio compreso tra 0,1 e 100 μm) sono comparabili alla lunghezza d'onda (1550 nm), e l'indice di rifrazione complesso m = 1,55–0,005i per la polvere del Medio Oriente include sia scattering che assorbimento29. I seguenti modelli fisici di attenuazione sono stati implementati con le rispettive equazioni e impostazioni dei parametri.
Per condizioni di cielo sereno, è stata utilizzata la legge di Beer-Lambert:
Aclear = 10×log₁₀(e(α×d)) (1)
dove α è il coefficiente di estinzione (variato utilizzando una distribuzione normale centrata a 0,02 dB/km con una variazione di ±0,005 dB/km a 1550 nm in condizioni di cielo sereno) e d è la distanza di trasmissione (fissata a 3 km). Per condizioni di nebbia, è stato implementato il modello di Kim utilizzando l'equazione:
Afog = 10×ln(10)/V×(λ/550)−q (2)
dove V è la visibilità in chilometri (variabile da 0,05 km a 10 km), λ è la lunghezza d'onda in nanometri (fissata a 1550 nm) e q è il coefficiente di distribuzione dimensionale delle particelle calcolato come: q=1,6 per V>50 km, q=1,3 per 6<V<50 km, q=0,585×V(1/3) per 1 <V<6 km, q=0 per 0,5<V<1 km e q=0,5 per V<0,5 km. Per le condizioni di pioggia, è stato utilizzato il modello di Carbonneau:
Arain=0.023×R0.93 (3)
dove R è la velocità di precipitazione in mm/h (variata tra 0,25 e 50 mm/h in base ai dati pluviometrici dell'Iraq). La relazione di efficienza di estinzione è stata utilizzata per le condizioni di tempesta di polvere mediante la diffusione di Mie:
Adust=10×log₁₀(e(τ×L)) (4)
dove τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r è il raggio della particella (0,1–100 μm in base alla composizione della polvere irachena), Qext è l'efficienza di estinzione calcolata utilizzando la teoria di Mie, λ=1550 nm, m=1,55–0,005i è l'indice di rifrazione complesso per la polvere del Medio Oriente e N(r) è la distribuzione dimensionale delle particelle modellata mediante una distribuzione log-normale con raggio medio geometrico di 2,5 μm e deviazione standard di 2,0. Il modello di attenuazione è stato implementato per le condizioni di neve come segue:
Asnow = 0.1×S0.75 (5)
dove S è la velocità di nevicata in mm/h (0,5–15 mm/h). Questa equazione empirica è stata scelta sulla base dei lavori presenti in letteratura30, in cui sono stati sviluppati modelli di attenuazione per la propagazione ottica attraverso la neve utilizzando la teoria della diffusione di Mie applicata alle distribuzioni dimensionali dei fiocchi di neve. L'equazione è valida per tassi di caduta della neve compresi tra 0,5 e 15 mm/h e assume condizioni di neve secca con diametri tipici dei fiocchi compresi tra 1 e 10 mm. Il coefficiente 0,1 e l'esponente 0,75 sono stati ottenuti mediante fitting di curve ai calcoli di diffusione di Mie30 per la neve a 1550 nm. Il modello non tiene conto della neve umida o delle precipitazioni miste, che possono presentare proprietà di attenuazione variabili, anche se fornisce una stima ragionevole per la neve secca. Poiché l'approccio è computazionalmente efficiente, spesso citato nelle pubblicazioni sulle comunicazioni ottiche in spazio libero (FSO) e adatto alle condizioni nevose previste nel nord dell'Iraq (regione del Kurdistan nei mesi di gennaio e febbraio), è stato scelto per questa indagine. Utilizzando Numpy per i calcoli numerici, tutti i modelli sono stati implementati in Python 3.9. Il modello corrispondente è stato applicato alle condizioni meteorologiche scelte casualmente e ai dati ambientali campionati per calcolare il valore di attenuazione per ogni campione. La distribuzione meteorologica ottenuta comprendeva 814 condizioni di cielo sereno (54,27%), 375 eventi di polvere (25,00%), 157 eventi di nebbia (10,47%), 111 eventi di pioggia (7,40%) e 43 eventi di neve (2,87%).
L'esame delle informazioni meteorologiche storiche raccolte da stazioni meteorologiche irachene in diverse regioni (Baghdad, Basra, Mosul e Ramadi) tra il 2020 e il 2024 è stato utilizzato per determinare le proporzioni delle condizioni atmosferiche. I dati originali sono stati forniti dal Ministero dei Trasporti dell'Iraq e dall'Organizzazione Meteorologica e Sismologica dell'Iraq (IMOS). I dati includevano registrazioni meteorologiche giornaliere che riportavano le condizioni atmosferiche correnti per ciascun giorno. Tra le caratteristiche specifiche estratte da questi registri figuravano temperatura (minima, massima e media giornaliera), umidità relativa, visibilità, quantità di precipitazioni e occorrenze di tempeste di sabbia. Una parte dei dati IMOS è accessibile tramite il portale open data del governo iracheno (https://www.motrans.gov.iq/); tuttavia, i record specifici utilizzati in questo studio non sono archiviati pubblicamente in un unico repository centrale. Le informazioni climatiche utilizzate per calcolare le percentuali delle condizioni meteorologiche e dei valori dei parametri sono riassunte nella Tabella 1. I giorni con cielo sereno sono stati definiti come giorni senza precipitazioni, con visibilità superiore a 10 km e assenza di attività di polvere, rappresentando il 54,27% dei 1.825 giorni registrati. I giorni con tempesta di sabbia (inclusa tempesta di sabbia completa (visibilità < 1 km) e tempesta di sabbia parziale (visibilità tra 1 e 10 km))) hanno rappresentato il 19,45% del totale, mentre i giorni piovosi hanno costituito il 26,28%. < 1 km) e polvere sospesa (visibilità 1–5 km)) hanno rappresentato il 25,00% dei giorni, indicando l'elevata frequenza di eventi di tempesta di sabbia nel clima arido e semi-arido dell'Iraq. I giorni con visibilità inferiore a 1 km causata dalla sospensione di goccioline d'acqua (escludendo la riduzione della visibilità indotta dalla polvere) sono stati classificati come giorni di nebbia. La percentuale di giorni di nebbia è stata del 10,47% e tali giorni si sono verificati principalmente in inverno nelle regioni settentrionali dell'Iraq. Giorni di pioggia, giorni con precipitazioni misurabili >0,1 mm, erano del 7,40%, coerente con la bassa media delle precipitazioni annuali in Iraq, pari a 150–200 mm all'anno. I giorni con neve (giorni con accumulo di precipitazioni ghiacciate) costituivano il 2,87% dei giorni ed erano limitati alle aree montuose del nord (regione del Kurdistan) nei mesi di gennaio e febbraio. Queste proporzioni sono state successivamente utilizzate come pesi probabilistici per il campionamento casuale nella generazione del dataset. Pertanto, il dataset sintetico riflette la frequenza reale di ciascuna condizione meteorologica nell'ambiente iracheno.
Considerazioni sui bias nella generazione di dati sintetici
Per ridurre i possibili bias sono stati adottati diversi passaggi:
(1) Selezionare la distribuzione: Le proprietà statistiche dei dati climatici di origine sono state utilizzate per selezionare le distribuzioni di probabilità. La temperatura presentava una distribuzione normale con media e deviazione standard registrate dall'IMOS. L'umidità era distribuita uniformemente sull'intero intervallo osservato (0-100%). Si è ipotizzato che la visibilità seguisse una distribuzione log-normale, per tenere conto della frequente occorrenza di eventi di bassa visibilità durante le tempeste di sabbia. La concentrazione di polvere seguiva una distribuzione esponenziale, con probabilità più elevate a basse concentrazioni e code lunghe in corrispondenza di eventi estremi di polvere31. Questo risultato era coerente con la frequenza osservata di eventi di polvere in Iraq32.
(2) Proporzioni delle condizioni meteorologiche: l'analisi dei dati IMOS per il periodo 2020–2024, comprendente 1.825 osservazioni giornaliere in tutte e quattro le regioni, ha prodotto le seguenti proporzioni: 54,3% cielo sereno, 24,9% polvere, 10,5% nebbia, 7,4% pioggia e 2,8% neve. I giorni con cielo sereno sono stati definiti come giorni senza precipitazioni, con visibilità >10 km e in assenza di attività di polvere. I giorni con tempeste di sabbia includevano sia tempeste di sabbia complete (visibilità <1 km) sia polvere sospesa (visibilità 1–5 km). Un giorno di nebbia è stato definito come un giorno in cui la visibilità era inferiore a 1 km e la causa era la sospensione di goccioline d'acqua (e non polvere). I giorni di pioggia sono stati definiti come giorni con precipitazioni misurabili >0,1 mm. I giorni di neve sono stati definiti come giorni con precipitazioni ghiacciate accumulate33.
(3) Intervalli dei parametri: gli intervalli dei parametri si basavano sugli estremi osservati nei record IMOS: la temperatura variava da −4,89 °C (Mosul, inverno) a 47,99 °C (Basra, estate), la visibilità variava da 0,05 km (tempeste di sabbia severe) a 29,99 km (condizioni di cielo sereno) e la concentrazione di polvere variava da 0 a 4,96 mg/m3 (in base alla concentrazione massima di polvere osservata durante eventi severi di haboob)34.
(4) Assunzioni di indipendenza: Si è assunto che i parametri ambientali fossero campionati in modo indipendente, il che rappresenta una semplificazione delle condizioni reali in cui le variabili atmosferiche sono correlate (ad esempio, un'elevata concentrazione di polvere è spesso associata a scarsa visibilità). Al fine di fornire un ambiente di simulazione controllato per un confronto metodico dei modelli, è stata adottata questa assunzione di indipendenza 35. Le conseguenze di tali presupposti sono trattate nella Discussione.
(5) Divisione stratificata: La suddivisione tra training e test è stata effettuata in modo stratificato in base alla categoria di condizione meteorologica (cielo sereno, nebbia, pioggia, polvere, neve) per garantire che la proporzione di ciascuna condizione meteorologica nei set di addestramento e di verifica corrispondesse alla distribuzione originale del dataset. In questo modo, il set di test non risulta sbilanciato rispetto alle condizioni meteorologiche rare (in particolare la neve al 2,87%)36.
Riconoscimento della generazione deterministica della sequenza bersaglio
È importante sottolineare che la buona prestazione predittiva osservata qui potrebbe essere in parte dovuta al fatto che il modello apprende o approssima le equazioni fisiche deterministiche utilizzate per generare i valori target sintetici37. A differenza delle misurazioni sperimentali nel mondo reale, che contengono rumore di misura, errori strumentali e fenomeni fisici non modellati, il dataset sintetico fornisce una relazione pulita e priva di rumore tra le caratteristiche in ingresso e l'obiettivo di attenuazione. Questo perché i valori di attenuazione sono stati calcolati direttamente dai modelli fisici di propagazione (legge di Beer-Lambert, modello di Kim, modello di Carbonneau e teoria dello scattering di Mie) sulla base dei parametri in ingresso. Pertanto, le metriche quantitative di prestazione (R2, RMSE, MAE) rappresentano le prestazioni su dati sintetici derivati da equazioni e non devono essere interpretate come prestazioni attese su dati osservativi o sperimentali rumorosi. I risultati dovrebbero essere considerati principalmente come una valutazione comparativa delle metodologie di modellazione in un ambiente di simulazione controllato38.
Set completo di caratteristiche per l'addestramento del modello
Il set di dati di addestramento disponeva di 10 caratteristiche in ingresso per l'addestramento del modello:
1. Temperatura (°C)
2. Umidità (%)
3. Visibilità (km)
4. Concentrazione di polvere (mg/m3)
5. Tasso di precipitazione (mm/h)
6. Tasso di nevicata (mm/h)
7. Velocità del vento (m/s)
8. Pressione atmosferica (hPa)
9. Mese (numerico, 1–12)
10. Stagione (codificata in forma one-hot: primavera, estate, autunno, inverno)
Chiarimento importante: le condizioni meteorologiche (cielo sereno, nebbia, pioggia, polvere, neve) sono state utilizzate come variabile categorica per la stratificazione durante la suddivisione del dataset e non sono state incluse come caratteristiche di input per alcun modello. L'analisi SHAP include solo le 10 caratteristiche elencate sopra. La variabile stagione è stata codificata con il metodo one-hot (4 categorie: primavera, estate, autunno, inverno) e, per l'analisi SHAP, i contributi delle variabili stagionali codificate in questo modo sono stati sommati per ogni stagione al fine di produrre un singolo valore di contributo stagionale. Questo valore combinato rappresenta il contributo totale di tutte le variabili relative alla stagione alla previsione dell'attenuazione. Prima di creare la figura riassuntiva, sono state identificate le quattro colonne stagionali codificate con il metodo one-hot e i relativi valori SHAP sono stati sommati per ogni campione. Questo metodo garantisce che l'utilizzo della stagione da parte del modello come variabile categorica complessa sia coerente con l'analisi SHAP.
I principali fattori ambientali che hanno influenzato direttamente l'attenuazione ottica attraverso meccanismi fisici erano le caratteristiche 1–6. L'aggiunta delle caratteristiche 7 e 8 (velocità del vento e pressione) come fattori meteorologici supplementari potrebbe avere un impatto indiretto sull'attenuazione, influenzando la stabilità dell'aria e la dispersione degli aerosol. Per tenere conto delle variazioni stagionali delle condizioni atmosferiche, le caratteristiche 9–10 (mese e stagione) sono state incluse come descrittori temporali. Il valore di attenuazione (dB/km) è stato utilizzato come variabile obiettivo per tutti i modelli. Le statistiche chiave del dataset includevano la temperatura (28,55°C ± 11,18°C), l'umidità (42,01% ± 25,56%), la visibilità (13,10 ± 10,91 km; intervallo: 0,05–29,99 km), la concentrazione di polvere (0,74 ± 1,30 mg/m3; massimo: 4,96 mg/m3), l'attenuazione (4,80 ± 7,20 dB/km; intervallo: 0,09–50,93 dB/km), la distanza operativa (5,74 ± 1,97 km) e il rapporto segnale-rumore (64,88 ± 15,07 dB). La distanza operativa e il rapporto segnale-rumore sono stati calcolati a partire dai valori di attenuazione utilizzando le equazioni standard del bilancio del collegamento FSO.
Calcolo del campo operativo
L'intervallo operativo (in km) è stato calcolato utilizzando l'equazione del bilancio di collegamento:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
dove: Prx = potenza ricevuta (impostata alla sensibilità minima di −30 dBm); Ptx = potenza di trasmissione (fissa a 20 dBm); Gt = guadagno del trasmettitore (calcolato a partire dalle dimensioni dell'apertura); Gr = guadagno del ricevitore (calcolato a partire dalle dimensioni dell'apertura); λ = lunghezza d'onda (1550 nm); R = distanza in km; A = attenuazione atmosferica in dB/km (calcolata a partire dai modelli fisici).
Guadagni del trasmettitore e del ricevitore: Il guadagno del trasmettitore (Gt) è stato calcolato come: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. Il guadagno del ricevitore (Gr) è stato calcolato come: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. L'apertura di trasmissione aveva un diametro di 2,5 cm e un'efficienza pari a 0,7. L'apertura ricevente aveva un diametro di 20 cm e un'efficienza pari a 0,7. L'equazione è stata risolta in modo iterativo rispetto a R per determinare la massima distanza raggiungibile dal collegamento per ciascun valore di attenuazione.
Calcolo del rapporto segnale-rumore
Il rapporto segnale-rumore (SNR) in dB è stato calcolato utilizzando l'equazione:
SNR=Prx−10×log₁₀(kTB)−NF (7)
dove: Prx = potenza ricevuta in dBm (calcolata a partire dal bilancio del collegamento); k = 1,38×10⁻23 J/K (costante di Boltzmann); T = 290 K (temperatura del ricevitore); B = 109 Hz (larghezza di banda del ricevitore, 1 GHz); NF = 3 dB (fattore di rumore del ricevitore). Il livello del rumore è stato calcolato come:
10 × log10(kTB) ≈ −84 dBm (8)
Per ogni campione, dopo aver calcolato l'attenuazione A utilizzando il modello fisico appropriato, la distanza operativa è stata ricavata risolvendo il bilancio del collegamento per R, e il rapporto segnale-rumore (SNR) è stato calcolato a partire dalla potenza ricevuta risultante Prx a quella distanza.
Valori dell'Intervallo Operativo Specifici per le Condizioni Meteorologiche: L'intervallo operativo variava in base alle condizioni meteorologiche: cielo sereno (7,12 ± 1,85 km), nebbia (5,81 ± 1,92 km), neve (5,42 ± 1,56 km), pioggia (3,81 ± 0,98 km) e polvere (3,72 ± 1,08 km). Un margine di 3 dB non è stato applicato nei calcoli attuali; l'intervallo operativo rappresenta la portata massima teorica senza margine di sistema. L'intervallo operativo riportato (5,74 ± 1,97 km) è la media complessiva su tutte le condizioni meteorologiche39.
Distanza di Trasmissione Fissa: La distanza di trasmissione nei modelli di attenuazione fisica è stata impostata a 3 km. Questa è la distanza del collegamento per la quale sono stati effettuati i calcoli di attenuazione. La portata operativa riportata è la distanza massima teorica calcolata utilizzando l'equazione del bilancio del collegamento, che può differire dalla distanza di trasmissione fissa di 3 km. I valori di attenuazione specifici per le condizioni meteorologiche sono stati registrati per condizioni di cielo sereno (0,27±0,06 dB/km), nebbia (1,88±1,92 dB/km), neve (6,45±2,54 dB/km), pioggia (13,58±6,32 dB/km) e polvere (13,10±7,32 dB/km). Tutti i valori quantitativi riportati in questo manoscritto sono espressi come media ± deviazione standard (DS), salvo diversa indicazione40.
L'R2 di cross-validazione per la Random Forest è riportato pari a 0,960±0,007. In alcuni casi, come per la temperatura (−4,89 a 47,99°C), la visibilità (0,05 a 29,99 km), la concentrazione di polvere (0 a 4,96 mg/m3) e l'attenuazione (0,09 a 50,93 dB/km), l'intervallo (dal valore minimo al massimo) è indicato per esteso. Il dataset è stato suddiviso in sottogruppi per il test (300 campioni; 20%) e per l'addestramento (1.200 campioni; 80%). Per effettuare la suddivisione tra training e test è stato utilizzato un campionamento casuale stratificato. La stratificazione è stata applicata in base alla categoria di condizioni meteorologiche (cielo sereno, nebbia, pioggia, polvere e neve) per garantire che la percentuale di ciascuna condizione meteorologica nel set di addestramento (80%) e in quello di test (20%) corrispondesse alla distribuzione originale del dataset. In particolare, 1.200 (80%) dei 1.500 campioni sono stati assegnati al set di apprendimento e 300 (20%) al set di test. I campioni sono stati selezionati casualmente per ciascuna categoria di condizioni meteorologiche, mantenendo le proporzioni originali: dai 814 campioni di cielo sereno (54,27%), 651 sono stati assegnati al training e 163 al test; dai 375 campioni di polvere (25,00%), 300 al training e 75 al test; dai 157 campioni di nebbia (10,47%), 126 al training e 31 al test; dai 111 campioni di pioggia (7,40%), 89 al training e 22 al test; dai 43 campioni di neve (2,87%), 34 al training e 9 al test. Il campionamento casuale all'interno di ogni strato è stato effettuato utilizzando un seme casuale pari a 42 per garantire la riproducibilità. Questo approccio stratificato è stato scelto per evitare una rappresentazione sbilanciata delle condizioni meteorologiche rare (in particolare la neve al 2,87%) nel set di test, il che potrebbe portare a una valutazione delle prestazioni non affidabile per tali condizioni.
Valutazione del modello di apprendimento automatico
Sono stati valutati sei metodi di apprendimento automatico, inclusa la regressione con macchine a vettori di supporto (SVR) con un kernel a funzione di base radiale (C = 100), i K-vicini più prossimi (KNN; k = 10, con pesatura per distanza), RF (200 alberi, profondità massima = 20), boosting estremo del gradiente (XGBoost; 200 stimatori, profondità massima = 10, tasso di apprendimento = 0,1), macchina con boosting del gradiente leggero (LightGBM; 200 stimatori, profondità massima = 10, tasso di apprendimento = 0,1) e regressione lineare di base. Per tutti i modelli di apprendimento automatico e di apprendimento profondo, è stata effettuata la taratura degli iperparametri per i parametri più critici, mentre sono stati mantenuti i valori predefiniti per i parametri non specificati. Per i modelli di apprendimento automatico, i seguenti parametri sono stati regolati esplicitamente utilizzando una ricerca a griglia con validazione incrociata a 5 ripetizioni sul set di addestramento: 1) Foresta casuale: numero di alberi (testati: 50, 100, 150, 200, 250) e profondità massima (testata: 10, 15, 20, 25, senza limite), con valori ottimali selezionati di 200 alberi e profondità 20. 2) XGBoost: numero di stimatori (testati: 100, 150, 200, 250), profondità massima (testata: 6, 8, 10, 12) e tasso di apprendimento (testato: 0,05, 0,1, 0,2), con valori ottimali di 200 stimatori, profondità 10 e tasso di apprendimento 0,1. 3) LightGBM: sono stati utilizzati intervalli di taratura identici, ottenendo 200 stimatori, profondità 10 e tasso di apprendimento 0,1. 4) SVR: sono stati regolati il parametro di regolarizzazione C (testato: 1, 10, 50, 100) e il coefficiente del kernel gamma (testato: ‘scale’, ‘auto’, 0,1, 0,01), con valori ottimali C = 100 e kernel RBF. 5) KNN: è stato regolato il numero di vicini k (testato: 3, 5, 7, 10, 15), con valore ottimale k = 10 e abilitata la votazione pesata per distanza.
Tutti gli altri parametri per questi modelli sono stati lasciati ai valori predefiniti specificati in scikit-learn (vedere la Tabella dei materiali per la versione; ad esempio, Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). Per i modelli di deep learning, l'architettura (numero di strati e unità per strato) e la dropout rate (20%) sono stati regolati manualmente mediante sperimentazione iterativa sul set di validazione, mentre l'ottimizzatore (Adam), il tasso di apprendimento iniziale (0,001), la pazienza dello stop anticipato (20 epoche) e i parametri di riduzione del tasso di apprendimento (fattore 0,5, pazienza 10) sono stati impostati in base alle pratiche standard presenti in letteratura e mantenuti fissi in tutti gli esperimenti di deep learning.
Fonti di dati climatici
Le informazioni meteorologiche storiche raccolte da stazioni meteorologiche irachene in diverse località (Baghdad, Basra, Mosul e Ramadi) tra il 2020 e il 2024 sono state utilizzate per calcolare le proporzioni degli stati atmosferici e le distribuzioni delle variabili. I dati grezzi sono stati forniti dal Ministero dei Trasporti dell'Iraq e dall'Organizzazione Meteorologica e Sismologica dell'Iraq (IMOS). I dati includevano registrazioni meteorologiche giornaliere che descrivevano lo stato atmosferico prevalente per ciascun giorno. Le variabili specifiche ottenute da questi registri comprendevano temperatura (minima, massima e media giornaliera), umidità relativa, visibilità, quantità di precipitazioni e occorrenze di tempeste di polvere. I dati IMOS sono parzialmente disponibili attraverso il portale open data del governo iracheno (https://www.motrans.gov.iq/), anche se i registri specifici utilizzati in questo studio non sono archiviati pubblicamente in un repository centralizzato. Un riepilogo dei dati climatici utilizzati per determinare le proporzioni delle condizioni meteorologiche e gli intervalli dei parametri è riportato nella Tabella 1.
È stata utilizzata una cross-validation a cinque ripetizioni sul set di addestramento (1.200 campioni) per ottimizzare gli iperparametri e stimare le prestazioni di tutti i modelli di apprendimento automatico. Tutte le variabili in ingresso (temperatura, umidità, visibilità, concentrazione di polvere, intensità di pioggia, intensità di neve, velocità del vento, pressione) sono state normalizzate mediante standardizzazione (normalizzazione con punteggio Z): x_scaled = (x − μ)/σ, dove μ e σ sono rispettivamente la media e la deviazione standard del set di addestramento. L'operazione di standardizzazione è stata effettuata all'interno di ciascun fold della cross-validation, utilizzando esclusivamente le statistiche del fold di addestramento, per evitare il data leakage. I modelli basati su alberi (Random Forest, XGBoost, LightGBM) sono invarianti rispetto alla scala, ma è stata applicata la stessa standardizzazione per garantire coerenza tra tutti i modelli di apprendimento automatico. Per i modelli di deep learning è stata utilizzata la normalizzazione min-max: x_scaled = (x−x_min)/(x_max−x_min), che scala le caratteristiche nell'intervallo [0, 1] in base ai valori minimo e massimo del set di addestramento. L'uso di ingressi limitati consente una convergenza più rapida delle reti neurali, motivo per cui è stata scelta questa procedura. Il set di test è stato scalato utilizzando i parametri ottenuti dal set di addestramento, e non è stato impiegato per la selezione del modello né per l'ottimizzazione degli iperparametri.
Sono state registrate metriche di prestazione complete, inclusi il coefficiente di determinazione del test (R2), errore quadratico medio (RMSE), errore assoluto medio (MAE), R di cross-validazione2e il tempo di addestramento. I tempi di addestramento per tutti i modelli di machine learning e deep learning sono riportati in secondi (s) per i modelli più veloci (Regressione Lineare, KNN, SVR, Random Forest, XGBoost, LightGBM) e in minuti (min) per i modelli più lenti (architetture di deep learning). Tutti i modelli sono stati addestrati nello stesso ambiente computazionale per garantire un confronto equo.41.
Il tempo di addestramento è stato misurato utilizzando il modulo time di Python, ovvero il tempo effettivo trascorso dall'inizio alla fine della funzione di addestramento del modello, escludendo il tempo necessario per il caricamento e la pre-elaborazione dei dati. Il tempo di addestramento per un modello di apprendimento profondo corrisponde al tempo impiegato per completare tutte le epoche fino all'arresto precoce. Ciò include la propagazione in avanti, la propagazione all'indietro e i controlli di validazione. Tutti gli esperimenti sono stati eseguiti con il sistema privo di altri processi computazionalmente intensivi, al fine di ottenere misurazioni temporali coerenti. I tempi riportati rappresentano la media di 5 esecuzioni indipendenti (deviazioni standard)42.
Valutazione del modello di apprendimento profondo
Sei architetture di apprendimento profondo sono state valutate utilizzando l'accelerazione GPU, inclusi un percettrone multistrato (MLP; 64-32-16), una rete neurale profonda (DNN) con normalizzazione del batch (128-64-32-16), una rete long short-term memory (LSTM; 64-32 unità, lunghezza della sequenza = 10), una rete neurale convoluzionale unidimensionale (1D-CNN), un modello ibrido CNN–LSTM e una rete basata sull'attenzione. Tutti i modelli di apprendimento profondo sono stati implementati utilizzando TensorFlow con l'API Keras ed eseguiti con accelerazione GPU (vedere Tabella dei Materiali per le versioni di hardware e software). L'architettura 1D-CNN era composta da tre strati convoluzionali (64, 128 e 256 filtri, dimensione del kernel 3, attivazione ReLU, padding=’same’), due strati MaxPooling1D (dimensione del pool 2), uno strato GlobalAveragePooling1D, uno strato denso con 128 unità e attivazione ReLU, uno strato Dropout (0,2) e uno strato di output denso (1 unità, attivazione lineare), per un totale di circa 245.000 parametri addestrabili. L'architettura ibrida CNN-LSTM accettava sequenze in ingresso di 10 passi temporali con 5 caratteristiche, utilizzando due strati Conv1D (64 e 128 filtri, dimensione del kernel 3, ReLU, padding=’same’), uno strato MaxPooling1D (dimensione del pool 2), due strati LSTM (64 e 32 unità, return_sequences=False), strati Dropout (0,2), uno strato denso (32 unità, ReLU) e uno strato di output denso (1 unità, attivazione lineare), per un totale di circa 198.000 parametri addestrabili. La rete basata sull'attenzione utilizzava un meccanismo di attenzione multi-testa con 4 teste (dimensioni chiave e valore di 64), in cui l'ingresso veniva proiettato su 64 dimensioni, seguito da un'attenzione basata sul prodotto scalare normalizzato (formula: Attention(Q, K, V) = softmax(QKT/√d_k)V), connessioni residue, normalizzazione del livello, una rete feedforward (128→64 unità), un'operazione di global average pooling, Dropout (0,2), uno strato denso (32 unità, ReLU) e uno strato di output denso (1 unità, attivazione lineare), per un totale di circa 167.000 parametri addestrabili43.
Tutti i modelli hanno utilizzato l'arresto anticipato (patience = 20), la riduzione del tasso di apprendimento (fattore = 0,5, patience = 10), il dropout (20%) e l'ottimizzatore Adam (tasso di apprendimento = 0,001). Per tutti i modelli di apprendimento profondo, la dimensione del batch è stata impostata a 32 campioni, il numero massimo di epoche di addestramento è stato fissato a 200 con arresto anticipato (patience = 20, ripristino dei migliori pesi), e la funzione di perdita utilizzata è stata l'errore quadratico medio (MSE). La suddivisione tra training e validazione è stata la seguente: partendo dagli originali 1.200 campioni di addestramento (dopo la suddivisione 80/20 tra training e test), l'80% (960 campioni) è stato utilizzato per l'addestramento e il 20% (240 campioni) per la validazione. La suddivisione tra training e validazione è stata stratificata in base alle condizioni meteorologiche per preservarne la distribuzione. Il set di validazione è stato utilizzato esclusivamente per l'arresto anticipato, la riduzione del tasso di apprendimento e il monitoraggio dell'overfitting; non è mai stato impiegato per la selezione del modello o l'ottimizzazione degli iperparametri al di là di queste procedure automatizzate. Non è stato previsto un set di validazione separato per i modelli di machine learning; invece, è stata utilizzata una validazione incrociata a cinque ripetizioni sui 1.200 campioni di addestramento per ottimizzare gli iperparametri e stimare le prestazioni44.
Giustificazione per la valutazione dell'architettura LSTM e CNN–LSTM
Il set di dati principale è costituito da campioni meteorologici generati in modo indipendente, ma abbiamo anche testato architetture LSTM e CNN–LSTM per i seguenti motivi: (1) le condizioni atmosferiche nel mondo reale presentano autocorrelazione temporale e il test di modelli basati su sequenze ci permette di determinare se la cattura di tali dipendenze possa migliorare l'accuratezza delle previsioni; (2) ricerche recenti nella previsione atmosferica hanno dimostrato il valore potenziale delle architetture sequenziali per modellare l'evoluzione temporale dei parametri meteorologici34; (3) il test di un'ampia gamma di architetture garantisce un confronto esaustivo tra approcci metodologici, che rappresenta un contributo fondamentale di questo studio; e (4) l'architettura ibrida CNN–LSTM combina l'estrazione di caratteristiche spaziali con la modellazione temporale, il che potrebbe risultare vantaggioso per catturare le complesse interazioni tra molteplici variabili atmosferiche45.
Formattazione dei dati per l'input del modello sequenziale
Per le architetture sequenziali (LSTM e CNN–LSTM), i dati di ingresso sono stati riorganizzati da campioni indipendenti a pseudo-sequenze utilizzando un approccio a finestra mobile. In particolare, i 1.200 campioni di addestramento sono stati innanzitutto raggruppati in categorie di condizioni meteorologiche per preservare la coerenza fisica. All'interno di ciascuna categoria meteorologica, i campioni sono stati ordinati in base ai loro timestamp generati (osservazioni simulate orarie per l'anno solare 2024). Successivamente, è stata applicata una finestra mobile di lunghezza 10 per produrre sequenze di ingresso composte da 10 passi temporali consecutivi (ciascuno con 5 caratteristiche: temperatura, umidità, visibilità, concentrazione di polvere e intensità di pioggia) al fine di prevedere l'attenuazione al 11° passo temporale. Questo metodo preserva l'ordinamento temporale delle osservazioni simulate, consentendo al contempo ai modelli sequenziali di apprendere le dipendenze temporali. La struttura del set di test era la stessa, fatta eccezione per la medesima dimensione della finestra e il medesimo insieme di caratteristiche. Riconosciamo che questa strutturazione pseudo-sequenziale rappresenta una semplificazione metodologica e non riflette le dinamiche temporali del mondo reale. Abbiamo riconosciuto questa limitazione nella sezione Discussione.
Valutazione degli approcci ibridi
Sono stati esaminati tre approcci ibridi. Il primo approccio era un insieme a voto (Voting Ensemble) che mediava le previsioni provenienti dai modelli Random Forest, XGBoost e Deep Neural Network utilizzando pesi uguali (a ciascun modello veniva assegnato un peso di 1/3), con la previsione finale calcolata come:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
È stata scelta una ponderazione equa per evitare l'introduzione di ulteriori iperparametri e per valutare le prestazioni di base dell'insieme senza alcun bias verso un singolo modello. Il secondo approccio ha impiegato un metodo di stacking con meta-learner Ridge. I modelli di base erano Foresta Casuale, XGBoost e una Rete Neurale Profonda (basata sull'attenzione). La procedura di stacking prevedeva due fasi: innanzitutto, ciascun modello di base è stato addestrato sull'intero insieme di training di 1.200 campioni utilizzando una cross-validation a 5 fold per generare predizioni out-of-fold, creando così una nuova matrice di meta-caratteristiche di dimensione 1.200×3 (una predizione per modello di base per ogni campione). In secondo luogo, un meta-learner basato su regressione Ridge (parametro di regolarizzazione L2 alpha=1,0) è stato addestrato su queste meta-caratteristiche, utilizzando i valori originali di attenuazione come obiettivo, per apprendere i pesi ottimali di combinazione dei modelli di base. La predizione finale ottenuta tramite stacking era:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
dove i pesi w sono stati appresi dal meta-algoritmo Ridge. Il terzo approccio era una rete neurale informata dalla fisica, che combinava il 70% delle predizioni della rete neurale con il 30% proveniente dal modello di Kim per i campioni in condizioni di nebbia. La combinazione è stata effettuata mediante media pesata fissa utilizzando la seguente formula:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
dove ŷneural è l'output della rete neurale basata sull'attenzione e ŷKim è l'attenuazione calcolata a partire dal modello di nebbia di Kim in base all'input di visibilità. Per i campioni senza nebbia, la componente fisica è stata impostata a 0 e il modello è stato eseguito come rete neurale pura. I pesi (70% neurale e 30% fisico) sono stati fissati in base a esperimenti preliminari sul set di validazione (non sul set di test), in cui abbiamo testato combinazioni di pesi pari a 90:10, 80:20, 70:30, 60:40 e 50:50. È stata scelta la suddivisione 70/30 poiché forniva il valore di R2 di validazione migliore e al contempo manteneva un vincolo fisico sufficiente derivato dal modello di Kim per regolarizzare le previsioni ed evitare output fisicamente implausibili, specialmente in condizioni di nebbia, dove il modello di Kim fornisce limiti teorici di attenuazione ben stabiliti.
Analisi dell'importanza e dell'interpretabilità delle caratteristiche
È stato utilizzato il modello Random Forest con importanza delle caratteristiche basata sull'impurità (riduzione della varianza) per estrarre tutte e 10 le classifiche di importanza delle caratteristiche in ingresso. L'analisi ha mostrato che la concentrazione di polvere (67,3%) e la visibilità (21,2%) erano i predittori più importanti, spiegando insieme l'88,5% dell'importanza predittiva totale. La terza caratteristica più importante era l'intensità della pioggia (6,0%), seguita dalla velocità del vento (2,1%), dalla temperatura (1,5%), dall'umidità (0,9%), dal mese (0,5%), dalla stagione (0,3%), dal tasso di nevicata (0,1%) e dalla pressione atmosferica (0,1%). I bassi punteggi di importanza per le caratteristiche temporali (mese e stagione) indicano che la variazione stagionale nell'attenuazione atmosferica è catturata principalmente da parametri ambientali sottostanti piuttosto che da schemi basati esclusivamente sul tempo.
È stata eseguita un'analisi SHAP (Shapley Additive exPlanations) per valutare le relazioni tra i fattori ambientali e l'attenuazione. L'implementazione SHAP utilizzata è stata il modulo TreeExplainer della libreria SHAP, specificamente ottimizzato per modelli basati su alberi, inclusi Random Forest, XGBoost e LightGBM (vedere la Tabella dei Materiali per la versione). La configurazione per l'analisi SHAP è stata la seguente: il modello Random Forest addestrato è stato passato a TreeExplainer, che ha calcolato i valori SHAP utilizzando l'approccio di attribuzione delle caratteristiche interventista (marginale) basato sull'aspettativa condizionata dell'output del modello. I valori SHAP sono stati calcolati per tutti e 300 i campioni del set di test, generando una matrice di dimensioni 300 × 10 (un valore SHAP per ogni caratteristica per ogni campione). Per ogni caratteristica, il valore SHAP rappresentava il suo contributo alla previsione rispetto alla linea di base (la previsione media del modello). Valori SHAP negativi indicavano una riduzione; mentre valori SHAP positivi indicavano che la caratteristica aumentava la previsione di attenuazione. L'intensità del contributo era indicata dall'ampiezza del valore SHAP. La distribuzione dei valori SHAP per ogni caratteristica (utilizzando grafici a nuvola d'api), la direzione dell'influenza (la correlazione tra i valori della caratteristica e i valori SHAP) e le classifiche di importanza delle caratteristiche sono state tutte visualizzate mediante grafici riassuntivi. Le funzioni di plotting integrate nella libreria SHAP—shap.summary_plot() per il grafico a nuvola d'api e shap.bar_plot() per l'importanza globale delle caratteristiche—sono state utilizzate per creare tutte le visualizzazioni SHAP.
Gestione delle variabili codificate in modalità one-hot: per codificare la variabile stagione sono state utilizzate inizialmente quattro colonne binarie (primavera, estate, autunno e inverno). Al fine di ottenere un singolo valore di contributo per "stagione" per ogni campione nell'analisi SHAP, i contributi di queste quattro variabili codificate in modalità one-hot sono stati combinati sommando i valori SHAP per ciascuna categoria stagionale. Per realizzare questo raggruppamento, sono state identificate tutte le colonne corrispondenti ai gruppi stagionali codificati in modalità one-hot, sono stati estratti i valori SHAP per ogni campione e successivamente sommati elemento per elemento. I valori SHAP combinati risultanti rappresentano il contributo complessivo della stagione alla previsione dell'attenuazione. Questo metodo consente di visualizzare una singola riga "stagione" nel grafico riassuntivo SHAP e garantisce coerenza con l'utilizzo della stagione da parte del modello come variabile categorica composta. Poiché il valore combinato offre una rappresentazione più chiara del contributo totale della stagione, i valori SHAP relativi alla stagione non sono stati mostrati separatamente per ciascuna categoria stagionale.
Risultati
Le caratteristiche del dataset sintetico sono riassunte in Figura 1A–F. Il dataset includeva condizioni di cielo sereno, polvere, nebbia, pioggia e neve (Figura 1A), con campioni distribuiti tra stagioni calde-asciutte e fresche-umide (Figura 1B) e tra periodi diurni e notturni (Figura 1C). Le distribuzioni di temperatura, umidità e visibilità in diverse condizioni meteorologiche sono mostrate in Figura 1D–F.
I modelli di apprendimento automatico hanno dimostrato un'elevata capacità predittiva nella stima dell'attenuazione atmosferica (Figura 2A–D; Tabella 3). Il Random Forest (RF) ha ottenuto la migliore prestazione complessiva tra i modelli valutati, con un R2 sul test set pari a 0,9654 e un RMSE di 1,324 dB/km (Figura 2A; Tabella 3). Il RF ha spiegato il 96,54% della variazione osservata mantenendo un errore di previsione inferiore a 1,5 dB/km. Anche XGBoost ha mostrato buone prestazioni (Figura 2C), seguito da LightGBM (Figura 2B). La robustezza del modello è stata confermata da una validazione incrociata a cinque ripetizioni, con un valore di R2 nella validazione incrociata pari a 0,960 ± 0,007 per il RF (Figura 2D). Al contrario, il metodo K-Nearest Neighbors ha mostrato segni di overfitting, con un R2 sul training set pari a 1,000 e un R2 sul test set di 0,7341, mentre la regressione lineare ha ottenuto prestazioni predittive moderate (Figura 2A; Tabella 3).
L'analisi dell'importanza delle caratteristiche relative alle 10 caratteristiche in ingresso sopra menzionate è mostrata in Figura 3A. I punteggi di importanza relativa sono ordinati come segue: concentrazione di polvere (67,3%), visibilità (21,2%), intensità della pioggia (6,0%), velocità del vento (2,1%), temperatura (1,5%), umidità (0,9%), mese (0,5%), stagione (0,3%), intensità della nevicata (0,1%) e pressione (0,1%). La variabile «condizione meteorologica» è utilizzata per la stratificazione del dataset, ma non è inclusa nell'analisi dell'importanza delle caratteristiche poiché si tratta di una variabile composita categorica che rappresenta diversi parametri fisici sottostanti, e il suo effetto è catturato dalle singole caratteristiche ambientali. Le analisi di importanza e interpretabilità delle caratteristiche hanno identificato le variabili ambientali più fortemente associate all'attenuazione (Figura 3A,B). La concentrazione di polvere (67,3%), la visibilità (21,2%) e l'intensità della pioggia (6,0%) insieme costituiscono il 94,4% dell'importanza predittiva totale (Figura 3A). L'analisi SHAP ha inoltre dimostrato che un aumento della concentrazione di polvere e una diminuzione della visibilità sono associate a previsioni di attenuazione maggiori (Figura 3B).
I modelli di deep learning hanno mostrato prestazioni predittive inferiori rispetto agli approcci di machine learning (Figura 4A–D). Il modello di deep learning con le migliori prestazioni, la rete basata sull'attenzione (Attention-based network), ha ottenuto un valore di R2 pari a 0,7766 e un RMSE di 3,362 dB/km (Figura 4A). Le architetture ricorrenti hanno mostrato prestazioni particolarmente scarse: sia i modelli LSTM che quelli CNN–LSTM hanno prodotto valori di R2 prossimi allo zero e valori di RMSE superiori a 7,19 dB/km (Figura 4B). La prestazione relativamente scarsa delle architetture LSTM e CNN-LSTM (R2 = 0,0110 e 0,0109 rispettivamente; RMSE = 7,193 dB/km e 7,196 dB/km) può essere parzialmente spiegata dalla natura pseudo-sequenziale dei dati in ingresso, che non coglie appieno la vera dinamica temporale delle condizioni atmosferiche.
A differenza delle applicazioni basate su serie temporali reali, in cui le dipendenze sequenziali sono forti e ben definite, il nostro dataset era composto principalmente da campioni indipendenti con un ordinamento temporale imposto artificialmente. Le scarse prestazioni predittive di queste architetture suggeriscono che l'informazione temporale estratta tramite l'approccio della finestra scorrevole era insufficiente o non rappresentativa dell'effettiva evoluzione atmosferica (Figura 4C). Questo conferma la nostra conclusione secondo cui, per dataset di questa natura, approcci più semplici di apprendimento automatico sono più adatti rispetto a modelli complessi di deep learning basati su sequenze. Le prestazioni di validazione per tutte le architetture di deep learning sono riassunte nella Figura 4D.
Le prestazioni degli approcci di machine learning, deep learning e ibridi sono riassunte nella Figura 5A,B e nella Tabella 3. Tra i metodi ibridi, il Voting Ensemble ha raggiunto un valore di R2 pari a 0,9340 e un RMSE di 1,827 dB/km (Figura 5A,B; Tabella 3). L'impilamento con meta-learner Ridge ha ottenuto un R2 di 0,9571 e un RMSE di 1,473 dB/km (Figura 5A,B; Tabella 3), avvicinandosi alle prestazioni di RF ma richiedendo tempi di addestramento sostanzialmente più lunghi. La rete neurale informata dalla fisica ha raggiunto un valore di R2 = 0,8269 e RMSE = 2,960 dB/km (Figura 5A,B; Tabella 3) e ha mostrato prestazioni migliori rispetto ai modelli di deep learning, sebbene inferiori rispetto ai migliori approcci di machine learning. Il confronto statistico tra i modelli RF e Stacking Ensemble non ha evidenziato differenze significative nelle prestazioni predittive (Tabella 3; test t per campioni appaiati: t = −1,74, p = 0,083). Pertanto, sebbene RF abbia ottenuto il valore numerico più alto di R2, la differenza rispetto al migliore approccio ibrido non è statisticamente significativa.
Complessivamente, i risultati supportano l'ipotesi secondo cui gli approcci di machine learning possono prevedere con precisione l'attenuazione atmosferica nelle condizioni meteorologiche dell'Iraq. Il modello RF ha ottenuto costantemente le prestazioni predittive più elevate (Figura 2A,B; Tabella 3), mentre le analisi di importanza delle caratteristiche e SHAP hanno identificato la concentrazione di polvere e la visibilità come i fattori ambientali predominanti che influenzano l'attenuazione (Figura 3A,B).
Dichiarazione sui dati di convalida: Tutte le valutazioni del modello sono state condotte sul dataset sintetico descritto nella sezione Metodi. Non sono stati utilizzati dati sperimentali o osservazionali sull'attenuazione atmosferica per la convalida del modello. Il dataset sintetico è stato creato impiegando modelli fisici di propagazione ben noti (legge di Beer-Lambert, modello di Kim, modello di Carbonneau e teoria dello scattering di Mie) con parametri meteorologici selezionati da distribuzioni di probabilità basate su registrazioni climatiche dell'Iraq. Come indicato nella sezione Metodi, l'elevata capacità predittiva potrebbe riflettere in parte l'apprendimento del modello o la sua approssimazione delle equazioni fisiche deterministiche utilizzate per generare i valori obiettivo. Pertanto, le metriche quantitative di prestazione (R2, RMSE, MAE) rappresentano le prestazioni su dati sintetici derivati da equazioni e devono essere interpretate come confronti relativi tra metodologie di modellizzazione in un ambiente di simulazione controllato, piuttosto che come garanzie assolute di prestazione per sistemi FSO operativi. Questo approccio fornisce un ambiente controllato per la valutazione comparativa delle metodologie di modellizzazione predittiva (elencate in Tabella 2), ma non sostituisce la convalida mediante misurazioni reali dell'attenuazione FSO in condizioni meteorologiche irachene effettive.
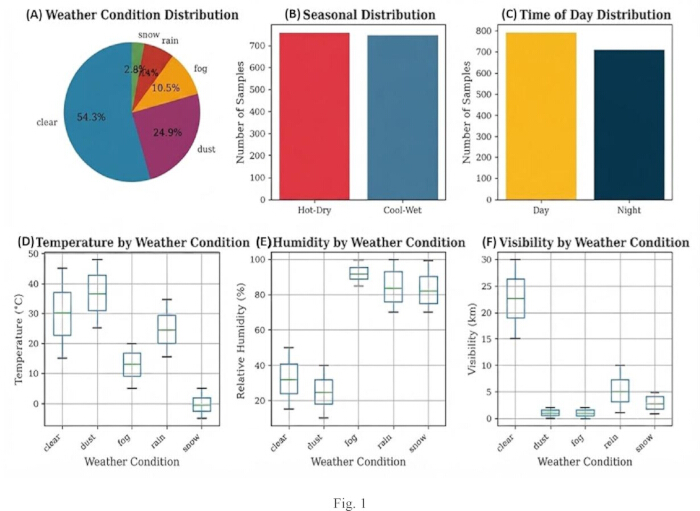
Figura 1: Caratteristiche del dataset sintetico e delle variabili ambientali utilizzate per la modellizzazione dell'attenuazione atmosferica. (A) Distribuzione delle condizioni meteorologiche presenti nel dataset, comprese situazioni di cielo sereno, polvere, nebbia, pioggia e neve. (B) Distribuzione stagionale dei campioni nei periodi caldo-secco e fresco-umido. (C) Distribuzione dei campioni raccolti in condizioni diurne e notturne. (D) Distribuzioni di temperatura per ciascuna condizione meteorologica. (E) Distribuzioni di umidità per ciascuna condizione meteorologica. (F) Distribuzioni di visibilità per ciascuna condizione meteorologica. I boxplot mostrano la mediana (linea centrale), l'intervallo interquartile (box) e i valori minimo e massimo (baffi). La temperatura è espressa in °C, l'umidità in % e la visibilità in km. Cliccare qui per visualizzare una versione ingrandita di questa figura.
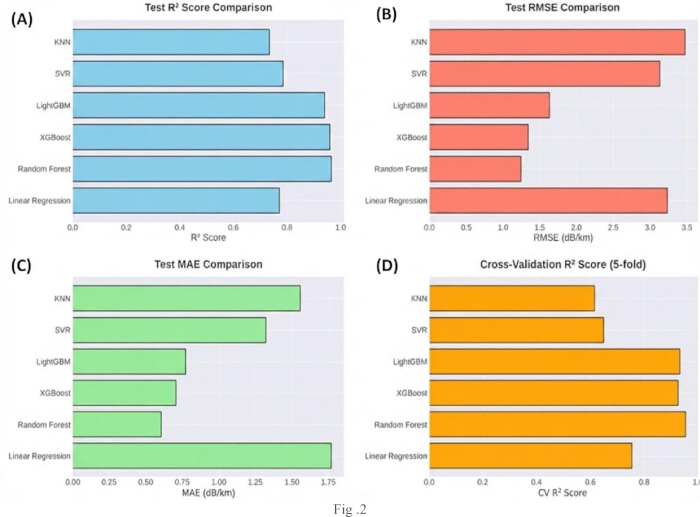
Figura 2: Confronto delle prestazioni dei modelli di apprendimento automatico per la previsione dell'attenuazione atmosferica. (A) Coefficienti di determinazione (R2) ottenuti nel test per i modelli di apprendimento automatico valutati, inclusi Regressione Lineare, Foresta Casuale, Extreme Gradient Boosting (XGBoost), Light Gradient Boosting Machine (LightGBM), Support Vector Regression (SVR) e K-Nearest Neighbors (KNN). (B) Valori di errore quadratico medio (RMSE) nel test per ciascun modello di apprendimento automatico. (C) Valori di errore assoluto medio (MAE) nel test per ciascun modello di apprendimento automatico. (D) Coefficienti di determinazione (R2) ottenuti mediante validazione incrociata a cinque ripetizioni. Valori più elevati di R2 e valori più bassi di RMSE e MAE indicano prestazioni predittive migliori. RMSE e MAE sono espressi in dB/km. Cliccare qui per visualizzare una versione ingrandita di questa figura.
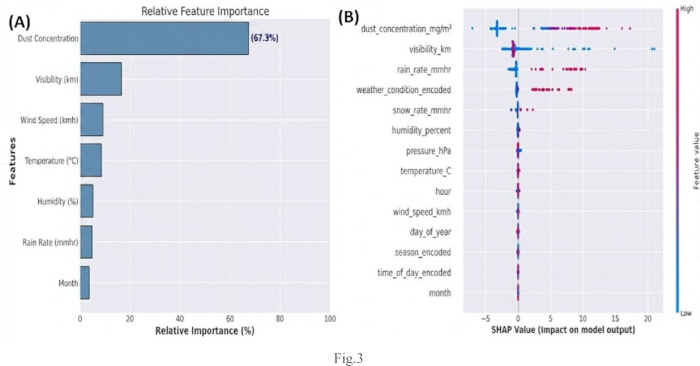
Figura 3: Analisi dell'importanza delle caratteristiche e interpretabilità del modello per la previsione dell'attenuazione atmosferica. (A) Classifiche relative dell'importanza delle caratteristiche basate sull'impurità ottenute dal modello Random Forest, che mostrano il contributo di tutte e 10 le variabili ambientali e temporali alla previsione dell'attenuazione. La caratteristica più influente è stata la concentrazione di polvere (67,3%), seguita dalla visibilità (21,2%), dalla velocità di pioggia (6,0%), dalla velocità del vento (2,1%), dalla temperatura (1,5%), dall'umidità (0,9%), dal mese (0,5%), dalla stagione (0,3%), dalla velocità di nevicata (0,1%) e dalla pressione atmosferica (0,1%). L'importanza relativa è espressa come percentuale dell'importanza totale del modello. (B) Grafico riassuntivo SHapley Additive exPlanations (SHAP) che illustra l'impatto delle singole caratteristiche sulle previsioni del modello. La matrice SHAP è stata calcolata per 300 campioni del set di test (300 × 10 caratteristiche). Per la variabile stagione codificata in one-hot (originariamente quattro colonne binarie: primavera, estate, autunno, inverno), i valori SHAP sono stati combinati sommando le quattro categorie per produrre un singolo valore di contributo ‘stagione’ per ogni campione. Ogni punto rappresenta un campione, e la scala cromatica indica il valore della caratteristica, che varia da basso (blu) ad alto (rosso). Valori SHAP positivi indicano un aumento dell'attenuazione prevista, mentre valori SHAP negativi indicano una diminuzione dell'attenuazione prevista. Cliccare qui per visualizzare una versione ingrandita di questa figura.
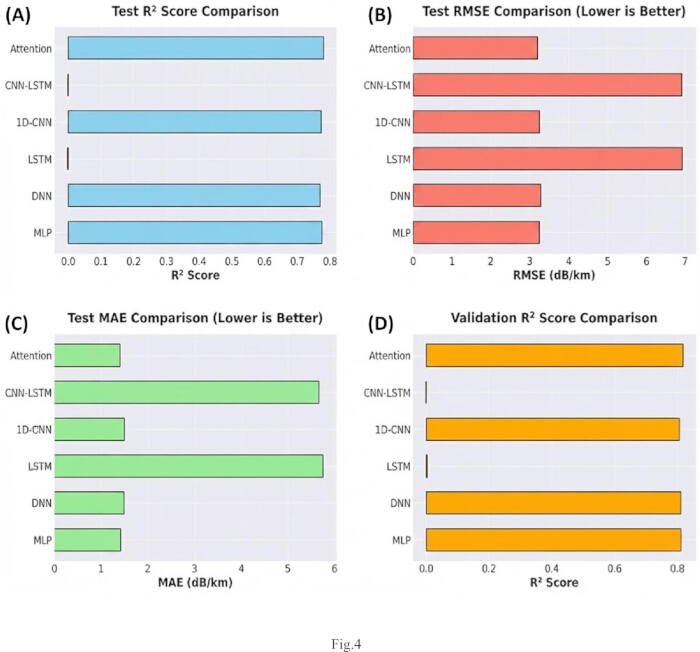
Figura 4Confronto delle prestazioni di modelli di apprendimento profondo per la previsione dell'attenuazione atmosferica. (A) Test del coefficiente di determinazione (R2) punteggi per le architetture di apprendimento profondo valutate, incluse il Perceptron Multistrato (MLP), la Rete Neurale Profonda (DNN), la Memoria a Lungo e Breve Termine (LSTM), la rete neurale convoluzionale monodimensionale (1D-CNN), la rete neurale convoluzionale–memoria a lungo e breve termine (CNN–LSTM) e i modelli basati sull'attenzione.BValori di errore quadratico medio (RMSE) del test per ciascun modello di apprendimento profondo.C) Valori dell'errore assoluto medio (MAE) per ciascun modello di apprendimento profondo. (D) Coefficiente di determinazione della validazione (R2) punteggi per i modelli di apprendimento profondo valutati. Punteggi R più elevati2 valori più bassi di RMSE e MAE indicano una migliore performance predittiva. RMSE e MAE sono riportati in dB/km. Cliccare qui per visualizzare una versione ingrandita di questa figura.
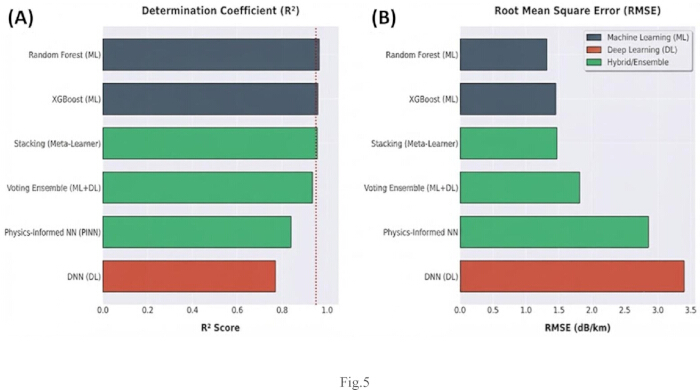
Figura 5: Prestazioni comparative di modelli di machine learning, deep learning e modelli ibridi per la previsione dell'attenuazione atmosferica. (A) Valori del coefficiente di determinazione (R2) per rappresentativi approcci di machine learning, deep learning e modelli ibridi, inclusi Random Forest, Extreme Gradient Boosting (XGBoost), Deep Neural Network (DNN), Voting Ensemble, Stacking e modelli di Physics-Informed Neural Network. (B) Valori dell'errore quadratico medio (RMSE) per gli stessi modelli. I modelli sono codificati a colori in base a tre categorie: machine learning (ML), deep learning (DL) e tecniche ibride/ensemble. Prestazioni predittive migliori sono indicate da valori più elevati di R2 e da valori più bassi di RMSE. L'RMSE è espresso in dB/km. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Condizione meteorologica | Proporzione | Intervallo di temperatura | Intervallo di umidità | Intervallo di visibilità | Intervallo del parametro principale |
| Cielo sereno | 54,27% (814 campioni) | −4,89 a 47,99°C | 0–100% | >10 km | — |
| Polvere | 25,00% (375 campioni) | 10–45°C | 10–60% | 0,05–5 km | Polvere: 0–4,96 mg/m3 |
| Nebbia | 10,47% (157 campioni) | −5 a 20°C | 70–100% | 0,05–1 km | — |
| Pioggia | 7,40% (111 campioni) | 5–30°C | 60–100% | 1–10 km | Pioggia: 0,25–50 mm/h |
| Neve | 2,87% (43 campioni) | −10 a 5°C | 50–100% | 0,5–5 km | Neve: 0,5–15 mm/h |
Tabella 1: Misure di prestazione dei modelli di apprendimento automatico per la previsione dell'attenuazione atmosferica.
| Modello | R2 del test | RMSE (dB/km) | MAE (dB/km) | R2 CV | Tempo di addestramento (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Support Vector Regression (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Regressione lineare | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-Nearest Neighbors (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tabella 2: Valutazione comparativa di specifici modelli di deep learning, ibridi e di machine learning.
| Modello | Categoria | R2 del test | RMSE (dB/km) | Posizione |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Ibrido | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Ibrido | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | Ibrido | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabella 3: Confronto dell'efficienza computazionale (addestramento e inferenza) di ciascun modello valutato.
DISPONIBILITÀ DEI DATI :
L'intero set di dati sintetico composto da 1.500 campioni con tutte le variabili di ingresso (temperatura, umidità, visibilità, concentrazione di polvere, intensità di pioggia, intensità di neve, velocità del vento, pressione atmosferica, mese, stagione e condizione meteorologica) e la variabile target (attenuazione in dB/km) è fornito come file supplementare insieme a questo manoscritto all'indirizzo https://doi.org/10.5281/zenodo.21792999. Il set di dati è formattato in modo che ogni campione corrisponda a una riga, inclusi tutte le variabili calcolate (intervallo operativo e SNR).
L'intero codice di implementazione, inclusi: script per la generazione dei dati (implementazioni di modelli fisici); funzioni per la preelaborazione e la normalizzazione delle caratteristiche; tutte le implementazioni dei modelli di apprendimento automatico; tutte le implementazioni di modelli di apprendimento profondo; script per la valutazione e la visualizzazione; e procedure di ottimizzazione degli iperparametri e di validazione incrociata, è previsto come file supplementare.
Dati climatici di origine: I dati climatici utilizzati per definire le distribuzioni di dati sintetici sono stati ottenuti dall'Organizzazione Meteorologica Irachena e di Sismologia (IMOS) e dal Ministero dei Trasporti iracheno, relativi al periodo 2020–2024. Un riepilogo dei dati climatici impiegati per determinare le proporzioni delle condizioni meteorologiche e gli intervalli dei parametri è riportato nella Tabella Supplementare 1. I record specifici IMOS utilizzati in questo studio non sono archiviati pubblicamente in un repository centralizzato, ma possono essere richiesti direttamente all'IMOS. Le statistiche riassuntive e le distribuzioni di probabilità derivate sono fornite nei materiali supplementari al fine di garantire la riproducibilità.
Informazioni sul repository: Il codice sorgente e il set di dati sono depositati in un repository pubblico (Zenodo) all'indirizzo https://doi.org/10.5281/zenodo.21792999.
Discussione
Al fine di prevedere l'attenuazione atmosferica nei sistemi di comunicazione FSO operanti in condizioni meteorologiche irachene, lo studio attuale ha valutato tecniche di machine learning, deep learning e metodi ibridi. Poiché gli effetti atmosferici continuano a rappresentare uno dei principali problemi che influenzano le prestazioni e la disponibilità del collegamento, valutazioni recenti hanno sottolineato l'importanza crescente della modellizzazione predittiva per i sistemi FSO21. I risultati hanno mostrato che gli approcci classici di machine learning, in particolare RF e XGBoost, hanno fornito un'elevata accuratezza predittiva e, in alcuni casi, hanno superato numericamente i metodi di deep learning e ibridi. Tuttavia, test statistici non hanno rilevato una differenza significativa (p=0.083) tra RF e il miglior ensemble ibrido (Stacking), il che significa che entrambi gli approcci possono raggiungere risultati simili su questo dataset. I nostri risultati indicano che i metodi ensemble basati su alberi risultano ancora altamente performanti per dati ambientali tabulari con dimensioni campionarie moderate e un numero ridotto di variabili predittive dominanti. L'analisi dell'importanza delle caratteristiche ha mostrato che la concentrazione di polvere e la visibilità sono i principali fattori determinanti dell'attenuazione, spiegando insieme la maggior parte del potere predittivo. Questo risultato è in accordo con studi precedenti che evidenziano l'importante influenza di nebbia, polvere, aerosol e inquinamento atmosferico sulla propagazione del segnale ottico22,23,24,25. Risultati simili sono stati riportati in applicazioni di monitoraggio ambientale, in cui i modelli di machine learning traggono spesso vantaggio da dataset contenenti un numero ridotto di variabili altamente informative26,27,28,29,30,31,32. L'analisi SHAP ha ulteriormente migliorato l'interpretabilità del modello quantificando l'influenza dei singoli parametri ambientali sulle previsioni di attenuazione.
Le prestazioni inferiori dei modelli di deep learning possono essere attribuite a diversi fattori. La dimensione del set di dati era relativamente modesta per l'addestramento di architetture neurali complesse (in https://doi.org/10.5281/zenodo.21792999), e le variabili ambientali mostravano un'importanza delle caratteristiche fortemente concentrata. Studi precedenti hanno dimostrato che i metodi di deep learning traggono generalmente vantaggio da set di dati ampi, strutture gerarchiche di caratteristiche e rappresentazioni non lineari complesse33,34,35,36,37. Al contrario, il set di dati sull'attenuazione utilizzato in questo studio conteneva un numero limitato di predittori dominanti e mancava delle dipendenze temporali necessarie per architetture ricorrenti. Le scarse prestazioni dei modelli LSTM e CNN–LSTM suggeriscono che i meccanismi di apprendimento sequenziale potrebbero non offrire benefici sostanziali per questa applicazione.
La predominanza della concentrazione di polvere (67,3%) e della visibilità (21,2%) come predittori dell'attenuazione atmosferica può essere attribuita a diversi fattori. Innanzitutto, la diffusione molecolare e l'assorbimento a 1550 nm sono oscurati dalla diffusione di Mie provocata dalle particelle di polvere. Nella teoria di Mie, l'efficienza di estinzione Q_ext è altamente sensibile alla concentrazione delle particelle e l'attenuazione cresce quasi linearmente con la concentrazione di polvere nel regime da moderato ad alto. In secondo luogo, l'Iraq è soggetto a frequenti tempeste di sabbia (25,00% dei giorni nei nostri dati climatici), che determinano valori di attenuazione compresi tra 4 e 30 dB/km. Questo valore contrasta con la nebbia (10,47%, 0,5–10 dB/km) e la pioggia (7,40%, 2–25 dB/km). La maggiore variabilità dell'attenuazione causata dalla polvere produce segnali più forti, facilitando l'apprendimento dei modelli. In terzo luogo, la distribuzione esponenziale della concentrazione di polvere (0,4–4,96 mg/m3) genera un ampio intervallo di valori di attenuazione. La coda lunga relativa agli eventi estremi di polvere produce valori elevati di attenuazione, fondamentali per una previsione accurata. In quarto luogo, il modello di diffusione di Mie presenta una dipendenza più semplice (approssimativamente lineare) dalla concentrazione di polvere, più facile da approssimare per modelli basati su alberi rispetto alla relazione più complessa tra visibilità e attenuazione da nebbia nel modello di Kim. Infine, questo risultato ha un'importanza pratica, poiché le tempeste di sabbia rappresentano una delle condizioni ambientali più difficili per le comunicazioni ottiche in spazio libero (FSO) nel Medio Oriente. Una previsione accurata durante gli eventi di polvere è essenziale per il funzionamento affidabile del sistema.
I risultati avanzano la ricerca sulle comunicazioni FSO fornendo indicazioni pratiche sulla selezione degli algoritmi per la previsione dell'attenuazione atmosferica. Una previsione accurata dell'attenuazione è essenziale per la progettazione delle reti, la gestione adattativa dei collegamenti e il dispiegamento affidabile dei sistemi di comunicazione ottica in ambienti difficili come il Medio Oriente23,28,30,36. Inoltre, la metodologia potrebbe essere applicabile ad altri problemi di previsione ambientale che coinvolgono la propagazione dell'aria, il monitoraggio atmosferico e la valutazione delle prestazioni delle reti ottiche38,39,40. L'uso di dataset reali più ampi, tecniche avanzate di apprendimento ensemble, framework di trasferimento dell'apprendimento o architetture più complesse informate dalla fisica sono altri possibili approcci per esaminare questa idea41,42,43,44,45.
Portata delle conclusioni e problemi di generalizzabilità
Le conclusioni di questo lavoro si basano principalmente su un dataset sintetico generato a partire da modelli fisici di propagazione ben consolidati (legge di Beer-Lambert, modello di Kim, modello di Carbonneau e teoria dello scattering di Mie). Questo approccio metodologico comporta alcune implicazioni per la portata e la generalizzazione dei nostri risultati:
Conclusioni dai dati simulati: (1) Classificazione comparativa delle prestazioni di approcci di apprendimento automatico, apprendimento profondo e metodi ibridi nella previsione dell'attenuazione atmosferica. (2) Individuazione della concentrazione di polvere e della visibilità come predittori ambientali predominanti dell'attenuazione ottica nelle condizioni modellate. (3) Vantaggio in termini di efficienza computazionale dei metodi ensemble basati su alberi rispetto alle architetture di apprendimento profondo. (4) Interpretabilità dell'importanza delle caratteristiche e delle analisi SHAP per spiegare le previsioni del modello.
Conclusioni che richiedono conferma nel mondo reale: (1) I valori assoluti di R2 e RMSE ottenuti dai modelli valutati dipendono dalle caratteristiche specifiche del dataset sintetico e potrebbero riflettere la capacità dei modelli di apprendere le equazioni fisiche deterministiche utilizzate per generare gli obiettivi. (2) Resta da dimostrare che il modello migliore, la Random Forest, possa essere applicato a condizioni atmosferiche reali sconosciute. (3) È necessaria una validazione sul campo affinché i risultati possano essere applicati a unità FSO operative installate in Iraq. (4) È necessario confermare che le classifiche di importanza delle caratteristiche identificate siano robuste anche in condizioni di misurazione sul campo.
È importante distinguere tra le prestazioni su dati sintetici derivati da equazioni e quelle su dati osservativi o sperimentali rumorosi. Il set di dati sintetico fornisce una relazione pulita e priva di rumore tra le variabili in ingresso e l'obiettivo di attenuazione, il che può produrre indicatori di prestazione predittiva più elevati rispetto a quelli ottenibili con dati reali affetti da rumore di misurazione, errori strumentali e fenomeni fisici non modellati. Raccomandiamo che lavori futuri siano orientati all'acquisizione di misurazioni reali di attenuazione FSO nelle condizioni meteorologiche irachene, al fine di convalidare i risultati presentati in questo studio e valutare la vera generalizzabilità delle metodologie proposte.
Implicazioni dei dati sintetici per la generalizzabilità del modello
Le implicazioni dell'uso di dati sintetici in questo studio devono essere attentamente valutate per quanto riguarda la generalizzabilità dei modelli:
Vantaggi dell'Approccio Sintetico Il set di dati è fisicamente coerente e basato su consolidati quadri teorici grazie all'utilizzo di modelli fisici di propagazione affermati. I parametri meteorologici sono stati estratti da registrazioni meteorologiche dell'Iraq per far sì che il set di dati rispecchi le proprietà statistiche delle effettive condizioni atmosferiche in Iraq. Oltre a evitare variabili disturbanti proprie delle misurazioni in campo (come errori di misura, calibrazione degli strumenti o registrazioni di dati insufficienti), questo contesto controllato consente un'analisi metodica delle metodologie di modellizzazione.
Limitazioni alla generalizzabilità Il dataset sintetico presenta limitazioni nel catturare la complessità completa dell'attenuazione atmosferica reale, inclusi: (1) l'interazione di più fenomeni atmosferici che si verificano contemporaneamente; (2) il comportamento non lineare e non stazionario dei parametri atmosferici; (3) la variabilità climatica a lungo termine non catturata dalle distribuzioni di campionamento; (4) effetti microclimatici localizzati che potrebbero influenzare significativamente la propagazione FSO; e (5) il rumore e l'incertezza intrinseci nella raccolta di dati nel mondo reale.
Considerazioni sui bias nella generazione di dati sintetici L'assunzione di campionamento indipendente dei parametri ambientali (vedi Metodi) rappresenta una semplificazione eccessiva delle condizioni reali, in cui le variabili atmosferiche tendono a essere correlate (ad esempio, alte concentrazioni di polvere tendono a correlarsi con bassa visibilità). È stata adottata un'ipotesi di indipendenza al fine di ottenere un ambiente di simulazione controllato per il confronto sistematico dei modelli. Tuttavia, questo metodo potrebbe non cogliere tutta la complessità delle interazioni tra i parametri atmosferici. Utilizziamo un metodo di suddivisione stratificata (mantenendo i rapporti tra le condizioni meteorologiche nei set di addestramento e di test) per ridurre al minimo il rischio di una rappresentazione sbilanciata delle condizioni rare nel set di test (in particolare la neve, presente al 2,87%).
Generazione Deterministica dell'Obiettivo: L'elevata prestazione predittiva osservata in questo studio può essere parzialmente spiegata dal fatto che i modelli hanno appreso le equazioni fisiche deterministiche utilizzate per generare i valori obiettivo. Al contrario, i dati sperimentali del mondo reale contengono rumore di misurazione, errori strumentali e fenomeni fisici non modellati che rendono la previsione più complessa. Pertanto, le metriche quantitative di prestazione (R2, RMSE, MAE) devono essere interpretate come confronti relativi tra metodologie in un ambiente di simulazione controllato, piuttosto che come garanzie assolute di prestazione per sistemi FSO operativi.
Pertanto, sebbene i risultati comparativi sui ranghi di prestazione dei modelli siano probabilmente robusti (a causa della coerenza fisica dei dati sintetici), le metriche di prestazione assolute (R2, RMSE, MAE) non devono essere considerate indicative delle prestazioni attese in sistemi FSO operativi. È necessario verificare la generalizzabilità del modello in contesti reali utilizzando misurazioni sperimentali di attenuazione atmosferica ottenute in diverse condizioni meteorologiche in Iraq.
Ci sono alcune limitazioni da considerare. In primo luogo, lo studio si è basato su un dataset sintetico generato mediante modelli fisici di propagazione ben noti, piuttosto che su osservazioni dirette in campo. Come già menzionato, le metriche quantitative di prestazione (R2, RMSE, MAE) non devono essere interpretate come garanzie assolute di prestazione per sistemi FSO operativi, ma piuttosto come confronti relativi tra approcci in un ambiente di simulazione controllato. In secondo luogo, i modelli tradizionali e quelli basati sull'apprendimento profondo potrebbero non aver appreso rappresentazioni robuste delle caratteristiche a causa delle dimensioni ridotte del dataset. In terzo luogo, altri indicatori di prestazione FSO, come la disponibilità del collegamento, gli errori di puntamento e l'attenuazione indotta dalla turbolenza, non sono stati considerati, privilegiando invece la previsione dell'attenuazione. In quarto luogo, le proporzioni delle condizioni meteorologiche sono state calcolate utilizzando dati storici dal 2020 al 2024, i quali potrebbero non riflettere con precisione le variazioni annuali nei modelli climatici iracheni. In quinto luogo, la struttura pseudo-sequenziale dei dati in ingresso nei modelli CNN–LSTM e LSTM rappresenta una semplificazione metodologica che potrebbe non catturare adeguatamente la dinamica temporale delle applicazioni reali. Tali limitazioni devono essere prese in considerazione durante la valutazione dei risultati, poiché potrebbero influenzare la generalizzabilità delle conclusioni.
Priorità raccomandata: Verifica nel mondo reale. La raccolta e l'analisi di misurazioni effettive di attenuazione FSO in condizioni meteorologiche irachene rappresentano la via più importante per futuri sviluppi. Tale attività dovrebbe includere: (1) l'installazione di testbed FSO in diverse regioni dell'Iraq (ad esempio, Baghdad, Basra, Mosul, Ramadi) per registrare le variazioni climatiche regionali; (2) l'uso di strumenti calibrati presso le posizioni FSO per misurare simultaneamente i parametri atmosferici (temperatura, umidità, visibilità, concentrazione di polvere); (4) la documentazione dell'attenuazione durante eventi meteorologici estremi (tempeste di sabbia, nebbia fitta, pioggia intensa); (5) la pubblicazione dei dati raccolti per favorire la riproducibilità e la ricerca comparativa; e (3) il monitoraggio continuo per almeno un intero ciclo annuale al fine di catturare le fluttuazioni stagionali. Una tale validazione pratica offrirebbe l'opportunità di valutare la generalizzabilità del modello e di migliorare le tecniche predittive sviluppate nella presente ricerca.
Per convalidare e migliorare i modelli generati, le future ricerche dovrebbero concentrarsi sull'incorporamento di misurazioni reali di FSO ottenute in condizioni meteorologiche irachene. Ulteriori studi potrebbero esaminare strategie di apprendimento per trasferimento che sfruttano set di dati atmosferici pertinenti, programmi di apprendimento online in grado di adattarsi a condizioni ambientali variabili, e strategie ibride basate su esperimenti e simulazioni che combinano dati misurati con modelli fisici. Ricerche aggiuntive sull'intelligenza artificiale interpretabile e su approcci avanzati di apprendimento basati sulla fisica potrebbero inoltre fornire ulteriori chiarimenti sui meccanismi alla base dell'attenuazione atmosferica e rafforzare la robustezza dei futuri sistemi di previsione.
Dichiarazioni
Conflitto di interessi: Gli autori dichiarano di non avere conflitti di interessi.
Ringraziamenti
Gli autori dichiarano che per questa ricerca non è stato ricevuto alcun finanziamento esterno. Desideriamo ringraziare il Centro Internazionale di Ricerca Applicata e Teorica (IATRC), Baghdad Quarter, Iraq.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Toolkit CUDA | NVIDIA Corporation | 11.8 | Libreria per l'accelerazione GPU per il training del deep learning |
| cuDNN | NVIDIA Corporation | 8.6.0 | Libreria per reti neurali profonde accelerata da GPU |
| GPU (unità di elaborazione grafica) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Utilizzata per il training del deep learning accelerato da GPU |
| CPU (unità centrale di elaborazione) | Intel Corporation | Core i9-13900K, 24 core/32 thread | Processore workstation per il training e la valutazione di tutti i modelli |
| Memoria di sistema (RAM) | n/a | 64 GB DDR5, 5200 MHz | Memoria del workstation |
| API Keras | Open source (parte di TensorFlow) | inclusa in TensorFlow 2.11.0 | API di alto livello per il deep learning utilizzata per tutte le architetture DL |
| LightGBM | Open source (Microsoft) | 3.3.5 | Framework di gradient boosting |
| NumPy | Open source (NumFOCUS) | 1.23.5 | Libreria per il calcolo numerico |
| Sistema operativo | Canonical Ltd. | Ubuntu 22.04 LTS | Sistema operativo del workstation |
| Python | Python Software Foundation | 3.9 | Linguaggio di programmazione utilizzato per la generazione dei dati e la modellazione |
| scikit-learn | Open source | 1.2.2 | Libreria di machine learning (RF, SVR, KNN, regressione lineare, cross-validation, scaling) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | Libreria per l'interpretabilità dei modelli, modulo TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | Framework di deep learning utilizzato per tutte e sei le architetture DL |
| XGBoost | Open source | 1.7.5 | Libreria di Extreme Gradient Boosting |
Riferimenti
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.