In questo studio, presentiamo un protocollo per l'arricchimento del DNA mitocondriale da singoli ovociti umani mediante l'uso della Esoneucleasi V e per la preparazione di librerie di sequenziamento duplex per il rilevamento altamente accurato di varianti del DNA mitocondriale utilizzando piattaforme di sequenziamento compatibili con Illumina.
Articolo metodologico
Protocollo per il sequenziamento duplex del DNA mitocondriale in singoli ovociti umani
In questo articolo
Sommario
Abstract
Gli oociti sono densamente popolati da mitocondri, organelli produttori di energia che contengono il proprio genoma, il DNA mitocondriale (mtDNA). Ogni cellula contiene molteplici copie di mtDNA, con un numero di copie variabile tra i diversi tipi di tessuto. Gli oociti possiedono il numero più elevato di copie di mtDNA, con centinaia di migliaia di molecole di mtDNA per cellula. Poiché i mitocondri vengono ereditati esclusivamente attraverso la linea materna, un'accurata rilevazione delle varianti di mtDNA è essenziale per studi sull'ereditarietà, sull'invecchiamento e sulle malattie. La presenza di molteplici copie di mtDNA permette la coesistenza di molecole selvatiche e mutate all'interno della stessa cellula, una condizione nota come eteroplasmia, in cui varianti a bassa frequenza e de novo possono verificarsi a frequenze inferiori all'1%. Il sequenziamento convenzionale di nuova generazione (NGS) non possiede un'accuratezza sufficiente per distinguere in modo affidabile queste varianti rare dagli errori introdotti durante la preparazione della libreria e il sequenziamento. In questo lavoro presentiamo un protocollo per l'arricchimento di mtDNA da singoli oociti umani mediante l'uso della Esoneucleasi V per rimuovere il DNA lineare, seguito dalla preparazione della libreria di sequenziamento duplex per un'analisi altamente accurata del mtDNA. Questo flusso di lavoro consente il sequenziamento corretto degli errori da singoli oociti, facilitando il rilevamento affidabile di varianti di mtDNA a bassa frequenza e l'analisi dell'eteroplasmia e della mutagenesi de novo. Il protocollo fornisce un approccio riproducibile per studiare la variabilità del genoma mitocondriale in singoli oociti mediante piattaforme di sequenziamento compatibili con Illumina.
Introduzione
I mitocondri svolgono ruoli fondamentali in processi cellulari essenziali, tra cui la produzione di energia, l'apoptosi, il segnaling e l'omeostasi del calcio1. Possiedono un proprio genoma, il DNA mitocondriale (mtDNA), una molecola circolare a doppio filamento lunga circa 16,6 kb nei mammiferi. Sebbene la maggior parte dei geni mitocondriali ancestrali sia stata trasferita nel genoma nucleare durante l'endosimbiosi, il mtDNA conserva 37 geni che codificano per 13 polipeptidi della fosforilazione ossidativa (OXPHOS), 22 RNA di trasferimento (tRNA) e due RNA ribosomiali (rRNA)2. Le mutazioni nel mtDNA possono compromettere l'espressione genica e la funzione mitocondriale e possono causare gravi disturbi3. Poiché i mitocondri vengono ereditati esclusivamente attraverso la linea materna, il mtDNA dell'ovocita svolge un ruolo fondamentale nella fecondazione, nello sviluppo embrionale e nella salute della prole4. Di conseguenza, il rilevamento e la caratterizzazione delle mutazioni del mtDNA e delle loro frequenze rivestono un notevole interesse. Ad esempio, comprendere la mutagenesi germinale associata all'invecchiamento e alle malattie è un prerequisito importante per lo sviluppo di strategie terapeutiche per l'infertilità femminile.
A differenza del DNA nucleare, il DNA mitocondriale (mtDNA) è presente in molteplici copie per cellula, con un numero che varia da centinaia a migliaia di copie nelle cellule somatiche a seconda del tipo di tessuto, superando le 100.000 copie negli ovociti maturi4. L'elevato numero di copie di mtDNA rende gli ovociti particolarmente adatti allo studio della mutagenesi mitocondriale a livello di singola cellula. Tuttavia, la rilevazione di mutazioni de novo nel mtDNA, in particolare quelle presenti a frequenze molto basse, rimane una sfida poiché le frequenze di errore del sequenziamento convenzionale di nuova generazione (NGS) superano quelle di molte varianti reali5. Per questo motivo, sono necessari metodi di sequenziamento con correzione degli errori per distinguere le mutazioni autentiche dagli artefatti introdotti durante la preparazione delle librerie, l'amplificazione e il sequenziamento. Uno di questi approcci è il sequenziamento duplex (DS)6,7. Nel DS, i frammenti di DNA vengono legati ad adattatori contenenti marcatori molecolari randomizzati a doppio filamento di 12 nucleotidi prima dell'amplificazione. Questi identificatori molecolari unici etichettano ciascuna molecola di DNA originale a entrambe le estremità, consentendo di raggruppare in famiglie le letture di sequenza provenienti dallo stesso filamento stampo sulla base della sequenza di marcatori condivisa. Viene generata una sequenza consenso del singolo filamento (SSCS) da ciascuna famiglia di letture, dopodiché le SSCS complementari derivate dal duplex di DNA originale vengono combinate per produrre una sequenza consenso duplex (DCS). Solo le varianti rilevate nella maggioranza delle letture all'interno di entrambe le SSCS complementari e confermate nella DCS risultante sono considerate mutazioni reali, consentendo frequenze di errore che sono di diversi ordini di grandezza inferiori rispetto ai metodi convenzionali di NGS8. Questa strategia risulta particolarmente vantaggiosa per la rilevazione di varianti di mtDNA a bassa frequenza e di eteroplasmia in singole cellule.
Un limite importante della maggior parte dei protocolli di sequenziamento duplex pubblicati è la necessità di quantità relativamente elevate di DNA iniziale durante la preparazione della libreria, rendendo questi metodi inadatti per applicazioni su singola cellula6,7,9. L'obiettivo generale di questo protocollo è consentire un sequenziamento duplex altamente accurato del DNA mitocondriale (mtDNA) da singoli ovociti umani, mediante un flusso di lavoro ottimizzato per l'arricchimento del mtDNA, la preparazione della libreria e il sequenziamento. Per ridurre al minimo il sequenziamento dei segmenti nucleari di DNA mitocondriale (NUMTs) e migliorare l'efficienza del sequenziamento, questo protocollo include un passaggio di arricchimento basato sull'esonucleasi V, che digerisce selettivamente il DNA lineare preservando il mtDNA circolare. Il flusso di lavoro risultante fornisce un approccio pratico per il rilevamento accurato di varianti del mtDNA in singoli ovociti ed è adatto a studi sulle eteroplasmie, la mutagenesi de novo, l'invecchiamento e le malattie mitocondriali.
Protocollo
La raccolta e la lavorazione degli ovociti umani sono state approvate dalla Commissione Etica della Johannes Kepler University di Linz (Numero di approvazione 1293/2020). Eseguire tutte le procedure in conformità con le linee guida istituzionali, inclusi il consenso informato, l'anonimizzazione dei campioni e tutte le normative applicabili relative all'uso di tessuti umani.
NOTA: anche se questo protocollo è descritto per ovociti umani, adattare i primer specifici per la specie per applicare il flusso di lavoro ad altre specie. Utilizzare materiali monouso a basso legame per il DNA (ad esempio, provette e puntali per pipetta) durante tutto il protocollo per minimizzare la perdita di campione. Eseguire tutti i passaggi fino alla prima purificazione nella provetta originale per la raccolta di ovociti a basso legame. Non vortexare i campioni, poiché l'agitazione meccanica potrebbe danneggiare i filamenti di DNA. Mescolare invece i componenti della reazione mediante pipettaggio delicato o leggeri colpetti sulla provetta, seguiti da una breve centrifugazione. Ogni volta che possibile, eseguire l'isolamento del DNA, la preparazione del master mix e l'allestimento della reazione in stazioni di lavoro dedicate per la reazione a catena della polimerasi (PCR) o in aree di laboratorio fisicamente separate per minimizzare le contaminazioni.
1. Preparazione di tamponi e reagenti
- Preparare il buffer di lisi per oociti (OLB), Tris-HCl 10 mM, buffer TE, buffer TElow e Tris-NaCl 10 mM secondo la Tabella 1, combinando i volumi specificati delle soluzioni stock e portando ciascuna soluzione al volume finale indicato con acqua di grado per biologia molecolare. Aliquotare 1 mL dei buffer preparati, conservare le aliquote a 4°C e utilizzarle entro 1 anno.
Tabella 1: Composizione dei tamponi utilizzati nell'intero protocollo. Composizioni dei tamponi e concentrazioni finali per la preparazione di Tris-HCl 10 mM, tampone TE, tampone TElow, Tris-NaCl 10 mM e tampone di lisi degli oociti (OLB). Preparare tutti i tamponi utilizzando acqua di grado per biologia molecolare. Regolare il pH delle soluzioni stock di Tris-HCl ed EDTA prima della preparazione dei tamponi, se necessario, seguendo le raccomandazioni del produttore. L'OLB viene integrato con proteinasi K termolabile immediatamente prima della lisi del campione, come descritto nel protocollo. Cliccare qui per scaricare il file.
2. Raccolta di singoli ovociti
NOTA: Gli ovociti umani utilizzati in questo protocollo sono stati raccolti da pazienti programmate per un'iniezione intracitoplasmatica dello sperma (ICSI) presso il Kinderwunsch Zentrum (centro per la fertilità) dell'Ospedale Universitario Kepler di Linz, Austria. I protocolli di stimolazione ovarica si sono basati sulla risposta ovarica prevista della paziente, e le dosi sono state adattate in base alle caratteristiche individuali, tra cui età, livelli di ormone anti-Mülleriano (AMH) e peso corporeo, in conformità con le raccomandazioni della Società Europea di Riproduzione Umana ed Embriologia (ESHRE)10. La soppressione pituitaria è stata ottenuta mediante l'uso di agonisti o antagonisti dell'ormone liberatore delle gonadotropine (GnRH), in combinazione con la stimolazione gonadotropina per favorire la maturazione follicolare. La crescita follicolare è stata monitorata regolarmente mediante ecografia transvaginale prima dell'induzione dell'ovulazione. Gli ovociti sono stati quindi recuperati mediante aspirazione transvaginale dei follicoli, e il liquido follicolare contenente i complessi cumulo-ovocitari (COC) è stato raccolto11. Solo ovociti immaturi o non fecondati, che non potevano essere utilizzati per il trattamento ICSI della paziente e che altrimenti sarebbero stati scartati, sono stati resi disponibili per la ricerca dopo aver ottenuto il consenso informato. Le pazienti con un numero maggiore di follicoli antrali (AFC) sono state preferibilmente contattate per la donazione di ovociti poiché avevano maggiori probabilità di produrre ovociti immaturi o non fecondati idonei alla ricerca. Tutte le procedure eseguite prima della selezione degli ovociti per la ricerca devono rispettare le normative nazionali relative alla fecondazione in vitro e all'uso di tessuti umani. Tutti i materiali devono essere manipolati in condizioni sterili all'interno di una cappa a flusso laminare. Assicurarsi che tutti i materiali e i mezzi di coltura certificati CE che vengono a contatto diretto con gli ovociti siano sterili, preriscaldati a 37°C e mantenuti a un pH compreso tra 7,20 e 7,40.
- Prelevare i COC dal liquido follicolare e trasferirli in 750 µL di mezzo GM501 Cult sotto olio minerale sterile dopo stimolazione ovarica controllata e recupero transvaginale degli ovociti.
- Rimuovere le cellule del cumulo circostanti dalla zona pellucida (ZP) mediante digestione enzimatica con ialuronidasi. Incubare gli ovociti in 500 µL di GM501 Ialuronidasi (80 U/mL) per 30–60 s a 37°C, seguita da tre lavaggi in 750 µL di mezzo GM501 Cult. Rimuovere meccanicamente con cura eventuali cellule del cumulo residue utilizzando pipette per denudazione.
- Per ovociti in telofase I (TI) o metafase II (MII), aprire la ZP mediante una serie di impulsi laser adiacenti al globulo polare ed estrarre il primo globulo polare usando micromanipolatori. Regolare le impostazioni del laser in base allo spessore della ZP (1–3 impulsi; durata dell'impulso, 1,5–2,6 ms; diametro del punto, 16–20 µm). Utilizzare il laser per rimuovere eventuali cellule del cumulo residue, riducendo così al minimo la contaminazione dell'ovocita con DNA cellulare somatico.
- Trasferire ogni ovocita singolarmente in 2–3 µL di soluzione salina fosfato 1× (PBS) in una provetta da 200 µL a bassa adesione. Congelare immediatamente la provetta a −20°C. Per la conservazione a lungo termine, trasferire gli ovociti congelati a −80°C.
NOTA: Dopo la scongelazione, eseguire il resto del protocollo in modo continuo e senza interruzioni fino al completamento del primo passaggio di amplificazione. - Per monitorare eventuali contaminazioni da DNA ambientale durante l'intero protocollo, includere un controllo negativo costituito da 2 µL di PBS 1× senza ovocita durante la preparazione della libreria (dal Passaggio 4 in avanti). Elaborare il controllo negativo esattamente come tutti gli altri campioni di ovociti. Nessun DNA rilevabile dovrebbe essere osservato nel controllo negativo in alcuna fase del protocollo.
3. Sintesi dell'adattatore
NOTA: Preparare gli adattatori prima di iniziare la preparazione della libreria. Conservare gli adattatori sintetizzati a −80°C per un massimo di 3 mesi. Preparare aliquote per evitare cicli ripetuti di congelamento e scongelamento, e non ricongelare gli adattatori dopo lo scongelamento. Tutte le sequenze di oligonucleotidi utilizzate in questo protocollo sono elencate nella Tabella 2.
Tabella 2: Oligonucleotidi e primer utilizzati nell'intero protocollo. La tabella elenca tutti gli oligonucleotidi impiegati per la sintesi degli adattatori, l'amplificazione della libreria, la reazione a catena della polimerasi quantitativa (qPCR), la quantificazione della libreria e la stima dell'arricchimento del DNA mitocondriale (mtDNA), insieme alle loro sequenze, ai metodi di purificazione, alle quantità fornite o alle concentrazioni di stock raccomandate e al produttore. La sequenza dell'oligonucleotide carrier mostrata è un esempio di sequenza utilizzata nel presente protocollo. L'asterisco (*) all'interno delle sequenze dei primer indica un legame fosforotioato. I nucleotidi randomizzati (N) nell'adattatore mws55 rappresentano l'identificatore molecolare univoco (UMI), mentre Y indica la base pirimidinica degenere (C o T). A meno che non indicato diversamente, gli oligonucleotidi sono stati sintetizzati mediante purificazione standard con desalazione. Cliccare qui per scaricare il file.
- Preparare un'aliquote di etanolo al 96% (EtOH) e conservarla a −20°C per i successivi passaggi di purificazione. Preparare l'EtOH al 80% fresco immediatamente prima dell'uso.
- Mescolare 20.5 µL ciascuno dei 100 µM mws51_short e 100 µM oligonucleotidi mws55 in un 200 µL tubo a bassa adesione per ottenere un volume totale di 41 µL (2.000 pmol di ciascun oligonucleotide).
- Incubare gli oligonucleotidi combinati a 95°C per 5 min in un termociclatore con la temperatura del coperchio impostata a 110°C. Avviare il cronometro dopo che il campione ha raggiunto 95°C, spegnere il termociclatore dopo 5 min e lasciare le provette all'interno del termociclatore per 1 h per consentire un raffreddamento lento fino alla temperatura ambiente (RT) e l'annealing ("adattatore annealed").
- Preparare un Extension Master Mix combinando 1× NEB Buffer 2 (5.6 µL di 10× stock), 3,5 mM deossinucleosidi trifosfati (dNTPs; 5.6 µL di stock da 10 mM), 11,5 U di frammento Klenow (2.3 µL di 5 U/µL stock) e 2.5 µL di acqua di grado per biologia molecolare fino a un volume finale di 16 µL.
- Rimuovere 1 µL dell'adattatore ricottato preparato al passaggio 3.3, diluirlo 1:20 in TEbasso buffer, etichettare l’aliquota come “annealed” e conservarla a 4°C per elettroforesi su gel di agarosio.
- Aggiungere 16 µL del mix maestro di estensione al resto 40 µL di oligonucleotidi ricotturati e mescolare accuratamente.
- Incubare la reazione a 37°C per 1 h con il coperchio del termociclatore impostato a 47°C.
- Purificare gli oligonucleotidi allungati mediante precipitazione con EtOH. Aggiungere 28 µL di acetato di ammonio (NH4OAc) al 56 µL miscela di reazione e mescolare accuratamente.
- Trasferire l'intera reazione in una provetta da 1,5 mL a bassa adesività e aggiungere 168 µL di EtOH ghiacciato al 96%
- Capovolgere il tubo diverse volte e incubare a −20°C per 30 min per precipitare il DNA.
- Preparare 1 mL di EtOH al 80% fresco e raffreddarlo a −20°C. Raffreddare preventivamente la centrifuga a 4°C.
- Centrifugare a 14.000 × g per 30 min.
- Rimuovere con attenzione il soprannatante senza disturbare il pellet. Aggiungere 1 mL di EtOH al 80% freddo su ghiaccio senza mescolare né capovolgere il tubo.
- Centrifugare a 14.000 × g per 5 min.
- Rimuovere tutto l’EtOH residuo e lasciare asciugare all’aria il pellet di DNA per 10–15 min, fino a quando non rimane alcun liquido visibile e il pellet appare trasparente. Non asciugare eccessivamente gli oligonucleotidi.
- Risospendere il pellet in 41 µL di acqua di grado per biologia molecolare.
- Rimuovere 1 µL, diluirlo 1:20 in TEbasso buffer, etichettare l’aliquota come “prolungato” e conservarla a 4°C.
- Preparare un mix maestro di restrizione combinando 47 µL di acqua di grado biologico molecolare, 1× CutSmart Buffer (10 µL di 10× stock) e 15 U di HpyCH4III (3 µL di 5 U/µL stock) a un volume finale di 60 µL.
- Aggiungere 60 µL del mix maestro di restrizione a 40 µL di oligonucleotidi purificati e mescolare accuratamente.
- Incubare la reazione a 37°C per 16 h con il coperchio del termociclatore impostato a 47°C.
- Preparare 6,5 mL di EtOH fresco all'80% e raffreddarlo a −20°C. Raffreddare preventivamente la centrifuga a 4°C.
- Trasferire gli adattatori digeriti in una provetta da 1,5 mL a bassa adesività e aggiungere 900 µL di acqua di grado per biologia molecolare.
- Aggiungere 500 µL di NH4OAc e mescolare accuratamente.
- Dividere la soluzione in sei 250 µL aliquote in provette da 1,5 mL a basso legame. Aggiungere 500 µL di etanolo al 96% ghiacciato in ogni provetta.
- Capovolgere i tubi più volte e incubare a −20°C per 30 min per precipitare il DNA.
- Centrifugare a 14.000 × g per 30 min. Rimuovere con attenzione il soprannatante senza disturbare il pellet. Aggiungere 1 mL di EtOH al 80% freddo di ghiaccio in ogni provetta senza mescolare né capovolgere. Centrifugare a 14.000 × g per 5 min.
- Rimuovere tutto l'EtOH residuo e fare essiccare all'aria i pellet degli adattatori.
- Risospendere ogni pellet in 6.7 µL di tampone Tris-NaCl e unire tutte e sei le sospensioni per ottenere un volume finale di 41 µL. Rimuovere 1 µL, diluirlo 1:10 in TEbasso buffer, etichettare l’aliquota come “cut” e conservarla a 4°C.
- Preparare aliquote della soluzione madre di adattatori e conservarle a −80°C. Misurare la concentrazione dell'adattatore e determinare l'A260/280 e A260/230 rapporti di assorbanza dell’aliquota “tagliata” utilizzando uno spettrofotometro. La concentrazione prevista dell’adattatore è 30–50 µM, con un A260/280 rapporto di >1,7 e un A260/230 rapporto di >1.9.
- Eseguire gli aliquote "annealed", "extended" e "cut" su un gel di agarosio al 2% a 125 V per 45 min per verificare la formazione degli adattatori e il completamento della digestione con enzimi di restrizione (Figura 1).
NOTA: L'aliquota "annealed" dovrebbe contenere due bande che rappresentano le frazioni annealed e non annealed. L'adattatore annealed è previsto migrare a circa 90 bp e consiste in una regione a doppio filamento di 13 bp con un'estremità a singolo filamento di 68 nt, mentre gli oligonucleotidi non annealed migrano a circa 60 bp. Dopo l'estensione, l'adattatore presenta una regione a doppio filamento di 37 bp con un'estremità a forma di Y di 44 nt ed è previsto migrare a circa 110 bp. Dopo la digestione con enzimi di restrizione, un frammento di 8 bp viene rimosso dall'adattatore. Dovrebbero essere visibili tre bande: una banda predominante a circa 100 bp (adattatore finale) e due bande deboli a circa 60 bp (oligonucleotidi rimanenti non annealed) e 8 bp (frammento di restrizione).
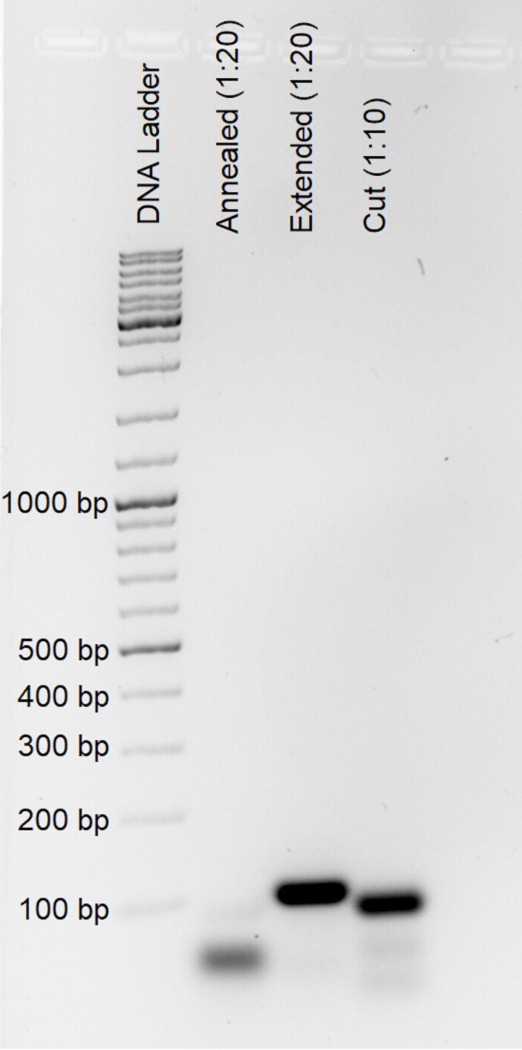
Figura 1. Analisi rappresentativa della dimensione dei frammenti dei prodotti intermedi e degli adattatori finali per il sequenziamento duplex. Aliquote raccolte durante la sintesi degli adattatori dopo l'appaiamento degli oligonucleotidi ("annealed", diluiti 1:20), l'estensione con riempimento ("extended", diluiti 1:20) e la digestione con l'enzima di restrizione HpyCH4III ("cut", diluiti 1:10) sono state analizzate mediante elettroforesi su gel di agarosio al 2% per verificare la corretta formazione degli adattatori duplex per il sequenziamento. Cliccare qui per visualizzare una versione ingrandita di questa figura.
4. Lisi del singolo ovocita
- Preparare il tampone OLB integrato con proteinasi K termolabile (OLB+) aggiungendo 1 µL di proteinasi K termolabile (0,120 U/µL) a 99 µL di OLB, ottenendo una concentrazione finale di proteinasi K pari a 0,0012 U/µL.
- Scongelare gli oociti a temperatura ambiente (RT). Aggiungere immediatamente 4 µL di OLB+ a ciascun oocita. Sciacquare più volte le pareti del tubo con il tampone di lisi per assicurare il trasferimento completo dell'oocita nel tampone ed evitare che il campione aderisca alle pareti del tubo.
- Mescolare accuratamente il campione, centrifugare brevemente per raccogliere il contenuto sul fondo del tubo e incubare a 37°C per 16 h in un termociclatore con la temperatura del coperchio impostata a 47°C.
NOTA: Non viene effettuata alcuna valutazione indipendente della lisi degli oociti prima della frammentazione. Un'incubazione di 16 h nelle condizioni di lisi specificate è generalmente sufficiente per ottenere la lisi completa di un singolo oocita. La quantità di DNA recuperato può comunque variare a causa della perdita di campione durante le manipolazioni e delle differenze nel numero di copie di mtDNA tra gli oociti. - Inattivare la proteinasi K termolabile incubando i campioni a 55°C per 15 min in un termociclatore con la temperatura del coperchio impostata a 75°C.
NOTA: Completare il flusso di lavoro successivo senza interruzioni dopo la lisi e l'inattivazione della proteinasi K, a meno che un passaggio successivo del protocollo non indichi esplicitamente un punto di sosta.
5. Digestione con esonucleasi V
- Lasciare che i campioni raggiungano l'equilibrio alla temperatura ambiente (RT) prima di procedere.
- Preparare una miscela maestra di Esoneucleasi V unendo 4 µL di cloruro di magnesio 25 mM (MgCl₂), 1 µL di Tris-HCl 10 mM, 1 µL di adenosina trifosfato (ATP) 10 mM e 1 µL di Esoneucleasi V (soluzione madre a 10 U/µL) per ottenere un volume finale di 7 µL.
- Preparare una soluzione lavorativa di ribonucleasi A (RNase A) a 1 mg/mL diluendo 1 µL di soluzione madre di RNase A a 10 mg/mL con 99 µL di acqua di grado per biologia molecolare. Aggiungere circa 0,1 µL della soluzione di RNase A diluita a ciascun campione di ovocita lisato.
NOTA: Utilizzare una pipetta adatta per questo passaggio. Quando si elaborano più campioni contemporaneamente, è possibile utilizzare una pipetta multicanale adeguata, a condizione che si prendano precauzioni per evitare contaminazioni incrociate tra i campioni. Poiché l'accuratezza della pipettaggio può diminuire quando si dispensano volumi così piccoli con una pipetta multicanale, ispezionare attentamente tutti i canali. In alternativa, immergere brevemente la punta della pipetta nella soluzione di RNase A diluita è sufficiente per trasferire circa 0,1 µL. Piccole deviazioni rispetto a questo volume non influiscono sul rendimento del protocollo. Verificare preventivamente il volume approssimativo trasferito utilizzando una pipetta monocanale. - Aggiungere 7 µL della miscela maestra di Esoneucleasi V a ciascun campione di ovocita lisato e mescolare accuratamente. Incubare i campioni a 37°C per 1 h in un termociclatore con la temperatura del coperchio impostata a 47°C.
- Aggiungere 38 µL di tampone TE a ciascun campione per ottenere un volume di reazione finale di circa 51 µL. Inattivare termicamente gli enzimi incubando i campioni a 70°C per 30 min in un termociclatore con la temperatura del coperchio impostata a 75°C.
- Procedere immediatamente alla preparazione della libreria.
6. Frammentazione
- Frantumare il DNA fino a una dimensione media dei frammenti di circa 550 paia di basi (bp) mediante sonificazione.
NOTA: questo protocollo descrive la frammentazione del DNA utilizzando uno strumento di ultrasonificazione focalizzata Covaris M220, di seguito indicato come sonicatore; tuttavia, possono essere utilizzati anche sistemi equivalenti. Poiché i campioni contengono detriti cellulari oltre al DNA dopo la lisi, ottimizzare le condizioni di frammentazione in base allo strumento specifico e al tipo di campione per ottenere una distribuzione relativamente ristretta delle dimensioni dei frammenti centrata intorno alla dimensione desiderata. - Trasferire l'intero volume del campione (circa 51 µL) in una provetta da 50 µL per ultrasonificazione focalizzata.
- Frantumare il DNA per 70 s utilizzando un Duty Factor del 10%, una Potenza Incidente di Picco di 75 W e 200 cicli per raffica a 20°C.
- Trasferire immediatamente ciascun campione frammentato (circa 50 µL) dalla provetta di sonificazione a una provetta da 200 µL a bassa adesività, poiché le provette di sonificazione non sono a bassa adesività. La provetta originale utilizzata per la raccolta degli ovociti può essere riutilizzata a questo scopo. Ispezionare il coperchio della provetta di sonificazione alla ricerca di liquido residuo e recuperare qualsiasi campione rimanente per massimizzare il recupero.
- Procedere immediatamente con la riparazione dei capi e l'aggiunta della coda poli-A.
7. Riparazione Finale/A-Tailing
- Preparare una miscela madre per la riparazione dei capi e l'aggiunta della coda poli-A contenente 7 µL di End Prep Reaction Buffer e 3 µL di End Prep Enzyme Mix.
- Aggiungere 10 µL della miscela madre per la riparazione dei capi e l'aggiunta della coda poli-A a ciascun campione per ottenere un volume finale di reazione di 60 µL. Mescolare accuratamente aspirando e dispensando 10 volte con una pipetta.
- Incubare i campioni a 20°C per 30 minuti con il coperchio del termociclatore spento, seguito da un'incubazione a 65°C per 30 minuti con la temperatura del coperchio impostata a 75°C.
- Procedere immediatamente alla ligazione degli adattatori.
8. Legatura dell'adattatore
- Preparare una miscela madre di ligazione contenente 30 µL di miscela di ligazione e 1 µL di potenziatore di ligazione.
- Scongelare un'aliquote dell'adattatore sintetizzato e diluirlo 1:4000 in tampone Tris-NaCl.
- Aggiungere 1,5 µL dell'adattatore diluito a ciascun campione di DNA con estremità riparate e coda di A. Aggiungere 31 µL della miscela madre di ligazione e mescolare accuratamente.
- Incubare i campioni a 20°C per 15 minuti. Aggiungere 1 µL dell'adattatore diluito a ciascun campione per ottenere un volume finale di reazione di 93,5 µL. Mescolare accuratamente e incubare a 4°C per 16 ore.
- Procedere immediatamente alla purificazione.
9. Purificazione del DNA legato all'adattatore
- Lasciare equilibrare le perle magnetiche e il tampone TElow a temperatura ambiente (RT) per almeno 30 minuti. Durante questo periodo, preparare EtOH fresco all'80%. Preparare una soluzione di oligonucleotide carrier aggiungendo 1 µL dell'oligonucleotide carrier (sequenza non presente nel genoma umano; vedere Tabella 2) a 99 µL di tampone TElow per ottenere una concentrazione finale di 1 nM.
- Trasferire 74,8 µL di perle magnetiche, corrispondenti a un rapporto perle-campione di 0,8×, in un tubo da 1,5 mL a bassa adesività. Aggiungere l'intero volume di 93,5 µL di DNA legato agli adattatori e mescolare accuratamente.
- Incubare la miscela perle-campione a temperatura ambiente per 15 minuti. Dopo 7,5 minuti, mescolare delicatamente la sospensione e centrifugare brevemente il tubo.
- Centrifugare brevemente il tubo, posizionarlo su un supporto magnetico e incubare per 5 minuti per consentire una completa separazione delle perle. Rimuovere con attenzione e scartare il sopranatante limpido, quindi chiudere immediatamente il tubo.
- Aggiungere 400 µL di EtOH all'80%, incubare per 30 secondi e rimuovere l'EtOH. Aggiungere 200 µL di EtOH all'80%, incubare per 30 secondi e rimuovere l'EtOH.
- Rimuovere il tubo dal supporto magnetico e centrifugare brevemente. Riportare il tubo sul supporto magnetico, rimuovere qualsiasi residuo di EtOH e lasciare asciugare le perle all'aria per meno di 5 minuti.
- Aggiungere 50 µL di tampone TElow supplementato con oligonucleotidi carrier. Rimuovere il tubo dal supporto magnetico e risospendere completamente le perle mediante pipettaggio.
- Incubare la sospensione a temperatura ambiente per 5 minuti, mescolando occasionalmente. Centrifugare brevemente il tubo, riportarlo sul supporto magnetico e incubare per ulteriori 5 minuti.
- Durante gli ultimi 5 minuti della prima separazione magnetica, preparare un nuovo tubo da 1,5 mL a bassa adesività contenente 40 µL di perle magnetiche. Trasferire 50 µL dell'eluito nel tubo preparato per eseguire la seconda purificazione con un rapporto perle-campione di 0,8×.
- Mescolare accuratamente e incubare a temperatura ambiente per 15 minuti. Dopo 7,5 minuti, mescolare delicatamente la sospensione e centrifugare brevemente il tubo.
- Posizionare il tubo sul supporto magnetico e incubare per 5 minuti per consentire una completa separazione delle perle. Rimuovere con attenzione e scartare il sopranatante limpido, quindi chiudere immediatamente il tubo.
- Aggiungere 400 µL di EtOH all'80%, incubare per 30 secondi e rimuovere l'EtOH. Aggiungere 200 µL di EtOH all'80%, incubare per 30 secondi e rimuovere l'EtOH.
- Rimuovere il tubo dal supporto magnetico e centrifugare brevemente. Riportare il tubo sul supporto magnetico, rimuovere qualsiasi residuo di EtOH e lasciare asciugare le perle all'aria per meno di 5 minuti.
- Aggiungere 15,5 µL di Tris-HCl a ciascun campione. Rimuovere il tubo dal supporto magnetico e risospendere completamente le perle mediante pipettaggio.
- Incubare la sospensione a temperatura ambiente per 5 minuti, mescolando occasionalmente. Centrifugare brevemente il tubo, riportarlo sul supporto magnetico e incubare per ulteriori 5 minuti.
- Trasferire 15 µL dell'eluito in un nuovo tubo da 200 µL a bassa adesività. Prelevare 1 µL dell'eluito e diluirlo 1:10 in Tris-HCl per analisi di PCR quantitativa (qPCR) in attomoli e di arricchimento del DNA mitocondriale (mtDNA).
10. Stima nell'ordine degli attomoli
NOTA: Determinare la quantità approssimativa di DNA legato agli adattatori per regolare l'input di DNA e il numero di cicli utilizzati nei successivi PCR di amplificazione e indicizzazione. Poiché la quantità di campione è limitata, le misurazioni dirette della concentrazione potrebbero non essere affidabili; pertanto, stimare la quantità di DNA mediante qPCR. Analizzare i prodotti di amplificazione mediante elettroforesi su gel di agarosio per valutare la distribuzione delle dimensioni dei frammenti e rilevare i dimeri residui degli adattatori. I valori di Cq possono variare a seconda dei reagenti e dello strumento di PCR in tempo reale utilizzati. Le correzioni dei valori di Cq basate sul rilevamento dei dimeri di adattatori, così come le quantità di input di DNA a valle e il numero di cicli di PCR, si basano principalmente su osservazioni empiriche e potrebbero richiedere un'ottimizzazione per singole preparazioni di libreria.
- Preparare una miscela madre per qPCR di attomoli contenente 5 µL di 2× KAPA HiFi HotStart Reaction Mix (di seguito denominata miscela PCR ad alta fedeltà 2×), 1 µL del Dual-NEBNext Universal PCR Primer for Illumina (10 µM; di seguito denominato primer universale per libreria), 1 µL del primer mws20 (10 µM), 0,5 µL di EvaGreen 20× e 0,5 µL di acqua di grado per biologia molecolare per ogni reazione.
- Aggiungere 8 µL della miscela madre in ciascun pozzetto designato di una piastra 96 pozzetti compatibile con qPCR. Aggiungere 2 µL del campione diluito 1:10 per ottenere un volume finale di reazione di 10 µL.
- Sigillare la piastra e centrifugarla brevemente prima di inserirla nell'apparecchio di PCR in tempo reale.
- Eseguire la qPCR utilizzando le seguenti condizioni di termociclaggio: 45 s a 98°C, seguiti da 45 cicli di 15 s a 98°C, 30 s a 65°C e 45 s a 72°C.
- Determinare il ciclo di quantificazione (Cq) impostando la soglia di fluorescenza a 1.000 unità di fluorescenza relative (RFU).
NOTA: Selezionare una soglia di fluorescenza compatibile con l'apparecchio di PCR in tempo reale e utilizzare la stessa soglia in tutti gli esperimenti per consentire il confronto dei valori di Cq. - Separare i prodotti di amplificazione della qPCR su un gel di agarosio al 1,5% a 125 V per 40 minuti.
- Controllare il gel alla ricerca di dimeri di adattatori residui. I dimeri di adattatori migrano a circa 130 pa (Figura 2).
- Se i dimeri di adattatori sono visibili, correggere il valore di Cq utilizzando il fattore di correzione del Cq in attomoli (ACF) appropriato indicato in Figura 2. Selezionare l'ACF in base all'intensità della banda del dimero di adattatori osservata nel gel di agarosio, utilizzando gli esempi rappresentativi in Figura 2 come riferimento. Un valore di Cq in attomoli corretto con ACF compreso tra 22 e 26 è ottimale; tuttavia, valori <29 sono generalmente accettabili.
NOTA: In alternativa alla correzione del valore di Cq, se necessario può essere effettuata un'ulteriore purificazione; tuttavia, ciò potrebbe comportare una notevole perdita di libreria. I campioni con bande forti di dimeri di adattatori sono tipicamente associati a valori elevati di Cq in attomoli nella qPCR, indicativi di un basso quantitativo di DNA in ingresso. I campioni con valori di Cq ≥29 producono generalmente famiglie di ampliconi di grandi dimensioni e basse profondità di sequenziamento del DNA mitocondriale (<100×) e potrebbero pertanto essere esclusi dal sequenziamento. Poiché i valori di Cq dipendono dall'apparecchio di PCR in tempo reale e dalle condizioni del saggio, è consigliabile stabilire valori di soglia specifici per il laboratorio durante l'implementazione di questo protocollo.
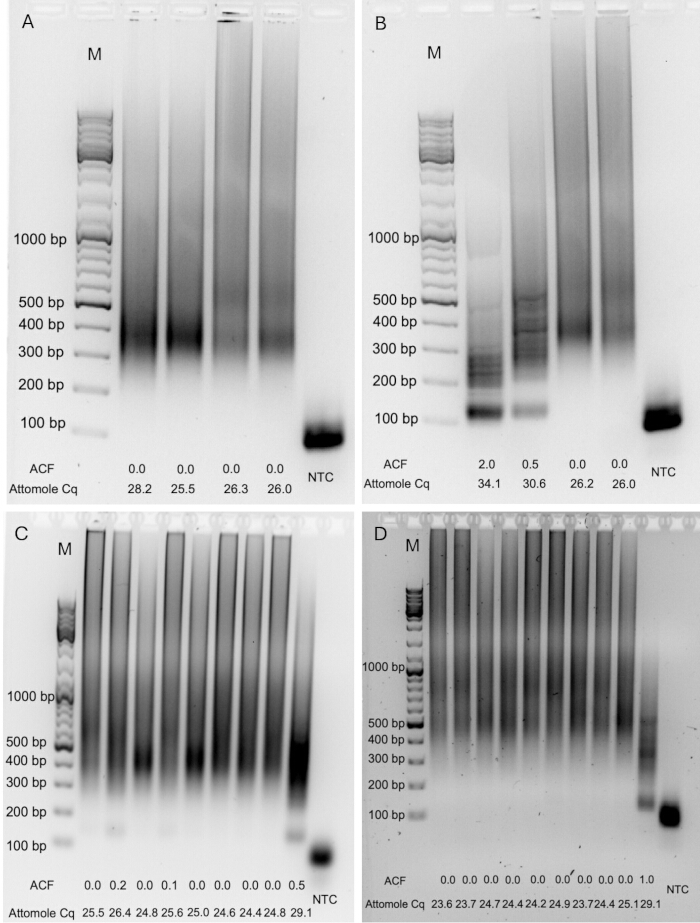
Figura 2. Prodotti rappresentativi di reazione a catena della polimerasi quantitativa nell'ordine degli attomoli (qPCR) utilizzati per stimare l'input della libreria e identificare i dimeri di adattatore/innesco. I prodotti qPCR nell'ordine degli attomoli sono stati analizzati mediante elettroforesi su gel di agarosio al 1,5% per valutare la distribuzione delle dimensioni dei frammenti e rilevare la presenza di dimeri residui di adattatore/innesco. (A–D) Esempi rappresentativi che mostrano librerie con diverse quantità di DNA legato all'adattatore e livelli variabili di dimeri di adattatore/innesco. Per ogni campione è riportato il fattore di correzione del ciclo di quantificazione nell'ordine degli attomoli (ACF) e il corrispondente ciclo di quantificazione non corretto (Cq). M, marcatore di dimensione del DNA; NTC, controllo senza stampo. Cliccare qui per visualizzare una versione ingrandita di questa figura.
11. Stima dell'arricchimento del DNA mitocondriale (Opzionale)
NOTA: Stimare l'arricchimento del DNA mitocondriale (mtDNA) mediante qPCR utilizzando primer specifici per il gene mitocondriale ND6 e per gli elementi nucleari Alu. Calcolare la differenza nei valori di Cq tra le sequenze nucleari e mitocondriali per stimare l'arricchimento del mtDNA. Utilizzare il valore assoluto di Cq della sequenza mitocondriale per stimare la quantità di mtDNA presente nel campione. I valori di Cq possono variare a seconda dei reagenti, dei materiali monouso e dello strumento di PCR in tempo reale utilizzato. Adattare le sequenze dei primer per altre specie. Consultare le pubblicazioni precedenti per i primer specifici per il topo e il macaco12,13. Questo passaggio è facoltativo e fornisce una stima approssimativa dell'arricchimento del mtDNA prima del sequenziamento.
- Preparare miscele master separate per i bersagli mitocondriali e nucleari. Per ogni reazione, unire 5 µL di PowerUp SYBR Green Mix 2×, 0,4 µL di ciascun primer della coppia di primer corrispondente (10 µM ciascuno) e 2,1 µL di acqua di grado per biologia molecolare.
- Aggiungere 8 µL della rispettiva miscela master in ciascun pozzetto designato di una piastra qPCR da 96 pozzetti. Aggiungere 2 µL del campione diluito 1:10 per ottenere un volume finale di reazione di 10 µL.
- Sigillare la piastra e centrifugarla brevemente prima di inserirla nell'apparecchiatura di PCR in tempo reale.
- Eseguire la qPCR utilizzando le seguenti condizioni di termociclaggio: 2 min a 95°C, seguiti da 45 cicli di 15 s a 95°C, 20 s a 56°C e 30 s a 72°C.
- Determinare il Cq impostando la soglia di fluorescenza a 100 RFU.
NOTA: Selezionare una soglia di fluorescenza compatibile con l'apparecchiatura di PCR in tempo reale e utilizzare la stessa soglia in tutti gli esperimenti per consentire il confronto dei valori di Cq. Correlare i valori di Cq con le efficienze di arricchimento ottenute dal sequenziamento e utilizzare questi valori come riferimento per le preparazioni successive di librerie. - Calcolare il ΔCq associato all'arricchimento sottraendo il Cq del bersaglio nucleare da quello del bersaglio mitocondriale (CqmtDNA − CqnDNA). Una volta disponibili i dati iniziali di sequenziamento, generare una curva standard specifica per il laboratorio per stimare la proporzione di letture di sequenziamento derivate dal mtDNA.
NOTA: Se i dati di sequenziamento non sono ancora disponibili, Equazione 1 può essere utilizzata per ottenere una stima approssimativa della percentuale prevista di letture di sequenziamento derivate dal mtDNA, utilizzando una curva standard di esempio generata da sette librerie di ovociti (ΔCq = −0,8, 16,83%; ΔCq = −2,1, 33,62%; ΔCq = −3,0, 45,57%; ΔCq = −3,9, 60,34%; ΔCq = −5,0, 77,98%; ΔCq = −6,2, 89,25%; ΔCq = −8,4, 95,09%). Deve essere raggiunto un valore di ΔCq <−1 per garantire un'efficace rimozione del DNA nucleare. Efficienze di arricchimento inferiori possono essere compensate assegnando ulteriori letture di sequenziamento per ottenere una profondità di sequenziamento sufficiente del mtDNA; tuttavia, ciò potrebbe aumentare la contaminazione da segmenti nucleari di DNA mitocondriale (NUMT). Poiché la relazione tra ΔCq e contenuto di mtDNA dipende dai reagenti, dai materiali monouso, dall'apparecchiatura e dalle condizioni sperimentali, Equazione 1 deve essere considerata un esempio di calibrazione e, ogni volta possibile, devono essere stabilite curve standard specifiche per il laboratorio.
mtDNA stimato (%) = −11,006 × ΔCq + 13,776 (1)
12. Amplificazione della libreria
NOTA: Eseguire la prima amplificazione in due passaggi PCR consecutivi. Eseguire la prima PCR utilizzando un singolo primer per generare un'amplificazione lineare. Successivamente, aggiungere il secondo primer per consentire un'amplificazione esponenziale durante la seconda PCR.
- Determinare l'input di DNA per la prima PCR di amplificazione utilizzando i risultati della qPCR in attomoli.
- Per le librerie di singolo ovocita, utilizzare campioni con un valore di Cq nella qPCR in attomoli tipicamente superiore a 22. Se un campione presenta un valore di Cq inferiore, diluirlo fino a un valore di Cq di circa 22 seguendo la Tabella 3. Le librerie con valori di Cq ≥29 producono generalmente famiglie di ampliconi molto grandi e profondità di sequenziamento del mtDNA poco elevate, pertanto non sono consigliate per proseguire la preparazione della libreria o il sequenziamento.
- Preparare una miscela madre di amplificazione contenente 20 µL di miscela PCR ad alta fedeltà 2× e 4 µL del primer mws20 (10 µM) per ogni reazione.
- Aggiungere 24 µL della miscela madre di amplificazione a 14 µL del campione diluito.
- Eseguire la PCR di amplificazione lineare utilizzando le seguenti condizioni di termociclaggio: 45 s a 98°C, seguiti da 12 cicli di 15 s a 98°C, 30 s a 60°C e 45 s a 72°C, seguiti da 2 min a 72°C.
- Aggiungere 4 µL del primer universale per la libreria (10 µM) e mescolare accuratamente.
- Eseguire la PCR di amplificazione esponenziale utilizzando le seguenti condizioni di termociclaggio: 45 s a 98°C, seguiti da 9 cicli di 15 s a 98°C, 30 s a 65°C e 45 s a 72°C, seguiti da un'estensione di 2 min a 72°C.
NOTA: Al termine della prima amplificazione, i campioni possono essere conservati a 4°C e il protocollo può essere ripreso in un secondo momento, se necessario. Eseguire tutti i passaggi precedenti, dalla lisi dell'ovocita fino alla prima amplificazione, senza interruzioni. - Aggiungere 10 µL di acqua di grado per biologia molecolare a ciascun campione.
- Purificare il DNA amplificato utilizzando 40 µL di microsferette magnetiche (0,8× il volume del campione), seguendo la seconda procedura di purificazione con microsferette magnetiche descritta nei passaggi 9.9–9.15. Lavare le microsferette due volte con 200 µL di EtOH al 80%, eluire il DNA in 15,5 µL di Tris-HCl e trasferire 15 µL dell'eluato in una nuova provetta a bassa adesione da 200 µL.
NOTA: Questo rappresenta un punto di sosta adeguato. Conservare il DNA purificato a 4°C oppure procedere immediatamente all'indicizzazione.
Tabella 3: Fattori di diluizione e corrispondenti fattori di correzione del ciclo di quantificazione (Cq) della reazione a catena della polimerasi quantitativa (qPCR) utilizzati per standardizzare l'input di DNA nella prima reazione a catena della polimerasi (PCR) di amplificazione della libreria. I campioni con valori Cq qPCR in attomoli inferiori al valore target sono stati diluiti con acqua di grado per biologia molecolare prima della prima PCR di amplificazione. Il valore Cq corretto è stato ottenuto aggiungendo il fattore di correzione per la diluizione appropriato al valore Cq misurato sperimentalmente ed è stato successivamente utilizzato per determinare il numero di cicli della PCR di indicizzazione e la profondità di sequenziamento target (Tabella 4). I volumi di campione e di acqua producono un volume finale di input di 14 µL per la prima PCR di amplificazione. L'asterisco (*) indica che il fattore di correzione per la diluizione elencato deve essere aggiunto al valore Cq qPCR in attomoli misurato sperimentalmente per ottenere il Cq corretto. I fattori di correzione sono stati determinati empiricamente per questo flusso di lavoro. Cliccare qui per scaricare questo file.
13. Indicizzazione
- Determinare il numero di cicli di PCR di indicizzazione utilizzando il valore di Cq della qPCR corretto per dimeri e diluizione, espresso in attomoli, secondo la Tabella 4.
- Preparare una miscela madre di indicizzazione contenente 25 µL di miscela PCR ad alta fedeltà 2× e 10 µL di una coppia di primer con doppio indicizzatore univoco (10 µM) per ogni campione.
- Aggiungere 35 µL della miscela madre di indicizzazione a 15 µL di ciascun campione amplificato.
- Eseguire la PCR di indicizzazione utilizzando le seguenti condizioni di termociclaggio: 45 s a 98°C, seguiti dal numero appropriato di cicli costituiti da 15 s a 98°C, 30 s a 65°C e 45 s a 72°C, seguiti da un'estensione finale a 72°C per 2 min.
- Purificare le librerie indicizzate utilizzando 40 µL di microsferette magnetiche (0,8× volume del campione). Lavare le microsferette due volte con EtOH al 80% ed eluire il DNA in 21 µL di tampone TElow.
- Trasferire l'eluito in una provetta a bassa adesione per DNA.
- Misurare la concentrazione di DNA utilizzando un saggio Qubit per DNA ad alta sensibilità o un saggio fluorimetrico equivalente.
- Conservare le librerie a 4°C prima del sequenziamento o a −80°C per il congelamento a lungo termine.
NOTA: Questo rappresenta un punto di arresto sicuro.
Tabella 4: Numero di cicli della reazione a catena della polimerasi (PCR) per l'indicizzazione e profondità di sequenziamento target determinati a partire dal ciclo di quantificazione (Cq) corretto della PCR quantitativa (qPCR) espressa in attomoli. Il valore di Cq corretto incorpora il valore sperimentale di Cq della qPCR in attomoli insieme a qualsiasi fattore di correzione per dimeri di adattatori (Figura 2) e al fattore di correzione per diluizione (Tabella 3). Il valore di Cq corretto è stato utilizzato per determinare sia il numero di cicli della PCR di indicizzazione sia il numero raccomandato di letture di sequenziamento in lettura accoppiata da assegnare a ciascuna libreria prima del pooling. Le assegnazioni target delle letture di sequenziamento costituiscono una linea guida iniziale e potrebbero richiedere un'ottimizzazione specifica per ciascun laboratorio, in base allo strumento di PCR in tempo reale, alla piattaforma di sequenziamento, alla strategia di multiplexing e ai requisiti sperimentali. Cliccare qui per scaricare questo file.
14. Controllo di qualità
- Valutare la qualità della libreria, la distribuzione delle dimensioni dei frammenti e la presenza di dimeri residui di adattatori o primer mediante un Bioanalyzer, TapeStation o uno strumento equivalente per l'analisi dei frammenti di acidi nucleici. Le dimensioni dei frammenti dovrebbero variare approssimativamente tra 300 e 1.000 bp. Picchi residui di piccole dimensioni (<5% dell'intensità di fluorescenza del campione [RFU] nel tracciato del Bioanalyzer) erano generalmente accettabili (Figura 3A–D). I dimeri residui di adattatori o primer apparivano come picchi distinti a circa 70–150 bp (Figura 3E–H). La concentrazione finale della libreria dovrebbe essere almeno 5 ng/µL. Consultare il File Supplementare 1 (Guida alla risoluzione dei problemi) se uno o più di questi criteri di qualità non sono soddisfatti.
- (Facoltativo) Se vengono rilevati dimeri di adattatori o primer (Figura 3E–H), portare il volume della libreria a 50 µL con acqua di grado per biologia molecolare, aggiungere 40 µL di perle magnetiche (0,8× volume del campione) ed eseguire un'ulteriore purificazione. Lavare le perle due volte con EtOH al 80% ed eluire la libreria purificata in 21,5 µL di tampone TElow.
- (Facoltativo) Ripetere l'analisi di controllo qualità (Passaggio 14.1) per confermare la completa rimozione dei dimeri di adattatori e primer.
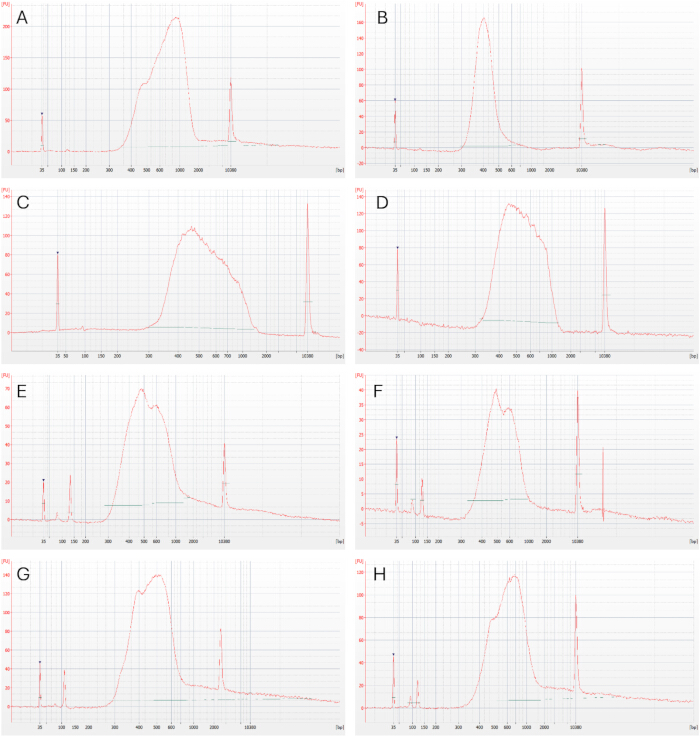
Figura 3. Analisi rappresentativa dei frammenti di librerie di sequenziamento con codici identificativi. Elettroferogrammi rappresentativi ottenuti mediante l'analisi dei frammenti con Bioanalyzer, che mostrano la qualità delle librerie dopo la PCR di indicizzazione. (A–D) Librerie con distribuzione delle dimensioni dei frammenti prevista (circa 300-1000 bp) e senza dimeri di adattatore/innesco rilevabili, adatte al sequenziamento senza ulteriore purificazione. (E–H) Librerie contenenti dimeri residui di adattatore e/o innesco che richiedono un'ulteriore purificazione con perle magnetiche prima del sequenziamento. I picchi a circa 35 bp e 10.380 bp corrispondono rispettivamente ai marcatori interni inferiore e superiore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
15. Unione e sequenziamento
- Misurare la concentrazione di ciascuna libreria indicizzata utilizzando un saggio di quantificazione basato su qPCR compatibile con librerie preparate per Illumina, come il Collibri Library Quantification Kit, seguendo il protocollo del produttore. Diluire ogni libreria 1:100.000 nel tampone di diluizione fornito e analizzare ogni campione in almeno duplicato; si consiglia l'analisi in triplicato. Analizzare gli standard in triplicato.
- Calcolare il valore medio del ciclo di quantificazione (Cq) per ciascun campione e standard. Generare una curva standard a partire dai valori medi di Cq degli standard e calcolare la concentrazione di ciascuna libreria seguendo le istruzioni del produttore.
- Unire le librerie in base al numero previsto di letture appaiate determinato dal valore di Cq in attomoli corretto per la presenza di dimeri di adattatore e diluizione ottenuto al Passaggio 10 e alle allocazioni indicate in Tabella 4.
NOTA: Il rapporto di unione dipende dal valore di Cq corretto di ciascuna libreria di ovociti e dal corrispondente numero target di letture appaiate. I valori riportati in Tabella 4 sono approssimativi e possono variare tra diversi strumenti di PCR in tempo reale. Stabilire valori specifici per il laboratorio per ottenere prestazioni ottimali. - Calcolare la frazione relativa di unione per ciascuna libreria dividendo il suo numero target di letture appaiate per la somma dei letture target assegnate a tutte le librerie. Determinare la quantità necessaria di ciascuna libreria moltiplicando questa frazione per la quantità molare totale del pool finale, quindi calcolare il volume corrispondente della libreria a partire dalla sua concentrazione molare misurata. Combinare i volumi calcolati per ottenere il pool finale.
- Sequenziare le librerie unite utilizzando una piattaforma di sequenziamento Illumina o un'altra piattaforma compatibile con le sequenze adattatrici Illumina. Utilizzare una configurazione a letture appaiate con una lunghezza minima di 2 × 150 bp. Si raccomandano letture più lunghe, come 2 × 250 o 2 × 300 bp, poiché migliorano la capacità di identificare e filtrare le letture derivate da segmenti nucleari di DNA mitocondriale più corti (NUMTs).
- Sequenziare le librerie unite, ad esempio su una piattaforma Illumina NovaSeq 6000 utilizzando una chimica di sequenziamento basata sulla sintesi a due canali con un kit di reagenti SP v1.5 (500 cicli) e una configurazione a letture appaiate di 2 × 250 bp, inclusa un'integrazione del 5% di PhiX. Caricare la libreria ed eseguire il sequenziamento seguendo le istruzioni del produttore. Le prestazioni tipiche del sequenziamento dovrebbero raggiungere almeno il 75% di basi con un punteggio qualitativo ≥Q30 e almeno il 60% di cluster che superano il filtro.
16. Analisi bioinformatica
NOTA: Il seguente flusso di lavoro descrive l'analisi dei dati in Galaxy utilizzando gli strumenti di analisi Du Novo8,14,15. L'analisi può essere eseguita anche mediante un'installazione locale di Du Novo o di altri software sviluppati per dati di sequenziamento duplex.
- Caricare i file FASTQ appaiati demultiplexati, generati utilizzando BCL Convert o uno strumento di demultiplexing equivalente, su un'installazione locale di Galaxy o su un'istanza pubblica di Galaxy14.
- Valutare la qualità delle letture di sequenziamento utilizzando FastQC (versione Galaxy 0.72+galaxy1). Esaminare, al minimo, i moduli Qualità della Sequenza per Base, Contenuto GC per Sequenza e Contenuto di Adattatori.
- Generare sequenze di consenso a singolo filamento (SSCS) e sequenze di consenso a doppio filamento (DCS) dai file FASTQ appaiati demultiplexati utilizzando la pipeline Du Novo (versione Galaxy 3.0.2). Utilizzare una dimensione minima della famiglia di tre letture per la formazione delle SSCS e chiamare un nucleotide di consenso quando è presente in almeno il 70% delle letture15. Abilitare la correzione degli errori nei barcode con fino a tre discrepanze. Fare riferimento al tutorial Du Novo della Galaxy Training Network per istruzioni dettagliate sull'utilizzo della pipeline16.
- Utilizzare Sequence Content Trimmer (versione Galaxy 0.2.3) per rimuovere le basi rappresentate da “NRYSWKMBDHV” e scartare le letture più corte di 10 bp.
- Tagliare i primi 10 nucleotidi dall'estremità 5′ di ogni DCS utilizzando FASTQ Trimmer (versione Galaxy 1.1.5) per ridurre il bias associato alla riparazione delle estremità. Allineare le letture DCS tagliate al genoma di riferimento umano, come GRCh38.p14 contenente la revised Cambridge Reference Sequence (rCRS; NC_012920.1), utilizzando BWA-MEM (versione Galaxy 0.7.17.1).
NOTA: Possono essere utilizzati altri assemblaggi del genoma umano, inclusi T2T-CHM13v2.0 o assemblaggi più recenti. - Filtrare i file BAM utilizzando BAMTools Filter BAM datasets su una varietà di attributi (versione Galaxy 2.5.2+galaxy1). Mantenere le letture con qualità di mappatura >20 che si allineano a chrM, rappresentano allineamenti primari, sono appaiate, sono correttamente appaiate e hanno un compagno mappato. Questi criteri riducono i potenziali allineamenti derivati da NUMT17.
- Allineare a sinistra le letture utilizzando Bam Left Align (versione Galaxy 1.3.1). Rimuovere le regioni sovrapposte delle letture DCS appaiate utilizzando BAMUtil clipOverlap (versione Galaxy 1.0.15+galaxy1).
- Chiamare varianti a singolo nucleotide (SNV) e inserzioni/cancellazioni (indel) utilizzando Call variants with LoFreq (versione Galaxy 2.1.5+galaxy2) con le impostazioni predefinite.
- Escludere le letture DCS appaiate contenenti più di due varianti, se presenti, per ridurre la potenziale contaminazione da NUMT. I campioni con un arricchimento efficiente del mtDNA sono tipicamente privi di letture derivanti da NUMT rilevabili; tuttavia, un'esaurimento insufficiente del DNA nucleare può portare a sequenze derivate da NUMT.
- Esaminare ogni libreria per potenziale contaminazione incrociata tra campioni utilizzando differenze specifiche della sequenza mtDNA del donatore, inclusi varianti fissi e eteroplasmie ad alta frequenza. Se viene rilevata contaminazione incrociata, applicare le precauzioni descritte nel File Supplementare 1 (Guida alla Risoluzione dei Problemi). Se la distribuzione delle dimensioni dei frammenti supera l'intervallo raccomandato o la dimensione media del frammento è >900 bp, eseguire una purificazione doppia selettiva per dimensione come descritto in precedenza18.
- Eseguire analisi successive sulle varianti rilevate in base agli obiettivi dello studio.
- Includere solo i campioni con una profondità media di sequenziamento mitocondriale DCS di ≥100× per le analisi successive. Non sono stati applicati valori soglia minimi fissi per il numero di letture appaiate o per il rendimento di SSCS o DCS.
Risultati
Le librerie di sequenziamento duplex sono state preparate da ovociti umani rappresentativi di diverse fasi di maturazione, inclusi ovociti allo stadio di vescicola germinale (GV), metafase I (MI), MII, stadio pronucleare (0PN) e TI. Le librerie preparate con successo sono state sottoposte a sequenziamento su una piattaforma Illumina NovaSeq 6000 utilizzando una flow cell SP con letture appaiate di 2 × 250 bp. L'analisi dei dati è stata eseguita in Galaxy utilizzando la pipeline Du Novo per il raggruppamento delle famiglie di letture e la generazione di letture di consenso8,14,15. Le metriche rappresentative del sequenziamento per le librerie processate con successo sono riassunte nella Tabella Supplementare 1, mentre i campioni che hanno prodotto risultati subottimali durante la preparazione delle librerie e sono stati esclusi dal sequenziamento sono riassunti nella Tabella Supplementare 2.
Sono stati eseguiti diversi passaggi di controllo qualità durante la preparazione della libreria per valutare la quantità di DNA legato agli adattatori, l'arricchimento del mtDNA, la concentrazione della libreria e la distribuzione delle dimensioni dei frammenti. Il primo passaggio di controllo qualità è stato il saggio qPCR in attomoli, utilizzato per stimare la quantità di DNA legato agli adattatori (Figura 4A,B). Il valore di ciclo di quantificazione (Cq) calcolato è stato corretto quando sono stati rilevati dimeri di adattatori o primer mediante elettroforesi su gel di agarosio dei prodotti di amplificazione della qPCR (Figura 2A–D). I dimeri di adattatori o primer sono stati generalmente osservati in campioni con valori Cq più elevati, indicativi di una minore quantità di DNA legato agli adattatori. Utilizzando le condizioni descritte in questo protocollo, è stato ottenuto un valore medio corretto di Cq della qPCR in attomoli pari a 25,8 (Tabella Supplementare 1). Sulla base del valore Cq corretto, l'input di DNA per la prima PCR di amplificazione è stato regolato secondo lo schema di diluizione mostrato in Tabella 3. I campioni con valori Cq corretti di ≥22 sono stati utilizzati senza diluizione, mentre i campioni con valori Cq corretti di <22 sono stati diluiti prima dell'amplificazione. Questa regolazione è stata effettuata per ottimizzare la dimensione delle famiglie di letture e ridurre il numero di letture di sequenziamento necessarie. I campioni con valori Cq corretti di >28 hanno generalmente prodotto famiglie di letture più grandi (dimensione media della famiglia, 21,8), con conseguente riduzione del numero di DCS e una profondità media di sequenziamento del mtDNA di <200× (Tabella Supplementare 1). L'aggiustamento del valore Cq corretto a un intervallo compreso tra 22 e 28 ha portato a una dimensione media della famiglia di 7,91, valore prossimo alla dimensione di famiglia di circa sei precedentemente riportata come ottimale per il sequenziamento duplex6,7. Dimensioni di famiglia maggiori possono comunque risultare vantaggiose per campioni con input molto bassi, come singoli ovociti, poiché possono aumentare la profondità di sequenziamento.
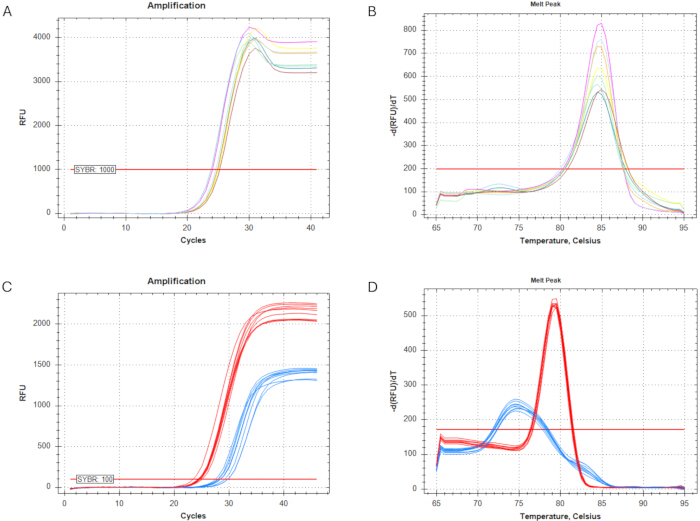
Figura 4. Saggi di PCR quantitativa (qPCR) utilizzati per la quantificazione della libreria e la stima dell'arricchimento del DNA mitocondriale (mtDNA). Il DNA legato agli adattatori purificato è stato diluito 1:10 prima dell'analisi qPCR. (A) Curve di amplificazione ottenute con il saggio qPCR in attomoli, utilizzato per stimare la quantità di DNA legato agli adattatori. La soglia di fluorescenza è stata impostata a 1.000 unità di fluorescenza relative (RFU). (B) Analisi della curva di denaturazione del saggio qPCR in attomoli. (C) Curve di amplificazione del saggio qPCR per la stima dell'arricchimento del mtDNA. La soglia di fluorescenza è stata impostata a 100 RFU. L'amplificazione della sequenza mitocondriale del gene della subunità 6 della NADH deidrogenasi (ND6) è mostrata in rosso, mentre l'amplificazione della sequenza nucleare dell'elemento ripetitivo Alu è mostrata in blu. (D) Analisi della curva di denaturazione dei prodotti qPCR mitocondriali e nucleari. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Prima del pooling delle librerie, tutte le librerie sono state analizzate mediante Bioanalyzer o TapeStation per valutare la distribuzione delle dimensioni dei frammenti e rilevare la presenza di dimeri residui di adattatori o primer. Esempi rappresentativi di librerie ottimali e di librerie contenenti dimeri residui di adattatori o primer sono mostrati nella Figura 3A–H. I dimeri di adattatori o primer comparivano come picchi a circa 70–150 bp (Figura 3E–H); quando rilevati, le librerie sono state sottoposte a un'ulteriore purificazione con perle magnetiche prima del sequenziamento. Poiché la selezione per dimensione è stata intenzionalmente omessa per minimizzare la perdita di campione, le librerie sequenziate presentavano una dimensione mediana dell'inserto di 275 bp (Tabella Supplementare 1).
L'arricchimento del mtDNA è stato stimato mediante qPCR utilizzando loci bersaglio mitocondriali e nucleari, permettendo di prevedere la proporzione di letture di sequenziamento attese per il genoma mitocondriale (Figura 4C,D). I valori medi di Cq sono stati 25,2 per il bersaglio mitocondriale e 29,7 per il bersaglio nucleare (Tabella Supplementare 1), corrispondenti a un ΔCq medio (CqmtDNA − CqnDNA) di −4,5. In media, il 67,5% delle letture di sequenziamento a estremità accoppiate si è mappato sul genoma di riferimento mitocondriale. Sia la stima di arricchimento del mtDNA sia il valore corretto di Cq in attomoli della qPCR sono stati considerati durante il raggruppamento delle librerie. Alle librerie con valori di Cq corretti più elevati e un arricchimento del mtDNA più efficiente è stato assegnato un numero proporzionalmente inferiore di letture di sequenziamento secondo lo schema di allocazione riportato in Tabella 4, al fine di promuovere un output di sequenziamento bilanciato tra i campioni.
Sulla base dei valori di Cq qPCR corretti in attomoli, è stato assegnato un numero medio di 4 milioni di letture paired-end per libreria (Tabella 4). A causa di una generazione inefficiente di cluster, dopo il sequenziamento si è ottenuta una media di 1,3 milioni di letture paired-end per libreria; tuttavia, questo rendimento di sequenziamento è stato sufficiente per l'analisi successiva di sequenziamento duplex (Tabella Supplementare 1). Il mappaggio delle DCS sul genoma mitocondriale di riferimento ha prodotto una profondità mediana di sequenziamento di 567× lungo l'intero genoma mitocondriale (Figura 5A,B,D; Tabella Supplementare 1). In media, per ogni libreria sono stati generati 344.554 SSCS e 96.322 DCS (Tabella Supplementare 1). Le libreria risultanti avevano una dimensione media della famiglia di letture di 8,32, con dimensioni di famiglia maggiori generalmente osservate nelle libreria con valori di Cq qPCR corretti in attomoli più elevati (Figura 5C,E; Tabella Supplementare 1). Questi risultati sono coerenti con quelli ottenuti in uno studio precedente effettuato a densità ottimale di cluster, in cui è stata raggiunta una profondità mediana di sequenziamento del mtDNA di 1.440×19.
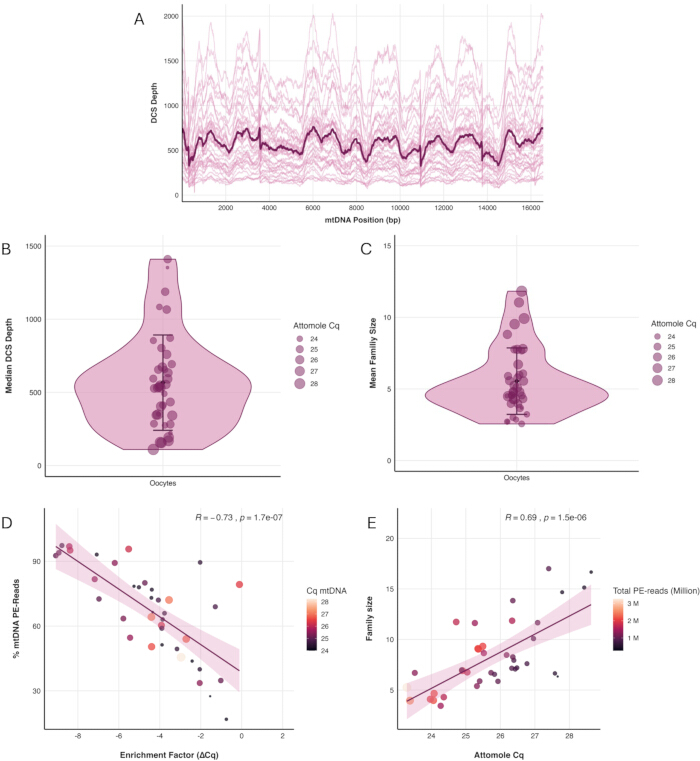
Figura 5. Prestazioni del sequenziamento di librerie di sequenziamento duplex da singolo oocita. (A) Profondità della sequenza consenso duplex (DCS) lungo il genoma mitocondriale. Le linee sottili rappresentano librerie individuali, mentre la linea spessa rappresenta la profondità media su tutte le librerie. (B) Distribuzione della profondità mediana DCS per librerie individuali. (C) Distribuzione della dimensione media della famiglia DCS per librerie individuali. Nei grafici (B) e (C), ogni punto rappresenta una libreria, e il colore del punto indica il ciclo di quantificazione qPCR in attomoli (Cq). (D) Correlazione di Pearson tra la stima dell'arricchimento di mtDNA (ΔCq) e la proporzione di letture di sequenziamento allineate al genoma di riferimento mitocondriale. (E) Correlazione di Pearson tra il valore Cq qPCR in attomoli e la dimensione media della famiglia DCS. Nei grafici (D) ed (E), ogni punto rappresenta una libreria; il colore del punto indica il valore Cq qPCR in attomoli, e la dimensione del punto rappresenta il numero totale di letture appaiate ottenute per quella libreria. n = 39 librerie. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella supplementare 1. Metriche di sequenziamento e qualità delle librerie per le librerie di sequenziamento duplex ottimali di ovociti umani. Questa tabella riassume le metriche di qualità delle librerie pre-sequenziamento, le misurazioni della reazione a catena della polimerasi quantitativa (qPCR), le prestazioni di sequenziamento e i risultati dell'analisi di sequenziamento duplex per le librerie che hanno superato il controllo di qualità ed sono state incluse nelle analisi successive. I parametri riportati includono lo stadio di sviluppo dell'ovocita, i risultati della qPCR per l'arricchimento del DNA mitocondriale (mtDNA), le misurazioni qPCR in attomoli, il fattore di correzione per i dimeri di adattatore (ACF), il numero di cicli di PCR per l'indicizzazione, la profondità di sequenziamento paired-end prevista, la concentrazione della libreria, il rendimento del sequenziamento, l'arricchimento del mtDNA, i conteggi di letture delle sequenze consenso a singolo filamento (SSCS) e delle sequenze consenso duplex (DCS), le statistiche sulla dimensione delle famiglie, la profondità di sequenziamento e le distribuzioni delle dimensioni degli inserti. Gli identificatori dei campioni sono stati anonimizzati prima dell'analisi. I numeri previsti di letture paired-end sono stati assegnati in base al valore corretto del ciclo di quantificazione (Cq) della qPCR in attomoli (Tabella 4). Cliccare qui per scaricare il file.
Tabella supplementare 2. Metriche di qualità pre-sequenziamento per le librerie di ovociti umani non ottimali escluse dalle analisi di sequenziamento duplex successive. Questa tabella riassume i risultati del controllo di qualità pre-sequenziamento per le librerie che non hanno soddisfatto i criteri di inclusione nelle analisi di sequenziamento successive. I parametri riportati includono l'identificativo del campione, lo stadio di sviluppo dell'ovocita, i risultati della reazione a catena della polimerasi quantitativa (qPCR) per l'arricchimento del DNA mitocondriale (mtDNA), il fattore di correzione per i dimeri di adattatore (ACF), il ciclo di quantificazione qPCR corretto in attomoli (Cq), il numero di cicli di PCR per l'indicizzazione e la concentrazione della libreria misurata mediante il saggio Qubit High Sensitivity DNA Assay. Le librerie sono state escluse in base ai criteri di controllo qualità descritti nel protocollo. Cliccare qui per scaricare questo file.
File supplementare 1. Guida alla risoluzione dei problemi per la preparazione delle librerie di sequenziamento mitocondriale duplex da singolo ovocita. Questo file supplementare fornisce raccomandazioni per la risoluzione dei problemi relativi alle fasi critiche del flusso di lavoro, inclusa la prevenzione della perdita di campioni, la preparazione e la valutazione della qualità degli adattatori, la purificazione con perle magnetiche, il controllo di qualità delle librerie, le prestazioni del sequenziamento, la contaminazione incrociata tra campioni e la contaminazione da segmenti nucleari di DNA mitocondriale (NUMT). La guida integra il protocollo principale e deve essere consultata quando le metriche di qualità delle librerie o le prestazioni del sequenziamento risultano al di fuori degli intervalli raccomandati. Cliccare qui per scaricare il file.
Discussione
Le varianti del DNA mitocondriale identificate negli ovociti riflettono una combinazione di mutagenesi de novo, variazioni nell'eteroplasmia attraverso le generazioni e gli effetti dell'invecchiamento e delle malattie sulla linea germinale femminile. Questo protocollo descrive un metodo per l'arricchimento del DNA mitocondriale da singoli ovociti, seguito dalla preparazione della libreria per il sequenziamento duplex e dal sequenziamento, consentendo la rilevazione e l'analisi altamente accurata delle mutazioni del DNA mitocondriale. Nonostante il numero elevato di copie del DNA mitocondriale presenti negli ovociti, questo flusso di lavoro richiede la preparazione completa di una libreria di sequenziamento a partire da una singola cellula. Di conseguenza, una manipolazione accurata del campione è essenziale durante tutta la procedura, come descritto in dettaglio nel Supplementary File 1 (Troubleshooting Guide). Nonostante una manipolazione accurata del campione, circa il 5% delle preparazioni di libreria potrebbe fallire a causa della perdita dell'ovocita durante le fasi iniziali di manipolazione o della perdita del campione durante la preparazione della libreria.
Il controllo di qualità durante e dopo la preparazione della libreria è essenziale per verificare un'efficace ligazione degli adattatori, valutare l'arricchimento del DNA mitocondriale, ottimizzare l'input di DNA per l'amplificazione, rilevare la presenza residua di adattatori o dimeri di primer e determinare se siano necessari ulteriori passaggi di purificazione o amplificazione. L'utilizzo dello stesso strumento di qPCR in tempo reale per tutte le preparazioni di libreria garantisce condizioni di reazione costanti e migliora la comparabilità, la riproducibilità e l'affidabilità delle misurazioni impiegate per il controllo di qualità successivo e l'ottimizzazione del protocollo. I numeri di cicli PCR per l'amplificazione della libreria e l'aggiunta degli indici descritti in questo protocollo potrebbero richiedere aggiustamenti qualora venissero utilizzati strumenti, enzimi o reagenti diversi. Il primo passaggio di amplificazione è suddiviso in una fase di amplificazione lineare mediante un singolo primer, seguita da un'amplicazione esponenziale dopo l'aggiunta del secondo primer. Questa strategia riduce al minimo la probabilità che errori introdotti durante il primo ciclo di amplificazione vengano amplificati a livelli tali da risultare difficili da distinguere da vere mutazioni del DNA. I numeri di cicli raccomandati sono stati scelti per ottenere una dimensione ottimale delle famiglie di letture per l'analisi di sequenziamento duplex; tuttavia, potrebbero richiedere un'ottimizzazione in base alla quantità e alla qualità del DNA in ingresso. Campioni con un input di DNA più basso potrebbero richiedere un numero maggiore di cicli di amplificazione, mentre campioni con un input di DNA più elevato potrebbero necessitare di un numero inferiore di cicli per evitare un'eccessiva amplificazione e preservare la complessità della libreria.
Sebbene questo protocollo sia dimostrato utilizzando singoli ovociti umani, il flusso di lavoro non è limitato a campioni umani. Abbiamo precedentemente applicato lo stesso approccio per studiare la mutagenesi nella linea germinale di topi e macachi12,13, indicando che la preparazione delle librerie per il duplex sequencing è applicabile agli ovociti di molte specie, previa ottimizzazione delle sequenze dei primer specifiche per ciascuna specie e, ove necessario, di altri parametri sperimentali. Nonostante l'ampia applicabilità del duplex sequencing, il protocollo di arricchimento del DNA mitocondriale e di preparazione delle librerie descritto qui non è facilmente trasferibile a singole cellule somatiche, poiché il numero di copie del DNA mitocondriale in queste cellule è tipicamente inferiore di diversi ordini di grandezza rispetto a quello degli ovociti, limitando così la quantità di DNA disponibile come input per la preparazione delle librerie. Tuttavia, le librerie per il duplex sequencing possono essere generate da campioni bulk di cellule somatiche quando combinate con un arricchimento ottimizzato del DNA mitocondriale prima della preparazione delle librerie. Un'altra limitazione del duplex sequencing è la necessità di frammentare il DNA, procedura che può introdurre errori artifatti, in particolare vicino alle estremità dei frammenti. Di conseguenza, le basi localizzate alle estremità dei frammenti sono solitamente escluse dalle analisi successive e il rilevamento e la caratterizzazione di inserzioni e delezioni possono essere influenzati dal processo di frammentazione. I recenti progressi nelle tecnologie di sequenziamento a lettura lunga, in particolare quelle sviluppate da Oxford Nanopore Technologies, potrebbero in futuro consentire un sequenziamento altamente accurato di intere molecole di DNA mitocondriale senza frammentazione. Tuttavia, al momento l'ottenimento dell'accuratezza necessaria per un rilevamento affidabile delle mutazioni dipende dall'analisi di molecole di DNA native, non amplificate. Poiché la quantità di DNA presente in un singolo ovocita è insufficiente per questi approcci, la loro applicazione a questo tipo di campione è attualmente impraticabile.
Rispetto agli approcci utilizzati in studi precedenti, tra cui la PCR a lungo raggio e il sequenziamento convenzionale massicciamente parallelo20,21,22, questo protocollo offre diversi vantaggi. Ogni passaggio di amplificazione comporta il rischio di introdurre mutazioni artefattuali che possono ostacolare il rilevamento di varianti a bassa frequenza, spesso rendendo necessari soglie di frequenza dell'allele minore di almeno l'1%. Al contrario, il tasso di errore notevolmente inferiore ottenuto con il sequenziamento duplex migliora l'accuratezza nell'identificazione delle mutazioni e supera quello degli approcci di sequenziamento convenzionali5. Di conseguenza, questo metodo fornisce un quadro più affidabile per il rilevamento e la quantificazione di mutazioni rare del DNA mitocondriale. Utilizzando questo flusso di lavoro, in precedenza abbiamo dimostrato che, a differenza della maggior parte dei tessuti somatici, gli ovociti sfuggono in gran parte all'accumulo di mutazioni del DNA mitocondriale legato all'età19. Se questo effetto protettivo apparente si mantiene in condizioni patologiche che alterano il microambiente ovarico, come l'endometriosi, e compromettono la qualità degli ovociti, rimane sconosciuto e richiede ulteriori indagini.
Dichiarazioni
Gli autori dichiarano di non avere interessi concorrenti.
Ringraziamenti
Ringraziamo sinceramente il team del Centro di Fecondazione In Vitro dell'Ospedale Universitario Kepler di Linz per il supporto fornito nella raccolta degli ovociti. Ringraziamo inoltre N. Stoler e A. Nekrutenko per aver sviluppato l'istanza di analisi duplex sequencing su Galaxy e per aver fornito indicazioni sull'analisi dei dati. Questo lavoro è stato sostenuto dalla borsa di studio Schrödinger del Fondo Austriaco per la Scienza (FWF) (DOI: 10.55776/J4096; BA) e dal progetto autonomo FWF (DOI: 10.55776/P36928; BA). KDM è stato sostenuto in parte da una sovvenzione degli Istituti Nazionali di Salute R01GM116044 e dal Willaman Chair Endowment Fund del College di Scienze Eberly presso la Pennsylvania State University.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| 96 Coppie di Primer con Doppio Indice Unico | New England Biolabs | E6440S/L | Coppie uniche di primer con doppia indicizzazione per la PCR |
| Etanolo assoluto, grado biologia molecolare, 96% | Fisher BioReagents | 15518181 | Preparare etanolo al 80% fresco utilizzando acqua di grado per biologia molecolare |
| Agarosio, bassa elettroendosmosi | Biozym | 840000 | Per la preparazione di gel di agarosio al 1,5% e al 2% |
| Soluzione di acetato di ammonio, 5 M | Thermo Fisher Scientific | J60688.AD | Utilizzato per la precipitazione con etanolo |
| ATP, 10 mM | New England Biolabs | P0756S/L | Utilizzato per la digestione con Esoneucleasi V |
| Strumento per elettroforesi automatizzata | Agilent Technologies | G2992AA | È stato utilizzato l'Agilent 2100 Bioanalyzer, ormai fuori produzione; è possibile utilizzare un 4150 TapeStation o uno strumento equivalente per l'analisi dei frammenti di acidi nucleici. |
| Kit Bioanalyzer per DNA ad alta sensibilità | Agilent Technologies | 5067-4626 | Per la valutazione della distribuzione dimensionale della libreria e dei dimeri di adattatore/innesco |
| Oligonucleotide vettore | Integrated DNA Technologies (IDT) | Sintesi su misura | Sequenza non complementare al genoma umano. Un esempio di sequenza è riportato nella Tabella 2. Preparare una soluzione madre di 100 nM e diluire a una concentrazione finale di 1 nM. |
| Sistema di rilevamento PCR in tempo reale CFX96 Touch | Bio-Rad | 12011319 | Lo strumento utilizzato in questo studio non è più in produzione; può essere utilizzato un termociclatore CFX Opus 96 o uno strumento equivalente per PCR in tempo reale, anche se i valori di Cq potrebbero variare. |
| Collibri Library Quantification Kit | Invitrogen | A38524100 | Per la quantificazione delle librerie con indice prima dell'aggregazione |
| Mezzo per la rimozione delle cellule del cumulo contenente ialuronidasi (80 U/mL) | Gynemed | 4 HY 0010 | GM501 Ialuronidasi |
| tubo PCR a basso legame per DNA 200 µL | Corning | PCR-02-L-C | Tubo Axygen Maximum Recovery |
| Tubo a bassa adesione per DNA, 0,5 mL | Biozym | 710136 | |
| Tubo a bassa adesione per DNA, 1,5 mL | Biozym | 710176 | |
| DNA Polimerasi I, frammento grande (Klenow) (5 U/µL) | New England Biolabs | M0210S/L | Utilizzato durante l'estensione dell'adattatore |
| Miscela di dNTP (dATP, dCTP, dGTP e dTTP in equimolarità), 10 mM | New England Biolabs | N0447S/L | Utilizzato durante l'estensione dell'adattatore |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Componente dei tamponi TE e TElow |
| EvaGreen dye, 20× | Biotium | 31077-T | Utilizzato in qPCR attomolari |
| Esonucleasi V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Utilizzato per la digestione del DNA lineare |
| Pettingine ad altezza fissa | Bio-Rad | 1704446EDU | Per elettroforesi su gel di agarosio |
| Strumento per l'ultrasonificazione focalizzata | Covaris | 500295 | M220 ultrasonificatore focalizzato |
| tubo per ultrasonificazione focalizzata 50 µL | Covaris | 520166 | microTUBE-50 AFA Fiber Screw-Cap |
| Colorante per caricamento in gel, 6x× | Thermo Fisher Scientific | R1161 | TriTrack DNA Loading Dye |
| Olio minerale GM501 | Gynemed | 4 MO 0100 | Utilizzato per sovrapporre il mezzo di raccolta degli ovociti al fine di prevenire l'evaporazione e mantenere condizioni di coltura sterili e stabili, inclusi temperatura, osmolarità e pH, durante la manipolazione degli ovociti |
| High-fidelity PCR Mix, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Kit per saggio del DNA fluorometrico ad alta sensibilità | Invitrogen | Q32854 | Kit per saggio Qubit dsDNA ad alta sensibilità |
| Enzima di restrizione HpyCH4III (5 U/µL) | New England Biolabs | R0618S/L | Utilizzato per la digestione di restrizione con adattatori |
| Centrifuga da laboratorio, refrigerata | Eppendorf | 5406000313 | Deve supportare 14.000 × g a 4 °C |
| Sistema laser per l'apertura della zona pellucida | Vitrolife | 19310/0146 | Utilizzato per la rimozione del globulo polare |
| Kit per la preparazione di librerie | New England Biolabs | E7645S/L | NEBNext Ultra II DNA Library Prep Kit; include reagenti per la riparazione dei capi e l'aggiunta della coda poli-A (A-tailing) e per la ligazione |
| Soluzione di cloruro di magnesio, 25 mM | New England Biolabs | B9021S/L | Utilizzato per la digestione con Esoneucleasi V |
| Reagente per la purificazione con perle magnetiche | Beckman Coulter | A63881 | AMPure XP Beads |
| Supporto magnetico | Invitrogen | 12-321-D | Per la separazione con perline magnetiche |
| Micromanipolatore | Luigs & Neumann GmbH | SM II/2 | Utilizzato per la rimozione del globulo polare |
| Microscopio | Olympus | IX51 | Utilizzato per la rimozione del globulo polare |
| Acqua di grado per biologia molecolare | Thermo Fisher Scientific | 327290010 | Utilizzato per la preparazione e la diluizione dei reagenti |
| Mezzo di coltura per ovociti | Gynemed | 4 GM 501H-20 | Mezzo di coltura GM501 |
| Piastra PCR, 96 pozzetti | Biozym | AF4TI-0960-C | Pozzetti trasparenti, telaio trasparente, profilo basso, con bordo rialzato |
| Sigillo per piastra PCR | Bio-Rad | MSB1001B | Compatibile con lo strumento di PCR in tempo reale |
| Salina fosfato tampone (PBS), 20× | Cell Signaling Technology | 9808S | Diluire a 1× con acqua di grado per biologia molecolare |
| Pipette per la manipolazione e il trasferimento del cumulo–complessi oocitari (COCs) e oociti | CooperSurgical | MXL3-150 (150 µm) | Utilizzato per la rimozione meccanica delle cellule del cumulo e il trasferimento di COC e ovociti. Per ulteriori dimensioni delle pipette, consultare il sito web del produttore. |
| Alimentatore per elettroforesi su gel | Bio-Rad | 1645050 | Alimentatore PowerPac Basic |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Utilizzato per saggi di qPCR mitocondriali e nucleari |
| Fluorimetro Qubit | Invitrogen | Q33238 | È stato utilizzato il fluorimetro Qubit 1, ormai fuori produzione; può essere usato un modello più recente o uno strumento equivalente per la quantificazione fluorimetrica degli acidi nucleici. |
| RNase A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Diluire a 1 mg/mL prima dell'uso |
| Spettrofotometro | Thermo Fisher Scientific | NDULTRAGL | È stato utilizzato lo strumento NanoDrop OneC, ormai fuori produzione; può essere utilizzata una versione più recente o un microspettrofotometro equivalente. |
| Colorante per gel di DNA SYBR Safe | Invitrogen | S33102 | Per elettroforesi su gel di agarosio |
| Termostato ciclico | Bio-Rad | 1861096 | T100 Thermal Cycler |
| Proteinasi K termolabile (0,120 U/µL) | New England Biolabs | P8111S/L | Utilizzato per la lisi di singolo ovocita |
| Tris-acetato-EDTA (TAE), 50× | Fisher Scientific | BP1332-1 | Diluire a 1× per elettroforesi su gel di agarosio |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Utilizzato per la preparazione e la diluizione dei reagenti |
| Tween 20 | Fisher BioReagents | 11417160 | Componente del tampone di lisi degli ovociti |
| Ladder universale di DNA | Thermo Fisher Scientific | SM0333 | GeneRuler DNA Ladder pronta all'uso (100–1.000 bp |
| Wide Mini-Sub Cell GT Cell | Bio-Rad | 1704468EDU | Per elettroforesi su gel di agarosio |
| Vassoio per gel UV-trasparente Wide Mini-Sub Cell GT (15 × 7 cm | Bio-Rad | 1704426 | Per elettroforesi su gel di agarosio |
Riferimenti
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo