Questo protocollo propone FedMediFormer-XAI, un framework multimodale per l'intelligenza sul diabete che rispetta la privacy grazie all'apprendimento federato, ai trasformatori multimodali, all'aumento basato sulla diffusione, alla raccomandazione personalizzata di farmaci basata su grafi e all'intelligenza artificiale spiegabile, per una previsione accurata, un processo decisionale trasparente e una gestione personalizzata del diabete.
Articolo metodologico
FedMediFormer-XAI: Transformer Multimodali Federati con Augmentation tramite Diffusione e Raccomandazione di Farmaci Basata su Grafi per il Diabete
In questo articolo
Sommario
Abstract
La gestione del diabete si scontra con diversi ostacoli, come dati sanitari frammentati, preoccupazioni relative alla privacy, scarsa interpretabilità e mancanza di indicazioni terapeutiche personalizzate. Questo studio introduce FedMediFormer-XAI, un framework unificato e completo che integra apprendimento federato, trasformatori multimodali, aumento dei dati basato sulla diffusione, Reti Neurali su Grafi (GNN) per la raccomandazione di farmaci e Intelligenza Artificiale Spiegabile (XAI) per l'analisi del diabete. Il sistema utilizza diversi tipi di dati sanitari, ad esempio cartelle cliniche, indicatori di salute della popolazione, dati di monitoraggio continuo del glucosio, immagini del fondo retinico, misurazioni di sensori indossabili e informazioni farmacologiche. Per generare campioni sintetici e affrontare lo squilibrio tra classi, vengono impiegati modelli di diffusione, mentre architetture trasformatore multimodali vengono utilizzate per apprendere le relazioni tra fonti di dati molto diverse. L'apprendimento federato consente un addestramento collaborativo dei modelli in modo da preservare la privacy, senza condividere i dati grezzi dei pazienti. Il componente basato su grafi cattura le interazioni paziente-farmaco e farmaco-farmaco per raccomandazioni farmacologiche personalizzate. Metodi di spiegabilità come SHapley Additive exPlanations (SHAP), visualizzazione dell'attenzione, gradienti integrati e ragionamento controfattuale forniscono interpretazioni trasparenti dei risultati di previsione e raccomandazione. Nell'implementazione rappresentativa, il framework proposto ha raggiunto un'accuratezza del 94,2%, una precisione del 93,1%, un richiamo del 92,8%, un punteggio F1 del 92,9%, un Coefficiente di Correlazione di Matthews (MCC) di 0,88 e un'Area Sottesa alla Curva Caratteristica Operativa del Ricevitore (AUC-ROC) di 0,96. Il modulo di raccomandazione basato su grafi ha ottenuto precisione = 0,89, richiamo = 0,84 e Guadagno Cumulativo Scontato Normalizzato (NDCG) = 0,91. Il protocollo fornisce un approccio strutturato per integrare dati sanitari eterogenei mediante trasformatori multimodali, apprendimento federato, aumento basato sulla diffusione, raccomandazione basata su grafi e intelligenza artificiale spiegabile. I risultati computazionali riportati dimostrano il potenziale del framework nella previsione del diabete e nella raccomandazione personalizzata di farmaci, mentre la progettazione federata supporta la gestione decentralizzata dei dati. È necessaria una valutazione clinica prospettica multicentrica per stabilire l'utilità clinica, la generalizzabilità e l'applicabilità nel mondo reale.
Introduzione
Il diabete mellito è tra le principali malattie metaboliche croniche che colpiscono l'umanità e rappresenta un grave problema di sanità pubblica, poiché continua a diffondersi, con effetti a lungo termine e costi elevatissimi per il trattamento dei pazienti1,2. Secondo un rapporto, attualmente nel mondo ci sono oltre 537 milioni di adulti affetti da diabete, e si prevede che questa cifra aumenterà notevolmente nei prossimi decenni3. Se i livelli elevati di zucchero nel sangue non vengono controllati, la persona svilupperà le complicazioni più gravi, come malattie coronariche4, danni renali5, neuropatie6, perdita della vista7 e ictus cerebrale8. Pertanto, riconoscere la malattia nella fase più precoce, monitorare regolarmente le condizioni del paziente e fornire formazione attraverso approcci medici avanzati sono passaggi necessari per aiutare i pazienti a condurre una vita più sana e, in tal modo, ridurre le spese del sistema sanitario statale9,10.
Oggi, l'uso di cartelle cliniche elettroniche (EHR), dispositivi indossabili, sistemi di monitoraggio continuo della glicemia (CGM), tecnologie di imaging retinico e applicazioni per la salute mobile si sta diffondendo rapidamente, generando grandi volumi di dati sanitari eterogenei che possono essere analizzati11. Questi diversi strumenti di raccolta dati possono fornire informazioni variegate sul corpo umano, sulla sua capacità di funzionare in diverse fasi di una malattia, su come il paziente risponde a diversi tipi di trattamento e su come si comporta nella vita reale12. L'intelligenza artificiale (AI) si è dimostrata la soluzione migliore per elaborare dati altamente complessi, prevedere il diabete, monitorare l'andamento della malattia e assistere i medici nelle decisioni cliniche13. Inoltre, algoritmi di apprendimento automatico, tra cui foreste casuali, macchine a vettori di supporto e metodi di boosting del gradiente, hanno ottenuto ottimi risultati nella valutazione del rischio di diabete14. Più di recente, architetture di apprendimento profondo hanno permesso l'estrazione automatica di caratteristiche e migliorato le prestazioni predittive in svariate applicazioni sanitarie15.
Utilizzando metodi di apprendimento multimodale, l'intelligenza artificiale applicata al diabete è stata notevolmente potenziata unendo record clinici strutturati, misurazioni fisiologiche, immagini della retina e indicatori comportamentali in un unico quadro predittivo16. Sfruttando più fonti di informazione, i modelli multimodali possono identificare schemi che non risultano visibili quando ogni modalità viene analizzata separatamente17. Recentemente, modelli basati su architetture Transformer hanno imparato in modo molto efficace dipendenze a lungo raggio e relazioni contestuali a partire da tipologie diverse di dati sanitari18. Tuttavia, problemi come classi sbilanciate, dati mancanti, eterogeneità dei dati e generalizzabilità limitata ostacolano ancora l'ampia diffusione dei sistemi di intelligenza artificiale multimodali in ambito clinico19.
Nonostante questi sviluppi, molti sistemi di intelligenza per il diabete esistenti si basano ancora su framework di apprendimento centralizzati che richiedono intrinsecamente la consolidazione dei dati dei pazienti provenienti da diverse istituzioni in un unico archivio20. Metodi di questo tipo stanno già generando controversie riguardo alla privacy dei pazienti, alla gestione dei dati, alla sicurezza informatica e al rispetto della normativa21. Di fatto, a causa di considerazioni legali ed etiche, i fornitori di assistenza sanitaria spesso hanno limitazioni nella condivisione dei dati sensibili dei pazienti22. In questo contesto, l'apprendimento federato si sta affermando come una soluzione praticabile, in quanto consente di addestrare un modello collaborativo senza condividere i dati effettivi dei pazienti23. Attraverso un'ottimizzazione decentralizzata e un'aggregazione sicura dei parametri, l'apprendimento federato permette analisi sanitarie protette nella privacy sfruttando conoscenze provenienti da set di dati distribuiti geograficamente24. Tuttavia, l'overhead di comunicazione, l'eterogeneità dei client e la stabilità della convergenza rappresentano ancora problemi significativi negli scenari sanitari federati25.
Un altro svantaggio dei sistemi di intelligenza per il diabete attualmente in uso è la mancanza di trasparenza e di supporto per una terapia personalizzata. Molti modelli di deep learning si comportano come scatole nere, il che rappresenta un problema per i clinici che desiderano comprendere il ragionamento alla base delle previsioni e delle raccomandazioni26. I metodi di intelligenza artificiale interpretabile (XAI), come SHAP, gradienti integrati, visualizzazione dell'attenzione e ragionamento controfattuale, stanno dimostrando un notevole potenziale nel migliorare la trasparenza del modello e la fiducia dei clinici27. Inoltre, le reti neurali su grafi (GNN) si sono affermate come gli strumenti più avanzati per catturare le interazioni paziente-farmaco e farmaco-farmaco, consentendo raccomandazioni farmacologiche personalizzate e la valutazione della sicurezza terapeutica28. Anche i nuovi modelli di diffusione hanno introdotto soluzioni per generare dati sanitari sintetici realistici e affrontare lo squilibrio tra classi29.
I transformer, l'apprendimento federato, la generazione di dati sintetici basata su diffusione, le reti neurali su grafi e l'intelligenza artificiale spiegabile hanno ciascuno mostrato risultati promettenti nelle applicazioni sanitarie; tuttavia, la loro integrazione all'interno di un unico framework riproducibile di intelligenza per il diabete rimane limitata. Gli approcci esistenti affrontano comunemente questi componenti in modo indipendente, concentrandosi sull'apprendimento che preserva la privacy senza raccomandazioni di trattamento personalizzate, sulla previsione multimodale senza addestramento decentralizzato, o sulla spiegabilità senza supporto decisionale clinico basato su grafi. Sebbene i modelli di diffusione possano supportare il bilanciamento delle classi e le architetture transformer possano apprendere relazioni tra modalità sanitarie eterogenee, protocolli standardizzati per integrare queste tecnologie complementari rimangono limitati. Pertanto, questo lavoro presenta un protocollo metodologico unificato che combina previsione multimodale, aumento basato sulla diffusione, ottimizzazione federata, raccomandazione personalizzata di farmaci basata su grafi e intelligenza artificiale spiegabile all'interno di un flusso di lavoro riproducibile, fornendo al contempo una base per future validazioni cliniche e applicazioni pratiche.
A differenza degli studi che presuppongono la disponibilità di set di dati multimodali a livello del paziente, questo protocollo integra set di dati pubblici eterogenei senza effettuare un abbinamento diretto dei pazienti. Vengono addestrati modelli indipendenti specifici per ogni modalità per ciascuna fonte di dati, e gli embedding delle caratteristiche latenti sono combinati attraverso un meccanismo di attenzione incrociata tra modalità. Questa progettazione preserva il rigore metodologico consentendo al contempo l'integrazione del sapere multimodale attraverso diversi archivi sanitari.
Il protocollo proposto è destinato principalmente allo sviluppo metodologico e ai contesti di intelligenza artificiale per l'assistenza sanitaria distribuita, in cui sono disponibili fonti di dati eterogenee distribuite tra diversi archivi o istituzioni e la centralizzazione diretta dei dati è limitata. Nell'attuale implementazione, i dataset specifici per modalità sono indipendenti e non sono abbinati per paziente; pertanto, l'integrazione multimodale viene effettuata a livello di rappresentazione appresa piuttosto che attraverso una corrispondenza diretta a livello di paziente. Un'applicazione pratica richiederebbe dati paziente multimodali adeguatamente collegati, una preelaborazione coerente e definizioni di esiti uniformi tra i siti partecipanti, un'infrastruttura computazionale idonea e il rispetto dei requisiti etici, di privacy e normativi applicabili.
Questo articolo presenta FedMediFormer-XAI, un framework federato basato su trasformatori multimodali che consente un'intelligenza sul diabete rispettosa della privacy, integrando funzionalità di previsione, raccomandazione e spiegabilità in un'unica soluzione. Questo framework combina un'aumentazione dei dati basata sulla diffusione per affrontare lo squilibrio tra le classi, un apprendimento multimodale basato su trasformatori per la previsione del diabete, un apprendimento federato per lo sviluppo collaborativo del modello, una raccomandazione personalizzata di farmaci basata su reti neurali grafiche e metodi di intelligenza artificiale spiegabile per supportare decisioni cliniche in modo trasparente. L'architettura generale e il flusso di lavoro del framework proposto FedMediFormer-XAI sono illustrati nella Figura 1.
I principali contributi del framework proposto FedMediFormer-XAI sono riassunti come segue: (1) Viene presentato un protocollo unificato che integra l'apprendimento federato, i trasformatori multimodali, l'aumento dei dati basato sulla diffusione, la raccomandazione personalizzata di farmaci basata su reti neurali su grafi e l'intelligenza artificiale spiegabile all'interno di un singolo flusso di lavoro riproducibile per l'intelligenza sul diabete. (2) Viene sviluppata una strategia di apprendimento federato che preserva la privacy, abilitando l'addestramento collaborativo del modello tra client sanitari distribuiti simulati senza condividere i dati pazienti originali. (3) Viene introdotta un'architettura di trasformatore multimodale per apprendere congiuntamente rappresentazioni complementari da cartelle cliniche strutturate, dati di monitoraggio continuo del glucosio, immagini del fondo retinico e indicatori di salute della popolazione. (4) Viene integrata la generazione sintetica di dati basata sulla diffusione per ridurre lo sbilanciamento delle classi e migliorare la robustezza del modello, preservando al contempo le caratteristiche statistiche dei dati di addestramento originali. (5) Viene impiegato un modulo di apprendimento su grafi eterogenei basato su GraphSAGE per modellare le relazioni paziente-farmaco e farmaco-farmaco, al fine di fornire raccomandazioni personalizzate di farmaci e un ordinamento dei trattamenti consapevole delle interazioni. (6) Vengono integrate diverse tecniche di intelligenza artificiale spiegabile, tra cui SHapley Additive exPlanations (SHAP), gradienti integrati, visualizzazione dell'attenzione e spiegazioni controfattuali, per migliorare la trasparenza del modello e fornire output di previsione e raccomandazione interpretabili. (7) Viene fornito un protocollo di validazione completo, che include valutazione predittiva, valutazione dell'apprendimento federato, valutazione delle raccomandazioni, analisi dell'esplicabilità, valutazione centrata sul clinico, validazione esterna e valutazione della riproducibilità.
Protocollo
Tutti i set di dati utilizzati in questo studio sono stati ottenuti da archivi pubblicamente disponibili e contenevano informazioni sui pazienti de-identificate. Tra questi vi erano il Pima Indians Diabetes Dataset, il CDC Diabetes Health Indicators Dataset, il OhioT1DM Dataset, il APTOS 2019 Blindness Detection Dataset, il Drug Review Dataset e il Drug-Drug Interaction Dataset. Non è stata prevista alcuna reclutamento diretto di pazienti, intervento, raccolta di campioni o accesso a informazioni sanitarie personali identificabili. Lo studio si è limitato a un'analisi secondaria di set di dati anonimizzati disponibili pubblicamente, finalizzata allo sviluppo e alla validazione metodologica, ed è stato condotto in conformità con i requisiti istituzionali per l'utilizzo di tali dati. La valutazione centrata sull'uomo descritta in questo protocollo è prevista per un'implementazione futura e non è stata effettuata nel presente studio. I ricercatori che intendono svolgere tale valutazione dovrebbero ottenere l'approvazione appropriata dal Comitato Etico Istituzionale, ottenere il consenso informato scritto da tutti i partecipanti e rispettare i requisiti istituzionali applicabili, gli accordi sul trattamento dei dati e le normative nazionali.
1. Configurare l'ambiente computazionale
- Installare Python 3.11 come ambiente di programmazione principale. Installare PyTorch 2.3 e TensorFlow 2.15 per lo sviluppo e l'addestramento di modelli di deep learning. Installare la libreria Transformers (v4.45) per implementare architetture basate su transformer.
- Installare PyTorch Geometric (v2.5) per supportare la costruzione e l'addestramento di reti neurali su grafi. Installare SHAP (v0.47) e Captum (v0.8) per eseguire analisi di spiegabilità e attribuzione delle caratteristiche.
- Installare NumPy, Pandas e Scikit-learn per il calcolo numerico, la pre-elaborazione dei dati e le utilità di machine learning. Installare OpenCV e Matplotlib per le operazioni di elaborazione e visualizzazione delle immagini. Installare NetworkX per costruire e analizzare grafi di interazioni tra farmaci.
- Installare il CUDA Toolkit e i driver NVIDIA compatibili per abilitare il calcolo accelerato tramite hardware. Configurare una GPU NVIDIA RTX 4090 con almeno 32 GB di memoria di sistema. Impostare il seme casuale a 42 per l'addestramento, la validazione e i test, al fine di garantire risultati riproducibili. Verificare le installazioni e la compatibilità delle librerie software utilizzate. Registrare le versioni del software, le specifiche hardware e i parametri di configurazione del modello impiegati nell'analisi.
2. Preparare e preelaborare i set di dati
- Scaricare e organizzare i dataset clinici, fisiologici, di imaging e farmacologici richiesti in repository specifici per modalità e verificarne l'integrità. Confermare le caratteristiche dei dataset, gli obiettivi predittivi e i livelli di integrazione come specificato in Tabelle 1 e 2. Il flusso di lavoro è illustrato in Figura 2.
- Rimuovere record duplicati, non validi o incoerenti e record privi di variabili essenziali. Dividere ciascun dataset applicabile in sottoinsiemi di addestramento (70%), validazione (15%) e test (15%) indipendenti per paziente. Applicare l'imputazione mediana, la scalatura Min-Max e la codifica categorica utilizzando esclusivamente il sottoinsieme di addestramento, quindi applicare le trasformazioni ottenute senza modifiche ai sottoinsiemi di validazione e test. Eseguire la generazione di dati sintetici solo sul sottoinsieme di addestramento. Verificare la partizione e la prevenzione delle fughe di dati in conformità con Tabella Supplementare 1.
- Importare i dati relativi a glucosio, assunzione di cibo, dosaggio di insulina, attività fisica e sonno. Standardizzare i timestamp, allineare gli eventi a intervalli regolari, interpolare linearmente i valori di glucosio non registrati, suddividere i record continui in finestre di lunghezza fissa e applicare la normalizzazione con z-score per generare gli input per il trasformatore temporale.
- Caricare le immagini del fondo oculare e rimuovere file corrotti o illeggibili, duplicati, immagini prive di etichette, o immagini con artefatti gravi o visibilità insufficiente del campo retinico.
- Ridimensionare le immagini conservate a 224 × 224 pixel, normalizzare le intensità dei pixel nell'intervallo [0, 1] e applicare l'equalizzazione adattiva dell'istogramma con limite al contrasto (CLAHE).
- Arricchire le immagini di addestramento mediante rotazione casuale compresa tra ±15°, inversione orizzontale con probabilità 0,5, zoom casuale compreso tra 0,9 e 1,1× e regolazione della luminosità compresa tra ±20%. Non applicare arricchimento stocastico alle immagini di validazione o test. Archiviare le immagini elaborate per l'addestramento del Vision Transformer.
- Integrare le rappresentazioni specifiche per ciascuna modalità secondo la strategia di integrazione dei dataset riassunta in Tabella 2. Non eseguire abbinamenti diretti a livello di paziente tra repository indipendenti quando non sono disponibili identificatori comuni di pazienti.
- Archiviare ciascun dataset pubblico come dataset indipendente e specifico per modalità, poiché gli identificatori dei pazienti non sono condivisi tra i repository.
- Addestrare separatamente gli estrattori di caratteristiche specifici per ciascuna modalità utilizzando i rispettivi dataset: (a) Cartelle cliniche → codificatore TabTransformer; (b) Indicatori sanitari della popolazione → codificatore TabTransformer; (c) Monitoraggio continuo del glucosio → Trasformatore Temporale; (d) Immagini del fondo oculare → Vision Transformer; (e) Dati farmacologici → modulo GraphSAGE
- Estrarre autonomamente le rappresentazioni latenti da ciascuna modalità. Fondere esclusivamente le rappresentazioni latenti apprese tramite il modulo proposto di fusione con attenzione incrociata tra modalità, piuttosto che unire direttamente i record grezzi dei pazienti.
- Assicurarsi che non venga effettuato alcun abbinamento artificioso tra pazienti appartenenti a dataset pubblici indipendenti. Mantenere partizioni indipendenti di addestramento, validazione e test per ciascun dataset durante tutte le fasi di pre-elaborazione, arricchimento e sviluppo del modello.
- Archiviare le rappresentazioni multimodali fuse per le previsioni successive, l'apprendimento federato, l'interpretazione dei risultati e la raccomandazione personalizzata di farmaci (Figura 2).
3. Eseguire l'ampliamento dei dati basato sulla diffusione
- Applica un'augmentazione basata sulla diffusione ai dataset strutturati di tipo tabellare relativi a dati clinici e di salute della popolazione utilizzando TabDDPM. Genera campioni sintetici esclusivamente dalla partizione di addestramento preelaborata per evitare perdite di informazioni. Configura il modello secondo la Tabella Supplementare 2.
- Allena TabDDPM per un massimo di 500 epoche utilizzando l'ottimizzatore Adam (learning rate = 1 × 10⁻4; dimensione del batch = 256). Applica l'arresto anticipato se la perdita di validazione non migliora di almeno 0,001 per 20 epoche consecutive. Genera campioni sintetici per le classi sottorappresentate.
- Valuta la qualità dei dati sintetici utilizzando le statistiche di Kolmogorov–Smirnov (KS), la divergenza di Jensen–Shannon, la distanza di Wasserstein, l'analisi delle correlazioni per caratteristica e le prestazioni di classificazione in attività successive. Confronta le distribuzioni delle caratteristiche originali e sintetiche mediante sovrapposizione di istogrammi, stima della densità kernel e coefficienti di correlazione a coppie.
- Accetta i campioni sintetici solo quando le distribuzioni delle caratteristiche per classe rimangono coerenti con i dati di addestramento originali (test KS, p > 0,05; divergenza di Jensen–Shannon < 0,10) e non contengono valori clinici irrealistici. Combina i campioni accettati con il dataset originale di addestramento per generare un dataset bilanciato per classe. Il flusso di lavoro di augmentazione è mostrato nella Figura 3.
- Convalida i dati sintetici riaddestrando il modello di predizione del diabete utilizzando i dataset di addestramento originale e aumentato. Confronta Accuratezza, F1-score, MCC e AUC-ROC per valutare i cambiamenti nella generalizzazione del modello e nei bias distribuzionali.
4. Sviluppare il modello transformer multimodale
Configurare il trasformatore multimodale con codificatori specifici per ciascuna modalità per dati clinici strutturati, sequenze di monitoraggio glicemico continuo (CGM) e immagini del fondo oculare, come illustrato in Figura 4. Integrare le rappresentazioni risultanti mediante attenzione incrociata tra modalità per la previsione del diabete e la raccomandazione personalizzata di farmaci basata su grafi.
- Sviluppare l'Encoder Clinico
- Inizializzare l'architettura dell'encoder TabTransformer. Inserire variabili cliniche normalizzate e indicatori di salute della popolazione. Generare rappresentazioni di caratteristiche contestuali utilizzando meccanismi di attenzione del transformer.
- Configurare l'encoder TabTransformer con 32 variabili cliniche strutturate in ingresso, una dimensione dell'embedding pari a 128, quattro livelli del transformer, otto testine di attenzione, una dimensione feed-forward di 512, un tasso di dropout dello 0,20 e un'attivazione Gaussian Error Linear Unit (GELU).
- Apprendere embedding clinici latenti che catturino le relazioni tra gli attributi del paziente. Archiviare gli embedding clinici risultanti per l'integrazione multimodale.
- Sviluppare l'Encoder per il Monitoraggio Continuo della Glicemia
- Inizializzare l'encoder temporale del transformer. Inserire sequenze di monitoraggio continuo della glicemia e misurazioni fisiologiche. Utilizzare meccanismi di auto-attenzione per codificare le dipendenze temporali.
- Configurare il transformer temporale con una lunghezza della sequenza di 96 passi temporali, un intervallo di campionamento di 15 min, una dimensione dell'embedding pari a 128, quattro livelli del transformer, otto testine di attenzione, codifica posizionale sinusoidale e un tasso di dropout dello 0,20.
- Produrre embedding sequenziali che riflettano la dinamica glicemica del paziente. Mantenere pronti gli embedding temporali per il successivo processo di fusione.
- Sviluppare l'Encoder Vision Transformer
- Inizializzare l'architettura del Vision Transformer. Inserire immagini preelaborate del fondo oculare. Dividere le immagini in porzioni di dimensioni fisse.
- Configurare il Vision Transformer con una risoluzione dell'immagine in ingresso di 224 × 224 pixel, una dimensione della porzione di 16 × 16 pixel, una dimensione dell'embedding pari a 768, 12 blocchi del transformer, 12 testine di attenzione e un tasso di dropout dello 0,10.
- Generare rappresentazioni di caratteristiche a livello di porzione. Acquisire caratteristiche visive che indicano patologie retiniche e biomarcatori associati alla malattia. Conservare gli embedding delle immagini per la fusione multimodale.
- Eseguire la Fusione Intermodale
- Estrarre le rappresentazioni latenti dagli encoder clinico, CGM e Vision Transformer e proiettare ciascuna in uno spazio latente comune di 256 dimensioni utilizzando proiezioni lineari indipendenti seguite da Normalizzazione del Livello.
- Concatenare i token delle modalità proiettate, aggiungere embedding di tipo di modalità apprendibili e applicare un'attenzione multi-testina intermodale per consentire lo scambio di informazioni tra le rappresentazioni cliniche, CGM e retiniche. Configurare il blocco di attenzione con otto testine, uno spazio del modello di 256 dimensioni, un livello feed-forward di 1.024 dimensioni, attivazione GELU, dropout dello 0,10, connessioni residue e Normalizzazione del Livello.
- Eseguire una media pooling per ciascun gruppo di token specifico della modalità e concatenare le rappresentazioni risultanti. Proiettare il vettore concatenato di 768 dimensioni in una rappresentazione unificata multimodale di 512 dimensioni e conservare i pesi di attenzione e le rappresentazioni fuse per analisi successive di spiegabilità e ablazione.
- Inviare la rappresentazione unificata ai moduli di previsione del diabete e di raccomandazione farmacologica basati su GraphSAGE. Mantenere le partizioni originali specifiche per modalità durante l'addestramento, la validazione e i test, senza abbinamenti artificiali a livello paziente tra i dataset indipendenti.
- Configurare il transformer multimodale secondo i parametri del modello riassunti nella Tabella Supplementare 3.
5. Configurare l'apprendimento federato
- Configurare il framework di apprendimento federato per consentire un addestramento collaborativo del modello tra istituzioni sanitarie distribuite geograficamente, senza lo scambio di dati a livello individuale. Eseguire l'ottimizzazione locale del modello in ciascuna istituzione partecipante utilizzando i dati disponibili localmente. Condividere esclusivamente i parametri del modello protetti con il server centrale di aggregazione. Preservare la privacy dei pazienti, consentendo al contempo lo sviluppo collaborativo di modelli multimodali.
- Separare i dataset multimodali e distribuirli tra più client federati per simulare lo scenario di diverse istituzioni sanitarie che collaborano senza condividere i propri dati.
- Configurare la rete di apprendimento federato con 10 client ospedalieri partecipanti, un server centrale di aggregazione, cinque epoche locali per ogni round di comunicazione, 100 round di comunicazione, una frazione di partecipazione dei client dell'80%, selezione casuale dei client ad ogni round di comunicazione e un minimo di otto client partecipanti per round.
- Assegnare a ogni client un dataset appartenente a una particolare istituzione, in modo che i dati rimangano locali e riservati. Ripartire i dati multimodali di addestramento tra 10 client ospedalieri simulati utilizzando una strategia non indipendente e identicamente distribuita (non-IID) basata su Dirichlet per generare distribuzioni di classe eterogenee, composizioni demografiche e dimensioni dei dataset dei clienti.
- Utilizzare un seme casuale fisso per garantire la riproducibilità. Verificare le distribuzioni risultanti a livello dei client e mantenere queste partizioni per tutta la durata dell'addestramento federato. Mantenere i dataset di validazione e di test indipendenti dalle partizioni dei client.
- Inizializzare ogni client locale con i parametri del modello globale ricevuti dal server di aggregazione centrale. Addestrare il trasformatore multimodale locale per cinque epoche utilizzando i dati di addestramento locali del client. Ottimizzare il modello locale utilizzando l'ottimizzatore AdamW con una velocità di apprendimento di 1 × 10⁻4.
- Calcolare gli aggiornamenti dei parametri del modello locale al termine dell'addestramento locale. Proteggere i parametri del modello locale prima della trasmissione al server centrale di aggregazione. Trasmettere i parametri del modello locale protetti al server centrale di aggregazione per l'aggregazione globale.
- Ricevere i parametri del modello protetti da tutti i client ospedalieri partecipanti. Verificare l'integrità degli aggiornamenti del modello ricevuti prima dell'aggregazione. Aggregare i pesi del modello locale utilizzando l'algoritmo Federated Averaging (FedAvg). Aggiornare il trasformatore multimodale globale utilizzando i parametri del modello aggregati.
- Ridistribuire i parametri aggiornati del modello globale ai client ospedalieri partecipanti. Ripetere le procedure di addestramento locale e di aggregazione globale fino al completamento di 100 cicli di comunicazione o fino al raggiungimento del criterio di convergenza prestabilito.
- Proteggere i parametri del modello trasmessi utilizzando il meccanismo specificato di aggregazione sicura e la crittografia AES-256. Autenticare i client partecipanti mediante certificati digitali.
- Stabilire canali di comunicazione crittografati utilizzando Transport Layer Security (TLS) 1.3. Conservare soltanto i parametri del modello globale aggregati al termine di ogni ciclo di comunicazione.
- Valutare la privacy e la sicurezza mediante analisi dell'esposizione dei dati grezzi, della condivisione non autorizzata, dell'inferenza di appartenenza e dell'inversione del modello. Per l'inferenza di appartenenza, confrontare l'AUC-ROC dell'attacco con la linea di base casuale (0,50); valutare l'inversione utilizzando l'indice di similarità strutturale (SSIM) e il rapporto segnale-rumore di picco (PSNR) per le immagini retiniche e l'errore normalizzato di ricostruzione per le caratteristiche numeriche.
- Verificare l'aggregazione sicura confermando che il server non possa accedere agli aggiornamenti individuali non aggregati dei client. Verificare la protezione AES-256/TLS 1.3 e confermare che non avvengano trasmissioni di aggiornamenti del modello non crittografati.
- Confrontare le metriche sulla privacy tra configurazioni federate e centralizzate, ove applicabile, e riportare le metriche specificate in Tabella supplementare 4.
- Stimare la complessità computazionale dell'addestramento di un transformer locale come O(N × L × d2), dove N rappresenta il numero di campioni, L rappresenta il numero di strati del transformer e d rappresenta la dimensione dell'embedding.
- Stimare la complessità computazionale dell'aggregazione federata come O(K × P) per ogni ciclo di comunicazione, dove K rappresenta il numero di client partecipanti e P rappresenta il numero di parametri del modello addestrabili.
- Scambiare solo i parametri del modello protetti tra i client partecipanti e il server centrale di aggregazione durante ogni round di comunicazione. Calcolare il sovraccarico di comunicazione in base alla dimensione del modello, al numero di client partecipanti e al numero di round di comunicazione.
- Confrontare l'overhead dello scambio di parametri con il costo stimato del trasferimento dei corrispondenti dataset sanitari multimodali. Configurare il framework di apprendimento federato in base ai parametri riassunti in Tabella supplementare 4. Il flusso di lavoro dell'apprendimento federato e il processo di aggregazione dei parametri sono illustrati in Figura 5.
6. Costruire il modulo di raccomandazione personalizzata dei farmaci
- Importare i dati farmacologici, relativi ai farmaci, al trattamento del paziente e alle interazioni tra farmaci nell'ambiente computazionale. Costruire un grafo sanitario eterogeneo contenente nodi relativi a pazienti, farmaci, malattie, esami di laboratorio e fattori di rischio clinici.
- Definire le relazioni tra paziente-malattia, paziente-farmaco, malattia-farmaco, interazione tra farmaci e paziente-laboratorio come archi del grafo. Verificare la struttura del grafo ed eliminare relazioni duplicate, non valide o disconnesse prima dell'addestramento del modello.
- Rappresentare i nodi paziente mediante età, sesso, indice di massa corporea (BMI), HbA1c, glicemia, pressione sanguigna e durata del diabete. Rappresentare i nodi farmaco mediante classe del farmaco, meccanismo d'azione, dosaggio, frequenza di somministrazione ed effetti avversi noti.
- Rappresentare i nodi malattia mediante gravità della malattia, stadio della malattia e complicanze associate. Codificare gli attributi categorici e normalizzare le caratteristiche continue dei nodi prima dell'addestramento di GraphSAGE.
- Inizializzare gli embedding dei nodi utilizzando le caratteristiche dei nodi preelaborate. Campionare fino a 25 nodi vicini per ogni nodo bersaglio durante l'aggregazione del vicinato. Aggregare le rappresentazioni dei nodi vicini utilizzando l'aggregazione media. Aggiornare gli embedding dei nodi bersaglio utilizzando le rappresentazioni aggregate del vicinato.
- Applicare la funzione di attivazione rectified linear unit (ReLU) dopo ogni livello di GraphSAGE. Normalizzare gli embedding risultanti dei nodi. Ripetere la procedura di aggregazione del vicinato su tre livelli di GraphSAGE.
- Configurare il modello GraphSAGE con una dimensione nascosta di 256, una dimensione dell'embedding di 128, tre livelli di GraphSAGE, una dimensione di campionamento dei vicini pari a 25, una percentuale di dropout di 0,30, una velocità di apprendimento di 1 × 10⁻4, una dimensione del batch di 512 e un massimo di 100 epoche di addestramento. Ottimizzare il modello utilizzando l'ottimizzatore Adam.
- Calcolare l'embedding specifico del paziente a partire dal modello GraphSAGE addestrato. Calcolare gli embedding per i farmaci candidati. Calcolare i punteggi di idoneità tra la rappresentazione del paziente e le rappresentazioni dei farmaci candidati. Ordinare i farmaci candidati in base ai loro punteggi di idoneità predetti.
- Identificare ed eliminare i farmaci controindicati o potenzialmente non sicuri utilizzando le informazioni disponibili sulle interazioni tra farmaci. Restituire i cinque farmaci idonei con punteggio più alto come raccomandazioni personalizzate Top-5.
- Addestrare il modello di raccomandazione utilizzando la funzione di perdita Bayesian Personalized Ranking (BPR). Ottimizzare l'obiettivo di ordinamento in modo da assegnare punteggi più elevati ai farmaci clinicamente appropriati rispetto ai farmaci candidati meno adatti.
- Identificare i nodi vicini influenti e le relazioni nel grafo clinicamente rilevanti che contribuiscono a ciascuna raccomandazione di farmaco. Calcolare i punteggi di attribuzione delle caratteristiche relative a paziente, malattia, laboratorio e farmaco che contribuiscono alla raccomandazione.
- Generare spiegazioni basate su grafi visivi che mostrano le relazioni che contribuiscono a ciascuna raccomandazione personalizzata di farmaco. Configurare il modello di raccomandazione GraphSAGE secondo i parametri riassunti nella Tabella Supplementare 5. Il flusso di lavoro per la raccomandazione personalizzata di farmaci basata su grafi è illustrato nella Figura 6.
7. Eseguire la valutazione dell'interpretabilità
- Eseguire l'analisi SHAP
- Caricare il trasformatore multimodale addestrato e il dataset di test tenuto in riserva nell'ambiente computazionale.
- Inizializzare lo spiegatore SHAP utilizzando il modello predittivo addestrato e un campione di background composto da 100 campioni di addestramento, selezionati esclusivamente dal dataset di addestramento mediante campionamento casuale stratificato in base alla classe dell'esito diabete. Mantenere la distribuzione approssimativa delle classi della partizione completa di addestramento nel campione di background e utilizzare un seme casuale fisso pari a 42 per garantire una selezione riproducibile dei campioni. Calcolare i valori SHAP per i campioni di test selezionati.
- Calcolare l'importanza globale delle caratteristiche a partire dai valori assoluti di SHAP, generare visualizzazioni SHAP globali e locali e conservare i valori calcolati per analisi quantitative e statistiche successive.
- Eseguire l'analisi dei gradienti integrati
- Selezionare campioni rappresentativi correttamente classificati e mal classificati dal dataset di test tenuto in riserva. Definire input di base specifici per ogni modalità prima di calcolare i Gradienti Integrati. Utilizzare un valore di base pari a zero per le caratteristiche numeriche cliniche e CGM normalizzate, rappresentando un contributo nullo della caratteristica normalizzata, e utilizzare un'immagine di base con valori nulli per l'input dell'immagine retinica normalizzata.
- Calcolare i punteggi di attribuzione dei Gradienti Integrati utilizzando 100 passi di interpolazione tra l'input di base e l'input originale. Normalizzare i punteggi di attribuzione risultanti per consentire il confronto tra caratteristiche e modalità. Generare visualizzazioni di attribuzione per identificare le caratteristiche cliniche, temporali e di imaging influenti che contribuiscono alle singole previsioni del modello.
- Eseguire la visualizzazione dell'attenzione
- Estrarre le matrici di attenzione dai livelli del trasformatore addestrato per campioni di test rappresentativi. Calcolare i pesi medi di attenzione attraverso le teste di attenzione corrispondenti. Generare mappe termiche di attenzione per visualizzare le interazioni cross-modali tra rappresentazioni cliniche, temporali e di imaging retinico. Identificare le caratteristiche cliniche, temporali e retiniche dominanti che ricevono pesi elevati di attenzione durante la previsione.
- Estrarre i pesi di attenzione dal trasformatore multimodale addestrato per un campione di test tenuto in riserva selezionato casualmente e visualizzare le distribuzioni corrispondenti di attenzione per le caratteristiche cliniche, temporali CGM, spaziali retiniche e cross-modali.
- Generare spiegazioni controfattuali
- Selezionare record di pazienti rappresentativi dal dataset di test tenuto in riserva. Definire intervalli e vincoli clinicamente accettabili per le caratteristiche modificabili del paziente prima di generare campioni controfattuali. Limitare le caratteristiche continue all'intervallo osservato nei dati di addestramento e limitare le caratteristiche categoriche alle categorie valide osservate nei dati di addestramento. Non modificare le caratteristiche demografiche immutabili, inclusi età e sesso.
- Generare campioni controfattuali modificando minimamente solo le caratteristiche modificabili consentite, mantenendo i vincoli predefiniti clinici e del dominio delle caratteristiche. Rifiutare i controfattuali che contengono valori al di fuori dell'intervallo osservato nei dati di addestramento, stati categorici non validi o modifiche a caratteristiche immutabili. Identificare le modifiche alle caratteristiche clinicamente plausibili più piccole necessarie per alterare l'esito previsto.
- Segnalare le caratteristiche modificate, i valori originali, i valori controfattuali e i corrispondenti cambiamenti nelle previsioni del modello. Il flusso di lavoro per la valutazione della spiegabilità è illustrato nella Figura 7, mentre esempi rappresentativi di output di visualizzazione dell'attenzione e di spiegazioni controfattuali sono presentati nella Figura Supplementare 1.
- Valutare la qualità delle spiegazioni
- Calcolare la fedeltà per quantificare l'accordo tra le spiegazioni generate e il comportamento del modello predittivo. Calcolare la stabilità generando ripetutamente spiegazioni in presenza di piccole perturbazioni in ingresso e confrontando i modelli di attribuzione risultanti. Valutare la coerenza confrontando le spiegazioni generate per campioni di test clinicamente simili.
- Calcolare la sparsità determinando il numero o la proporzione di caratteristiche che contribuiscono in modo significativo a ciascuna spiegazione. Valutare la completezza per determinare se le caratteristiche attribuite spiegano adeguatamente l'output corrispondente del modello. Valutare la sensibilità misurando i cambiamenti nei punteggi di attribuzione a seguito di perturbazioni controllate delle caratteristiche in ingresso.
- Calcolare l'infedeltà per quantificare il disaccordo tra le attribuzioni delle caratteristiche e i cambiamenti osservati nelle previsioni del modello. Registrare tutte le metriche quantitative di spiegabilità per analisi statistiche successive.
- Eseguire la validazione clinica prospettica
- Per una futura validazione clinica prospettica, ottenere l'approvazione dal comitato etico istituzionale competente prima di reclutare esperti clinici. Dopo aver ottenuto l'approvazione etica, reclutare 12 clinici composti da sei endocrinologi, tre specialisti in diabete e tre farmacologi clinici, e ottenere il consenso informato da tutti i partecipanti prima di avviare la valutazione.
- Selezionare casualmente previsioni del modello rappresentative e le corrispondenti spiegazioni per la valutazione da parte dei clinici. Presentare le spiegazioni selezionate in modo indipendente a ciascun clinico partecipante utilizzando un formato di valutazione standardizzato.
- Chiedere a ciascun clinico di valutare l'utilità, la rilevanza clinica, l'interpretabilità e l'affidabilità della spiegazione utilizzando una scala Likert a cinque punti. Registrare i punteggi anonimi dei clinici e calcolare l'accordo tra valutatori e le corrispondenti misure statistiche come specificato al Passo 7.7.
- Eseguire l'analisi statistica
- Valutare la distribuzione dei punteggi di valutazione quantitativi prima di selezionare il test statistico di confronto. Applicare un test t per campioni appaiati a misurazioni appaiate normalmente distribuite o il test dei ranghi con segno di Wilcoxon a misurazioni appaiate non normalmente distribuite, secondo opportunità.
- Calcolare il kappa di Fleiss per quantificare l'accordo tra i clinici partecipanti. Calcolare intervalli di confidenza al 95% per le metriche principali di spiegabilità e di valutazione clinica. Impostare la soglia di significatività statistica a p < 0,05.
- Segnalare le statistiche del test calcolate, gli intervalli di confidenza e i valori p insieme ai risultati di valutazione corrispondenti. Valutare e riportare le metriche di spiegabilità secondo i criteri riassunti nella Tabella Supplementare 6.
8. Valutare le prestazioni del modello
- Confronta FedMediFormer-XAI con Logistic Regression, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer e il multimodal transformer centralizzato utilizzando accuratezza, precisione, richiamo, punteggio F1, MCC e AUC-ROC.
- Esegui ogni valutazione del modello di riferimento utilizzando la stessa strategia predefinita di training, validazione e test per garantire un confronto coerente con il framework proposto.
- Ripeti la valutazione del modello in esecuzioni sperimentali indipendenti e registra le metriche di prestazione ottenute in ciascuna esecuzione. Calcola la media, la deviazione standard (SD) e l'intervallo di confidenza al 95% (IC) per Accuratezza, Precisione, Richiamo, Punteggio F1, MCC e AUC-ROC. Riporta i risultati delle prestazioni come media ± SD insieme all'IC corrispondente al 95%.
- Valuta la normalità delle differenze appaiate nelle prestazioni tra FedMediFormer-XAI e ciascun modello di riferimento. Applica un test t appaiato per misurazioni appaiate normalmente distribuite e il test di Wilcoxon per misurazioni appaiate non normalmente distribuite. Imposta la soglia di significatività statistica a p < 0,05.
- Riporta le statistiche del test corrispondenti, i valori p e gli intervalli di confidenza al 95% per quantificare la significatività statistica e l'incertezza delle differenze osservate nelle prestazioni.
- Conta il numero totale di round di comunicazione fino a quando i modelli convergono definitivamente. Monitora le prestazioni del modello globale durante l'addestramento federato. Analizza come la convergenza evolve nel tempo in funzione dei round di comunicazione.
- Verifica l'efficacia dell'aggregazione dei parametri. Esamina in che modo l'apprendimento decentralizzato influisce sulle prestazioni predittive. Confronta i risultati ottenuti con l'apprendimento federato e con quello centralizzato.
- Valuta la convergenza federata lungo i round di comunicazione e confronta le prestazioni predittive federate e centralizzate. Valuta i suggerimenti di farmaci utilizzando Precision@5, Recall@5 e NDCG@5.
- Genera campioni negativi – campioni di farmaci dal pool di farmaci candidati idonei selezionando i medicinali che non sono osservati come interazioni positive paziente-farmaco per il paziente corrispondente. Escludi dal pool di campionamento negativo tutte le interazioni positive note e tutti i farmaci controindicati. Mantieni un rapporto fisso di campionamento negativo/positivo di 1:1 per l'addestramento della raccomandazione e utilizza un seme casuale fisso pari a 42 per garantire la riproducibilità della selezione dei campioni negativi.
- Definisci l'insieme di elementi rilevanti per ogni paziente esclusivamente dai dati di valutazione tenuti in serbo. Definisci l'insieme di elementi rilevanti Ru per il paziente u come l'insieme dei farmaci che soddisfano i criteri di interazione positiva paziente-farmaco nei record reali tenuti in serbo. Non utilizzare le predizioni del modello per costruire Ru. Rimuovi i farmaci controindicati dall'insieme di raccomandazione candidato prima del ranking.
- Genera i cinque farmaci idonei con punteggio più alto per ogni paziente in valutazione. Calcola Precision@5 come la proporzione dei cinque farmaci raccomandati che appartengono all'insieme di elementi rilevanti Ru del paziente. Calcola Recall@5 come la proporzione dei farmaci rilevanti del paziente recuperati tra le cinque raccomandazioni. Calcola NDCG@5 utilizzando la rilevanza graduata dei farmaci raccomandati, assegnando una rilevanza maggiore ai farmaci clinicamente appropriati e rilevanza zero ai farmaci non rilevanti. Aggrega le metriche su tutti i pazienti in valutazione e riporta la media di Precision@5, Recall@5 e NDCG@5.
- Costruisci il ground truth per la raccomandazione prima della valutazione del modello e mantieni separate le interazioni paziente-farmaco tenute in serbo dai dati di addestramento per la raccomandazione. Non utilizzare interazioni di farmaci nel test set, etichette del test set o informazioni su trattamenti futuri durante l'addestramento di GraphSAGE, il campionamento negativo o il ranking dei candidati.
- Misura la fedeltà per verificare quanto bene le spiegazioni rispecchiano il comportamento del modello. Valuta la stabilità delle spiegazioni attraverso esami multipli. Giudica la comprensibilità sulla base di criteri orientati ai medici.
- Analizza la coerenza delle spiegazioni tra diversi tipi di dati. Conferma il valore clinico delle spiegazioni prodotte. Le metriche di valutazione utilizzate nello studio sono riassunte nella Supplementary Table 7.
9. Eseguire la validazione clinica prospettica
- Eseguire una validazione clinica prospettiva dopo aver ottenuto l'approvazione etica appropriata e il consenso informato, seguendo le procedure di reclutamento, valutazione, raccolta dati e analisi statistica descritte nei passaggi 7.6–7.8. Il disegno della validazione clinica prospettica, inclusa la composizione dei partecipanti, i criteri di valutazione, le condizioni di confronto e le analisi statistiche pianificate, è riassunto nella Tabella Supplementare 8.
10. Eseguire la validazione e la valutazione della riproducibilità
- Eseguire studi di ablazione rimuovendo sistematicamente singoli componenti dal framework completo FedMediFormer-XAI, mantenendo invariate le partizioni del dataset, le procedure di pre-elaborazione, le impostazioni di addestramento e i criteri di valutazione. Valutare il modello completo e le configurazioni senza aumento basato sulla diffusione, apprendimento federato, raccomandazione di farmaci basata su GraphSAGE e fusione multimodale.
- Confrontare le configurazioni ablate con il framework completo FedMediFormer-XAI utilizzando Accuratezza, Precisione, Richiamo, F1-score, MCC e AUC-ROC. Quantificare la variazione di ciascuna metrica di prestazione per determinare il contributo di ogni componente del framework. Confrontare i risultati della validazione con quelli dei test interni per valutare la generalizzabilità. Eseguire test di significatività statistica per determinare l'affidabilità delle differenze di prestazione osservate.
- Valutare la generalizzabilità del framework utilizzando un dataset esterno indipendente, qualora sia disponibile un dataset con variabili di ingresso e definizioni di esito compatibili. Applicare le stesse procedure di pre-elaborazione e valutazione utilizzate per il dataset di test interno e confrontare le metriche di prestazione risultanti con i risultati del test interno.
- Eseguire l'analisi di significatività statistica su ripetute esecuzioni sperimentali. Valutare la normalità delle differenze appaiate di prestazione prima del test statistico. Applicare un test t appaiato per misurazioni appaiate normalmente distribuite e il test dei ranghi con segno di Wilcoxon per misurazioni appaiate non normalmente distribuite. Impostare la soglia di significatività statistica a p < 0,05.
- Calcolare la media e l'intervallo di confidenza al 95% per Accuratezza, Precisione, Richiamo, F1-score, MCC e AUC-ROC. Riportare le corrispondenti statistiche del test, i valori p e gli intervalli di confidenza per i principali confronti tra modelli. Documentare tutti i parametri del modello, le procedure di pre-elaborazione, le configurazioni di addestramento e i protocolli di valutazione necessari per riprodurre gli esperimenti descritti.
- Conservare il codice sorgente, i file di configurazione, gli script di valutazione e le specifiche dei modelli addestrati utilizzati negli esperimenti descritti. Mantenere registrazioni dettagliate dell'addestramento del modello, delle impostazioni sperimentali, dei semi casuali e dei risultati di valutazione.
- Verificare completezza e coerenza dei materiali disponibili per la riproducibilità. Assicurarsi che i metodi e i materiali documentati forniscano informazioni sufficienti per la riproduzione indipendente del flusso di lavoro sperimentale.
- Riassumere le risorse per la riproducibilità e le procedure di validazione utilizzate nello studio in Tabella Supplementare 9. Documentare la procedura dello studio di ablazione e i criteri di valutazione per analizzare il contributo dei principali componenti del framework.
Risultati
Analisi delle prestazioni predittive
FedMediFormer-XAI ha dimostrato prestazioni predittive migliorate rispetto ai modelli di base unimodali e convenzionali valutati. L'aumento basato sulla diffusione ha migliorato la rappresentazione delle classi minoritarie e le prestazioni predittive risultanti sono riassunte nella Tabella 3. La valutazione con esecuzioni ripetute ha dimostrato prestazioni predittive stabili tra i modelli valutati. FedMediFormer-XAI ha ottenuto le prestazioni complessive più elevate, con un'accuratezza del 94,20 ± 0,34% (IC 95%: 93,78–94,62), una precisione del 93,10 ± 0,30% (IC 95%: 92,73–93,47), un richiamo del 92,80 ± 0,28% (IC 95%: 92,45–93,15) e un punteggio F1 del 92,90 ± 0,28% (IC 95%: 92,55–93,25). Il modello ha ottenuto un MCC di 0,88 ± 0,02 (IC 95%: 0,86–0,90) e un AUC-ROC di 0,96 ± 0,01 (IC 95%: 0,95–0,97). Il trasformatore multimodale centralizzato ha fornito le seconde migliori prestazioni complessive, mentre i modelli di apprendimento automatico unimodali e convenzionali hanno mostrato prestazioni predittive relativamente inferiori. Questi risultati indicano che l'apprendimento della rappresentazione multimodale, combinato con l'ottimizzazione federata, produce prestazioni migliorate e più stabili nella classificazione del diabete.
Studio di ablazione
È stata utilizzata un'ablazione componente per componente per valutare il contributo dell'aumento basato sulla diffusione, dell'apprendimento federato, della raccomandazione di farmaci basata su GraphSAGE e della fusione multimodale. L'intero framework FedMediFormer-XAI ha raggiunto un'accuratezza del 94,20 ± 0,34%, una precisione del 93,10 ± 0,30%, un richiamo del 92,80 ± 0,28%, un punteggio F1 del 92,90 ± 0,28%, un MCC di 0,88 ± 0,02 e un AUC-ROC di 0,96 ± 0,01 su cinque esecuzioni indipendenti. Rimuovendo l'aumento basato sulla diffusione, l'accuratezza è scesa al 91,80 ± 0,42%, corrispondente a una diminuzione di 2,40 punti percentuali, mentre il punteggio F1 e l'AUC-ROC sono diminuiti rispettivamente a 90,30 ± 0,38% e 0,94 ± 0,01. Tale riduzione indica il contributo dell'aumento basato sulla diffusione alla rappresentazione delle classi minoritarie e alla robustezza predittiva.
La rimozione dell'apprendimento federato ha determinato un'accuratezza del 93,10 ± 0,37%, corrispondente a una diminuzione di 1,10 punti percentuali rispetto al framework completo. Precisione, richiamo, punteggio F1, MCC e AUC-ROC sono stati anch'essi ridotti rispettivamente al 92,20 ± 0,34%, 91,80 ± 0,32%, 92,00 ± 0,33%, 0,86 ± 0,02 e 0,95 ± 0,01. Questo confronto dimostra il contributo della configurazione federata alle prestazioni predittive.
La rimozione del componente di raccomandazione personalizzata dei farmaci basato su GraphSAGE ha determinato un cambiamento relativamente modesto nelle prestazioni di previsione del diabete, con un'accuratezza ridotta al 93,80 ± 0,35% e uno score F1 al 92,60 ± 0,30%. Gli indicatori MCC e AUC-ROC corrispondenti sono stati rispettivamente 0,87 ± 0,02 e 0,96 ± 0,01. Questo risultato indica che GraphSAGE contribuisce principalmente alla raccomandazione personalizzata dei farmaci piuttosto che determinare direttamente le prestazioni nella classificazione del diabete.
La riduzione maggiore è stata osservata quando è stata rimossa la fusione multimodale. L'accuratezza è diminuita all'87,60 ± 0,55%, con una diminuzione di 6,60 punti percentuali, mentre precisione, richiamo, punteggio F1, MCC e AUC-ROC sono diminuiti rispettivamente all'86,80 ± 0,51%, 85,90 ± 0,54%, 86,30 ± 0,52%, 0,76 ± 0,03 e 0,91 ± 0,01. Questo risultato dimostra l'importanza di modellare congiuntamente le informazioni complementari provenienti dalle modalità cliniche, dai sensori CGM e retinici.
Analisi del federated learning
Il framework del federated learning ha consentito un addestramento collaborativo del modello tra client distribuiti, mantenendo al contempo un trattamento decentralizzato dei dati clinici grezzi. Durante l'addestramento, il modello locale di ciascun client è stato affinato individualmente e combinato mediante il metodo Federated Averaging. Dopo 100 cicli di comunicazione, il modello globale ha raggiunto la convergenza, e le sue prestazioni predittive sono rimaste coerenti con quelle dell'apprendimento centralizzato. Il framework del federated learning ha dimostrato una convergenza stabile lungo i cicli di comunicazione, nonostante le distribuzioni eterogenee dei dati tra i client. Lo scambio protetto dei parametri ha preservato il trattamento decentralizzato dei dati, mentre il modello globale ha mantenuto prestazioni predittive competitive rispetto al modello centralizzato di riferimento. Tabella 4 confronta le implementazioni centralizzata e federata. Il federated learning ha richiesto un tempo aggiuntivo di addestramento a causa dell'overhead di comunicazione, pur mantenendo prestazioni predittive paragonabili a quelle dell'apprendimento centralizzato.
Analisi delle Prestazioni a Livello di Dataset
Per valutare la generalizzabilità attraverso diverse modalità sanitarie, abbiamo valutato le prestazioni su ciascun dataset separatamente. Il modello multimodale FedMediFormer-XAI ha dimostrato prestazioni elevate e generalmente competitive su tutti i dataset valutati. Ha raggiunto un'accuratezza del 91,8%, 93,1%, 92,4% e 94,2% rispettivamente sui dataset Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM e APTOS 2019. Sebbene il dataset APTOS 2019 abbia ottenuto un'accuratezza (94,7%) e una precisione (93,9%) leggermente superiori rispetto al modello multimodale, l'approccio multimodale proposto ha mantenuto prestazioni competitive su tutti i dataset, raggiungendo un AUC-ROC di 0,96, paragonabile al valore più alto di AUC-ROC a livello di dataset. I risultati complessivi a livello di dataset sono presentati in Tabella 5. Per singoli dataset, l'analisi delle immagini retiniche ha ottenuto le migliori prestazioni quando utilizzata da sola, mentre la fusione multimodale ha prodotto previsioni più stabili e bilanciate.
Analisi di raccomandazione farmacologica personalizzata
Il componente di raccomandazione basato su reti neurali grafiche è stato valutato utilizzando informazioni sull'efficacia dei farmaci e dati sulle interazioni tra farmaci, con i farmaci candidati ordinati in base ai punteggi di idoneità paziente-farmaco appresi ed escludendo combinazioni controindicate durante la generazione delle raccomandazioni. L'uso del formato grafico eterogeneo e la modellizzazione delle interazioni paziente-farmaco e farmaco-farmaco hanno permesso un'analisi approfondita, sostenendo così scelte terapeutiche personalizzate e la valutazione della sicurezza. Il modello di raccomandazione GraphSAGE ha efficacemente catturato le relazioni complesse tra pazienti, malattie, risultati di laboratorio e farmaci. Le raccomandazioni personalizzate hanno dimostrato elevate prestazioni di classificazione, mantenendo al contempo spiegazioni clinicamente significative attraverso l'analisi del vicinato del grafo e l'attribuzione delle caratteristiche.
Secondo la Tabella 6, il modulo di raccomandazione personalizzata dei farmaci è stato valutato utilizzando Precisione@5, Richiamo@5 e NDCG@5. Queste metriche quantificano la rilevanza e la qualità del posizionamento delle prime cinque raccomandazioni di farmaci personalizzate generate dal modulo di raccomandazione basato su GraphSAGE. Il sistema di raccomandazione ha ottenuto prestazioni elevate nel posizionamento, con precisione = 0,89, richiamo = 0,84 e NDCG = 0,91.
Analisi della spiegabilità
Il framework incorpora SHAP, gradienti integrati, visualizzazione dell'attenzione e spiegazioni controfattuali per supportare l'interpretazione delle previsioni multimodali. SHAP è stato utilizzato per quantificare i contributi a livello di caratteristica, i gradienti integrati per attribuire le previsioni alle caratteristiche di input, la visualizzazione dell'attenzione per esaminare il focus del modello attraverso le diverse modalità e le spiegazioni controfattuali per identificare i cambiamenti nelle caratteristiche associati a previsioni alternative. Figura 8 presenta un grafico riassuntivo rappresentativo di SHAP ottenuto dal modello addestrato FedMediFormer-XAI, mentre Figura 9 presenta rappresentative visualizzazioni dell'attenzione estratte dal transformer addestrato. Queste figure rappresentano output ottenuti dalla valutazione del modello e non illustrazioni schematiche dell'architettura proposta.
In Figura 8 sono presentate le classifiche a livello aggregato dell'importanza delle caratteristiche. Le caratteristiche con valori SHAP assoluti più elevati hanno avuto un'influenza maggiore sulle previsioni del modello e si sono anche allineate bene con le conoscenze cliniche esistenti.
Figura 9 presenta visualizzazioni rappresentative dell'attenzione estratte direttamente dal modello addestrato FedMediFormer-XAI per un campione di test tenuto in disparte selezionato casualmente. Le visualizzazioni includono l'attenzione alle caratteristiche cliniche, l'attenzione temporale del CGM, l'attenzione spaziale della retina e l'attenzione incrociata tra le tre modalità. La visualizzazione dell'attenzione ha ulteriormente dimostrato l'allocazione appresa dal modello dell'attenzione attraverso più modalità. Il campione selezionato ha mostrato un'attenzione relativamente maggiore all'HbA1c, alla durata del diabete e all'età tra le caratteristiche cliniche, mentre la mappa di attenzione del CGM ha evidenziato diversi periodi con una marcata variabilità glicemica. La mappa di attenzione retinica ha identificato specifiche regioni dell'immagine che contribuiscono alla rappresentazione del modello, e la matrice di attenzione incrociata ha mostrato pattern di attenzione sia intra-modale che inter-modale. Come mostrato in Figura 9, le mappe di attenzione rappresentative derivate dal modello evidenziano pattern temporali selezionati del glucosio, variabili cliniche influenti e regioni dell'immagine retinica clinicamente rilevanti in un campione di test tenuto in disparte.
Risultati della valutazione centrata sull'uomo
È stato progettato un protocollo prospettico di valutazione centrata sull'uomo per analizzare la fiducia degli operatori sanitari, l'interpretabilità, l'usabilità, l'utilità clinica e la pertinenza delle spiegazioni in condizioni di sola previsione e di previsione più spiegazione. La valutazione proposta coinvolgerà endocrinologi, specialisti in diabete e farmacologi clinici, con l'approvazione appropriata del Comitato Etico Istituzionale e il consenso informato. Poiché questa valutazione è prevista per un'implementazione futura e prospettica, i punteggi degli esiti a livello di operatore sanitario non vengono riportati nel presente protocollo.
Tabella 7 riassume il disegno proposto per la valutazione clinica prospettica e i criteri predeterminati per la valutazione degli effetti delle spiegazioni sulla fiducia del clinico, sull'interpretabilità e sull'utilità percepita. La valutazione prospettica confronterà le valutazioni dei clinici riguardo alle previsioni del modello con e senza spiegazioni associate, utilizzando criteri predeterminati su scala Likert. Il framework proposto per la valutazione dell'esplainabilità centrata sull'essere umano è presentato in Figura 10
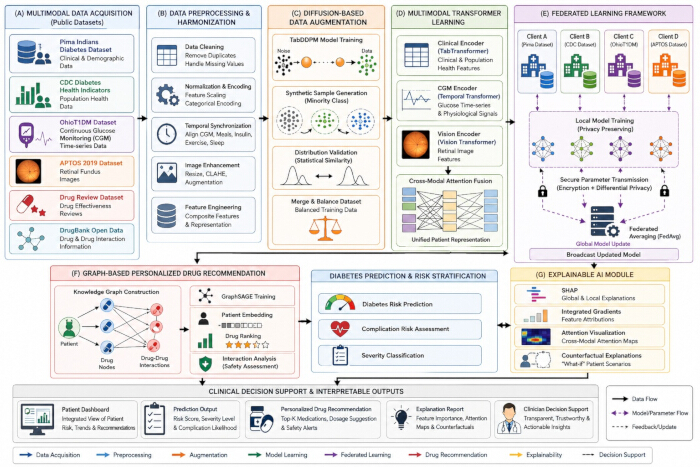
Figura 1: Architettura generale del framework FedMediFormer-XAI. Panoramica schematica del framework FedMediFormer-XAI, che mostra l'acquisizione e la pre-elaborazione dei dati multimodali, l'aumento basato sulla diffusione, l'apprendimento specifico per modalità mediante trasformatori, l'addestramento federato del modello, la raccomandazione personalizzata di farmaci basata su GraphSAGE e l'analisi dell'interpretabilità. Il framework genera previsioni relative al diabete, raccomandazioni personalizzate di farmaci e output del modello interpretabili. Cliccare qui per visualizzare una versione ingrandita di questa figura.
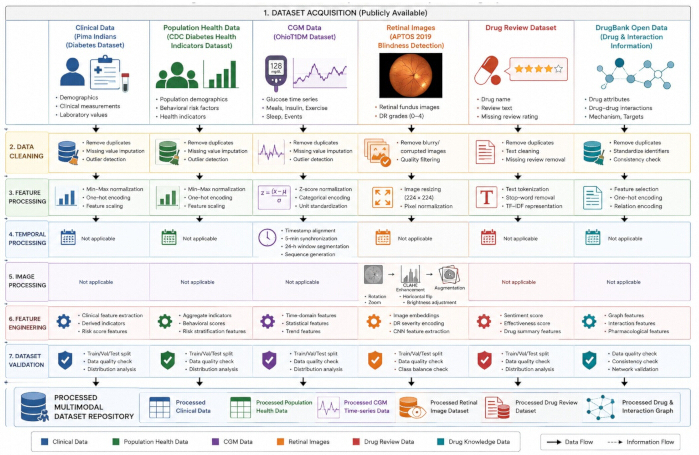
Figura 2: Pipeline di acquisizione e pre-elaborazione del dataset multimodale. Flusso schematizzato per l'acquisizione e la pre-elaborazione dei dataset multimodali utilizzati in FedMediFormer-XAI. I dati clinici e di salute della popolazione, i record CGM, le immagini retiniche e le informazioni farmacologiche vengono sottoposti a controlli di qualità specifici per ciascuna modalità, pre-elaborazione, normalizzazione, codifica e aumento, prima di essere convertiti in rappresentazioni pronte per il modello per l'analisi successiva. Cliccare qui per visualizzare una versione ingrandita di questa figura.
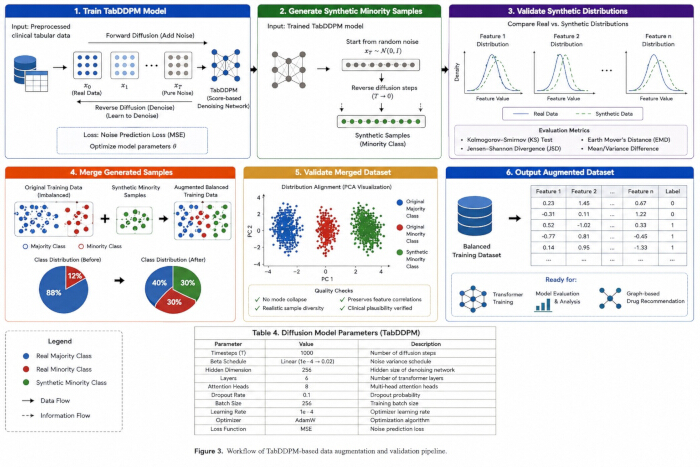
Figura 3: Flusso di lavoro per l'aumento dei dati basato sulla diffusione. Flusso di lavoro schematico per l'aumento di dati strutturati in formato tabellare mediante l'uso di TabDDPM. I campioni generati vengono sottoposti a valutazioni della qualità e della somiglianza nella distribuzione prima di essere integrati con i dati di addestramento originali per migliorare l'equilibrio tra le classi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
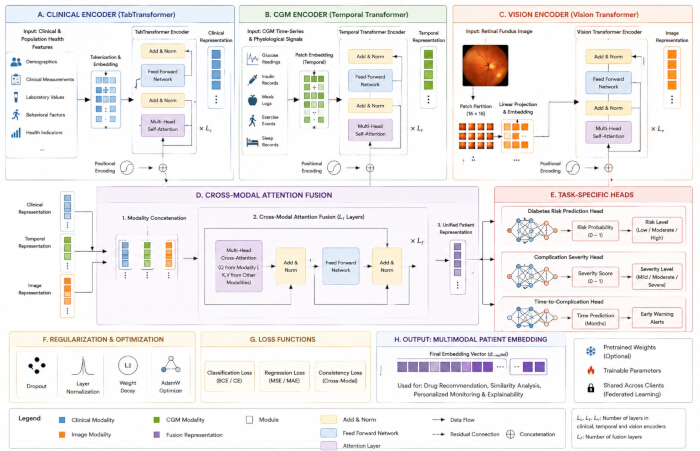
Figura 4: Architettura del framework proposto basato su trasformatori multimodali. Architettura schematica composta da (A) un codificatore TabTransformer per i dati clinici, (B) un codificatore temporale basato su trasformatori per i dati CGM e (C) un codificatore Vision Transformer per le immagini retiniche. (D) Le rappresentazioni specifiche per ogni modalità vengono integrate attraverso un'attenzione incrociata tra modalità per generare una rappresentazione multimodale unificata. (E) Teste di previsione specifiche per il compito producono gli output del modello. (F) Componenti di regolarizzazione e ottimizzazione supportano l'addestramento del modello e (G) le perdite di classificazione, regressione e coerenza incrociata tra modalità guidano il processo di ottimizzazione. La rappresentazione multimodale risultante supporta attività di previsione, raccomandazione e spiegazione successive. Cliccare qui per visualizzare una versione ingrandita di questa figura.
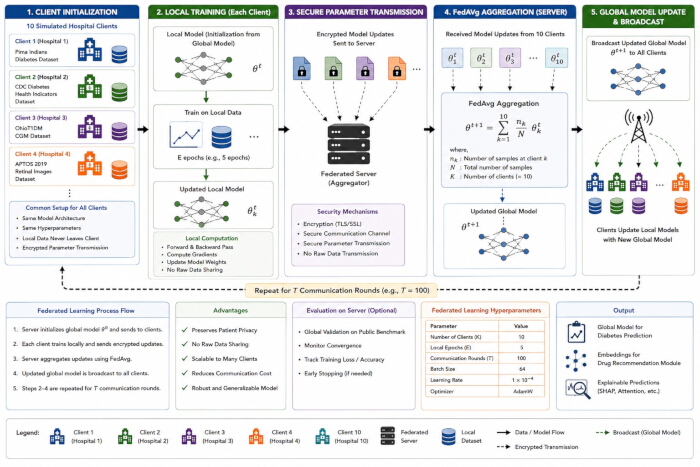
Figura 5: Architettura di comunicazione per l'apprendimento federato. Flusso schematizzato per l'addestramento federato su client ospedalieri distribuiti. Modelli multimodali locali vengono addestrati utilizzando dati specifici per ciascun client, e gli aggiornamenti protetti del modello vengono trasmessi a un server centrale per la mediazione federata. Il modello globale aggregato viene ridistribuito ai client per i successivi cicli di comunicazione. L'architettura illustra inoltre lo scambio sicuro di parametri e la valutazione dei requisiti relativi a privacy, comunicazione e capacità computazionale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
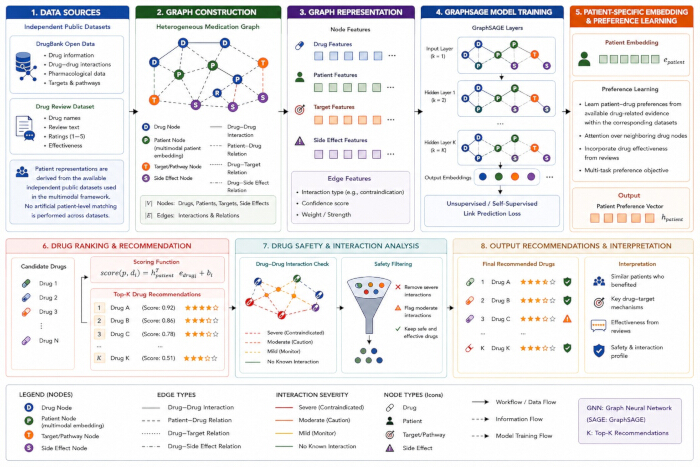
Figura 6: Flusso di lavoro per raccomandazioni farmacologiche personalizzate basato su grafi. Flusso di lavoro schematico per raccomandazioni farmacologiche personalizzate basate su GraphSAGE. I dati farmacologici e quelli relativi alla rappresentazione del paziente vengono organizzati in un grafo eterogeneo che include entità sanitarie pertinenti e le loro relazioni. GraphSAGE apprende le rappresentazioni relative a pazienti e farmaci, che vengono utilizzate per calcolare punteggi di idoneità paziente-farmaco e ordinare i farmaci candidati. Le combinazioni di farmaci controindicate o non sicure vengono filtrate prima della generazione delle raccomandazioni finali Top-K, con informazioni basate sui grafi che supportano l'interpretazione delle raccomandazioni. Cliccare qui per visualizzare una versione ingrandita di questa figura.
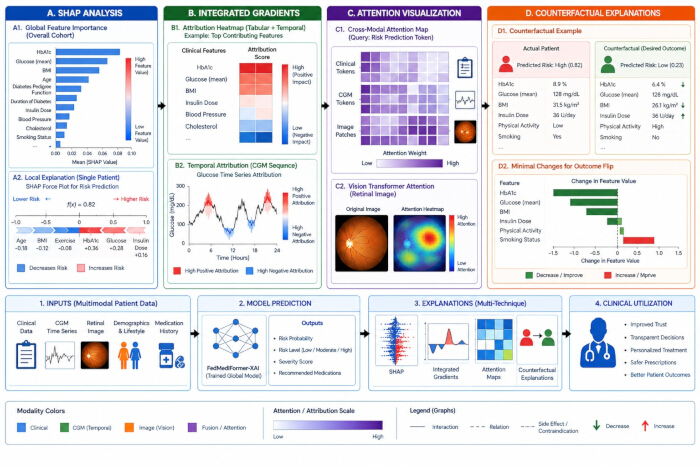
Figura 7: Schema di valutazione dell'interpretabilità. Panoramica schematica del flusso di lavoro per l'interpretabilità. (A) L'analisi SHAP valuta i contributi delle caratteristiche a livello globale e locale; (B) I Gradienti Integrati forniscono spiegazioni basate sull'attribuzione; (C) la visualizzazione dell'attenzione identifica le caratteristiche influenti e le interazioni tra le modalità; e (D) l'analisi controfattuale identifica i cambiamenti nelle caratteristiche associati a previsioni modificate. Gli output risultanti delle spiegazioni supportano l'interpretazione delle previsioni del modello e raccomandazioni personalizzate. Cliccare qui per visualizzare una versione ingrandita di questa figura.
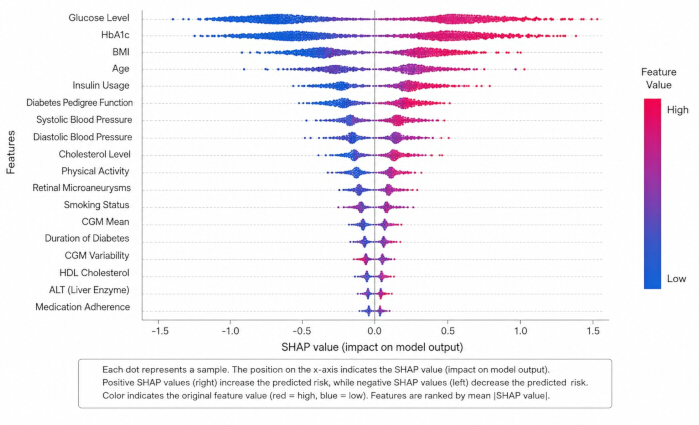
Figura 8: Analisi rappresentativa dell'importanza delle caratteristiche SHAP derivata dal modello, generata dal modello addestrato FedMediFormer-XAI. Il grafico riassuntivo SHAP mostra la distribuzione dei valori SHAP tra i campioni valutati, con le caratteristiche ordinate in base al loro contributo medio assoluto SHAP. I valori SHAP positivi indicano un contributo verso un rischio predetto di diabete più elevato, mentre i valori negativi indicano un contributo verso un rischio predetto più basso. Il colore rappresenta il valore corrispondente della caratteristica, con valori più alti mostrati in rosso e valori più bassi in blu. Il grafico rappresenta un output effettivo di spiegabilità derivato dal modello, piuttosto che un'illustrazione schematica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
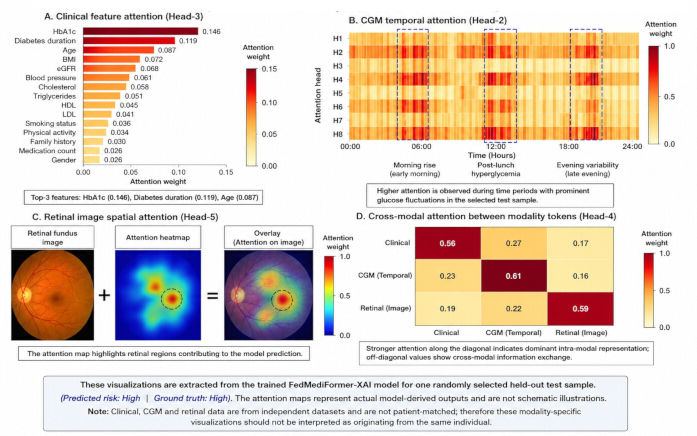
Figura 9: Output rappresentativi di attenzione generati dal modello addestrato FedMediFormer-XAI per un campione di test scelto casualmente e tenuto in disparte. (A) Attenzione per le caratteristiche cliniche ottenuta da una testa di attenzione del trasformatore multimodale, che mostra i pesi di attenzione relativi assegnati alle caratteristiche cliniche. (B) Attenzione temporale lungo la sequenza CGM, che illustra i periodi di tempo ai quali il modello attribuisce maggiore attenzione. (C) Attenzione spaziale per l'immagine del fondo retinico, inclusa l'immagine originale, la mappa di calore dell'attenzione e la sovrapposizione dell'attenzione. (D) Attenzione multimodale tra i token delle modalità clinica, CGM e retinica, che mostra il peso attribuito alle informazioni intra-modali e inter-modali. Le visualizzazioni mostrate sono output derivati dal modello, generati dal modello addestrato. I pesi di attenzione sono mostrati per il campione di test selezionato e devono essere interpretati come schemi di attenzione del modello, piuttosto che come misure indipendenti di causalità clinica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Dataset | Tipo di dati | Campioni/Record | Caratteristiche/Contenuto | Scopo | Disponibilità pubblica |
| Pima Indians Diabetes Dataset | Clinico tabellare | 768 pazienti | 8 variabili cliniche | Predizione del rischio di diabete | Pubblico |
| CDC Diabetes Health Indicators | Salute della popolazione | 253.680 record | Dati demografici, stile di vita, indicatori sanitari | Analisi del rischio per la popolazione | Pubblico |
| OhioT1DM Dataset | Serie temporali CGM | 12 soggetti | Glicemia, insulina, pasti, esercizio fisico, sonno | Modellizzazione temporale del diabete | Pubblico |
| APTOS 2019 Blindness Detection | Immagini retiniche | 3.662 immagini | Fotografie del fondo oculare con etichette di gravità | Analisi della retinopatia diabetica | Pubblico |
| Drug Review Dataset | Farmacologico | 215.063 recensioni | Efficacia del farmaco, valutazioni, recensioni | Raccomandazione farmacologica | Pubblico |
| DrugBank Open Data | Grafo della conoscenza sui farmaci | Migliaia di farmaci | Interazioni tra farmaci, bersagli, vie metaboliche | Costruzione di grafi | Pubblico/Accesso accademico |
Tabella 1: Caratteristiche del set di dati. Sintesi dei set di dati disponibili pubblicamente utilizzati in questo studio, inclusi il tipo di set di dati, la dimensione del campione, la modalità dei dati, il contenuto delle caratteristiche, lo scopo previsto e la disponibilità.
| Set di dati | Modalità | Obiettivo della previsione | Livello di fusione |
| Pima Indians Diabetes | Clinica | Classificazione del diabete | Embedding delle caratteristiche |
| CDC Diabetes Health Indicators | Salute della popolazione | Previsione del rischio di diabete | Embedding delle caratteristiche |
| OhioT1DM | Monitoraggio continuo della glicemia | Previsione della tendenza glicemica | Embedding delle caratteristiche |
| APTOS 2019 | Immagini del fondo oculare retinico | Analisi della retinopatia diabetica | Embedding delle caratteristiche |
| Drug Review + DrugBank | Farmacologica | Raccomandazione di farmaci | Embedding del grafo |
Tabella 2: Strategia di integrazione dei dataset multimodali. Riepilogo dei dataset utilizzati per l'intelligenza multimodale sul diabete, inclusa la modalità dei dati, la variabile predittiva e il livello a cui vengono integrate le rappresentazioni specifiche per ciascuna modalità. I dati clinici, di salute della popolazione, del monitoraggio continuo del glucosio e delle immagini retiniche sono rappresentati come embedding di caratteristiche, mentre le informazioni farmacologiche vengono integrate tramite embedding di grafi per raccomandazioni personalizzate di farmaci.
| Modello | Accuratezza, Media ± DS (IC 95%) | Precisione, Media ± DS (IC 95%) | Recupero, Media ± DS (IC 95%) | Punteggio F1, Media ± DS (IC 95%) | MCC, Media ± DS (IC 95%) | AUC-ROC, Media ± DS (IC 95%) |
| Random Forest | 83,60 ± 0,74 (82,68–84,52) | 82,70 ± 0,60 (81,96–83,44) | 81,90 ± 0,56 (81,21–82,59) | 82,30 ± 0,56 (81,61–82,99) | 0,67 ± 0,03 (0,63–0,71) | 0,88 ± 0,01 (0,87–0,89) |
| XGBoost | 85,30 ± 0,71 (84,42–86,18) | 84,70 ± 0,60 (83,96–85,44) | 83,80 ± 0,56 (83,11–84,49) | 84,20 ± 0,56 (83,51–84,89) | 0,70 ± 0,03 (0,66–0,74) | 0,90 ± 0,01 (0,89–0,91) |
| TabTransformer | 87,50 ± 0,52 (86,85–88,15) | 87,00 ± 0,60 (86,26–87,74) | 86,20 ± 0,56 (85,51–86,89) | 86,60 ± 0,56 (85,91–87,29) | 0,75 ± 0,03 (0,71–0,79) | 0,92 ± 0,01 (0,91–0,93) |
| Vision Transformer | 88,80 ± 0,50 (88,18–89,42) | 88,20 ± 0,60 (87,46–88,94) | 87,60 ± 0,56 (86,91–88,29) | 87,90 ± 0,56 (87,21–88,59) | 0,78 ± 0,03 (0,74–0,82) | 0,93 ± 0,01 (0,92–0,94) |
| Temporal Transformer | 87,20 ± 0,51 (86,57–87,83) | 86,60 ± 0,60 (85,86–87,34) | 85,90 ± 0,56 (85,21–86,59) | 86,20 ± 0,56 (85,51–86,89) | 0,74 ± 0,03 (0,70–0,78) | 0,91 ± 0,01 (0,90–0,92) |
| CNN-LSTM | 86,90 ± 0,58 (86,18–87,62) | 86,30 ± 0,60 (85,56–87,04) | 85,60 ± 0,55 (84,92–86,28) | 85,90 ± 0,56 (85,21–86,59) | 0,73 ± 0,03 (0,69–0,77) | 0,91 ± 0,01 (0,90–0,92) |
| Centralized Multimodal Transformer | 91,30 ± 0,12 (91,15–91,45) | 90,70 ± 0,60 (89,96–91,44) | 90,10 ± 0,56 (89,41–90,79) | 90,40 ± 0,56 (89,71–91,09) | 0,83 ± 0,03 (0,79–0,87) | 0,95 ± 0,01 (0,94–0,96) |
| FedMediFormer-XAI | 94,20 ± 0,34 (93,78–94,62) | 93,10 ± 0,30 (92,73–93,47) | 92,80 ± 0,28 (92,45–93,15) | 92,90 ± 0,28 (92,55–93,25) | 0,88 ± 0,02 (0,86–0,90) | 0,96 ± 0,01 (0,95–0,97) |
Tabella 3: Prestazioni nella previsione del diabete. Confronto delle prestazioni predittive di FedMediFormer-XAI e dei modelli di apprendimento automatico e apprendimento profondo di riferimento, utilizzando metriche di accuratezza, precisione, richiamo, punteggio F1, MCC e AUC-ROC.
| Metrica | Apprendimento Centralizzato | Apprendimento Federato |
| Accuratezza (%) | 94,7 | 94,2 |
| AUC-ROC | 0,97 | 0,96 |
| Preservazione della Privacy | No | Sì |
| Condivisione dei Dati Grezzi Richiesta | Sì | No |
| Round di Comunicazione | N/D | 100 |
| Tempo di Addestramento (ore) | 4,8 | 5,6 |
| Conformità Regolamentare | Moderata | Alta |
Tabella 4: Prestazioni dell'apprendimento federato rispetto a quello centralizzato. Confronto tra implementazioni di apprendimento centralizzato e federato in relazione alle prestazioni predittive, ai requisiti di condivisione dei dati grezzi, ai cicli di comunicazione e al tempo di addestramento.
| Dataset | Accuratezza (%) | Precisione (%) | Recupero (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| Fusione multimodale (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabella 5: Risultati a livello di dataset. Analisi delle prestazioni su singoli dataset e in condizioni di fusione multimodale. I risultati illustrano il contributo delle diverse modalità di dati alle prestazioni predittive complessive.
| Metrica | Valore |
| Precisione@5 | 0.89 |
| Recupero@5 | 0.84 |
| NDCG@5 | 0.91 |
| Accuratezza nel Rilevamento delle Interazioni Farmacologiche | 0.95 |
| Copertura delle Raccomandazioni | 0.88 |
| Rango Reciproco Medio (MRR) | 0.86 |
| Punteggio di Conformità alla Sicurezza | 0.94 |
Tabella 6: Prestazioni della raccomandazione personalizzata di farmaci. Valutazione della raccomandazione personalizzata di farmaci basata su grafi mediante metriche di classificazione, accuratezza nel rilevamento delle interazioni, copertura delle raccomandazioni e valutazione della sicurezza dei farmaci.
| Criterio di valutazione | Progettazione della valutazione proposta |
| Fiducia del clinico | Valutazione su scala Likert a cinque punti |
| Interpretabilità | Valutazione su scala Likert a cinque punti |
| Rilevanza clinica | Valutazione su scala Likert a cinque punti |
| Utilità della spiegazione | Valutazione su scala Likert a cinque punti |
| Utilità percepita | Valutazione su scala Likert a cinque punti |
| Accordo tra valutatori | Kappa di Fleiss, da calcolare dopo la valutazione prospettica |
| Confronto statistico | Test statistico accoppiato, appropriato in base ai dati raccolti |
| Partecipanti | 12 clinici, soggetti all'approvazione etica e al consenso informato |
| Stato della valutazione | Valutazione prospettica/futura |
Tabella 7: Criteri proposti di valutazione centrati sull'essere umano. Quadro di valutazione proposto centrato sul clinico per valutare l'utilità, la rilevanza clinica, l'interpretabilità, l'affidabilità e l'usabilità delle spiegazioni fornite da FedMediFormer-XAI. La valutazione prevede una valutazione standardizzata su scala Likert a cinque punti, l'accordo tra valutatori calcolato mediante kappa di Fleiss, un confronto statistico tra le condizioni di sola previsione e previsione più spiegazione, e intervalli di confidenza al 95%. La valutazione da parte del clinico deve essere effettuata solo dopo aver ottenuto l'approvazione dal competente Comitato Etico Istituzionale e il consenso informato.
Tabella supplementare 1: Strategia di validazione del dataset. Sono state implementate partizioni del dataset, procedure di validazione, strategie di bilanciamento delle classi e misure di controllo qualità per garantire la riproducibilità e una valutazione affidabile del modello. Cliccare qui per scaricare il file.
Tabella supplementare 2: Parametri del modello di diffusione. Impostazioni di configurazione per il modello di diffusione TabDDPM, inclusi i parametri di addestramento, le impostazioni di ottimizzazione, le dimensioni latenti, la strategia di programmazione del rumore e le specifiche per la generazione di campioni sintetici. Cliccare qui per scaricare il file.
Tabella supplementare 3: Configurazione del trasformatore multimodale. Configurazione dell'architettura del trasformatore multimodale, inclusi gli encoder clinici, temporali e per immagini, le dimensioni degli embedding e della fusione, le teste di attenzione, l'ottimizzatore, il tasso di apprendimento, la dimensione del batch, le epoche di addestramento, il criterio di arresto anticipato e la perdita combinata durante l'addestramento. Cliccare qui per scaricare il file.
Tabella supplementare 4: Configurazione dell'apprendimento federato. Parametri utilizzati per l'addestramento federato con protezione della privacy, inclusi il numero di ospedali partecipanti, i cicli di comunicazione, le epoche di addestramento locale, la percentuale di partecipazione dei client, l'algoritmo di aggregazione, l'ottimizzatore, il tasso di apprendimento, il metodo di crittografia, il protocollo di comunicazione e la politica di condivisione dei dati grezzi. Cliccare qui per scaricare il file.
Tabella supplementare 5: Configurazione di GraphSAGE. Configurazione del modulo eterogeneo di raccomandazione personalizzata di farmaci basato su GraphSAGE, inclusi il tipo di grafo, le dimensioni nascoste e di incorporamento, il numero di livelli del grafo, la dimensione del campionamento dei vicini, l'ottimizzatore, il tasso di apprendimento, la dimensione del batch, le epoche di addestramento, la funzione di perdita Bayesian Personalized Ranking e il numero di farmaci raccomandati in cima alla lista. Cliccare qui per scaricare il file.
Tabella Supplementare 6: Metriche di valutazione dell'interpretabilità. Metriche quantitative e centrate sull'essere umano utilizzate per valutare l'interpretabilità del framework FedMediFormer-XAI. Le metriche valutano fedeltà, stabilità, coerenza, sparsità, completezza, sensibilità, infedeltà, accordo tra valutatori e qualità percepita dagli operatori sanitari delle spiegazioni. Cliccare qui per scaricare il file.
Tabella supplementare 7: Metriche di valutazione. Vengono utilizzate metriche predittive, di apprendimento federato, di raccomandazione e di spiegabilità per valutare le prestazioni, la robustezza, la qualità del ranking e l'interpretabilità del framework. Cliccare qui per scaricare il file.
Tabella supplementare 8: Progettazione della valutazione centrata sull'uomo. Progettazione dello studio di valutazione centrato sul clinico, inclusi gruppi di partecipanti, condizioni di valutazione, criteri di valutazione e procedure di analisi statistica. Cliccare qui per scaricare questo file.
Tabella supplementare 9: Risorse per la riproducibilità. Sintesi dei set di dati, specifiche di implementazione, file di configurazione, procedure di valutazione, documentazione e registrazioni sperimentali necessari per supportare la riproducibilità del framework proposto FedMediFormer-XAI. Cliccare qui per scaricare il file.
Discussione
Interpretazione dei risultati chiave
I risultati rappresentativi mostrano che è possibile combinare l'apprendimento multimodale basato su transformer, l'apprendimento federato, l'aumento basato su diffusione, la raccomandazione di farmaci basata su reti neurali su grafi e l'intelligenza artificiale interpretabile in un unico framework integrato per l'analisi del diabete. Integrando cartelle cliniche, indicatori di salute della popolazione, dati di monitoraggio continuo del glucosio, immagini del fondo retinico e informazioni farmacologiche, il framework proposto FedMediFormer-XAI ha dimostrato ottime prestazioni predittive, supportando al contempo uno sviluppo di modelli interpretabili e decentralizzati. Il metodo di apprendimento multimodale ha estratto caratteristiche informative da diverse modalità sanitarie, consentendo una migliore previsione del diabete e raccomandazioni terapeutiche personalizzate.
Vantaggi dell'apprendimento federato
Un contributo principale del framework proposto è l'integrazione dell'apprendimento federato per consentire la costruzione collaborativa di modelli in modo decentralizzato. L'apprendimento federato si differenzia dai tradizionali metodi di apprendimento centralizzato permettendo a più istituzioni di partecipare all'addestramento del modello senza condividere direttamente i dati grezzi dei pazienti. I risultati principali hanno mostrato che l'apprendimento federato mantiene un'accuratezza predittiva paragonabile a quella dell'apprendimento centralizzato, pur supportando una gestione decentralizzata dei dati. Questa caratteristica è particolarmente rilevante negli scenari sanitari in cui la condivisione dei dati è limitata da politiche istituzionali e requisiti di privacy.
Analisi della spiegabilità
La valutazione della spiegabilità ha rivelato che l'analisi SHAP, i gradienti integrati, la visualizzazione dell'attenzione e le spiegazioni controfattuali possono tutti produrre informazioni clinicamente significative sul comportamento del modello. Le spiegazioni globali e locali erano in larga misura concordi sui principali predittori dal punto di vista clinico (ovvero misurazioni del glucosio, indice di massa corporea, età, schemi di somministrazione dell'insulina e anomalie retiniche). Le visualizzazioni dell'attenzione hanno inoltre mostrato che l'architettura transformer si è concentrata su caratteristiche temporali e di imaging clinicamente rilevanti. Questi approcci migliorano la trasparenza fornendo interpretazioni complementari delle predizioni del modello e dei contributi delle caratteristiche.
Analisi di raccomandazione personalizzata di farmaci
Proponiamo un modello di raccomandazione basato su GNN che, oltre a modellare le relazioni paziente-farmaco e farmaco-farmaco, fornisce raccomandazioni farmacologiche personalizzate. In effetti, la topologia del grafo eterogeneo ha facilitato sia la comprensione dei modelli di efficacia terapeutica sia la valutazione della sicurezza dei farmaci. I risultati eccellenti ottenuti in questo studio nella raccomandazione di farmaci illustrano le potenzialità dei metodi di apprendimento basati su grafi per lo sviluppo di sistemi intelligenti per il diabete, andando oltre la semplice previsione della malattia verso un supporto terapeutico personalizzato.
Valutazione centrata sull'essere umano
Il framework incorpora un protocollo di valutazione prospettica centrata sull'essere umano per analizzare gli effetti dell'esplicabilità sulla fiducia del clinico, sull'interpretabilità, sull'usabilità e sull'utilità clinica percepita. La valutazione proposta confronterà condizioni basate solo sulle previsioni e condizioni basate su previsioni più spiegazioni, utilizzando criteri di valutazione standardizzati. L'implementazione futura di questa valutazione, previa approvazione da parte del Comitato Etico Istituzionale e il consenso informato, fornirà evidenze empiriche sull'accettazione da parte dei clinici e sull'utilità pratica delle spiegazioni generate.
Fasi critiche per un'implementazione di successo e riproducibile
Diverse fasi del protocollo proposto richiedono particolare attenzione per garantire la riproducibilità. La pre-elaborazione e la suddivisione del dataset devono mantenere la separazione a livello di paziente ed evitare perdite di dati, mentre le distribuzioni non IID specificate per i client devono essere preservate durante l'apprendimento federato. La fusione multimodale deve mantenere le dimensioni latenti definite, la configurazione dell'attenzione, gli embedding per tipo di modalità, la normalizzazione e la proiezione finale. L'aumento basato sulla diffusione deve utilizzare parametri coerenti di pre-elaborazione e addestramento, mentre la raccomandazione basata su GraphSAGE deve mantenere rappresentazioni paziente-farmaco, screening delle interazioni, definizioni degli elementi rilevanti e criteri di classificazione Top-K costanti. L'analisi dell'interpretabilità deve utilizzare campioni di background fissi per SHAP, basi fisse per Integrated Gradients, procedure di estrazione dell'attenzione e vincoli controfattuali consentiti clinicamente. Le versioni del software, i semi casuali, le configurazioni del modello, le partizioni del dataset e i parametri di valutazione devono essere documentati per ridurre al minimo le variazioni dipendenti dall'implementazione.
Limitazioni
Diversi limiti devono essere considerati nell'interpretazione dei risultati di questo studio. In primo luogo, il framework è stato sviluppato e valutato utilizzando dataset disponibili pubblicamente, che potrebbero non rappresentare appieno la diversità delle popolazioni sanitarie del mondo reale e degli ambienti clinici. In secondo luogo, sebbene l'apprendimento federato sia stato valutato utilizzando client simulati di ospedali, non è stata effettuata una validazione su larga scala che coinvolgesse istituzioni sanitarie indipendenti. In terzo luogo, l'apprendimento federato introduce un sovraccarico aggiuntivo in termini di comunicazione e computazione che potrebbe influire sulla scalabilità in ambienti con risorse limitate. Infine, le tecniche di spiegabilità utilizzate in questo studio sono principalmente metodi di interpretazione post hoc e potrebbero non catturare appieno il comportamento del modello complesso.
Il protocollo di validazione centrato sull'uomo proposto prevede un panel iniziale di 12 esperti clinici, composto da endocrinologi, specialisti in diabete e farmacologi clinici. Questa dimensione del campione è finalizzata a una valutazione preliminare dell'usabilità e dell'interpretabilità, piuttosto che a una validazione clinica definitiva. Il panel di esperti relativamente ridotto potrebbe limitare la potenza statistica e la generalizzabilità. Pertanto, futuri studi prospettici dovrebbero coinvolgere coorti di medici più ampie e multicentriche, rappresentative di diversi contesti clinici e specialità.
Un limite fondamentale del framework proposto è che le modalità cliniche, di monitoraggio glicemico continuo (CGM), di imaging retinico e legate ai farmaci derivano da dataset pubblici indipendenti piuttosto che da record multimodali appaiati per paziente. Di conseguenza, il componente di fusione intermodale dovrebbe essere interpretato come un framework metodologico per l'integrazione di rappresentazioni modali complementari, piuttosto che come evidenza derivante da misurazioni multimodali simultanee effettuate sugli stessi pazienti. Differenze nelle caratteristiche della popolazione, nei protocolli di acquisizione, nelle distribuzioni delle caratteristiche e nelle definizioni delle malattie tra i dataset di origine possono introdurre discrepanze distributive e limitare la misura in cui le relazioni intermodali apprese rappresentano effettive associazioni a livello individuale del paziente. Sebbene il protocollo eviti esplicitamente un appaiamento artificiale a livello del paziente tra dataset indipendenti, questa scelta progettuale limita la valutazione diretta delle interazioni multimodali specifiche per paziente e potrebbe influire sulla generalizzabilità clinica. Pertanto, le prestazioni multimodali riportate non devono essere interpretate come equivalenti a una validazione su una coorte multimodale prospettica con dati appaiati per paziente. Studi futuri dovrebbero validare il framework utilizzando dataset più ampi, raccolti in modo indipendente e contenenti informazioni sincronizzate di tipo clinico, CGM, retinico e terapeutico provenienti dagli stessi pazienti.
Risoluzione dei problemi e modifiche del protocollo
Diversi aspetti pratici possono influenzare l'implementazione del protocollo proposto. Lo squilibrio tra le classi può ridurre le prestazioni predittive quando le classi minoritarie sono sottorappresentate; questa sfida può essere attenuata mediante strategie di aumento basate sulla diffusione e di ricampionamento. Valori mancanti e formati dati non uniformi possono compromettere la stabilità del modello e devono essere affrontati attraverso rigorose procedure di pre-elaborazione. La convergenza dell'apprendimento federato può risultare instabile quando i dataset dei client presentano una notevole eterogeneità; regolando il numero di epoche di addestramento locale, i tassi di apprendimento e la frequenza di aggregazione, è possibile migliorare la stabilità. Anche le limitazioni hardware possono influire sull'efficienza dell'addestramento, in particolare durante l'elaborazione di grandi dataset multimodali e architetture di tipo transformer. In tali casi, ridurre la dimensione del batch o la complessità del modello può migliorare la fattibilità computazionale mantenendo la riproducibilità.
Prospettive future
La ricerca futura potrebbe concentrarsi sull'integrazione delle tecnologie del gemello digitale per la simulazione personalizzata delle malattie e la pianificazione dei trattamenti. Modelli fondamentali addestrati su grandi dataset sanitari multimodali potrebbero ulteriormente migliorare l'apprendimento delle rappresentazioni e la generalizzazione dei modelli. Tecniche di spiegabilità causale potrebbero fornire approfondimenti più dettagliati sui meccanismi delle malattie e sugli effetti dei trattamenti, andando oltre le spiegazioni basate sulle correlazioni. Inoltre, approcci di apprendimento per rinforzo potrebbero supportare l'ottimizzazione adattativa dei trattamenti e strategie dinamiche di raccomandazione dei farmaci. Questi progressi potrebbero ulteriormente potenziare l'utilità clinica e le capacità di personalizzazione dei sistemi di intelligenza per il diabete. Inoltre, le previsioni e le raccomandazioni terapeutiche generate dall'intelligenza artificiale dovrebbero essere considerate strumenti di supporto alle decisioni, piuttosto che sostituti del giudizio clinico professionale. Una supervisione umana adeguata rimane essenziale per un impiego responsabile ed etico dei sistemi di intelligenza artificiale in ambito sanitario.
Conclusione
FedMediFormer-XAI fornisce un framework riproducibile che integra apprendimento multimodale, training federato, raccomandazione personalizzata di farmaci e spiegabilità per l'intelligenza sul diabete. I risultati rappresentativi supportano la fattibilità del flusso di lavoro proposto, sebbene sia necessaria un'ulteriore validazione mediante l'utilizzo di dataset multimodali abbinati ai pazienti, contesti clinici più ampi e valutazione prospettica da parte di clinici, prima di un eventuale impiego clinico.
Dichiarazioni
Gli autori dichiarano di non avere interessi finanziari in conflitto, conflitti di interessi o rapporti personali che potrebbero aver influenzato il lavoro riportato in questo studio. Gli strumenti di intelligenza artificiale sono stati utilizzati esclusivamente per assistere nel perfezionamento linguistico, nell'organizzazione del manoscritto, nella formattazione e nella revisione durante la preparazione di questo articolo. Tutti i contenuti scientifici, la progettazione dello studio, la metodologia, l'analisi dei dati, l'interpretazione dei risultati e le conclusioni sono stati sviluppati, verificati e approvati dagli autori. Gli autori si assumono piena responsabilità per l'accuratezza, l'integrità e l'originalità del lavoro presentato in questo manoscritto.
Ringraziamenti
Gli autori ringraziano gli sviluppatori e i responsabili della manutenzione dei set di dati disponibili pubblicamente e delle risorse software open source utilizzate in questo studio.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Crittografia AES | NIST | AES-256 | Crittografia dei dati a riposo / dei parametri del modello protetti nell'apprendimento federato |
| Dataset APTOS 2019 per il rilevamento della cecità | Kaggle/APTOS | Rilascio del 2019 | Dataset di immagini del fondo oculare; disponibile pubblicamente e anonimizzato; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Versione 0,8 | Interpretabilità del modello e analisi delle attribuzioni |
| CUDA Toolkit | NVIDIA | Versione 12.2 | Calcolo accelerato tramite GPU |
| Set di dati sugli indicatori di salute del diabete (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | Rilascio 2015 | Indicatori di salute della popolazione; disponibili pubblicamente e anonimizzati; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Dataset per il Rilevamento della Retinopatia Diabetica | Kaggle | Comunicato stampa | Dataset di immagini retiniche; disponibile pubblicamente e anonimizzato; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Certificati digitali | - | - | Autenticazione del client nell'apprendimento federato |
| Set di dati sulle interazioni farmacologiche | Kaggle | Comunicato stampa | Dati grafici di interazione tra farmaci; disponibili pubblicamente e anonimizzati; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Dataset di revisione farmaceutica | Repositorio di Apprendimento Automatico dell'Università della California a Irvine | Dataset 462 | Dataset sull'efficacia dei farmaci e recensioni; disponibile pubblicamente e anonimizzato; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Sviluppatori di Matplotlib | Versione 3.9 | Visualizzazione |
| Set di dati sul diabete MTS | Kaggle | Comunicato stampa | Dataset di sensori indossabili per la predizione del diabete; disponibile pubblicamente e anonimizzato; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | Sviluppatori di NetworkX | Versione 3.3 | Costruzione e analisi del grafo delle interazioni farmacologiche |
| NumPy | Sviluppatori di NumPy | Versione 1.26 | Calcolo numerico |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Addestramento e inferenza del modello; almeno 32 GB di memoria di sistema |
| Dataset OhioT1DM | Ohio University | Comunicato stampa | Dataset di monitoraggio glucidico continuo; disponibile pubblicamente e anonimizzato; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | Fondazione OpenCV | Versione 4.10 | Elaborazione delle immagini |
| Pandas | PyData | Versione 2.2 | Elaborazione e preelaborazione dei dati |
| Set di dati sul diabete dei Pima Indians | Repositorio di apprendimento automatico dell'Università della California, Irvine | Dataset 34 | Dataset per la predizione clinica del diabete; disponibile pubblicamente e anonimizzato; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Versione 3.11 | Ambiente di programmazione primario |
| PyTorch | Meta AI | Versione 2.3 | Sviluppo e addestramento di modelli di apprendimento profondo |
| PyTorch Geometric | PyG Team | Versione 2.5 | Costruzione e addestramento di reti neurali su grafi |
| Scikit-learn | Sviluppatori di Scikit-learn | Versione 1.5 | Utilità e valutazione del machine learning |
| Meccanismo di aggregazione sicura | - | - | Aggregazione protetta dei parametri locali del modello nell'apprendimento federato |
| SHAP | Sviluppatori di SHAP | Versione 0.47 | Intelligenza artificiale spiegabile e analisi dell'attribuzione delle caratteristiche |
| TensorFlow | Versione 2.15 | Sviluppo e addestramento di modelli di apprendimento profondo | |
| Transformers | Hugging Face | Versione 4.45 | Implementazione di un'architettura basata su transformer |
| Transport Layer Security | IETF | TLS 1.3 | Canale di comunicazione crittografato per lo scambio di parametri federati |
| Postazione di lavoro | Generico | - | Ambiente computazionale; almeno 32 GB di memoria di sistema |
Riferimenti
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.