Questo studio integra un esperimento basato su scenari ed elettroencefalogrammi per esaminare come il contesto dei ruoli di esperto e di accompagnatore sia associato alla fiducia nei diversi contesti delle attività mediche.
Articolo metodologico
Inquadramento del ruolo e fiducia nell'IA medica: prove da un esperimento basato su scenari ed EEG
In questo articolo
Sommario
Abstract
L'intelligenza artificiale medica online si è evoluta da strumenti analitici di back-end a interfacce di servizio rivolte ai pazienti, rendendo la fiducia calibrata un problema sempre più importante in termini di progettazione e governance. Basandosi sulla teoria della coerenza del ruolo, questo studio ha esaminato come l'attribuzione del ruolo di esperto o di compagno sia associata alla fiducia in diversi contesti di compiti medici. Lo studio 1 ha utilizzato un esperimento basato su scenari 2 (ruolo: esperto vs. compagno) × 2 (compito: consulenza su malattia vs. consulenza su salute) (N = 300). L'attribuzione del ruolo di esperto ha aumentato la percezione di professionalità, mentre quella di compagno ha aumentato la presenza sociale; entrambe le percezioni erano indipendentemente associate alla fiducia complessiva quando inserite contemporaneamente nel modello. L'associazione indiretta tramite la percezione di professionalità era condizionata dal contesto del compito, ma un confronto diretto tramite bootstrap non ha mostrato differenze significative tra gli indici di moderazione-mediata per la fiducia complessiva. Le analisi diagnostica delle misure hanno indicato un notevole sovrapporsi tra la professionalità percepita e la fiducia cognitiva, e tra la presenza sociale e la fiducia affettiva, richiedendo un'interpretazione cauta. Lo studio 2 ha confrontato affermazioni attribuite al ruolo di esperto e di compagno utilizzando l'EEG in 39 osservazioni accoppiate. L'attribuzione del ruolo di esperto è stata accompagnata da un maggiore ERS (sincronizzazione della potenza) nella banda theta fronto-medianea e da un ΔPLV theta FCz-F6 meno negativo rispetto al basale, mentre a livello comportamentale non si sono osservate differenze significative nel tasso di fiducia, nel tempo di risposta o nel tasso di risposte mancanti. Questi risultati EEG rappresentano correlati esplorativi a livello di processo, piuttosto che una validazione neurale del modello indiretto condizionale. Nel complesso, gli indizi relativi al ruolo sembrano modellare valutazioni non esclusive orientate alla competenza e orientate alla relazione. La progettazione del ruolo dovrebbe sostenere una dipendenza calibrata attraverso confini delle capacità, comunicazione dell'incertezza, avvisi basati sul rischio e opportuni meccanismi di escalation, piuttosto che semplicemente massimizzare la fiducia.
Introduzione
L'IA medica copre attualmente applicazioni lato server come il riconoscimento delle immagini, l'analisi patologica e la scoperta di farmaci, oltre a interfacce di servizio rivolte ai pazienti. Le analisi del settore prevedono una crescita continua del mercato dell'IA sanitaria fino al 20331. I modelli linguistici di grandi dimensioni consentono ai sistemi di IA medica di rispondere a domande sanitarie, interpretare risultati di test, riassumere informazioni e fornire raccomandazioni in linguaggio naturale2. Questo cambiamento modifica il rapporto dell'utente con la tecnologia. Uno strumento analitico lato server viene valutato da clinici e organizzazioni, mentre un'interfaccia rivolta ai pazienti deve comunicare il proprio ruolo, le evidenze, l'incertezza e i limiti agli utenti. L'IA medica può presentarsi come un assistente diagnostico, un'interfaccia da medico di famiglia o un compagno per la gestione della salute, e ognuna di queste forme può influenzare la percezione dell'utente riguardo all'identità del servizio offerto dal sistema. Poiché questi sistemi partecipano sempre più alle consulenze per malattie e alla gestione quotidiana della salute, la fiducia diventa qualcosa di più di un semplice atteggiamento verso la tecnologia. Essa influenza se gli utenti rivelano informazioni, considerano credibili le raccomandazioni, interagiscono con il sistema e agiscono seguendo indicazioni sanitarie. La fiducia è dunque una questione centrale nella progettazione e nel governo delle piattaforme digitali per la salute.
La sola capacità tecnica non determina se gli utenti considerano l'intelligenza artificiale medica come credibile e accettabile. Le revisioni sugli agenti conversazionali in ambito sanitario mostrano che l'implementazione dipende dalla qualità dell'interazione, dalla rilevanza clinica, dalla trasparenza e dalle condizioni di utilizzo3. Studi recenti sull'evidenza credibile per l'intelligenza artificiale medica sostengono in modo analogo che la prestazione del modello non è sufficiente se le affermazioni non sono supportate da evidenze adeguate all'uso previsto4. La trasparenza è essenziale perché i pazienti devono poter identificare i limiti delle capacità, l'incertezza e la base di una raccomandazione, piuttosto che dedurre l'affidabilità unicamente da un linguaggio scorrevole5. La ricerca sui sistemi informativi considera in modo simile l'adozione della diagnosi assistita dall'IA come un problema di configurazione della fiducia, in cui interpretabilità, protezione della privacy e segnali dell'interfaccia influenzano congiuntamente l'accettazione6. Queste considerazioni sono importanti per le interfacce basate su modelli linguistici. La scorrevolezza può rendere una risposta facile da comprendere, lasciando irrisolto se il sistema possieda conoscenze cliniche, se la sua raccomandazione si applichi alle circostanze dell'utente e quando sia necessario un intervento da parte di un clinico qualificato. La domanda rilevante non è soltanto se l'intelligenza artificiale medica può produrre una risposta, ma se gli utenti possono valutarla con un livello di fiducia appropriato.
La fiducia nell'intelligenza artificiale medica è sensibile al contesto della prestazione. Le ricerche sulla resistenza all'intelligenza artificiale medica mostrano che gli utenti possono rifiutare le raccomandazioni algoritmiche in decisioni ad alto rischio perché ritengono che un algoritmo non possa tenere conto della loro unicità7. Tuttavia, questa resistenza non è universale. Gli studi sull'apprezzamento degli algoritmi indicano che le persone possono preferire il giudizio algoritmico quando le attività sono oggettive e le regole più chiare8. Nelle consultazioni sanitarie online, la personalizzazione e l'accuratezza dei consigli generati dall'IA influenzano la fiducia e l'adozione9. Ricerche basate su scelte discrete che confrontano consultazioni tradizionali, digitali e basate sull'IA rilevano inoltre che preferenze e aspettative di fiducia variano a seconda del formato10. Il lavoro di squadra tra esseri umani e IA può inoltre ridurre la resistenza, trasferendo la fiducia dall'esperienza umana a un servizio supportato dall'IA11. La fiducia nell'intelligenza artificiale medica si sviluppa quindi attraverso l'interazione tra rischio percepito, esigenze della prestazione, stile comunicativo e valutazione del sistema. La consultazione per una malattia rende evidenti l'incertezza, la possibile perdita, le conseguenze diagnostiche e i costi degli errori. La consulenza sanitaria riguarda più spesso alimentazione, esercizio fisico, sonno, aderenza terapeutica e gestione preventiva, ambiti in cui un'interazione prolungata e l'accessibilità relazionale possono assumere un peso maggiore. Di conseguenza, lo stesso segnale dell'interfaccia può essere interpretato in modo diverso quando un utente cerca aiuto per una possibile malattia piuttosto che per la gestione sanitaria a lungo termine.
L'inquadramento del ruolo è una caratteristica dell'interfaccia attraverso cui tali aspettative possono essere comunicate. L'intelligenza artificiale in ambito medico può essere presentata come un esperto che enfatizza l'autorità professionale, il ragionamento strutturato, i confini clinici e le evidenze di capacità, oppure come un compagno che sottolinea empatia, rassicurazione, supporto sociale e continuità. Questa distinzione riguarda competenza e calore, le due dimensioni della percezione sociale, ma non si riduce semplicemente alla scelta tra un sistema competente e un sistema empatico12. Lo stile comunicativo e l'inquadramento dell'agency influenzano le valutazioni degli agenti conversazionali13. Nelle applicazioni mediche mobili, i segnali sociali e le preoccupazioni relative alla privacy influiscono congiuntamente sulla fiducia e sull'intenzione comportamentale14. I segnali antropomorfi negli agenti conversazionali sanitari possono aumentare la presenza sociale, la fiducia e l'accettazione, sebbene possano anche generare aspettative che superano le effettive capacità del sistema15. Studi sui team umano-AI mostrano inoltre che calore e competenza predicono diverse forme di ricettività16. In compiti ad alto rischio, la fiducia dipende dall'allineamento tra ruolo del team, contesto della mansione e violazione delle prestazioni17. La coerenza tra il ruolo sociale di un chatbot e le sue prestazioni influisce anche sulla costruzione e sul ripristino della fiducia18. I segnali di esperto e di compagno, pertanto, rendono evidenti diversi criteri valutativi piuttosto che modificare semplicemente il tono della conversazione.
Rimangono due lacune. In primo luogo, la ricerca non ha spiegato come la rilevanza di segnali orientati alla competenza e alla relazione cambi in base alle esigenze del compito medico. Le revisioni sulla fiducia umana nell'intelligenza artificiale sottolineano la dipendenza dal contesto, ma non chiariscono come i segnali di esperto e di compagno operino nelle consultazioni relative a malattia e salute19. In secondo luogo, gli studi sulla fiducia nell'IA medica si basano su autovalutazioni, fornendo prove limitate sui processi associati alla valutazione modulata dal ruolo. Privacy, trasparenza, responsabilità e bias limitano inoltre l'interpretazione dei segnali di ruolo nella parte front-end20,21. Per colmare queste lacune, questo studio si basa sulla teoria della congruità di ruolo, che spiega la valutazione attraverso l'allineamento tra segnali di ruolo e richieste salienti nel contesto22. Lo studio 1 utilizza un esperimento randomizzato con disegno fattoriale 2 (ruolo: esperto vs. compagno) × 2 (compito: consultazione per malattia vs. consultazione per salute) basato su scenari (N = 300) per esaminare l'inquadramento del ruolo, il contesto del compito e associazioni indirette parallele attraverso la percezione di professionalità e presenza sociale. Lo studio 2 utilizza un esperimento EEG separato, con disegno within-subjects (N = 39), per confrontare l'attività nella banda theta in risposta a affermazioni inquadrate come esperto o come compagno. Lo studio 1 valuta associazioni comportamentali e moderazione contestuale; lo studio 2 fornisce un confronto esplorativo a livello di processo, piuttosto che una validazione neurale del modello indiretto condizionale.
Quadro teorico e sviluppo dell'ipotesi
Ruolo del framing nell'intelligenza artificiale medica
L'IA medica opera in contesti ad alto rischio che coinvolgono la predisposizione alle malattie, le raccomandazioni terapeutiche, la responsabilità legale e i confini etici23. La definizione del ruolo è quindi rilevante perché il linguaggio iniziale può rendere più o meno evidenti all'utente i limiti delle capacità, delle evidenze e delle responsabilità. Anche la ricerca sulla trasparenza sottolinea che i sistemi di IA medica dovrebbero comunicare chiaramente i limiti delle proprie capacità e le basi delle evidenze5. Le risposte in stile esperto trasmettono competenza attraverso terminologia formale, ragionamento strutturato, dichiarazioni di limiti e raccomandazioni d'azione, mentre le risposte in stile compagno trasmettono supporto relazionale mediante empatia, rassicurazione e un linguaggio collaborativo. Questi indicatori non sono semplicemente elementi decorativi dell'interfaccia: essi modellano gli standard che gli utenti applicano quando valutano un sistema24,25. L'antropomorfizzazione può suscitare risposte sociali, ma può anche generare aspettative irrealistiche e confondere i confini della responsabilità26,27. Le ricerche sui team uomo-IA e sui chatbot indicano inoltre che la cordialità, la competenza, l'adeguatezza del ruolo rispetto al contesto e la coerenza tra ruolo sociale e prestazione influenzano l'accettazione e la fiducia16,17,18. In questo studio, la congruità del ruolo indica l'allineamento tra gli indicatori trasmessi da una risposta dell'IA e le esigenze valutative evidenti nel compito della consultazione22.
Doppio percorso di fiducia: professionalità percepita e presenza sociale
La congruità di ruolo è dedotta dall'interazione osservata tra ruolo e compito, piuttosto che misurata come costrutto soggettivo separato. L'interpretazione è quindi legata all'interazione sperimentale e non implica che i partecipanti abbiano riferito consapevolmente una sensazione di adattamento al ruolo. La fiducia comprende giudizi cognitivi riguardo competenza e affidabilità e giudizi affettivi riguardo sicurezza relazionale e comfort28,29,30. Nell'uso dell'IA in ambito medico, gli utenti valutano sia la capacità del sistema di supportare una decisione sanitaria, sia il fatto che l'interazione con esso risulti sufficientemente sicura e accessibile. L'inquadramento da esperto dovrebbe rendere più evidente la valutazione orientata alla competenza. Evidenze provenienti dalla ricerca sui sistemi di supporto alle decisioni cliniche indicano che spiegazioni e informazioni sul ragionamento del sistema influenzano la fiducia e il grado di affidamento31. Nelle consultazioni sanitarie online, personalizzazione e attenzione al paziente sono anch'esse associate a fiducia e accettazione9. La professionalità percepita cattura una valutazione orientata alla competenza, rilevante per la fiducia25. La ricerca sulle consultazioni sanitarie online identifica inoltre la credibilità della fonte come fattore rilevante per l'accettazione degli utenti riguardo i suggerimenti sanitari32. Il presente studio verifica quindi se l'inquadramento da esperto sia associato a una maggiore professionalità percepita.
H1: I ruoli di accompagnamento generano una minore professionalità percepita rispetto alle intelligenze artificiali mediche di tipo esperto.
L'inquadramento di confronto dovrebbe rendere più evidente la valutazione relazionale. La presenza sociale si riferisce alla qualità interpersonale percepita nell'interazione mediata, piuttosto che alla convinzione che il sistema sia umano33. È associata alla qualità dell'interazione, alla fiducia e all'accettazione nei servizi online e negli agenti conversazionali per la salute15,34.
La presenza sociale può ridurre il costo psicologico della rivelazione di informazioni personali e favorire lo scambio di informazioni durante una consulenza online32. Il presente studio, pertanto, verifica se l'inquadramento della figura del compagno sia associato a una maggiore presenza sociale.
H2: I ruoli di esperto generano una presenza sociale inferiore rispetto alle intelligenze artificiali mediche di tipo companion.
La professionalità percepita e la presenza sociale sono considerate associazioni parallele e non esclusive con la fiducia. L'affidamento corretto su automazione ad alto rischio dipende dalle capacità del sistema, dai suoi limiti e dai requisiti della task, piuttosto che dal massimizzare la fiducia stessa35.
H3: La professionalità percepita e la presenza sociale prevedono ciascuna in modo positivo la fiducia quando modellate simultaneamente.
Effetto moderatore del contesto della prova
Gli stessi indicatori di ruolo possono avere un peso psicologico diverso nei vari compiti medici. L'allineamento tra compito e tecnologia fornisce una giustificazione contestuale per esaminare se gli indicatori di ruolo corrispondono ai requisiti del compito36. La consulenza per malattia comporta un'incertezza maggiore, rischi di perdita ed elevati costi di errore, rendendo particolarmente rilevanti professionalità, accuratezza e chiari confini7,37. Di conseguenza, gli indicatori di esperto dovrebbero essere più strettamente allineati a queste esigenze rispetto agli indicatori di accompagnatore. La consulenza per la salute si concentra sulla gestione a lungo termine della salute, sulla persistenza comportamentale e sulla continuità dell'interazione. Le revisioni sui sistemi di supporto decisionale clinico basati sull'intelligenza artificiale e sugli agenti conversazionali per la salute sottolineano l'importanza delle informazioni contestuali, dell'attuabilità, dell'interazione e delle condizioni di implementazione3,38,39.
Questo studio prevede che la differenza tra esperti e compagni nella percezione della professionalità sarà maggiore in una consulenza relativa a una malattia rispetto a una consulenza relativa alla salute. Non considera un'interazione non significativa sulla presenza sociale come prova di invarianza. L'ipotesi è formulata come segue:
H4: Il contesto del compito modera in modo significativo l'impatto dei ruoli esperti sulla professionalità percepita. L'impatto è più forte nella consulenza relativa a malattie rispetto alla consulenza relativa alla salute.
Protocollo
Panoramica della ricerca
Lo studio è stato condotto in conformità con la Dichiarazione di Helsinki ed è stato approvato dal Comitato Etico dell'Università di Huaqiao (M2025021), che comprendeva sia l'esperimento online in scenari simulati sia l'esperimento EEG. Tutti i partecipanti hanno fornito il consenso informato e hanno ricevuto un compenso al termine dello studio.
Questo articolo comprende due studi complementari (vedi Figura 1). Lo studio 1 è un esperimento randomizzato di scenario 2 × 2 che stima gli effetti del contesto di ruolo e del contesto di compito, valuta la struttura della misurazione e verifica associazioni indirette condizionali parallele attraverso la percezione di professionalità e presenza sociale. Lo studio 2 è un esperimento EEG a soggetti ripetuti che confronta l'attività nella banda theta in risposta a dichiarazioni formulate in un contesto da esperto e in un contesto da compagno, interpretato come confronto esplorativo a livello di processo. Gli studi forniscono evidenze comportamentali e neurali a livelli diversi; non vengono considerati come un singolo meccanismo progressivo.
Studio 1: Esperimento basato su scenario
Partecipanti e disegno dello studio
Lo studio 1 ha utilizzato un disegno sperimentale tra soggetti 2 × 2 bilanciato con due fattori: la definizione del ruolo (esperto vs. compagno) e il contesto del compito (consulto per malattia vs. consulto per salute). Il calcolo iniziale effettuato con G*Power prevedeva un effetto medio globale per l'ANOVA (f = 0,25), α = 0,05 e potenza = 0,80, indicando un minimo di 128 partecipanti40. Poiché tale calcolo non era specificamente adattato agli effetti indiretti condizionali, viene riportato come base originale del reclutamento piuttosto che come prova di potenza per la mediazione moderata. Con un campione di N = 300 e quattro gruppi bilanciati, un'analisi di sensibilità ha indicato una potenza dell'80% nel rilevare un'interazione con f = 0,162 (η2 parziale = 0,026) a α = 0,05.
Abbiamo inoltre condotto un’analisi post hoc della potenza basata su simulazioni per gli indici di moderazione-mediazione utilizzando il dataset del questionario SPSS composto da 300 casi. La simulazione ha generato 1.000 campioni bilanciati 2 × 2 a partire dal modello con mediatori paralleli stimato, mediante il ricampionamento dei residui empirici; ogni dataset simulato ha utilizzato 500 intervalli di confidenza bootstrap percentili basati sul ricampionamento dei casi. Le probabilità stimate che l'intervallo di confidenza escludesse lo zero sono risultate pari a 0,698 per l'indice di professionalità, 0,157 per l'indice di presenza sociale e 0,279 per la differenza diretta tra i due indici. Questa analisi è condizionata ai coefficienti osservati, alle distribuzioni dei residui e alla specificazione del modello, e non costituisce una giustificazione a priori della dimensione del campione. L'analisi completa della potenza post hoc basata su simulazioni è riportata in Tabella Supplementare S1.
Trecento partecipanti sono stati reclutati tramite Credamo e assegnati casualmente a quattro condizioni (n = 75 per cella). Il campione includeva 109 uomini (36,3%) e 191 donne (63,7%); il 43,7% aveva un'età compresa tra 21 e 30 anni, il 41,3% tra 31 e 40 anni, e il 69,7% possedeva una laurea triennale. Sono stati completati tutti gli elementi richiesti del questionario. Non è stato utilizzato alcun elemento specifico per verificare l'attenzione né un'esclusione preregistrata in base al tempo di completamento, e nessun partecipante è stato escluso. Il tempo mediano di completamento è stato di 268 s (intervallo = 67-1.894 s). Un'analisi post hoc di robustezza, escludendo le risposte al di sotto del quinto percentile del tempo di completamento (<125 s; n mantenuto = 285), ha valutato la sensibilità alle risposte insolitamente rapide. Le statistiche dettagliate dei controlli di manipolazione e le analisi di sensibilità relative al tempo di completamento sono riportate in Tabella Supplementare S2.
Stimoli sperimentali e procedura
I materiali stimolo comprendevano un'introduzione allo scenario del compito e una risposta al dialogo con un medico artificiale, formando quattro serie sperimentali complete. Lo scenario di consulto medico chiedeva ai partecipanti di immaginare un dolore toracico notturno ricorrente e palpitazioni, nonché la preoccupazione riguardo alla necessità di cure ospedaliere immediate. Lo scenario di consulto per la salute chiedeva ai partecipanti di immaginare di essere in buona salute generale e di cercare un piano personalizzato per dieta ed esercizio fisico. Ogni categoria di compito era rappresentata da uno scenario; le conclusioni sono pertanto limitate a questi due scenari, piuttosto che essere generalizzate a tutti i tipi di consulto medico o per la salute.
Tutti e quattro gli screenshot del questionario utilizzavano lo stesso'icona e mostravano il nome del sistema, Medical AI (DiagnosPro), mantenendo così costante l'identità visualizzata in tutte le condizioni. Le risposte formulate in chiave esperta utilizzavano un'analisi strutturata, affermazioni su rischi o evidenze, un linguaggio diretto e raccomandazioni d'azione esplicite. Le risposte formulate in chiave collaborativa utilizzavano empatia, rassicurazione, termini collaborativi e suggerimenti flessibili. La manipolazione, pertanto, rappresentava un insieme di indicazioni comunicative e informative coerenti con il ruolo; non isolava il framing del ruolo da specificità, attuabilità, certezza, dettagli medici o supporto emotivo. Il nome condiviso DiagnosPro potrebbe inoltre aver trasmesso un segnale di espertise in tutte le condizioni. L'insieme completo degli stimoli è fornito nel Supplementary File 1.
I partecipanti hanno prima letto il modulo di consenso informato e sono stati quindi assegnati casualmente a una delle quattro condizioni sperimentali. Dopo aver letto lo scenario e lo stimolo dialogico, hanno compilato il questionario in base alle proprie risposte. Il questionario iniziava con verifiche di controllo, seguite da misure della professionalità percepita, presenza sociale, fiducia e dati demografici. La procedura ha richiesto circa 15 min.
Tutte le scale utilizzavano un punteggio Likert a 7 punti, dove 1 indicava fortemente in disaccordo e 7 indicava fortemente d'accordo. La professionalità percepita è stata misurata con tre elementi: «Questo intelligenza artificiale medica è in grado di fornire consigli medici», «Questo intelligenza artificiale medica appare molto professionale» e «Questo intelligenza artificiale medica è un esperto nel campo medico» (α = .883)41. La presenza sociale è stata misurata con tre elementi: «Nell'interazione con questo intelligenza artificiale medica, ho percepito un contatto umano», «L'interazione con questo intelligenza artificiale medica mi ha fatto sentire vicino» e «Questo intelligenza artificiale medica è sembrato socievole durante l'interazione» (α = .932)42. La fiducia cognitiva comprendeva tre elementi: «Posso fare affidamento su questo intelligenza artificiale medica perché possiede le competenze necessarie per fornire consigli», «Ho fiducia nell'accuratezza dei consigli forniti da questo intelligenza artificiale medica» e «Questo intelligenza artificiale medica ha capacità sufficienti per gestire il mio problema di salute» (α = .837). La fiducia affettiva comprendeva tre elementi: «Questo intelligenza artificiale medica mi fa sentire calore e attenzione», «Fare affidamento su questo intelligenza artificiale medica mi fa sentire al sicuro perché sembra preoccuparsi della mia salute» e «Credo che questo intelligenza artificiale medica non farebbe intenzionalmente nulla di dannoso nei miei confronti» (α = .700). La fiducia complessiva era la media di tutti e sei gli elementi relativi alla fiducia (α = .784). Queste misurazioni sono state analizzate come risultati orientati alla competenza, interpersonali, di fiducia cognitiva, di fiducia affettiva e di fiducia complessiva, piuttosto che come costrutti mutuamente esclusivi.
L'analisi è proseguita in quattro fasi. Primo, un'analisi fattoriale confermativa ha confrontato il modello a quattro fattori proposto con alternative a due e un fattore; sono stati esaminati l'affidabilità composta, la varianza media estratta, le correlazioni latenti e i rapporti eterotrait-monotrait. Secondo, modelli fattoriali completi 2 x 2 hanno stimato gli effetti principali e di interazione per la professionalità percepita, la presenza sociale, la fiducia cognitiva, la fiducia affettiva e la fiducia complessiva, con medie delle celle, intervalli di confidenza e η2 parziale. Le medie marginali stimate e gli intervalli di confidenza al 95% sono mostrati in Figura 2. Terzo, il Modello 7 della macro PROCESS 4.2 beta ha inserito simultaneamente la professionalità percepita e la presenza sociale come mediatori paralleli, con 5.000 campioni bootstrap percentili43. La definizione del ruolo è stata codificata come 1 = esperto e 2 = accompagnatore, e il contesto del compito come 1 = consulenza per malattia e 2 = consulenza per salute. Un bootstrap con campionamento comune ha confrontato direttamente i due indici di mediazione moderata. Quarto, la fiducia cognitiva e quella affettiva sono state analizzate separatamente come risultati esplorativi. Poiché i mediatori e gli esiti sono stati misurati contemporaneamente, le stime vanno interpretate come associazioni indirette compatibili con la mediazione, piuttosto che come meccanismi psicologici causali.
Studio 2: Esperimento di EEG
Partecipanti
Lo studio 2 ha reclutato 40 partecipanti. Un partecipante è stato escluso perché le prove con artefatti superavano il 30% in almeno una condizione sperimentale, lasciando 39 partecipanti nelle analisi finali dell'EEG. Questo criterio ha garantito che ogni partecipante incluso contribuisse con almeno il 70% delle prove in ciascuna condizione. Tutti i partecipanti hanno fornito un consenso informato scritto e hanno ricevuto un compenso al termine dell'esperimento. Le informazioni demografiche non potevano essere associate a tutti i record EEG conservati e pertanto non sono riassunte per il campione finale di EEG.
Stimoli sperimentali e procedura
L'esperimento è stato condotto in un laboratorio EEG standard utilizzando un disegno sperimentale a soggetti ripetuti, con stimoli presentati in E-Prime 2.1. Ai partecipanti è stato chiesto di immaginare di interagire con un sistema di intelligenza artificiale medica e di valutare il proprio livello di fiducia nel sistema per ciascuno scenario di consulto medico. L'esperimento ha manipolato il ruolo percepito del sistema di intelligenza artificiale medica, includendo varianti di tipo esperto e di tipo compagno.
Sono stati costruiti complessivamente 40 stimoli costituiti da frasi cinesi. La condizione di tipo esperto conteneva 20 stimoli che iniziavano con «Esperto di intelligenza artificiale medica», mentre la condizione di tipo compagno conteneva 20 stimoli paralleli che iniziavano con «Compagno di intelligenza artificiale medica». Gli scenari medici includevano sia funzioni diagnostiche professionali, come chiedere informazioni sulla storia clinica, analizzare referti medici, valutare dati sulla frequenza cardiaca, interpretare test genetici, giudicare il rischio di malattia e raccomandare piani terapeutici, sia funzioni di supporto alla gestione della salute, come mostrare attenzione verso lo stato fisico, chiedere informazioni sulla qualità del sonno, alleviare l'ansia, registrare dati sanitari, incoraggiare l'aderenza alle terapie e fornire consigli quotidiani per la salute. Le condizioni differivano quindi anche per contenuto semantico e complessità; non era disponibile alcun abbinamento indipendente degli stimoli né un pretest.
Prima dell'esperimento formale, i partecipanti hanno completato un breve blocco di pratica. Ogni prova iniziava con una croce di fissazione di 500 ms, seguita da un intervallo vuoto randomizzato di 300–500 ms e da un'affermazione di Intelligenza Artificiale Medica presentata per 1.600 ms. I partecipanti esprimevano quindi un giudizio binario sulla fiducia a proprio ritmo, premendo il tasto F per indicare fiducia oppure il tasto J per indicare assenza di fiducia (vedi Figura 3). Le affermazioni presentate nel frame dell'esperto e del compagno venivano mostrate in ordine casuale. I log della sessione E-Prime indicavano 80 prove formali per ogni registrazione: 40 prove con esperto e 40 con compagno, con ciascuna delle 20 affermazioni uniche per ruolo presentata due volte.
Dati della prova comportamentale
I dati delle attività comportamentali erano utilizzabili per 38 dei 39 partecipanti nel campione finale di EEG; la registrazione del compito E-Prime di un partecipante non era utilizzabile. Pertanto, le analisi comportamentali hanno utilizzato N = 38. I risultati comportamentali dettagliati e la contabilizzazione del campione sono riportati nella Tabella S3 Supplementare. La fiducia è stata codificata come risposta al tasto F; le risposte al tasto J indicavano assenza di fiducia. Le risposte vuote o un tempo di risposta registrato pari a 0 ms sono state codificate come mancanti. Il tasso di fiducia è stato calcolato tra le prove a cui è stato risposto, e il tempo di risposta è stato sintetizzato considerando le prove a cui è stato risposto. I dati neurali disponibili per l'analisi contenevano misure aggregate per condizione, ma nessun indice EEG a livello di singola prova né un identificatore verificato che collegasse ogni registrazione comportamentale al relativo registro EEG; pertanto, non è stato stimato alcun modello misto a livello di prova per EEG e giudizi di fiducia.
Registrazione ed elaborazione dell'EEG
È stato utilizzato il gel elettrolitico conduttivo Quik-Gel per mantenere l'impedenza tra elettrodo e cute al di sotto di 5 kOhm. FCz era il riferimento online predefinito del dispositivo e la frequenza di campionamento era di 1.000 Hz. Il riferimento offline alla media delle mastoidi bilaterali è stato eseguito mediante la funzione di riferimento interno di CURRY; FCz è stato mantenuto e automaticamente ricostruito rispetto al nuovo riferimento, senza utilizzare comandi o script personalizzati per la ricostruzione. L'ulteriore elaborazione offline è stata effettuata in MATLAB R2020b con EEGLAB44 e ICLabel45. I dati sono stati sottocampionati a 500 Hz e filtrati con passa-banda da 0,1 a 40 Hz. Canali difettosi e segmenti di dati gravemente contaminati sono stati identificati e rimossi mediante ispezione visiva; non è stata applicata alcuna interpolazione automatica né alcuna soglia automatica di rigetto dei segmenti. È stata quindi utilizzata l'implementazione predefinita di runica di EEGLAB (ICA Infomax) e sono state rimosse le componenti per cui ICLabel assegnava una probabilità di almeno 0,70 a una classe di artefatti (ad esempio, attività oculare, muscolare, cardiaca, di rumore di rete o di rumore del canale). I partecipanti con più del 30% di prove contaminate da artefatti in una delle due condizioni sono stati esclusi, garantendo una conservazione di almeno il 70% delle prove in ciascuna condizione. Gli epoch duravano da −1.000 a 1.996 ms. Per l'analisi della connettività funzionale, i dati preelaborati sono stati ulteriormente sottocampionati a 250 Hz ed è stata esclusa la presenza di elettrodi periferici, inclusi P7, P8, F7 e F8, prima della stima della sincronia di fase.
Si è riscontrato che l'attività theta registrata in siti fronto-mediani del cuoio capelluto è associata a elaborazioni attivate da richieste di controllo cognitivo46. La sincronizzazione di fase nella banda theta tra elettrodi frontali medi e laterali è stata inoltre associata alla coordinazione durante l'elaborazione legata al controllo47. In particolare, un aumento della sincronizzazione di fase nella banda theta tra siti come FCz e F6 è stato osservato in seguito al rilevamento di conflitti o di errori48. Poiché queste misurazioni del cuoio capelluto non sono specifiche unicamente al controllo cognitivo, vengono considerate qui come indicatori convergenti del processo piuttosto che come letture dirette di un singolo meccanismo cognitivo.
Innanzitutto, la sincronizzazione legata all'evento (ERS) nella banda theta fronto-mediale è stata quantificata nella banda 4–8 Hz all'interno della finestra post-stimolo compresa tra 800 e 1.000 ms. L'ERS è stata calcolata mediante analisi tempo-frequenza, con la variazione relativa della potenza calcolata rispetto al basale pre-stimolo compreso tra −500 e −200 ms. Valori positivi indicano un aumento della potenza (sincronizzazione), mentre valori negativi indicano una riduzione della potenza (desincronizzazione). In secondo luogo, la connettività funzionale è stata stimata dopo un ulteriore sottocampionamento dei dati preelaborati a 250 Hz ed esclusione degli elettrodi periferici, inclusi P7, P8, F7 e F8. È stata applicata una trasformata di Fourier a breve termine (STFT) prima di calcolare il valore di bloccaggio di fase nella banda theta tra FCz e F6. La variazione del PLV corretta per il basale (ΔPLV) è stata calcolata rispetto al basale pre-stimolo compreso tra −600 e −200 ms. Il valore PLV grezzo è compreso tra 0 e 1; pertanto, valori negativi di ΔPLV indicano una diminuzione rispetto al basale e non un bloccaggio di fase negativo. Queste misure scalpari vengono interpretate come schemi esplorativi associati all'elaborazione legata al controllo e alla coordinazione prefrontale; esse non identificano direttamente un processo cognitivo specifico né una sorgente neurale.
Risultati
Studio 1: Risultati dello scenario-esperimento
Modello di misurazione. Il modello a quattro fattori si è adattato meglio rispetto alle alternative a due e a un fattore, ma l'adattamento assoluto è risultato discutibile: χ2(48) = 223,93, p < ,001; CFI = ,935; TLI = ,911; RMSEA = ,111; SRMR = ,140. I loadings standardizzati variavano da ,382 a ,937. L'affidabilità composta era ,886 per la professionalità percepita, ,932 per la presenza sociale, ,840 per la fiducia cognitiva e ,709 per la fiducia affettiva; i corrispondenti valori AVE erano ,722, ,821, ,636 e ,474. La validità discriminante era limitata: i valori HTMT erano ,935 tra professionalità percepita e fiducia cognitiva, e ,926 tra presenza sociale e fiducia affettiva. I risultati dell'analisi del processo condizionale vanno pertanto interpretati con cautela, e le analisi della fiducia specifiche per dimensione sono di carattere esplorativo (Tabella 1).
Verifiche di manipolazione. I partecipanti sottoposti al framing dell'esperto (n = 150, M = 5,57, SD = 1,18) hanno valutato l'IA medica come più simile a un esperto rispetto ai partecipanti sottoposti al framing del compagno (n = 150, M = 3,21, SD = 1,76). Poiché le varianze differivano, F = 47,42, p < .001, è stato utilizzato il test di Welch, t(259,90) = 13,63, p < .001, differenza media = 2,36, IC 95% [2,02, 2,70]. I partecipanti nel gruppo della condizione di malattia (n = 150, M = 2,51, SD = 1,53) hanno assegnato punteggi più bassi all'orientamento verso la prevenzione sanitaria rispetto ai partecipanti nel gruppo della condizione di salute (n = 150, M = 5,98, SD = 1,22), F = 10,96, p = .001; t di Welch (284,11) = −21,70, p < .001, differenza media = −3,47, IC 95% [−3,79, −3,16]. I gradi di libertà di Welch non sono uguali a N − 2 quando le varianze sono disuguali; tutte le analisi hanno utilizzato N = 300.
Statistiche descrittive per condizione sperimentale. Per il framing dell'esperto, malattia e consulto sanitario hanno prodotto valori medi di percezione della professionalità di 5,69 (SD = 0,83) e 5,85 (SD = 0,63), valori medi di presenza sociale di 4,28 (SD = 1,54) e 4,25 (SD = 1,64) e valori medi di fiducia generale di 5,45 (SD = 0,86) e 5,28 (SD = 0,87), rispettivamente. Per il framing del compagno, i valori medi corrispondenti per malattia e salute sono stati 4,52 (SD = 1,47) e 5,25 (SD = 0,94) per la percezione della professionalità, 5,68 (SD = 1,07) e 5,93 (SD = 0,74) per la presenza sociale e 5,30 (SD = 1,02) e 5,61 (SD = 0,64) per la fiducia generale. Tabella 2 riporta tutti gli intervalli di confidenza specifici per condizione e i test fattoriali completi.
Risultati del disegno fattoriale completo. La professionalità percepita ha mostrato un effetto principale del ruolo, F(1, 296) = 56,92, p < .001, η2 parziale = .161, un effetto principale del contesto compito, F(1, 296) = 14,37, p < .001, η2 parziale = .046, e un'interazione ruolo × compito, F(1, 296) = 5,89, p = .016, η2 parziale = .020. La presenza sociale ha mostrato un effetto principale del ruolo, F(1, 296) = 105,57, p < .001, η2 parziale = .263, ma né l'effetto principale del compito, F(1, 296) = 0,59, p = .442, né l'interazione, F(1, 296) = 0,84, p = .359, sono risultati significativi. Quest'ultimo risultato indica che non è stata rilevata una moderazione; non stabilisce pertanto un'equivalenza tra i compiti. Per la fiducia cognitiva, l'interazione ruolo × compito è risultata significativa, F(1, 296) = 5,60, p = .019, η2 parziale = .019; l'interazione corrispondente non è risultata significativa per la fiducia affettiva, F(1, 296) = 3,48, p = .063, η2 parziale = .012. La fiducia generale non ha mostrato un effetto principale del ruolo, F(1, 296) = 0,81, p = .369, né un effetto principale del compito, F(1, 296) = 0,55, p = .459, ma l'interazione ruolo × compito è risultata significativa, F(1, 296) = 5,78, p = .017, η2 parziale = .019. Nella consulenza per malattia, la fiducia generale non differiva tra il ruolo di compagno e quello di esperto, differenza media = −0,15, SE = 0,14, t(296) = −1,06, p = .288, IC 95% [−0,42, 0,13]. Nella consulenza per la salute, la fiducia generale era maggiore nel ruolo di compagno, differenza media = 0,33, SE = 0,14, t(296) = 2,34, p = .020, IC 95% [0,05, 0,60].
Associazioni indirette condizionali parallele. Quando professionalità percepita e presenza sociale sono state inserite contemporaneamente, entrambe hanno mostrato un'associazione positiva con la fiducia complessiva: b = 0,4872, SE = 0,0258, p < .001, IC 95% [0,4294, 0,5460] e b = 0,3293, SE = 0,0208, p < .001, IC 95% [0,2762, 0,3829], rispettivamente. L'associazione diretta legata al ruolo non è risultata significativa: b = 0,0119, SE = 0,0680, p = .861, IC 95% [−0,1071, 0,1361]. Le associazioni indirette legate alla professionalità erano pari a −0,5695 nella consulenza per malattia, IC bootstrap 95% [−0,7687, −0,3851], e −0,2923 nella consulenza per salute, IC bootstrap 95% [−0,4288, −0,1634]. Le associazioni indirette legate alla presenza sociale erano pari a 0,4625 nella consulenza per malattia, IC bootstrap 95% [0,3165, 0,6091], e 0,5532 nella consulenza per salute, IC bootstrap 95% [0,3855, 0,7383] (Tabella 3). L'indice di mediazione moderata attraverso la professionalità percepita era 0,2772, IC bootstrap 95% [0,0594, 0,5035], mentre l'indice attraverso la presenza sociale era 0,0907, IC bootstrap 95% [−0,0984, 0,3008]. Il contrasto diretto bootstrap tra gli indici non era significativo: differenza = 0,1864, IC bootstrap 95% [−0,0856, 0,4447]. I risultati supportano quindi una moderazione contestuale dell'associazione indiretta con la professionalità, ma non dimostrano una moderazione contestuale statisticamente differente tra le due associazioni.
Analisi esplorative delle dimensioni della fiducia. Per la fiducia cognitiva, il contrasto tra gli indici di moderazione-mediazione della professionalità e della presenza sociale è risultato positivo, differenza = 0,3707, IC bootstrap al 95% [0,0493, 0,6996]. Per la fiducia affettiva, il contrasto corrispondente non è stato confermato, differenza = 0,0022, IC bootstrap al 95% [−0,3421, 0,3127]. Entrambi i mediatori hanno mantenuto associazioni positive con entrambe le dimensioni della fiducia, indicando effetti trasversali piuttosto che esclusivi. Considerati i valori elevati di HTMT, questi risultati non devono essere interpretati come una separazione definitiva dei meccanismi cognitivi e affettivi.
Potenza post hoc della mediazione moderata. Sotto le assunzioni del modello stimato e di ri-campionamento dei residui, la probabilità stimata che l'intervallo di confidenza ottenuto con il metodo del percentile bootstrap escludesse lo zero era pari a .698 per l'indice di professionalità, .157 per l'indice di presenza sociale e .279 per la loro differenza diretta (1.000 simulazioni; 500 ri-campionamenti bootstrap per ogni simulazione). Queste stime, basate sul disegno osservato, spiegano perché l'indice di professionalità supportato e il contrasto diretto non significativo non dovrebbero essere interpretati come prova conclusiva di una moderazione contestuale differente.
Robustezza del tempo di completamento. Escludendo le 15 risposte al di sotto di 125 s, sono rimasti 285 casi. L'interazione complessiva relativa alla fiducia è rimasta significativa, p = .029; l'indice di professionalità è rimasto confermato, IC bootstrap al 95% [0.0242, 0.4827]; e il confronto tra gli indici di moderazione della mediazione è rimasto non significativo, IC bootstrap al 95% [−0.1027, 0.4506]. Le conclusioni principali non dipendevano dalle risposte più veloci del 5%.
Studio 2: risultati dell'EEG
Aumento reattivo del theta fronto-midline. Nel campione analitico finale (N = 39), l'aumento reattivo del theta (ERS) nella finestra 4–8 Hz, 800–1.000 ms è risultato maggiore nel condizionamento con cornice esperta (M = 0,2948, DS = 0,8218) rispetto al condizionamento con cornice del compagno (M = −0,0422, DS = 1,2155), differenza media = 0,3369, IC 95% [0,0125, 0,6614], t(38) = 2,10, p = ,042, dz di Cohen = 0,337, η2 parziale = ,104. Il valore p aggiustato con il metodo di Holm per i due esiti EEG appaiati riportati è ,042. Tale differenza indica un diverso processamento nella banda theta in questa finestra di compito; tuttavia, l'aumento reattivo del theta da solo non identifica un processo psicologico specifico.
Variazione della PLV (ΔPLV) della coerenza di fase theta, corretta rispetto al basale in FCz-F6. Nel campione analitico finale (N = 39), la ΔPLV theta era meno negativa nel condizionamento con cornice esperta (M = −0.0111, SD = 0.0546) rispetto al condizionamento con cornice del compagno (M = −0.0350, SD = 0.0473), differenza media = 0,0239, IC 95% [0,0058, 0,0420], t(38) = 2,68, p = ,011, dz di Cohen = 0,429, η2 parziale = ,159. Il valore p aggiustato con metodo di Holm per i due esiti EEG appaiati riportati era ,022. Questo andamento indica una riduzione minore della coerenza di fase theta rispetto al basale nel condizionamento con cornice esperta; da solo, non dimostra un maggiore controllo prefrontale né un meccanismo cognitivo specifico (vedere Figura 4 e Tabella 4).
Risultati della prova comportamentale. Nei 38 record di prova analizzati, la percentuale di risposta di fiducia è stata dell'83,1% (SD = 15,8%) nel caso del framing esperto e dell'82,4% (SD = 17,5%) nel caso del framing del compagno, differenza media = 0,7 punti percentuali, IC 95% [−0,9, 2,4], t(37) = 0,91, p = ,371, dz = 0,147. I tempi medi di risposta sono stati rispettivamente di 828,7 ms (SD = 204,6) e 826,1 ms (SD = 208,9), differenza media = 2,5 ms, IC 95% [−14,0, 19,1], t(37) = 0,31, p = ,758, dz = 0,050. Le percentuali di mancata risposta sono state rispettivamente del 6,3% (SD = 7,4%) e del 5,2% (SD = 6,3%), differenza media = 1,1 punti percentuali, IC 95% [−1,0, 3,1], t(37) = 1,05, p = ,302, dz = 0,170.
Dichiarazione sulla disponibilità dei dati:
I dati del questionario dello Studio 1 anonimizzati, i file EEG preelaborati e i file di output EEG aggregati che supportano lo Studio 2 sono disponibili pubblicamente su Open Science Framework (OSF) all'indirizzo https://doi.org/10.17605/OSF.IO/JKSP7. I materiali supplementari includono gli stimoli sperimentali completi (File Supplementare 1), verifiche di manipolazione, analisi comportamentali aggiuntive, analisi post hoc della potenza statistica e informazioni metodologiche di supporto.
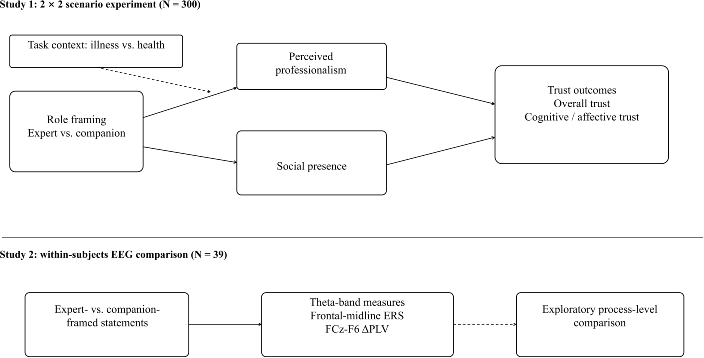
Figura 1. Quadro di riferimento della ricerca. Lo studio 1 è un esperimento basato su scenari 2 × 2 (N = 300) che esamina il ruolo del contesto decisionale, il contesto dell’attività e associazioni indirette parallele attraverso la professionalità percepita e la presenza sociale. Lo studio 2 fornisce un confronto esplorativo tramite elettroencefalograme di affermazioni formulate in chiave di esperto e di compagno (N = 39); non verifica direttamente il modello indiretto condizionale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
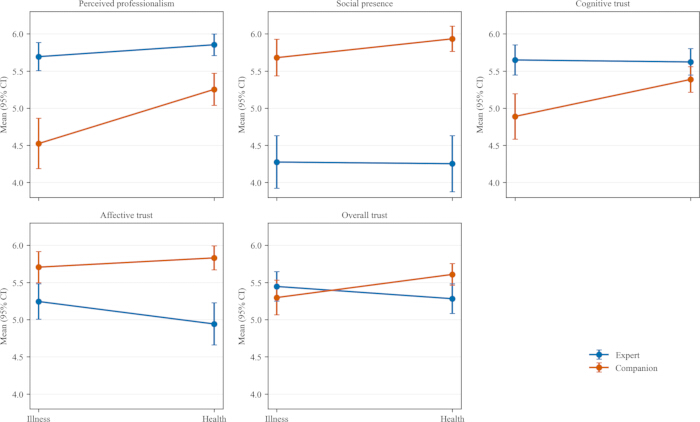
Figura 2. Grafici di contesto del ruolo × contesto della mansione per professionalità percepita, presenza sociale, fiducia cognitiva, fiducia affettiva e fiducia complessiva. I punti indicano le medie delle celle, e le barre di errore indicano gli intervalli di confidenza al 95% (n = 75 per cella). Cliccare qui per visualizzare una versione ingrandita di questa figura.
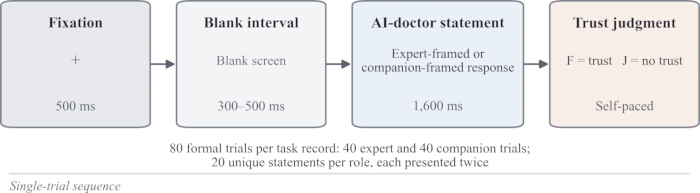
Figura 3. Sequenza per singolo tentativo nello Studio 2. Ogni tentativo comprendeva una fissazione di 500 ms, un intervallo vuoto variabile tra 300 e 500 ms, un'afferazione del medico AI formulata come esperto o come compagno di 1.600 ms e un giudizio binario di fiducia a ritmo autonomo. I registri delle attività E-Prime indicavano 80 prove formali per ogni registrazione di attività, con 40 prove per ciascuna condizione di inquadramento del ruolo e due presentazioni di ciascuna delle 20 affermazioni uniche per condizione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
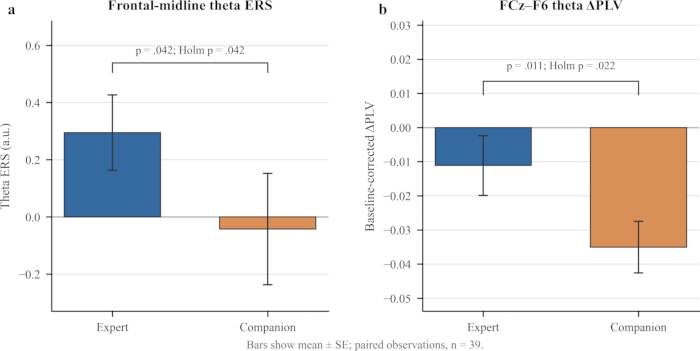
Figura 4. Effetti del contestualizzazione del ruolo dell'IA medica sulla sincronizzazione correlata all'evento theta fronto-mediane e sul valore di blocco di fase theta tra FCz e F6. (A) Sincronizzazione correlata all'evento theta nella regione fronto-mediane. (B) Variazione del valore di blocco di fase theta tra FCz e F6 corretta rispetto alla baseline (ΔPLV); valori negativi indicano una diminuzione rispetto alla baseline pre-stimolo. Le barre mostrano la media ± errore standard per n = 39. I test t per campioni appaiati hanno restituito p = .042 per la ERS theta e p = .011 per il ΔPLV; i valori di p aggiustati con il metodo di Holm per questi due risultati riportati sono stati rispettivamente .042 e .022. Abbreviazioni: Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella 1: Diagnostica del modello di misurazione per lo Studio 1. La tabella riporta i carichi standardizzati, l'alfa di Cronbach, l'affidabilità composta, la varianza media estratta, le correlazioni latenti e i valori HTMT per la professionalità percepita, la presenza sociale, la fiducia cognitiva e la fiducia affettiva. N = 300. Il modello a quattro fattori si è adattato meglio rispetto alle alternative, ma RMSEA e SRMR hanno indicato un adattamento assoluto debole e due valori HTMT hanno superato lo 0,90. Abbreviazioni: CR = affidabilità composta; AVE = varianza media estratta; HTMT = rapporto eterotrait-monotrait. Cliccare qui per scaricare questa tabella.
Tabella 2: Statistiche descrittive a quattro condizioni e test fattoriali completi 2 × 2 per lo Studio 1. Le voci delle celle riportano n, media, deviazione standard e intervallo di confidenza al 95%; i test fattoriali riportano F, p e η2 parziale. N = 300; n = 75 per cella. Il ruolo è stato codificato come 1 = esperto e 2 = compagno; il contesto del compito è stato codificato come 1 = malattia e 2 = consulto sanitario. I coefficienti e gli intervalli di confidenza sono non standardizzati. Cliccare qui per scaricare questa tabella.
Tabella 3: Associazioni indirette condizionali parallele nello Studio 1. N = 300. L'inquadramento del ruolo è stato codificato come 1 = esperto e 2 = compagno; il contesto dell'attività è stato codificato come 1 = consulto per malattia e 2 = consulto per salute. Percepita professionalità e presenza sociale sono state inserite contemporaneamente. Le stime sono non standardizzate e gli intervalli di confidenza basati su percentili con bootstrap sono stati calcolati utilizzando 5.000 ricampionamenti. La tabella include associazioni indirette condizionali, entrambi gli indici di mediazione moderata e il loro confronto diretto tramite bootstrap. Il confronto diretto tra i due indici di mediazione moderata per la fiducia complessiva è stato 0,1864, IC 95% [-0,0856; 0,4447]. Cliccare qui per scaricare questa tabella.
Tabella 4: Risultati EEG accoppiati nello Studio 2. N = 39 osservazioni appaiate nel campione analitico finale. La tabella riporta le medie delle condizioni, le differenze medie appaiate, gli intervalli di confidenza al 95%, test appaiati t test, dz di Cohen, η parziale2e valori di p aggiustati con il metodo di Holm per l'ERS theta frontale-mediale e per il ΔPLV theta baseline-corrected in FCz-F6. La correzione di Holm riguarda esclusivamente i due esiti EEG accoppiati riportati e non ricostruisce alcuna ricerca più ampia non documentata su elettrodi, bande o finestre temporali. Fare clic qui per scaricare questa Tabella.
File supplementare 1: Stimoli sperimentali utilizzati nello Studio 1. Il file contiene il testo completo delle risposte dell'intelligenza artificiale medica formulate dagli esperti e formulate dal compagno di viaggio, utilizzate negli scenari di consulto per malattia e di consulto per salute. Sono forniti sia il testo originale in cinese sia la traduzione in inglese.Cliccare qui per scaricare il file.
Tabella Supplementare S1. Analisi della potenza basata su simulazione post hoc per il modello di moderazione-mediazione. Cliccare qui per scaricare il file.
Tabella supplementare S2. Statistiche per il controllo delle manipolazioni e analisi di sensibilità sui tempi di completamento per lo Studio 1. Cliccare qui per scaricare il file.
Tabella supplementare S3. Risultati delle prove comportamentali, conteggio dei campioni e statistiche descrittive per lo Studio 2. Cliccare qui per scaricare il file.
Discussione
Implicazioni teoriche
I due studi forniscono evidenze a livelli diversi. Lo studio 1 identifica associazioni ruolo-per-compito e associazioni indirette parallele in un esperimento di scenario randomizzato, mentre lo studio 2 offre un confronto esplorativo a livello di processo mediante EEG. I risultati, pertanto, sostengono un'interpretazione limitata della valutazione basata sul ruolo, piuttosto che un singolo meccanismo progressivo. I risultati estendono la teoria della congruità di ruolo all'intelligenza artificiale medica, trattando la congruità come l'allineamento tra indizi di ruolo e richieste valutative rilevanti per il compito22. Questa interpretazione si distingue dai contenuti di competenza-benevolenza e dall'adeguatezza compito-tecnologia. I risultati relativi all'avversione agli algoritmi e all'apprezzamento degli algoritmi possono essere compresi come valutazioni sensibili al contesto riguardo alla corrispondenza tra indizi di ruolo e di capacità rispetto al compito49,50.
I risultati supportano anche associazioni parallele e non esclusive tra il definire il ruolo, la professionalità percepita, la presenza sociale e la fiducia. Poiché la professionalità si sovrappone alla fiducia cognitiva e la presenza sociale si sovrappone alla fiducia affettiva, le evidenze sostengono un contenuto valutativo differenziato, ma non due meccanismi nettamente separati. L'interazione ruolo-per-compito sulla professionalità percepita è coerente con la teoria della coerenza del ruolo proposta. Le evidenze sostengono una moderazione contestuale dell'associazione con la professionalità, ma non dimostrano meccanismi contestuali statisticamente asimmetrici né invarianza nel percorso della presenza sociale.
I risultati dell'EEG forniscono una prospettiva a livello di processo esplorativo. Le affermazioni formulate dagli esperti erano accompagnate da pattern distinti nella banda theta, ma le condizioni differivano anche per contenuto semantico e complessità, e a livello di condizione il comportamento non mostrava differenze affidabili nella fiducia. Le misurazioni dell'EEG, pertanto, non stabiliscono un meccanismo distinto di controllo cognitivo o di fiducia. I risultati neurali devono essere considerati generatori di ipotesi. Lo studio 2 non ha manipolato il contesto del compito, misurato la professionalità percepita o la presenza sociale, né ha collegato gli indici dell'EEG a livello di prova con i giudizi di fiducia; i risultati dell'EEG, quindi, integrano piuttosto che validare il modello indiretto condizionale.
I risultati sono compatibili con una dipendenza adeguata, piuttosto che massima. La dipendenza dal sistema automatizzato dovrebbe essere calibrata in base alle capacità, ai limiti e ai requisiti della specifica attività35. Studi precedenti descrivono meccanismi cognitivi adattivi che potrebbero sostenere una fiducia e una dipendenza calibrate51. La prospettiva NeuroIS sostiene l'uso di misure neurali come complemento alle evidenze comportamentali nell'esame di processi risolti nel tempo52. Precedenti studi con fMRI mostrano inoltre che l'attività neurale durante i giudizi di fiducia in tempo reale varia a seconda dei soggetti e dei contesti53.
Implicazioni gestionali
Per le piattaforme mediche online, l'implicazione pratica consiste in una fiducia calibrata piuttosto che in una semplice massimizzazione della fiducia. I suggerimenti relativi al ruolo devono essere abbinati alle esigenze del compito e combinati con comunicazione dell'incertezza, indicazione esplicita dei limiti di capacità, avvisi basati sul rischio e trasferimento a clinici qualificati.
Nei moduli ad alto rischio che coinvolgono diagnosi, interpretazione di risultati anomali, consigli medici o triage, segnali orientati alla competenza possono aiutare gli utenti a riconoscere i limiti delle evidenze e delle azioni senza conferire un'autorità infondata. In moduli a rischio minore, come alimentazione, esercizio fisico, sonno, aderenza terapeutica e supporto emotivo, segnali orientati alla relazione possono favorire l'engagement senza creare false rassicurazioni o antropomorfismi inappropriati.
La progettazione del ruolo dovrebbe essere modulare e basata su scenari, piuttosto che su un'impostazione di personalità fissa. La configurazione del ruolo deve essere integrata con spiegazioni, avvisi sulla privacy, etichette di rischio e meccanismi di escalation. La ricerca sulla governance sottolinea che trasparenza, responsabilità, gestione dei bias e privacy devono essere progettate insieme, in modo che indicatori di ruolo credibili nell'interfaccia non nascondano rischi nel backend6,20,21.
Limiti della ricerca e direzioni future
Lo studio 1 è un esperimento basato su uno scenario piuttosto che su una consultazione reale. Le condizioni non sono state pretestate in modo indipendente per quanto riguarda la lunghezza, la frequenza delle parole, la leggibilità, l'accuratezza, l'efficacia pratica, la valenza emotiva, l'attivazione, il rischio, la familiarità o la complessità. Studi futuri dovrebbero utilizzare più scenari, nomi di sistema neutri, stimoli abbinati per contenuto, manipolazioni indipendenti o misurazioni temporalmente separate e effetti casuali a livello di partecipante e di stimolo.
Lo studio 2 ha fornito evidenze EEG a livello di processo, ma l'associazione demografica finale con 39 persone era incompleta, le affermazioni EEG non erano state abbinate in modo indipendente né pretestate per lunghezza delle frasi, frequenza delle parole, leggibilità, valenza emotiva, attivazione, rischio percepito, familiarità e complessità, e l'uso di etichette di ruolo esplicite potrebbe aver generato caratteristiche di richiesta. Lo studio attuale ha utilizzato il valore di bloccaggio di fase corretto rispetto al basale (ΔPLV) come misura predeterminata della connettività funzionale. Sebbene l'indice ponderato del ritardo di fase (wPLI) sia meno sensibile alla conduzione di volume, non è stato incluso nella pipeline di analisi originale. Studi futuri dovrebbero verificare se i risultati attuali si replicano utilizzando il wPLI o altre misure complementari di connettività. Gli output neurali disponibili sono aggregati per condizione e non possono essere associati a giudizi di fiducia a livello di singola prova; un modello misto EEG-comportamento a livello di prova non è stato pertanto stimato. Il PLV scalpare è inoltre sensibile agli effetti di riferimento comune e di conduzione di volume. Queste limitazioni implicano che i risultati neurali debbano rimanere esplorativi e non debbano essere interpretati come evidenza di un meccanismo unico di controllo cognitivo o di fiducia.
Dichiarazioni
Gli autori non hanno conflitti di interessi da dichiarare.
Durante la preparazione di questo lavoro, gli autori hanno utilizzato ChatGPT per migliorare la qualità del linguaggio. Dopo aver utilizzato questo strumento/servizio, gli autori hanno rivisto e modificato il contenuto secondo necessità e si assumono piena responsabilità per il contenuto della pubblicazione.
Ringraziamenti
Questo progetto di ricerca è stato sostenuto dai Progetti Generali Finanziati dal Fondo Nazionale per le Scienze Sociali, RPC (Grant No. 22BGL006).
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Piattaforma online per sondaggi Credamo | Credamo (Jianshu), Cina | Non applicabile | Piattaforma online per questionari, assegnazione casuale e reclutamento partecipanti utilizzata nello Studio 1. |
| Funzione di riferimento ripetuto CURRY | Compumedics Neuroscan, USA | Versione non specificata | Riferimento offline integrato, passando dal riferimento online FCz alla media dei mastoidi bilaterali; il punto FCz è stato automaticamente ricostruito rispetto al nuovo riferimento. |
| Cuffia EEG a 64 canali | Compumedics Neuroscan (Compumedics Limited), Australia | Modello/numero di catalogo non specificato | Cuffia EEG con elettrodi Ag/AgCl a 64 canali utilizzata per la registrazione continua dell'EEG. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Versione 2023.0 | Toolbox MATLAB utilizzato per la pre-elaborazione dell'EEG e l'analisi delle componenti indipendenti. |
| E-Prime | Psychology Software Tools, Inc., USA | Versione 2.1 | Presentazione degli stimoli e raccolta delle risposte nello Studio 2. |
| G*Power | Heinrich Heine University Dusseldorf, Germania | Versione 3.1.9.7 | Calcolo iniziale originale delle dimensioni del campione, analisi della sensibilità all'interazione e analisi statistica post hoc basata su modelli per lo Studio 1. |
| IBM SPSS Statistics | IBM Corp., USA | Versione 27 | Ambiente statistico utilizzato per eseguire la macro PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Versione 1.7 | Plugin EEGLAB utilizzato per classificare le componenti indipendenti artefattuali. |
| MATLAB | The MathWorks, Inc., USA | Rilascio R2020b | Ambiente informatico utilizzato per l'elaborazione e l'analisi dell'EEG. |
| Macro PROCESS per SPSS | Andrew F. Hayes, Canada | Versione 4.2 beta | Modello 7 con professionalità percepita e presenza sociale inserite contemporaneamente come mediatori paralleli, utilizzando 5.000 campioni bootstrap al percentile nello Studio 1. |
| Gel elettrolitico conduttivo Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australia | Numero di catalogo non specificato; 32 oz | Gel conduttivo utilizzato per ridurre l'impedenza tra elettrodo e cute durante la registrazione dell'EEG. |
| Amplificatore EEG SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; numero di catalogo non specificato | Amplificatore EEG a 64-256 canali configurato per la registrazione a 64 canali. |
Riferimenti
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.