Questo studio computazionale presenta un flusso di lavoro consapevole dei compartimenti per la valutazione di trascrittomi pubblici di virus respiratori, dimostrando che le risposte dell'ospite a livello nasale e sanguigno mostrano una concordanza genica limitata, ma producono moduli specifici per compartimento riproducibili e biologicamente interpretabili in diversi set di dati indipendenti, confronti clinici, recupero longitudinale e analisi di robustezza.
Articolo di ricerca
Benchmarking dei trascrittomi di virus respiratori basato sui compartimenti per i moduli di risposta dell'ospite nasale e sanguigno: uno studio computazionale
In questo articolo
Sommario
Abstract
I trascrittomi pubblici dei virus respiratori sono preziosi per lo studio delle risposte dell'ospite, ma le differenze nella fonte del tessuto, nella definizione dei controlli e nel disegno dello studio possono ostacolare le analisi combinate. Abbiamo sviluppato un flusso di lavoro computazionale consapevole del compartimento per determinare se sia possibile identificare un'attività riproducibile della risposta dell'ospite mantenendo il contesto biologico nasale e sanguigno. La coorte pediatrica accoppiata GSE117827 ha funto da dataset di riferimento, comprendente trascrittomi di tamponi nasali e del sangue intero provenienti da infezioni sintomatiche da picornavirus, infezioni sintomatiche da virus respiratorio sinciziale, rilevamento asintomatico di picornavirus e controlli negativi al virus. Dopo il filtraggio da parte del comitato per la nomenclatura genica HUGO (HGNC), sono stati analizzati 27.685 geni. Sono stati definiti separatamente moduli nasali e sanguigni di 50 geni codificanti proteine a partire dalle risposte positive più elevate e successivamente bloccati prima della valutazione esterna. Gli effetti a livello genico nei compartimenti nasale e sanguigno erano quasi indipendenti (r di Pearson = 0,015) e i moduli condividevano sei geni di sovrapposizione esplorativa (indice di Jaccard = 0,064). Tuttavia, il modulo nasale ha distinto l'infezione dai controlli in coorti indipendenti delle vie aeree superiori, con aree sotto la curva caratteristica operativa del ricevitore (AUROC) di 0,749, 0,693 e 0,609, mentre il modulo sanguigno ha raggiunto valori AUROC di 0,832, 0,924 e 0,870 in coorti sanguigne esterne. In dati longitudinali di infezione naturale, i punteggi abbinati sono diminuiti dalla fase acuta alla dimissione, con delta accoppiati di 0,436 per i campioni nasali e 0,330 per il sangue. Tre ulteriori dataset di riferimento, comprendenti 666 campioni esterni, insieme a geni casuali nulli, analisi di dimensione del modulo, stabilità bootstrap, correlazioni con programmi di marcatori e partizione della varianza, hanno definito la robustezza e i limiti del flusso di lavoro. Il set di 33 acidi ribonucleici messaggeri (mRNA) di Pandya si è confermato più efficace nella discriminazione tra infezioni virali e batteriche, mentre il modulo sanguigno è aumentato anche nella polmonite batterica. Questi risultati supportano l'uso di moduli specifici del compartimento come punteggi riutilizzabili dell'attività della risposta dell'ospite per il confronto tra coorti e il monitoraggio della ripresa, piuttosto che come biomarcatori universali validi per tutti i tessuti o classificatori autonomi di patogeni.
Introduzione
Le firme trascrittomiche dell'ospite sono ampiamente utilizzate per classificare i sindromi infettivi e confrontare le risposte immunitarie tra diversi patogeni1,2,3,4,5. I virus respiratori spesso attivano geni stimolati dall'interferone (ISG), mediatori infiammatori e vie di presentazione dell'antigene che si sovrappongono6,7,8,9,10. Studi recenti accoppiati e longitudinali mostrano inoltre che le risposte locali delle vie aeree e quelle sistemiche possono differire per tempistica, composizione cellulare e intensità11. Questo aspetto riguarda non solo l'influenza, il virus respiratorio sinciziale (RSV), il rhinovirus e il SARS-CoV-2. Il metapneumovirus umano rimane una causa importante di malattie respiratorie, tuttavia la letteratura relativa alla risposta dell'ospite e alle interventi terapeutici è ancora in fase di sviluppo12,13. Queste osservazioni effettuate su diverse infezioni da virus respiratori evidenziano ulteriormente le differenze tra le risposte locali delle vie aeree e quelle sistemiche dell'ospite14. Per gli studi computazionali sull'interazione ospite-virus, la domanda pratica non è quindi soltanto se una risposta esista. È piuttosto se i dati pubblici possano essere riutilizzati attraverso un flusso di lavoro trasparente che preservi il contesto tissutale e produca punteggi riproducibili della risposta dell'ospite.
La maggior parte dei dataset pubblici di trascrittomica per i virus respiratori non è stata progettata per consentire un'analisi incrociata pulita tra virus diversi o tra tessuti diversi. La fonte del tessuto, il momento temporale, la gravità, l'età, la definizione del gruppo di controllo e la piattaforma variano spesso contemporaneamente. I dataset di espressione ad alto rendimento sono inoltre vulnerabili a variazioni tecniche indesiderate e a variazioni a livello di studio15,16. Un'analisi aggregata può quindi recuperare una firma interferonica o infiammatoria marcata, ma al contempo oscurarne l'origine. I campioni nasali catturano la biologia immunitaria epiteliale e mucosale, mentre il sangue intero riflette le risposte leucocitarie sistemiche. Trattare questi compartimenti come intercambiabili rende semplice il calcolo di un punteggio, ma ne complica l'interpretazione.
Abbiamo basato l'analisi su GSE117827, una coorte nasale-sanguigna appaiata proveniente dallo stesso studio, piuttosto che sulla più ampia raccolta disponibile per la scoperta17. La coorte è di piccole dimensioni, ma riduce i fattori di confondimento tra studi quando vengono confrontate le dimensioni degli effetti a livello nasale e sanguigno. Include infezione sintomatica da picornavirus, infezione sintomatica da RSV, rilevamento asintomatico di picornavirus e controlli negativi per il virus. L'abbiamo quindi utilizzata soltanto come punto di riferimento per moduli specifici di compartimenti separati. L'appartenenza ai moduli è stata bloccata prima dei test esterni. La stabilità della selezione basata sulla coorte ridotta è stata esaminata mediante ricampionamento bootstrap stratificato, analisi di geni casuali come valori nulli e analisi di sensibilità della dimensione dei moduli.
Abbiamo aggiunto un livello di confronto con comparatori batterici e non infettivi. GSE63990 contiene campioni di sangue intero da pazienti con malattie respiratorie acute etichettati come virali, batterici o non infettivi18. GSE40012 contiene casi di polmonite grave acquisita in ambito comunitario, sindrome da risposta infiammatoria sistemica (SIRS) e controlli sani19. Questi gruppi permettono di verificare se un modulo riflette un'attività generale della risposta dell'ospite o una specificità per classe di patogeno. GSE53543 è stato analizzato separatamente come confronto per una perturbazione da rinovirus in cellule mononucleate del sangue periferico (PBMC) es vivo. Questo dataset misura la reattività dei leucociti in risposta a uno stimolo controllato, ma non è equivalente a un'infezione naturale.
La nostra premessa è deliberatamente conservativa. Non cerchiamo di dimostrare una firma antivirale universale a partire da dati pubblici eterogenei. Piuttosto, ci chiediamo se un flusso di lavoro consapevole dei compartimenti possa produrre punteggi di modulo che rimangano utili dopo un test esterno. L'uso previsto è complementare ai classificatori diagnostici come il Pandya 33-mRNA. Questi moduli quantificano l'attività della risposta dell'ospite nel naso e nel sangue attraverso coorti diverse, la ripresa e i gradienti dei sintomi. Non sono progettati per assegnare una classe di patogeno.
Protocollo
Questo studio ha riesaminato dati anonimi e pubblicamente disponibili e non ha comportato nuovi reclutamenti, interventi o raccolta di campioni. Pertanto, per la presente analisi secondaria non è stata richiesta l'approvazione etica istituzionale né un nuovo consenso informato. L'approvazione etica e il consenso informato per gli studi originali sono stati riportati rispettivamente dai generatori dei dati.
Progettazione dello studio e logica del flusso di lavoro
Abbiamo condotto uno studio bioinformatico retrospettivo basato su dati pubblici, utilizzando set di dati depositati nel Gene Expression Omnibus20,21. Non sono stati generati nuovi campioni da pazienti, esperimenti di coltura cellulare, modelli animali o validazioni in laboratorio. Il flusso di lavoro ha adottato un approccio basato sull'ancoraggio iniziale. Il dataset GSE117827 è stato utilizzato per la stima dell'effetto, la costruzione dei moduli, l'analisi della concordanza tra compartimenti e l'analisi del gradiente sintomatologico. Dataset indipendenti sono stati introdotti soltanto dopo aver fissato l'appartenenza ai moduli. Il flusso di lavoro comprendeva l'ancoraggio a coppie di compartimenti, il mappaggio HGNC e il filtraggio per geni codificanti proteine, la costruzione separata di moduli per naso e sangue, la validazione in tessuti omologhi e longitudinale, il confronto con parametri clinici e analisi di robustezza. Le analisi di conferma comprendevano test bloccati su tessuti omologhi e analisi longitudinali. Le analisi sull'overlap genico, sul gradiente sintomatologico, sui programmi marcatore e sulla varianza erano esplorative o descrittive.
Cohorte di riferimento e confronto principale
GSE117827 contiene profili di espressione da tamponi nasali e sangue intero di 26 bambini: 9 casi sintomatici di picornavirus, 5 rilevamenti asintomatici di picornavirus, 6 casi sintomatici di RSV e 6 controlli asintomatici negativi al virus17. A due casi di RSV mancavano i campioni di sangue. La progettazione completa della coorte di riferimento comprendeva quindi 50 campioni, mentre il confronto principale infetti contro controlli includeva 40 campioni, escludendo i rilevamenti asintomatici di picornavirus dalla costruzione dei moduli. Per il confronto principale, i campioni sintomatici di picornavirus e quelli sintomatici di RSV sono stati etichettati come infetti, mentre i campioni asintomatici negativi al virus sono stati etichettati come controlli. I rilevamenti asintomatici di picornavirus non sono stati considerati controlli poiché il rilevamento virale in assenza di sintomi è biologicamente distinto dalla salute negativa al virus. Questi campioni sono stati esclusi dalla costruzione dei moduli e successivamente utilizzati per un'analisi del gradiente sintomatologico.
Mappatura delle sonde e pre-elaborazione
GSE117827 è stato profilato su GPL23126. Gli identificatori dei cluster trascrizionali sono stati associati ai simboli genici utilizzando il file di annotazione Clariom D Human na36, hg38 distribuito tramite la piattaforma GEO GPL24539. Sono stati mantenuti solo i simboli approvati da HGNC22. Sono state rimosse le sonde di controllo, le sonde ERCC, i cluster trascrizionali non mappati e i simboli non approvati. I multipli cluster trascrizionali associati allo stesso simbolo approvato sono stati raggruppati calcolando l'espressione mediana. Dopo il filtraggio e il raggruppamento, sono risultati disponibili 27.685 geni per l'analisi degli ancoraggi. Una trasformazione log₂(x + 1) è stata applicata solo quando il 95° percentile della matrice di espressione superava 50, indicando una scala di intensità non logaritmica. I geni con oltre il 20% di valori mancanti sono stati eliminati; i valori mancanti rimanenti sono stati sostituiti con la mediana del gene. Successivamente, ogni gene è stato standardizzato su tutti i campioni di quel dataset come z = (x − media)/deviazione standard campionaria (ddof = 1). Ai geni con varianza nulla è stato assegnato un valore standardizzato pari a 0. La costruzione dei moduli è stata limitata alle voci classificate come geni codificanti proteine nel set completo HGNC.
Analisi dell'effetto dimensionale e costruzione dei moduli
I compartimenti nasale e sanguigno sono stati analizzati separatamente. I campioni virali sintomatici sono stati confrontati con i controlli negativi al virus utilizzando le differenze medie standardizzate di Hedges g e test di Welch a due code23. Hedges g è stato calcolato come la differenza media tra infetto e controllo divisa per la deviazione standard combinata, moltiplicata per la correzione per piccoli campioni 1 − 3/(4df − 1), dove df = ninfected + ncontrol − 2. I test di Welch sono stati eseguiti assumendo varianze disuguali. I tassi di falsa scoperta di Benjamini–Hochberg sono stati calcolati su tutti i geni testati all'interno di ciascun compartimento24. Poiché nessun gene codificante proteine soddisfaceva la combinazione prespecificata rigorosa di FDR < 0,05 e Hedges g > 0,8 nella piccola coorte di riferimento, i geni con effetto positivo sono stati ordinati prima in base al valore P di Welch a due code in ordine crescente, quindi in base a Hedges g in ordine decrescente, utilizzando il simbolo genico come criterio deterministico finale per lo spareggio. I primi 50 geni hanno formato ciascun modulo principale. Un numero di 50 geni è stato scelto a priori come dimensione moderata del modulo, in grado di mantenere un'ampia rilevanza biologica limitando al contempo la perdita di geni mancanti tra diverse piattaforme. Questa dimensione del modulo non è stata ottimizzata rispetto all’AUROC esterno. Analisi di sensibilità basate su 10, 25, 50, 100 e 200 geni hanno prodotto lo stesso risultato qualitativo di separazione della coorte di riferimento. L'obiettivo era la riproducibilità a livello di modulo, non la scoperta di singoli geni.
Concordanza tra compartimenti
Le stime di Hedges g a livello nasale e sanguigno sono state allineate per gene e confrontate utilizzando le correlazioni di Pearson e di Spearman. L'overlapping tra i primi 50 moduli nasali e i primi 50 moduli sanguigni è stato riassunto mediante il conteggio dell'intersezione e l'indice di Jaccard. I geni sovrapposti sono stati interpretati come candidati esplorativi di sovrapposizione tra ranghi in diversi compartimenti, piuttosto che come biomarcatori conservati e validati.
Validazione esterna con tessuti abbinati
La validazione del punteggio del modulo ha utilizzato set di dati pubblici indipendenti con gruppi di origine interpretabili. La validazione delle vie aeree superiori ha incluso i campioni di lavaggio nasale per RSV del dataset GSE41374 e i dataset per SARS-CoV-2 GSE152075 e GSE156063. La validazione su sangue ha incluso GSE171110 e due unità del dataset GSE38900 normalizzate separatamente: GPL10558 (36 campioni; 28 RSV e 8 controlli) e GPL6884 (138 campioni; 107 RSV e 31 controlli). Per ogni dataset esterno, le sonde sono state associate ai simboli HGNC e i simboli duplicati sono stati accorpati mediante l'espressione mediana. All'interno di ciascun dataset sono state applicate le stesse regole di trasformazione, filtraggio dei valori mancanti, imputazione mediana e standardizzazione z per gene utilizzate per il dataset di riferimento. Il punteggio del modulo è stato calcolato come media non pesata dei valori di espressione standardizzati per i geni del modulo rappresentati. Sono stati riportati AUROC, precisione media e FDR del test di Welch come metriche di portabilità, non come stime della performance diagnostica clinica.
Ampie serie di dati clinici di riferimento e dataset di perturbazione ex vivo
Due dataset provenienti da sangue intero sono stati utilizzati come cohorti di riferimento clinico piuttosto che come cohorti di scoperta. Nel dataset GSE63990, i campioni sono stati assegnati, in base ai metadati depositati sullo stato di infezione, a infezione respiratoria virale (n = 117), infezione respiratoria batterica (n = 73) o malattia non infettiva (n = 90); i campioni privi di una di queste etichette inequivocabili sono stati esclusi18. Nel dataset GSE40012, i campi diagnostici depositati sono stati associati a polmonite da influenza A (n = 39), polmonite batterica senza influenza (n = 61), SIRS senza polmonite (n = 40), controlli sani (n = 36) o polmonite mista batterica/influenzale (n = 14)19. I campioni con polmonite mista batterica/influenzale sono stati descritti ma esclusi dai confronti binari del test di riferimento.
GSE53543 contiene 196 profili di PBMC ex vivo provenienti da 98 individui. Ogni individuo ha contribuito con un campione solo in mezzo e un campione esposto al rhinovirus 16 per 24 h; gli identificatori dei soggetti hanno confermato 98 coppie complete. Il benchmark principale ha riportato l'AUROC tra i 98 campioni stimolati e i 98 non stimolati poiché l'AUROC è una metrica di separazione per rango. L'appaiamento dei soggetti è stato mantenuto nei metadati ed è stato utilizzato in un'analisi di sensibilità accoppiata delle differenze nei punteggi. Questo esperimento è stato analizzato separatamente rispetto all'infezione clinica naturale e non è stato utilizzato per sostenere affermazioni diagnostiche cliniche.
Le matrici grezze delle serie GEO sono state scaricate per GSE63990, GSE40012 e GSE53543. Per GSE63990 è stata utilizzata la piattaforma GPL571, per GSE40012 la GPL6947 e per GSE53543 la GPL10558. Le sonde sono state mappate su simboli approvati da HGNC e i mappaggi duplicati sono stati ridotti mediante l'espressione mediana. Sono state utilizzate matrici normalizzate depositate. La regola generale del 95° percentile ha richiesto la trasformazione log₂(x + 1) solo per le matrici su scala non logaritmica. GSE53543 era già stato trasformato in log₂, normalizzato per invarianza del rango e corretto per il giorno di elaborazione da parte degli investigatori originali, pertanto non è stata applicata alcuna ulteriore trasformazione logaritmica. Dopo aver rimosso i geni con oltre il 20% di valori mancanti e aver imputato con la mediana i valori mancanti rimanenti, ogni gene è stato standardizzato con z su tutti i campioni all'interno del proprio dataset. Il livello di riferimento comprendeva 470 campioni clinici di sangue intero e 196 campioni di PBMC es vivo.
Confronto con firme di riferimento
I moduli nasali e del sangue di ancoraggio sono stati confrontati con tre insiemi di riferimento non pesati. L'insieme ufficiale di 33 mRNA di Pandya è stato trascritto dalla Tabella Supplementare 1 del rapporto originale del classificatore5. Il comparatore Andres-Terre comprendeva 33 geni orientati all'interferone, selezionati dalla firma riportata per multi-virus3. Il comparatore Hallmark comprendeva un sottoinsieme nucleo di 33 geni dell'interferone-alfa, associato all'insieme MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. Gli elenchi completi dei geni per tutti e tre gli insiemi di riferimento sono forniti in Dati Supplementari 1. Questi punteggi di riferimento non ricreano i classificatori originali pesati. Per ogni dataset, è stato calcolato un punteggio come media non pesata dei punteggi z per gene disponibili; era richiesto almeno un minimo di tre geni rappresentati, e il numero di geni rappresentati è stato riportato. I confronti di riferimento includevano virale contro batterico, virale contro non infettivo, virale contro batterico-o-non infettivo, virale contro sano/controllo, e batterico contro sano/controllo, laddove i gruppi necessari erano disponibili. L'AUROC e la precisione media sono stati interpretati come metriche di confronto. I valori P del test di Welch sono stati corretti utilizzando la procedura di Benjamini–Hochberg su tutte le combinazioni valide di dataset-confronto-modulo nella tabella di riferimento.
Validazione longitudinale indipendente
I set di dati appaiati acuto-rispetto-al-dimesso GSE97741 e GSE97742 sono stati utilizzati esclusivamente per la validazione longitudinale27. I campioni etichettati come infezione singola da RSV (RSVsi) o da rhinovirus (hRV) nei metadati depositati hanno costituito l'analisi principale; le co-infezioni da RSV (RSVco) sono state mantenute solo nei risultati supplementari. Le etichette acuto e dimesso sono state estratte dai titoli dei campioni. I campioni sono stati abbinati per set di dati, compartimento, gruppo virale e identificatore del soggetto, e sono stati mantenuti solo i soggetti con entrambi i punti temporali. Il gruppo combinato principale comprendeva 38 coppie RSVsi e 30 coppie hRV (68 coppie per compartimento).
Nessuna selezione genica, affinamento del modulo o ottimizzazione delle soglie è stata effettuata utilizzando GSE97741 o GSE97742. Questi set di dati sono stati riservati per la validazione esterna. Gli identificatori delle sonde sono stati associati ai simboli HGNC approvati e i simboli duplicati sono stati ridotti mediante l'espressione mediana. Prima del calcolo dei punteggi dei moduli fissi di GSE117827, sono state applicate le stesse procedure: trasformazione logaritmica al 95° percentile, filtro dei valori mancanti, imputazione mediana e standardizzazione per gene all'interno di ciascun set di dati mediante z-score.
Per ogni tessuto e modulo, i punteggi acuti e di dimissione sono stati abbinati per soggetto e gruppo virale. È stata calcolata la differenza tra fase acuta e dimissione per ogni coppia. Il valore di Cohen dz è stato calcolato come la media delle differenze abbinate divisa per la deviazione standard campionaria. Sono stati riportati test t appaiati a due code e test di Wilcoxon a due code per ranghi con segno, insieme all'AUROC per la separazione tra i punteggi acuti e di dimissione. I valori FDR di Benjamini–Hochberg sono stati calcolati su tutti e 20 i test t appaiati validi nell'output longitudinale completo (due set di dati, due fonti di moduli e cinque sommari predeterminati per gruppo virale).
Analisi del gradiente sintomatologico e analisi post-hoc
Dopo aver fissato l'appartenenza ai moduli, le rilevazioni di picornavirus asintomatiche escluse in GSE117827 sono state utilizzate esclusivamente per l'analisi del gradiente sintomatologico. Il punteggio clinico ordinale era 0 per i controlli negativi al virus, 1 per le rilevazioni asintomatiche di picornavirus e 2 per le infezioni sintomatiche. La correlazione di Spearman ha valutato la tendenza ordinale, mentre il test di Kruskal-Wallis ha valutato le differenze complessive tra i tre gruppi. Test post-hoc di Mann-Whitney U a due code hanno confrontato le tre coppie di gruppi. La correzione di Benjamini-Hochberg è stata applicata separatamente all'interno di ogni compartimento alla sua famiglia di tre confronti a coppie.
Arricchimento funzionale
I geni dei moduli nasale e sanguigno sono stati analizzati con Enrichr tramite gseapy utilizzando le librerie MSigDB Hallmark 2020, Reactome 2022 e GO Biological Process 202325,26,28,29,30,31. Enrichr ha utilizzato il suo framework standard di sovra-rappresentazione basato sul test esatto di Fisher. La libreria ha riportato la correzione di Benjamini–Hochberg P valori < 0,05 sono stati considerati significativi. I otto termini più significativi per modulo tra le tre librerie interrogate sono stati ordinati in base al valore corretto P valore. I risultati dell'arricchimento sono stati utilizzati esclusivamente per l'interpretazione.
Analisi di robustezza, programma del marcatore e varianza
Le analisi di robustezza hanno verificato se i risultati dipendessero dalla dimensione del modulo o dalla selezione casuale. Sono state valutate dimensioni dei moduli di 10, 25, 50, 100 e 200 geni. Per l'analisi nulla basata su geni casuali, l'universo di riferimento comprendeva i geni codificanti per proteine dell'HGNC presenti nella matrice GSE117827 processata. Sono stati campionati 500 insiemi di 50 geni senza reimmissione, utilizzando un seme casuale NumPy pari a 20260622. La riselezione bootstrap era limitata ai 1.000 geni codificanti per proteine con effetto positivo, classificati più in alto nell'analisi iniziale originale per ciascun compartimento. In ogni ricampionamento, i geni codificanti per proteine con effetto positivo sono stati ordinati in base al valore P di Welch bilaterale crescente e successivamente in base alla differenza media decrescente. Sono stati selezionati i primi 50 geni. La stabilità dei geni è stata calcolata come numero di selezioni diviso per 100. Sono stati visualizzati i 20 geni con la frequenza di selezione più elevata in ciascun compartimento.
I punteggi dei programmi basati su marcatori sono stati utilizzati come ausili descrittivi piuttosto che come stime della frazione cellulare. Sono stati valutati sei programmi curati: epiteliale (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monocita/macrophage (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrofilo (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plasma (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) e interferone mieloide (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). Ogni punteggio del programma è stato calcolato come media dei punteggi z per gene disponibili, richiedendo almeno tre geni rappresentati. I valori P di Spearman sono stati corretti utilizzando la procedura di Benjamini–Hochberg sull'intera famiglia di correlazioni tra dataset, modulo e programma. L'eta-quadrato unidirezionale è stato calcolato come il rapporto tra la somma dei quadrati tra i gruppi e la somma totale dei quadrati per ogni coppia modulo-fattore. Le righe prive del fattore rilevante sono state escluse da tale calcolo. Questa analisi era di tipo descrittivo e non ha corretto per fattori mutuamente correlati.
Riproducibilità
Tutte le analisi sono state condotte utilizzando flussi di lavoro automatizzati in Python 3.12.13, con i pacchetti software e le versioni riportati nella Tabella dei Materiali. Le procedure randomizzate hanno utilizzato un seme fisso pari a 20260622. Le matrici di espressione pubbliche di GEO sono state elaborate utilizzando una struttura di progetto coerente che separava i dati grezzi, i dati elaborati, gli output statistici, le tabelle e le figure. Sono stati conservati le definizioni dei moduli, i record di cura dei campioni, le stime delle dimensioni dell'effetto, le statistiche di validazione, i risultati di arricchimento, le analisi di robustezza e i dati sorgente delle figure per supportare la verifica indipendente. Il codice di analisi, le specifiche delle dipendenze e i dati derivati di supporto sono disponibili come descritto nell’affermazione sulla disponibilità dei dati.
Risultati
Il benchmarking basato su passaggi ancorati ha separato gli effetti genici specifici del tessuto da quelli pan-tessutali
La matrice ancorata curata GSE117827 conteneva 27.685 geni approvati da HGNC. Il confronto principale nasale includeva 15 campioni infetti sintomatici e 6 campioni di controllo negativi al virus; il confronto ematico includeva 13 campioni infetti sintomatici e 6 controlli (Tabella 1). Poiché questa piccola coorte non può supportare una scoperta stabile a livello di singolo gene, è stata utilizzata come ancoraggio a compartimenti accoppiati. La stabilità è stata valutata a livello di modulo mediante ricampionamento bootstrap, test nulli con geni casuali, validazione esterna e analisi di sensibilità alla dimensione del modulo.
| Origine | Gruppo | Condizione | Confronto principale | n |
| Sangue | RSV | Infetto | Sì | 4 |
| Sangue | Picornavirus asintomatico | Secondario | No | 5 |
| Sangue | Picornavirus sintomatico | Infetto | Sì | 9 |
| Sangue | Controllo negativo al virus | Controllo | Sì | 6 |
| Nasale | RSV | Infetto | Sì | 6 |
| Nasale | Picornavirus asintomatico | Secondario | No | 5 |
| Nasale | Picornavirus sintomatico | Infetto | Sì | 9 |
| Nasale | Controllo negativo al virus | Controllo | Sì | 6 |
Tabella 1: Progettazione dell'ancora GSE117827 dopo la cura del contrasto primario. Distribuzione dei campioni tra i compartimenti ematici e nasali nel dataset dell'ancora abbinata dopo la cura del contrasto primario. I campioni di virus respiratorio sinciziale (RSV) sintomatici e i campioni di picornavirus sintomatici sono stati classificati come infetti e inclusi nel contrasto primario, mentre i controlli negativi al virus sono stati classificati come controlli e inclusi nel contrasto primario. I campioni di picornavirus asintomatici sono stati designati come secondari ed esclusi dalla costruzione dei moduli; sono stati utilizzati esclusivamente nell'analisi esplorativa del gradiente dei sintomi. Due casi di RSV non disponevano di campioni ematici, risultando in quattro campioni ematici e sei campioni nasali di RSV.
Tra i 27.685 geni condivisi, le stime di Hedges g per naso e sangue erano quasi scorrelate (Pearson r = 0,015; Figura 1). Questo risultato è emerso all'interno di un singolo studio ed è meno influenzato dalle differenze tra studi rispetto a un confronto transversale aggregato tra coorti. La densa nuvola centrale mostra che la maggior parte dei geni non ha mostrato un comportamento simile in entrambi i compartimenti. I geni sovrapposti evidenziati rappresentano eccezioni poste in cima a entrambe le liste di rango. Questo schema sostiene la costruzione separata di moduli per naso e sangue.
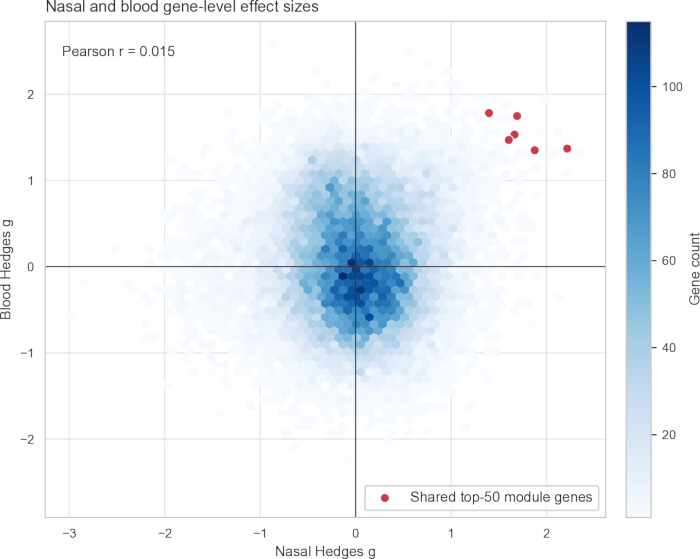
Figura 1. Dimensioni dell'effetto a livello genico nel naso e nel sangue nella coorte ancoretta accoppiata GSE117827. I valori di Hedges g confrontano l'infezione sintomatica con controlli negativi al virus per 27.685 geni. Le stime nasali (15 infetti, 6 controlli) sono riportate sull'asse x, mentre le stime ematiche (13 infetti, 6 controlli) sull'asse y. La tonalità dei bin esagonali indica il numero di geni per ogni bin. I punti rossi indicano i sei geni condivisi tra i primi 50 moduli nasali ed ematici. Pearson r = 0,015. Cliccare qui per visualizzare una versione ingrandita di questa figura.
La costruzione dei moduli ha prodotto un piccolo sovrapposizione centrata sugli interferoni
I 50 principali moduli nasali e sanguigni condividevano sei geni: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 e XAF1 (indice di Jaccard = 0,064; Tabella 2; Figura 2). ISG15, IFIT1, RSAD2 e XAF1 sono compatibili con una biologia antivirale associata agli interferoni32,33,34. CCRL2 è meglio interpretato nel contesto della migrazione dei leucociti infiammatori35. ACRBP non ha un ruolo antivirale stabilito. Tutti e sei i geni sono riportati per trasparenza, ma nessuno è indicato come biomarcatore validato trasversale ai tessuti. I valori FDR di questi singoli geni non erano significativi nel piccolo coorte di riferimento. L'interpretazione principale si basa quindi sulla validazione a livello di modulo bloccato, e non sull'elenco delle sovrapposizioni.
| Gene | Hedges g nasale | FDR nasale | Hedges g ematico | FDR ematico | Interpretazione |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.442 | Gene antivirale stimolato dall'interferone; sovrapposizione esplorativa |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Nessun ruolo antivirale accertato; mantenuto per trasparenza |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.442 | Gene antivirale stimolato dall'interferone; sovrapposizione esplorativa |
| RSAD2 | 1.663 | 0.213 | 1.532 | 0.442 | Gene antivirale stimolato dall'interferone; sovrapposizione esplorativa |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.442 | Contesto infiammatorio di migrazione dei leucociti; non specifico per i virus |
| XAF1 | 1.603 | 0.226 | 1.47 | 0.442 | Fattore dell'apoptosi associato all'interferone; sovrapposizione esplorativa |
Tabella 2: Sovrapposizione esplorativa completa tra i moduli principali del naso e del sangue. Tutti e sei i geni condivisi sono riportati con i valori di Hedges g per naso e sangue e i valori FDR specifici per gene. Tutti e sei i geni sono considerati candidati esplorativi di sovrapposizione nel rango poiché i valori FDR specifici per gene non erano significativi nel piccolo coorte di ancoraggio. ACRBP è mantenuto per trasparenza nonostante non abbia un ruolo antivirale stabilito. Nessuno dei sei geni è presentato come biomarcatore universale validato; l'evidenza principale si basa sulla validazione esterna a livello di modulo.
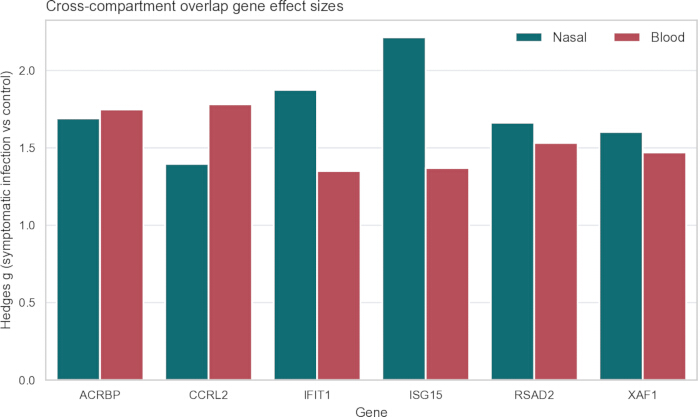
Figura 2. Dimensioni dell'effetto dei sei geni sovrapposti esplorativi tra naso e sangue. Sono mostrate le stime di Hedges g per naso e sangue per ACRBP, CCRL2, IFIT1, ISG15, RSAD2 e XAF1 nel dataset GSE117827. Valori positivi indicano un'espressione maggiore nell'infezione sintomatica rispetto ai controlli negativi al virus. È mostrata l'intera sovrapposizione per trasparenza; i valori FDR per singolo gene non erano significativi, e questi geni non sono presentati come biomarcatori universali validati. Cliccare qui per visualizzare una versione ingrandita di questa figura.
L'arricchimento funzionale ha fornito un controllo biologico sul contenuto dei moduli
Entrambi i moduli mostravano un arricchimento per le vie di interferone e antivirali, anche se la composizione genica e l'intensità dell'arricchimento differivano (Figura 3). Vengono visualizzati gli otto termini più significativi per modulo. Per il modulo nasale, risposta caratteristica all'interferone-gamma (aggiustato P = 2.23 × 10⁻24), risposta caratteristica all'interferone-alfa (aggiustata P = 1.40 × 10⁻22), segnalazione dell'interferone-alfa/beta in Reactome (aggiustato P = 3.64 × 10⁻19) e risposta di difesa GO al virus (aggiustato P = 5.47 × 10⁻15) classificati tra i termini principali. Il modulo del sangue ha mostrato la stessa biologia generale, ma con un'intensità di arricchimento inferiore: risposta all'interferone-alfa (aggiustato P = 3.87 × 10⁻6), segnalazione dell'interferone-alfa/beta in Reactome (aggiustato P = 5.70 × 10⁻6), risposta all'interferone-gamma (aggiustata P = 8.89 × 10⁻6) e risposta difensiva al virus (aggiustato P = 1.07 × 10⁻4). Questi risultati supportano una coerenza biologica senza implicare un identico ordinamento genico nei compartimenti.
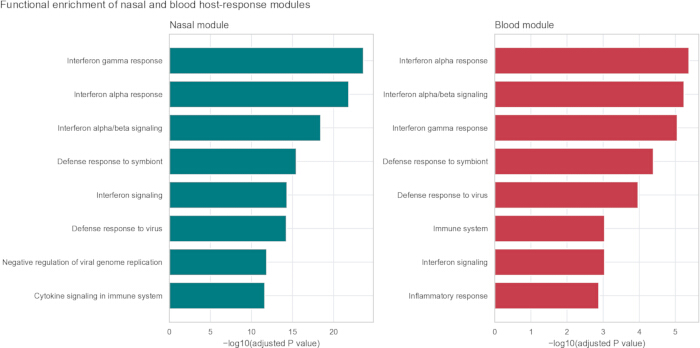
Figura 3. Termini di arricchimento selezionati per i moduli nasale ed ematico. È stata eseguita un'analisi di sovrarappresentazione utilizzando Enrichr con Hallmark 2020, Reactome 2022 e GO Biological Process 2023. Sono mostrati gli otto termini con i valori di P aggiustati secondo Benjamini–Hochberg più piccoli per ciascun modulo. La lunghezza delle barre rappresenta −log10(valore di P aggiustato). I pannelli sinistro e destro mostrano rispettivamente i moduli nasale ed ematico. I termini sono visualizzati in minuscolo iniziale. L'analisi di arricchimento non ha modificato l'appartenenza ai moduli. Cliccare qui per visualizzare una versione ingrandita di questa figura.
I moduli bloccati sono stati testati in una validazione esterna con tessuti abbinati
Il modulo nasale bloccato ha raggiunto valori di AUROC di 0.749 in GSE41374, 0.693 in GSE152075 e 0.609 in GSE156063 (Tabella 3; Figura 4). Il modulo ematico bloccato ha raggiunto valori di AUROC di 0.832 in GSE171110, 0.924 nell'unità GSE38900 GPL10558 e 0.870 nell'unità GPL6884. Le prestazioni degli ancoraggi interni sono omesse poiché sono ottimisticamente distorte per costruzione. Gli AUROC esterni sono considerati riassuntivi della portabilità. Essi non stabiliscono la sensibilità clinica, la specificità o l'idoneità per la diagnosi.
| Cohorte | Campione/virus | Modulo | n positivi | n negativi | Geni rappresentati | AUROC | Precisione media | FDR del test di Welch |
| GSE152075 | SARS-CoV-2 delle vie aeree superiori | Nasale | 430 | 54 | 50 | 0.693 | 0.935 | 2.20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 delle vie aeree superiori | Nasale | 93 | 100 | 49 | 0.609 | 0.551 | 1.38 × 10⁻² |
| GSE171110 | SARS-CoV-2 del sangue intero | Sangue | 44 | 10 | 50 | 0.832 | 0.959 | 7.94 × 10⁻⁴ |
| GSE38900-GPL10558 | RSV del sangue intero | Sangue | 28 | 8 | 50 | 0.924 | 0.979 | 7.94 × 10⁻⁴ |
| GSE38900-GPL6884 | RSV del sangue intero | Sangue | 107 | 31 | 49 | 0.87 | 0.962 | 3.47 × 10⁻¹⁵ |
| GSE41374 | Lavaggio nasale per RSV | Nasale | 76 | 10 | 50 | 0.749 | 0.951 | 2.63 × 10⁻² |
Tabella 3: Validazione del punteggio del modulo esterno abbinato al tessuto. Il modulo nasale bloccato è stato testato in GSE41374, GSE152075 e GSE156063, e il modulo sanguigno bloccato è stato testato nelle unità della piattaforma GSE171110 e in GSE38900, GPL10558 e GPL6884. La tabella riporta i numeri di campioni positivi e negativi, i geni del modulo rappresentati, l’AUROC, la precisione media e il FDR del test di Welch. Le prestazioni dell’ancora interna sono omesse. L’AUROC e la precisione media sono riportate come riepilogo della portabilità e non come stime delle prestazioni diagnostiche cliniche.
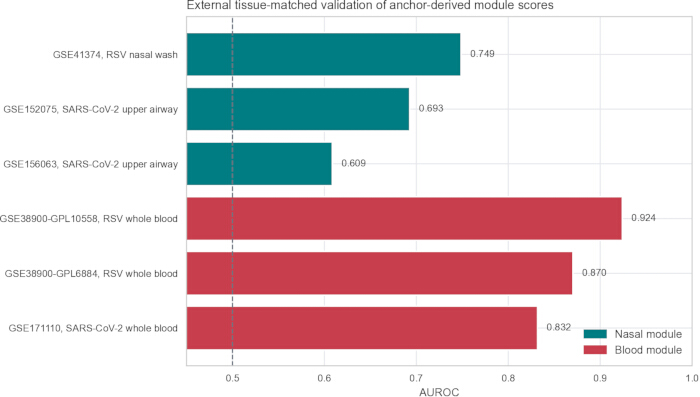
Figura 4. Portabilità dei punteggi dei moduli abbinati a tessuti esterni. Gli AUROC sono mostrati per il modulo nasale nei dataset GSE41374 (76 RSV, 10 controlli), GSE152075 (430 SARS-CoV-2, 54 controlli) e GSE156063 (93 SARS-CoV-2, 100 controlli), e per il modulo ematico nei dataset GSE171110 (44 SARS-CoV-2, 10 controlli), GSE38900-GPL10558 (28 RSV, 8 controlli) e GSE38900-GPL6884 (107 RSV, 31 controlli). I punteggi corrispondono alle medie non pesate dei valori z per gene rappresentati. La linea tratteggiata indica un AUROC = 0,5. I valori rappresentano riepiloghi di portabilità, non stime diagnostiche cliniche. Cliccare qui per visualizzare una versione ingrandita di questa figura.
La validazione longitudinale ha verificato se i punteggi diminuiscono durante il recupero
I set di dati complementari GSE97741/GSE97742 hanno fornito un contesto indipendente di validazione in caso di infezione naturale, con campioni prelevati in fase acuta e al momento della dimissione da bambini ricoverati27. Questi campioni non sono stati utilizzati come dati di scoperta per controlli sani. Sono stati impiegati per valutare se i punteggi dei moduli derivati dagli ancoraggi diminuissero dalla fase acuta della malattia fino alla dimissione.
Per il gruppo predefinito combinato di singola infezione da RSV e rinovirus, sono stati analizzati 68 soggetti appaiati per ogni tessuto (Tabella 4; Figura 5). Il modulo del sangue è diminuito dalla fase acuta della malattia al momento della dimissione nel sangue (delta medio = 0,330; Cohen dz = 0,740; FDR del test appaiato = 1,98 × 10⁻7; AUROC = 0,765). Il modulo nasale è diminuito anche nei campioni nasofaringei (delta medio = 0,436; Cohen dz = 0,477; FDR del test appaiato = 3,06 × 10⁻4; AUROC = 0,679). Le traiettorie appaiate e i loro errori standard mostrano che il calo a livello di gruppo non è stato determinato da pochi valori estremi non appaiati.
| Dataset | Fonte del campione | Modulo | Tessuto abbinato | n coppie | Delta medio acuto-dimissione | Cohen dz | AUROC | FDR del test accoppiato |
| GSE97741 | Blood | Blood | Sì | 68 | 0.330 | 0.740 | 0.765 | 1.98 × 10⁻⁷ |
| GSE97741 | Blood | Nasal | No | 68 | 0.479 | 0.721 | 0.755 | 3.19 × 10⁻⁷ |
| GSE97742 | Nasopharyngeal | Blood | No | 68 | 0.361 | 0.914 | 0.845 | 9.42 × 10⁻¹⁰ |
| GSE97742 | Nasopharyngeal | Nasal | Sì | 68 | 0.436 | 0.477 | 0.679 | 3.06 × 10⁻⁴ |
Tabella 4: Validazione longitudinale indipendente acuto-versus-dimissione. La tabella riporta il numero di coppie complete, la differenza media tra punteggio acuto e punteggio alla dimissione, il Cohen dz, l'AUROC e il valore FDR del test appaiato per i moduli fissi nei dataset GSE97741 e GSE97742. Un delta positivo indica un punteggio del modulo più elevato durante la fase acuta della malattia. I valori FDR del test appaiato sono valori P aggiustati secondo Benjamini–Hochberg per il test t appaiato bilaterale, calcolati su tutti e 20 i test t appaiati validi nell'output longitudinale completo.
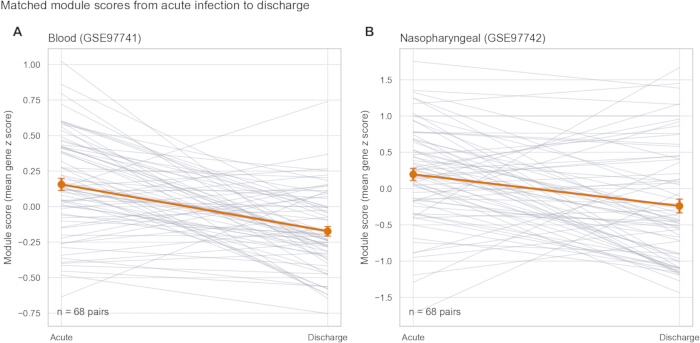
Figura 5. Variazioni accoppiate del punteggio del modulo dalla malattia acuta alla dimissione. (A) Punteggi del modulo ematico nel sangue intero (GSE97741). (B) Punteggi del modulo nasale in campioni nasofaringei (GSE97742). Ogni pannello contiene 68 coppie complete di soggetti: 38 infezioni singole da RSV e 30 infezioni da rhinovirus. Linee sottili collegano le misurazioni appaiate per soggetto. I punti arancioni indicano le medie del gruppo e le barre di errore arancioni indicano l'errore standard della media. Sono stati eseguiti test t appaiati bilaterali e test di Wilcoxon per ranghi con segno; è stata applicata la correzione FDR di Benjamini–Hochberg su 20 test t appaiati longitudinali validi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
I test su compartimenti incrociati hanno rivelato una sfumatura utile. Il modulo sanguigno applicato a campioni nasofaringei ha prodotto un AUROC di 0,845, anche se le dimensioni degli effetti individuali nel naso e nel sangue erano debolmente concordanti nell'ancora. L'analisi delle traiettorie abbinate ha mostrato un declino costante del punteggio, piuttosto che una distribuzione inversa delle etichette. Pertanto, il risultato non costituisce evidenza che gli stessi geni individuali dominino entrambi i tessuti. Indica invece che un programma interferonico/infiammatorio coordinato può essere riassunto da insiemi genici diversi ma parzialmente ridondanti. La specificità del compartimento è più marcata a livello del posizionamento dei geni ed è non assoluta a livello di percorso o di punteggio.
Rilevazioni asintomatiche escluse hanno verificato il comportamento del gradiente sintomatologico
Le rilevazioni asintomatiche di picornavirus in GSE117827 sono state escluse dalla costruzione del modulo per evitare di inserirle nel gruppo di controllo principale. Questo gruppo escluso ha successivamente fornito un controllo biologico. In entrambi i compartimenti, i punteggi dei moduli sono aumentati attraverso i gruppi ordinati di controlli negativi al virus, rilevazione asintomatica di picornavirus e infezione sintomatica (Figura 6A,B).
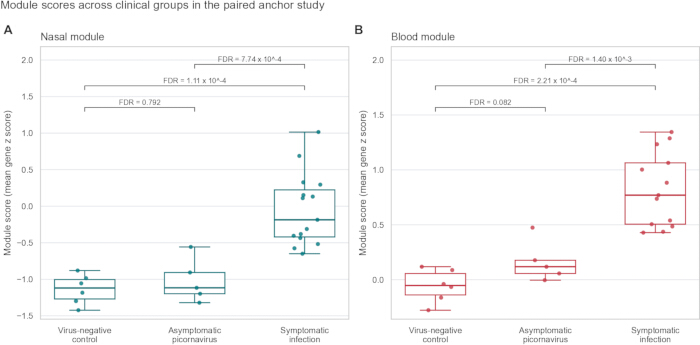
Figura 6. Punteggi dei moduli lungo il gradiente sintomatologico escluso. (A) Modulo nasale: 6 controlli negativi ai virus, 5 rilevazioni asintomatiche di picornavirus e 15 infezioni sintomatiche. (B) Modulo ematico: 6 controlli negativi ai virus, 5 rilevazioni asintomatiche di picornavirus e 13 infezioni sintomatiche. I punti rappresentano campioni individuali. Le linee centrali indicano le mediane; i riquadri si estendono dal 25° al 75° percentile; i baffi si protrudono fino ai valori più estremi entro 1,5 volte l'intervallo interquartile. Le etichette riportano i confronti post-hoc a due code di Mann-Whitney U con correzione di Benjamini-Hochberg effettuati su tre confronti per compartimento. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Il modulo nasale era correlato con il punteggio ordinale dei sintomi (rho di Spearman = 0,818, P = 3,28 × 10⁻7; Kruskal-Wallis P = 1,57 × 10⁻4). Il modulo ematico mostrava un gradiente simile (rho = 0,861, P = 6,89 × 10⁻8; Kruskal-Wallis P = 1,92 × 10⁻4). Dopo la correzione all'interno di ciascuna famiglia di tre confronti, l'infezione sintomatica differiva dai controlli e dalle rilevazioni asintomatiche in entrambi i compartimenti. Le rilevazioni asintomatiche non differivano dai controlli negativi al virus (FDR nasale = 0,792; FDR ematico = 0,082). I moduli riflettevano quindi l'attività della risposta dell'ospite sintomatico in modo più chiaro rispetto alla sola rilevazione virale.
I parametri clinici hanno definito il confine tra la risposta dell'ospite e la specificità del patogeno
I parametri clinici hanno definito la distinzione tra l'attività della risposta dell'ospite e la classificazione del patogeno (Tabella 5; Figura 7). Nel dataset GSE63990, il modulo nasale ha prodotto valori di AUROC pari a 0,782 per la distinzione tra malattia virale e batterica e 0,791 per la distinzione tra malattia virale e non infettiva. Il modulo ematico ha prodotto rispettivamente valori di AUROC pari a 0,678 e 0,753. Il comparatore basato sulle 33 mRNA di Pandya ha ottenuto prestazioni migliori, con valori di AUROC pari a 0,867 e 0,852 rispettivamente. Questo risultato era previsto per un insieme progettato per discriminare tra infezioni virali e non virali, e dimostra che i moduli di ancoraggio non dovrebbero essere presentati come classificatori diagnostici sostitutivi.
| Dataset | Confronto | Nasale di riferimento | Sangue di riferimento | Pandya 33 mRNA | Andres-Terre ISG | Interferone-alfa Hallmark |
| GSE63990 | Virale vs batterico | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE63990 | Virale vs non infettivo | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | Polmonite virale vs batterica | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE40012 | Polmonite virale vs SIRS | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | Polmonite virale vs sano | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | Polmonite batterica vs sano | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | PMBC stimolati ex vivo con rhinovirus vs non stimolati | 1 | 0.957 | 1 | 1 | 1 |
Tabella 5: Benchmark AUROC per i moduli ancorati e i set di risposta del sistema ospite di riferimento. GSE63990 e GSE40012 sono coorti cliniche di sangue intero. GSE53543 è un esperimento di perturbazione di PBMC ex vivo che coinvolge 98 soggetti appaiati ed è riportato separatamente dalle coorti cliniche naturali. I set di riferimento sono stati valutati come medie geniche non pesate, anziché come i loro classificatori pesati originali. I valori AUROC sono riportati come metriche di benchmarking e non come stime della performance diagnostica clinica.
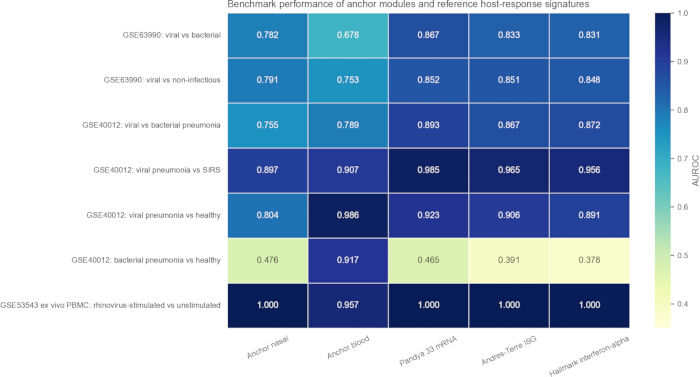
Figura 7. Confronto AUROC dei moduli di ancoraggio e dei set di risposta ospite di riferimento. Le righe rappresentano confronti predeterminati nei dataset GSE63990, GSE40012 e GSE53543; le colonne rappresentano i due moduli di ancoraggio e i tre set di riferimento non pesati. Il dataset GSE53543 è etichettato come PBMC stimolati ex vivo con rhinovirus rispetto a non stimolati ed è presentato separatamente dai cohort clinici naturali. Il comparatore Hallmark è etichettato come Hallmark interferone-alfa. I valori nelle celle indicano gli AUROC utilizzati per il confronto dei metodi e non devono essere interpretati come stime delle prestazioni diagnostiche cliniche. Cliccare qui per visualizzare una versione ingrandita di questa figura.
GSE40012 ha definito con maggiore precisione questo limite. Il comparatore Pandya ha raggiunto valori di AUROC pari a 0,893 per polmonite virale rispetto a polmonite batterica e 0,985 per polmonite virale rispetto a SIRS. Il modulo del sangue ha distinto la polmonite da influenza A dai controlli sani (AUROC = 0,986) e da SIRS (AUROC = 0,907), ma ha anche distinto la polmonite batterica dai controlli sani (AUROC = 0,917). Il modulo del sangue misura quindi un'attività infiammatoria sistemica e associata agli interferoni di ampia portata. Non è specifico per i virus e un punteggio elevato non consente di assegnare la classe del patogeno.
Nel benchmark separato GSE53543 su PBMC es vivo, il modulo nasale e i comparatori dell'interferone hanno raggiunto un AUROC di 1,000 per i PBMC stimolati dal rhinovirus rispetto ai PBMC trattati solo con mezzo; il modulo sanguigno ha raggiunto un AUROC di 0,957. Tutti e 98 i soggetti hanno contribuito con condizioni accoppiate. Questo risultato controllato supporta la reattività dei programmi valutati alla stimolazione da rhinovirus. Non stima tuttavia la performance diagnostica clinica.
Verifiche di robustezza hanno testato la dimensione del modulo, alternative casuali e la stabilità della selezione
La separazione degli ancoraggi è rimasta invariata considerando i primi 10, 25, 50, 100 e 200 geni in classifica (Figura 8A). Queste AUROC interne non costituiscono una validazione esterna, ma mostrano che il risultato qualitativo non dipendeva dalla scelta esatta di 50 geni. In 500 insiemi casuali di 50 geni, le mediane AUROC nulle erano 0.489 per il tessuto nasale e 0.705 per il sangue; i corrispondenti percentili al 99° erano 0.722 e 0.872 (Figura 8B). I moduli osservati superavano queste distribuzioni nulle. Le frequenze di selezione ottenute con il metodo bootstrap erano distribuite piuttosto che concentrate in un’unica lista invariante (Figura 8C). Questo risultato riflette direttamente la piccola dimensione del campione di ancoraggio. Esso supporta un segnale aggregato stabile, ma mette in guardia contro il considerare ogni gene selezionato come fisso.
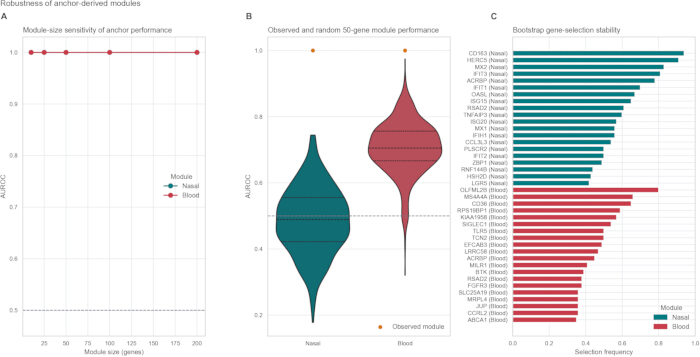
Figura 8. Analisi della robustezza rispetto alle dimensioni del modulo, ai geni casuali e al metodo bootstrap. (A) Valore medio AUROC al variare delle dimensioni del modulo (10, 25, 50, 100 e 200 geni); questi valori rappresentano controlli interni di sensibilità. (B) Distribuzioni dell’AUROC ottenute da 500 insiemi casuali di 50 geni codificanti proteine, estratti senza reimmissione dai geni presenti in GSE117827 (seed = 20260622). I punti arancioni indicano i valori osservati di AUROC per ciascun modulo. Le linee orizzontali all’interno di ogni diagramma a violino indicano il 25° percentile, la mediana e il 75° percentile. (C) La riselezione tramite bootstrap è stata limitata ai 1.000 geni codificanti proteine con effetto positivo, ordinati in base al punteggio più alto nell’analisi iniziale dell’ancoraggio per ciascun compartimento. Le barre mostrano i 20 geni con la frequenza di selezione più elevata per compartimento; la frequenza di selezione è stata calcolata come numero di selezioni diviso per 100. Cliccare qui per visualizzare una versione ingrandita di questa figura.
L'analisi dei marcatori e della varianza ha chiarito cosa misurano i punteggi
Nei dataset GSE40012, GSE53543 e GSE63990, entrambi i moduli hanno mostrato correlazioni più consistenti con il programma dell'interferone mieloide (Figura 9A). Le correlazioni per il modulo nasale sono state rispettivamente 0,812, 0,878 e 0,882; quelle per il modulo ematico sono state 0,517, 0,843 e 0,774. La ripartizione della varianza è stata descrittiva (Tabella 6; Figura 9B). Per il modulo ematico, la condizione e il gruppo dettagliato hanno spiegato una varianza maggiore (eta-quadrato = 0,282 e 0,250, rispettivamente) rispetto al dataset (0,066), al tipo di campione (0,026) o al gruppo di provenienza (0,025). Per il modulo nasale, il gruppo dettagliato e la condizione hanno spiegato anch'essi una varianza maggiore rispetto al dataset, al tipo di campione o al gruppo di provenienza. La condizione biologica e il gruppo dettagliato hanno quindi spiegato frazioni più elevate della varianza dei punteggi dei moduli rispetto al dataset o al tipo di campione, anche se effetti residui legati al dataset e alla composizione rappresentano una limitazione nell'uso ripetuto di dati pubblici in bulk.
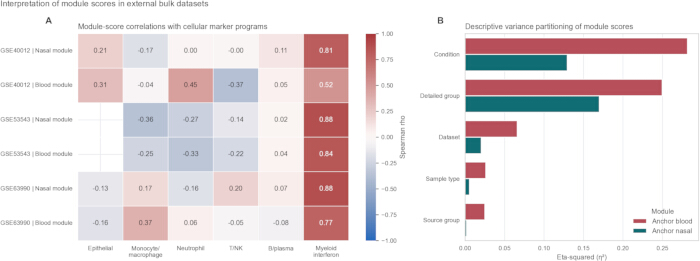
Figura 9. Correlazioni tra marcatori e programmi e partizione descrittiva della varianza. (A) Correlazioni di Spearman tra i punteggi dei moduli e i punteggi di sei programmi marcatore in GSE40012, GSE53543 e GSE63990. I programmi richiedevano almeno tre geni rappresentati. I valori di P sono stati corretti per tutte le correlazioni tra dataset, modulo e programma. Le celle vuote indicano combinazioni non disponibili o non stimabili dopo i requisiti di geni e campioni. (B) Eta-quadrato unidirezionale (η2; somma dei quadrati tra gruppi / somma totale dei quadrati) per condizione, gruppo dettagliato, dataset, tipo di campione e gruppo di origine. L'analisi ha incluso 934 punteggi di modulo del sangue e 1.469 punteggi di modulo nasale ed è descrittiva, non causale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Modulo | Fattore | Eta-quadrato | n campioni |
| Sangue di ancoraggio | Condizione | 0.282 | 934 |
| Sangue di ancoraggio | Gruppo dettagliato | 0.25 | 934 |
| Sangue di ancoraggio | Set di dati | 0.066 | 934 |
| Sangue di ancoraggio | Tipo di campione | 0.026 | 934 |
| Sangue di ancoraggio | Gruppo di origine | 0.025 | 934 |
| Nasale di ancoraggio | Gruppo dettagliato | 0.17 | 1469 |
| Nasale di ancoraggio | Condizione | 0.13 | 1469 |
| Nasale di ancoraggio | Set di dati | 0.021 | 1469 |
| Nasale di ancoraggio | Tipo di campione | 0.006 | 1469 |
| Nasale di ancoraggio | Gruppo di origine | 0.002 | 1469 |
Tabella 6: Partizione descrittiva della varianza dei punteggi dei moduli. È riportata una riga per ogni coppia modulo-fattore, con il corrispondente valore di eta-quadrato e la dimensione del campione. L'eta-quadrato è stato calcolato come la somma dei quadrati tra i gruppi divisa per la somma totale dei quadrati, dopo l'esclusione delle righe con punteggio del modulo o del fattore mancante. I fattori sono stati valutati singolarmente; pertanto, l'analisi è descrittiva, non corregge per fattori mutuamente correlati e non deve essere interpretata in senso causale.
Disponibilità dei dati:
Tutti i set di dati trascrittomici analizzati in questo studio sono disponibili pubblicamente presso il Gene Expression Omnibus con i numeri di accessione GSE117827, GSE41374, GSE152075, GSE156063, GSE171110, GSE38900, GSE97741, GSE97742, GSE63990, GSE40012 e GSE53543. I dati derivati dall'analisi alla base delle figure e tabelle principali e il codice di analisi sono disponibili presso l'autore corrispondente su richiesta ragionevole. In questo studio non sono stati utilizzati dati a livello individuale nuovi o soggetti a restrizioni.
Discussione
La lezione principale è operativa: iniziare dal compartimento campionato, piuttosto che dalla matrice combinata più ampia. GSE117827 è piccolo, ma il suo disegno accoppiato consente un confronto diretto naso-sangue all'interno di un unico studio. La correlazione quasi nulla a livello genico degli effetti mostra che un elenco unico di geni ordinati da un'analisi pan-tessutale nasconderebbe una struttura compartimentale significativa. Progettare moduli separati è stata quindi la scelta più giustificabile. Le prestazioni esterne e longitudinali supportano un'attività di risposta dell'ospite riproducibile a livello di modulo, piuttosto che una lista universale di geni.
La portabilità a livello genico e a livello di modulo è diversa. Il modulo del sangue ha mostrato buone prestazioni nei campioni longitudinali del nasofaringe (AUROC 0,845), nonostante una scarsa concordanza tra le dimensioni dell'effetto individuali nel naso e nel sangue. Le traiettorie abbinate non hanno mostrato inversione delle etichette. Una spiegazione più probabile è la ridondanza dei percorsi biologici: l'attività coordinata dell'interferone e quella infiammatorie possono essere riassunte da diversi sottoinsiemi di geni in diversi compartimenti6,7,8,9,10,11,32,33,34. Per questo motivo descriviamo i moduli come sensibili al compartimento piuttosto che esclusivi del compartimento. Le classifiche esatte differiscono, ma un componente comune a livello di percorso biologico rimane rilevabile. I profili bulk mescolano inoltre i cambiamenti di espressione con variazioni nella composizione cellulare. Le correlazioni tra marcatori e programmi possono segnalare questo problema, ma non possono fornire meccanismi risolti a livello cellulare36,37.
I parametri clinici definiscono un secondo limite. I confronti basati sulle 33 mRNA di Pandya e sull'interferone si sono rivelati più efficaci nella discriminazione tra infezioni virali e batteriche. I moduli di ancoraggio rispondono a una domanda diversa: quanto intensamente un campione esprime un programma di risposta ospite acuta? Il modulo sanguigno è aumentato anche nella polmonite batterica. Dovrebbe pertanto essere interpretato come un punteggio di attività infiammatoria/sistemica interferonica generale, piuttosto che come un classificatore specifico per i virus. Un punteggio elevato può supportare il confronto tra coorti, il monitoraggio della risposta o la descrizione dello stato infiammatorio, ma non consente di identificare il patogeno. L'importanza clinica crescente di virus come il metapneumovirus umano sostiene ulteriormente la necessità di una validazione diversificata per patogeni e adatta ai tessuti, piuttosto che un'estrapolazione da un insieme ristretto di virus12,13.
I sei geni sovrapposti sono di carattere esplorativo. ISG15, IFIT1, RSAD2 e XAF1 hanno ruoli plausibilmente legati all'interferone32,33,34; CCRL2 è associato alla migrazione dei leucociti infiammatori35; ACRBP non ha un'interpretazione antivirale stabilita. La dimensione ridotta del gruppo e i valori FDR non significativi a livello genico impediscono affermazioni più forti. L'innovazione metodologica risiede altrove: un ancoraggio abbinato all'interno dello stesso studio, moduli specifici per compartimenti fissati, test esterni abbinati al tessuto, analisi abbinata del recupero, confronto con parametri clinici di riferimento e verifiche esplicite di casualità, dimensione, bootstrap, marcatori e varianza. Questa gerarchia di evidenze fornisce un quadro conservativo per l'interpretazione dei risultati.
Permangono diversi limiti. Il gruppo di ancoraggio comprende solo 15 campioni nasali infetti e 6 controlli, e 13 campioni ematici infetti e 6 controlli. I risultati dell'analisi bootstrap confermano che l'appartenenza individuale ai geni non è completamente stabile. I casi sintomatici di RSV e picornavirus sono stati raggruppati, pertanto gli effetti di ancoraggio non sono specifici per virus. I gruppi esterni differiscono per età, piattaforma, gravità, tempistica e definizione dei controlli. GSE53543 è uno studio di perturbazione accoppiato ex vivo. GSE63990 e GSE40012 forniscono comparatori clinici utili ma non includono campionamenti accoppiati naso-sangue. Carica virale, durata dei sintomi, necessità di ossigeno e gravità non erano disponibili in modo uniforme. Un disegno prospettico più solido raccoglierebbe tamponi nasali e campioni ematici dagli stessi partecipanti in tempi corrispondenti, con misurazioni della carica virale e dei sintomi, comparatori negativi per virus sintomatici e batteri, e una validazione a risoluzione cellulare11,14,36,37.
In conclusione, gli attuali trascrittomi pubblici supportano moduli riproducibili di attività della risposta ospite a livello nasale e sanguigno quando il contesto tissutale viene preservato. Non supportano invece una firma genica pan-tissutale interscambiabile. L'ancoraggio abbinato ha mostrato una scarsa concordanza a livello genico, mentre i punteggi dei moduli bloccati si sono trasferiti all'interno di tessuti corrispondenti e sono diminuiti durante la fase di recupero. La risposta del modulo sanguigno nella polmonite batterica e le prestazioni superiori di un classificatore consolidato nel distinguere infezioni virali da quelle batteriche definiscono l'uso previsto: questi moduli descrivono l'attività della risposta ospite e consentono un benchmarking trasparente dei coorti; non sono classificatori autonomi di patogeni. Il codice di analisi e i dati derivati sono disponibili come descritto nell'indicazione sulla disponibilità dei dati, al fine di supportare la verifica indipendente e il riutilizzo del flusso di lavoro.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi finanziari o non finanziari relativi a questo lavoro.
Ringraziamenti
Gli autori ringraziano i ricercatori e i partecipanti degli studi GEO pubblici ri-analizzati in questo lavoro. Nessun'altra persona soddisfaceva i criteri per l'autorevolezza. Questa ricerca non ha ricevuto alcun finanziamento specifico da agenzie di finanziamento pubbliche, commerciali o senza scopo di lucro.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Insieme di geni stimolati dall'interferone multi-virus di Andres-Terre | Andres-Terre et al. | Comparatore di 33 geni; Dati Supplementari 1 | Comparatore orientato all'interferone non pesato, curato sulla base della firma multi-virus riportata; l'elenco completo dei geni è fornito nei Dati Supplementari 1. |
| Enrichr | Ma'ayan Laboratory | Accesso 18 agosto 2026; RRID:SCR_001575 | Risorsa per l'analisi di sovrarappresentazione di insiemi genici, accessibile tramite gseapy. |
| Gene Expression Omnibus | National Center for Biotechnology Information | GEO; RRID:SCR_005012 | Repositorio pubblico di trascrittomi utilizzato per accedere ai set di dati analizzati. |
| Gene Ontology | Gene Ontology Consortium | GO Biological Process 2023; RRID:SCR_002811 | Biblioteca di annotazioni funzionali utilizzata tramite Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Piattaforma per GSE53543 e per l'unità di validazione GSE38900 composta da 36 campioni. |
| GPL23126 | NCBI GEO | GPL23126 | Piattaforma di espressione per GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Annotazione Clariom D Human na36, hg38 utilizzata per il mappaggio dei cluster trascrizionali in GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Annotazione della piattaforma applicata a GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Piattaforma per l'unità di validazione su sangue intero GSE38900 con 138 campioni per RSV. |
| GPL6947 | NCBI GEO | GPL6947 | Annotazione della piattaforma applicata a GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Set di dati principale di riferimento accoppiato di tamponi nasali e sangue intero. |
| GSE152075 | NCBI GEO | GSE152075 | Set di dati esterno di validazione delle vie aeree superiori per SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Set di dati esterno di validazione delle vie aeree superiori per SARS-CoV-2. |
| GSE171110 | NCBI GEO | GSE171110 | Set di dati esterno di validazione su sangue intero per SARS-CoV-2. |
| GSE38900 | NCBI GEO | GSE38900; GPL10558 e GPL6884 | Validazione esterna su sangue intero per RSV analizzata come unità di piattaforma distinte da 36 e 138 campioni, normalizzate separatamente. |
| GSE40012 | NCBI GEO | GSE40012 | Termine di riferimento clinico per polmonite da influenza A, polmonite batterica, SIRS e controlli sani. |
| GSE41374 | NCBI GEO | GSE41374 | Set di dati esterno di validazione con lavaggio nasale per RSV. |
| GSE53543 | NCBI GEO | GSE53543 | Termine di riferimento accoppiato di perturbazione da rinovirus su PBMC es vivo, comprendente 98 soggetti e 196 campioni. |
| GSE63990 | NCBI GEO | GSE63990 | Termine di riferimento clinico su sangue intero per infezioni virali, batteriche e non infettive. |
| GSE97741 | NCBI GEO | GSE97741 | Set di dati di validazione longitudinale su sangue intero, confronto tra fase acuta e dimissione. |
| GSE97742 | NCBI GEO | GSE97742 | Set di dati di validazione longitudinale nasofaringea, confronto tra fase acuta e dimissione. |
| gseapy | sviluppatori di gseapy | Versione 1.3.1 | Interfaccia Python utilizzata per interrogare Enrichr. |
| Risorsa simboli genici HGNC | HUGO Gene Nomenclature Committee | Accesso 18 agosto 2026; RRID:SCR_002827 | Risorsa per la normalizzazione dei simboli genici approvati e la classificazione dei geni codificanti proteine. |
| Matplotlib | squadra di sviluppo di Matplotlib | Versione 3.11.1 | Generazione di figure. |
| Insiemi genici Hallmark MSigDB | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Biblioteca di arricchimento Hallmark accessibile tramite Enrichr. |
| Insieme genico Hallmark MSigDB di risposta all'interferone-alfa | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; sottoinsieme principale di 33 geni nei Dati Supplementari 1 | Comparatore non pesato di risposta all'interferone-alfa; il sottoinsieme esatto è fornito nei Dati Supplementari 1. |
| NumPy | sviluppatori di NumPy | Versione 2.5.2 | Calcoli numerici e campionamento casuale con seme. |
| pandas | squadra di sviluppo di pandas | Versione 3.0.5 | Elaborazione di dati tabellari. |
| Insieme di 33 mRNA di risposta dell'ospite di Pandya | Pandya et al. | Tabella Supplementare 1; Dati Supplementari 1 | Set ufficiale di 33 geni valutato come comparatore non pesato. |
| Python | Python Software Foundation | Versione 3.12.13 | Ambiente di analisi computazionale. |
| Reactome | Reactome | Reactome 2022; RRID:SCR_003485 | Biblioteca di arricchimento di percorsi metabolici accessibile tramite Enrichr. |
| scikit-learn | sviluppatori di scikit-learn | Versione 1.9.0 | Calcoli di AUROC e precisione media. |
| SciPy | sviluppatori di SciPy | Versione 1.18.0 | Test di Welch, t appaiato, Wilcoxon, Mann–Whitney e test di correlazione. |
| Seaborn | squadra di sviluppo di Seaborn | Versione 0.13.2 | Grafica statistica. |
| statsmodels | sviluppatori di statsmodels | Versione 0.14.6 | Utilità statistiche. |
Riferimenti
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.