Questo lavoro di ricerca ha presentato un approccio, FusionNetX, arricchendo la capacità di fusione delle caratteristiche di DenseNet121 ed EfficientNetB7 per la classificazione dei tumori cerebrali su cinque dataset pubblicamente disponibili, con aumento dei dati, preelaborazione e personalizzazione del modello ibrido (fusione intermedia), ottenendo risultati compresi tra il 98,77% e il 99,89%, superando diversi parametri di valutazione.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo metodologico
FusionNetX: un modello di fusione di caratteristiche profonde che sfrutta la risonanza magnetica e il deep learning per il miglioramento della rilevazione dei tumori cerebrali
In questo articolo
Sommario
Abstract
I tumori cerebrali sono considerati una delle malattie più letali al mondo e la loro diagnosi errata mette a rischio la vita dei pazienti e riduce il tasso di sopravvivenza. L'uso della risonanza magnetica (MRI) combinata con tecniche basate sull'apprendimento profondo, in particolare reti neurali convoluzionali, è fondamentale per superare questo ostacolo, poiché consente un esame più dettagliato della struttura interna del cervello e offre straordinarie capacità di apprendimento e previsione. La necessità di una diagnosi accurata del tumore cerebrale rimane significativa. Pertanto, viene proposto un modello avanzato di apprendimento profondo basato sulla fusione di caratteristiche (FusionNetX) che sfrutta i punti di forza di due modelli preaddestrati, DenseNet121 ed EfficientNetB7, mediante iperparametri di fine-tuning personalizzati, inclusi strati addestrabili e non addestrabili. Il modello proposto FusionNetX è stato applicato a cinque dataset pubblici di tumori cerebrali: Br35H, Figshare, Sartaj, Masoud e Balanced Brain Tumor. Sono stati applicati alcuni passaggi di pre-elaborazione per migliorare la qualità delle immagini e affrontare il problema dell'overfitting mediante ridimensionamento e aumento dei dati. Utilizzando diverse metriche di valutazione delle prestazioni, come accuratezza, perdita, valore predittivo positivo, valore predittivo negativo, tasso di veri positivi, tasso di veri negativi, punteggio F1, tasso di falsi negativi e tasso di falsi positivi, si è riscontrato che il modello proposto FusionNetX raggiunge un'accuratezza del 99,33% per Br35H, del 99,13% per Figshare, del 99,89% per Masoud, del 99,19% per BBT-Dataset e del 98,77% per Sartaj. Inoltre, i cinque dataset di tumori cerebrali sono stati valutati utilizzando la fusione tardiva e la fusione basata sull'attenzione per dimostrare il valore del modello FusionNetX proposto, ottenendo risultati sostanzialmente migliori, con miglioramenti compresi tra lo 0,3% e l'1,9% su tutti i dataset. Inoltre, è stata calcolata la curva ROC (receiver operating characteristic) e i risultati ottenuti da diverse metriche di valutazione indicano che il modello proposto FusionNetX è in grado di rilevare e prevedere con precisione i tumori cerebrali, aiutando i professionisti sanitari a prendere decisioni tempestive.
Introduzione
Il cancro è la malattia più letale nel corpo umano ai giorni nostri a causa della sua gravità e del tasso di crescita in aumento, mentre numerose patologie tumorali, come i tumori cerebrali, il cancro al seno, i noduli polmonari, il cancro renale e altri, si riscontrano nel corpo umano, provocando un aumento del tasso di mortalità. Il cancro si sviluppa quando le cellule o i tessuti nel corpo di una persona si moltiplicano in modo anomalo. Quando il cancro metastatizza, può danneggiare altri organi umani e diventare più pericoloso1. Poiché il cervello controlla ogni funzione corporea, qualsiasi danno a esso può avere conseguenze estese sull'intero organismo. Per questo motivo i tumori cerebrali o il cancro sono così letali per l'essere umano2. Inoltre, i tumori cerebrali sono suddivisi principalmente in due categorie: benigni e maligni. "Benigno" significa fondamentalmente non canceroso; si tratta semplicemente di un problema cerebrale che può essere risolto modificando l'ambiente circostante. Nel caso della malignità, invece, la situazione è considerata pericolosa a causa della sua natura metastatica, ovvero della capacità delle cellule o dei tessuti anomali di spostarsi verso altre parti del corpo o da esse, alterando il funzionamento di altri organi e aumentando ulteriormente la probabilità di sviluppare cancro nell'organismo3.
Inoltre, secondo l'American Brain Tumor Association e l'Organizzazione Mondiale della Sanità (WHO), i tumori pituitari, i meningiomi e i gliomi rappresentano le tre principali categorie di tumori cerebrali4. I gliomi hanno origine dalle cellule gliali, che nutrono i neuroni nel cervello. I tumori pituitari hanno inizio nell'ipofisi, situata alla base del cervello e responsabile di numerose funzioni corporee; i tumori meningiomi, invece, si sviluppano nelle meningi, membrane che proteggono l'encefalo e il midollo spinale. Inoltre, diverse modalità di imaging medico vengono comunemente utilizzate per esaminare le strutture interne del corpo a fini diagnostici, tra cui radiografie, tomografie computerizzate (TC) e risonanza magnetica (RM)5,6. Ogni modalità di imaging presenta vantaggi e svantaggi specifici. La risonanza magnetica è una tecnica di imaging in grado di fornire immagini dettagliate dei tessuti molli e delle cellule del corpo, specialmente del cervello. Il cancro coinvolge tessuti o cellule anomali nel corpo, e la risonanza magnetica permette di visualizzare in modo dettagliato tali anomalie, risultando così una modalità di imaging più utile per la diagnosi di tumori cerebrali o del cancro. Inoltre, la risonanza magnetica è più sicura rispetto ad altre tecniche di imaging poiché non emette radiazioni dannose durante l'esame dell'anatomia interna del corpo.
Inoltre, molte metodologie computazionali sono impiegate per affrontare le sfide diagnostiche associate ai tumori cerebrali, tra cui l'apprendimento automatico (ML), l'elaborazione delle immagini (IP) e l'apprendimento profondo (DL); ciascun approccio viene applicato a immagini ottenute mediante tecniche di imaging per diagnosticare il cancro7. Questi metodi imparano i modelli e le strutture nascoste di diversi oggetti presenti nelle immagini, al fine di diagnosticare il cancro identificando i pattern nella regione colpita. Ogni approccio computazionale presenta vantaggi e svantaggi specifici nel processo diagnostico. Gli approcci basati su ML e IP estraggono caratteristiche definite manualmente, il che porta spesso a previsioni inaccurate e a diagnosi errate, specialmente su dataset di grandi dimensioni8. Per superare i problemi legati all'estrazione manuale delle caratteristiche, si sta passando a modelli basati sull'apprendimento profondo, comunemente noti come modelli basati su reti neurali convoluzionali (CNN), in grado di apprendere ed estrarre automaticamente le migliori caratteristiche dalle immagini per diagnosticare con precisione i tumori. Gli approcci basati su DL sono ormai comunemente utilizzati nell'imaging medico per diagnosticare malattie nel corpo umano, in particolare per la rilevazione precoce e accurata di tumori cerebrali, cancro al seno, cancro ai polmoni e altre patologie, grazie alla loro capacità di apprendere ed estrarre modelli complessi da dati su larga scala producendo risultati più precisi9. Il principale problema riscontrato nei modelli DL è il consumo elevato di risorse e la necessità di un ampio campionamento dei dati, superato da un altro approccio basato sull'apprendimento profondo chiamato apprendimento per trasferimento10 (TL), in cui si utilizzano modelli pre-addestrati per diagnosticare la malattia, risparmiando tempo e risorse. La diagnosi precoce e accurata dei problemi di salute è resa possibile da modelli pre-addestrati, che hanno già appreso caratteristiche fondamentali relative a trama, colore, bordi e altri aspetti da un ampio dataset. Tali modelli possono quindi essere trasferiti a un nuovo dataset mai visto in precedenza, sfruttando il modello esistente e aggiungendo iperparametri e strati addestrabili e non addestrabili11. È stato condotto un numero significativo di ricerche sulla classificazione dei tumori cerebrali e la Tabella 112,13,14,15,16,17,18,19,20,21,22,23 presenta i dettagli di tali ricerche, inclusi gli approcci, i dataset e i risultati. Tuttavia, nessuno studio ha ancora impiegato una metodologia che combini due modelli di apprendimento per trasferimento per un'estrazione robusta delle caratteristiche e che regoli le tecniche di regolarizzazione per garantire un addestramento e un test fluidi. Una valutazione approfondita della metodologia proposta fornisce informazioni sulle prestazioni del modello in relazione a diverse caratteristiche dei tumori cerebrali.
| Rif | Approccio | Campioni di dati | Risultati | Limitazioni |
| 12 | CNN personalizzata | Br35H | Accuratezza = 97,45%, | È ancora necessario migliorare i risultati; invece di utilizzare una CNN progettata autonomamente, è preferibile utilizzare un modello CNN preesistente con modifiche. |
| Piùssia = 0,1141%, | ||||
| Recupero = 98,09%, | ||||
| F1-Score = 97,69%, | ||||
| Precisione = 97,29%, | ||||
| Br35H aumentato | Accuratezza = 98,99%, | |||
| Precisione = 98,90%, | ||||
| Piùssia = 0,0570%, | ||||
| Recupero = 98,91%, | ||||
| F1-Score = 99,04% | ||||
| 13 | Modello DNN con fusione di caratteristiche | Br35H | Accuratezza = 98,22%, | È ancora necessario migliorare i risultati e, invece di utilizzare un modello personalizzato, c'è ancora bisogno di utilizzare un modello preesistente per la fusione delle caratteristiche. |
| FNR = 1,77%, | ||||
| Sensibilità = 98,2%, | ||||
| F1-Score = 98%, | ||||
| Specificità = 98%, | ||||
| Figshare | Accuratezza = 98,01%, | |||
| Sensibilità = 96,03%, | ||||
| F1-Score = 96%, | ||||
| Specificità = 98,67%, | ||||
| FNR = 3,96% | ||||
| 14 | AlexNet con SGD | Br35H | Accuratezza = 98,79%, | È ancora necessario apportare alcuni miglioramenti ai risultati e dobbiamo verificare modelli basati su CNN più avanzati su diversi campioni di dati. |
| MCR = 1,20%, | ||||
| Sensibilità = 98,98%, | ||||
| Specificità = 98,58%, | ||||
| F1-Score = 98,82% | ||||
| 15 | InceptionV3 | Figshare | Accuratezza = 98,89%, | Gli autori hanno utilizzato il dataset Figshare, che comprende tre classi di tumori; invece di classificarli, hanno classificato la presenza o l'assenza del tumore, e c'è ancora bisogno di migliorare i risultati nonché di categorizzare le classi tumorali. |
| SensibilitàB = 95,28%, | ||||
| SensibilitàM = 94,47% | ||||
| 16 | ResNet50 ottimizzato | Figshare | Accuratezza = 99,03%, | Sono necessari ulteriori parametri di valutazione delle prestazioni e ulteriori miglioramenti dei risultati. |
| Recupero = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | Accuratezza = 98,22%, | È ancora necessario migliorare i risultati. |
| Sensibilità = 98,11%, | ||||
| Precisione = 98,22%, | ||||
| Figshare | F1-Score = 98,41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Accuratezza = 99,18%, | C'è un lieve miglioramento nei risultati e la necessità di verificare ulteriori set di dati relativi ai tumori cerebrali. |
| Recupero = 99,11%, | ||||
| F1-Score = 99,08, | ||||
| Precisione = 99,07%, | ||||
| Sartaj | Accuratezza = 97,24%, | |||
| Recupero = 97,58%, | ||||
| F1-Score = 97,28%, | ||||
| Precisione = 97,06%, | ||||
| 19 | CNN-SVM | Brats | Accuratezza = 98,02%, | È necessario applicare alcuni modelli preesistenti con SVM e c'è ancora bisogno di migliorare i risultati. |
| F1-Score = 98,31%, | ||||
| Precisione = 98,09%, | ||||
| Sensibilità = 98,53%, | ||||
| Specificità = 97,30%, | ||||
| Sartaj | Accuratezza = 96,83%, | |||
| Precisione = 95,36%, | ||||
| Sensibilità = 94,73%, | ||||
| Specificità = 97,56%, | ||||
| F1-Score = 95% | ||||
| 20 | EfficientNetB3 fine-tuned | Figshare | Accuratezza = 98,70% | È necessario utilizzare le varianti sopra menzionate di EfficientNetB3 per migliorare i risultati. |
| Sartaj | Accuratezza = 97,50% | |||
| 21 | InceptionV4 | Masoud | Accuratezza = 98,7%, | Sono richiesti alcuni miglioramenti nei risultati utilizzando ulteriori set di dati. |
| Precisione = 99%, | ||||
| Sensibilità = 98%, | ||||
| Specificità = 99%, | ||||
| F1-Score = 99,1% | ||||
| 22 | VGG16 | Masoud | Accuratezza = 98% | È necessario migliorare i risultati verificando ulteriori modelli di reti neurali profonde. |
| 23 | MFR-CNN | Masoud | Accuratezza = 94%, | È un'architettura complessa utilizzata in questa soluzione proposta. |
| Recupero = 96%, | ||||
| F1-Score = 96%, | ||||
| Precisione = 96%, |
Tabella 1: Esame comparativo dei lavori di ricerca più recenti. La tabella riassume le ricerche esistenti, insieme ai loro approcci, campioni di dati, risultati e limitazioni. Cliccare qui per scaricare questa tabella.
Tabella 1 esamina gli approcci esistenti, evidenziandone i limiti nel miglioramento dei risultati e la necessità di utilizzare modelli DL preesistenti, valutandone al contempo le prestazioni rispetto a diversi parametri statistici, il tutto all'interno di un framework efficiente che ottiene prestazioni migliori su diversi dataset di tumori cerebrali.
Obiettivi dello studio e formulazione del problema
L'interpretazione manuale richiede molto tempo ed è soggetta a variabilità inter-osservatore; pertanto, la categorizzazione rapida e accurata dei tipi di tumore cerebrale mediante risonanza magnetica è fondamentale per il processo decisionale clinico. La maggior parte degli approcci di apprendimento profondo (DL) per la classificazione automatizzata dei tumori cerebrali attualmente disponibili si basa su una singola rete principale o su una semplice fusione a livello decisionale, il che non sfrutta appieno le rappresentazioni complementari di caratteristiche provenienti da diverse architetture preaddestrate, e spesso viene validata su un solo dataset, limitando la fiducia nella loro generalizzabilità.
Questo progetto di ricerca mira a sviluppare e fornire un metodo completo e accurato per la diagnosi dei tumori cerebrali nel cervello umano, utilizzando un framework DL a doppio backbone (EfficientNetB7 e DenseNet121) che sfrutta rappresentazioni complementari di caratteristiche per consentire una classificazione robusta dei tumori cerebrali a partire da immagini di risonanza magnetica. Valuta inoltre la robustezza del framework su più dataset pubblici indipendenti. Questo approccio può aiutare i radiologi e il personale paramedico a diagnosticare rapidamente ed efficacemente i tumori cerebrali, salvando vite umane grazie al riconoscimento e alla classificazione tempestivi.
Per risolvere un determinato problema di ricerca e raggiungere gli obiettivi di questo progetto, si formulano le seguenti domande di ricerca e contributi per affrontarle: 1) La fusione a livello di caratteristiche (intermedio) di due reti profonde preaddestrate è migliore rispetto alle tecniche di fusione a livello decisionale (finale) e basate sull'attenzione per la classificazione dei tumori cerebrali? 2) Il sistema proposto fornirà prestazioni di classificazione costanti su numerosi dataset MRI di tumori cerebrali acquisiti indipendentemente?
L'ambito di questo studio è limitato alla classificazione a livello di immagine (fetta MRI 2D), utilizzando cinque dataset pubblici di risonanze magnetiche di tumori cerebrali (Br35H, Figshare, Sartaj, Masoud e BBT-Dataset); valutati in modo indipendente, senza confronti tra dataset; e impiegando l'architettura specifica, la pipeline di pre-elaborazione e la configurazione sperimentale descritte nella sezione metodologia. Lo studio non include validazione a livello di paziente né test in un contesto di impiego clinico.
I principali contributi di questo lavoro di ricerca sono i seguenti: 1) Il contributo principale di questo lavoro di ricerca consiste nell'utilizzare modelli preaddestrati duali per un'estrazione delle caratteristiche più efficace, inclusi DenseNet121 ed EfficientNetb7 con iperparametri ottimizzati. 2) Un'architettura innovativa del modello, con una tecnica avanzata di regolarizzazione integrata con caratteristiche concatenate provenienti da un modello preaddestrato doppio, per prestazioni robuste. 3) È stata applicata una strategia efficace di aumento dei dati per aumentare la diversità dei campioni di addestramento, al fine di apprendere caratteristiche più generiche e specifiche, superando i problemi di overfitting. 4) Le prestazioni del modello proposto sono state valutate su cinque diversi dataset pubblici di tumori cerebrali, concentrandosi su vari parametri statistici di valutazione, tra cui accuratezza, tasso di errore di classificazione, precisione, valore predittivo negativo, sensibilità, specificità, F1-Score, tasso di falsi negativi e tasso di falsi positivi.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
La malattia più minacciosa al mondo è il tumore cerebrale. Una diagnosi accurata può essere vantaggiosa per la sopravvivenza dei pazienti. Tuttavia, esiste la necessità di un sistema diagnostico preciso in grado di rilevare i tumori cerebrali in una fase precoce. Per affrontare questo problema, è stata proposta una tecnica più affidabile per il rilevamento accurato dei tumori cerebrali nelle fasi iniziali, basata su un meccanismo ibrido di apprendimento profondo doppio con iperparametri ottimizzati e strati finemente regolati, derivanti dai modelli DenseNet121 ed EfficientNetB7. L'approccio proposto utilizza come input immagini MRI 2D e fornisce in output una previsione di presenza o assenza del tumore per il dataset di classificazione binaria Br35H, e la categorizzazione del tumore per altri quattro dataset di classificazione multiclasse. Pertanto, questa sezione illustra i passaggi principali dell'approccio proposto, dall'acquisizione dei dati all'output finale, inclusi acquisizione dei dati, pre-elaborazione dei dati, suddivisione dei dati, selezione del modello, estrazione delle caratteristiche, previsione del tumore e valutazione del modello proposto, come mostrato in Figura 1.
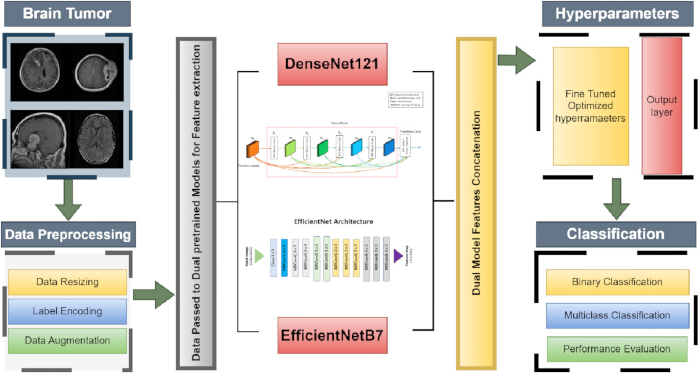
Figura 1: Flusso della metodologia proposta. Questo diagramma mostra l'architettura generale del modello proposto, inclusa l'acquisizione e la pre-elaborazione dei dati; due modelli pre-addestrati per l'estrazione di caratteristiche; la concatenazione delle loro caratteristiche; e l'ottimizzazione degli iperparametri per la classificazione e il tipo di tumore. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Acquisizione dei dati
In qualsiasi ricerca sperimentale, il primo passo è l'acquisizione dei dati. A tal fine, sono stati scelti cinque diversi dataset pubblicamente disponibili, tra cui Br35H24, Figshare25, Sartaj26, Masoud27 e il dataset basato su immagini MRI di tumori cerebrali proveniente dalla libreria open-source Kaggle28, già utilizzati da numerosi ricercatori per la diagnosi del rilevamento dei tumori cerebrali. Il dataset Br35H contiene 3.000 immagini suddivise in due classi: immagini cerebrali sane e non sane (con tumore), con 1.500 immagini per ciascuna classe, mentre il dataset Figshare comprende 3.064 immagini, suddivise in tre gruppi in base al tipo di tumore: 1.426 immagini di glioma, 708 immagini di meningioma e 930 immagini di tumori pituitari. Il dataset Sartaj contiene 3.264 immagini categorizzate in quattro classi di tumore: gliomi (926 immagini), meningiomi (937 immagini), tumori pituitari (901 immagini) e sani o senza tumore (500 immagini). Inoltre, il dataset Masoud comprende anch'esso quattro diverse classi di tumore, le cui immagini sono state prese dai tre dataset sopra menzionati, per un totale di 7023 immagini, ulteriormente categorizzate in glioma (1621 immagini), meningioma (1645 immagini), pituitario (1757 immagini) e sano o senza tumore (2000 immagini). L'ultimo dataset scelto è un dataset basato su immagini MRI, che comprende anch'esso quattro classi per un totale di 5248 immagini, ulteriormente suddivise per tipo di tumore, inclusi 1312 immagini di glioma, 1312 immagini di meningioma, 1312 immagini di tumore pituitario e 1312 immagini sane o senza tumore, già equamente distribuite tra i tipi di tumore e considerate un dataset bilanciato.
Preelaborazione dei dati
Dopo l'acquisizione dei dati, il passo successivo è la preelaborazione, fondamentale per ottenere risultati migliori e più utili per gli approcci computazionali volti a estrarre e apprendere le caratteristiche migliori dai dati, producendo risultati più accurati. Il primo passo applicato è stato il ridimensionamento delle immagini. Sono stati selezionati cinque dataset pubblicamente disponibili con diverse classi e dimensioni delle immagini, anche all'interno dello stesso dataset, per diverse classi di tumori, e sono stati uniformemente ridimensionati a 224 x 224 per una migliore interpretazione e apprendimento del modello. Inoltre, è stata applicata l'aumentazione dei dati a tutti i dataset generando campioni aggiuntivi da angolazioni diverse, migliorando così l'estrazione e l'apprendimento da parte dei modelli di apprendimento profondo (DL). A tale scopo, è stato applicato a tutte le immagini un intervallo di rotazione del 7%, ruotandole fino a 7 gradi. Successivamente, è stato applicato a tutte le immagini uno spostamento casuale del 5% in senso orizzontale e verticale, con uno spostamento del 5% in altezza e larghezza rispetto alle immagini originali. Dopodiché, le immagini sono state ingrandite del 10% rispetto alle immagini originali e, infine, tutte le immagini sono state capovolte orizzontalmente e verticalmente. Il motivo principale per cui si effettua l'aumentazione dei dati29 è superare il problema dell'overfitting e migliorare la capacità di generalizzazione dei modelli addestrandoli su diverse versioni trasformate dei campioni di dati originali. Prima di suddividere i dataset in training e validazione, è stata applicata la codifica delle etichette, che risulta più utile nel calcolo della funzione di perdita (loss) durante l'addestramento e la validazione, rendendo inoltre i campioni di dati più efficaci affinché i modelli possano elaborare correttamente le etichette. Inoltre, il dataset è stato suddiviso in insiemi di training e validazione con un rapporto 80% a 20%30 per ciascuno, e Tabella 2 mostra la distribuzione complessiva dei campioni di dati e i rispettivi rapporti di training e validazione.
| Dataset | Classi tumorali | Immagini totali | Immagini di addestramento | Immagini di validazione |
| Br35H | Salute | 1500 | 1200 | 300 |
| Tumore | 1500 | 1200 | 300 | |
| Immagini totali | 3000 | 2400 | 600 | |
| Figshare | Glioma | 1426 | 1141 | 285 |
| Meningioma | 708 | 566 | 142 | |
| Pituitario | 930 | 744 | 186 | |
| Immagini totali | 3064 | 2451 | 613 | |
| Sartaj | Glioma | 926 | 741 | 185 |
| Meningioma | 937 | 749 | 188 | |
| Nessun tumore | 500 | 400 | 100 | |
| Pituitario | 901 | 721 | 180 | |
| Immagini totali | 3264 | 2611 | 653 | |
| Masoud | Glioma | 1621 | 1297 | 324 |
| Meningioma | 1645 | 1316 | 329 | |
| Nessun tumore | 2000 | 1600 | 400 | |
| Pituitario | 1757 | 1405 | 352 | |
| Immagini totali | 7023 | 5618 | 1405 | |
| Dataset bilanciato sui tumori cerebrali (BBT-Dataset) | Glioma | 1312 | 1050 | 262 |
| Meningioma | 1312 | 1050 | 262 | |
| Nessun tumore | 1312 | 1050 | 262 | |
| Pituitario | 1312 | 1050 | 262 | |
| Immagini totali | 5248 | 4200 | 1048 |
Tabella 2: Distribuzione del set di dati. La tabella mostra le statistiche per classe riguardo al numero totale di immagini e a quelle utilizzate per il training e per la validazione nei set di dati sui tumori cerebrali.
Il set di dati Br35H è composto da 3000 immagini, di cui 2400 selezionate per l'addestramento e 600 per la validazione. Il set di dati Figshare comprende 3064 immagini. Di tutte le immagini, 2451 sono state selezionate per l'addestramento e le rimanenti 613 per la validazione. Il set di dati Sartaj ha un totale di 3264 immagini, di cui 2611 utilizzate per l'addestramento e le rimanenti 653 per la validazione. Il set di dati Masoud ha un totale di 7023 immagini; di queste, 5618 sono state utilizzate per l'addestramento e le rimanenti 1405 per la validazione. Il set di dati BBT ha un totale di 5248 immagini. Delle immagini totali, 4200 sono state considerate ai fini dell'addestramento, mentre le restanti 1048 immagini sono state considerate ai fini della validazione. Inoltre, Figura 2 illustra di seguito le varie immagini di tumori cerebrali.
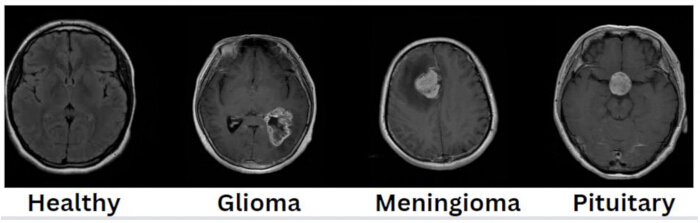
Figura 2: Immagini di tumori cerebrali, inclusi i tipi di tumore. Il dataset contiene quattro immagini di tessuto cerebrale sano e tre immagini tumorali: glioma, meningioma e pituitario. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Modello proposto
Dopo la fase di pre-elaborazione, il passo successivo consiste nel proporre un modello di addestramento efficace esclusivamente per la classificazione dei tumori cerebrali. A tal fine, è stato proposto un modello efficiente per l'addestramento, specificamente progettato per classificare i tumori cerebrali. In particolare, si propone un nuovo ed efficiente modello ibrido basato sulla fusione di caratteristiche pre-addestrate, comprendente DenseNet12131,32 ed EfficientNetB733, utilizzati per estrarre le caratteristiche dalle immagini; successivamente, le caratteristiche estratte vengono concatenate e trasmesse a diversi iperparametri finemente regolati, inclusi strati addestrabili e non addestrabili, al fine di diagnosticare con precisione i tumori cerebrali. Il modello è stato implementato su cinque diversi dataset pubblicamente disponibili, discussi nelle sezioni precedenti. Inoltre, il modello DenseNet121 è stato sviluppato da Gao Huang e dai suoi collaboratori nel 2017 e comprende 121 strati. L'obiettivo principale di questo modello è massimizzare il riutilizzo delle caratteristiche ed evitare il problema del gradiente scomparso34. Gli strati di questo modello sono organizzati in blocchi densi, ognuno contenente diversi strati convoluzionali che estraggono e apprendono le caratteristiche. Ogni strato riceve la mappa delle caratteristiche da tutti gli strati precedenti come ingresso, e il suo output viene collegato agli output di quegli strati e trasmesso come ingresso agli strati successivi nello stesso blocco in modo feed-forward. Inoltre, tra i blocchi densi vengono inseriti strati di transizione, ognuno composto da un livello convoluzionale 1 × 1, un livello BatchNormalization e livelli di pooling medio 2 × 2, che riducono la mappa delle caratteristiche per controllare la complessità del modello. Infine, viene aggiunto un livello con funzione di attivazione SoftMax (AF) prima di un livello di global average pooling per la classificazione. La struttura fondamentale del modello DenseNet121 è mostrata in Figura 334 riportata di seguito.
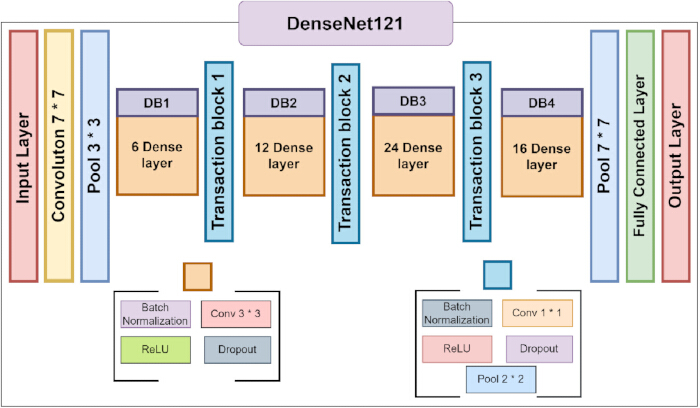
Figura 3: Dettaglio architetturale di DenseNet12134. Questa figura mostra il dettaglio architetturale del modello DenseNet121, inclusi tutti i blocchi densi e di transizione. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Inoltre, il modello EfficientNetB7 è stato ideato da Tan e Lee nel 2019. Appartiene alla famiglia EfficientNet, che comprende varianti dalla B0 alla B7, e il suo obiettivo principale è superare gli altri modelli utilizzando meno parametri e minore potenza computazionale. La larghezza del modello (numero di canali per livello), la profondità (numero di livelli) e la risoluzione possono essere regolate finemente tramite una scalatura composta, che rappresenta la caratteristica fondamentale del modello. Inoltre, questo modello è composto da blocchi MBConv (convoluzione a collo di bottiglia invertita mobile), che includono un livello di espansione convoluzionale 1 × 1 responsabile dell'ampliamento dei canali, una convoluzione separabile per profondità che applica la convoluzione a ciascun canale separatamente, e un livello di proiezione convoluzionale 1 × 1 che riduce il numero di canali al valore originale. Ogni blocco MBConv include inoltre blocchi Squeeze and Excitation (SE)35, che ricalibrano le caratteristiche per canale, aiutando la rete a concentrarsi su quelle più importanti. Invece della sigmoide o di qualsiasi altra funzione di attivazione (AF), viene utilizzata la funzione Swish, che offre prestazioni superiori rispetto a ReLU consentendo valori negativi, favorendo così il flusso del gradiente. Inoltre, viene aggiunto un livello di output finale con una funzione di attivazione SoftMax prima di un livello di global average pooling per scopi di classificazione. Figura 435 mostra il design di base del modello EfficientNetB7, mentre Figura 5 illustra l'architettura del modello raccomandata.
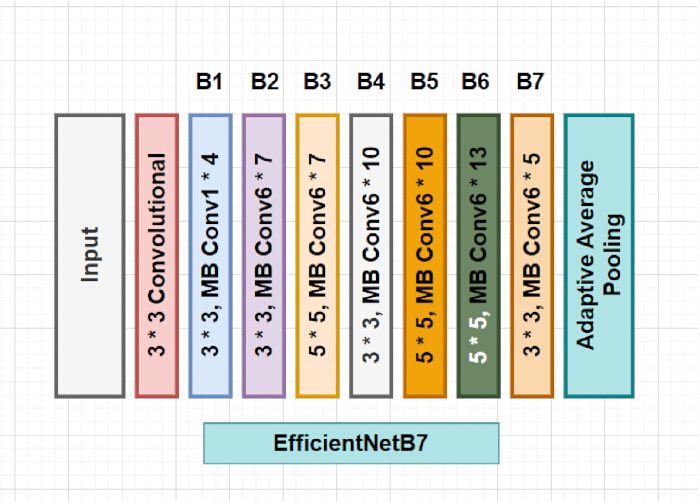
Figura 4: Dettaglio architetturale di EfficientNetB735. Questa figura mostra il dettaglio architetturale del modello EfficientNetB7, inclusi tutti i blocchi convoluzionali a collo di bottiglia invertito per dispositivi mobili. Cliccare qui per visualizzare una versione ingrandita di questa figura.
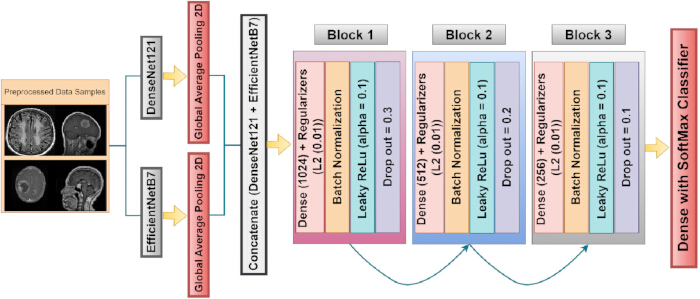
Figura 5: Architettura proposta del modello ibrido fuso. L'architettura proposta illustra come le immagini preelaborate vengano trasmesse all'estratore di caratteristiche, costituito da tre blocchi personalizzati con diversi iperparametri, seguiti da un livello di uscita. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Inoltre, inizialmente le caratteristiche sono state estratte dai modelli preaddestrati DenseNet121 ed EfficientNetB7. I pesi aggiornati dei modelli preaddestrati sono stati caricati sui modelli addestrati e sono stati bloccati i livelli di base non addestrabili per impedire un ulteriore addestramento del modello. Questo dovrebbe aiutare il modello a mantenere le conoscenze migliori acquisite in precedenza, ad adattarle alla luce di nuovi campioni di dati per migliorare la convergenza e a concentrarsi sui livelli aggiuntivi da addestrare ed estrarre caratteristiche avanzate. Le equazioni 1 e 2 riportate di seguito illustrano il funzionamento dei modelli DenseNet121 ed EfficientNetB7.
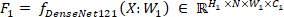 (1)
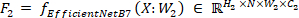 (2)
Le equazioni 1 e 2 sopra mostrano il funzionamento del modello preaddestrato relativamente all'estrazione delle caratteristiche; F1 indica le mappe delle caratteristiche in uscita prodotte dal modello DenseNet121 preaddestrato e F2 indica le mappe delle caratteristiche in uscita prodotte dal modello EfficientNetB7 preaddestrato applicando un'elaborazione alle immagini in ingresso, rappresentate da X. Inoltre, W1 e W2 sono i parametri apprendibili o pesi associati ai primi blocchi e strati dei modelli DenseNet121 ed EfficientNetB7, rispettivamente. Ulteriormente, ∈ RN ×H1×W1×C1 e ∈ RN ×H2×W2×C2 rappresentano la dimensionalità delle mappe delle caratteristiche in uscita dei modelli DenseNet121 ed EfficientNetB7, rispettivamente, con dimensioni H1 ×N×W1×C1 e H2 ×N×W2×C2, dove N rappresenta la dimensione del batch delle immagini, considerata pari a 16. Inoltre, H1×W1 rappresenta l'altezza e la larghezza delle immagini, rispettivamente, per il modello DenseNet121 e H2×W2 rappresenta l'altezza e la larghezza delle immagini per il modello EfficientNetB7 ed è stata selezionata con dimensioni di 224 × 224. C1 e C2 rappresentano il canale colore per i modelli DenseNet121 ed EfficientNetB7, rispettivamente. Dopo aver ottenuto le mappe delle caratteristiche in uscita dal modello, ovvero 2560 canali da EfficientNetB7 e 1024 da DenseNet121, viene applicato il livello di global average pooling 2D36 alle mappe delle caratteristiche in uscita per ridurre la dimensione spaziale calcolando la media di tutte le dimensioni spaziali in un singolo vettore, il che risulta più comodo per il passaggio al livello successivo al fine di un'ottimale estrazione delle caratteristiche e riconoscimento di schemi in termini di caratteristiche interpretabili.
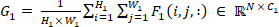 (3)
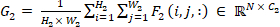 (4)
Le equazioni 3 e 4 sopra mostrano il funzionamento del livello di global average pooling 2D applicato rispettivamente ai modelli DenseNet121 ed EfficientNetB7, dove  e
 mostrano la procedura di normalizzazione della somma dividendo per il numero totale di posizioni spaziali di entrambi i modelli, in modo da garantire che l'output raggruppato sia una media piuttosto che una semplice somma.
 e
 rappresentano la sommatoria lungo le dimensioni spaziali delle mappe di caratteristiche, mentre i e j servono semplicemente per iterare rispettivamente lungo l'altezza e la larghezza, al fine di sommare le mappe di caratteristiche per entrambi i modelli. Inoltre, F1(i, j, :) e F2(i, j, :) rappresentano i valori delle mappe di caratteristiche in specifiche posizioni spaziali (i, j) lungo tutti i canali, rispettivamente per i modelli DenseNet121 ed EfficientNetB7. Questa operazione di pooling aggrega le informazioni spaziali in una rappresentazione più compatta e accurata, preservando al contempo le caratteristiche più importanti di ogni immagine. Inoltre, gli output dei livelli di global average pooling vengono concatenati per produrre un singolo vettore di caratteristiche per ogni campione, che viene spesso utilizzato per fondere caratteristiche provenienti da modelli diversi al fine di migliorare le prestazioni sfruttando i punti di forza di entrambi i modelli; l'equazione 5 mostra come funziona.
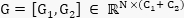 (5)
L'equazione 5 mostra il procedimento di concatenazione di due diversi vettori caratteristici di modelli [G1, G2], dove G1 rappresenta il vettore delle caratteristiche del modello DenseNet121 e G2 rappresenta il vettore delle caratteristiche del modello EfficientNetB7, mentre la forma del vettore caratteristico concatenato è rappresentata da RN ×(C1+ C2), dove N è la dimensione del batch, che indica il numero di campioni elaborati in parallelo, e (C1+ C2) è il numero totale di caratteristiche ottenute rispettivamente dal modello 1 e dal modello 2, pari a circa 3584, che vengono elaborate in parallelo; il vettore caratteristico risultante dalla concatenazione è indicato con G. Inoltre, sono stati aggiunti tre blocchi distinti per modificare il modello fuso al fine di estrarre caratteristiche più complesse, migliorare la generalizzazione ed evitare l'overfitting, al fine di ottenere risultati più precisi ed efficienti. Ogni blocco è composto da un livello denso con un numero diverso di neuroni: il primo blocco ha 1024 neuroni nei suoi strati densi, che si concentrano sull'acquisizione di un'ampia gamma di caratteristiche e modelli più generici nei dati; il secondo blocco ha 512 neuroni nel suo strato denso, che affina specificamente le caratteristiche riducendone la dimensionalità e concentrandosi su modelli più specifici. Il terzo blocco contiene 256 neuroni nel suo strato denso, che distillano ulteriormente le caratteristiche per garantire che solo le caratteristiche e i modelli più rilevanti vengano trasmessi allo strato di uscita per svolgere un compito più pertinente. Inoltre, sono state applicate tecniche di regolarizzazione L237 a ogni strato denso di ciascun blocco per prevenire l'overfitting penalizzando pesi elevati, il che aumenta anche la complessità del modello. Dopo ciascun blocco è stato introdotto uno strato di dropout38 per ignorare casualmente rispettivamente il 30%, il 20% e il 10% dei neuroni nei blocchi 1, 2 e 3, costringendo così la rete a sviluppare caratteristiche più robuste che non dipendano da un singolo neurone. Per stabilizzare il processo di addestramento, dopo ogni strato denso viene applicato uno strato di BatchNormalization39, che garantisce che le attivazioni rimangano entro un intervallo stabile e aiuta il modello a evitare problemi come il vanishing gradient e l'exploding gradient durante la fase di addestramento. Inoltre, questo strato di BatchNormalization accelera anche il processo di addestramento, consentendo al modello di convergere più rapidamente grazie all'appiattimento del paesaggio della funzione di perdita, rendendo più facile per gli ottimizzatori raggiungere minimi globali. Infine, in ciascun blocco viene utilizzata l'attivazione leaky ReLU40 per generare non linearità, consentendo al modello di apprendere modelli complessi; la leaky ReLU presenta vantaggi rispetto ad altre funzioni di attivazione poiché evita che un neurone diventi inattivo permettendo un piccolo gradiente non nullo anche per ingressi negativi. L'equazione 6 illustra il funzionamento dei diversi blocchi integrati nel modello ibrido fuso.
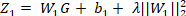 (6)
Dopo aver ottenuto il vettore concatenato, G viene elaborato dal livello denso (completamente connesso) del blocco 1, composto da 1024 neuroni, in cui la matrice dei pesi W1 trasforma il vettore in ingresso G in un vettore in uscita di dimensione 1024, e ogni elemento del vettore in uscita è una combinazione lineare delle caratteristiche in ingresso. Successivamente, al vettore di bias b1 viene aggiunto ciascuno dei 1024 elementi del vettore in uscita, consentendo al modello di spostare in modo indipendente l'uscita delle caratteristiche in ingresso. Inoltre, il termine di regolarizzazione L2: λ||W1||22 penalizza i pesi elevati, scoraggiando il modello dal dipendere eccessivamente da un singolo neurone, il che aiuta a evitare l'overfitting. Qui, la matrice dei pesi di un determinato livello è W1 nella rete neurale, mentre ||W1||22 indica la norma L2 al quadrato della matrice dei pesi W1 e λ è il parametro di regolarizzazione che controlla il grado di regolarizzazione applicata, impostato a 0,1 in tutti i blocchi. Z1 diventa la nuova rappresentazione delle caratteristiche dopo aver applicato il livello denso e la regolarizzazione L2 all'ingresso proveniente dal vettore concatenato G, come mostrato nell'equazione 6.
Dopo aver ottenuto l'output dal livello denso del blocco 1 come Z1, è stato applicato il livello BatchNormalization, utilizzato per accelerare il processo di addestramento, e l'equazione 7 riportata di seguito mostra il suo funzionamento.
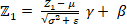 (7)
σ2 rappresenta la varianza dell'output dell'ultimo strato Z1 all'interno del batch, mentre μ è la media dell'output Z1 calcolata separatamente per ogni neurone, pari a 1024 nel primo strato denso. Invece, ε è una costante molto piccola inclusa per garantire la stabilità numerica ed evitare la divisione per zero. L'output normalizzato può essere regolato dal modello modificando il parametro di scala apprendibile γ, mentre lo spostamento dell'output normalizzato può essere effettuato tramite il parametro di shift apprendibile β. Infine, dopo aver applicato il livello di normalizzazione del batch (BatchNormalization) all'output dello strato denso, l'output normalizzato Z1 assicura che le attivazioni abbiano una distribuzione coerente tra i diversi strati, il che contribuisce a stabilizzare e accelerare l'addestramento. Dopo la normalizzazione del batch, l'output normalizzato Z1 passa attraverso la funzione di attivazione leaky ReLU, che introduce non-linearità nella rete, aiutando ad apprendere modelli complessi nei dati. Invece di scegliere ReLU o un'altra funzione di attivazione, è stata scelta leaky ReLU, una versione modificata della funzione ReLU che considera anche piccoli valori negativi anziché porli a zero come fa la funzione di attivazione ReLU, risolvendo così il problema del "dying ReLU". L'equazione 8 riportata di seguito mostra il suo funzionamento.
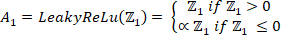 (8)
Dove Z1 appartiene all'uscita del livello BatchNormalization, che viene fornita come ingresso a Leaky ReLU per eseguire la non linearità, mentre ∝ è una costante piccola utilizzata per determinare l'inclinazione della parte negativa della funzione. Inoltre, A1 mostra l'uscita ottenuta dopo aver applicato la non linearità. Infine, un livello dropout viene applicato all'uscita A1 ricevuta come ingresso dall'attivazione Leaky ReLU, come mostrato nell'equazione 9.
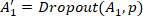 (9)
Dove A1 è l'uscita originale della funzione di attivazione ricevuta dall'ultima funzione di attivazione ReLu e dove p è la percentuale di dropout, che varia tra 0 e 1 ed è stata impostata rispettivamente a 0,3, 0,2 e 0,1 per i tre strati a blocchi, semplicemente per eliminare una frazione di neuroni. Inoltre, A1′ indica l'uscita modificata dopo l'applicazione dello strato di dropout, da cui alcuni neuroni sono stati impostati a 0. Il principale vantaggio del suo utilizzo è semplicemente quello di prevenire il problema dell'overfitting e ridurre la co-adattazione. Inoltre, l'uscita del blocco1 A1′ viene passata al blocco successivo per estrarre ulteriori caratteristiche astratte, applicando gli stessi parametri presenti nel blocco 1, con alcune differenze: 512 neuroni nello strato denso invece di 1024 e una percentuale di dropout di 0,2 invece di 0,3; le altre sequenze operative sono identiche, come descritto nelle seguenti equazioni da 10 a 13.
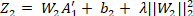 (10)
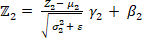 (11)
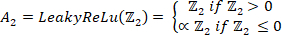 (12)
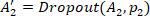 (13)
Dopo aver ottenuto l'output dal blocco 1, A1′, questo viene passato attraverso il livello denso (completamente connesso) del blocco 2 composto da 512 neuroni, in cui la matrice dei pesi W2 trasforma il vettore in ingresso A1′ in un vettore di output a 512 dimensioni, e ogni elemento del vettore di output è una combinazione lineare delle caratteristiche in ingresso. Successivamente, al vettore di bias b2 viene aggiunto ciascuno dei 512 elementi nell'output, consentendo al modello di spostare in modo indipendente l'output delle caratteristiche in ingresso. Inoltre, viene applicata anche la regolarizzazione L2, in cui: λ||W2||22 penalizza i pesi elevati, riducendo così il rischio di overfitting impedendo al modello di affidarsi eccessivamente a un particolare neurone in questo blocco specifico. Qui, W2 rappresenta la matrice dei pesi di un determinato livello della rete neurale, mentre λ è il parametro di regolarizzazione che controlla il grado di regolarizzazione applicata, impostato a 0,1. Z2 diventa la nuova rappresentazione delle caratteristiche dopo aver applicato il livello denso e la regolarizzazione L2 all'input proveniente dal blocco 1, come mostrato nell'equazione 10.
Inoltre, il layer di BatchNormalization è stato applicato alla nuova caratteristica Z2, utilizzato per accelerare il processo di addestramento, dove σ22 rappresenta la varianza all'interno del batch, mentre μ2 è la media dell'output Z2. Sebbene ε sia una costante piccola incorporata per garantire la stabilità numerica, γ è un parametro di scala apprendibile che consente al modello di modificare l'output normalizzato, e β è un parametro di spostamento apprendibile che consente al modello di traslare l'output normalizzato. Infine, dopo aver applicato il layer di BatchNormalization, mostrato nell'equazione 11, l'output normalizzato Z2 è stato elaborato dalla funzione di attivazione ReLU leaky, che ha introdotto non-linearità nella rete, come mostrato nell'equazione 12. Dove Z2 appartiene all'output del layer di BatchNormalization, che viene fornito come ingresso alla ReLU leaky per introdurre la non-linearità. Mentre, A2 indica l'output ottenuto dopo l'applicazione della non-linearità.
Infine, viene applicato un livello dropout all'uscita A2 ricevuta in ingresso dalla funzione di attivazione Leaky ReLU, come mostrato nell'equazione 13. Dove A2 è l'uscita ricevuta dall'ultima funzione di attivazione ReLU e dove p2 è la percentuale di dropout, scelta pari a 0,2 per questo blocco, al fine di disattivare una frazione di neuroni. Inoltre, A2′ indica l'uscita modificata dopo l'applicazione del livello dropout, nella quale alcuni neuroni sono stati impostati a 0. Successivamente, l'uscita del blocco 2, A2′, viene passata al terzo blocco per estrarre ulteriori caratteristiche più astratte, applicando gli stessi parametri utilizzati nel blocco 2, con alcune differenze: 256 neuroni nel livello denso anziché 512 e una percentuale di dropout pari a 0,1 anziché 0,2; le altre sequenze operative rimangono invariate, come descritto nelle equazioni seguenti da 14 a 17.
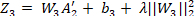 (14)
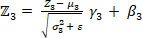 (15)
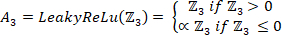 (16)
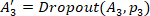 (17)
Dopo aver ottenuto l'output dal blocco 2, A2′, questo viene passato attraverso il livello denso (completamente connesso) del blocco 3 composto da 256 neuroni, dove la matrice dei pesi W3 trasforma il vettore in ingresso A2′ in un vettore di output a 256 dimensioni, e ogni elemento del vettore di output è una combinazione lineare delle caratteristiche in ingresso. Successivamente, al vettore di bias b3 viene aggiunto ciascuno dei 256 elementi nell'output, consentendo al modello di spostare in modo indipendente l'output delle caratteristiche in ingresso. Inoltre, viene applicata anche la regolarizzazione L2, in cui: λ||W3||22 penalizza i pesi elevati, scoraggiando il modello dal dipendere eccessivamente da un singolo neurone, il che aiuta a evitare l'overfitting. Qui, W3 rappresenta la matrice dei pesi di un determinato livello della rete neurale, mentre il grado di regolarizzazione impiegato è controllato dal parametro di regolarizzazione λ, impostato a 0,01. Z3 diventa la nuova rappresentazione delle caratteristiche dopo aver applicato il livello denso e la regolarizzazione L2 all'input proveniente dal blocco 3, come mostrato nell'equazione 14.
Inoltre, il layer BatchNormalization è stato applicato alla nuova caratteristica Z3, utilizzato per accelerare il processo di addestramento, dove σ32 rappresenta la varianza all'interno del batch, mentre μ3 è la media dell'uscita Z3. Mentre, ε è una piccola costante aggiunta per garantire la stabilità numerica. L'uscita normalizzata può essere regolata dal modello mediante il parametro di scala apprendibile γ3 e traslata mediante il parametro di spostamento apprendibile β3. Infine, dopo aver applicato il layer BatchNormalization, mostrato nell'equazione 15, l'uscita normalizzata Z3 viene elaborata dalla funzione di attivazione leaky ReLU, che introduce non-linearità nella rete, come mostrato nell'equazione 16. Dove Z3 appartiene all'uscita del layer BatchNormalization, che viene fornita come ingresso a Leaky ReLU per introdurre la non-linearità. Mentre, A3 indica l'uscita ottenuta dopo l'applicazione della non-linearità.
Infine, viene applicato un livello dropout all'uscita A3 ricevuta in ingresso dalla funzione di attivazione Leaky ReLU, come mostrato nell'equazione 17. Dove A3 è l'uscita ricevuta dall'ultima funzione di attivazione ReLU e dove p3 è la frequenza di dropout, scelta pari a 0,1 per questo blocco, al fine di disattivare una frazione di neuroni. Inoltre, A3′ indica l'uscita modificata dopo l'applicazione del livello dropout, nella quale alcuni neuroni sono stati impostati a 0.
Inoltre, l'output del blocco 3 A3′ viene elaborato dall'ultimo strato denso a fini di classificazione, con un numero K di neuroni che rappresenta il numero effettivo di classi nel dataset, come descritto nell'equazione 18 riportata di seguito.
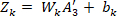 (18)
La matrice dei pesi associata allo strato denso è Wk, responsabile della trasformazione del vettore 256-dimensionale A3′ in un vettore k-dimensionale, che rappresenta le caratteristiche apprese dal blocco precedente e costituisce l'uscita. Inoltre, bk rappresenta il vettore di bias che regola la previsione per garantire che la funzione di attivazione produca un'uscita non nulla quando l'ingresso è zero, mentre Zk è l'uscita dell'ultimo strato prima dell'applicazione della funzione di attivazione e genera i logit per ciascuna classe. Infine, viene applicato un classificatore SoftMax41 che converte il logit Zk nella probabilità di ciascuna classe, come mostrato nelle equazioni 19 e 20.
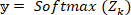 (19)
 (20)
Dove la probabilità predetta della classe iesima è rappresentata da yi, K è il numero di classi, mentre Zk, i è il logit per la classe iesima, e eZk, i è l'esponenziale del logit della classe iesima. y mostra la distribuzione di probabilità di tutte le classi possibili e garantisce che la somma delle probabilità sia pari a 1. Tabella 3 di seguito riporta i dettagli degli iperparametri utilizzati per addestrare il modello ibrido proposto, inclusi i dettagli architetturali adottati per migliorare la riproducibilità e le prestazioni.
| Parametri iper | Modello proposto (FusionNetX) |
| Dimensione dell'immagine | 224 × 224 |
| Architettura del backbone | EfficientNetB7 e DenseNet121 preaddestrati come BBA1 e BBA2 |
| Aumento dei dati | Intervallo di rotazione = 7, |
| Intervallo di spostamento in larghezza/altezza fino a 0,05, | |
| Intervallo di zoom fino a 0,01, | |
| Capovolgimento orizzontale/verticale | |
| Rapporto di suddivisione dei dati | 80% per l'addestramento e 20% per la validazione, con campionamento stratificato e randome_state fisso = 42 |
| Estrazione e fusione delle caratteristiche | Viene applicato un global average pooling sull'uscita di ciascun backbone: 2560 per BBA1 e 1024 per BBA2, fusi per ottenere 3584 vettori di caratteristiche congiunte. |
| Composizione del blocco completamente connesso | 3 blocchi completamente connessi con 1 strato di uscita. Ogni blocco contiene regolarizzazione L2 (λ=0,01), BatchNormalization, LeakyReLU (α=0,01), Dropout (0,3, 0,2 e 0,1) e dimensione nascosta (1024, 512, 256) rispettivamente. Nessuna connessione skip aggiuntiva introdotta nella testa di fusione |
| Funzione di attivazione | Leaky ReLU & SoftMax |
| Ottimizzatore e tasso di apprendimento | Adam con tasso di apprendimento fisso a 0,00001, senza scheduler del tasso di apprendimento. |
| Funzione di perdita | sparse_categorical_crossentropy |
| Dimensione del batch | 16 |
| Epoche | 100 epoche fisse per ciascun dataset |
| Piattaforma utilizzata | Kaggle Notebook dotato di GPU P100 e 16 GB di VRAM con le piattaforme TensorFlow e Keras. |
Tabella 3: Iperparametri utilizzati per addestrare il modello proposto e dettagli architetturali suggeriti. Questa tabella fornisce i dettagli strutturali e architetturali del modello proposto, insieme ai parametri ottimizzati e all'ambiente di implementazione.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Questa parte illustra i risultati dei test effettuati sul modello proposto di fusione di caratteristiche doppie su cinque dataset open source relativi ai tumori cerebrali, inclusi i dataset Br35H, Figshare, Sartaj, Masoud e Balanced Brain Tumor, e le loro prestazioni sono state valutate in base a diversi parametri statistici di valutazione delle prestazioni, tra cui accuratezza42,43,44, tasso di errore di classificazione (MCR)
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Come concluso, il modello proposto ha funzionato come segue: innanzitutto, la dimensione dell'immagine è stata impostata a 224 × 224, una dimensione moderata che consente a qualsiasi modello di apprendimento profondo di estrarre e apprendere caratteristiche adeguate dai campioni di dati mantenendo tutte le informazioni importanti; successivamente è stata eseguita l'aumentazione dei dati, utile per rendere i campioni più diversificati, aspetto fondamentale affinché il modello possa estrarre caratteristiche da diversi pian...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno nulla da dichiarare e non hanno conflitti di interessi. Inoltre, non sono stati utilizzati strumenti di intelligenza artificiale per generare il manoscritto né le figure.
Ringraziamenti
Gli autori esprimono la loro gratitudine per il sostegno fornito dal Princess Nourah bint Abdulrahman University Researchers Supporting Project (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Riyadh, Arabia Saudita. Gli autori ringraziano inoltre i partecipanti alla ricerca e le istituzioni che hanno contribuito a questo studio.
Finanziamento:
Questo lavoro è stato sostenuto da una borsa della National Research Foundation of Korea (NRF) finanziata dal governo della Corea (MSIT) (n. RS-2023-00218176) e dal fondo per la ricerca dell'Università Soonchunhyang. Progetto di sostegno ai ricercatori dell'Università Princess Nourah bint Abdulrahman numero (PNURSP2026R192), Università Princess Nourah bint Abdulrahman, Riyad, Arabia Saudita.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Dataset di tumori cerebrali Br35H | Kaggle (contribuente del dataset) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Dataset pubblico; classificazione binaria (tumore / nessun tumore) 300 immagini MRI |
| Dataset di tumori cerebrali Figshare | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Dataset pubblico; multiclasse (glioma, meningioma, tumore pituitario) 3064 immagini MRI |
| Dataset MRI per la classificazione dei tumori cerebrali di Sartaj | Kaggle (dataset di Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | Dataset pubblico; multiclasse (glioma, meningioma, nessun tumore, tumore pituitario) 3264 immagini MRI |
| Dataset MRI di tumori cerebrali di Masoud | Kaggle (dataset di Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | Dataset pubblico; multiclasse (glioma, meningioma, nessun tumore, tumore pituitario) 7023 immagini MRI |
| BBT-Dataset (Dataset di tumori cerebrali) | Kaggle (contribuente del dataset) | https://doi.org/10.34740/kaggle/dsv/6758053 | Dataset pubblico; tumore cerebrale multiclasse bilanciato, 5248 immagini MRI |
| Python | Fondazione Python | https://www.python.org | Linguaggio di programmazione, versione 3.10.13 |
| TensorFlow / Keras | Google / sviluppatori di TensorFlow | https://www.tensorflow.org | Framework di deep learning; costruzione, addestramento e valutazione del modello, versione 2.15.0 |
| EfficientNetB7 (pre-addestrato) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | Backbone pre-addestrato su ImageNet; estrazione di caratteristiche |
| DenseNet121 (pre-addestrato) | Keras Applications | https://keras.io/api/applications/densenet/ | Backbone pre-addestrato su ImageNet; estrazione di caratteristiche |
| scikit-learn | sviluppatori di scikit-learn (NumFOCUS) | https://scikit-learn.org | Codifica delle etichette, suddivisione training-test, metriche di valutazione (report di classificazione, matrice di confusione, ROC/AUC) |
| OpenCV (cv2) | Squadra OpenCV | https://opencv.org | Caricamento e ridimensionamento delle immagini |
| NumPy | sviluppatori di NumPy (NumFOCUS) | https://numpy.org | Calcolo numerico e operazioni su array |
| pandas | squadra di sviluppo di pandas (NumFOCUS) | https://pandas.pydata.org | Organizzazione dei dati e tabulazione delle metriche |
Riferimenti
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.