Questo articolo presenta un flusso di lavoro computazionale supervisionato da esseri umani per esaminare le rappresentazioni ricorrenti delle donne in 433 dipinti cinesi d'esportazione dell'epoca Qing. Sette categorie di riferimento umano e segnali visivi ricorrenti caratterizzano i modelli all'interno del corpus, mentre i risultati rimangono limitati alle immagini campionate e non misurano la realtà sociale Qing o la ricezione storica.
Articolo di ricerca
Identità femminile e immaginazione di classe nelle pitture d'esportazione cinesi della dinastia Qing: uno studio assistito dall'intelligenza artificiale sull'interpretazione interculturale
In questo articolo
Sommario
Abstract
Questo studio ha esaminato le rappresentazioni ricorrenti dell'identità femminile e degli indicatori visivi legati alla classe sociale in un corpus di 433 dipinti cinesi dell'epoca Qing destinati all'esportazione, databili tra il 1757 e il 1911. Il flusso di lavoro ha integrato CLIP ViT-B/32 per l'etichettatura preliminare, il modello Segment Anything Model (SAM) per il supporto alla localizzazione, riduzione della dimensionalità e clustering, oltre a una codifica iconografica manuale effettuata da due codificatori indipendenti. Le etichette generate da CLIP sono state utilizzate per l'organizzazione iniziale, SAM ha svolto un ruolo di ausilio nella localizzazione, mentre la codifica umana concordata ha fornito le categorie di riferimento. I risultati complessivi hanno identificato sette categorie basate sul riferimento umano: élite/bellezza (n = 112), lavoro (n = 72), ambiente domestico (n = 64), servitù (n = 58), rituali/nozze (n = 45), mercato (n = 43) e spettacolo (n = 39). Le etichette computazionali preliminari corrispondevano alle etichette di riferimento umano in 356 dei 433 dipinti (82,2%), con valori di richiamo a livello di categoria compresi tra il 73,3% e l'88,4%. Combinazioni ricorrenti di abbigliamento, ambientazione spaziale, oggetti, postura e relazioni sociali rappresentate sono state utilizzate per caratterizzare i profili visivi di queste categorie. La valutazione delle 433 coppie di etichette intelligenza artificiale–umano a livello di singolo caso ha prodotto punteggi completi di precisione, richiamo e F1 a livello di categoria, insieme a una matrice di confusione che illustra i modelli di classificazione. La validazione dei cluster ha confermato la soluzione di clustering selezionata e dimostrato una corrispondenza tra i cluster ottenuti e le categorie di riferimento definite dagli esseri umani. Nel complesso, le combinazioni ricorrenti di abbigliamento, ambientazione spaziale, oggetti, postura e relazioni sociali indicano tipologie figurative strutturate all'interno del corpus analizzato. Questi risultati descrivono la rappresentazione visiva nei dipinti cinesi dell'epoca Qing destinati all'esportazione, ma non devono essere interpretati come misure dirette dello status legale, dell'esperienza vissuta, della domanda di mercato o della ricezione storica da parte degli stranieri.
Introduzione
I dipinti cinesi di esportazione della dinastia Qing facevano parte delle reti commerciali e culturali che collegavano Canton e altri centri collezionistici con acquirenti euroamericani a partire dalla fine del diciottesimo secolo1,2,3,4,5. Mercanti, viaggiatori, diplomatici, missionari e collezionisti acquisirono questi dipinti come beni portatili, souvenir, fonti di informazione visiva e rappresentazioni di luoghi, occupazioni, processi produttivi, usanze e tipi sociali. La loro circolazione, pertanto, rifletteva sia le pratiche delle botteghe cinesi sia le aspettative dei mercati esterni.
La domanda estera favoriva soggetti riconoscibili, formati seriali, motivi ripetuti e scene che potevano essere raccolte e confrontate. I laboratori adattavano il supporto, le dimensioni, la composizione e il soggetto in funzione della vendita, mentre gli acquirenti spesso preferivano rappresentazioni chiare di mestieri, cerimonie, interni, giardini, strade e tipi sociali pittoreschi. Le versioni ripetute di scene provenienti dai laboratori di Canton dimostrano ulteriormente come artisti e assistenti adattassero l'iconografia e le tecniche pittoriche occidentali per i committenti d'oltreoceano1,2,3,4,5. Sebbene la domanda di mercato possa aver influenzato ciò che veniva prodotto e conservato, l'attuale corpus non misura direttamente le preferenze o le reazioni dei singoli acquirenti.
Questi dipinti dovrebbero pertanto essere considerati fonti selettive e mediate, piuttosto che registrazioni complete della vita quotidiana. Le loro scene possono idealizzare, semplificare, standardizzare o adattare le pratiche sociali attraverso convenzioni delle botteghe artistiche, selezione del mercato, acquisizione da parte dei musei, catalogazione e digitalizzazione1,2,3,4,5. L'interpretazione storica deve distinguere le caratteristiche direttamente osservabili nei dipinti dalle inferenze riguardanti gli individui rappresentati, le condizioni di produzione e i significati attribuiti alle opere da parte degli osservatori successivi.
Le figure femminili offrono un mezzo mirato per esaminare questa distinzione. Abbigliamento, acconciatura, postura, ambientazione spaziale, oggetti, attività e rapporti con altre figure possono organizzare le donne in ruoli visivamente ricorrenti, tra cui categorie di élite/bellezza, domestiche, servitù, lavoro manuale, mercato, spettacolo, e rituali/nozze. Queste categorie sono descrizioni analitiche di schemi figurativi e non stabiliscono, di per sé, rango legale, ricchezza, occupazione, etnia, affiliazione Banner o Han, carattere morale o identità vissuta.
La storia dell'arte digitale e la visione artificiale possono facilitare confronti su larga scala di collezioni visive digitalizzate, consentendo al contempo un'analisi critica delle assunzioni incorporate nei modelli computazionali6,7. I modelli visione–linguaggio possono aiutare nell'identificare e organizzare motivi visivi ricorrenti, sebbene il pregiudizio culturale rimanga una limitazione importante quando i vocabolari dei modelli contemporanei vengono applicati a immagini storiche non occidentali8. Ricerche computazionali correlate sulla pittura tradizionale cinese dimostrano in modo simile il valore di combinare il rilevamento quantitativo di schemi con un'interpretazione informata dal contesto storico9.
Questo studio affronta tre domande: (1) Quali categorie di identità femminile codificate manualmente sono rappresentate nel corpus? (2) Quali combinazioni di abbigliamento, ambientazione spaziale, oggetti, postura e relazioni sociali caratterizzano queste categorie? (3) In che modo l'accuratezza complessiva nel riscontro esatto e il richiamo a livello di categoria variano tra le sette categorie? Il flusso di lavoro si basa su approcci computazionali applicati alla pittura tradizionale cinese9, limitando al contempo le sue affermazioni storiche alle immagini campionate e alle analisi documentate.
Il contributo previsto è sia storiografico che tecnico. Il confronto su scala di corpus può identificare formule pittoriche ricorrenti che successivamente possono essere contestualizzate attraverso un'analisi storica approfondita. Questo approccio può orientare la ricerca su genere, gerarchia, rappresentazioni della vita quotidiana e incontri interculturali, senza considerare la frequenza delle immagini come prova della prevalenza sociale o la somiglianza visiva come dimostrazione dell'identità storica.
Protocollo
Disegno dello studio e unità analitica
Ogni dipinto o scheda catalografica è stato considerato come un'unità analitica. È stato adottato un disegno osservazionale basato su corpus, che combina la revisione dei metadati, un'organizzazione computazionale preliminare, una codifica manuale indipendente e un'interpretazione di tipo storico-artististico. Il periodo dello studio è stato definito tra il 1757 e il 1911, e i criteri di inclusione ed esclusione sono stati applicati all'interno di questo arco temporale. Sono state analizzate opere d'arte storiche e i relativi metadati catalografici. Quando sono state confrontate distribuzioni su intervalli di tempo di durata disuguale, i conteggi sono stati normalizzati in base alla durata degli intervalli, tenendo conto, nell'interpretazione, di eventuali bias di sopravvivenza e di acquisizione.
Costruzione e selezione del corpus
I record candidati sono stati recuperati dai cataloghi museali citati, dagli archivi digitali e dai cataloghi pubblicati. Per ciascun record candidato sono stati conservati l'istituzione, il titolo, la data o l'intervallo di date, il supporto, il numero di accessione o di catalogo, l'URL stabile della fonte, la data di recupero e l'indicazione sui diritti. I collegamenti alle fonti sono stati mantenuti anche quando il file immagine corrispondente non poteva essere legalmente ridistribuito. La procedura di screening descritta ha avuto inizio con 612 immagini candidate. Di queste, 85 sono state escluse perché al di fuori del periodo 1757–1911 o della tradizione delle pitture per l'esportazione, 58 sono state escluse perché riproduzioni moderne, record sfocati o raffiguranti soggetti errati, 29 sono state escluse perché prive di una figura femminile identificabile o di risoluzione d'immagine adeguata, e 7 sono state escluse per mancanza di metadati sufficienti. Il corpus analitico finale comprendeva 433 record.
Standardizzazione dei metadati e preelaborazione delle immagini
A ciascun dipinto del corpus analitico finale è stato assegnato un identificatore QEP stabile compreso tra QEP_001 e QEP_433. Sono stati conservati i metadati museali associati, inclusi istituzione, numero di inventario, titolo, data, tecnica o materiali, luogo di origine, link alla fonte e descrizione catalografica disponibile. Per l'analisi visiva, sono stati registrati l'etichetta preliminare dell'IA, la categoria umana definitiva, il numero di figure femminili, il gruppo d'età, la postura, l'abbigliamento, l'ambientazione spaziale, gli oggetti associati e le relazioni sociali. Ciascun dipinto è stato classificato in una delle sette categorie principali: élite/bellezza, domestico, servitore, lavoro, mercato, spettacolo o rituale/nozze. Per le scene contenenti più figure femminili, la figura principale è stata identificata in base alla rilevanza visiva e al ruolo centrale nella narrazione. Quando nessuna figura femminile risultava dominante, la categoria principale è stata assegnata in base all'attività principale rappresentata e al contesto generale della scena. Le categorie sovrapposte sono state risolte privilegiando l'attività rappresentata e il contesto della scena rispetto all'abbigliamento o all'aspetto. I casi ambigui sono stati esaminati indipendentemente da entrambi i codificatori e risolti mediante consenso. Le immagini originali sono state salvate in formato JPEG o PNG. Sono stati ritagliati soltanto i bordi della pagina web, le cornici del catalogo o i margini non pertinenti all'immagine. I contenuti dipinti non sono stati ricostruiti, ricolorati, migliorati o restaurati.
Etichettatura preliminare basata su CLIP
L'encoder di immagini CLIP ViT-B/32 è stato utilizzato per l'analisi preliminare della similarità immagine-testo9. I termini candidati relativi all'identità includevano donna dell'élite, donna domestica, domestica, donna lavoratrice, venditrice del mercato, donna performer, sposa e donna rituale. I termini relativi alla scena includevano interno cinese, giardino, mercato di strada, laboratorio artigianale, produzione del tè, lavorazione tessile e scena cerimoniale. Per ogni immagine è stato mantenuto l'insieme completo dei modelli di prompt, il loro ordine, qualsiasi combinazione di prompt, le procedure di normalizzazione del testo, le regole decisionali, i punteggi di confidenza e i casi di parità.
L'elenco completo di prompt è stato applicato in modo coerente a tutte le immagini utilizzando il modello OpenAI CLIP ViT-B/32 implementato in Python 3.10 con PyTorch 2.0.1 e il pacchetto OpenAI CLIP. L'inferenza è stata eseguita su una GPU abilitata CUDA con una dimensione del batch di 32 utilizzando precisione FP32. Ogni immagine è stata ridimensionata e ritagliata al centro a 224 × 224 pixel, e i canali RGB sono stati normalizzati utilizzando la trasformazione di pre-elaborazione associata al modello ViT-B/32. I prompt testuali sono stati costruiti utilizzando i descrittori di identità e di scena definiti in precedenza e codificati con l'encoder testuale di CLIP. È stata calcolata la similarità coseno tra gli embedding normalizzati di immagine e testo, e il prompt con il punteggio di similarità più alto è stato assegnato come etichetta preliminare dell'IA. I punteggi di similarità per tutte le etichette candidate sono stati conservati per un successivo controllo umano. È stato utilizzato un seme casuale fisso pari a 42, e procedure di pre-elaborazione, modelli di prompt e regole decisionali identiche sono state applicate a tutti e 433 i dipinti.
Localizzazione assistita da SAM
Il Segment Anything Model (SAM) è stato utilizzato esclusivamente per localizzare figure, abiti, mobili, strumenti, oggetti rituali e aree architettoniche a fini di ispezione visiva umana. È fondamentale sottolineare che SAM non ha partecipato al processo di classificazione; le sue maschere, ritagli e caratteristiche derivate sono state isolate dai processi di etichettatura e clustering di CLIP, garantendo che l'applicazione di SAM fornisse soltanto supporto alla localizzazione senza influenzare né sovrastimare le prestazioni di classificazione.
Sono stati applicati manualmente punti di riferimento o box delimitatori, quando necessario, per affinare la localizzazione degli elementi visivi. Le maschere SAM sono state generate per figure femminili, capi d'abbigliamento, mobili, strumenti, oggetti rituali ed elementi architettonici, e ogni risultato di segmentazione è stato ispezionato visivamente per verificare un'adeguata copertura regionale. Le maschere risultanti hanno supportato l'identificazione e la revisione delle caratteristiche iconografiche rilevanti, ma non sono state utilizzate per l'etichettatura CLIP o l'assegnazione di categorie.
Riduzione della dimensionalità e clustering
Sono stati calcolati gli embedding delle immagini CLIP ed è stato utilizzato UMAP con distanza coseno per la visualizzazione in due dimensioni10. È stata registrata la rappresentazione utilizzata per il clustering, insieme alla sua procedura di pre-elaborazione, dimensionalità e definizione della distanza.
Sono stati applicati il K-means e il clustering gerarchico alle rappresentazioni basate sulle caratteristiche delle immagini per identificare raggruppamenti visivi ricorrenti all'interno del corpus11. Le soluzioni candidate del K-means per k = 5–9 sono state valutate utilizzando il coefficiente di siluetta e l'indice di Davies–Bouldin. È stata utilizzata l'inizializzazione K-means++ con n_init = 10, max_iter = 300, tol = 1 × 10⁻4 e random_state = 42. Il clustering gerarchico è stato eseguito mediante clustering agglomerativo con collegamento medio (average linkage) e distanza coseno. Le soluzioni candidate sono state confrontate utilizzando indici di validazione quantitativi, stabilità dei cluster e interpretabilità dal punto di vista storico-artistico, e la soluzione finale dei cluster è stata selezionata in base alla rappresentazione più coerente dei modelli visivi ricorrenti. L'assegnazione finale dei cluster per ciascuno dei 433 dipinti è stata mantenuta per successivi confronti con le categorie codificate manualmente.
Codifica manuale, formazione e arbitrato
Due codificatori hanno esaminato indipendentemente tutte le 433 immagini utilizzando un manuale di codifica versionato che copriva la categoria principale, il numero di figure, il gruppo di età, la postura, l'abbigliamento, l'ambiente spaziale, gli oggetti e le relazioni sociali. I record specifici per ciascun codificatore sono stati conservati prima dell'arbitrato. I codificatori avevano competenze pertinenti in storia dell'arte e analisi visiva ed erano stati formati mediante il manuale di codifica standardizzato ed esempi rappresentativi dal corpus di dipinti. Prima della codifica formale, hanno completato un'esercitazione di calibrazione che includeva 30 dipinti, volta a favorire un'interpretazione coerente delle sette categorie identitarie e delle cinque dimensioni degli indicatori visivi.
Durante la codifica formale, entrambi i codificatori hanno valutato in modo indipendente tutti i dipinti idonei, rimanendo ciechi rispetto alle decisioni di codifica dell'altro, alle etichette preliminari dell'IA e alle assegnazioni dei cluster. L'affidabilità tra i codificatori è stata valutata utilizzando il kappa di Cohen. Il valore osservato di kappa per la categoria di identità principale è stato 0,88, mentre le variabili categoriali relative ai suggerimenti visivi sono comprese tra 0,79 e 0,92, dimostrando un elevato accordo tra i codificatori. I disaccordi sono stati risolti attraverso discussione e consenso, e le categorie adjudicate e i codici relativi ai suggerimenti visivi sono stati registrati per le analisi successive12. Le etichette pre-adjudicazione sono state mantenute.
Accordo tra intelligenza artificiale e valutazione umana e stima delle prestazioni
La categoria umana definitiva è stata utilizzata come riferimento per il confronto descrittivo con un'etichetta preliminare dell'intelligenza artificiale per ogni dipinto. L'accuratezza complessiva nel riscontro esatto è stata calcolata come 356/433 (82,2%). Il richiamo per categoria è stato calcolato come il numero di corrispondenze esatte tra intelligenza artificiale e valutazione umana diviso per il supporto della categoria secondo il riferimento umano. Il supporto per categoria, le corrispondenze esatte, gli errori e i relativi denominatori sono stati riportati esplicitamente.
Sulla base delle 433 etichette abbinate a livello di caso generate dall'intelligenza artificiale e dall'uomo, sono stati calcolati i falsi positivi per classe target, nonché la precisione, il richiamo e i punteggi F1 per categoria. È stata costruita una matrice di confusione completa per analizzare i modelli di classificazione fuori dalla diagonale, i quali hanno successivamente guidato la revisione delle discrepanze, la documentazione della tassonomia degli errori e le regole di risoluzione.
Pacchetto e materiali per la riproducibilità
Il flusso di lavoro computazionale e i materiali di ricerca a supporto sono stati organizzati in un archivio controllato per versione. Il pacchetto per la riproducibilità è stato progettato per includere script per la pre-elaborazione, l'analisi CLIP, la localizzazione SAM, l'UMAP, il clustering, l'analisi dell'accordo e la generazione di figure, insieme al codice di codifica manuale, ai file di configurazione, alle informazioni sulle dipendenze, agli output derivati a livello di caso e a un inventario in formato leggibile da macchina delle fonti delle immagini e delle informazioni sui diritti. È stato assegnato un identificatore persistente ai materiali di ricerca archiviati per facilitare la riproducibilità e il riutilizzo.
Microsoft Excel 2021 è stato utilizzato per organizzare e gestire i metadati. Le analisi computazionali hanno impiegato CLIP ViT-B/32 per l'etichettatura preliminare visione–linguaggio, SAM per la localizzazione degli elementi visivi, UMAP con distanza del coseno per la riduzione della dimensionalità, e clustering k-means e gerarchico per l'analisi esplorativa dei pattern. Le soluzioni di clustering sono state valutate mediante il coefficiente di siluetta e l'indice di Davies–Bouldin, mentre l'accordo tra codificatori è stato verificato utilizzando la kappa di Cohen. L'ambiente software, le configurazioni dei modelli, le impostazioni computazionali e i valori di partenza casuali utilizzati nell'intero flusso di lavoro sono stati documentati per garantire la riproducibilità.
Risultati
Costruzione del corpus e composizione descrittiva
Figura 1 presenta una panoramica in quattro parti del corpus. Figura 1A mostra il processo di selezione riportato, che passa da 612 record candidati a 433 record conservati. Figura 1B mostra esempi rappresentativi di media e formati. Figura 1C presenta i conteggi suddivisi in quattro intervalli temporali, e Figura 1D riassume la composizione del corpus per fonte e tipo di supporto. Poiché gli intervalli temporali coprono periodi di durata disuguale, questi conteggi descrivono la composizione del corpus campionato e non devono essere interpretati come tassi storici di produzione.
Tabella 1 riassume le caratteristiche aggregate del corpus. Le collezioni museali comprendevano 302 record, gli archivi digitali 81 e i cataloghi pubblicati 50. I supporti sono stati classificati come acquerello da esportazione (n = 176), dipinti su carta di pith (n = 112), fogli da album da esportazione (n = 83), dipinti di figure (n = 41) e altri formati (n = 21). I metadati sono stati classificati come completi (n = 288), parziali (n = 118) o minimi (n = 27). Le figure femminili sono state classificate come centrali (n = 214), secondarie (n = 102) o multiple (n = 117). Ogni blocco di classificazione comprendeva tutti e 433 i record.
Etichette preliminari dell'IA e categorie di riferimento umano
Tabella 2 riassume l'accordo complessivo tra le etichette preliminari generate dall'IA e le categorie di riferimento umane per i 433 dipinti, mentre Tabella supplementare 1 fornisce le corrispondenti etichette preliminari basate su intelligenza artificiale a livello di singolo caso, le classificazioni degli annotatori, le categorie di riferimento umane definitive, lo stato di corrispondenza e gli assegnamenti ai cluster. In generale, le etichette attribuite dall'intelligenza artificiale e quelle di riferimento umano hanno coinciso per 356 dipinti, corrispondenti a un'accuratezza di corrispondenza esatta dell'82,2%. Il richiamo a livello di categoria è stato calcolato come la proporzione di corrispondenze esatte tra intelligenza artificiale e riferimento umano rispetto al supporto di riferimento umano per ciascuna categoria.
Il richiamo a livello di categoria è variato dal 73,3% per scene rituali/matrimoniali (33/45) all'88,4% per élite/bellezza (99/112). Il richiamo è stato dell'84,7% per lavoro manuale (61/72), dell'82,1% per spettacolo (32/39), del 79,7% per ambiente domestico (51/64), del 79,3% per servitore (46/58) e del 79,1% per mercato (34/43). Nel complesso, l'accordo esatto è stato di 356/433 (82,2%). La valutazione delle coppie a livello di caso ha permesso il calcolo della precisione e dei punteggi F1 per tutte e sette le categorie, con valori compresi tra il 74,5% e l'89,2% per la precisione e tra 0,75 e 0,88 per i punteggi F1. Una matrice di confusione completa, che illustra i falsi positivi per classe target e i modelli fuori dalla diagonale, è riportata nella Supplementary Figure 1.
Riepiloghi dei modelli computazionali riportati
Figura 2 presenta quattro visualizzazioni di analisi computazionali riportate. Figura 2A mostra una galleria di nove dipinti con sovrapposizioni di segmentazione colorate utilizzate per la localizzazione visiva e la revisione. Figura 2B mostra un grafico a dispersione UMAP degli embedding di immagini CLIP riportati, con contorni di densità etichettati da C1 a C7. Figura 2C confronta il numero di dipinti riportati (punti pieni) con il richiamo a livello di categoria (cerchi vuoti), e Figura 2D presenta una galleria di dipinti rappresentativi raggruppati secondo le stesse etichette. La validazione dei cluster ha supportato la soluzione di clustering selezionata, che ha prodotto un punteggio di siluetta di 0,54 e un indice di Davies-Bouldin di 0,92. L'associazione tra cluster e categorie umane ha dimostrato un forte allineamento, con ciascun cluster derivato che corrispondeva prevalentemente a una categoria di riferimento distinta.
Tabella 3 presenta sette profili computazionali riportati con dimensioni campionarie corrispondenti ai sette supporti delle categorie di riferimento umano. La tabella di contingenza cluster-per-categoria è fornita nella Tabella Supplementare 2 e mostra la distribuzione delle sette categorie di riferimento umano valutate tra i cluster C1–C7. L'analisi di questi assegnamenti di cluster a livello di singolo caso ha dimostrato che il raggruppamento computazionale ha recuperato strutture visive che corrispondevano strettamente alle sette categorie di riferimento umano.
Associazioni basate sui segnali visivi e sintesi interpretativa
Tabella 4 riassume i profili qualitativi dei segnali visivi utilizzati per caratterizzare le sette categorie codificate manualmente. Questi profili descrivono associazioni ricorrenti tra abbigliamento, contesto spaziale, postura, oggetti e relazioni sociali. Tali profili non sono stati ottenuti da una tabulazione incrociata quantitativa e pertanto non stabiliscono status legale, etnia, causalità sociale né ricezione da parte del pubblico.
Figura 3 integra sintesi quantitative descrittive delle caratteristiche visive codificate con un modello concettuale interpretativo. Figura 3A presenta le sette categorie di riferimento umano valutate e le relative dimensioni campionarie. Figura 3B mostra le associazioni relative tra queste categorie e i marcatori visivi codificati lungo cinque dimensioni: abbigliamento, contesto spaziale, oggetti, postura e relazioni sociali. Le intensità delle associazioni visualizzate sono state calcolate a partire dalle annotazioni a livello di singolo caso all'interno di ciascuna categoria di riferimento umano. Figura 3C riassume le relazioni tra categorie di riferimento umano, dimensioni di marcatura visiva e archetipi di implicazione categoriale, utilizzando flussi ponderati derivati dalle osservazioni codificate. Queste relazioni quantitative descrivono schemi rappresentativi ricorrenti all'interno dei dipinti campionati e non devono essere interpretate come stime di distribuzioni demografiche o sociali storiche. Figura 3D presenta un modello interpretativo interculturale e deve essere compreso come un quadro interpretativo informato dal contesto storico, piuttosto che come un percorso causale sottoposto a verifica empirica.
Interpretazione integrata dei modelli visivi
Nell'intero corpus, le sette categorie di identità femminile si sono caratterizzate per combinazioni ricorrenti di abbigliamento, ambientazione spaziale, oggetti, postura e relazioni sociali. Queste combinazioni hanno fornito evidenze descrittive di convenzioni visive strutturate nei dipinti analizzati. Le interpretazioni storiche relative al genere, alla gerarchia e alla mediazione interculturale sono rimaste di carattere inferenziale.
Nel complesso, i risultati aggregati hanno identificato sette categorie di identità femminile di riferimento umano e cinque dimensioni ricorrenti utilizzate per caratterizzarle: abbigliamento, contesto spaziale, oggetti, postura e relazioni sociali. Le etichette preliminari dell'IA corrispondevano alle categorie umane concordate in 356 su 433 dipinti (82,2%), con il valore più basso di richiamo a livello di categoria osservato per le scene rituali/nuziali (73,3%). Questi risultati hanno sostenuto l'organizzazione descrittiva e il confronto del corpus. Le etichette caso-per-caso di IA e umane hanno permesso stime della precisione e dell'F1 a livello di categoria. In modo indipendente, l'analisi dei cluster ha identificato strutture corrispondenti alle sette categorie di riferimento umano. Tuttavia, questi risultati computazionali descrivono convenzioni di rappresentazione visiva piuttosto che stabilire affermazioni causali sulla realtà sociale storica o sulla ricezione da parte del pubblico.
DISPONIBILITÀ DEI DATI:
I dati a supporto di questo studio, inclusi metadati, informazioni sulle fonti e registrazioni di screening, sono disponibili su Zenodo all'indirizzo https://doi.org/10.5281/zenodo.21130291.
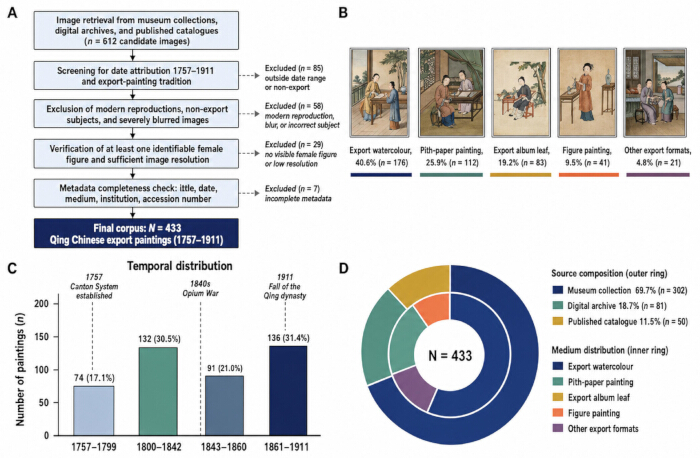
Figura 1: Costruzione del corpus e composizione descrittiva del campione di 433 dipinti. (A) Selezione sequenziale di 612 immagini candidate, che ha portato a 433 dipinti idonei. Le esclusioni comprendevano dipinti al di fuori del periodo di studio o della tradizione dei dipinti di esportazione (n = 85), riproduzioni moderne, immagini sfocate o soggetti errati (n = 58), immagini senza una figura femminile identificabile o con risoluzione inadeguata (n = 29) e record con metadati insufficienti (n = 7). (B) Esempi rappresentativi di cinque supporti e formati: acquerello di esportazione (40,6%, n = 176), dipinto su carta di midollo di pith (25,9%, n = 112), foglio d'album di esportazione (19,2%, n = 83), dipinto di figura (9,5%, n = 41) e altri formati di esportazione (4,8%, n = 21). (C) Distribuzione dei dipinti campionati in quattro intervalli cronologici. (D) Distribuzione delle fonti delle collezioni (anello esterno) e dei supporti/formati (anello interno). Le percentuali si basano sul campione totale (N = 433) e sono arrotondate a una cifra decimale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
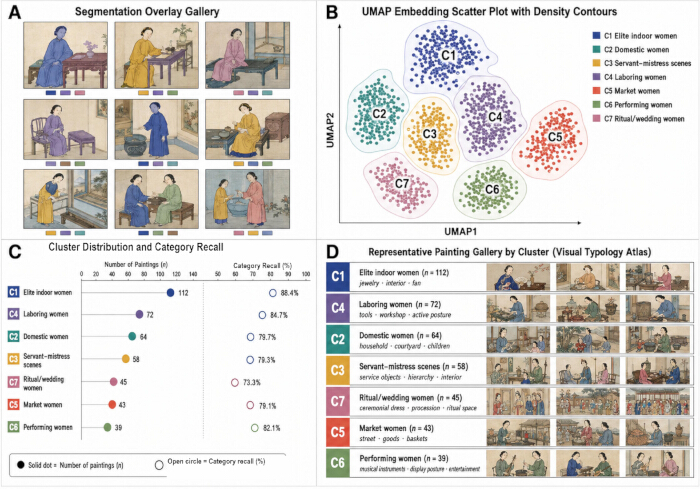
Figura 2: Segmentazione riportata, visualizzazione dell'incorporamento, distribuzione dei cluster, richiamo delle categorie e dipinti rappresentativi. (A) Galleria di nove dipinti con sovrapposizioni di segmentazione colorate utilizzate per localizzare figure o elementi visivi da esaminare. (B) Grafico a dispersione UMAP degli incorporamenti immagine CLIP riportati, con contorni di densità ed etichette C1–C7. (C) Numero riportato di dipinti (punti pieni, asse superiore) e richiamo delle categorie (cerchi vuoti, asse inferiore); il richiamo delle categorie corrisponde al numero di corrispondenze esatte diviso per il supporto di riferimento umano. Non vengono mostrati intervalli di confidenza né barre di errore. (D) Galleria di dipinti rappresentativi raggruppati in base alle etichette C1–C7, con immagini selezionate in base alla loro vicinanza ai rispettivi centroidi dei cluster. Abbreviazioni: AI = intelligenza artificiale; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = etichette riportate 1–7. Cliccare qui per visualizzare una versione ingrandita di questa figura.
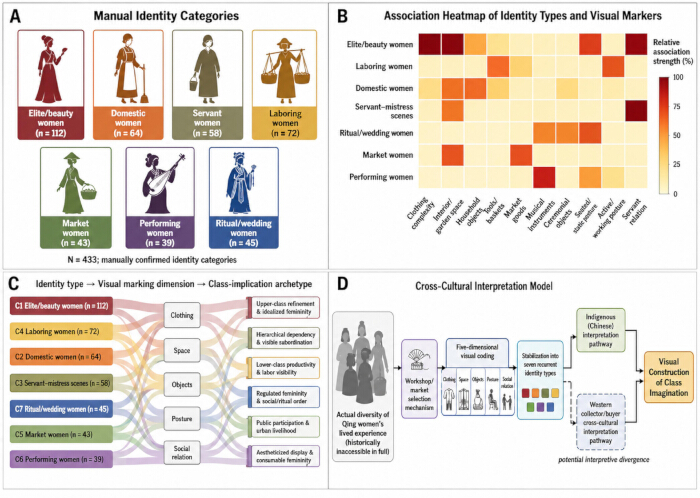
Figura 3: Associazioni basate su indizi visivi e modello interpretativo interculturale. (A) Sette categorie di identità femminile di riferimento umano valutate e le rispettive dimensioni campionarie all'interno del corpus di 433 dipinti. (B) Mappa termica delle associazioni che mostra l'intensità relativa delle relazioni tra le sette categorie di riferimento umano e i marcatori visivi codificati relativi a abbigliamento, contesto spaziale, oggetti, postura e relazioni sociali. Le intensità delle associazioni sono state ricavate dalle annotazioni a livello di singolo caso all'interno di ciascuna categoria. (C) Rappresentazione a flusso (alluvial) che riassume le relazioni ponderate tra categorie di riferimento umano, dimensioni dei marcatori visivi e archetipi implicati per classe, basate sulle osservazioni codificate. (D) Modello concettuale di interpretazione interculturale che collega le attività raffigurate, la selezione di botteghe e mercati, la codifica visiva in cinque dimensioni, i tipi ricorrenti di identità e i possibili percorsi interpretativi. Cliccare qui per visualizzare una versione ingrandita di questa figura.
Tabella 1: Caratteristiche del corpus e completezza dei metadati (N = 433). Le frequenze e le percentuali riassumono sei blocchi distinti: intervallo temporale, fonte, supporto o formato, completezza dei metadati, rappresentazione di figure femminili e tipo di scena. Ogni blocco utilizza N = 433 come denominatore e ha un totale di 433; le percentuali rappresentano proporzioni all'interno di ciascun blocco del corpus, arrotondate a una cifra decimale. Cliccare qui per scaricare il file.
Tabella 2: Etichette preliminari dell'IA e categorie di riferimento umano (N = 433). Il supporto rappresenta il numero di dipinti assegnati a ciascuna categoria di riferimento umano. Le corrispondenze esatte indicano i dipinti per cui l'etichetta preliminare generata dall'IA corrispondeva alla categoria di riferimento umano. Il richiamo a livello di categoria è calcolato come il numero di corrispondenze esatte diviso per il numero di supporti di riferimento umano. Cliccare qui per scaricare il file.
Tabella 3: Sintesi del profilo computazionale riportato. C1–C7 riproducono le dimensioni dei profili validati e le etichette dominanti. L'integrazione delle assegnazioni di cluster a livello di singolo caso e della tabella di contingenza cluster-per-categoria conferma che il clustering non supervisionato ha efficacemente catturato le strutture visive corrispondenti alle sette categorie di riferimento umano. Cliccare qui per scaricare il file.
Tabella 4: Profili qualitativi delle categorie di identità femminile e dei segnali visivi correlati alla classe. Le frequenze e le percentuali riassumono le categorie di riferimento umane, mentre l'abbigliamento, lo spazio, gli oggetti, la postura e le relazioni sociali caratterizzano i profili visivi ricorrenti associati a ciascuna categoria. Le interpretazioni relative alla classe rappresentano letture iconografiche di modelli pittorici piuttosto che misurazioni dirette dello status sociale storico. Cliccare qui per scaricare il file.
Figura supplementare 1: Matrice di confusione che confronta le etichette preliminari dell'IA con le categorie di riferimento umane per il corpus di 433 dipinti. Le righe rappresentano le categorie di riferimento umane (etichette reali) e le colonne rappresentano le categorie preliminari generate da CLIP (etichette previste). I valori delle celle indicano il numero di dipinti per ciascuna combinazione di etichette tra IA e umano. Le celle sulla diagonale rappresentano corrispondenze esatte tra IA e umano, con il relativo richiamo a livello di categoria mostrato come percentuale. Le celle fuori dalla diagonale rappresentano discrepanze tra la classificazione preliminare dell'IA e la categoria di riferimento umana. L'accuratezza complessiva per corrispondenza esatta è stata dell'82,2% (356/433). Cliccare qui per scaricare questo file.
Tabella supplementare 1: Confronto a livello di singolo caso tra le etichette preliminari dell'IA, le categorie di riferimento umane concordate e le assegnazioni dei cluster UMAP. Ogni riga rappresenta uno dei 433 dipinti cinesi di epoca Qing esportati inclusi nel corpus analitico. La tabella riporta l'identificatore immagine QEP stabile, l'etichetta preliminare CLIP ViT-B/32, le classificazioni indipendenti del Codificatore Umano 1 e del Codificatore Umano 2, la categoria di riferimento umana concordata, lo stato di corrispondenza tra IA e valutazione umana e l'assegnazione al cluster UMAP. "Corrispondenza esatta" indica accordo tra l'etichetta preliminare dell'IA e la categoria di riferimento umana concordata; "Discordanza" indica disaccordo. La categoria umana concordata è stata utilizzata come classificazione di riferimento per le analisi di accordo tra IA e valutazione umana. Cliccare qui per scaricare il file.
Tabella supplementare 2: Tabella di contingenza delle categorie di riferimento umano e delle assegnazioni dei cluster computazionali. Le righe rappresentano le sette categorie di riferimento umano stabilite tramite valutazione congiunta, e le colonne rappresentano i cluster C1–C7 ottenuti dall'analisi di clustering computazionale. I valori delle celle indicano il numero di dipinti assegnati a ciascuna combinazione categoria-cluster. Il supporto totale rappresenta il numero di dipinti in ciascuna categoria di riferimento umano. La concentrazione delle osservazioni attraverso le combinazioni categoria-cluster fornisce una valutazione descrittiva della corrispondenza tra i cluster computazionali derivati in modo indipendente e le categorie di riferimento umano stabilite tramite valutazione congiunta. Cliccare qui per scaricare il file.
Discussione
Nei riassunti aggregati forniti, 433 record sono stati organizzati in sette categorie di riferimento umano e descritti attraverso cinque famiglie di segnali visivi. La categoria elite/bellezza era la più ampia (112 su 433), e 356 etichette preliminari corrispondevano al riferimento umano riportato (82,2%). Queste sono osservazioni del corpus. Esse supportano lo studio di formule ricorrenti nelle immagini, ma non l'affermazione più forte secondo cui tali formule riproducono fedelmente la società Qing o hanno causato una particolare reazione tra il pubblico straniero13.
Il discorso prescrittivo sul genere, la posizione all'interno dell'ambiente domestico, il lavoro e la legge Qing hanno plasmato la vita delle donne senza determinarla in modo uniforme. Gli studi sulle donne dell'Alto Qing documentano la loro partecipazione al lavoro, alla scrittura, ai rituali, alla religione e allo svago, accanto ai regimi familiari e di castità prescrittivi. Gli Otto Stendardi formavano un gruppo ereditario e multietnico definito da leggi e pratiche amministrative; pertanto, l'appartenenza agli Stendardi non dovrebbe essere automaticamente equiparata all'etnia manciù14,15,16,17. In questo studio, l'abbigliamento, la postura, gli oggetti e l'ambientazione sono indizi figurativi piuttosto che prove di rango legale, affiliazione Stendardo/Cinese, etnia, conformità morale o identità vissuta. Sarebbero necessarie evidenze archivistiche e giuridiche per sostenere tali affermazioni.
I risultati computazionali richiedono anche un'adeguata cautela culturale e tecnica. I modelli generali di visione e linguaggio non dovrebbero essere considerati culturalmente neutri. I risultati pubblicati su CulturalVQA mostrano prestazioni disomogenee tra diverse regioni e sfaccettature culturali, ma tale benchmark non ha valutato CLIP ViT-B/32 né ha utilizzato opere d'arte storiche dell'Asia orientale8,18,19. Esso pertanto giustifica, piuttosto che sostituire, un benchmark appositamente progettato per questo corpus. Fino a quando un tale esperimento non sarà disponibile, CLIP rappresenta un ausilio preliminare per l'organizzazione dei dati, non un'autorità sull'identità o la gerarchia qing. La pipeline computazionale ha confermato che SAM ha funzionato esclusivamente come evidenza ausiliaria di localizzazione; nessuna maschera né caratteristiche derivate dalle maschere sono state utilizzate come input per l'etichettatura o il clustering, garantendo che la categorizzazione visiva si basasse unicamente sugli embedding semantici globali delle immagini non segmentate. La ricerca nel campo del patrimonio digitale sottolinea inoltre l'importanza della sensibilità culturale, della supervisione interdisciplinare, dell'accessibilità, della protezione dei dati e di flussi di lavoro trasparenti20.
Storicamente, la rilevanza dei motivi risiede nel commercio delle pitture d'esportazione: laboratori cinesi e domanda straniera selezionarono e standardizzarono soggetti trasportabili, comprensibili e collezionabili; le immagini ripetute nei laboratori dimostrano inoltre una copia con variazioni piuttosto che una duplicazione puramente meccanica1,2,3,4,5. Il corpus può quindi contribuire alle storie del genere, della gerarchia, delle immagini della vita quotidiana e degli incontri interculturali mostrando quali formule si ripetono su larga scala. Tuttavia, non dimostra che le immagini siano registrazioni etnografiche complete. Il confronto computazionale può guidare la lettura approfondita e la contestualizzazione interculturale21, mentre i documenti sulla produzione, le cronologie degli acquisti e le prove di ricezione dovranno sostenere affermazioni riguardo alle intenzioni di mercato o al significato per il pubblico.
La risposta affettiva e cognitiva rimane un ulteriore indirizzo di ricerca piuttosto che un risultato del presente studio. Shi e colleghi hanno combinato valutazioni di preferenza, analisi su dimensioni latenti e il tracciamento oculare per distinguere i percorsi emotivi, formali-estetici e cognitivi nelle risposte alle immagini delle lanterne a puntino di Xiashi22. Un disegno comparabile potrebbe verificare se gli osservatori prestano attenzione in modo diverso a vestiti, oggetti, posture o gerarchie nei dipinti destinati all'esportazione. Poiché questo studio non ha raccolto valutazioni, dati di tracciamento oculare o altre informazioni sul pubblico, non è possibile dedurre l'attivazione emotiva, la rilevanza visiva o la ricezione a partire dal solo contenuto dell'immagine.
I limiti sono teorici, metodologici e pratici. Dal punto di vista teorico, le categorie di segnali materiali semplificano il genere, le relazioni domestiche, la gerarchia giuridica, l'etnia e l'esperienza vissuta. Dal punto di vista metodologico, le inferenze sono limitate dalla sopravvivenza del materiale, dalle pratiche di raccolta, dalla digitalizzazione, dai metadati, dai modelli zero-shot, dalla codifica e da bias legati a periodi disomogenei. Sebbene la pipeline analitica dimostri una solida capacità di rilevamento di schemi, questi bias strutturali sottolineano la necessità di considerare gli output computazionali come analisi di convenzioni pittoriche piuttosto che come finestre trasparenti sulla realtà sociale qing. Dal punto di vista pratico, i diritti d'immagine limitano la ridistribuzione, e i risultati potrebbero non essere generalizzabili tra istituzioni, periodi, media o ambienti computazionali. Entro questi limiti, lo studio propone un quadro supervisionato dall'uomo per trasformare osservazioni visive ripetute in domande storiche verificabili, piuttosto che in conclusioni automatizzate. Trattandosi di uno studio interpretativo e non di un intervento, non ha valutato i progressi verso alcun Obiettivo di Sviluppo Sostenibile (SDG) o indicatore. Tuttavia, l'argomento trattato è pertinente all'Obiettivo 5, e la documentazione attenta ai diritti e l'impostazione educativa interculturale sono concettualmente allineate agli obiettivi 11.4 e 4.7; nessun risultato relativo agli SDG è stato misurato. Il pacchetto di riproducibilità fornito allinea lo studio alle recenti richieste di flussi di lavoro trasparenti nel campo del patrimonio digitale e ai requisiti FAIR relativi a identificatori persistenti, metadati ricchi, licenze, provenienza e dati, algoritmi, strumenti e flussi di lavoro riutilizzabili20,23.
Dichiarazioni
Gli autori non hanno nulla da dichiarare.
Ringraziamenti
Gli autori ringraziano il Victoria and Albert Museum, il British Museum, il Metropolitan Museum of Art, il Smithsonian National Museum of Asian Art, il Peabody Essex Museum, l'Hong Kong Museum of Art, la British Library, il Getty Research Institute e altre istituzioni detentrici e gruppi di catalogazione i cui record online hanno supportato la scoperta del corpus. L'accesso a un record online non implica il permesso di ridistribuirne l'immagine; i diritti a livello di pannello e i collegamenti alle fonti sono pertanto documentati separatamente. Gli autori riconoscono inoltre le comunità di ricerca aperta che supportano CLIP e SAM, nonché il supporto amministrativo fornito dalla City University of Macau e dalla Guangdong Polytechnic Normal University.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Modello visione-linguaggio utilizzato per l'immagine preliminare–analisi della similarità del testo e assegnazione di etichette preliminari di intelligenza artificiale. |
| Workstation informatico | Autori’ workstation informatico | GPU abilitata CUDA; configurazione hardware esatta da riportare | Postazione di lavoro utilizzata per l'inferenza CLIP e SAM e le analisi computazionali; le specifiche relative a GPU, CPU, RAM, sistema operativo e CUDA devono essere riportate dall'ambiente originale di esecuzione. |
| Matplotlib | Sviluppo del team di Matplotlib | pacchetto Python; versione esatta da riportare | Utilizzato per la visualizzazione computazionale e la generazione di figure e grafici di analisi. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Utilizzato per l'organizzazione dei metadati, la registrazione dei filtri e la gestione dei dati di studio in formato tabellare. |
| NumPy | Sviluppatori di NumPy | pacchetto Python; versione esatta da riportare | Utilizzato per il calcolo numerico e la manipolazione di matrici di caratteristiche delle immagini e di matrici analitiche. |
| pandas | pandas development team | pacchetto Python; versione esatta da riportare | Utilizzato per la gestione di dati strutturati, l'elaborazione di metadati e l'organizzazione degli output analitici a livello di singolo caso. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Ambiente di programmazione utilizzato per implementare il flusso di lavoro di analisi computazionale delle immagini. |
| PyTorch 2.0.1 | Fondazione PyTorch | PyTorch 2.0.1 | Framework di deep learning utilizzato per eseguire la codifica di immagini e testi basata su CLIP e l'inferenza su GPU. |
| scikit-learn | sviluppatori di scikit-learn | pacchetto Python; versione esatta da riportare | Utilizzato per il clustering K-means, il clustering gerarchico aggregativo, il coefficiente di siluetta, Davies–indice di Bouldin e Cohen’calcoli s kappa |
| Modello di Segmentazione Universale (SAM) | Meta AI Research | SAM | Modello di segmentazione utilizzato per localizzare figure femminili, capi di abbigliamento, mobili, strumenti, oggetti rituali e aree architettoniche per l'ispezione visiva. |
| umap-learn | McInnes et al. | Implementazione Python di UMAP | Utilizzato per la riduzione della dimensionalità e la visualizzazione bidimensionale degli embedding delle immagini CLIP con distanza coseno. |
Riferimenti
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.