VoiceNet-RAI integra caratteristiche MFCC, incorporamenti multilingue wav2vec 2.0 e EfficientNet-Lite per la classificazione del genere e dell'età a partire da dati vocali. Il framework raggiunge un'accuratezza fino al 97,87% nel sottoinsieme in lingua inglese e supporta applicazioni responsabili nel riconoscimento vocale, nell'autenticazione e nella perizia informatica.
È richiesta un abbonamento a JoVE per visualizzare questo contenuto. Accedi o inizia la tua prova gratuita.
Articolo di ricerca
VoiceNet: Un framework di intelligenza artificiale responsabile e multilingue per la classificazione del genere e dell'età tramite il parlato
127 visualizzazioni
⸱
11 settembre 2026
In questo articolo
Sommario
Abstract
Una classificazione accurata del genere e dell'età a partire dai dati vocali è importante per un'interazione uomo-computer (HCI) personalizzata, sicura ed etica. Con l'uso crescente di modelli preaddestrati su grandi quantità di dati per il riconoscimento vocale, come wav2vec 2.0, sorge la necessità di sfruttare tali rappresentazioni in modo responsabile per inferenze demografiche multilingue e rispettose della privacy. Questo studio propone VoiceNet-RAI, un framework di apprendimento profondo (DL) che integra i coefficienti cepstrali in scala di frequenza Mel (MFCC) con incorporamenti multilingui basati su transformer tratti da wav2vec 2.0, all'interno di un'architettura EfficientNet-Lite, al fine di supportare una classificazione accurata, equa e trasparente in diversi contesti linguistici. Il framework combina informazioni contestuali e spettrali per migliorare la robustezza in condizioni di registrazione variabili. Esperimenti condotti su dati vocali multilingui che coprono 28 lingue dimostrano prestazioni elevate nella classificazione, con un sottoinsieme inglese che raggiunge un'accuratezza del 97,87%, una precisione del 98,61%, un richiamo del 98,70% e un punteggio F1 del 98,65%. Una validazione esterna effettuata utilizzando il dataset Mozilla Common Voice ha prodotto un'accuratezza del 98,27% nella classificazione del genere, dimostrando la generalizzabilità su un dataset indipendente. Un'analisi di ablazione ha inoltre mostrato che la combinazione delle caratteristiche MFCC e wav2vec 2.0 migliora le prestazioni rispetto a rappresentazioni basate solo su dati grezzi o solo su MFCC. Questi risultati dimostrano il potenziale delle rappresentazioni vocali ibride spettrali-contestuali per una classificazione robusta e responsabile del genere e dell'età.
Introduzione
Il riconoscimento vocale è un componente fondamentale della comunicazione umana, attraverso il quale gli individui esprimono i propri sentimenti, pensieri e obiettivi. Le voci umane vengono prodotte attraverso un processo biologico in cui l'aria viene espirata dai polmoni e modellata in suoni dagli organi articolatori come le labbra, la lingua e i denti1. L'orecchio svolge un ruolo essenziale nell'identificazione della voce e può distinguere tra voci maschili e femminili in base a caratteristiche come volume e tono. Una caratteristica che contribuisce a differenze significative nel tono vocale tra maschi e femmine è il dimorfismo sessuale2. La classificazione per età e genere a partire dalla voce è rilevante per numerose applicazioni, tra cui l'interazione uomo-macchina, il riconoscimento automatico del genere, saluti personalizzati, pre-classificazione delle emozioni nel parlato e la classificazione delle chiamate basata sul genere3.
Il parlato è una parte intrinseca dell'interazione umana. La voce umana contiene molteplici caratteristiche che variano tra gli individui e possono fornire informazioni sugli stati emotivi e mentali, nonché sull'età e sul sesso. Queste caratteristiche multidimensionali possono essere utilizzate in applicazioni come sistemi di sicurezza basati sulla voce e assistenti di Intelligenza Artificiale (AI) orientati al parlato. Altri ambiti in cui l'analisi della voce riveste un'importanza fondamentale includono i sistemi di Verifica Automatica del Parlante (ASV) e i sistemi di intelligenza artificiale basati sulle emozioni. I sistemi di input basati sulla voce possono inoltre ridurre lo spazio di ricerca all'interno dei database4,5. Inoltre, i sistemi di sicurezza basati sull'AI possono utilizzare i dati vocali per applicazioni come indagini penali e protezione delle vittime. Le voci maschili e femminili presentano caratteristiche diverse a causa delle variazioni nelle proprietà risonanti del tratto vocale. Queste caratteristiche possono essere estratte dai segnali vocali in una forma adatta all'elaborazione computazionale, consentendo la classificazione del genere a partire dai dati vocali6,7. Pertanto, sono necessari algoritmi di apprendimento efficaci per la classificazione del genere basata sulla voce. Gli algoritmi di Deep Learning (DL) sono particolarmente adatti per la classificazione legata al parlato grazie alla loro capacità di apprendere modelli complessi dai dati audio. Tali modelli possono includere strati convoluzionali, ricorrenti, temporalmente convoluzionali o completamente connessi, a seconda dell'architettura. Questi strati possono apprendere caratteristiche acustiche rilevanti, tra cui tono e intonazione. Una volta addestrato, un modello può classificare il genere a partire da registrazioni audio mai viste in precedenza8. Un altro settore importante della ricerca nel campo del Machine Learning (ML) è la classificazione dell'età a partire da registrazioni vocali. Gli algoritmi di ML possono utilizzare caratteristiche acustiche come intonazione, timbro e ampiezza per identificare modelli legati all'età. Tecniche come l'Analisi delle Componenti Principali (PCA) possono inoltre essere applicate per estrarre modelli informativi dai dati vocali e potenzialmente migliorare le prestazioni di classificazione9.
L'apprendimento profondo (DL) ha dimostrato prestazioni elevate in applicazioni come il riconoscimento di immagini, emozioni e parlato. Le reti neurali profonde (DNN), in particolare, sono ampiamente utilizzate per compiti legati al parlato. In questo studio, approcci basati sul DL sono applicati alla classificazione della voce in combinazione con consolidate tecniche di estrazione delle caratteristiche. I coefficienti cepstrali nel dominio della frequenza mel (MFCC) catturano le caratteristiche spettrali rilevanti dei segnali vocali e forniscono una rappresentazione efficiente per l'elaborazione successiva. Le caratteristiche estratte sono successivamente integrate in un framework di apprendimento per trasferimento per la classificazione del genere e dell'età basata sulla voce10,11.
Studi recenti hanno adottato in misura crescente rappresentazioni del parlato basate su apprendimento auto-sorvegliato e architetture Transformer per la classificazione di attributi del parlante. I ricercatori hanno analizzato i bias demografici, inclusi i bias di genere ed età, in modelli del parlato auto-sorvegliati come HuBERT e wav2vec 2.0, sottolineando l'importanza di valutazioni consapevoli dell'equità12. Più di recente, approcci basati su Transformer e indipendenti dalla lingua hanno dimostrato l'efficacia delle rappresentazioni contestuali apprese per il riconoscimento del genere in condizioni multilingue e rumorose13. Sinha et al. hanno ulteriormente esaminato le rappresentazioni layer-wise di wav2vec 2.0 per la classificazione di età e genere, mostrando che diversi strati del Transformer catturano livelli differenti di informazioni relative al parlante14. Questi sviluppi motivano il framework proposto VoiceNet-RAI, che combina informazioni spettrali convenzionali basate su MFCC con rappresentazioni contestuali di wav2vec 2.0, integrando al contempo considerazioni multilingue e di Intelligenza Artificiale Responsabile.
Studi recenti hanno dimostrato che l'età e il genere del parlante possono essere caratterizzati utilizzando sia caratteristiche acustiche convenzionali sia rappresentazioni basate sull'apprendimento profondo. Gli approcci che combinano informazioni acustiche e temporali hanno mostrato che caratteristiche complementari del parlato possono migliorare le prestazioni nella classificazione di età e genere15,16. Ricerche correlate hanno inoltre dimostrato che caratteristiche del parlato trasformate, generate mediante rappresentazioni profonde a collo di bottiglia, possono migliorare le prestazioni nella classificazione dell'età e del genere del parlante17. Questi risultati supportano l'utilizzo più ampio di rappresentazioni spettrali, temporali e apprese per compiti di classificazione che coinvolgono segnali vocali e derivati dal parlato.
Diversi studi hanno analizzato il riconoscimento dell'età e del genere a partire dal parlato, utilizzando approcci basati sull'apprendimento automatico e sul deep learning18,19,20,21,22,23,24,25,26,27,28,29,30. Approcci più recenti hanno esplorato rappresentazioni trasformate degli MFCC e reti neurali profonde per la classificazione dell'età e del genere del parlante31, mentre la variabilità multilingue e dipendente dalla lingua rimane un aspetto importante da considerare nello sviluppo di sistemi robusti di classificazione demografica basati sulla voce. Differenze nella pronuncia, nella struttura fonetica, nelle caratteristiche del parlante e nelle condizioni di registrazione possono ridurre la generalizzabilità del modello tra lingue e popolazioni diverse. Di conseguenza, l'uso di rappresentazioni complementari del parlato, sia spettrali che contestuali, potrebbe migliorare la robustezza in contesti multilingui.
Sebbene approcci ibridi abbiano precedentemente combinato più caratteristiche acustiche o classificatori ensemble per il riconoscimento demografico basato sulla voce, VoiceNet-RAI si distingue integrando due livelli complementari di rappresentazione del parlato all'interno di un framework unificato. In particolare, le caratteristiche convenzionali MFCC preservano le caratteristiche spettrali e vocali localizzate, mentre wav2vec 2.0 fornisce rappresentazioni contestualizzate apprese dal parlato grezzo mediante un codificatore Transformer. Piuttosto che basarsi esclusivamente su descrittori acustici progettati manualmente o su una singola rappresentazione profonda, VoiceNet-RAI esegue una fusione a livello di caratteristiche delle rappresentazioni MFCC e wav2vec 2.0 aggregate temporalmente, quindi affina la rappresentazione ibrida risultante utilizzando EfficientNet-Lite. La novità scientifica risiede quindi nell'integrazione coordinata di rappresentazioni spettrali, contestuali auto-sorvegliate e profonde leggere per la classificazione di genere ed età, insieme a una valutazione multilingue, una validazione su dataset indipendenti e un'analisi dell'equità nei sottogruppi. Questa combinazione estende i tradizionali pipeline ibridi di classificazione del parlato oltre la fusione di caratteristiche orientata all'accuratezza, verso un framework che considera contemporaneamente la complementarità delle rappresentazioni, la progettazione di modelli leggeri, la generalizzabilità e l'Intelligenza Artificiale Responsabile.
I principali contributi di questa ricerca includono lo sviluppo di un approccio per l'identificazione del genere e dell'età a partire dai dati vocali, integrando le caratteristiche MFCC e quelle di wav2vec 2.0 con EfficientNet-Lite. Sono stati condotti esperimenti approfonditi su un dataset di registrazioni vocali provenienti da 28 lingue, valutando le caratteristiche originali, le caratteristiche MFCC, le caratteristiche wav2vec 2.0 e le loro combinazioni mediante modelli di ML e DL. Le prestazioni del modello sono state valutate sia utilizzando l'intero dataset multilingue che il sottoinsieme relativo alla lingua inglese. Il framework è stato ulteriormente valutato da una prospettiva multilingue e di Intelligenza Artificiale Responsabile, attraverso analisi di sottogruppi specifici per genere e lingua, una valutazione indipendente dal parlante e una validazione mediante il dataset Mozilla Common Voice. Inoltre, le prestazioni del framework proposto sono state confrontate con gli approcci all'avanguardia riportati nella letteratura esistente, fornendo anche risultati di cross-validazione. È stato condotto un ampio corpo di ricerca correlata e la Tabella 1 riassume questi studi, inclusi i modelli, i dataset e i risultati riportati19,20,21,22,23,24,25,26,27,28,29,30,31.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Protocollo
Questo studio ha utilizzato i set di dati pubblicamente disponibili BVC Challenging Voice Set e Mozilla Common Voice senza coinvolgimento diretto dei partecipanti. Pertanto, non è stato richiesto il parere del comitato etico istituzionale né un consenso informato aggiuntivo. Sono stati elaborati soltanto i dati necessari per la classificazione del genere e dell'età, e non è stato effettuato alcun tentativo di identificare i singoli parlanti. L'intera metodologia del flusso di lavoro del framework proposto è illustrata nella Figura 1.
Acquisizione dei dati
Il set di dati utilizzato nell'approccio proposto era composto da file audio in formato .wav ottenuti dal BVC Challenging Voice Set, un set di dati vocali pubblicamente disponibile sviluppato dal gruppo Biometrics Vision and Computing (BVC) e ospitato su GitHub32. Il set di dati conteneva registrazioni vocali di 526 individui, inclusi 336 parlanti maschi e 190 femmine. Comprendeva circa 3.964 registrazioni, incluse registrazioni di singole frasi e di più frasi per ciascun parlante. Tabella 2 riassume le caratteristiche demografiche, la copertura linguistica, le proprietà delle registrazioni, la strategia di partizionamento dei dati e le impostazioni di preelaborazione utilizzate per i set di dati vocali nel framework proposto VoiceNet-RAI.
Estrazione delle caratteristiche
I file audio sono stati elaborati per estrarne le proprietà essenziali, successivamente memorizzate in un file CSV. I metadati, inclusi età, sesso e pronuncia del parlante, sono stati estratti dai corrispondenti file README. Per elaborare i file WAV ed estrarre le caratteristiche rilevanti si è utilizzato Python insieme al pacchetto SciPy. Sono state impiegate la Trasformata di Fourier Veloce (FFT) e le funzioni di frequenza di NumPy per convertire i segnali audio dal dominio del tempo a quello della frequenza. I file WAV rappresentavano l'ampiezza come funzione del tempo; tuttavia, per il compito di classificazione risultavano di maggiore interesse le caratteristiche relative alla frequenza in grado di distinguere le voci maschili da quelle femminili33.
Per trasformare i segnali audio in rappresentazioni nel dominio della frequenza, è stata implementata la Trasformata Discreta di Fourier (DFT) utilizzando l'algoritmo FFT. La trasformata di Fourier converte un segnale nel dominio del tempo in uno spettro di frequenza. Poiché questo spettro non conservava informazioni temporali, il segnale audio è stato suddiviso in segmenti sovrapposti e la trasformata di Fourier è stata applicata a ciascun segmento mediante l'approccio della Trasformata di Fourier a Tempo Ridotto (STFT). La funzione np.fft.fft ha generato lo spettro di frequenza complesso, mentre np.fft.fftfreq ha fornito le frequenze campione corrispondenti. Nella directory di esempio erano disponibili 10 file audio per un singolo parlante. Ciascun file WAV è stato elaborato utilizzando finestre scorrevoli di 200 ms per estrarre le frequenze dominanti. Ad esempio, una registrazione audio di 4 secondi ha prodotto un elenco di 20 valori di frequenza. Per una directory contenente 10 registrazioni, le 10 liste corrispondenti, ciascuna contenente 20 valori di frequenza, sono state combinate in una lista di liste. Le frequenze sono state filtrate per mantenere solo i valori compresi tra 20 Hz e 280 Hz, escludendo al contempo il rumore potenziale intorno a 50 Hz.
Rappresentazione delle caratteristiche ibride MFCC e wav2vec 2.0
Per catturare sia le rappresentazioni contestuali del parlato a livello elevato sia le caratteristiche acustiche a basso livello, questo studio ha adottato una strategia ibrida di estrazione delle caratteristiche che integra le caratteristiche MFCC con gli embedding basati su Transformer di wav2vec 2.0.
Estrazione delle caratteristiche MFCC
I coefficienti cepstrali basati sulla scala di frequenza mel (MFCC) sono caratteristiche ampiamente utilizzate nell'elaborazione di segnali vocali e audio, in particolare per applicazioni come il riconoscimento vocale e l'identificazione del parlante34,35. In questo studio, l'estrazione degli MFCC ha trasformato i segnali audio in vettori di caratteristiche rappresentanti caratteristiche percettivamente rilevanti della voce. Il processo è iniziato con una pre-enfasi per potenziare le componenti ad alta frequenza, seguita da framing e finestramento per dividere il segnale in brevi frame sovrapposti. Ogni campione audio è stato inizialmente ricampionato a 16 kHz e suddiviso in frame di 25 ms con un'overlap di 10 ms. Successivamente, la Trasformata di Fourier Veloce (FFT) è stata applicata a ciascun frame per convertire il segnale dal dominio del tempo a quello della frequenza.
Lo spettro di frequenza risultante è stato elaborato attraverso una serie di bancche di filtri Mel che approssimavano la risposta in frequenza non lineare della percezione uditiva umana. Queste bancche di filtri enfatizzavano le frequenze più rilevanti dal punto di vista percettivo, riducendo al contempo il contributo di quelle meno informative. Successivamente, è stato calcolato il logaritmo dell'uscita di ciascuna banca di filtri per approssimare la sensibilità logaritmica dell'udito umano alla sonorità. Successivamente, è stata applicata una Trasformata Cosinusoidale Discreta (DCT) alle energie logaritmiche delle banche di filtri per decorrelare i coefficienti e generare una rappresentazione compatta del segnale audio. I coefficienti risultanti, noti come MFCC, catturavano le caratteristiche spettrali importanti del parlato. Gli MFCC sono stati utilizzati per la classificazione del genere e dell'età poiché catturavano caratteristiche acustiche in grado di differenziare le voci in base a questi attributi.
estrazione dell'embedding wav2vec 2.0
Il modello Wav2vec 2.0 Base è stato pre-addestrato su ampie corpora di dati vocali non etichettati. Il modello era composto da un codificatore Transformer a più strati che elaborava segnali audio grezzi in ingresso e generava incorporamenti vocali contestualizzati36.
Dato un'onda in ingresso x ∈ RT, il modello wav2vec 2.0 produce una sequenza di rappresentazioni latenti:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
dove ogni vettore di embedding aveva una dimensionalità di 768. Per ottenere una rappresentazione di lunghezza fissa adatta alla classificazione, è stata applicata un'operazione di media temporale su tutti i passi temporali.
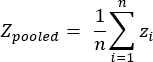 (2)
Meccanismo di fusione delle caratteristiche
Le caratteristiche MFCC e wav2vec 2.0 sono state fuse mediante concatenazione a livello di caratteristiche. In particolare, le caratteristiche MFCC sono state inizialmente aggregate utilizzando la media temporale per produrre un vettore di lunghezza fissa.
m ∈ R40 (3)
Il vettore finale di caratteristiche ibride è stato ottenuto come:
h = [m || zpooled] ∈ R808 (4)
dove || indica la concatenazione. Questa fusione ha combinato incorporamenti contestuali profondi con caratteristiche spettrali progettate manualmente, consentendo al modello di catturare sia informazioni semantiche di alto livello sia pattern acustici dettagliati.
Tutti i campioni audio sono stati inizialmente ricampionati a 16 kHz. Le caratteristiche MFCC sono state calcolate per frame e mediate temporalmente per produrre un vettore fisso di 40 dimensioni, mentre gli embedding di wav2vec 2.0 sono stati mediati nel tempo per generare una rappresentazione di 768 dimensioni. Poiché entrambi gli insiemi di caratteristiche sono stati convertiti in vettori di lunghezza fissa prima della fusione, non è stato necessario un allineamento temporale a livello di frame. Le rappresentazioni risultanti di MFCC e wav2vec sono state quindi concatenate in un vettore ibrido di 808 dimensioni prima di essere trasmesse al modello di classificazione.
Integrazione con EfficientNet-Lite
Il vettore di caratteristiche fuso, h, è stato riorganizzato in un formato adatto all'apprendimento delle caratteristiche ed è stato fornito come ingresso al modello EfficientNet-Lite per l'addestramento. Un livello di proiezione completamente connesso ha innanzitutto mappato il vettore di dimensione 808 in uno spazio latente di dimensioni superiori, dopodiché i blocchi di EfficientNet-Lite hanno affinato le caratteristiche gerarchiche. Sono stati utilizzati livelli di normalizzazione del batch e di dropout per ridurre l'overfitting e migliorare la generalizzazione del modello. La funzione di attivazione SoftMax è stata impiegata per generare le probabilità finali predette per le classi di genere ed età. La rappresentazione fusa, h ∈ R808, è stata inizialmente trattata come un vettore di caratteristiche unidimensionale e fatta passare attraverso un livello di proiezione completamente connesso che la ha mappata in 4.096 dimensioni. La rappresentazione proiettata è stata quindi riorganizzata in un tensore 1 × 64 × 64 prima di essere fornita all'architettura EfficientNet-Lite.
Per adattarsi alla rappresentazione delle caratteristiche del segnale vocale a canale singolo, anziché all'ingresso immagine convenzionale a tre canali, il livello convoluzionale iniziale di EfficientNet-Lite è stato modificato da tre a un solo canale in ingresso. I restanti blocchi di estrazione delle caratteristiche di EfficientNet-Lite sono stati mantenuti senza modifiche architetturali significative. È stato applicato un livello di pooling globale medio adattivo alle mappe di caratteristiche finali per produrre una rappresentazione di lunghezza fissa. La testa di classificazione originale è stata sostituita con un livello completamente connesso specifico per il compito, contenente due unità di uscita per la classificazione del genere e il numero corrispondente di unità di uscita per i gruppi d'età predefiniti. Infine, è stata applicata la funzione di attivazione SoftMax per generare le probabilità delle classi. La rappresentazione ibrida proposta combina embedding vocali moderni auto-sorvegliati con caratteristiche tradizionali di elaborazione del segnale. Gli embedding wav2vec 2.0 catturano informazioni contestuali e dipendenze a lungo raggio, mentre le caratteristiche MFCC forniscono informazioni acustiche complementari a basso livello. L'integrazione di queste rappresentazioni ha migliorato le prestazioni di classificazione, in particolare in condizioni di parlato rumoroso e multilingue.
Classificatore ML
In questa ricerca, le prestazioni di diversi algoritmi di apprendimento automatico sono state analizzate per la classificazione del genere e del gruppo di età basata sulla voce.
Foresta casuale
La foresta casuale (Random Forest, RF) è stata utilizzata come classificatore robusto di apprendimento automatico (Machine Learning, ML), combinando più alberi decisionali (Decision Trees, DTs) per migliorare l'accuratezza delle previsioni e ridurre l'overfitting. La RF ha operato attraverso una procedura di apprendimento d'insieme (ensemble learning) in cui le previsioni provenienti da più alberi sono state aggregate per generare la previsione finale37,38. Questo approccio ha permesso alla RF di individuare schemi diversificati nei dati riducendo al contempo l'overfitting comunemente associato ai singoli DTs. La casualità introdotta durante la costruzione degli alberi ha migliorato la generalizzabilità del modello, rendendo la RF adatta a compiti di classificazione come la classificazione del genere e dell'età a partire da dati vocali.
Regressione Logistica
La regressione logistica (LR) è stata utilizzata come modello statistico di apprendimento automatico per la classificazione39. Per la classificazione binaria, la LR stima la probabilità di un risultato in base alle caratteristiche di input mediante la funzione logistica (sigmoide), e le probabilità risultanti vengono utilizzate per generare le previsioni di classe. La LR era applicabile anche a problemi di classificazione multiclasse che coinvolgono più di due classi. Per la classificazione multiclasse, la LR ha utilizzato approcci come uno contro tutti o la regressione SoftMax, a seconda dell'impostazione della classificazione.
Classificatore Extra Tree
Il classificatore Extra Trees (ETC) è stato utilizzato come algoritmo di apprendimento ensemble che combina diversi alberi decisionali (DT) per generare previsioni40,41. A differenza della foresta casuale (RF), l'ETC introduce un ulteriore grado di casualità selezionando in modo casuale le caratteristiche candidate e le soglie di suddivisione durante la costruzione degli alberi. Questa procedura genera alberi meno correlati e riduce la sensibilità del modello a singole caratteristiche, migliorando così la robustezza al rumore. L'indice di Gini è stato utilizzato come criterio di suddivisione per valutare l'importanza delle caratteristiche e partizionare i dati.
Macchina a vettori di supporto
La macchina a vettori di supporto (SVM) è stata utilizzata come classificatore di apprendimento automatico (ML) per identificare un confine decisionale ottimale in uno spazio delle caratteristiche ad alta dimensionalità42. L'obiettivo consisteva nel determinare un iperpiano che massimizzasse il margine tra le classi. Un margine più ampio tra il confine decisionale e i punti dati più vicini generalmente favoriva una migliore separazione tra classi e una maggiore capacità di generalizzazione. L'SVM è applicabile a diverse attività di apprendimento automatico, inclusi classificazione, regressione e analisi dei dati basata su caratteristiche.
Reti neurali convoluzionali
Le reti neurali convoluzionali (CNN) sono state utilizzate come modelli di apprendimento profondo (DL) per compiti di classificazione che coinvolgono rappresentazioni strutturate di dati immagine e audio. Le CNN unidimensionali (1D-CNN) sono state inoltre ampiamente applicate a dati sequenziali e testuali. Le architetture CNN utilizzavano filtri convoluzionali e operazioni di pooling per estrarre caratteristiche discriminanti dai dati in ingresso43,44. Per la classificazione del genere e dell'età a partire da dati vocali, le CNN sono state applicate a rappresentazioni derivate dal parlato per apprendere modelli associati a tono, frequenza, intonazione e altre caratteristiche vocali rilevanti per distinguere tra gruppi di età e generi.
VGG19
VGG19 è stato utilizzato come architettura di apprendimento profondo caratterizzata da una struttura gerarchica di estrazione delle caratteristiche profonda e relativamente uniforme45. La sua architettura impiega piccoli filtri convoluzionali 3 × 3 su 19 strati, consentendo un'estrazione progressiva di caratteristiche discriminanti. Quando applicata a rappresentazioni derivate dal parlato, VGG19 cattura sia pattern acustici di basso livello, come le variazioni di tono e frequenza, sia caratteristiche discriminanti di livello superiore. La sua architettura profonda permette un'astrazione progressiva delle caratteristiche per modellare le caratteristiche vocali associate al genere e all'età.
EfficientNet-Lite
EfficientNet-Lite è stata utilizzata come architettura DL computazionalmente efficiente46,47. Il modello ha impiegato una strategia di ridimensionamento bilanciata per ottenere prestazioni elevate nella classificazione, richiedendo al contempo meno risorse computazionali rispetto ad architetture DL più pesanti. Il suo approccio di ridimensionamento composto ha considerato congiuntamente profondità, larghezza del modello e risoluzione dell'ingresso per ottenere un'estrazione efficiente delle caratteristiche.
EfficientNet-Lite è stato selezionato per il framework proposto VoiceNet-RAI grazie alla sua architettura leggera e al vantaggioso equilibrio tra prestazioni di classificazione e complessità del modello. Rispetto ad architetture più pesanti, utilizza blocchi convoluzionali efficienti e una scalatura composta per ottenere un apprendimento efficace delle caratteristiche con un numero ridotto di parametri e minori requisiti computazionali. Queste caratteristiche rendono EfficientNet-Lite adatto al framework di classificazione vocale proposto e ne favoriscono il potenziale impiego in ambienti con risorse limitate.
MobileNet
MobileNet è stato utilizzato come architettura DL leggera per applicazioni con risorse computazionali limitate, inclusi ambienti di calcolo mobile ed edge48. L'efficienza computazionale è stata ottenuta principalmente attraverso convoluzioni separabili per profondità, che hanno ridotto il numero di parametri e di operazioni computazionali rispetto alle architetture convoluzionali tradizionali. Queste caratteristiche hanno reso MobileNet adatto alla valutazione della classificazione per genere ed età a partire da dati vocali, mantenendo requisiti computazionali relativamente bassi.
InceptionV3
InceptionV3 è stato utilizzato come architettura profonda per estrarre caratteristiche gerarchiche da rappresentazioni derivate dal parlato49. L'architettura integrava operazioni convoluzionali, di pooling e miste per estrarre caratteristiche a diversi livelli di astrazione. Per la classificazione del genere e dell'età a partire dai dati vocali, InceptionV3 è stato impiegato per apprendere modelli acustici complessi e rappresentazioni gerarchiche associate alle variazioni nelle caratteristiche vocali.
Parametri di valutazione
L'accuratezza è stata una delle metriche di valutazione più frequentemente utilizzate per i compiti di classificazione50. Sebbene l'accuratezza fornisca una misura utile delle prestazioni complessive della classificazione, non sempre offre una valutazione completa, in particolare per set di dati sbilanciati. Pertanto, sono state utilizzate metriche aggiuntive, tra cui precisione, richiamo e punteggio F1, per valutare le prestazioni del modello. Queste metriche hanno fornito una valutazione più completa considerando le previsioni corrette e quelle errate per ciascuna classe.
L'accuratezza è stata definita come il rapporto tra osservazioni correttamente classificate e numero totale di osservazioni. Sebbene l'accuratezza fosse particolarmente informativa per dataset bilanciati, il dataset utilizzato in questo studio era sbilanciato. Pertanto, i Veri Positivi (TP), Falsi Positivi (FP), Veri Negativi (TN) e Falsi Negativi (FN) sono stati considerati nel calcolo e nell'interpretazione delle metriche di classificazione. L'equazione riportata di seguito rappresenta la definizione standard di accuratezza:
Precisione = (VP+VN)/(VP+VN+FP+FN)×100 (5)
La precisione valuta la capacità del classificatore di restituire solo istanze rilevanti:
Precisione= TP/(TP+FP) ×100 (6)
Il richiamo, noto anche come sensibilità, misura la capacità del classificatore di identificare tutte le istanze rilevanti:
Sensibilità= VP/(FN+VP) × 100 (7)
L'F1-score combina precisione e richiamo in una singola misura ed è particolarmente utile per valutare le prestazioni di classificazione su dataset sbilanciati:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Risultati
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Discussione
Questo studio ha sviluppato e valutato un framework automatizzato per la classificazione del genere e dell'età a partire da dati vocali, integrando caratteristiche MFCC e incorporamenti wav2vec 2.0 con EfficientNet-Lite. Nei primi esperimenti, EfficientNet-Lite ha raggiunto un'accuratezza del 83,48%, una precisione dell'82,87%, un richiamo del 84,28% e un punteggio F1 del 83,54% utilizzando le caratteristiche originali. Dopo l'integrazione delle caratteristiche MFCC, le prestazioni sono migliorate notevolmente, con un'ac...
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Dichiarazioni
Gli autori non hanno conflitti di interessi da dichiarare.
Ringraziamenti
Gli autori desiderano ringraziare il progetto di sostegno alla ricerca dell'Università Princess Nourah bint Abdulrahman (PNURSP2026R748), Università Princess Nourah bint Abdulrahman, Riyadh, Arabia Saudita, per il finanziamento di questa ricerca.
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Insieme vocale impegnativo BVC | Biometrics Vision and Computing Group / OgeNI | Insieme vocale impegnativo BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, variante esatta utilizzata | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| Unità di elaborazione grafica (GPU) | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Dataset Mozilla Common Voice | Fondazione Mozilla | Common Voice, versione utilizzata negli esperimenti | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | Sviluppatori NumPy | Versione esatta utilizzata negli esperimenti | https://numpy.org/ |
| Processore | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Fondazione Python Software | Versione esatta utilizzata negli esperimenti | https://www.python.org/ |
| PyTorch | Fondazione PyTorch | Versione esatta utilizzata negli esperimenti | https://pytorch.org/ |
| Scikit-learn | Sviluppatori Scikit-learn | Versione esatta utilizzata negli esperimenti | https://scikit-learn.org/ |
| SciPy | Sviluppatori SciPy | Versione esatta utilizzata negli esperimenti | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, edizione/versione esatta se disponibile | https://www.microsoft.com/windows/windows-11 |
Riferimenti
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Accesso limitato. Accedi o avvia una prova gratuita per visualizzare questo contenuto.