Questo protocollo integra registrazioni comportamentali multimodali per valutare i correlati osservabili dello sforzo cognitivo e l'efficacia funzionale della revisione nella traduzione scritta e nell'interpretazione simultanea dall'inglese al cinese. Il metodo combina la registrazione dei battiti sulla tastiera, l'acquisizione dello schermo, l'analisi audio, la codifica basata su trascrizioni e una valutazione della qualità standardizzata.
Articolo metodologico
Un protocollo comportamentale per valutare lo sforzo cognitivo e la revisione strategica nei compiti di traduzione e interpretazione a vista dall'inglese al cinese
In questo articolo
Sommario
Abstract
Questo articolo presenta un protocollo comportamentale multimodale per esaminare i correlati osservabili dello sforzo cognitivo e della revisione strategica durante la traduzione scritta e l'interpretazione simultanea dall'inglese al cinese. Per la traduzione scritta vengono sincronizzati i registri delle battute a macchina e le registrazioni dello schermo, mentre per l'interpretazione simultanea si utilizzano registrazioni audio e trascrizioni letterali. Gli episodi di revisione e di autorettifica vengono codificati per tipo e per esito funzionale (efficace, neutro o dannoso), indipendentemente dalle valutazioni globali della qualità dell'output. In una dimostrazione condotta con 62 partecipanti suddivisi in gruppi di principianti ed esperti, entrambi i gruppi hanno completato le due condizioni di compito in ordine controbilanciato. I partecipanti esperti hanno ottenuto punteggi medi più elevati per la qualità dell'output nella traduzione scritta (20,1 ± 2,1 rispetto a 16,8 ± 2,3) e nell'interpretazione simultanea (18,9 ± 2,4 rispetto a 15,4 ± 2,6), nonché una proporzione maggiore di revisioni o autorettifiche efficaci. Poiché le pause, le cancellazioni, la latenza iniziale e la densità di revisione sono indicatori indiretti e sensibili al compito, vengono interpretati come correlati comportamentali che richiedono una triangolazione piuttosto che misure dirette di un costrutto unitario. Il protocollo è concepito per testi espositivi controllati e può essere adattato ad altre coppie linguistiche dopo aver ricalibrato le modalità di inserimento, le soglie delle pause, la comparabilità dei testi e le procedure di valutazione.
Introduzione
La traduzione scritta e l'interpretazione simultanea da inglese a cinese richiedono comprensione del testo sorgente, trasferimento interlinguistico e formulazione nella lingua di arrivo, ma impongono condizioni operative diverse. La traduzione scritta permette una lettura ricorsiva e una revisione differita, mentre l'interpretazione simultanea richiede una produzione orale sotto vincoli temporali più stringenti. Carico cognitivo, difficoltà di elaborazione e sforzo cognitivo sono costrutti correlati ma non intercambiabili: il carico riguarda le esigenze del compito, mentre lo sforzo riguarda le risorse che un partecipante impiega per farvi fronte. Lo sforzo cognitivo è latente e multidimensionale; pertanto, latenza, pause, omissioni e densità di revisione sono considerate qui come correlate comportamentali che possono riflettere processi di pianificazione, monitoraggio, motori o difficoltà, e devono essere interpretate congiuntamente piuttosto che come misurazioni dirette dello sforzo1,2,3,4,5,6,7,8.
La ricerca orientata ai processi combina i punteggi del prodotto con registrazioni comportamentali allineate nel tempo per identificare quando e come avvengono le decisioni di traduzione. La registrazione dei battiti sulla tastiera è utile per analizzare le sequenze di produzione e revisione, ma la composizione del testo cinese tramite metodo di inserimento può separare gli eventi fisici dei tasti dai caratteri effettivamente inseriti; è quindi necessaria una registrazione sincronizzata dello schermo per ricostruire lo stato del testo visibile9,10,11. Le soglie delle pause sono scelte analitiche e non confini cognitivi universali, e soglie più brevi possono modificare sostanzialmente le conclusioni basate sulle pause8,12. Di conseguenza, il protocollo richiede verifiche esplicite di sincronizzazione, analisi della sensibilità alle soglie e distinzione tra misure specifiche del compito e misure condivise.
La frequenza delle revisioni da sola non indica se il monitoraggio migliori un output. Le revisioni scritte e le autocorrezioni orali possono riguardare la scelta lessicale, la sintassi, il significato o lo stile, ma il loro esito funzionale deve essere valutato in relazione al significato della fonte e al segmento precedente nella lingua di arrivo. La ricerca sull'interpretazione simultanea da e verso l'inglese e il cinese mostra che formazione, direzionalità, coordinamento occhi-voce e fattori specifici della lingua che innescano problemi possono alterare i modelli di prestazione13,14,15,16. Per questo motivo, tipo di episodio, esito dell'episodio, qualità del prodotto finale e comportamenti legati all'erogazione vengono codificati come variabili distinte.
Il protocollo è stato progettato per adulti o traduttori/interpreti esperti che lavorano con brevi testi espositivi non specialistici in sessioni controllate basate su computer. È particolarmente adatto quando è possibile acquisire registrazioni di battute e schermo per la produzione scritta, e registrare audio di alta qualità per la produzione orale. Il quadro metodologico può essere adattato ad altre coppie linguistiche, ma il confronto testuale, la segmentazione in unità informative, il comportamento della tastiera o del metodo di inserimento, le soglie di pausa e gli indicatori di valutazione devono essere riconvalidati per ciascuna coppia linguistica e sistema di scrittura17. La dimostrazione confronta le condizioni del compito piuttosto che attribuire tutte le differenze esclusivamente alla modalità, poiché variano anche la lunghezza del testo, i limiti di tempo, la modalità di output e le opportunità di revisione.
Protocollo
Tutti i metodi che prevedono l'utilizzo di soggetti umani sono stati eseguiti nel rispetto delle linee guida istituzionali e hanno ricevuto l'approvazione esplicita del Comitato per l'Etica della Ricerca Umana dell'Istituto di Informatica di Guilin (Numero di approvazione: UYHAJ2025899). Il consenso informato scritto è stato ottenuto da tutti i partecipanti prima della loro partecipazione. Si prega di consultare la Tabella dei Materiali per un elenco completo delle attrezzature e del software utilizzati in questo studio.
1. Reclutamento dei partecipanti e assegnazione ai gruppi
- Reclutare 62 partecipanti, compresi studenti di lingua inglese o di traduzione e tirocinanti professionisti di interpretariato. Verificare che tutti i partecipanti siano madrelingua cinesi con vista e udito normali o corretti alla normalità.
- Assegnare ai partecipanti con meno di 12 mesi di formazione strutturata in traduzione il gruppo di principianti, e quelli con almeno 12 mesi al gruppo esperto. Riportare separatamente la pratica precedente di traduzione scritta e di interpretariato a vista per tutti i partecipanti.
- Esaminare i partecipanti prima dell'assegnazione del compito per escludere coloro che hanno avuto un'esposizione precedente ai testi sorgente, deficit sensoriali non corretti o incapacità nell'utilizzo del metodo standardizzato di inserimento del testo cinese.
- Escludere i compiti dopo la registrazione solo per motivi predeterminati, come l'uso non consentito di strumenti esterni, esecuzione incompleta, file corrotti o audio inutilizzabili.
- Conservare un registro delle esclusioni dei compiti senza informazioni personali identificabili. Riportare il campione finale analizzato in modo coerente nel testo e nella Figura 1A–D.
2. Selezione dei materiali e valutazione pilota
- Selezionare brevi testi espositivi in inglese provenienti da ambiti accademici generali, educativi, sociali o della comunicazione pubblica. Utilizzare testi per traduzione scritta di circa 180–220 parole e testi per interpretazione simultanea di circa 120–160 parole.
- Accoppiare o aggiustare statisticamente la lunghezza del testo, la difficoltà lessicale, la complessità sintattica, la densità informativa e la familiarità con l'argomento tra le diverse condizioni di compito.
- Chiedere a tre esperti bilingui di valutare in modo indipendente difficoltà lessicale, complessità sintattica, densità informativa, familiarità con l'argomento e idoneità al trasferimento su una scala da 1 a 5 (1 = molto bassa, 5 = molto alta).
- Calcolare un coefficiente di correlazione intraclasse (ICC) con effetti casuali bilaterali e un intervallo di confidenza del 95% per le valutazioni medie. Rivedere gli elementi che mostrano un accordo scarso (ICC < 0,75).
- Mantenere le coppie di testi solo quando le variabili standardizzate di accoppiamento rientrano in un margine di tolleranza del ±10%.
- Definire un'unità informativa come la più piccola proposizione nel testo sorgente che esprime un'idea, una relazione o un evento valutabile autonomamente. Risolvere le divergenze sui confini prima dell'amministrazione del compito.
- Effettuare un test pilota delle istruzioni, del metodo di inserimento, della sincronizzazione, della qualità del suono e dei limiti di tempo con partecipanti che non saranno inclusi nell'analisi principale. Registrare le distribuzioni dei tempi di completamento e la proporzione di partecipanti che raggiungono ciascun limite di tempo.
- Rivedere un testo o un limite di tempo qualora i partecipanti del test pilota mostrino prestazioni al massimo o al minimo della scala, ambiguità persistente o instabilità nella registrazione. Documentare ogni modifica prima dell'avvio dello studio principale.
3. Somministrazione del compito e configurazione della registrazione
- Testare i partecipanti singolarmente in una stanza tranquilla e insonorizzata, utilizzando configurazioni standardizzate di hardware e software.
- Leggere uno script di istruzioni standardizzato e consentire un elemento di prova non sperimentale. È vietato l'uso di dizionari, motori di ricerca, intelligenza artificiale generativa, traduzione automatica e corpora esterni.
- Controbilanciare i due ordini delle attività (traduzione scritta prima rispetto all'interpretazione simultanea prima) all'interno di ciascun gruppo di formazione e mantenere un intervallo di riposo di 5 minuti.
- Preparare l'elenco di assegnazione prima del completamento del reclutamento e mantenere nascosta l'assegnazione fino alla conferma dell'idoneità. Se vengono utilizzati più testi sorgente, controbilanciare l'identità del testo indipendentemente dall'ordine delle attività e conservare una variabile di identificazione del testo per l'analisi.
- Presentare il testo sorgente inglese in modo continuo e istruire il partecipante a produrre una traduzione cinese accurata e naturale nel campo di input designato. È consentita la modifica libera, ma è rigorosamente vietato incollare testo proveniente dall'esterno.
- Applicare il limite massimo di 20 minuti stabilito nel test preliminare senza mostrare un cronometro, e registrare se tale limite viene raggiunto.
- Registrare continuamente l'intero processo di traduzione scritta, utilizzando un software di registrazione delle battute sincronizzato con la registrazione continua dello schermo. Conservare le traduzioni finali insieme ai file di registro con timestamp per successive estrazioni comportamentali.
- Presentare il testo sorgente per l'interpretazione simultanea sullo schermo e istruire il partecipante a iniziare una resa orale in cinese senza appunti scritti.
- Applicare costantemente il limite massimo di 6 minuti e registrare se tale limite viene raggiunto. Distinguere un'osservazione limitata nel tempo da un'osservazione completata regolarmente.
- Registrare l'output orale mediante software di acquisizione audio digitale. Generare trascrizioni rigorosamente verbatim da queste registrazioni per facilitare la codifica successiva.
4. Estrazione di indicatori del processo comportamentale
- Estrai i correlati comportamentali del compito scritto dai file di registro, definendo la latenza iniziale come l'intervallo tra l'inizio dello stimolo e il primo carattere cinese inserito.
- Estrai il tempo totale del compito, il numero e la durata delle pause, la frequenza di cancellazione, la densità di revisione e la velocità di produzione. Mantieni i timestamp grezzi e il denominatore esatto utilizzato per ciascuna misura normalizzata.
- Utilizza 2 s come soglia operativa per le pause scritte. Indica se le pause durante la navigazione con il cursore, la selezione del testo o la scelta dei candidati del metodo di inserimento sono incluse.
- Estrai i correlati comportamentali del compito orale dall'onda sonora e dalla trascrizione verificata, definendo la latenza iniziale come l'intervallo tra la presentazione dello stimolo e il primo enunciato significativo nella lingua bersaglio.
- Escludi l'inalazione, lo schiarimento della gola e i suoni non lessicali abbandonati dal calcolo della latenza iniziale. Estrai il tempo totale di interpretazione, le pause silenziose, le pause riempite, le ripetizioni, i falsi inizi, le autocorrezioni e la velocità del parlato.
- Definisci una pausa silenziosa orale come un silenzio all'interno di un enunciato di almeno 1,0 s. Verifica i confini delle pause confrontandoli con l'onda sonora e la trascrizione verificata ed escludi i silenzi iniziali e finali dal conteggio delle pause all'interno dell'enunciato.
- Compila un registro di controllo qualità per ogni compito somministrato. Documenta se il file di processo applicabile è leggibile e completo, se la trascrizione è stata verificata e se la codifica è stata completata o sottoposta a verifica. Conserva il registro originale e traccia tutte le correzioni nel registro di audit.
5. Codifica della revisione strategica e dell'autocorrezione orale
- Ricostruire ogni revisione scritta allineando il log dei tasti premuti, il video dello schermo e il testo finale.
- Trattare un episodio come una sequenza continua di azioni di modifica rivolte allo stesso segmento bersaglio e chiudere l'episodio quando la produzione riprende altrove per almeno 2 s o quando viene modificato un segmento diverso.
NOTA: Per l'input cinese, distinguere le modifiche di composizione prima del conferimento dalle cancellazioni del testo bersaglio dopo il conferimento e codificare solo queste ultime come revisioni testuali. - Assegnare un tipo principale di revisione in base a cambiamenti semantici, sintattici, lessicali o stilistici. Consentire un'etichetta secondaria nei casi sovrapposti, ma utilizzare l'etichetta principale per conteggi mutuamente esclusivi. Applicare gli esempi pratici forniti nel Supplementary File 1.
- Produrre una trascrizione verbale con timestamp prima di codificare l'autocorrezione orale. Istruire il primo trascrittore a segnalare contenuti lessicali, pause riempitive, ripetizioni, falsi inizi, interruzioni e segmenti inintelligibili.
- Fare in modo che un secondo revisore esperto verifichi la trascrizione rispetto all'audio e risolva le discrepanze mantenendo i timestamp originali dell'audio.
- Definire un'autocorrezione orale come una riformulazione esplicita che sostituisce, completa o corregge un segmento immediatamente precedente nella lingua bersaglio. Non dedurre un monitoraggio nascosto dal silenzio da solo. Applicare le stesse regole decisionali lessicali, sintattiche, semantiche e stilistiche all'autocorrezione orale.
- Codificare una ripetizione esatta senza modifica correttiva come disfluenza, un inizio abbandonato seguito da una nuova costruzione come falso inizio più correzione, e un'omissione o una traduzione errata senza riformulazione esplicita come errore di output.
- Quando l'audio non è chiaro o quando due categorie risultano ugualmente plausibili, contrassegnare l'episodio come ambiguo. Mantenere etichette provvisorie per gli episodi ambigui e risolverli prima dell'analisi dell'affidabilità.
- Valutare l'esito funzionale confrontando i segmenti bersaglio pre-episodio e post-episodio con l'unità informativa sorgente e il contesto locale del testo bersaglio. Effettuare questa valutazione prima di rivelare il punteggio globale finale. Non utilizzare un cambiamento nel punteggio globale come definizione di efficacia.
- Codificare due volte almeno il 20% degli output selezionati tra entrambi i gruppi e gli ordini di compito, e calcolare l'affidabilità sui codici indipendenti prima della risoluzione delle discrepanze.
- Riformare e ricodificare quando l'accordo tra i valutatori scende al di sotto di un kappa di Cohen di 0,80. Documentare esattamente questa soglia e tutte le azioni correttive intraprese.
6. Valutazione della qualità e modellizzazione statistica
- Valutare ogni traduzione scritta finale e resa di interpretazione a prima vista utilizzando la griglia analitica da 25 punti riportata nel File Supplementare 1.
- Assegnare un punteggio da 0 a 5 per accuratezza, completezza, appropriatezza lessicale, coerenza e naturalezza nella lingua di destinazione, utilizzando gli indicatori specificati. Non interpolare i criteri di valutazione dopo aver esaminato l'appartenenza ai gruppi.
- Indicare ai valutatori di utilizzare sia l'audio che la trascrizione verificata per le dimensioni relative all'interpretazione a prima vista. Analizzare le misure di pausa e disfluenza separatamente dai punteggi della griglia.
- Formare due valutatori indipendenti utilizzando il manuale operativo e almeno 10 esempi di pratica, mantenendo i valutatori ciechi rispetto al gruppo dei partecipanti e all'ordine delle attività.
- Dopo la valutazione indipendente e la codifica degli episodi, calcolare l'affidabilità prima della discussione. Risolvere le divergenze di opinione mediante consenso e consultare un terzo valutatore solo qualora non si raggiunga un accordo.
- Indicare un coefficiente di correlazione intraclasse a effetti casuali bilaterali e ad accordo assoluto per i punteggi continui medi della qualità. Riportare il kappa di Cohen per il codice primario di revisione e un kappa separato per il codice di esito efficace/neutro/dannoso. Specificare il numero esatto e la percentuale di episodi codificati due volte.
- Verificare che ogni file di processo sia leggibile e completo prima dell'analisi, allineare i registri delle attività scritte con i corrispondenti registri schermo e controllare la corrispondenza delle trascrizioni con l'audio.
- Registrare i fallimenti di allineamento, i problemi di intelligibilità e le azioni correttive in un registro di controllo qualità. Normalizzare le misure di frequenza utilizzando 100 unità informative del testo originale per la frequenza delle pause e 100 caratteri cinesi prodotti per la densità di revisione scritta.
- Codificare l'esito funzionale in modo indipendente dal punteggio finale di qualità olistica. Codificare un episodio come efficace quando il segmento post-revisione migliora il testo senza introdurre nuovi errori, come neutro quando non produce alcun cambiamento sostanziale e come dannoso quando introduce un errore.
- Calcolare il tasso di efficacia come numero di episodi efficaci diviso per il totale degli episodi classificabili, escludendo gli episodi ambigui dal denominatore.
- Analizzare la dimostrazione come un dataset esplorativo a misure ripetute. Specificare il modello a effetti fissi per prevedere il punteggio totale di qualità utilizzando la condizione di compito, il gruppo di formazione, le metriche di pausa, la densità di revisione, il tasso di efficacia, il carico di disfluenza e la velocità del parlato.
- Includere un effetto casuale per partecipante (intercetta), e includere effetti casuali per il testo originale solo se il disegno sperimentale include un numero sufficiente di testi campionati in modo indipendente.
- Centrare i predittori continui, esaminare i residui e verificare la collinearità. Riportare il metodo di stima, la versione del software, β, SE, IC 95%, valori p esatti, componenti della varianza, AIC, BIC e R2 marginale/condizionale. Descrivere l'analisi come esplorativa ed evitare affermazioni causali di tipo confermativo.
- Esportare un pacchetto di analisi riproducibile contenente dati anonimizzati, dizionario, manuale operativo, griglia di valutazione, dettagli del software, script e risultati. Verificare che ogni valore in figure e tabelle possa essere ricondotto a una variabile e a un passaggio analitico specificati prima della pubblicazione.
Risultati
Caratteristiche basali dei partecipanti e disponibilità dei dati
Il questionario comprendeva 62 partecipanti (31 principianti e 31 esperti), e il foglio delle attività conteneva 124 registrazioni, indicando due registrazioni di attività completate per partecipante (Tabella 1). Il gruppo di principianti aveva meno di 12 mesi di formazione strutturata in traduzione (massimo osservato, 8,6 mesi), mentre il gruppo esperto aveva almeno 12 mesi di formazione (minimo osservato, 13,3 mesi). Le distribuzioni per età, sesso, durata dell'apprendimento dell'inglese, livello di competenza e ordine delle attività erano simili tra i gruppi. Figura 1 riporta il campione finale analizzato e distingue correttamente i dati specifici per attività: i log dei battiti a tastiera e le registrazioni schermo si riferiscono alla traduzione scritta, le registrazioni audio e le trascrizioni verbatim si riferiscono all'interpretazione simultanea, e le valutazioni di qualità si applicano a entrambe.
Profili comportamentali in diverse condizioni di compito
I profili comportamentali differivano tra le due condizioni di compito e tra i gruppi di addestramento (Tabella 2; Figura 2A–E). La traduzione scritta presentava tempi di completamento più lunghi e pause medie più prolungate, mentre l'interpretazione simultanea presentava un numero maggiore di pause ogni 100 unità informative al di sotto della soglia riportata. All'interno di ciascuna condizione di compito, il gruppo addestrato completava i compiti più rapidamente e otteneva punteggi medi di output più elevati. Questi contrasti non devono essere interpretati come effetti puramente legati alla modalità, poiché anche la lunghezza del testo, il limite di tempo, la modalità di output e l'opportunità di revisione differivano. Le pause non sono uniformemente disruptive: una pausa può riflettere una difficoltà irrisolta, una pianificazione riuscita, un'attività di monitoraggio o un'azione legata al metodo di input; pertanto, le misure relative alle pause vengono interpretate insieme alle misure di revisione, consegna e qualità.
Ripensamento strategico, auto-correzione e modellizzazione predittiva
Il framework di codifica ha separato il tipo di episodio dall'esito funzionale (Tabella 3; Figura 3A–D). I partecipanti addestrati hanno prodotto più episodi di revisione scritta rispetto ai principianti (12,4 ± 3,7 contro 8,9 ± 3,0 per compito), mentre il numero totale di autoricorsi orali non differiva in modo significativo tra i gruppi (4,9 ± 1,6 contro 4,4 ± 1,5 per compito). Tuttavia, il gruppo addestrato ha mostrato una proporzione maggiore di episodi efficaci in entrambi i compiti. Il riepilogo degli effetti misti riportato nella Tabella 4 presenta associazioni piuttosto che percorsi causali; pertanto, la Figura 3E mostra le stime degli effetti fissi riportate e gli intervalli di confidenza anziché un diagramma causale.
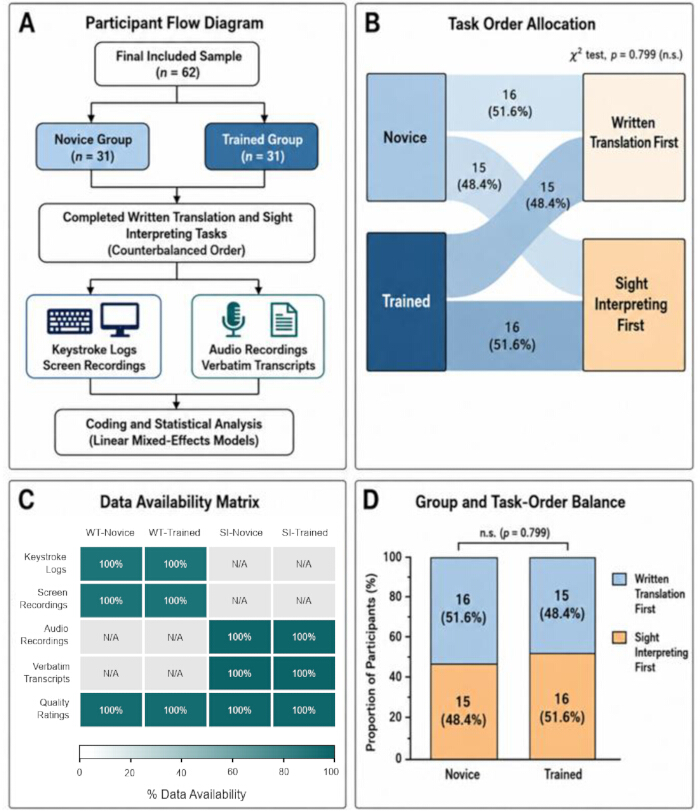
Figura 1: Flusso dei partecipanti, assegnazione dell'ordine delle attività e disponibilità dei dati specifici per attività. (A) Campione finale analizzato di 62 partecipanti e 124 registrazioni delle attività. (B) Assegnazione controbilanciata dell'ordine delle attività all'interno dei gruppi di principianti e addestrati. (C) Matrice di disponibilità in cui i log delle pressioni dei tasti e le registrazioni schermo sono applicabili solo alla traduzione scritta, le registrazioni audio e le trascrizioni verbali solo all'interpretazione simultanea, e le valutazioni di qualità a entrambe le attività. (D) Bilanciamento tra gruppo e ordine (test chi-quadrato, p = 0,799). n = 62 partecipanti (31 per gruppo). Cliccare qui per visualizzare una versione ingrandita di questa figura.
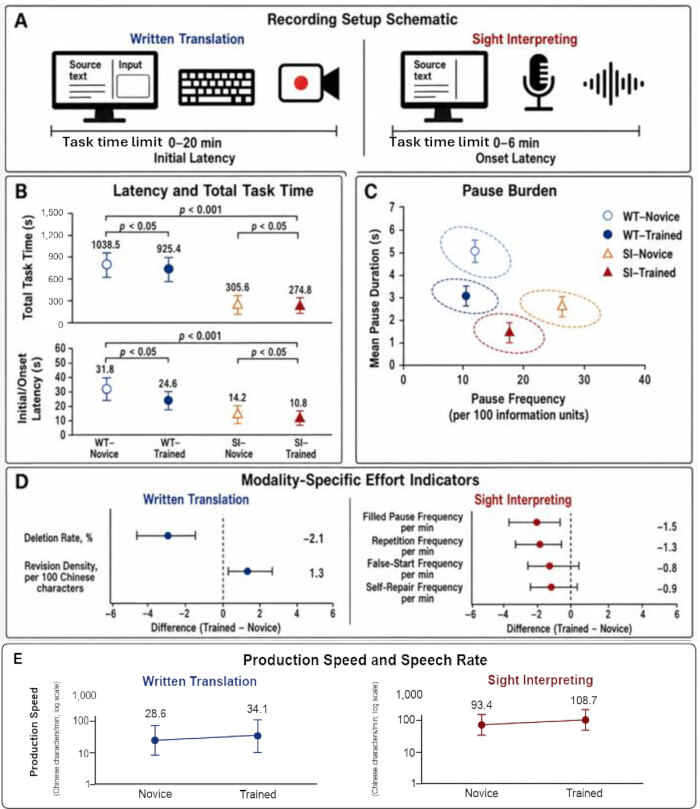
Figura 2: Profili comportamentali nelle condizioni di compito di traduzione scritta e interpretazione simultanea. (A) Setup di registrazione specifico per compito. (B) Latenza iniziale/di inizio e tempo totale del compito. (C) Distribuzione congiunta della frequenza delle pause e della durata media delle pause. (D) Indicatori specifici per compito di eliminazione, revisione e disfluenza orale. (E) Velocità di produzione scritta e velocità del parlato orale. Nei pannelli B, C ed E, i punti e le barre di errore mostrano le medie del gruppo ± DS; nel pannello D, i punti mostrano le differenze medie tra esperti e principianti e le barre di errore mostrano gli intervalli di confidenza al 95%. n = 31 partecipanti per gruppo. Nel pannello E, l'asse y è visualizzato su scala logaritmica. Cliccare qui per visualizzare una versione ingrandita di questa figura.
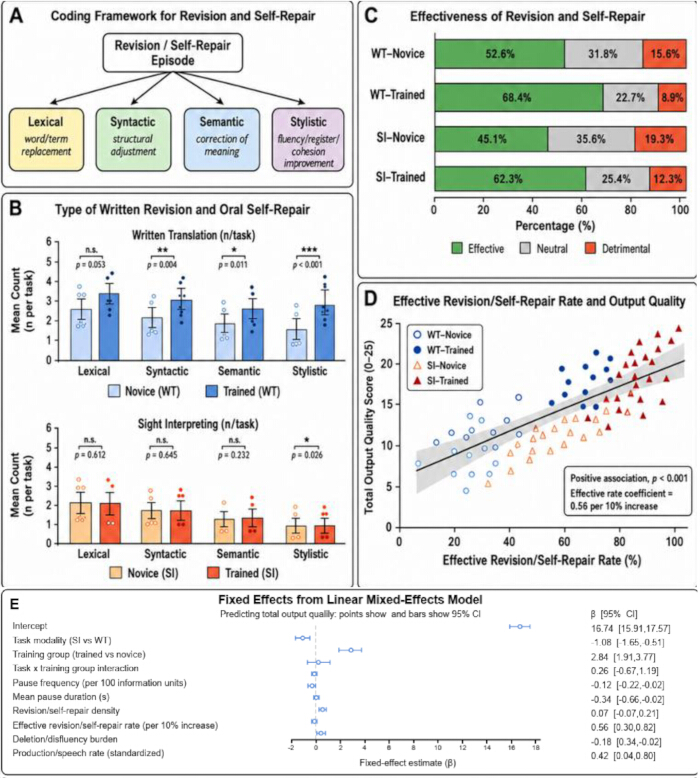
Figura 3: Codifica della revisione/autoricorso, esiti funzionali e associazioni con la qualità dell'output. (A) Quadro decisionale per l'assegnazione indipendente del tipo di episodio e dell'esito funzionale. (B) Valori medi di episodi lessicali, sintattici, semantici e stilistici in ciascuna condizione di compito. (C) Proporzioni medie di episodi efficaci, neutrali e dannosi. (D) Associazione descrittiva tra la frequenza di episodi efficaci e il punteggio totale di qualità dell'output. (E) Grafico a foreste che mostra gli effetti fissi di un modello lineare a effetti misti con intervalli di confidenza al 95% (dettagli in Tabella 4); il grafico indica un'associazione e non rappresenta un modello causale. Cliccare qui per visualizzare una versione ingrandita di questa figura.
| Variabili | Gruppo principiante (n = 31) | Gruppo addestrato (n = 31) | Valore di p |
| Età, anni | 21.9 ± 1.7 | 22.4 ± 1.9 | 0.279 |
| Femmine, n (%) | 22 (71,0) | 21 (67,7) | 0.779 |
| Durata dell'apprendimento dell'inglese, anni | 12,4 ± 2,1 | 12,9 ± 2,2 | 0,36 |
| Punteggio di competenza in inglese | 548,6 ± 41,3 | 562,4 ± 45,8 | 0,216 |
| Durata della formazione in traduzione, mesi | 5,6 ± 3,0 | 18,7 ± 5,4 | <0,001 |
| Durata della formazione in interpretariato, mesi | 2,3 ± 2,1 | 13,9 ± 5,7 | <0,001 |
| Pratica precedente di traduzione scritta ≥5 compiti, n (%) | 9 (29,0) | 24 (77,4) | <0,001 |
| Pratica precedente di interpretariato a prima vista ≥5 compiti, n (%) | 5 (16,1) | 20 (64,5) | <0,001 |
| Traduzione scritta per prima, n (%) | 16 (51,6) | 15 (48,4) | 0,799 |
| Interpretariato a prima vista per primo, n (%) | 15 (48,4) | 16 (51,6) | 0,799 |
Tabella 1: Caratteristiche dei partecipanti e profili iniziali di formazione linguistica per gruppo. Le variabili sono riportate come media ± deviazione standard per i dati continui e come conteggi (percentuali) per i dati categoriali. I valori di p riportati riflettono confronti tra gruppi per verificare l'equilibrio demografico iniziale e confermare le differenze previste nella durata della formazione.
| Variabili | Traduzione scritta Principiante (n = 31) | Traduzione scritta Esperto (n = 31) | Interpretazione a vista Principiante (n = 31) | Interpretazione a vista Esperto (n = 31) | Effetto del compito p | Effetto del gruppo p |
| Latenza iniziale/di inizio, s | 31,8 ± 12,4 | 24,6 ± 9,7 | 14,2 ± 5,6 | 10,8 ± 4,2 | <0,001 | 0,003 |
| Tempo totale del compito, s | 1038,5 ± 168,2 | 925,4 ± 151,6 | 305,6 ± 59,3 | 274,8 ± 50,7 | <0,001 | 0,004 |
| Frequenza delle pause, per 100 unità informative | 18,6 ± 6,1 | 14,2 ± 5,0 | 24,8 ± 7,4 | 19,6 ± 6,3 | <0,001 | 0,001 |
| Durata media delle pause, s | 4,1 ± 1,2 | 3,3 ± 1,0 | 2,7 ± 0,8 | 2,3 ± 0,7 | 0,012 | 0,002 |
| Velocità di produzione/eloquio, caratteri cinesi/min | 28,6 ± 6,7 | 34,1 ± 7,5 | 93,4 ± 18,9 | 108,7 ± 20,4 | 0,001 | |
| Tasso di omissione, % | 8,9 ± 3,4 | 6,8 ± 2,7 | 0,009 | |||
| Densità di revisione, per 100 caratteri cinesi | 7,6 ± 2,8 | 8,9 ± 3,1 | 0,087 | |||
| Frequenza delle pause riempite, per min | 5,7 ± 1,9 | 4,2 ± 1,6 | 0,002 | |||
| Frequenza di ripetizione, per min | 4,9 ± 1,8 | 3,6 ± 1,4 | 0,004 | |||
| Frequenza di false partenze, per min | 2,8 ± 1,1 | 2,0 ± 0,9 | 0,006 | |||
| Frequenza di autorettifica, per min | 4,8 ± 1,7 | 3,9 ± 1,4 | 0,031 | |||
| Punteggio totale di qualità, 0–25 | 16,8 ± 2,3 | 20,1 ± 2,1 | 15,4 ± 2,6 | 18,9 ± 2,4 | 0,002 | <0,001 |
| Accuratezza, 0–5 | 3,4 ± 0,7 | 4,1 ± 0,6 | 3,1 ± 0,8 | 3,8 ± 0,7 | 0,004 | <0,001 |
| Completezza, 0–5 | 3,3 ± 0,8 | 4,0 ± 0,6 | 3,0 ± 0,8 | 3,7 ± 0,7 | 0,006 | <0,001 |
| Adeguatezza lessicale, 0–5 | 3,2 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,041 | <0,001 |
| Coesione, 0–5 | 3,5 ± 0,6 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,6 | 0,003 | <0,001 |
| Naturalità nella lingua target, 0–5 | 3,4 ± 0,7 | 4,0 ± 0,6 | 3,1 ± 0,7 | 3,8 ± 0,7 | 0,007 | <0,001 |
Tabella 2: Indicatori del processo comportamentale e qualità dell'output nelle diverse condizioni di compito e gruppi. I valori sono espressi come media ± deviazione standard. I valori p riportati indicano gli effetti principali della modalità del compito (traduzione scritta rispetto all'interpretazione simultanea) e del background formativo (principiante rispetto a esperto) su ciascuna variabile di processo e di qualità.
| Variabili | Traduzione scritta Principiante | Traduzione scritta Esperto | p valore | Interpretazione a vista Principiante | Interpretazione a vista Esperto | p valore |
| Revisione lessicale/autocorrezione, n/compito | 3,4 ± 1,5 | 4,2 ± 1,7 | 0,053 | 1,8 ± 0,8 | 1,7 ± 0,7 | 0,612 |
| Revisione sintattica/autocorrezione, n/compito | 2,1 ± 1,1 | 3,0 ± 1,2 | 0,004 | 1,1 ± 0,7 | 1,2 ± 0,8 | 0,645 |
| Revisione semantica/autocorrezione, n/compito | 1,8 ± 1,0 | 2,5 ± 1,1 | 0,011 | 0,9 ± 0,6 | 1,1 ± 0,7 | 0,232 |
| Revisione stilistica/autocorrezione, n/compito | 1,6 ± 0,9 | 2,7 ± 1,2 | <0,001 | 0,6 ± 0,4 | 0,9 ± 0,6 | 0,026 |
| Totale episodi di revisione/autocorrezione, n/compito | 8,9 ± 3,0 | 12,4 ± 3,7 | <0,001 | 4,4 ± 1,5 | 4,9 ± 1,6 | 0,209 |
| Episodi efficaci, % | 52,6 ± 13,5 | 68,4 ± 12,1 | <0,001 | 45,1 ± 14,2 | 62,3 ± 13,0 | <0,001 |
| Episodi neutrali, % | 31,8 ± 10,4 | 22,7 ± 8,8 | 0,001 | 35,6 ± 11,7 | 25,4 ± 9,6 | 0,001 |
| Episodi dannosi, % | 15,6 ± 7,1 | 8,9 ± 5,6 | <0,001 | 19,3 ± 8,6 | 12,3 ± 6,8 | 0,001 |
Tabella 3: Tipo ed efficacia delle revisioni scritte e delle autoricompense orali nelle diverse condizioni di compito. I tipi di episodio sono riportati come conteggi medi per compito (± deviazione standard), e gli esiti funzionali sono riportati come percentuali medie (± deviazione standard). I valori di p indicano la significatività delle differenze tra gruppi all'interno di ciascuna modalità di compito.
| Effetti fissi | β | SE | IC 95% | valore p |
| Intersezione | 16,74 | 0,42 | 15,91 a 17,57 | <0,001 |
| Modalità del compito: interpretazione simultanea vs traduzione scritta | -1,08 | 0,29 | -1,65 a -0,51 | <0,001 |
| Gruppo di formazione: esperti vs principianti | 2,84 | 0,47 | 1,91 a 3,77 | <0,001 |
| Interazione tra modalità del compito e gruppo di formazione | 0,26 | 0,47 | -0,67 a 1,19 | 0,581 |
| Frequenza delle pause, ogni 100 unità informative | -0,12 | 0,05 | -0,22 a -0,02 | 0,018 |
| Durata media delle pause, s | -0,34 | 0,16 | -0,66 a -0,02 | 0,041 |
| Densità di revisione/autocorrezione | 0,07 | 0,07 | -0,07 a 0,21 | 0,334 |
| Tasso efficace di revisione/autocorrezione, ogni aumento del 10% | 0,56 | 0,13 | 0,30 a 0,82 | <0,001 |
| Carico di omissioni/disfluenze | -0,18 | 0,08 | -0,34 a -0,02 | 0,027 |
| Velocità di produzione/eloquio, standardizzata | 0,42 | 0,19 | 0,04 a 0,80 | 0,032 |
Tabella 4: Effetti fissi riportati dal modello lineare a effetti misti che prevede la qualità complessiva dell'output. Il riepilogo riporta i coefficienti non standardizzati (β), gli errori standard (SE), gli intervalli di confidenza al 95% (CI) e i valori p esatti per tutti i predittori relativi al compito e al comportamento specificati.
Discussione
Questo studio illustra un protocollo multimodale per misurare indicatori di processo osservabili e codificare la revisione strategica nella traduzione scritta e nell'interpretazione simultanea inglese-cinese. Il protocollo non misura direttamente una variabile unitaria dello sforzo cognitivo. Piuttosto, la latenza, le pause, le cancellazioni e i modelli di revisione vengono interpretati come correlati comportamentali sensibili al compito, il cui significato dipende dalla triangolazione con registrazioni sincronizzate e prove di qualità dell'output1,2,3,4,5,6,7,8. I due compiti differiscono anche per materiali, tempistiche, modalità di output e opportunità di revisione; i confronti rappresentativi descrivono quindi differenze legate alle condizioni del compito piuttosto che effetti isolati della modalità. Il principale contributo analitico consiste nella separazione della frequenza di revisione dall'esito funzionale. Nei riassunti riportati, i partecipanti addestrati hanno effettuato un numero maggiore di revisioni scritte, non minore, mentre il numero totale di autoricorrezioni orali non ha mostrato differenze significative tra i gruppi. Le proporzioni più elevate di episodi efficaci suggeriscono che la valutazione della qualità potrebbe essere più informativa della semplice frequenza grezza, ma questa interpretazione dipende da regole decisionali trasparenti, codifica indipendente degli esiti e affidabilità dichiarata. Il manuale di codifica e gli esempi svolti nel File Supplementare 1 hanno lo scopo di rendere questa distinzione riproducibile piuttosto che promozionale.
I passaggi critici sono l'allineamento tra registrazioni, la qualità dell'audio, la verifica della trascrizione e la coerenza della codifica. I timestamp disponibili e i segnali relativi ai confini delle attività devono essere verificati durante l'allineamento dei log e delle registrazioni. L'audio deve essere esaminato per rilevare clipping e intelligibilità prima della trascrizione, e i confini delle pause proposti devono essere verificati confrontandoli con l'onda sonora e la trascrizione. Per l'input cinese, le pressioni dei tasti durante la composizione non devono essere equiparate alle revisioni dei caratteri inseriti. Questi controlli e le relative azioni correttive devono essere registrati in un log di controllo qualità.
L'interpretazione è limitata da diversi fattori. La dimostrazione utilizza coorti di studenti e tirocinanti, brevi testi espositivi generali, diverse lunghezze di compito e limiti di tempo, e un campione basato sulla disponibilità. Le condizioni del compito differiscono inoltre per la modalità di output e le opportunità di revisione, e il dataset non contiene identificatori di testi sorgente campionati in modo indipendente, necessari per stimare la variazione a livello testuale. Inoltre, le soglie delle pause sono scelte operative, e pause più lunghe possono riflettere sia una pianificazione produttiva sia difficoltà non risolte. Una generalizzazione a professionisti, domini specializzati, altre coppie linguistiche o altri sistemi di scrittura richiede una nuova validazione dei materiali, delle modalità di gestione dell'input, delle soglie e degli ancoraggi di valutazione.
Lavori futuri potranno combinare i registri comportamentali con il tracciamento oculare, la pupillometria o misure soggettive del carico di lavoro per verificare a quali pause e revisioni corrispondano attenzione, sforzo percepito o pianificazione efficace5,6,13,14,15,16. Shreve et al. hanno utilizzato il tracciamento oculare nella traduzione a vista e non devono essere citati come uno studio di pupillometria18; la pupillometria è discussa direttamente da Seeber5. Tali estensioni multimodali dovrebbero mantenere distinte la domanda complessiva del compito, lo sforzo investito, il comportamento osservato e la prestazione. Il presente protocollo è pertanto meglio utilizzato come un quadro trasparente di valutazione del processo, i cui indicatori supportano, ma di per sé non dimostrano, affermazioni relative allo sforzo cognitivo latente.
Dichiarazioni
Gli autori dichiarano di non avere conflitti di interessi commerciali o finanziari. Per quanto riguarda l'uso dell'intelligenza artificiale, gli autori dichiarano che OpenAI Codex è stato utilizzato durante il processo di revisione esclusivamente per assistere nella correzione linguistica, nei controlli di coerenza, nella preparazione delle revisioni tracciate e nella rigenerazione dei layout delle figure sulla base dei dati forniti dagli autori. Gli autori hanno attentamente esaminato tutti gli output assistiti dall'IA e si assumono piena responsabilità per l'accuratezza, l'integrità e l'originalità del manoscritto finale. La cartella di lavoro strutturata alla base dei riassunti riportati è disponibile pubblicamente su Zenodo (https://doi.org/10.5281/zenodo.21189434). Il File Supplementare 1 contiene il manuale di codifica e la griglia di valutazione qualitativa ancorata.
Ringraziamenti
L'autore ringrazia l'Istituto di Tecnologia dell'Informazione di Guilin per il supporto di laboratorio, gli esperti bilingui che hanno valutato i testi originali, i valutatori indipendenti e i partecipanti. Questa ricerca non ha ricevuto alcun finanziamento specifico da agenzie di finanziamento nei settori pubblico, commerciale o no-profit.
Materiali
| Nome | Azienda | Numero di catalogo | Commenti |
|---|---|---|---|
| Software per l'analisi acustica (Praat) | Paul Boersma e David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Computer desktop | Dell | OptiPlex | |
| Software per la registrazione audio digitale (Audacity) | Squadra Audacity | https://www.audacityteam.org/ | |
| Software per la registrazione dei tasti premuti (Inputlog) | Università di Anversa | https://www.inputlog.net/ | |
| Software per la registrazione dello schermo (OBS Studio) | Progetto OBS | https://democreator.wondershare.com/ | |
| Software per l'analisi statistica (SPSS) | IBM | Versione 27 |
Riferimenti
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Ristampe e permessi
Questo articolo è stato pubblicato
Video in arrivo